2026-10-15·Run 生命周期·Run 生命周期
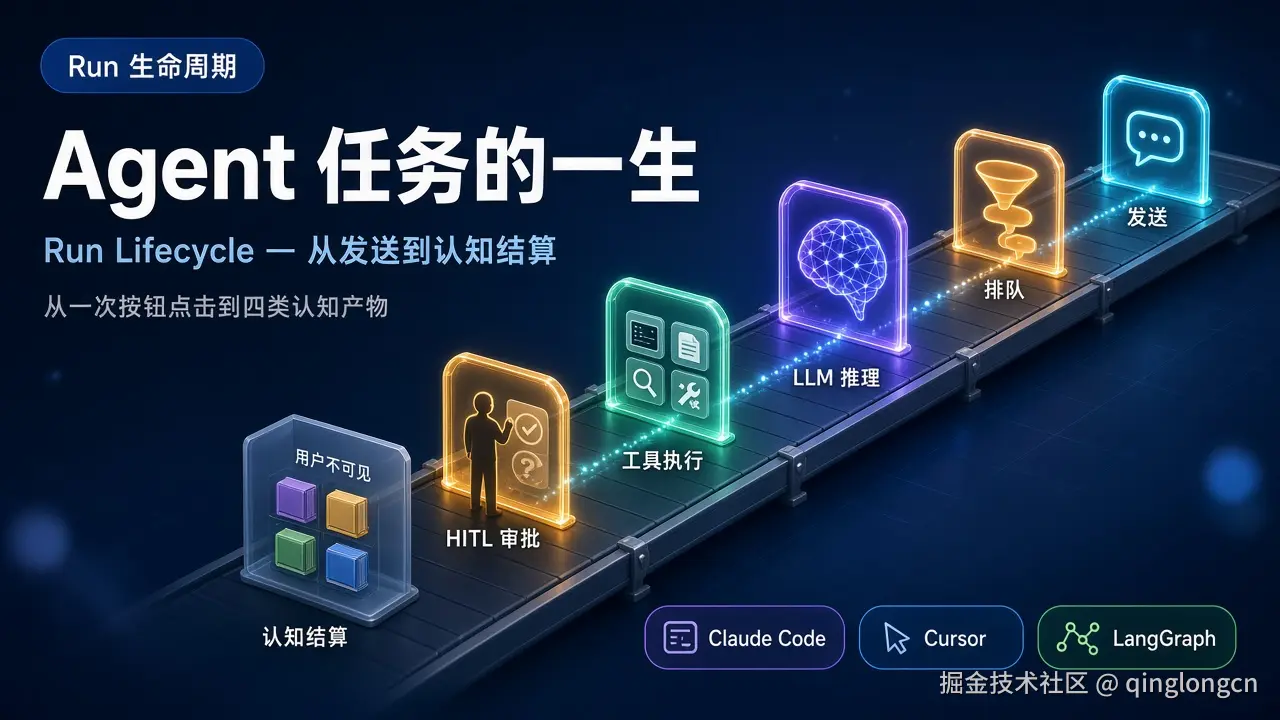
用户按下发送后发生了什么?任务排队、LLM 推理、工具执行、认知结算------一个完整的 Agent 任务比一次 API 调用复杂得多。本文用 Claude Code、Cursor、LangGraph Platform 和一个独立 Agent 引擎四种方案的实际行为,走完一次 Agent 任务的完整生命周期。
不是一次函数调用
在大多数 Agent 框架中,执行一次任务像调函数:result = agent.run("帮我修代码")------发送、等待、返回。
但生产环境中的 Agent 任务(我们称之为 Run)远比一次函数调用复杂:
- 它可能持续 5 分钟到 2 小时(SWE-bench 上的复杂 issue 修复经常超过 30 分钟、100+ 步工具调用)
- 中途可能需要等用户审批("Agent 要删文件,你确认吗?")
- 网络可能断了(但任务应该继续跑------不能因为 Wi-Fi 断 5 秒就丢 30 分钟的工作)
- 用户可能点了"停止"(Agent 正在写文件,不能直接杀------会留下损坏的文件)
- 进程可能崩了(OOM / panic / 机器重启------下次启动用户要能看到发生了什么)
每个 Agent 产品都必须面对这些问题。 我们来看不同产品和框架怎么处理。
各种产品和框架的任务管理
Claude Code:CLI 会话
Claude Code 的"任务"是一次 CLI 会话。用户在终端输入消息,Agent 跑完后等待下一条输入。
任务创建 :用户输入一行文字 → 进入 while 循环。Claude Code 官方文档(code.claude.com)将其描述为"gather context → take action → verify results"三阶段循环。 并发控制 :无------CLI 是单线程单会话。同一时刻只有一个任务在跑。 任务恢复 :--resume 恢复上次会话------加载历史消息后开新循环。会话存储是 append-only 的(arXiv:2604.14228)。这是会话级恢复 (重建上下文),不是任务级续播 (从事件 seq=47 继续)。 进程崩溃:对话历史存盘在本地,进程退出不丢失。但正在执行的工具调用的结果会丢失。子 Agent 最多嵌套 3 层(code.claude.com/docs/en/sub-agents)。
Cursor Agent Mode:编辑器集成
Cursor 的任务和 IDE 深度集成------Agent 直接操作编辑器 buffer(内存中的文件内容),而非磁盘文件。
任务创建 :用户在 Chat Panel 发消息 → Agent 开始。 并发控制 :同一个工作区同一时刻只能有一个 Agent 任务------第二个会被拒绝("该工作区已有生成任务进行中")。这防止了两个任务并发修改同一个文件的竞态。 可见性 :用户实时看到 Agent 在读什么文件、改什么代码。Apply 机制让代码修改先 diff 预览再确认。 可逆性:Revert 一键撤销 Agent 的所有修改------这是 Cursor 最好的"安全网"之一。
LangGraph Platform:图结构编排
LangGraph 是 LangChain 团队的 Agent 编排框架,2024-2025 年从 AgentExecutor 演进到图结构编排。它的任务管理围绕 Thread 和 Run 两个核心概念。
任务创建 :一个 Thread 是对话容器(类似 Session),一个 Run 是这个 Thread 内的一次执行。客户端调用 POST /threads/{id}/runs 创建 Run(LangGraph Platform 文档,langchain-ai.github.io)。 并发控制 :同一 Thread 同一时刻只允许一个活跃 Run------第二个会排队等待。不同 Thread 之间完全并行。这和编程类 Agent"同对话同一时刻只跑一个"的思路一致。 Checkpoint 三级持久性 :LangGraph 的 Checkpoint 机制是其任务管理的核心。每个 super-step boundary (图中一个节点执行完毕的边界)自动保存状态。Checkpoint 有三种持久性级别:durability="sync" 每步同步持久化到数据库、"async" 异步写入(崩溃时可能丢失当前步)、"exit" 仅在图执行完毕时保存。自部署方案使用 PostgresSaver 持久化(docs.langchain.com)。 Interrupt / Resume :Agent 执行到某个节点时可以暂停(interrupt),等用户审批后 Resume 从 Checkpoint 继续。这是内置的人机交互支持 ------不需要自己写审批逻辑。 Pending Writes:并行节点中已完成的节点的输出作为"pending writes"保存在 Checkpoint 中。如果某个并行分支失败,已完成分支的结果不需要重新执行------从 Checkpoint 恢复时只重跑失败的分支。
Temporal 和 Inngest:持久执行引擎
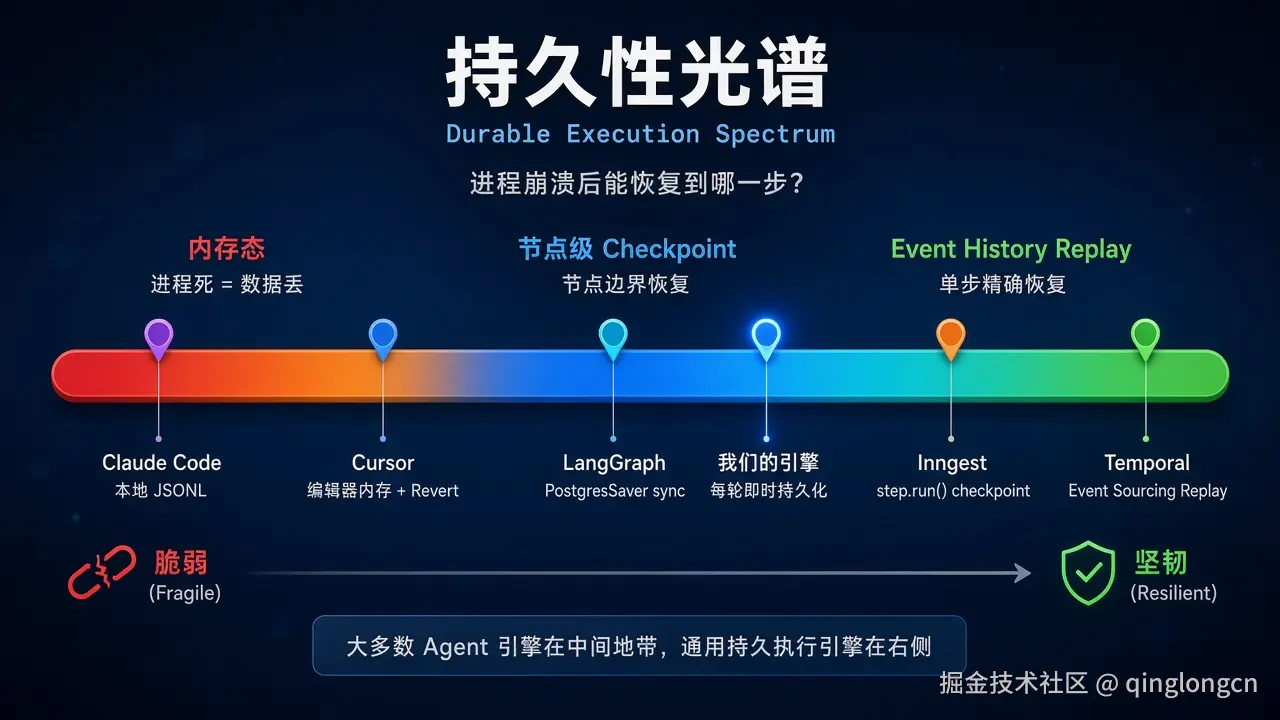
LangGraph 的 Checkpoint 解决了框架内 的状态持久化,但它的恢复粒度是节点级------节点内部崩溃(比如一次 LLM 调用跑了 30 秒后 OOM)会导致整个节点重执行。Temporal 和 Inngest 提供了更细粒度的持久执行(durable execution)。
Temporal 的核心机制是事件溯源(event sourcing):它记录每一步的输入和输出,进程崩溃后通过 replay 恢复到精确的那一步。Temporal 团队的博客(temporal.io/blog)称之为"the thread is the workflow"------工作流就是代码本身,不需要状态机转换。2025 年推出的 Temporal LangGraph 插件让 LangGraph 作为 Temporal Workflow 运行,把 LangGraph 的图结构编排和 Temporal 的系统级持久性结合在一起。
Inngest 采用不同策略:用 step.run() 包裹每次 LLM 调用和工具执行,每个 step 自动 checkpoint + retry。Inngest 文档(inngest.com/docs)将其定义为"a durable agent is a durable workflow whose next step is chosen by a model"。限制也很明确:每个函数最多 1000 步、每步结果最大 4MiB、总状态最大 32MiB。
大多数 Agent 引擎没有直接采用 Temporal 或 Inngest ,原因不是它们不好,而是 Agent 任务有自己的持久化需求------对话历史、记忆、工具执行记录需要以特定结构存储,通用的持久执行引擎需要大量适配。但它们提供的持久性光谱是理解任务管理的好框架:从"内存中、进程死即丢"到"每一步持久化、replay 恢复",每种方案都在这条光谱上占据一个位置。
我们的引擎:多租户服务端
我们的引擎是服务端运行的------可能同时服务多个用户、多个部门。
任务创建 :请求进入一个有界队列(满了返回 HTTP 429"稍后再试")。Supervisor 按序取出执行。 并发控制 :两层------① Cell 级(同一个租户同时可以跑多少任务,受配额限制)② Session 级(同一个对话同一时刻只允许一个任务------保证对话历史的线性一致性)。 任务状态 :从创建到完成有明确的状态转换------排队中 → 执行中 → 等待审批(HITL)→ 认知结算 → 完成/终止。每个状态的含义和转换条件是确定的。 认知结算 :任务结束时有一个用户不可见的收尾步骤------让模型回顾对话,产出会话摘要(下次对话注入)、长期记忆(跨会话可用)、反思和学习。
五个必须面对的工程问题
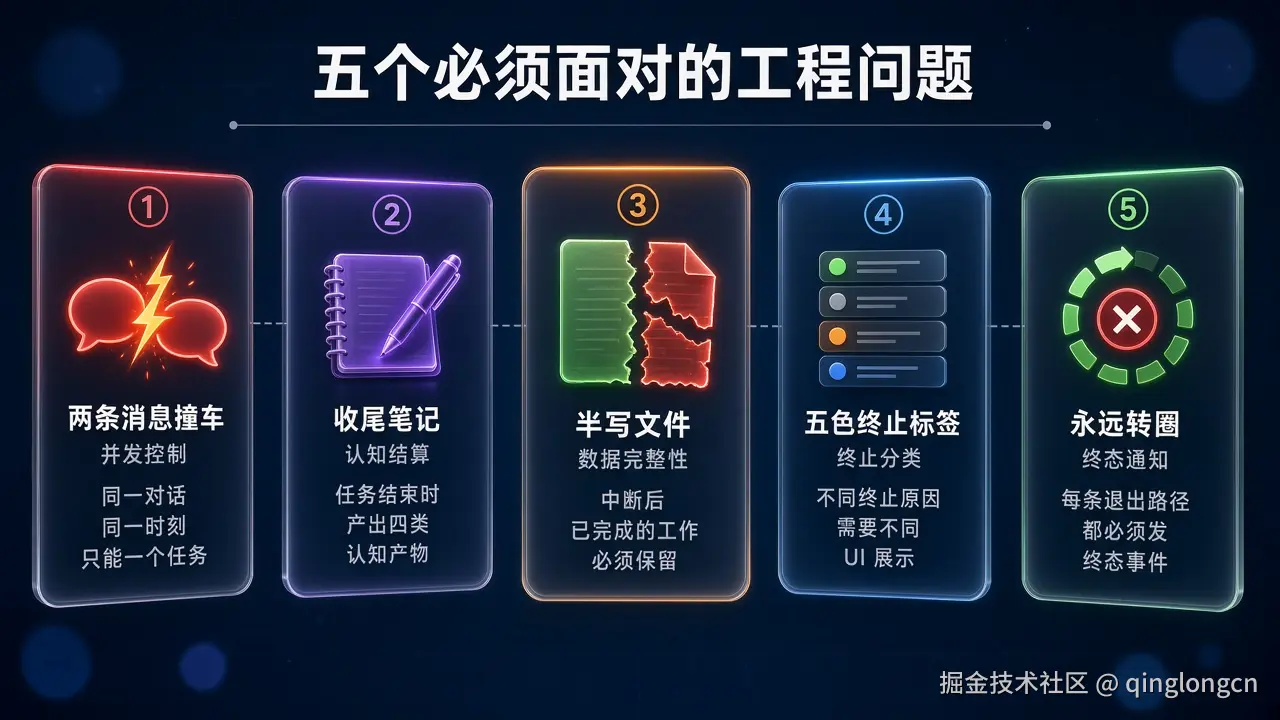
无论你用哪种架构,以下五个问题都需要答案。
问题一:同一个用户快速发两条消息会怎样?
场景:用户发了"帮我改 auth 模块",Agent 开始跑。3 秒后用户又发"等等,先看看 auth 的测试"。
如果允许两个任务并发跑同一个对话:两者同时往消息历史追加内容 → 消息顺序混乱 → 下次加载历史时 LLM 看到不一致的对话 → 推理质量劣化。
正确做法:同一个对话同一时刻只允许一个活跃任务。第二条消息要么排队(等第一个跑完),要么中断第一个再开始第二个。Claude Code 天然避免了这个问题(CLI 单线程);Cursor 用 chatInFlight 锁;LangGraph Platform 在同一 Thread 内排队(后续 Run 等待前一个完成);我们的引擎在协议层强制同一 Session 单任务串行。
值得注意的是,LangGraph 的并发控制是 Thread 级 的------不同 Thread 之间完全并行,同一 Thread 内严格串行。这和我们的设计不谋而合:对话是串行的自然单位,不是 Cell、不是用户、不是进程。把串行粒度放大到"同一用户的所有对话"会阻塞合理的并行工作(用户同时在不同对话中做不同事情);放小到"同一个消息"则没有意义(消息处理本身就是原子的)。
问题二:任务结束时需要"收尾"吗?
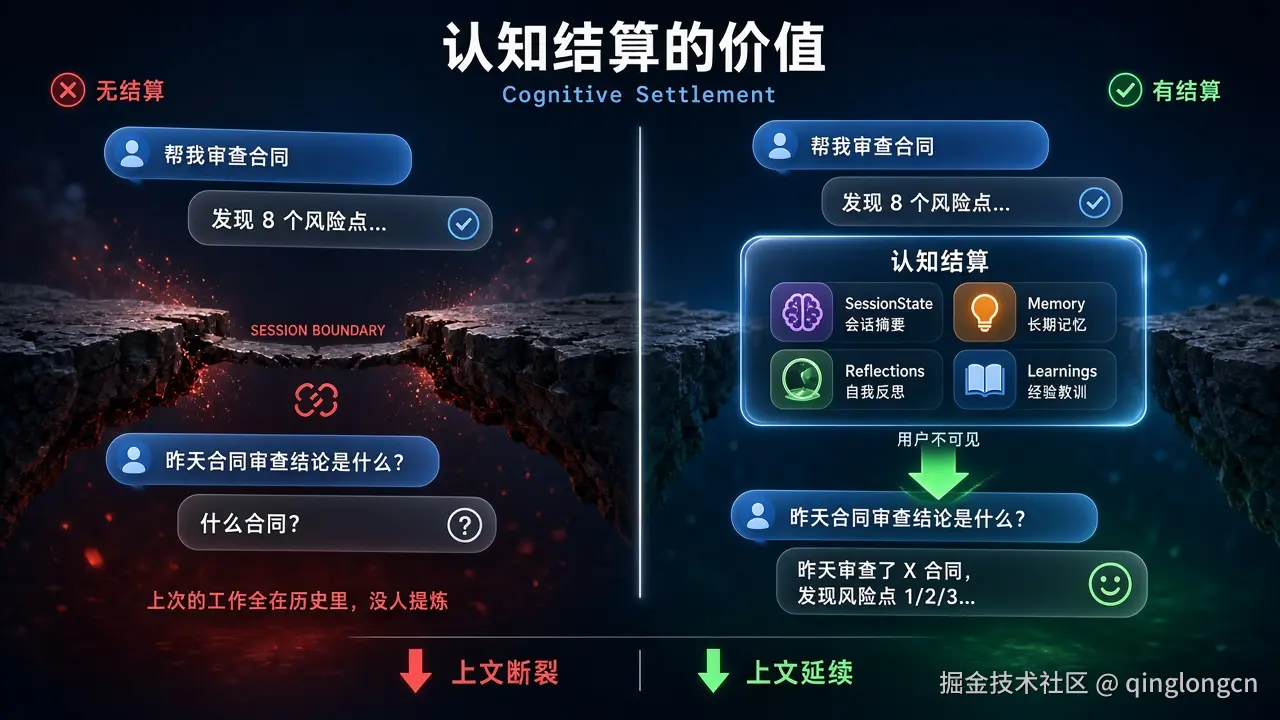
场景:Agent 花了 30 分钟帮你审查合同,提了 8 个风险点。明天你开始新对话问"昨天的合同审查结论是什么"------Agent 还记得吗?
如果没有收尾:昨天的 8 个风险点在昨天的消息历史里,但不在任何结构化的地方。新对话要么加载全部历史(token 成本高),要么从零开始("什么合同?")。
如果有收尾:任务结束时产出一份结构化摘要------"我们审查了 X 合同,发现风险点 1/2/3..."。下次对话注入这份摘要(几百 token),模型立刻知道"上次聊了什么"。
各产品的做法值得展开对比:
Claude Code 有两套独立的记忆系统。Session Memory (code.claude.com/docs/en/sessions)在上下文窗口快满时自动触发压缩------把当前对话浓缩为摘要后继续。但这是被动的 (由 token 预算触发),不是任务结束时的主动总结。Auto Memory (code.claude.com/docs/en/memory)让模型在对话中主动写入 MEMORY.md 文件(首 200 行 / 25KB),记住用户偏好和项目规约。这些记忆在后续会话中自动注入------但写入时机分散在对话过程中,没有一个统一的"结算"时刻。已知的问题包括:--resume 恢复的会话不刷新 MEMORY.md(GitHub issue #97722),compact 后的消息可能不被 --resume 正确加载(issue #47508)。
OpenAI 在 ChatGPT 中有持久记忆------模型在对话中调用 memory.save() 存入偏好。但和 Claude Code 一样,写入时机由模型自行决定,不是结构化的"任务收尾"。
开源生态的做法 :Mem0(mem0.ai)提供 add API 在每轮对话后提取记忆;Zep(getzep.com)自动从对话中抽取事实和关系存入知识图谱。这些都是 turn-level 的------每轮对话后钩子触发。它们的优势是即时性,劣势是缺乏全局视角:第 50 轮对话时模型做了一个总结性决策,但前 49 轮的记忆已经各自独立存储了,没有一次"回顾全局再提炼"的机会。
我们的做法 :在每次任务结束时强制执行认知结算 ------一次 LLM 调用同时产出四类认知产物:会话状态 (下次对话注入的浓缩上下文)、记忆条目 (跨会话可用的事实和偏好)、反思 (对工作过程的自我审视)和学习(可迁移的经验教训)。这个结算由主对话模型完成(只有它有完整上下文),不是辅助模型。任何终止路径------正常完成、用户中断、死循环检测、预算耗尽------都必须执行结算,唯一例外是进程级崩溃(panic)。
为什么是"强制"而不是"可选"? 因为如果结算是可选的,工程师会在"没什么好总结的"场景下跳过它------而这些场景恰恰是模型学到"不要再犯"的最佳时机。被死循环检测终止的任务,比正常完成的任务更需要产出反思。
问题三:任务终止后的数据完整性
场景:Agent 改了 5 个文件后被用户中断(或死循环被检测到、或进程崩溃)。那 5 个文件的修改还在吗?对话历史完整吗?
关键原则 :终止不等于撤销。Agent 被中断前完成的工作应该保留------用户下次可以在同一对话继续。消息历史中的 tool_use 和 tool_result 必须配对------否则下次加载历史时 LLM Provider 会报格式错误。
Cursor 的做法:保留修改但提供 Revert(用户主动撤销)。 Claude Code 的做法:保留修改 + 对话历史存盘。 我们的做法:每轮工具执行的结果立即持久化(不等任务结束)。中断后为未执行的工具调用补上占位结果(保持消息配对一致)。
问题四:任务终止的原因影响 UI 展示
不同的终止原因需要不同的 UI 展示------"正常完成"和"死循环被检测到"不能用同一个样式:
| 终止类型 | 前端应该显示什么 | 应该有"重试"按钮吗 |
|---|---|---|
| 正常完成 | 无特殊标记 | 否 |
| 用户主动取消 | 灰色"已取消"标记 | 否(用户主动的) |
| 死循环检测 | "AI 似乎在重复操作" | 否(重试同样输入还会循环) |
| Provider 瞬时错误 | 红色错误提示 | 是(重试可能成功) |
| 安全策略拦截 | "内容不符合安全策略" | 否(换表述可能成功) |
如果引擎不告诉前端"为什么停的",前端就只能一视同仁地显示"出错了"------用户被迫对每种终止做同样的反应(刷新 / 重试),而有些重试是注定无效的。
这需要引擎把终止原因分类------哪些可重试、哪些不可重试、哪些应该提示用户换表述。我们把终止原因分成六组(正常完成 / 用户控制 / 引擎检测 / 安全拒绝 / 故障 / 阶段错误),每组有明确的"可重试"属性。
问题五:如何保证"不管怎么结束,用户都知道发生了什么"
最隐蔽的 bug:任务终止了但前端不知道------永远显示"运行中"。用户以为 Agent 还在跑,等了 10 分钟才发现"它已经停了"。
根因 :Agent 任务的最后一步(发终态事件到前端)在某些退出路径上被遗漏了。比如:模型调用正在进行中,用户点了停止,callLLM 函数返回了一个"被中断"的状态------但这个状态的处理路径没有发终态事件。
我们遇到过这个真实 bug:用户点停止后前端显示"引擎内部错误"+ 一个无效的重试按钮------因为终态事件遗漏触发了兜底机制,兜底机制合成了一个错误事件。修复:每一条退出路径都必须在返回前发终态事件------不依赖最后的统一出口,因为某些退出路径(异常 / 中断)根本到不了那个出口。
LangGraph 的 Pending Writes 机制为这个问题提供了另一个视角。在并行执行的场景中(比如多个工具同时运行),部分节点完成、部分节点失败时,已完成节点的输出会作为 Pending Writes 保存在 Checkpoint 中。恢复执行时只需重跑失败的节点------用户不会丢失已完成的工作。这是"终止不等于全部作废"的具体实现。
非编程赛道的任务生命周期
上面的讨论主要围绕编程类 Agent。但任务生命周期的挑战在其他赛道同样存在------而且往往更复杂。
企业工单处理(ServiceNow、Zendesk):一个 IT 服务请求可能经历"提交 → 分类 → 自动执行 → 等待审批 → 人工复核 → 关闭"六个阶段,每个阶段都可能触发 Agent 子任务。ServiceNow 的 Now Assist Agent 在 2025 年的设计中引入了 case-based 生命周期------每个工单是一个 Case,Agent 的每次介入是 Case 上的一次 Run,审计追踪贯穿始终。
金融合规审查:合同审查或合规检查类 Agent 面临更严格的审计要求------不仅要记录"做了什么",还要记录"为什么这么做"和"考虑了什么替代方案"。这推动了对任务终态(包括中间决策点)持久化的更高要求。
自动化流程(UiPath、Power Automate):UiPath 在 2025 年推出的 Agentic Automation 区分了"编排式"(orchestrated,流程固定)和"自主式"(autonomous,Agent 决定下一步)两种模式------本质上是第三种和第五种编排范式在工业流程中的投影。每种模式对任务恢复、异常处理和审计的要求不同。
共性:无论赛道如何,任务生命周期都需要回答同样的五个问题------并发控制、收尾、数据完整性、终止分类和终态通知。区别只在具体答案的复杂度和合规要求。
任务状态的行业对比
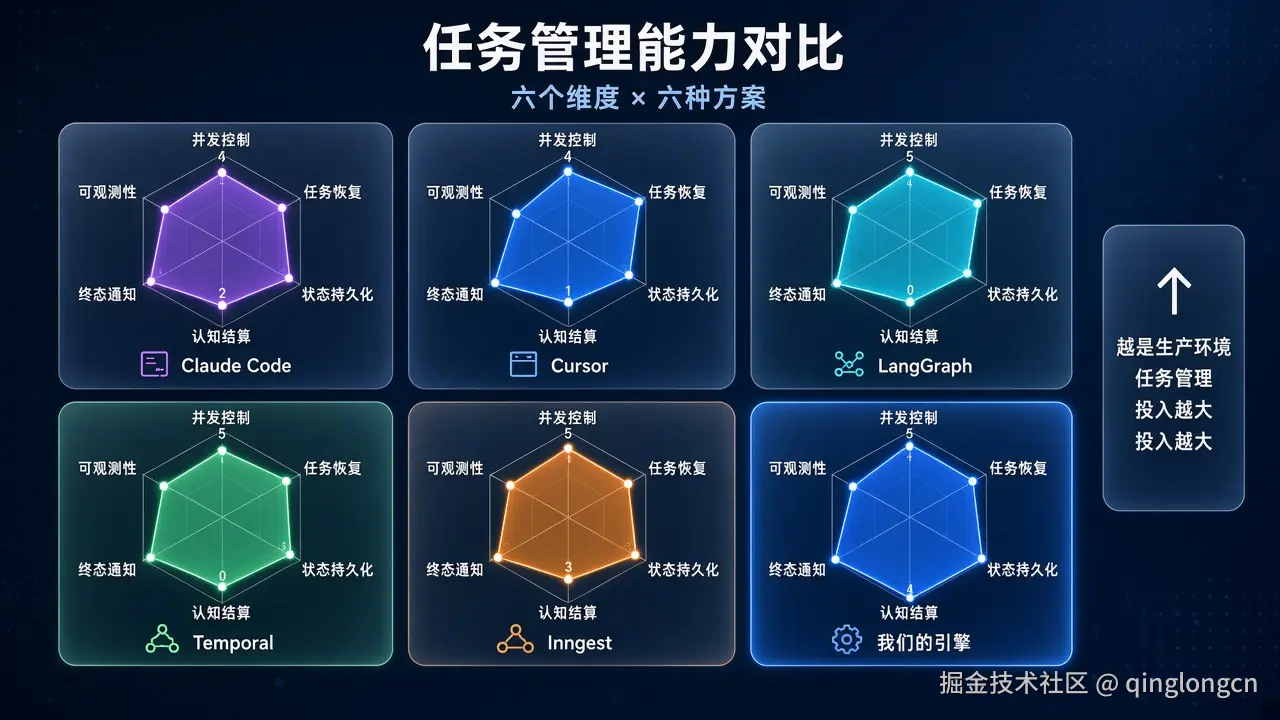
以下对比展示了不同产品和方案在任务管理六个维度上的做法------从最简单的 CLI 会话到最完整的持久执行引擎:
| 维度 | Claude Code | Cursor | LangGraph Platform | Temporal | Inngest | 我们的引擎 |
|---|---|---|---|---|---|---|
| 并发控制 | CLI 单线程,天然串行 | chatInFlight 锁,单工作区单任务 | 同 Thread 串行、跨 Thread 并行 | 完全自定义(Workflow 粒度) | Step 级串行 | Session 串行 + Cell 级配额 |
| 任务恢复 | --resume 重建对话上下文 |
无 | Checkpoint + POST /runs Resume |
Event History Replay(单步精度) | step.run() 自动 checkpoint |
三层 DB 持久化 + 首请求 WarmUp |
| 状态持久化 | 本地 JSONL 文件 | 编辑器内存 + 磁盘 revert | PostgresSaver(sync/async/exit 三级) | 事件溯源日志 | 每步自动持久化 | 每轮即时持久化(三层 SQLite) |
| 认知结算 | 分散式(Auto Memory + Session Memory) | 无 | 无(需应用层实现) | 无(通用引擎) | 无(通用引擎) | 强制终态结算(四类产物) |
| 终态通知 | CLI stdout | 编辑器 UI 更新 | SSE 事件 / WebSocket | Workflow completion callback | Step completion event | SSE 终态事件(六组分类) |
| 可观测性 | 本地日志 | 编辑器 UI | LangSmith 追踪 | Temporal UI + 历史查询 | Inngest Dashboard | per-Run Trace + Evidence Chain |
这张表揭示了一个趋势:越是面向生产环境的方案,在任务管理上的投入越大。CLI 工具可以用"进程就是任务"的简单模型;服务端 Agent 引擎则需要完整的生命周期管理------因为任务可能持续数小时、服务多个用户、且必须在崩溃后恢复。
引用来源
本文所有数据均可通过以下链接验证。
- Claude Code 官方文档 --- How Claude Code works - Claude Code Docs
- Claude Code Session 与 Memory --- Manage sessions - Claude Code Docs / How Claude remembers your project - Claude Code Docs
- Claude Code Context Window 管理 --- Explore the context window - Claude Code Docs
- Cursor Agent Mode --- Cursor Docs --- Agent, Rules, MCP, Skills & CLI
- arXiv:2604.14228 "Dive into Claude Code" --- append-only 会话存储设计
- LangGraph Persistence 文档 --- Persistence - Docs by LangChain
- LangGraph Checkpointers --- Checkpointers - Docs by LangChain
- LangGraph Platform API --- langchain-ai.github.io/langgraph/c...
- Temporal 博客 "Durable flexible multi-agent systems" --- Durable, flexible multi-agent systems | Temporal
- Temporal LangGraph 插件 --- LangGraph in production: Temporal's LangGraph Plugin adds Durable Execution | Temporal
- Inngest Durable Agents --- Durable AI Agents | Survive Failures & Resume - Inngest Docs
- Amazon Kiro 事件 --- Amazon's Kiro coding agent deleted a production environment, causing a 13-hour AWS outage · AI Failure Index
- Claude Code GitHub Issues --- #97722, #47508
- Halkwinds Research, "AI Agent Adoption Report 2026" --- 单 Agent 3-4 月到生产