关注我的公众号:【编程朝花夕拾】,可获取首发内容。
01 引言
在分享RapidOCR的项目的时候,有老铁提到了MinerU项目,今天特意了解一下。才发现这是一个巨无霸,功能也更丰富。顺便整理了一下分享给大家。
02 简介
MinerU 是上海人工智能实验室 OpenDataLab 团队开源的一站式文档解析工具,核心目标只有一个:
把
Markdown / JSON。
MinerU 4.0 将多格式文档解析、文档库和服务工具整合到统一工作流,面向文档转换、应用集成和 Agent 阅读。MinerU 不是 RAG 框架、不是向量数据库、不是 chat-with-doc 应用。它只负责"文档 → 结构化内容"这一层,是 Agent / RAG 链路最上游的"数据清洗器"。
特点:
MinerU 4.0 将多格式文档解析、文档库和服务工具整合到统一工作流,面向文档转换、应用集成和 Agent 阅读。
- 四档解析 :
Flash用于快速预览与索引,Basic提供基础OCR/模型解析,Standard与Advanced面向更复杂的版面和更高的质量需求。 - 多格式输入 :
PDF、图片,以及DOC/DOCX、PPT/PPTX、XLS/XLSX、RTF、ODT/ODS/ODP、EPUB、OFD、HTML/MHTML、CSV/TSV。原生文档由DocVortex提供解析能力。 - 文档库与 Agent 阅读:发现文件、缓存结果、搜索内容,按页或块继续阅读,并保留稳定引用位置。
- 独立模型配置 :小模型选择
ONNX或Torch;VLM独立选择llama.cpp、vLLM、LMDeploy。 - 统一工具入口 :
Python SDK、V1 API、无状态批处理、多服务Router和基于Gradio的WebUI。 - 结构化结果与渲染 :统一文档模型支持
Markdown、HTML、LaTeX、DOCX、EPUB、PDF、Structured Content、Content List V1/V2九种渲染目标;各CLI/API的导出范围见输出格式与结果协议.
GitHub地址:github.com/opendatalab...
官网地址:opendatalab.github.io/MinerU/
03 部署
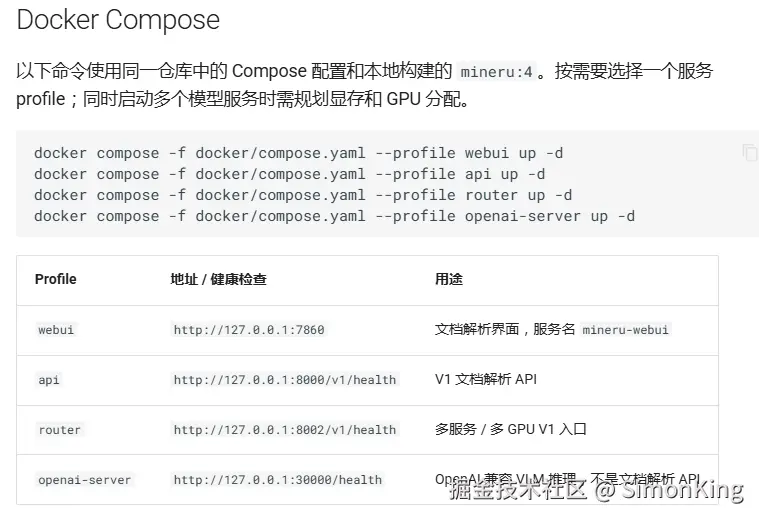
官方提供了多种部署方式,我们以docker部署为例。Docker Compose有分为多个profile。我们部署webui。
3.1 克隆仓库
GitHub 直连慢,走 githubfast 镜像.
bash
git clone https://githubfast.com/opendatalab/MinerU.git
cd MinerU
3.2 构建
bash
docker compose -f docker/compose.yaml --profile webui up -d构建过程可能不会失败。如果使用需要使用国内的 自建镜像
bash
docker build -t mineru:4 -f docker/china/Dockerfile .现在很多SSH有了AI的能力,可以直接将文档给它,让它直接部署。
构建完成之后会发现这个镜像超级大:

因为里面包含了大模型。
04 测试
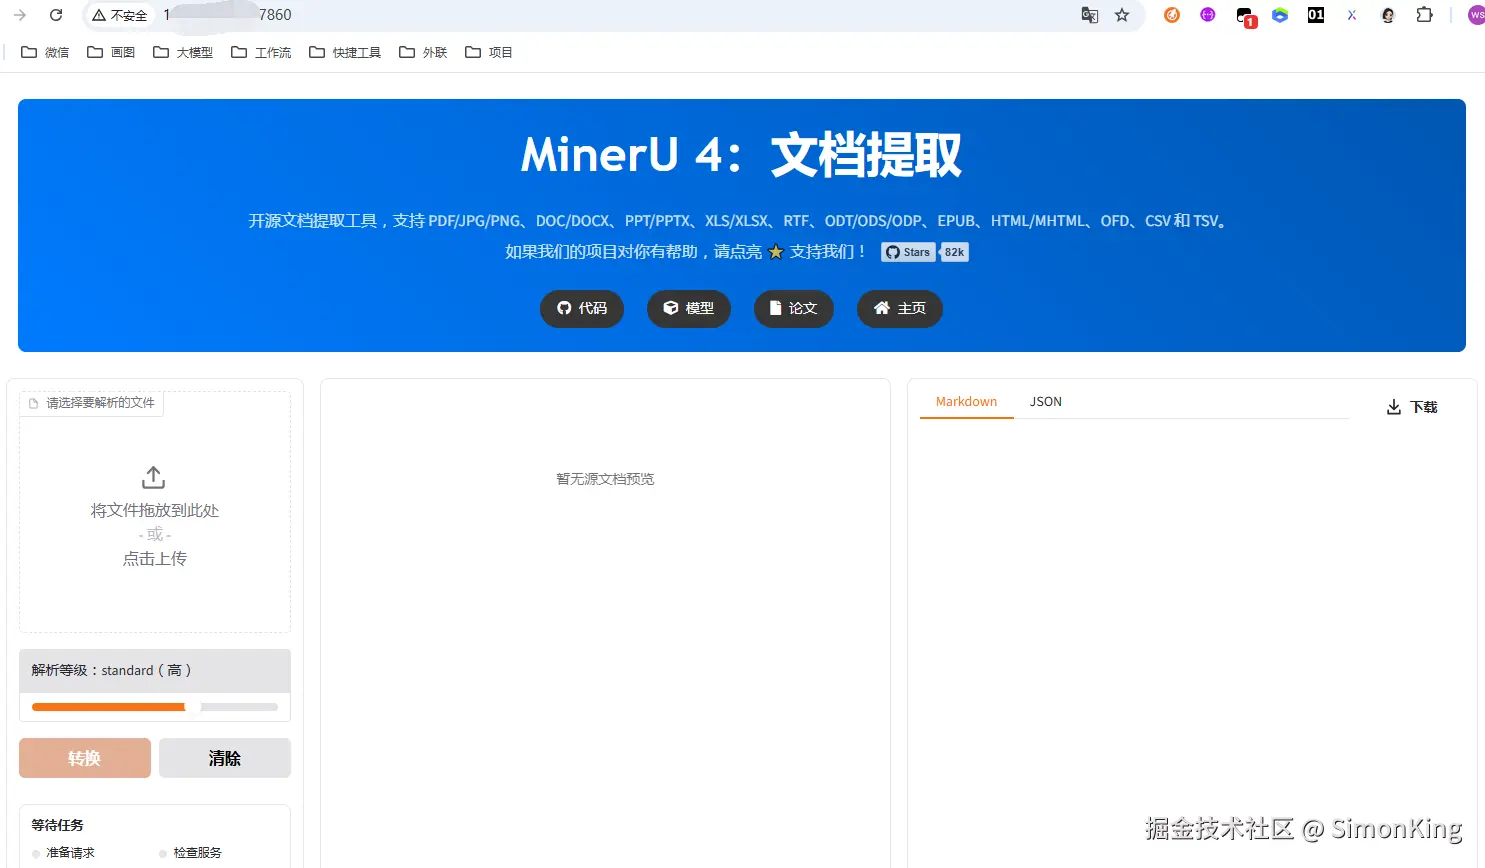
访问:ip:7860即可看到页面:
选了一张图片发现失败了:
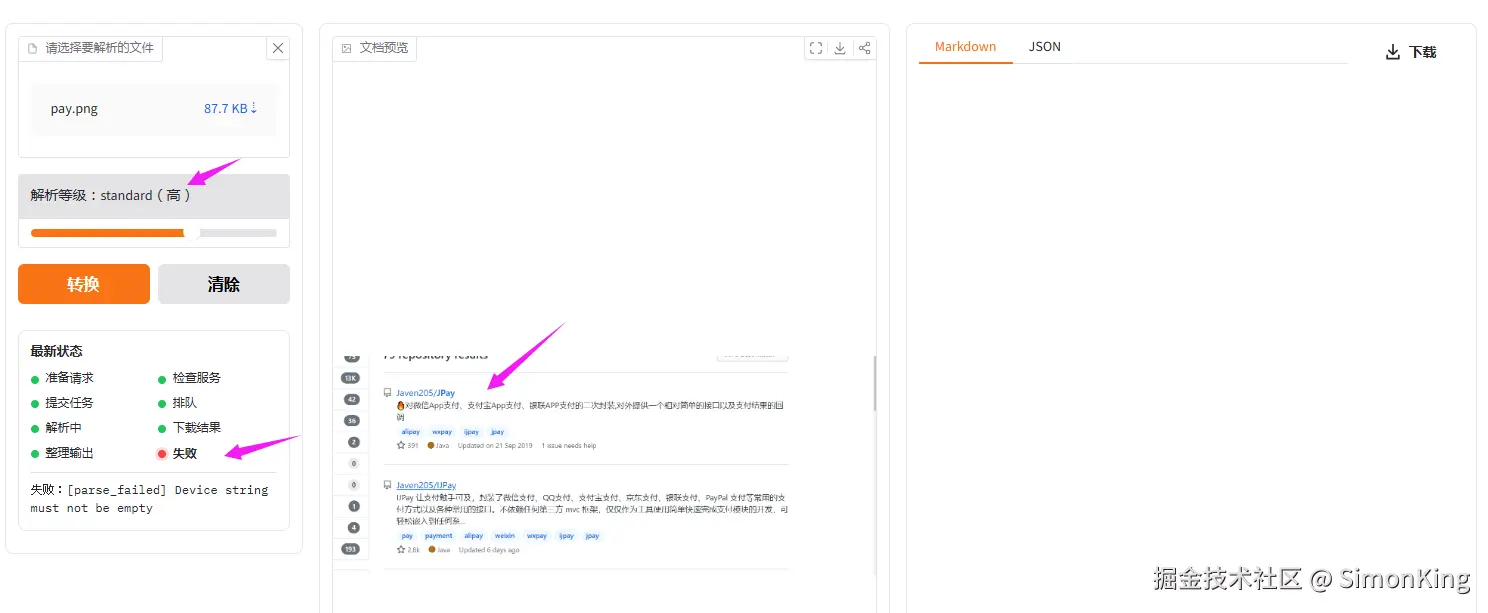
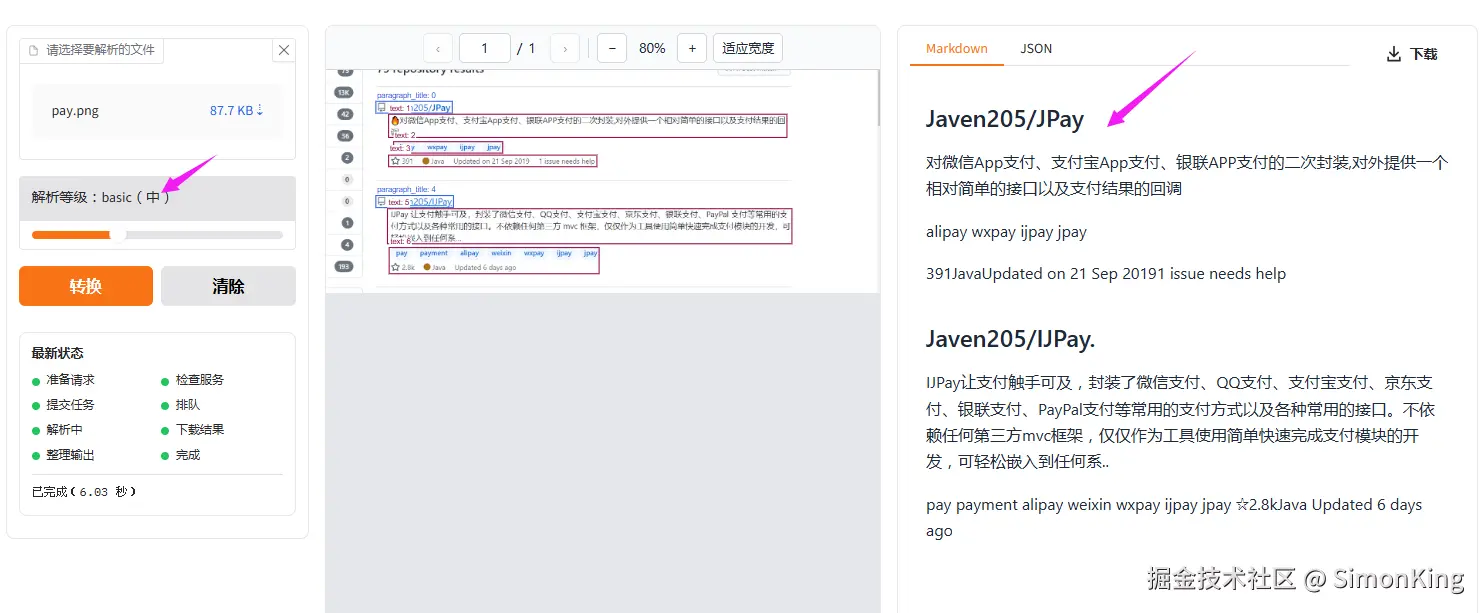
是使用这里使用的纯CPU,它是有限制的,可以将解析登记降到basic
05 小结
如果需要用到项目中可以使用:
bash
docker compose -f docker/compose.yaml --profile api up -d通过API的方式调用。纯CPU的话,感觉还是有点鸡肋,反应不是那么快,占的空间还大。