别再上来就堆 Redis!点赞系统从打挂数据库到 18w 写峰值,我把这套方案讲透了
爆款视频瞬间涌进几十万点赞,按钮卡 3 秒,数据库行锁排到爆------这场景我真遇到过。这篇文章把高并发点赞&关注的完整方案讲透:瓶颈定位、架构演进、生产级代码、踩坑经验,一条链路全包。适合正在做互动系统,或者准备面试的后端朋友。
一、别急着喊 Redis,先看清这是个什么业务
很多人一听"高并发点赞",脑子里就开始堆 Redis、MQ、分库分表。但真正好的方案一定是贴着业务设计的,不是背模板。动手之前,我习惯先对齐三件事:
- 量级:是"总量大"(百亿级点赞关系)还是"瞬时热点大"(单条内容 10w+ QPS)?这两个解法完全不同;
- 一致性:点赞数允许最终一致吗?差几秒、差几个数用户能接受吗?
- 读写比:读是不是远多于写?关注列表要不要分页排序?
对齐完,业务画像基本就出来了:
| 维度 | 特征 | 对设计的影响 |
|---|---|---|
| 写 | 点赞/取消、关注/取关都是轻量操作,热点事件下瞬时冲到数万 QPS | 不能直写 DB,必须异步削峰 |
| 读 | 列表页、详情页、个人主页都要展示计数和状态,读 QPS 是写的 5~10 倍 | 读才是大头,多级缓存扛量 |
| 一致性 | 自己的操作必须立即可见,别人的计数晚 1~2 秒完全能接受 | 典型的最终一致场景 |
| 幂等 | 同一用户不能重复点赞、重复涨粉 | 判重是全链路的命门 |
| 可靠性 | 不能丢、不能重 | 异步链路必须有兜底 |
我们实际压出来的指标:写峰值 5k~5w+ QPS,读峰值 10w+,目标是写 <100ms、读 <20ms。
点赞和关注看着像,其实有微妙差异,方案上得区别对待:
| 维度 | 点赞 | 关注 |
|---|---|---|
| 写特征 | 高频、可反复取消 | 高频、双向关系(关注/粉丝) |
| 数据结构 | 计数 String + 状态 Set/Bitmap | 双向 ZSet/Set |
| 查询特征 | 赞数要实时展示,关系可延迟 | 列表要按时间排序分页 |
| 一致性容忍 | 计数可秒级延迟,状态不能错 | 关系最终一致即可 |
还有个容易被忽略的用户心理:用户只关心自己有没有操作成功,没人关心自己是第 10086 个赞还是第 10087 个赞。所以"自己的操作秒级可见"必须保,全局计数可以稍微飘一飘。这个判断直接决定了后面整个架构的走向。
一句话总结这个业务:写多读更多、强依赖去重、容忍最终一致。
那最朴素的实现会死在哪?往下看。
二、瓶颈在哪:同步直写的三个死穴
最简单的实现:点赞 → 查库判断是否点过 → INSERT/DELETE 关系 → UPDATE 计数。这条链路在高并发下有三个死穴,随便中一个就躺。
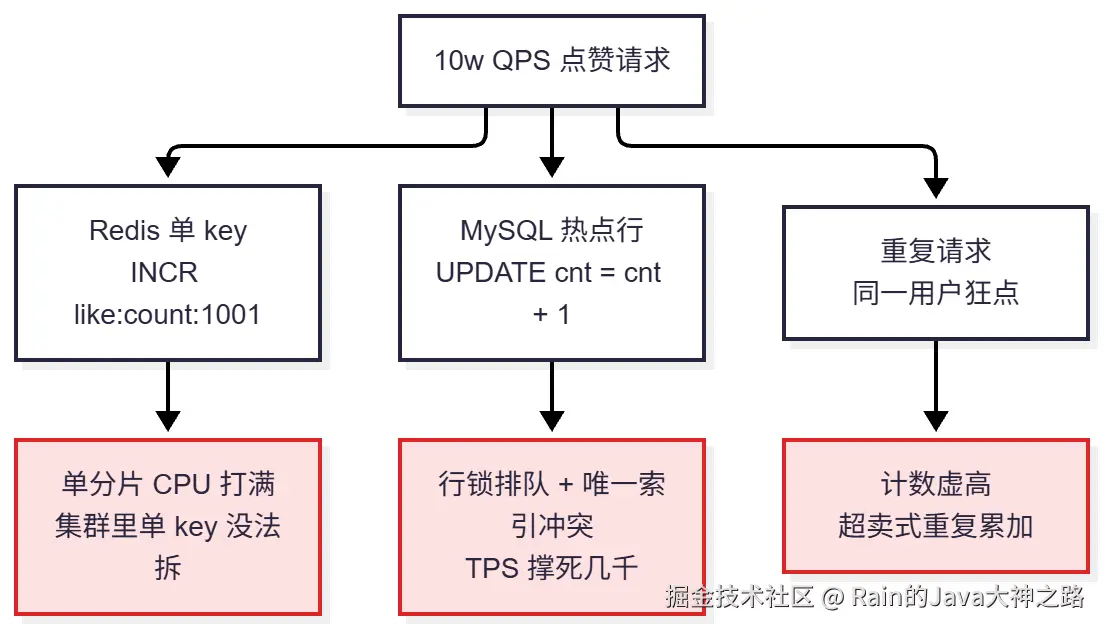
死穴一:数据库热点行锁。 UPDATE t_like_count SET cnt = cnt + 1 WHERE content_id = 1001,InnoDB 行锁串行执行,所有事务在这一行上排队,TPS 撑死几千。单机 MySQL 写到 5k QPS 基本就到顶了,峰值下 IOPS 打满、连接池耗尽,大事务还会拖慢主从同步。我之前就踩过这个坑:V1 版本直写 DB,QPS 过 500 请求就开始堆积,一条热点内容直接把库锁炸。
死穴二:Redis 单 key 热点。 "那改 Redis INCR 总行了吧"------还是太天真。Redis Cluster 里一个 key 只会落在一个 slot 上,单 key 的 OPS 上限大概 8~10 万。爆款内容 10w QPS 全压在一个计数 key 上,对应分片的 CPU 直接打满,集群其他节点干看着帮忙都帮不上。
死穴三:幂等缺失。 客户端重试、用户狂点,"判断没点过 → 插入 → 计数 +1"三步分开执行,高并发下两个请求同时判断"没点过",计数直接虚高,跟超卖一个道理。
还有两个隐蔽的坑:
- 幂等校验开销大:每次操作前先查库判断状态,读压力被成倍放大;
- 读写互相阻塞:写操作占着行锁,连带读计数的请求也大量超时。
知道死在哪,就知道该往哪救了。
三、架构演进:从青铜到王者
我不喜欢一上来就甩最终方案,先讲演进------每一版解决上一版的主要矛盾,这也是面试里最加分的讲法。
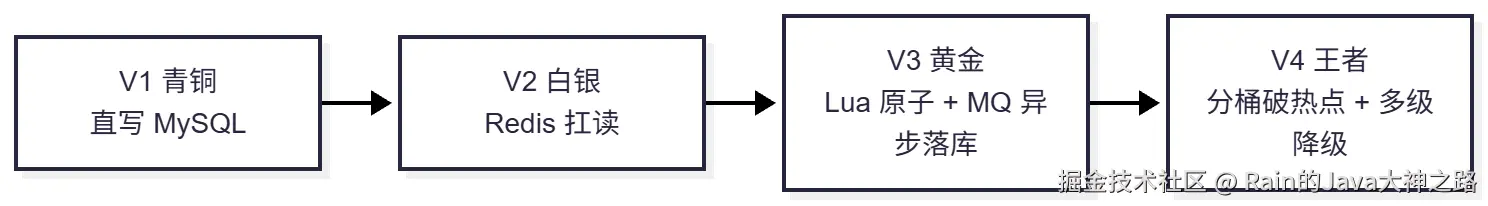
- V1 青铜------直写 MySQL:查状态、写关系、更计数全在库里。热点行锁 + 全表扫描判重,前面说了,QPS 过 500 就开始堆。
- V2 白银------Redis 扛读 :计数放
String,关系放Set,先写 Redis 再异步写库。明显顺滑了,但隐患不少:热门帖子的 Set 几十万元素有大 key 风险;异步消息一丢,Redis 挂了数据就没了;判重还是完全依赖 Redis。 - V3 黄金------Lua 原子 + MQ 异步落库:用 Lua 脚本把并发问题在 Redis 里消化,MQ 削峰、批量落库,唯一索引兜底幂等。到这版已经是生产级雏形。
- V4 王者------分桶破热点 + 多级降级:计数分桶、本地聚合、Caffeine 本地缓存、热点探测、完整降级预案。今天讲的就是这一版。
最终架构长这样:
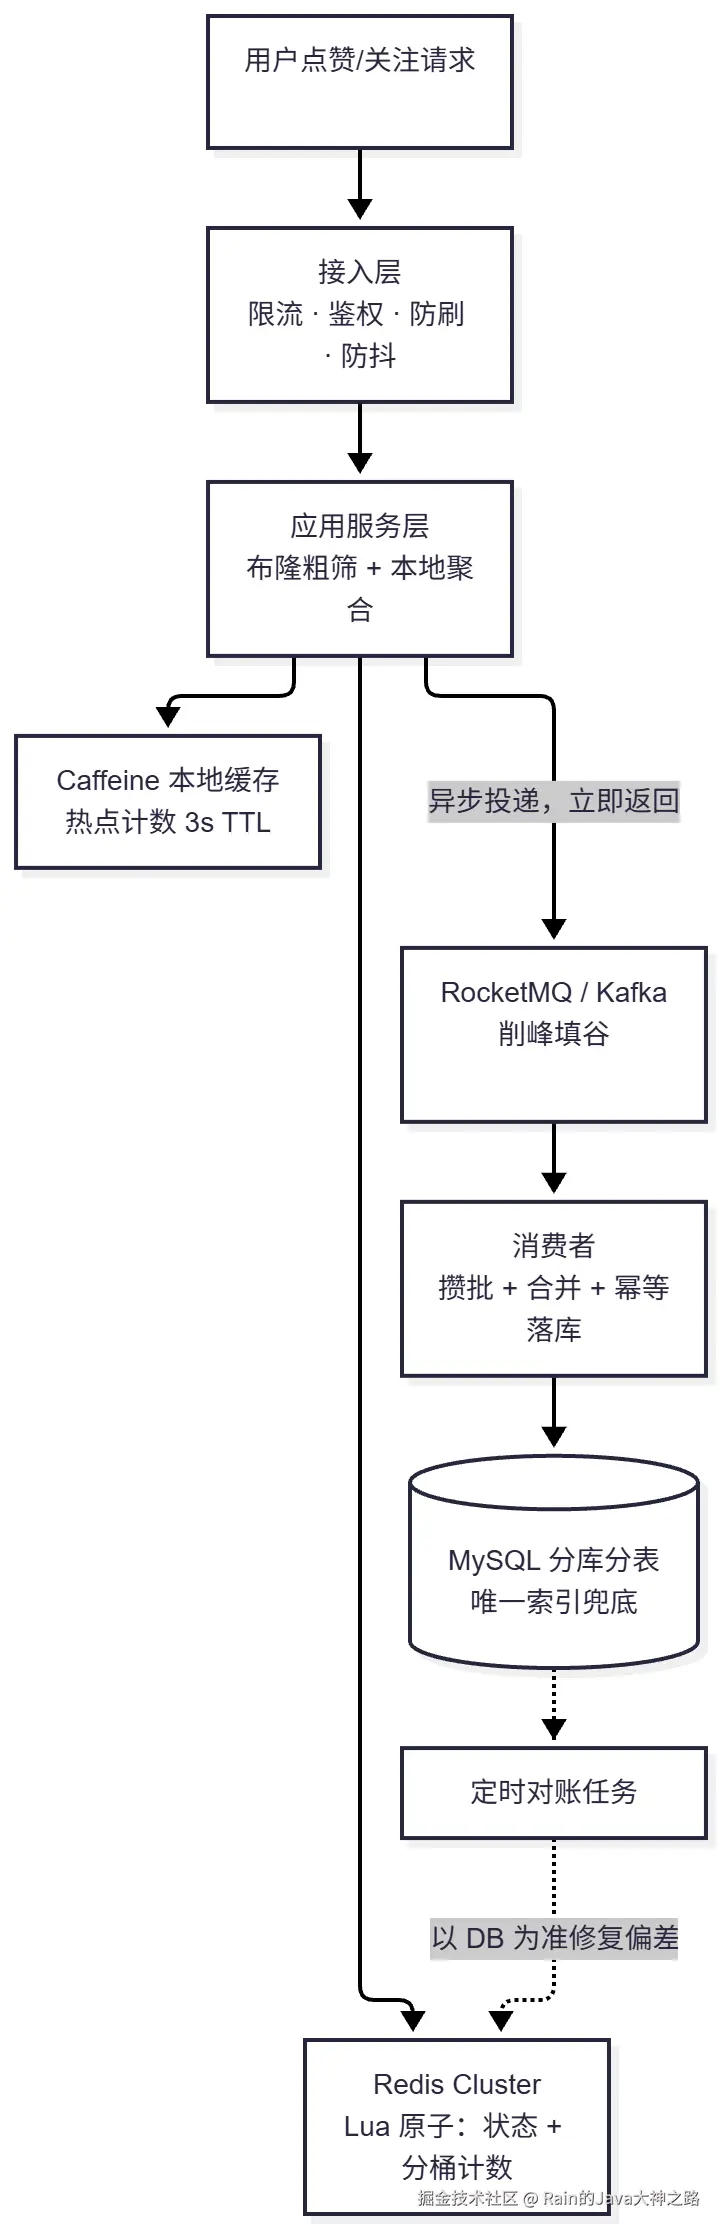
各层职责一张表说清:
| 层 | 职责 | 关键技术 |
|---|---|---|
| 接入层 | 鉴权、限流、防刷 | 用户维度令牌桶、风控黑名单、前端防抖 |
| 服务层 | 无状态编排 | Caffeine、布隆过滤器、Lua 原子脚本、异步投递 |
| Redis 层 | 主存储 & 计数中心 | Set/Bitmap/ZSet、分桶计数 |
| MQ 层 | 削峰、重试、顺序 | 分区键 = targetId、Tag 分流 |
| DB 层 | 冷归档 & 对账基准 | 唯一索引幂等、批量 UPSERT、分库分表 |
整条链路可以这么记:Redis 是"承诺层",MQ 是"水库",消费者是"闸门",对账是"补账会计"。
写路径只有五步:
- 请求进来,网关限流 + 参数校验 + 布隆过滤器粗筛;
- Lua 脚本原子更新 Redis 的计数和关系状态;
- 立即给前端返回成功,用户侧秒级可见;
- 异步把操作消息投到 MQ;
- 消费端消费消息,幂等批量写入 MySQL。
这里有个经典取舍:先更缓存还是先写 DB?答案是先更缓存。 用户对自己操作的即时性要求最高,"我点了马上看到"是体验底线,持久化交给异步链路去保证。
设计总纲:缓存扛读、异步削写、原子幂等、最终一致。数据库不扛洪峰,只吃它吃得下的量。
框架立住了,下面逐层往下抠。先从最让人纠结的选型问题开始。
四、选型第一问:关系存 Set、Bitmap 还是 Hash?
"谁点过赞"这个关系集合,很多人想都不想就写 Set。Set 不是不对,但不是所有场景都最优。先看对比:
| 方案 | 结构 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|---|
Set |
SADD like:{targetId} userId |
直观、存原始 ID、SADD 天然幂等 |
内存开销大 | 通用场景,首选 |
Bitmap |
SETBIT like:{targetId} userId 1 |
内存省约 32 倍,GETBIT 严格 O(1) |
要求 userId 连续或可控 | 用户 ID 自增可控 |
Hash |
HSET like:{targetId} userId ts |
可带时间戳等元信息 | 大 key 风险 | 需要记录操作时间 |
ZSet |
ZADD follow:{uid} ts targetId |
天然按时间排序分页 | 内存占用更大 | 关注列表要按时间序 |
算笔内存账:1000 万用户点赞,Set 存 1000 万个字符串大约 500MB+ ;Bitmap 只需要 1.25MB(1000 万 bit)。100 万用户也就 120KB 左右。差了两个数量级,这就是大 V 场景下 Set 和 Bitmap 的本质区别。
但千万别上来就用 Bitmap,先看你的 uid 分布。这是最容易踩的坑:
| 场景 | 存储选型 | 原因 |
|---|---|---|
| uid 连续、≤ 1 亿 | 直接 BITMAP |
10 亿 bit ≈ 125MB/对象,占用可控,BITCOUNT 极快 |
| uid 稀疏且很大(雪花 ID) | 分段 Bitmap 或回退 Set |
Bitmap 按最大 uid 分配空间,直接撑爆 |
| 超大对象 + 稀疏 | 分段 RoaringBitmap |
压缩稀疏位图,几 KB 装十万级 |
如果 userId 是雪花算法生成的 long,Bitmap 会按最大 ID 分配位图,空间爆炸。这时候要么分段,要么上 RoaringBitmap,要么老老实实回 Set。分段路由的写法:
java
/** 分段位图路由:高位分段 + 段内偏移,避免稀疏 uid 撑爆内存 */
public final class BitmapRouter {
    private static final long SEG = 1L << 28;   // 每段 2.68 亿个位 ≈ 32MB

    public static String segKey(String biz, long targetId, long uid) {
        return "like:bit:" + biz + ":" + targetId + ":" + (uid / SEG);
    }

    public static long offset(long uid) {
        return uid % SEG;
    }
}计数就简单了:String 结构 + INCR/DECR 原子增减。有个细节提醒:关注数、粉丝数要放独立计数 key ,别偷懒用 SCARD。SCARD 本身是 O(1),但大 key 的读写会阻塞 Redis 单线程;而且粉丝列表一旦分片,SCARD 只能拿到单片数量。所以用 HINCRBY follow:cnt:fans:{uid} 1 单独维护总数,读总数 O(1) 且不受分片影响。
结构选好了,还剩第一个并发硬骨头:原子性。
五、原子性这件事:一个 Lua 脚本消化所有并发
先看坑。"判断 → 写入 → 计数"三条命令分开执行,高并发下两个请求同时判断"没点过"、同时 SADD、同时 INCR,计数直接翻倍。很多人以为"进了 Redis 就自动原子",这是天大的误会------原子的是单条命令,不是你的业务组合。
为什么选 Lua:
- Redis 单线程执行 Lua,脚本整体不被打断,天然原子;
- "判重 + 写入 + 计数 + 返回"四步合并成 1 次网络往返。同步链路里最贵的是网络 IO,不是 Redis 计算;
- 比 Java 层加锁性能高得多,并发问题在缓存层就消化掉,DB 感知不到任何冲突。
为什么不用 MULTI/EXEC? 它只是排队执行,做不了"读了结果再决定下一步"的分支逻辑------你拿不到中间命令的返回值,幂等判断就得两次 RT。Lua 天然支持条件分支 + 一次 RT,没理由不选。
通用版脚本(Set 存关系,点赞/取消通用):
lua
-- operate.lua 点赞/取消点赞原子脚本
-- KEYS[1]: 关系集合key   KEYS[2]: 计数key
-- ARGV[1]: 操作类型 1=点赞 0=取消
-- ARGV[2]: userId
-- 返回值: 1=操作真实生效 0=重复操作(幂等) -1=参数错误

local relationKey = KEYS[1]
local countKey    = KEYS[2]
local op          = tonumber(ARGV[1])
local userId      = ARGV[2]

if op == 1 then
    if redis.call('SISMEMBER', relationKey, userId) == 1 then
        return 0                        -- 已点赞,幂等拦截
    end
    redis.call('SADD', relationKey, userId)
    redis.call('INCR', countKey)
    redis.call('EXPIRE', relationKey, 604800)   -- 冷内容 7 天过期
    redis.call('EXPIRE', countKey, 604800)
    return 1
elseif op == 0 then
    if redis.call('SISMEMBER', relationKey, userId) == 0 then
        return 0                        -- 没点过,拒绝无意义取消,防负数
    end
    redis.call('SREM', relationKey, userId)
    redis.call('DECR', countKey)
    return 1
else
    return -1
end
几个细节值得品:
- 返回值设计是灵魂 。
1真实生效、0重复请求、-1参数错误,业务层拿到结果直接走分支,不用再回 Redis 查一次,省一次 RTT; - 防负数:取消之前先判存在,"点赞 +1、取消 -2"这种负数事故从根上不存在;
- 冷数据 7 天过期,过期后由 DB 兜底重建,不占无效内存(如果业务对计数敏感,也可以不设过期,交给对账兜底,两种流派都行);
- 点赞和取消走同一段脚本,逻辑对称,好测好维护。
Java 侧调用,注意三个点:布隆前置、真实生效才发 MQ、MQ 失败有兜底:
java
@Service
public class LikeServiceImpl implements LikeService {
    @Resource
    private StringRedisTemplate redisTemplate;
    @Resource
    private RocketMQTemplate mqTemplate;

    private static final DefaultRedisScript<Long> OPERATE_SCRIPT =
        new DefaultRedisScript<>(new ClassPathResource("operate.lua"), Long.class);
    private static final String MQ_RETRY_KEY = "interact:mq:retry";

    public Result like(Long targetId, Long userId, boolean like) {
        // ① 布隆过滤器前置:挡掉 90% 内容/用户不存在的无效请求
        if (!targetBloomFilter.mightContain(targetId)
                || !userBloomFilter.mightContain(userId)) {
            return Result.fail("操作对象不存在");
        }

        // ② Lua 原子更新:并发在 Redis 单线程里消化
        Long effect = redisTemplate.execute(OPERATE_SCRIPT,
                List.of(buildRelationKey(targetId), buildCountKey(targetId)),
                like ? "1" : "0", String.valueOf(userId));
        if (effect == null || effect == 0) {
            return Result.fail("请勿重复操作");      // 幂等命中,快速返回
        }

        // ③ 只有真实生效的操作才进 MQ,落库流量天然减半
        LikeEvent msg = LikeEvent.of(targetId, userId, like);
        try {
            mqTemplate.sendOneWay("social_interact_topic",
                    MessageBuilder.withPayload(msg).build());
        } catch (Exception e) {
            // 兜底:发送失败进 Redis 重试队列,定时任务 10s 扫一次重发
            redisTemplate.opsForList().leftPush(MQ_RETRY_KEY, JSON.toJSONString(msg));
            log.error("MQ 发送失败,进重试队列, targetId:{}", targetId, e);
        }
        return Result.ok();   // 立即返回,用户侧秒级可见
    }
}
技术亮点 :①
sendOneWay单向发送性能最高,不等 Broker 确认;② MQ 发送失败不回滚缓存,而是进重试队列------用户体验和最终不丢都要;③ 只有真实生效的操作才投递消息,持久化流量天然砍半。
面试里如果被追问"Redis 凭什么保证原子性",两个关键词就够了:单线程 + Lua 整体执行不被打断。
原子性是解决了,但顶流明星官宣,几亿人同时砸同一个 key,怎么办?
六、热点 Key 治理:把集中的写打散
Redis Cluster 能把数据分片,但拆不了单个 key。爆款内容的计数 key 注定被打爆,三板斧,由浅入深。
6.1 第一斧:计数分桶
把 like:count:{targetId} 拆成 like:count:{targetId}:{0~15},写的时候随机(或按 userId 哈希)选片,读的时候求和:
java
private static final int SHARD_NUM = 16;   // 分片数按量级选:8、16、100 都可以

// 写:随机路由到分片,把单 key 压力摊到 N 个 key
public void incrSharded(Long contentId) {
    int shard = ThreadLocalRandom.current().nextInt(SHARD_NUM);
    redis.opsForValue().increment("like:count:" + contentId + ":" + shard);
}

// 读:MGET 一次拿回求和(配合本地缓存,3~5 秒才回源一次)
public long getLikeCount(Long contentId) {
    return caffeine.get(contentId, id -> {
        long sum = 0;
        for (int i = 0; i < SHARD_NUM; i++) {
            String v = redis.opsForValue().get("like:count:" + id + ":" + i);
            sum += v == null ? 0 : Long.parseLong(v);
        }
        return sum;
    });
}
分片数是经验值:16 片就是写压力降 16 倍;读变成 16 个 key 的 MGET------但读有本地缓存兜着,几乎不回 Redis,这个代价基本白嫖。
更彻底的做法是直接在 Lua 里完成分桶,一次 RT 搞定:
lua
-- SETBIT 的返回值就是幂等标记:旧值为 1 说明早就点过,不需要额外判断
local old = redis.call('SETBIT', bitmapKey, uid, 1)
if old == 1 then
    return {0, sumBuckets(cntKey)}      -- 重复点赞:不动计数,直接返回当前总数
end

-- 分桶计数:把「一个热点 key」拆成 100 个 field,写压力均摊
local bucket = uid % 100
redis.call('HINCRBY', cntKey, 'b' .. bucket, 1)
技术亮点 :
SETBIT的返回值就是旧值,直接拿来当幂等标记,比SISMEMBER + SADD两步省一次判断;计数从"一个热点 key"变成"一个 Hash 的 100 个 field",读总数时HGETALL拿 100 个 field(不到 1KB),Lua 内累加微秒级。
6.2 第二斧:本地聚合,100 次请求合成 1 次
分桶是把压力摊开,但每个请求还是要打一次 Redis。更狠的做法:应用层先攒一手。
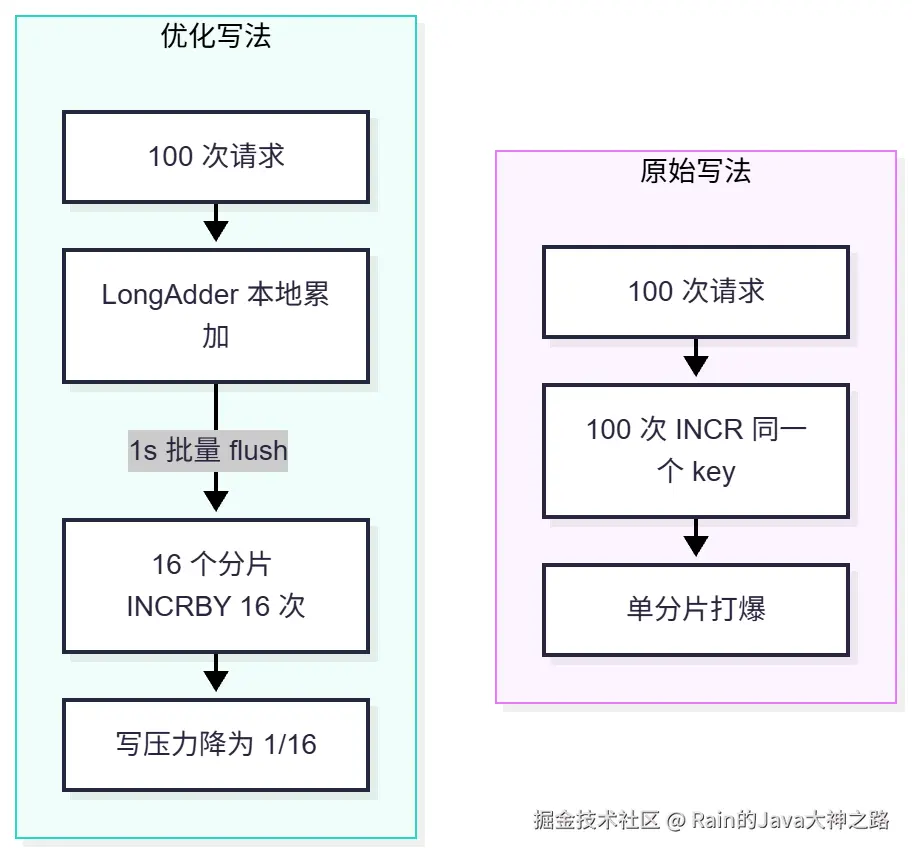
横向拆(分片)+ 纵向合(聚合),双管齐下:
java
/**
 * 热点计数写入器:本地聚合 + 分片打散
 * 亮点:LongAdder 无锁累加、定时 flush、失败回滚
 */
@Component
public class HotCounterWriter {

    private static final int SHARD = 16;
    private final ConcurrentHashMap<String, LongAdder> buffer = new ConcurrentHashMap<>(1024);

    @Resource
    private StringRedisTemplate redis;

    @Scheduled(fixedRate = 1000)
    public void flush() {
        for (Map.Entry<String, LongAdder> e : buffer.entrySet()) {
            long delta = e.getValue().sumThenReset();   // 原子取走并清零
            if (delta == 0) continue;
            try {
                redis.opsForValue().increment(e.getKey(), delta);   // 一次 INCRBY 合并
            } catch (Exception ex) {
                e.getValue().add(delta);   // flush 失败回滚 buffer,不丢数据
                log.error("flush counter fail, key={}", e.getKey(), ex);
            }
        }
    }

    /** 写路径:只做本地累加,纳秒级 */
    public void incr(long objId, int delta) {
        int shard = ThreadLocalRandom.current().nextInt(SHARD);
        buffer.computeIfAbsent("like_cnt:" + objId + ":" + shard,
                k -> new LongAdder()).add(delta);
    }
}
两个面试加分点:
LongAdder用分段 CAS 避免伪共享,sumThenReset()保证"取走 + 清零"的原子性;- flush 失败要回滚 buffer------很多人的方案在这里悄悄丢数据,这一行就是分水岭。
加了这一层,Redis 网络调用量从每请求 1 次降到约 1/50。
6.3 第三斧:Caffeine 本地缓存扛读
热点计数读多写少,应用层加一级短 TTL 缓存,绝大部分读请求不出 JVM:
java
private final Cache<Long, Long> cache = Caffeine.newBuilder()
        .maximumSize(10_000)
        .expireAfterWrite(3, TimeUnit.SECONDS)   // 容忍 3 秒不一致,拦掉 90%+ 重复读
        .build();
6.4 热点 Key 怎么发现?
别等告警响了才知道有热点,三条路:
- Redis 自带
redis-cli --hotkeys、MONITOR抽样(生产环境慎用MONITOR); - 自研滑动窗口统计:本地每 1s 上报 top N 到聚合服务;
- 业界方案:JD-hotkey、Sentinel 集群流控。
发现之后立即本地缓存 + 分桶 + 限流 三板斧。极端情况下,还可以把顶流热点内容单独迁到独立热点集群 ,别让一个热 key 打爆普通实例;写侧再极端一点,用 ConcurrentLinkedQueue 暂存、每 50ms 批量发 Redis,用少量延迟换吞吐。
(这段比较硬核,觉得有用的话先点个关注不迷路,下面还有更实战的。)
写端防住了,几十万 QPS 的数据怎么温和地落进 MySQL?
七、落库削峰:光有 MQ 不够,还得控流速
总原则:Redis 操作成功后立即返回用户,不等写库,MQ 异步消费落库。但这里有五个细节,少一个,洪峰照样出事。
7.1 生产端:Tag 分流 + 分区键保序
java
// 点赞/取消打不同 Tag:可以单独限流、单独排查、单独重试
Message msg = new Message("LIKE_TOPIC",
        isLike ? "LIKE" : "UNLIKE",
        userId + ":" + postId);
producer.send(msg);

// Kafka 场景:分区键用 postId,保证同一帖子的消息有序
kafkaTemplate.send("like-events", postId.toString(), event);
消息体只带"谁对什么做了什么",别塞冗余字段。分区键 = targetId 还有个好处:同一对象的消息有序,消费端可以按对象维度安全地批量聚合。
7.2 消费端:攒批 + 合并,把 10w QPS 压成 600 TPS
千万别逐条落库,否则等于把洪峰从接口侧平移到数据库侧,前面全白干。消费端做三层压缩:
第一层:攒批。 攒够 100 条或 1 秒超时(激进点 50ms 兜底 flush),批量写。
第二层:最终态合并。 用户反复点赞又取消("抖手党"),一个窗口内按 (userId, targetId) 聚合,只落最终状态,DB 写量再砍一半。
第三层:计数合并。 计数是聚合数据,天然适合批量合并------100 条消息在消费端合成一次 INCRBY,DB 写入次数从 100 变 1。按 contentId 分组求和,一条 SQL 批量 UPSERT。
三层揉在一个消费者里:
java
/**
 * 点赞落库消费者:攒批 + 最终态合并 + 幂等落库
 * 亮点:MQ 线程只入队不阻塞;失败进 WAL,绝不静默丢
 */
@Component
public class LikePersistConsumer {

    private final BlockingQueue<LikeMsg> buffer = new LinkedBlockingQueue<>(200_000);

    @RocketMQMessageListener(topic = "like_topic", consumerGroup = "like_consumer_group")
    public void onMessage(LikeMsg msg) {          // 只做入队,绝不阻塞 MQ 线程
        if (!buffer.offer(msg)) {                 // 队列满 = 压力过载信号
            Metrics.counter("like_buffer_full").increment();
            directWrite(msg);                     // 兜底:同步单条写,保证不丢
        }
    }

    @PostConstruct
    void startFlushLoop() {
        Thread t = new Thread(this::flushLoop, "like-flush");
        t.setDaemon(true);
        t.start();
    }

    private void flushLoop() {
        List<LikeMsg> batch = new ArrayList<>(1000);
        while (!Thread.currentThread().isInterrupted()) {
            batch.clear();
            buffer.drainTo(batch, 1000);                 // 攒批,最大 1000 条
            if (batch.isEmpty()) {
                LockSupport.parkNanos(50_000_000L);      // 50ms 兜底 flush,控制延迟
                continue;
            }
            try {
                persist(mergeFinalState(batch));
            } catch (Exception e) {
                RetryQueue.push(batch, e);               // 失败进重试队列/本地磁盘 WAL
            }
        }
    }

    /** 最终态合并:同一用户同一目标反复操作,只落最后一条 */
    private List<LikeMsg> mergeFinalState(List<LikeMsg> batch) {
        Map<String, LikeMsg> merged = new LinkedHashMap<>();
        for (LikeMsg m : batch) {
            merged.put(m.getUserId() + ":" + m.getTargetId(), m);  // 后到覆盖先到
        }
        return new ArrayList<>(merged.values());
    }

    /** 单条 SQL 批量提交:唯一索引保证幂等,重复写无副作用 */
    private void persist(List<LikeMsg> batch) {
        jdbc.batchUpdate(
            "INSERT INTO t_like(user_id, target_id, status, update_time) " +
            "VALUES (?,?,?,NOW()) " +
            "ON DUPLICATE KEY UPDATE status = VALUES(status), update_time = NOW()",
            new BatchPreparedStatementSetter() {
                @Override
                public void setValues(PreparedStatement ps, int i) throws SQLException {
                    LikeMsg m = batch.get(i);
                    ps.setLong(1, m.getUserId());
                    ps.setLong(2, m.getTargetId());
                    ps.setInt(3, m.getStatus());
                }
                @Override
                public int getBatchSize() { return batch.size(); }
            });
        // 计数不在这里做热点行 +1:以 Redis 为准,分钟级快照回写 + 对账校正
    }
}
7.3 幂等:关键不在消费端"判重",在唯一索引
很多人会在消费端写一大段"先查后插"的判重逻辑。其实给 (user_id, target_id) 建唯一索引,配合 ON DUPLICATE KEY UPDATE 或 INSERT IGNORE 更干净------重复消息冲突直接跳过,MQ 怎么重投都没有副作用。
sql
-- 关系表:唯一索引是幂等的最后一道防线
CREATE TABLE t_like (
  id          BIGINT AUTO_INCREMENT PRIMARY KEY,
  user_id     BIGINT NOT NULL,
  target_id   BIGINT NOT NULL,
  status      TINYINT NOT NULL,          -- 1 赞 / 0 取消,软删除避免物理删的写放大
  update_time DATETIME,
  UNIQUE KEY uk_user_target (user_id, target_id)
) ENGINE=InnoDB;

-- 计数表与明细表分离,避免行锁互相影响
INSERT INTO t_like_count (content_id, like_count) VALUES (?, ?)
ON DUPLICATE KEY UPDATE like_count = like_count + VALUES(like_count);

-- 关系写入:撞唯一索引直接跳过
INSERT IGNORE INTO t_like (user_id, target_id, status) VALUES (?, ?, 1);
如果担心重复消息打 DB,可以再加一层:消费前用 Redis SETNX 打消费标记(24 小时过期),重复消息直接 ACK,比查库性能高一个量级;批内还可以按消息 ID 先去一遍重。双层幂等下来,重复数据出现的概率约等于零。
库表层面还有几个配置项:点赞关系表按 targetId 分库分表,关注表按 userId 分,单表控制在千万级以内;关注是双向关系,DB 侧一般双向表双写 (t_follow(from, to) + t_fans(to, from)),各自按自己的查询维度分片------这个第九章细讲。
重要结论 :DB 主表不做
cnt = cnt + 1的热点行更新。计数以 Redis 为准,按分钟级快照回写,对账任务再校正。分片表能解决总 TPS,但解决不了单条内容的行热点------把"自增"从 DB 里挪出去,Redis 才是正确的计数载体。
7.4 令牌桶控落库流速:最容易被忽略的一环
MQ 把洪峰蓄住了,但如果消费者一股脑全拉出来写库,洪峰只是换了个地方砸。用 Redis 实现分布式令牌桶,消费前先拿令牌:
lua
-- KEYS[1] = token:bucket:{name}
local tokens = tonumber(redis.call('GET', KEYS[1]) or '0')
if tokens >= 1 then
    redis.call('DECR', KEYS[1])
    return 1
end
return 0
配合定时任务按固定速率补令牌,数据库写入 TPS 从"不可控的洪峰"变成"恒定的可预期值"。这一步不做,前面的削峰等于白削。
7.5 消息可靠性:不丢不重
- 生产端:发送失败进 Redis 重试队列 / 本地消息表,定时任务扫描重发;
- 消费端:手动 ACK + 重试 ,重试超过 N 次进死信队列 或落本地磁盘 WAL,由补偿任务重放;
- 顺序:分区键 = targetId,同对象有序,重试不产生副作用。
写链路到此闭环。但读端的体验,同样有不少活儿要干。
八、读端也别糊弄:批量查询与缓存三防
列表页要展示 20 条内容,每条都得拿"点赞数 + 我是否赞过"。最朴素的写法是循环查 Redis------20 次网络 IO,RT 直接 50ms 起步。
8.1 Pipeline 批量查,N 次 IO 变 1 次
java
// 别在 for 循环里调 Redis!Pipeline 打包命令,一次网络往返搞定
public List<Boolean> batchCheckLiked(Long userId, List<Long> postIds) {
    List<Object> results = redisTemplate.executePipelined(new RedisCallback<Object>() {
        @Override
        public Object doInRedis(RedisConnection connection) {
            for (Long postId : postIds) {
                connection.setCommands()
                        .getBit(("like:post:" + postId).getBytes(), userId);
            }
            return null;
        }
    });
    return results.stream().map(Boolean.TRUE::equals).collect(Collectors.toList());
}
Set 存关系的可以用 SMISMEMBER(Redis 6.2+)一次批量判断多个成员,效果一样。这一步优化下来,批量查状态的 RT 从 50ms 降到 2ms 左右,列表页 N+1 问题直接消失。列表页非首屏的内容还可以懒加载,滑到再查。
8.2 读链路:多级缓存兜底
"我是否点过赞"的完整读链路:本地 Caffeine(热点内容 3s TTL)→ Redis Bitmap GETBIT O(1) → 回 DB。布隆过滤器还能挡掉绝大部分"肯定没点过"的冷查询,穿透流量到不了存储层。
缓存老三样,顺手一起打包处理:
| 问题 | 场景 | 解法 |
|---|---|---|
| 穿透 | 查不存在的 targetId、恶意刷 | 布隆过滤器前置拦截;空值缓存 + 短 TTL |
| 击穿 | 热点内容过期瞬间打穿 DB | 互斥锁/单飞回源;逻辑过期;热点预加载 |
| 雪崩 | 大面积 key 同时过期 | TTL 加随机值;多级缓存降级 |
点赞讲完,关注才是那块更硬的骨头。
九、关注专场:双向关系、大 V 粉丝、Feed 扩散
关注比点赞多出三个难点:双向关系存储、大 V 粉丝大 key、Feed 写扩散。
9.1 双向关系:关注 + 粉丝,两手都要硬
关注必须同时维护两份关系:"我关注的"和"关注我的"。结构选型上和点赞有个关键差异------关注列表天然要按时间排序分页,所以 ZSet 比 Set 更合适:
text
following:{userId}   member = 被关注人ID, score = 关注时间戳
follower:{userId}    member = 粉丝ID,      score = 关注时间戳
ZREVRANGE 天然按时间倒序分页,不需要额外排序字段或索引。当然,如果你的业务不需要时间序,用 Set 更简单省事。
关注/取关同样走 Lua 双向原子,一次调用同时更新关注表、粉丝表和计数,规避分布式事务:
lua
-- KEYS[1] = following:{userId}, KEYS[2] = follower:{targetId}
-- ARGV[1] = targetId, ARGV[2] = userId, ARGV[3] = 时间戳
local exists = redis.call('ZSCORE', KEYS[1], ARGV[1])
if exists then return 1 end                           -- 已关注,幂等
redis.call('ZADD', KEYS[1], ARGV[3], ARGV[1])         -- 我的关注列表
redis.call('ZADD', KEYS[2], ARGV[3], ARGV[2])         -- 对方的粉丝列表
redis.call('HINCRBY', 'follow:cnt:fans', ARGV[1], 1)  -- 对方粉丝数 +1
return 0
取关就是 ZREM 双向删 + HINCRBY -1,同一段脚本反过来。两个业务校验别忘:不能关注自己;双向计数用异步更新,别塞进一个大事务里抢锁。
共同关注是个高频加分点:两人关注集合求交集,一次 SINTER 秒出,不用扫表:
java
public Set<String> mutualFollow(Long userId, Long otherId) {
    return redis.opsForSet().intersect("follow:" + userId, "follow:" + otherId);
}
9.2 大 V 粉丝千万级:分片 + 热页缓存
千万级粉丝的集合要是敢 SMEMBERS 全量拉,Redis 单线程能阻塞好几秒,经典大 key 事故现场。我的处理:
- 粉丝 Set 分片:按粉丝 uid 哈希拆 64 片,每片 ≤ 20w 元素;
- 动态分片 :小 V 用单 Set 保持简单,只有大 V 才分片(粉丝 ≥ 10w 触发),别过度设计;
- 分页用
SSCAN带游标遍历,绝不全量拉取; - 独立计数 key 维护粉丝总数,不受分片影响。
java
public final class FollowKeys {
    private static final int SHARDS = 64;
    private static final long BIG_V_THRESHOLD = 100_000L;

    /** 我关注的人(中小规模,单 Set 即可) */
    public static String following(long uid) { return "follow:ing:" + uid; }

    /** 粉丝数:独立计数 key,避免 SCARD 大 key */
    public static String fansCnt(long uid) { return "follow:cnt:fans:" + uid; }

    /** 大 V 粉丝列表:按粉丝 uid 哈希分片 */
    public static String fansShard(long vUid, long fanUid) {
        return "follow:fans:" + vUid + ":" + (fanUid % SHARDS);
    }

    public static boolean isBigV(long fans) { return fans >= BIG_V_THRESHOLD; }
}粉丝列表的读也要分层:只缓存前 100 页热数据(或者只做最近 7 天活跃粉丝的冷热分离),深翻页的冷数据直接回 DB,更早的历史数据走离线计算或数仓。关系落库时按粉丝 userId 取模分表,把大 V 的粉丝打散到不同表里。
java
public List<Long> fans(long userId, int page) {
    if (page > 100) return fanMapper.selectByPage(userId, page);  // 冷数据直接查库
    String key = "fans:" + userId + ":" + page;
    return cache.get(key, () -> fanMapper.selectByPage(userId, page));
}
9.3 Feed 流扩散:大 V 必须拉
关注做完了还得有 Feed 流,这才是写扩散最容易炸的地方:
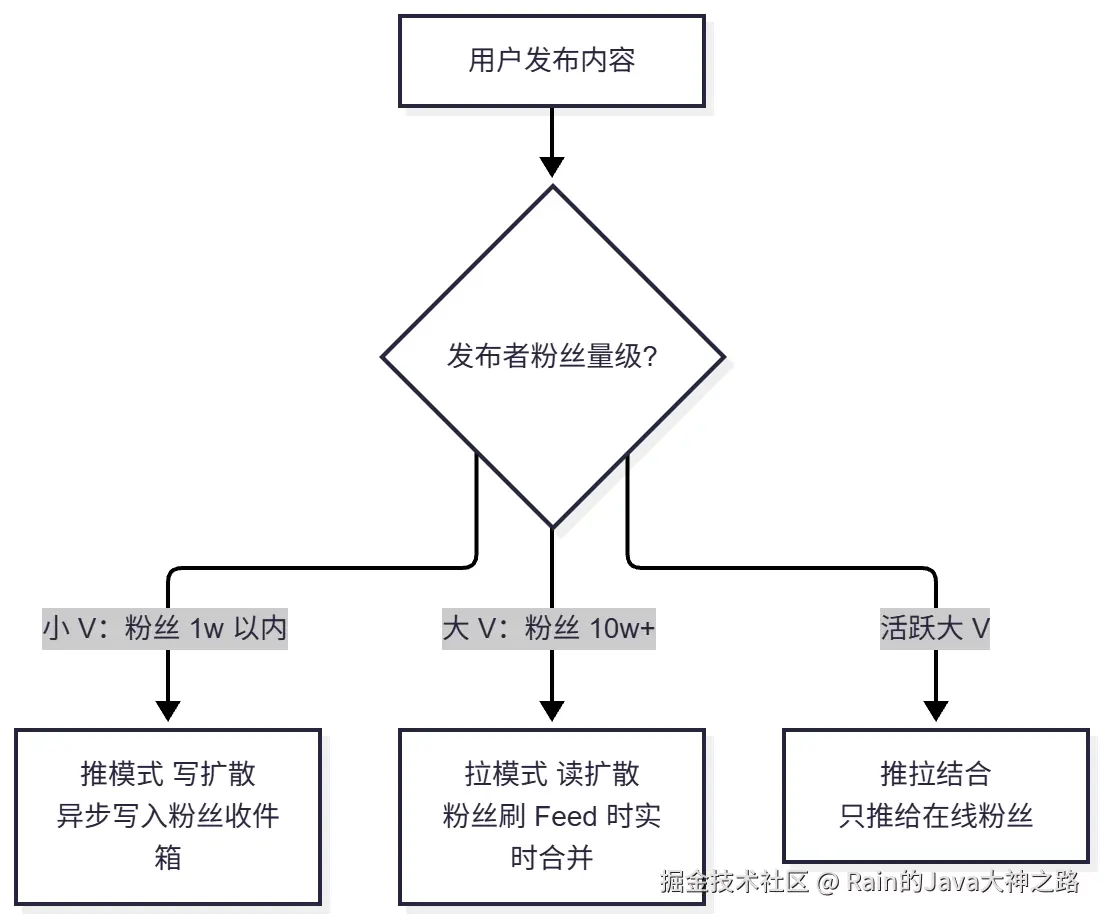
| 用户类型 | 模式 | 说明 |
|---|---|---|
| 小 V(粉丝 < 1w) | 写扩散(推) | 发一条内容,异步投递到粉丝收件箱 inbox:{fanUid} |
| 大 V(粉丝 ≥ 10w) | 读扩散(拉) | 不推,粉丝刷 Feed 时实时合并其关注的大 V 内容 |
| 活跃大 V | 推拉结合 | 只推给"在线粉丝",离线粉丝走拉取,收件箱 + 拉取结果归并排序 |
踩坑提醒 :一口气给 1000w 粉丝写扩散 = 1000w 次写,MQ 瞬间堆积百万。必须 MQ + 批量合并 + 异步削峰,而且大 V 走拉模式从根上避免。推/拉的粉丝阈值(1w 或 10w)做成配置,可以动态调。
功能都齐了,一致性和容灾才决定这套方案能不能活。
十、一致性兜底:对账 + 三级降级
先立个认知:点赞计数本质是派生数据,可以从 DB 重建。所以别追求 Redis 和 DB 强一致,接受秒级延迟,用对账任务做最终修正。真正需要强一致的只有"我到底点没点赞"这个用户侧状态------而它读多写少,直接读 DB 从库或走缓存就行。分清这两者,方案就不会过度设计。
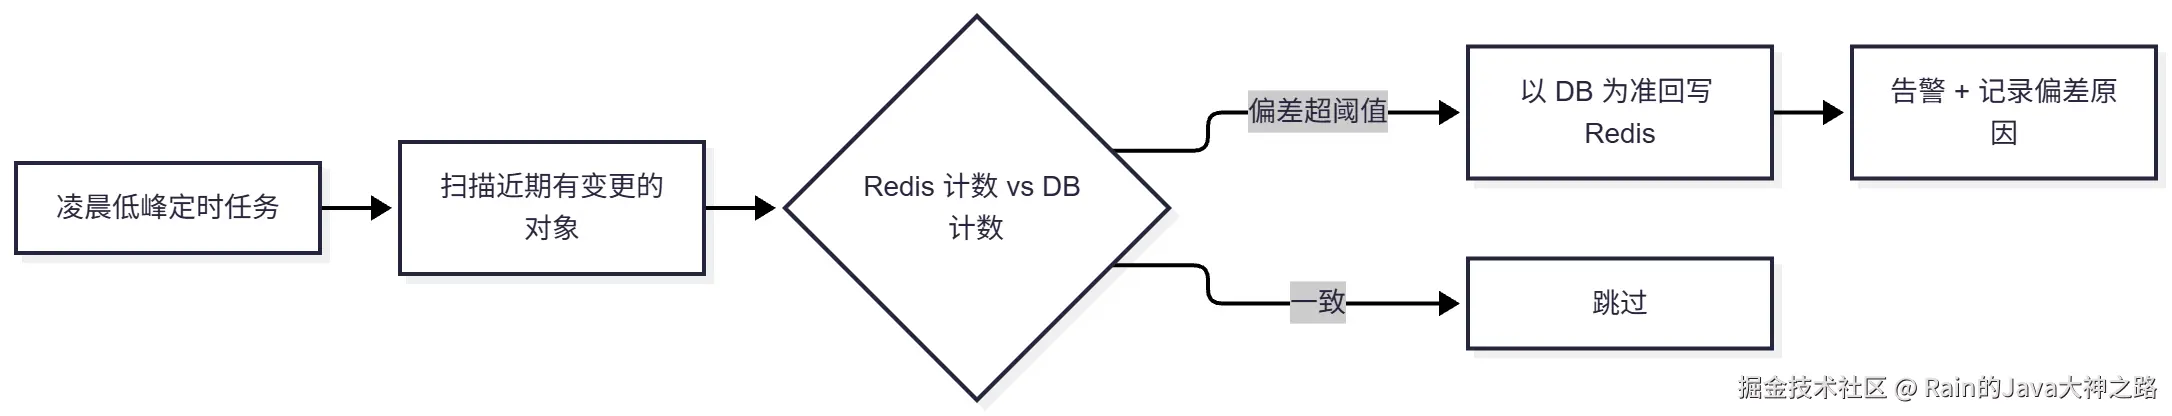
10.1 对账:是兜底,不是主链路
java
@Scheduled(cron = "0 */10 * * * ?")
public void reconcile() {
    long maxId = loadLastCheckPoint();
    // 增量对账:只扫近期有变更的对象,不做百亿级全量比对
    for (Long targetId : recentTargets(maxId)) {
        long dbCount = likeMapper.countValid(targetId);
        long redisCount = Optional.ofNullable(
                redis.opsForValue().get("like:count:" + targetId))
                .map(Long::parseLong).orElse(0L);
        if (dbCount != redisCount) {
            log.warn("对账不平 targetId={}, db={}, redis={}",
                    targetId, dbCount, redisCount);
            redis.opsForValue().set("like:count:" + targetId, String.valueOf(dbCount));
        }
    }
}
几个认知点:
- 对账不是主链路,是兜底。正常 99.9% 的数据靠 MQ 已经一致了,对账只处理 MQ 丢失、消费失败、极端并发的边角差异;
- 增量对账:只比对"近 1 小时有变更"的对象,分片并行 + 抽样校验,百亿级关系也跑得动;
- 以 DB 为基准回写 Redis------因为 DB 的关系表有唯一索引、不会丢,是事实来源;
- 差异超阈值要告警,再配一个手动校准接口,出问题一键触发。频次不用高,凌晨低峰跑一次即可;对计数敏感的业务可以缩到 10 分钟。
10.2 Redis 挂了:三级降级
- 第一级:Caffeine 本地缓存兜住读,计数继续服务(允许短暂陈旧);
- 第二级 :写请求进本地队列/MQ,Redis 恢复后回放重建;计数也可以降级为"只入 MQ 落库",页面展示
999+这类近似值; - 第三级 :超过阈值直接限流降级,提示"点赞稍后再试",绝不让流量穿透到 DB 把库打挂。
降级期间点赞可以暂不返回实时赞数,但操作状态不能丢 ------因为 MQ 是持久化的。记住这句话:Redis 只是加速层,数据真相在 DB 和 MQ 里。
高可用基建也不能少:主从 + 哨兵/Cluster 自动切换,AOF everysec 持久化,双活机房。多机房并发写冲突的场景,用单机房主写 + 就近读 + 异步同步,幂等脚本保证重复执行结果一致,天然收敛。
10.3 异常推演:这些角落必须提前想好
- Redis 主从切换丢数据:不依赖 Redis 持久化,MQ 作为主事实来源,重放消息重建缓存;
- 消息积压:动态加消费者;批量聚合插入可临时改成顺序插入,减小锁冲突;
- 布隆过滤器删不了:取消点赞后布隆里还标记存在------误判只是多一次 Redis 查询,不致命,定期重建即可;
- 极端热点(瞬时百万赞):本地写缓冲合并,50ms 批量发送,用少量延迟换吞吐;
- 计数负数:Lua 前置判断之外,计数更新加最小值保护(小于 0 直接置 0),对账发现负数直接修正为 DB 实际值并告警。
系统层面的坑都填完了,最后一个防线:总有人想刷你的赞。
十一、防刷兜底:别让刷子毁了你的计数
幂等只能防"重复",防不了"恶意"。防线要一层层叠:
- 前端防抖:点击后按钮置灰,拦截重复点击(只能防君子);
- 网关限流:按用户 ID、内容 ID 维度的令牌桶,过滤恶意刷量;
- Sentinel 热点参数限流:按 objId 维度限流,热点内容多一道保险;
- 滑动窗口频控:同一用户对同一内容,5 秒内最多操作 3 次;
- 风控黑名单:异步识别刷子账号,直接拒绝 + 计数回滚。
滑动窗口用 Redis ZSET 实现,脚本保证原子性:
java
public boolean isAllowed(Long userId, Long postId) {
    String key = "rate:like:" + userId + ":" + postId;
    long now = System.currentTimeMillis();
    long window = 5_000;   // 5 秒窗口
    long maxOps = 3;       // 最多操作 3 次

    String lua = "redis.call('ZREMRANGEBYSCORE', KEYS[1], 0, ARGV[1]) " +
                 "local cnt = redis.call('ZCARD', KEYS[1]) " +
                 "if cnt < tonumber(ARGV[2]) then " +
                 "    redis.call('ZADD', KEYS[1], ARGV[3], ARGV[3]) " +
                 "    redis.call('PEXPIRE', KEYS[1], ARGV[4]) " +
                 "    return 1 " +
                 "else return 0 end";
    Long result = redisTemplate.execute(RedisScript.of(lua, Long.class),
            List.of(key),
            String.valueOf(now - window), String.valueOf(maxOps),
            String.valueOf(now), String.valueOf(window + 1000));
    return result != null && result == 1L;
}另外在极端峰值下,还可以做业务降级:关闭"点赞用户列表"这类非核心展示,只保核心计数------牺牲非核心,保核心链路不雪崩。
十二、效果:用数据说话
折腾这么多,到底提升多少?同一套 JMeter 环境、单热点对象 10w QPS 压测下的对比:
| 指标 | 同步直写 DB | 优化后 | 变化 |
|---|---|---|---|
| 接口 QPS | 8,000 | 120,000+ | ↑ 15 倍 |
| P99 时延 | 320ms | 42ms(平均 1~3ms) | ↓ 7 倍+ |
| DB 写入 TPS | 8,000 | 600 | ↓ 13 倍(这是功劳) |
| 单对象写峰值 | ~8w QPS(单 key 瓶颈) | 100w+(本地聚合 + 分片) | ↑ 12 倍 |
| Redis 网络调用 | 1 次/请求 | 约 1/50 次 | ↓ 98% |
| 判重存储(千万级) | Set ~500MB | Bitmap ~1.25MB | ↓ 99.7% |
| 一致性 | 强一致 | 秒级最终一致,不一致率 <0.001% | 对账兜底 |
这套方案在亿级用户的社交项目里真实落地过,线上稳定跑了 2 年,经历过多次明星官宣、春晚级流量峰值,单集群写峰值 18w QPS,接口平均 RT 稳定在 2ms 以内,支撑过单日十亿级点赞请求,低峰校准后可以做到完全一致。单机轻松扛 3w+ QPS,且每一层都能独立水平扩容,不存在整体单点。
压测方法也说一下,面试常被追问:JMeter/自研压测机 → 单热点对象 10w QPS → 重点观察 Redis 单分片 CPU、DB 行锁等待、MQ 堆积、GC,改造前后对比同一套指标。数据不会骗人。
十三、高频追问,快问快答
Q1:为什么用 Lua,不用 Redis 事务 MULTI/EXEC? MULTI/EXEC 是排队执行,做不了分支逻辑,拿不到中间返回值,幂等判断就得两次 RT。Lua 支持条件分支 + 一次 RT + 整体原子,没理由不选。
Q2:计数拆成 100 个桶,读总数会不会很慢? 不会。桶数固定 100,HGETALL 一次拿 100 个 field 不到 1KB,Lua 内累加微秒级;外层还有 3 秒的 Caffeine,绝大多数读根本回不到 Redis。
Q3:为什么不 UPDATE cnt = cnt + 1 配合分片表? 分片表能解决总 TPS,但解决不了单条内容的行热点------同一条内容的所有点赞还是打在同一个分片上。把"自增"从 DB 挪出去,Redis 才是正确的计数载体。
Q4:热点 Key 怎么发现? 三条路:redis-cli --hotkeys / MONITOR 抽样;自研滑动窗口统计 top N;JD-hotkey / Sentinel 集群流控。发现后立即本地缓存 + 分桶 + 限流三板斧。
Q5:进程挂了,本地 buffer 里的计数丢了怎么办? 三层:① 优雅停机时 flush 一遍;② 缩短 flush 间隔(比如 500ms)减小丢失窗口;③ 计数是派生数据,对账任务从 DB 重建,成本可控。
Q6:定时对账会不会太慢?对不上以谁为准? 对账是兜底不是主链路,99.9% 的数据靠 MQ 已经一致。以 DB 为基准回写 Redis------因为 Redis 计数是可重建的派生数据,DB 关系表(唯一索引 + 不丢)才是事实来源。
Q7:关注计数为什么单独一个 key? SCARD 大 key 会阻塞单线程,而且列表分片后 SCARD 只能拿到单片数量。HINCRBY 独立计数器,读总数 O(1) 且不受分片影响。
Q8:前端展示的点赞数不准怎么办? 社交产品普遍接受最终一致(微博抖音也一样)。前端可以做乐观更新------先 +1,后端异步校正,体验反而更流畅。
Q9:怎么评估方案的可扩展性? 服务层无状态横向扩;Redis Cluster 分片扩容(分桶计数天然支持再拆);MQ 加分区提吞吐;DB 分库分表预留 2 倍余量。每一层都能独立扩容,没有整体单点。
十四、难点全景表,建议收藏
| # | 技术难点 | 现象 / 根因 | 解决方案 |
|---|---|---|---|
| 1 | DB 热点行锁竞争 | cnt = cnt + 1 串行排队,IOPS 打满 |
Redis 计数 + MQ 异步,DB 不做自增 |
| 2 | 并发重复计数 | 先查后改的竞态条件 | Lua 原子:检查 + 写入 + 计数一步完成 |
| 3 | 幂等 | 客户端重试、用户狂点 | SETBIT/SISMEMBER 判断 + DB 唯一索引双保险 |
| 4 | 热点 Key 打爆单分片 | 单 key 单 slot,OPS 有上限 | 分桶/分片 + 本地聚合 + Caffeine + 热点集群 |
| 5 | 大 Key 阻塞 Redis | 百万级 Set SMEMBERS 阻塞单线程 |
Set 分片(最多拆 1024 片)/ Bitmap / SSCAN 分页 |
| 6 | 幂等存储爆炸 | 判重集合比计数大几个量级 | Bitmap / 分段 RoaringBitmap |
| 7 | 缓存与 DB 不一致 | MQ 丢失、消费失败 | 重试队列 + 死信 + WAL + 定时对账 |
| 8 | 计数变负数 | 重复扣减 | Lua 扣前先判存在 + 最小值保护 |
| 9 | 列表页 N+1 查询 | 20 条内容 20 次 IO | Pipeline / SMISMEMBER 批量,RT 50ms→2ms |
| 10 | 大 V 粉丝千万级 | 大 key + 深分页 | 64 分片 + 热页缓存 + 独立计数 + 冷热分离 |
| 11 | 写扩散风暴 | 一条内容推千万粉丝 | 推拉结合,大 V 走拉模式 |
| 12 | MQ 重复 / 乱序 / 丢失 | 网络重投、消费失败 | 幂等消费 + 分区键保序 + 手动 ACK |
| 13 | 穿透 / 击穿 / 雪崩 | 恶意查询、热点过期、集中过期 | 布隆过滤器 + 互斥回源 + TTL 加随机值 |
| 14 | 恶意刷赞 | 脚本高频调用 | 滑动窗口 + 令牌桶 + 风控黑名单 |
| 15 | Redis 故障 | 主从切换丢数据 | 三级降级 + MQ 重放重建 |
| 16 | 关注分片后双向查询 | 粉丝维度跨库 | 双向表双写 t_follow + t_fans |
| 17 | 对账成本高 | 百亿级全量比对慢 | 增量对账 + 分片并行 + 抽样校验 |
| 18 | 多机房并发写冲突 | 同用户两地同时点赞 | 单机房主写 + 就近读 + 幂等收敛 |
十五、写在最后:三句话带走整套方案
回头看这套设计,本质就三句话:
- 把集中的写打散------分桶、分片、本地聚合;
- 把高频的写合并------攒批、最终态合并、计数聚合;
- 把不重要的一致性后置------异步落库 + 对账兜底。
计数是派生数据,可以重建;用户状态才是真正的强一致诉求。分清这两者,方案就不会过度设计。高并发设计不是"让数据库更快",而是"让数据库少干活"。
如果真要上线,我最担心的是计数漂移 和冷启动击穿,所以上线前必做三件事:
- 全链路压测,必须包含热点单 key 场景;
- 灰度发布 + DB 与 Redis 计数差异对比看板;
- 对账任务和降级开关,先于业务代码上线。
落地检查清单,上线前挨个勾一遍:
- 限流:用户维度令牌桶 + 内容维度热点限流
- 幂等:Lua 脚本 + DB 唯一索引双保险
- 热点:计数分桶 + 本地缓存 + 热点探测
- 削峰:MQ 攒批(100 条 / 50ms),分区键 = targetId
- 一致性:定时对账 + 差异告警 + 自动校正
- 降级:本地缓存兜底 → 队列回放 → 限流提示
- 监控:Redis 热点/大 key、MQ 堆积、DB 慢 SQL、一致性差异率

最后送个面试方法论:遇到"高并发 XX 功能优化",按这个顺序讲------量化需求 → 定位瓶颈 → 分层拆解 → 关键代码 → 一致性兜底 → 降级预案 → 监控验证 。面试官想听的从来不是"我用过 Redis",而是你为什么这么选、选错了会怎样。