多智能体编排:拆分、隔离与收敛的完整实战
一句话剧透全文:多智能体的本质不是"更多的 Agent",而是"更小的上下文"------每路子 Agent 用自己的独立窗口去探索,只把结论上交。拆分、隔离、收敛这三步怎么用代码落地,和真正跑在生产上的系统相比骨架有多像、缺件缺在哪,这篇一次讲透。
0. 引子:一个把上下文滚雪球的问题
想象你问智能体一个需要查三个地方的问题:
对比我知识库里那三篇讲索引的笔记,观点有什么异同?
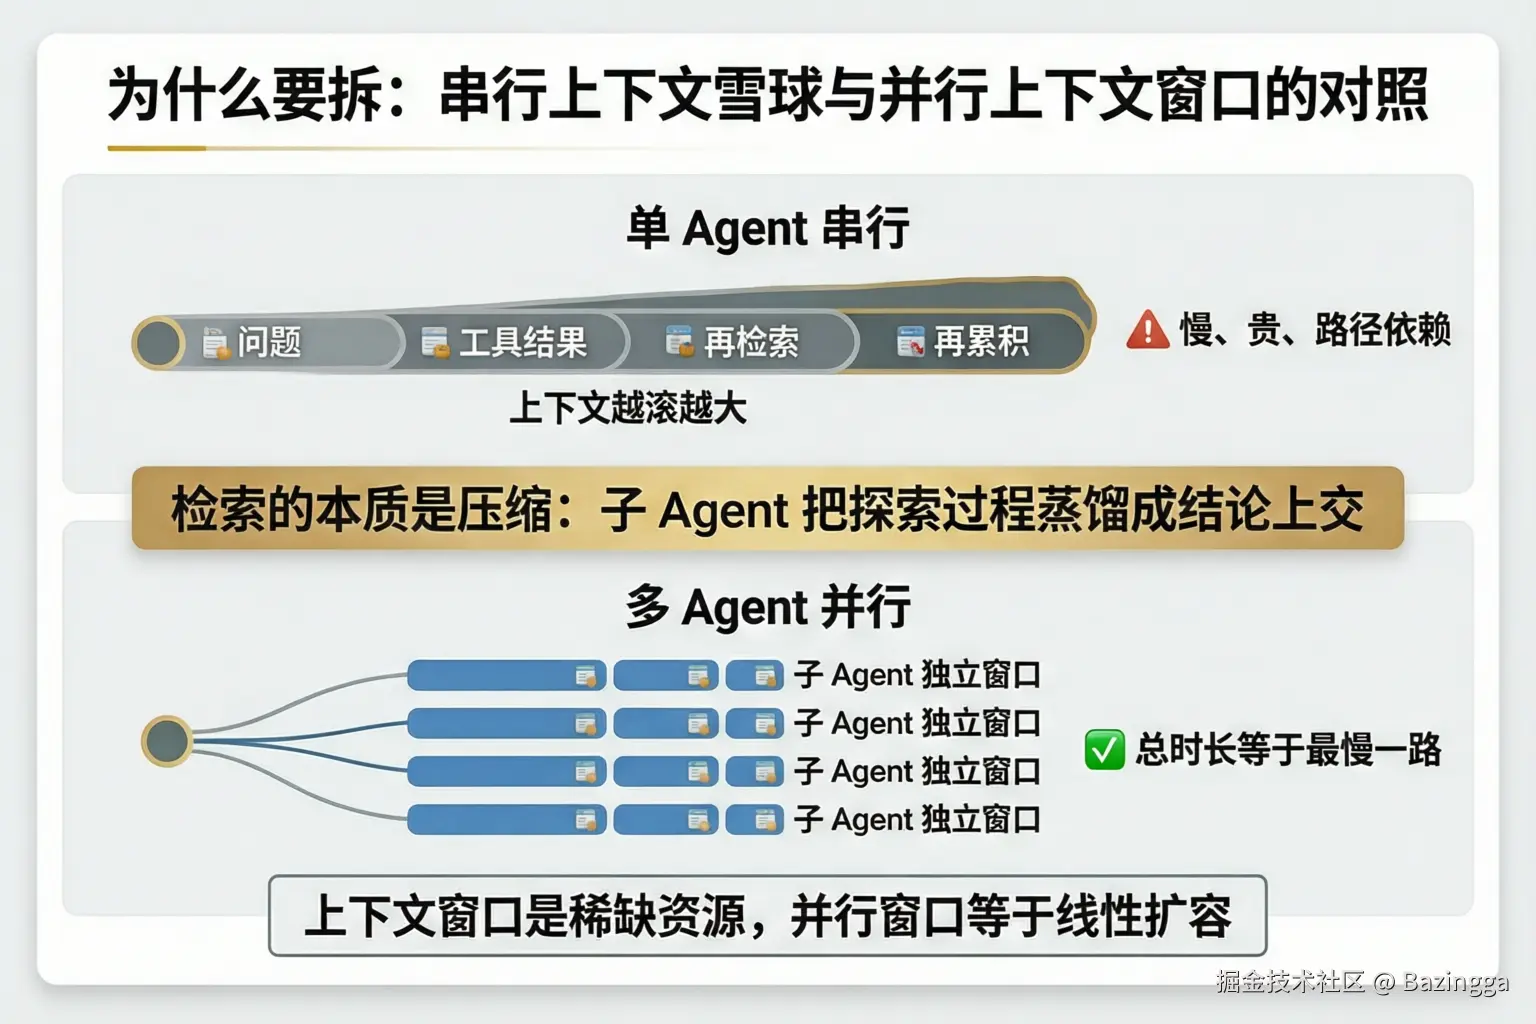
单个 Agent 的处理方式是串行的:检索第一篇 → 结果进入上下文 → 检索第二篇 → 结果叠在第一篇上面 → 检索第三篇 → 此时上下文已经很肥 → 开始写对比。写着写着你会发现一个残酷的事实:回答质量最好的时机是三份材料刚凑齐的那一刻,之后每多生成一个字,最早的那份材料就被稀释一分。
这不是玄学,是注意力机制的物理规律------上下文越长,每个 token 分到的注意力权重越薄。工程上还有一个雪上加霜的账:串行执行时,每一步的工具结果都会滚进后续所有步骤的输入,你为同一个中间结果反复支付 token,越到后面越贵。
多智能体编排(multi-agent orchestration)就是对这个问题的正面回答。这篇文章用一个真实可运行的 Java 实现做解剖标本,讲清三件事:
- 怎么拆------什么样的问题值得拆成几路,谁来做这个决定;
- 怎么隔离------几路子 Agent 并行跑,怎么保证互不干扰、不污染主会话;
- 怎么聚合------各路结论回来后,怎么合成一份比"拼接"更好的答案。
最后拿它和 Anthropic 公开的生产级多智能体系统做对比:骨架有多一致,差的那几个件到底是什么。
文中代码取自一个 Java 技术栈的示例工程(Spring Boot + Reactor + AgentScope Java + Spring AI),为可读性做了精简,但每一行都来自真实实现,不是示意伪码。
1. 为什么要拆:上下文窗口是稀缺资源
先把"拆"的动机讲透,后面所有设计才有依凭。
单 Agent 串行处理复杂问题,有三宗罪:
| 病症 | 机制 | 直观感受 |
|---|---|---|
| 慢 | 第 3 次检索必须等前两次跑完 | 排队办理,前面不结算你干等 |
| 贵 | 每步工具结果滚进后续所有步骤的输入,token 越滚越多 | 为同一个中间结果反复付费 |
| 路径依赖 | 第一步检索歪了,后面的推理全建在歪的地基上 | 一步走错,步步被带偏 |
第三宗罪最隐蔽也最致命。单 Agent 的探索是一条线:它在第 1 步搜到的内容,会直接影响第 2 步搜什么、第 3 步怎么想。整条路径像多米诺------而在开放性的研究型问题里,"第一步就搜歪"是常态而非意外。
多 Agent 并行的解法,Anthropic 在他们的多智能体研究系统文章里有一句精辟的总结:搜索的本质是压缩(the essence of search is compression) ------从海量语料里蒸馏出几条洞见。子 Agent 正是压缩的执行者:每路子 Agent 拿着自己的独立上下文窗口去探索,中间过程(可能翻了几十个网页、调了十几次工具)都留在自己的窗口里,最后只把蒸馏过的结论上交。
主控 Agent 收到的不是几万 token 的原始材料,而是三份各几百 token 的浓缩情报。上下文窗口这个稀缺资源,就这样被"并行多窗口 + 结论上交"线性扩容了。
一句话总结:拆分买的不是"更多人手",是"更干净的窗口"。
2. 什么问题值得拆:三判据天平
看到这里你可能想把手头所有问题都拆了------且慢。拆分本身有成本:规划要一次模型调用、每路子 Agent 是独立的 token 消耗、收敛还要再一次模型调用。拆一个不值得拆的问题,等于雇三个顾问回答一道口算题。
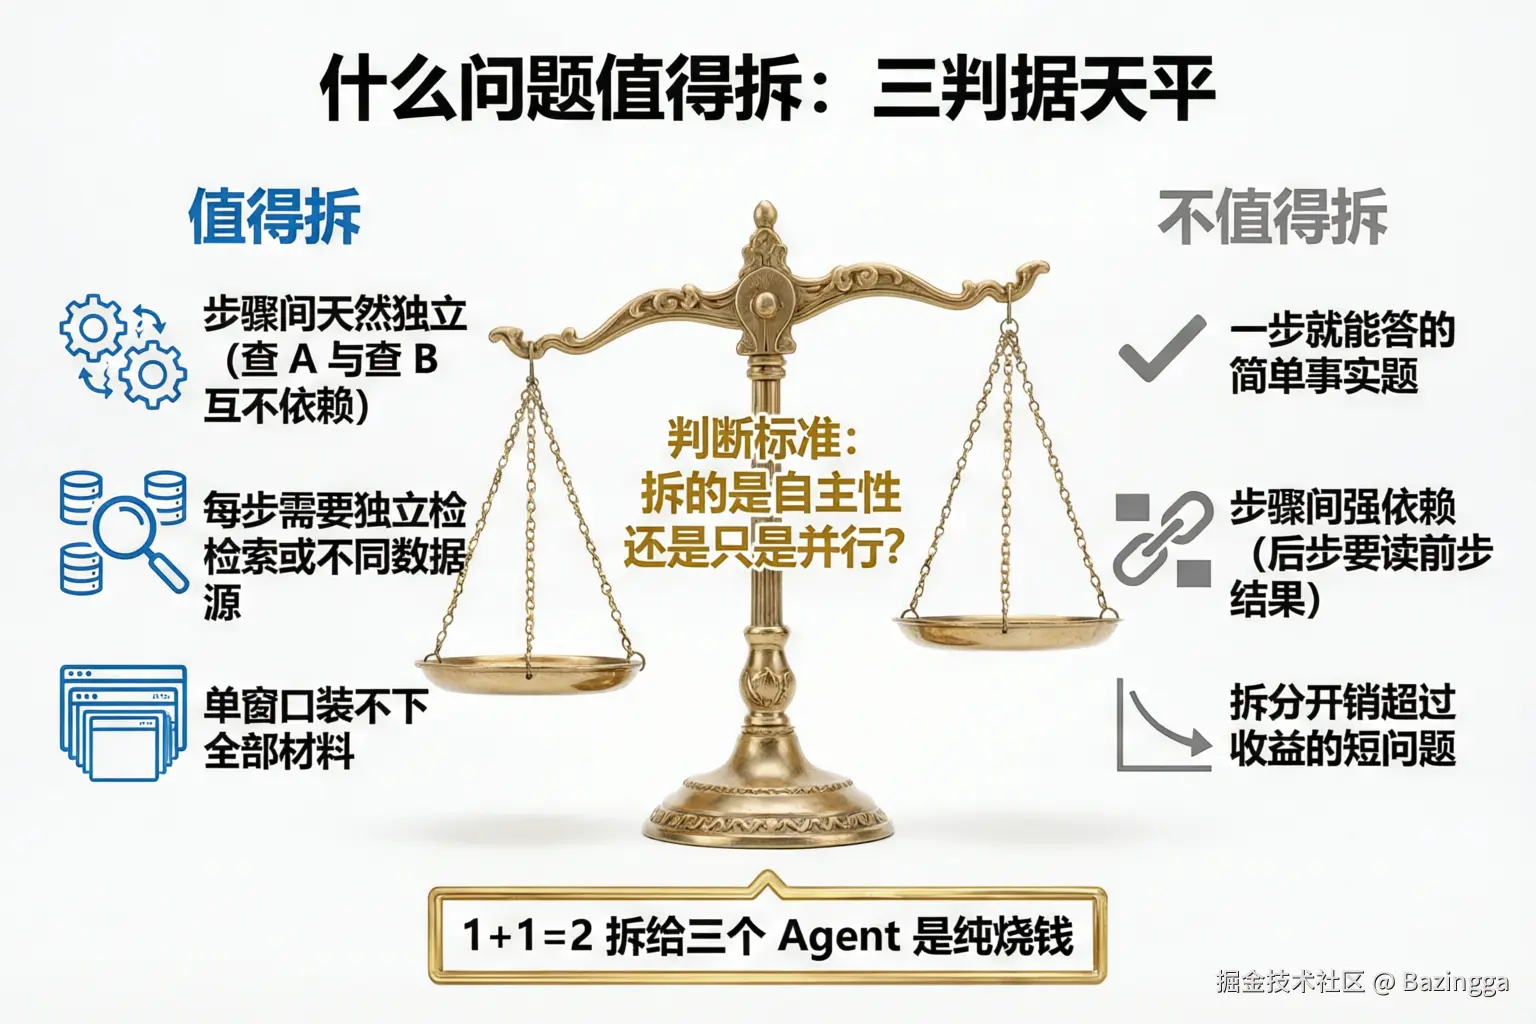
什么值得拆?三判据天平左边,每一条都在问同一件事------拆的是自主性还是只是并行:
值得拆的三个信号:
- 步骤间天然独立------查 A 和查 B 互不依赖,谁先谁后都行。独立意味着可以真正并行,而不是表面开多路、实际互相等;
- 每步需要独立检索或不同数据源------一路查知识库、一路查浏览器、一路查资产台账,各查各的,中间结果不需要互相喂;
- 单窗口装不下全部材料------三份原始材料合计远超上下文预算,但三份结论装得下。这是"压缩"收益最大化的场景。
不值得拆的三个信号:
- 一步就能答的简单事实题------"Java 21 是哪年发布的",一次检索搞定,拆开纯属浪费;
- 步骤间强依赖------后步要读前步的结果才能开工(比如"先解析文档结构,再按结构提取字段")。强依赖问题拆开反而要额外的传递开销,不如单 Agent 顺序推进;
- 拆分开销超过收益的短问题------判断口径很简单:预计单 Agent 三五步内能完成的问题,拆分的管理成本(规划 + 收敛 + 并行开销)大概率吃掉全部收益。
天平底下压着的那句话值得抄在工位上:"1 + 1 = 2"拆给三个 Agent 是纯烧钱。技术上能不能拆?能------规划器完全可以把它拆成"查 1"、"查 +"、"查 2",三路并行一秒汇合,答案还多花了一次规划调用和一次收敛调用的钱。能拆和值得拆之间隔着一道经济账,这道账就是三判据天平。
顺带回答一个高频问题:**纯推理问题(不查任何资料)值得拆吗?**也看独立性。"先列要点、再组织成文"这种内在强依赖的流程不值得拆;而"从三个独立视角分析这个方案"就值得------三个视角彼此独立,各自的思考过程留在各自窗口,只交换结论。
3. 整体架构:一个主控,一群分身,一个收口
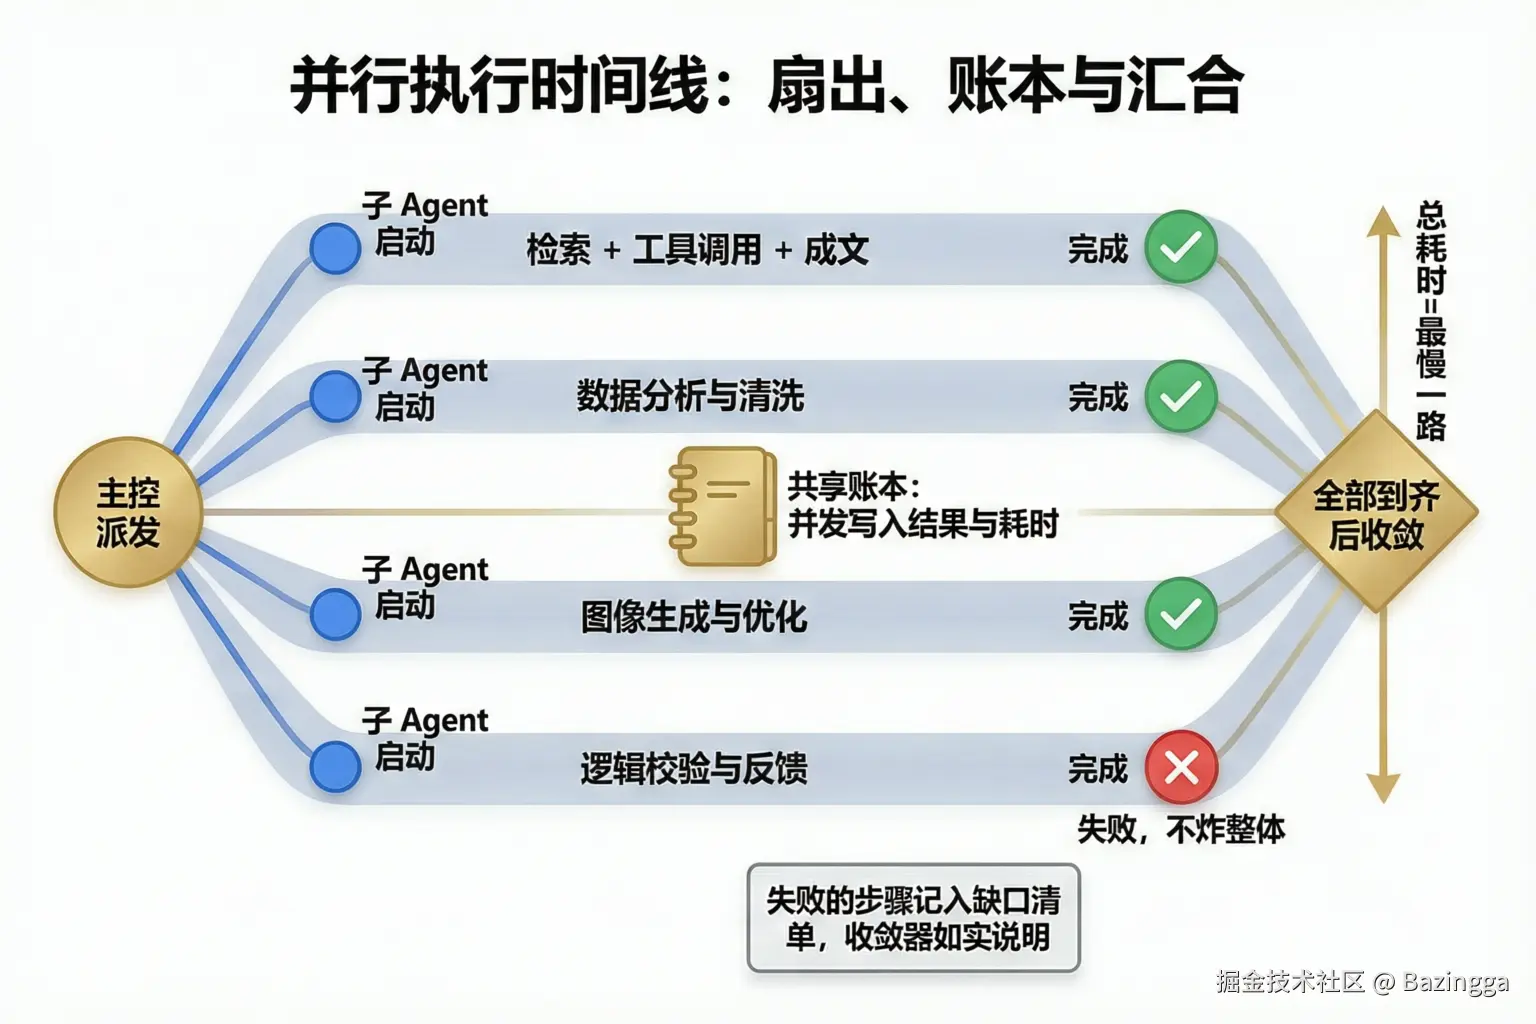
值得拆的问题怎么拆?先看整体骨架。业界把这个模式叫 orchestrator-workers(编排者-工人):一个主控 Agent 负责拆任务和收结果,若干工人 Agent 各领一份子任务独立执行。
一次完整请求的生命周期是四幕:
用户提问
   │
   ▼
┌─────────┐    ┌──────────┐    ┌─────────────────┐    ┌─────────┐
│ ① 规划   │───▶│ ② 扇出    │───▶│ ③ 并行执行        │───▶│ ④ 收敛   │
│ 模型拆任务│    │ 代码分派   │    │ 各路子Agent独立探索 │    │ 模型聚合  │
│ 2~5 步   │    │ 并发拉起   │    │ 只交结论          │    │ 代码保底  │
└─────────┘    └──────────┘    └─────────────────┘    └─────────┘
第一幕·规划 :主控把问题交给一个"规划器"模型,产出结构化的分步计划(2~5 步,每步一句话说清做什么)。注意:拆几步、每步干什么,是模型的决策。
第二幕·扇出 :代码拿到计划,按步骤数并发拉起子 Agent。每路子 Agent 拿到:一次性会话身份、独立上下文窗口、只读工具面、(需要时的)独立浏览器实例。注意:怎么派、并发多少、边界在哪,是代码的决策。
第三幕·并行执行:各路子 Agent 独立探索------检索、翻网页、调用工具,全程在自己的窗口里,互不知晓彼此存在。跑完只上交一份几百字的结论。总耗时约等于最慢的一路,而不是各路之和。
第四幕·收敛 :代码把各路结论收集齐,交给"收敛器"模型合成最终回答。模型聚合失败时,代码降级拼接保底------模型聚合,代码兜底。
这个四幕结构里藏着一个贯穿全文的原则:模型决策判断类问题,代码决策确定性问题。下一节开始逐幕拆开看代码。
4. 怎么拆:规划段的三道保险
拆分的核心是一个看似简单的函数:把用户的问题变成一份步骤清单。但"让大模型输出可靠的结构化计划"这件事,坑比想象的多------模型可能输出不合法的 JSON、可能一口气拆出五十步、可能拒绝拆分。示例实现用三道保险把这些问题全部兜住。
第一道:结构化输出 + 解析重试 。规划器被要求输出严格的 JSON({"steps": [...]}),解析失败自动重试一次:
java
/**
 * 规划段:模型结构化产出 2~5 步计划。解析失败重试 1 次;
 * 两次都失败降级为「整段文本 = 单步计划」(执行链路绝不因规划失败而中断)。
 */
private List<String> makePlan(ReasoningRequest request) {
    String prompt = promptRegistry.render(PLAN_EXECUTE_PLANNER,
            new PlannerParams(request.message()));
    for (int attempt = 1; attempt <= 2; attempt++) {
        ChatResponse response = chatModel.call(new Prompt(
                List.of(new UserMessage(prompt)),
                OpenAiChatOptions.builder().model(judgeModelName()).build()));
        List<String> steps = parseSteps(response.getResult().getOutput().getText());
        if (!steps.isEmpty()) {
            return capSteps(steps, request);
        }
        // 解析失败:第 1 次重试,第 2 次走降级
        if (attempt == 2) {
            String text = response.getResult().getOutput().getText();
            if (text != null && !text.isBlank()) {
                return List.of(text.strip());  // 兜底:整段文本当单步计划
            }
        }
    }
    return List.of("直接回答用户问题(规划降级)");
}
注意降级链的终点:哪怕规划器两次都输出垃圾,用户依然能得到回答------整段输出被当作"单步计划"交给执行器,系统退化为单 Agent 直答。执行链路绝不因规划失败而中断,这是比"拆得漂亮"更重要的工程原则。
第二道:步数钳制。规划器也是模型,也会跑飞------比如给一个简单问题拆出二十步。代码用硬上限兜底:
java
/**
 * 步数钳制(旋钮 maxPlanSteps,2-10 默认 5):超限截断防规划器跑飞
 */
private List<String> capSteps(List<String> steps, ReasoningRequest request) {
    int max = request.intParam("maxPlanSteps", 5, 2, 10);
    if (steps.size() <= max) {
        return steps;
    }
    return new ArrayList<>(steps.subList(0, max));
}第三道:提示词纪律。拆分质量的上限由规划提示词决定,示例工程的规划提示词长这样(节选):
text
你是执行规划器。针对用户问题,产出一份可执行的分步计划。

规划纪律:
- 步骤数 2~5 步:过少退化为一问一答,过多让执行失焦
- 每步一句话写清「做什么、用什么工具」,执行者会按步骤顺序推进
- 需要查数据的步骤写明用哪个工具
- 纯推理/写作类问题也要拆(如「先列要点再组织成文」),但不虚构数据来源

只输出一个 JSON 对象:
{"steps": ["第一步...", "第二步..."]}三个纪律各有分工:步数区间 (2~5)防止两个极端;写明工具 让子任务落到具体数据源,避免"去研究一下"这种空转指令;纯推理也要拆把适用面从"检索型问题"扩到"思考型问题"。
这里值得停一秒体会架构意图:模型决定"拆不拆、拆几步、每步干什么",代码决定"最多拆几步、解析失败怎么办、跑飞了怎么截断"。判断权给模型(它擅长理解问题结构),保险丝给代码(它擅长确定性执行)。后面每一幕都会反复出现这个分工。
5. 怎么隔离:五维隔离,一道都不能省
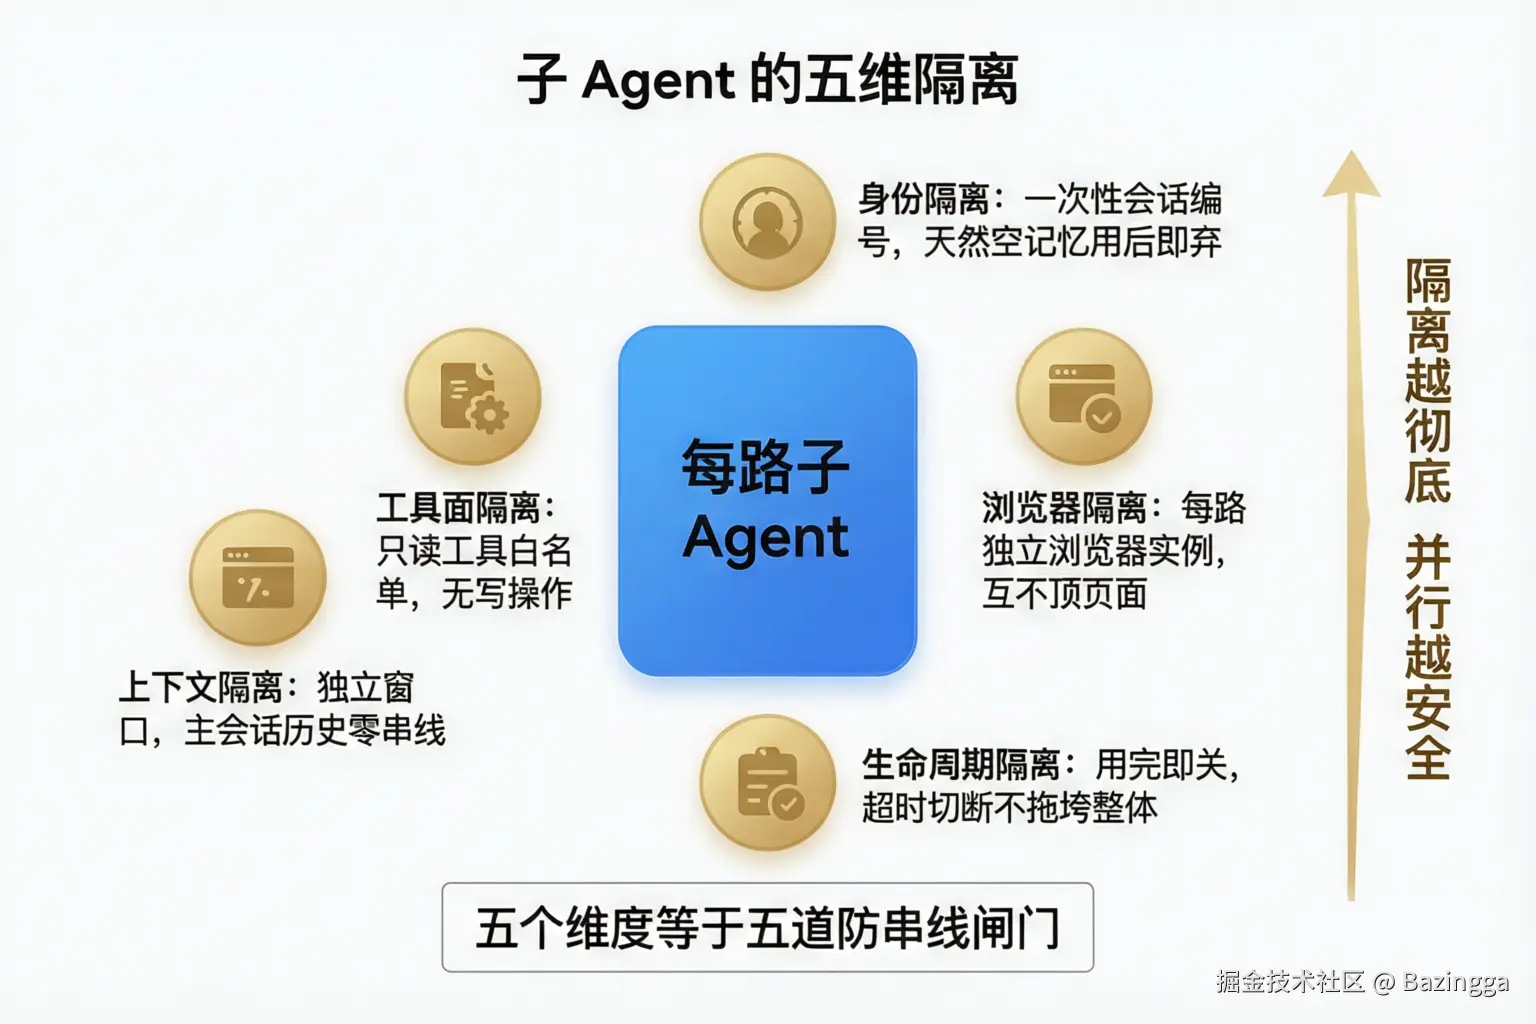
并行是双刃剑:多路子 Agent 同时跑,任何一处共享状态都是串线隐患------两路子 Agent 共用一个浏览器会互相顶掉对方的页面;共写一段会话记忆会让用户的历史被污染;一个子 Agent 卡死会拖垮整批请求。示例实现把隔离拆成五个维度,逐一落到代码。
5.1 身份与记忆隔离:一次性身份证
每路子 Agent 拿到的不是主会话身份,而是一个一次性编号:
java
String subSession = request.sessionId() + "-spawn-" + (index + 1);
// 记忆隔离:一次性 scopeKey 当 userId------会话记忆/工作区按它隔离,
// 天然为空、用后即弃,与主会话及用户长期记忆零串线
String scopeKey = UserContexts.spawnScopeKey(request.sessionId(), index + 1);
scopeKey 是精妙的一笔:框架的会话记忆和用户工作区都以 userId 为隔离键,把一次性的 spawn 编号当 userId 用,子 Agent 的记忆就落在一片天然为空的命名空间里------它读不到主会话历史、读不到用户长期记忆,写下的东西也随编号废弃。不需要任何"清理记忆"的代码,隔离是身份系统的免费副产品。
5.2 上下文隔离:各窗口互不知晓
子 Agent 的系统提示词只描述它自己的子任务,不携带主会话的任何历史。三路子 Agent 对彼此的存在一无所知------这保证了并行探索的独立性:第二路不会因为看到第一路的中间结论而改变自己的检索方向。独立性不是浪费,是防止"三路殊途同归地查了同一个地方"的必要条件。
5.3 工具面隔离:只读白名单
子 Agent 能用的工具是主 Agent 的只读子集。以浏览器工具为例,白名单显式列出八个读类操作:
java
/**
 * 浏览器只读子集:页面读/截图/调试读/等待。
 * 排除 click/type/tabs------页面写交互不进并行子 Agent。
 */
private static final List<String> BROWSER_READONLY_TOOLS = List.of(
        "browser_navigate",
        "browser_navigate_back",
        "browser_snapshot",
        "browser_find",
        "browser_take_screenshot",
        "browser_console_messages",
        "browser_network_requests",
"browser_wait_for");白名单里没有 click、type、tabs------并行场景下的写行为不可控:三路子 Agent 若都能点按钮,谁也无法预料页面最终停在什么状态。写权限留在主 Agent(串行、可控),子 Agent 只读不写,这是并行安全的底线。
5.4 浏览器隔离:一人一个实例
只读还不够------三路子 Agent 共享一个浏览器实例,就算都只做导航,也会互相顶掉对方的页面。所以每路子 Agent 独立拉起自己的浏览器连接:
java
public Handle create(boolean includeBrowser) {
    Toolkit toolkit = new Toolkit();
    // 本地只读工具注册(知识检索/资产查询,无文件写入)......
    McpSyncClient browserClient = null;
    if (includeBrowser && mcpProperties.isEnabled()) {
        browserClient = newStdioClient();   // 独立 MCP 连接(--isolated 独立浏览器实例)
        for (McpSchema.Tool tool : browserClient.listTools().tools()) {
            if (!BROWSER_READONLY_TOOLS.contains(tool.name())) {
                continue;                   // 只注册白名单内的工具
            }
            toolkit.registerAgentTool(toBridge(tool, browserClient));
        }
    }
    return new Handle(toolkit, browserClient);  // 句柄交给调用方,用完必须 close()
}
每路一个独立的 MCP stdio 客户端,背后是一个独立浏览器进程------三路并行导航各自的页面,物理上不可能互相干扰。
5.5 生命周期隔离:用完即关
并行子 Agent 是重资源(浏览器进程、MCP 连接),泄漏一个就脏一批。示例用 Reactor 的 Flux.using 把生命周期钉死在流上:
java
Flux<String> agentFlow = Flux.using(
        () -> {
            // 资源获取:工具面 + 子 Agent 实例
            Handle handle = subAgentToolkitFactory.create(true);
            HarnessAgent agent = agentScopeAgentFactory
                    .createBuilder(workerPrompt, handle.toolkit()).build();
            return new SubAgentResources(handle, agent);
        },
        res -> res.agent().streamEvents(new UserMessage(task), ctx)
                .timeout(STEP_TIMEOUT),          // 超时切断,单步不死等
        res -> {
            res.agent().close();                 // 无论正常/异常/超时,都执行
            res.handle().close();                // 连带终止浏览器子进程
        });
Flux.using 的语义是 try-with-resources 的流式版:无论流以何种方式终止(完成、报错、超时、取消),清理逻辑一定执行 。再配一道 timeout(STEP_TIMEOUT)------单步超时切断,失败记为该步的 failed 状态,不拖垮其他路,也不拖垮整体。
五维隔离串起来读,其实是同一个思想的五个投影:并行子 Agent 是"一次性餐具"------独立身份、独立窗口、只读面、独立实例、用完即弃。哪一维偷懒,哪一维就是事故的温床:共享浏览器 → 页面互顶;共享记忆 → 数据污染;没有超时 → 一路卡死全家等待。
6. 怎么聚合:收敛不是拼接
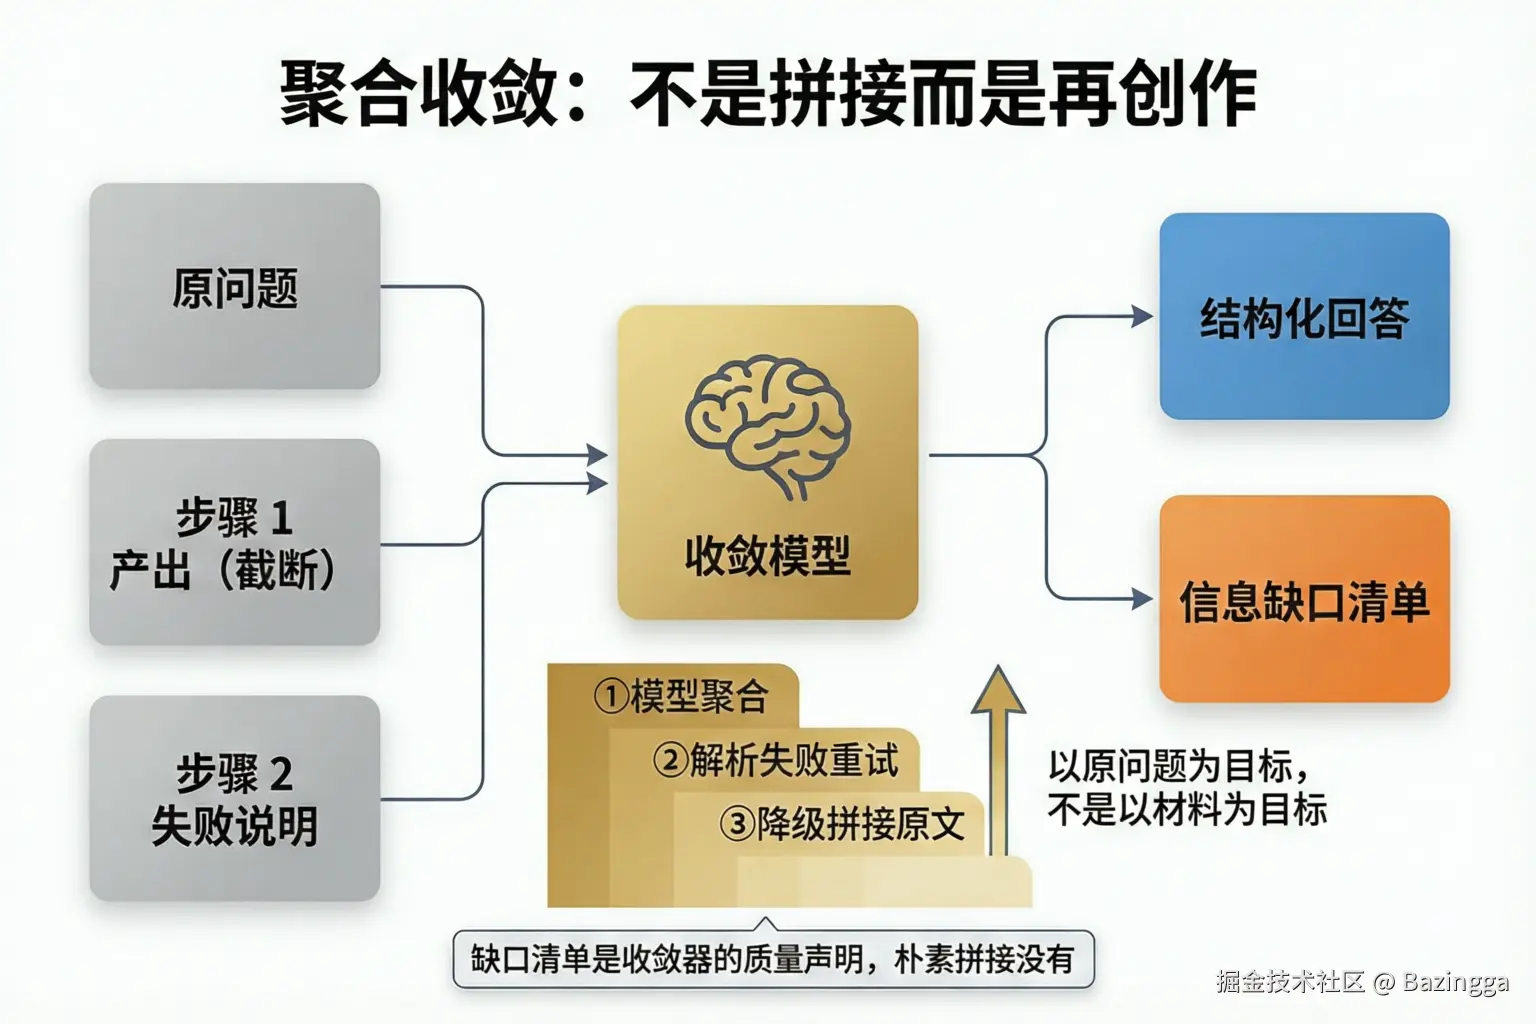
各路结论到齐后,最偷懒的聚合是按顺序拼起来返回------但拼接恰恰是浪费:三路结论可能互相矛盾、可能重复覆盖同一信息、可能各自带幻觉。示例实现的收敛器做三件拼接做不到的事:交叉验证、突出重点、如实报缺口。
先看收敛器的输入怎么组装:
java
/**
 * 收敛段:子任务产出 → 结构化 JSON(answer + gaps)。
 * 解析失败重试 1 次;两次都失败降级为拼接各步产出原文------
 * 执行链路绝不因收敛失败而中断。
 */
private SynthResult synthAnswer(ReasoningRequest request, List<String> steps,
                                Map<Integer, StepOutcome> outcomes, Long profileId) {
    StringBuilder results = new StringBuilder();
    for (int i = 0; i < steps.size(); i++) {
        StepOutcome outcome = outcomes.get(i);
        results.append("步骤").append(i + 1).append(":")
                .append(outcome == null || outcome.output() == null
                        ? "(执行失败:" + outcome.failure() + ")"
                        : truncate(outcome.output(), STEP_SYNTH_CHARS))  // 每步截断,防单路淹没收敛器
                .append("\n\n");
    }
    // ......调用收敛模型,解析 answer + gaps,失败重试 1 次后降级拼接
}
两个细节值得放大:
每步产出截断后再进收敛器 。任何一路子 Agent 跑飞了产出超长文本,也不能淹没收敛器的输入------收敛材料预算是按步配额的,这是对"压缩"原则的二次执行:子 Agent 压缩探索过程,收敛器再压缩子 Agent 的产出。
失败步骤如实进材料。某路失败,收敛器看到的不是空白,而是明示的"(执行失败:超时)"------收敛模型可以据此在回答里说明这个方向没查到,而不是装作这步不存在。
再看收敛器的产出结构。它被要求输出两个字段:
text
你是收敛器。多个并行子 Agent 各自完成了子任务,请把它们的产出收敛为最终回答。

收敛纪律:
- 直接输出最终回答的正文,不要逐条复述子任务、不要输出「根据步骤N」式的元叙述
- 各子任务产出冲突时,采用信息更完整/更具体的一方,必要时一句话注明分歧
- 子任务失败或未找到信息的部分如实说明,不虚构补齐
- 篇幅与问题复杂度匹配:简单问题两三句话,复杂问题给结构化要点

只输出一个 JSON 对象:
{"answer": "最终回答正文", "gaps": ["未能覆盖的信息缺口,无则空数组"]}
gaps 是这个设计的灵魂 。它逼着收敛器诚实:合并完所有材料后,用户问题里还有哪些部分没被覆盖?这些缺口随回答一起返回给前端,随消息存档。对比"拼接式聚合"------三段原文粘在一起,矛盾照单全收、缺口无人申明------answer + gaps 的结构化产出把聚合从"物理合并"升级成了"再创作":收敛器是拿三份情报写简报的参谋,不是装订工。
最后是降级链:收敛模型解析失败重试一次,两次都失败,代码直接拼接各步产出原文返回(degradedSynth),并打上降级标记。和规划段一样------用户永远能拿到一个可用的回答,哪怕是以最丑的形态。
7. 三种决策权各就各位
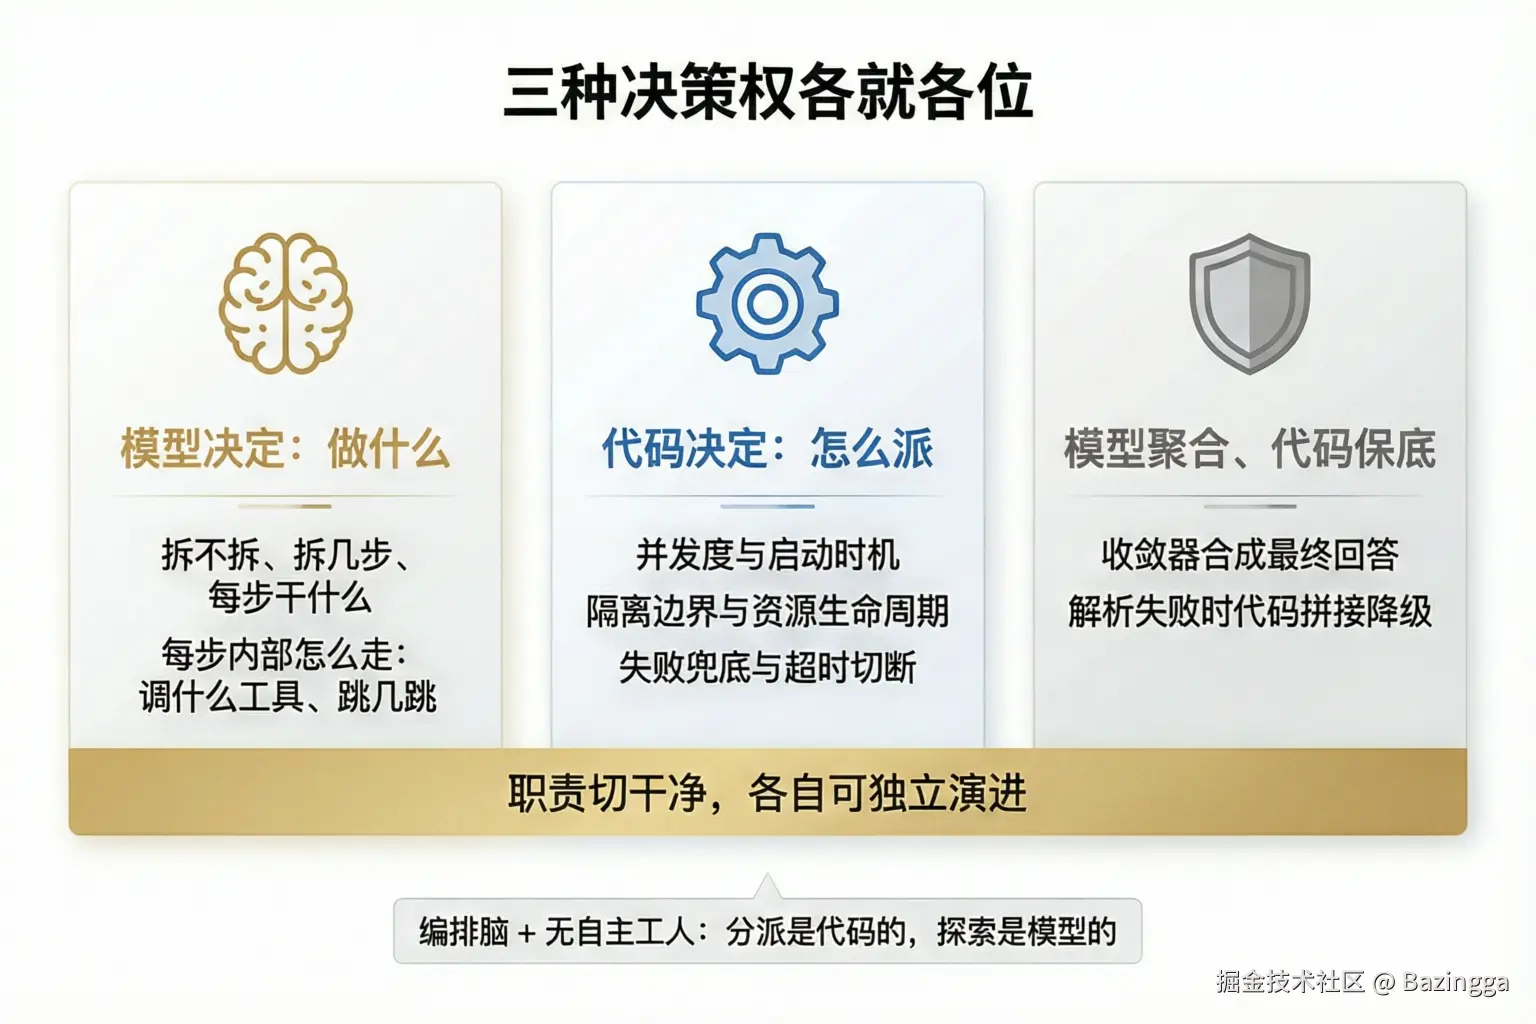
把四幕串起来复盘,会发现整个系统其实只在做一件事:把决策权切干净。
| 决策权 | 归属 | 具体内容 |
|---|---|---|
| 做什么 | 模型 | 拆不拆、拆几步、每步干什么;每步内部调什么工具、跳几跳 |
| 怎么派 | 代码 | 并发度与启动时机;隔离边界与资源生命周期;超时切断与失败兜底 |
| 怎么收 | 模型为主,代码保底 | 收敛器合成最终回答与缺口;解析失败时代码降级拼接 |
为什么这样切?因为两类问题需要两种系统:
判断类问题 ("这个问题需要查几个方向?")没有确定性答案,硬写规则只会得到一个脆弱的 if-else 迷宫------交给模型,它读得懂问题结构; 确定性问题("最多并发几路?超时几秒?失败怎么办?")不需要也不应该让模型发挥------交给代码,它的行为可以预测、可以测试、可以审计。
这套切法有个更深的好处:职责切干净,各自可独立演进。想换更强的规划模型?只动规划段,扇出与隔离的代码一行不改;想调并发策略?只动代码,提示词原封不动。模型和代码各自迭代互不牵连------这在生产系统里是生存能力,不只是代码洁癖。
还有一个容易忽视的架构事实:这套实现里的子 Agent 是无自主工人 ------它们不商量、不投票、不自主改派任务,只完成领到的单一子任务。多智能体 literature 里有大量"Agent 间对话协商"的复杂拓扑,但对于"并行研究"这个场景,编排脑 + 无自主工人是最经济也最可控的形态:分派是代码的,探索是模型的,谁也不抢谁的活。
8. 与生产系统对比:骨架惊人地一致
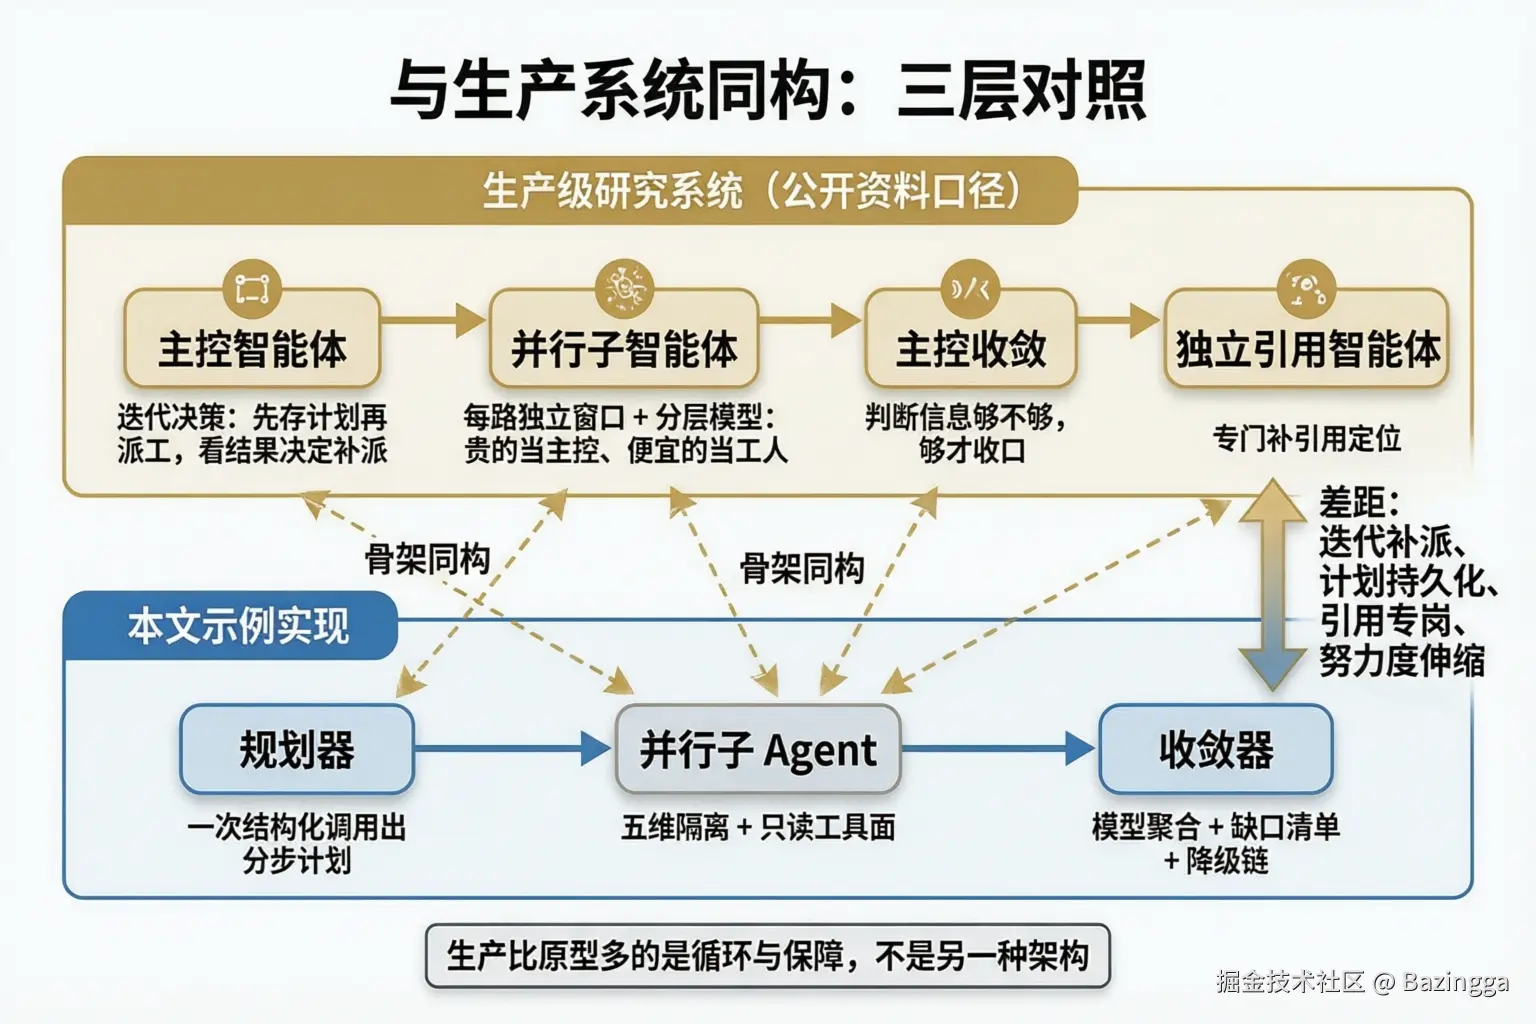
这套示例实现的思路,和 Anthropic 2025 年公开的 Claude 多智能体研究系统(Research 功能)有多少共性?把两边并排放:
| 骨架件 | Anthropic 生产系统 | 示例实现 |
|---|---|---|
| 拓扑 | orchestrator-workers:LeadResearcher 主控 + 并行 subagents | 规划器 + 并行 spawn 子 Agent + 收敛器 |
| 并行窗口 | 每个 subagent 独立上下文窗口,探索过程自我消化 | 每路子 Agent 独立会话 + 一次性记忆空间 |
| 探索后上交结论 | subagent 把探索蒸馏成要点返回主控 | 子 Agent 只回传文本结论,过程帧全部丢弃 |
| 任务委托要素 | 目标 + 输出格式 + 工具指引 + 任务边界 | 子任务提示词:单一任务 + 500 字内 + 检索不到明说 |
| 收敛聚合 | LeadResearcher 综合多路发现,再交 CitationAgent 补引用 | 收敛器合成 answer + gaps,冲突注明分歧 |
| 防失控 | 提示词嵌套努力度规则(简单题 1 个 agent,复杂题 10+) | 步数钳制 2~10 默认 5 + 单步超时切断 |
六行对照,骨架完全同构。这不是巧合------orchestrator-workers 是这类"并行研究"问题的收敛解:只要问题的本质是"多方向独立探索后合并",这个拓扑就是自然形态,生产系统和个人项目在这里没有本质分歧。
更提气的是 Anthropic 公开的两个数字:他们的多智能体系统(Opus 主控 + Sonnet 子 Agent)在内部研究评测上比单 Agent Opus 高出 90.2% ;并且在 BrowseComp 评测的分析里,单是 token 用量一项就解释了 80% 的性能方差。第二个数字特别值得咀嚼------多智能体系统有效的核心机制就是"花更多的 token、花在更干净的窗口里"。示例实现里"子 Agent 独立窗口 + 结论上交 + 每步截断"那一整套设计,全都是在伺候这同一个机理。
9. 与生产系统对比:差距清单,缺件缺在哪
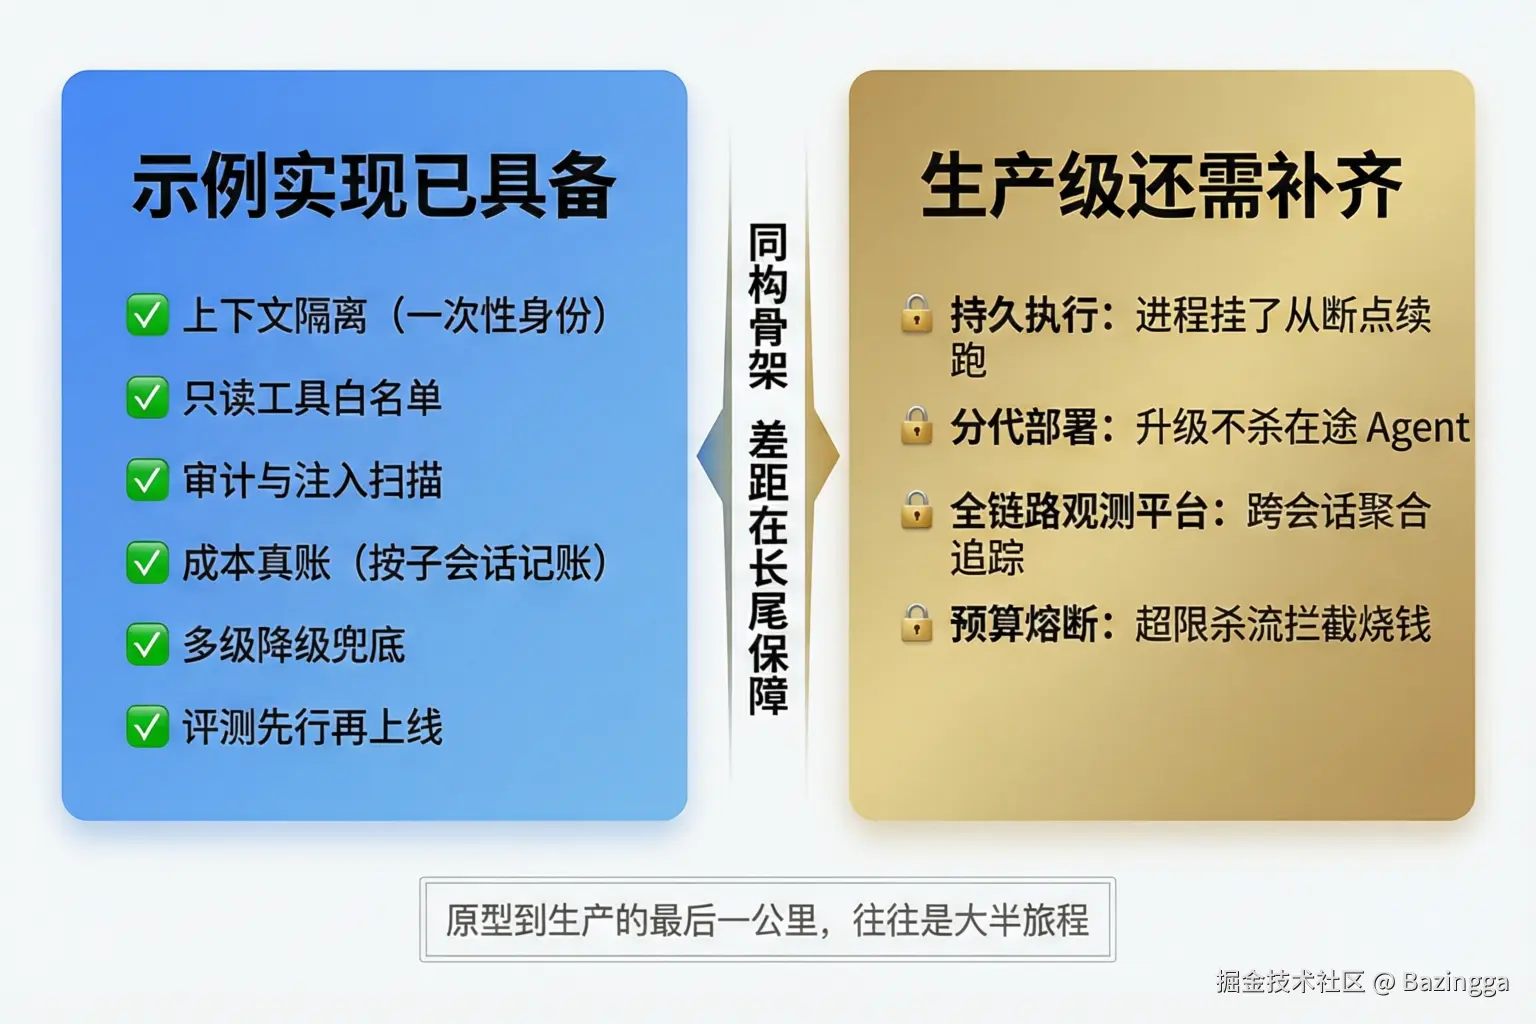
骨架一致,不代表可以直接上生产。把示例实现和生产系统放在"生产就绪"的标尺下量,缺的件集中在四套保障体系上。
差距一:一次性扇出 vs 迭代补派 。示例实现的执行是"一次拆完就跑":规划器出 3 步,3 路并行,跑完收敛,结束。生产系统是循环 :主控拿到各路结论后评估"信息够不够",不够就补派新的子 Agent ------研究方向是随着发现动态生长的。这正是 Anthropic 强调的"研究工作本质是 path-dependent(路径依赖)"的应对之道。示例实现的收敛器只能输出 gaps(缺口报告)却没有下一步动作------缺口报告给用户看了,没回流给编排。把 gaps 接回规划器触发第二轮补派,是这个骨架升级成循环的最短路径。
差距二:内存执行 vs 持久执行 。示例实现的计划放在内存里,进程一重启全部丢失;子 Agent 跑到一半服务发布,这批请求整体失败。生产系统把计划持久化(Anthropic 的做法是把计划存进 Memory------他们的 LeadResearcher 上下文超过 20 万 token 会被截断,计划必须先落盘再干活),并且用持久执行框架(LangGraph 的 checkpointer、Temporal 的工作流)保证"跑到第几步、每步什么状态"随时可查、可恢复、可重放。示例实现对应的能力是零。
差距三:单模型通吃 vs 模型分层 。示例实现里规划器、子 Agent、收敛器用的是同一个模型槽位------能跑,但浪费:拆任务和写简报是"参谋"活,适合强模型;按既定子任务检索翻页是"侦察兵"活,便宜模型完全胜任。生产系统的标准做法是分层:Anthropic 用 Opus 当主控、Sonnet 当子 Agent------钱花在刀刃(决策)上,刀背(执行)用平价件。这套代价结构差异在规模化后是数量级的。
差距四:无观测无预算 vs 全链可观测 + 预算熔断。四套保障里最后两套:
- 可观测:生产系统对每次委派有完整 trace(哪个子 Agent、调了什么工具、花了多少 token、哪步失败);示例实现只记了各步耗时和成败状态,子 Agent 内部的探索轨迹是黑盒;
- 评估与预算:生产系统有评测集持续回归(改动前后对比回答质量),有 token 预算熔断(防止一次请求烧穿配额------多智能体天然是 token 放大器,没有熔断等于油门焊死)。Anthropic 甚至提到他们专门建了工具测试 Agent 来迭代工具描述,未来 Agent 使用新工具的任务完成时间降了 40%。示例实现两者皆无。
还有一套工程外围------分代部署(Rainbow Deployment:新旧版本并存逐步切流,长任务在旧版本里自然跑完)------属于部署基础设施,个人工程基本不碰,但值得知道它解决的是"我的多智能体任务要跑十分钟,这十分钟里服务刚好发布"这类真实矛盾。
把差距清单压成一张表:
| 能力 | 示例实现 | 生产系统 |
|---|---|---|
| 执行模式 | 一次扇出,跑完即收 | 循环研究,按需补派 |
| 计划状态 | 内存态,重启即失 | 持久化,可恢复可重放 |
| 模型策略 | 单槽位通吃 | 决策/执行分层选模 |
| 过程可观测 | 步级状态 + 耗时 | 全链 trace + 决策模式审计 |
| 质量保障 | 解析重试 + 降级链 | 评测集回归 + token 预算熔断 |
| 部署形态 | 单实例原地重启 | 分代部署平滑切流 |
但请注意读法:这张表不是"示例实现不及格",而是"骨架已对,缺的全是生产外围件" 。第 8 节的六行骨架同构意味着:把差距清单上的件一件件补到这个骨架上,方向是对的、不用推倒重来。反过来说,如果一开始就奔着生产件去搭系统(先上持久化、先上分代部署),骨架没想清楚,外围件只会把错误的设计焊得更死。先让最小骨架跑通正确的拓扑,再按真实痛点逐件补生产能力------这个顺序本身就是多智能体工程的方法论。
10. 预判疑惑
Q1:多路子 Agent 会互相干扰吗? 不会,因为第 5 节的五维隔离让它们在物理上碰不到彼此:独立会话身份、独立记忆空间、独立上下文、独立浏览器实例、用完即焚的生命周期。需要警惕的反而是"隔离不彻底的干扰"------比如两路共享一个浏览器,页面互相顶掉,这种干扰是静默数据污染:不报错、不抛异常,答案悄悄变错。隔离维度的预算不能省,省出来的都是排查成本。
Q2:拆错了怎么办?规划器把不该拆的拆了? 三层兜底:步数钳制防跑飞(最多 5 步);单步失败不炸整体(记 failed、收敛器如实说明);收敛器的 gaps 把覆盖不了的部分明示出来。最坏情况的退化路径也保证可用:规划两次失败 → 降级单步直答。多智能体系统里"优雅降级到单智能体"永远比"多智能体硬撑"更优先。
Q3:成本不是翻倍了吗? 是------并行扇出天然是 token 放大器,N 路子 Agent 至少是 N 倍的执行开销,再加规划和收敛两次调用。这笔账有两个平衡项:一是并行省下的串行上下文滚雪球(第 1 节的"贵"),长链路任务里省的未必比放大的少;二是 Anthropic 的实测结论------token 花得对,性能回报是 90% 级别的。真正的问题不是"贵不贵"而是"值不值",判据回到第 2 节的三判据天平。
Q4:为什么不直接用现成的多智能体框架? 可以先掂量一下:这个示例的核心编排(扇出 + 隔离 + 汇合 + 收敛)总共不到百行 Reactor 代码------orchestrator-workers 拓扑本身不复杂,复杂的是外围生产件。现成框架的价值恰好在第 9 节的差距清单里:持久化、重试、trace、预算管控。所以答案是:拓扑自己写(可控、可学、可调试),生产件要么买框架要么逐件补------先想清楚自己缺的是哪个,再决定引不引。
结语
三句话压缩全文:
- 拆分买的是更小的上下文------子 Agent 各自消化探索过程,只上交结论,值得与否看三判据(独立、多源、超窗);
- 隔离是并行的准入证------身份、记忆、工具面、浏览器、生命周期五个维度一道不能省,省哪道哪道出静默事故;
- 骨架同构生产,外围决定生死------orchestrator-workers 的拓扑和生产系统完全一致,差的四套保障(循环补派、持久执行、模型分层、可观测与预算)才是生产化的真功课。