Claude Code 和 Codex 都有一个 effort 档位,从 low 到 xhigh 甚至 max。常听到的用法是:觉得模型回得慢,就把 effort 调高一档,好像这样它会更卖力、更快做完。两家的官方文档说的是相反的事。Codex 文档的原话是「Higher reasoning effort can improve results for complex tasks, but it takes longer and uses more tokens.」Anthropic 的文档则写「low effort can significantly reduce response times and costs」。
本文先讲 effort 到底控制什么,再讲为什么多想一定意味着多等,然后给出我在本机用 Claude Code 2.1.304(Opus 5.5)和 Codex CLI 0.162.1(GPT-6.1 Sol)做的 16 次计时,接着整理想提速时真正该调的几个开关,最后按 low 到 max 逐档说明各自适合什么任务。
effort 不是油门,是额度。它决定模型这一轮愿意花多少输出 token 去想、去写、去调工具,不改变每个 token 生成得多快。慢的时候调高 effort,最好的结果是没有变化,更常见的结果是更慢、更贵。调高 effort 的理由只有一个:结果质量不够。
effort 控制的是输出 token 数量
Anthropic 对 effort 参数的定义是:「The effort parameter lets you control how many tokens Claude spends when responding to requests.」它影响整个回复里的所有输出 token,包括思考、正文和工具调用。档位低时,模型会把操作合并成更少的工具调用、少写开场白;档位高时,会多调工具、先讲计划、写更详细的总结。
OpenAI 对 reasoning.effort 的说法是「guides the model on how much to think when performing a task」,并直接写了取舍方向:「Lower effort favors speed and lower token usage, while at higher effort the model thinks more completely to provide higher quality responses.」
两家都没有给 effort 赋予「更快」的含义。档位越高,模型被允许、也被鼓励花更多 token。
思考 token 也要一个个生成,也按输出计费
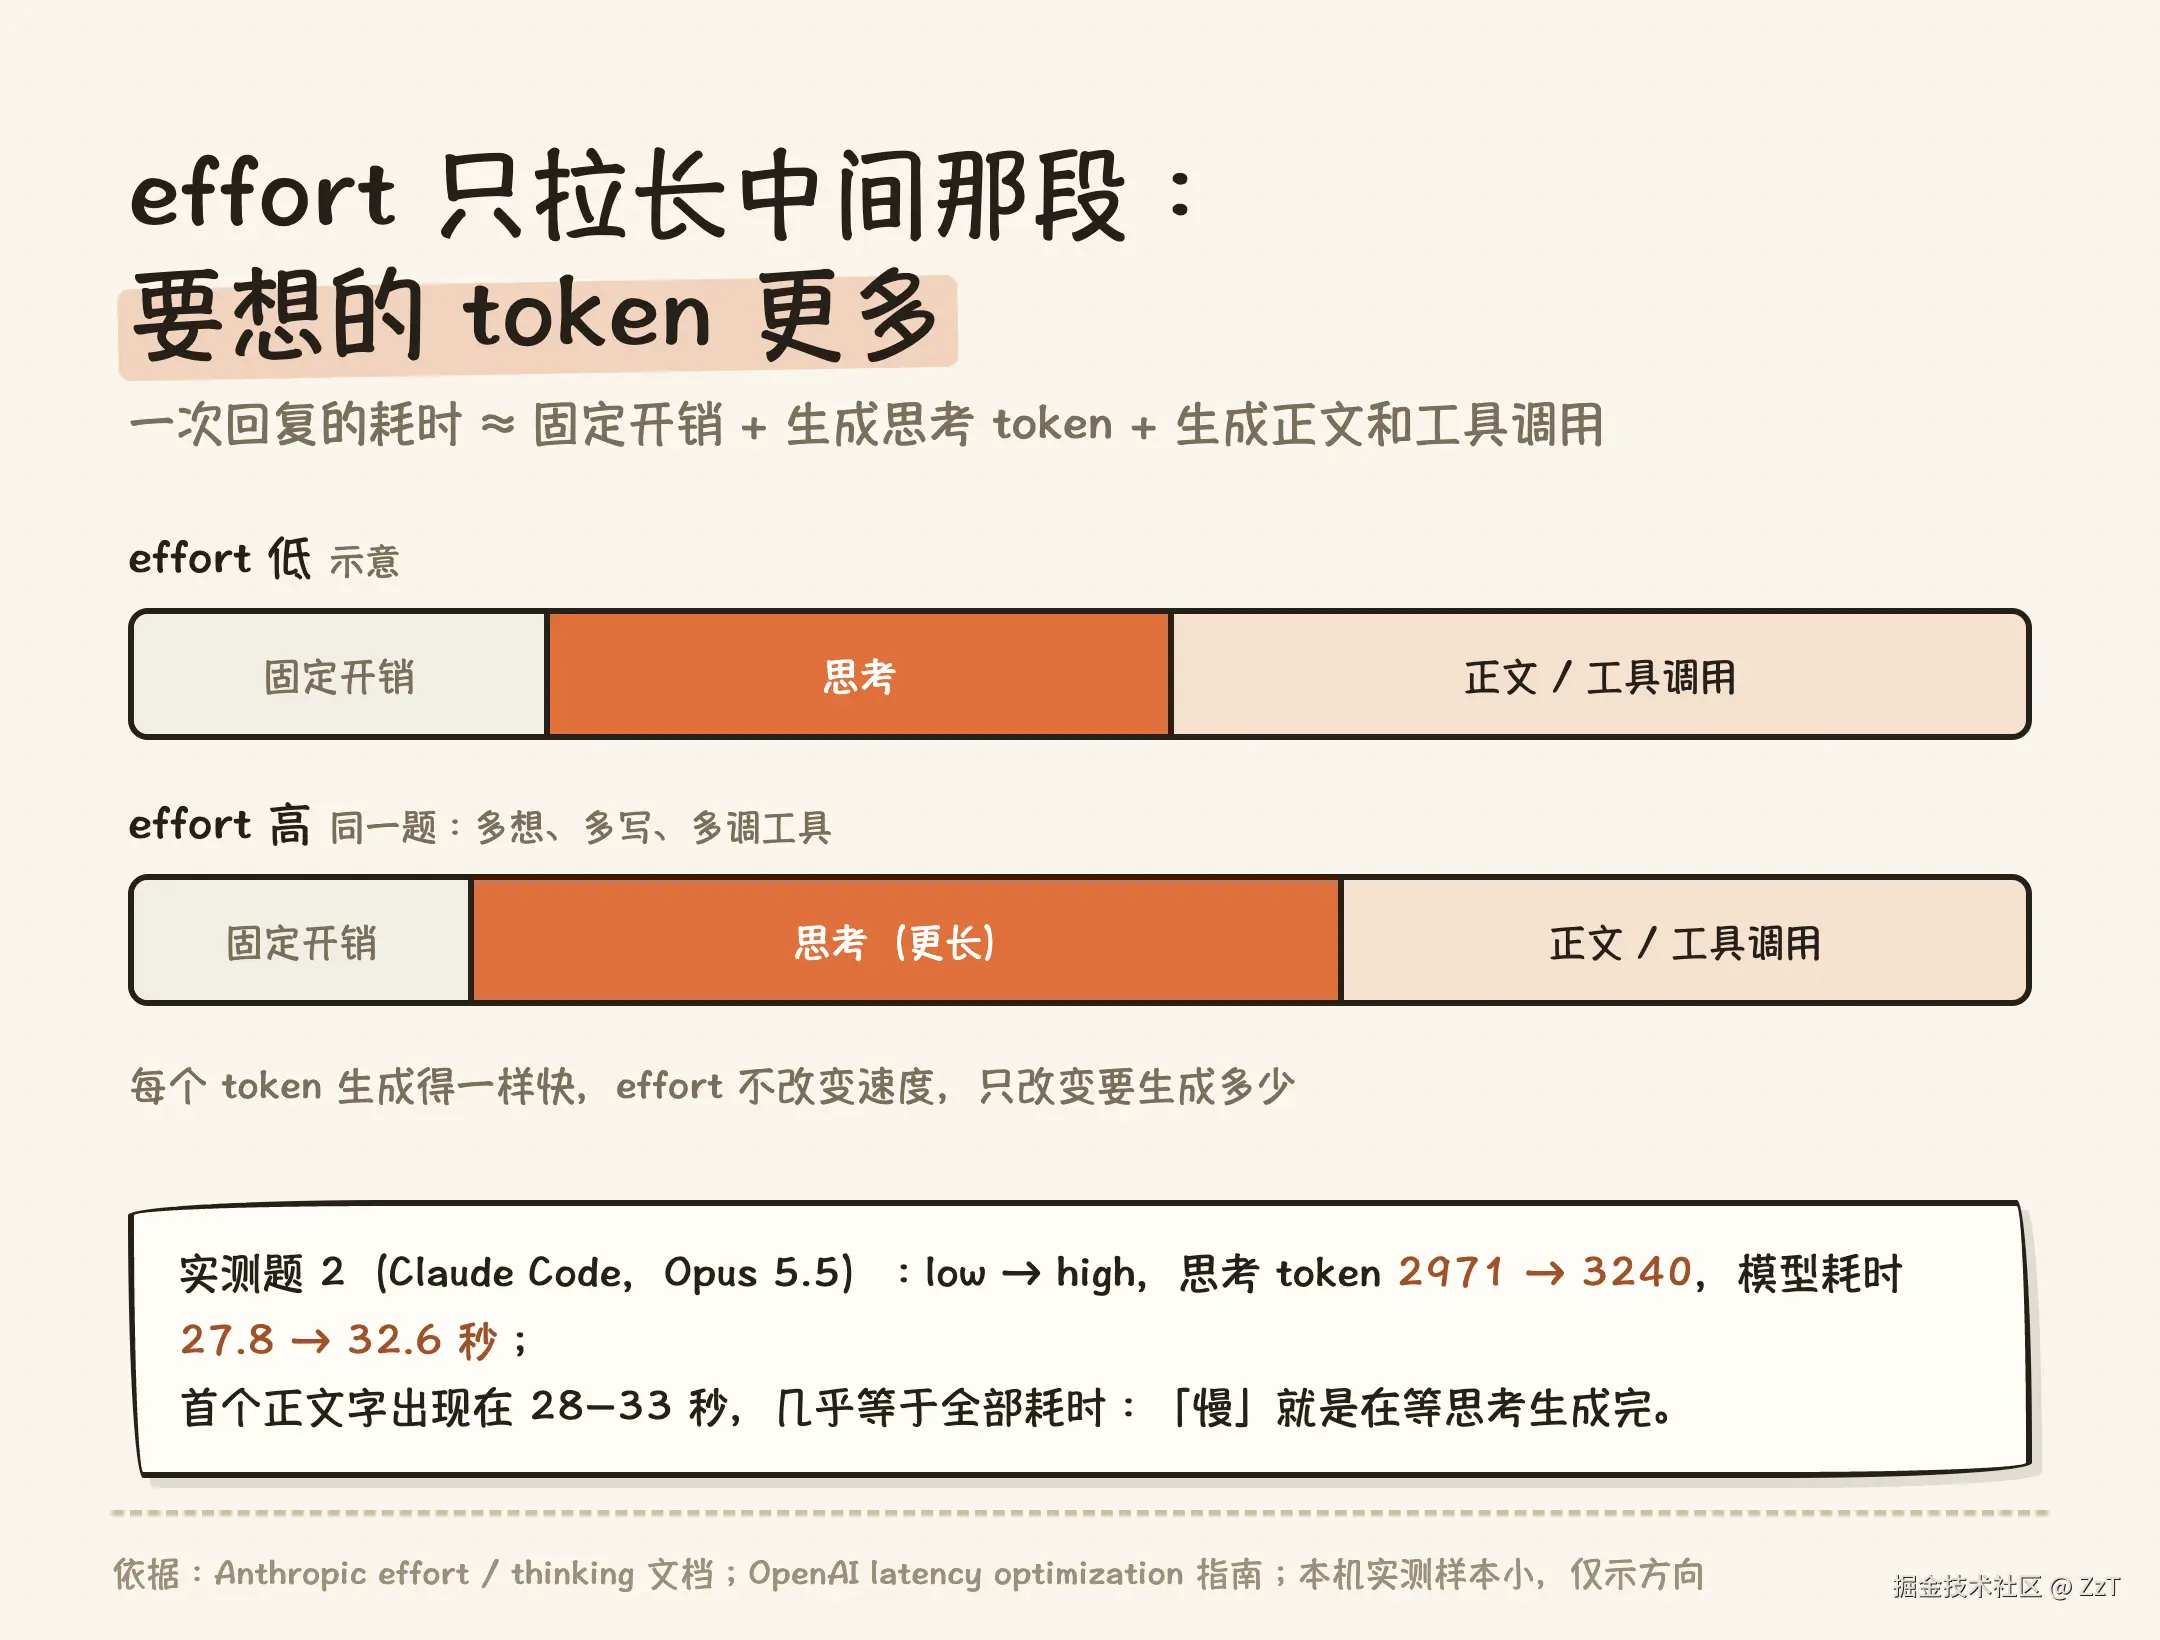
一次回复的耗时,可以粗略拆成三段:
- 固定开销:客户端启动、加载系统提示和工具定义、连接 MCP 等,和 effort 无关。
- 思考:模型先生成思考 token,生成完才开始写正文。
- 正文和工具调用:真正给你看的输出。
effort 只影响后两段的长度。OpenAI 的延迟优化指南写得很直接:「Generating tokens is almost always the highest latency step when using an LLM」,输出 token 减半,延迟大约也减半。思考 token 的生成方式和正文一样,逐个生成,所以多想 3000 个 token,就要多等生成 3000 个 token 的时间。
钱也一样。Anthropic 写明思考 token「are billed as output tokens, even when the thinking text isn't returned to you」;OpenAI 也说推理 token 在 API 里看不到,但「are billed as output tokens」。界面上只看到一行摘要,账单按完整的思考量算。
16 次本地计时:调高没有变快
我用两道题在空目录里各跑了几轮,记录总耗时、思考 token 和对错。题 1 是一个 30 行 Python 函数里的差一错误(off-by-one),题 2 是「1 到 10000 中各位数字和为 23、且能被 7 整除的数有几个」,不允许用工具。
| 题 | 工具 | effort | 总耗时 | 思考 token | 答对 |
|---|---|---|---|---|---|
| 题 1(每档 2 次) | Codex | low / medium / high | 33--40 / 39--47 / 40--43 秒 | 全部 0 | 全对 |
| 题 1(每档 2 次) | Claude Code | low / medium / high | 9--12 / 9--10 / 9--9.5 秒 | 25--30 / 31--70 / 22--31 | 全对 |
| 题 2 | Codex | low / high | 59.4 / 55.9 秒 | 1016 / 1034 | 全对 |
| 题 2 | Claude Code | low / high | 35.1 / 40.3 秒 | 2971 / 3240 | 全对 |
这组数据样本小(每格 1 到 2 次),没测 xhigh 和 max,也没测多轮 agent 任务,只能说明方向,不能当基准。能读出来的有三点。
第一,调高没有让任何一组变快。题 1 上各档耗时的差别在同档两次之间的波动范围内;题 2 上 Claude Code 从 low 到 high,思考 token 多了 9%,模型耗时从 27.8 秒涨到 32.6 秒,多了 17%。
第二,题 2 上 Claude Code 的首个正文 token 出现在 28 到 33 秒,几乎等于全部耗时。用户感受到的「慢」,就是在等思考 token 生成完。
第三,正确率也没有因为调高而变化。这两道题对 Opus 5.5 和 GPT-6.1 Sol 来说都不够难,low 已经全对。
简单任务上,慢的往往不是模型在想
题 1 上 Codex 每档的思考 token 都是 0,正文只有 31 个 token,但每次仍要 33 到 47 秒。这段时间花在启动客户端、发送约 2.6 万 token 的系统提示和工具定义、连接本机配置的 MCP 服务上。Claude Code 同一题总耗时约 9 秒,其中模型本身只用了 3 到 7 秒,其余是 CLI 启动。
这时候调 effort 毫无作用,因为模型几乎没在想。该查的是固定开销:MCP 服务连不上时会拖慢启动,系统提示和工具定义越多,每轮要发送的输入越大。
effort 只给方向,想多少主要看题目
Anthropic 的文档写得很明确:「Effort is a behavioral signal, not a strict token budget.」也就是说,effort 只告诉模型大致该花多少力气,并不规定它最多能用多少 token。低档位遇到足够难的问题,模型仍然会思考,只是比高档位想得少;高档位遇到简单问题,也可能根本不思考。每个档位都由模型按请求自己决定要不要想、想多少。
实测题 2 上,Codex 的 low 和 high 推理 token 分别是 1016 和 1034,基本一样:推理量的大头由题目决定,档位只是在这个基础上往上或往下推一点。想限制一次最多花多少 token,应该用 max_tokens(Anthropic)或 max_output_tokens(OpenAI),不是 effort。
还有一个容易被忽略的代价:Anthropic 文档提到,effort 的值会写进 prompt,请求之间改档位会让 prompt 缓存失效。长对话里来回切 effort,会多付一次缓存写入,首个 token 也会来得更晚。
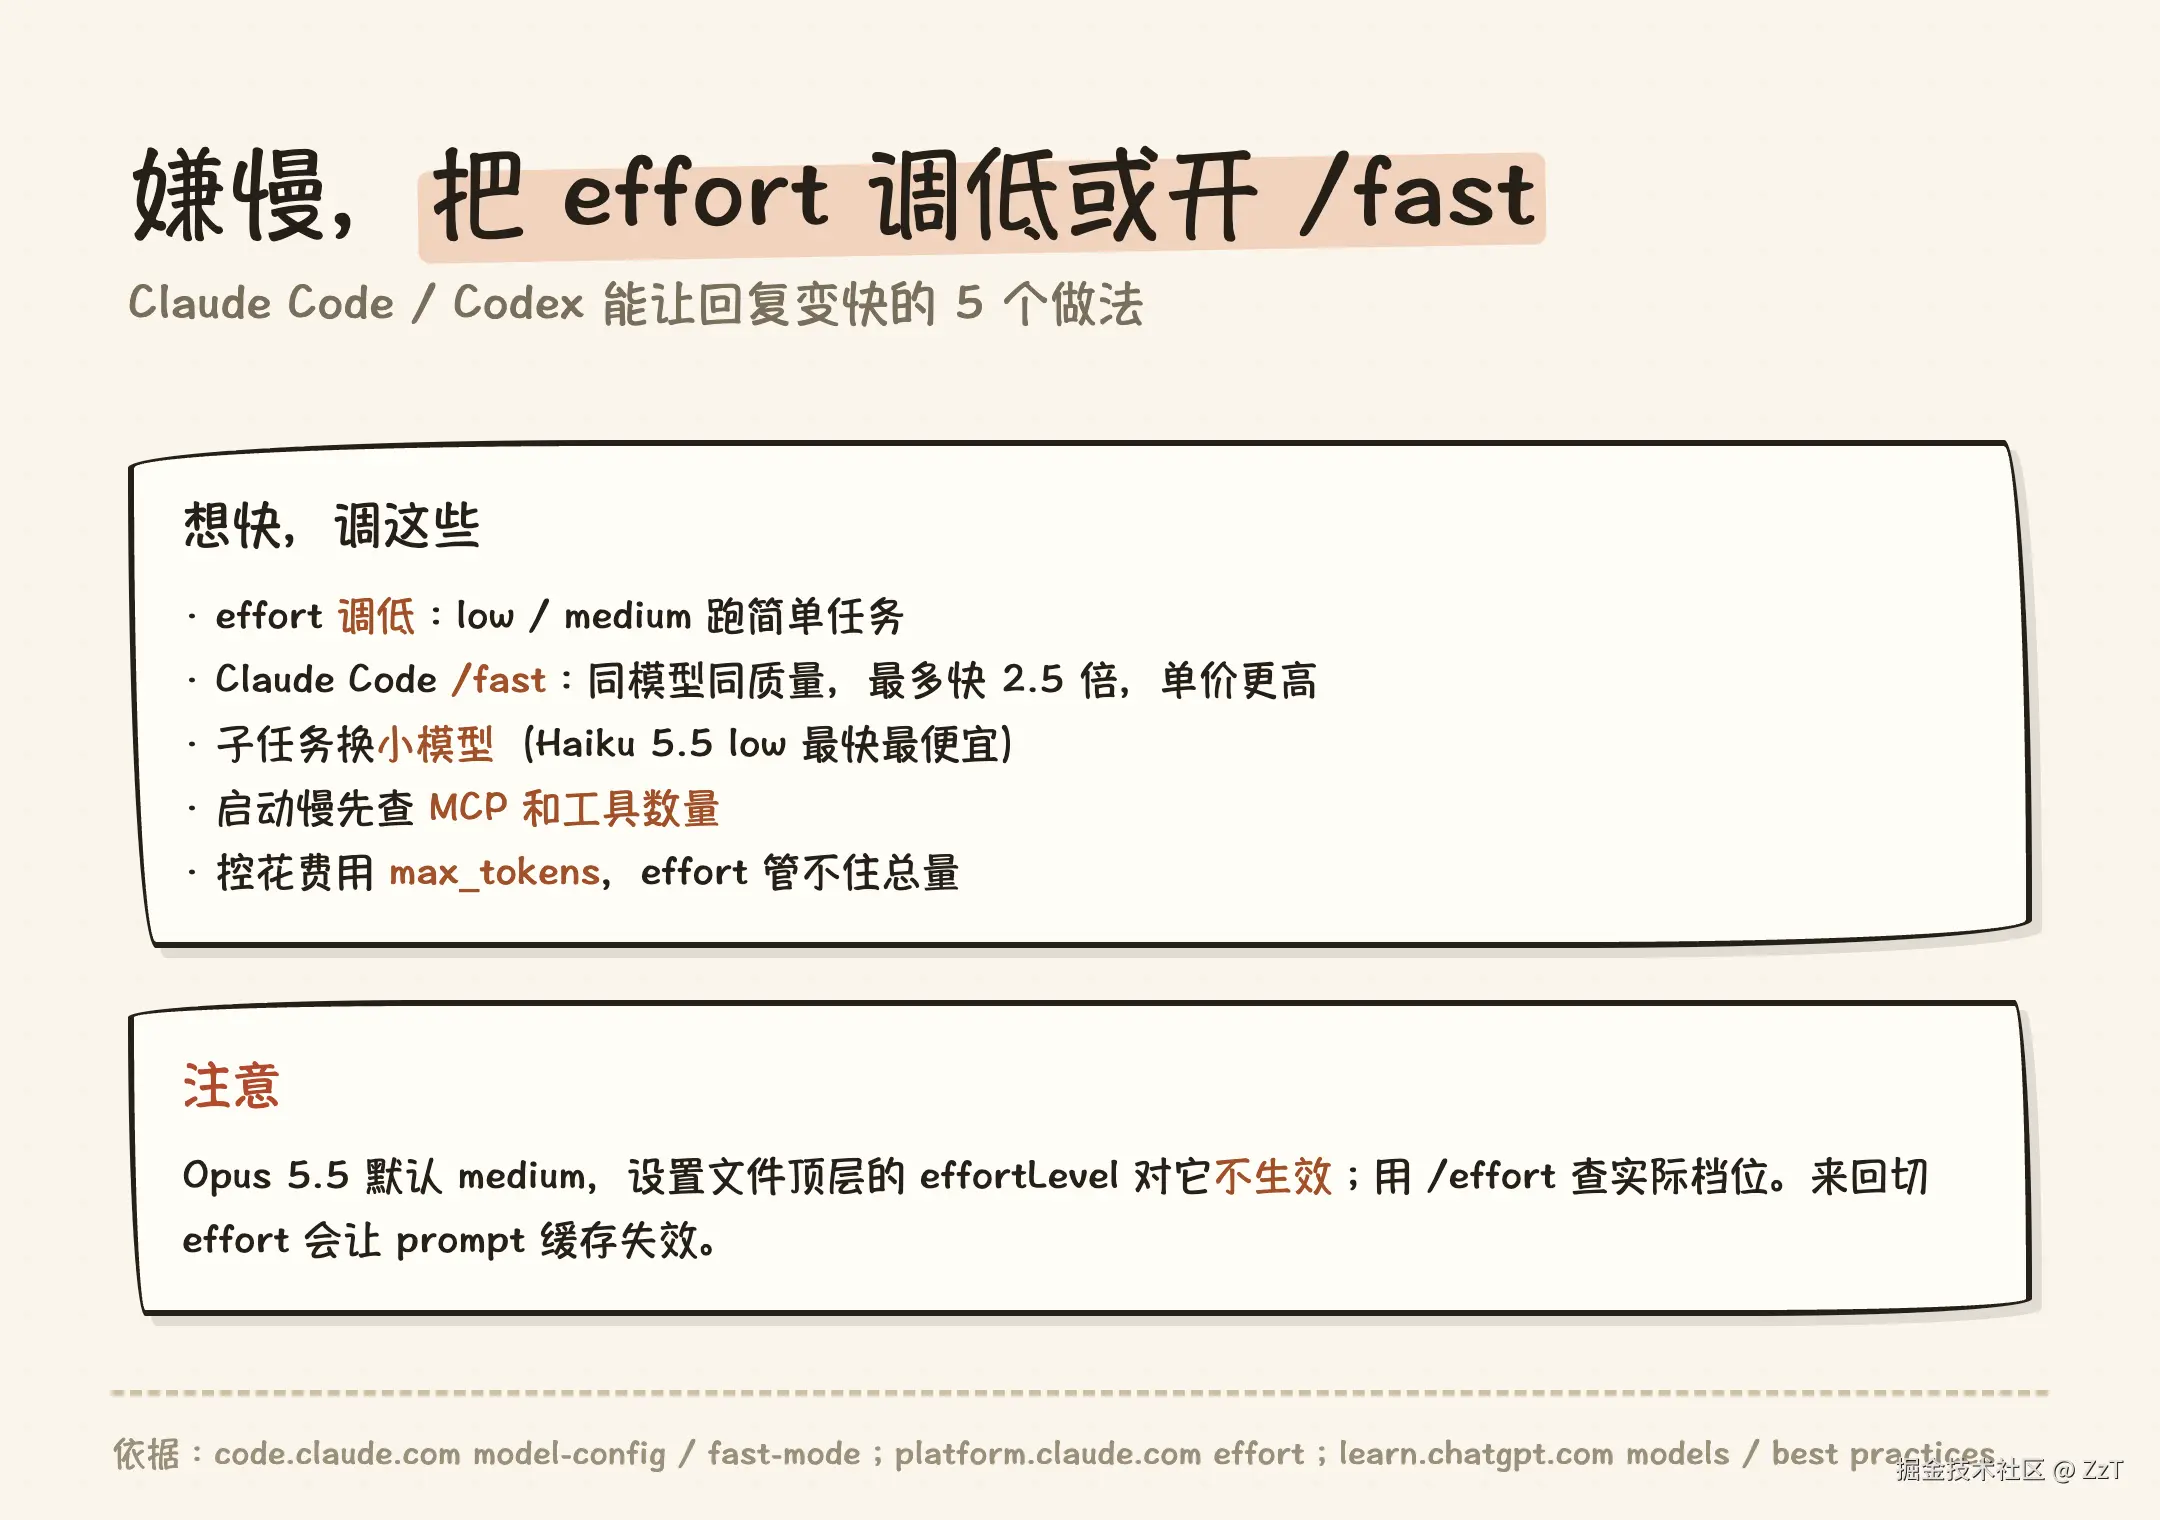
想快,该调这几个开关
| 想要 | 做法 | 依据 |
|---|---|---|
| 简单任务更快、更省 | 调低 effort(low / medium) | Anthropic:low 适合「Simpler tasks that need the best speed and lowest costs, such as subagents」;Codex:「Low for faster, well-scoped tasks」 |
| 同样的质量更快 | Claude Code 开 /fast |
官方:Opus 最多快 2.5 倍,同模型同质量,单价更高;可以和低 effort 一起用 |
| 便宜又快的子任务 | 换小模型 | Claude 的 Haiku 5.5,官方称 low 是「the cheapest and fastest level」 |
| 启动就慢 | 检查 MCP 服务和工具数量 | 实测:思考 0 token 时,Codex 每次仍要 30 秒以上 |
| 防止一次花太多 | 设 max_tokens / max_output_tokens |
effort 管不住总量 |
在 Claude Code 里设 effort 有四种方式:会话里用 /effort,启动时加 --effort,环境变量 CLAUDE_CODE_EFFORT_LEVEL,或在设置文件里写 effortLevel。前三种优先于设置文件。要注意,Opus 5.5 默认是 medium,而且官方说明用户设置里顶层的 effortLevel 对 Opus 5.5 不生效。我本机的设置文件就写着 "effortLevel": "xhigh",实际跑的仍是 medium。想确认自己用的是哪档,在会话里直接运行 /effort 查看,比读配置文件可靠。
Codex 里在交互界面用 /model 选档位,配置文件里是 model_reasoning_effort。界面上的名字(Light、Extra High)和配置里的值(low、xhigh)不一致,查文档时容易对不上。
low 到 max 五个档位分别适合什么任务
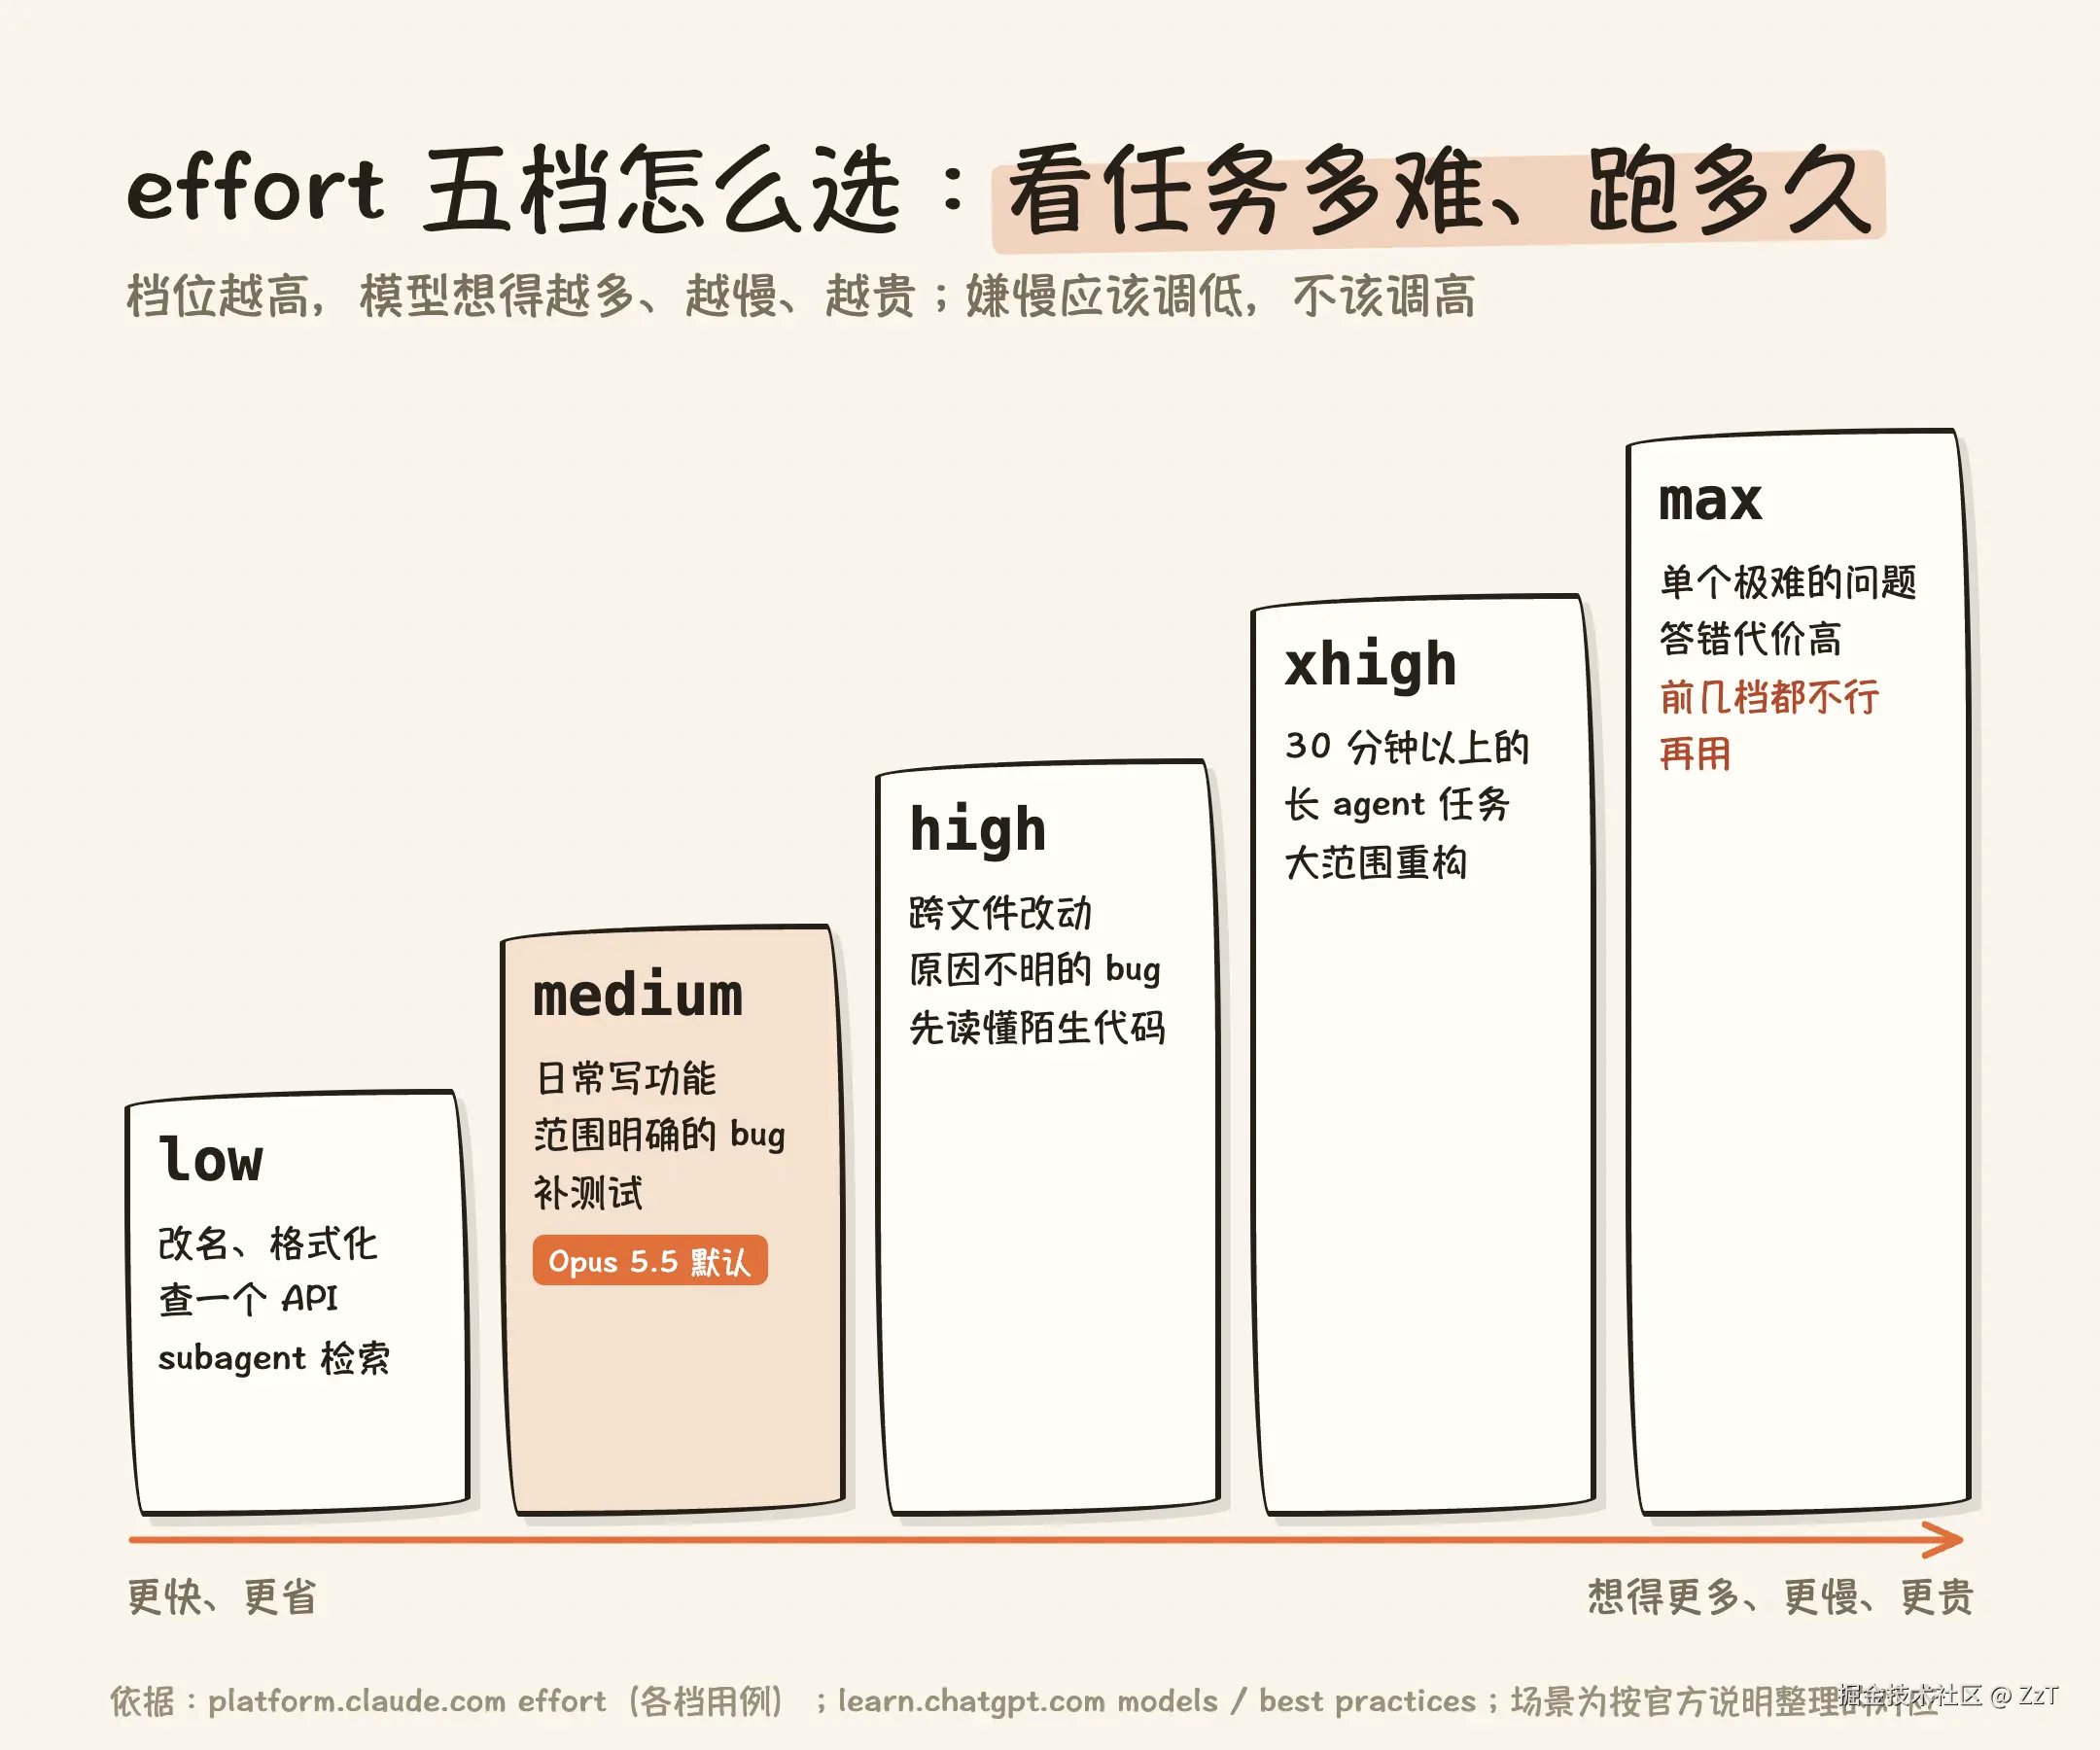
两家的档位基本一一对应:Codex 界面上的 Light 就是配置里的 low,Extra High 就是 xhigh。下表中间一列是官方对每档用途的说明,右列是我按这些说明和前面的实测给出的日常对应场景。
| 档位 | 官方说明 | 适合的场景 |
|---|---|---|
| low | Anthropic:「Simpler tasks that need the best speed and lowest costs, such as subagents」;Codex:Light 适合「quick, well-scoped tasks」 | 改名、补类型标注、格式化、查一个 API 的用法、批量做同一类小改动,以及派给 subagent 的检索和汇总 |
| medium | Anthropic:「Agentic tasks that require a balance of speed, cost, and performance」;Codex:Medium「balances speed and depth for tasks that need more planning」 | 日常写功能、修范围明确的 bug、补测试。Opus 5.5 在 Claude Code 里默认就是这一档 |
| high | Anthropic 用例:「Complex reasoning, difficult coding problems, agentic tasks」;Codex:「Medium or High for more complex changes or debugging」 | 跨多个文件的改动、原因不明的 bug、要先读懂一大块陌生代码才能动手的任务 |
| xhigh | Anthropic:「Long-running agentic and coding tasks (over 30 minutes) with token budgets in the millions」;Codex:「Extra High for long, agentic, reasoning-heavy tasks」 | 让 agent 连续跑半小时以上的任务:大范围重构、从零搭一个模块、按一份长 spec 实现整套功能 |
| max | Anthropic:「Absolute maximum capability with no constraints on token spending」;Codex 文档称 Max 让模型在单个任务上有更多推理时间 | 单个很难、答错代价高的问题,例如并发 bug、算法正确性,且 high 和 xhigh 都试过仍解决不了 |
前面的实测可以对上这张表:一个函数里的差一错误属于 low 那一行,low 和 high 一样全对,耗时也一样,开高只是多花钱。
选档时还有三点要注意。
第一,不是每个模型都有全部五档。Claude Code 里 Opus 4.6 和 Sonnet 4.6 没有 xhigh,设成 xhigh 会按 high 运行。max 不能写进设置文件,要用的话在启动时加 --effort max,只对这一次会话生效。
第二,max 要慎用。Anthropic 对 Opus 4.7 的说明是:多数任务上 max「adds significant cost for relatively small quality gains」,在结构化输出这类任务上还可能想过头。
第三,低档下推理明显偏浅、结果出错时,直接调高一档,不要靠在 prompt 里写「认真想」来弥补。在 Claude Code 里只有 ultrathink 是会被识别的关键词,只作用于当前这一轮,写「think hard」不起作用。
调高的理由始终是质量不够,而不是速度不够。先用低档位跑,结果不够好再往上加一档,这个顺序比反过来省时间也省钱。