在实时湖仓中,Apache Paimon 负责管理持续变化的湖上数据,StarRocks 则通过 Paimon Catalog 提供报表、交互式分析和跨源关联。数据保存在湖上,用户用熟悉的 SQL 就能完成查询。
当数据量和查询并发增长,用户会关心几个实际问题:持续变化的主键表能否查得更快?宽表聚合能否减少等待?查询变慢时,能否看清时间和内存花在哪里?
接入 Paimon C++,让 StarRocks 能够通过原生执行路径处理更多 Paimon 查询,在保持湖表语义的同时,减少跨语言交互开销,并更好地复用缓存、内存管理和查询分析能力。
一、Paimon C++ 是什么,为什么要引入它
让 C++ 引擎直接理解 Paimon 表
Paimon C++,也称 paimon-cpp,是 Apache Paimon 的 C++ 实现,为原生计算引擎提供访问 Paimon 表的能力。对 StarRocks 用户而言,它是查询引擎内部的一个组件,不需要单独部署服务,也不改变已有的 SQL 查询方式。
Paimon 表的读取,既要理解文件格式,也要理解表的规则。
例如,一笔订单先后经历"待支付""已支付""已完成"几个状态,相关记录可能保存在不同的数据文件中。查询时,需要根据 Paimon 的合并规则还原应当看到的记录,并处理已删除数据。单独读出每个 Parquet 或 ORC 文件,还不足以完成这类查询。
StarRocks 已有的文件 Reader 擅长直接读取 Parquet、ORC 数据。对于需要处理主键合并等表格式语义的任务,过去通常需要通过 JNI 调用 Paimon Java SDK。Paimon C++ 为这些任务提供了原生读取路径。
C++ 引擎的优势
更低的读取开销。 StarRocks 的执行引擎以 C++ 进行向量化计算。通过 Paimon C++ 读取数据,可以减少 Java 与 C++ 之间的调用和数据转换,让读取、合并与后续计算衔接得更紧密。短查询、宽表扫描和主键表合并,是值得重点评估的场景。
更多任务可以原生执行。 Paimon C++ 理解主键合并、删除向量等表格式语义,让原生读取覆盖到更多无法简单按文件直读的任务。用户仍然查询同一张 Paimon 表,由底层读取组件保证结果符合表的规则。
更统一的资源管理与观测。 原生接入可以复用 StarRocks 的 I/O 和数据缓存,减少重复访问远程存储。相关内存分配与读取指标也可以接入内存管理和 Query Profile,帮助用户判断瓶颈发生在数据读取、版本合并还是后续计算。
二、StarRocks 如何通过 Paimon C++ 查询湖上数据
一次查询的整体过程
从用户视角看,整条链路可以分为查询规划、并行读取和计算三个步骤。
用户提交 SQL 后,StarRocks FE 根据 Paimon 的表结构、快照和文件信息,确定需要读取的数据范围,并把任务分发给执行节点。执行节点通过 Paimon C++ 读取数据,处理所需的主键版本合并和删除信息,再交给 StarRocks 完成过滤、关联、聚合等计算,最终返回查询结果。 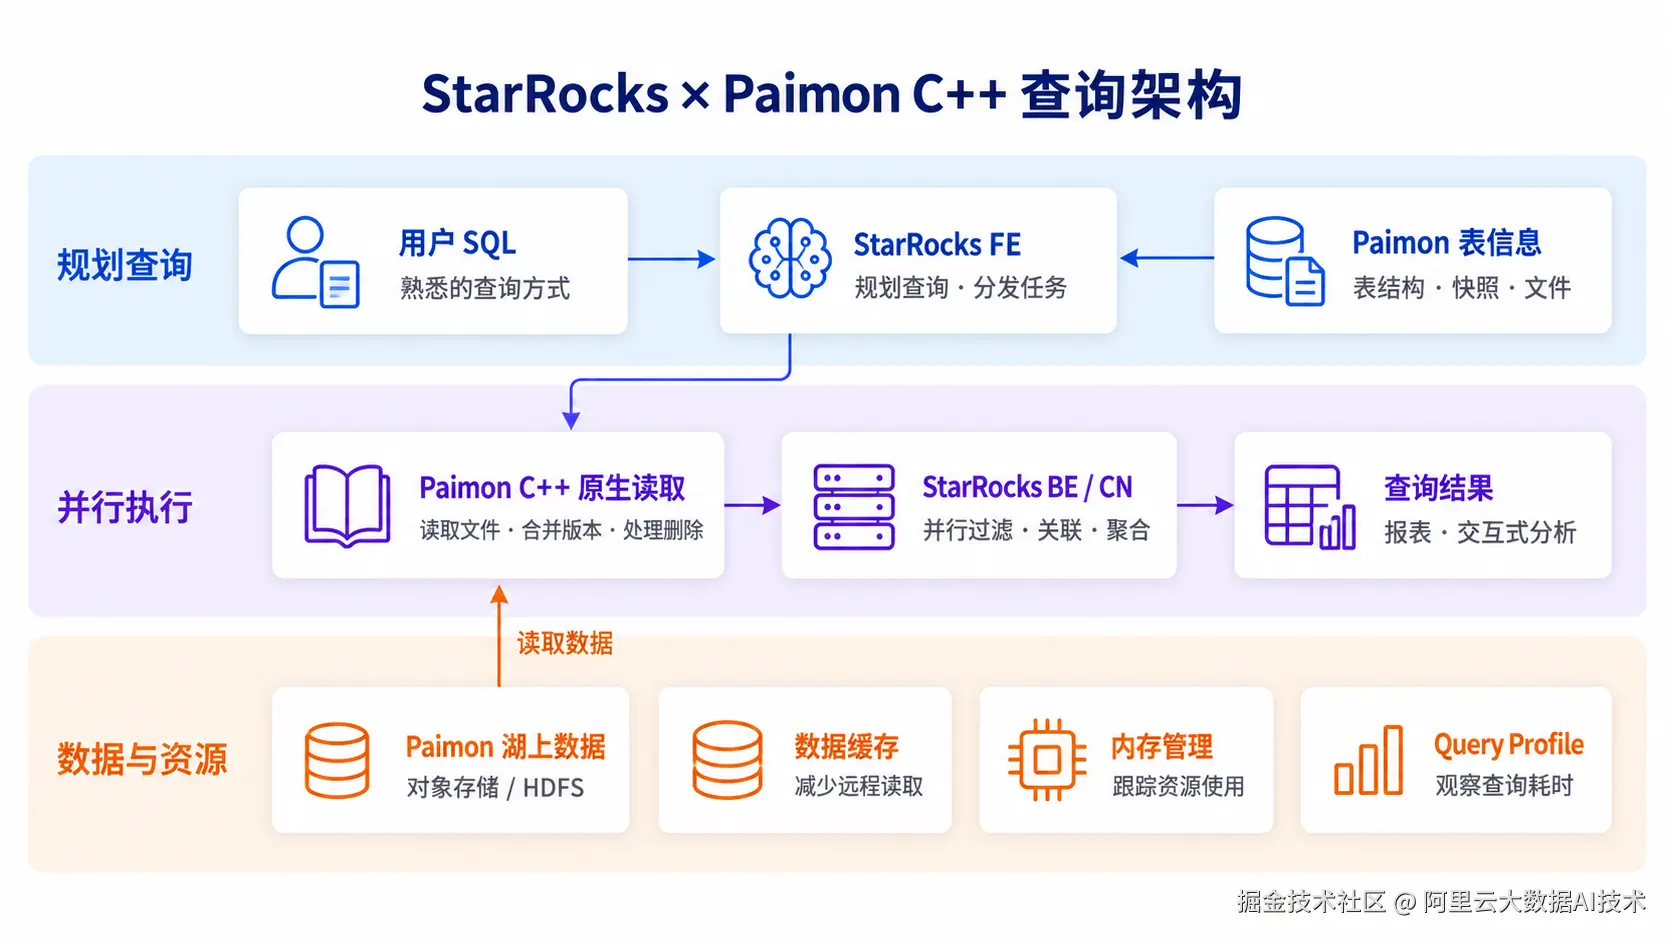 图 1:Paimon C++ 负责原生读取,StarRocks 负责查询规划与并行计算,数据仍保存在 Paimon 中。
在这条链路中,缓存帮助减少远程读取,内存管理负责跟踪资源使用,Query Profile 则让查询耗时更容易分析。这些能力围绕同一次查询发挥作用,用户可以沿用 StarRocks 的查询和调优习惯。
三种 Reader 分别负责什么
接入 Paimon C++ 后,StarRocks 可以使用三种 Reader。它们承担的任务有所不同。
StarRocks 文件 Reader:直接读取 Parquet、ORC。 当一项读取任务可以安全地转换为文件直读时,使用 StarRocks 自身的文件 Reader 即可。这类任务常见于追加表,也可能出现在已经满足直读条件的主键表中。因此,Reader 的选择不能只看表有没有主键。
Paimon C++ Reader:原生处理 Paimon 表语义。 对于需要在读取时合并多个版本等任务,Paimon C++ 能够根据 Paimon 的规则组织和读取数据。它也可以读取支持范围内的普通 Paimon 数据,价值在于把更多原本依赖 Java SDK 的工作放到原生执行路径中。
JNI Reader:通过 Paimon Java SDK 读取。 对于系统表等需要 Java 路径处理的特殊任务,仍可以使用 JNI Reader。用户也可以显式选择这条路径,用于兼容性排查和性能对照。
三种 Reader 如何选择
读取器的选择分两步:先看用户设置的读取模式,再看具体任务能由哪种 Reader 处理。 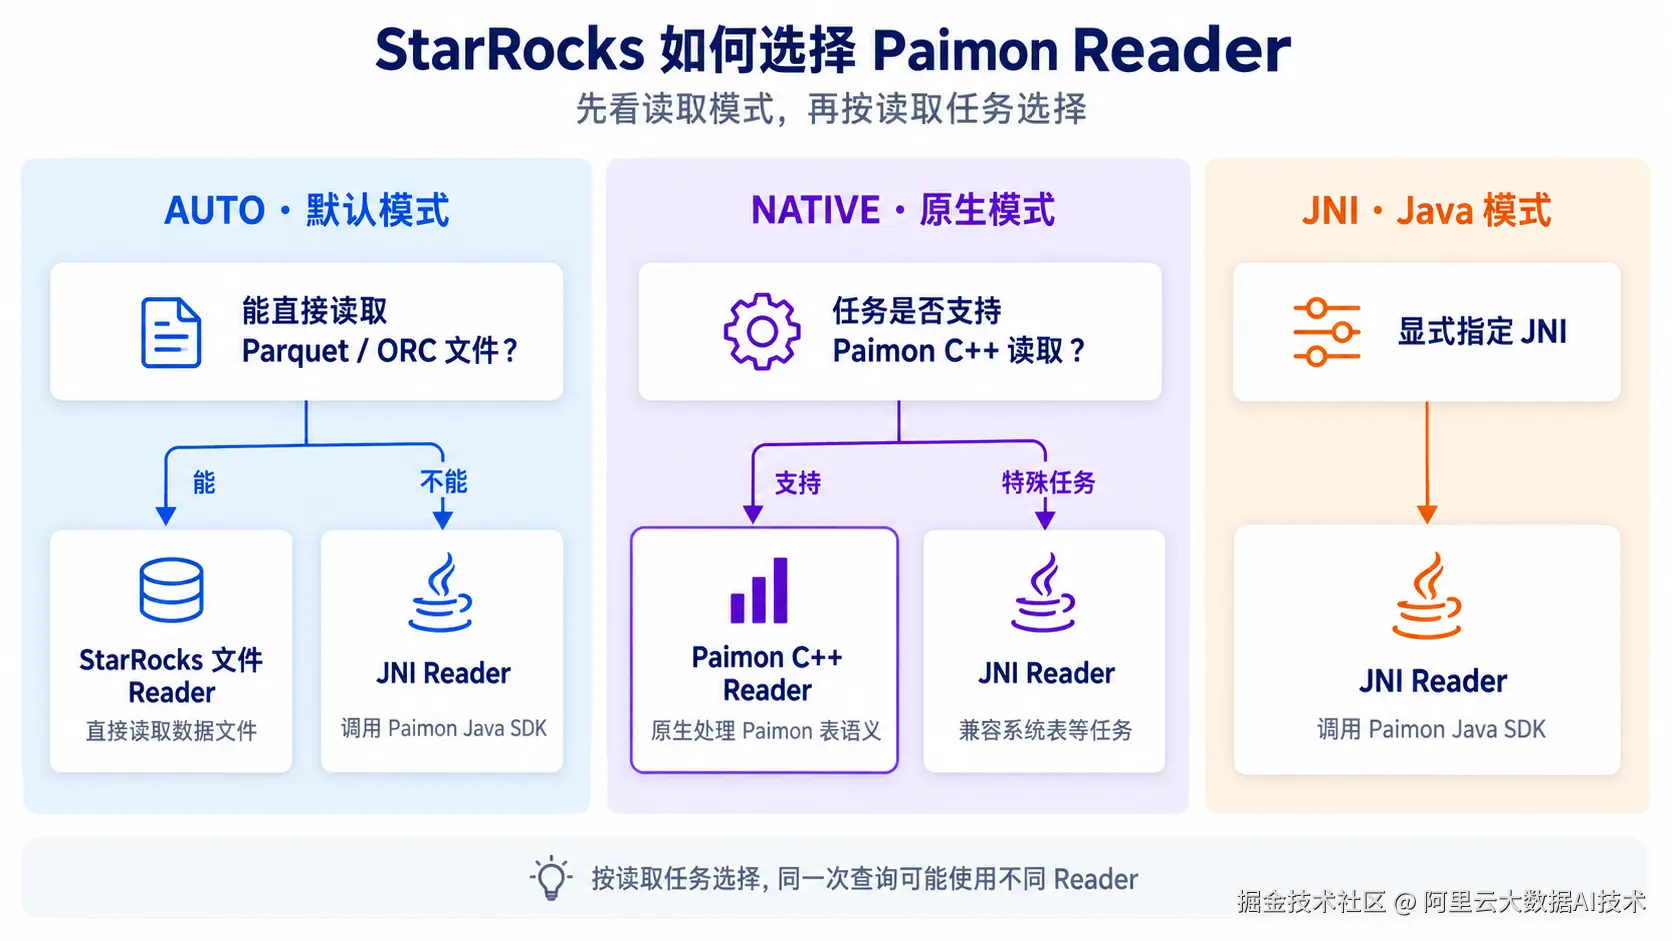 图 2:默认模式优先尝试文件直读,原生模式对支持的任务使用 Paimon C++,Java 模式指定 JNI。
在本文使用的 paimon_reader_mode 配置方式下:
-
AUTO 是默认模式。 对能够直接读取 Parquet、ORC 文件的任务,优先使用 StarRocks 文件 Reader;其余任务保留 JNI 读取路径。
-
NATIVE 是显式启用 Paimon C++ 的模式。 支持的普通表读取任务交给 Paimon C++,系统表等特殊任务仍可能使用 JNI。
-
JNI 是显式使用 Java SDK 的模式。 查询通过 JNI Reader 读取 Paimon 数据,便于与原生路径进行对照。
选择发生在具体的读取任务上,同一次查询可能使用不同的 Reader。AUTO 也不意味着一定会启用 Paimon C++,评估原生读取收益时,需要显式选择 NATIVE 并核对实际执行路径。
三、如何使用 Paimon C++ 的读取能力
建立 Paimon Catalog
用户仍然通过 Paimon Catalog 访问湖表。以 Hive Metastore 和 HDFS 存储为例,创建 Catalog 的方式如下:
CREATE EXTERNAL CATALOG paimon_lake
PROPERTIES (
"type" = "paimon",
"paimon.catalog.type" = "rest",
"uri" = "cn-hangzhou-vpc.dlf.aliyuncs.com",
"paimon.catalog.warehouse" = "<dlf_catalog_name>",
"token.provider" = "dlf"
);
这里的 paimon.catalog.warehouse 表示 DLF Catalog 名称。uri 和 dlf.region 需要替换为 DLF 实例所在地域的实际配置。
启用原生读取,执行原有 SQL
以下示例使用 paimon_reader_mode,该参数在 v4.2 的文档中引入。使用前,需要确认当前集群版本和执行节点支持 Paimon C++ Reader。
先查看参数:
SHOW VARIABLES LIKE 'paimon_reader_mode';
再为当前会话选择原生读取,并开启 Profile:
SET paimon_force_jni_reader = false;
SET paimon_reader_mode = 'NATIVE';
SET enable_profile = true;
其中,paimon_force_jni_reader 是优先级更高的强制开关。如果它为 true,查询仍会使用 JNI,因此评估 Native Reader 前应将其关闭。
接下来,执行已有查询即可。例如,对已经存在的订单表统计当天已支付金额:
SELECT
order_date,
SUM(amount) AS paid_amount
FROM paimon_lake.sales.orders
WHERE order_date = '2026-09-01'
AND order_status = 'PAID'
GROUP BY order_date;
应用不需要为 Paimon C++ 重写 SQL。对于已经接入 Paimon Catalog 的业务,主要变化发生在数据读取层。
结合实际查询评估效果
可以选择主键表查询、宽表聚合和常用过滤查询,在数据快照一致的条件下,对比 NATIVE 与 JNI 的执行结果和耗时。测试时应保持缓存条件一致,避免把缓存预热带来的变化误认为 Reader 的收益。
除了总耗时,还应结合 Profile 和读取器诊断信息,关注实际读取路径、扫描数据量、远程读取、缓存命中和内存使用。如果主要耗时发生在 Join 或聚合阶段,替换 Reader 对整体耗时的影响可能较小。
完成测试后,可以恢复默认模式:
SET paimon_reader_mode = 'AUTO';
四、性能表现与后续规划
性能表现:
以下测试比较了 Paimon C++ Reader 与 JNI Reader,环境为单个 BE、8 核 CPU、32 GB 内存。
| 查询场景 | Paimon C++ Reader | JNI Reader | 加速比,约 |
|---|---|---|---|
| 100 万行追加表,COUNT(*) | 150 ms | 220 ms | 1.5 倍 |
| 80 万行、1000 列主键表,COUNT(*) | 403 ms | 1251 ms | 3.1 倍 |
| 100 万行表,读取 3 列进行聚合 | 202 ms | 451 ms | 2.2 倍 |
| 主键表,读取两列并 LIMIT 1 | 231 ms | 403 ms | 1.7 倍 |
| 1000 万行表,等值过滤后计数 | 274 ms | 376 ms | 1.4 倍 |
| 80 万行、1000 列主键表,全宽聚合 | 18.5 s | 62.0 s | 3.4 倍 |
在这些场景中,查询加速约为 1.4~3.4 倍。主键表计数从 1251 ms 降到 403 ms,千列宽表聚合从 62 秒降到 18.5 秒,体现了原生路径在降低读取和数据处理开销方面的价值。
后续规划:覆盖更多湖上查询场景
围绕原生读取,后续演进从三个方向展开。
扩大原生读取覆盖。 持续完善不同表类型、数据类型和表结构演进场景下的读取能力,让更多查询能够通过原生路径完成,并保持与 Paimon 表格式的兼容。
进一步降低查询开销。 围绕元数据准备、远程 I/O、数据合并和列式数据转换继续优化,同时完善缓存利用和查询指标,让性能提升更容易被观察和验证。
探索多模态与索引加速。 随着 Paimon 对 BLOB、全局索引、向量和全文检索能力的扩展,StarRocks 可以进一步探索把过滤和检索条件下推到湖上索引,减少需要读取的数据,为更多分析与检索场景提供统一的 SQL 入口。相关能力将随版本逐步推进。