导读:Apache Doris 5.0 增量计算预告(1)|场景方案篇:数据的实时写入只是第一步,如何让下游指标与宽表低延迟、低成本地同步变更,是实时数仓搭建的核心挑战。依赖定时全量重算,不仅数据滞后,也会造成极大的计算资源浪费。本文结合典型订单业务场景,系统介绍 Apache Doris 5.0 增量计算体系的实现机制,并通过实时指标汇总、客户订单宽表、库内 ETL 加工以及跨系统数据流出四大实践,提供清晰的技术选型与落地指导。
作者:陈明雨,Apache Doris PMC Chair
实时分析不仅关注新数据的写入,更依赖下游指标与宽表的同步更新,以准确反映业务的最新状态。
以电商订单为例,用户支付订单、客服修改地址、运营更正金额....这些状态变化需要实时反映在经营看板与业务宽表中,以便团队跟踪实际业务情况。
过去处理这类更新,通常靠定时任务全量重算。数据一旦多起来,这种做法就会很尴尬:重算得慢,运营看的数据是滞后的;重算得频繁,又会为了几条修改去重复扫描整张大表,浪费大量计算资源。
Apache Doris 5.0 引入以 Changelog 与 Table Stream 为基础的增量计算体系,支持捕捉和消费行级变化,并在此基础上提供物化视图增量维护能力,根据数据变化更新查询结果。
本文将结合订单业务场景,介绍 Doris 5.0 增量计算的核心能力与四大落地实践,并给出实际选型建议。
增量计算的基础设施:Changelog 与 Table Stream
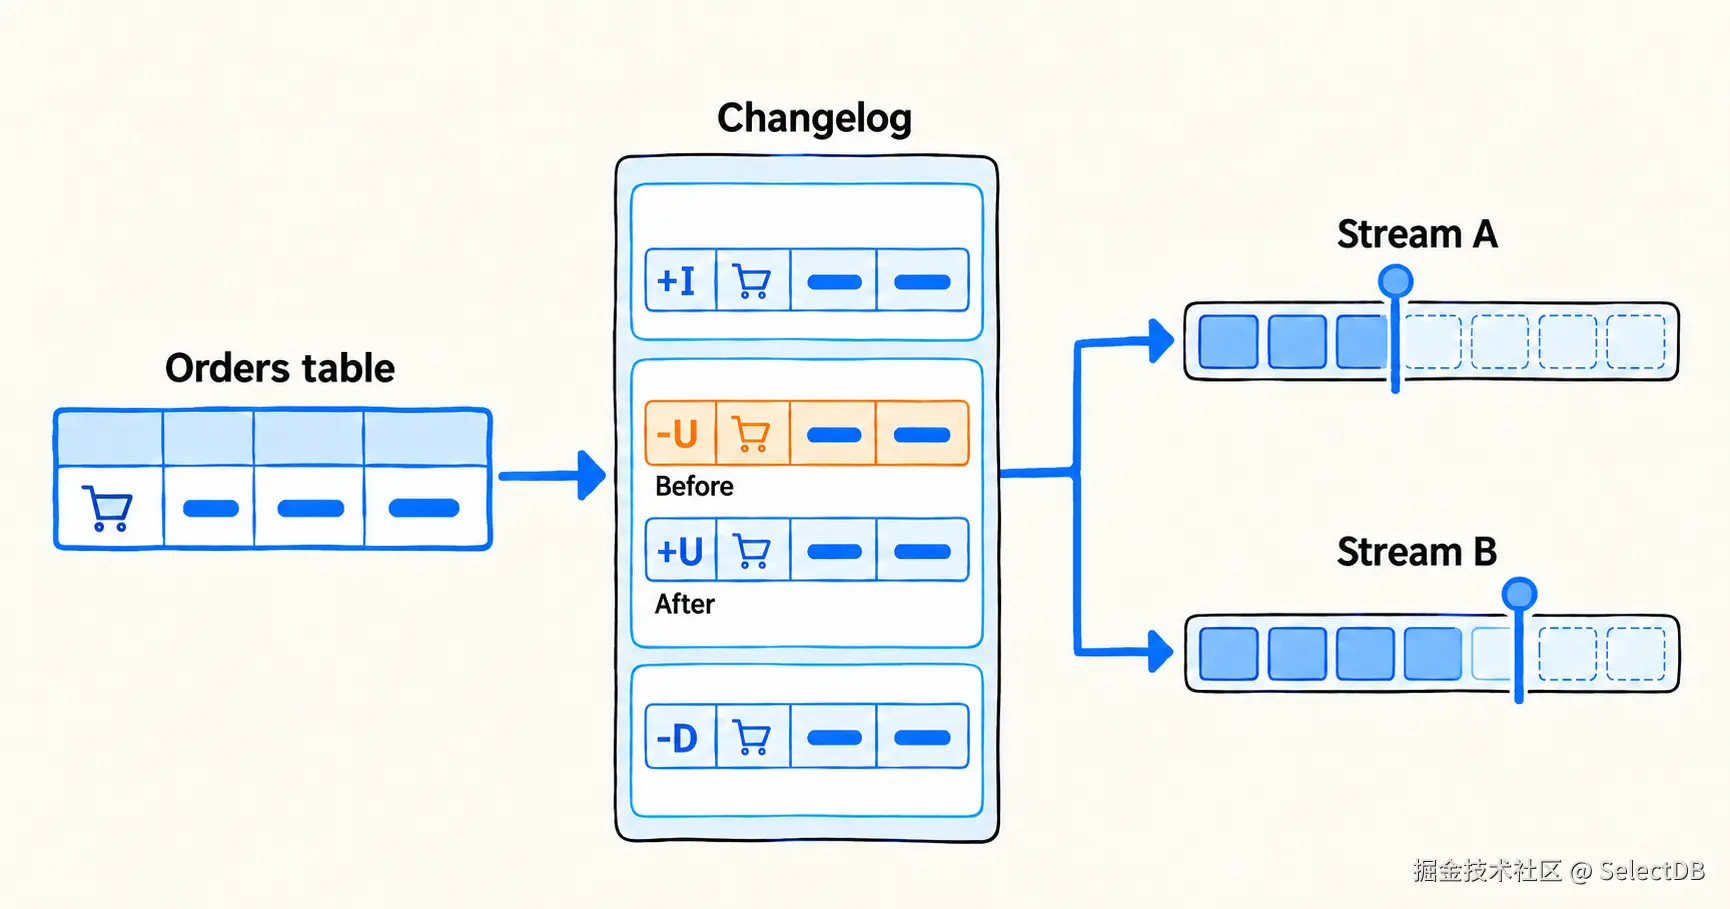
订单修改后,指标和宽表要跟着更新,系统需要知道改了什么,也得记住每个下游处理到了哪里。为此,Doris 5.0 引入了两项增量计算基础设施:Changelog 和 Table Stream。
Changelog:保存每一行的变化
订单表保存当前状态,Changelog 则记录行的新增、更新和删除。查询表可以看到订单现在的样子;读取 Changelog 可以看到它怎样变成现在这样。
例如,订单 1 原来是"待支付、100 元",后来变成"已支付、120 元"。订单表只显示新状态,按状态汇总时却还得从待支付分组减去原来的 100 元。Changelog 可以同时保存更新前后的行。更新前的行称为 before 镜像;删除订单时,也靠这份旧值判断要从指标中减去什么。
Doris 写入受支持的内表时,会持久化行变更,并附上提交时间戳和记录序号,供下游按顺序读取。本文的示例需要处理更新和删除,因此使用 Unique Key 表,在建表时开启 Changelog 和旧值记录。
Table Stream:像读表一样持续消费变化
Table Stream 关联一张开启 Changelog 的基表,读取的是该 Stream 尚未消费的变化。客服宽表和审计任务如果都要处理订单变化,可以各建一个 Stream。客服任务处理完订单 1 的修改,审计任务的消费进度不会因此改变。
每个 Stream 按分区保存自己的消费位点。普通 SELECT 只查看待处理变化,不推进位点;执行 INSERT INTO ... SELECT ... FROM <stream> 时,目标表写入和位点推进在同一事务中提交,失败则一起回滚。任务可以选择只看新增记录的 append_only、折叠同一订单多次修改的 min_delta,或保留每次修改的 detail。
Changelog 保存"改了什么",Table Stream 管理"消费到了哪里"。两者共同构成增量计算的基础设施,为上层功能持续读取和处理数据变化提供支持。物化视图增量维护就是建立在这套基础设施之上的一项功能。
物化视图增量维护(IVM)
什么是 IVM
物化视图将一条 SQL 查询的结果保存下来,供后续查询直接使用。基表发生变化后,这份已保存的结果也需要更新。物化视图增量维护(Incremental View Maintenance,简称 IVM),就是根据基表的新增、更新和删除,计算这些变化对查询结果的影响,再据此更新物化视图。
用户仍用 SQL 定义物化视图。对于受支持的聚合或关联查询,Doris 会基于 Changelog 与 Table Stream 自动读取变化、生成增量计算计划并维护结果,无须用户逐条编写变更处理逻辑,也无须每轮重算全部数据。
IVM 如何更新查询结果
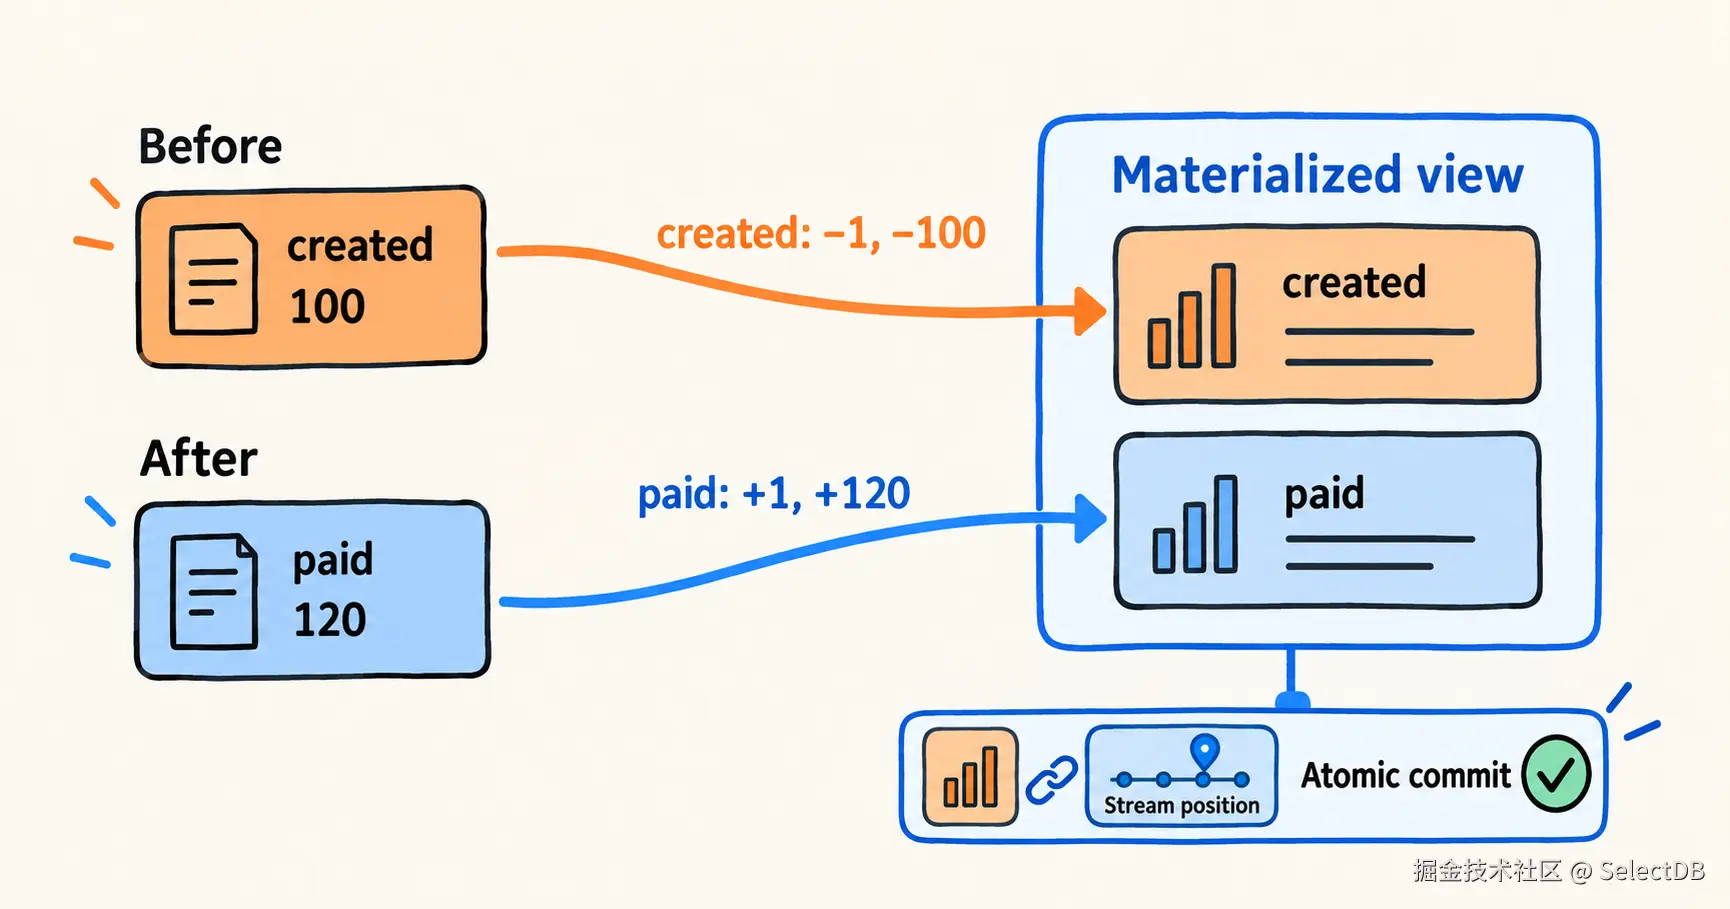
沿用前面的订单例子:订单 1 从"待支付、100 元"变为"已支付、120 元"。如果物化视图按订单状态统计订单数和金额,那么这次修改需要从待支付分组减去一笔订单和 100 元,再向已支付分组加上一笔订单和 120 元。
IVM 通过以下过程完成维护:
- 读取基表变化。 Doris 为参与维护的基表创建内部 Table Stream。Changelog 保存行的旧值和新值,刷新任务通过 Table Stream 读取本轮尚未消费的变化。
- 计算结果变化。 Doris 根据物化视图的定义生成增量计算计划。在这个例子中,计划根据旧行撤回待支付分组的贡献,再根据新行加入已支付分组的贡献。
- 提交结果与进度。 刷新任务在同一事务中提交物化视图结果和 Table Stream 消费位点,成功时一起提交,失败时一起回滚,保证结果与消费进度一致。
物化视图首次刷新需要先建立结果基线,之后才能在此基础上应用变化。刷新任务是异步的,完成前物化视图可能落后于基表。需要自定义库内加工时,也可以自行创建和消费 Table Stream。
基于 Changelog 与 Table Stream,Doris 5.0 提供了自动化视图维护(IVM)与灵活流式消费两类能力。下面结合订单业务,分别介绍其在实时指标统计、客户订单宽表、数仓库内加工 以及跨系统数据流出四个场景的具体应用。
四大典型场景
场景一:经营指标跟随订单状态更新
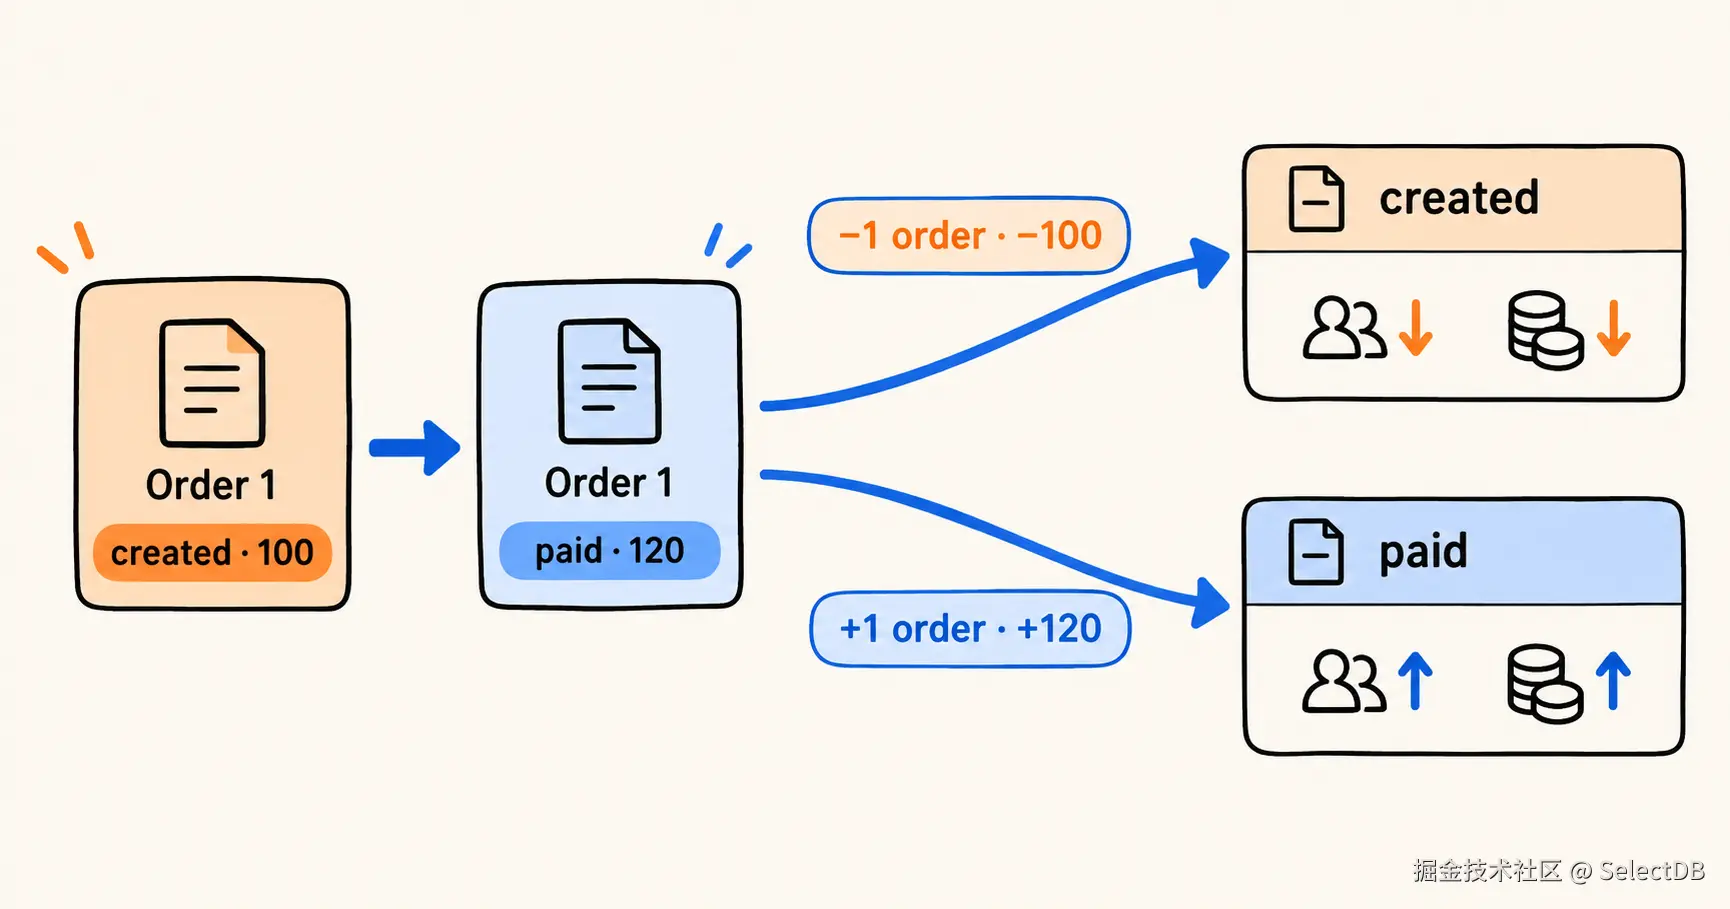
运营团队按订单状态查看订单数、金额和平均金额。订单支付后,这笔订单要从待支付分组移入已支付分组;金额修订和订单删除也要反映在已有指标中。只累加新订单,结果会算错。
对受支持的聚合查询,可以用 IVM 根据 Changelog 中的旧值和新值维护相关分组。业务团队仍用 SQL 定义指标,无须为每种修改单独编写撤回逻辑,也有机会减少对历史分区的重复扫描。
以下示例要求在 FE 的 fe.conf 和 BE 的 be.conf 中设置 enable_feature_changelog = true,并重启相应节点使配置生效。示例订单表使用 Unique Key 模型,建表时开启 Changelog 和 before 镜像:
sql
CREATE DATABASE incr_article_demo;
USE incr_article_demo;
CREATE TABLE orders (
order_id BIGINT,
customer_id BIGINT,
order_status VARCHAR(16),
amount DECIMAL(12, 2)
)
UNIQUE KEY(order_id)
DISTRIBUTED BY HASH(order_id) BUCKETS 1
PROPERTIES (
"replication_num" = "1",
"enable_unique_key_merge_on_write" = "true",
"changelog.enable" = "true",
"changelog.need_historical_value" = "true"
);
INSERT INTO orders VALUES
(1, 10, 'created', 100.00),
(2, 20, 'paid', 200.00),
(3, 10, 'paid', 300.00);聚合 SQL 定义了按状态统计的指标。先完整刷新一次并等待任务成功,建立基线后再修改订单,随后触发增量刷新:
sql
CREATE MATERIALIZED VIEW orders_by_status
BUILD DEFERRED
REFRESH INCREMENTAL FALLBACK ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES ("replication_num" = "1")
AS
SELECT order_status,
COUNT(*) AS order_count,
SUM(amount) AS total_amount,
AVG(amount) AS avg_amount
FROM orders
GROUP BY order_status;
REFRESH MATERIALIZED VIEW orders_by_status COMPLETE;
-- 等待上述刷新任务成功后,再执行后续订单变更。
INSERT INTO orders VALUES
(1, 10, 'paid', 120.00),
(2, 20, 'paid', 180.00);
DELETE FROM orders WHERE order_id = 3;
INSERT INTO orders VALUES (4, 30, 'created', 400.00);
REFRESH MATERIALIZED VIEW orders_by_status INCREMENTAL FALLBACK;刷新完成后,已支付分组有订单 1 和 2,金额合计 300;待支付分组只有订单 4。这里统计的是示例订单金额。实际业务中的成交额、退款额应按各自口径定义,不能把退款直接当作删除订单。
场景二:持续维护客户订单宽表
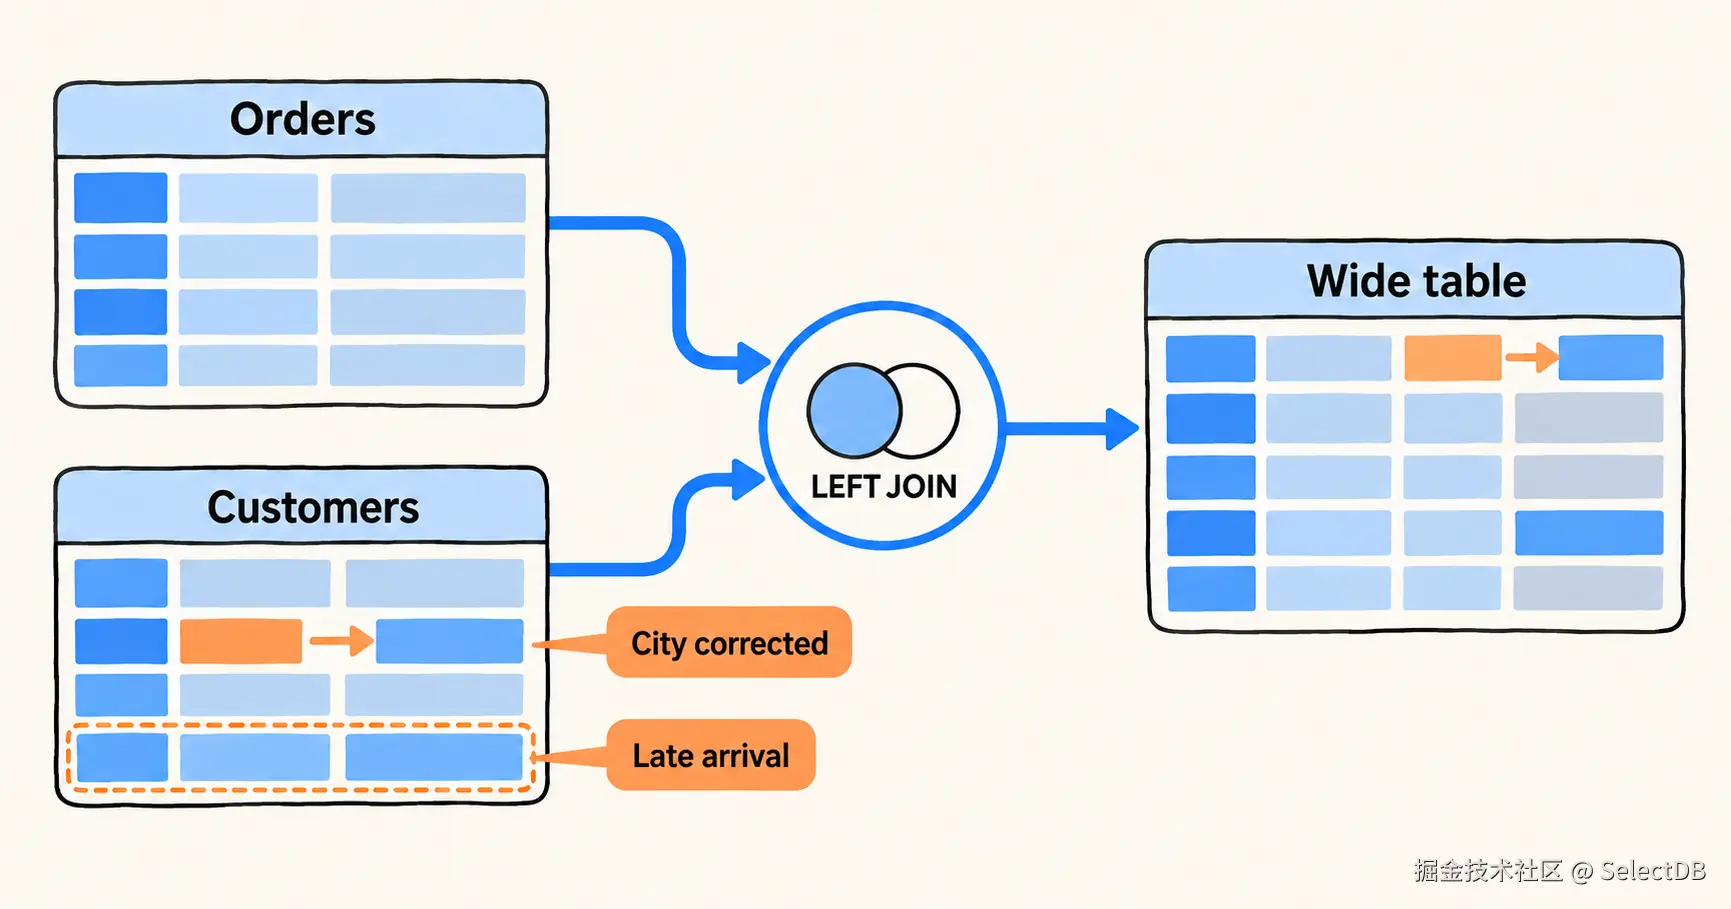
单表状态汇总解决了指标更新问题,但在实际业务中,运营与客服往往还需要将订单与客户资料关联成一张宽表。
如果客户修改了城市,或者资料补录晚于订单创建,仅处理订单表的增量就会丢失更新。借助 IVM 的 Join 维护能力,两端数据的变更均能自动同步至宽表。
沿用场景一的订单表,先创建客户表和宽表视图,再补入客户 30,将客户 10 的城市改为 Hangzhou:
sql
CREATE TABLE customers (
customer_id BIGINT,
customer_name VARCHAR(32),
city VARCHAR(32)
)
UNIQUE KEY(customer_id)
DISTRIBUTED BY HASH(customer_id) BUCKETS 1
PROPERTIES (
"replication_num" = "1",
"enable_unique_key_merge_on_write" = "true",
"changelog.enable" = "true",
"changelog.need_historical_value" = "true"
);
INSERT INTO customers VALUES
(10, 'Alice', 'Beijing'),
(20, 'Bob', 'Shanghai');
CREATE MATERIALIZED VIEW orders_with_customer
BUILD DEFERRED
REFRESH INCREMENTAL FALLBACK ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES ("replication_num" = "1")
AS
SELECT o.order_id, o.order_status, o.amount,
c.customer_name, c.city
FROM orders o
LEFT JOIN customers c ON o.customer_id = c.customer_id;
REFRESH MATERIALIZED VIEW orders_with_customer COMPLETE;
-- 等待上述刷新任务成功后,再执行后续客户资料变更。
INSERT INTO customers VALUES
(10, 'Alice', 'Hangzhou'),
(30, 'Carol', 'Shenzhen');
REFRESH MATERIALIZED VIEW orders_with_customer INCREMENTAL FALLBACK;刷新后,订单 1 显示客户的新城市 Hangzhou,订单 4 也补上了原先缺失的客户信息。这个视图关联的是客户当前属性。若报表要显示下单时的城市,就得在数据模型中保留当时的属性。
场景三:数仓分层按变化加工
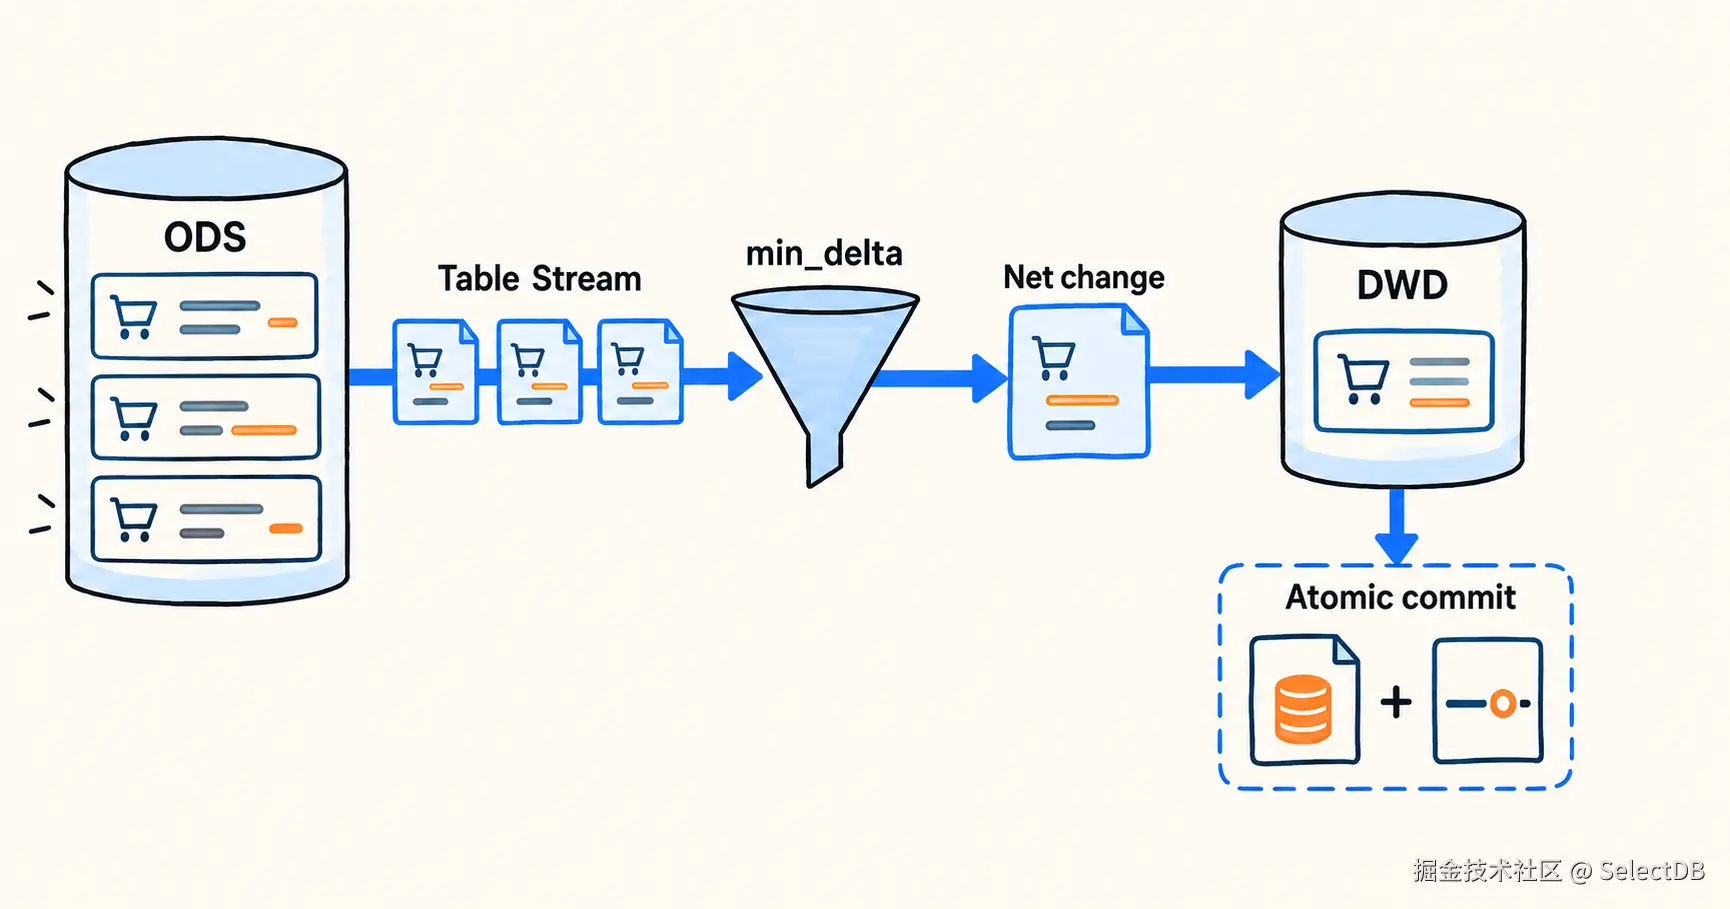
IVM 适用于通过标准 SQL 进行自动化视图维护。而在复杂的数仓分层(如 ODS 到 DWD)中,若需要自定义数据清洗逻辑、折叠中间多次修改,或在任务失败后重试,则可以配合 Table Stream 构建库内流式加工 Pipeline。
例如,为订单表建立 Stream,把存量订单及后续变化写入下游 Unique Key 表:
sql
CREATE STREAM orders_dwd_stream ON TABLE orders
PROPERTIES (
"type" = "min_delta",
"show_initial_rows" = "true"
);
CREATE TABLE dwd_orders (
order_id BIGINT,
order_status VARCHAR(16),
amount DECIMAL(12, 2)
)
UNIQUE KEY(order_id)
DISTRIBUTED BY HASH(order_id) BUCKETS 1
PROPERTIES (
"replication_num" = "1",
"enable_unique_key_merge_on_write" = "true"
);
INSERT INTO dwd_orders (order_id, order_status, amount, __DORIS_DELETE_SIGN__)
SELECT order_id, order_status, amount,
CASE WHEN __DORIS_STREAM_CHANGE_TYPE_COL__ = 'DELETE' THEN 1 ELSE 0 END
FROM orders_dwd_stream
WHERE __DORIS_STREAM_CHANGE_TYPE_COL__ IN ('APPEND', 'UPDATE_AFTER', 'DELETE');第一次执行会写入订单当前状态,以后重复执行这条 INSERT 来处理净变化。UPDATE_AFTER 覆盖旧值,DELETE 借助删除标记清除下游旧行;这条状态同步链路不用把 UPDATE_BEFORE 写入目标表。如果要追溯每一次修改,则应另建 detail 类型的 Stream,把变化存入审计表。
场景四:通过 Flink 将 Doris 变化用于其他系统
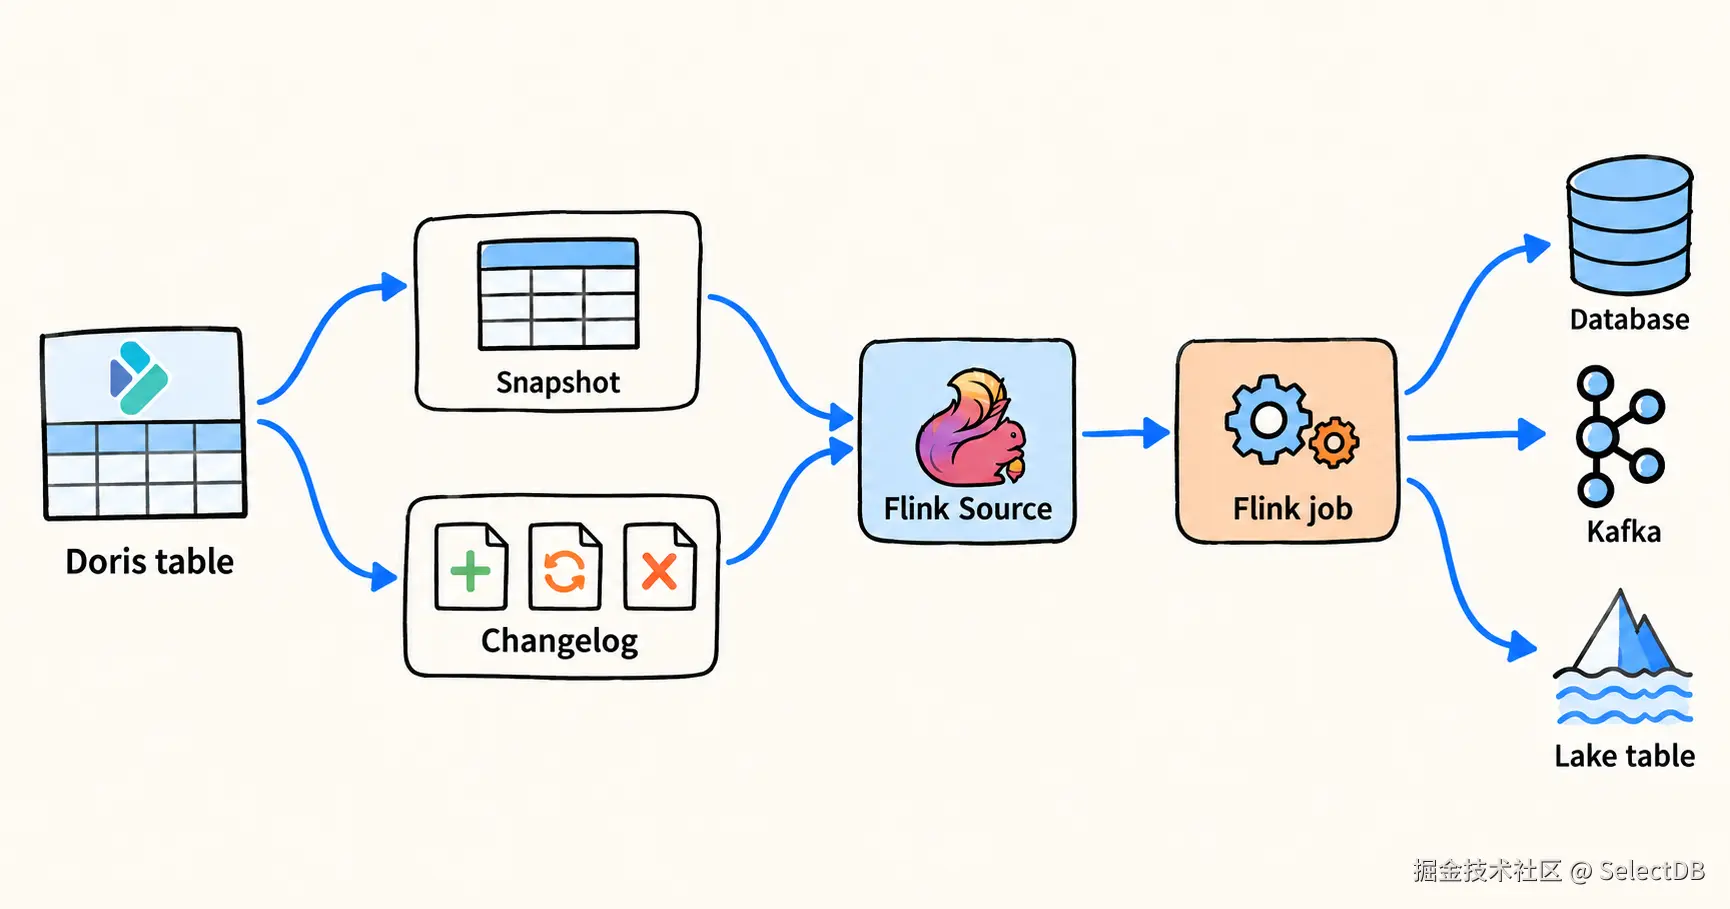
除了 Doris 内部的数仓加工,这些订单变更有时还需要实时分发给 Kafka、数据湖或其他业务系统。
利用 Flink Doris Connector,可以直接将 Doris 表作为增量 Source,将数据变化实时流出到下游。
在 Flink SQL Client 中,将前面创建的 orders 表设为 Source:
ini
SET 'execution.checkpointing.interval' = '10s';
SET 'table.exec.source.cdc-events-duplicate' = 'true';
CREATE TABLE orders_from_doris (
order_id BIGINT,
customer_id BIGINT,
order_status STRING,
amount DECIMAL(12, 2),
PRIMARY KEY (order_id) NOT ENFORCED
) WITH (
'connector' = 'doris',
'fenodes' = '<fe-host>:8030',
'table.identifier' = 'incr_article_demo.orders',
'username' = '<doris-user>',
'password' = '<doris-password>',
'source.scan.mode' = 'initial',
'source.changelog.increment-type' = 'detail'
);
-- 提交查询以启动 Source,在另一个 Doris SQL 会话中执行下文的订单变更。
SELECT * FROM orders_from_doris;快照读取完成后,以下订单新增、支付和删除还会进入 Flink 作业:
sql
INSERT INTO orders VALUES (5, 30, 'created', 50.00);
INSERT INTO orders VALUES (5, 30, 'paid',    50.00);
DELETE FROM orders WHERE order_id = 5;
initial 让作业先读取存量快照,再接着读取后续变更。该示例面向 Doris 5.0.0+ 和 Flink Doris Connector 26.4.0+;提前体验时,需要使用包含 Changelog 接口改动的 Doris 与 Connector 构建。写入业务数据库、Kafka 或湖表时,目标 Sink 也必须能处理更新和删除。整条链路如何恢复、能提供什么交付语义,还取决于 Checkpoint、日志保留、去重方式和 Sink,不能只看 Source 的配置。
适用场景及使用建议
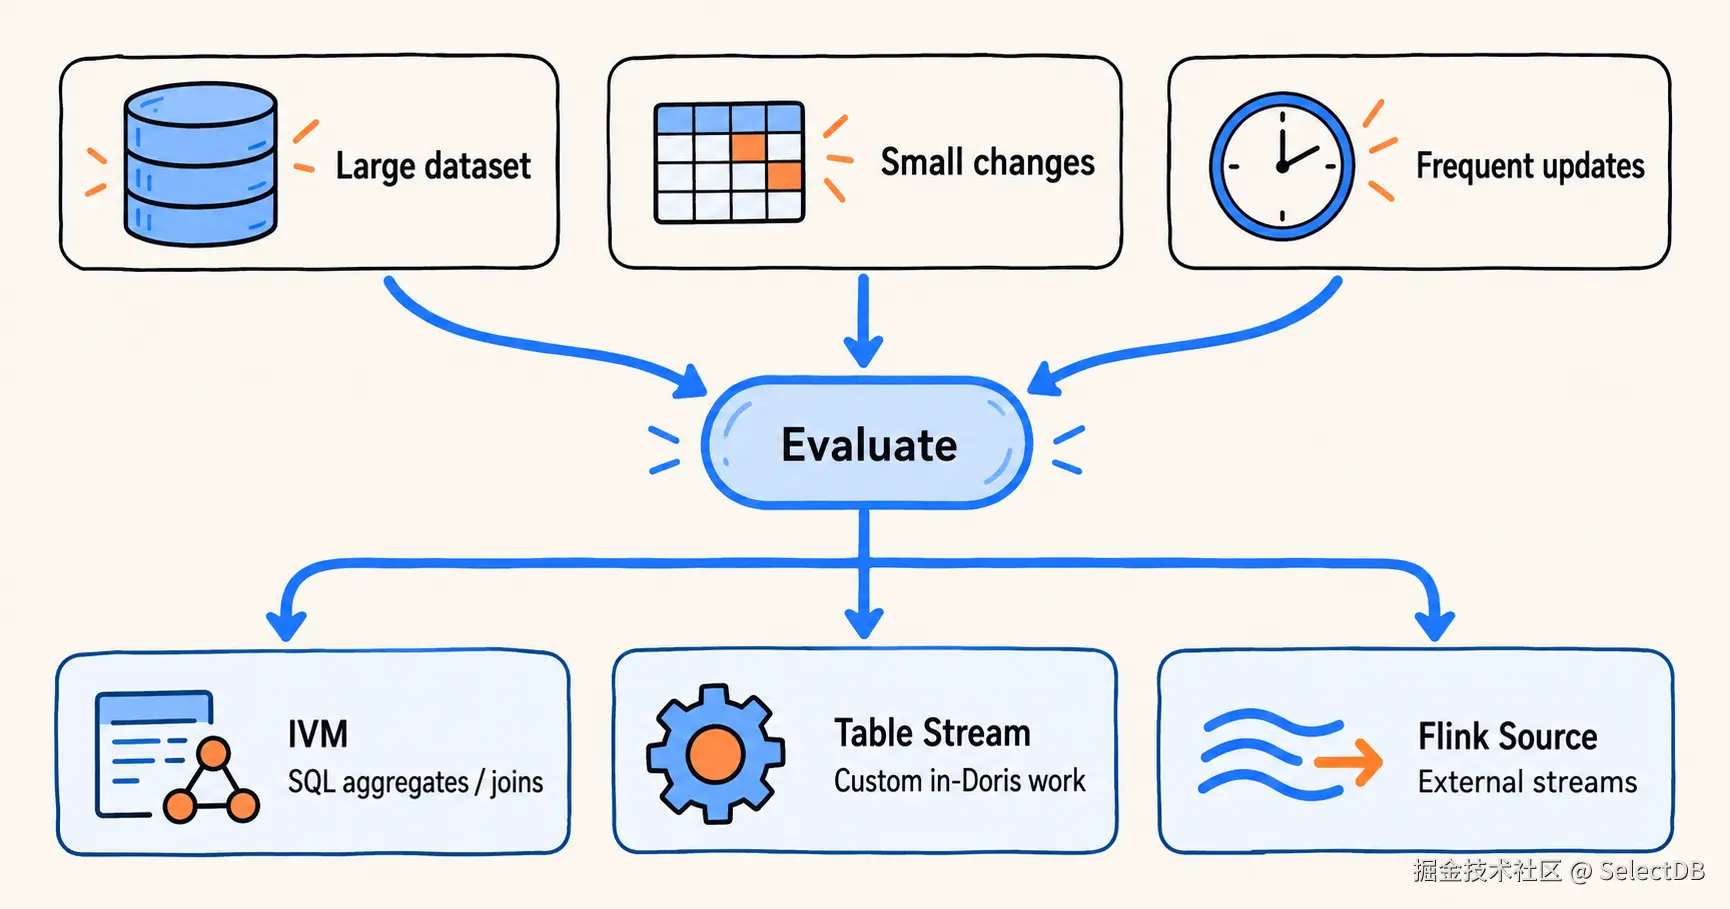
增量计算并非全量计算的绝对替代品,其核心价值在于解决高频更新、大存量数据场景下的计算成本与延迟问题。在实际架构设计中,建议参考以下策略:
- 自定义库内加工(Table Stream) :适用于复杂的数仓分层 ETL。通过定义基础的 Table Stream,业务可以自行管理对 Changelog 的消费方式和调度方式。Table Stream 产出的数据支持自动折叠中间变更(
min_delta),并能精准记录消费位点,方便任务失败后从断点重试。 - 物化视图增量维护(IVM) :适用于标准的 SQL 汇总与多表关联。IVM 基于 Table Stream,通过 SQL 定义和内部调度简化数据加工逻辑。除了支持数据分层加工外,还能支持物化视图透明加速。
- 跨系统数据流出(Flink Doris Connector) :对 Changelog 直接消费,适用于将 Doris 内部的数据变更无缝对接给下游 Kafka 或数据湖的场景。
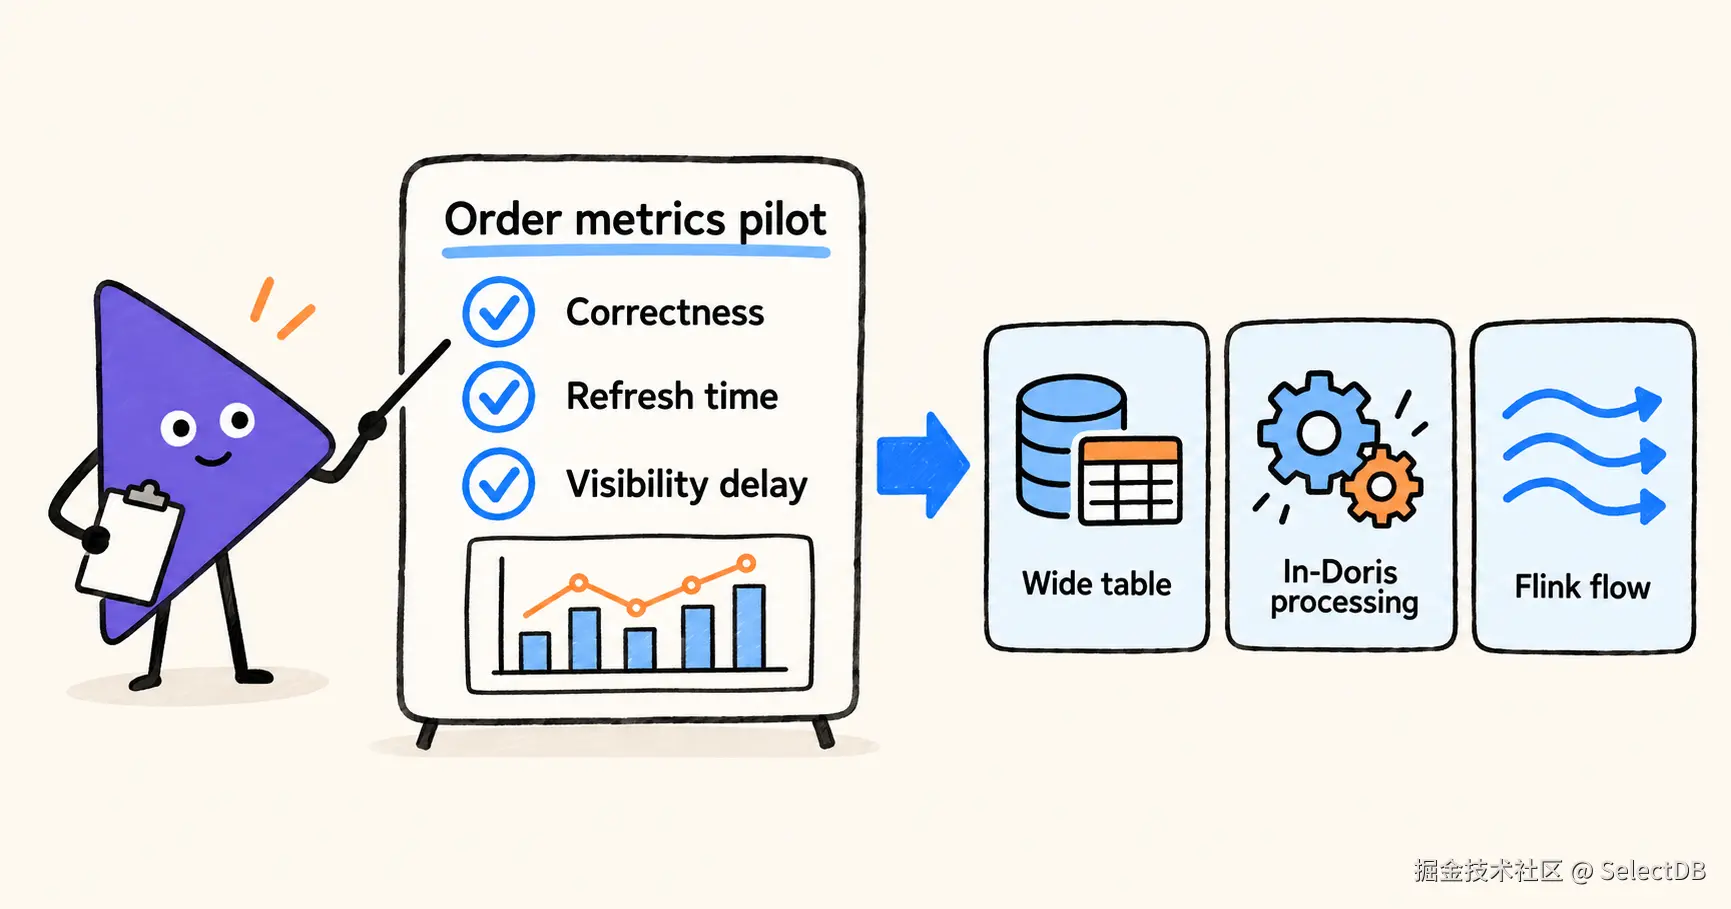
在实际落地时,建议先从规则明确的单表汇总(如订单状态统计)切入试点,验证端到端延迟与计算资源消耗,再逐步推广至更复杂的业务链路。
在下一篇《增量计算技术解析》中,我们将深入内核视角,讲解 Changelog 的存储设计与 IVM 增量计划的生成原理。
结束语
Apache Doris 5.0 的增量计算体系,标志着 Doris 从"实时写入、全量计算"向"实时写入、增量精准计算"的全面进化。这一能力不仅大幅降低了高频变更场景下的资源开销,更进一步提升了数据端到端的可见性时效。
Apache Doris 5.0 即将正式上线,届时这一核心能力将全面开放。如果您希望提前体验增量计算带来的高性能实时分析能力,或需要在企业生产环境中快速构建稳定、低延迟的实时数仓,欢迎关注后续官方资讯及通告。
我们是谁
飞轮科技由 Apache Doris 原创团队创立,贡献超 95% 社区代码。旗下的 SelectDB 是基于 Apache Doris 内核打造的企业级/云原生极速分析数据库,在 Doris 极致性能基础上增强了安全稳定、可视化运维及多云托管等能力(性能快同类 3-10 倍)。面向 Agent 时代,为全球企业提供智能体时代的高性能实时分析服务。