2026-10-15·Run 生命周期·Run 生命周期
用户点'停止'时 Agent 正在写文件------直接杀会留下损坏的文件。进程 OOM 崩了------对话历史还在吗?这篇讲两件事:如何优雅地停下一个正在工作的 Agent,以及进程崩溃后如何恢复。含企业版版本错配导致部门数据消失的真实事故,以及行业五阶段生命周期规范。
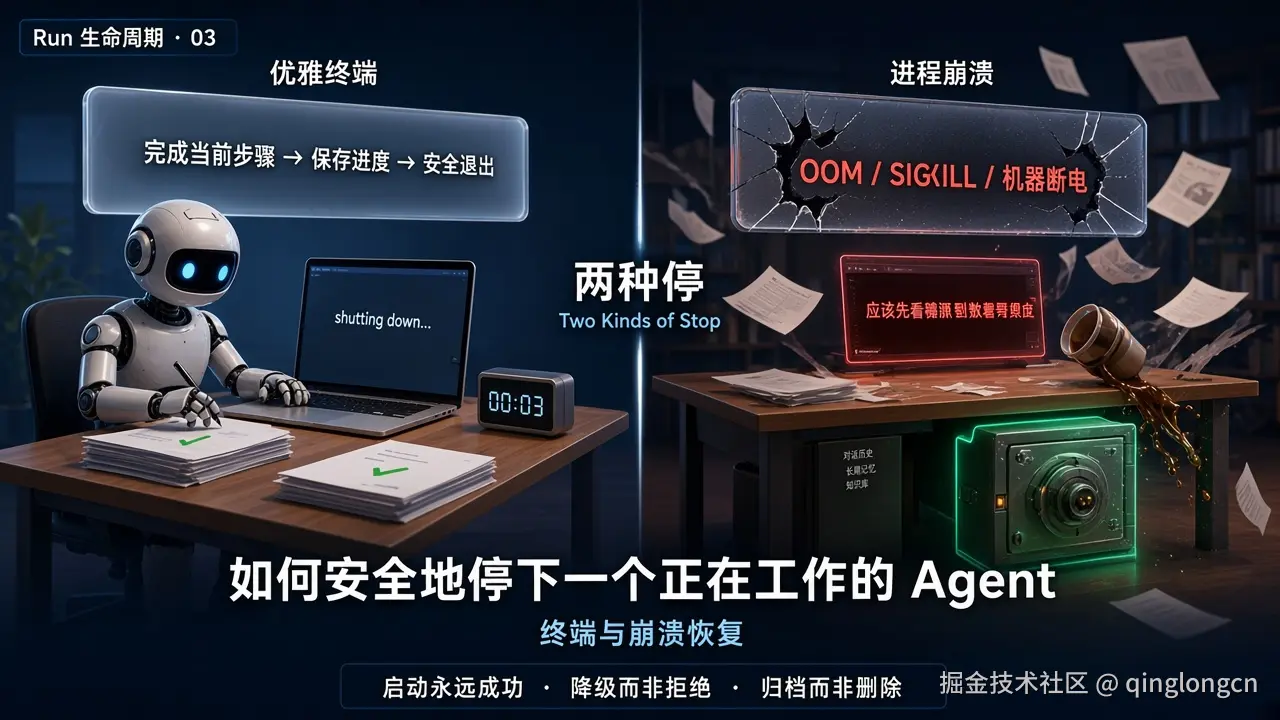
两种"停"
Agent 的"停"有两种------主动停 (用户点了"停止")和被动停(进程崩了)。两者的工程挑战完全不同。
主动停的挑战:Agent 正在做半截事(写文件写一半 / 子进程在跑 / 消息历史待更新)------怎么安全收尾而不留下损坏的状态?
被动停的挑战:进程突然消失(OOM / SIGKILL / 机器断电)------已持久化的数据还完整吗?正在跑的任务怎么标记?下次启动能不能接着来?
第一部分:主动停------优雅中断
问题的复杂性
用户点了"停止"。此刻 Agent 可能正在:
| 状态 | 直接杀的后果 |
|---|---|
执行 exec("npm install") |
npm 子进程变成孤儿,继续在后台跑 |
执行 write_file("app.ts", ...) |
文件写了一半------下次 Agent 读到损坏的文件 |
| 等 LLM 返回(流式传输中) | 半截的回复丢失 |
| 等用户审批(HITL 阻塞中) | 审批请求悬空,前端永远显示"等待审批" |
Claude Code 怎么做
Claude Code 是 CLI------用户按 Ctrl+C 发 SIGINT。进程处理信号 → 完成当前工具调用 → 退出。
这在 CLI 场景够用------用户看到"正在结束..."几秒后进程退出。但它有一个限制:如果工具调用耗时很长(比如 npm install 跑了 5 分钟),Ctrl+C 要等工具跑完才会退出。用户可以再按一次 Ctrl+C 强制杀------但那就是"不安全停止"了。
Claude Code 的 --resume 有一些已知问题值得留意。GitHub issue #47508 记录了一个问题:上下文压缩(compact)后的消息可能不被 --resume 正确加载------意味着压缩后恢复的会话可能丢失部分上下文。issue #86324 更微妙:当用户 rewind/undo 时,文件状态被回滚了但对话上下文没有同步------Agent 继续自信地引用已不存在的代码。这两个问题揭示了一个共性挑战:状态恢复需要多个维度同步(文件系统 + 对话历史 + 压缩后的摘要),任何一个维度不同步都会导致 Agent 的认知与现实脱节。
Cursor 怎么做
Cursor 的 Cancel 按钮中断 Agent 任务。由于代码修改是 Apply 机制(先 diff 预览再确认),Cancel 时只需要丢弃未 Apply 的 diff------不会留下半写的文件。这是 Apply 机制的附带好处。
安全中断的通用原则
从各产品的实践中可以提炼出三条通用原则:
原则一:协作式而非抢占式
不是在任意时刻杀掉执行线程------而是设一个"中断标志",Agent 在"安全点"检查这个标志然后停下来。安全点通常在:每轮循环开头、每个工具调用之间。
原则二:正在执行的工具给收尾时间
如果 Agent 正在执行 write_file,给它几秒时间写完(通常 < 1 秒)。超时才强制取消。文件要么完整写入,要么不存在------不能半写。
原则三:消息历史必须保持一致
Agent 的对话历史中如果有"我要调用 read_file 工具"(tool_use)但没有对应的"工具返回了 xxx"(tool_result),下次加载历史时 LLM Provider 会报格式错误。中断后必须为每个未完成的工具调用补上占位结果。
在我们的引擎中,这三条原则体现为:
- 中断信号设标志,不杀线程
- 给正在执行的工具 3 秒收尾窗口
- 中断后自动为未执行的工具调用补上"操作被中断"的占位结果
- 中断是幂等的------用户焦急地连点三次"停止",效果和一次相同
- 中断不删除已完成的工作------Agent 在被中断前的成果全部保留
行业五阶段生命周期规范
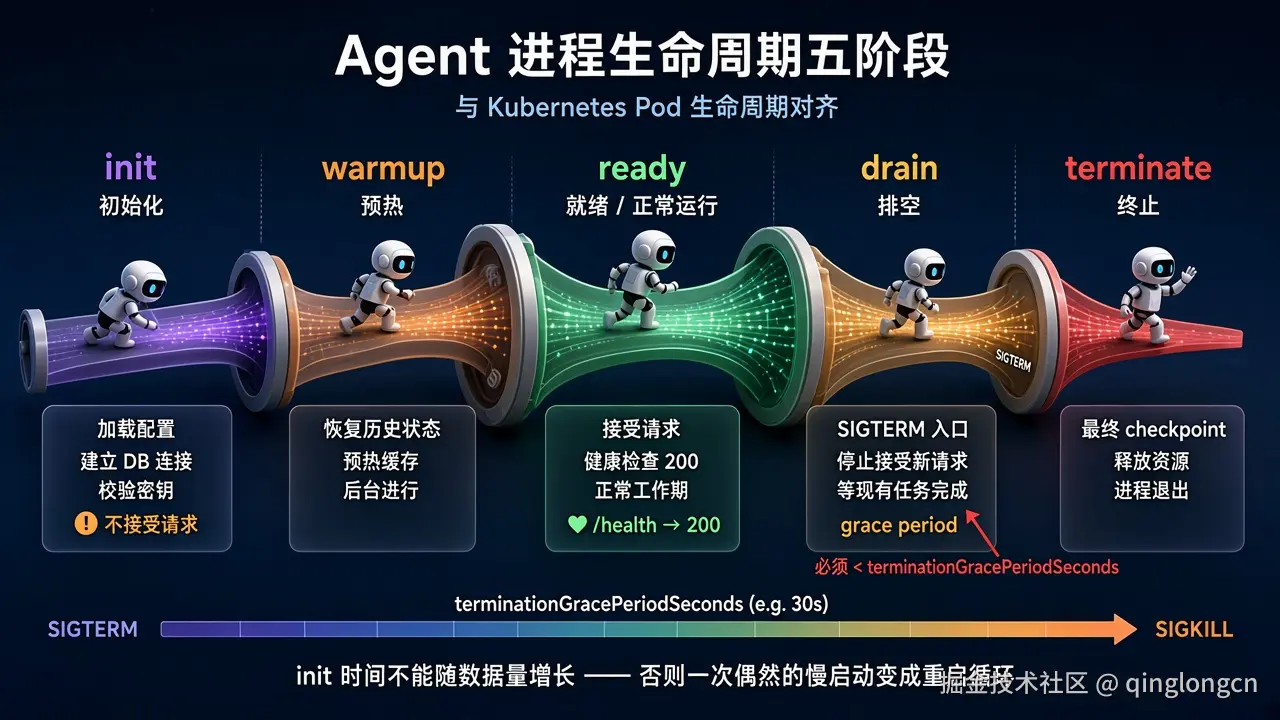
Agent 进程的生命周期不只是"跑起来"和"停下来"。Geodocs 在 2026 年发布的 AI Agent 启停规范(geodocs.dev/ai-agents/agent-startup-shutdown-spec)定义了五阶段模型,与 Kubernetes Pod 的生命周期高度对齐:
bash
init → warmup → ready → drain → terminateinit(初始化) :加载配置、建立数据库连接、校验密钥。这个阶段不应该接受请求。 warmup(预热) :恢复历史状态、预热缓存、加载模型连接。可以在后台进行。 ready(就绪) :可以接受请求了。健康检查开始返回 200。 drain(排空) :收到停止信号后,停止接受新请求,等现有任务完成。这是"优雅停止"的核心阶段。 terminate(终止):所有任务完成(或超时后强制终止),执行最终 checkpoint,释放资源。
SIGTERM 触发 drain → terminate 的转换。关键约束:drain 的超时(grace period)必须小于进程管理器的 SIGKILL 超时 ------比如 Kubernetes 的 terminationGracePeriodSeconds 默认 30 秒,你的 drain 必须在 30 秒内完成,否则 SIGKILL 到来时正在做的 checkpoint 被打断,结果比不做 checkpoint 更糟。
一个容易忽略的点 :init 阶段的耗时不能随数据量增长而增长。如果有 100 个租户的引擎在 init 时逐个加载每个租户的状态,租户数 × 加载时间 = 启动时间。当这个时间超过进程管理器的启动超时(systemd 的 TimeoutStartSec / Kubernetes 的 readiness probe),进程管理器会判定"启动失败"然后杀掉进程------而杀掉后重启又要走一遍同样的路。一次偶然的慢启动变成一轮比一轮深的重启循环。
解法:init 阶段只做"能在有界常数时间内完成的事"(绑端口、注册服务),租户级加载在 ready 之后后台进行。
第二部分:被动停------崩溃恢复
崩溃恢复不是理论问题。Amazon Kiro(2025 年 12 月)在一个生产环境中决定"删除并重建整个环境"来修一个小 bug------因为它继承了工程师的高权限。如果这个操作中途崩溃(电源中断/OOM),环境会处于什么状态?半删除------既不是旧的也不是新的。 这比完全删除更难恢复(AI Failure Index)。
进程崩溃时的状态分布
进程突然退出时,Agent 的状态分布在四个地方:
| 位置 | 例子 | 崩溃后 |
|---|---|---|
| 内存 | 当前循环的消息列表、LLM 流式响应缓冲 | 丢失 |
| 磁盘(已提交) | 已写入数据库的历史消息、工具调用追踪 | 保留 |
| 磁盘(WAL 未提交) | SQLite WAL 日志中的待提交写入 | 自动恢复(SQLite WAL 回放) |
| 子进程 | exec 启动的子进程 | 可能变孤儿 |
好消息:已提交到数据库的数据不丢(SQLite 的 ACID 保证 + WAL 自动回放)。用户之前的对话历史、长期记忆、知识库------全在。
坏消息:当前正在执行的那一轮(内存中的消息、半返回的 LLM 响应、正在跑的工具调用的结果)------丢失了。
LangGraph 与 Temporal 的恢复粒度对比
不同产品的崩溃恢复,本质区别在于恢复粒度------崩溃后能恢复到多精确的位置。
LangGraph Platform 的恢复粒度是 node boundary(图中一个节点执行完毕的边界,LangGraph 称之为"super-step boundary")。如果一个节点内部崩溃------比如一次 LLM 调用执行了 30 秒后 OOM------整个节点需要重新执行。但 LangGraph 的 Pending Writes 机制保证:并行节点中已完成的结果不丢失,只重跑失败的节点。
Temporal 的恢复粒度是 single activity------每一步的输入和输出都记录在事件历史中,崩溃后 replay 恢复到精确的那一步。这意味着即使一次 LLM 调用跑了 30 秒后崩溃,如果这次调用是一个 activity,它只需要重试这一次调用------不需要重跑整个节点。代价是事件历史的存储开销和 replay 的时间成本。
Microsoft Foundry 在 2026 年推出了 Agent 崩溃恢复模型(learn.microsoft.com/azure/foundry/agents),采用三个标志位:store=true(持久化 Run 状态)+ background=true(后台运行)+ resilient_background=True(崩溃可恢复)。Agent 在检测到需要恢复时调用 exit_for_recovery(),Foundry 重启 Agent 并注入上次的 checkpoint------关键设计:恢复不消耗 retry 预算,因为恢复不是"第二次尝试",是"同一次尝试的继续"。
我们的引擎 的恢复粒度介于 LangGraph 和 Temporal 之间:每轮(turn)即时持久化。每次工具调用的结果、每条消息、每次 token 计量------在产出的那一刻就写入数据库。不等一个 node 完成,不等整个任务结束。崩溃后丢失的只有"当前正在执行的那一轮"------可能是一次 LLM 调用的流式响应或一次工具执行的结果。
启动时恢复
进程重启后,引擎需要做两件事:
一、识别"孤儿任务"------扫描数据库中标记为"运行中"的任务,但当前进程里没有它们 → 它们的宿主进程已经崩了。标记为"进程崩溃终止",用户可以看到"Agent 在这里因进程崩溃而终止"。
二、确保启动成功 ------不管之前发生了什么(数据库部分损坏、WAL 残留、半写的文件),重启后引擎必须能正常工作。这是一条刚性原则------如果上一次崩溃导致下一次起不来,一次临时故障就升级成了永久不可用。
做法是降级而非拒绝:发现某层数据损坏 → 标记该层为"降级"(其他层正常工作),不是整体拒绝启动。比如追踪数据损坏 → 追踪不可用但对话和记忆正常 → Agent 可以继续工作,只是看不到历史追踪。
"测试 SIGKILL,不只是 SIGTERM"
一篇被广泛引用的工程博客(dev.to/gabrielanhaia)提出了一个尖锐的观点:大多数团队只测试优雅关闭(SIGTERM),从不测试强制杀死(SIGKILL)。
测试方法是:fork 一个 Agent 进程 → 让它开始执行任务 → 发 SIGKILL(不是 SIGTERM)→ 重启 → 验证:①数据没有损坏 ②没有重复执行 ③ 用户能看到发生了什么。
"没有重复执行"这一条最容易忽略。如果 Agent 在崩溃前已经执行了 exec("npm install") 并拿到了结果,但结果还在内存中没来得及持久化------重启后 Agent 不知道已经执行过了,可能再执行一次。对于幂等操作(读文件)无害,对于非幂等操作(发消息、写数据库、调用外部 API)可能产生副作用。
Temporal 的事件溯源天然解决了这个问题------每个 activity 的结果都持久化了,replay 时直接回放结果而不重新执行。LangGraph 的 Checkpoint 在 node boundary 持久化,node 内部的中间结果仍可能重执行。你的引擎选择在哪个粒度持久化,决定了 SIGKILL 后会不会重复执行。
一个真实的事故:版本错配导致数据消失
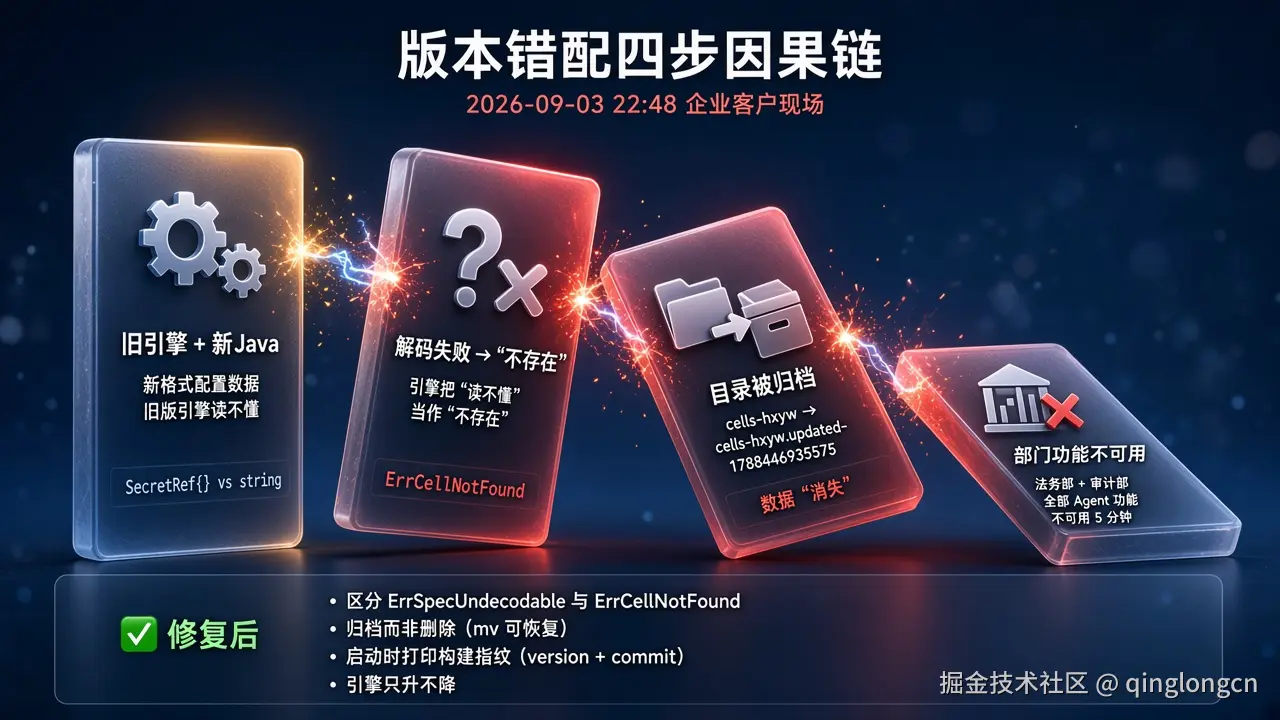
这个事故不是运行时崩溃------但它暴露了恢复逻辑的一个深层缺陷:"读不懂"和"不存在"被混为一谈。
场景 :2026 年 9 月,企业客户现场部署。运维在更新 Java 应用时没有同步更新 Agent 引擎。新版 Java 写入了新格式的配置数据(渠道凭证从明文字符串升级为加密对象)------旧版引擎读不懂。
发生了什么(精确时间线 2026-09-03 22:48):
- 旧版引擎读取新格式的配置 → JSON 解码失败 → 认为这个租户"不存在"
- 应用层查询这个租户 → 引擎说"不存在" → 应用层触发自动创建流程
- 引擎把已有的 租户目录当作"孤儿"归档(改名为
.deleted-1788446935575)→ 然后发现 ID 已注册 → 报 500 - 结果:法务部和审计部两个部门的对话历史、记忆、知识库从活动目录消失了
数据没有真丢 ------归档目录还在。运维手工 mv 目录回来 → 恢复。但中间有 5 分钟那两个部门的所有 Agent 功能不可用。
这和 Kubernetes 的 rolling update 是同一类问题。Kubernetes 在滚动更新时保证新旧 Pod 共存------新 Pod 必须能读懂旧 Pod 写的数据,旧 Pod 也不能因为新数据格式就把旧数据删了。这个事故就是缺少了这个保证。
修复后的四条纪律:
- "读不懂"和"不存在"是两种错误 ------引擎区分
ErrSpecUndecodable(格式不认识)和ErrCellNotFound(真的没有)。前者保留数据、降级运行;后者才触发清理 - 归档不是删除 ------对"可能是孤儿"的数据做归档(改名),不做删除。改名是运维可以
mv回来的操作;删除是不可逆的 - 引擎启动时打印构建指纹 (
version=... commit=...)------运维看一行日志就知道"跑的是哪个版本",不需要 strace - 引擎只升不降------确需回退版本时,先在测试环境验证旧版能读懂现有数据
崩溃恢复的行业对比
以下对比展示了不同产品在崩溃恢复三个关键维度上的做法:
| 维度 | Claude Code | Cursor | LangGraph Platform | Temporal | Microsoft Foundry | 我们的引擎 |
|---|---|---|---|---|---|---|
| 恢复粒度 | 会话级(全部历史) | 文件级(diff/revert) | 节点级(super-step) | 单步级(activity) | 任务级(checkpoint) | 每轮级(turn) |
| 数据保全 | 对话完整,当前操作丢失 | 代码 diff 保留 | 已完成节点+pending writes 保留 | 全部保留(event replay) | Checkpoint 保留 | 已提交数据全保留,当前轮丢失 |
| 用户可见性 | --resume 可看历史 |
Revert 可撤销 | Run status API 可查 | Temporal UI 可查全历史 | 管理面板可查 | "进程崩溃终止"标记 + 追踪 |
| 恢复时间 | 秒级(加载历史) | 即时(文件在磁盘) | 秒级(读 checkpoint) | 秒-分级(replay) | 秒级 | 百毫秒级(WarmUp) |
| SIGKILL 安全 | ✅(append-only 文件) | ✅(磁盘文件) | ✅(Postgres ACID) | ✅(event store ACID) | ✅(Azure 托管) | ✅(SQLite ACID + WAL) |
崩溃恢复的通用原则
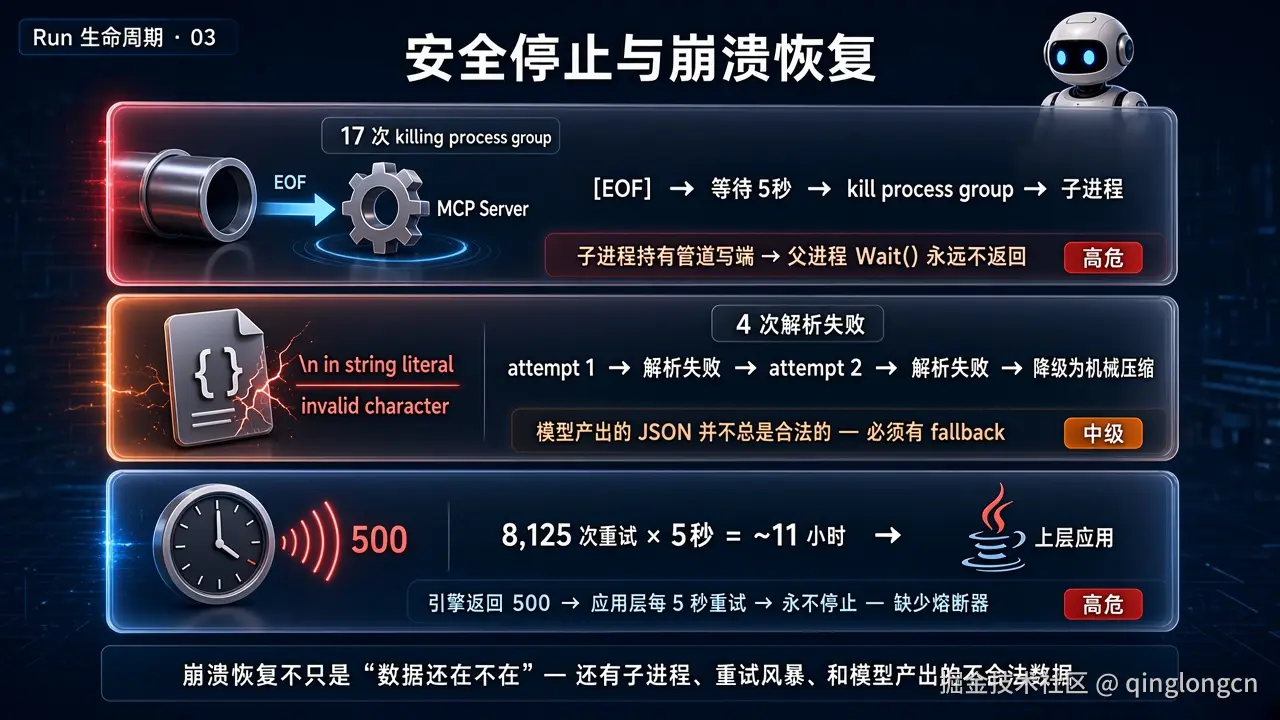
从各产品的实践和我们的教训中,提炼出五条通用原则:
| 原则 | 含义 | 违反后果 |
|---|---|---|
| 启动永远成功 | 无论之前发生什么,重启后能正常工作 | 一次崩溃 → 永久不可用 |
| 降级而非拒绝 | 部分数据损坏 → 那部分不可用,其他正常 | 追踪数据坏了 → 整个 Agent 不可用(过度惩罚) |
| 持久化在执行时而非结束时 | 每轮工具结果立即写盘,不等任务结束 | 崩溃丢失整个任务的所有工作 |
| 归档而非删除 | 不确定的数据做归档(可恢复),不做删除 | 误判导致不可逆的数据丢失 |
| 区分"读不懂"和"不存在" | 格式不认识 ≠ 数据不存在 | 版本错配导致正常数据被清理 |
Claude Code 天然满足第三条(对话历史在每轮后写入本地文件)。Cursor 通过 Apply 机制部分满足第四条(修改先 diff 再确认,Cancel = 丢弃 diff 不影响磁盘)。Temporal 通过事件溯源满足前四条。我们的引擎在企业多租户场景中把五条都做到了系统级------因为企业客户不能接受"崩溃一次就不可用",更不能接受"升级一次就丢数据"。
引用来源
本文所有数据均可通过以下链接验证。
- Amazon Kiro 删除生产环境 --- Amazon's Kiro coding agent deleted a production environment, causing a 13-hour AWS outage · AI Failure Index
- Cursor Plan Mode rm -rf 事件 --- blog.barrack.ai
- Claude Code GitHub Issues --- #47508, #86324
- Claude Code 官方文档 --- Manage sessions - Claude Code Docs
- LangGraph Persistence --- Persistence - Docs by LangChain
- LangGraph Checkpointers --- Checkpointers - Docs by LangChain
- Temporal Durable Execution --- Durable, flexible multi-agent systems | Temporal
- Microsoft Foundry Agent Recovery --- Recover long-running work after a crash (preview) - Microsoft Foundry | Microsoft Learn
- AI Agent 五阶段生命周期规范 --- geodocs.dev/ai-agents/a...
- 测试 SIGKILL 不只是 SIGTERM --- Resuming an AI Agent After a Deploy Killed It Mid-Task - DEV Community
- Agent 优雅关闭 --- Graceful Shutdown Patterns for AI Agent Systems: Why Kill Signals Corrupt Long-Running Workflows | bigyan.dev
- LLM-D 优雅关闭 --- llm-d.ai/docs/dev/op...