SeaweedFS 原理与实践:从文件上传到分布式存储
一张图片、一份文档或一段视频上传到分布式存储后,文件名由谁保存?内容放在哪台机器?增加存储节点后,系统又如何找到原来的文件?
理解 SeaweedFS,可以从两类信息入手:文件的内容 ,以及找到这些内容所需要的记录。SeaweedFS 把目录管理、卷位置管理和内容读写交给不同组件,使它们能够按需要分别扩展。
本文围绕一个通用文件 report.pdf,依次介绍对象关系、上传下载、索引定位、空间回收、接口使用和集群维护。图中的数据量与节点布局用于解释原理。具体默认值、维护功能和接口支持范围,应以实际使用的发布版本为准。
一、先分清对象、数据块、卷和存储节点
这些名字描述的是不同层次,不能相互替代。
| 名称 | 表示什么 | 谁管理 |
|---|---|---|
| Bucket | S3 接口中的桶,是对象的逻辑归属与管理边界 | S3 网关及其关联的 Filer |
| Key | 对象在桶内的名称,例如 articles/report.pdf |
S3 网关和 Filer |
| 文件 Entry | 文件属性、内容块引用等元数据记录 | Filer,持久化到 Filer Store |
| Chunk | 文件的一段内容,一个文件可以对应多个 Chunk | Filer 或相关读写路径 |
| Needle / Blob | 底层卷中存储的内容记录,可以承载一个 Chunk | Volume Server |
| Volume | 聚合许多内容记录的逻辑数据卷 | Master 跟踪位置,Volume Server 保存内容 |
| Collection | 一组 Volume 的逻辑分组 | Master 的卷拓扑及相关分配逻辑 |
| Volume Server | 运行存储服务的节点,可以承载许多 Volume | 存储进程及其本地磁盘 |
1.1 Bucket 与 Key 是访问地址
例如:
ini
Bucket = files
Key    = articles/report.pdf
S3 的对象名称可以包含 /。在对象接口中,它是 Key 的一部分,可以用来表达前缀。SeaweedFS 的 S3 网关还会把对象映射到 Filer 的目录空间,默认路径形如:
bash
/buckets/files/articles/report.pdf在标准 S3 部署中,一个 Bucket 对应一个专用 Collection。Collection 名称可能受到 Filer Group 等配置影响,因此不应只根据桶名自行拼接内部卷名。1
1.2 Collection 分组,Volume 承载内容
一个 Collection 可以有多个 Volume;一个 Volume Server 也可以同时承载不同 Collection 的卷。它们可以共享同一台服务器,但仍然属于各自的逻辑卷分组。
如果启用卷副本,同一个逻辑 Volume 会出现在多个 Volume Server 上。下面展示了一个可能的布局:
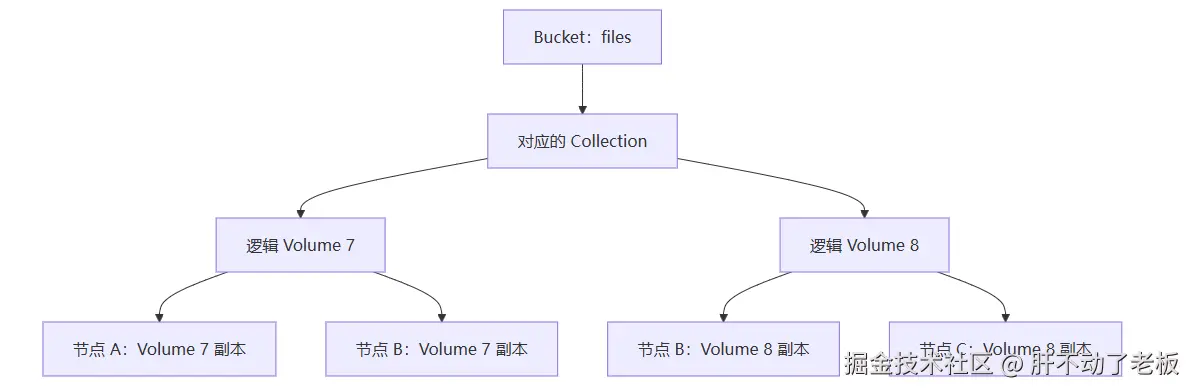 这里,节点 B 同时保存了两个不同的逻辑卷。Bucket 不是一台服务器,Volume 也不是用户看到的文件夹。 2
二、五个组件如何分工
SeaweedFS 可以分层使用。Master 与 Volume Server 构成底层 Blob 存储;Filer 在其上提供目录和文件管理;S3 网关再提供 S3 兼容接口。Filer Store 是 Filer 使用的元数据存储后端。2-1
| 组件 | 具体负责什么 | 不应与什么混淆 |
|---|---|---|
| Master | 跟踪卷的位置、容量和状态,参与文件标识与写入位置分配 | 保存每个业务文件名的目录数据库 |
| Volume Server | 读写本地卷中的内容记录,维护定位索引,执行相关存储操作 | 用户可见的 Bucket 或目录 |
| Filer | 管理目录、文件属性、Chunk 引用及相关文件操作 | 只做字符串路径转换的代理 |
| Filer Store | 持久化文件和目录元数据 | 保存全部文件内容的数据库 |
| S3 Gateway | 接收 S3 请求,处理签名和权限等接口逻辑,协调文件读写 | 对象数据的最终持久化位置 |
下图按职责展示主要关系。实线表示内容访问路径,虚线表示元数据或控制信息交互。
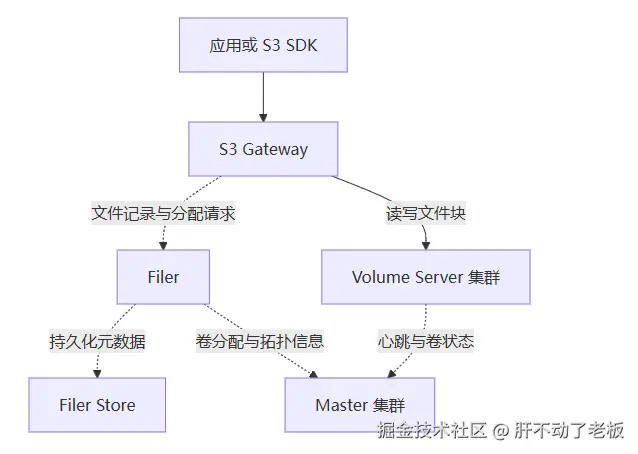
这是 S3 常见读写路径的职责图。直接使用 Filer HTTP 接口时,文件字节也可以由 Filer 接收、读取和转发。不同入口不一定经过相同的数据转发链路。
2.1 Master 为什么比较轻量
Master 主要跟踪卷,而不是为每个业务路径维护一条目录记录。文件数量增长时,Master 不必按相同数量保存文件名和路径。
卷中可以聚合很多内容记录,所以控制面通常能以较少的拓扑信息管理较多文件。不过,Master 仍有 CPU、内存、网络和调度能力上限,其容量与可用性也需要监控。
2.2 Filer 的"无状态"如何理解
Filer 进程仍然有缓存、连接、任务状态等运行时数据。部署资料中的 stateless,通常强调:持久元数据由 Filer Store 承担,可以在正确共享或同步元数据的前提下运行多个 Filer 实例。
Filer Store 可以是本地嵌入式存储,也可以是外部数据库。两个分别使用独立本地数据库的 Filer,并不会仅因为接在同一个负载均衡后面,就自动拥有完整一致的目录视图。3
2.3 组件通信不只有一种协议
组件间既有 gRPC,也有 HTTP。例如,拓扑订阅与部分内部调用使用 gRPC,而面向 Volume Server 的内容读写可以走 HTTP。不能把全部内部流量统一描述为 gRPC 长连接。4
三、一次上传和下载具体发生了什么
3.1 一个文件可以对应多个内容块
假设上传一个 12 MiB 的 report.pdf,并把该上传路径的内部块上限配置为 4 MiB。为了说明分块,可以把内容理解为 C1、C2、C3 三个块。
| 内容块 | 文件中的逻辑偏移 | 长度 | 底层位置示例 |
|---|---|---|---|
| C1 | 0 | 4 MiB | Volume 7 中的一条内容记录 |
| C2 | 4 MiB | 4 MiB | Volume 7 中的另一条内容记录 |
| C3 | 8 MiB | 4 MiB | Volume 8 中的一条内容记录 |
Filer 的文件记录保存块引用和逻辑位置等信息,读取时据此重建文件。各块是否分布在不同卷或不同机器,取决于分配策略、可写卷和副本配置,不能保证每个文件都均匀摊到全部节点上。
块很多时,实现还可以使用 Chunk Manifest 等机制管理引用;少量分块并不意味着一定额外生成一个清单块。5
3.2 上传:内容写入与元数据提交
以下时序图展示普通 S3 上传的主要步骤,省略了缓存、重试、加密、Multipart 等分支。图中 Filer 泳道包含其对 Filer Store 的访问,并不表示 Store 与 Filer 是同一个进程。
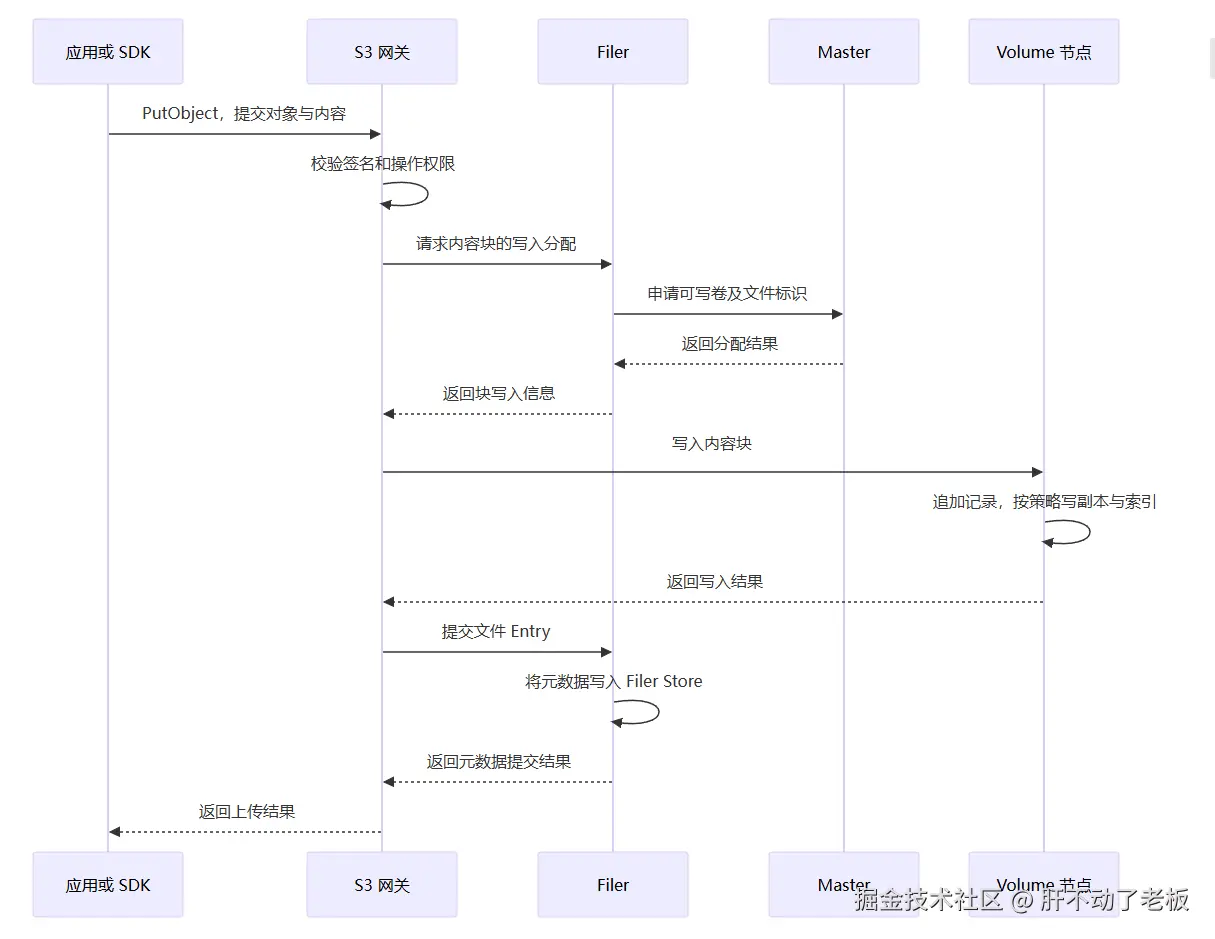 这个顺序降低了"目录已经可见、内容尚未完成写入"的风险,但内容节点、Filer Store 和业务数据库并没有因此变成一个全局事务。
例如,内容写入后元数据提交失败,可能留下需要清理的内容;服务端成功但响应在网络中丢失,客户端也可能收到超时。应用需要结合确定的对象 Key、上传状态和校验结果处理这些边界。6
另外,节点返回写入成功、所有副本确认写入,以及数据已经刷入断电后仍能保存的介质,是不同层次的问题。持久性要求需要结合 fsync 等设置、元数据持久化和故障测试一起评估。7
3.3 下载:从对象地址找到内容
下载时,网关先获取文件记录,再定位内容所在卷的可用节点。
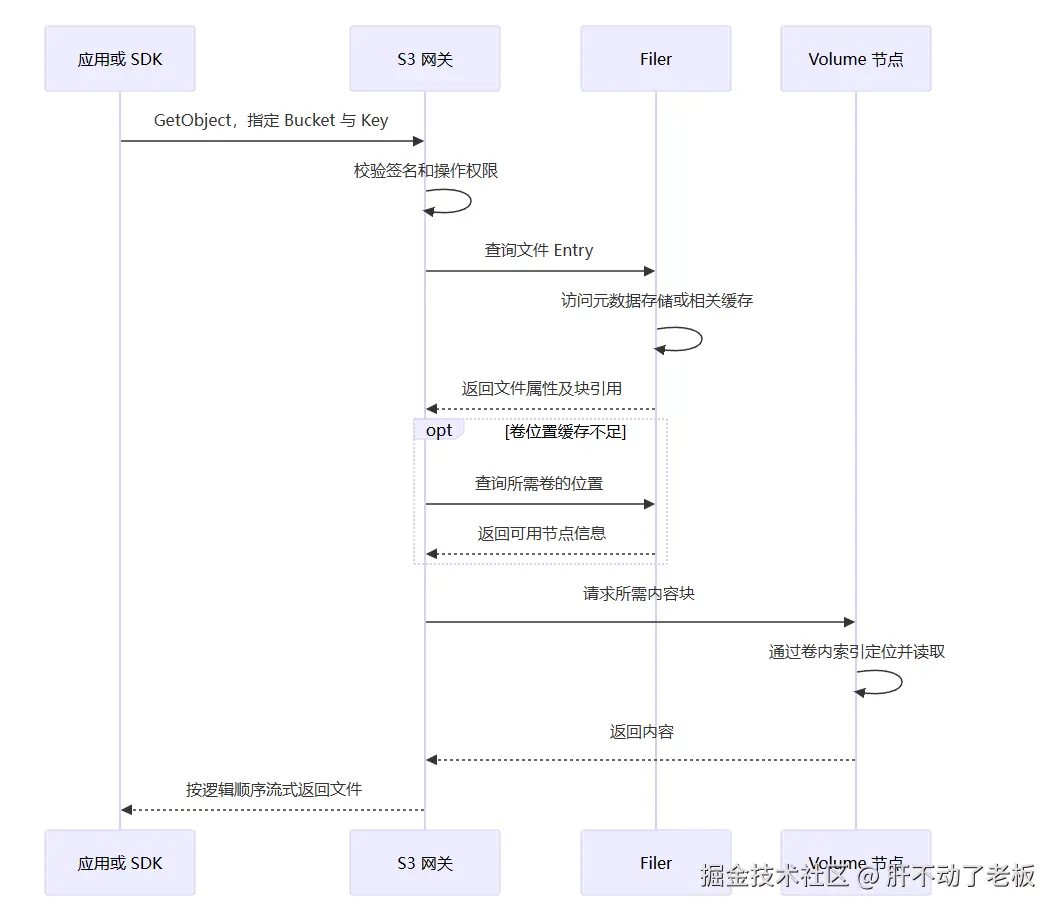 卷位置通常可以从缓存和拓扑更新中获得,必要时再查询。Master 不需要为每次下载转发文件字节。对于范围读取,读写路径可以只处理所需区间涉及的内容。8
四、为什么聚合存储有利于小文件访问
4.1 把许多内容记录写进较大的卷文件
Volume Server 将许多 Blob 组织进较大的 Volume,减少每个小对象都依赖独立操作系统文件所带来的管理开销。
普通卷的核心文件包括:
| 文件 | 作用 |
|---|---|
.dat |
保存内容记录,以及相应的记录头、校验或其他格式信息 |
.idx |
保存索引记录,帮助恢复或维护内容定位关系 |
卷还可能有辅助元信息文件、不同索引模式产生的文件及维护临时文件。因此,一个卷并不严格等于磁盘上永远只有两个文件。
常见默认卷容量上限约为 30 GB,可以通过配置调整;它也不是卷创建时必然已经占满的实际磁盘大小。当一个卷不再满足新内容分配条件时,系统会按容量和放置策略使用或创建其他可写卷,旧卷中的有效内容仍然可以读取。9
4.2 FID 是内容记录的标识
底层 Blob API 返回的 FID 通常具有这样的形式:
3,01637037d6这是官方示例中的格式。逗号前标识 Volume,逗号后编码了 File Key 和 Cookie 等部分,并非普通的十进制文件编号。
Volume Server 使用卷标识选择对应的卷,再通过 File Key 查找记录位置。Cookie 参与记录访问时的匹配校验,不能替代访问鉴权。10
4.3 "16 字节索引"与真实内存占用
在常见的 32 位偏移索引格式中,一条 .idx 记录的字段布局可以概括为:
| 字段 | 常见长度 | 用途 |
|---|---|---|
| Key | 8 字节 | 标识卷内的内容记录 |
| Offset | 4 字节 | 编码内容在数据文件中的位置 |
| Size | 4 字节 | 记录数据长度或相关状态 |
这些字段合计 16 字节。不同构建选项可能改变偏移格式;数据记录本身还有其他格式开销。
若只计算一亿条这种标准索引记录的字段字节,结果是:
css
100,000,000 × 16 B = 1,600,000,000 B
                   ≈ 1.6 GB
≈ 1.49 GiB这个计算说明索引字段较紧凑,不能直接当作一亿个文件的进程总内存预算。运行时数据结构、缓存、连接和读写缓冲区都会消耗内存;索引日志也可能包含更新或删除记录。
SeaweedFS 还支持不同的索引实现。内存索引模式可以在启动时依据持久索引重建内存定位结构,磁盘型索引则采用不同的内存与 I/O 权衡。不能把所有部署都理解为把全部索引永久放在内存里。11
4.4 O(1) 描述的是哪一层
SeaweedFS 的 O(1) 访问模型,主要描述底层 Blob 的定位优势:已知卷和记录标识后,可以通过紧凑索引找到数据位置,避免依赖深层目录查找来定位每个小对象。
一次完整下载仍可能涉及元数据库、多个 Chunk、网络传输、缓存、权限校验与存储设备。实现中的读取系统调用次数,也不能直接等同于物理磁盘 I/O 次数。
因此,性能测试要测具体工作负载:文件大小、并发、缓存命中、索引模式、副本策略以及所用硬盘都会影响结果。7-1
五、更新、删除和 Vacuum 如何衔接
5.1 追加写入如何处理更新
普通卷采用以追加写入为主的数据组织方式。这里需要区分两个层次。
| 使用方式 | 更新时的主要变化 |
|---|---|
| Raw Blob API 覆盖同一个 FID | 可以追加新记录,并使索引指向新的位置 |
| Filer / S3 覆盖同一路径或对象 | 通常写入新内容块,更新文件 Entry,再清理不再需要的旧块 |
所以,"对象名称相同"不表示底层 FID 必须保持不变。若启用版本保留,旧内容还可能继续被历史版本引用。
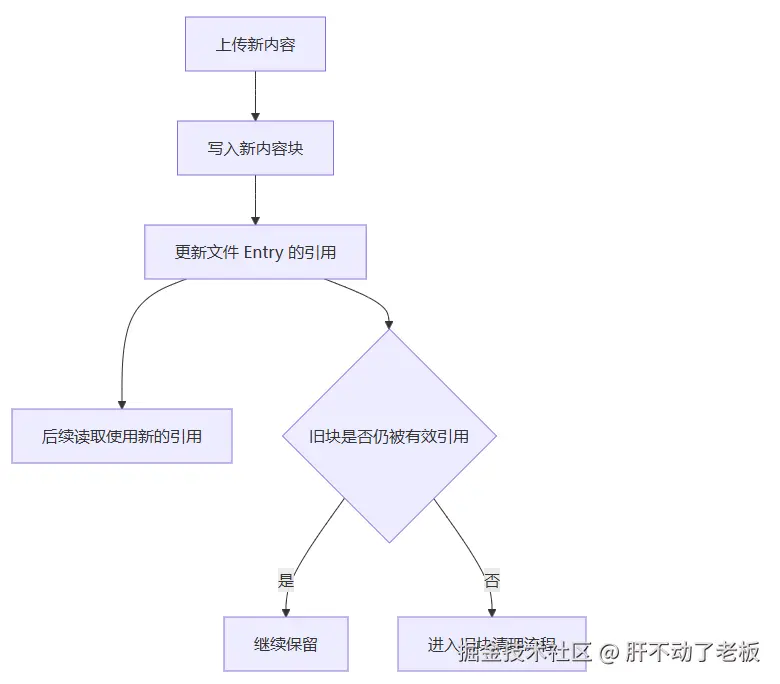
术语说明: 此处"引用"指文件、版本或存储元数据对内容块的使用关系,不表示自动具备跨文件的内容共享能力。
5.2 删除首先改变可见性和有效状态
在文件层,删除涉及移除目录或对象记录,以及后续处理内容块。在底层卷中,删除通常通过删除记录和索引状态变更,使原内容不再作为有效记录提供访问。
原来占据 .dat 的字节不一定立即从磁盘中消失。文件不可见、内容块已标记删除、磁盘空间已经释放,是三个不同的阶段。12
5.3 Vacuum 回收不再有效的空间
Vacuum 可以理解为:把一个卷里仍然有效的内容重新整理到紧凑的数据文件中,并生成与之匹配的索引,再完成切换和旧文件清理。
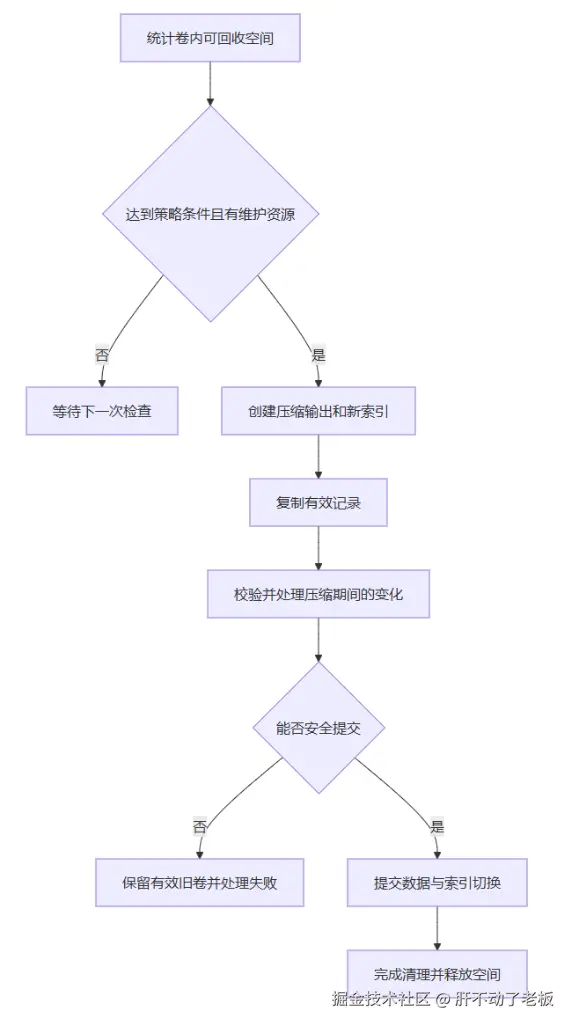 这是原理流程,具体文件后缀、扫描方式和提交协议属于实现细节。压缩可以有不同的数据扫描或索引扫描路径,并不一定只遍历一张内存表;数据与索引的提交也不能简化成一次重命名就天然获得双文件事务。
维护期间能否接收写入、如何处理新增变化和失败恢复,需要结合对应版本与卷状态理解。在线维护依然会消耗资源,不能据此承诺访问完全不受影响。13
5.4 回收空间之前,要先有工作空间
整理期间,旧数据与新输出会暂时共存。因此,磁盘余量需要覆盖压缩输出、并发维护、持续写入以及故障修复所需的临时空间。
余量应结合卷大小、存活数据比例和任务并发计算,而不是固定为每台服务器只留 32 GB。空间不足可能让压缩或写入失败,需要暂停任务、增加容量或通过受支持的方式迁移数据,不能依赖 Vacuum 在零余量下自动解围。
六、Filer Store 的元数据账本长什么样
6.1 一条文件记录包含什么
文件元数据可以包含名称、属性、时间、扩展信息和 Chunk 引用等。一个大文件可能关联多个内容块,所以文件路径与底层 FID 并不总是一对一。
以 SQL 后端的一种常见组织方式为例,可以把核心字段理解为:
| 字段 | 含义 |
|---|---|
dirhash |
父目录的哈希,用于辅助定位和索引组织 |
name |
当前文件或目录的名称 |
directory |
父目录的路径信息 |
meta |
编码后的文件属性与内容块信息 |
这是字段语义示意,不是要求手工执行的建表规范。SQL 实现可以利用父目录哈希与名称构成索引,并在查询条件中核对完整目录。真实列类型、索引、表名以及桶表策略,应以所选驱动和配置为准。14
Filer 从数据库取出 meta 后,解码为内存中的文件记录,再获得内容块引用等信息。Protobuf 编码与 gzip 压缩是不同步骤:某些实现会按条件额外压缩元数据,不能把使用 Protobuf 本身理解为始终执行高比例压缩。
6.2 并非所有后端都只有一张 filemeta
Filer 支持多种 Store,它们的组织方式并不相同。SQL 驱动可以使用默认元数据表,也可能支持按 Bucket 使用独立表;嵌入式键值存储和其他数据库则有自己的键空间设计。
因此,Bucket 是否共用一张 SQL 表,是后端实现与配置问题。Bucket 对应的 Collection,又是底层卷分组问题。数据库中的表布局与存储节点上的卷分组,需要分别理解。 3-1
6.3 数据库如何扩展
元数据查询性能受索引、缓存命中、目录分布、热点、并发和存储设备影响,不能仅根据"文件达到千万级"就保证某个固定延迟,也不能按文件数量机械决定必须更换哪一种数据库。
更合理的做法是先观察瓶颈:查询还是写入变慢?热点是否集中在少数目录?数据库缓存与 I/O 是否已经饱和?连接池是否符合该版本的访问模式?
更换 Store 时,需要验证数据迁移、事务和一致性语义、字符与排序行为,以及备份恢复流程。数据库使用相近的通信协议,并不自动意味着只改一个连接地址就能完成无风险迁移。3-2
七、通过 S3 接口使用 SeaweedFS
7.1 接口选择与业务边界
| 入口 | 适合什么需求 | 使用者需要承担什么 |
|---|---|---|
| S3 API | 对象上传、下载、范围读取、Multipart 等 | 配置 SDK,管理对象地址、权限与业务状态 |
| Filer HTTP | 直接使用目录和文件接口 | 对接 Filer 接口及其访问控制 |
| Raw Blob API | 直接管理底层 Blob | 自行保存 FID 并管理上层业务映射 |
| FUSE 等文件接口 | 需要文件路径或挂载语义的程序 | 验证接口语义、缓存、故障行为与性能 |
一般应用可以优先评估 S3 API,以复用成熟 SDK 和工具。S3 兼容意味着支持相应接口与行为,不表示 AWS S3 的每项服务、配置和策略都完全相同。应针对实际使用的功能检查支持列表并测试。1-1
7.2 Multipart Part 与内部 Chunk
S3 Multipart 把一次上传分成多个 Part,便于并发传输和失败重试;内部 Chunk 描述存储系统如何组织文件内容。一个 Part 与一个 Chunk 不必一一对应。
客户端通常需要管理 uploadId、Part 编号和完成信息,成功后提交 Complete,废弃时执行 Abort。内部 Chunk 的引用和重建由存储路径处理。ETag、分片组合校验值与普通整文件摘要也不能混为一谈。15
7.3 预签名 URL 如何工作
预签名 URL 把特定对象、HTTP 操作、时间条件和签名信息放入 URL,让接收者在授权范围内发起访问。
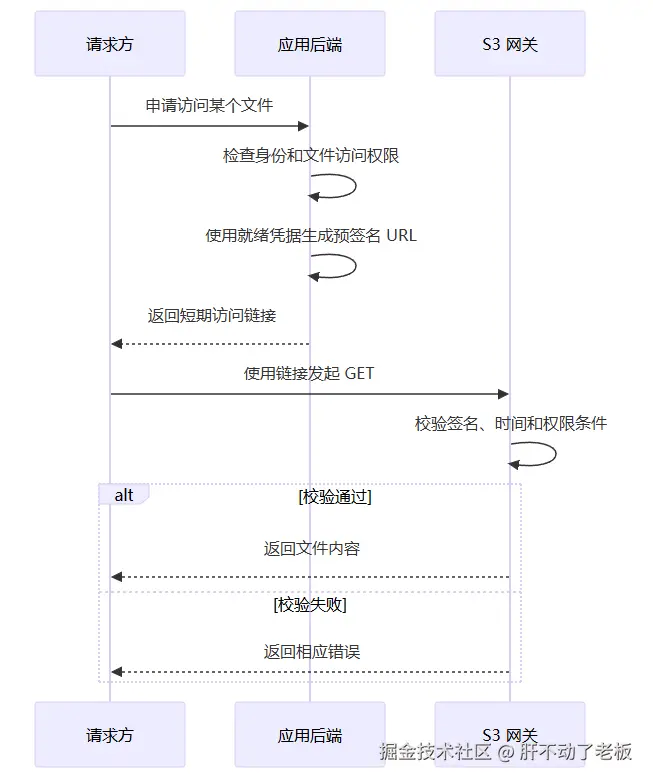 凭据和签名参数已经就绪时,SDK 通常可以本地生成 URL,不必为"签名"这一步先请求对象存储。但凭据刷新或其他准备过程仍可能产生网络请求,生成链接也不代表已经验证文件存在。
签名提供完整性与授权校验,不负责把文件内容加密。传输保护应使用 HTTPS。持有有效预签名链接的人通常可以使用它,所以链接需要避免泄露到公开日志或不受控渠道;"链接未被篡改"不等于"只有原接收者才能访问"。16
7.4 一个精简的 Python 示例
以下示例使用 boto3,演示 S3 兼容端点、显式签名设置与临时下载链接。环境变量中的地址和凭据由部署环境提供,目标 Bucket 需要已经存在。
ini
import os

import boto3
from botocore.config import Config

s3 = boto3.client(
    "s3",
    endpoint_url=os.environ["S3_ENDPOINT"],
    region_name=os.environ.get("S3_REGION", "us-east-1"),
    aws_access_key_id=os.environ["S3_ACCESS_KEY"],
    aws_secret_access_key=os.environ["S3_SECRET_KEY"],
    aws_session_token=os.environ.get("S3_SESSION_TOKEN"),
    config=Config(
        signature_version="s3v4",
        s3={"addressing_style": "path"},
    ),
)

bucket = "files"
key = "articles/report.pdf"

s3.upload_file("report.pdf", bucket, key)

download_url = s3.generate_presigned_url(
    "get_object",
    Params={"Bucket": bucket, "Key": key},
    ExpiresIn=600,
)
这里采用 path-style 寻址,Region 的默认字符串是示例配置。真实环境还要验证凭据类型、端点、代理、签名范围及所用 SDK 版本的行为。
长期保存的文件地址应使用 Bucket、Key,必要时再加 Version ID。临时 URL 可以按需生成,不宜作为文件永久定位信息。
7.5 如何排查签名失败
SigV4 会对请求的重要部分进行规范化并签名。常见排查顺序是:
- 确认 Access Key、Secret Key,以及临时凭据所需的 Session Token 是否完整且有效。
- 确认客户端和网关时间同步,Region 与签名配置相符。
- 确认签名时使用的 Host、端口、路径和查询参数,与网关验证时使用的信息一致。
- 检查反向代理的转发头、外部地址配置和路径重写。
- 按 SDK 与服务端版本验证上传流式编码、校验头和 Multipart 行为。
部署可以使用 NTP 或 chrony 保持时钟同步。时间容差、URL 到期和凭据有效期是相关但不同的条件,不宜用一个固定分钟数概括全部校验。17
八、部署、扩容与日常维护
8.1 服务角色与物理机器分别规划
同一个 weed 程序可以启动不同角色,也可以在单机组合运行多个角色。学习和功能验证可以从单机开始;生产部署则需要根据故障域、资源竞争和可用性目标安排。
下面是一种参考布局,强调职责和故障域,并非固定的机器配比:
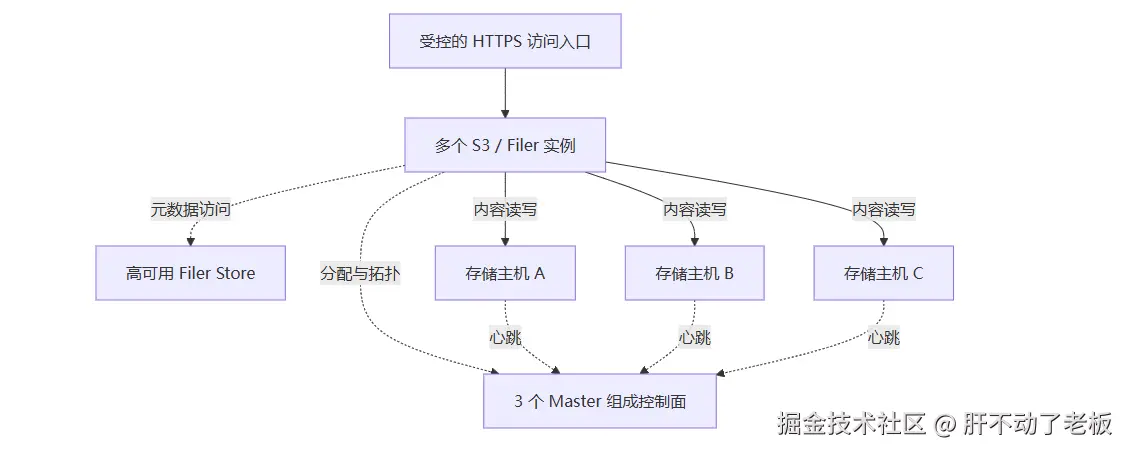 Master 需要稳定的运行环境、网络与状态目录;Volume Server 需要按吞吐、索引、复制和维护负载规划 CPU、内存与磁盘;Filer 和 S3 网关则需要同时关注元数据访问、网络与并发资源。
分开部署有助于隔离故障和竞争,但不等于所有规模都必须为每个角色单独购买一台物理机。共享主机时,应明确资源限制、持久化目录和故障影响。18
常见默认端口如下,实际均应结合启动参数和访问策略确认:
| 组件 | HTTP 端口 | gRPC 端口 |
|---|---|---|
| Master | 9333 | 19333 |
| Volume Server | 8080 | 18080 |
| Filer | 8888 | 18888 |
| S3 Gateway | 8333 | --- |
对外可以通过统一 HTTPS 地址提供所需接口;数据库、存储内部接口和管理面应限制在受控网络中。
8.2 容量扩展与卷分配
增加一个 Volume Server,可以向集群提供新的卷槽和磁盘容量。节点注册后,Master 根据拓扑、Collection、副本和可写卷等条件参与分配。
新增节点不要求立即把全部历史数据重新搬迁。已有可写卷仍可能接收新内容,因此下一次上传不一定立刻写到新节点。是否迁移旧卷、如何平衡容量和访问负载,可以交给配置后的维护任务或受控操作处理。19
-max 用于控制数据目录的卷数量上限,当前实现也支持用 0 按可用空间估算。规划时还要考虑卷容量、多个目录是否共用物理磁盘,以及压缩和修复余量,不能只计算"硬盘容量除以固定卷大小"。9-1
8.3 控制面高可用与内容副本
多 Master 通过 Raft 维持相应控制状态和 Leader。典型高可用配置使用 3 个 Master,保持多数派才能完成相关控制操作。选举与恢复耗时受到版本、配置和网络影响。
控制面故障、元数据库故障与内容副本故障的影响不同。即使 Master 暂时无法完成分配,部分已有对象仍可能依靠缓存位置和存活副本读取,不能把所有故障统一理解为整个系统立即停止。20
普通卷的副本数量可以用三位编码指定。例如 001 表示原件加一份副本,总共两份;同一逻辑卷的副本保存在哪些机器或机架,需要结合物理故障域正确配置。
副本确认成功与刷盘持久性应分别验证。节点失联后,Master 可以更新拓扑;补齐副本则需要相应命令或已配置的维护流程,不能假设每次短暂断连都会立刻触发全量复制。21
8.4 日常运维关注什么
| 观察对象 | 重点指标 | 常见动作 |
|---|---|---|
| 接口访问 | 成功率、错误类型、读写延迟 | 关联请求日志,定位入口或后端问题 |
| 磁盘与卷 | 空间、I/O、可写卷、卷分布、副本缺失 | 提前扩容、修复副本、调整放置 |
| 元数据服务 | 查询与写入延迟、热点、数据库可用性 | 调整访问模式、容量、缓存与连接配置 |
| 维护任务 | Vacuum、迁移、修复等进度与资源消耗 | 设置并发、速率、时间窗并核验结果 |
| 备份 | 最近成功时间、滞后、完整性和恢复耗时 | 补齐备份并定期恢复演练 |
较新版本提供 Admin 与 Worker 协作的维护机制:Admin 协调任务,Worker 检测或执行相应工作,并报告进度。部署时需要审核启用的任务类型和策略,尤其是压缩、迁移和其他资源消耗较大的任务。22
对象浏览工具可以辅助上传和下载,但不能替代集群监控、卷维护、数据库管理与备份恢复。选择图形客户端时,应分别检查语言、许可证、签名支持和功能兼容性。
8.5 备份需要保住完整的查找链路
在线副本主要用于应对部分节点或介质故障。历史恢复还需要独立的备份策略,因为误删和错误更新也可能传播到在线系统。
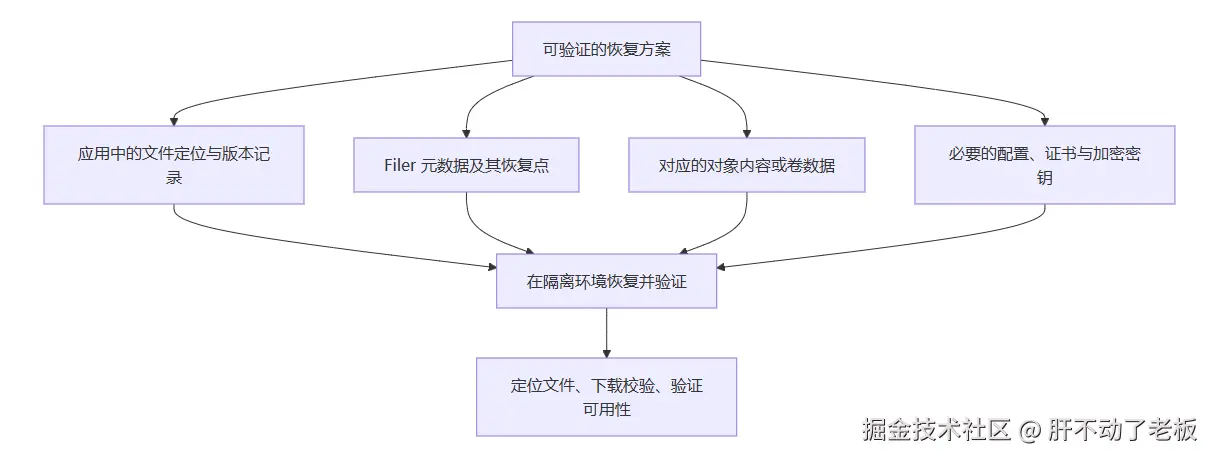 S3 对象级备份与卷级备份的恢复路径不同,应选择适合的方案并验证元数据与内容能够对应。活跃数据也需要纳入保护,不能只备份已经写满的冷卷。
备份周期和保留策略由 RPO 与 RTO 决定:前者表示允许丢失多长时间的数据,后者表示服务需要在多长时间内恢复。备份是否成功,最终应通过真实恢复来验证。23
参考资料
以下资料包含官方架构说明、接口文档和实现源码。部分 Wiki 与主分支会持续更新,涉及实现细节时应同时查看所用发布版本。
- SeaweedFS 官方:Amazon S3 API,包括桶到 Filer 路径、Collection 的映射与接口支持情况。↩︎↩︎
- SeaweedFS 官方:Components。↩︎↩︎
- SeaweedFS 官方:Filer Stores;Directories and Files。↩︎↩︎↩︎
- SeaweedFS 官方:HTTP REST API。↩︎
- SeaweedFS 源码:Filer 参数;Chunk Manifest。↩︎
- SeaweedFS 源码:S3 对象写入。↩︎
- SeaweedFS 维护者讨论:读取、索引与 fsync 语义。↩︎↩︎
- SeaweedFS 源码:S3 对象读取;官方 Directories and Files。↩︎
- SeaweedFS 官方:Production Setup;源码 Volume 参数。↩︎↩︎
- SeaweedFS 官方:Blob Store Architecture。↩︎
- SeaweedFS 源码:存储类型;索引实现。↩︎
- SeaweedFS 源码:卷写入与删除。↩︎
- SeaweedFS 源码:卷压缩。↩︎
- SeaweedFS 源码快照:SQL Store,涉及默认表、桶表和元数据编码。其他后端应查看各自驱动实现。↩︎
- AWS 官方:Multipart upload overview;Checking object integrity。实际支持能力仍需核对 SeaweedFS 版本。↩︎
- AWS 官方:Download and upload objects with presigned URLs;Boto3 官方:Presigned URLs。↩︎
- SeaweedFS 官方:S3 Nginx Proxy。↩︎
- SeaweedFS 官方:Production Setup。↩︎
- SeaweedFS 官方:Volume Management。↩︎
- SeaweedFS 官方:Failover Master Server;源码 Master 启动与配置。↩︎
- SeaweedFS 官方:Replication。↩︎
- SeaweedFS 官方:Worker。↩︎
- SeaweedFS 官方:Async Filer Metadata Backup;Async Backup。↩︎