后端 Web 实战:员工管理模块(多表关系 + 多表查询 + 分页查询 + 条件分页)
大家好!上一篇我们完成了部门管理的增删改查,这一篇继续推进 Tlias 智能学习辅助系统的第二个模块------员工管理 。从页面原型可以看到,查询员工列表时除了要展示员工基本信息,还要带出所属部门名称 ,数据横跨
dept和emp两张表,这就牵出了今天的主线:多表关系 (一对多 / 一对一 / 多对多 + 外键约束)→ 多表查询 (笛卡尔积 / 内连接 / 外连接 / 子查询)→ 员工列表查询(准备工作 / 分页查询 / 条件分页查询,含 PageHelper 分页插件与 MyBatis 动态 SQL)。
一、前言
实现了部门管理之后,接下来我们来实现员工管理的功能。先看员工列表查询的页面原型:
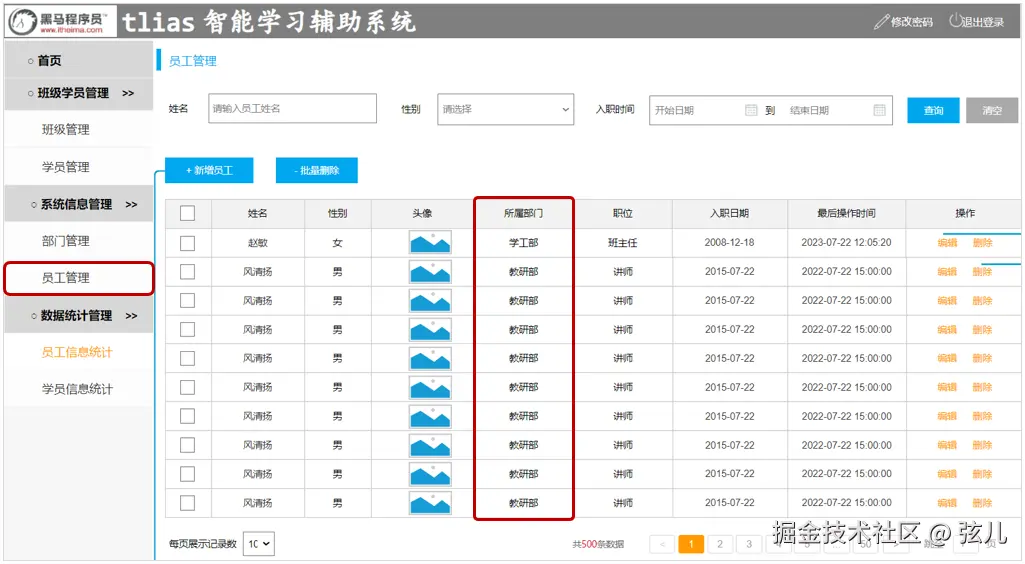
从页面原型可以看到,查询员工信息时,除了要展示姓名、性别、头像、职位、入职日期、最后操作时间这些员工信息外,还要展示出所属部门 ,那此时就需要从两张表中查询数据------一张是部门表,一张是员工表,这就涉及到了多表操作。所以今天的课程内容如下:
✅ 课程内容
- 多表关系
- 多表查询
- 员工列表查询
二、多表关系
项目开发中,进行数据库表结构设计时,会根据业务需求及业务模块之间的关系,分析并设计表结构。由于业务之间相互关联,各个表结构之间也存在着各种联系,基本上分为三种:
- 一对多(多对一)
- 多对多
- 一对一
2.1 一对多
场景:部门与员工的关系(一个部门下有多个员工)。
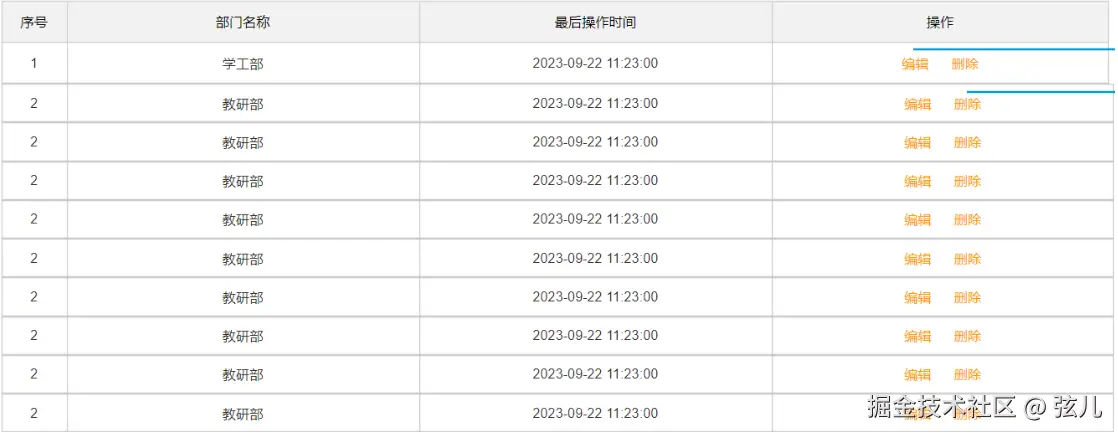
部门管理的页面原型:
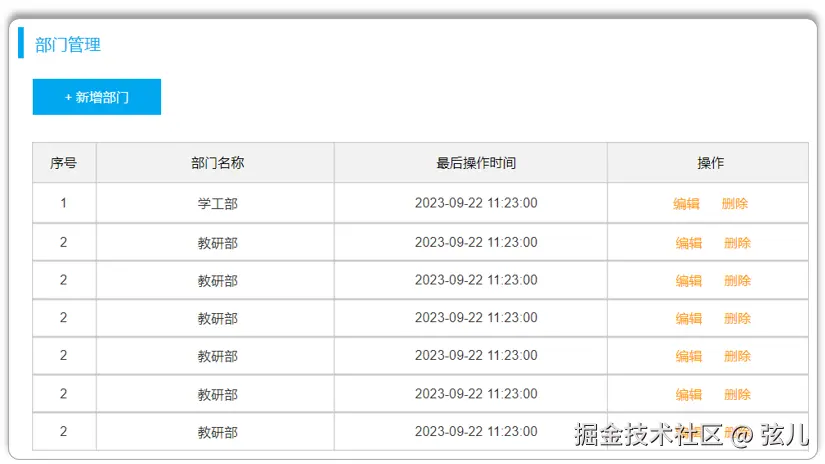
员工管理的页面原型:
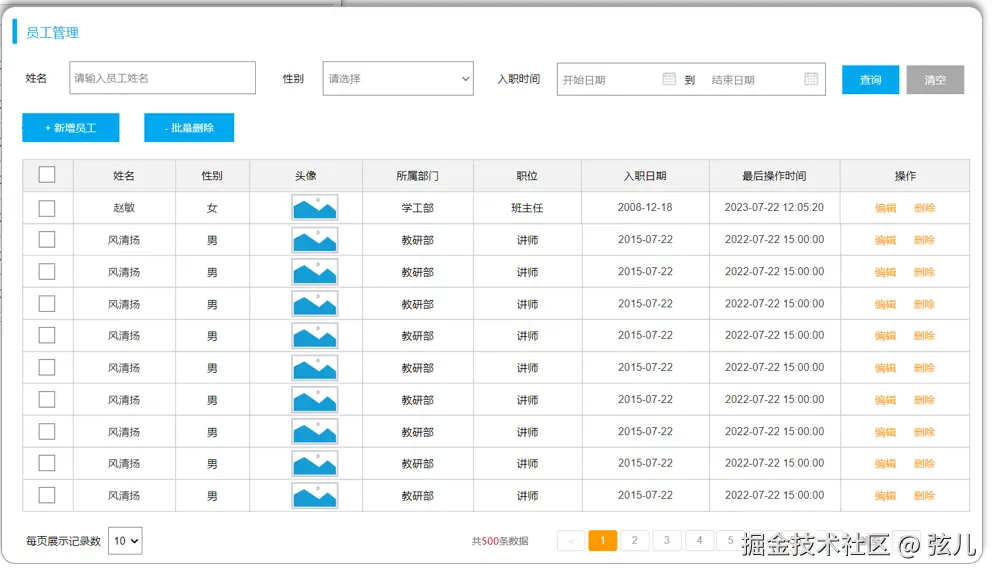
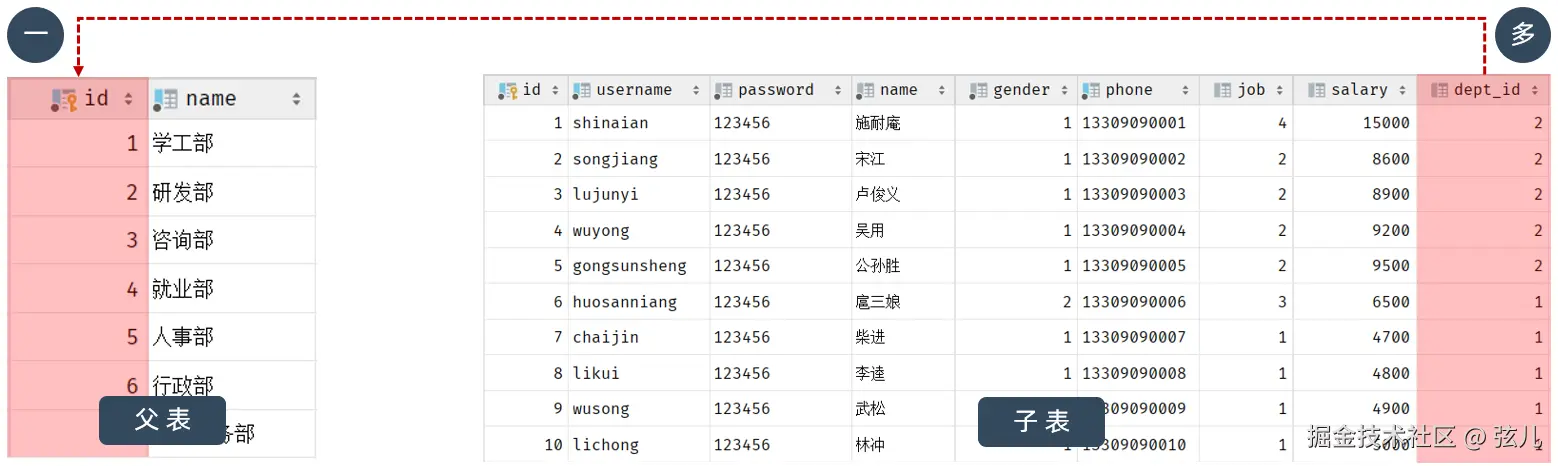
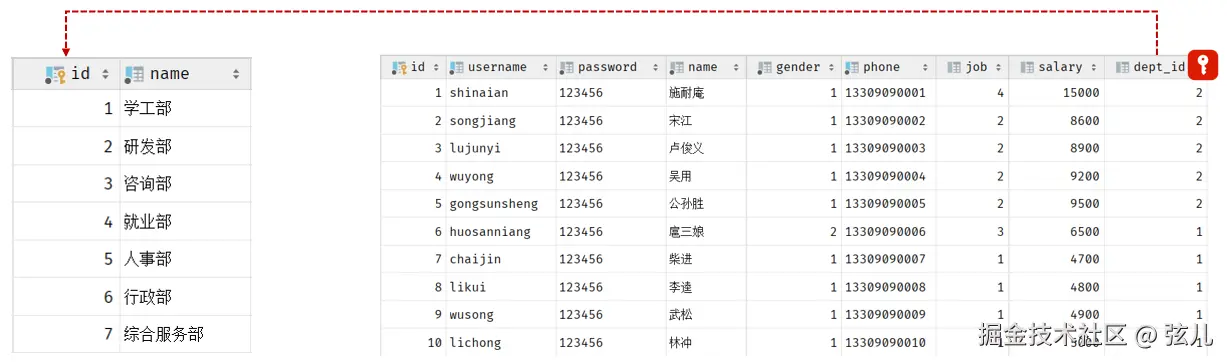
由于一个部门下会关联多个员工,而一个员工归属于某一个部门,那么此时我们就需要在 emp 表中增加一个字段 dept_id 来标识这个员工属于哪一个部门,dept_id 关联的是 dept 表的 id:
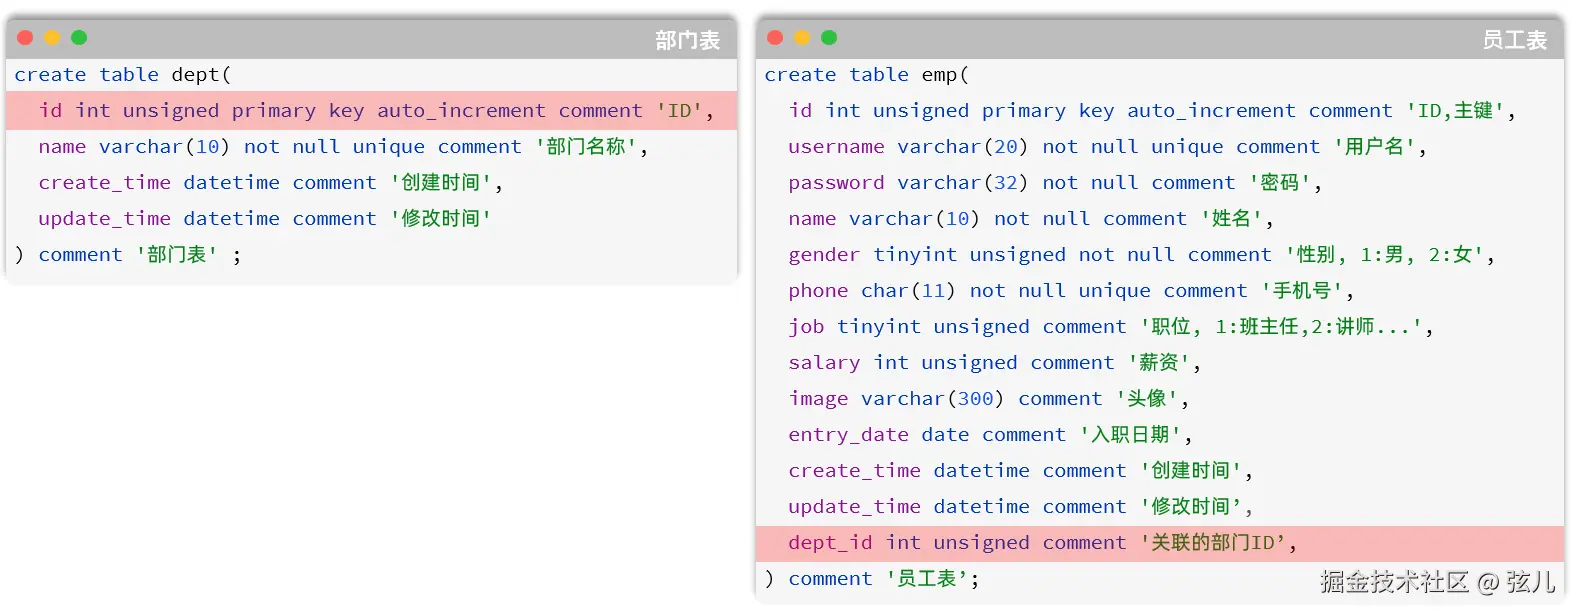
上述 emp 员工表的 dept_id 字段,关联的是 dept 部门表的 id。部门表是一的一方,也称为父表 ;员工表是多的一方,称之为子表:
接下来,把两张表创建出来,SQL 语句如下:
sql
CREATE TABLE dept (
  id int unsigned PRIMARY KEY AUTO_INCREMENT COMMENT 'ID, 主键',
  name varchar(10) NOT NULL UNIQUE COMMENT '部门名称',
  create_time datetime DEFAULT NULL COMMENT '创建时间',
  update_time datetime DEFAULT NULL COMMENT '修改时间'
) COMMENT '部门表';

INSERT INTO dept VALUES (1,'学工部','2024-09-25 09:47:40','2023-04-25 09:47:40'),
                      (2,'教研部','2024-09-25 09:47:40','2024-10-09 15:17:04'),
                      (3,'咨询部2','2024-09-25 09:47:40','2024-11-30 21:26:24'),
                      (4,'就业部','2024-09-25 09:47:40','2024-09-25 09:47:40'),
                      (5,'人事部','2024-09-25 09:47:40','2024-09-25 09:47:40'),
                      (6,'行政部','2024-11-30 20:56:37','2024-11-30 20:56:37');

create table emp(
    id int unsigned primary key auto_increment comment 'ID,主键',
    username varchar(20) not null unique comment '用户名',
    password varchar(50) default '123456' comment '密码',
    name varchar(10) not null comment '姓名',
    gender tinyint unsigned not null comment '性别, 1:男, 2:女',
    phone char(11) not null unique comment '手机号',
    job tinyint unsigned comment '职位, 1 班主任, 2 讲师, 3 学工主管, 4 教研主管, 5 咨询师',
    salary int unsigned comment '薪资',
    image varchar(300) comment '头像',
    entry_date date comment '入职日期',
    dept_id int unsigned comment '部门ID',
    create_time datetime comment '创建时间',
    update_time datetime comment '修改时间'
) comment '员工表';

INSERT INTO emp VALUES
    (1,'shinaian','123456','施耐庵',1,'13309090001',4,15000,'5.png','2000-01-01',2,'2023-10-20 16:35:33','2023-11-16 16:11:26'),
    (2,'songjiang','123456','宋江',1,'13309090002',2,8600,'01.png','2015-01-01',2,'2023-10-20 16:35:33','2023-10-20 16:35:37'),
    (3,'lujunyi','123456','卢俊义',1,'13309090003',2,8900,'01.png','2008-05-01',2,'2023-10-20 16:35:33','2023-10-20 16:35:39'),
    -- ...(水浒人物测试数据,此处省略部分行)
    (36,'linghuchong','123456','令狐冲',1,'18809091212',2,6800,'1.png','2023-10-19',2,'2023-10-20 20:44:54','2023-11-09 09:41:04');
✅ 问题:一对多的表关系,在数据库层面该如何实现? 在数据库表中多的一方 ,添加字段,来关联一的一方的主键。
2.2 多表问题分析
问题
表结构创建完毕后,两张表的数据分别为:
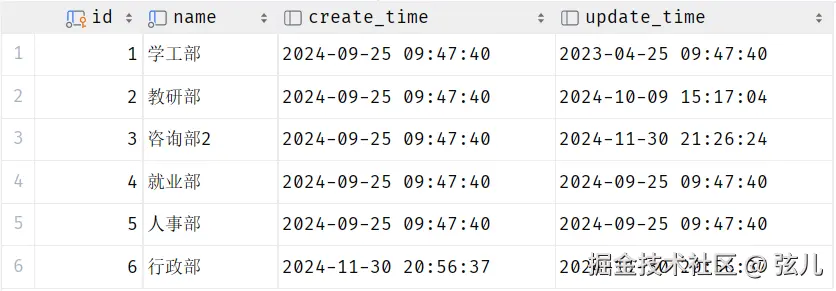
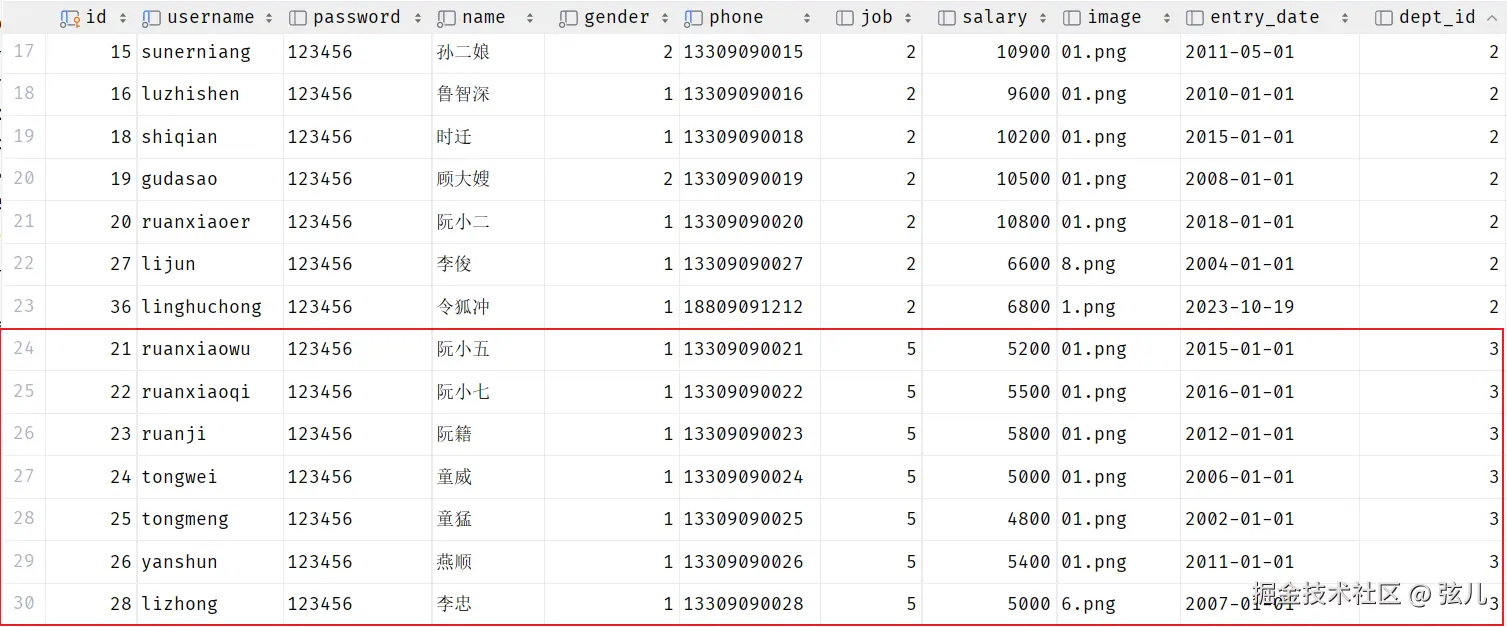
可以看到,3 号部门下关联着 7 个员工。当删除 3 号部门后,数据变为:
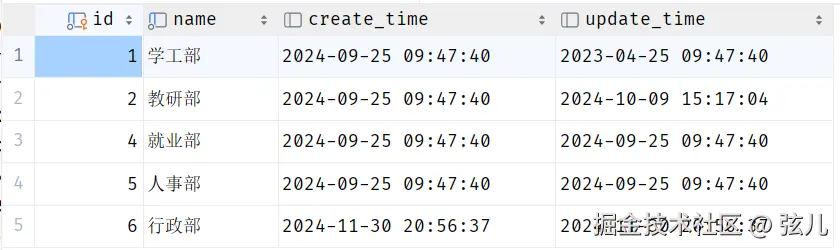
3 号部门被删除了,但依然还有 7 个员工属于 3 号部门,此时就出现了数据的不完整、不一致问题。
分析
- 现象:部门数据可以直接删除,然而还有部分员工归属于该部门下,出现数据的不完整、不一致问题;
- 原因:目前两张表在数据库层面并未建立关联,所以无法保证数据的一致性和完整性;
- 解决方案 :通过数据库中的外键约束来解决。
✅ 外键约束:让两张表的数据建立连接,保证数据的一致性和完整性。 对应的关键字:
foreign key
外键约束的语法:
sql
-- 创建表时指定
create table 表名(
        字段名    数据类型,
        ...
        [constraint]   [外键名称]  foreign  key (外键字段名)   references   主表 (主表列名)
);

-- 建完表后,添加外键
alter table  表名  add constraint  外键名称  foreign key(外键字段名) references 主表(主表列名);
接下来,为员工表的 dept_id 建立外键约束,关联部门表的主键。添加外键约束时,得保证当前数据库表中的数据是完整的,所以需要先将之前删除掉的数据添加回来。
方式 1:通过 SQL 语句操作
sql
-- 修改表:添加外键约束
alter table emp add constraint fk_dept_id foreign key (dept_id) references dept(id);
方式 2:图形化界面操作
在左侧菜单栏,在 emp 表上右键,选择 modify Table... (old UI):
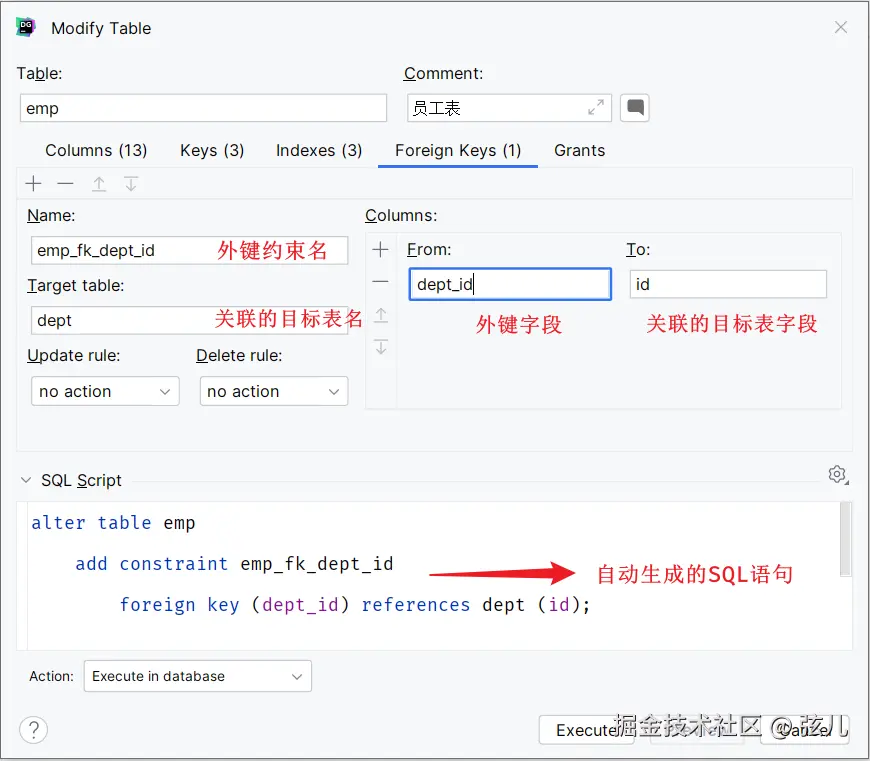
添加了外键之后,再删除 ID 为 3 的部门,就会发现数据库报错,不允许删除:
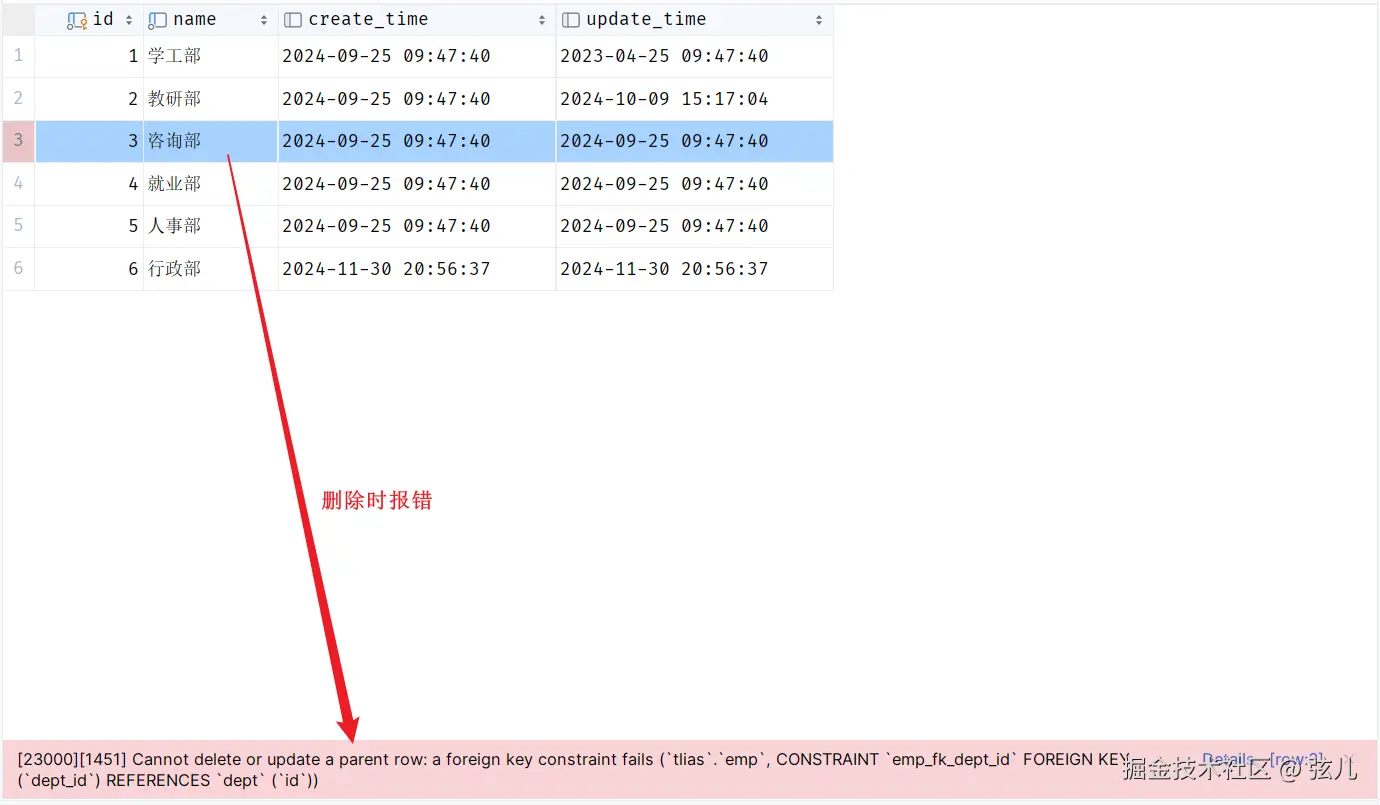
外键约束(foreign key)保证了数据的完整性和一致性。
物理外键与逻辑外键
- 物理外键
- 概念:使用
foreign key定义外键关联另外一张表; - 缺点:
- 影响增、删、改的效率(需要检查外键关系);
- 仅用于单节点数据库,不适用于分布式、集群场景;
- 容易引发数据库的死锁问题,消耗性能。
- 概念:使用
- 逻辑外键
- 概念:在业务层逻辑中解决外键关联;
- 通过逻辑外键,可以很方便地解决上述问题。
📌 注意: 在现在的企业开发中,很少会使用物理外键,都是使用逻辑外键。甚至在一些数据库开发规范中,会明确指出禁止使用物理外键
foreign key。
2.3 一对一
一对一关系在实际开发中应用比较简单,通常是用来做单表的拆分------将一张大表拆分成两张小表,把大表中的一些基础字段放在一张表,其他字段放在另一张表,以此来提高数据的操作效率。
一对一的应用场景:用户表(基本信息 + 身份信息):
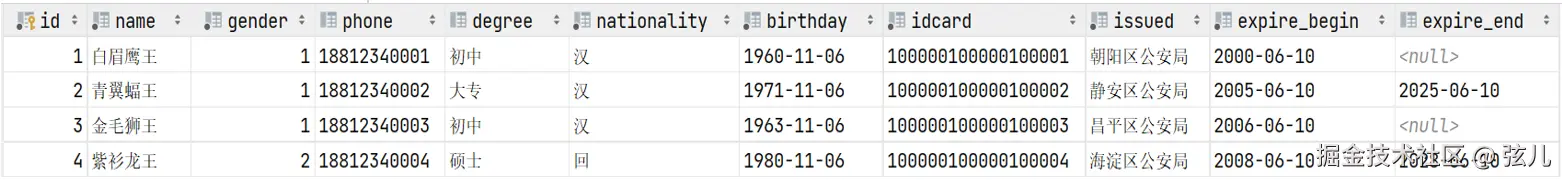
- 基本信息:用户的 ID、姓名、性别、手机号、学历
- 身份信息:民族、生日、身份证号、身份证签发机关、身份证的有效期(开始时间、结束时间)
如果业务系统中对用户的基本信息查询频率特别高,而对身份信息查询频率很低,出于提高查询效率的考虑,就可以把这张大表拆分成两张小表:一张存放用户基本信息,一张存放身份信息。二者是一对一关系------一个用户只能对应一个身份证,一个身份证也只能关联一个用户。
那在数据库层面怎么体现一对一关系呢?其实一对一可以看成一种特殊的一对多 :一对多是在多的一方添加外键,同理,一对一只需要在任意一方添加一个外键即可:
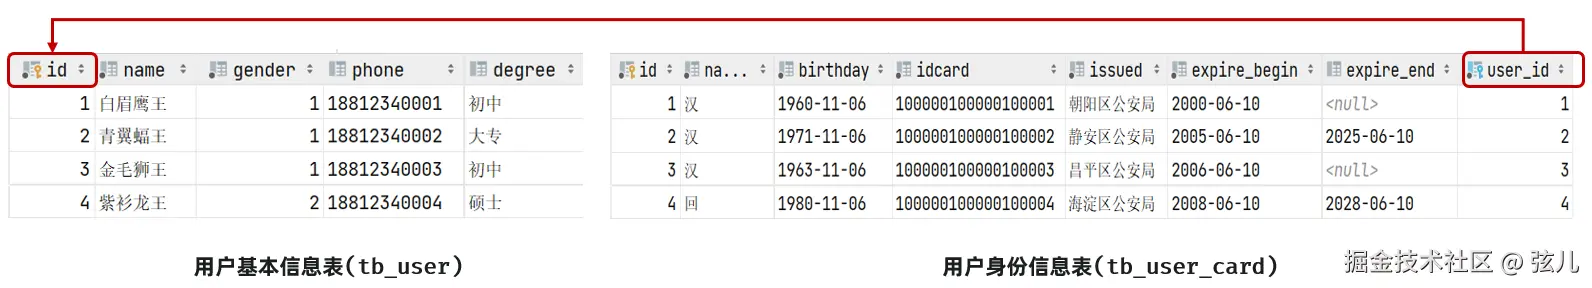
SQL 脚本:
sql
-- 用户基本信息表
create table tb_user(
    id int unsigned primary key auto_increment comment 'ID',
    name varchar(10) not null comment '姓名',
    gender tinyint unsigned not null comment '性别, 1 男  2 女',
    phone char(11) comment '手机号',
    degree varchar(10) comment '学历'
) comment '用户基本信息表';
-- 测试数据
insert into tb_user values (1,'白眉鹰王',1,'18812340001','初中'),
                        (2,'青翼蝠王',1,'18812340002','大专'),
                        (3,'金毛狮王',1,'18812340003','初中'),
                        (4,'紫衫龙王',2,'18812340004','硕士');

-- 用户身份信息表
create table tb_user_card(
    id int unsigned primary key auto_increment comment 'ID',
    nationality varchar(10) not null comment '民族',
    birthday date not null comment '生日',
    idcard char(18) not null comment '身份证号',
    issued varchar(20) not null comment '签发机关',
    expire_begin date not null comment '有效期限-开始',
    expire_end date comment '有效期限-结束',
    user_id int unsigned not null unique comment '用户ID',
    constraint fk_user_id foreign key (user_id) references tb_user(id)
) comment '用户身份信息表';
-- 测试数据
insert into tb_user_card values (1,'汉','1960-11-06','100000100000100001','朝阳区公安局','2000-06-10',null,1),
        (2,'汉','1971-11-06','100000100000100002','静安区公安局','2005-06-10','2025-06-10',2),
        (3,'汉','1963-11-06','100000100000100003','昌平区公安局','2006-06-10',null,3),
        (4,'回','1980-11-06','100000100000100004','海淀区公安局','2008-06-10','2028-06-10',4);
✅ 一对一:在任意一方加入外键,关联另外一方的主键,并且设置外键为唯一的(UNIQUE)
2.4 多对多
多对多关系在开发中也很常见,比如:学生和老师的关系(一个学生可以有多个授课老师,一个老师也可以有多个学生);学生和课程的关系(一个学生可以选修多门课程,一门课程也可以供多个学生选修)。
案例:学生与课程的关系
- 关系:一个学生可以选修多门课程,一门课程也可以供多个学生选择;
- 实现关系:建立第三张中间表 ,中间表至少包含两个外键,分别关联两方主键。
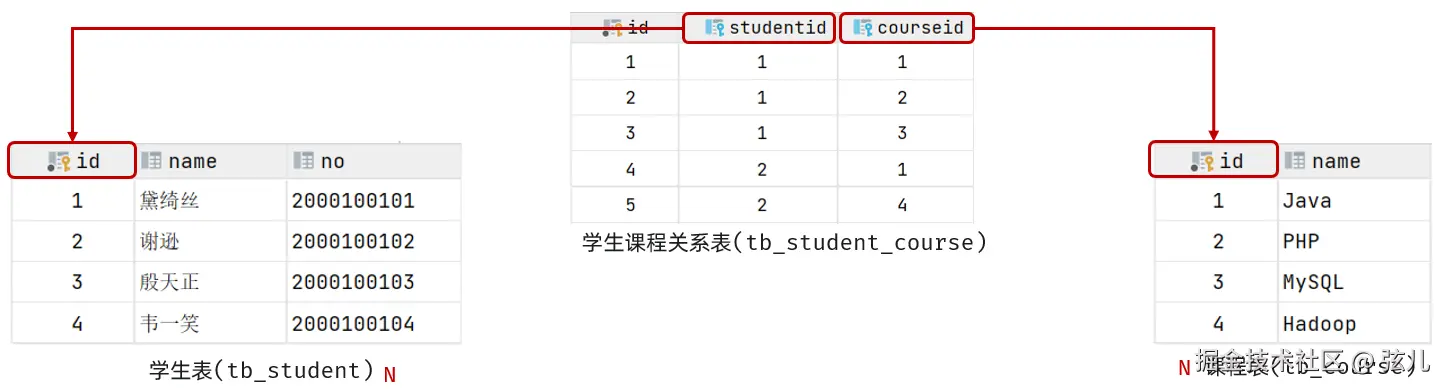
SQL 脚本:
sql
-- 学生表
create table tb_student(
    id int auto_increment primary key comment '主键ID',
    name varchar(10) comment '姓名',
    no varchar(10) comment '学号'
) comment '学生表';
-- 测试数据
insert into tb_student(name, no) values ('黛绮丝', '2000100101'),
                                        ('谢逊', '2000100102'),
                                        ('殷天正', '2000100103'),
                                        ('韦一笑', '2000100104');

-- 课程表
create table tb_course(
   id int auto_increment primary key comment '主键ID',
   name varchar(10) comment '课程名称'
) comment '课程表';
-- 测试数据
insert into tb_course (name) values ('Java'), ('PHP'), ('MySQL'), ('Hadoop');

-- 学生课程表(中间表)
create table tb_student_course(
   id int auto_increment comment '主键' primary key,
   student_id int not null comment '学生ID',
   course_id  int not null comment '课程ID',
   constraint fk_courseid foreign key (course_id) references tb_course (id),
   constraint fk_studentid foreign key (student_id) references tb_student (id)
)comment '学生课程中间表';

-- 测试数据
insert into tb_student_course(student_id, course_id) values (1,1),(1,2),(1,3),(2,2),(2,3),(3,4);
✅ 多对多:需要建立一张中间表,中间表中有两个外键字段,分别关联两方的主键。
2.5 案例
通过一个综合案例加深对多表关系的理解,并掌握多表设计的流程。
需求:根据参考资料中提供的《Tlias 智能学习辅助系统》页面原型,设计员工管理模块涉及到的表结构。
步骤:
- 阅读页面原型及需求文档,分析各个模块涉及到的表结构,及表结构之间的关系;
- 根据页面原型及需求文档,分析各个表结构中具体的字段及约束。
分析:涉及到的模块有------
- 部门管理:涉及一张部门表,前面已经设计过了,无需再设计:
- 员工管理:
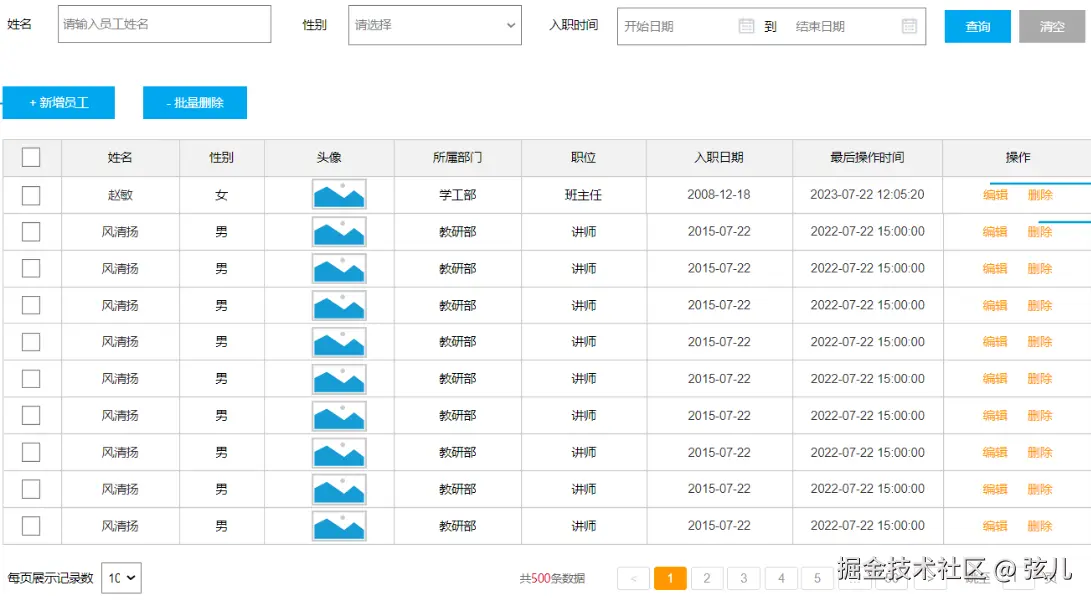
在员工列表查询的页面原型中,点击「新增员工」按钮,会弹出一个新增员工的表单:
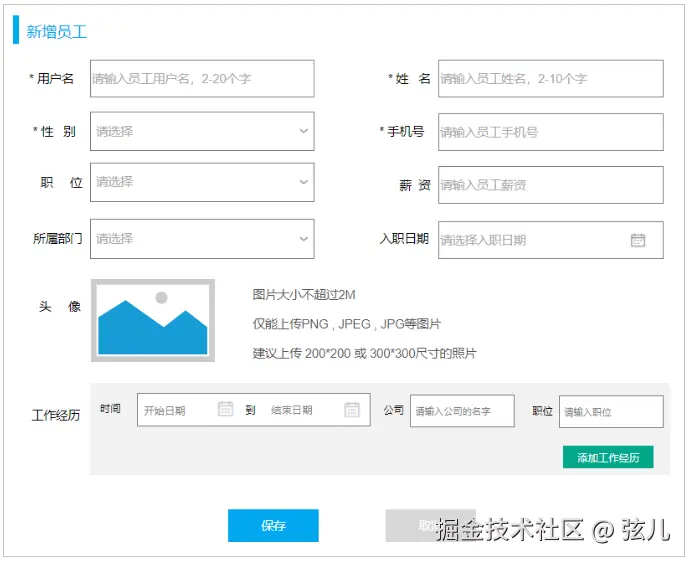
从页面原型可以看到:
- 每一个员工归属于某一个部门,一个部门下可以有多个员工,所以部门与员工是一对多关系;
- 员工还有工作经历 信息,每个员工可以添加多个工作经历,所以工作经历可以设计成一张表,员工与工作经历是一对多关系。
那么这里总共会涉及三张表:部门表、员工表、员工工作经历表。最终的表结构如下:
sql
-- 部门表
create table dept (
  id int unsigned PRIMARY KEY AUTO_INCREMENT COMMENT 'ID, 主键',
  name varchar(10) NOT NULL UNIQUE COMMENT '部门名称',
  create_time datetime COMMENT '创建时间',
  update_time datetime COMMENT '修改时间'
) COMMENT '部门表';

-- 员工表
create table emp(
    id int unsigned primary key auto_increment comment 'ID,主键',
    username varchar(20) not null unique comment '用户名',
    password varchar(50) default '123456' comment '密码',
    name varchar(10) not null comment '姓名',
    gender tinyint unsigned not null comment '性别, 1:男, 2:女',
    phone char(11) not null unique comment '手机号',
    job tinyint unsigned comment '职位, 1 班主任, 2 讲师, 3 学工主管, 4 教研主管, 5 咨询师',
    salary int unsigned comment '薪资',
    image varchar(300) comment '头像',
    entry_date date comment '入职日期',
    dept_id int unsigned comment '部门ID',  -- 关联的是dept部门表的ID
    create_time datetime comment '创建时间',
    update_time datetime comment '修改时间'
) comment '员工表';

-- 员工工作经历表
create table emp_expr(
    id int unsigned primary key auto_increment comment 'ID, 主键',
    emp_id int unsigned null comment '员工ID', -- 关联的是emp员工表的ID
    begin date null comment '开始时间',
    end date null comment '结束时间',
    company varchar(50) null comment '公司名称',
    job varchar(50) null comment '职位'
) comment '工作经历';注意:上述表结构设计中,我们使用的都是逻辑外键。
三、多表查询
3.1 概述
数据准备
创建数据库,执行如下 SQL 脚本:
sql
-- 部门表
create table dept(
    id int unsigned primary key auto_increment comment 'ID, 主键',
    name varchar(10) not null unique comment '部门名称',
    create_time datetime comment '创建时间',
    update_time datetime comment '修改时间'
) comment '部门表' ;

insert into dept (id, name, create_time, update_time) values
        (1,'学工部',now(),now()),
        (2,'教研部',now(),now()),
        (3,'咨询部',now(),now()),
        (4,'就业部',now(),now()),
        (5,'人事部',now(),now());

-- 员工表
create table emp(
    id int unsigned primary key auto_increment comment 'ID,主键',
    username varchar(20) not null unique comment '用户名',
    password varchar(32) not null comment '密码',
    name varchar(10) not null comment '姓名',
    gender tinyint unsigned not null comment '性别, 1:男, 2:女',
    phone char(11) not null unique comment '手机号',
    job tinyint unsigned comment '职位, 1:班主任,2:讲师,3:学工主管,4:教研主管,5:咨询师',
    salary int unsigned comment '薪资',
    image varchar(300) comment '头像',
    entry_date date comment '入职日期',
    dept_id int unsigned COMMENT '关联的部门ID',
    create_time datetime comment '创建时间',
    update_time datetime comment '修改时间'
) comment '员工表';

-- 准备测试数据(30 条水浒人物数据,此处省略部分行)
INSERT INTO `emp` VALUES (1,'shinaian','123456','施耐庵',1,'13309090001',4,15000,'https://dawn-itcast.oss-cn-hangzhou.aliyuncs.com/01.png','2000-01-01',2,'2023-10-27 16:35:33','2023-10-27 16:35:35'),
                        (2,'songjiang','123456','宋江',1,'13309090002',2,8600,'https://dawn-itcast.oss-cn-hangzhou.aliyuncs.com/01.png','2015-01-01',2,'2023-10-27 16:35:33','2023-10-27 16:35:37'),
                        -- ...
                        (30,'liyun','123456','李云',1,'13309090030',NULL,NULL,'https://dawn-itcast.oss-cn-hangzhou.aliyuncs.com/01.png','2020-03-01',NULL,'2023-10-27 16:35:33','2023-10-27 16:36:31');
介绍
多表查询:查询时从多张表中获取所需数据。
单表查询的 SQL 语句:
select 字段列表 from 表名;多表查询只需要使用逗号分隔多张表即可,如:select 字段列表 from 表1, 表2;
查询用户表和部门表中的数据:
sql
select * from emp , dept;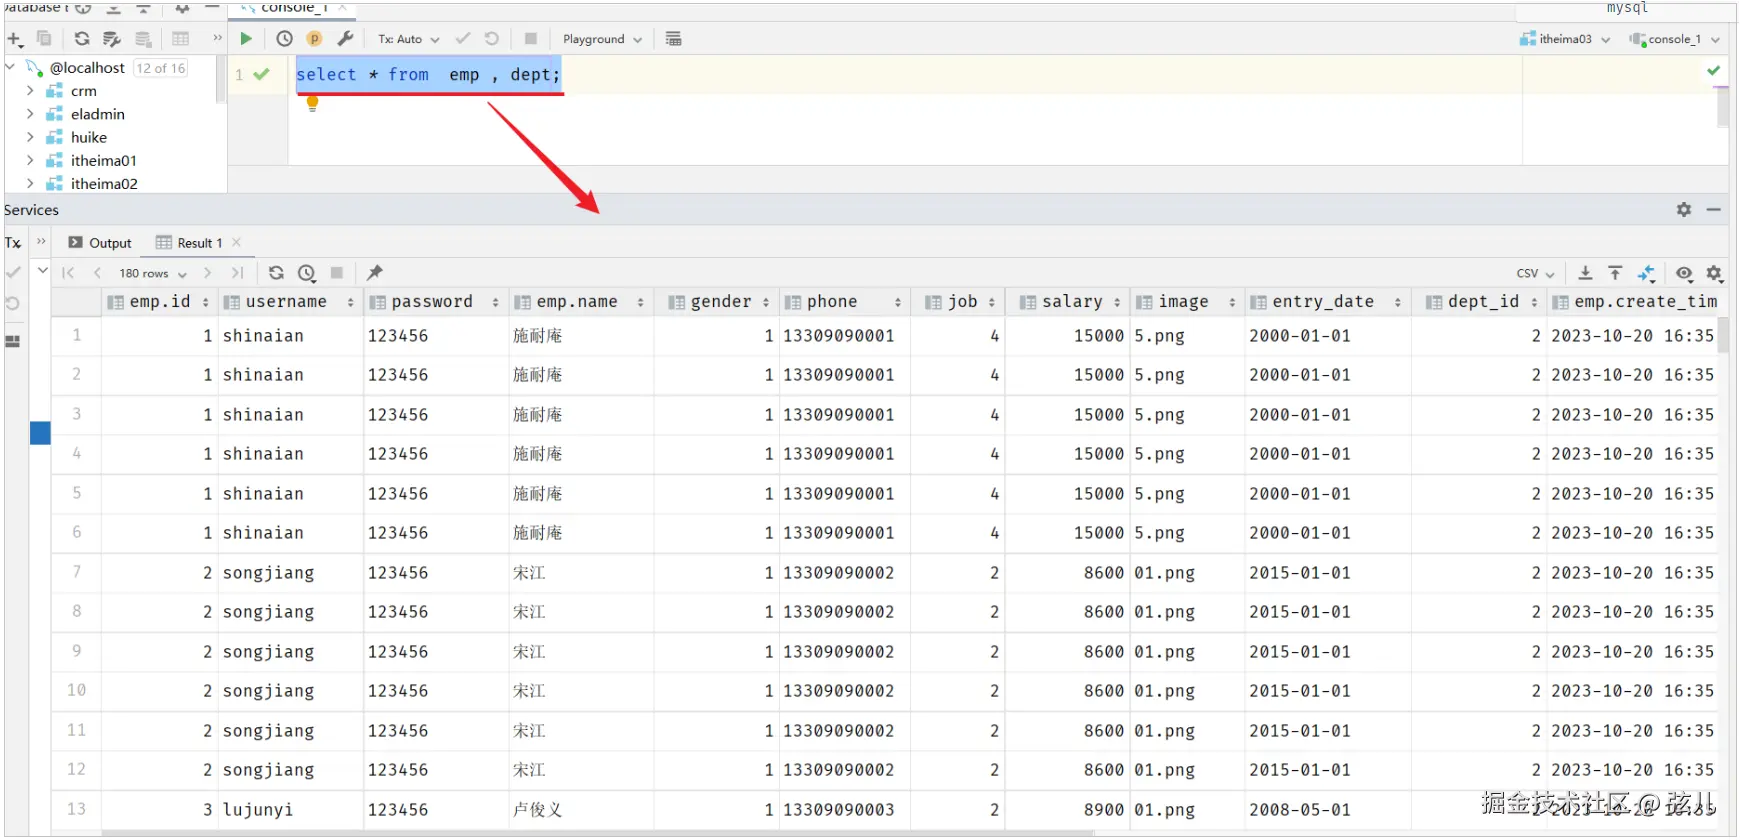
此时查询结果中包含了大量的结果集,总共 180 条 记录,这其实就是员工表所有记录(30 行)与部门表所有记录(6 行)的所有组合情况,这种现象称之为笛卡尔积。
笛卡尔积:笛卡尔乘积是指在数学中,两个集合(A 集合和 B 集合)的所有组合情况:
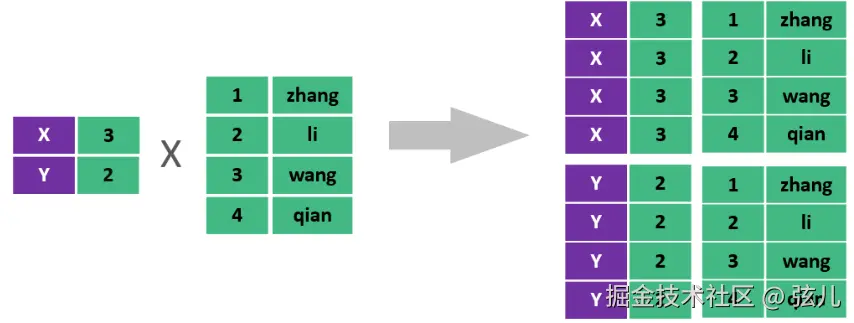
在多表查询时,需要消除无效的笛卡尔积,只保留表关联部分的数据:
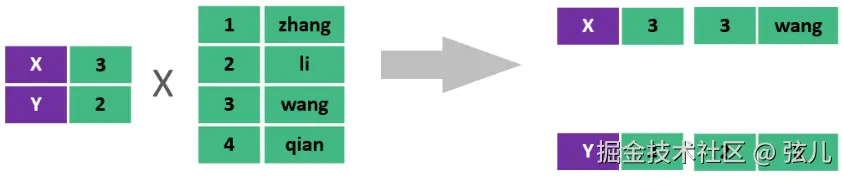
如何去除无效的笛卡尔积呢?只需要给多表查询加上连接查询的条件即可:
sql
select * from emp , dept where emp.dept_id = dept.id ;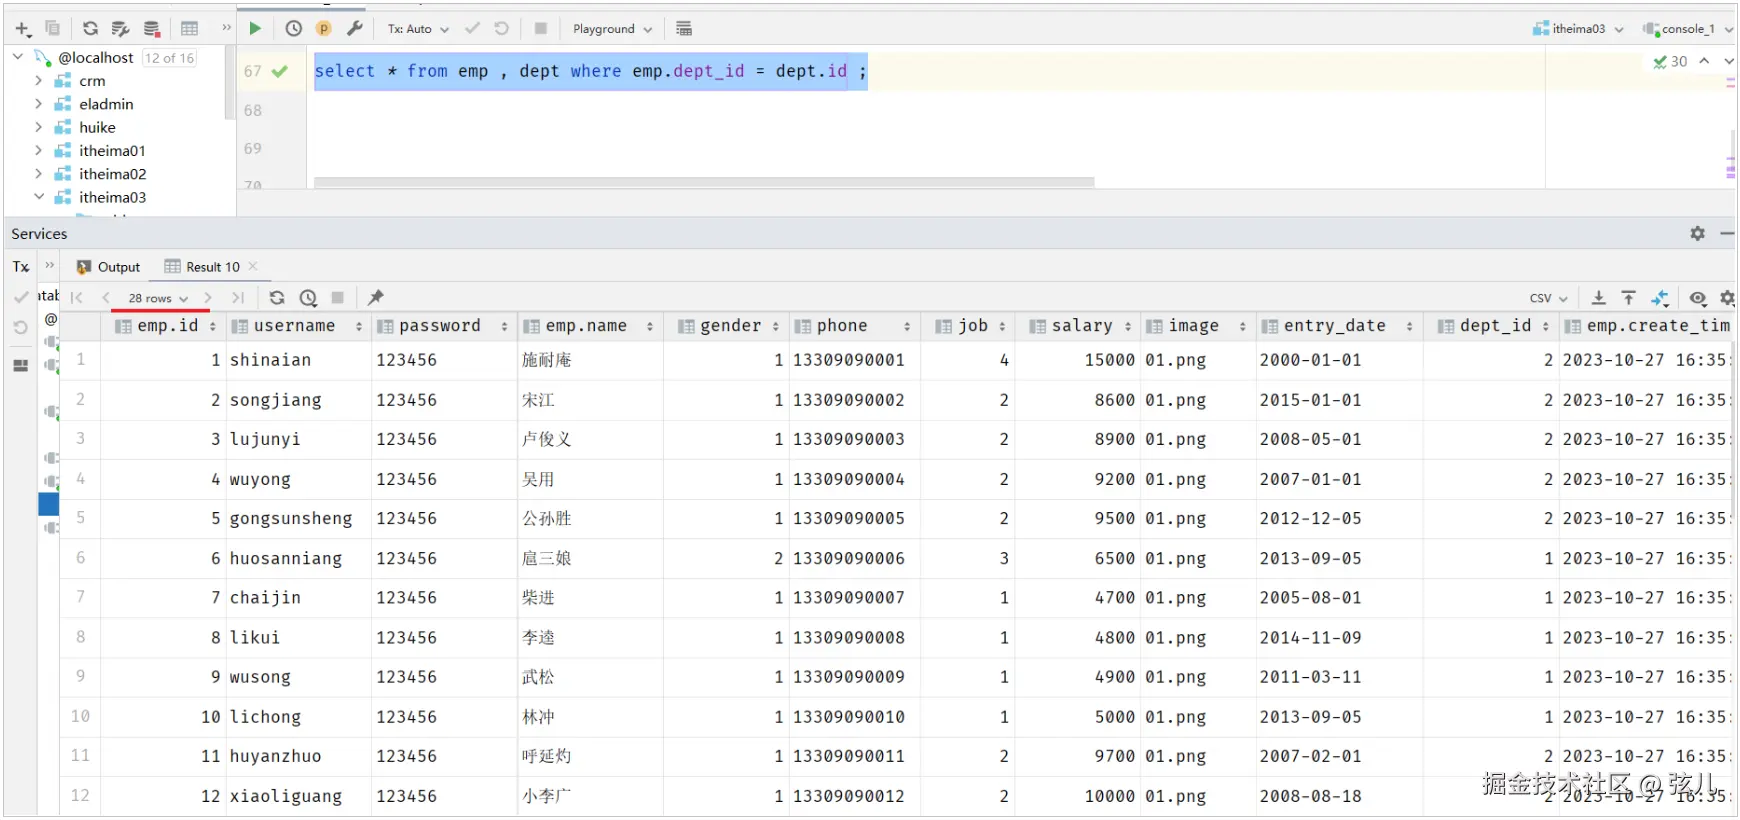
这样,就查询出来了所有的员工及其所属的部门信息。而由于 id 为 29、30 的员工没有 dept_id 字段值,所以在多表查询时,根据连接条件并没有查询到。
分类
多表查询可以分为:
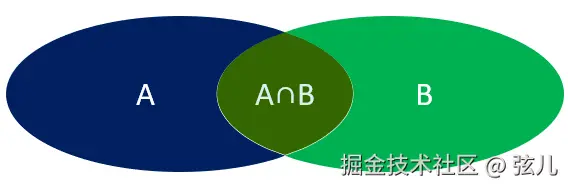
- 连接查询
- 内连接:相当于查询 A、B 交集部分数据;
- 外连接
- 左外连接:查询左表所有数据(包括两张表交集部分数据);
- 右外连接:查询右表所有数据(包括两张表交集部分数据)。
- 子查询
3.2 内连接
内连接查询:查询两表或多表中交集部分数据。
内连接从语法上可以分为:
- 隐式内连接
- 显式内连接
隐式内连接语法:
sql
select 字段列表 from 表1 , 表2 where 条件 ... ;显式内连接语法:
sql
select 字段列表 from 表1 [ inner ] join 表2 on 连接条件 ... ;案例 1:查询所有员工的 ID、姓名及所属的部门名称
- 隐式内连接实现:
sql
select emp.id, emp.name, dept.name from emp , dept where emp.dept_id = dept.id;- 显式内连接实现:
sql
select emp.id, emp.name, dept.name from emp inner join dept on emp.dept_id = dept.id;案例 2:查询性别为男,且工资高于 8000 的员工的 ID、姓名及所属的部门名称
- 隐式内连接实现:
sql
select emp.id, emp.name, dept.name from emp , dept where emp.dept_id = dept.id and emp.gender = 1 and emp.salary > 8000;- 显式内连接实现:
sql
select emp.id, emp.name, dept.name from emp inner join dept on emp.dept_id = dept.id where emp.gender = 1 and emp.salary > 8000;✅ 在多表联查时,我们指定字段时,需要在字段名前面加上表名,来指定具体是哪一张表的字段,如:
emp.dept_id。
给表起别名简化书写:
sql
select  字段列表 from 表1 as 别名1 , 表2 as  别名2  where  条件 ... ;

select  字段列表 from 表1 别名1 , 表2  别名2  where  条件 ... ;  -- as 可以省略
使用了别名的多表查询:
sql
select e.id, e.name, d.name from emp as e , dept as d where e.dept_id = d.id and e.gender = 1 and e.salary > 8000;📌 注意事项: 一旦为表起了别名,就不能再使用表名来指定对应的字段了,此时只能够使用别名来指定字段。
3.3 外连接
外连接分为两种:左外连接 和右外连接。
左外连接语法:
sql
select 字段列表 from 表1 left [ outer ] join 表2 on 连接条件 ... ;左外连接相当于查询表 1(左表)的所有数据,当然也包含表 1 和表 2 交集部分的数据。
右外连接语法:
sql
select 字段列表 from 表1 right [ outer ] join 表2 on 连接条件 ... ;右外连接相当于查询表 2(右表)的所有数据,当然也包含表 1 和表 2 交集部分的数据。
案例 1:查询员工表所有员工的姓名和对应的部门名称(左外连接)
sql
-- 左外连接:以left join关键字左边的表为主表,查询主表中所有数据,以及和主表匹配的右边表中的数据
select e.name , d.name from emp as e left join dept as d on e.dept_id = d.id ;
案例 2:查询部门表所有部门的名称和对应的员工名称(右外连接)
sql
-- 右外连接:以right join关键字右边的表为主表,查询主表中所有数据,以及和主表匹配的左边表中的数据
select e.name , d.name from emp as e right join dept as d on e.dept_id = d.id;
案例 3:查询工资高于 8000 的所有员工的姓名和对应的部门名称(左外连接)
sql
select e.name , d.name from emp as e left join dept as d on e.dept_id = d.id where e.salary > 8000;📌 注意事项: 左外连接和右外连接是可以相互替换的,只需要调整连接查询时 SQL 语句中表的先后顺序就可以了。而我们在日常开发使用时,更偏向于左外连接。
3.4 子查询
介绍
SQL 语句中嵌套 select 语句,称为嵌套查询,又称子查询。
sql
SELECT * FROM t1 WHERE column1 = ( SELECT column1 FROM t2 ... );子查询外部的语句可以是 insert / update / delete / select 的任何一个,最常见的是 select。
根据子查询结果的不同分为:
- 标量子查询(子查询结果为单个值 一行一列)
- 列子查询(子查询结果为一列,但可以是多行)
- 行子查询(子查询结果为一行,但可以是多列)
- 表子查询(子查询结果为多行多列 相当于子查询结果是一张表)
子查询可以书写的位置:
- where 之后
- from 之后
- select 之后
📌 子查询的要点: 先对需求做拆分,明确具体的步骤,然后再逐条编写 SQL 语句,最终将多条 SQL 语句合并为一条。
标量子查询
子查询返回的结果是单个值 (数字、字符串、日期等),最简单的形式,这种子查询称为标量子查询。
常用的操作符:= <> > >= < <=
案例 1:查询最早入职的员工信息
sql
-- 1. 查询最早的入职时间
select min(entry_date) from emp;  -- 结果: 2000-01-01

-- 2. 查询入职时间 = 最早入职时间的员工信息
select * from emp where entry_date = '2000-01-01';

-- 3. 合并为一条SQL
select * from emp where entry_date = (select min(entry_date) from emp);
案例 2:查询在阮小五入职之后入职的员工信息
sql
-- 1. 查询 "阮小五" 的入职日期
select entry_date from emp where name = '阮小五'; -- 结果: 2015-01-01

-- 2. 根据上述查询到的入职日期,查询在该日期之后入职的员工信息
select * from emp where entry_date > '2015-01-01';

-- 3. 合并SQL为一条SQL
select * from emp where entry_date > (select entry_date from emp where name = '阮小五');
列子查询
子查询返回的结果是一列(可以是多行),这种子查询称为列子查询。
常用的操作符:
| 操作符 | 描述 |
|---|---|
in |
在指定的集合范围之内,多选一 |
not in |
不在指定的集合范围之内 |
案例:查询「教研部」和「咨询部」的所有员工信息
sql
-- 1. 查询 "教研部" 和 "咨询部" 的部门ID
select id from dept where name = '教研部' or name = '咨询部'; -- 结果: 3,2

-- 2. 根据上面查询出来的部门ID, 查询员工信息
select * from emp where dept_id in(3,2);

-- 3. 合并SQL为一条SQL语句
select * from emp where dept_id in (select id from dept where name = '教研部' or name = '咨询部');
行子查询
子查询返回的结果是一行(可以是多列),这种子查询称为行子查询。
常用的操作符:= <> IN NOT IN
案例:查询与「李忠」的薪资及职位都相同的员工信息
sql
-- 1. 查询 "李忠" 的薪资和职位
select salary , job from emp where name = '李忠'; -- 结果: 5000, 5

-- 2. 根据上述查询到的薪资和职位, 查询对应员工的信息
select * from emp where (salary, job) = (5000,5);

-- 3. 将两条SQL合并为一条SQL
select * from emp where (salary, job) = (select salary , job from emp where name = '李忠');
表子查询
子查询返回的结果是多行多列 ,常作为临时表,这种子查询称为表子查询。
案例:获取每个部门中薪资最高的员工信息
sql
-- a. 获取每个部门的最高薪资
select dept_id, max(salary) from emp group by dept_id;

-- b. 查询每个部门中薪资最高的员工信息
select * from emp e , (select dept_id, max(salary) max_sal from emp group by dept_id) a
    where e.dept_id = a.dept_id and e.salary = a.max_sal;
案例
根据需求,完成多表查询 SQL 语句的编写。
1. 查询「教研部」性别为男,且在「2011-05-01」之后入职的员工信息
sql
select e.* from emp as e , dept as d where e.dept_id = d.id and d.name = '教研部' and e.gender = 1 and e.entry_date > '2011-05-01';2. 查询工资低于公司平均工资且性别为男的员工信息
sql
select e.* from emp as e , dept as d where e.dept_id = d.id and e.salary < (select avg(salary) from emp) and e.gender = 1;3. 查询部门人数超过 10 人的部门名称
sql
select d.name , count(*) from emp as e , dept as d where e.dept_id = d.id group by d.name having count(*) > 10;4. 查询在「2010-05-01」后入职,且薪资高于 10000 的「教研部」员工信息,并根据薪资倒序排序
sql
select * from emp e , dept d where e.dept_id = d.id and e.entry_date > '2010-05-01' and e.salary > 10000 and d.name = '教研部' order by e.salary desc;5. 查询工资低于本部门平均工资的员工信息【难】
sql
-- 5.1 查询每个部门的平均工资
select dept_id, avg(salary) avg_sal from emp group by dept_id;

-- 5.2 查询工资 低于本部门平均工资 的员工信息
select e.* from emp e , (select dept_id, avg(salary) avg_sal from emp group by dept_id) as a
          where e.dept_id = a.dept_id and e.salary < a.avg_sal;
四、员工列表查询
接下来,完成员工列表的查询功能实现。具体需求如下:
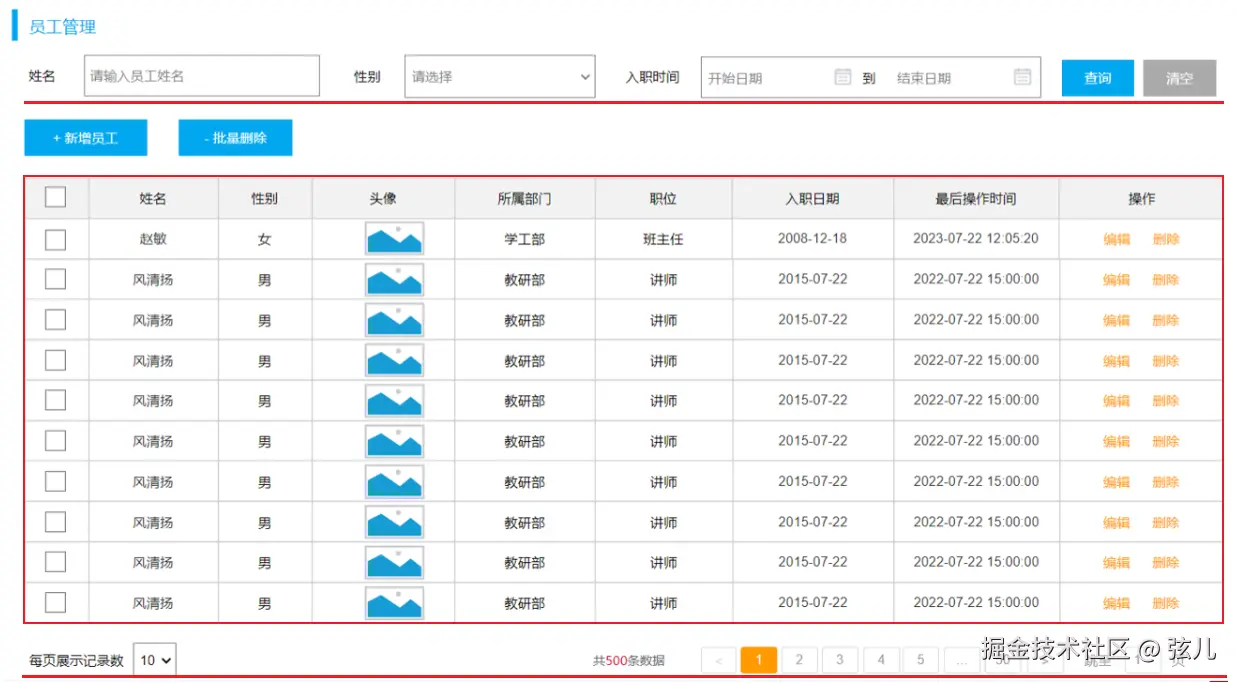
查询员工列表数据时,既需要查询员工的基本信息,还需要查询员工所属的部门名称 ,所以这里涉及多表查询操作。而且,查询时既要考虑搜索栏中的查询条件,还要考虑对查询结果进行分页处理。
接下来实现这个功能,分为三个部分逐一实现:
- 准备工作
- 分页查询
- 条件分页查询
4.1 准备工作
需求:查询所有员工信息,并查询出部门名称(涉及到的表:emp、dept):
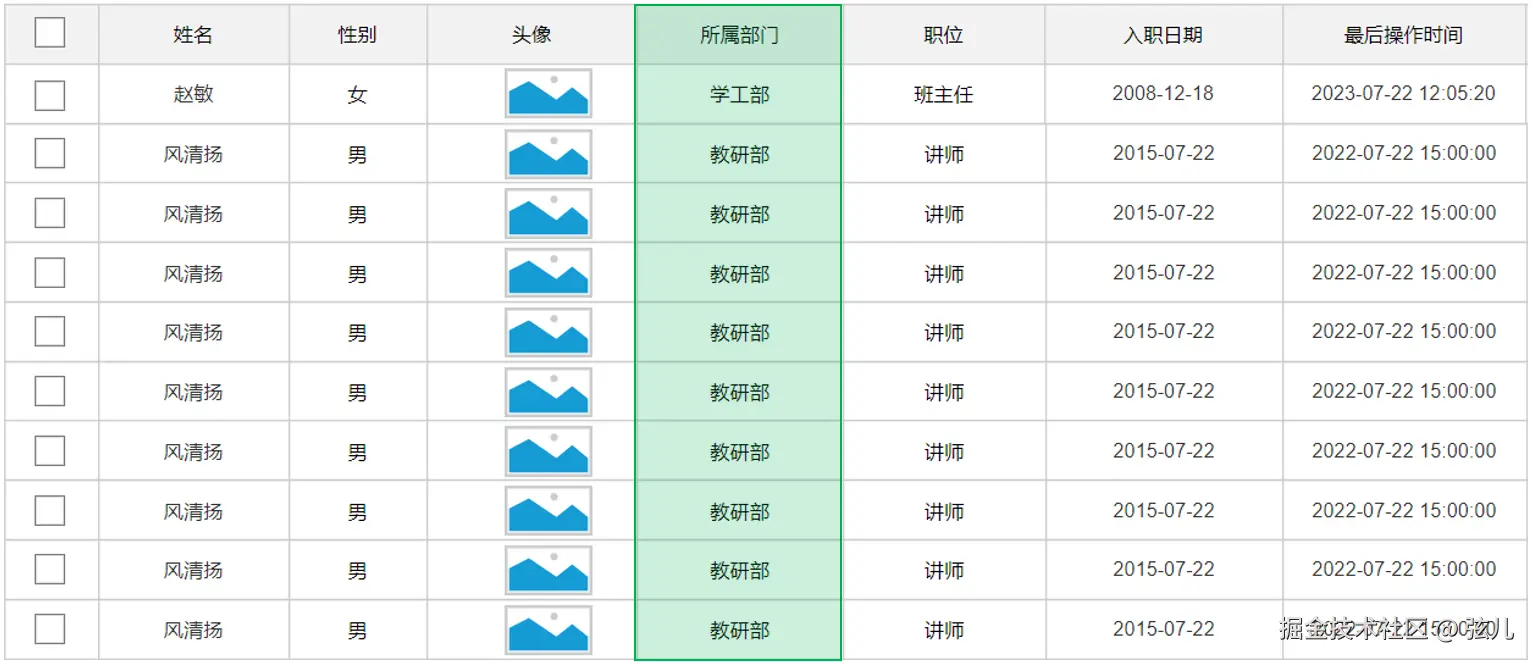
基础代码准备
1) 创建员工管理相关表结构
sql
-- 员工表
create table emp(
    id int unsigned primary key auto_increment comment 'ID,主键',
    username varchar(20) not null unique comment '用户名',
    password varchar(50) default '123456' comment '密码',
    name varchar(10) not null comment '姓名',
    gender tinyint unsigned not null comment '性别, 1:男, 2:女',
    phone char(11) not null unique comment '手机号',
    job tinyint unsigned comment '职位, 1 班主任, 2 讲师 , 3 学工主管, 4 教研主管, 5 咨询师',
    salary int unsigned comment '薪资',
    image varchar(300) comment '头像',
    entry_date date comment '入职日期',
    dept_id int unsigned comment '部门ID',
    create_time datetime comment '创建时间',
    update_time datetime comment '修改时间'
) comment '员工表';

INSERT INTO emp VALUES
    (1,'shinaian','123456','施耐庵',1,'13309090001',4,15000,'https://web-framework.oss-cn-hangzhou.aliyuncs.com/2023/1.jpg','2000-01-01',2,'2023-10-20 16:35:33','2023-11-16 16:11:26'),
    -- ...(水浒人物测试数据,此处省略部分行)
    (36,'linghuchong','123456','令狐冲',1,'18809091212',2,6800,'https://web-framework.oss-cn-hangzhou.aliyuncs.com/2023/1.jpg','2023-10-19',2,'2023-10-20 20:44:54','2023-11-09 09:41:04');

-- 员工工作经历信息
create table emp_expr(
    id int unsigned primary key auto_increment comment 'ID, 主键',
    emp_id int unsigned comment '员工ID',
    begin date comment '开始时间',
    end  date comment '结束时间',
    company varchar(50) comment '公司名称',
    job varchar(50) comment '职位'
)comment '工作经历';
2) 准备 emp 表对应的实体类 Emp、EmpExpr
java
package com.itheima.pojo;

import lombok.Data;

import java.time.LocalDate;
import java.time.LocalDateTime;
import java.util.List;

@Data
public class Emp {
    private Integer id; //ID,主键
    private String username; //用户名
    private String password; //密码
    private String name; //姓名
    private Integer gender; //性别, 1:男, 2:女
    private String phone; //手机号
    private Integer job; //职位, 1:班主任,2:讲师,3:学工主管,4:教研主管,5:咨询师
    private Integer salary; //薪资
    private String image; //头像
    private LocalDate entryDate; //入职日期
    private Integer deptId; //关联的部门ID
    private LocalDateTime createTime; //创建时间
    private LocalDateTime updateTime; //修改时间

    //封装部门名称数
    private String deptName; //部门名称
}
java
package com.itheima.pojo;

import lombok.Data;

import java.time.LocalDate;

/**
 * 工作经历
 */
@Data
public class EmpExpr {
    private Integer id; //ID
    private Integer empId; //员工ID
    private LocalDate begin; //开始时间
    private LocalDate end; //结束时间
    private String company; //公司名称
    private String job; //职位
}
3) 准备 Emp 员工管理的基础结构,包括 Controller、Service、Mapper
EmpMapper:
java
package com.itheima.mapper;

import com.itheima.pojo.Emp;
import org.apache.ibatis.annotations.Mapper;
import java.util.List;

@Mapper
public interface EmpMapper {

}
EmpService:
java
package com.itheima.service;

public interface EmpService {
}
EmpServiceImpl:
java
package com.itheima.service.impl;

import com.itheima.mapper.EmpMapper;
import com.itheima.service.EmpService;
import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.stereotype.Service;

/**
 * 员工管理
 */
@Service
public class EmpServiceImpl implements EmpService {

    @Autowired
    private EmpMapper empMapper;

}
EmpController:
java
package com.itheima.controller;

import com.itheima.service.EmpService;
import lombok.extern.slf4j.Slf4j;
import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.web.bind.annotation.RestController;

/**
 * 员工管理
 */
@Slf4j
@RestController
public class EmpController {

    @Autowired
    private EmpService empService;

}
SQL & Mapper 接口
先考虑一下:查询所有员工数据及其关联的部门名称,这个 SQL 该如何实现?这里要查询所有员工,也就意味着,即使员工没有部门,也需要将该员工查询出来 。所以,这里需要用左外连接实现,具体 SQL 如下:
1) 基于 AI 生成对应的 SQL 语句
sql
-- 查询所有的员工信息,如果员工关联了部门,也要查询出部门名称
select e.*, d.name as dept_name from emp e left join dept d on e.dept_id = d.id;
2) Mapper 接口方法定义
定义一个员工管理的 Mapper 接口 EmpMapper 并完成员工信息的查询:
java
@Mapper
public interface EmpMapper {

    /**
     * 查询所有的员工及其对应的部门名称
     */
    @Select("select e.*, d.name as deptName from emp e left join dept d on e.dept_id = d.id")
    public List<Emp> list();

}
注意:上述 SQL 语句中给部门名称起了别名 deptName,是因为接口文档中要求返回给前端的数据中必须叫 deptName。这里需要将查询返回的每一条记录都封装到 Emp 对象中,就必须保证查询返回的字段名与属性名一一对应 ,所以我们在 Emp 中定义了一个属性 deptName 用来封装部门名称(见上文 Emp 实体)。
代码编写完毕后,编写一个单元测试对上述程序进行测试:
java
@SpringBootTest
class TliasWebManagementApplicationTests {

    @Autowired
    private EmpMapper empMapper;

    @Test
    public void testList(){
        List<Emp> empList = empMapper.list();
        empList.forEach(System.out::println);
    }
}
运行单元测试后,控制台输出的数据:
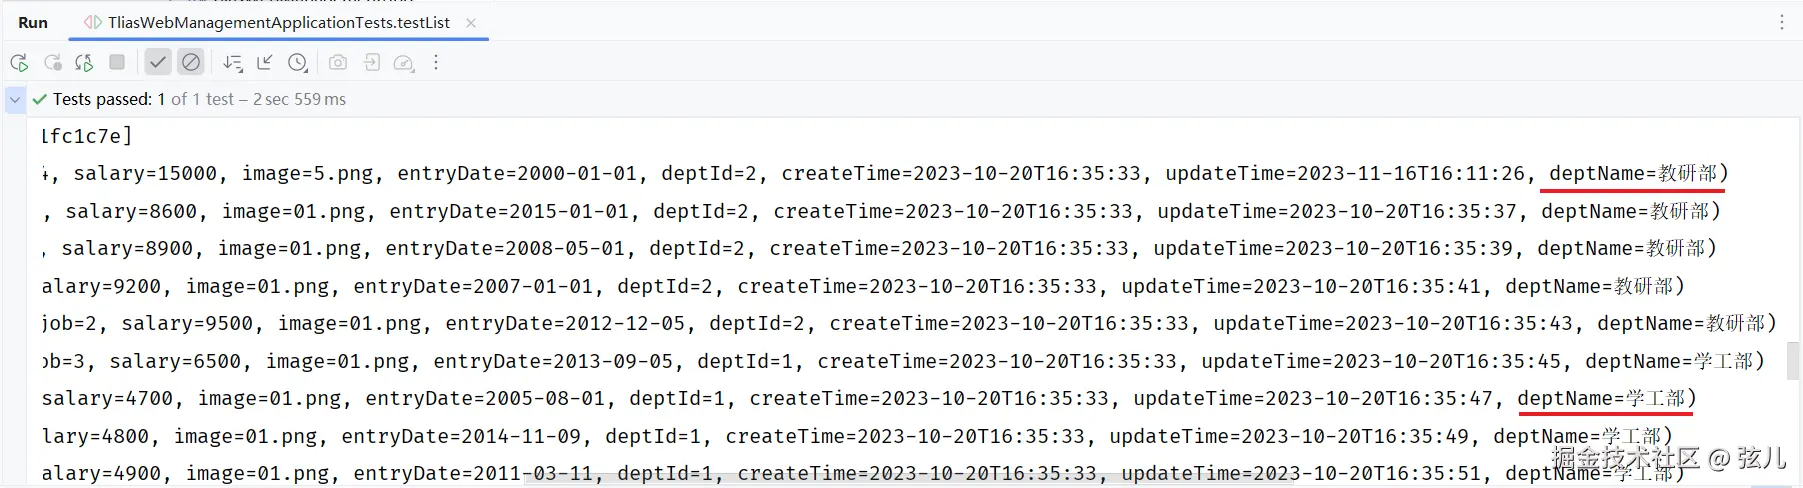
可以看到,员工的信息和员工关联的部门名称都查询出来了。
4.2 分页查询
分析
上面在 Mapper 接口中完成了查询所有员工及其部门名称的功能,把数据库中的所有数据都查询出来了。试想如果数据库中的数据有很多(假设几千几万条)的时候,将数据全部展示出来肯定不现实,那如何解决这个问题呢?
使用分页解决:每次只展示一页的数据,比如一页展示 10 条,想再看其他数据就点击页码查询。员工管理的需求中就要求分页查询,具体页面原型如下:
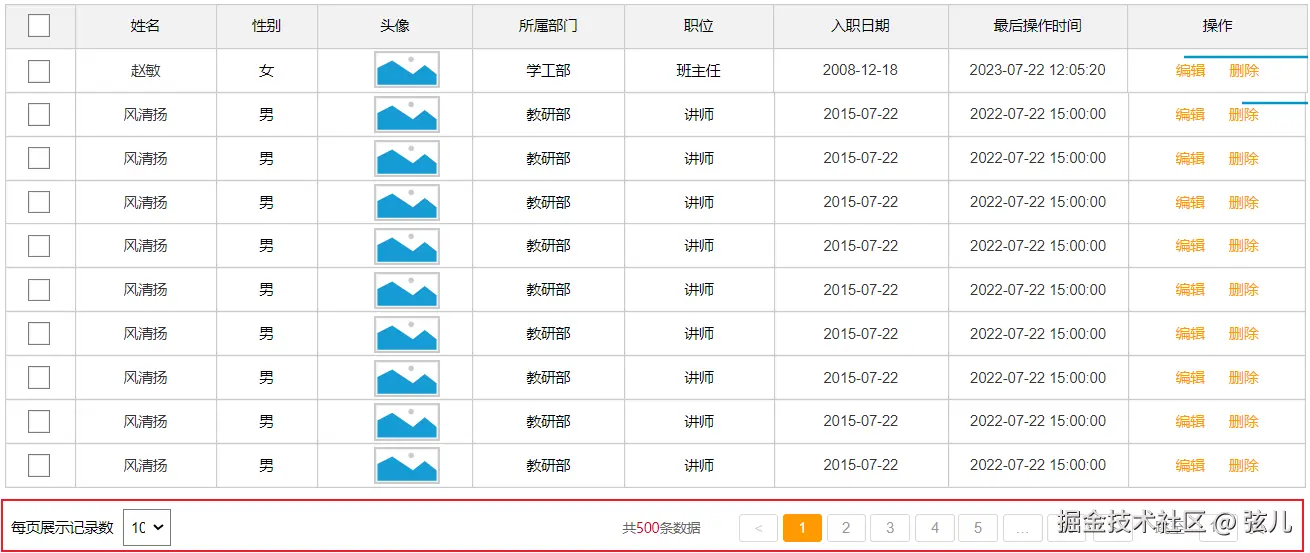
要从数据库中进行分页查询,需要使用 LIMIT 关键字,格式为:limit 开始索引 每页显示的条数。
- 查询第 1 页数据的 SQL 语句:
sql
select * from emp limit 0,10;- 查询第 2 页数据的 SQL 语句:
sql
select * from emp limit 10,10;- 查询第 3 页数据的 SQL 语句:
sql
select * from emp limit 20,10;观察以上 SQL 语句发现:开始索引一直在改变,每页显示条数是固定的。
开始索引的计算公式:
scss
开始索引 = (当前页码 - 1) * 每页显示条数继续基于页面原型分析,得出以下结论:
- 前端在请求服务端时传递的参数:
- 当前页码
page - 每页显示条数
pageSize
- 当前页码
- 后端需要响应给前端的数据:
- 所查询到的数据列表(存储到 List 集合中)
- 总记录数
total
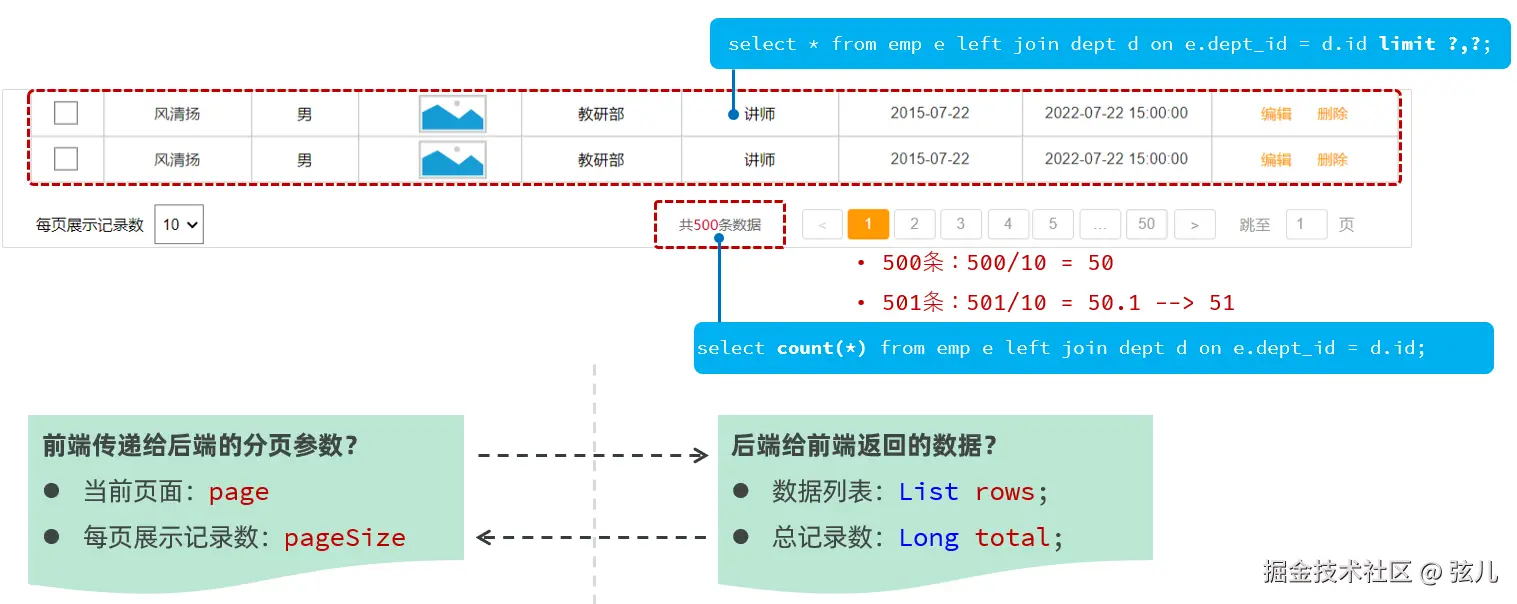
后台给前端返回的数据包含:List 集合(数据列表)、total(总记录数)。而这两部分通常封装到 PageResult 对象中,并将该对象转换为 json 格式的数据响应回浏览器:
java
@Data
@NoArgsConstructor
@AllArgsConstructor
public class PageResult {
        private Long total; //总记录数
        private List rows; //当前页数据列表
}
接口描述
1) 基本信息
请求路径:/emps 请求方式:GET 接口描述:该接口用于员工列表数据的条件分页查询
2) 请求参数
| 参数名称 | 是否必须 | 示例 | 备注 |
|---|---|---|---|
| name | 否 | 张 | 姓名 |
| gender | 否 | 1 | 性别, 1 男, 2 女 |
| begin | 否 | 2010/1/1 | 范围匹配的开始时间(入职日期) |
| end | 否 | 2020/1/1 | 范围匹配的结束时间(入职日期) |
| page | 是 | 1 | 分页查询的页码,如果未指定,默认为1 |
| pageSize | 是 | 10 | 分页查询的每页记录数,如果未指定,默认为10 |
请求数据样例:
arduino
/emps?name=张&gender=1&begin=2007-09-01&end=2022-09-01&page=1&pageSize=103) 响应数据
参数格式:application/json
参数说明:
| 名称 | 类型 | 是否必须 | 备注 |
|---|---|---|---|
| code | number | 必须 | 响应码, 1 成功, 0 失败 |
| msg | string | 非必须 | 提示信息 |
| data | object | 必须 | 返回的数据 |
| - total | number | 必须 | |
| - rows | object \[\] | 必须 | |
| - id | number | 非必须 | |
| - username | string | 非必须 | |
| - name | string | 非必须 | |
| - password | string | 非必须 | |
| - gender | number | 非必须 | |
| - image | string | 非必须 | |
| - job | number | 非必须 | |
| - salary | number | 非必须 | |
| - entryDate | string | 非必须 | |
| - deptId | number | 非必须 | |
| - deptName | string | 非必须 | |
| - createTime | string | 非必须 | |
| - updateTime | string | 非必须 |
响应数据样例:
json
{
  "code": 1,
  "msg": "success",
  "data": {
    "total": 2,
    "rows": [
       {
        "id": 1,
        "username": "jinyong",
        "password": "123456",
        "name": "金庸",
        "gender": 1,
        "image": "https://web-framework.oss-cn-hangzhou.aliyuncs.com/2022-09-02-00-27-53B.jpg",
        "job": 2,
        "salary": 8000,
        "entryDate": "2015-01-01",
        "deptId": 2,
        "deptName": "教研部",
        "createTime": "2022-09-01T23:06:30",
        "updateTime": "2022-09-02T00:29:04"
      },
      {
        "id": 2,
        "username": "zhangwuji",
        "password": "123456",
        "name": "张无忌",
        "gender": 1,
        "image": "https://web-framework.oss-cn-hangzhou.aliyuncs.com/2022-09-02-00-27-53B.jpg",
        "job": 2,
        "salary": 6000,
        "entryDate": "2015-01-01",
        "deptId": 2,
        "deptName": "教研部",
        "createTime": "2022-09-01T23:06:30",
        "updateTime": "2022-09-02T00:29:04"
      }
    ]
  }
}目前我们只考虑分页查询,先不考虑查询条件,接口文档中与分页查询相关的参数就两个:page 和 pageSize。
原始方式
代码实现
通过查看接口文档------员工列表查询:
请求路径:/emps 请求方式:GET 请求参数:跟随在请求路径后的参数字符串。例:
/emps?page=1&pageSize=10响应数据:json 格式
1) EmpController
java
@Slf4j
@RequestMapping("/emps")
@RestController
public class EmpController {

    @Autowired
    private EmpService empService;

    @GetMapping
    public Result page(@RequestParam(defaultValue = "1") Integer page ,
                       @RequestParam(defaultValue = "10") Integer pageSize){
        log.info("查询员工信息, page={}, pageSize={}", page, pageSize);
        PageResult pageResult = empService.page(page, pageSize);
        return Result.success(pageBean);
    }

}
📌
@RequestParam(defaultValue="默认值")// 设置请求参数默认值
2) EmpService
java
public interface EmpService {
    /**
     * 分页查询
     * @param page 页码
     * @param pageSize 每页记录数
     */
    PageResult page(Integer page, Integer pageSize);
}
3) EmpServiceImpl
java
@Service
public class EmpServiceImpl implements EmpService {

    @Autowired
    private EmpMapper empMapper;

    @Override
    public PageResult page(Integer page, Integer pageSize) {
        //1. 获取总记录数
        Long total = empMapper.count();

        //2. 获取结果列表
        Integer start = (page - 1) * pageSize;
        List<Emp> empList = empMapper.list(start, pageSize);

        //3. 封装结果
        return new PageResult(total, empList);
    }
}
4) EmpMapper
java
@Mapper
public interface EmpMapper {

    /**
     * 查询总记录数
     */
    @Select("select count(*) from emp e left join dept d on e.dept_id = d.id ")
    public Long count();

    /**
     * 查询所有的员工及其对应的部门名称
     */
    @Select("select e.*, d.name deptName from emp as e left join dept as d on e.dept_id = d.id limit #{start}, #{pageSize}")
    public List<Emp> list(Integer start , Integer pageSize);

}
功能测试
功能开发完成后,重新启动项目,使用 Apifox 发起 GET 请求:
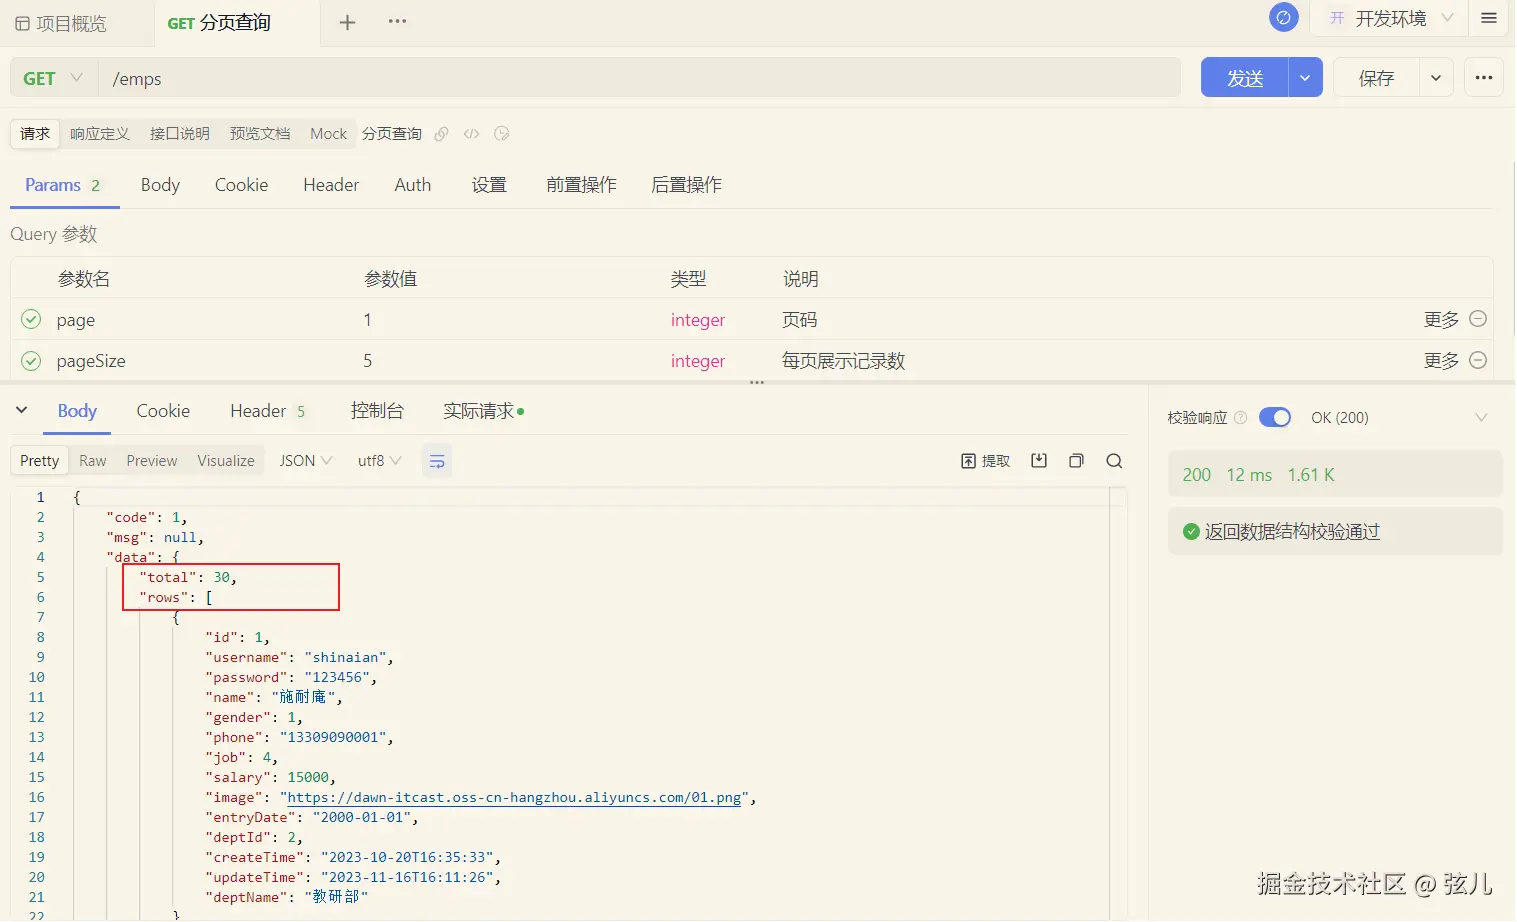
前后端联调
打开浏览器,测试后端功能接口:
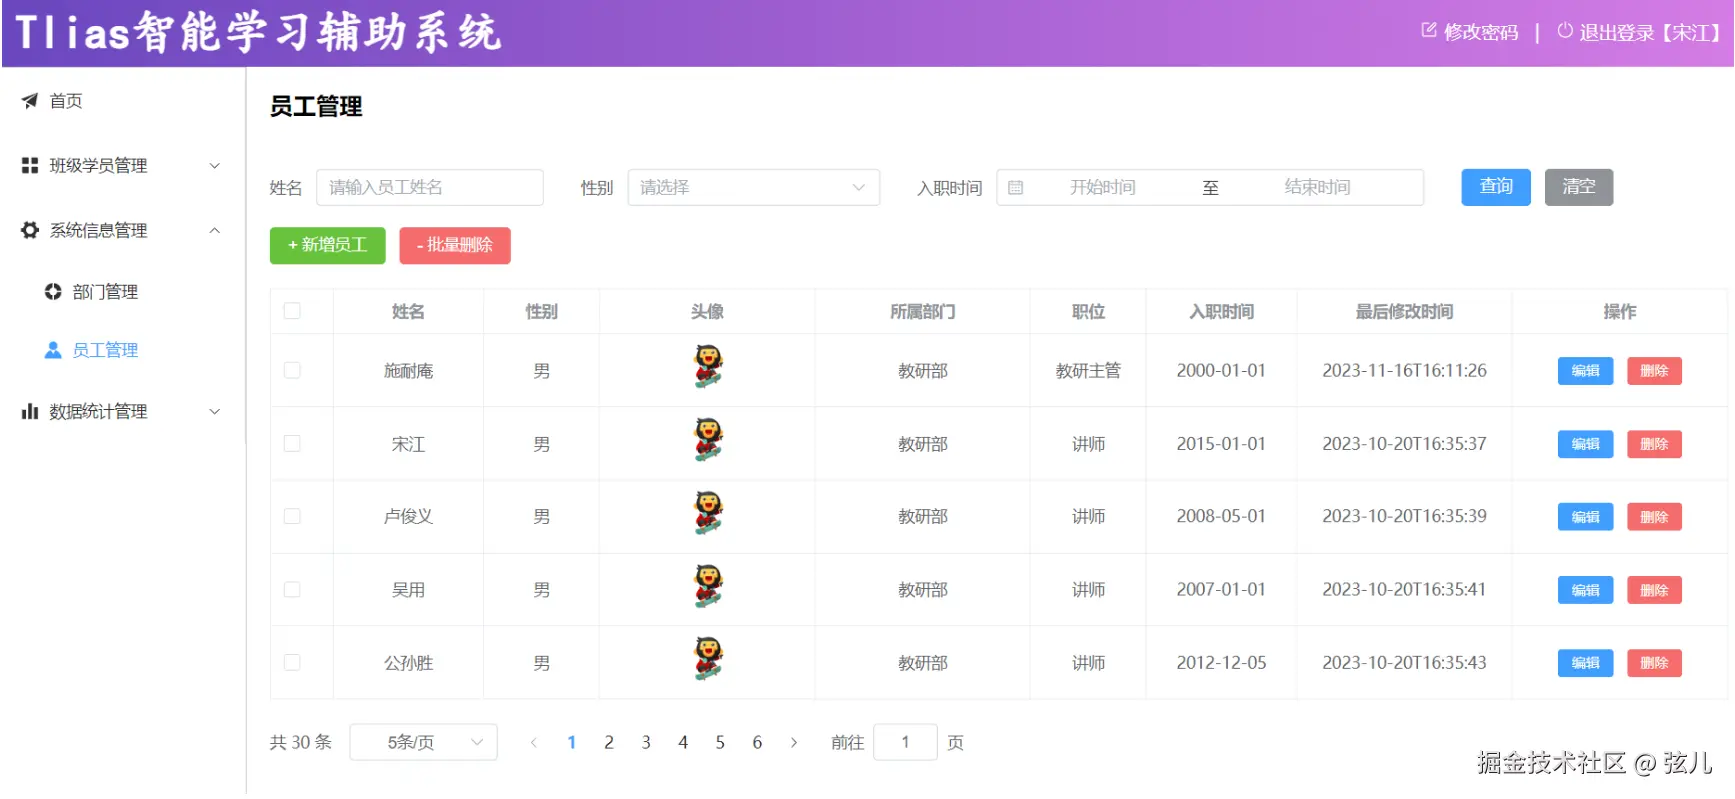
点击下面的页码,可以正常查询出对应的数据。
PageHelper 分页插件
介绍
前面我们已经完成了基础的分页查询,大家会发现:分页查询功能编写起来比较繁琐。而分页查询的功能是非常常见的,查询员工信息需要分页,将来做其他项目时,查询用户信息、订单信息、商品信息等等都需要分页查询。
分页查询的思路、步骤是比较固定的:在 Mapper 接口中定义两个方法执行两条不同的 SQL 语句(1. 查询总记录数;2. 指定页码的数据列表);在 Service 中调用 Mapper 的两个方法,分别获取总记录数、查询结果列表,再封装到 PageResult 对象中。
结论:原始方式的分页查询,存在着"步骤固定"、"代码频繁"的问题。
解决方案:使用现成的分页插件完成。对于 MyBatis 来讲现在最主流的就是 PageHelper。
PageHelper 是第三方提供的 MyBatis 框架中的一款功能强大、方便易用的分页插件,支持任何形式的单表、多表的分页查询。 官网:pagehelper.github.io/
对比一下使用 PageHelper 分页插件与原始方式进行分页在代码实现上的差别:
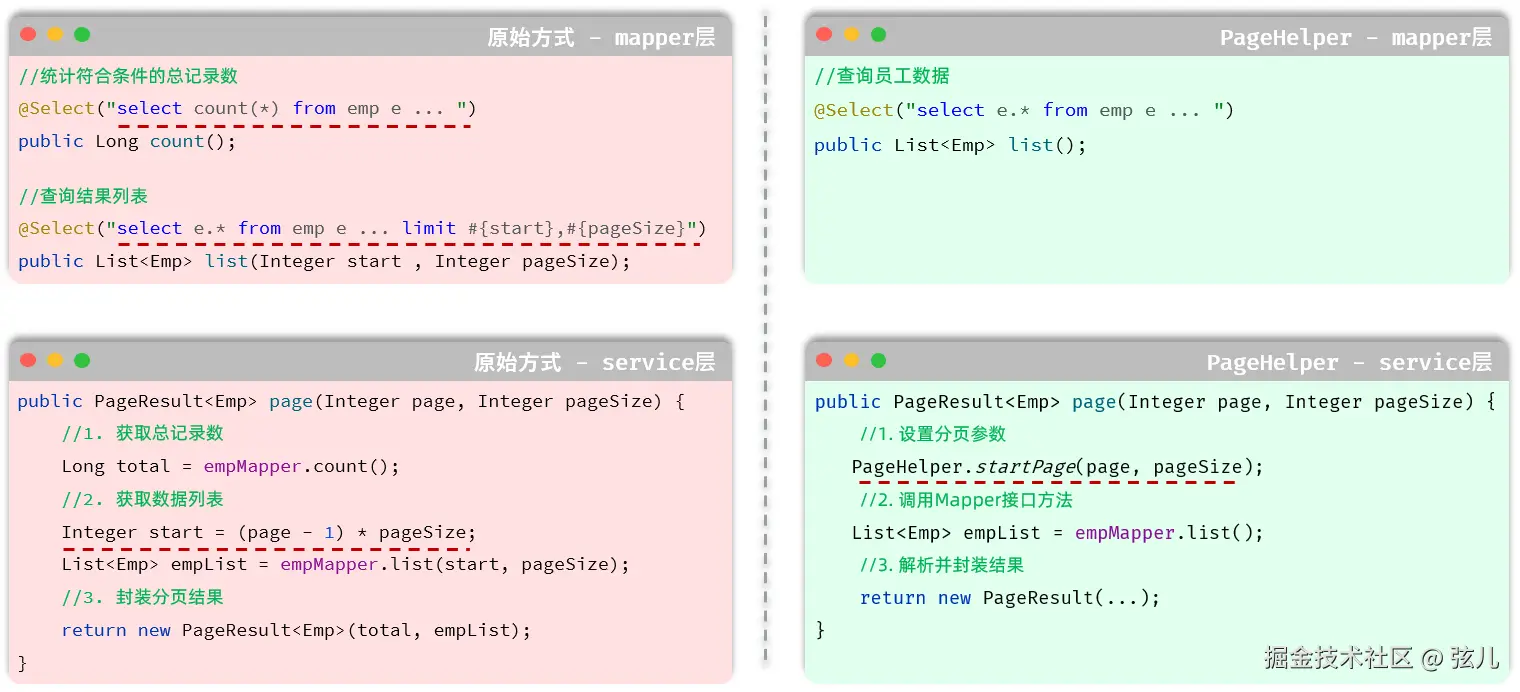
- Mapper 接口层 :
- 原始分页查询:需要在 Mapper 接口中定义两条 SQL 语句;
- PageHelper 实现分页:只需要编写一条 SQL 语句,而且不需要考虑分页操作,就是一条正常的查询语句。
- Service 层 :
- 原始方式:需要根据页码、每页展示记录数,手动计算起始索引;
- PageHelper:无需手动计算起始索引,直接告诉 PageHelper 需要查询哪一页的数据、每页展示多少条记录即可。
代码实现
使用了 PageHelper 分页插件后,就无需在 Mapper 中手动分页了,只需要进行正常的列表查询;在 Service 层中,调用 Mapper 方法之前设置分页参数,调用 Mapper 方法执行查询之后,解析分页结果并封装到 PageResult 对象中返回。
1) 在 pom.xml 引入依赖
xml
<!--分页插件PageHelper-->
<dependency>
    <groupId>com.github.pagehelper</groupId>
    <artifactId>pagehelper-spring-boot-starter</artifactId>
    <version>1.4.7</version>
</dependency>
2) EmpMapper
java
/**
 * 查询所有的员工及其对应的部门名称
 */
@Select("select e.*, d.name deptName from emp as e left join dept as d on e.dept_id = d.id")
public List<Emp> list();
3) EmpServiceImpl
java
@Override
public PageResult page(Integer page, Integer pageSize) {
    //1. 设置分页参数
    PageHelper.startPage(page,pageSize);

    //2. 执行查询
    List<Emp> empList = empMapper.list();
    Page<Emp> p = (Page<Emp>) empList;

    //3. 封装结果
    return new PageResult(p.getTotal(), p.getResult());
}
功能测试
重启项目,打开 Apifox 发起 GET 请求,访问 http://localhost:8080/emps?page=1&pageSize=5:
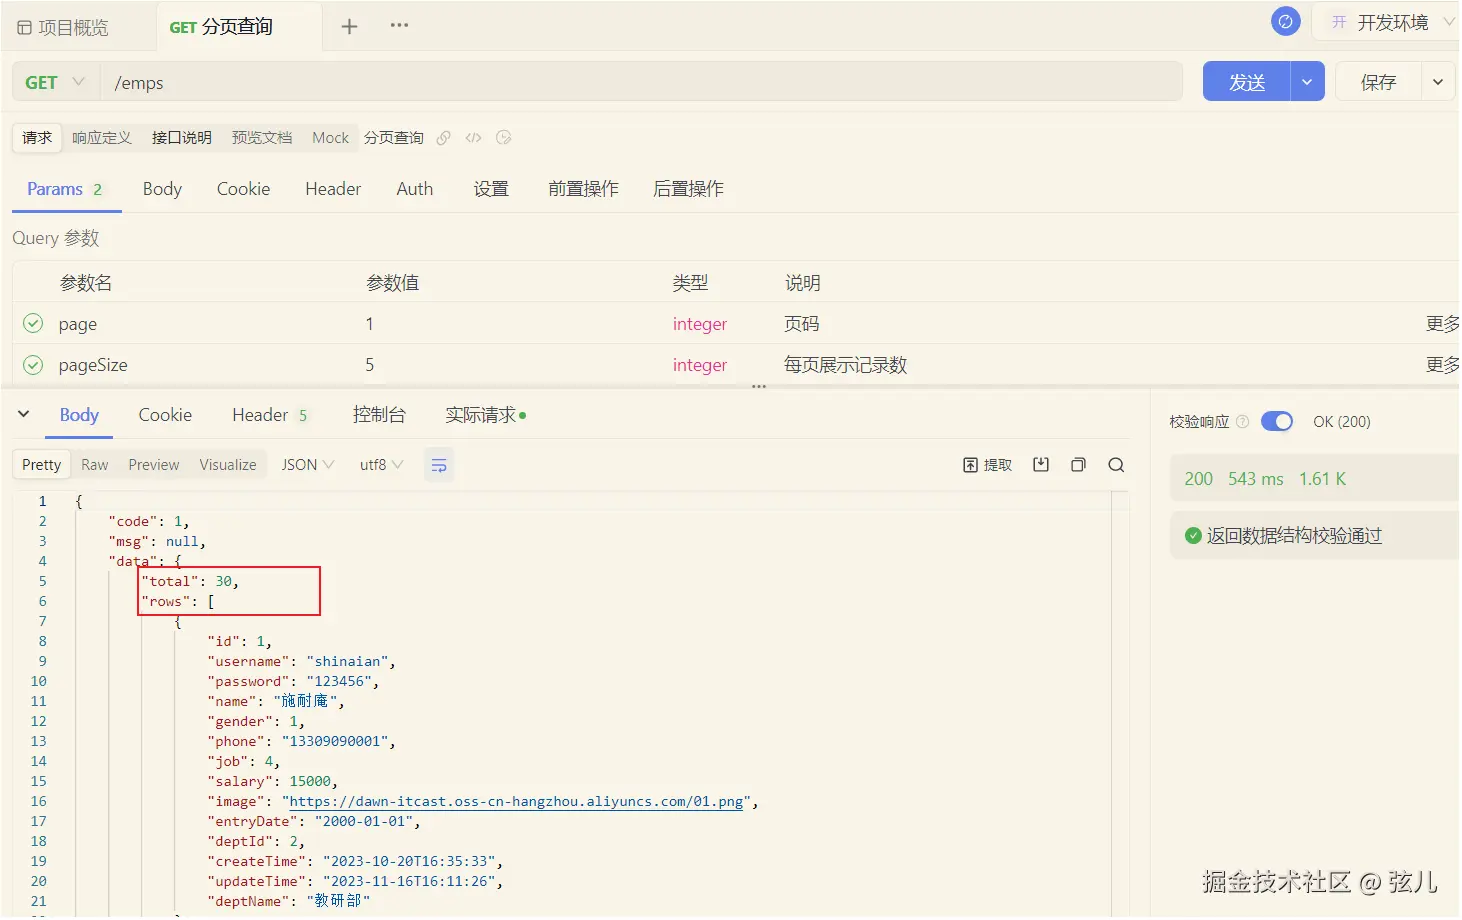
数据可以正常查询返回,正常实现了分页查询。
实现机制
打开 IDEA 的控制台,可以看到分页查询时输出的 SQL 语句:
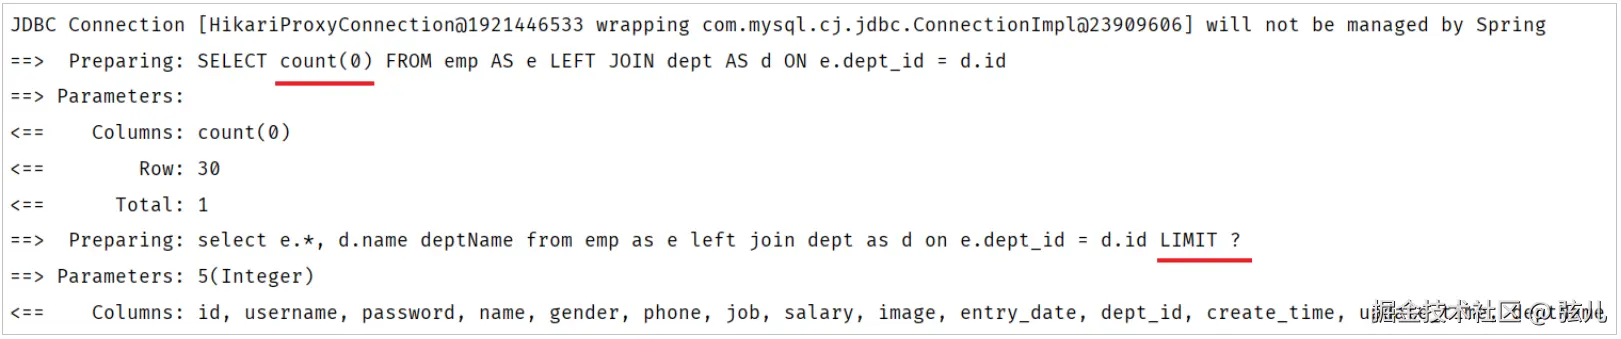
执行了两条 SQL 语句,而这两条 SQL 语句其实是从我们在 Mapper 接口中定义的 SQL 演变而来的。
- 第一条 SQL 语句,用来查询总记录数:

其实就是将我们编写的 SQL 语句进行的改造增强:将查询返回的字段列表替换成了 count(0) 来统计总记录数。
- 第二条 SQL 语句,用来进行分页查询,查询指定页码对应的数据列表:

其实就是将我们编写的 SQL 语句进行的改造增强:在 SQL 语句之后拼接上了 limit 进行分页查询。由于测试时查询的是第一页,起始索引是 0,所以简写为 limit ?。
PageHelper 在进行分页查询时会执行上述两条 SQL,并将查询到的总记录数与数据列表封装到 Page<Emp> 对象中,我们获取查询结果时,只需要调用 Page 对象的方法即可。
📌 注意:
- PageHelper 实现分页查询时,SQL 语句的结尾一定一定一定不要加分号(;);
- PageHelper 只会对紧跟在其后的第一条 SQL 语句进行分页处理。
4.3 条件分页查询
完成分页查询后,下面需要在分页查询的基础上添加条件。
需求
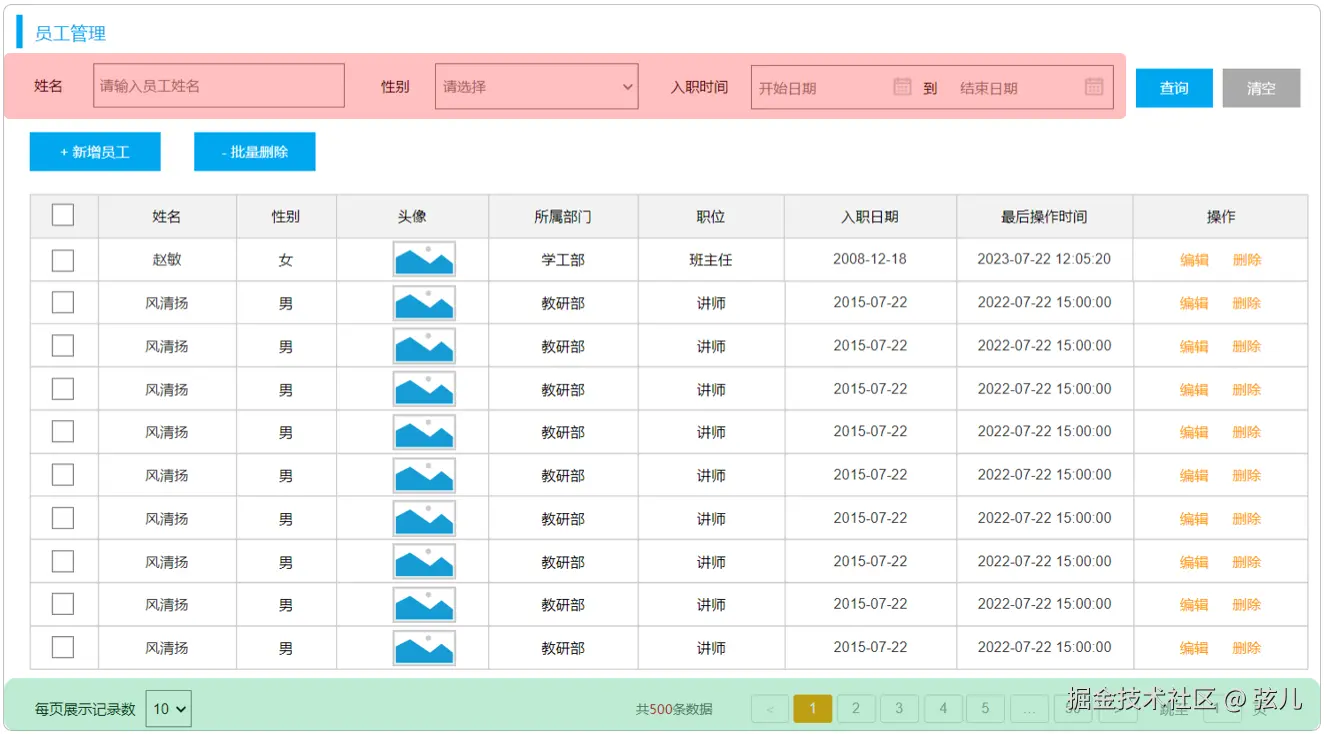
通过员工管理的页面原型可以看到,员工列表页面的查询不仅需要考虑分页,还需要考虑查询条件。搜索栏的搜索条件有三个:
- 姓名:模糊匹配
- 性别:精确匹配
- 入职日期:范围匹配
接口描述
参照接口文档中的「员工管理」→「员工列表查询」。
思路分析
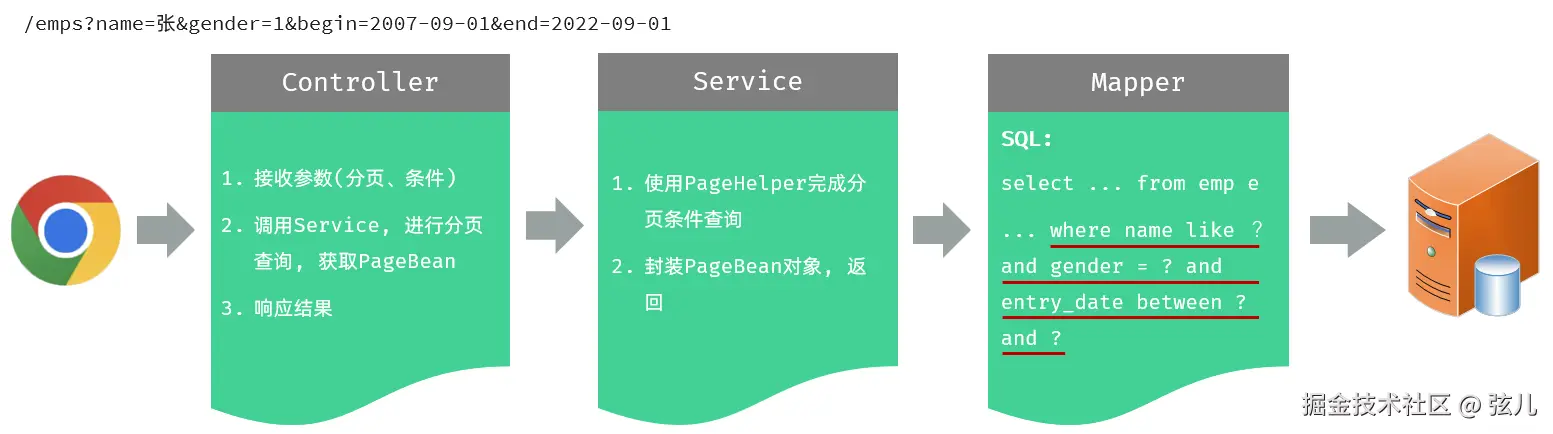
功能开发
通过查看接口文档------员工列表查询:
请求路径:/emps 请求方式:GET
请求参数:
| 参数名称 | 是否必须 | 示例 | 备注 |
|---|---|---|---|
| name | 否 | 张 | 姓名 |
| gender | 否 | 1 | 性别, 1 男, 2 女 |
| begin | 否 | 2010/1/1 | 范围匹配的开始时间(入职日期) |
| end | 否 | 2020/1/1 | 范围匹配的结束时间(入职日期) |
| page | 是 | 1 | 分页查询的页码,如果未指定,默认为1 |
| pageSize | 是 | 10 | 分页查询的每页记录数,如果未指定,默认为10 |
在原有分页查询的代码基础上进行改造。
1) 在 EmpController 方法中通过多个方法形参依次接收这几个参数
java
@Slf4j
@RestController
@RequestMapping("/emps")
public class EmpController {

    @Autowired
    private EmpService empService;

    @GetMapping
    public Result page(@RequestParam(defaultValue = "1") Integer page,
                       @RequestParam(defaultValue = "10") Integer pageSize,
                       String name, Integer gender,
                       @DateTimeFormat(pattern = "yyyy-MM-dd") LocalDate begin,
                       @DateTimeFormat(pattern = "yyyy-MM-dd") LocalDate end) {
        log.info("查询请求参数: {}, {}, {}, {}, {}, {}", page, pageSize, name, gender, begin, end);
        PageResult pageResult = empService.page(page, pageSize);
        return Result.success(pageResult);
    }
}
2) 修改 EmpService 及 EmpServiceImpl 中的代码逻辑
EmpService:
java
public interface EmpService {
    /**
     * 分页查询
     */
    PageResult page(Integer page, Integer pageSize, String name, Integer gender, LocalDate begin, LocalDate end);
}
EmpServiceImpl:
java
/**
 * 员工管理
 */
@Service
public class EmpServiceImpl implements EmpService {

    @Autowired
    private EmpMapper empMapper;

    @Override
    public PageResult page(Integer page, Integer pageSize, String name, Integer gender, LocalDate begin, LocalDate end) {
        //1. 设置PageHelper分页参数
        PageHelper.startPage(page, pageSize);
        //2. 执行查询
        List<Emp> empList = empMapper.list(name, gender, begin, end);
        //3. 封装分页结果
        Page<Emp> p = (Page<Emp>) empList;
        return new PageResult(p.getTotal(), p.getResult());
    }
}
3) 调整 EmpMapper 接口方法
java
@Mapper
public interface EmpMapper {

    /**
     * 查询所有的员工及其对应的部门名称
     */
    public List<Emp> list(String name, Integer gender, LocalDate begin, LocalDate end);

}
由于 SQL 语句比较复杂,建议将 SQL 语句配置在 XML 映射文件中。
4) 新增 Mapper 映射文件 EmpMapper.xml
xml
<!--定义Mapper映射文件的约束和基本结构-->
<!DOCTYPE mapper
        PUBLIC "-//mybatis.org//DTD Mapper 3.0//EN"
        "http://mybatis.org/dtd/mybatis-3-mapper.dtd">
<mapper namespace="com.itheima.mapper.EmpMapper">
    <select id="list" resultType="com.itheima.pojo.Emp">
        select e.*, d.name deptName from emp as e left join dept as d on e.dept_id = d.id
        where e.name like concat('%',#{name},'%')
          and e.gender = #{gender}
          and e.entry_date between #{begin} and #{end}
    </select>
</mapper>
功能测试:
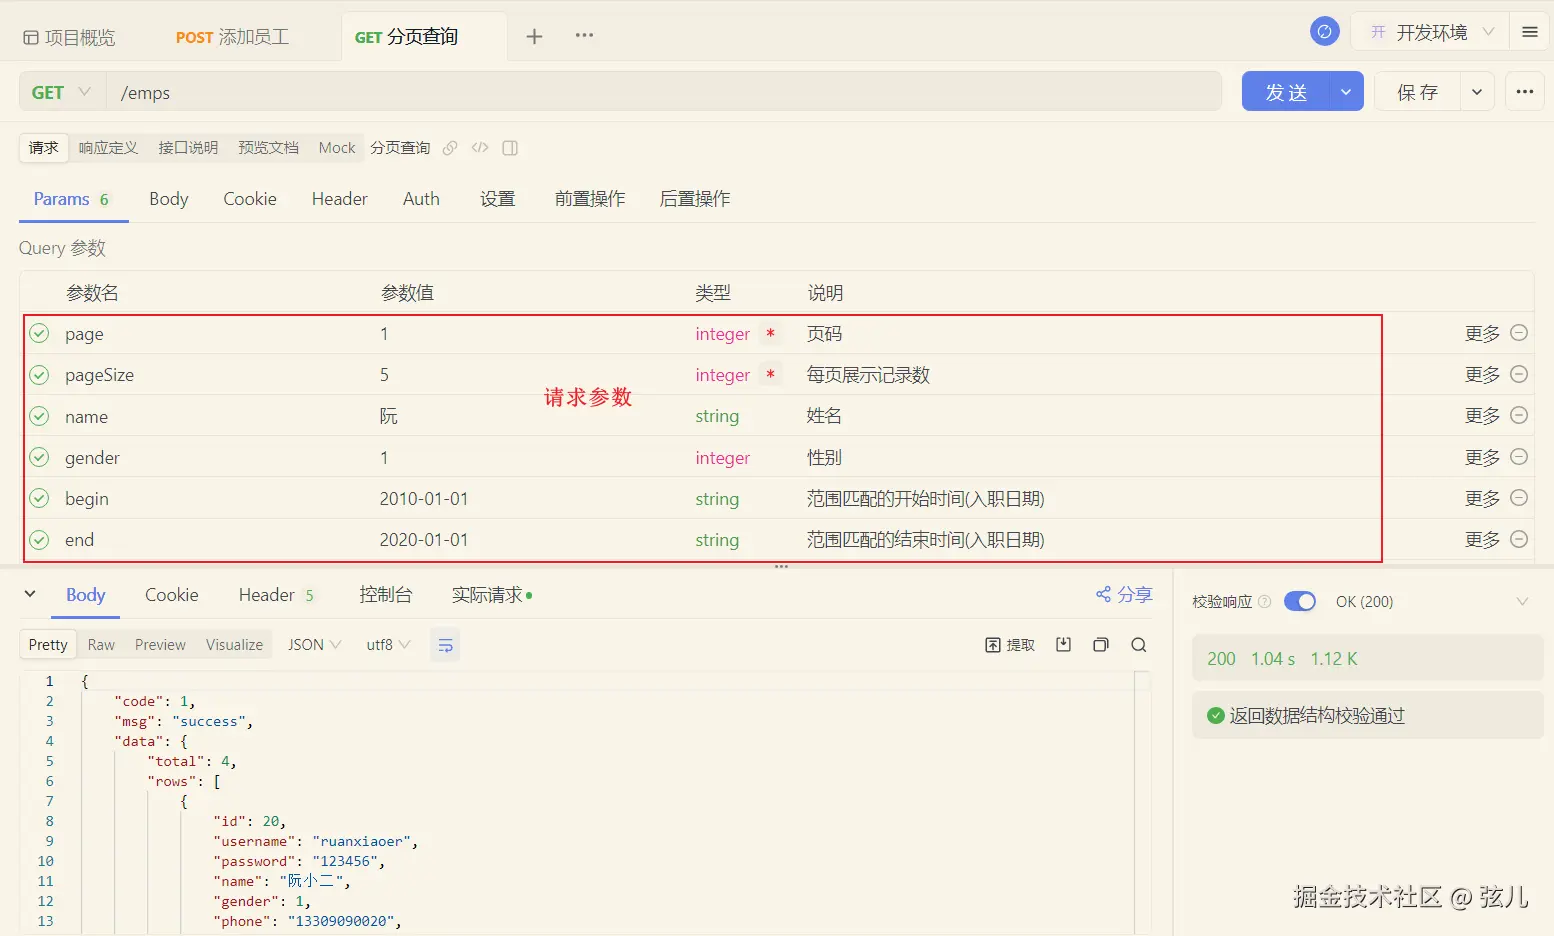
测试时需要注意传递的查询条件,有些查询条件查不到数据,因为数据库没有符合条件的记录。
程序优化 1
在上述分页条件查询中,请求参数比较多,有 6 个:
- 请求参数:
/emps?name=张&gender=1&begin=2007-09-01&end=2022-09-01&page=1&pageSize=10
在 Controller 层方法中直接声明 6 个参数,功能可以实现,但是不方便维护和管理:
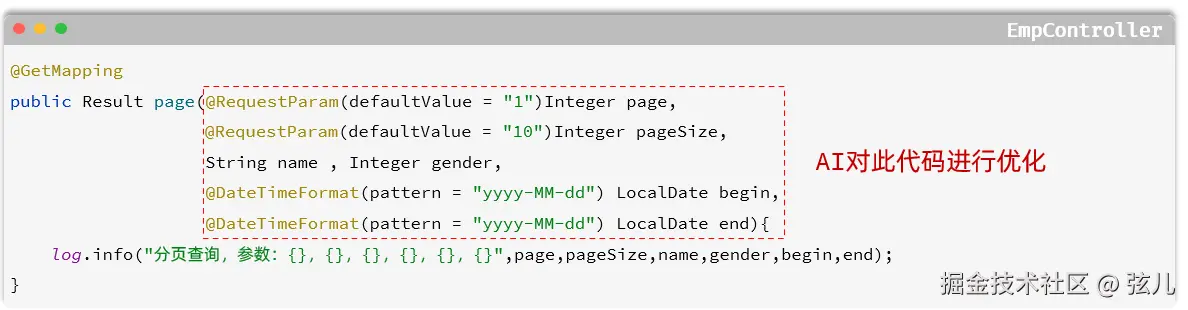
接下来,可以通过通义零码 AI 辅助工具对这块代码进行优化:
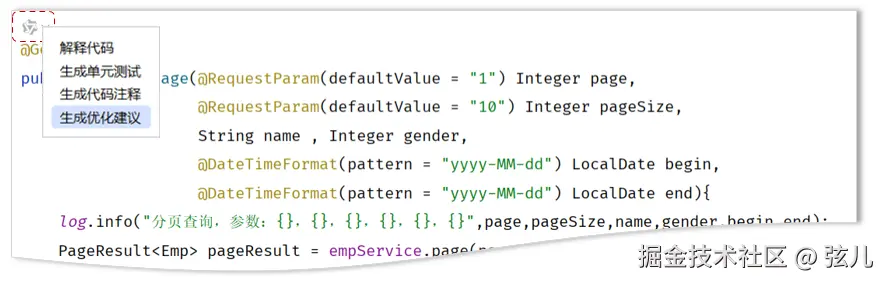
优化思路:定义一个实体类,来封装这几个请求参数【需要保证,前端传递的请求参数和实体类的属性名是一样的】。
1) 定义实体类 EmpQueryParam
java
package com.itheima.pojo;

import lombok.Data;
import org.springframework.format.annotation.DateTimeFormat;
import java.time.LocalDate;

@Data
public class EmpQueryParam {

    private Integer page = 1; //页码
    private Integer pageSize = 10; //每页展示记录数
    private String name; //姓名
    private Integer gender; //性别
    @DateTimeFormat(pattern = "yyyy-MM-dd")
    private LocalDate begin; //入职开始时间
    @DateTimeFormat(pattern = "yyyy-MM-dd")
    private LocalDate end; //入职结束时间

}
2) EmpController 接收请求参数
java
@GetMapping
public Result page(EmpQueryParam empQueryParam) {
    log.info("查询请求参数: {}", empQueryParam);
    PageResult pageResult = empService.page(empQueryParam);
    return Result.success(pageResult);
}
3) 修改 EmpService 接口方法
java
public interface EmpService {
    /**
     * 分页查询
     */
    //PageResult page(Integer page, Integer pageSize, String name, Integer gender, LocalDate begin, LocalDate end);
    PageResult page(EmpQueryParam empQueryParam);
}
4) 修改 EmpServiceImpl 中的 page 方法
java
@Service
public class EmpServiceImpl implements EmpService {

    @Autowired
    private EmpMapper empMapper;

    /*@Override
    public PageResult page(Integer page, Integer pageSize, String name, Integer gender, LocalDate begin, LocalDate end) {
        //1. 设置PageHelper分页参数
        PageHelper.startPage(page, pageSize);
        //2. 执行查询
        List<Emp> empList = empMapper.list(name, gender, begin, end);
        //3. 封装分页结果
        Page<Emp> p = (Page<Emp>) empList;
        return new PageResult(p.getTotal(), p.getResult());
    }*/

    public PageResult page(EmpQueryParam empQueryParam) {
        //1. 设置PageHelper分页参数
        PageHelper.startPage(empQueryParam.getPage(), empQueryParam.getPageSize());
        //2. 执行查询
        List<Emp> empList = empMapper.list(empQueryParam);
        //3. 封装分页结果
        Page<Emp> p = (Page<Emp>)empList;
        return new PageResult(p.getTotal(), p.getResult());
    }
}
5) 修改 EmpMapper 接口方法
java
@Mapper
public interface EmpMapper {

    /**
     * 查询所有的员工及其对应的部门名称
     */
//    @Select("select e.*, d.name as deptName from emp e left join dept d on e.dept_id = d.id")
//    public List<Emp> list(String name, Integer gender, LocalDate begin, LocalDate end);

    /**
     * 根据查询条件查询员工
     */
    List<Emp> list(EmpQueryParam empQueryParam);
}
EmpMapper.xml 中的配置无需修改。
代码优化完毕后,重新启动运行测试,依然正常运行:
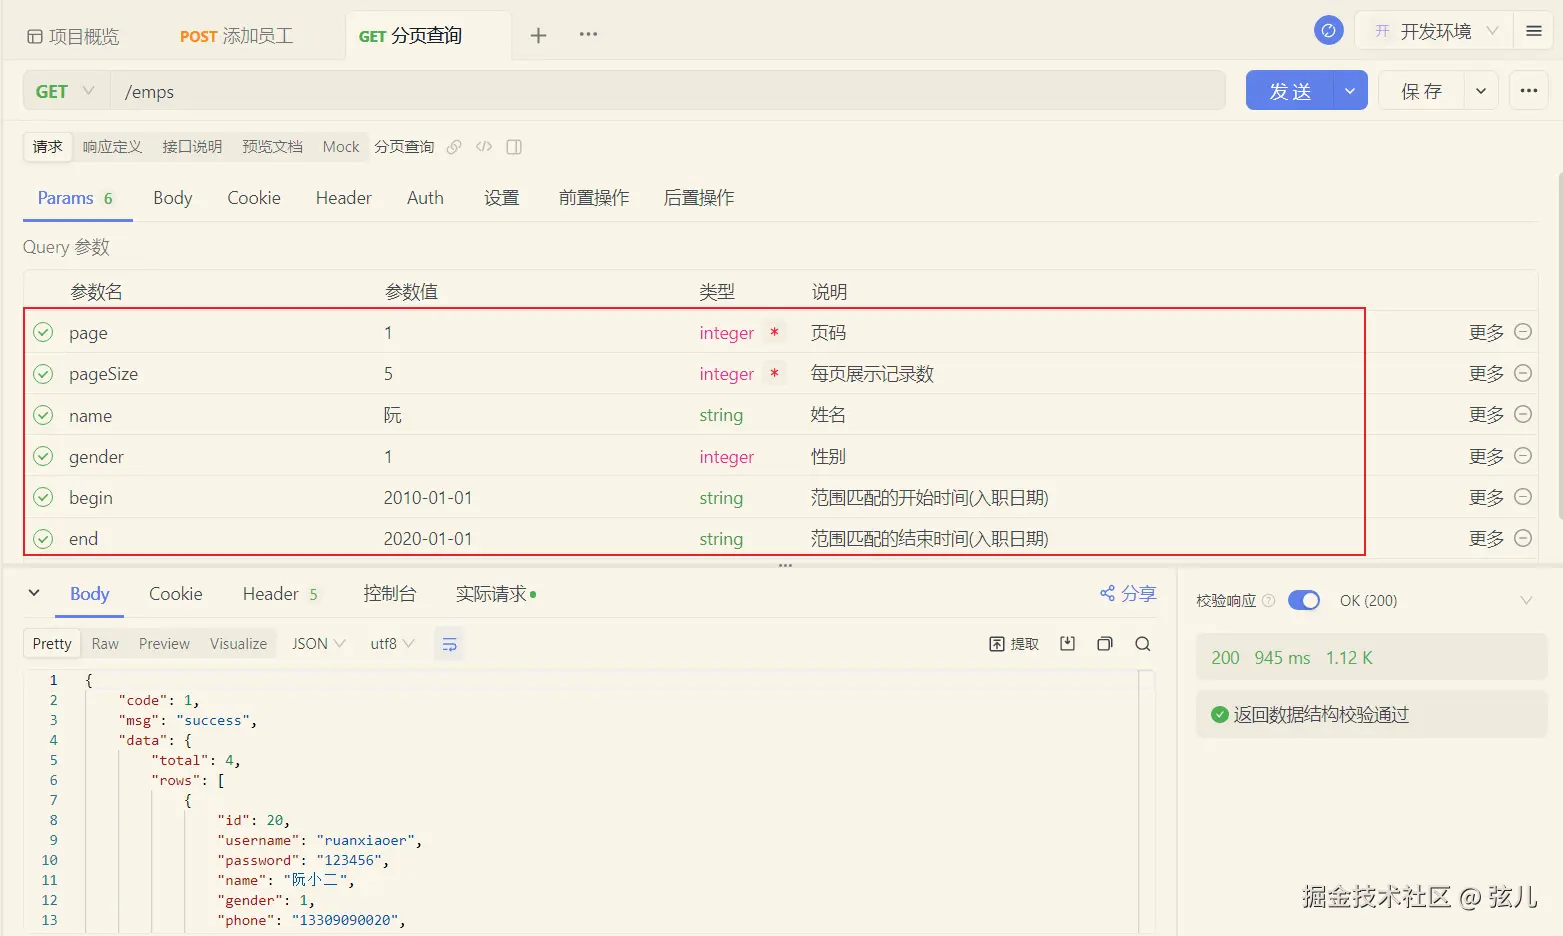
当测试时页码输入负数,查询是有问题的,查不到对应的数据:
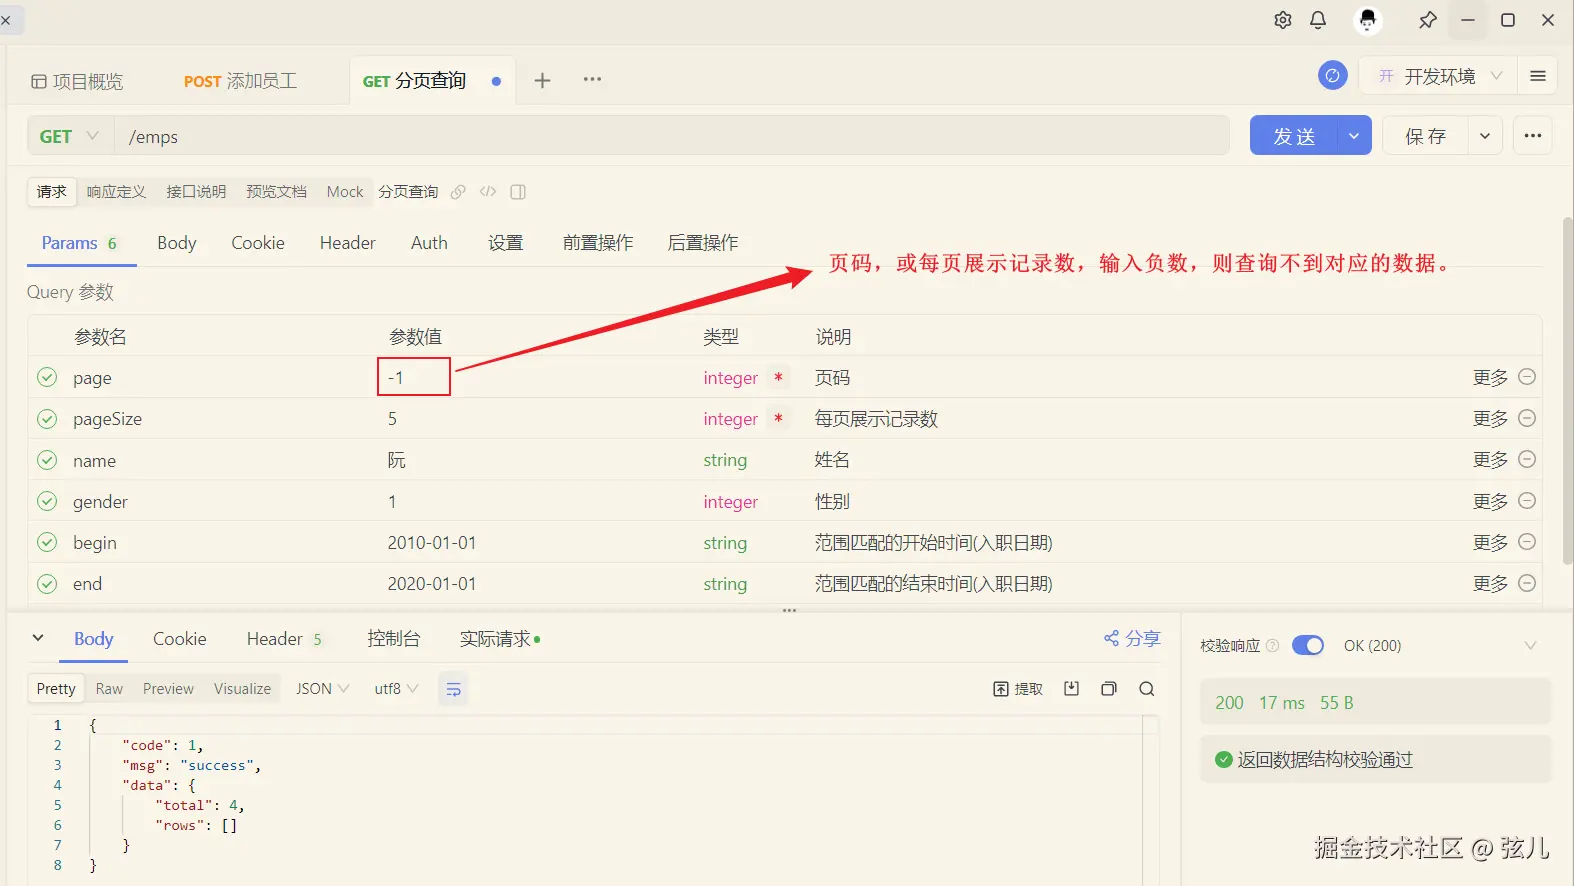
其实在 PageHelper 中,可以通过合理化参数配置 来解决这个问题,直接在 application.yml 中引入如下配置即可:
yaml
pagehelper:
  reasonable: true
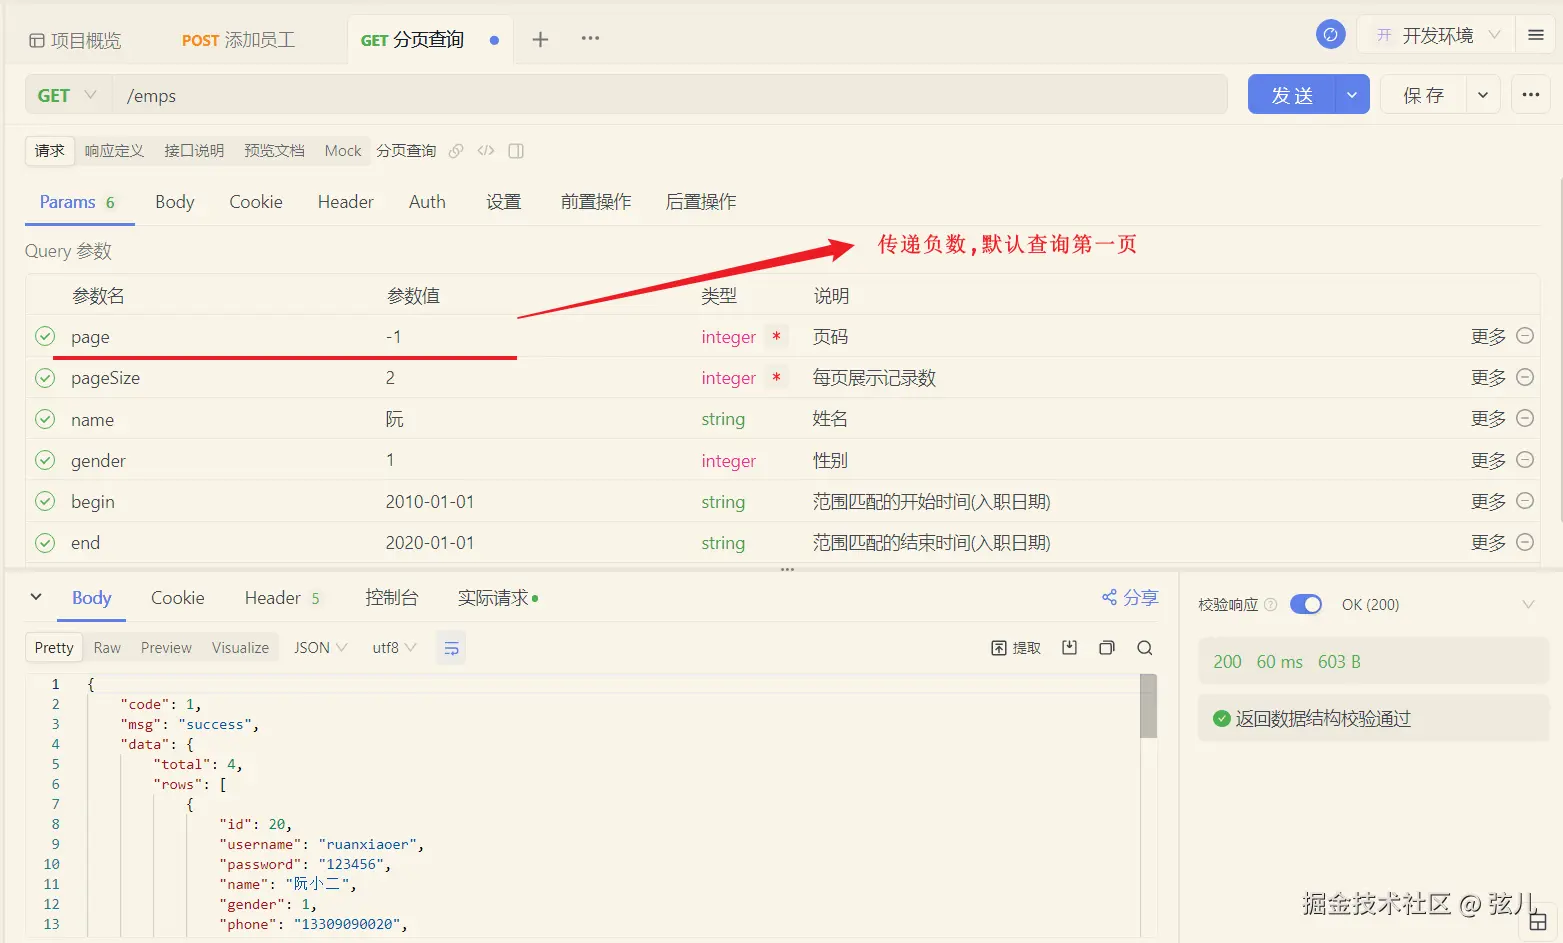
helper-dialect: mysqlreasonable:分页合理化参数,默认值为 false。当该参数设置为 true 时,pageNum<=0 时会查询第一页,pageNum>pages(超过总数)时会查询最后一页;默认 false 时,直接根据参数进行查询。
测试如下:
程序优化 2
当前查询时,Mapper 映射配置文件中的 SQL 语句查询条件是写死 的,而员工管理中根据条件查询员工信息时,查询条件是可选的,可以输入也可以不输入:

- 如果只输入姓名这个查询条件,则 SQL 语句中只根据 name 字段查询:
sql
select e.*, d.name deptName from emp as e left join dept as d on e.dept_id = d.id where e.name like concat('%',#{name},'%');- 如果只输入性别这个查询条件,则 SQL 语句中只根据 gender 字段查询:
sql
select e.*, d.name deptName from emp as e left join dept as d on e.dept_id = d.id where e.gender = #{gender};- 如果输入姓名 和性别这两个查询条件,则 SQL 语句中要根据 name、gender 两个字段查询:
sql
select e.*, d.name deptName from emp as e left join dept as d on e.dept_id = d.id
where e.name like concat('%',#{name},'%') and e.gender = #{gender};
可以看到,SQL 语句不应该是写死的,而应该根据用户输入的条件的变化而变化 ,这就需要通过 MyBatis 中的动态 SQL 来实现。
所谓动态 SQL,指的就是随着用户的输入或外部的条件的变化而变化的 SQL 语句。
具体代码实现如下:
xml
<!--定义Mapper映射文件的约束和基本结构-->
<!DOCTYPE mapper
        PUBLIC "-//mybatis.org//DTD Mapper 3.0//EN"
        "http://mybatis.org/dtd/mybatis-3-mapper.dtd">
<mapper namespace="com.itheima.mapper.EmpMapper">
    <select id="list" resultType="com.itheima.pojo.Emp">
        select e.*, d.name deptName from emp as e left join dept as d on e.dept_id = d.id
        <where>
            <if test="name != null and name != ''">
                e.name like concat('%',#{name},'%')
            </if>
            <if test="gender != null">
                and e.gender = #{gender}
            </if>
            <if test="begin != null and end != null">
                and e.entry_date between #{begin} and #{end}
            </if>
        </where>
    </select>
</mapper>
这里用到了两个动态 SQL 的标签:<if> 和 <where>,它们的具体作用如下:
📌
<if>:判断条件是否成立,如果条件为 true,则拼接 SQL。<where>:根据查询条件,来生成 where 关键字,并会自动去除条件前面多余的 and 或 or。
代码优化完毕后,重新启动服务测试:
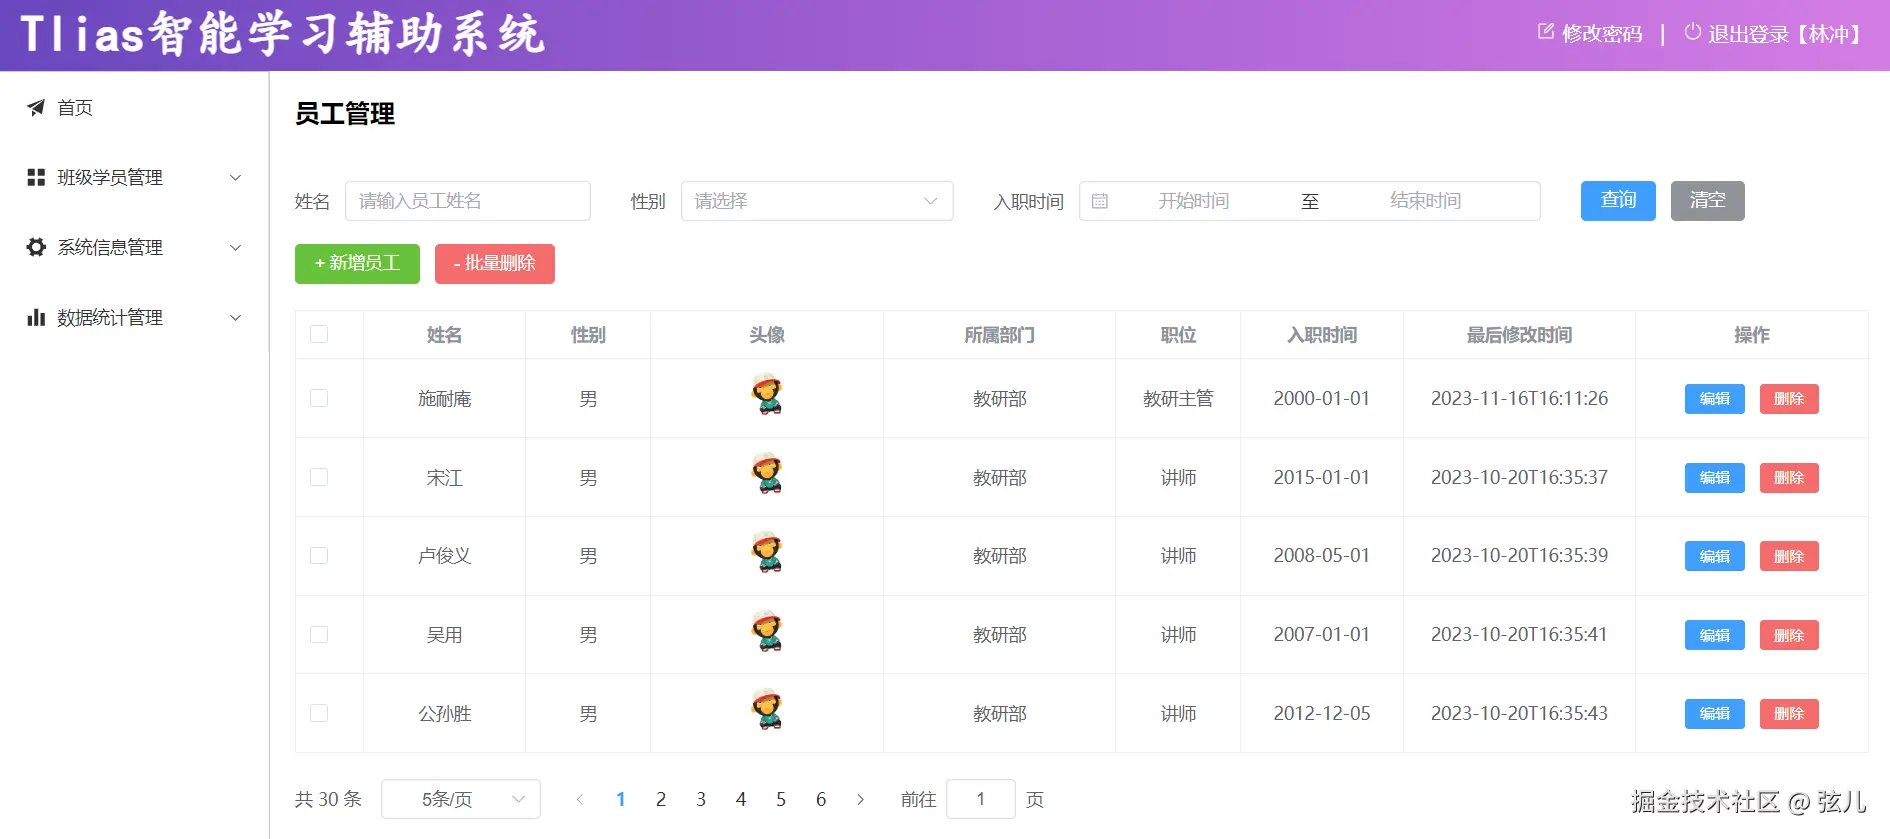
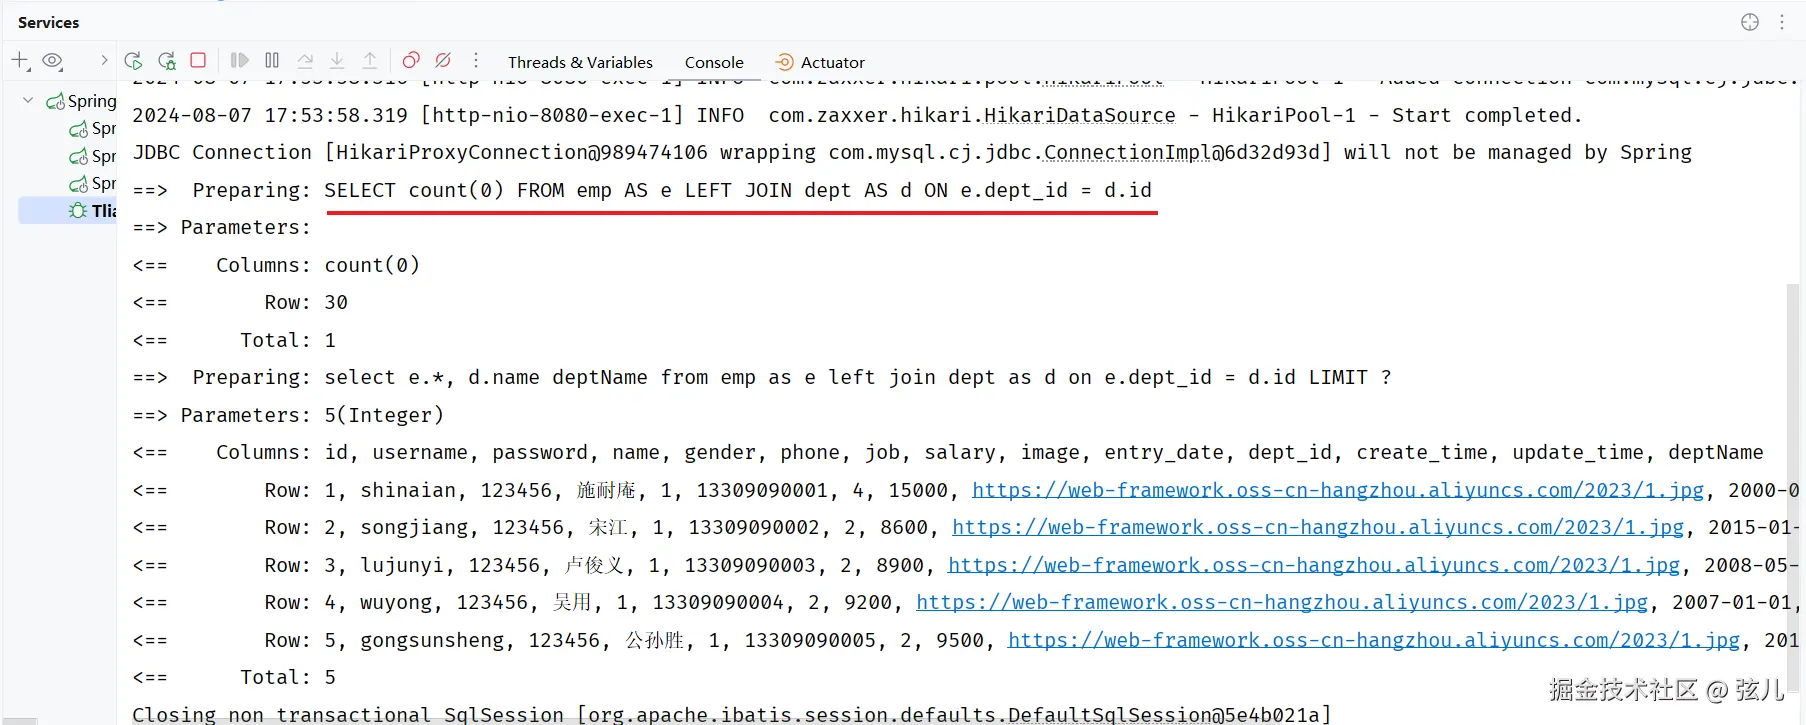
没有输入任何查询条件时,运行日志如下:
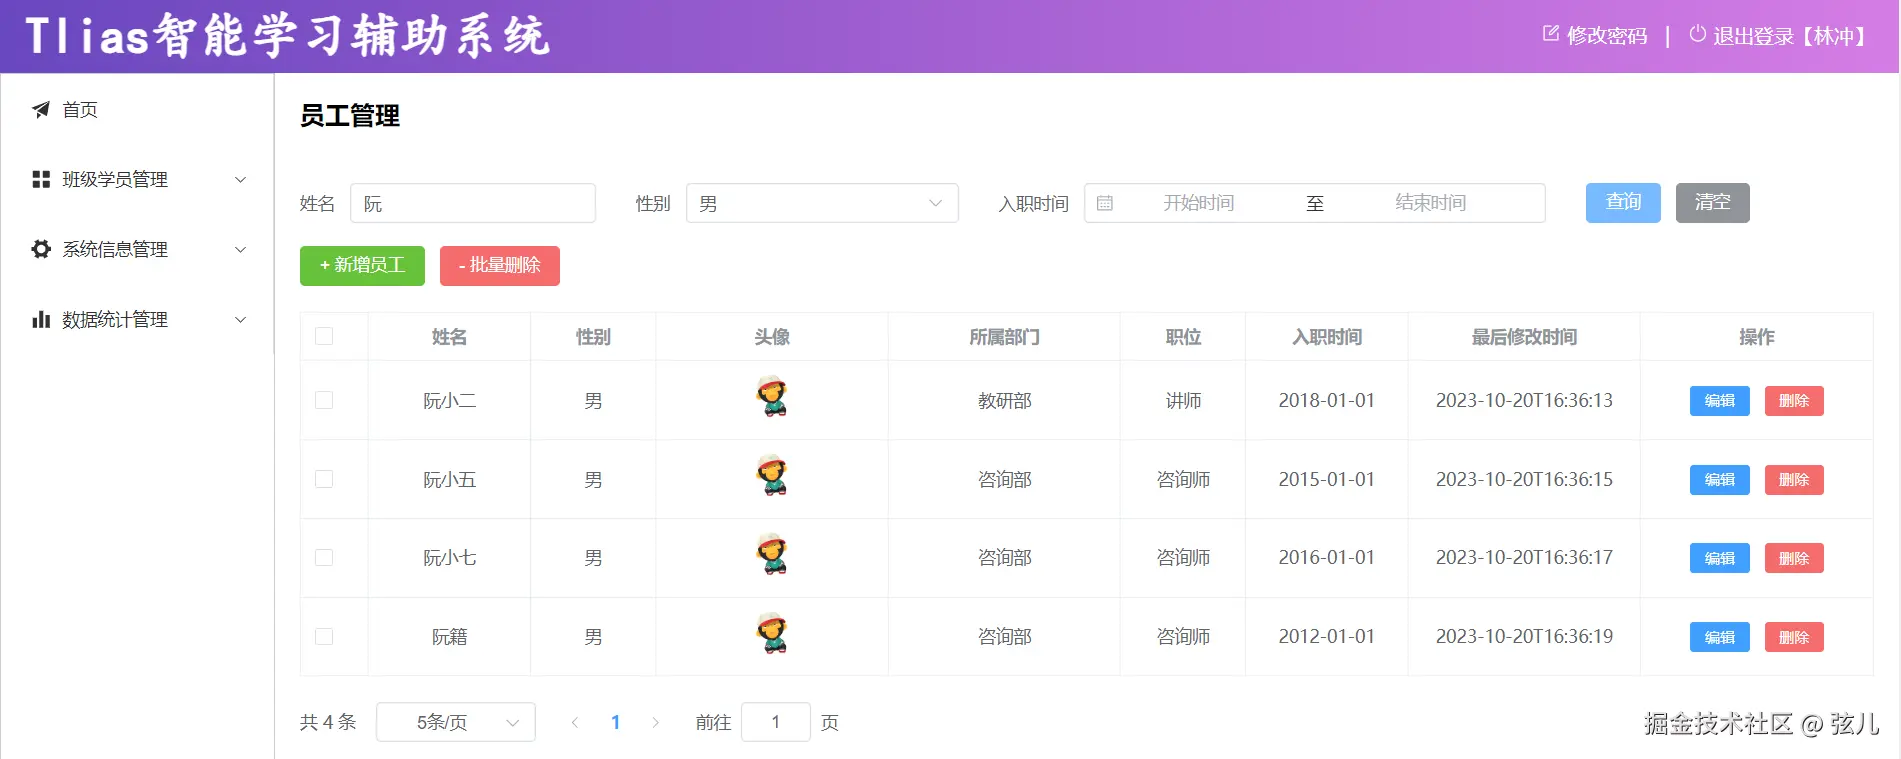
当我们输入姓名和性别时:
运行日志如下:
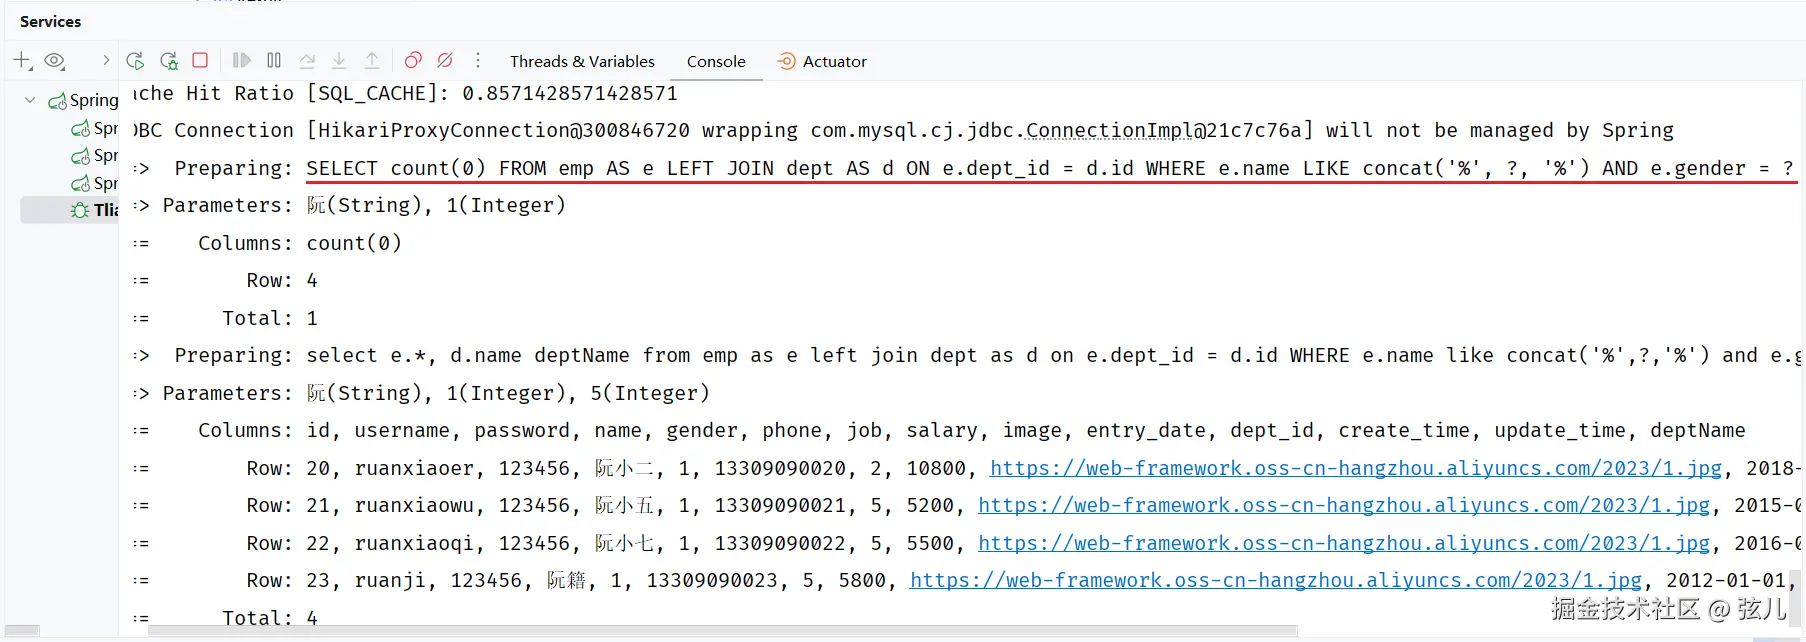
可以看到,输入不同的搜索条件时,会动态地根据查询条件拼接 SQL 语句。
五、总结
这一篇信息量不小,帮大家梳理一下主线:
- 多表关系 :一对多在多的一方加字段 关联一的一方主键;一对一是特殊的一对多,任意一方加外键 + UNIQUE;多对多建中间表 (至少两个外键)。数据库中真正建外键叫物理外键 (效率低、不适合集群、易死锁,企业基本不用),企业主流是逻辑外键(业务层解决关联)。
- 多表查询 :多表查询会先产生笛卡尔积 (30×6=180 条),加连接条件消除无效部分;内连接 取交集(隐式
from 表1,表2 where...与显式inner join ... on ...);外连接 以某一边为主表(左外最常用,与右外可互换);子查询按结果分为标量/列/行/表四类,可写在 where / from / select 之后。 - 员工列表查询 :先做准备工作(建表 + Emp 实体加
deptName属性 + 左外连接查询);再做分页查询 (limit 开始索引,每页条数,开始索引 = (页码-1)×每页条数,PageResult 封装 total + rows;原始方式两条 SQL 太繁琐,换 PageHelper 插件一行startPage搞定,SQL 结尾别加分号);最后做条件分页查询 (姓名模糊 + 性别精确 + 入职日期范围,6 个参数用EmpQueryParam实体封装,条件可选则用动态 SQL 的<if>+<where>自动拼接)。
参考内容 heuqqdmbyk.feishu.cn/wiki/XXQTwB... 黑马磊哥