资深 Java 面试到 Agent 开发工程师 · 第 12 集
不一定。Java 代码写了 new,字节码里也有 new,HotSpot 的 JIT 编译器仍可能把这次对象分配消掉。成立的前提是:它能确认这样执行不会改变程序结果。对象保存到了共享容器里、需要供后续代码使用时,通常就不能按这个办法处理。
1. 同样创建 Point,区别在哪
第 10 集讲过堆中的对象和保存引用的变量。看下面两种写法,Point 都只有两个整数:
java
public class PointDemo {
    static final class Point {
        final int x, y;
        Point(int x, int y) {
            this.x = x;
            this.y = y;
        }
    }

    static volatile Point saved;

    static int local(int n) {
        Point p = new Point(n, n + 1);
        return p.x + p.y;
    }

    static int publish(int n) {
        Point p = new Point(n, n + 1);
        saved = p;
        return p.x + p.y;
    }

    public static void main(String[] args) {
        System.out.println(local(3));   // 7
        System.out.println(publish(3)); // 7
    }
}
local() 只需要返回两个字段的和,没有把 p 交给其他代码。编译器把构造方法和后面的字段读取一起分析时,就有机会直接计算 n + (n + 1),省掉这个临时对象。
publish() 把引用写进了静态字段。其他代码可能读取 saved,拿到这个对象,分配便不能像前者那样直接省掉。volatile 让其他线程按相应可见性规则读取;即使去掉它,保存到静态字段也不会自动变成方法内部的临时对象。
两个方法返回值一样,分配行为却可能不同。单次运行这段程序能验证返回值,不能证明哪次分配已被优化。
2. 代码什么时候交给 JIT 编译
javac 通常把 Java 源文件编译成字节码。程序运行时,HotSpot 可以由解释器执行字节码;某个方法经常调用,或方法里的循环反复执行,就可能触发即时编译,也叫 JIT。JIT 生成当前机器能执行的代码,放进代码缓存,后续使用这份编译结果。
HotSpot 21 默认采用分层编译。C1 编译较快,可以生成带运行信息收集功能的代码;C2 花更多编译时间进行更复杂的优化。运行信息包括方法调用、循环和接收对象的类型等,帮助编译器判断哪些路径值得优化。
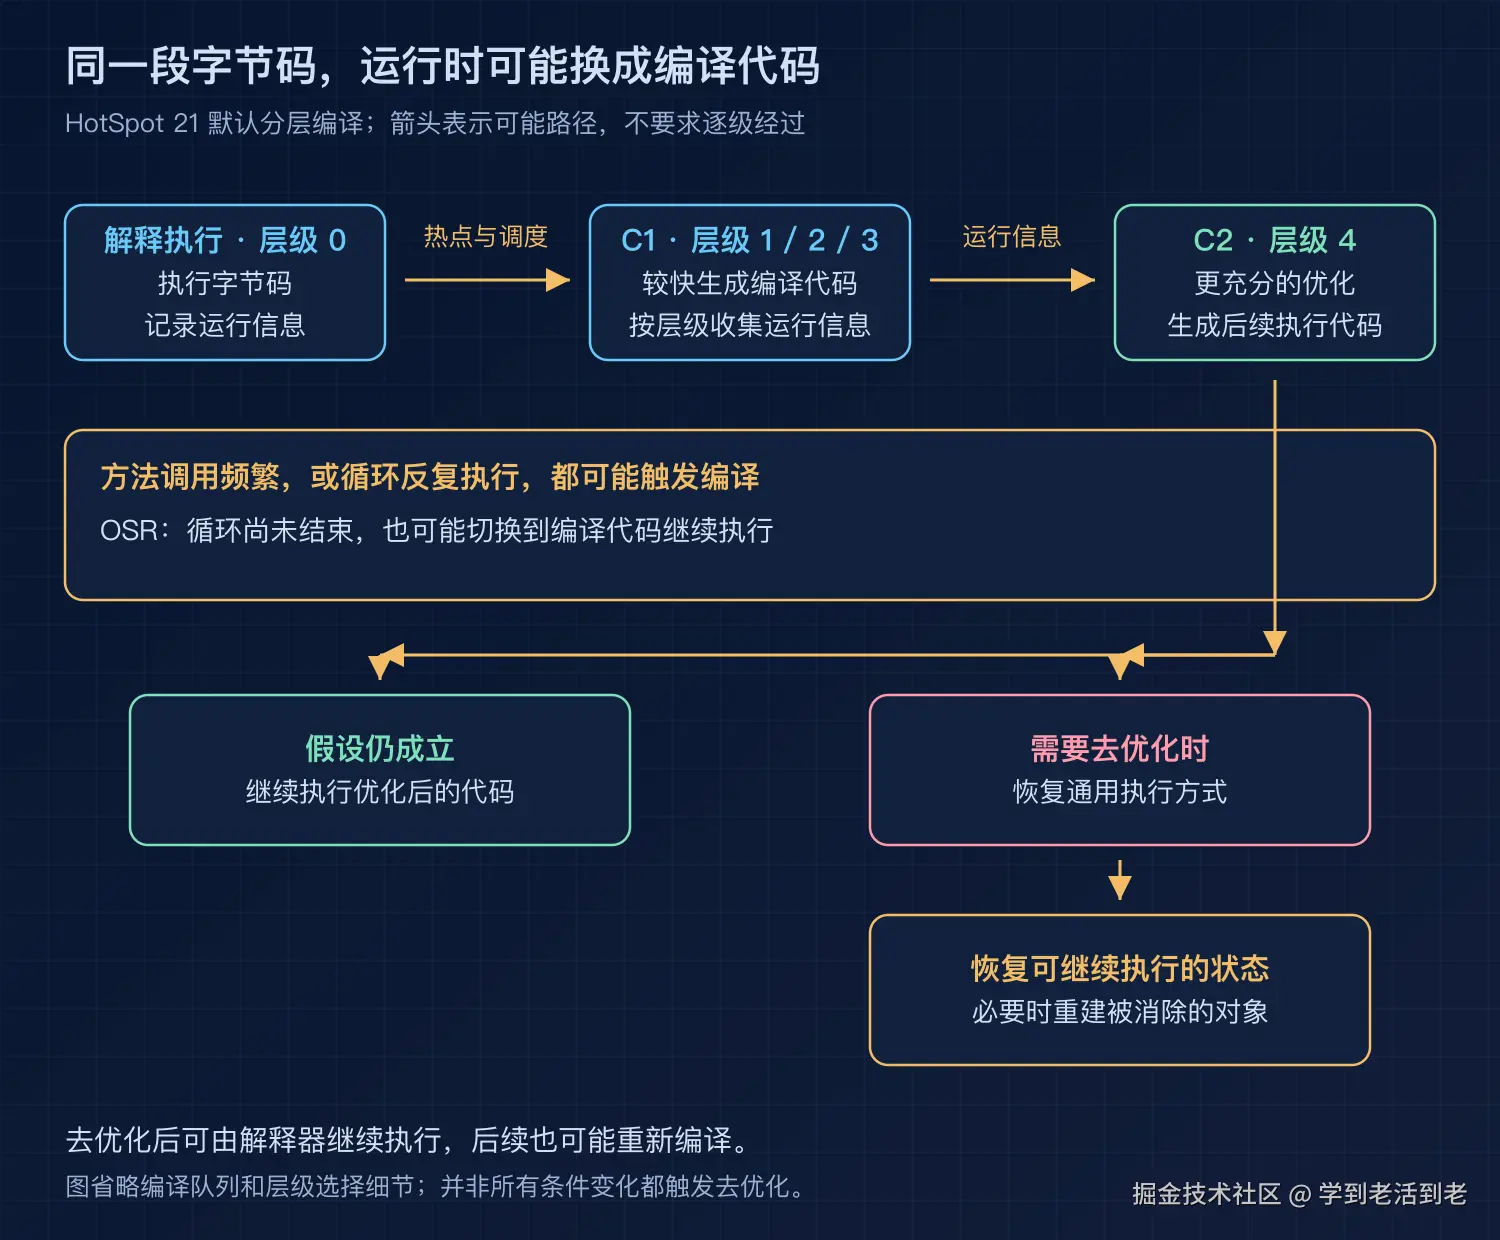
| 执行层级 | 作用 |
|---|---|
| 0:解释器 | 执行字节码,并参与收集运行信息 |
| 1:C1 | 生成较简单的编译代码,不收集 profiling 信息 |
| 2、3:C1 | 分别收集有限或较完整的运行信息,供后续编译参考 |
| 4:C2 | 利用分析与运行信息,做更充分的优化 |
不是每个方法都按 0、1、2、3、4 依次走完。HotSpot 根据热度、编译队列和已有运行信息选择路径;同一个方法也可能先后有多份编译结果。循环还没结束,也可能切换到编译代码执行,这叫 OSR,即在执行过程中替换代码。
因此,刚启动就测一次,与服务运行一段时间后的结果可能差很多。类初始化、编译和缓存变化都可能混在差异里,不能直接归因于某项优化。
3. 逃逸分析怎样让这次分配消失
编译器要追踪:新对象的引用传到了哪里,哪些代码能使用它。这个过程叫逃逸分析。
这里的"逃逸"与分析范围有关。把对象返回给调用方,意味着它离开了当前方法;把它保存到静态字段或已对外可见的对象中,可能让更大范围的代码访问它。若调用方和被调用方被一起编译,编译器又可能看到更完整的使用过程,所以不能只看方法里有没有 return p 就判定最终结果。
方法内联会影响这个范围。它把被调用方法的操作合并进调用处参与优化。对于 local(),构造方法被内联以后,C2 更容易一起分析"传入两个整数、写入字段、读取字段、相加"的过程。
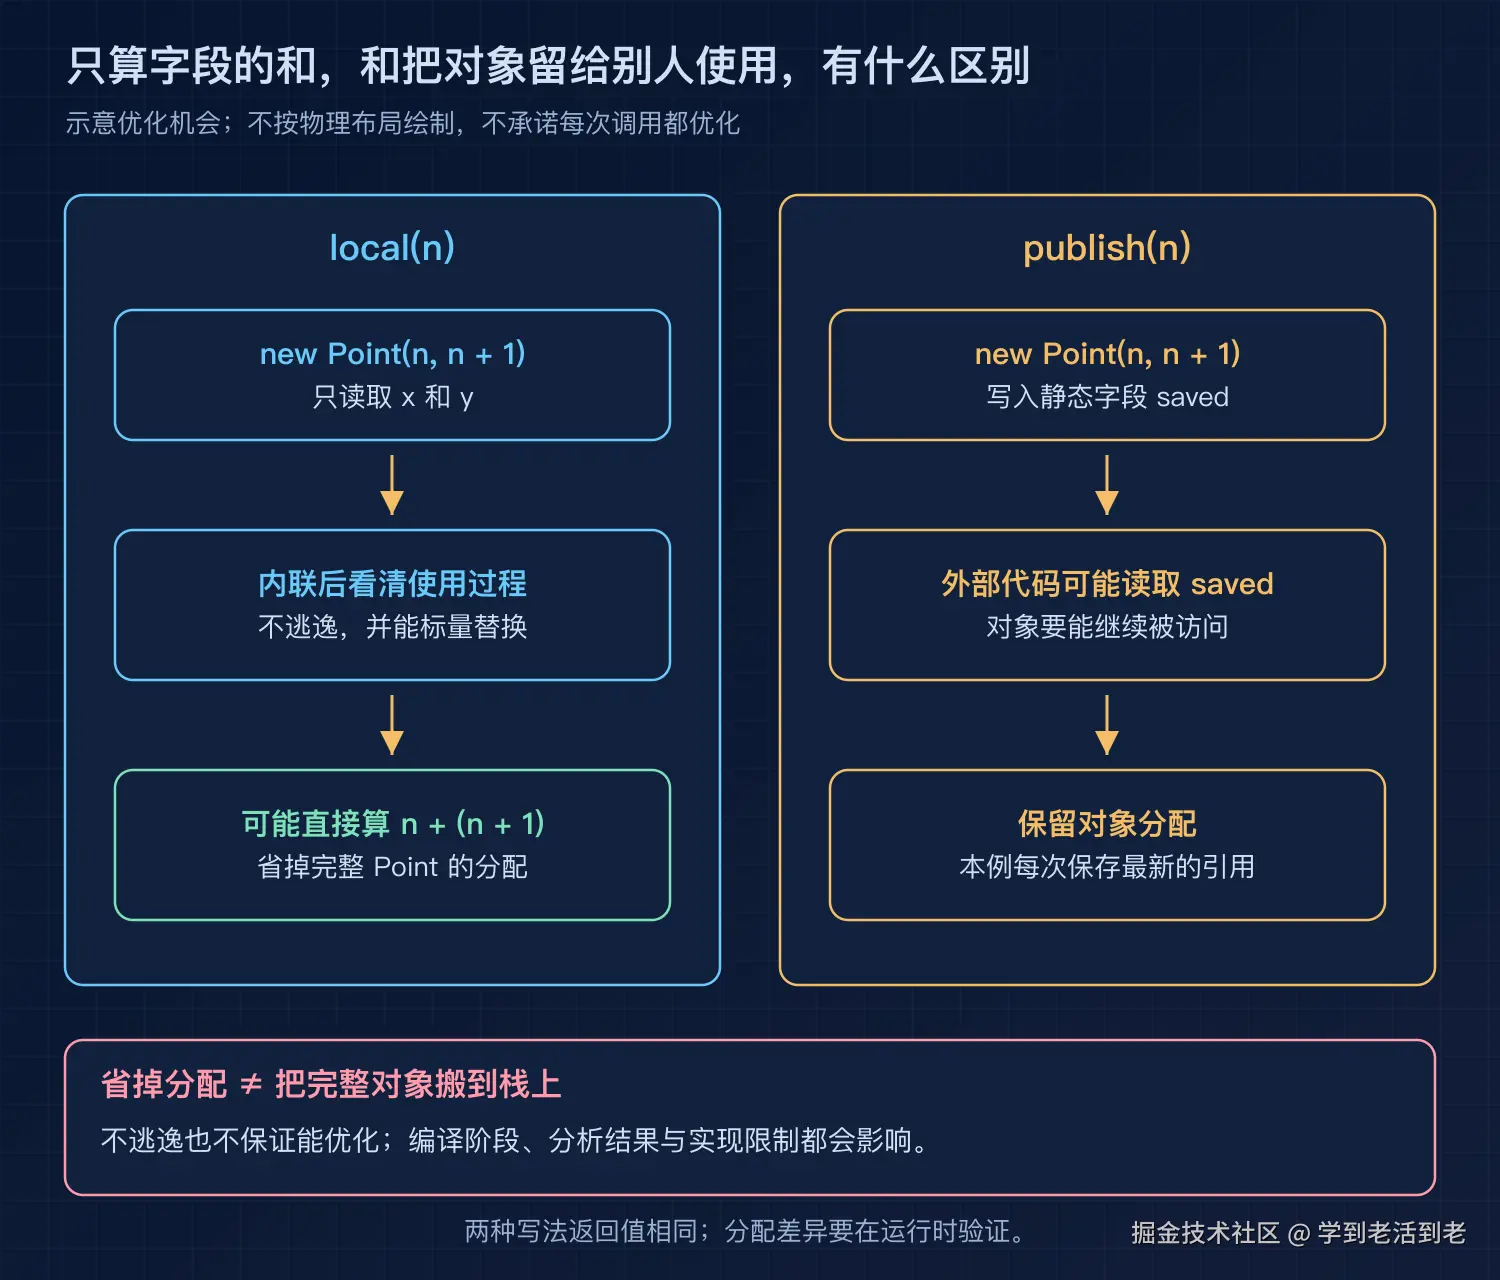
把对象拆成单独的字段值参与计算,叫标量替换。标量在这里就是 x、y 这样的单个值。后续只需这些值时,编译代码可以不分配完整的 Point。这与"把完整对象搬到线程栈上"不同;HotSpot 21 官方文档明确说明,其逃逸分析优化不会用栈分配来替换这类堆分配。
值最终放在寄存器还是栈槽,由后续编译决定。读者在 Java 代码里无法依赖这个位置。规范仍要求程序表现正确,例如 publish() 的调用者仍能拿到保存的对象。
"不逃逸"也不等于"一定能消除"。OpenJDK jdk-21+35 的 C2 源码中,筛选候选对象时同时检查:
cpp
if (noescape && ptn->scalar_replaceable()) {
    adjust_scalar_replaceable_state(ptn);
    if (ptn->scalar_replaceable()) {
        jobj_worklist.push(ptn);
    } else {
        found_nsr_alloc = true;
    }
}| 源码名字 | 含义 |
|---|---|
noescape |
分析认定对象不逃逸 |
ptn |
编译器内部代表该对象的分析节点 |
scalar_replaceable() |
检查对象能否拆成独立值 |
jobj_worklist |
保存候选对象的列表,供后续编译处理 |
found_nsr_alloc |
记录发现了不能标量替换的分配 |
调整后仍符合条件,才加入候选列表;后续还要继续处理,不是加入列表就已完成优化。
例如对象没有交给其他线程,编译器却看不清一次调用内部怎样使用它,或分析遇到复杂引用关系、实现限制,分配就可能保留。方法是否已经进入 C2 编译,也会影响观察结果。
4. 优化依赖的条件变了怎么办
JIT 可以根据运行期间观察到的类型优化方法调用。例如一处接口调用一直收到同一种实现,编译器可能带上类型检查,把这份实现的方法内联进去。
后来传入另一种实现时,原来的假设不再满足。编译代码会检查条件,根据编译方式走其他路径,或触发去优化:恢复能继续正确执行的状态,交回解释器等较通用的执行方式。后续也可能重新编译。
已经被标量替换的对象,在某些去优化路径上还需要重新创建,恢复字段值。对象消除不能破坏 Java 的可观察行为。去优化是 HotSpot 支持动态执行的一种机制,不表示业务代码一定写错了。
5. 工作中怎样确认对象分配有没有减少
比如服务为每条记录创建一个临时 Point,只用两个数算结果。是否要改代码,应当看分配量和 GC 开销;源码里 new 的数量不能回答这个问题。
本地用 HotSpot 21 对上面的两种用法做了独立进程对照:先重复调用预热,再用当前线程的累计分配字节数估算值,计算测量区间新增了多少堆分配。调用结果累加并被使用,防止整段计算因为结果无人使用而被删除。
| 对照 | 本次每次调用的平均分配量 |
|---|---|
默认配置运行 local |
0 字节 |
加 -XX:-DoEscapeAnalysis,关闭逃逸分析后运行同一 local |
24 字节 |
默认配置运行 publish |
24 字节 |
每种配置各跑三个独立 JVM,每次预热后测量 200 万次调用,结果一致,计算校验值也一致。它支持本例的临时分配被消除这一判断;24 字节是当前运行版本与布局下的观测值,不是所有 Point 的固定大小。这是小程序对优化机会的验证,不是服务性能收益。分配字节数变少,不自动等于请求延迟按同样比例下降;真实请求还可能消耗在数据库、网络和锁等待上。
正式比较小段 Java 代码,可用 JMH。预热让代码有机会进入稳定执行阶段;测量多轮并 fork 多个 JVM,减少某个进程已有编译状态的影响。返回计算结果,或交给 Blackhole 消费,避免无用计算被删。把输入设为运行时状态,避免编译器把固定答案提前算好。
不要为了防止消除,把本来局部使用的 Point 存到静态容器,再声称测到了原方法:保存对象已经改变了逃逸条件。如果要测原方法的优化效果,返回它算出的整数即可;如果研究对象发布开销,则单独保留发布版本。
想观察首段 PointDemo 的编译过程,可以把 main 换成下面这个版本,再重新编译:
java
public static void main(String[] args) {
    long sum = 0;
    for (int i = 0; i < 2_000_000; i++) {
        sum += local(i);
    }
    System.out.println(sum);
}
sh
java -XX:+UnlockDiagnosticVMOptions -XX:+PrintCompilation -XX:+PrintInlining PointDemo输出中查找 PointDemo::main、PointDemo::local 和构造方法。实际运行中的一行是:
text
29 9 4 PointDemo::local (22 bytes)左边依次是启动后的毫秒数、编译编号和层级;4 表示本篇配置下的 C2 编译。内联输出还会列出调用目标及成功或未内联的原因,inline (hot) 表示热点调用被内联。服务也可以在诊断环境加这些参数,再执行相关请求;日志可能很多,适合短时查看。这些记录帮助确认编译条件,仍不能单独证明某个 new 已被消除。
微基准之后,还要在接近真实请求和数据量的压测中对比分配速率、GC 时间、吞吐和延迟。关闭逃逸分析用于诊断对照,不是线上加速配置。
常见面试题怎么答?
1. Java 对象一定在堆上分配吗?
JVM 规范用堆描述类实例和数组的存储。实际执行时,HotSpot JIT 能消除部分不可观察的对象分配,例如 local() 里的临时 Point。逃逸分析帮助确定引用用途,标量替换让字段独立参与计算;不能把这种优化概括成所有局部对象都在栈上分配。不逃逸、能标量替换、进入合适的编译阶段等条件都要满足。
2. 什么是内联,为什么会影响逃逸分析?
内联把调用目标的操作纳入当前编译范围,让编译器一起分析参数、字段和返回值。原本从一个小方法返回的对象,调用方可能只读两个字段;把两边一起看,就可能消除这次分配。内联受目标是否明确、方法大小等条件限制,方法小也不保证一定内联。
3. 分层编译和去优化分别解决什么问题?
分层编译在启动开销和后续执行效率之间做取舍:解释器、C1 和 C2 参与不同阶段,收集信息后对热点做更充分的优化。去优化处理编译假设失效等情况,恢复正确的执行状态;随后可能重新编译。两者都说明执行代码会变化,因此微基准需要预热、多个进程和防止无用计算被删。
读完自测
1. javap 里仍有 new Point,能证明运行时一定分配了 Point 吗?
参考要点:不能。javap 展示字节码,JIT 在运行期还能继续优化。应在明确版本、预热条件下观察分配,并做合适对照;一次耗时和一次 GC 次数不足以证明。
2. 一段方法只创建并返回 Point,是否肯定不能消除分配?
参考要点:要看调用处。若调用方被一起编译,只取字段算整数,可能消除;若把返回对象存入共享列表继续使用,就与前者不同。源码中的单个方法边界不一定是最终优化边界。
3. 默认配置下临时对象几乎不产生分配,线上仍有很多同类对象,先查什么?
参考要点:检查实际调用是否保存、返回或传递对象,以及调用是否按预期编译和内联。真实路径、输入类型、运行时长都可能与小实验不同。结合分配分析和编译信息定位,不因实验能优化就断定线上也已消除。
参考资料与实验说明
实际运行使用 Zulu HotSpot 21.0.12.1(build 21.0.12.1+1-LTS),源码核对固定 OpenJDK jdk-21+35。分配实验使用 64 MiB 堆和 -Xbatch 让编译同步完成,只观察分配量与计算结果,没有计时,也没有运行 JMH 或真实服务压测。