一、故障现象:产线突然反馈操作卡顿
10月23日上午11:15,产线现场反馈业务操作缓慢,部分页面提交超时,影响现场生产作业。
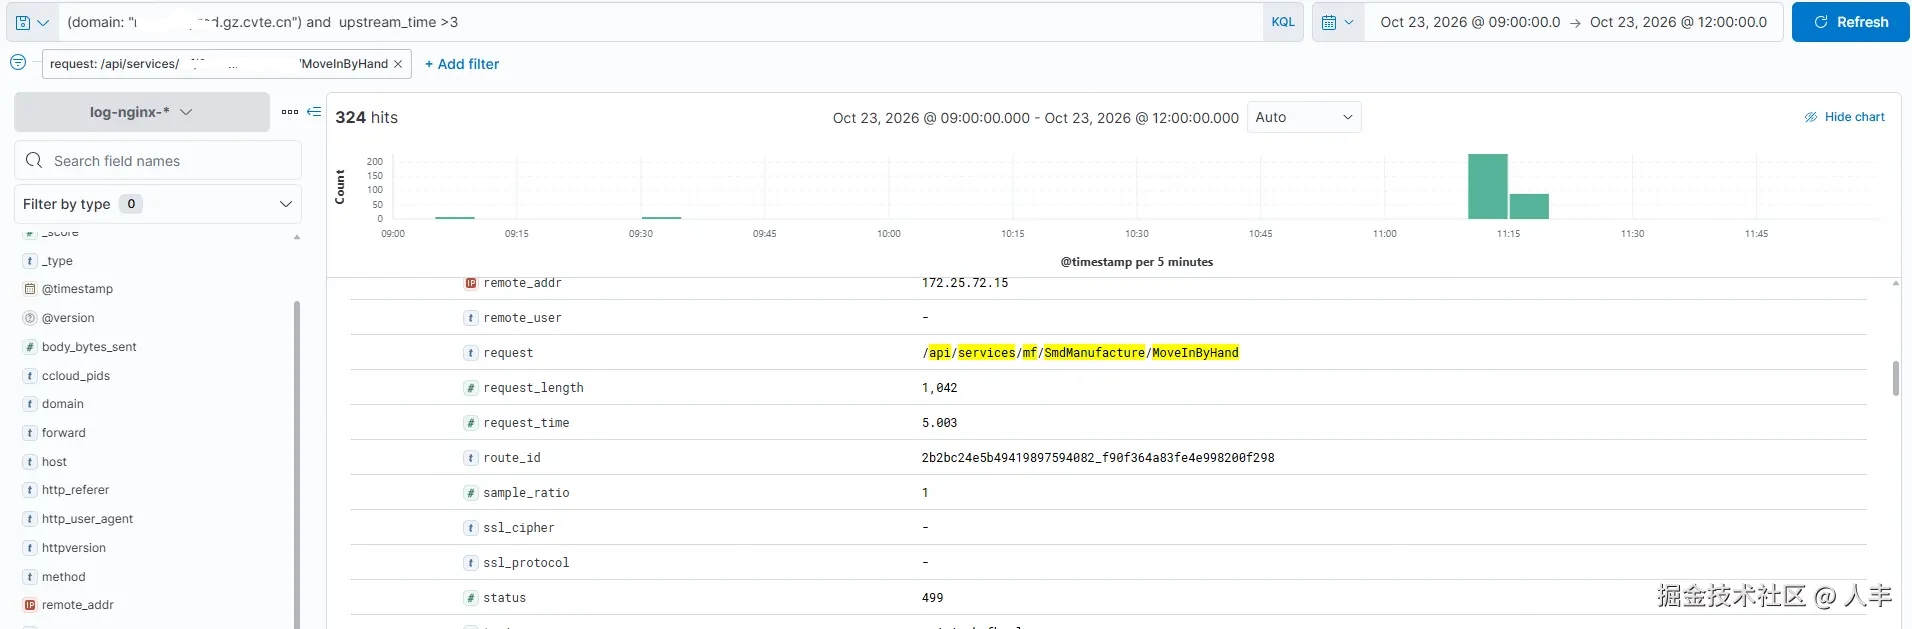
✅ 第一步:查看Nginx接口日志,查看核心MES进站接口:/api/services/mf/SmdManufacture/MoveInByHand,发现大量请求upstream_time > 3秒、也有返回499(有些上位机超过5秒自动取消请求导致499),请求集中爆发时段正好是 11:10~11:25,和产线反馈卡顿时间完全吻合。
✅ 第二步:排查应用容器资源 查看业务服务容器监控:CPU、内存水位平稳,没有冲高、没有OOM、没有线程池打满的迹象,排除应用本身资源瓶颈。
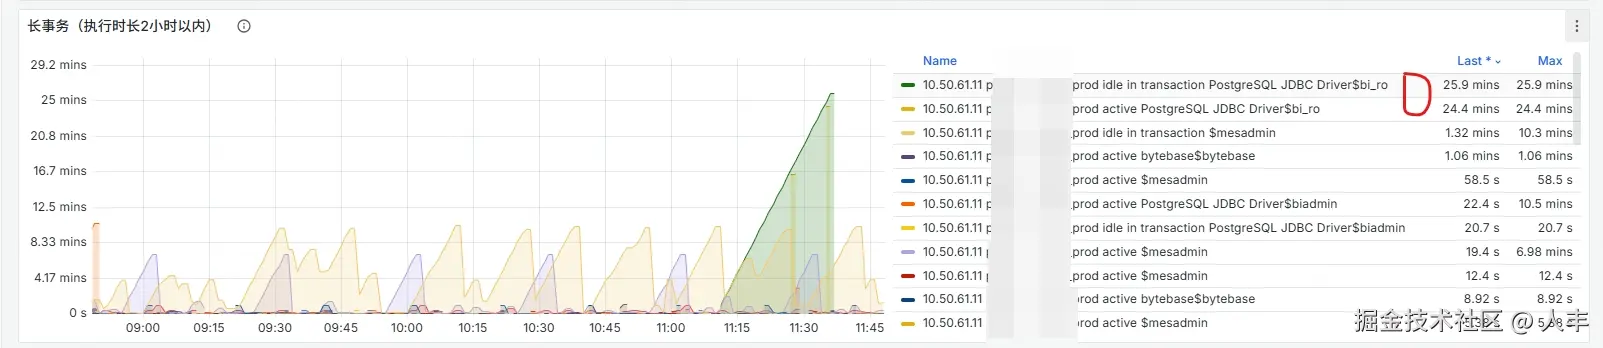
✅ 第三步:转向数据库排查,找到根因线索 来到数据库监控面板,一眼发现异常:数据库出现大量idle in transaction长事务,最长事务达到25.9分钟,执行账号为bi_ro。 和数仓团队确认:这个账号是数仓定时抽取数据所用账号,长事务来自数仓的数据抽取任务。
这里先科普一个关键知识点:PostgreSQL长事务的危害 PostgreSQL的MVCC机制依靠快照实现,只要存在一个长时间不提交、不回滚的事务,数据库就不能清理旧版本数据(死元组),表膨胀、vacuum无法正常回收空间;同时会阻塞主从同步、复制槽,严重时直接拖垮整个库的查询性能,业务SQL抢锁、扫描旧数据版本,最终表现就是产线业务越跑越慢。
二、梳理我们当前两套同步链路
先理清环境架构,方便理解后面的冲突难点:
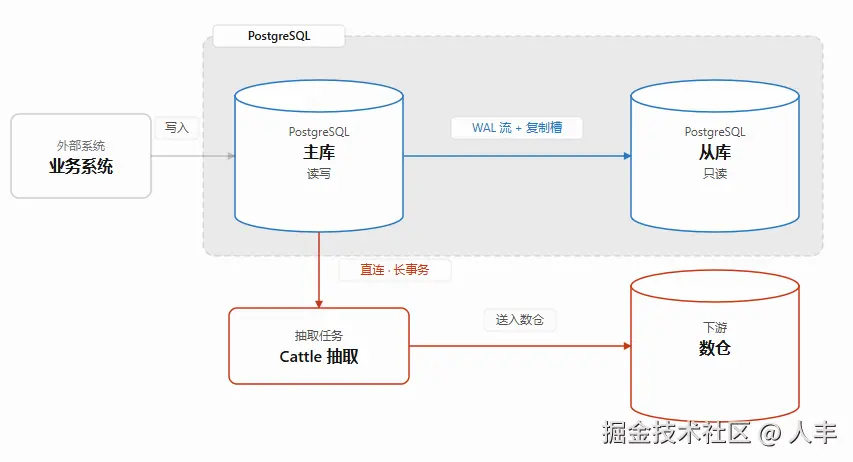
链路A:主库 → 从库(WAL主从复制)
PostgreSQL主库在数据变更时,会持续生成WAL(预写日志)。
- 主库产生WAL日志流;
- 从库通过**复制槽(replication slot)**订阅主库的WAL;
- 主库会保留还没有被从库消费完成的WAL文件,不会自动清理;
- 从库回放WAL,保持和主库数据一致,承担只读查询、分流压力。
复制槽的核心作用:保证主库不会提前删掉从库还没消费完的WAL,避免从库断同步、数据丢失。
链路B:主库 → 数仓(Cattle定时抽取任务)
我们数仓使用Cattle定时任务做数据抽取,当前抽取是直连PostgreSQL主库执行大查询 ,也就是本次故障的源头: 数仓的大查询开启事务后,查询耗时很久,事务长时间处于idle in transaction,形成长事务。
👉 大家第一反应:那把Cattle抽取改成读从库不就行了? 这里就是本次最棘手的坑:直接切从库抽取,会和主从复制槽冲突,抽取任务大概率超时报错。
为什么从库抽取 + 主从复制槽会冲突?
这里给大家讲清楚原理:
- PostgreSQL从库是只读备库,本身不支持独立的快照隔离,备库的查询快照依赖主库的WAL流;
- 备库上长时间运行的只读查询,会hold住一个快照,这个快照会要求:主库不能清理这个快照之前的WAL;
- 如果备库同时存在长查询 + 复制槽,会叠加约束:主库必须同时保留「复制槽需要的WAL」+「备库长查询快照需要的WAL」;
- 一旦Cattle的抽取是超大范围查询、执行时间很长:
- 备库查询持有快照不释放 → 主库WAL无法回收,WAL日志疯狂堆积;
- 如果WAL磁盘空间不足,主库直接阻塞写;
- 同时备库回放WAL会被快照卡住,复制延迟持续走高,抽取查询本身也会因为版本、回放节奏问题超时失败。
简单一句话总结:
备库长查询会阻止主库回收WAL,复制槽又强制保留WAL,两者叠加,风险被放大,直接导致抽取任务不稳定、容易报错。
✅ 架构简图
三、当前我们的可选方案对比
结合上面的冲突原理,我们梳理了2个可行方案,也抛出来和各位技术同行一起讨论:
方案1:Cattle抽取继续读主库,做任务侧优化(短期止血)
优点:改动最小,不用改链路,不会触发复制槽冲突 优化动作:
- 拆分超大抽取SQL,避免单条SQL扫描全表;
- 设置事务超时,强制回收长时间空闲事务,避免
idle in transaction常驻; - 错峰调度:把数据抽取调度到凌晨业务低峰,避开白天产线业务高峰期;
- 抽取SQL加合适limit、增量抽取,不每次全量拉取; 缺点:抽取依然会占用主库资源,极端情况依然会产生长事务影响产线。
方案2:新增独立从库(专门给数仓抽取使用,独立复制槽)
优点:
- 业务读压力、数仓抽取压力物理隔离;
- 专属从库单独配置复制槽,数仓长查询只会影响这一条复制链路,不影响业务使用的备库;
- 业务主从同步不受数仓任务影响,是企业比较成熟稳定的方案。 缺点:需要新增服务器资源,有硬件成本,需要维护多一套备库。
四、本次故障复盘小结
- 产线业务卡顿,根因不是应用、不是容器资源,而是数仓抽取任务带来的长事务;
- PostgreSQL
idle in transaction长事务是隐形杀手,表面看查询已经跑完,事务没提交,快照一直持有,阻塞vacuum、影响整个库性能; - 不是简单一句"数仓读从库"就能解决,物理备库长查询 + 复制槽有天然的WAL保留冲突,这个坑很多团队都会踩;
- 数仓、BI、报表类大查询,是生产数据库长事务高发源头,一定要做链路隔离,不要直接共用业务主库。
关于这个场景,各位数据库大佬、运维同行,如果你们遇到过类似PostgreSQL备库+复制槽+数仓抽取的场景,有没有更优、低成本的方案?欢迎在评论区一起交流讨论。