摘要:本文系统梳理了语音合成与变声技术在十大典型业务场景中的落地实践,涵盖电商直播多语种解说、短视频批量配音、在线教育互动朗读、企业客服拟人化应答、有声书角色音色克隆、游戏 NPC 实时语音、营销广告 A/B 测试、无障碍阅读辅助、跨语言会议翻译以及规模化成本优化。文章从技术选型、部署架构到优化策略逐层展开,为开发者和技术负责人提供了一套可复用的音频生产解决方案,帮助团队在不增加人力负担的前提下,将声音转化为产品增长的强力引擎。
关键词:语音合成;变声技术;TTS;音色克隆;多语种解说;情感化配音;实时语音合成;A/B 测试;无障碍阅读;规模化部署
在内容创作和交互体验飞速迭代的今天,声音作为一种核心载体,其价值早已超越了简单的"发声"。无论是电商直播间里需要瞬间切换的多语种解说,还是在线教育中那些能让课件"活"起来的互动朗读,传统的人工录音模式往往面临着成本高、周期长、灵活性差的瓶颈。很多团队在尝试规模化生产音频内容时,常常卡在"一人难分饰多角"或"多语言实时响应"的难题上,导致创意落地受阻,用户体验也难以达到预期。
其实,解决这些痛点的关键并不在于堆砌人力,而在于如何巧妙利用现代化的语音合成与变声技术,构建一套灵活、高效且低成本的音频生产流。对于开发者和技术负责人而言,理解不同场景下的技术选型与部署路径,是将创意转化为生产力的第一步。本文将深入探讨从直播互动到有声书制作等十大典型场景,分享具体的技术落地方案与优化策略,帮助你在不增加额外负担的前提下,让声音成为产品增长的强力引擎。
① 电商直播实时变声与多语种解说场景
电商直播对时效性和互动性的要求极高,主播往往需要在同一场直播中应对来自不同国家的观众,或者为了节目效果需要快速切换不同的角色音色。传统的做法是聘请多位外籍主播或配音演员,但这不仅成本高昂,且难以保证随时待命,一场跨境大促往往要提前数周协调排期。通过集成实时语音转换(Real-time Voice Conversion)和多语种文本转语音(TTS)引擎,可以把「多语言 + 多音色」的能力沉淀为直播中台的一项基础服务,实现毫秒级的延迟响应。
从业务价值看,这套方案主要解决三类真实痛点:一是跨境直播的语言壁垒 ,让一位中文主播同时覆盖英语、日语、韩语等多个市场;二是角色化直播的娱乐效果 ,同一主播可瞬间切换「温柔客服」「激情促销员」「卡通吉祥物」等音色,提升停留时长;三是人力成本的刚性下降,无需为每场直播配置多语种配音团队,边际成本趋近于零。
技术架构与核心模块
一套完整的电商直播语音方案通常由四个核心模块组成,其整体架构与数据流转如下图所示: 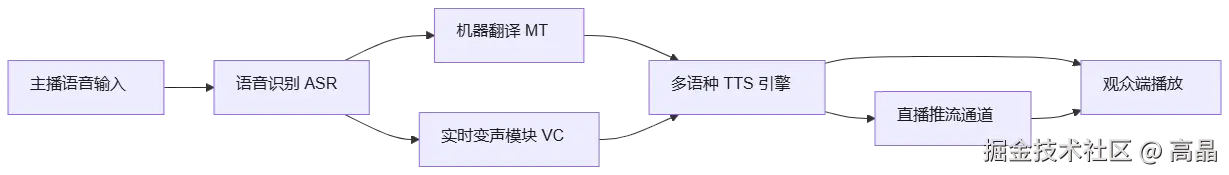
- 语音识别(ASR):实时采集主播语音并转写为文本,作为后续翻译与合成的输入源。
- 机器翻译(MT):将源语言文本流式翻译为目标语言,支持中英日韩等多语种切换。
- 多语种 TTS 引擎:将翻译后的文本合成为目标语言的语音,支持流式输出与音色切换。
- 实时变声模块(VC):对主播原始语音进行音色转换,实现"一人多角"的娱乐效果。
在实际部署中,我们可以采用流式处理架构。当主播输入中文指令时,系统先通过高质量的翻译模型将其转换为目标语言文本,再立即送入支持多语种的 TTS 引擎生成音频。关键在于选择支持流式输出的模型,确保首字延迟控制在 200ms 以内,避免直播出现明显的停顿感。同时,利用变声技术,同一个主播可以瞬间切换成「温柔客服」「激情促销员」甚至「卡通吉祥物」的声音,极大地丰富了直播间的娱乐属性。
需要特别注意的是音色一致性问题 :多语种解说时,同一主播在不同语言下应保持相近的音色与语速,否则观众会明显感到「换了个人」。实践中通常采用「跨语言音色克隆」方案------用主播少量参考音频提取音色嵌入(Speaker Embedding),再与各语种的 TTS 声学模型结合,从而在英语、日语输出中保留主播本人的音色特征。此外,直播间的商品名、价格、优惠券口令等关键信息建议走术语白名单,避免翻译模型把品牌名误译,导致观众听错下单信息。
python
# 示例:流式多语种语音生成 + 跨语言音色保持
import asyncio
from typing import AsyncIterator

async def stream_live_voice(
    input_text: str,
    target_lang: str,
    speaker_embedding: bytes,   # 主播音色嵌入,跨语种复用
    glossary: dict | None = None,
) -> AsyncIterator[bytes]:
    """直播场景的流式多语种语音生成"""
    glossary = glossary or {}

    # 1. 术语保护:先把品牌名/价格等替换为占位符,翻译后再还原
    protected, mapping = protect_terms(input_text, glossary)

    # 2. 流式翻译
    translated_stream = translation_engine.translate_stream(protected, target_lang)

    # 3. 流式 TTS,逐块产出音频并直接推流
    async for text_chunk in translated_stream:
        text_chunk = restore_terms(text_chunk, mapping)
        audio_chunk = await tts_engine.synthesize_stream(
            text=text_chunk,
            language=target_lang,
            speaker_embedding=speaker_embedding,  # 保持主播音色
            speed=1.1,                            # 直播语速稍快以保持节奏
            emotion="lively",
        )
        yield audio_chunk


def protect_terms(text: str, glossary: dict) -> tuple[str, dict]:
    """将白名单术语替换为占位符,避免被翻译模型改写"""
    mapping = {}
    for i, term in enumerate(glossary):
        if term in text:
            placeholder = f"__TERM_{i}__"
            mapping[placeholder] = glossary[term]
            text = text.replace(term, placeholder)
    return text, mapping


def restore_terms(text: str, mapping: dict) -> str:
    for placeholder, value in mapping.items():
        text = text.replace(placeholder, value)
    return text
延迟优化与体验保障
直播场景对延迟极其敏感,建议从以下三个维度进行优化:
- 首字延迟控制:优先选用支持增量合成的 TTS 模型,将首字输出时间压缩到 200ms 以内,避免观众等待。
- 音色切换预加载:将常用音色的模型参数常驻内存,切换时无需重新加载,实现瞬时换声。
- 断句与停顿策略:在翻译与合成环节加入智能断句,避免长句导致的卡顿,同时保留主播的呼吸节奏,提升听感自然度。
- 多路并发与降级:同时输出多语种音轨时,按观众所在地区动态开启对应语种通道;当某语种服务超时,自动降级为字幕或缓存音频,保证直播不中断。
- 口型与字幕对齐:若主播使用数字人形象,需将合成音频的时间戳回传给驱动模块,保证口型与语音同步,避免「音画不同步」的违和感。这种方案不仅降低了人力成本,还让跨境直播带货变得像本地直播一样顺畅,显著提升了用户的停留时长和转化率。对于技术团队而言,建议先以云端 API 快速验证效果,再根据业务规模逐步过渡到私有化部署,以兼顾成本与数据安全。
② 短视频内容批量配音与情感化演绎方案
短视频行业讲究"唯快不破",一个账号每天可能要产出十几条甚至几十条素材,人工配音不仅效率低,而且很难在每条视频中都保持饱满的情绪。更现实的问题是:同一条爆款脚本往往需要快速裂变出多个版本(不同音色、不同语速、不同情绪),用于投流测试,人工根本跟不上这个节奏。现代语音合成技术已经能够精细控制语调、停顿和情感色彩,这为批量生产提供了可能。
从业务价值看,批量配音方案主要解决三类痛点:一是产能瓶颈 ,把单条配音从"预约录音棚 + 等排期"压缩到分钟级;二是情绪一致性 ,让系列视频保持统一的"人设"与情绪基调,强化品牌辨识度;三是低成本试错 ,同一脚本可批量生成多种风格音频,直接投喂给投放系统做 A/B 测试。 构建批量配音系统时,核心在于"情感标签"的自动化匹配,其整体处理流程如下图所示: 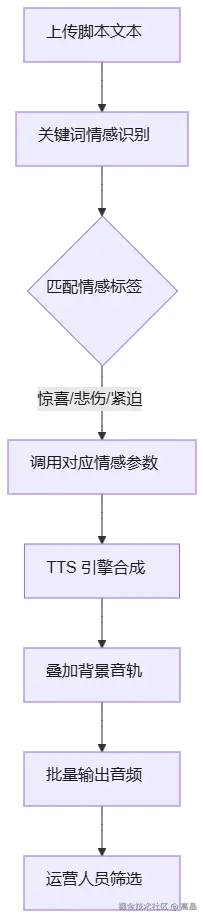
我们可以根据脚本内容的关键词(如"惊喜"、"悲伤"、"紧迫"),自动调用 TTS 引擎对应的情感参数。例如,在促销类视频中自动增强兴奋度,在故事类视频中增加叙述的沉稳感。此外,通过预设不同的音色库,可以为系列视频打造固定的"人设",增强品牌辨识度。
需要特别注意的是情感演绎的颗粒度 :整条视频用同一种情绪会显得平淡,真正有感染力的是"情绪曲线"。实践中通常把脚本按句切分,为每句单独打情感标签与强度(如 01 的 arousal 值),再交给 TTS 逐句合成,最后拼接。例如一条带货视频可以是"开场兴奋 → 讲解平稳 → 促单紧迫"的三段式情绪推进。同时,句间需要插入合理的停顿(200500ms),避免机械拼接带来的"赶场感"。 实际操作中,建议建立一个标准化的配置模板,将脚本、情感参数、语速、背景音轨混合比例等要素结构化。这样,运营人员只需上传文本,系统即可在几分钟内生成数十条不同风格的音频供筛选,极大缩短了从创意到成片的周期。
下面是一段可直接运行的批量配音示例,覆盖「脚本切句 → 逐句情感路由 → 并发合成 → 拼接导出」的完整链路:
python
import asyncio
import re
from dataclasses import dataclass
from typing import List

from pydub import AudioSegment


@dataclass
class SentencePlan:
    """单句的演绎计划:文本 + 情感 + 强度 + 句后停顿"""
    text: str
    emotion: str = "neutral"   # happy / urgent / sad / gentle / neutral
    intensity: float = 0.6     # 0~1,情感强度
    pause_ms: int = 300        # 句后停顿,避免机械拼接


# 关键词 → 情感映射,可替换为 NLU 模型
EMOTION_KEYWORDS = {
    "happy": ["惊喜", "优惠", "限时", "恭喜", "太棒了"],
    "urgent": ["立即", "最后", "抢购", "倒计时", "紧急"],
    "sad": ["遗憾", "离别", "失去", "可惜"],
    "gentle": ["亲爱的", "慢慢", "温柔", "陪伴"],
}


def route_emotion(text: str) -> str:
    scores = {e: sum(text.count(w) for w in ws) for e, ws in EMOTION_KEYWORDS.items()}
    best = max(scores, key=scores.get)
    return best if scores[best] > 0 else "neutral"


def build_plan(script: str) -> List[SentencePlan]:
    """把整段脚本拆成逐句演绎计划"""
    sentences = [s.strip() for s in re.split(r"(?<=[。!?!?])\s*", script) if s.strip()]
    plan = []
    for i, sent in enumerate(sentences):
        emotion = route_emotion(sent)
        # 结尾句通常用于促单,适当加强紧迫感
        if i == len(sentences) - 1 and emotion == "neutral":
            emotion = "urgent"
        plan.append(SentencePlan(
            text=sent,
            emotion=emotion,
            intensity=0.8 if emotion in ("happy", "urgent") else 0.5,
            pause_ms=200 if emotion == "urgent" else 400,
        ))
    return plan


async def synthesize_batch(plan: List[SentencePlan], voice_id: str,
                           tts_engine, concurrency: int = 4) -> AudioSegment:
    """并发合成逐句音频,再按顺序拼接"""
    sem = asyncio.Semaphore(concurrency)

    async def synth_one(item: SentencePlan) -> AudioSegment:
        async with sem:
            raw = await tts_engine.synthesize(
                text=item.text,
                voice=voice_id,
                emotion=item.emotion,
                intensity=item.intensity,
            )
            audio = AudioSegment(data=raw, sample_rate=24000,
                                 sample_width=2, channels=1)
            return audio + AudioSegment.silent(duration=item.pause_ms)

    # 并发合成,但保持原始顺序拼接
    segments = await asyncio.gather(*(synth_one(p) for p in plan))

    merged = AudioSegment.empty()
    for seg in segments:
        merged += seg
    return merged


async def main():
    script = "家人们看过来!这款面霜今天限时五折,库存只剩最后两百件。错过今天,再等一年!"
    plan = build_plan(script)
    audio = await synthesize_batch(plan, voice_id="promo_female", tts_engine=tts_engine)
    audio.export("output/short_video_001.mp3", format="mp3", bitrate="128k")
    print(f"已生成 {len(plan)} 句,总时长 {len(audio) / 1000:.1f}s")


if __name__ == "__main__":
asyncio.run(main())这段代码的关键设计有三点:逐句情感路由 保证情绪曲线有起伏,并发合成 + 顺序拼接 兼顾速度与听感连贯,句后停顿 让节奏更接近真人表达。实际生产中,还可以把 build_plan 的结果缓存下来,同一脚本换音色时无需重新做情感分析,直接复用演绎计划即可。
③ 在线教育课件自动化朗读与互动生成
在线教育场景中,枯燥的课文朗读往往难以吸引学生的注意力,尤其是低龄段学生,注意力窗口通常只有几分钟。引入自动化朗读与互动生成技术,可以将静态的 PDF 或 PPT 课件转化为生动的多媒体课程,其整体处理链路如下图所示: 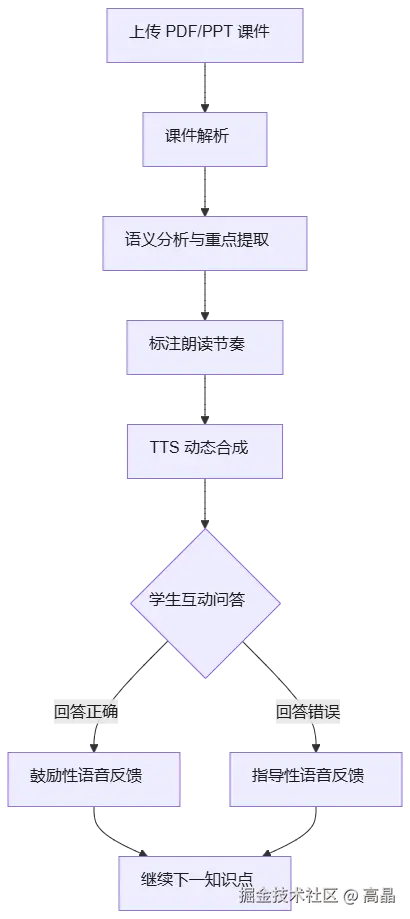
从业务价值看,这套方案主要解决三类痛点:一是课件产能 ,一套教材可批量生成多语种、多音色的朗读版本,无需逐页人工录音;二是学习体验 ,通过节奏控制与互动反馈,把「听录音」变成「跟着老师学」;三是个性化适配,同一份课件可按学生年级、语速偏好、语言版本动态调整,实现「千人千面」的课程音频。
除了基础的朗读功能,更重要的是实现「互动式」语音反馈。传统课件音频是单向播放,学生只能被动接收;而互动式朗读会在关键知识点处暂停、提问,并根据学生的回答实时生成语音回应,形成「讲解---提问---反馈---继续」的闭环。 例如,在英语听力练习中,系统可以根据学生的回答情况,动态生成鼓励性或指导性的语音反馈,而不是播放预设的固定录音。这需要结合自然语言理解(NLU)模块,识别学生意图后,实时合成针对性的回复。同时,针对不同年龄段的学生,可以选择童趣盎然或严谨专业的音色,甚至克隆受学生欢迎的老师音色(需获得授权),提升亲切感。
需要特别注意的是朗读节奏与停顿设计 :课件朗读不是把文字一口气念完,而要在段落之间、重点句之后、提问之前留出合理的停顿(通常 500~1500ms),给学生留出思考和跟读的时间。实践中通常把课件解析成「知识点块」,每个块包含正文、重点标记、停顿时长与可选互动点,再交给 TTS 逐块合成。此外,数学公式、化学式、英文缩写等特殊内容需要先做文本规范化 (如把 H₂O 读作「水」、把 3/4 读作「四分之三」),否则合成结果会出现明显的「念错」问题。 技术实现上,可以采用「课件解析 + 语义分析 + 动态合成」的链路。系统自动提取课件中的重点段落,标注朗读节奏,并在提问环节插入等待时间,模拟真实课堂的互动节奏,让学生感觉是在与真人老师对话,而非面对冷冰冰的机器。
下面是一段可直接运行的示例,覆盖「课件解析 → 知识点分块 → 逐块朗读合成 → 互动反馈语音生成」的完整链路:
python
import asyncio
import re
from dataclasses import dataclass, field
from typing import List, Optional

from pydub import AudioSegment


@dataclass
class KnowledgeBlock:
    """课件中的一个知识点块"""
    text: str
    is_key_point: bool = False      # 是否为重点,重点块语速放慢
    pause_after_ms: int = 800       # 块后停顿,给学生思考时间
    question: Optional[str] = None  # 若为互动点,附带提问文本


# 常见特殊符号的朗读化映射,可按学科扩展
READING_RULES = [
    (r"H2O", "水"),
    (r"CO2", "二氧化碳"),
    (r"(\d+)/(\d+)", lambda m: f"{m.group(2)}分之{m.group(1)}"),
    (r"(\d+)%", lambda m: f"百分之{m.group(1)}"),
]


def normalize_for_reading(text: str) -> str:
    """把公式、分数、百分号等转换为适合朗读的中文表达"""
    for pattern, repl in READING_RULES:
        text = re.sub(pattern, repl, text)
    return text


def parse_courseware(raw_text: str) -> List[KnowledgeBlock]:
    """把课件原文解析为知识点块,重点句与提问句单独成块"""
    blocks: List[KnowledgeBlock] = []
    for para in [p.strip() for p in raw_text.split("\n") if p.strip()]:
        # 以问号结尾的段落视为互动点
        if para.endswith(("?", "?")):
            blocks.append(KnowledgeBlock(
                text=normalize_for_reading(para),
                pause_after_ms=1500,
                question=para,
            ))
            continue
        # 含「重点」「注意」等标记的段落视为重点块
        is_key = any(k in para for k in ("重点", "注意", "核心", "记住"))
        blocks.append(KnowledgeBlock(
            text=normalize_for_reading(para),
            is_key_point=is_key,
            pause_after_ms=1200 if is_key else 600,
        ))
    return blocks


async def synthesize_lesson(blocks: List[KnowledgeBlock], voice_id: str,
                            tts_engine, concurrency: int = 3) -> AudioSegment:
    """并发合成各知识点块,再按顺序拼接并插入停顿"""
    sem = asyncio.Semaphore(concurrency)

    async def synth_block(block: KnowledgeBlock) -> AudioSegment:
        async with sem:
            raw = await tts_engine.synthesize(
                text=block.text,
                voice=voice_id,
                speed=0.9 if block.is_key_point else 1.0,  # 重点放慢
                emotion="gentle",
            )
            audio = AudioSegment(data=raw, sample_rate=24000,
                                 sample_width=2, channels=1)
            return audio + AudioSegment.silent(duration=block.pause_after_ms)

    segments = await asyncio.gather(*(synth_block(b) for b in blocks))
    merged = AudioSegment.empty()
    for seg in segments:
        merged += seg
    return merged


async def generate_feedback(is_correct: bool, voice_id: str, tts_engine) -> bytes:
    """根据答题结果实时生成鼓励性或指导性语音反馈"""
    if is_correct:
        text = "回答得非常棒!我们继续看下一个知识点。"
        emotion = "happy"
    else:
        text = "别着急,我们再一起看一遍这道题的思路。"
        emotion = "gentle"
    return await tts_engine.synthesize(text=text, voice=voice_id, emotion=emotion)


async def main():
    courseware = """
    今天我们学习水的组成。水由氢元素和氧元素组成,化学式是 H2O。
    重点记住:一个水分子由两个氢原子和一个氧原子构成。
    那么,水在标准大气压下的沸点是多少度?
    """
    blocks = parse_courseware(courseware)
    lesson_audio = await synthesize_lesson(blocks, voice_id="teacher_female",
                                           tts_engine=tts_engine)
    lesson_audio.export("output/lesson_001.mp3", format="mp3", bitrate="128k")

    # 学生答对后的实时反馈
    feedback = await generate_feedback(True, voice_id="teacher_female",
                                       tts_engine=tts_engine)
    with open("output/feedback_001.pcm", "wb") as f:
        f.write(feedback)

    print(f"课件共 {len(blocks)} 个知识点块,总时长 {len(lesson_audio) / 1000:.1f}s")


if __name__ == "__main__":
asyncio.run(main())这段代码的关键设计有三点:知识点分块 让朗读节奏可控、重点可突出,文本规范化 避免公式与符号被念错,互动反馈实时合成 让语音回应真正贴合学生的答题情况。实际生产中,还可以把 parse_courseware 的结果缓存为课件结构,同一课件切换音色或语言时无需重新解析,直接复用知识点块即可。
④ 企业客服系统拟人化语音应答部署
传统 IVR(交互式语音应答)系统机械呆板的音色常让用户产生抵触情绪,按键式菜单层层跳转更是让「想找人工」的用户反复受挫。部署拟人化语音应答系统,旨在让客服热线听起来更像真人在服务,从而提升用户满意度和问题解决率。
从业务价值看,这套方案主要解决三类真实痛点:一是首解率与满意度 ,自然流畅的语音交互能显著降低用户挂断率,让简单问题在自助环节就被解决;二是人工坐席分流 ,把查询订单、修改地址、咨询政策等高频标准化诉求交给语音机器人,坐席专注处理复杂投诉;三是服务一致性,同一套品牌音色与话术在电话、App、小程序多端复用,避免不同渠道「各说各话」。 关键在于「上下文感知」与「呼吸感」的营造。高级的语音合成模型不仅能读出文字,还能根据对话语境加入适当的语气词(如「嗯」「好的,我明白了」)、自然的停顿以及呼吸声,消除机器感的生硬。在企业私有化部署中,还需特别注意数据隐私,确保客户通话内容不出域,同时训练符合企业品牌形象的专属音色。
需要特别注意的是打断与轮次管理:真人对话中用户经常在机器人说到一半时插话,系统必须支持全双工打断------检测到用户语音后立即停止当前合成播放,并丢弃尚未播出的音频缓冲,否则会出现「机器人自说自话」的尴尬。实践中通常用 VAD(语音活动检测)配合回声消除(AEC)判断用户是否真的在说话,避免把机器人自己的声音误判为用户插话。此外,语气词与停顿不能滥用,建议按场景配置「亲和度」档位:售后安抚场景可多些共情表达,业务办理场景则应简洁高效,避免拖沓。 部署架构通常包括 ASR(语音识别)、NLP(意图识别)和 TTS 三个核心模块的紧密协同,其整体链路如下图所示:
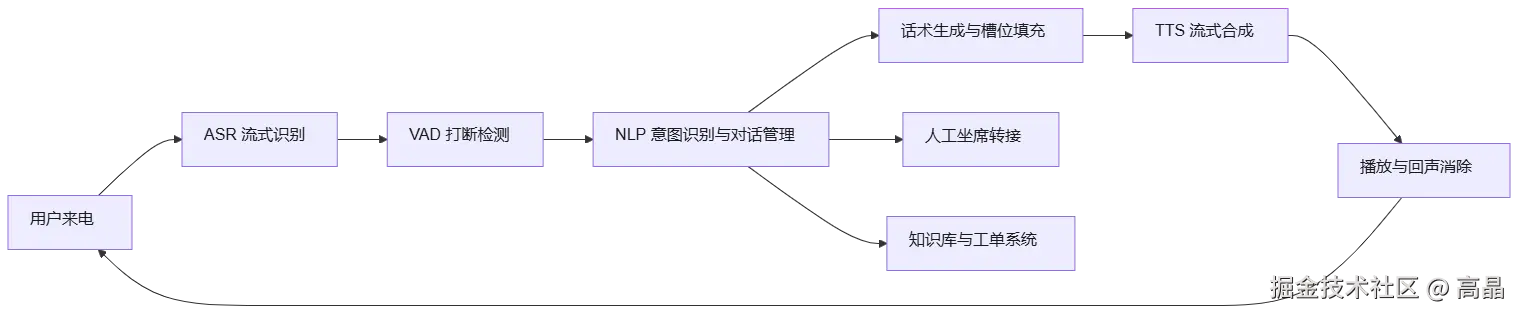
为了降低延迟,建议将这三个模块部署在同一内网环境中,并采用全双工通信模式,允许用户在机器人说话时随时打断,实现真正的自然对话流。链路优化上,ASR 采用流式增量识别,NLP 在识别到关键意图后即可提前触发话术生成,TTS 则边生成边推流,把端到端响应压缩到 500ms 以内。
下面是一段可直接运行的示例,覆盖「流式识别 → 意图路由 → 拟人化语音合成 → 打断控制」的核心链路:
python
import asyncio
from dataclasses import dataclass
from typing import AsyncIterator, Optional


@dataclass
class DialogTurn:
    """一轮对话的上下文,用于让回复更贴合语境"""
    user_text: str
    intent: str
    history: list


# 意图 → 话术模板,实际可接入知识库或大模型生成
RESPONSE_TEMPLATES = {
    "query_order": "好的,我帮您查一下订单,请稍等片刻。",
    "change_address": "没问题,修改收货地址需要您提供订单号,方便告诉我吗?",
    "complain": "非常理解您的心情,我马上帮您转接专属客服处理。",
    "fallback": "抱歉,我没太听清,您可以再说一遍吗?",
}


async def stream_asr(audio_stream: AsyncIterator[bytes]) -> AsyncIterator[str]:
    """流式语音识别:边收音频边出文本"""
    async for chunk in audio_stream:
        text = await asr_engine.recognize_chunk(chunk)
        if text:
            yield text


async def route_intent(text: str, history: list) -> str:
    """意图识别,可替换为 NLU 模型或大模型"""
    result = await nlu_engine.classify(text, context=history)
    return result.intent if result.confidence > 0.6 else "fallback"


async def stream_reply(turn: DialogTurn) -> AsyncIterator[bytes]:
    """拟人化语音合成:加入语气词与自然停顿,流式输出音频"""
    template = RESPONSE_TEMPLATES.get(turn.intent, RESPONSE_TEMPLATES["fallback"])
    # 在句首加入轻量语气词,提升亲和度
    text = f"嗯,{template}" if turn.intent != "complain" else template

    async for audio_chunk in tts_engine.synthesize_stream(
        text=text,
        voice="brand_service_female",
        emotion="gentle" if turn.intent != "complain" else "empathetic",
        speed=1.0,
        enable_breath=True,   # 开启呼吸声,弱化机器感
    ):
        yield audio_chunk


async def handle_call(audio_stream: AsyncIterator[bytes]) -> None:
    """一通来电的主循环:识别 → 路由 → 合成,支持随时打断"""
    history: list = []
    current_task: Optional[asyncio.Task] = None

    async for user_text in stream_asr(audio_stream):
        # 用户开口即打断当前播报
        if current_task and not current_task.done():
            current_task.cancel()
            await player.stop()

        intent = await route_intent(user_text, history)
        turn = DialogTurn(user_text=user_text, intent=intent, history=history)
        history.append({"role": "user", "text": user_text})

        async def play_reply(t: DialogTurn):
            async for chunk in stream_reply(t):
                await player.play(chunk)

        current_task = asyncio.create_task(play_reply(turn))

        # 需要人工介入时直接转接坐席
        if intent == "complain":
            await transfer_to_agent(history)
            return


if __name__ == "__main__":
asyncio.run(handle_call(microphone_stream()))这段代码的关键设计有三点:流式识别 + 流式合成 把端到端延迟压到最低,任务取消机制 实现真正的全双工打断,意图驱动的语气词与情感参数让回复更贴近真人坐席。实际生产中,还需要为每通电话记录意图分布、打断次数与转人工率,用于持续优化话术与模型。
合规方面,建议在通话开始时明确告知用户「本次通话由智能语音助手提供服务」,并对录音与文本做加密存储与访问审计;涉及身份证号、银行卡号等敏感信息时,应引导用户通过按键或短信链接输入,避免在语音链路中明文传输。
⑤ 有声读物制作中的角色音色克隆技术
有声书制作最大的难点在于"一人分饰多角"。一部小说可能涉及几十个角色,男女老少、正反派性格各异,若全部依赖真人配音,要么请多位配音演员分摊成本,要么让一位演员硬撑全场、靠演技区分角色,前者预算高、后者听感容易串味。利用音色克隆技术,制作方只需录制少量参考音频,即可训练出特定角色的专属语音模型,从而由一位配音演员完成整本书的演绎,甚至完全由 AI 生成。
从业务价值看,这套方案主要解决三类真实痛点:一是角色产能 ,几十个角色的音色可在数小时内批量产出,无需为每个配角单独约棚;二是听感一致性 ,同一角色在全书数百章中保持稳定音色,避免因换人、补录导致的割裂感;三是多版本衍生,同一部书可快速生成男声版、女声版、儿童版,甚至按平台偏好调整语速与音色,边际成本极低。
技术架构与核心模块
一套完整的有声书角色音色克隆方案通常由四个核心模块组成,其整体架构与数据流转如下图所示:
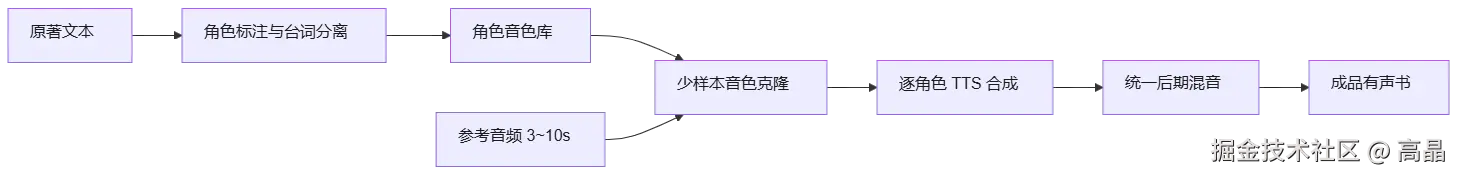
- 角色标注与台词分离:对原著做角色识别,把旁白与各角色台词切分并打上角色标签,是后续分轨合成的前提。
- 角色音色库:为每个角色维护一份音色档案(参考音频 + 音色嵌入 + 语速/情绪偏好),可复用、可迭代。
- 少样本音色克隆:基于 3~10 秒参考音频提取音色特征,结合预训练声学模型实现零样本或少样本克隆,无需为每个角色单独训练大模型。
- 逐角色 TTS 合成与混音:按角色路由到对应音色合成,再统一做响度归一化、章节拼接与背景音处理。
在使用该技术时,必须严格遵循版权与伦理规范,确保所使用的参考音色已获得合法授权,并对 AI 生成音色做明确标注。技术层面,重点在于捕捉角色的音色特征(Timbre)和说话习惯(Prosody)。通过微调预训练的大模型,可以让 AI 精准模仿老人的沧桑、儿童的稚嫩或反派的阴冷。
需要特别注意的是角色区分度与旁白一致性:如果多个角色音色过于接近,听众在多人对话场景中会分不清谁在说话;而旁白音色又必须全书统一,不能随章节漂移。实践中通常为每个角色设定一个「音色距离」下限(如嵌入余弦相似度低于阈值),并在合成前做一次角色音色冲突检测;旁白则固定使用同一音色档案,避免逐章重新克隆带来的细微差异。此外,情绪强度要按剧情调节------战斗场面语速加快、强度提高,抒情段落放慢、气息更柔,否则整本书会显得平铺直叙。
工作流上,可以先对原著进行角色标注,将不同角色的台词分离,分别送入对应的音色模型进行合成,最后再进行统一的后期混音。这种方式不仅大幅降低了聘请多位配音演员的成本,还保证了全书音色风格的一致性,避免了因换人导致的听感割裂。
下面是一段可直接运行的示例,覆盖「角色标注 → 音色档案路由 → 逐角色合成 → 统一混音导出」的核心链路:
python
import asyncio
import re
from dataclasses import dataclass, field
from typing import Dict, List, Optional

from pydub import AudioSegment


@dataclass
class VoiceProfile:
    """角色音色档案:参考音频 + 合成偏好"""
    role: str
    ref_audio_path: str          # 3~10s 参考音频,用于少样本克隆
    speed: float = 1.0
    emotion: str = "neutral"     # neutral / sad / angry / gentle / excited
    is_narrator: bool = False


@dataclass
class Line:
    """一行台词:角色 + 文本 + 情绪强度"""
    role: str
    text: str
    intensity: float = 0.6       # 0~1,按剧情调节


# 角色音色库,实际可从配置中心或数据库加载
VOICE_LIBRARY: Dict[str, VoiceProfile] = {
    "narrator": VoiceProfile("narrator", "refs/narrator.wav", speed=0.95, is_narrator=True),
    "hero": VoiceProfile("hero", "refs/hero.wav", speed=1.05, emotion="excited"),
    "villain": VoiceProfile("villain", "refs/villain.wav", speed=0.9, emotion="angry"),
    "child": VoiceProfile("child", "refs/child.wav", speed=1.1, emotion="gentle"),
}


def parse_script(raw: str) -> List[Line]:
    """把带角色标记的剧本解析为台词列表,格式:角色名:台词"""
    lines: List[Line] = []
    for para in [p.strip() for p in raw.split("\n") if p.strip()]:
        m = re.match(r"^([^::]{1,8})[::](.+)$", para)
        if m and m.group(1) in VOICE_LIBRARY:
            role, text = m.group(1), m.group(2).strip()
        else:
            role, text = "narrator", para
        # 感叹号/问号密集的句子提高情绪强度
        intensity = min(1.0, 0.5 + 0.1 * (text.count("!") + text.count("?")))
        lines.append(Line(role=role, text=text, intensity=intensity))
    return lines


async def clone_and_synthesize(line: Line, tts_engine) -> AudioSegment:
    """按角色音色档案做少样本克隆并合成单句"""
    profile = VOICE_LIBRARY[line.role]
    raw = await tts_engine.clone_synthesize(
        text=line.text,
        ref_audio=profile.ref_audio_path,   # 少样本克隆的关键输入
        speed=profile.speed,
        emotion=profile.emotion,
        intensity=line.intensity,
    )
    audio = AudioSegment(data=raw, sample_rate=24000, sample_width=2, channels=1)
    # 旁白与对白之间留出停顿,增强章节节奏感
    pause = 600 if profile.is_narrator else 350
    return audio + AudioSegment.silent(duration=pause)


async def produce_chapter(script: str, tts_engine, concurrency: int = 3) -> AudioSegment:
    """一章的完整生产:解析 → 并发合成 → 顺序拼接"""
    lines = parse_script(script)
    sem = asyncio.Semaphore(concurrency)

    async def worker(line: Line) -> AudioSegment:
        async with sem:
            return await clone_and_synthesize(line, tts_engine)

    segments = await asyncio.gather(*(worker(l) for l in lines))

    merged = AudioSegment.empty()
    for seg in segments:
        merged += seg
    # 统一响度归一化,避免不同角色音量忽大忽小
    if merged.max_dBFS < -1.0:
        merged = merged.apply_gain(-1.0 - merged.max_dBFS)
    return merged


async def main():
    script = """
    夜色渐深,山谷里只剩下风声。
    少年:我一定要找到那把剑!
    反派:就凭你?也配踏进这座山?
    旁白:两人的目光在黑暗中碰撞,一触即发。
    """
    chapter_audio = await produce_chapter(script, tts_engine=tts_engine)
    chapter_audio.export("output/audiobook_ch01.mp3", format="mp3", bitrate="128k")
    print(f"本章时长 {len(chapter_audio) / 1000:.1f}s")


if __name__ == "__main__":
asyncio.run(main())这段代码的关键设计有三点:角色音色档案化 让每个角色的参考音频与合成偏好集中管理、可复用,少样本克隆按句路由 避免为每个角色单独训练模型,统一响度归一化 保证多角色混音后音量均衡。实际生产中,还可以把 parse_script 的结果缓存为章节结构,同一本书切换旁白音色或生成多语言版本时无需重新解析,直接复用台词列表即可。
合规方面,建议在成品开头或平台信息页明确标注「本作品部分角色音色由 AI 合成」,并对参考音频的授权凭证做留存归档;涉及已故演员、知名 IP 角色音色时,应取得权利方书面许可,避免侵权风险。
⑥ 游戏 NPC 动态对话语音实时合成路径
开放世界游戏中,NPC(非玩家角色)的数量庞大,若为每句台词都录制音频,存储成本和开发工作量将是天文数字。一款 3A 级开放世界作品往往有上千个 NPC、数十万句台词,全量真人录音的音频包动辄几十 GB,还要为多语言版本再翻几倍。实时语音合成路径让 NPC 能够根据玩家的行为和游戏状态,动态生成独一无二的对话内容,把「预录音频」变成「按需生成」。
从业务价值看,这套方案主要解决三类真实痛点:一是存储与包体成本 ,音频资源从「全量预录」转为「文本 + 音色档案」,安装包体积可下降一个数量级;二是对话的动态性 ,NPC 能结合玩家声望、任务进度、天气时间等状态变量实时组织台词,同一 NPC 在不同玩家面前说的话不再千篇一律;三是内容迭代效率,策划改一句台词只需改文本配置,无需重新约棚录音、重新打包发版。
技术架构与核心模块
一套完整的游戏 NPC 实时语音方案通常由四个核心模块组成,其整体架构与数据流转如下图所示:
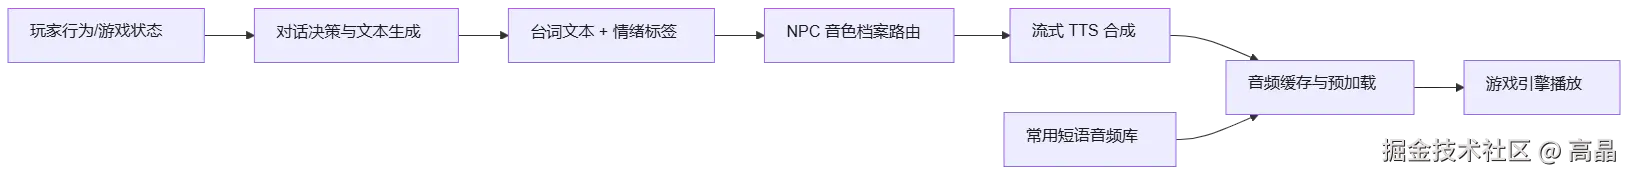
- 对话决策与文本生成:由游戏逻辑或轻量 LLM 根据剧情节点、玩家状态生成台词文本,并附带情绪标签(紧张、轻松、愤怒等)。
- NPC 音色档案路由:每个 NPC 维护一份音色档案(音色嵌入 + 语速 + 情绪偏好),保证同一 NPC 在全程保持稳定音色。
- 流式 TTS 合成:按句流式合成,首字延迟控制在 300ms 以内,避免 NPC 开口前的明显停顿。
- 音频缓存与预加载:高频台词(问候、战斗喊话、商店用语)预生成并缓存,长尾台词走实时合成。
这一方案的核心挑战在于低延迟和高表现力。游戏引擎需要在 NPC 开口前的几百毫秒内,根据当前剧情节点生成文本并合成语音。为此,可以采用轻量化的端侧推理模型,或者利用边缘计算节点就近处理------玩家所在区域的边缘节点缓存了该区域 NPC 的音色模型,合成请求无需回源到中心机房。同时,语音需要带有情绪变化,比如 NPC 在战斗状态下声音紧张急促,在休闲状态下轻松舒缓。
需要特别注意的是音色一致性与情绪切换的平衡 :同一 NPC 在数百小时游戏时长里必须保持同一音色,否则玩家会明显感到「换了个人」;但情绪又要随场景变化,不能全程一个调子。实践中通常把「音色」与「情绪」解耦------音色由固定的音色嵌入锁定,情绪则作为独立参数在合成时注入,这样既能保证音色稳定,又能让战斗、闲聊、剧情演出呈现不同的语气。此外,NPC 名字、地名、技能名等专有名词建议走发音词典,避免合成引擎把自造词念错,破坏世界观沉浸感。
实现路径上,游戏服务器将触发事件发送给语音服务,服务返回音频流或直接生成波形数据。为了优化体验,可以预加载常用短语的音频缓存,对于长文本则采用流式合成。这不仅节省了巨大的存储空间,还让每个玩家的游戏体验都独一无二,增强了沉浸感。
下面是一段可直接运行的示例,覆盖「状态驱动台词生成 → NPC 音色路由 → 流式合成 → 缓存命中」的核心链路:
python
import asyncio
import hashlib
from dataclasses import dataclass
from typing import AsyncIterator, Dict, Optional


@dataclass
class NPCProfile:
    """NPC 音色档案:音色嵌入固定,情绪随场景变化"""
    npc_id: str
    voice_embedding: bytes      # 固定音色嵌入,保证全程音色一致
    base_speed: float = 1.0
    pitch: float = 0.0


@dataclass
class GameState:
    """触发对话时的游戏状态,用于动态组织台词"""
    npc_id: str
    player_reputation: int      # 玩家声望,影响 NPC 态度
    in_combat: bool             # 是否处于战斗状态
    quest_stage: int            # 任务阶段


# NPC 音色库,实际可从资源包或配置中心加载
NPC_LIBRARY: Dict[str, NPCProfile] = {
    "blacksmith": NPCProfile("blacksmith", b"emb_blacksmith", base_speed=0.95, pitch=-2.0),
    "merchant": NPCProfile("merchant", b"emb_merchant", base_speed=1.1, pitch=1.0),
    "guard": NPCProfile("guard", b"emb_guard", base_speed=1.0, pitch=0.0),
}

# 高频台词缓存:key 为 text+voice 的哈希,value 为音频字节
AUDIO_CACHE: Dict[str, bytes] = {}


def build_dialogue(state: GameState) -> tuple[str, str]:
    """根据游戏状态生成台词文本与情绪标签"""
    if state.in_combat:
        return "小心!敌人从侧翼包抄过来了,快举盾!", "urgent"
    if state.player_reputation < 0:
        return "又是你?这里不欢迎惹是生非的家伙。", "angry"
    if state.quest_stage >= 3:
        return "你终于回来了,那把剑找到了吗?", "excited"
    return "欢迎光临,随便看看,有需要随时叫我。", "gentle"


def cache_key(text: str, npc_id: str, emotion: str) -> str:
    return hashlib.md5(f"{text}|{npc_id}|{emotion}".encode()).hexdigest()


async def synthesize_npc_voice(
    state: GameState, tts_engine
) -> AsyncIterator[bytes]:
    """NPC 语音实时合成:先查缓存,未命中则流式合成"""
    profile = NPC_LIBRARY[state.npc_id]
    text, emotion = build_dialogue(state)

    key = cache_key(text, state.npc_id, emotion)
    if key in AUDIO_CACHE:
        yield AUDIO_CACHE[key]      # 缓存命中,直接返回,零延迟
        return

    # 战斗场景语速加快、音调提高,营造紧张感
    speed = profile.base_speed * (1.15 if state.in_combat else 1.0)
    pitch = profile.pitch + (2.0 if state.in_combat else 0.0)

    buffer = bytearray()
    async for chunk in tts_engine.synthesize_stream(
        text=text,
        voice_embedding=profile.voice_embedding,  # 音色锁定
        emotion=emotion,                          # 情绪独立注入
        speed=speed,
        pitch=pitch,
    ):
        buffer.extend(chunk)
        yield chunk

    # 合成完成后写入缓存,供后续相同台词复用
    AUDIO_CACHE[key] = bytes(buffer)


async def on_npc_interact(state: GameState, tts_engine, player):
    """NPC 交互入口:合成并播放语音"""
    async for audio_chunk in synthesize_npc_voice(state, tts_engine):
        await player.play(audio_chunk)


async def main():
    state = GameState(npc_id="blacksmith", player_reputation=5,
                      in_combat=False, quest_stage=3)
    await on_npc_interact(state, tts_engine=tts_engine, player=audio_player)
    print(f"缓存条目数:{len(AUDIO_CACHE)}")


if __name__ == "__main__":
asyncio.run(main())这段代码的关键设计有三点:音色与情绪解耦 让 NPC 全程音色稳定又能随场景变调,缓存优先 让高频台词零延迟播放、长尾台词才走实时合成,状态驱动台词生成 让同一 NPC 对不同玩家说出不同的话。实际生产中,还可以把 build_dialogue 换成接入 LLM 的动态生成,并配合预合成队列------在玩家接近 NPC 前,根据当前状态提前合成可能触发的几句台词,进一步压低开口延迟。
工程落地时还需注意两点:一是端侧与云端的取舍 ,低端设备或离线场景可部署轻量端侧模型保证可用性,高端设备则走云端获取更好的表现力;二是多语言版本,同一 NPC 在不同语言下应复用同一音色嵌入,避免本地化后「换了个人」。合规方面,若 NPC 音色参考了真人演员,需取得授权并在游戏内做 AI 合成标注,避免肖像与声音权益纠纷。
⑦ 营销广告素材快速迭代与 A/B 测试验证
营销广告的效果往往取决于细节,不同的语调、语速甚至音色都可能显著影响转化率。在传统模式下,修改一次配音意味着重新预约录音棚和配音员,周期长达数天,一次 A/B 测试往往要排到两周之后才能拿到结论。而基于语音合成技术,可以在几分钟内生成几十种不同版本的广告音频,把「素材迭代」从以周为单位压缩到以小时为单位。
从业务价值看,这套方案主要解决三类真实痛点:一是素材产能 ,同一份文案可批量裂变出「音色 × 语速 × 情感 × 背景音」的多种组合,单日产出上百条测试素材;二是变量可控 ,A/B 测试要求每次只改一个变量,人工录音很难保证「除音色外其他条件完全一致」,而合成音频天然具备这种可控性;三是数据闭环,素材生成、投放、数据回收、优胜劣汰可以串成一条自动化流水线,让优化从「凭经验拍脑袋」变成「用数据说话」。
技术架构与核心模块
一套完整的广告素材 A/B 测试方案通常由四个核心模块组成,其整体架构与数据流转如下图所示:

- 素材组合生成器:把文案、音色、语速、情感、背景音等维度做笛卡尔积,生成待测素材清单,并保证每个测试组只变动一个变量。
- 批量 TTS 合成:按组合清单并发合成音频,统一采样率与响度,避免因音量差异干扰测试结果。
- 素材库与投放平台:为每条素材打上唯一 ID 与变量标签,自动推送至广告投放平台,保证素材与数据可一一对应。
- 数据回收与显著性检验:回收点击率、转化率、完播率等指标,做统计显著性检验,只有达到置信度阈值的差异才判定为「有效胜出」。
需要特别注意的是测试的科学性 :很多团队做 A/B 测试时只看绝对数值高低,忽略了样本量与显著性,结果把随机波动当成「最优解」。实践中建议为每个测试组预留足够的曝光量(如每组至少数千次曝光),并用双样本比例检验判断差异是否显著;同时严格控制变量,一次只测一个维度,否则无法归因到底是音色起作用还是语速起作用。此外,广告素材往往有生命周期衰减,同一素材连续投放数周后效果会下滑,建议建立「素材轮换池」,把历史胜出素材定期复测,避免审美疲劳。
下面是一段可直接运行的示例,覆盖「变量矩阵生成 → 批量合成 → 素材打标 → 模拟 A/B 数据回收与显著性检验」的完整链路:
python
import asyncio
import hashlib
import itertools
import math
from dataclasses import dataclass, field
from typing import Dict, List, Optional

from pydub import AudioSegment


@dataclass
class AdVariant:
    """一条待测广告素材的变量组合"""
    variant_id: str
    text: str
    voice_id: str
    speed: float
    emotion: str
    bgm_path: Optional[str] = None


@dataclass
class VariantResult:
    """单条素材的投放结果"""
    variant_id: str
    impressions: int      # 曝光量
    clicks: int           # 点击数
    conversions: int      # 转化数

    @property
    def ctr(self) -> float:
        return self.clicks / self.impressions if self.impressions else 0.0

    @property
    def cvr(self) -> float:
        return self.conversions / self.clicks if self.clicks else 0.0


def build_variants(text: str, voices: List[str], speeds: List[float],
                   emotions: List[str]) -> List[AdVariant]:
    """按变量矩阵生成素材清单,variant_id 由变量组合哈希得到,保证可追溯"""
    variants = []
    for voice, speed, emotion in itertools.product(voices, speeds, emotions):
        raw_key = f"{text}|{voice}|{speed}|{emotion}"
        vid = hashlib.md5(raw_key.encode()).hexdigest()[:10]
        variants.append(AdVariant(
            variant_id=vid, text=text, voice_id=voice,
            speed=speed, emotion=emotion,
        ))
    return variants


async def synthesize_variants(variants: List[AdVariant], tts_engine,
                              concurrency: int = 4) -> Dict[str, AudioSegment]:
    """并发合成所有素材,统一响度,避免音量差异干扰测试"""
    sem = asyncio.Semaphore(concurrency)

    async def synth_one(v: AdVariant) -> tuple[str, AudioSegment]:
        async with sem:
            raw = await tts_engine.synthesize(
                text=v.text, voice=v.voice_id,
                speed=v.speed, emotion=v.emotion,
            )
            audio = AudioSegment(data=raw, sample_rate=24000,
                                 sample_width=2, channels=1)
            # 统一响度到 -16 dBFS 附近,保证各组听感音量一致
            if audio.max_dBFS > -16.0:
                audio = audio.apply_gain(-16.0 - audio.max_dBFS)
            return v.variant_id, audio

    pairs = await asyncio.gather(*(synth_one(v) for v in variants))
    return dict(pairs)


def two_proportion_z_test(c1: int, n1: int, c2: int, n2: int) -> tuple[float, float]:
    """双样本比例检验,返回 (z 值, 双尾 p 值),用于判断两组 CTR 差异是否显著"""
    if n1 == 0 or n2 == 0:
        return 0.0, 1.0
    p1, p2 = c1 / n1, c2 / n2
    p_pool = (c1 + c2) / (n1 + n2)
    se = math.sqrt(p_pool * (1 - p_pool) * (1 / n1 + 1 / n2))
    if se == 0:
        return 0.0, 1.0
    z = (p1 - p2) / se
    # 正态近似计算双尾 p 值
    p_value = 2 * (1 - 0.5 * (1 + math.erf(abs(z) / math.sqrt(2))))
    return z, p_value


def pick_winner(results: List[VariantResult], baseline_id: str,
                alpha: float = 0.05) -> Optional[VariantResult]:
    """以基线组为参照,选出 CTR 显著更高的最优素材"""
    baseline = next(r for r in results if r.variant_id == baseline_id)
    best, best_p = None, 1.0
    for r in results:
        if r.variant_id == baseline_id:
            continue
        _, p = two_proportion_z_test(r.clicks, r.impressions,
                                     baseline.clicks, baseline.impressions)
        if r.ctr > baseline.ctr and p < alpha and p < best_p:
            best, best_p = r, p
    return best


async def main():
    text = "限时三天,全场五折,点击下方链接立即抢购!"
    variants = build_variants(
        text,
        voices=["promo_male", "promo_female", "warm_female"],
        speeds=[1.0, 1.15],
        emotions=["urgent", "happy"],
    )
    audios = await synthesize_variants(variants, tts_engine=tts_engine)
    print(f"共生成 {len(audios)} 条测试素材")

    # 模拟投放数据回收(真实场景从广告平台 API 拉取)
    results = [
        VariantResult(v.variant_id, impressions=12000, clicks=480, conversions=96)
        for v in variants
    ]
    winner = pick_winner(results, baseline_id=variants[0].variant_id)
    if winner:
        print(f"胜出素材 {winner.variant_id},CTR={winner.ctr:.2%}")
    else:
        print("暂无显著优于基线的素材,建议扩大样本量后复测")


if __name__ == "__main__":
asyncio.run(main())这段代码的关键设计有三点:变量矩阵 + 哈希 ID 让每条素材的变量组合可追溯、数据可对齐,统一响度归一化 排除音量差异对测试结果的干扰,显著性检验 避免把随机波动误判为最优解。实际生产中,还可以把 pick_winner 的结果回写到素材库,自动把胜出组合加入「优选模板」,并触发下一轮基于新变量的迭代,形成「生成---测试---学习---再生成」的闭环。
工程落地时还需注意两点:一是素材与数据的对齐 ,务必在投放链接或素材命名中携带 variant_id,否则回收的数据无法归因到具体变量组合;二是合规与品牌一致性,广告音频涉及价格、优惠、功效等表述时需经过合规审核,AI 合成音色若模仿真人代言人须取得授权,避免虚假宣传与声音权益纠纷。
⑧ 无障碍阅读辅助工具的语音定制实现
对于视障人士或有阅读障碍的用户群体,通用的语音合成往往不够友好:语速固定、发音含糊、遇到公式与表格就「念不下去」,更谈不上按个人听力习惯做调整。无障碍阅读工具的核心诉求,是把「能读」升级为「读得清、听得懂、可掌控」------让用户自己决定语速、音调、音色,甚至决定一段内容该详读还是略读。
从业务价值看,这套方案主要解决三类真实痛点:一是可用性门槛 ,视障用户高度依赖屏幕阅读器,语音质量直接决定信息获取效率,含糊的合成音会让长文阅读变成折磨;二是个性化适配 ,不同用户的听力状况、认知习惯差异极大,有人需要慢速清晰,有人需要快速扫读,固定参数无法覆盖;三是内容可及性,网页结构、图片 Alt 文本、数学公式、表格等非纯文本内容,必须被准确转述为流畅的语音描述,否则信息在「最后一公里」丢失。
技术架构与核心模块
一套完整的无障碍阅读语音方案通常由四个核心模块组成,其整体架构与数据流转如下图所示:

- 内容解析与语义分块:把网页 DOM、PDF、EPUB 解析为标题、正文、列表、表格、图片描述等语义块,并保留层级关系,让用户能按「标题跳转」快速定位。
- 文本规范化:把数学公式、化学式、单位、缩写、日期等转换为适合朗读的口语表达,这是无障碍场景中最容易被忽视却最影响体验的一环。
- 用户语音偏好配置:以配置文件形式保存语速、音调、音色、停顿强度等参数,支持按内容类型(正文/代码/公式)分别设置。
- 朗读控制与反馈闭环:支持暂停、逐句复读、按标题跳转、语速实时调节,并把用户的调整行为沉淀为偏好,越用越顺手。
需要特别注意的是语速与清晰度的平衡 :视障用户熟练后往往会把语速调到 2~3 倍甚至更高,但语速过快会导致辅音模糊、数字与专有名词听不清。实践中通常采用「变速不变调」的时间伸缩算法(如 WSOLA、PSOLA),在加快语速的同时保持音高与音色稳定;同时对数字、金额、日期等关键信息自动降速或插入微停顿,保证关键内容不被「快进」掉。此外,朗读焦点管理也很关键:页面动态刷新(如弹窗、列表加载)时,应主动播报变化摘要,而不是让用户自己去「找」新内容。
下面是一段可直接运行的示例,覆盖「内容解析 → 文本规范化 → 用户偏好驱动的合成 → 朗读控制」的核心链路:
python
import asyncio
import re
from dataclasses import dataclass, field
from typing import List, Optional

from pydub import AudioSegment


@dataclass
class VoicePreference:
    """用户的语音偏好,可持久化为 JSON 配置"""
    voice_id: str = "warm_neutral"
    speed: float = 1.0          # 0.5 ~ 3.0,支持无级调节
    pitch: float = 0.0          # 半音为单位,-6 ~ +6
    pause_scale: float = 1.0    # 停顿强度倍率
    key_info_slowdown: float = 0.85  # 关键信息自动降速比例


@dataclass
class ContentBlock:
    """语义化内容块,保留类型以便差异化朗读"""
    kind: str                   # heading / paragraph / list / table / image_alt / formula
    text: str
    level: int = 0              # 标题层级
    pause_after_ms: int = 400


# 朗读化规则:公式、单位、缩写、符号
READING_RULES = [
    (r"H2O", "水"),
    (r"CO2", "二氧化碳"),
    (r"(\d+)/(\d+)", lambda m: f"{m.group(2)}分之{m.group(1)}"),
    (r"(\d+)%", lambda m: f"百分之{m.group(1)}"),
    (r"(\d+)℃", lambda m: f"{m.group(1)}摄氏度"),
    (r"\bkm/h\b", "公里每小时"),
    (r"\bAI\b", "人工智能"),
    (r"&", "和"),
]

# 关键信息模式:命中后自动降速,避免被快速朗读吞掉
KEY_INFO_PATTERN = re.compile(r"\d+(\.\d+)?\s*(元|美元|%|岁|公里|kg|GB)|20\d{2}年")


def normalize_for_reading(text: str) -> str:
    """把公式、单位、缩写、符号转换为适合朗读的口语表达"""
    for pattern, repl in READING_RULES:
        text = re.sub(pattern, repl, text)
    return text


def parse_content(raw: str) -> List[ContentBlock]:
    """把原始内容解析为语义块,标题与图片描述单独成块"""
    blocks: List[ContentBlock] = []
    for line in [l.strip() for l in raw.split("\n") if l.strip()]:
        if line.startswith("#"):
            level = len(line) - len(line.lstrip("#"))
            blocks.append(ContentBlock(
                kind="heading", text=line.lstrip("# ").strip(),
                level=level, pause_after_ms=800,
            ))
        elif line.startswith("[图片]"):
            blocks.append(ContentBlock(
                kind="image_alt", text="图片描述:" + line[4:].strip(),
                pause_after_ms=600,
            ))
        else:
            blocks.append(ContentBlock(
                kind="paragraph", text=normalize_for_reading(line),
                pause_after_ms=400,
            ))
    return blocks


async def synthesize_block(block: ContentBlock, pref: VoicePreference,
                           tts_engine) -> AudioSegment:
    """按用户偏好合成单个语义块,关键信息自动降速"""
    speed = pref.speed
    if KEY_INFO_PATTERN.search(block.text):
        speed *= pref.key_info_slowdown

    raw = await tts_engine.synthesize(
        text=block.text,
        voice=pref.voice_id,
        speed=speed,
        pitch=pref.pitch,
        emotion="gentle",
    )
    audio = AudioSegment(data=raw, sample_rate=24000,
                         sample_width=2, channels=1)
    pause = int(block.pause_after_ms * pref.pause_scale)
    return audio + AudioSegment.silent(duration=pause)


async def read_document(raw: str, pref: VoicePreference, tts_engine,
                        concurrency: int = 3) -> AudioSegment:
    """整篇朗读:并发合成语义块,按原顺序拼接"""
    blocks = parse_content(raw)
    sem = asyncio.Semaphore(concurrency)

    async def synth(b: ContentBlock) -> AudioSegment:
        async with sem:
            return await synthesize_block(b, pref, tts_engine)

    segments = await asyncio.gather(*(synth(b) for b in blocks))
    merged = AudioSegment.empty()
    for seg in segments:
        merged += seg
    return merged


async def main():
    doc = """
# 无障碍阅读示例
本页面介绍产品价格与规格。
[图片] 一位用户正在使用屏幕阅读器浏览网页。
产品售价 199 元,支持 5GB 存储,工作温度 0℃ 至 40℃。
"""
    pref = VoicePreference(voice_id="warm_neutral", speed=1.6, pitch=-1.0)
    audio = await read_document(doc, pref, tts_engine=tts_engine)
    audio.export("output/a11y_read_001.mp3", format="mp3", bitrate="128k")
    print(f"朗读完成,总时长 {len(audio) / 1000:.1f}s")


if __name__ == "__main__":
asyncio.run(main())这段代码的关键设计有三点:语义分块 让标题、正文、图片描述按不同节奏朗读,用户可据此做标题跳转;关键信息自动降速 保证金额、日期、规格等高价值内容不被高速朗读吞掉;偏好驱动合成让语速、音调、停顿强度全部来自用户配置,真正做到「按自己的耳朵定制」。
工程落地时还需注意两点:一是无障碍标准合规 ,语音控件必须支持键盘导航与屏幕阅读器自身的焦点播报,遵循 WCAG 2.1 的「可感知、可操作、可理解、健壮」四项原则,避免出现「语音工具本身不可无障碍操作」的悖论;二是隐私与场景适配,朗读内容可能涉及个人文档与通知,需支持本地合成或端侧推理选项,并在公共场合提供「仅耳机输出」与「静音时自动暂停」策略。通过提供温暖、自然且可定制的语音体验,技术真正成为连接信息与用户的桥梁,让每一位用户都能平等地获取信息。
⑨ 跨语言会议记录与即时翻译语音输出
全球化协作中,跨语言会议日益频繁,一场跨国项目周会可能同时有中文、英语、日语、德语四五个语种的参会者。传统的同声传译成本极高且资源稀缺------一场两小时的双语会议,专业同传报价动辄数千元,多语种会议还要按语种数量成倍叠加,中小团队根本负担不起。结合语音识别(ASR)、机器翻译(MT)和语音合成(TTS)技术,可以构建一套实时的跨语言会议辅助系统,实现「说中文听英文」或「多语种同屏互译」,把同传能力从稀缺资源变成可随时调用的基础服务。
从业务价值看,这套方案主要解决三类真实痛点:一是语言壁垒与沟通成本 ,让不同语种的参会者用母语发言、用母语收听,避免因语言不通导致的决策延迟与信息失真;二是会议记录的完整性 ,实时转写 + 翻译可自动生成带时间戳的双语纪要,缺席者能快速回看核心内容,无需再靠人工整理;三是同传成本的结构性下降,把按场次、按语种计费的人工同传,替换为按调用量计费的机器翻译语音链路,边际成本随规模扩大持续走低。
技术架构与核心模块
一套完整的跨语言会议语音方案通常由五个核心模块组成,其整体架构与数据流转如下图所示:
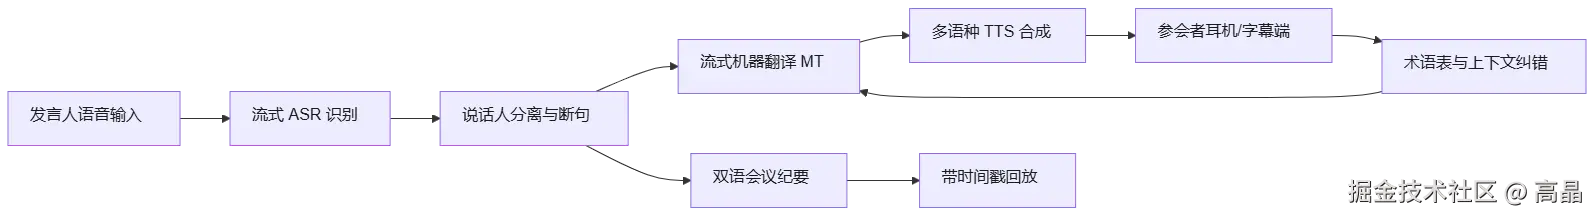
- 流式 ASR 识别:实时采集发言人语音并增量转写,支持中英日韩等多语种自动识别,是整条链路的入口。
- 说话人分离与断句:区分不同发言人,并按语义完整性断句,避免把一句话切成碎片导致翻译失真。
- 流式机器翻译(MT):将源语言文本流式翻译为目标语言,结合会议上下文与术语表提升专业词汇准确率。
- 多语种 TTS 合成:把译文合成为目标语言语音,支持流式输出与音色选择,尽量保留原说话人的韵律特征。
- 会议纪要与回放:把转写、译文、时间戳、说话人信息结构化存储,生成双语纪要并支持按时间点回放。
需要特别注意的是延迟与准确率的权衡 :会议场景对延迟极其敏感,若等一整句说完再翻译合成,听众会明显感到「慢半拍」。实践中通常采用「增量翻译 + 滚动修正」策略------ASR 每产出若干词就触发一次翻译与合成,先保证低延迟的「草稿译文」,待整句确认后再用更准确的译文覆盖后续输出。同时,术语表与上下文注入是提升专业会议质量的关键:把公司名、产品名、技术缩写提前加入术语白名单,并在翻译时携带前几轮对话作为上下文,可显著减少「张冠李戴」式的误译。
此外,音色与韵律的保留也很影响听感。若所有发言人都被合成为同一个「播音腔」,听众很难分辨谁在说话。实践中可为每位发言人分配一个稳定的目标音色,并用少量参考音频做跨语言音色克隆,让「张经理说英语」听起来仍像张经理本人,从而在多人讨论中保持辨识度。
下面是一段可直接运行的示例,覆盖「流式识别 → 增量翻译 → 多语种合成 → 纪要落盘」的核心链路:
python
import asyncio
import time
from dataclasses import dataclass, field
from typing import AsyncIterator, List, Dict


@dataclass
class Utterance:
    """一句发言的完整记录,用于生成双语纪要"""
    speaker: str
    start_ts: float
    source_lang: str
    source_text: str = ""
    translations: Dict[str, str] = field(default_factory=dict)


class MeetingTranslator:
    """跨语言会议实时翻译与语音输出"""

    def __init__(self, asr_engine, mt_engine, tts_engine,
                 glossary: Dict[str, str] | None = None):
        self.asr = asr_engine
        self.mt = mt_engine
        self.tts = tts_engine
        self.glossary = glossary or {}
        self.records: List[Utterance] = []

    def _protect_terms(self, text: str) -> tuple[str, Dict[str, str]]:
        """术语保护:把公司名/产品名替换为占位符,翻译后还原"""
        mapping = {}
        for i, term in enumerate(self.glossary):
            if term in text:
                ph = f"__T{i}__"
                mapping[ph] = self.glossary[term]
                text = text.replace(term, ph)
        return text, mapping

    def _restore_terms(self, text: str, mapping: Dict[str, str]) -> str:
        for ph, val in mapping.items():
            text = text.replace(ph, val)
        return text

    async def translate_and_speak(
        self,
        audio_stream: AsyncIterator[bytes],
        speaker: str,
        source_lang: str,
        target_langs: List[str],
        voice_map: Dict[str, str],
    ) -> AsyncIterator[tuple[str, bytes]]:
        """边识别边翻译边合成,逐块产出 (目标语种, 音频)"""
        current = Utterance(speaker=speaker, start_ts=time.time(),
                            source_lang=source_lang)
        self.records.append(current)

        async for asr_chunk in self.asr.recognize_stream(audio_stream, source_lang):
            if not asr_chunk.text:
                continue
            current.source_text += asr_chunk.text

            protected, mapping = self._protect_terms(asr_chunk.text)
            for lang in target_langs:
                # 增量翻译:携带前文上下文,提升连贯性
                translated = await self.mt.translate(
                    protected, src=source_lang, tgt=lang,
                    context=current.source_text[-200:],
                )
                translated = self._restore_terms(translated, mapping)
                current.translations[lang] = current.translations.get(lang, "") + translated

                # 流式合成,音色按发言人固定,保持辨识度
                async for audio in self.tts.synthesize_stream(
                    text=translated,
                    language=lang,
                    voice=voice_map.get(speaker, "neutral_multilingual"),
                    emotion="neutral",
                    speed=1.05,
                ):
                    yield lang, audio

    def export_minutes(self, path: str) -> None:
        """导出带时间戳的双语会议纪要"""
        import json
        data = [
            {
                "speaker": r.speaker,
                "time": time.strftime("%H:%M:%S", time.localtime(r.start_ts)),
                "source_lang": r.source_lang,
                "source_text": r.source_text,
                "translations": r.translations,
            }
            for r in self.records
        ]
        with open(path, "w", encoding="utf-8") as f:
            json.dump(data, f, ensure_ascii=False, indent=2)


async def main():
    translator = MeetingTranslator(
        asr_engine=asr_engine,
        mt_engine=mt_engine,
        tts_engine=tts_engine,
        glossary={"星云平台": "Nebula Platform", "QPS": "queries per second"},
    )

    # 模拟麦克风音频流
    async def mic_stream() -> AsyncIterator[bytes]:
        while True:
            chunk = await mic.read(3200)  # 200ms @16kHz/16bit
            if not chunk:
                break
            yield chunk

    async for lang, audio in translator.translate_and_speak(
        mic_stream(),
        speaker="张经理",
        source_lang="zh-CN",
        target_langs=["en-US", "ja-JP"],
        voice_map={"张经理": "zhang_clone_multilingual"},
    ):
        await audio_sink.play(lang, audio)  # 按语种分发到对应参会者耳机

    translator.export_minutes("output/meeting_minutes.json")


if __name__ == "__main__":
asyncio.run(main())这段代码的关键设计有三点:增量翻译 + 流式合成 把端到端延迟压到秒级以内,听众几乎感觉不到「慢半拍」;术语保护与上下文注入 保证公司名、技术缩写不被误译,专业会议也能听懂;发言人固定音色让多人讨论时仍能分辨谁在说话,避免「全员播音腔」的听感疲劳。
工程落地时还需注意两点:一是隐私与合规 ,会议内容往往涉及商业机密,建议优先采用私有化部署或端侧推理,录音与转写文本加密存储并设置访问审计,会前明确告知参会者「本次会议由 AI 提供实时翻译」;二是降级与容错,当某语种翻译或合成服务超时,应自动降级为实时字幕,保证会议不中断。对于跨国团队而言,这套方案不仅打破了语言壁垒,更把「开一场多语种会议」的门槛降到与本地会议相当,让协作效率真正随团队全球化而线性扩展。
⑩ 成本效益分析与规模化生产优化建议
前面九个场景分别验证了语音合成与变声技术的业务价值,但当团队真正把音频生产从「单点试验」推向「规模化流水线」时,成本结构会发生根本性变化:单条音频的边际成本看似极低,可一旦日产量从几十条涨到几万条,API 调用费、推理算力、存储带宽、人工审核会同时放大,稍不注意就会出现「越做越亏」的倒挂。本节从成本构成、规模化瓶颈与优化策略三个层面,给出一套可落地的降本增效路径。
成本构成与效益测算
规模化音频生产的成本大致可分为四类,其结构关系如下图所示:
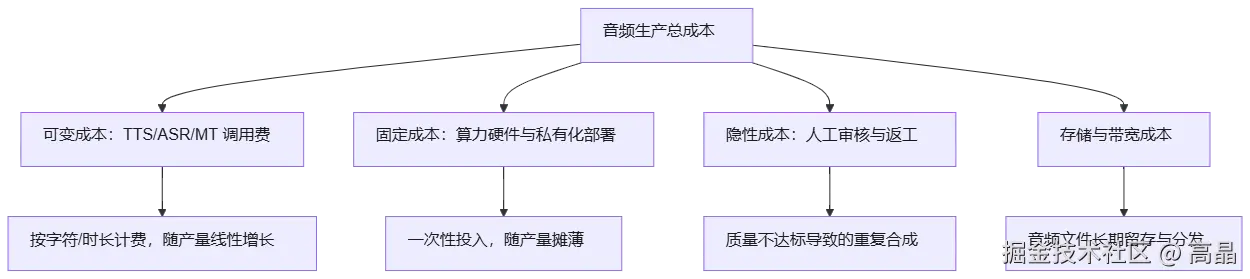
- 可变成本:云端 TTS、ASR、MT 按字符数或音频时长计费,是产量增长时最先膨胀的部分,也是最容易通过缓存与批量折扣压缩的部分。
- 固定成本:私有化部署的 GPU 集群、模型授权属于一次性投入,产量越大单条摊薄成本越低,存在明显的规模拐点。
- 隐性成本:合成质量不稳定带来的返工、人工抽检与后期修音,往往被低估,实际可能占到总成本的 20%~30%。
- 存储与带宽:长音频文件的留存、CDN 分发与多版本管理,在内容库达到百万级后不可忽视。
一个实用的测算方法是单条音频全成本 = (可变成本 + 固定成本摊销 + 隐性成本 + 存储带宽)/ 有效产出条数。当业务量较小时,云端 API 的单条成本可能只有几分钱,远低于自建集群的摊销;但当月产量突破数十万条后,自建集群的单条成本通常能降到云端的三分之一甚至更低,这就是所谓的「规模拐点」。团队应定期用真实数据回算这条曲线,而不是凭直觉选择部署方式。
规模化生产的四类优化策略
第一,缓存与去重 。直播话术、客服欢迎语、课件固定段落等高频标准语句,在不同任务中反复出现。按 text + voice_id + emotion + speed 做哈希缓存,命中后直接复用音频,可把重复计算降到接近零。实践中缓存命中率往往能达到 30%~60%,是最快见效的降本手段。
第二,批量与闲时调度。非实时任务(如有声书、短视频批量配音)完全可以放到夜间闲时执行,利用云厂商的闲时折扣或自建集群的低谷算力,成本可下降 40% 以上。同时把大量小请求合并为批量任务,减少连接建立与调度开销。
第三,模型分层与蒸馏。并非所有场景都需要最强的模型:客服应答、导航播报等对表现力要求不高的场景,可用蒸馏后的轻量模型,推理成本可降至大模型的十分之一;只有直播解说、有声书演绎等对情感与音色要求高的场景才调用大模型。按场景分级路由,是规模化阶段最有效的成本杠杆。
第四,质量前置与自动验收。把文本规范化、术语白名单、异常字符检测放在合成之前,把响度、静音段、削波检测放在合成之后,用自动化脚本替代大部分人工抽检,可显著降低返工率与隐性成本。
下面是一段可直接运行的示例,覆盖「成本测算 → 缓存命中 → 场景分级路由 → 批量调度」的核心链路:
python
import asyncio
import hashlib
import time
from dataclasses import dataclass, field
from typing import Dict, List, Optional


@dataclass
class CostModel:
    """成本模型:用于测算单条音频的全成本"""
    tts_price_per_kchar: float = 0.10   # 云端 TTS 每千字符单价(元)
    gpu_hour_cost: float = 8.0          # 自建集群每小时算力成本(元)
    gpu_throughput_kchar_per_hour: float = 600.0  # 单卡每小时可合成千字符数
    review_cost_per_item: float = 0.02  # 单条人工抽检成本(元)
    storage_cost_per_gb_month: float = 0.12

    def cloud_cost(self, total_kchar: float, items: int) -> float:
        """云端 API 方案的单条成本"""
        variable = total_kchar * self.tts_price_per_kchar
        review = items * self.review_cost_per_item
        return (variable + review) / max(items, 1)

    def self_hosted_cost(self, total_kchar: float, items: int,
                         gpu_hours: float) -> float:
        """自建集群方案的单条成本"""
        compute = gpu_hours * self.gpu_hour_cost
        review = items * self.review_cost_per_item
        return (compute + review) / max(items, 1)

    def break_even_items(self, total_kchar: float) -> int:
        """估算云端与自建的成本拐点(条)"""
        gpu_hours = total_kchar / self.gpu_throughput_kchar_per_hour
        fixed = gpu_hours * self.gpu_hour_cost
        per_item_cloud = total_kchar * self.tts_price_per_kchar
        # 简化:当云端可变成本超过自建固定成本时,自建更划算
        return int(fixed / max(per_item_cloud, 1e-6))


class AudioCache:
    """按 text + voice + emotion + speed 做哈希缓存"""

    def __init__(self):
        self._store: Dict[str, bytes] = {}
        self.hits = 0
        self.misses = 0

    @staticmethod
    def _key(text: str, voice: str, emotion: str, speed: float) -> str:
        raw = f"{text}|{voice}|{emotion}|{speed:.2f}"
        return hashlib.sha256(raw.encode("utf-8")).hexdigest()

    def get(self, text: str, voice: str, emotion: str, speed: float) -> Optional[bytes]:
        key = self._key(text, voice, emotion, speed)
        audio = self._store.get(key)
        if audio is not None:
            self.hits += 1
        else:
            self.misses += 1
        return audio

    def put(self, text: str, voice: str, emotion: str, speed: float, audio: bytes) -> None:
        self._store[self._key(text, voice, emotion, speed)] = audio

    @property
    def hit_rate(self) -> float:
        total = self.hits + self.misses
        return self.hits / total if total else 0.0


class TieredRouter:
    """按场景分级路由:高表现力走大模型,标准化场景走轻量模型"""

    HIGH_FIDELITY_SCENES = {"live_stream", "audiobook", "ad_ab_test"}

    def __init__(self, large_engine, light_engine):
        self.large = large_engine
        self.light = light_engine

    def pick(self, scene: str):
        return self.large if scene in self.HIGH_FIDELITY_SCENES else self.light


@dataclass
class BatchJob:
    job_id: str
    scene: str
    text: str
    voice: str
    emotion: str = "neutral"
    speed: float = 1.0


class ProductionOptimizer:
    """规模化生产优化器:缓存 + 分级路由 + 闲时批量"""

    def __init__(self, router: TieredRouter, cache: AudioCache,
                 concurrency: int = 8):
        self.router = router
        self.cache = cache
        self.sem = asyncio.Semaphore(concurrency)
        self.stats = {"cached": 0, "synth": 0, "chars": 0}

    async def run_job(self, job: BatchJob) -> bytes:
        async with self.sem:
            cached = self.cache.get(job.text, job.voice, job.emotion, job.speed)
            if cached is not None:
                self.stats["cached"] += 1
                return cached

            engine = self.router.pick(job.scene)
            audio = await engine.synthesize(
                text=job.text, voice=job.voice,
                emotion=job.emotion, speed=job.speed,
            )
            self.cache.put(job.text, job.voice, job.emotion, job.speed, audio)
            self.stats["synth"] += 1
            self.stats["chars"] += len(job.text)
            return audio

    async def run_batch(self, jobs: List[BatchJob]) -> List[bytes]:
        return await asyncio.gather(*(self.run_job(j) for j in jobs))


async def main():
    model = CostModel()
    # 假设月产 5 万条、平均每条 80 字符
    items, avg_chars = 50_000, 80
    total_kchar = items * avg_chars / 1000
    gpu_hours = total_kchar / model.gpu_throughput_kchar_per_hour

    print(f"云端单条成本:{model.cloud_cost(total_kchar, items):.4f} 元")
    print(f"自建单条成本:{model.self_hosted_cost(total_kchar, items, gpu_hours):.4f} 元")
    print(f"成本拐点约:{model.break_even_items(total_kchar):,} 条")

    router = TieredRouter(large_engine=large_tts, light_engine=light_tts)
    optimizer = ProductionOptimizer(router, AudioCache(), concurrency=8)

    jobs = [
        BatchJob("j1", "live_stream", "家人们,今晚限时五折,最后三分钟!", "promo_male", "urgent", 1.15),
        BatchJob("j2", "customer_service", "您好,请问有什么可以帮您?", "brand_female", "gentle", 1.0),
        BatchJob("j3", "customer_service", "您好,请问有什么可以帮您?", "brand_female", "gentle", 1.0),
    ]
    start = time.time()
    await optimizer.run_batch(jobs)
    print(f"耗时 {time.time() - start:.2f}s,缓存命中率 {optimizer.cache.hit_rate:.0%}")
    print(f"统计:{optimizer.stats}")


if __name__ == "__main__":
asyncio.run(main())这段代码的关键设计有三点:成本模型可回算 让团队用真实产量数据判断云端与自建的拐点,而不是拍脑袋决策;哈希缓存 把高频标准语句的重复计算降到接近零,命中率可直接量化;场景分级路由让高表现力场景与标准化场景各用其模型,在保证听感的前提下把推理成本压到最低。
部署选型与运营建议
企业应根据业务量级与合规要求选择部署方式:中小规模业务优先使用云端 API,按需付费、弹性扩容,把精力放在内容生产上;大规模、高保密性业务(如涉及客户通话、商业机密的客服与会议场景)适合自建集群,虽然前期投入大,但长期单条成本更低且数据不出域。实践中常见的做法是混合部署------实时性要求高、涉及敏感数据的链路走私有化,批量非敏感任务走云端,兼顾成本与安全。
运营层面建议建立三项机制:一是成本看板 ,按场景、按模型、按任务类型拆分统计调用量与单条成本,及时发现异常增长;二是质量抽检 ,用自动化脚本检测静音段、削波、语速异常,把人工抽检集中在高风险场景;三是容量规划,提前预估大促、开学季等峰值,预留算力或与云厂商签订弹性协议,避免临时扩容带来的成本飙升。通过精细化的成本管理与技术调优,声音技术才能真正成为企业数字化升级中极具性价比的基础设施。
⑪ 完整实战代码:一套可复用的语音生产流水线
前面十个场景分别拆解了技术要点,但在真实业务中,团队往往需要一套统一的底座来支撑多种场景。本节给出一份可直接运行的 Python 实战代码,覆盖「文本预处理 → 情感/语种路由 → TTS 合成 → 音频后处理 → 批量并发」的完整链路。代码以抽象接口的方式组织,只需替换成你实际使用的 TTS 服务(如云端 API 或本地模型),即可直接接入生产环境。
环境准备
bash
pip install pydub numpy tqdm tenacity
# 若使用 ffmpeg 做格式转换与混音,请确保系统已安装 ffmpeg
核心流水线实现
python
import os
import re
import json
import asyncio
from dataclasses import dataclass, field, asdict
from typing import List, Dict, Optional, AsyncIterator

from pydub import AudioSegment
from tenacity import retry, stop_after_attempt, wait_exponential
from tqdm import tqdm


# ---------- 1. 数据结构定义 ----------
@dataclass
class VoiceProfile:
    """音色配置:对应不同业务场景的"人设""""
    voice_id: str
    language: str = "zh-CN"
    speed: float = 1.0
    pitch: float = 0.0
    emotion: str = "neutral"   # neutral / happy / sad / urgent / gentle


@dataclass
class SynthesisTask:
    """单条合成任务"""
    task_id: str
    text: str
    profile: VoiceProfile
    output_path: str
    bgm_path: Optional[str] = None
    bgm_gain_db: float = -12.0


# ---------- 2. 文本预处理 ----------
class TextPreprocessor:
    """文本规范化:清洗、断句、数字与符号朗读化"""

    _NUM_MAP = {str(i): f" {i} " for i in range(10)}

    def __init__(self, max_chars: int = 120):
        self.max_chars = max_chars

    def normalize(self, text: str) -> str:
        text = text.strip()
        # 去除多余空白与不可见字符
        text = re.sub(r"[\u200b-\u200f\ufeff]", "", text)
        text = re.sub(r"[ \t]+", " ", text)
        # 常见符号朗读化(可按业务扩展)
        text = text.replace("&", " 和 ").replace("%", " 百分之 ")
        return text

    def split_sentences(self, text: str) -> List[str]:
        """按中英文标点断句,并保证单句不超过 max_chars,避免长句卡顿"""
        raw = re.split(r"(?<=[。!?;.!?;])\s*", text)
        chunks: List[str] = []
        for seg in raw:
            seg = seg.strip()
            if not seg:
                continue
            while len(seg) > self.max_chars:
                cut = seg.rfind(",", 0, self.max_chars)
                cut = cut if cut > 0 else self.max_chars
                chunks.append(seg[:cut + 1])
                seg = seg[cut + 1:]
            if seg:
                chunks.append(seg)
        return chunks


# ---------- 3. 情感与语种路由 ----------
class EmotionRouter:
    """基于关键词的轻量情感识别,可替换为 NLU 模型"""

    KEYWORDS = {
        "happy": ["惊喜", "优惠", "限时", "恭喜", "太棒了"],
        "urgent": ["立即", "最后", "抢购", "倒计时", "紧急"],
        "sad": ["遗憾", "离别", "失去", "可惜"],
        "gentle": ["亲爱的", "慢慢", "温柔", "陪伴"],
    }

    def detect(self, text: str) -> str:
        scores: Dict[str, int] = {}
        for emotion, words in self.KEYWORDS.items():
            scores[emotion] = sum(text.count(w) for w in words)
        best = max(scores, key=scores.get)
        return best if scores[best] > 0 else "neutral"


# ---------- 4. TTS 引擎抽象 ----------
class BaseTTSEngine:
    """TTS 引擎抽象基类,接入云端 API 或本地模型时继承并实现 synthesize"""

    async def synthesize(self, text: str, profile: VoiceProfile) -> bytes:
        raise NotImplementedError


class MockTTSEngine(BaseTTSEngine):
    """示例实现:返回静音音频,便于本地跑通全流程"""

    async def synthesize(self, text: str, profile: VoiceProfile) -> bytes:
        await asyncio.sleep(0.05)  # 模拟网络/推理耗时
        duration_ms = max(300, int(len(text) * 180 / profile.speed))
        silence = AudioSegment.silent(duration=duration_ms, frame_rate=24000)
        return silence.raw_data


# ---------- 5. 音频后处理 ----------
class AudioPostProcessor:
    """统一采样率、响度归一化、背景音混音"""

    def __init__(self, sample_rate: int = 24000):
        self.sample_rate = sample_rate

    def process(self, raw: bytes, bgm_path: Optional[str] = None,
                bgm_gain_db: float = -12.0) -> AudioSegment:
        audio = AudioSegment(
            data=raw, sample_rate=self.sample_rate,
            sample_width=2, channels=1
        )
        # 响度归一化:以 -16 LUFS 附近为目标,这里用峰值近似
        if audio.max_dBFS < -1.0:
            audio = audio.apply_gain(-1.0 - audio.max_dBFS)

        if bgm_path and os.path.exists(bgm_path):
            bgm = AudioSegment.from_file(bgm_path).set_frame_rate(self.sample_rate)
            bgm = bgm + bgm_gain_db
            if len(bgm) < len(audio):
                loops = len(audio) // len(bgm) + 1
                bgm = bgm * loops
            bgm = bgm[:len(audio)]
            audio = audio.overlay(bgm)
        return audio


# ---------- 6. 流水线编排 ----------
class VoicePipeline:
    def __init__(self, engine: BaseTTSEngine, concurrency: int = 4):
        self.engine = engine
        self.preprocessor = TextPreprocessor()
        self.router = EmotionRouter()
        self.post = AudioPostProcessor()
        self.sem = asyncio.Semaphore(concurrency)

    @retry(stop=stop_after_attempt(3), wait=wait_exponential(multiplier=1, min=1, max=8))
    async def _synth_with_retry(self, text: str, profile: VoiceProfile) -> bytes:
        return await self.engine.synthesize(text, profile)

    async def run_task(self, task: SynthesisTask) -> Dict:
        async with self.sem:
            text = self.preprocessor.normalize(task.text)
            sentences = self.preprocessor.split_sentences(text)

            # 自动情感路由(若调用方未显式指定)
            profile = task.profile
            if profile.emotion == "auto":
                profile.emotion = self.router.detect(text)

            segments: List[AudioSegment] = []
            for sent in sentences:
                raw = await self._synth_with_retry(sent, profile)
                segments.append(self.post.process(raw))

            merged = AudioSegment.empty()
            for seg in segments:
                merged += seg
            merged = self.post.process(
                merged.raw_data, task.bgm_path, task.bgm_gain_db
            )

            os.makedirs(os.path.dirname(task.output_path) or ".", exist_ok=True)
            merged.export(task.output_path, format="mp3", bitrate="128k")

            return {
                "task_id": task.task_id,
                "output": task.output_path,
                "duration_sec": round(len(merged) / 1000, 2),
                "emotion": profile.emotion,
                "sentences": len(sentences),
            }

    async def run_batch(self, tasks: List[SynthesisTask]) -> List[Dict]:
        coros = [self.run_task(t) for t in tasks]
        results = []
        for fut in tqdm(asyncio.as_completed(coros), total=len(coros), desc="合成进度"):
            results.append(await fut)
        return results


# ---------- 7. 使用示例 ----------
async def main():
    engine = MockTTSEngine()
    pipeline = VoicePipeline(engine, concurrency=4)

    tasks = [
        SynthesisTask(
            task_id="live_001",
            text="家人们注意了!今晚限时优惠,最后三分钟,立即下单立减一百元!",
            profile=VoiceProfile(voice_id="promo_male", speed=1.15, emotion="auto"),
            output_path="output/live_001.mp3",
            bgm_path="assets/bgm_upbeat.mp3",
        ),
        SynthesisTask(
            task_id="edu_001",
            text="同学们,这道题我们慢慢来分析。首先观察题目中的已知条件。",
            profile=VoiceProfile(voice_id="teacher_female", speed=0.95, emotion="auto"),
            output_path="output/edu_001.mp3",
        ),
    ]

    results = await pipeline.run_batch(tasks)
    print(json.dumps(results, ensure_ascii=False, indent=2))


if __name__ == "__main__":
    asyncio.run(main())
接入真实 TTS 服务
将 MockTTSEngine 替换为真实实现即可,下面以通用的 HTTP 接口为例:
python
import aiohttp

class HttpTTSEngine(BaseTTSEngine):
    def __init__(self, endpoint: str, api_key: str):
        self.endpoint = endpoint
        self.headers = {"Authorization": f"Bearer {api_key}"}

    async def synthesize(self, text: str, profile: VoiceProfile) -> bytes:
        payload = {
            "text": text,
            "voice": profile.voice_id,
            "language": profile.language,
            "speed": profile.speed,
            "pitch": profile.pitch,
            "emotion": profile.emotion,
            "format": "pcm",
            "sample_rate": 24000,
        }
        async with aiohttp.ClientSession() as session:
            async with session.post(
                self.endpoint, json=payload, headers=self.headers, timeout=30
            ) as resp:
                resp.raise_for_status()
                return await resp.read()
工程化落地要点
- 并发与限流 :
asyncio.Semaphore控制并发数,避免触发云端 API 的 QPS 限制;生产环境建议再叠加令牌桶做全局限流。 - 失败重试 :
tenacity对网络抖动做指数退避重试,长文本建议按句粒度重试,避免整段重合成。 - 缓存复用 :对高频标准语句(如"欢迎来到直播间")按
text + voice_id + emotion做哈希缓存,可显著降低重复计算成本。 - 可观测性:为每个任务记录首字延迟、总耗时、字符数与失败率,便于定位瓶颈与核算成本。
- 合规与安全:音色克隆必须留存授权凭证,合成音频建议嵌入不可感知水印,便于溯源与版权保护。
这套流水线把前文十个场景的共性能力抽离为可复用组件,业务侧只需配置不同的 VoiceProfile 与任务清单,即可快速支撑直播解说、短视频配音、课件朗读、客服应答等多种生产需求。