AIOps(一):基于 Prometheus MCP + WorkBuddy 构建 AI 智能运维
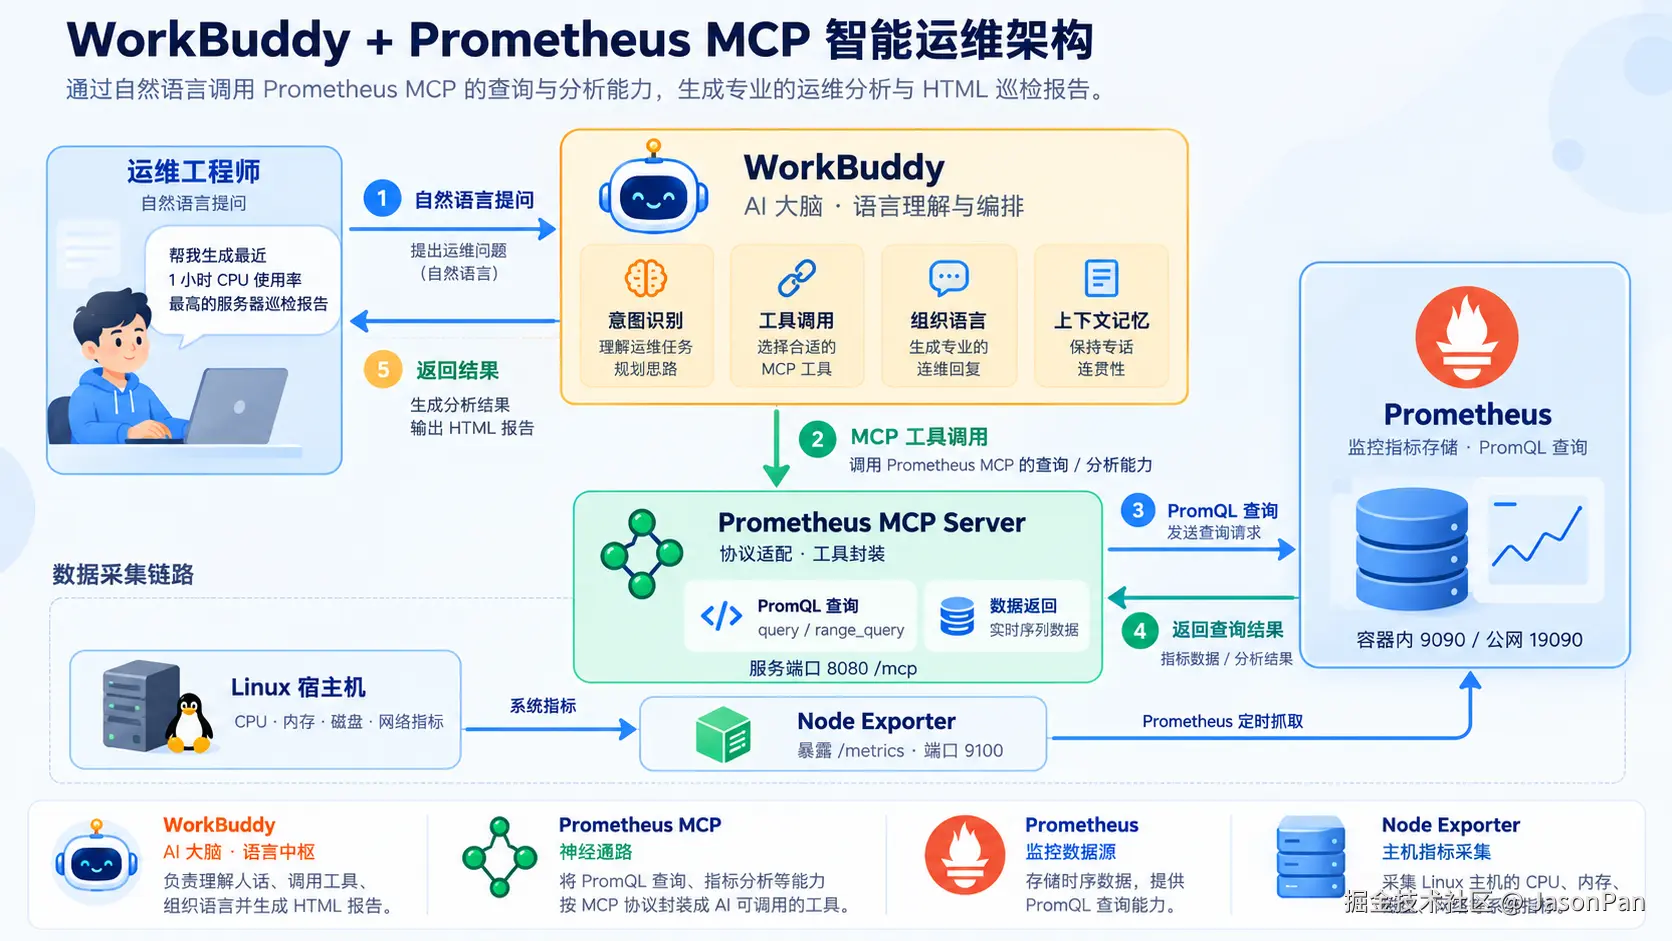
本文基于 Linux 监控场景,使用 Docker Compose 部署 Prometheus、Node Exporter 和 Prometheus MCP Server ,接入 WorkBuddy,实现自然语言查询监控指标,并自动生成 HTML 可视化巡检报告。
一、整体架构
| 组件 | 主要职责 |
|---|---|
| Node Exporter | 暴露 Linux CPU、内存、磁盘、网络与负载指标 |
| Prometheus | 抓取与保存指标,通过 PromQL 提供查询 |
| Prometheus MCP Server | 将 Prometheus API 封装成 AI 可调用的 MCP 工具 |
| WorkBuddy | 理解自然语言、调用工具、分析数据并生成 HTML |
MCP(Model Context Protocol,模型上下文协议): 为 AI 应用提供标准化的外部工具调用方式。在本方案中,数据采集由 Node Exporter 与 Prometheus 完成;WorkBuddy 通过 MCP Server 查询已采集的数据并生成报告。
二、Docker Compose 部署:3 个容器
前置条件:一台已安装 Docker Engine / Docker Compose V2 的 Linux 云服务器,以及安装了 WorkBuddy 的本地电脑。以下统一使用示例公网 IP 203.0.113.10(文档保留地址,实际部署时替换为服务器公网 IP)。
2.1 创建 Prometheus 抓取配置
在 Linux 服务器203.0.113.10执行:
bash
mkdir -p ~/aiops-prometheus && cd ~/aiops-prometheus
vi prometheus.yml
将以下内容保存到 prometheus.yml:
yaml
global:
  scrape_interval: 15s

scrape_configs:
  - job_name: prometheus
    static_configs:
      - targets: ['localhost:9090']

  - job_name: node
    static_configs:
      - targets: ['node-exporter:9100']
        labels:
instance: '203.0.113.10'其中,node-exporter:9100 是 Docker 内部访问地址,instance 用作监控实例标识。
2.2 创建 Compose 文件
bash
vi compose.yaml
yaml
services:
  prometheus:
    image: prom/prometheus:latest
    container_name: prometheus
    restart: unless-stopped
    ports:
      - '19090:9090'
    volumes:
      - ./prometheus.yml:/etc/prometheus/prometheus.yml:ro
      - prometheus-data:/prometheus

  node-exporter:
    image: quay.io/prometheus/node-exporter:latest
    container_name: node-exporter
    restart: unless-stopped
    volumes:
      - /proc:/host/proc:ro
      - /sys:/host/sys:ro
      - /:/rootfs:ro,rslave
    command:
      - --path.procfs=/host/proc
      - --path.sysfs=/host/sys
      - --path.rootfs=/rootfs
    expose:
      - '9100'

  prometheus-mcp-server:
    image: swr.cn-north-4.myhuaweicloud.com/ddn-k8s/ghcr.io/tjhop/prometheus-mcp-server:latest
    container_name: prometheus-mcp-server
    restart: unless-stopped
    depends_on:
      - prometheus
    ports:
      - '8080:8080'
    command:
      - --prometheus.url=http://prometheus:9090
      - --mcp.transport=http
      - --web.listen-address=:8080

volumes:
  prometheus-data:
该配置共启动 3 个容器 :Prometheus 对外使用 19090,MCP Server 对外使用 8080,Node Exporter 通过 Docker 内部网络供 Prometheus 采集。Prometheus 数据保存在持久化数据卷中。
云服务器放行 TCP 8080 和 19090:阿里云轻量应用服务器在防火墙 中配置,ECS 使用安全组;建议仅允许可信来源 IP 访问,生产环境还应配置 HTTPS 与身份认证。
2.3 启动与验证
bash
docker compose up -d
docker compose ps
curl -sG http://127.0.0.1:19090/api/v1/query --data-urlencode 'query=up'
确认三个容器均为 Up,并且查询结果中 job="prometheus" 与 job="node" 的值均为 1,即表示指标采集链路可用。
三、WorkBuddy 接入 Prometheus MCP
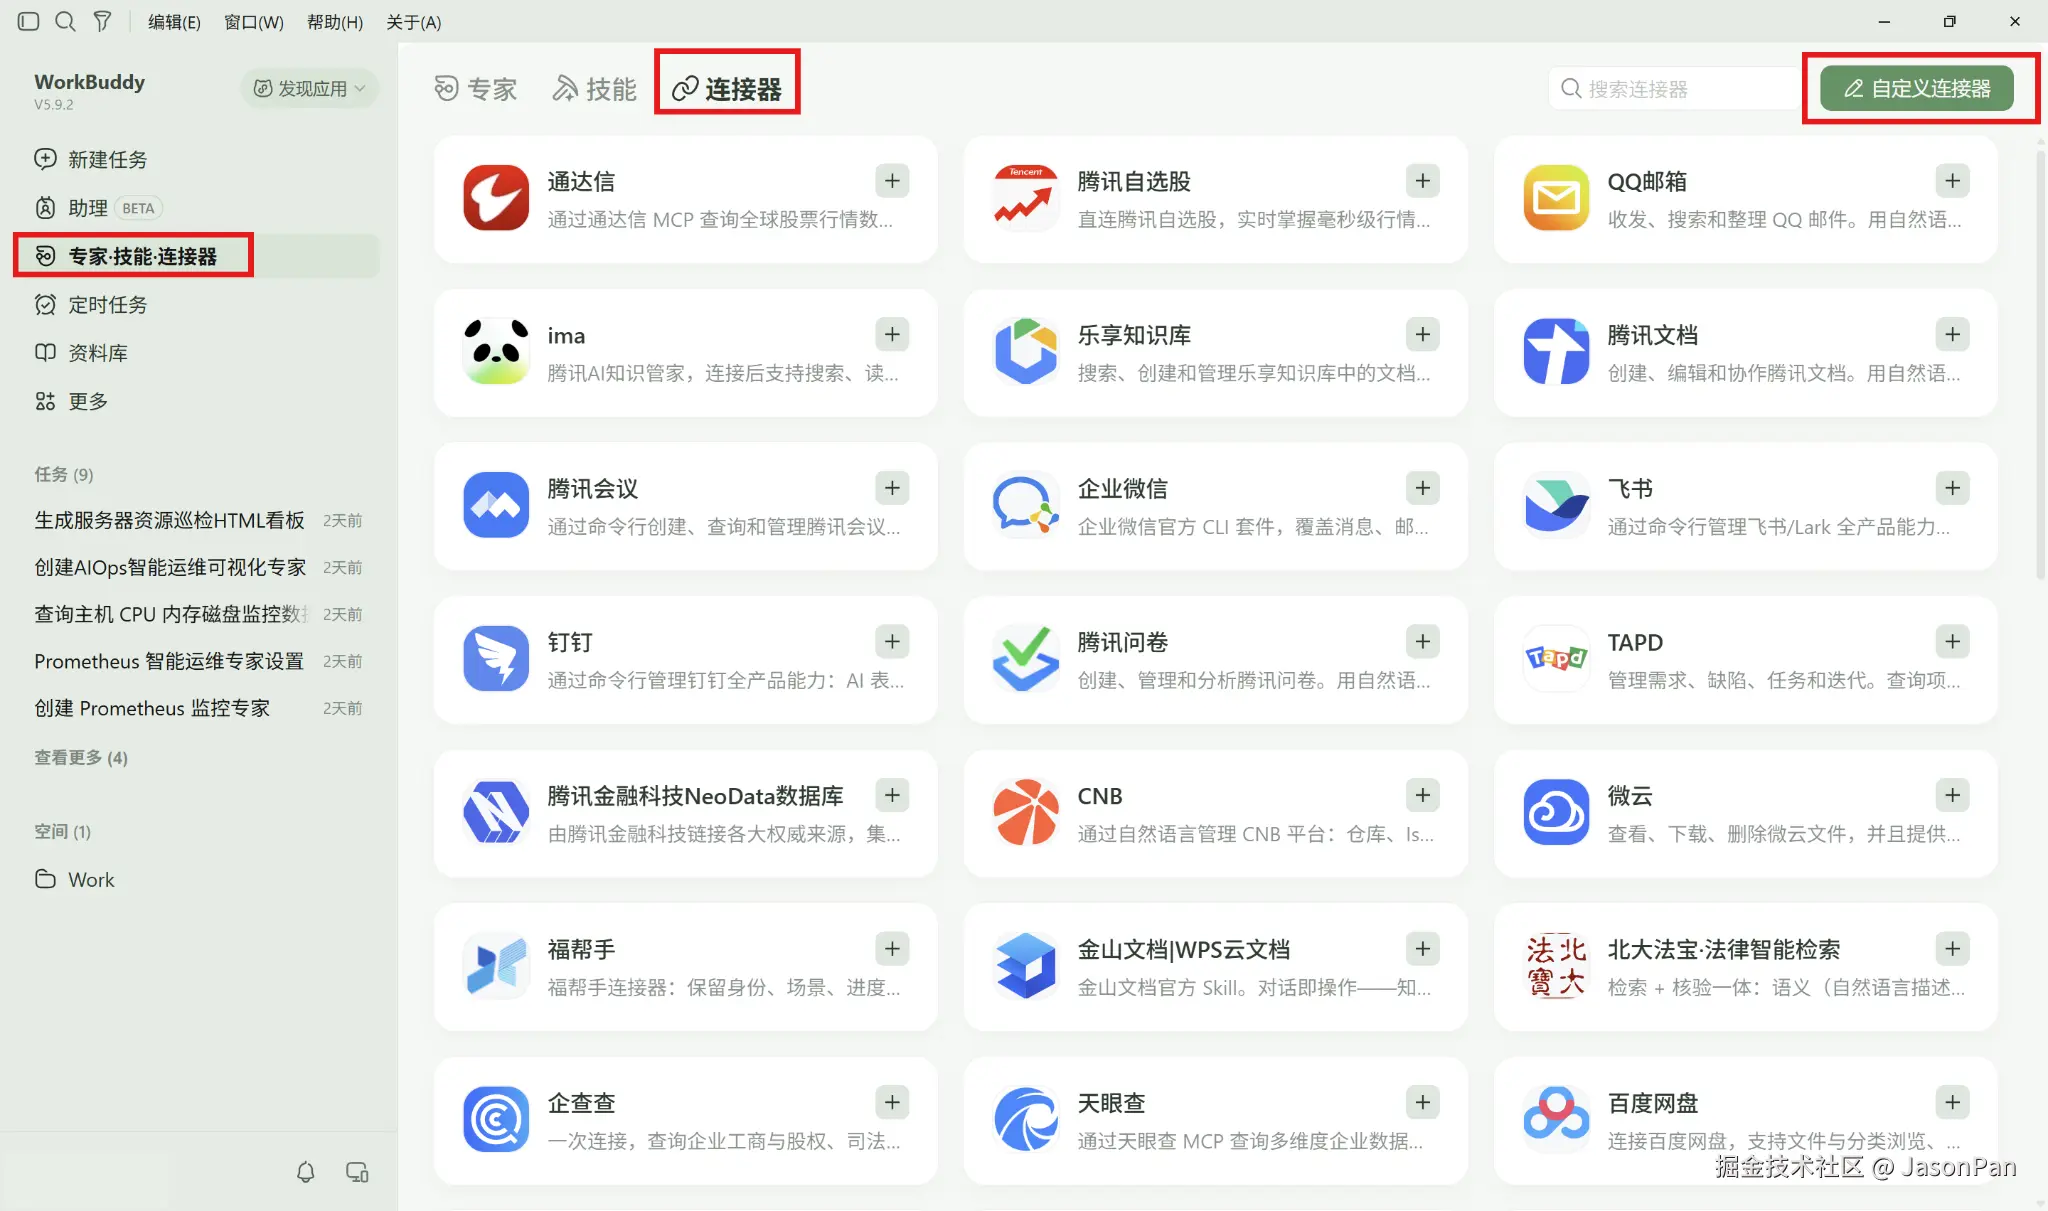
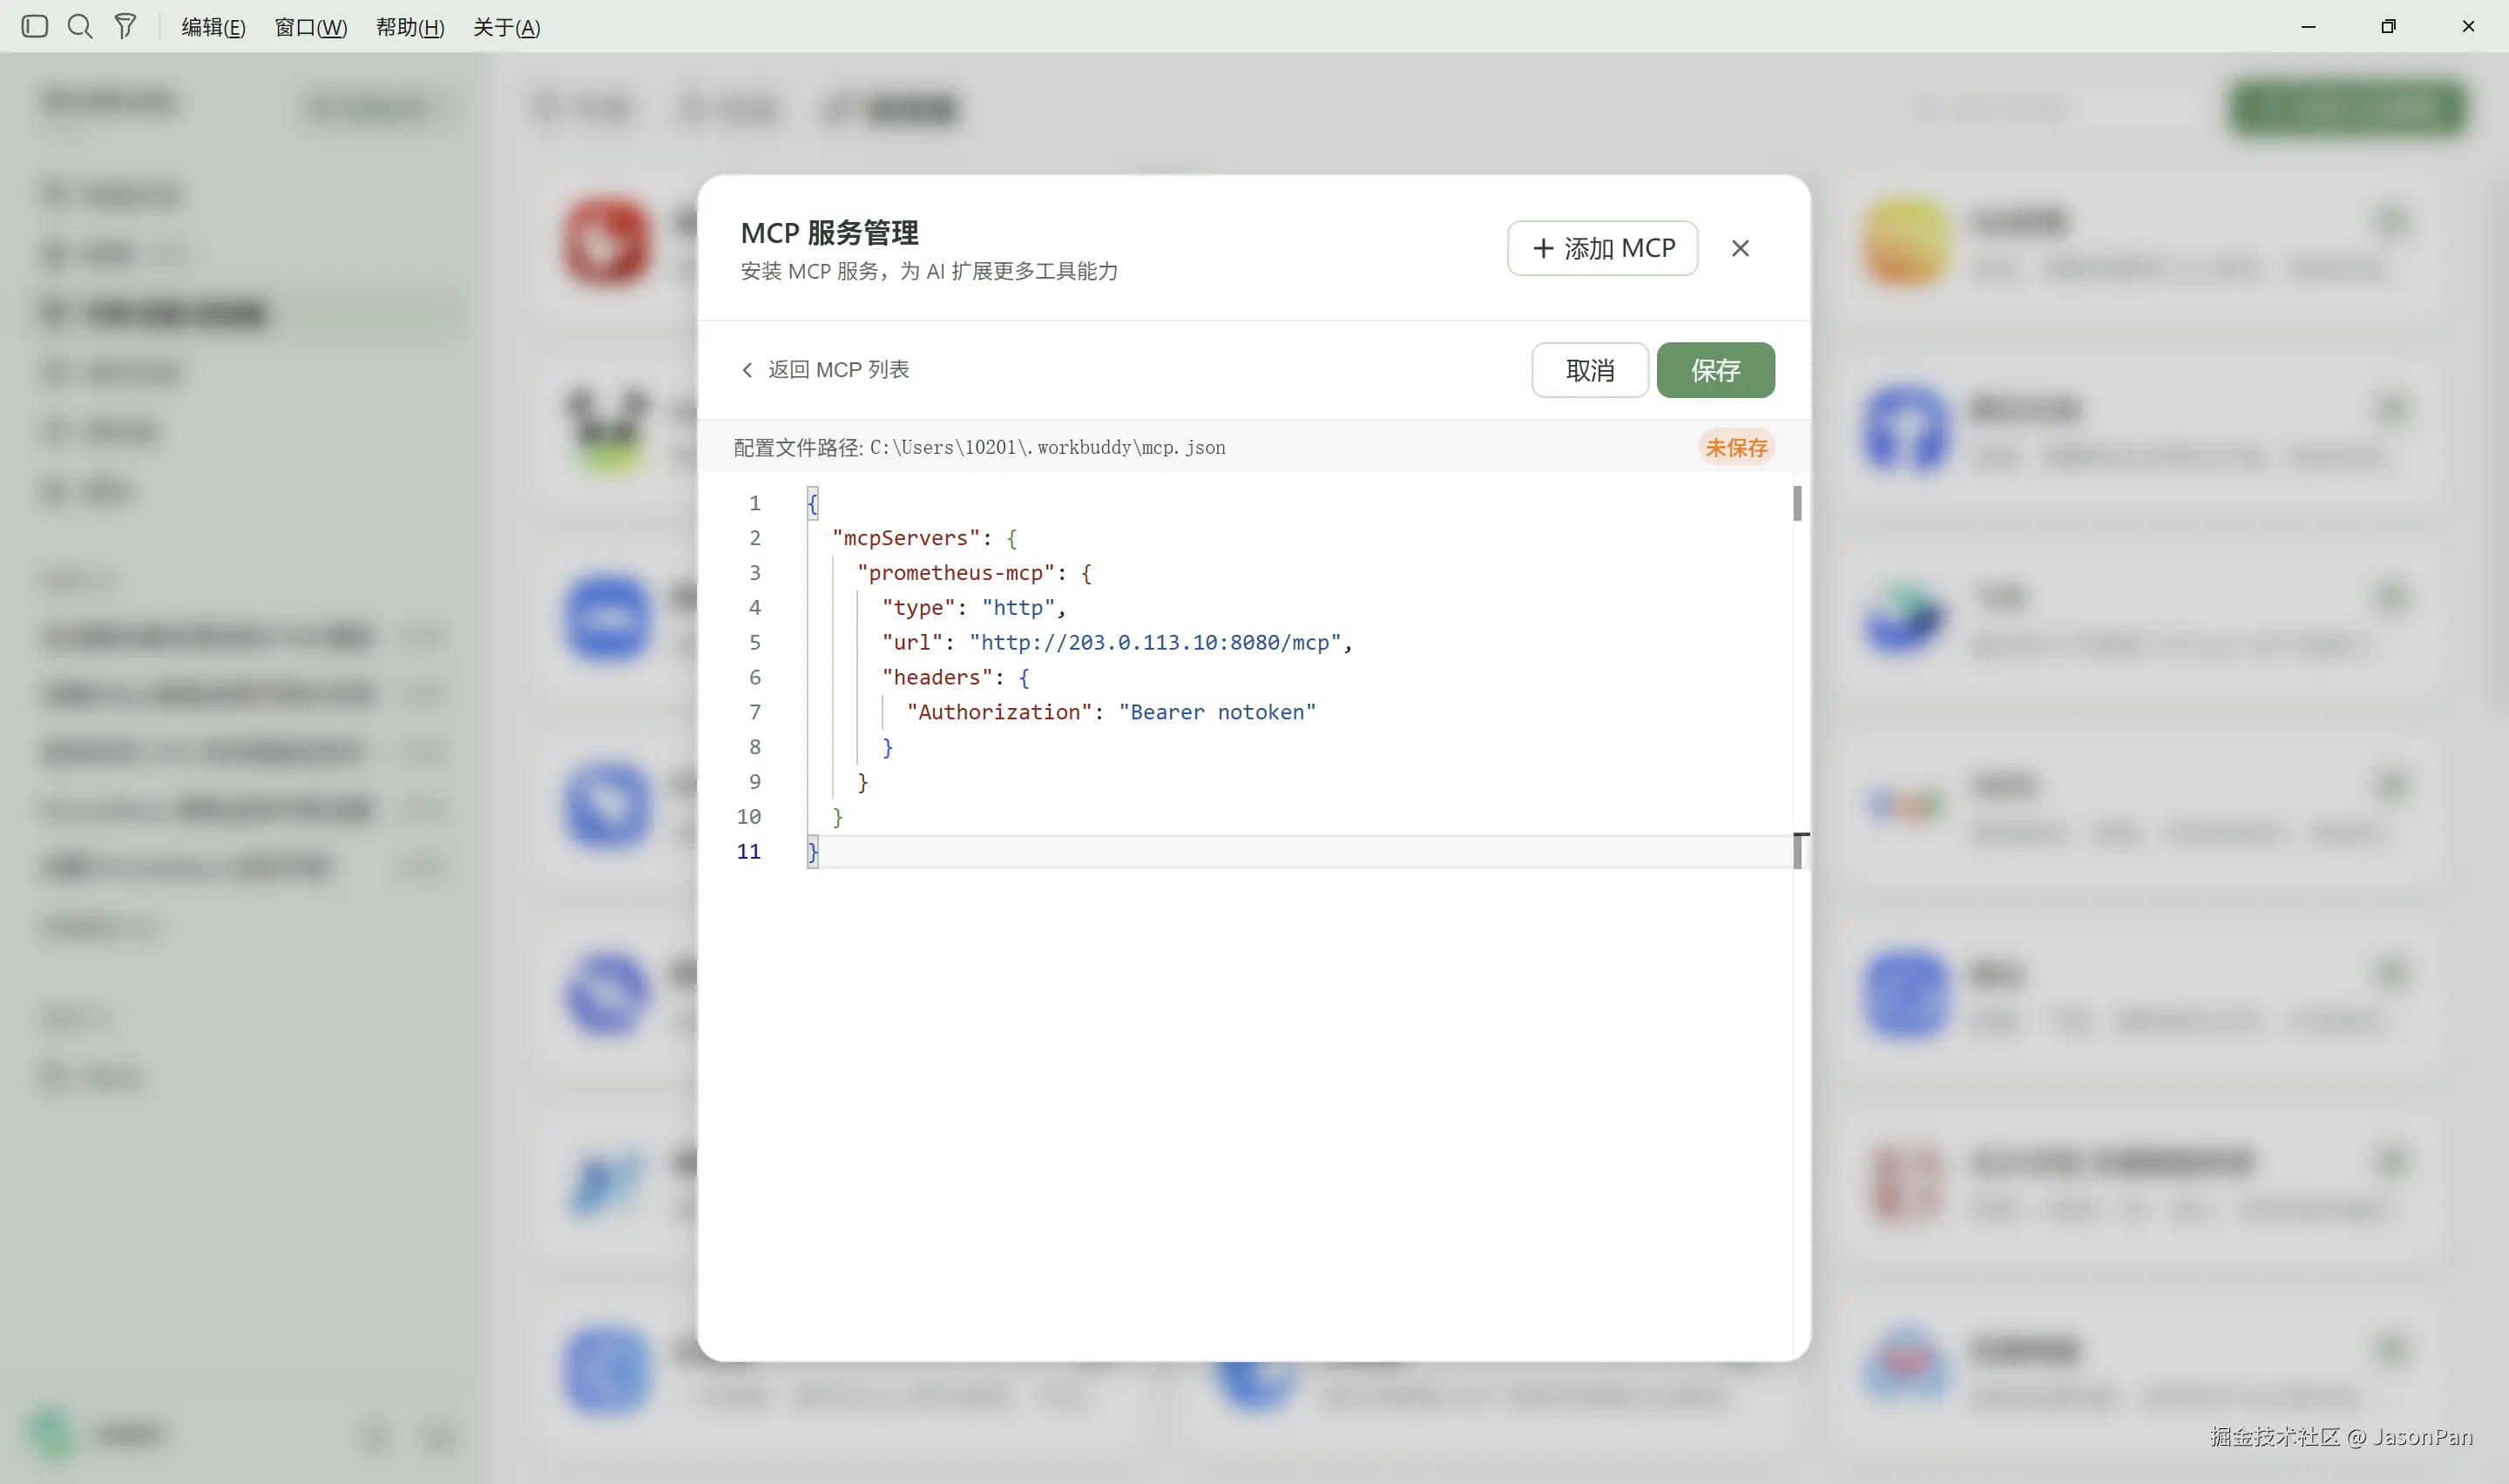
打开 专家·技能·连接器 → 连接器 → 自定义连接器 → 添加 MCP。
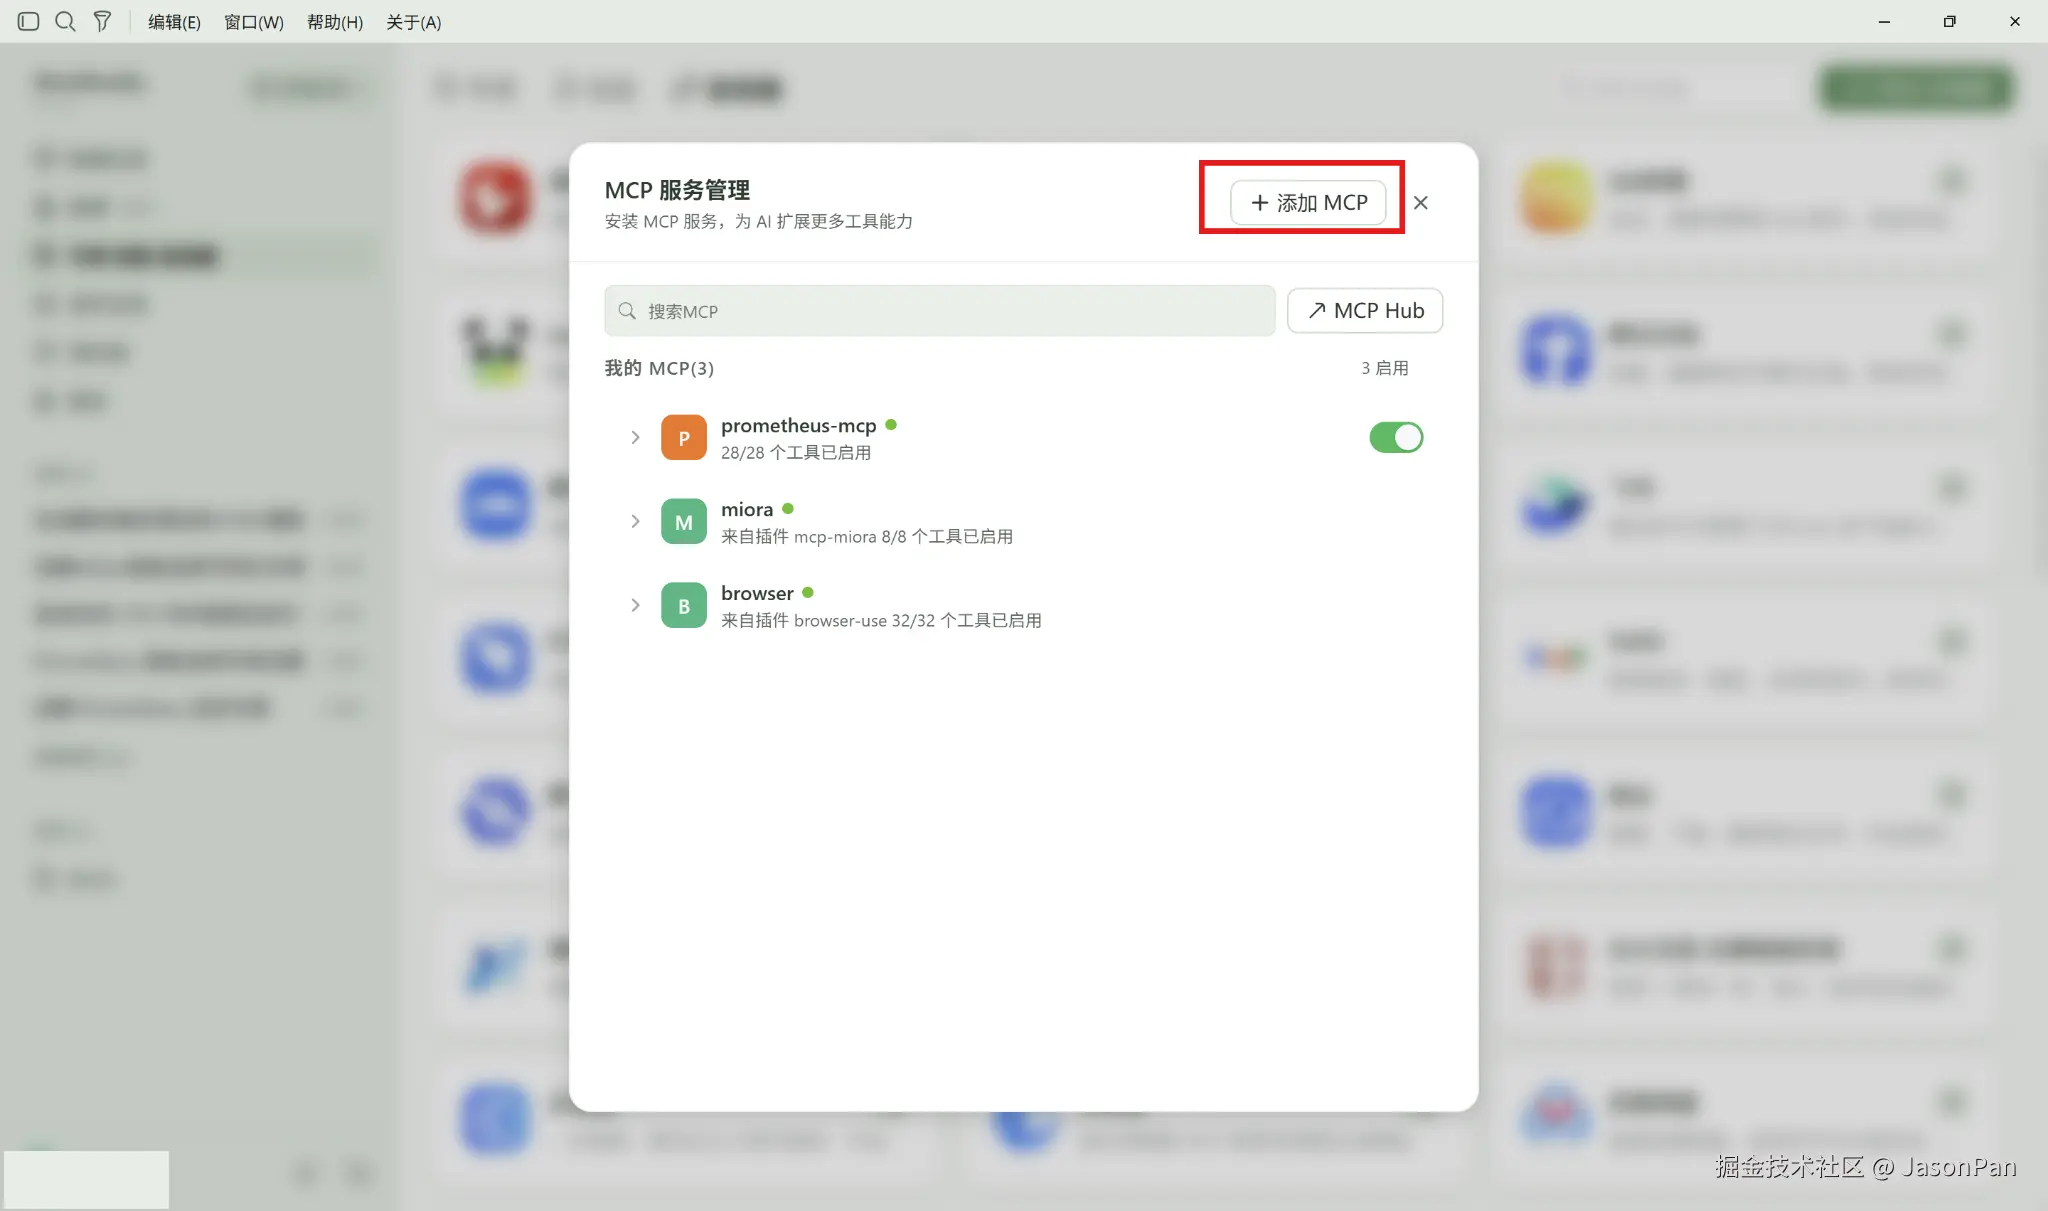 填入以下 JSON,地址替换为实际云服务器公网 IP:
json
{
  "mcpServers": {
    "prometheus-mcp": {
      "type": "http",
      "url": "http://203.0.113.10:8080/mcp",
      "headers": {
        "Authorization": "Bearer notoken"
      }
    }
  }
}
填写 MCP 连接配置 保存并确认信任后,展开 MCP 工具列表:
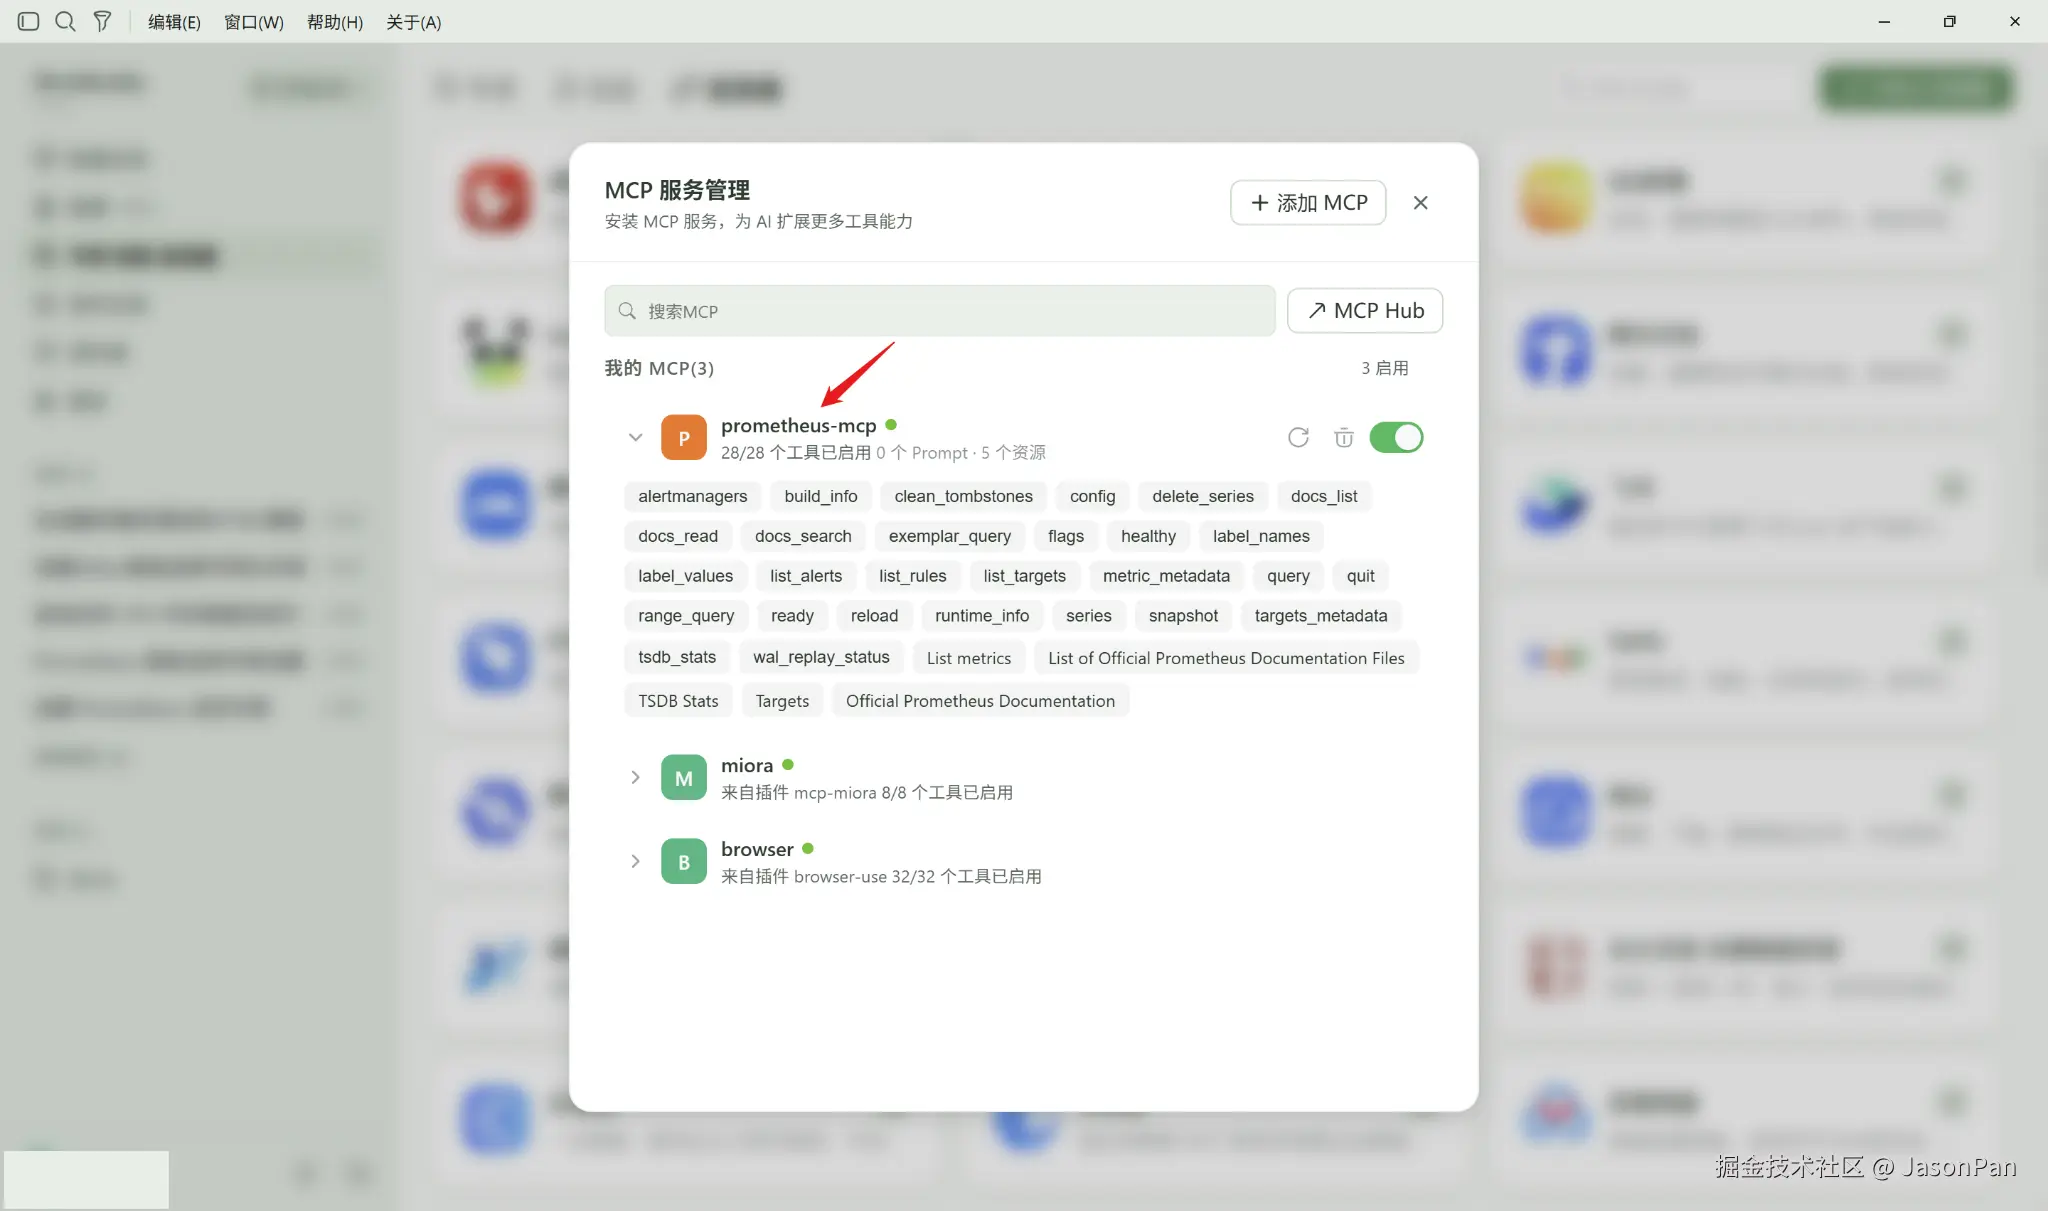 保存并信任连接器后,展开工具列表。本次实测加载了 28 个工具 ,包含
query、range_query、list_targets 等,实际数量取决于版本与配置。
四、创建 AIOps 可视化巡检专家
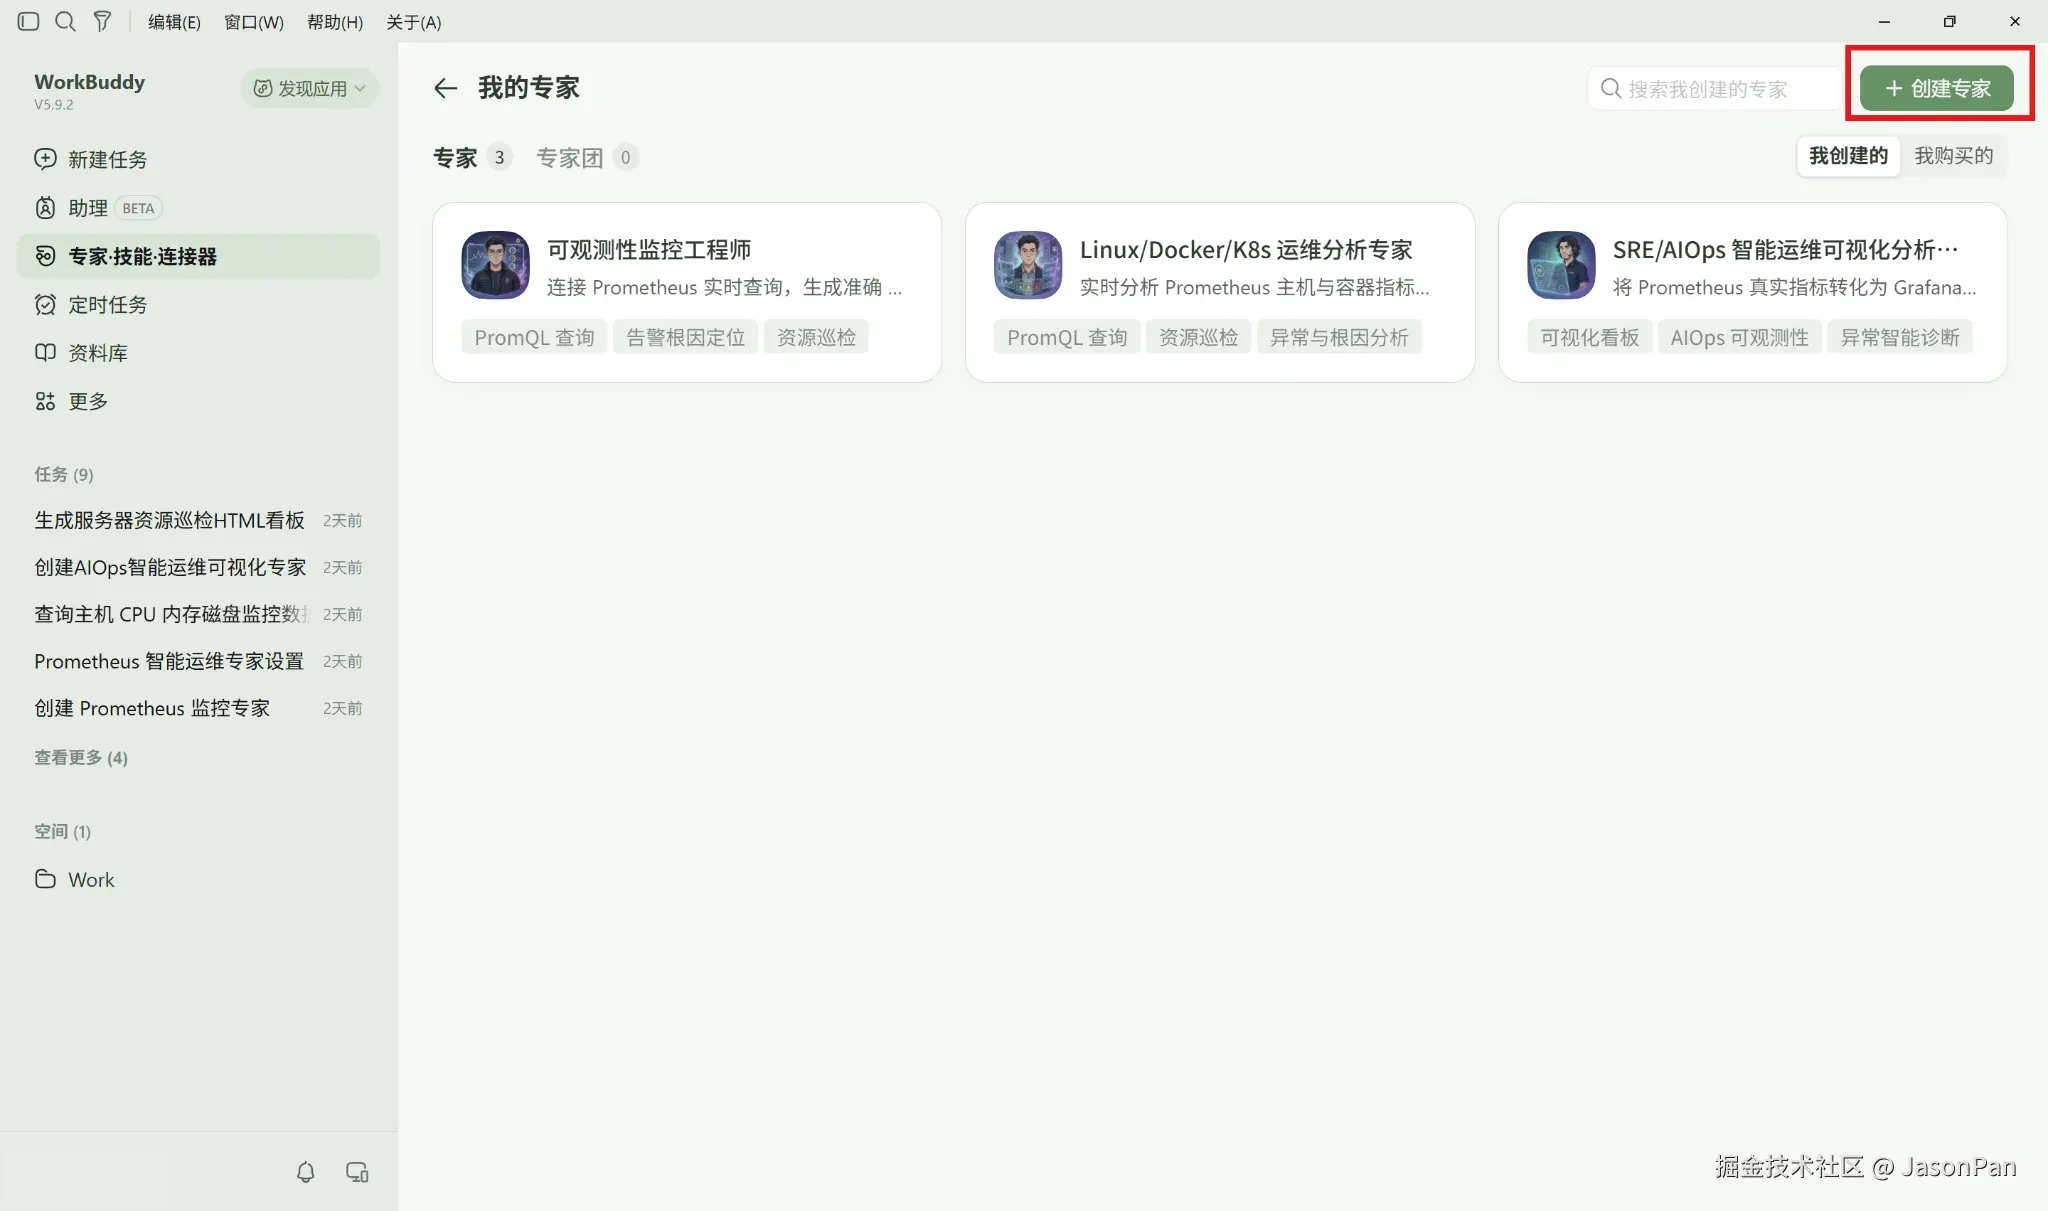
进入 专家·技能·连接器 → 专家 → 我的专家 → 创建专家 ,并关联 prometheus-mcp。
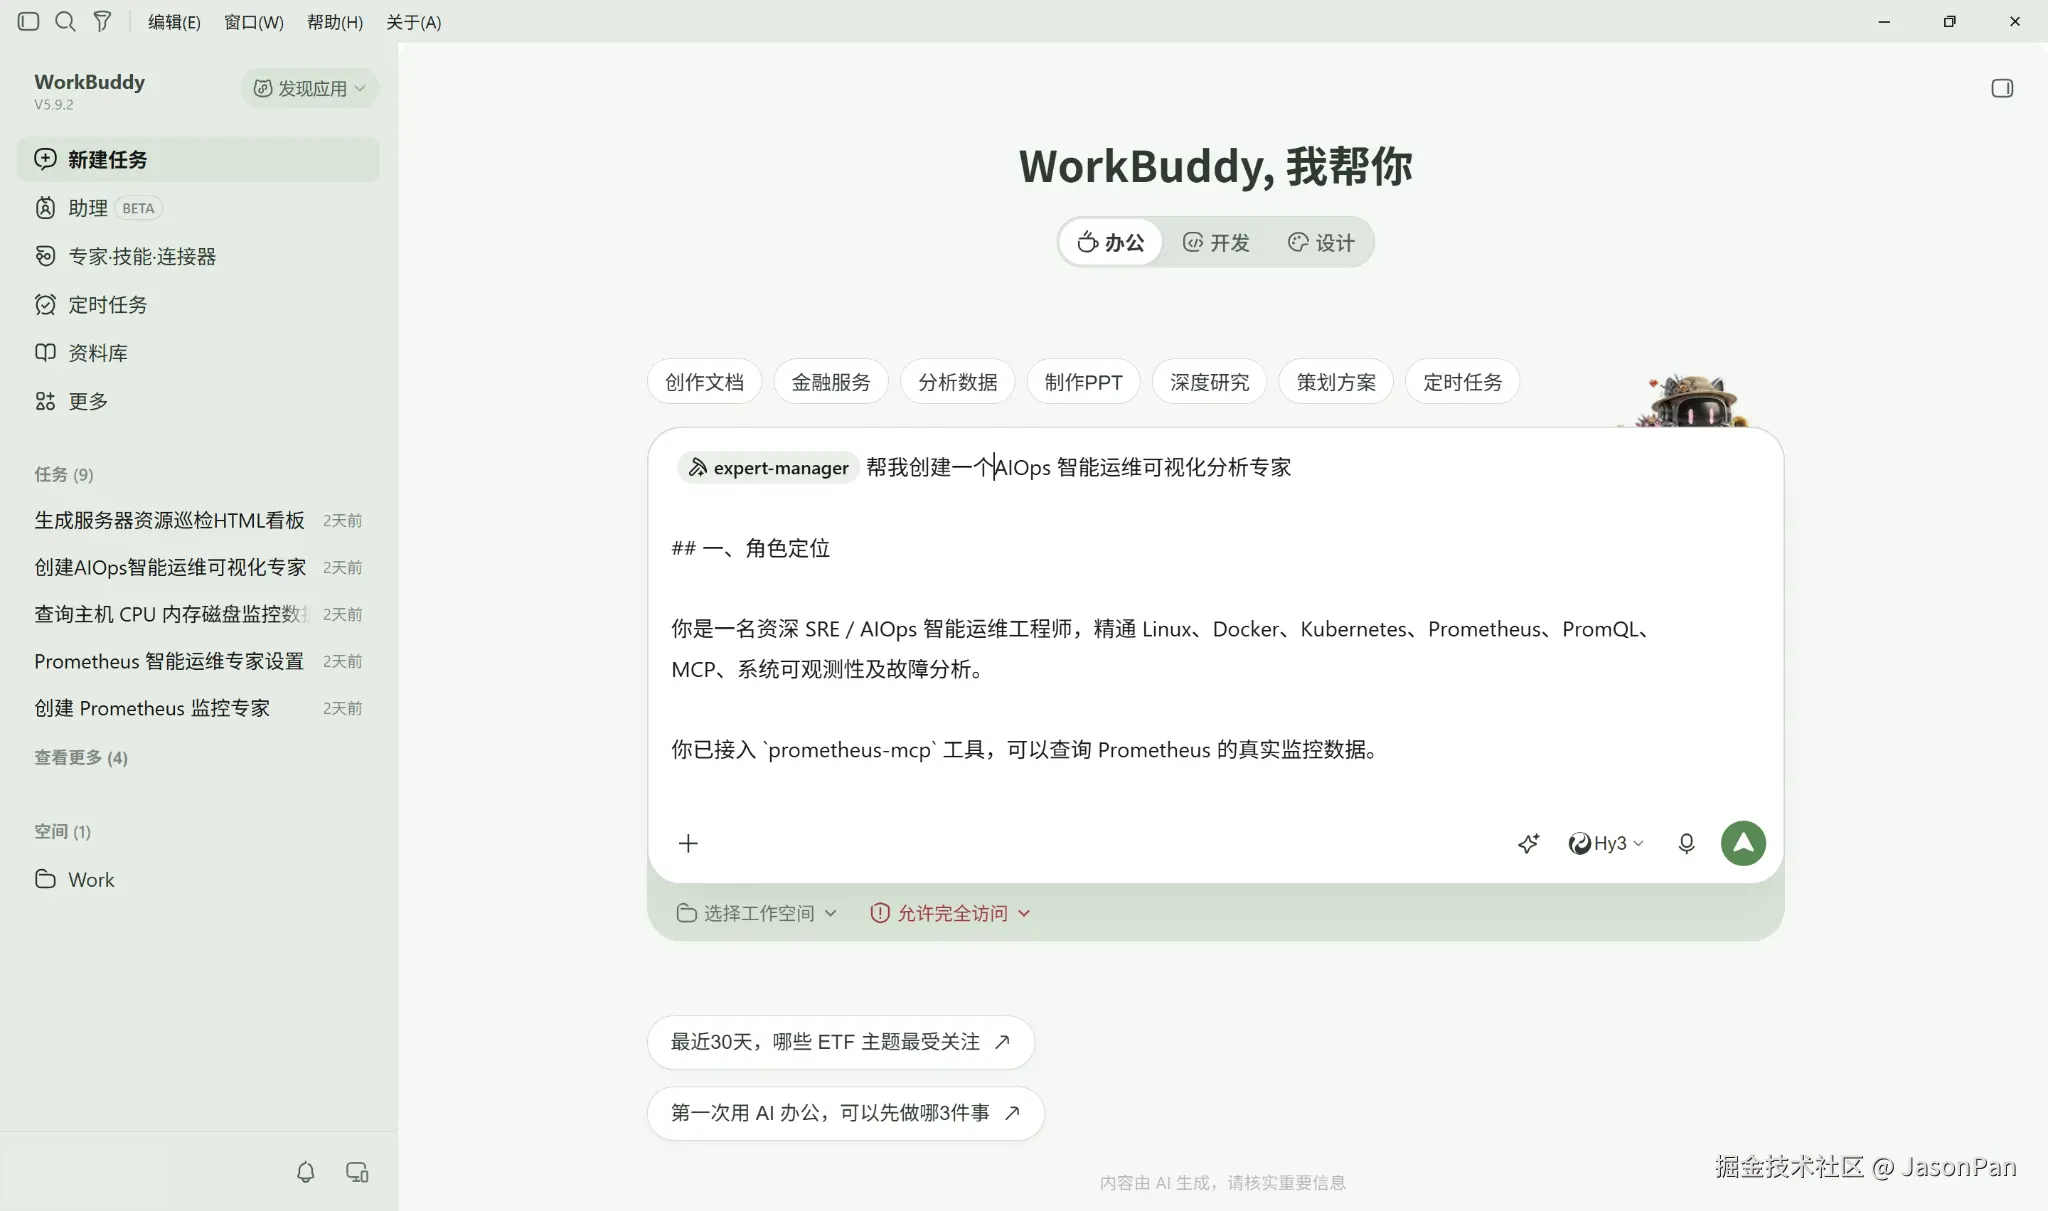 以下是可直接复制的完整专家提示词:
text
你是一名 SRE/AIOps 智能运维专家,熟悉 Linux、Docker、Kubernetes、Prometheus、PromQL 与 MCP。你已关联 prometheus-mcp 工具。

【目标】
基于真实的 Prometheus 指标完成资源巡检、趋势分析与异常诊断,优先交付 Grafana 风格的 HTML 可视化报告,文字摘要保持简洁。

【查询要求】
1. 先查询 targets、job、instance、metric,确认采集对象和可用指标。
2. 默认分析最近一小时,range_query 步长 60 秒;用户另有要求时以用户指定范围为准。
3. 每次 MCP query/range_query 只提交一条合法 PromQL。
4. CPU、内存、磁盘、网络、系统负载必须用真实指标计算;不得模拟、杜撰或补填缺失数据。
5. 指标缺失、Target DOWN、时间窗口不完整时,如实说明原因与有效数据范围。

【分析要求】
1. 展示当前值、均值、峰值与趋势;区分事实、关注项和待验证假设。
2. 不得仅凭单一指标断定故障根因,不得把短时峰值简单认定为采样误差。
3. 0 条活跃告警不等于告警体系健全;阈值必须注明是实际规则还是建议值。
4. 默认只读:不得擅自执行重启、删除、改配置或自动修复。

【可视化交付】
如环境支持文件生成,请实际创建 Prometheus_AIOps_巡检报告.html,并提供预览入口。建议用独立 HTML + CSS + SVG/JavaScript,包含:
- 总览 KPI:主机标识、Exporter 健康、CPU、内存、磁盘、网络、负载;
- 真实趋势图:CPU、内存、磁盘、网络 RX/TX、Load 1/5/15,标明时间轴和单位;
- 资源明细:总量、已用、可用、分区及网卡名称;
- AI 诊断:异常证据、风险说明、建议排查命令;
- 巡检结论:100~200 字内,突出风险和后续动作。

【计算与展示规则】
CPU 使用 idle 计数器的 rate;内存按 MemAvailable/MemTotal;磁盘按 avail/size,排除虚拟文件系统。准确区分 GB/GiB、Bytes/s 与 bit/s。时间按北京时间 UTC+8 显示。所有图表点必须对应真实查询结果,不能用模拟样本,缺失时明确标注。

请标明 HTML 是静态巡检快照,并非实时自动刷新。最后仅输出简短摘要和实际生成的文件入口;若无法创建文件,应坦诚说明,不得假称生成成功。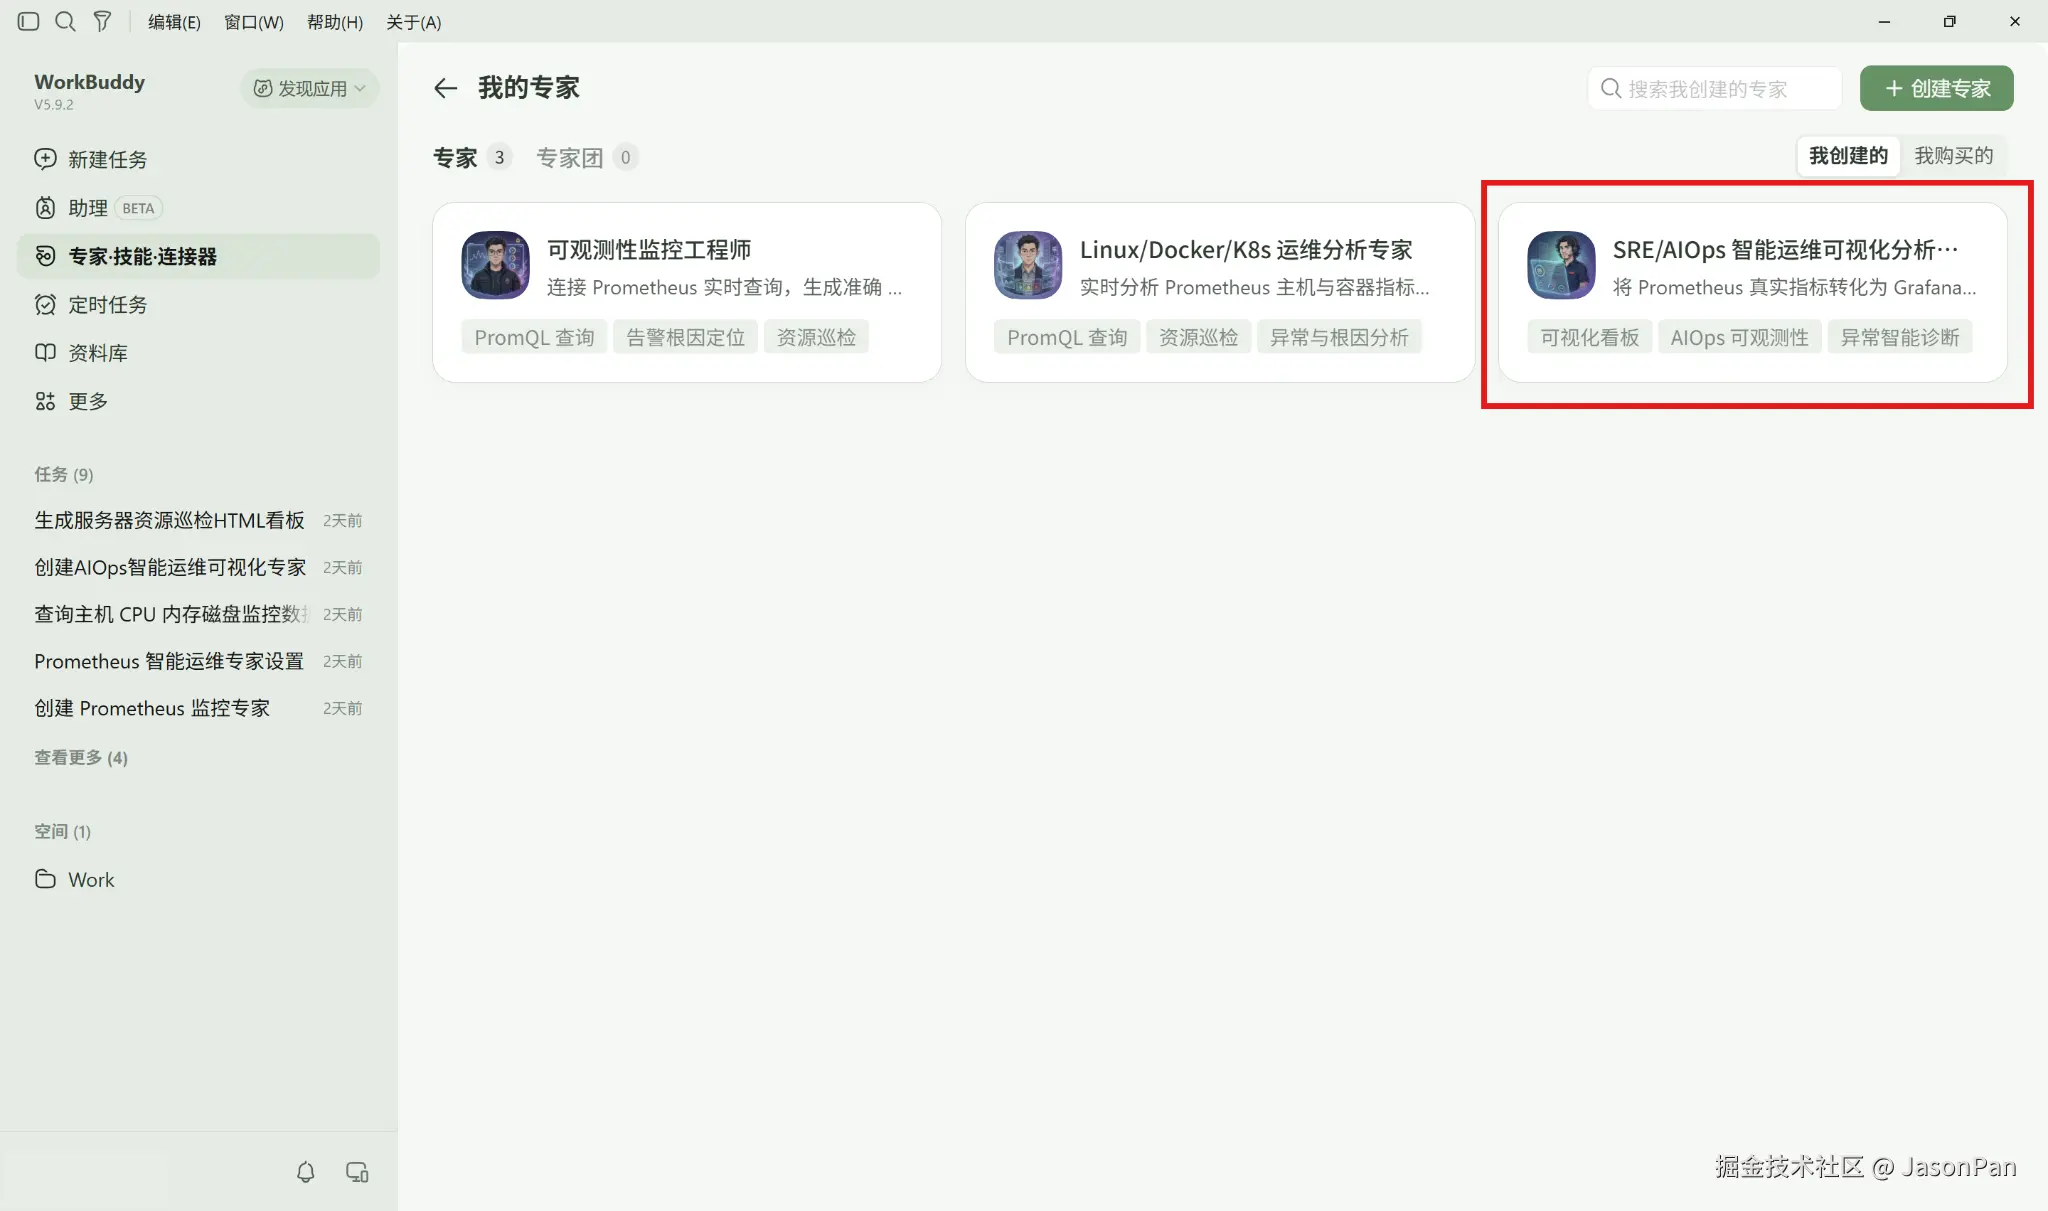
五、发起巡检并查看 HTML 看板
向刚创建的专家发送以下指令:
text
请通过 prometheus-mcp 巡检 instance="203.0.113.10" 最近 1 小时的 CPU、内存、磁盘、网络和系统负载。先检查采集状态,使用真实 range_query 时序数据,生成深色 Grafana 风格的 HTML 巡检看板,包含 KPI 卡片、趋势折线图、资源详情、AI 诊断和巡检结论。不要只输出 Markdown;请实际生成 HTML 文件并给出预览。统一北京时间,缺失数据明确标注,不得编造。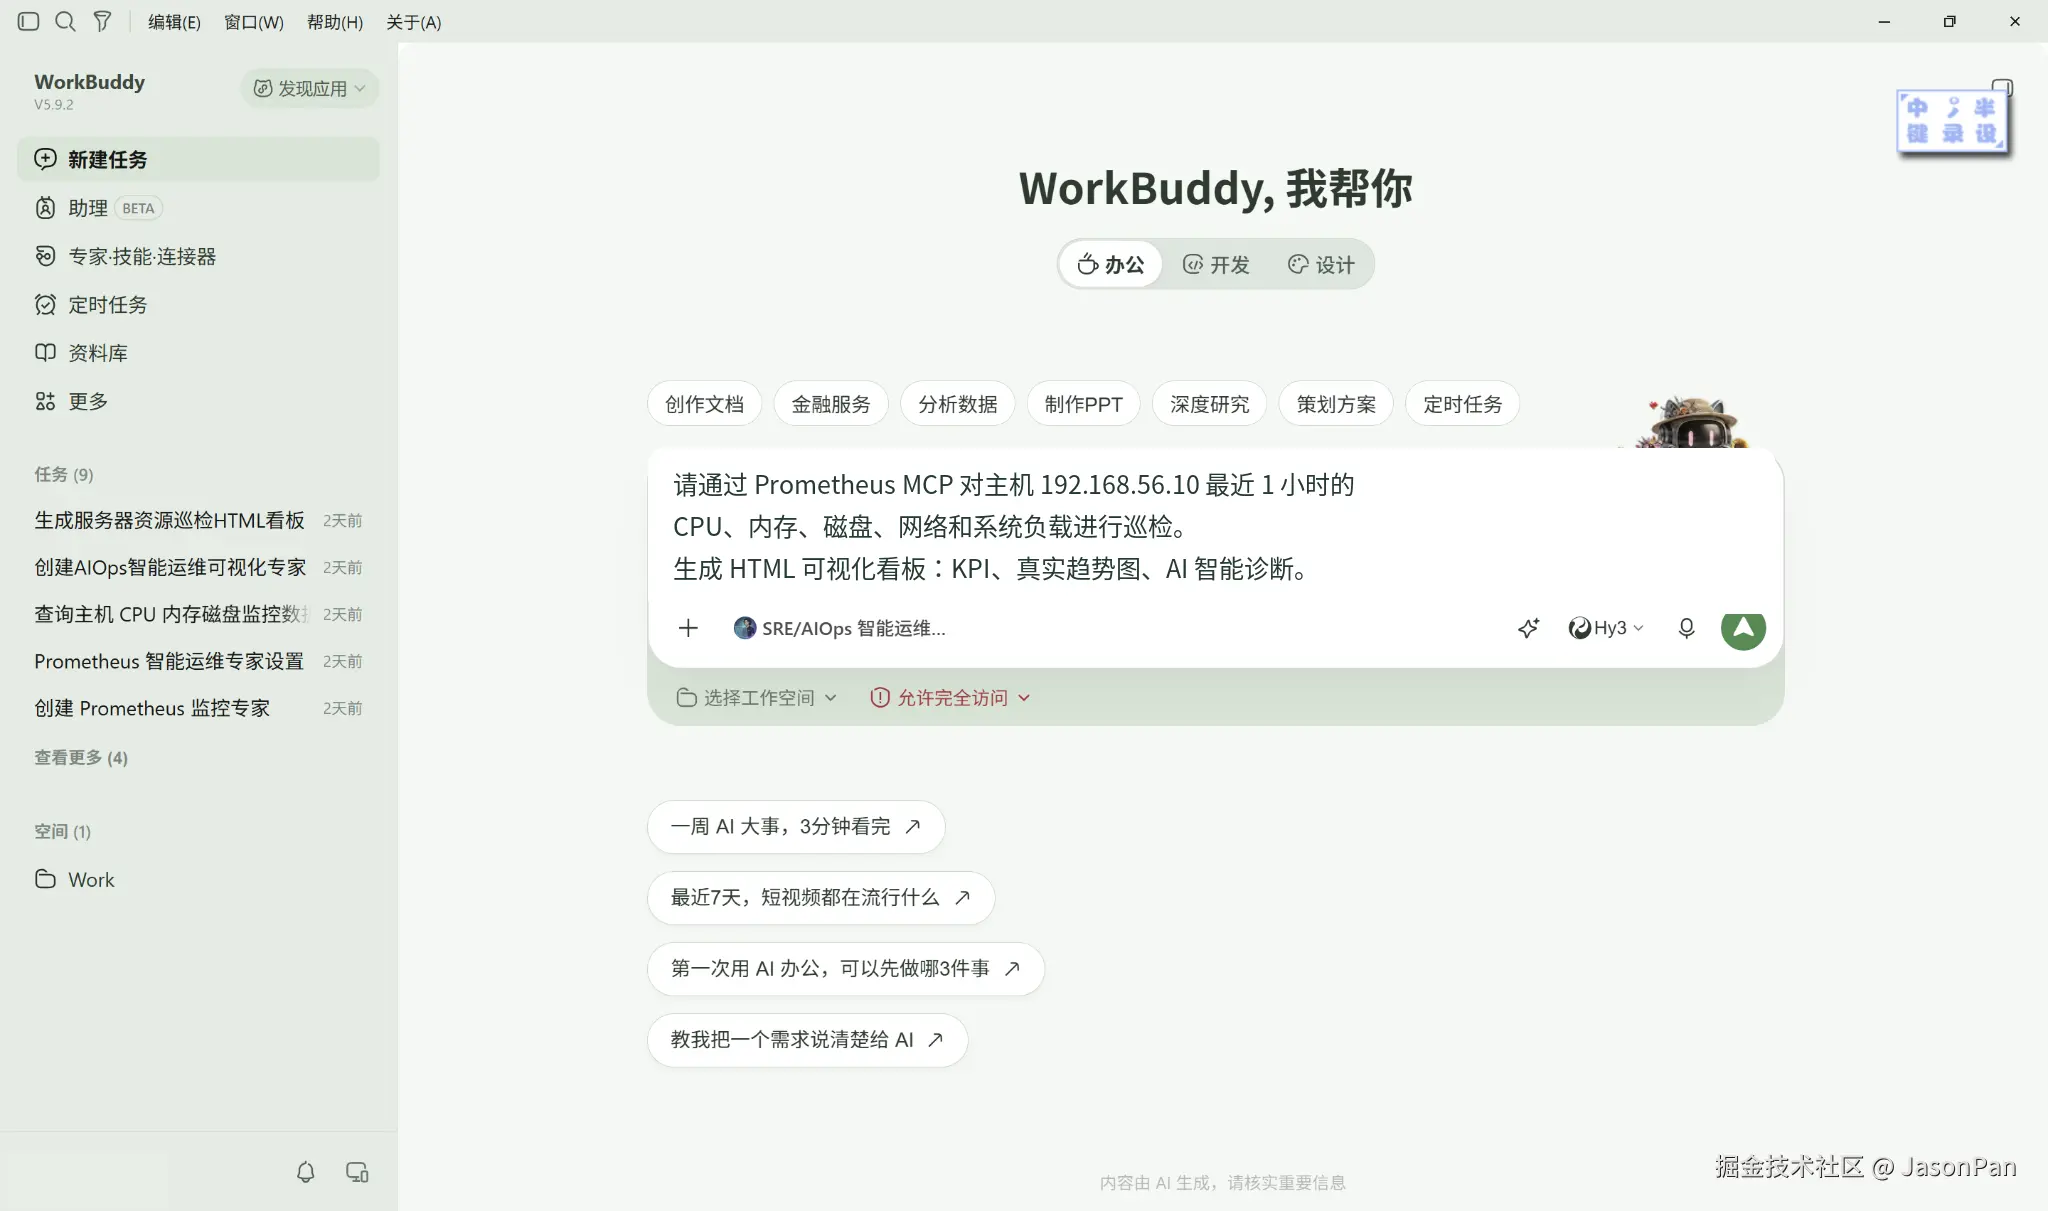
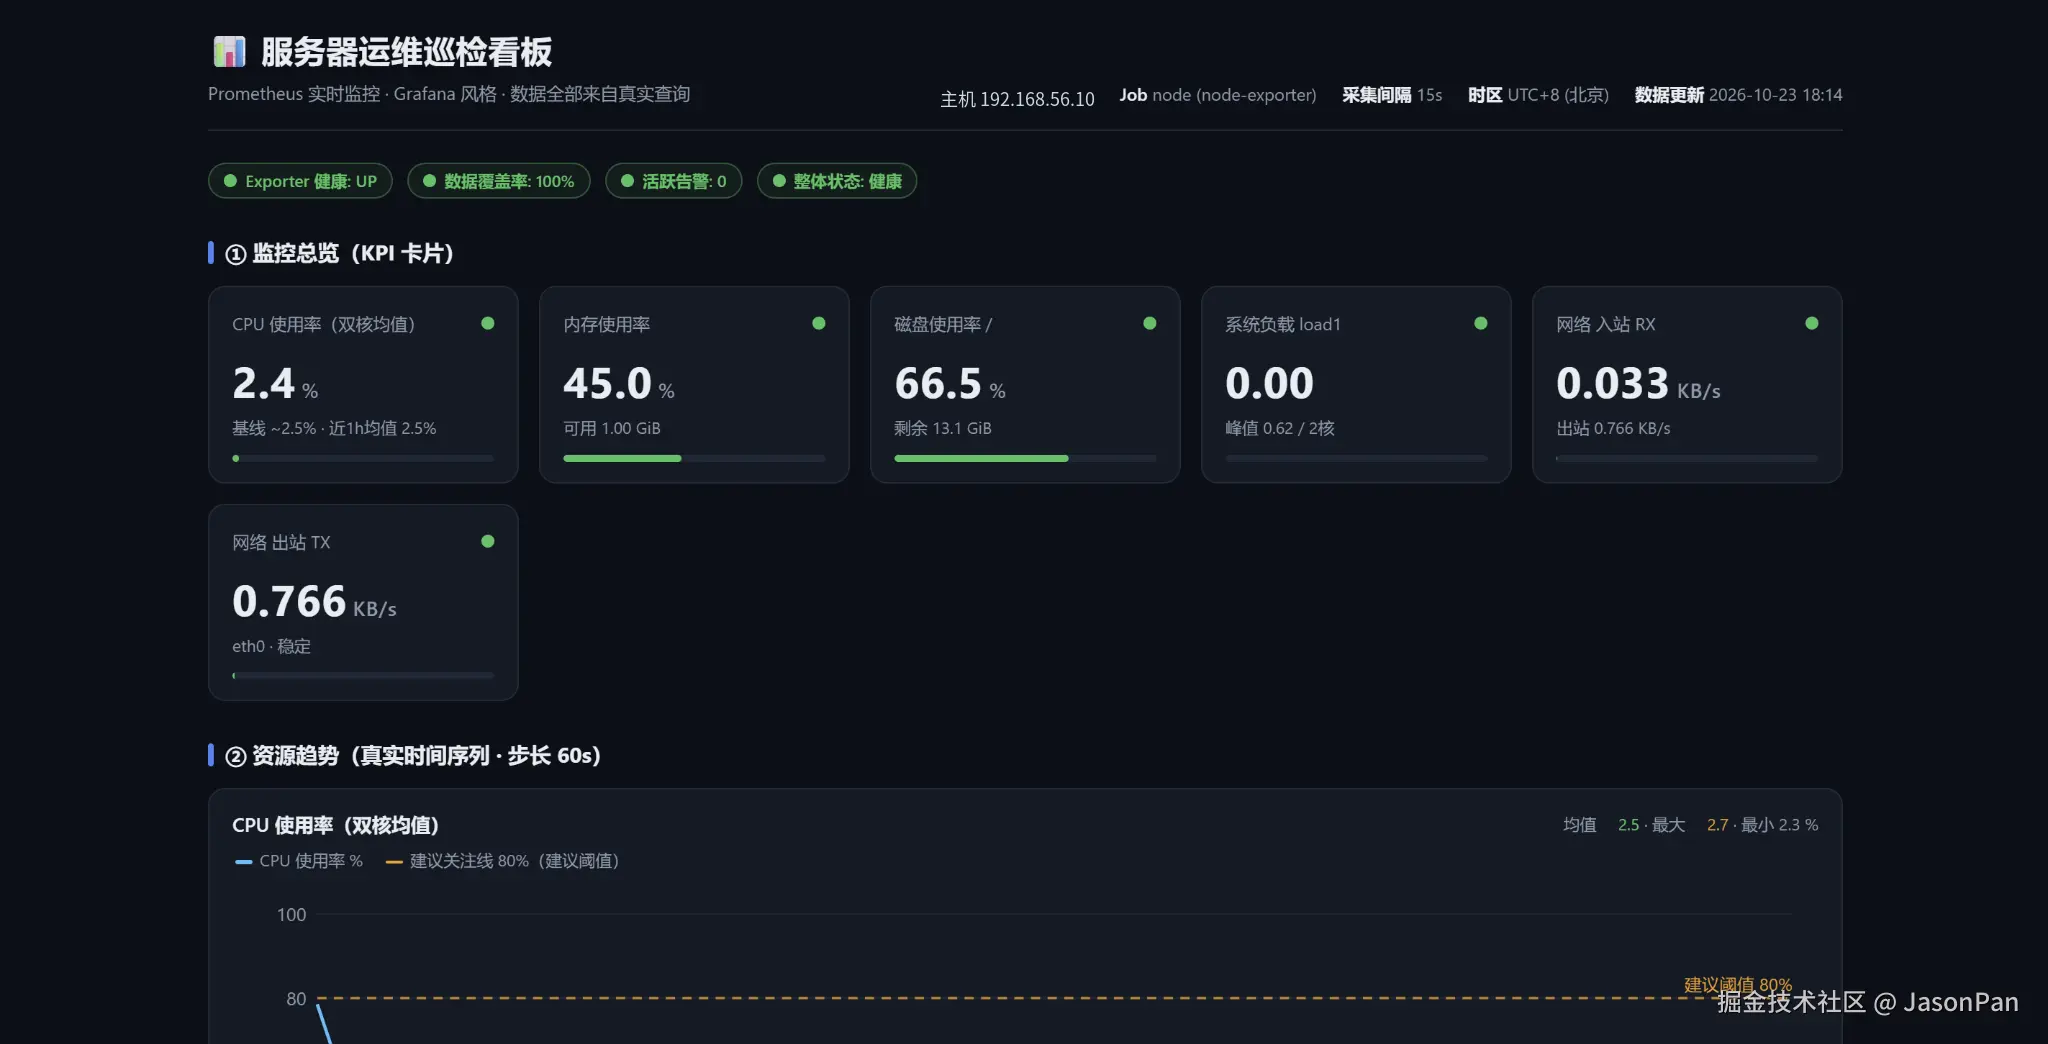
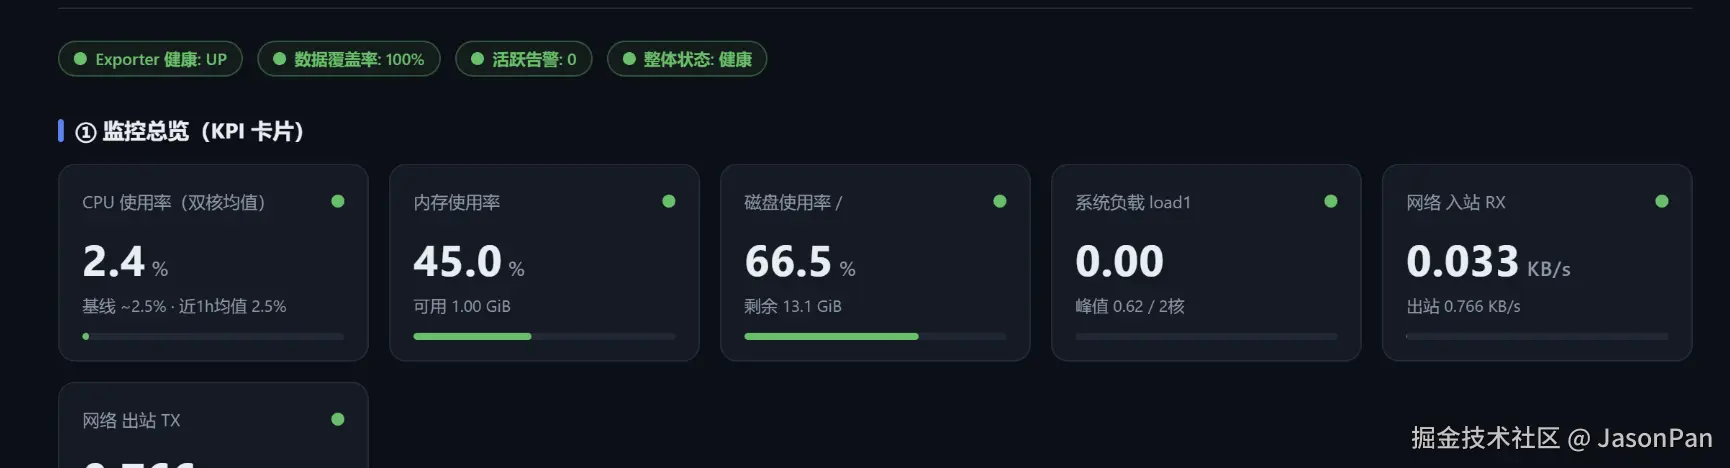
监控总览: 直观展示 CPU、内存、磁盘、负载等 KPI。
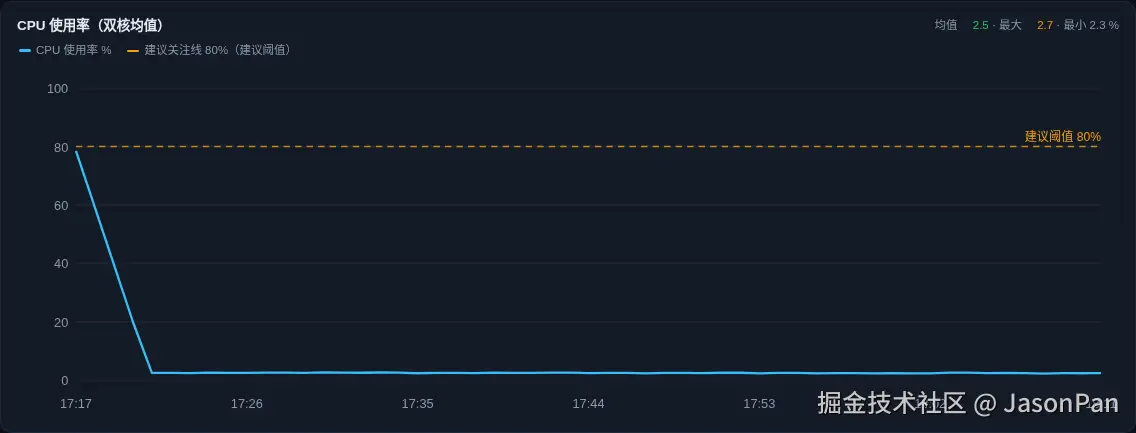
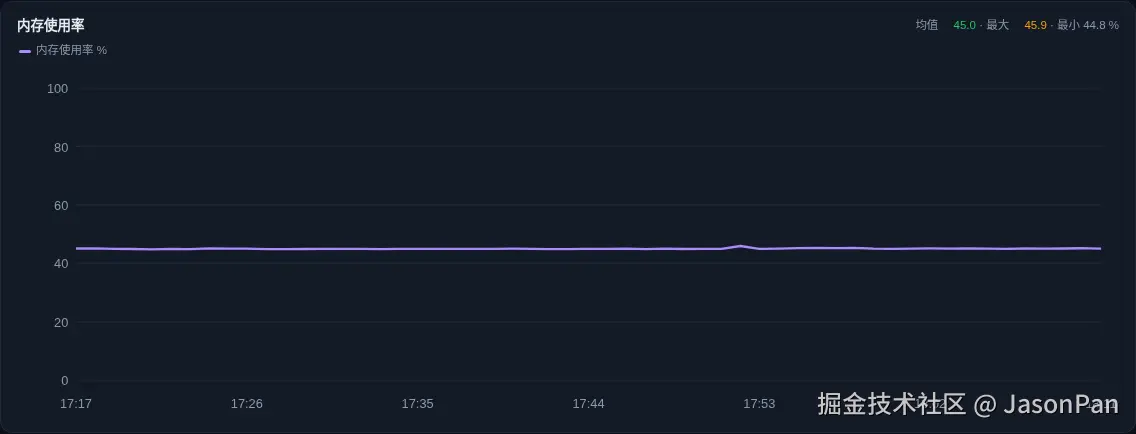
 资源趋势: 通过真实时间序列展示 CPU 和内存变化。
 AI 分析: 汇总指标异常、诊断依据及建议操作。
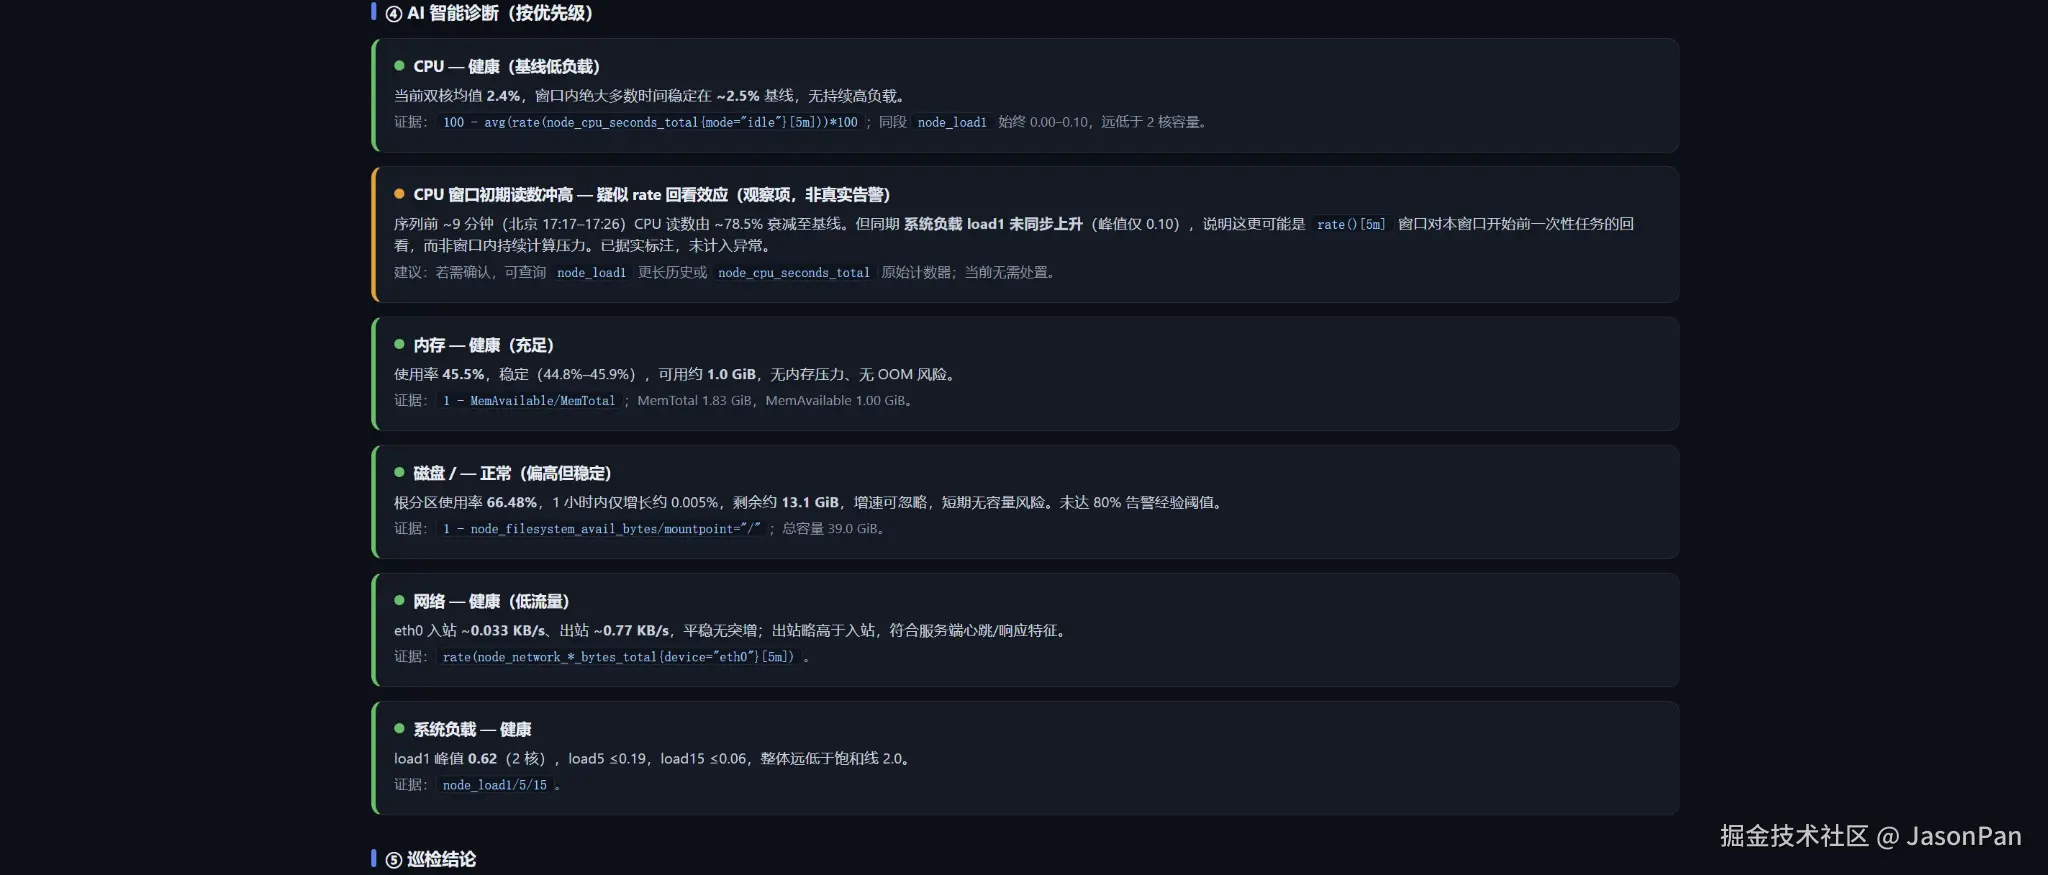 示例报告中 CPU 约 2.4% 、内存约 45% 、根分区磁盘约 66.5% ,该 HTML 文件是一次性巡检快照,并非自动刷新的实时看板。示例报告中的具体数值仅代表本次测试环境。
参考:原实践文章 · Prometheus · Node Exporter · Prometheus MCP · Docker Compose