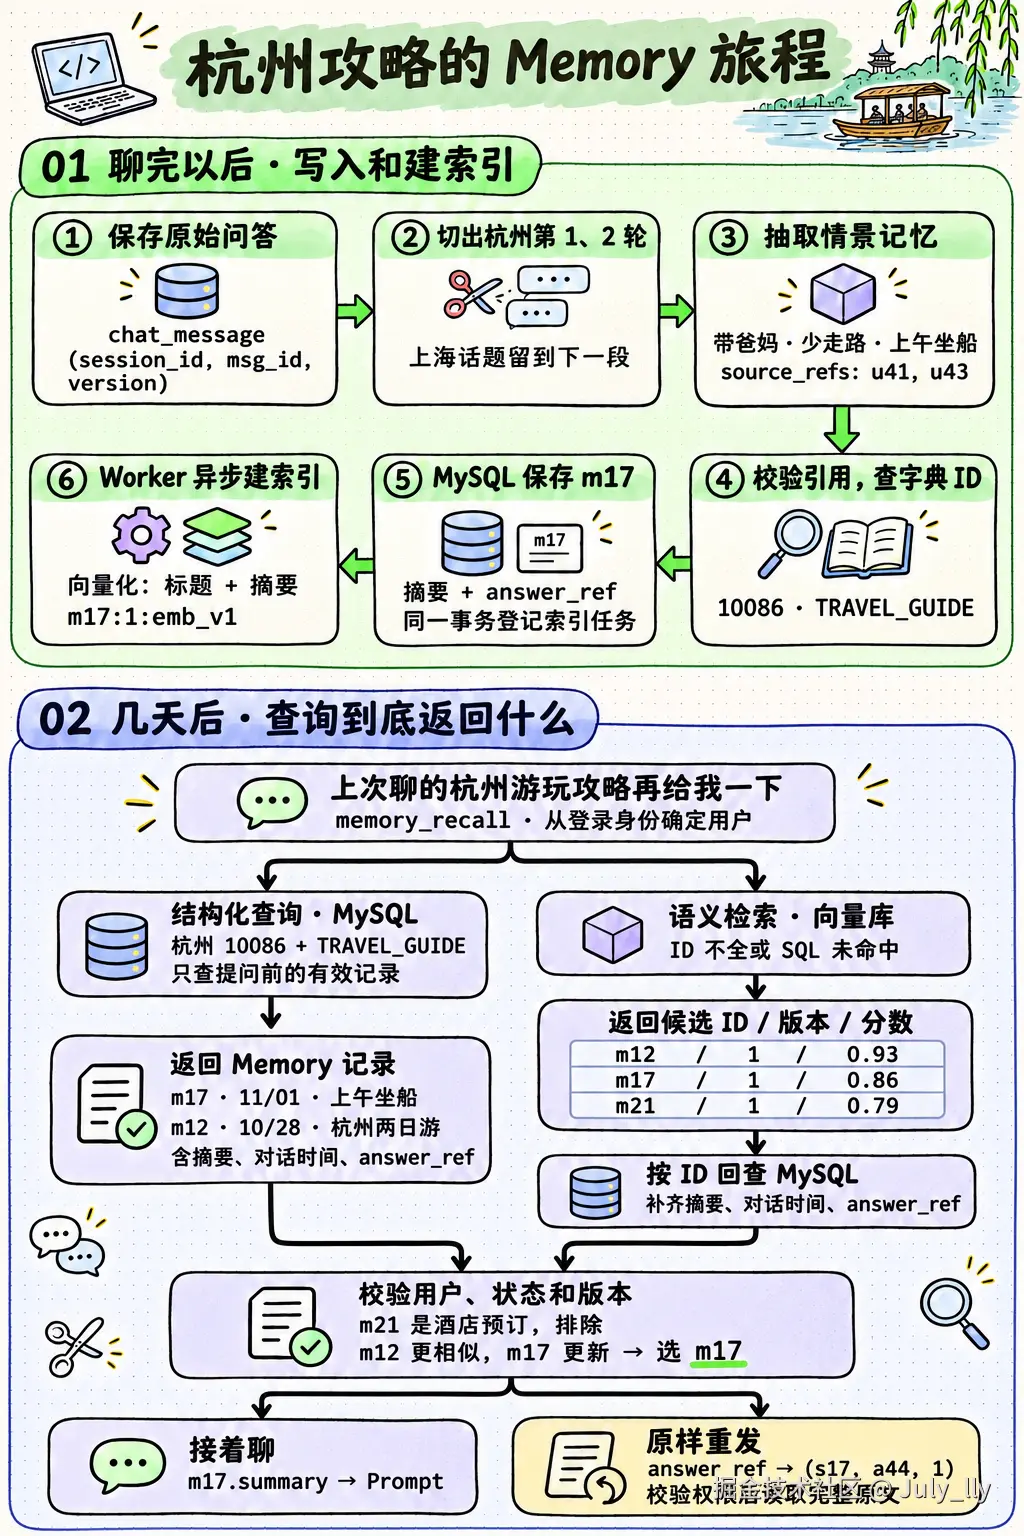
上一篇用杭州旅游攻略举例,讲了怎么用实体和主题缩小检索范围。这次还是做我们自己的个人 AI 助手,把时间拨回第一次对话结束的时候。助手已经发出一份攻略,用户紧接着改了坐船时间。几天后他说「上次那份再给我一下」,我们要找的是哪条回复? 上一篇 Memory 系统如何从 0 到 1 构建
| 轮次 | 用户 | 助手 |
|---|---|---|
| ① | 帮我做个杭州两日游攻略。这次带爸妈,别安排太多走路。 | 第一天去西湖,下午坐船。第二天去灵隐寺,午饭后回酒店休息。 |
| ② | 西湖坐船放上午吧。 | 第一天去西湖,上午坐船,下午在附近休息。第二天去灵隐寺,午饭后回酒店休息。 |
| ③ | 对了,上海虹桥到机场怎么走? | 你要去虹桥机场还是浦东机场? |
下面的表名、字段和 ID 都是为这套个人 AI 系统设计的示例。我们先把这三轮的原文存好,再看后台能从中提取出什么。
先存原文,再判断在哪里切开
Runtime 在回复完成后,把消息和一条待处理任务写进 MySQL。同一个会话里的两份攻略分别是 (s17, a42, 1) 和 (s17, a44, 1),依次是 session_id、msg_id、version。第二轮是新的追问,所以有新的 msg_id。如果用户在同一条回复上点重新生成,才复用 msg_id,把 version 往上加。
后台 Worker 领取任务,按会话读取上次切分游标之后的问答。先按授权过滤可用于记忆构建的消息,再组装按时间排列的 QA。每对 QA 带它最后一条消息的时间和序号。我们可以给模型一小段规则,让它判断前面的事有没有聊完,并从输入里选出旧话题最后一对 QA。杭州这组问答的示例输出如下。
json
{
  "should_split": true,
  "end_turn": 2,
  "title": "带爸妈去杭州两日游"
}
Worker 核对 end_turn 对应输入里的一轮,保存第①到第②轮的范围和标题,同时在同一事务里推进游标、登记抽取任务。第③轮留在下一次处理窗口。要是第 ③ 轮问的是「西湖船票在哪买」,可以返回 should_split=false,游标留在原位。用户要是聊完杭州就关了页面,我们还可以给连续未更新的会话设一个收尾任务,让最后一段也有机会入库。
这里的标题方便人看。上一篇定义的 TRAVEL_GUIDE 可以由许多条攻略共用,留给我们在检索时缩小范围。两者各有自己的字段。
给这次杭州行程留一条情景记忆
切分模型只回答「这件事聊到了哪一轮」。抽取模型接到的才是第 ① 和第 ② 轮的原文。Worker 根据分段 seg17 读消息,先过滤没有获准进入记忆的内容,再组装下面这份输入。每条消息都带编号和版本,上海那一轮根本不在这份输入里。
json
{
  "segment_id": "seg17",
  "messages": [
    {"msg_id": "u41", "version": 1, "role": "user", "text": "帮我做个杭州两日游攻略。这次带爸妈,别安排太多走路。"},
    {"msg_id": "a42", "version": 1, "role": "assistant", "text": "第一天去西湖,下午坐船。第二天去灵隐寺,午饭后回酒店休息。"},
    {"msg_id": "u43", "version": 1, "role": "user", "text": "西湖坐船放上午吧。"},
    {"msg_id": "a44", "version": 1, "role": "assistant", "text": "第一天去西湖,上午坐船,下午在附近休息。第二天去灵隐寺,午饭后回酒店休息。"}
  ]
}
给模型的指令也可以很短。只抽取这一段里有证据、下次可能用得上的事。前后有修改时,摘要保留用户最后确认的要求。每条候选都要指出依据了哪些用户消息。如果这段里有一份落实修改后的完整回复,可以再引用那条助手消息。只有一句「好,我改到上午」就不填这个引用,证据不足时可以不产出候选。
这次模型可以输出下面这条候选。这里的 JSON 是接口示意。
json
{
  "kind": "EPISODIC",
  "title": "带爸妈去杭州两日游",
  "summary": "用户计划带爸妈去杭州两日游,希望少走路,西湖坐船改到上午。",
  "entity_mentions": [{"text": "杭州", "type": "PLACE"}],
  "topic_hint": "旅游攻略",
  "source_refs": [{"msg_id": "u41", "version": 1}, {"msg_id": "u43", "version": 1}],
  "answer_candidate_ref": {"msg_id": "a44", "version": 1}
}
u41 支撑「带爸妈」「少走路」,u43 支撑「船放上午」。a44 的用途是找回当时给出的完整攻略。这里「少走路」只挂在这次行程下,不会上升成用户以后每次出游的偏好。
Worker 先校验输出结构,再用本次输入的消息清单核对每个引用的角色和版本。如果候选引用了一条不在清单里的消息,这条候选就不能直接入库。接着用上一篇的字典把「杭州」查成 10086,把「旅游攻略」查成 TRAVEL_GUIDE。没把握的 ID 留空,后面仍然可以用摘要做语义召回。最后由服务分配 memory_id=m17,从已校验的分段拿到 user_id 和 session_id,用杭州段最后一条消息 a44 的时间填 occurred_at。重跑任务的时间不参与这次行程的排序。
MySQL 存原文和正式记忆,向量库接上
MySQL 这边先做四张表。为了把流程讲清楚,memory只保存每条记忆的当前版本。原始消息按版本保留,才能准确回读某一版回复。
| 表 | 主键与主要字段 | 杭州这条怎么填 |
|---|---|---|
chat_message |
主键 (session_id, msg_id, version),另存 user_id、turn_no、role、content、created_at、visible_state |
(s17, a44, 1) 属于第 ② 轮,content 是上午坐船的完整攻略 |
conversation_segment |
主键 segment_id,另存 user_id、session_id、start_turn、end_turn、end_at |
seg17 属于 s17,覆盖第 ① 到第 ② 轮 |
memory |
主键 memory_id,另存 user_id、version、segment_id、kind、entity_id、topic_id、occurred_at、title、summary、source_refs、answer_ref、status |
m17 的 version=1,证据指向 u41 和 u43,完整回复指向 (s17, a44, 1) |
memory_index_job |
主键 (memory_id, memory_version, embedding_version),另存 status、attempts、next_retry_at |
(m17, 1, emb_v1) 等待后台写入向量库 |
memory.version 标记摘要和引用这一套记录的版本。answer_ref.version 标记原消息的版本。举个例子,我们发现摘要漏了「少走路」,可以把 Memory 升到第 2 版,answer_ref 仍然指向原来的 (s17, a44, 1)。
写入 memory 时,在同一个 MySQL 事务里登记索引任务。这版每段每种类型只产出一条记忆,可以用 (segment_id, kind) 做唯一键。初次抽取重试时复用已有的 Memory,这样同一个杭州段不会凭空变成两次旅行。建索引的 Worker 先确认任务的 memory_version 还是当前版本,再取 title + summary 生成 embedding。这条向量的输入就是「带爸妈去杭州两日游。用户计划带爸妈去杭州两日游,希望少走路,西湖坐船改到上午。」向量库只需要这一行。
| 向量库字段 | m17 对应值 |
用途 |
|---|---|---|
vector_id |
m17:1:emb_v1 |
同一任务重试时覆盖同一个键 |
embedding |
title + summary 生成的浮点数组 |
和查询向量算相似度 |
user_id |
user_7 |
召回前限定当前用户 |
memory_id、memory_version |
m17、1 |
批量回查 MySQL 并排除过期向量 |
embedding_version |
emb_v1 |
查询和入库使用同一版 embedding 配置 |
向量命中后先回 MySQL,answer_ref 和攻略正文都留在那里。即使建索引任务失败,按实体和主题的 SQL 查询还是能找到 m17。只走语义检索时,如果索引还有积压,未命中只代表这次没从已建索引里搜到,不能断言用户从没聊过。旧向量也可以异步清理,查询时先通过 MySQL 排除已删除的记录和已过期的版本。
几天后找回改到上午的版本
能拿到两个 ID,先走 MySQL
用户在新会话里问「上次聊的杭州游玩攻略再给我一下」。Runtime 把整句话交给 memory_recall。查询归属从已验证的登录身份拿,提问时间取服务收到这轮消息的时间。解析器负责标出地点、主题、时间意图和返回方式,真实的归属、ID 和时间边界由服务补齐。
比如「杭州」和「游玩攻略」分别命中字典里的别名(上篇讲了)。经过授权和归一化后,服务内部拿到的是下面这份查询计划。
json
{
  "user_id": "user_7",
  "entity_id": 10086,
  "topic_id": "TRAVEL_GUIDE",
  "time_intent": "PREVIOUS_RELATED",
  "before": "2026-11-05T09:00:00+08:00",
  "delivery_mode": "ORIGINAL"
}
服务把「上次」转成 occurred_at < before,再按 occurred_at 倒序,把最近的一次放前面。这次没有「带爸妈那份」之类的附加条件,所以「属于该用户、同一实体和主题、发生在提问之前」已经足够限定候选。我们可以这样查。
sql
SELECT memory_id, version, occurred_at, summary, answer_ref
FROM memory
WHERE user_id = :authenticated_user_id
  AND entity_id = 10086
  AND topic_id = 'TRAVEL_GUIDE'
  AND status = 'ACTIVE'
  AND occurred_at < :before
ORDER BY occurred_at DESC, memory_id DESC
LIMIT 5;只是这次的候选上限,排序靠的是那次对话结束的时间,memory_id 只用来稳定处理同一时间的记录。如果用户特意说「上次带爸妈那份」,还要判断候选是否满足「带爸妈」,不能把 SQL 的第一条直接当答案。
ID 没解析全,再用向量找候选
如果用户只说「之前排的那个两日游」,我们就没有可靠的地点 ID。服务可以用「两日游行程」生成查询向量,把「之前」单独留给时间过滤。即使两个 ID 都拿到了,SQL 查不到时也可以补一次向量检索,因为老记录可能缺少结构化标签。向量库可以像 Milvus 的过滤搜索 那样,先按当前用户和 embedding_version 限定搜索范围,再取一批语义相近的 (memory_id, memory_version, score)。如果已经确认用户问的是杭州,就保留这个条件,回查 MySQL 时排除有明确地点却和杭州冲突的结果。
接下来用 user_id 和候选 ID 批量查回 MySQL。先滤掉不可见、已删除、版本对不上或发生在提问时及之后的记录。再看摘要能不能回答用户要找的事。比如问的是游玩攻略,只有住宿订单就淘汰。词面判断不够时,可以把少量候选的标题、摘要和原问题交给重排模型,只让它判断是否相关。举个例子,如果「游玩攻略」的别名还没配好,语义召回后可能看到下面三条。相似度仅用于示意。
| 候选 | 对话时间 | 向量相似度 | 如何处理 |
|---|---|---|---|
m12 · 杭州两日游攻略 |
10 月 28 日 | 0.93 | 相关,先保留 |
m17 · 带爸妈去杭州两日游 |
11 月 1 日 | 0.86 | 相关,比 m12 更新 |
m21 · 杭州酒店预订 |
11 月 3 日 | 0.79 | 更晚,但不符合找攻略的目的 |
m12 的向量分数更高,最终还是选 m17。分数帮我们找候选,该选哪次看的是相关记录的对话时间。相关性门槛要用我们自己的历史问法和误召回样例来定,表里的 0.86 不能拿来当通用阈值。如果只说「那个两日游」,又搜到了杭州和苏州两份都说得通的行程,就先问用户指的是哪个城市。向量 Top K 也可能漏掉更新的那次,所以只走这条路径时,「最近」是指通过校验的候选里最近的一条。
找到的是 m17,发回的是 a44
如果用户想接着聊,Runtime 可以把 m17.summary 放进 Prompt。如果要原样重发,服务就用 answer_ref 验证原会话的访问权限和这版消息的可见状态,再按 (s17, a44, 1) 读 chat_message.content,直接交给界面展示。这样拿到的是改完的上午船班安排,连摘要省略的「午饭后回酒店休息」也能一起回来。找到了 Memory 但原文不可见时,可以返回 SOURCE_UNAVAILABLE。只有摘要仍然获准使用时,界面才可以另外展示摘要。
下面这张图对应本文的用户 memory 系统设计。