北漂 13 年,我把 Java 家底钉成了这张知识图谱(全站免费)
在北京漂了 13 年+,头发少了,代码多了。 唯一没变的,是每次
mvn clean install跑出 BUILD SUCCESS 那一下的踏实感。
后台被问爆的,永远是这三个问题:
- 算法刷了几百道,换个场景还是懵,到底该怎么刷?
- AI 来势汹汹,Java 工程师会不会被淘汰,该从哪下手?
- 下周就要面试,有没有能快速提分、不背八股的干货?
我一条一条回私信,回到后来反应过来一件事:我一直在重复输出同一批内容。 与其一遍遍发给不同的人,不如把这些年的沉淀,全部钉在一个地方。
所以有了这篇。它不是一篇推送,是一张地图。
先把话说在前头:这一页里的全部内容,永久免费。 不卖课、不拉群、没有付费墙,没有"加群领资料",没有"99 元解锁完整版"。你收藏这一篇,等于把我 13 年踩过的坑都揣进了兜里。
一、先说说我是谁(30 秒)
我不是什么站在神坛上的大佬,只是一个毕业就扎进北京、至今还在一线写代码、做 Code Review 的 Java 老兵。
- 13 年+ Java 全栈研发,从业务 CRUD 一路打怪升级到架构设计
- 9 年互金实战:写过支付核心,一分钱对不上,凌晨三点爬起来对账
- 5 年大数据:Java + Spark 跑通 T 级数据
- 3 年架构师:拆系统、定规范、带团队填坑,痛并快乐着
这个号从第一天起就定了三条铁律:不装大佬、不贩卖焦虑、不搞付费八股。
我只想把啃过的源码、踩过的线上坑,用大白话讲给你听。
🧭 先看全貌:九大模块导航
| 模块 | 一句话定位 | 你现在最该点开它,如果...... |
|---|---|---|
| ① 🏆 优质项目 | 能写进简历、扛得住追问的工业级项目拆解 | 简历上的项目自己都不想讲 |
| ② 🔬 源码解读 | 不逐行念代码,只讲"它凭什么这么写" | 面试被问源码就卡壳 |
| ③ 🧮 198 道算法题 | 按题眼归纳模板,不是题解搬运 | 下周面试,算法心里没底 |
| ④ 🤖 Java 研发 AI 方向 | Java 工程师落地大模型的实操路径 | 怕被 AI 甩下,又不知从哪下手 |
| ⑤ ☕️ Java 高频面试题 | 把八股还原成原理,反杀追问 | 背了很多,一被追问就露馅 |
| ⑥ 🏗️ 场景设计题 | 高并发系统的"凭什么这么设计" | 冲高级 / 架构岗 |
| ⑦ 🧰 1024 工具 | 本地处理、无广告的在线工具箱 | 谁都用得上,零门槛 |
| ⑧ 🐟 摸鱼网 | 技术人的精神休息区 | 今天已经盯了 8 小时屏幕 |
| ⑨ 🌐 官网 | 全站归档 + 全文检索 | 想系统性地从头学 |
不知道从哪看起?按身份抄作业:
text
应届 / 刷题求职   →  ③ 算法 → ⑤ 面试题 → ① 项目 → ⑥ 场景题
3~5 年想突破     →  ② 源码 → ⑥ 场景题 → ④ AI 方向
6 年+ 冲架构     →  ⑥ 场景题 → ② 源码 → ① 项目复盘
只是想看看       →  ⑦ 工具 → ⑧ 摸鱼,然后回 ①
这张图不用从头读到尾。它更像一个书签,按需点目录,用完就关。
三、九大模块,逐个拆开
① 🚀 优质项目 ------ 一个项目,换一张大厂入场券
------ 简历上写"参与"的人太多了,写"设计"的人很少
面试官一天看两百份简历,80% 的项目描述长一个样------"负责订单模块开发、参与系统优化"。这句话等于没写。而照着视频敲的玩具 Demo------单表 CRUD 套个 Controller,连个异常兜底都没有------面试官扫一眼就知道你没上过生产。
他只看一件事:这个东西是你做的,还是你 clone 的?
一个能打的项目,必须回答四件事:
| 维度 | 废话版 | 能拿 offer 版 |
|---|---|---|
| 量级 | "高并发系统" | 峰值 QPS 1.2w,日单量 80w |
| 难点 | "处理了性能问题" | 大促热点库存扣减,单行锁竞争让 RT 从 8ms 涨到 900ms |
| 动作 | "进行了优化" | 库存分段 + 乐观锁兜底 + 异步削峰,RT 降回 12ms |
| 结果 | "性能大幅提升" | 机器成本降 40%,大促零故障 |
这一栏里放的,全是从一线实战里提炼的脱敏项目,每一个都讲清楚三件事:当时线上的真实痛点是什么、选型时为什么选它而不是别的、上线后踩过哪些坑、最后怎么解的。
举几个硬核场景:
- SCRM客户管理系统 :企微消息回调风暴怎么抗?千万级客户标签如何用
RoaringBitmap做到毫秒级圈人?渠道活码的精准归因与 Redis Lua 防刷怎么做? - 高并发风控引擎:基于 Drools + 规则树,如何在 50ms 内拦截黑产?
- 企业级AI知识库(RAG):别只会调 API!从复杂文档(PDF/表格)解析、智能 Chunk 切分,到"向量+全文"混合检索召回(Hybrid Search),再到严苛的"行级数据权限隔离",带你手搓企业大脑。
每个项目都给你:架构图、核心表设计、关键代码,外加面试官最爱问的 20 个追问。你照着把代码跑通、把细节吃透,面试时根本不用背话术,张嘴讲的全是真实线上故事。
看项目有个四步法,跟着做,一个项目能吃透 80%:
| 阶段 | 动作 | 检验标准 |
|---|---|---|
| 1️⃣ 跑起来 | 拉代码 → 编译 → 启动 → 打断点 | 能本地启动,能触发一次完整调用 |
| 2️⃣ 画主链路 | 只画一条最核心的调用链,其余全砍掉 | 一张图能说清"请求从哪进、从哪出" |
| 3️⃣ 找扩展点 | 找 SPI、找 xxxFactory、找配置开关 |
能回答"我想换一个实现,改哪里" |
| 4️⃣ 改造它 | 加一个小功能 / 改一个 Bug / 提一个 PR | 代码真的跑通了你的改动 |
第 4 步是分水岭。前三步做完,你只是"读过";做完第 4 步,你才是"会了"。面试一问细节就露馅,九成是因为停在了第 2 步。
📌 合集入口 :优质项目合集
② 🔬 源码解读 ------ 别人背流程图,你讲"它凭什么这么写"
我见过太多人打开 Spring 源码,从 refresh() 第一行开始啃,啃到第三天放弃了。
错在方法。源码不是用来"读完"的,是用来"回答问题"的。正确姿势只有一句:带着一个问题进去,带着一张图出来。
更好的打开方式,是带着一个真实的线上故障进去。比如线上遇到线程池的拒绝策略异常,你再去啃 ThreadPoolExecutor,会瞬间明白每一行设计的用意。
我读源码用三遍法:
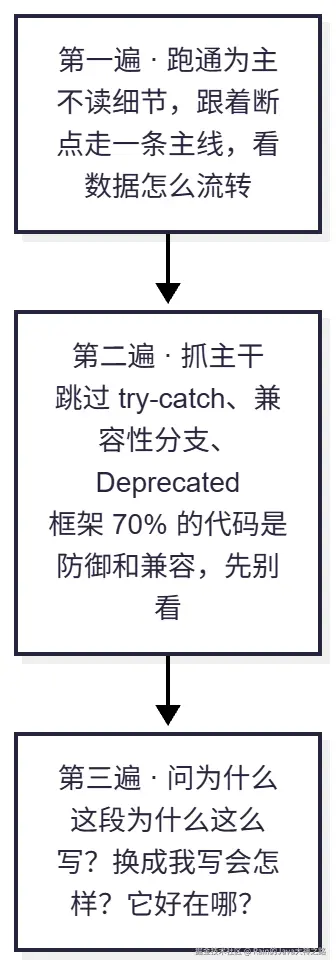
读源码有三层境界,可以对号入座:
| 境界 | 表现 | 面试官的感受 |
|---|---|---|
| 🟢 L1 看得懂 | 跟着注释和别人的文章能读下来 | "他看过" |
| 🟡 L2 说得出 | 能脱稿讲清一条链路,能画出时序图 | "他真读过" |
| 🔴 L3 改得动 | 能指出设计取舍,能说出"这里为什么不用 X" | "这个人可以进来干活了" |
这个模块不逐行念注释,只回答一类问题------"作者为什么不那么写":
| 源码 | 带着什么问题读 | 读完你能回答 |
|---|---|---|
| HashMap | 为什么容量必须是 2 的幂? | 扰动函数 & (n-1) & hash 的位运算取模 |
| ThreadPoolExecutor | 线程池是怎么"拒绝"任务的? | 4 种拒绝策略 + 为什么阿里规范禁用 Executors |
| AQS | 一把锁是怎么"排队"的? | CLH 变体队列 + state 语义 + 为什么唤醒不从头遍历 |
| Spring IOC | Bean 从 .class 到可用对象经历了什么? |
三级缓存解决循环依赖,为什么二级不够 |
| Spring 事务 | @Transactional 什么情况下失效? |
自调用、非 public、异常被吞,根源都在 AOP 代理那一层 |
| RocketMQ | 消息到底怎么做到"不丢"? | 刷盘、复制、offset 提交三道闸门 |
我的标准只有一条:如果我讲不清"作者为什么不那么写",这篇就不发。所以更新慢,但每一篇都经得起你拿去面试桌上被追问。
两个很多人不知道的隐藏技巧:
- 看
@since注释。 它能告诉你这个 API 是哪一代 JDK / 框架引入的,直接帮你定位"它替代了谁、为什么要替代"。 - 对比着读版本。 比如 HashMap 在 JDK 7 和 JDK 8 的差异(头插 vs 尾插、红黑树化),一个 diff 就能看懂整个演进动机。理解演进,比理解现状重要十倍。
📌 合集入口 :源码解读合集
③ 🧮 198 道算法题 ------ 不是为了刷题而刷题,是为了面试桌上不慌
先给结论:别背题,背题必挂。 你要练的是"看到题眼就反应出模型"的肌肉记忆,不是背答案。
我把这 198 道大厂高频题,完全抛开 LeetCode 题号,按"题眼 + 套路 + 模板"重新拆了一遍。每道题只讲三件事:暴力解法怎么一步步推到最优解、边界条件为什么会炸、面试官还会追问什么。
算法题的收益是极度长尾的。我统计过自己参与的几百场面试:80% 的算法题,来自不到 20% 的核心题型。 真正高频的"题眼"就那么十几个:
| 核心题眼 | 识别信号 | 出现频次 |
|---|---|---|
| 二分查找 | 有序数组 / 找边界 / 最小化最大值 | ⭐⭐⭐⭐⭐ |
| 滑动窗口 | 连续子数组 / 子串 / 最长最短 | ⭐⭐⭐⭐⭐ |
| DFS + 回溯 | 全排列 / 组合 / 路径搜索 | ⭐⭐⭐⭐⭐ |
| 动态规划 | 最值 / 计数 / 可行性判断 | ⭐⭐⭐⭐⭐ |
| 前缀和 + 哈希 | 子数组求和 / 区间计数 | ⭐⭐⭐⭐ |
| 单调栈 | 下一个更大元素 / 柱状图面积 | ⭐⭐⭐⭐ |
| 堆 / TopK | 第 K 大 / 中位数 / 合并 K 路 | ⭐⭐⭐⭐ |
| BFS 最短路 | 最少步数 / 层级遍历 | ⭐⭐⭐⭐ |
| 并查集 | 连通性 / 岛屿 / 朋友圈 | ⭐⭐⭐ |
| 位运算 | 异或性质 / 状态压缩 | ⭐⭐ |
方法只有一条:按题眼刷题,不按题号刷题。 一道题刷三遍,不如三道同类型题各刷一遍。
198 道题刷到最后,会收敛成 30 来个解题模板------背模板比背题快十倍。比如二分一个题眼,就收敛成"找值 / 找左边界 / 找右边界 / 答案二分"四个变体;动态规划收敛成"定义 → 转移 → 初始化 → 顺序 → 优化"五步法。
| 看到信号 | 直接套模板 | 收敛后模板数 |
|---|---|---|
| 有序 / 边界 | 二分四变体(找值/左边界/右边界/答案二分) | 约 2 个 |
| 连续子数组 | 滑动窗口骨架 + 收缩条件 | 约 2 个 |
| 最值 / 计数 | DP 五步法(定义→转移→初始化→顺序→优化) | 约 4 个 |
| 排列 / 组合 | 回溯决策树 + 剪枝 | 约 3 个 |
| 下一个更大 | 单调栈(递增 / 递减) | 约 2 个 |
| 第 K 大 | 快选 / 堆 | 约 2 个 |
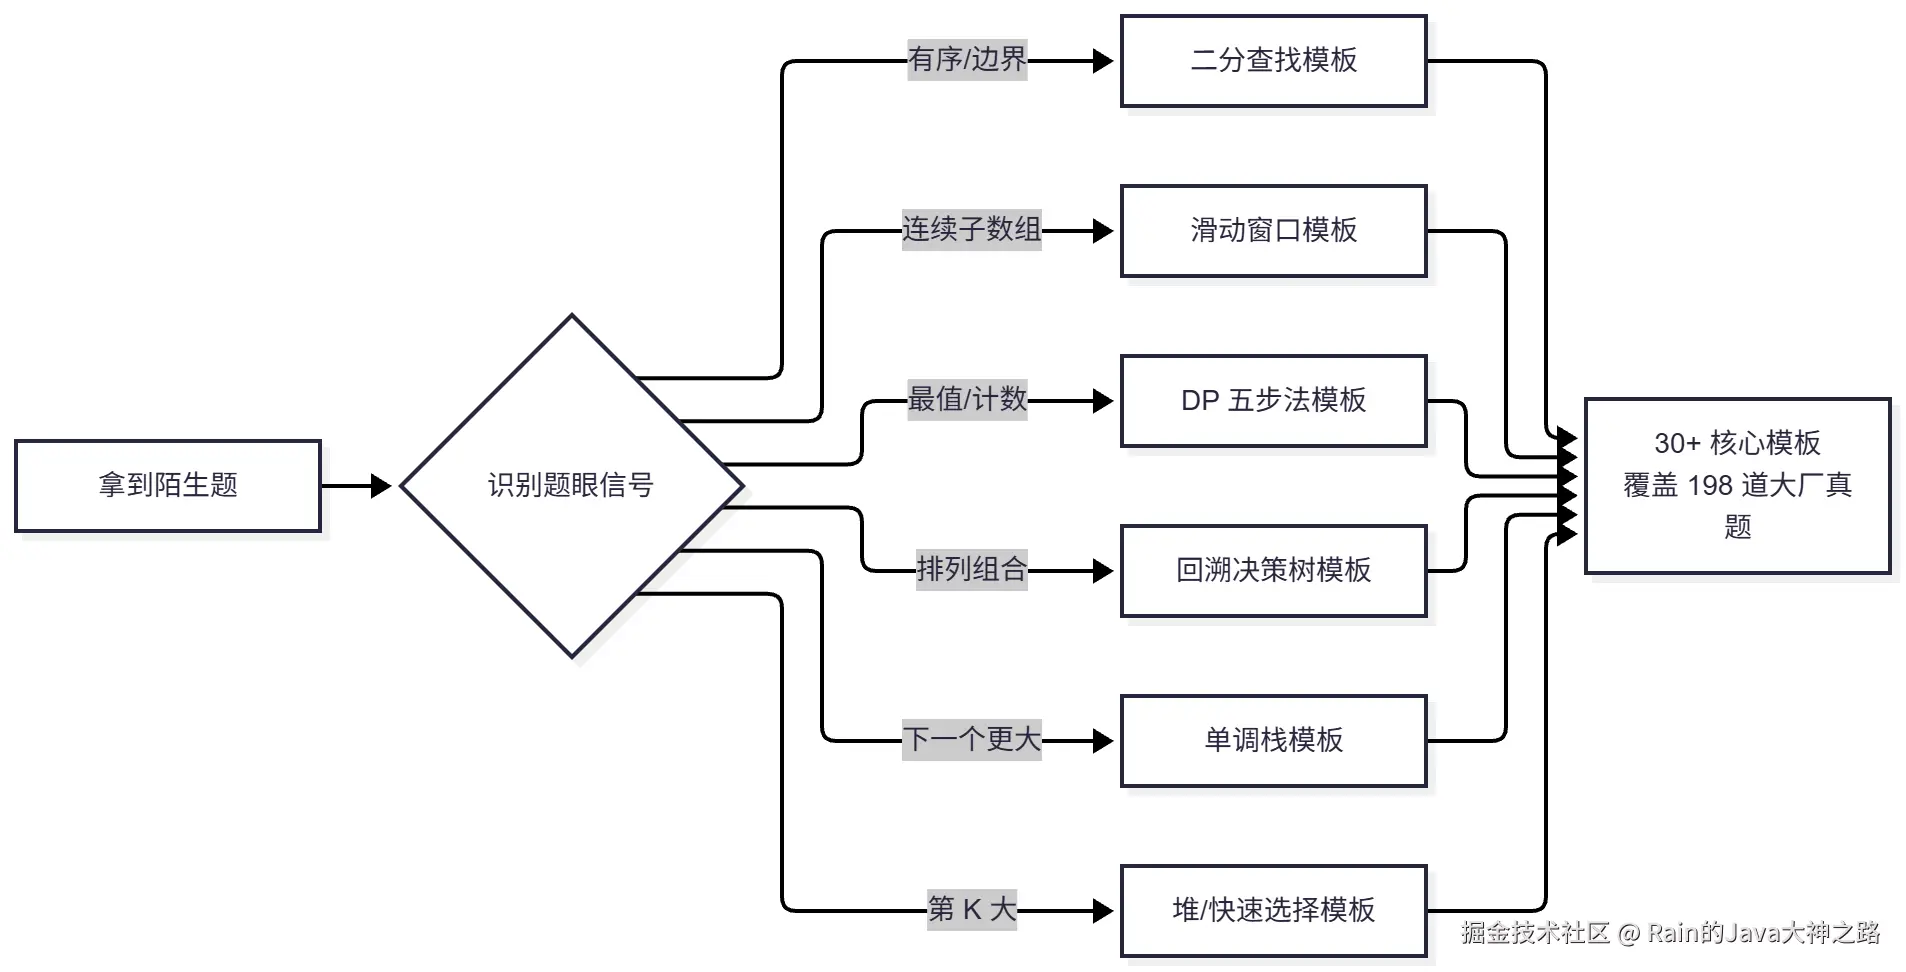
刷完的标准很硬,别糊弄自己:不看题解,25 分钟内 AC,并且能口述"为什么这么做"。做不到就重刷。
📌 直达合集 :198 道算法题全套题解
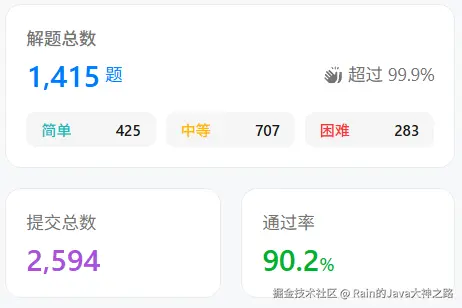
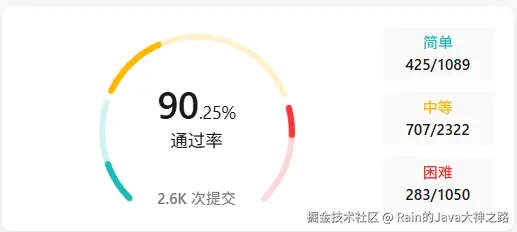
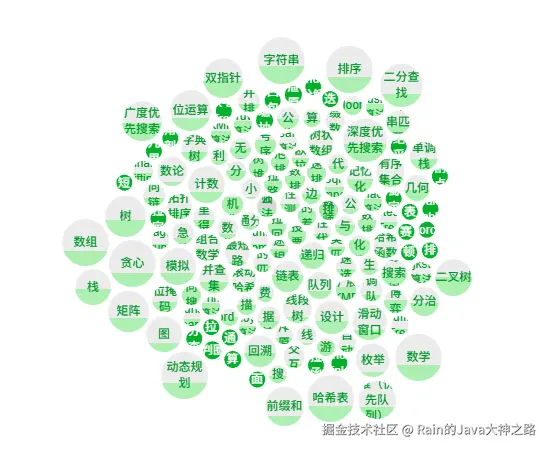
顺便贴一下笔者的LeetCode刷题榜
④ 🤖 Java 研发 AI 方向 ------ 被淘汰的不是 Java 工程师,是不碰 AI 的 Java 工程师
先说一个我观察了两年的事实:绝大多数公司做的根本不是"训练模型",而是"把大模型接进现有业务系统"。
而"接进现有业务系统"这件事------权限控制、审计日志、限流熔断、降级策略、可观测性、数据管道------恰恰全是 Java 工程师的主场。大模型本质上就是一个新的"外部依赖",跟当年我们接 Redis、接 MQ、接 ES 没有本质区别:
| 当年接入 Redis | 现在接入大模型 |
|---|---|
| 连接池 / 超时 / 重试 | Token 限流 / 超时 / 重试 / 降级 |
| 缓存一致性 | 语义缓存 / 向量召回一致性 |
| 主从切换 / 集群部署 | 多模型路由 / 主备模型切换 |
| 监控 QPS / 响应延迟 | 监控 Token 消耗 / 首字延迟 / 调用成本 |
| 热 Key / 大 Key 治理 | 超长上下文 / 慢 Prompt / 高频重复问 |
你的经验根本没有作废,只是换了一层皮。
Java 工程师在 AI 时代的价值,可以拆成四层,越往下越是你的主场:
| 层 | 要干的事 | 你的老本行直接能用 |
|---|---|---|
| 🔌 接入层 | SSE / WebSocket 流式、超时、重试、多模型路由 | WebFlux、OkHttp、Resilience4j、网关 |
| 🧩 编排层 | Prompt 模板、Function Calling、多轮上下文、工作流 | Spring AI / LangChain4j |
| 📚 数据层 | 文档解析 → 切分 → 向量化 → 召回 → 重排 | POI / Tika、ES / pgvector |
| 🛡️ 治理层 | Token 预算、限流、审计、幻觉兜底、全链路可观测 | Micrometer、SkyWalking、TraceId |
上层模型谁都能调,治理层才是护城河。
下面是我踩过的五个血泪坑,每个都烧过钱:
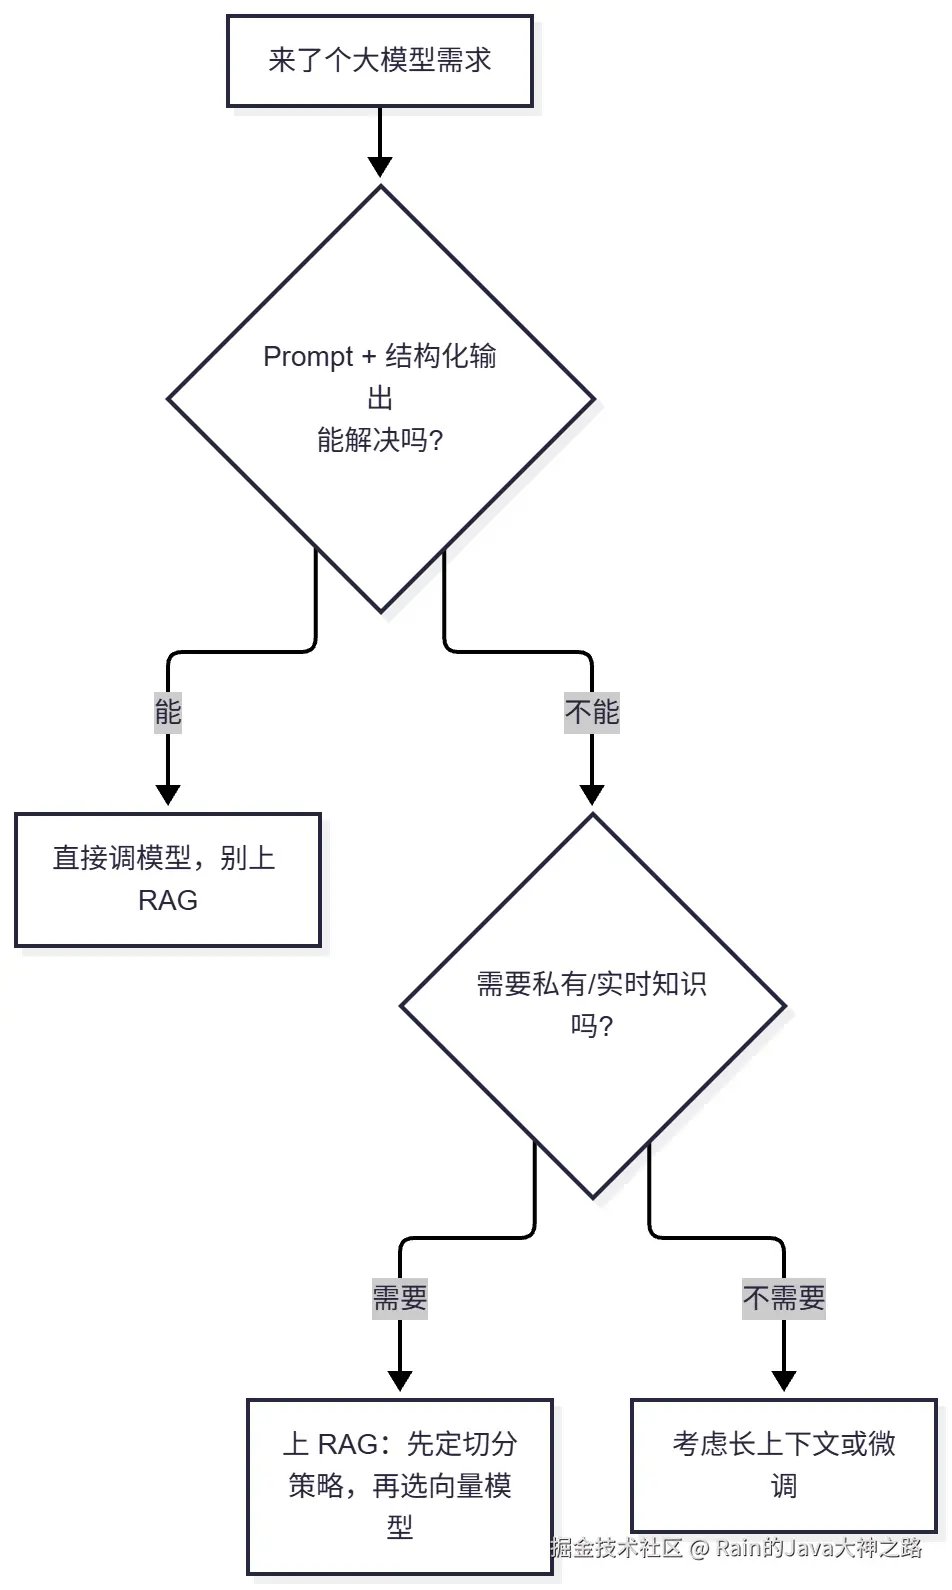
- 别一上来就 RAG。 60% 的需求,写好 Prompt + 结构化输出就够了,RAG 会显著拉高复杂度和延迟。到底上不上,看这张图:
- 切分策略比向量模型重要。 chunk 大小、overlap、父子分段,直接决定召回质量------换再贵的 embedding 模型都救不回来。
- 一定要做语义缓存。 同样的问题反复调模型,账单会教你做人。我靠缓存 + Prompt 瘦身,把 Token 成本砍了 70%。
- 流式输出必须配套超时降级。 大模型超时是常态,不是异常,别把它当 Exception 处理。
- 幻觉防不住,只能兜住。 答案必须带引用来源,做不到就别上生产。
框架怎么选,一句话版本:
| Spring AI | LangChain4j | |
|---|---|---|
| 适合谁 | Spring 全家桶团队,要自动装配、统一抽象 | 想轻量接入、快速验证想法的团队 |
| 优点 | 与 Spring Boot 无缝,ChatClient 抽象干净 |
依赖轻、上手快、社区活跃 |
| 注意 | 版本迭代快,跨版本 API 有变动,升级要回归 | 与 Spring 集成要自己多写一点 |
⚠️ 框架版本变化快,接入前请以官方文档当前版本为准,别照抄半年前的教程。
📌 直达合集 :Java 研发 AI 方向全套实战
⑤ ☕ Java 高频面试题 ------ 把八股还原成原理,你就无敌了
说一个很多人不敢告诉你的真相:面试官问 JVM、问并发,考的从来不是"你知不知道这个概念",而是------系统出问题时,你能不能靠这些知识定位到根因。
八股不是知识,是知识的尸体。我想告诉你的是活的东西:synchronized 的锁升级,在生产上是怎么让一个支付接口毛刺到 800ms 的;ThreadLocal 不 remove,是怎么把一次大促搞成 OOM 的。
所以这个模块的每一篇,永远是三段式:是什么 → 为什么这么设计 → 生产上怎么踩坑、怎么排查。
我整理了面试出现频率最高的几个知识域:
| 知识域 | 命中率 | 必会清单 |
|---|---|---|
| 并发编程 | 95% | JMM / volatile / 锁升级 / AQS / 线程池 / CAS / ThreadLocal |
| JVM | 90% | 内存区域 / GC 算法 / G1 & ZGC / OOM 排查 / 类加载机制 |
| Spring | 90% | IOC / AOP / 循环依赖 / 事务失效 / Bean 生命周期 |
| MySQL | 90% | 索引原理 / B+ 树 / MVCC / 锁机制 / 慢 SQL 优化 / 分库分表 |
| Redis | 85% | 数据结构 / 持久化 / 缓存三大问题 / 分布式锁 / 热 Key 治理 |
| 操作系统 | 85% | 进程线程 / 零拷贝 / IO 多路复用 / 虚拟内存 / 死锁 |
| 消息队列 | 80% | 不丢 / 不重 / 顺序 / 积压 / 事务消息 |
| 分布式系统 | 75% | CAP / 分布式事务 / 幂等性 / 分布式 ID / 限流熔断 |
每道真题都从三个维度拆:面试官想考什么、普通回答是什么、高分回答该怎么说。
拿我常问候选人的一题举例:synchronized 在 JDK 1.6 之后做了哪些优化?追问是有层次的:
| 层级 | 答的是什么 | 举例 |
|---|---|---|
| L1 | 是什么 | 偏向锁 → 轻量级锁 → 重量级锁 |
| L2 | 为什么 | 绝大多数场景没有竞争,加锁成本应趋近于零,所以要有偏向锁 |
| L3 | 生产怎么排查 | 锁升级导致性能毛刺,用 JFR / async-profiler 定位,Arthas monitor 抓锁竞争热点 |
| L4 | 边界在哪 | 偏向锁为何在 JDK 15 后被废弃:维护成本高、收益下降,默认关闭 |
答到第四层,就是 P6 和 P7 的分界线。有次一个候选人答到 L3 后补了一句:"我上个项目真遇到过锁升级毛刺,用 Arthas monitor 抓到热点,最后换成 LongAdder 解决的。"------当场就聊嗨了。
再示范一个"反杀追问"。面试官问:volatile 有什么用?
- ❌ 低分答案:保证可见性、禁止指令重排序。背完就没了。
- ✅ 高分答案:可见性靠的是 MESI 缓存一致性协议 + 内存屏障(StoreStore/LoadLoad...);禁止重排是 happens-before 规则的具体落地;它不保证原子性,所以
i++加了 volatile 也不安全,得用AtomicInteger或锁------这正是 DCL 单例必须加 volatile 的原因,防止对象半初始化被其他线程拿到。
同样的知识点,答到第三句,面试官的眼神就不一样了。
📌 直达合集 :Java 高频面试题深度解析
⑥ 🏗️ 场景设计题 ------ 面试的终极战场,也是架构师的日常
场景题没有标准答案,考的是取舍能力。面试官真正在听的,从来不是你用了什么技术,而是四件事:
- 你会不会先问清量级(QPS 多少?数据量多少?一致性要求多高?)
- 你能不能给出分层方案(先单机跑通,再谈分布式,最后谈极端情况)
- 你知不知道每个方案的代价(一致性 vs 可用性 vs 成本)
- 你是不是真的做过(做过和背过,一问细节就露馅)
我整理了一套万能答题框架,面试前直接套:
text
1. 澄清需求与量级:用户量、QPS、数据量、延迟与一致性要求
2. 识别核心矛盾:读写比例?热点分布?容量瓶颈?一致性优先级?
3. 分层架构设计:接入层 → 服务层 → 存储层 → 兜底降级层
4. 关键组件选型 + 理由(一定要说理由,不说理由等于白说)
5. 边界与异常处理:超时、重试、幂等、降级、监控告警
6. 演进路径:当量级翻 10 倍,哪个环节先扛不住?怎么升级?
整理了面试命中率 TOP 10 的经典场景,每个都从需求分析、技术选型、架构设计到压测调优走一遍:
| 排名 | 经典场景 | 核心考点 |
|---|---|---|
| 1 | 秒杀系统设计 | 热点库存、扣减一致性、限流分层、防刷机制 |
| 2 | 短链服务设计 | ID 生成、301/302 跳转、缓存加速、跳转埋点 |
| 3 | 实时排行榜 | Redis ZSet、分桶计算、冷热数据分离 |
| 4 | 延迟队列实现 | 时间轮算法、RocketMQ 延迟消息、Redis ZSet 方案 |
| 5 | Feed 流设计 | 推拉结合、大 V 问题、游标分页优化 |
| 6 | IM 即时通讯 | 长连接管理、消息可达性、已读未读状态 |
| 7 | 库存扣减系统 | 分布式锁 vs 乐观锁、超卖问题、幂等性保证 |
| 8 | 分布式 ID 生成 | 雪花算法、时钟回拨、号段模式 |
| 9 | 限流熔断方案 | 令牌桶/漏桶、滑动窗口、Sentinel 实战 |
| 10 | 海量数据去重/TopK | 布隆过滤器、位图、分治思想 |
这里有个高分段位提示。低分答案是"我用 Redis + MQ + 分库分表"------在堆组件。高分答案是"因为写 QPS 只有 200 但读有 10 万,所以我不上分库分表,先上缓存 + 读写分离;只有当写超过 5000 时,才需要拆"------在讲取舍。
会做减法的候选人,永远比会堆组件的候选人值钱。
📌 直达合集 :场景设计题全套拆解
⑦ 🧰 1024 工具 ------ 程序员的效率外挂,能少写一行是一行
写代码这件事,差不多 40% 的时间在切窗口、找工具、处理杂事。 这里的工具全是我亲测在用,无广告、不套路、免注册,打开就能用。
还有一条我很在意的底线:能在浏览器本地算完的,就不上传服务器。 你的 JSON、你的日志、你的密钥,不该经过别人的机器。
每天在各种广告满天飞的工具站之间切换,浪费的时间攒起来一年能有上百个小时,够你写完一个 side project 了。
📌 直达合集 :1024 程序员工具库
⑧ 🐟 摸鱼网 ------ 会摸鱼的程序员,才是好程序员
代码写不出来的时候,别硬刚。站起来喝杯水,摸五分钟鱼,灵感自己就来了。
这不是玄学。大脑有个默认模式网络(DMN)------你放松、走神、发呆的时候,它才真正开始工作,把平时八竿子打不着的知识做远距离连接。有些 bug 不是 debug 出来的,是上厕所路上想通的。
摸鱼不是偷懒,是给大脑换个进程调度算法,让后台继续跑 GC。盯着屏幕的第 8 个小时,产出往往不如摸鱼 10 分钟后的第 9 个小时。
📌 直达地址 :🐟 摸鱼网合集
⑨ 🌐 官网 ------ 所有内容的大本营
公众号文章多了,翻历史消息像大海捞针。官网把全站内容做了完整归档,支持全文检索,按"技术栈 + 难度 + 时间"多维索引,也支持离线阅读。就算哪天公众号翻不到了,你也永远能在这里找到所有干货。
📌 直达地址 :🏠 官网合集
四、最后,说点掏心窝子的话
以上所有内容,全部免费。不是限时免费,不是转发解锁,不是加群领取------打开就能看,看完就能用。
为什么?
因为我刚入行那会儿,兜里没钱,网上到处是割韭菜的"速成班"。是几个前辈随手写的博客,把我从坑里一次次捞出来的。这份人情,我一直记着。现在轮到我还了。
这 13 年+,我经历过:
- 凌晨三点,监控告警炸了,从床上弹起来连 VPN
- 大促当天,QPS 和心跳一起飙,对账差了 5 毛钱,查了一整夜
- 重构一个祖传模块,改一行崩一片,最后推倒重来
- 也有第一次把 P99 压到 20ms、第一次让系统稳稳扛过大促的爽快
这些坑我都踩过了。我踩过的,真的不想让你再踩一遍。所以我把它们写下来,用大白话,讲给你听。
这个号永远三不:不卖课、不贩卖焦虑、不设付费墙。 所有合集、所有源码、所有工具,全部免费开放。你要做的只有一件事------点个收藏,需要的时候找得到它。
Keep Coding, Keep Loving ------ 与所有 Java 同路人共勉。
如果你也在这条路上,欢迎常来坐坐。技术唠嗟、问题交流,随时都行。你要知道,你不是一个人,咱们一起,把代码写得更溜。
📌 建议操作:右上角「···」→ 收藏 + 置顶,下次找干货不用翻历史消息。 💬 有想看的选题,直接在评论区点菜,我尽量安排。 🔁 觉得有用,转给那个正在准备面试的朋友------也许他今晚就用得上。