前言 :封闭告一段落,开始系统复盘:一个生产 Agent 到底怎么跑起来。踩坑、经验和落地,最主要的是产品得到用户认可。尽量用几篇文章讲清,这篇文章是系列第3篇:接上 Function Calling(模型按约定格式提出「要调哪个工具、带什么参数」)不等于有 Agent。要把「想一步、做一步、看结果」做成能停、失败能写进对话、中途缺东西能问用户的循环。
用户说:"看看支付服务最近报错,顺便对照一下文档里的处理建议。"
上一篇把意图认清楚了。这篇盯住:认完意图之后,Agent 往往不是调一次工具就结束,而是要走好几步。
很多团队接上 Function Calling 之后,会默认「模型选工具 → 执行 → 把结果当答案」就算 Agent 了。线上很快会撞墙:
- 用户一句里有两件事,只办了一件;
- 工具一报错,整轮接口直接 400;
- 中间缺参数想问用户,状态却丢了;
- 前端只看见最后一段字,不知道中间查过什么。
继续用案例 OpsPilot(企业运维助手,虚构案例),技术栈仍是 TypeScript。这篇只把循环本身写清楚:想一步、做一步、看结果、再想。
ReAct(Reason + Act,边推理边行动)要解决的,就是把这件事做成稳定循环,而不是调一次就收工。
先把循环画出来
核心就这一圈,会转好几次:
text
Thought → Action → Observation → Thought → ... → Final Answer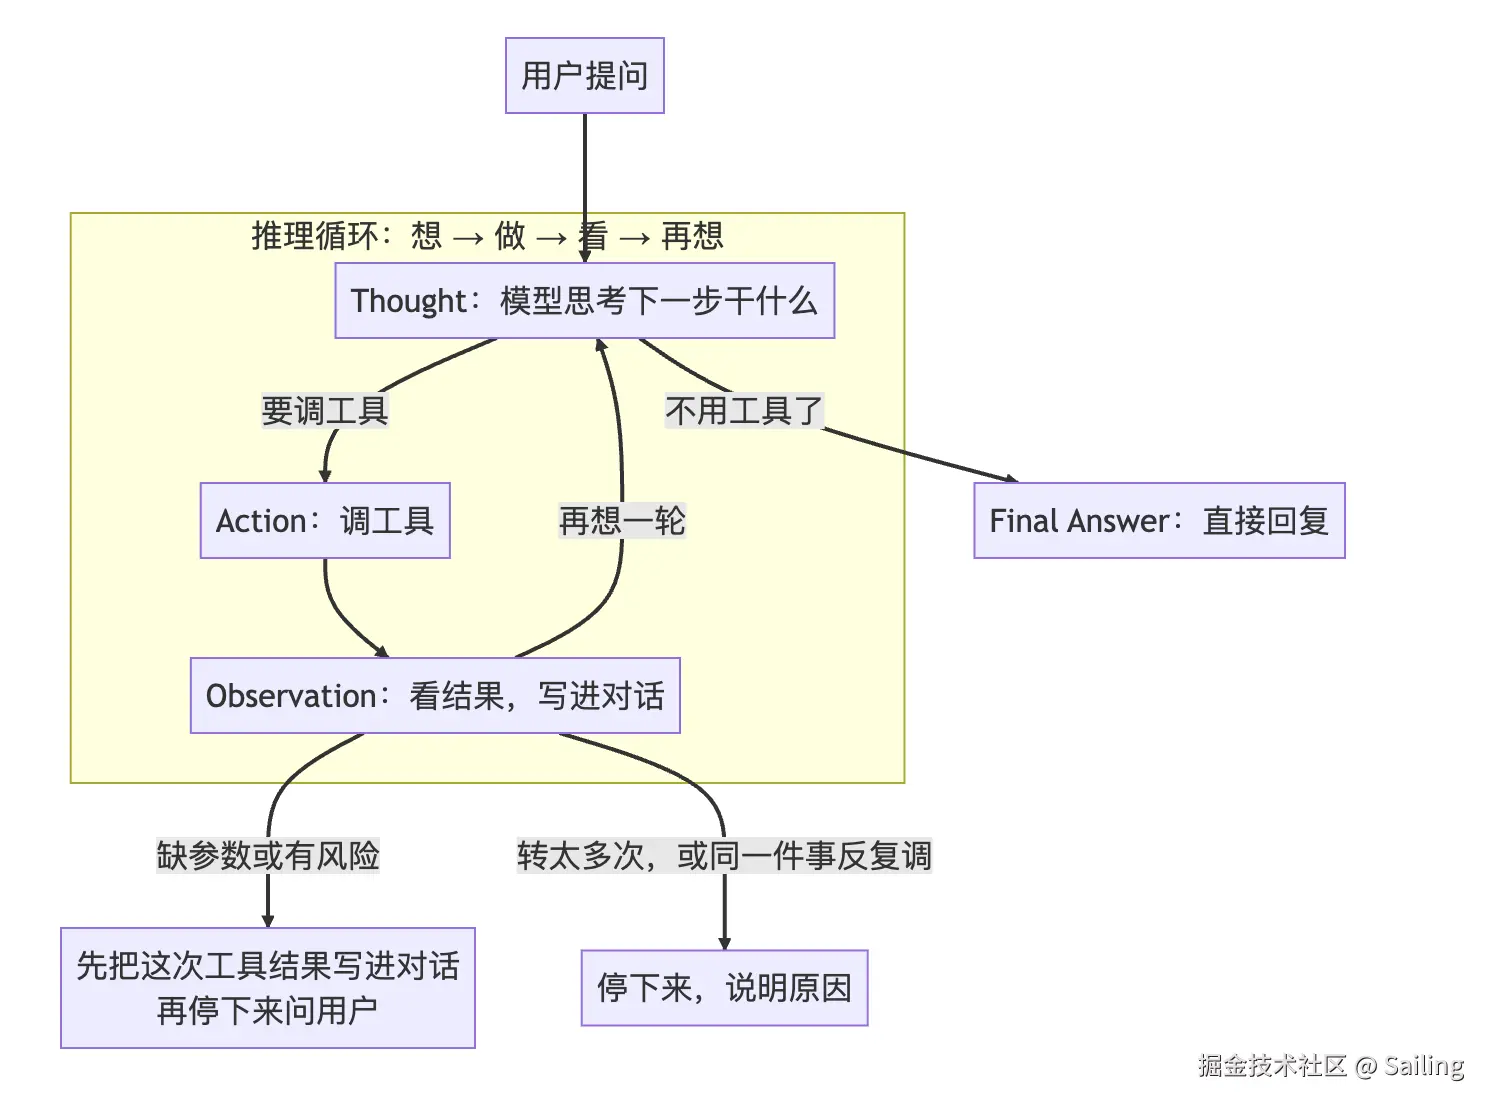
框里是主循环。看完结果默认回到 Thought,再想下一轮;只有不用工具了、要问用户、或转太多次,才从圈里出来。
图里几块分别是:
- Thought:模型思考下一步干什么。
- Action:提出要调哪个工具、带什么参数,并真正执行。
- Observation:工具跑完后写进对话的结果(成功、失败、取消都算)。
- Final Answer:不再调工具,直接给用户最终回复。
- 问用户 / 上限:参数不够,或操作有风险,就停下来问用户;转太多次也要停。问之前,先把已经跑完的工具结果写进对话,别把半截结果丢掉。
落到工程上,对话是一条条往下追加的:
text
模型:可能带 tool_calls(要调哪个工具、带什么参数、以及配对用的唯一 id)
你的执行层:跑工具,把结果写成一条 tool 消息(每个 id 一条)
模型:继续想 / 再调工具 / 给出最终回复
直到模型不再调工具,或必须停下来问用户,或已经转了太多次
只要用了工具,最少也要两轮模型调用:
text
第 1 轮:模型看用户话 → 提出要调哪些工具(可以一次提好几个)→ 代码把这些工具都跑完,结果写进对话
第 2 轮:模型看工具结果 → 不再调工具,直接给出最终回答 → return
第 1 轮里即便把需要的工具都调完了,仍然要进第 2 轮。第 1 轮结束时,对话里只有「要调什么」和「工具结果」,还没有给人看的最终回答;最终回答是第 2 轮模型看完结果之后才说出来的。
代码里是没有 toolCalls 就 return。正常答完时,停下来看模型这一轮还提不提工具;另外还有转太多次强制停、以及停下来问用户这两种情况。
还会出现第 3、第 4 轮,是因为第 2 轮看完结果后,可能又要再查一样东西------比如先查到服务 id,下一轮才查这份日志。那是步骤有依赖,不是一上来就规定必须转几圈。
LangChain / LangGraph 的 ReAct(createReactAgent / createAgent)也是同一套:
- 模型节点 → 有
tool_calls就进工具节点 → 再回到模型节点; - 直到最后一条模型消息没有
tool_calls才结束。 - 框架已画成图,逻辑和下面的
for一样。
工程上,循环在维护一张对话清单:
- 清单上只有四种话:系统约束、用户说的、模型说的、工具跑完的结果。
- 每一圈:把整张清单交给模型;模型要么直接答完,要么说「去调某某工具」。
- 若要调工具:代码真去跑;跑完(成功或失败都行)把结果追加进清单,再进入下一圈。
- 若不再调工具:循环结束,清单里最后那句助手话就是最终回复。
- 若转了太多次还没收工:强制停,给用户一句说明,别让接口挂掉。
该不该调、调哪个,交给模型;循环代码只负责:最多转几圈、每条工具结果能不能对上 id、用户取消、以及什么时候停。下面是一个简单的推理循环实现:
ts
// 对话里的一条消息,只能是下面四种之一
type ChatMessage =
  | { role: 'system'; content: string }                              // 系统约束
  | { role: 'user'; content: string }                                // 用户说的
  | { role: 'assistant'; content?: string; toolCalls?: ToolCall[] }  // 模型说的;可能带着「要调的工具」
  | { role: 'tool'; toolCallId: string; name: string; content: string } // 工具结果;toolCallId 必须对上模型那次提案

// 模型提出的一次工具调用
type ToolCall = {
  id: string                 // 唯一 id,后面写结果时要对上这个
  name: string               // 调哪个工具
  arguments: unknown         // 带什么参数(执行前再校验)
}

async function reactLoop(input: {
  messages: ChatMessage[] // 当前对话清单
  tools: ToolRuntime // 真去跑工具的那一层
  maxSteps: number // 最多转几圈
  signal: AbortSignal // 用户点停止
}): Promise<ChatMessage[]> {
  const messages = [...input.messages] // 复制一份,后面往上追加

  // 每一圈:模型想一次 →(可能)调工具 → 看结果;maxSteps 是上限
  for (let step = 0; step < input.maxSteps; step++) {
    // Thought:把整张清单交给模型
    const assistant = await callModel({
      messages,
      tools: input.tools.definitionsForModel(),
      signal: input.signal
    })

    messages.push(assistant)

    // 没有 toolCalls → Final Answer,结束
    if (!assistant.toolCalls?.length) {
      return messages
    }

    // Action:跑工具;失败也要写成结果
    const observations = await input.tools.executeAll(assistant.toolCalls, {
      signal: input.signal
    })

    // Observation:每个 id 一条,写进清单后再进入下一圈
    for (const obs of observations) {
      messages.push({
        role: 'tool',
        toolCallId: obs.callId,
        name: obs.toolName,
        content: obs.contentForModel
      })
    }
  }

  // 触达 maxSteps 还没收工 → 强制停
  messages.push({
    role: 'assistant',
    content: '这次已经转了太多次,先停。已查到的可以先告诉用户,并说明没能继续。'
  })
  return messages
}
失败了也要写进对话,多个工具要等齐
失败也要写成结果,写进对话
把工具结果写进对话、再交给模型看。而模型提出的每个 tool_call.id,后面都必须有一条对应的结果消息。少一条,下一轮请求对不齐,接口会直接 400。
OpenAI 和 Anthropic 的客户端工具都是这个要求。各家写法不一样:
- OpenAI 常见是
role: "tool"; - Anthropic 则是把
tool_result放进下一条 user 消息。
这些差异写在对接各家模型的适配层里就行,别假设「全世界都叫 ToolMessage」。Anthropic 还有一类工具由接口自己代跑,不经过你的执行层,也不走这套「你执行、你写回结果」的路径。
工具里直接 throw,框架对不上 id,整轮请求失败------用户看到的是接口错,不是「查库失败,换个说法」。正确做法是执行失败也是一种 Observation,写成结果给模型看,不是让循环崩溃。
ts
// 单工具执行:成功/失败都变成 Observation,禁止 throw 崩整轮
async function executeOne(call: ToolCall, runtime: ToolRuntime) {
  try {
    const result = await runtime.invoke(call) // 统一走校验/鉴权/超时
    return {
      callId: call.id,
      toolName: call.name,
      contentForModel: JSON.stringify({
        ok: true,
        data: result.forModel // 给模型看的裁剪结果
      }),
      interrupt: result.interrupt // 若要停下来问用户,先记下,等这批工具都跑完再处理
    }
  } catch (err) {
    // 失败也写成结果写进对话,模型可改参数、换工具,或告诉用户办不了
    return {
      callId: call.id,
      toolName: call.name,
      contentForModel: JSON.stringify({
        ok: false,
        errorCode: classifyError(err),
        message: publicErrorMessage(err) // 不要把报错堆栈写给模型
      }),
      interrupt: undefined
    }
  }
}
模型看到 ok: false 可以改参数、换工具,或老实告诉用户办不了。
一轮提出多个工具时,默认先等齐
OpsPilot 里常见:用户一句要查资源和查文档,模型一轮里可能同时提出两个工具:
text
tool_calls: [search_resource, search_knowledge_base]若 A 返回「缺参数,请用户选择」,B 还在飞,此时立刻结束请求、丢掉 B 的结果,下一轮很难对齐 call id,前端步骤条也会缺一块。
等这批工具都跑完,是我们自己的运行策略,不是哪家协议硬性要求。 Anthropic 官方也写明:并行时怎么执行由你决定,但每个 tool_use 都必须回一条 tool_result。LangChain / LangGraph 也一样:工具节点里可以一起跑,但「要不要等齐、写操作能不能并行」仍是你定的策略,不是框架替你拍板。更稳的默认:
- 只查不改的工具可以一起跑,并等齐结果;
- 会改数据的操作(重启、发布),不要一起跑;(切记,很重要)
- 用户点取消时,也要给每个已经发出的 id 写回一条「取消了」的结果,别取消了还空等到超时。
text
只查不改 → 可以一起跑,等齐结果,再决定要不要停下来问用户
会改数据 → 一个一个来;一批最多做一个写操作
用户取消 → 尽快停,但仍给每个已发出的 call id 写回一条取消或失败
ts
type BatchResult = {
  observations: Observation[]           // 本批全部工具结果(含失败)
  deferredInterrupt?: InterruptPayload  // 要问用户的话,等这批都跑完再交给上层
}

// 本批工具先全部跑完,再决定要不要停下来问用户(避免并行时丢掉某个 id)
async function executeBatch(calls: ToolCall[], runtime: ToolRuntime): Promise<BatchResult> {
  // 只查不改的可以一起跑;会改数据的不要走进这条并行路径
  const observations = await Promise.all(calls.map(c => executeOne(c, runtime)))

  const interrupt = observations.find(o => o.interrupt)?.interrupt
  return {
    observations,
    deferredInterrupt: interrupt
  }
}

const batch = await executeBatch(assistant.toolCalls, tools)
for (const obs of batch.observations) {
  messages.push(toToolMessage(obs)) // 按 call id 把结果写进对话
  emitSse({ type: 'tool_result', ...obs.forFrontend }) // SSE:服务端推事件给前端步骤条
}

// 这批都写进对话后,再停下来问用户:本轮请求结束;下次靠保存的进度,或用户补上的参数接着跑
if (batch.deferredInterrupt) {
  emitSse({ type: 'loop_interrupt', ...batch.deferredInterrupt })
  return
}
互不依赖的查询适合一起跑。要先拿到资源 id、再查这份日志时,别指望模型「碰巧」并行对------一个一个来,或走固定流程,更干净。
模型一次可提多个工具,和一次只许一个工具
模型自己决定调几个:一轮里可以同时提出好几个工具,执行层可以一起跑。适合探索、检索、说明类任务。
这一圈只许一个工具:跑完再把结果写进对话。适合必须先 A 后 B。
关键点:助手消息里一旦出现多个 tool_calls,每一个 id 都要有结果。不要只执行第一个、丢掉其余------下一轮会协议报错。更稳的做法是:这一圈只让模型看见一个工具(或强制它必须调这一个),从源头让它只提一个;如果还是多提了,没执行的那些也要写回一条「这一圈没执行」的结果。
ts
// 串行一圈:只让模型看见这一个工具,用来做「必须先 A 后 B」
async function serialStep(input: {
  messages: ChatMessage[]
  tool: ToolDefinition // 这一圈唯一允许的工具
  signal: AbortSignal
}) {
  const assistant = await callModel({
    messages: input.messages,
    tools: [input.tool.forModel], // 只给模型看这一个工具
    toolChoice: { type: 'auto' }, // 或改成强制必须调这个工具
    signal: input.signal
  })

  const calls = assistant.toolCalls ?? []
  if (!calls.length) {
    return { assistant, observations: [] as Observation[] }
  }

  // 每个 call id 都必须有一条结果;没执行的也要写回去,否则下一轮 400
  const observations: Observation[] = []
  for (const call of calls) {
    if (call.name === input.tool.name) {
      observations.push(await executeOne(call, /* 仅含本圈工具的执行层 */))
    } else {
      observations.push({
        callId: call.id,
        toolName: call.name,
        contentForModel: JSON.stringify({
          ok: false,
          errorCode: 'skipped_in_serial_step',
          message: `这一圈只允许 ${input.tool.name},此调用未执行`
        }),
        interrupt: undefined
      })
    }
  }

  return { assistant, observations }
}
产品上可以拆两条路:
- 主对话让模型自己决定调几个工具;
- 开通、发布这类必须按顺序来的,走串行或状态机。
别只靠 Prompt 硬逼"永远先查资源再查库",否则,用户换个说法就是漏洞。
边跑边推前端,以及停下来问用户
循环跑的时候,前端最好别干等最后一段字。模型一提出要调工具、工具一跑完、要停下来问人时,都应该立刻推到页面上,用户才知道正在查日志、正在对照文档。
常见两种推法:
| 推法 | 前端看到的 | 适合 |
|---|---|---|
| 按步骤推事件 | 正在调用某某工具、工具返回了什么 | 要步骤条的运维助手 |
| 按字推最终回答 | 回答一个字一个字冒出来 | 几乎不调工具的纯聊天 |
框架每次推整份对话时,只处理新增的那几条
有的框架(例如 LangGraph 的 streamMode: 'values')每次推过来的不是「刚多出来的一条」,而是到目前为止的整份对话。
打个比方:第 1 次推来 [A],第 2 次推来 [A, B],第 3 次推来 [A, B, C]。如果你每次都把整份列表再推给前端一遍,用户会看到 A、B 重复出现。
做法:记下上次处理到第几条,只把新增的那几条转成前端事件,再通过 SSE(服务端推事件)推给页面。SSE 协议怎么定、前端怎么接,系列后面再单独写;这里只要求别把同一批步骤推两遍。
ts
let processed = 0 // 上次已经处理到第几条

for await (const state of agent.stream(input, { streamMode: 'values' })) {
  const messages = state.messages as ChatMessage[]
  const delta = messages.slice(processed) // 只取新增的,切记
  processed = messages.length

  for (const msg of delta) {
    if (msg.role === 'assistant' && msg.toolCalls?.length) {
      for (const call of msg.toolCalls) {
        emitSse({
          type: 'tool_call',
          id: call.id,
          name: call.name,
          args: call.arguments
        })
      }
    }
    if (msg.role === 'tool') {
      emitSse({
        type: 'tool_result',
        toolCallId: msg.toolCallId,
        content: msg.content
      })
    }
  }
}
页面上步骤条怎么排、最终气泡怎么显示,是产品问题。循环这边至少做到:
- 推出去的事件顺序事后能还原;
- 数据库里能留下工具这一段;
- 同一批步骤别重复推;
循环里怎么停下来问用户
工具发现还缺参数(比如没选环境),或这是高风险操作(比如重启)时,别假装已经成功。让工具返回一种固定结构,表示"先停一下,问问用户":
ts
type InterruptPayload = {
  interrupt: true            // 标记:要问用户,不是普通失败
  interruptType: 'params_required' | 'confirm_risky' // 还缺参数 / 高风险要确认
  reason: string             // 给人看的原因
  payload: Record<string, unknown> // 前端要展示的表单、选项等
}
工具返回示例:
ts
{
  interrupt: true,
  interruptType: 'params_required',
  reason: '需要选择环境和应用后才能查日志',
  payload: {
    fields: ['environment', 'serviceId']
  }
}
主循环看到这个标记后:
- 给前端推一条"请补充或确认",然后结束本轮 HTTP。
- 用户选完再发下一轮------参数可以写进用户消息,也可以写进这次运行保存的进度。
LangGraph 里常见对应是 interrupt 把图挂起,用户补完再用 Command 之类接着跑。思路相同,只是进度由框架帮你存。注意三点:
- 前端要展示成「等你确认」,而不是红字报错。这是正常流程,不是失败。
- 服务端可以暂时不存进度:靠会话历史(数据库) + 用户这次提交的参数接着跑;有运行记录和保存的进度更稳。(后面的文章再写)
- 别在入口用关键词决定弹不弹框 :用户说了应用名,可能该先搜资源,不能一看到「日志」就弹表单。缺不缺参数,由工具或意图层 的结构化数据决定。
什么时候强制停,以及事后怎么排查
不设上限的 ReAct 会烧钱,也会死循环。一般来说:
- 一步就是循环转一圈:模型想一次,可能调工具,再把结果写回去。
- 生产里通常就卡这几条:最多转几圈、整轮最多跑多久、连续失败几次就停、同一个工具带同一组参数反复调就停。
LangGraph 的 recursion_limit 管的是图里跳了多少步,和手写循环里的 maxSteps 是一类开关,别指望框架默认就替你拦住"同参反复调"。
ts
type LoopLimits = {
  maxSteps: number           // 最多转几圈;建议起点 6~12,按场景自测
  maxWallTimeMs: number      // 整轮真实耗时上限,防请求挂死
  maxToolFailsInRow: number  // 连续工具失败上限
  identicalCallLimit: number // 同名同参连续重复上限
}

// 任一触达即停
function shouldStop(ctx: {
  step: number
  startedAt: number
  recentCalls: string[] // 工具名 + 参数摘要,用来发现同一件事反复调
  failStreak: number
  limits: LoopLimits
}): 'continue' | 'max_steps' | 'timeout' | 'loop_detected' | 'too_many_fails' {
  if (ctx.step >= ctx.limits.maxSteps) return 'max_steps'
  if (Date.now() - ctx.startedAt > ctx.limits.maxWallTimeMs) return 'timeout'
  if (ctx.failStreak >= ctx.limits.maxToolFailsInRow) return 'too_many_fails'

  const last = ctx.recentCalls[ctx.recentCalls.length - 1]
  let streak = 0
  for (let i = ctx.recentCalls.length - 1; i >= 0; i--) {
    if (ctx.recentCalls[i] !== last) break
    streak++
  }
  if (last && streak >= ctx.limits.identicalCallLimit) return 'loop_detected'

  return 'continue'
}
事后要能排查,每次循环至少留下:
- 这次运行、这次会话的 id。
- 每一步的模型耗时、是否产生
tool_calls。 - 每个工具的
callId、参数摘要、成功、失败、停下来问用户、耗时。 - 终止原因:正常答完、问用户、转太多次 ...
看数据面板先看三件事:
- 平均转了几圈;
- 工具失败率;
- 停下来问用户之后有多少能接着跑完。
圈数突然飙升,往往是工具说明没写清 ,或写回给模型的结果又长又乱 ,模型在原地反复调。
什么时候适合,什么时候别硬上
合适
- 就几步就能答完的业务问答:查资源 → 查文档 → 回答。
- 需要根据中间结果改主意的探索任务。
- 工具不多、失败可以重试、或能跟用户说清楚办不了的场景。
吃力
- 要等几个小时、要好几个人审批、必须严格先 A 后 B 的长流程。
- 生产变更必须能知道走到第几步了。
- 成本和延迟很敏感、不允许模型自己多转几圈的批量任务。
后面这种,把 "流程往下推" 交给规划、状态机或固定工作流,可以某一小步里再嵌一段 ReAct。把整段长任务丢给自由循环,常见结局是重复踩坑、状态说不清、账单和风险一起涨。
常见实现误区
- 工具一抛异常就让整轮 400 --- 失败应写成 Observation,写进对话。
- 多个工具还没跑完就丢掉结果 --- 只查的要默认等齐;会改数据的不要一起跑;用户取消时也要写回一条结果。
- 助手提了多个 tool_calls,却只把其中一个结果写回去 --- 切记,每个 id 都必须有结果。
- 把完整 Observation 原文塞回模型 --- 报错堆栈、手机号邮箱、超长列表会把上下文弄脏;写回去之前先去掉敏感信息,过长的截断。
- 用关键词在入口预判要不要进 ReAct --- 用户那句话什么意思,交给意图层按数据格式输出;循环入口只做鉴权,这个用户还能不能继续用。
- 没有最多转几圈、也没有"同一工具同一参数反复调"的检测 --- 模型会围着错误参数原地打转。
- 前端只渲染最终文本 --- 排障和用户信任都靠中间步骤;至少库里能还原发生过什么。
- 把"停下来问用户"当成普通报错 --- 问完还要能接着跑,不是前端飘一条失败提示就结束。
最小动手路径
- 用两个只读假工具(
search_resource、search_docs)跑通上面的reactLoop。 - 故意让一个工具抛错,确认循环仍能返回友好说明,且每个 call id 都有工具结果消息。
- 让模型一轮并行调两个工具,SSE(或日志)里能看到四条事件:两个 call、两个 result。
- 让其中一个工具返回「要问用户」,确认另一条结果仍被记录,然后再结束本轮。
- 让模型反复调同一个假工具,确认连续同参会触发
loop_detected;再把maxSteps收紧,确认转太多次时能停,并且给用户一句可读说明。
开发的时候都通了,再接真实鉴权、问用户之后怎么接着跑、以及监控。
这篇没展开、系列后面还会写的
这里面提到很多细节点,一篇文章写不完,后面专门拿出来写,都很重要:
| 主题 | 后面打算怎么写 |
|---|---|
| 流式推送、停下来问用户、接着跑 | 多轮对话与 SSE |
| 工具注册、参数校验、重试、权限 | 工具执行层 |
| 规划、状态机、长任务 | Agent Runtime |
| 上下文窗口、长期记忆 | 记忆与上下文 |
| 转了几圈、花了多少钱 | 模型成本 |
ReAct 是短任务的默认循环;长任务还要加规划或状态机。先把消息怎么配对、失败怎么写进对话、问用户前先等齐结果、以及什么时候强制停,这几件事做对,再谈框架选型,返工会少很多。
小结
上面细节不少,就这三条:
- 工具失败了,也要把结果写进对话 ,别让整轮接口直接崩掉;每个
tool_callid 都要对上一条结果。 - 会改数据的工具别一起跑;用户取消了,每个 call id 仍要有一条结果。
- 设好最多转几圈,并拦住"同一工具同一参数反复调",别一直烧 Token。
下一篇继续:《Agent 工具调用工程化:把 Tool Runtime 做扎实》。
希望这篇文章对你有所帮助、有所借鉴。