CUDA OOM 不只是"显存不够"
这篇文章解决什么问题
CUDA out of memory 只说明某次分配失败,不说明根因。可能是权重无法装入、attention激活峰值、VAE Decode、碎片、多个模型并存、缓存增长,或 CPU offload 反而耗尽系统内存。直接把分辨率减半虽然常能运行,但会掩盖真正瓶颈。
先给结论:根据 traceback 和节点边界定位失败阶段,再验证权重、激活、工作区、缓存和碎片等候选。阶段决定先查哪里,不直接证明根因。
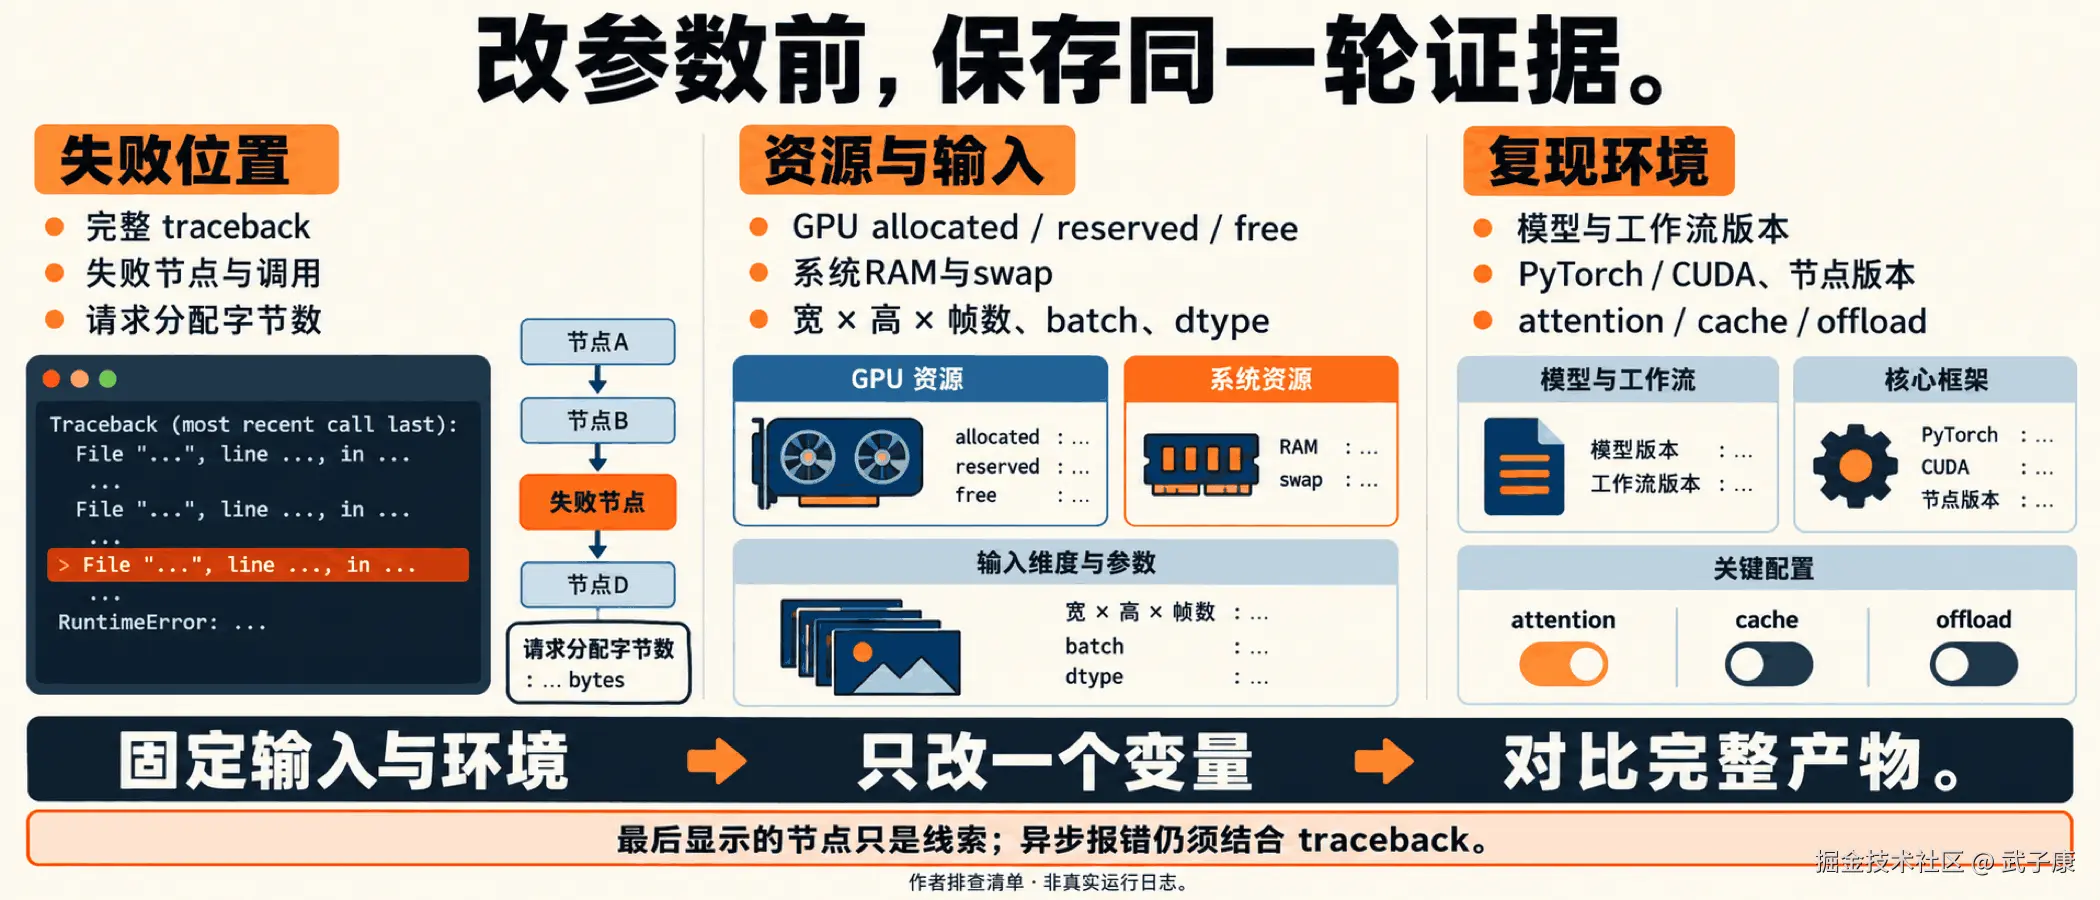
先保存完整错误
不要只截最后一行。保存:
- 完整 traceback;
- 哪个节点;
- 请求分配多少;
- GPU 总量、allocated、reserved、free;
- ComfyUI 启动参数;
- PyTorch/CUDA版本;
- 工作流 JSON;
- 模型与 LoRA;
- 分辨率、帧数、steps、CFG;
- 是否启用 attention/cache/offload;
- 系统 RAM 和 swap。
错误发生前最后一个节点是阶段线索,还需 traceback 确认;异步 CUDA 错误、预览和插件日志可能使显示时点与失败调用不一致。
按时间点分类
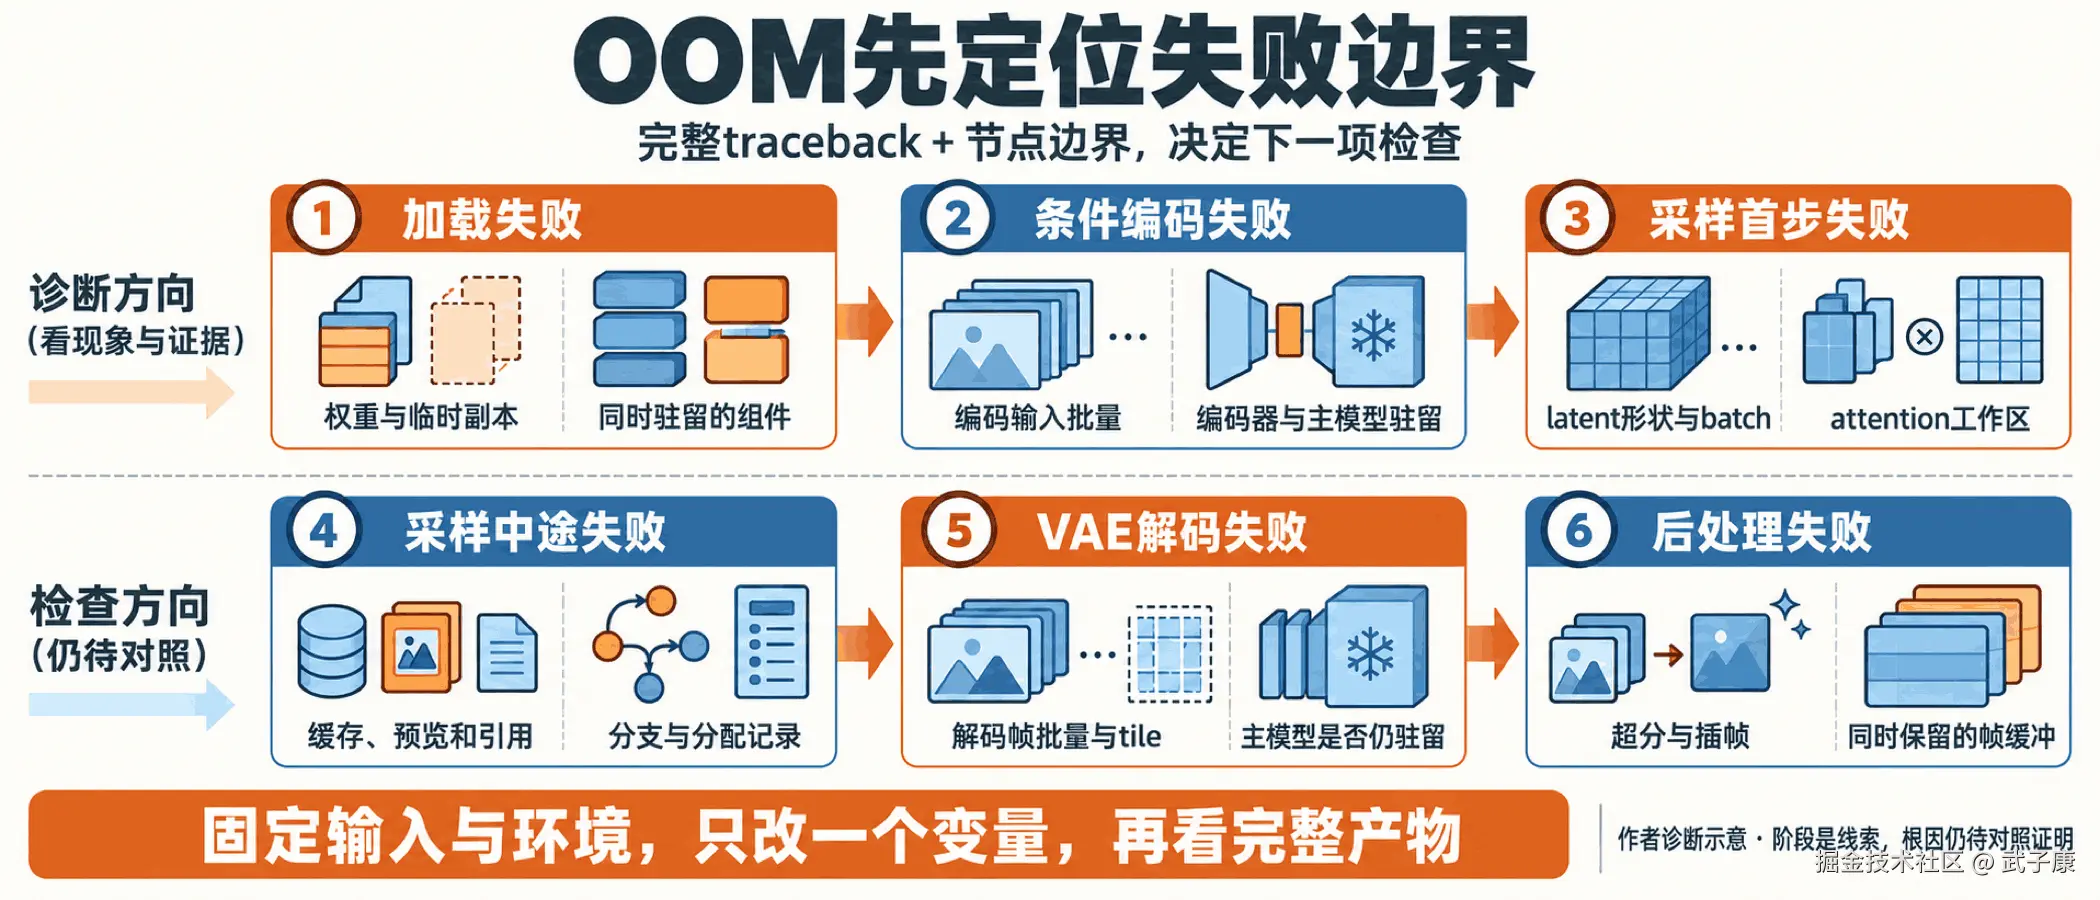
加载阶段 OOM
候选原因(以下都需要目标环境证据):
- BF16主模型权重本身超过可用显存;
- Wan双专家同时放入 GPU;
- Text Encoder、VAE和DiT同时驻留;
- loader先构建 FP32再转低精度;
- 量化加载时保留原权重副本;
- LoRA合并产生完整高精度副本;
- 另一个 ComfyUI进程占用显存。
处理顺序:
- 检查
nvidia-smi其他进程; - 使用模型官方低精度或可信量化;
- Text Encoder/VAE分阶段加载;
- 确认 loader不会先复制完整权重;
- 对双专家采用官方 offload;
- 减少同时加载的后处理模型;
- 重启进程排除残留引用。
如果已证明失败是纯权重驻留且加载不依赖目标形状,降分辨率不会减少那部分权重;不要仅凭"加载节点报错"提前下这个结论。
条件编码 OOM
常见于:
- 大文本编码器;
- Vision Encoder高分辨率输入;
- 批量参考图;
- VAE Encode一次处理长视频;
- 主模型已先驻留。
解决:
- 先编码条件并缓存 embedding,再卸载编码器;
- 减少参考图 batch;
- 输入视频分段编码;
- 使用官方支持的 CPU offload;
- 避免在 GPU同时驻留主模型;
- 检查图像是否意外被放大到超大尺寸。
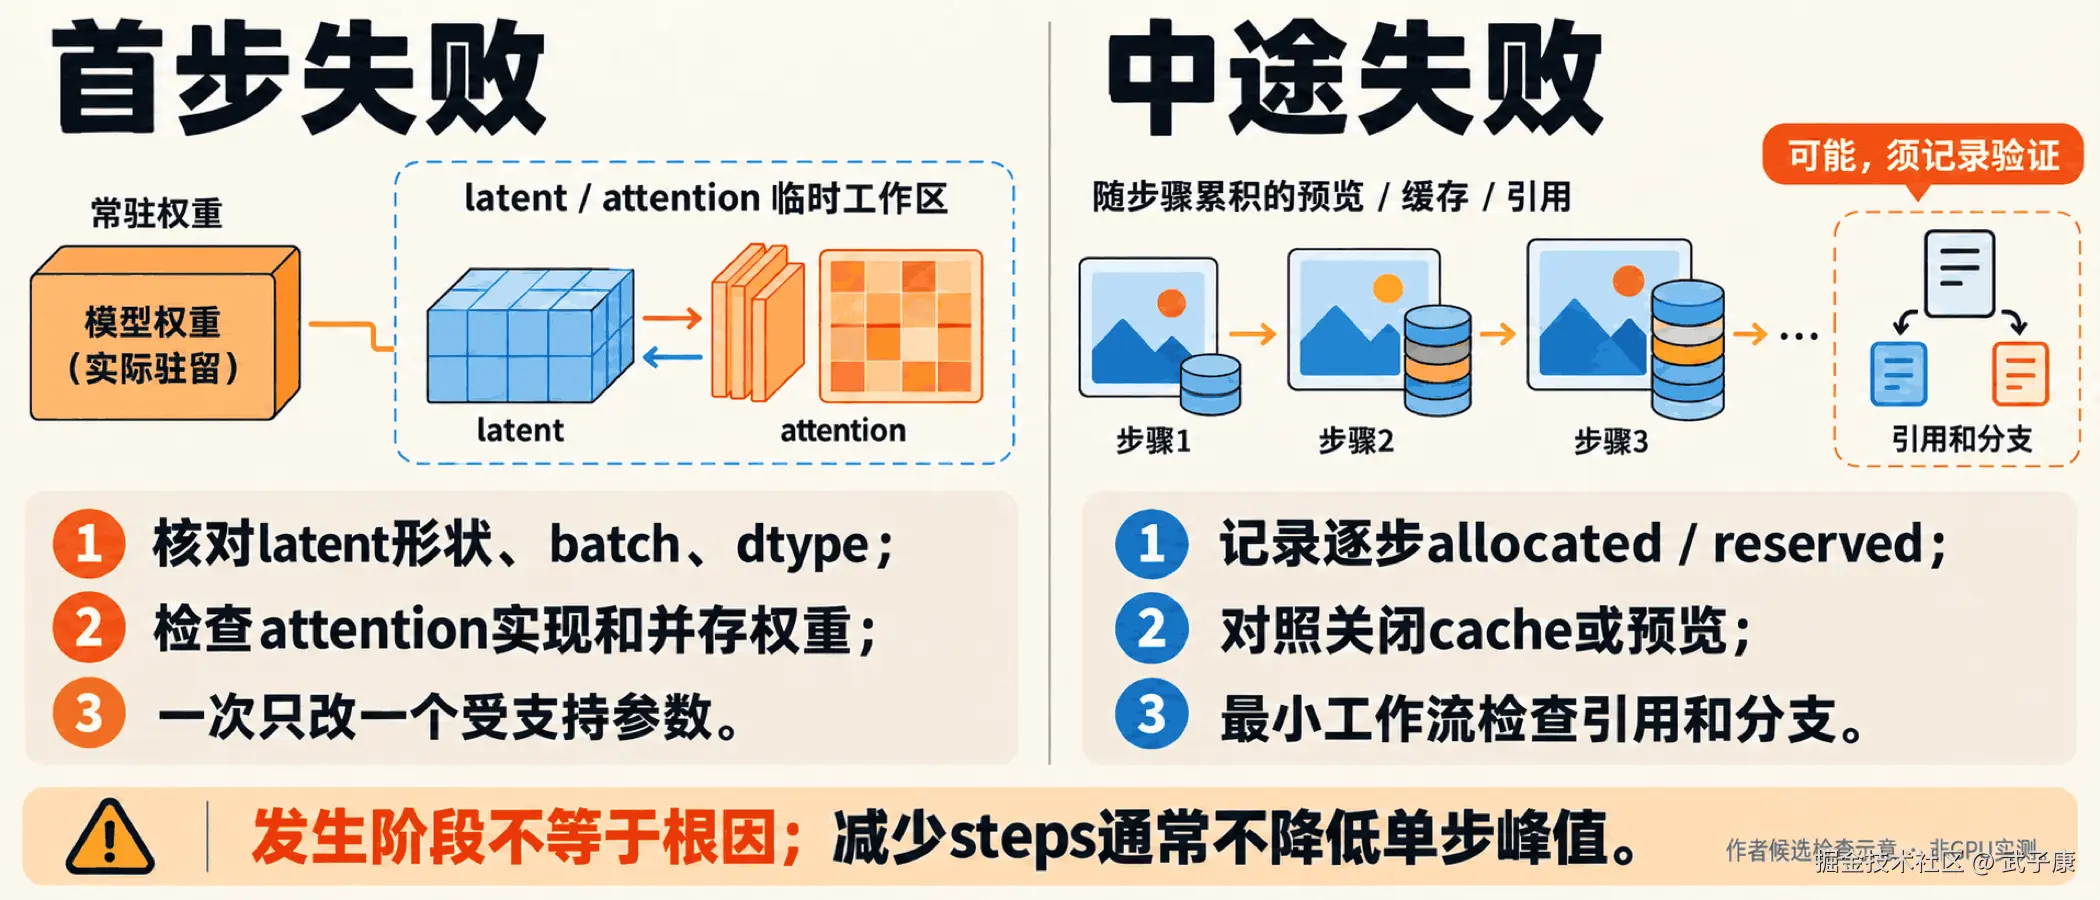
采样第一步 OOM
这可能与激活或工作区峰值有关,也可能叠加常驻权重、外部进程占用等因素。先核对以下变量:
text
latent T × H × W
patch/token
attention type
hidden width
CFG batch
dtype
expert
处理:
- 减少宽高或帧数;
- 使用官方支持的 Flash/Sage/分块 attention;
- 降低 CFG双分支内存,若模型支持;
- 减小 batch;
- 仅在目标模型和节点支持时启用 block swap(把暂不用的模型块移到主机内存),同时记录主机内存与传输代价;
- 选择更高压缩或更小模型;
- 检查节点是否意外重复 batch/latent。
减少 steps通常不会降低单步峰值,只减少时间。
采样中途 OOM
如果前几步成功,后面才 OOM,怀疑:
- cache 保存越来越多特征;
- 自定义节点保留每步 latent;
- preview/日志积累 GPU tensor;
- attention backend内存泄漏;
- Python列表引用;
- 碎片;
- 某些 timestep走不同专家/分支;
- 动态 shape触发新工作区。
做法:
- 关闭 TeaCache/MagCache等缓存;
- 关闭中间预览;
- 记录每步 allocated/reserved;
- 使用 PyTorch memory snapshot;
- 固定 shape;
- 更新或回退相关节点;
- 最小工作流复现;
- 不要把
empty_cache()当根治。
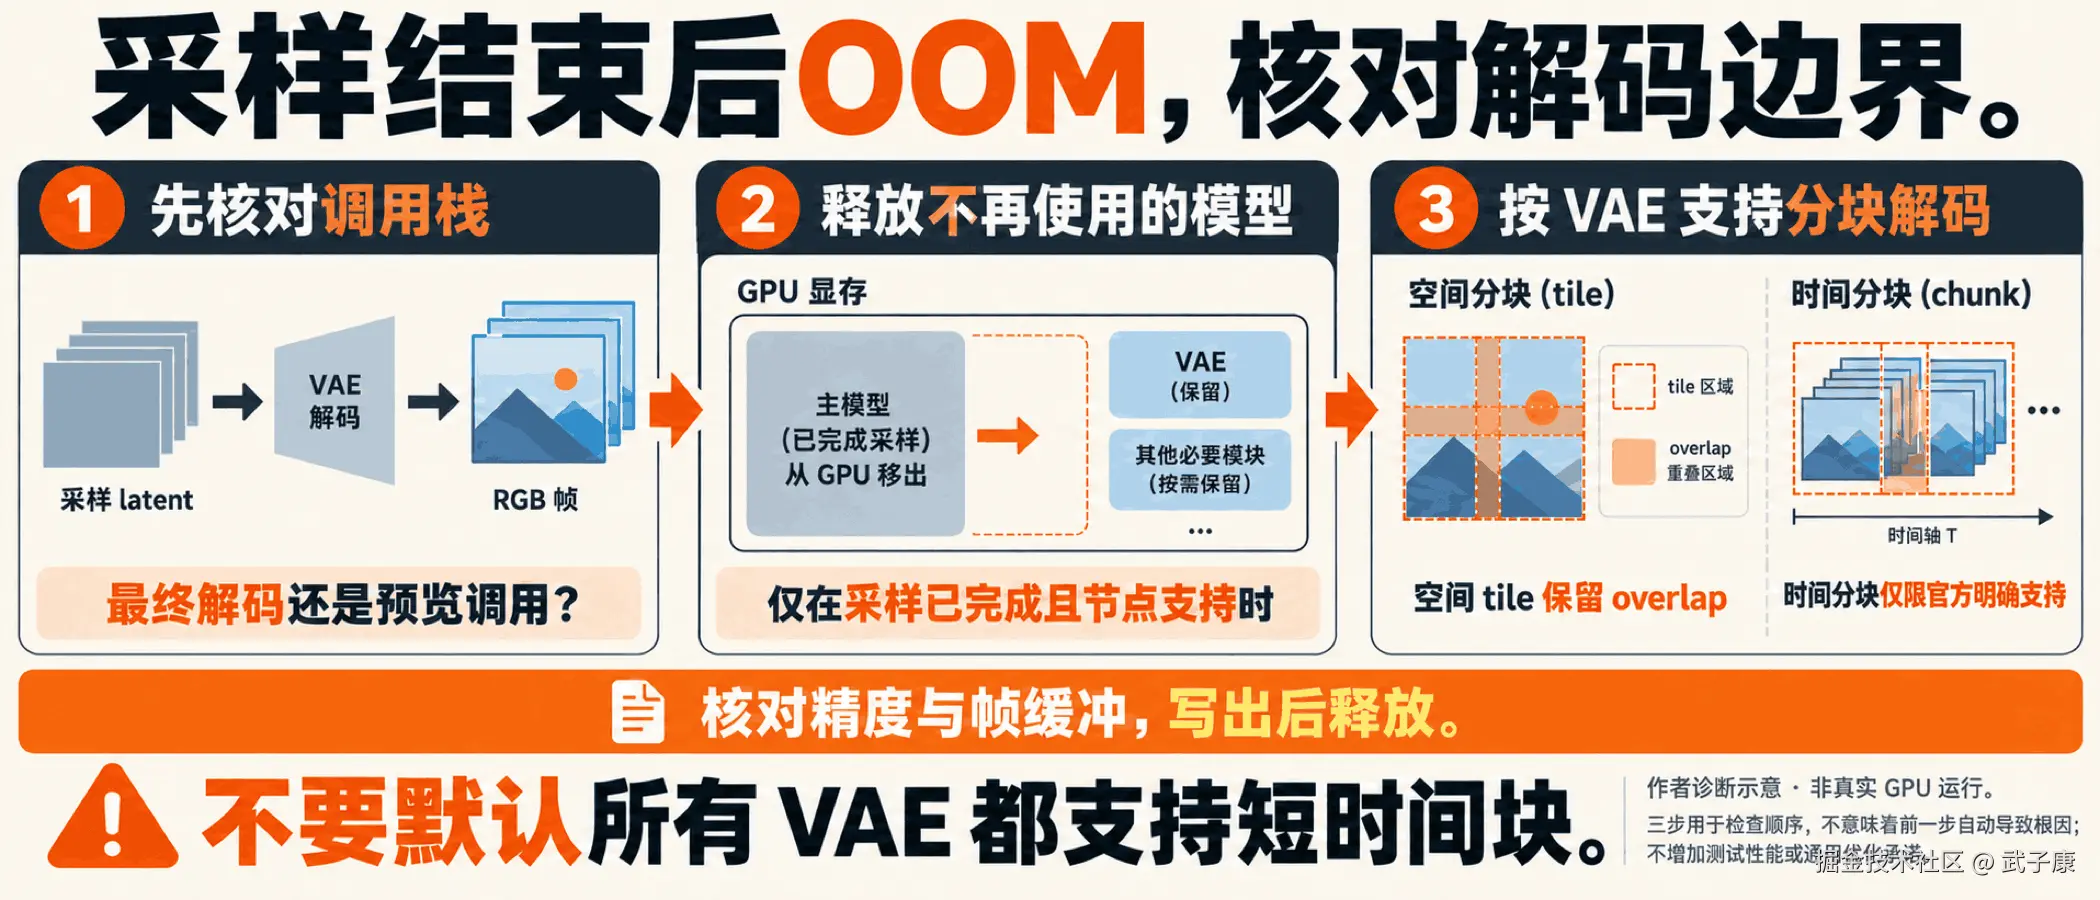
VAE Decode OOM
症状:采样完成,进度接近100%,在解码节点失败。
候选原因:
- RGB域激活;
- 一次解码全部帧;
- 主DiT仍常驻;
- tile关闭或过大;
- temporal chunk过长;
- VAE使用FP32;
- 输出帧被批量保留。
处理顺序:
- 在解码前卸载主模型与编码器;
- 使用官方 tiled VAE;
- 逐步减小 spatial tile;
- 仅在该 VAE 官方实现允许时使用 temporal tiling/chunk;
- 增加 overlap以减少接缝,但留意内存;
- 按该 VAE 官方支持选择精度,NaN 时单独核对数值稳定性;
- 流式写出帧,避免全部保留。
量化DiT只有在它仍占GPU导致叠加时才间接有用。
后处理 OOM
超分和插帧常被忽略。解决:
- 超分按帧或tile;
- 插帧分段;
- 每段写盘后释放;
- 不同时持有原帧、2x超分和插值帧;
- 后处理模型与生成模型分进程;
- 使用CPU编码,避免GPU编码缓冲叠加。
显存碎片
下面 PyTorch 片段是目标 CUDA 环境的诊断提示,本次没有安装或执行 PyTorch,没有采集真实 GPU 数据。
PyTorch缓存分配器可能保留分裂块。观察:
python
import torch

print(torch.cuda.memory_summary())
snapshot = torch.cuda.memory_snapshot()
重点区分:
- active bytes;
- inactive split;
- reserved;
- 大块请求失败;
- 调用栈。
PyTorch官方提供 CUDA memory management说明和快照工具。^1^ 环境变量调参必须基于当前版本文档,不应复制多年以前的固定值。
empty_cache() 的正确位置
下列片段未运行,变量由真实应用提供,不能直接当作独立最小程序。
它可释放未使用缓存块给驱动,适合阶段切换后且已删除对象:
python
del model_or_tensor
import gc
gc.collect()
torch.cuda.empty_cache()
若仍有引用,释放无效;若下一阶段马上需要相同尺寸,频繁清空反而增加分配成本。
CPU RAM 与 Swap
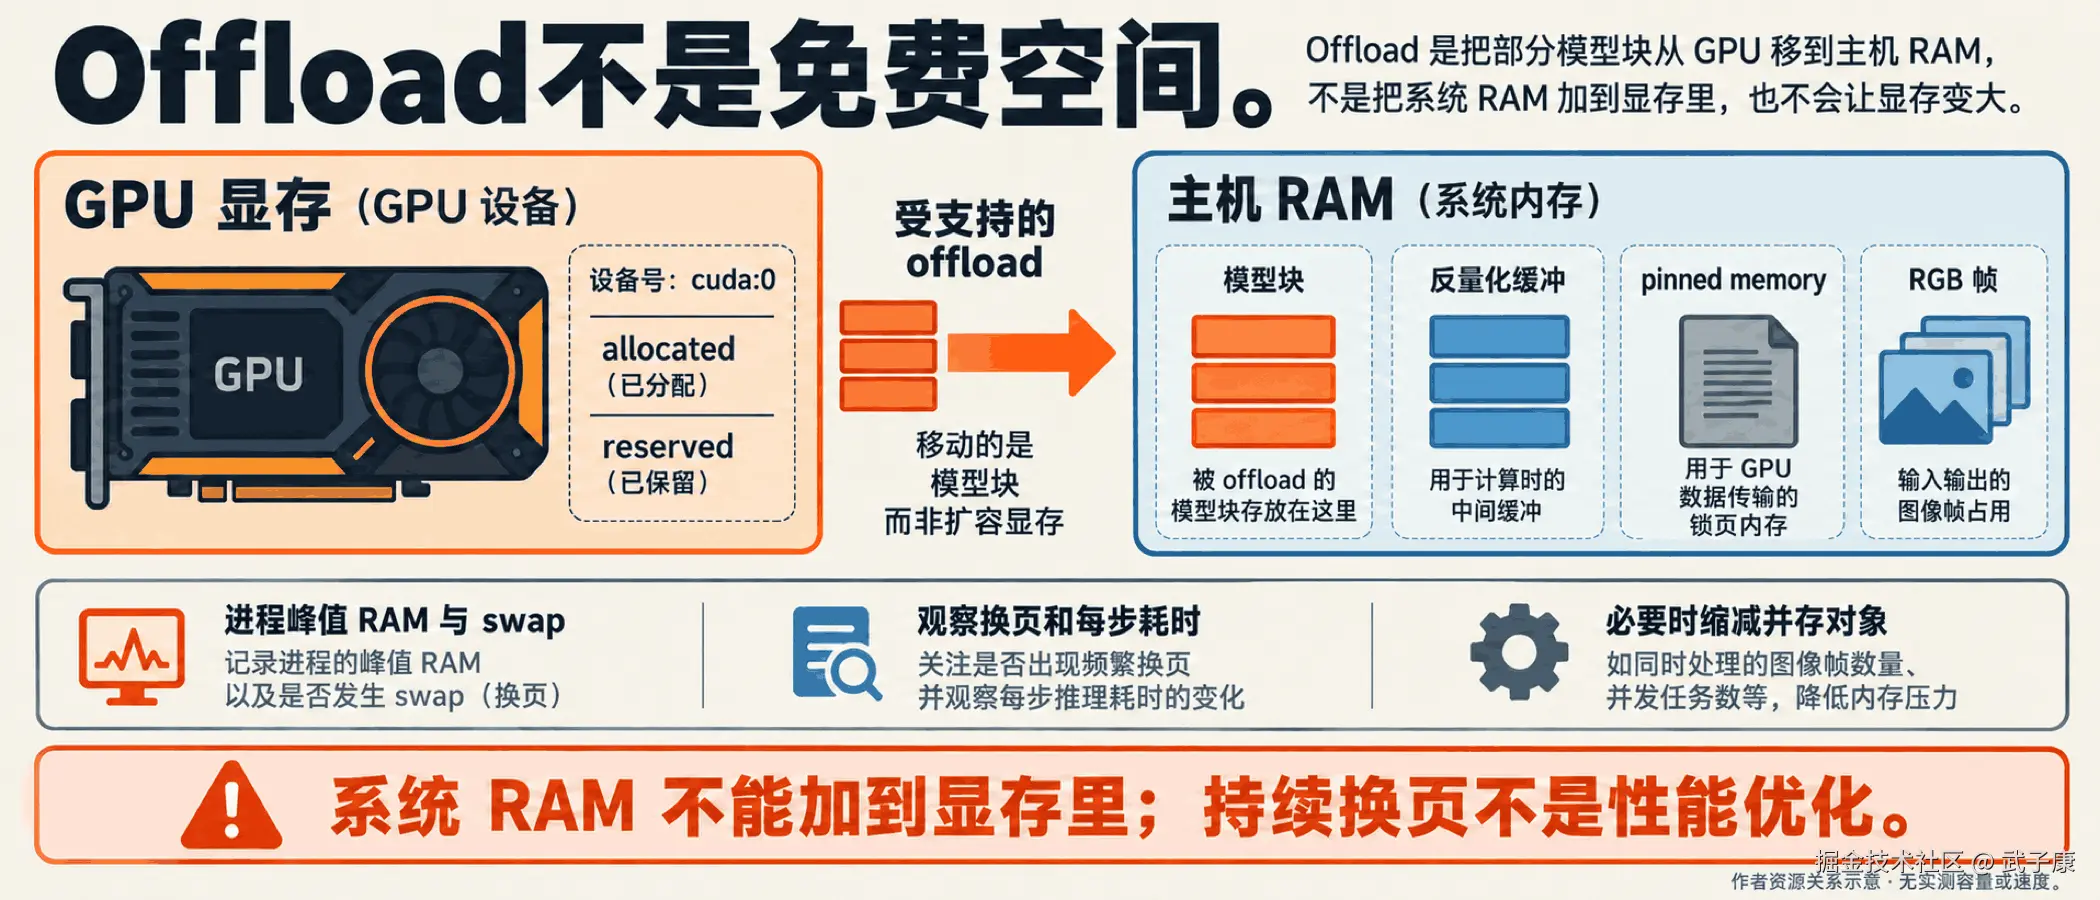
Offload不是免费空间。两个大模型、量化源文件、反量化缓冲、pinned memory和RGB帧可能耗尽系统RAM。症状:
- GPU利用率低;
- 磁盘持续读写; -系统卡顿;
- 每步时间越来越长;
- 进程被OS杀死而非CUDA OOM。
记录进程峰值主机内存和交换空间用量。Windows 分页文件可作容量保护;持续换页会拖慢生成,不能当性能优化。
最小复现法
从失败工作流复制:
text
一个模型
一个prompt
最小帧数
最小合法分辨率
官方VAE
无LoRA
无cache
无后处理
逐项加入:
text
目标分辨率
→ 目标帧数
→ LoRA
→ 量化
→ cache
→ 后处理
第一次失败的增量最有信息。
OOM处置矩阵
| 类型 | 降分辨率 | 量化权重 | Attention优化 | Offload | VAE Tile |
|---|---|---|---|---|---|
| 已证实纯权重加载 | 不减权重 | 可核对 | 一般非首项 | 可核对 | 非首项 |
| 采样激活候选 | 可核对 | 间接 | 可核对 | 间接 | 非首项 |
| VAE解码候选 | 可核对 | 间接 | 依实现 | 可核对 | 依官方支持 |
| 后处理候选 | 可核对 | 对后处理模型 | 依模型 | 可核对 | 依模型 |
| 碎片/泄漏待证 | 不能据此归因 | 不能据此归因 | 不确定 | 不确定 | 不确定 |
把失败阶段和根因分开记
建议一条记录只回答三个层次的问题:发生了什么、发生在哪个可识别边界、还缺什么证据。完整异常确认本次分配失败,调用栈和节点关联帮助识别边界,后续对照才处理原因。假设进度条显示采样完成,但栈顶仍在某个预览解码函数,记录应写"预览解码调用失败",不能自动并到最终 VAE 解码。反过来,栈顶在解码函数也不能直接证明模型已卸载或解码激活就是唯一占用。
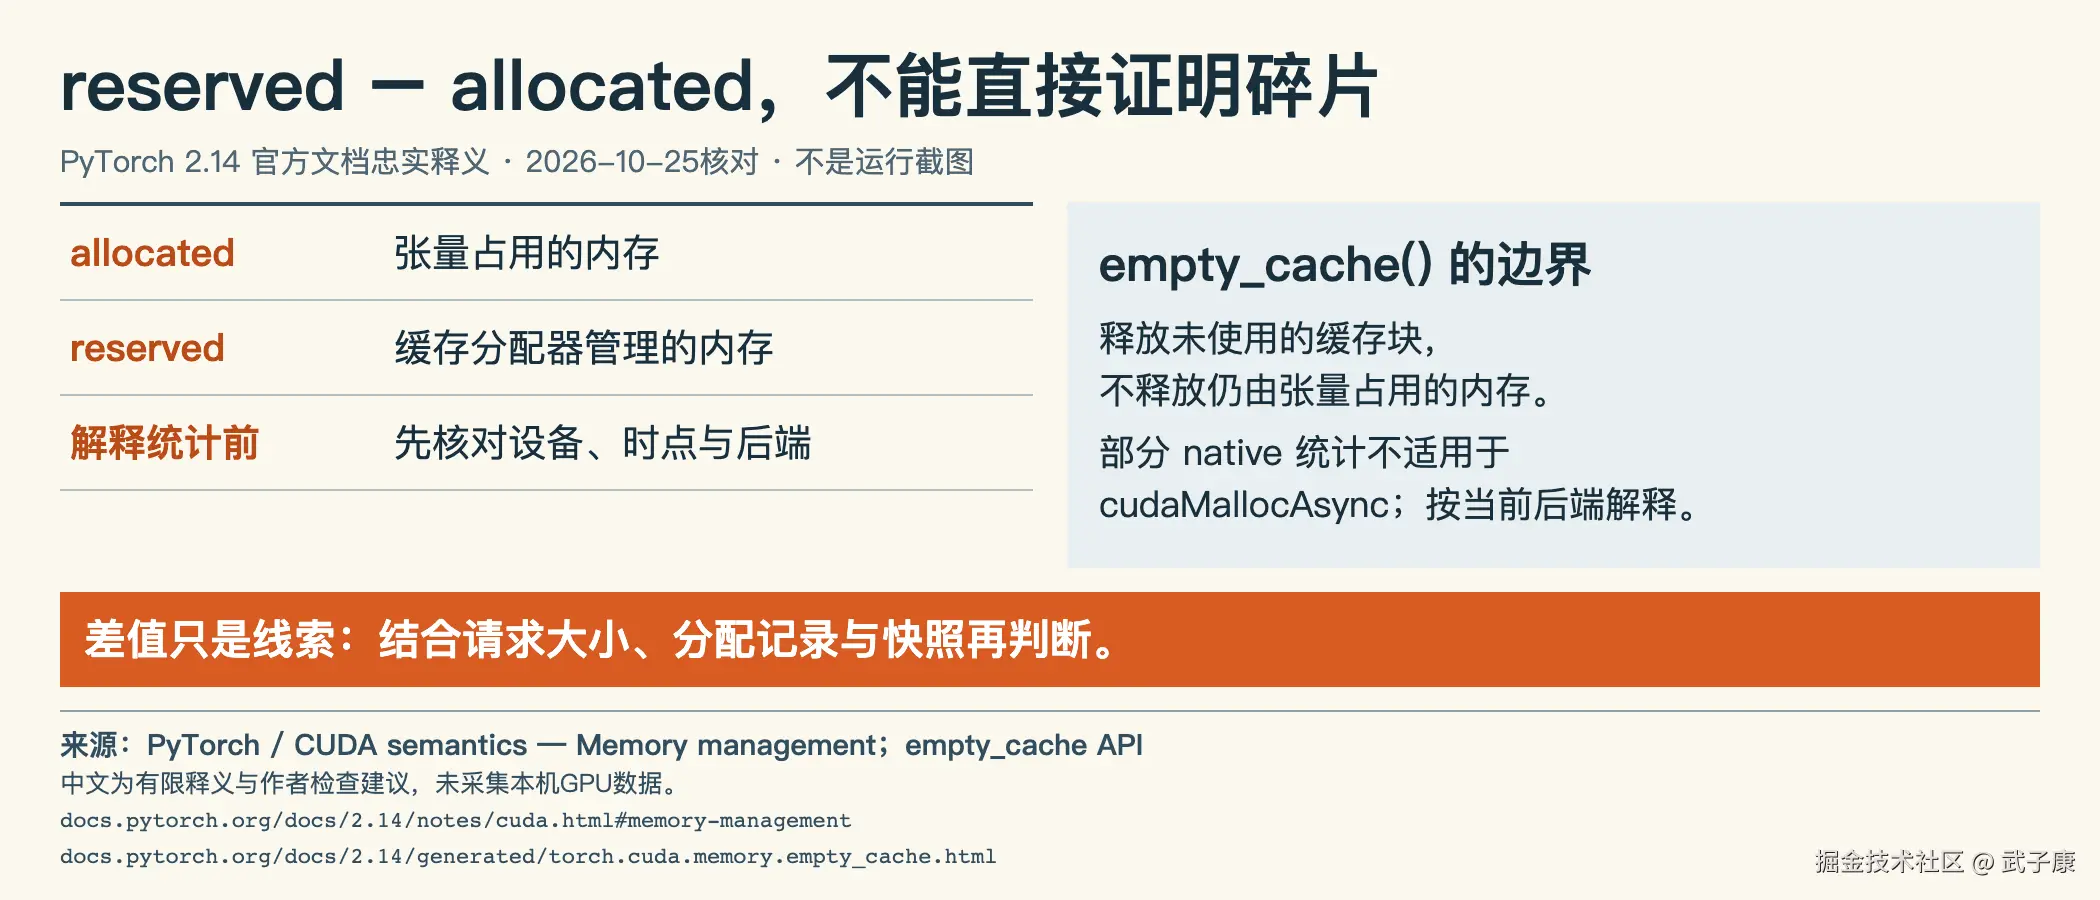
数值必须注明单位和工具。PyTorch allocated 描述张量占用,reserved 描述缓存分配器管理的内存,不等于同一时刻驱动报告的全部设备占用。其他 CUDA 库、其他进程和某些直接分配可能不在这份统计里。不同设备、不同采样时点的数字不能相减;主机 RAM 也不能合并成显存。驱动 free 较多而分配失败时,先保留完整错误、设备号和请求大小,再核 allocator 的后端、统计语义与分配记录。^2^
reserved 减 allocated 只是一个差值,不是"可立即用于任何大请求的连续块",也不是碎片证明。inactive split 可以提供另一条线索,仍需结合分配器后端与快照解释;采用 cudaMallocAsync 时,一些 native 分配器统计的含义不适用。不要把不同后端的数字直接套到同一阈值。没有这些证据,就把碎片写在候选栏,根因栏保持未知,避免把错误诊断传播给下一位维护者。
最小例:校验记录,不替 GPU 下结论
下面程序只用 Python 标准库处理作者构造的字典。六个阶段是本文的检查分类,不是 ComfyUI 的标准事件协议。输入已经具备完整字段,缺键会抛出 KeyError;真实日志的时间戳、设备关联、后端语义和字段缺失处理,需要调用方另做适配。数值统一为 MiB,并假设同一设备同一时点。程序不读日志,不启动模型,也不测显存。
这个例子的用途是在写故障单时防止两种错误:不一致的数值记录仍参与判断,以及一个差值直接变成已证实根因。非有限、负数、类型错误和超出声明关系的观察被拒绝。记录成立后只给出下一项检查方向,无论在哪个阶段失败,root_cause 都保留 UNKNOWN。对于没有声明 OOM 的记录,结果只写没有声明,不把它扩大成一次真实任务成功。
在包内 examples 目录运行:
bash
python3 check_oom_record.py完整程序:
python
"""Finite author fixtures, not a CUDA monitor or an OOM root-cause detector."""
import math

NEXT = {
    "load": "check_weight_copies_and_other_processes",
    "condition": "check_encoder_batch_and_residency",
    "sample_first": "check_latent_shape_and_attention_workspace",
    "sample_middle": "compare_cache_preview_and_branch_records",
    "decode": "check_decoder_batch_tiles_and_residency",
    "postprocess": "check_upscale_interpolation_and_frame_buffers",
}

def inspect(record):
    # shortcut: complete author dictionaries only; add an adapter for real logs.
    stage = record["stage"]
    if stage not in NEXT:
        raise ValueError("unknown_stage")
    if type(record["oom"]) is not bool:
        raise ValueError("oom_must_be_bool")
    fields = ("total_mib", "allocated_mib", "reserved_mib", "inactive_split_mib")
    values = [record[key] for key in fields]
    if any(type(v) not in (int, float) or not math.isfinite(v) or v < 0 for v in values):
        raise ValueError("invalid_memory_observation")
    total, allocated, reserved, split = values
    if not allocated <= reserved <= total or split > reserved:
        raise ValueError("inconsistent_memory_observation")
    return {
        "status": "DECLARED_OOM" if record["oom"] else "NO_DECLARED_OOM",
        "stage": stage,
        "reserved_minus_allocated_mib": reserved - allocated,
        "next_check": NEXT[stage],
        "root_cause": "UNKNOWN",
    }

def fixture(stage, **changes):
    row = dict(stage=stage, oom=True, total_mib=24000, allocated_mib=12000,
               reserved_mib=20000, inactive_split_mib=4000)
    row.update(changes)
    return row

def rejects(row, expected):
    try:
        inspect(row)
    except ValueError as exc:
        assert str(exc) == expected
    else:
        raise AssertionError("invalid fixture accepted")

def main():
    for stage in NEXT:
        result = inspect(fixture(stage))
        assert result["stage"] == stage and result["root_cause"] == "UNKNOWN"
        print(f"fixture_stage={stage} next={result['next_check']} root_cause=UNKNOWN")
    gap = inspect(fixture("sample_middle"))
    assert gap["reserved_minus_allocated_mib"] == 8000
    print("fixture_gap_mib=8000 fragmentation=NOT_PROVEN")
    assert inspect(fixture("load", oom=False))["status"] == "NO_DECLARED_OOM"
    assert inspect(fixture("decode", inactive_split_mib=0))["root_cause"] == "UNKNOWN"
    rejects(fixture("unknown"), "unknown_stage")
    rejects(fixture("load", oom=1), "oom_must_be_bool")
    rejects(fixture("load", allocated_mib=-1), "invalid_memory_observation")
    rejects(fixture("load", reserved_mib=float("nan")), "invalid_memory_observation")
    rejects(fixture("load", total_mib=float("inf")), "invalid_memory_observation")
    rejects(fixture("load", allocated_mib=21000), "inconsistent_memory_observation")
    rejects(fixture("load", inactive_split_mib=21000), "inconsistent_memory_observation")
    print("self_check=16_assertions_passed scope=author_fixture_only")

if __name__ == "__main__":
    main()
本次真实执行的标准输出如下,退出码为 0,标准错误为空。它是 CPU 上的有限教学数据校验,不是 CUDA 故障重现:
text
fixture_stage=load next=check_weight_copies_and_other_processes root_cause=UNKNOWN
fixture_stage=condition next=check_encoder_batch_and_residency root_cause=UNKNOWN
fixture_stage=sample_first next=check_latent_shape_and_attention_workspace root_cause=UNKNOWN
fixture_stage=sample_middle next=compare_cache_preview_and_branch_records root_cause=UNKNOWN
fixture_stage=decode next=check_decoder_batch_tiles_and_residency root_cause=UNKNOWN
fixture_stage=postprocess next=check_upscale_interpolation_and_frame_buffers root_cause=UNKNOWN
fixture_gap_mib=8000 fragmentation=NOT_PROVEN
self_check=16_assertions_passed scope=author_fixture_only
16 个断言由六种阶段映射、一个差值、一个无 OOM 声明、一个零 inactive split 以及七种拒绝数据构成。差值样例故意把 reserved 设为 20000、allocated 设为 12000,得到 8000;它仍输出碎片未证明。将 inactive split 改为零也不会产生"没有碎片"结论。这样的空白是输出契约的一部分:程序在证据不足时停止归因,而不是靠阶段名称补猜。
从记录推进到一个可复核的对照
先保留失败任务的完整配置,再复制成诊断任务。两者用不同的运行编号,原日志只读保存,工作流、组件文件哈希、输入、seed、节点版本和启动方式都随任务编号关联。若只是把日志截短或换成一句"显存不够",别人无法区分模型组合错误、并存资源不足和形状变化。第一次运行也可能伴随编译或加载,冷启动与后续驻留运行应分开说明,不把热启动结果覆盖冷启动失败。
第一项对照必须针对失败边界。加载失败时,可先核外部进程和同时驻留组件,减少一个并存组件后重跑;采样首步失败时,可固定组件并只改合法帧数或 batch;中途失败时,可只关预览或一种缓存;解码失败时,可保持最终 latent 和其他配置不变,只使用官方支持的解码方式。每一项都先定义改动与期望观察,不能一次换 VAE、精度、节点和分辨率,然后把成功归功于其中一个开关。
失败日志也要保留。某项调整跑通,说明在该次输入和配置下完整路径可运行;它没有证明原来的故障永远不会重现,也没有单独证明碎片。若修改同时减少了模型驻留和激活量,成功仍有多个解释,应继续缩小变量。某项调整仍失败时,记录实际失败边界是否迁移,而不是把它当无信息的失败删除。边界从采样移到解码,往往意味着先前瓶颈消退,但完整产物还没有通过。
检查真实内存曲线时,记录采样间隔和完成边界。Python 函数返回与 GPU 完成可能不同,稀疏采样也可能漏过短暂峰值;因此"监视器没看到峰值"不能直接否定激活或工作区候选。需要定位分配栈时,用 PyTorch 官方快照能力按目标版本采集,并说明它看到的范围;它并不能自动解释其他库的所有显存分配。本文没有执行这些采集,也没有提供任何模型峰值或节省百分比。^1^
常见处置为什么需要附条件
处置矩阵表示优先核对方向,不是保证收益的评分表。量化主要改变权重形式,加载器的反量化缓冲与临时副本仍可能抬高峰值。Offload 可能降低某阶段 GPU 驻留,却增加主机内存、传输与等待;系统被杀死时,还要读取操作系统证据,不能把退出一概归为 CUDA OOM。换 attention 实现时,除了显存还应核模型、形状、设备与数值兼容性,不从论文优势推断本机一定可用。
VAE 分块要尤其谨慎:空间和时间的拆分方式受该模型上下文依赖、节点实现和官方模板约束。缩小 temporal chunk 不是所有视频 VAE 的安全通用操作,可能减少可用上下文并产生画面异常。若目标官方指南规定不采用短时间分块,就先遵循该配置,再处理模型驻留或空间维度等其他变量。解决容量问题不能以明显失真的输出算成功,数值和图像检查应成为完成条件,而不是 OOM 消失后就结束诊断。
缓存清理同样需要对象生命期证据。先删除不再使用的对象,并确认没有列表、回调或插件保留引用,才讨论释放未使用缓存。频繁调用 empty_cache 不会替仍活跃的张量释放空间,也不能作为"修复泄漏"的证明。重启后能暂时运行是一个值得记录的对照,但它同时改变了状态、缓存和并存资源;要解释原因,还需比较之前和之后的记录,而不是把重启当成长期策略。
交接时留下四类材料
第一类是输入条件:工作流与模型组件哈希、节点版本、目标宽高帧数、dtype、seed、采样器与启动参数。第二类是失败证据:完整 traceback、请求分配大小、设备号、失败边界、同一时点的资源观察和观察工具。第三类是单变量对照:改了哪一个设置、对应运行编号、实际退出码、是否得到完整产物、失败是否移动。第四类是尚未证明的解释:碎片、引用增长、动态工作区或并存占用分别还缺哪项证据。
这四类材料可以让下一位维护者继续推进,而无需重复猜测。短帧成功不能替目标长帧通过,小分辨率成功不能替目标规格通过,采样完成不能替解码与写入通过。最终验收还应核视频实际帧数、尺寸和可读性,以及质量约束;这些目标环境检查都没有在本文执行。
本文结论
CUDA OOM 是分配失败信号。加载阶段先查权重与并存,采样第一步先查 token 与 attention,中途查缓存、分支和分配记录,VAE 阶段查解码批量,后处理查帧缓冲。它们都是检查方向;真实根因要由固定环境下的完整日志和对照支持。
参考资料
Footnotes
-
Understanding CUDA Memory Usage,PyTorch,持续更新,访问日期 2026-10-14。docs.pytorch.org/docs/2.14/t... ↩ ↩2
-
CUDA Semantics,PyTorch,持续更新,访问日期 2026-10-14。docs.pytorch.org/docs/2.14/n... caching allocator 和设备语义。 ↩