最近在开发 OneXAI 的智能化能力,重构了 OneXAI 的底层架构。新的 OneXAI 架构实现了一个智能化平台需要的几乎所有能力:智能体、知识库、工具、MCP、SKILL、模型等。而且每一个模块都是可插拔的。目的是提供一种零代码的方式,即使你不懂 Agent 开发,也能轻松、快速的贡献一些智能化场景和能力。
在新架构中,OneXAI 更多是作为一个智能编排引擎,将 SKILL、知识库、智能体、工具、MCP 等根据需要编排在一起。为了测试编排的效果,OneXAI 提供了 /ailab 命令用来对 AI 资源进行编排测试。/ailab 指令可以编排很多资源,例如:agent、mcp、skill,甚至包括值班模块。
作为当下最火的 SKILL,我重点进行了 SKILL 加载和执行能力的测试。在测试过程中发现了各种问题,例如:
在解决这些问题的过程中,不断从代码层面深入去了解 SKILL 的工作原理,随着了解的深入,不断的重构、优化代码,最终使得 OneXAI 成功支持了 SKILL 能力。
网上有很多介绍如何编写 SKILL 的文档,这些文档很有用。但很少有介绍 SKILL 原理的文章。本篇文章,通过介绍 SKILL 的实现原理,希望可以让你对 SKILL 有更多充分的认识。
SKILL 介绍
Skill 是一个开放标准的文件夹,包含一套告诉 AI 如何处理特定任务或工作流的指令。它是目前最强大的 AI 定制方式之一:教 AI 一次,永久受益------不再需要在每次对话中重新解释你的偏好、流程和领域知识。 Skill 解决的核心问题:
- AI 每次遇到相同任务,行为不稳定、结果不一致;
- 复杂流程需要反复编写相同代码,浪费时间和 token;
- 没有固定的输出格式,结果参差不齐;
在测试 OneXAI SKILL 执行能力过程中遇到的问题
以下是 OneXAI 找人智能化场景的 SKILL.md 文件内容:
markdown
---
name: domain-lead-identifier
description: 用于"找负责人/找对接人/找人/谁负责"场景。当用户需要了解某个工作、值班模块或问题由谁负责、需要对接哪个负责人时触发,通过严格流程解决"找人"类场景。
---

# 找人 (Find On-Call Person)

## 工作流程

### 步骤 1:基于文档查找负责人 (备选)**

请读取文件(使用read_file工具) references/onex-team.md 查看内容,并给出匹配的负责人。如果找不到很匹配的负责人,则进入步骤 2。

### 步骤 2:查找值班人 (优先)

1. **获取模块列表**:静默执行 `/oncall --list` 获取所有可用的值班模块及其描述。
2. **匹配模块**:根据用户的具体问题描述,与获取到的列表进行语义匹配,找出最合适的 `<module>`。
3. **获取值班人**:执行 `/duty <module>` 获取该模块的主备值班人。优先提取主值班人(列表的第一个人员)。
4. **工单创建判断**:
   - 仅当用户在上下文中**明确表达**了"拉群"、"建单"、"需要找他看问题"等意图时,直接提取问题描述作为 `<title>` (默认: "问题咨询"),执行 `/oncall <module> <title>`。
   - 若用户仅询问"谁负责",则停止操作,直接汇报值班人结果。

### 步骤 3:查询知识库 (最终兜底)

如果 **步骤 1** 和 **步骤 2** 均无结果,调用search_knowledge_base工具,查询相关对接人信息。

## 输出格式

当你向用户回复最终结果时,**必须严格遵守**以下排版规范:
- **【严禁标题】**:绝对不允许使用 `#`、`##` 等任何级别的 Markdown 标题。
- **【极简汇报】**:仅输出客观结果,**绝对禁止**输出"下一步建议"、"可选操作"、"温馨提示"等附加段落。
- **【结构化引导】**:使用加粗文本引导结果区块。

**标准输出模板:**
**匹配结果:** [简明扼要地输出值班模块名称及对应的主值班人姓名/联系方式]

## 注意事项

- **状态隔离**:每个步骤之间的工具调用结果仅作为你思考的上下文,不要将中间过程的大段 JSON 返回给用户。
- **失败兜底**:如果所有步骤均无法定位到负责人,请严格使用以下文案回复,不得随意发挥:"**查询结果:** 抱歉,暂时无法匹配到对应的负责人,请尝试提供更具体的业务线名称或使用其他途径查询。"
上面是经过调试之后的一个可用的SKILL。在沉淀出上述 SKILL的过程中,其实遇到了很多问题:
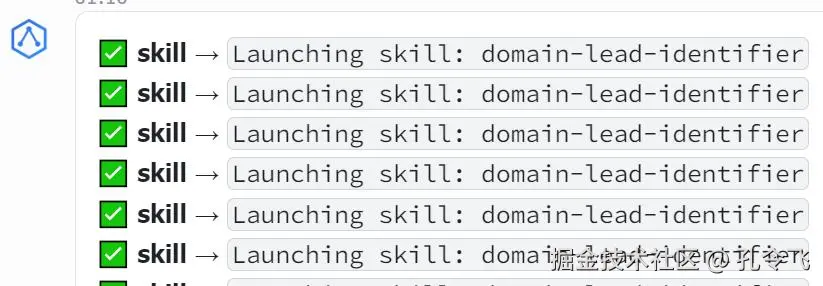
- 在最初的 SKILL.md 文件中有以下指引:
shell
## 工作流程

### 步骤 1:基于文档查找负责人 (备选)**

**请打开文档 references/onex-team.md 查看内容,并给出匹配的负责人。**
在调试的过程中,发现 LLM 根本不会打开 references/onex-team.md文档。
markdown
## 工作流程

### 步骤 1:查找值班人 (优先)

1. **获取模块列表**:静默执行 `/oncall --list` 获取所有可用的值班模块及其描述。
2. **匹配模块**:根据用户的具体问题描述,与获取到的列表进行语义匹配,找出最合适的 `<module>`。
   - *分支逻辑*:如果完全匹配不到合适的值班模块,请立即终止当前步骤,跳转至 **步骤 2**。
3. **获取值班人**:执行 `/duty <module>` 获取该模块的主备值班人。优先提取主值班人(列表的第一个人员)。
4. **工单创建判断**:
   - 仅当用户在上下文中**明确表达**了"拉群"、"建单"、"需要找他看问题"等意图时,直接提取问题描述作为 `<title>` (默认: "问题咨询"),执行 `/oncall <module> <title>`。
   - 若用户仅询问"谁负责",则停止操作,直接汇报值班人结果。

### 步骤 2:基于文档查找负责人 (备选)**

如果 **步骤 1** 无法匹配到对应的值班模块,则阅读以下 references/onex-team.md 内容,根据内容查找负责人。
基于上述 SKILL.md 发现 LLM 永远会调用 /oncall 命令尝试给出负责人信息。很难走到步骤2。
因为LLM输出的不确定性,再加上 LLM 的黑盒调用,导致上面的问题很难解决。后面我会详细介绍下 LLM 使用 SKILL 的原理。通过原理,来解释如何解决上述问题。
为什么用 Claude Code 的 SKILL 能力很丝滑?
相信大家在用 Claude Code、Cursor、CodeX、OpenCode 这类编程IDE的过程中,也会编写自己的 SKILL,你会发现使用过程很丝滑,LLM总是能很好地理解并执行 SKILL.md 文件中的内容。
之所以这样,是因为这类编程 IDE或者插件,内部其实针对性的支持了 SKILL。包括:SKILL 相关的 Prompt、内置了支持 SKILL 需要的工具,例如:文本阅读、查找、命令执行工具等。
同样,OneXAI 在集成 SKILL 的过程中,也需要支持好 SKILL。一开始 OneXAI 只是简单的将 SKILL 的 Matter 喂给了 LLM,缺失了很多内容,导致 LLM 无法正确的执行 SKILL。
SKILL 实现原理解析
这里,来详细介绍下 SKILL 的实现原理。
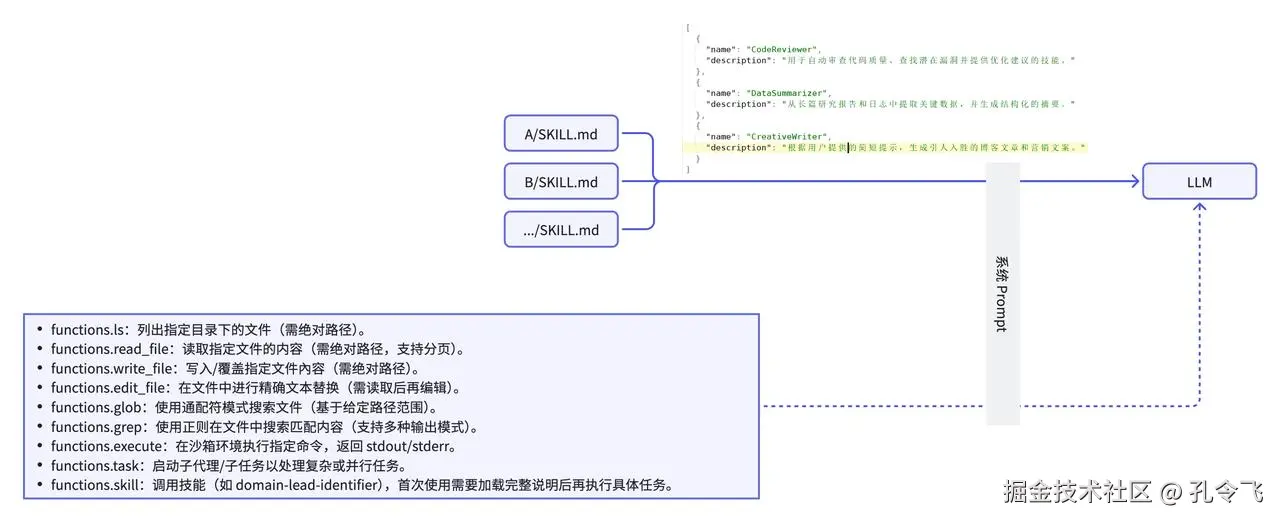
LLM 本身只有 Function Call的能力,也即根据你上报给 LLM 的工具 Tool Schema。生成工具调用的 JSON 格式的调用回复给到 LLM 客户端,由 LLM 客户端解析并执行工具调用。LLM 本身不具备调用工具的能力。当然,目前有不少 LLM 内置了工具调用的能力,例如:抓取网页等工具。但这些能力不是 LLM 本身的能力,而是 LLM 提供商封装的一层能力。
SKILL 对 LLM 其实是一个未知的概念。LLM 对 SKILL 的理解和执行其实是通过 Prompt + Tool Call 来实现的。
整个 SKILL 的 执行流程如下:
- **每次 LLM 调用添加 SKILL 系统的规范 Prompt:**在每次请求 LLM 的过程中,通过一些中间件能力自动注入 SKILL 系统关联的 Prompt,告诉 LLM 如何使用 SKILL,例如:
markdown
# Skill 系统

**如何使用 Skill(技能)(渐进式展示):**

Skill 遵循**渐进式展示**模式 - 你可以在上方看到 Skill 的名称和描述,但只在需要时才阅读完整说明:

1. **识别 Skill 适用场景**:检查用户的任务是否匹配某个 Skill 的描述
2. **阅读 Skill 的完整说明**:使用 '{tool_name}' 工具加载 Skill
3. **遵循 Skill 说明操作**:工具结果包含逐步工作流程、最佳实践和示例
4. **访问支持文件**:Skill 可能包含辅助脚本、配置或参考文档 - 使用绝对路径访问

**何时使用 Skill:**
- 用户请求匹配某个 Skill 的领域(例如"研究 X" -> web-research Skill)
- 你需要专业知识或结构化工作流程
- 某个 Skill 为复杂任务提供了经过验证的模式

**执行 Skill 脚本:**
Skill 可能包含 Python 脚本或其他可执行文件。始终使用绝对路径。

**示例工作流程:**

用户:"你能研究一下量子计算的最新发展吗?"

1. 检查可用 Skill -> 发现 "web-research" Skill
2. 调用 '{tool_name}' 工具读取完整的 Skill 说明
3. 遵循 Skill 的研究工作流程(搜索 -> 整理 -> 综合)
4. 使用绝对路径运行任何辅助脚本

记住:Skill 让你更加强大和稳定。如有疑问,请检查是否存在适用于该任务的 Skill!
有了上述 System SKILL,LLM 就能理解如何使用 SKILL。
- **提供
skill工具,使LLM加载 SKILL:**在请求 LLM 时,通过追加 SKILL System Prompt,LLM知道了如何使用 SKILL。那么你还需要提供一个工具,让 LLM 能够 List 当前的 SKILL。所以,在请求 LLM 的过程中,你的 Tool List 中,还应该提供一个能够列出当前 SKILL 列表的工具,例如:functions.skill:调用技能(如 domain-lead-identifier),首次使用需要加载完整说明后再执行具体任务。
skill 工具的描述中,其实详细列出了该skill工具可以用来执行哪些 SKILL、以及触发时机。工具描述如下:
markdown
在主对话中执行 Skill(技能)

<skills_instructions>
当用户要求你执行任务时,检查下方可用 Skill 列表中是否有 Skill 可以更有效地完成任务。Skill 提供专业能力和领域知识。

如何调用:
- 使用 <name> 标签内的完整字符串作为 Skill 名称(无需其他参数)
- 示例:
  - ` + "`" + `skill: "pdf"` + "`" + ` - 调用 pdf Skill
  - ` + "`" + `skill: "xlsx"` + "`" + ` - 调用 xlsx Skill
  - ` + "`" + `skill: "ms-office-suite:pdf"` + "`" + ` - 使用完全限定名称调用

重要说明:
- 当 Skill 相关时,你必须立即调用此工具作为第一个动作
- 切勿仅在文本回复中提及 Skill 而不实际调用此工具
- 这是阻塞性要求:在生成任何关于任务的其他响应之前,先调用相关的 Skill 工具
- 仅使用 <available_skills> 中列出的 Skill
- 不要调用已经运行中的 Skill
- Skill 内容中可能包含相对路径,需使用工具返回的 base directory 将其转换为绝对路径
</skills_instructions>

<available_skills>
<skill>
<name>
domain-lead-identifier
</name>
<description>
用于"找负责人/找对接人/找人/谁负责"场景。当用户需要了解某个工作、值班模块或问题由谁负责、需要对接哪个负责人时触发,通过严格流程解决"找人"类场景。
</description>
</skill>
</available_skills>- LLM执行过程中,调用
skill工具获取 SKILL列表: LLM在理解了如何使用 SKILL 之后,根据System Prompt,在推理的时候,会扫描当前 LLM 加载了哪些工具,发现有skill工具,根据其使用描述及当前需要的场景,会生成一个调用 SKILL 的请求:{"skill":"domain-lead-identifier"}。 - LLM 客户端执行
skill命令,返回 SKILL.md 内容:你的 Agent 收到{"skill":"domain-lead-identifier"}Tool Call 请求后会解析请求,并执行skill工具的Get方法。因为skill是 LLM 客户端注册给 LLM 的,所以skill客户端其实维护了一份映射,该映射能够根据 SKILL的名字,查找到 SKILL.md 的具体内容。OneXAI 实现了 GitLab 客户端,在具体执行Get方法时的流程如下:
go
// gitlabSkillEntry holds a loaded skill from GitLab.
type gitlabSkillEntry struct {
    frontMatter adkskill.FrontMatter
    content     string
    baseDir     string // virtual path within the repo
}并在内存中维持一个map结构:fileContents[f.Name] = string(content)。key为 SKILL的名字。Value为SKILL的Markdown内容。因为SKILL目录除了 SKILL.md 文件之外,还有 assets、references、scripts等内容。将这些内容保存在内存中, 会导致OneXAI后端需要很大的内存。所以。OneXAI会同步将上述 GitLab的 SKILL 仓库缓存在指定的 skills 目录下。保存路径格式为:<SkillsDir>/<repoKey>/<branch>[/<subDir>]/<skillDirName>/。采用这种格式的目的是为了确保 SKILL 的目录不冲突。
当 OneXAI 提供的 skill 命令之后,便会从内存中维护的 map 中返回对应 SKILL 名字的 content。在返回的时候,还会追加一个 Prompt:
markdown
正在启动 Skill:domain-lead-identifier
此 Skill 的目录:/path/to/domain-lead-identifier

# 找人 (Find On-Call Person)

## 工作流程

### 步骤 1:基于文档查找负责人 (备选)**

请读取文件(使用read_file工具) references/onex-team.md 查看内容,并给出匹配的负责人。如果找不到很匹配的负责人,则进入步骤 2。

### 步骤 2:查找值班人 (优先)

1. **获取模块列表**:静默执行 `/oncall --list` 获取所有可用的值班模块及其描述。
2. **匹配模块**:根据用户的具体问题描述,与获取到的列表进行语义匹配,找出最合适的 `<module>`。
3. **获取值班人**:执行 `/duty <module>` 获取该模块的主备值班人。优先提取主值班人(列表的第一个人员)。
4. **工单创建判断**:
   - 仅当用户在上下文中**明确表达**了"拉群"、"建单"、"需要找他看问题"等意图时,直接提取问题描述作为 `<title>` (默认: "问题咨询"),执行 `/oncall <module> <title>`。
   - 若用户仅询问"谁负责",则停止操作,直接汇报值班人结果。

### 步骤 3:查询知识库 (最终兜底)

如果 **步骤 1** 和 **步骤 2** 均无结果,调用search_knowledge_base工具,查询相关对接人信息。

## 输出格式

当你向用户回复最终结果时,**必须严格遵守**以下排版规范:
- **【严禁标题】**:绝对不允许使用 `#`、`##` 等任何级别的 Markdown 标题。
- **【极简汇报】**:仅输出客观结果,**绝对禁止**输出"下一步建议"、"可选操作"、"温馨提示"等附加段落。
- **【结构化引导】**:使用加粗文本引导结果区块。

**标准输出模板:**
**匹配结果:** [简明扼要地输出值班模块名称及对应的主值班人姓名/联系方式]

## 注意事项

- **状态隔离**:每个步骤之间的工具调用结果仅作为你思考的上下文,不要将中间过程的大段 JSON 返回给用户。
- **失败兜底**:如果所有步骤均无法定位到负责人,请严格使用以下文案回复,不得随意发挥:"**查询结果:** 抱歉,暂时无法匹配到对应的负责人,请尝试提供更具体的业务线名称或使用其他途径查询。"- **LLM 理解
skill的返回内容,并根据内容执行:**步骤4中,LLM 返回了一段文本,文本中包含了 SKILL的名字,Base Dir 及内容。LLM 会理解内容,并根据内容执行一些动作。例如:首先使用read_file工具读取references/onex-team.md文件中的内容。然后根据内容查找负责人。如果查找不到则执行/oncall指令,尝试从值班模块中查找负责人。在遵循 SKILL 的流程/指令中,LLM 需要读取references目录下的文件、需要执行scripts目录中的脚本,需要执行/oncall命令。 - **LLM 根据工具列表,请求 Tool Call:**在你向 LLM 注册你的SKILL能力的时候, 你还要同时注册 SKILL.md 中需要的一些工具,例如:文件读写类工具、脚本执行类工具、以及其他指令。OneXAI 向 LLM 注册了以下指令:
markdown
functions.ls:列出指定目录下的文件(需绝对路径)。
functions.read_file:读取指定文件的内容(需绝对路径,支持分页)。
functions.write_file:写入/覆盖指定文件內容(需绝对路径)。
functions.edit_file:在文件中进行精确文本替换(需读取后再编辑)。
functions.glob:使用通配符模式搜索文件(基于给定路径范围)。
functions.grep:使用正则在文件中搜索匹配内容(支持多种输出模式)。
functions.execute:在沙箱环境执行指定命令,返回 stdout/stderr。
functions.task:启动子代理/子任务以处理复杂或并行任务。
functions.skill:调用技能(如 domain-lead-identifier),首次使用需要加载完整说明后再执行具体任务。
functions.oncall:查询/搜索值班模块,或在建单模式下创建工单。
...
基于上述工具的Input Schema,LLM 便能够根据 SKILL.md 文档生成对应的 Tool Call。例如:读取 references/onex-team.md 文件中的内容。从而根据文件内容,来查找负责人。
- LLM 返回:LLM 在解析 SKILL.md 文件内容,并根据内容执行力流程和工具,最终将回答返回给 LLM 客户端,也即 OneXAI。OneXAI 将最终回答通过流式的方式展示给 Lark 用户。
所以,最终你可以发现,其实 LLM 并不理解,本身也不支持 SKILL。之所以 LLM 能够读懂并执行 SKILL。是因为 LLM 客户端通过一系列 Prompt + Tool 这些LLM 原始支持的 AI 资源,让LLM能读懂并执行SKILL。
OneXAI 如何支持 SKILL,并基于 SKILL 原理优化 SKILL.md 内容?
在了解了 LLM 具体是如何执行 SKILL的原理之后。OneXAI 后端提供了以下Tool,来供 LLM 读取 SKILL 目录下的文件,执行 SKILL 目录下的脚本:
markdown
functions.ls:列出指定目录下的文件(需绝对路径)。
functions.read_file:读取指定文件的内容(需绝对路径,支持分页)。
functions.write_file:写入/覆盖指定文件內容(需绝对路径)。
functions.edit_file:在文件中进行精确文本替换(需读取后再编辑)。
functions.glob:使用通配符模式搜索文件(基于给定路径范围)。
functions.grep:使用正则在文件中搜索匹配内容(支持多种输出模式)。
functions.execute:在沙箱环境执行指定命令,返回 stdout/stderr。
functions.task:启动子代理/子任务以处理复杂或并行任务。
如果,没有上述工具,你会发现 LLM 不知道如何执行 SKILL.md 中的内容,导致 LLM 重复的发送 SKILL 加载 Tool Call。
另外,在了解 references/onex-team.md 文件中的内容,其实是通过你提供的 Tool来读取的。所以在 SKILL.md 中会明确告诉 LLM 调用read_file工具来读取 references/onex-team.md 文件,尽可能避免 LLM 自猜测带来的推理结果不确定性。
另外,LLM 是通过理解 SKILL.md 内容来执行步骤的。所以,SKILL.md 中的内容最好是确定性的。不然 LLM 可能会发散去理解,带来很多不确定性。
在整个推理排障过程中,LLM 会多次调用工具,根据工具调用结果判断接下来的行为。所以,Agent 执行的可观测对整个排障帮助也很大。为了测试这些问题。部署了 Coze Loop,通过 Coze Loop 的 Trace 来查看 LLM 调用过程中的每一个输入和输出:
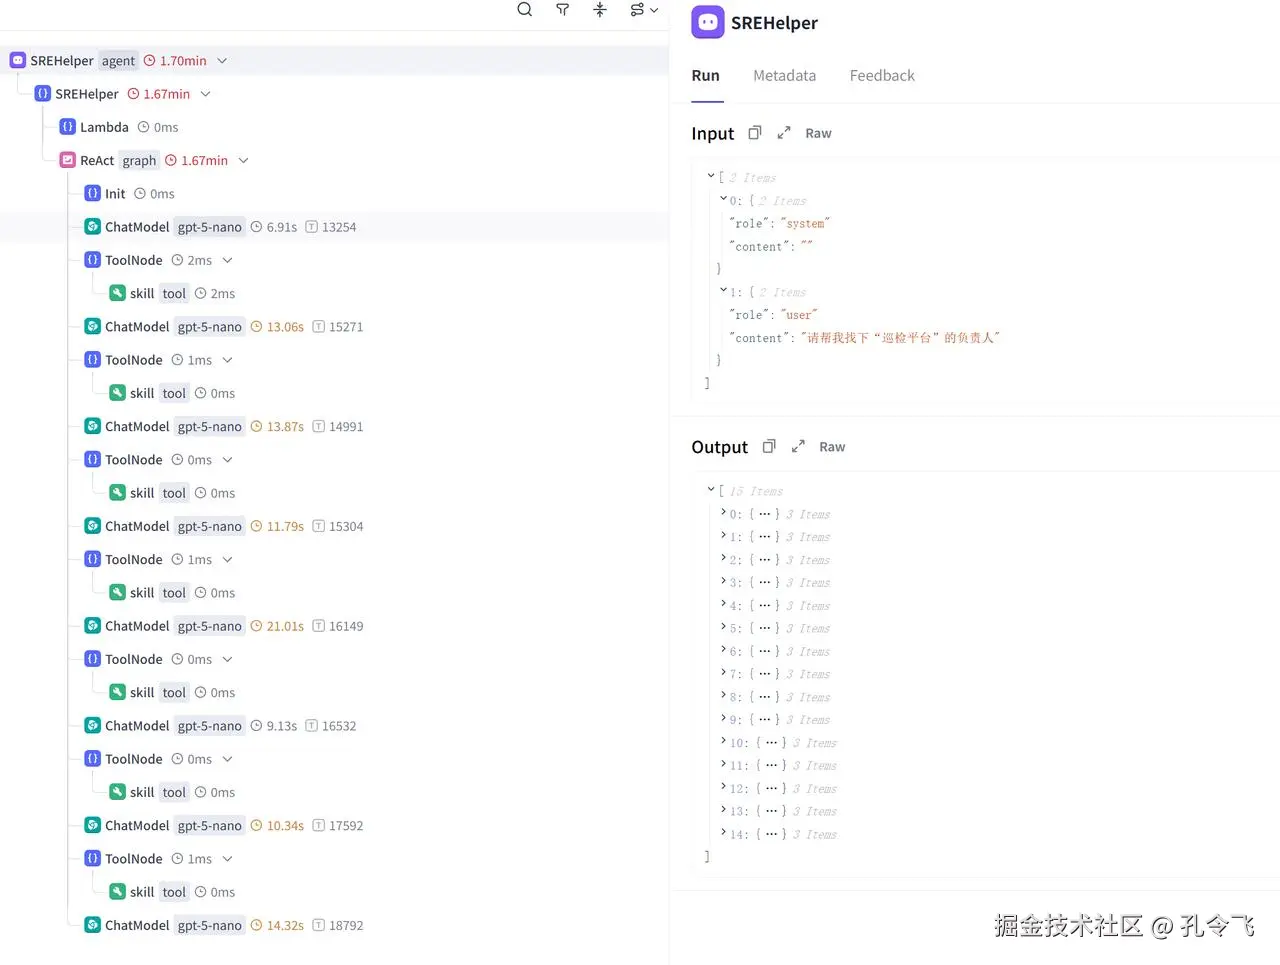
在 OneXAI 实现 SKILL 能力支持的过程中,发现最简单的是 query -> llm 的模式。但最难的是如何确保 LLM 输出的稳定性、准确性。这涉及到一整套的 AI Agent 工程化实践。例如:
- Prompt 工程;
- Agent 工程:人机协作、多 Agent 协作、图工具、链式编排、图编排、工作流编排、批处理等;
- 知识库:涉及到内容的丰富度、内容质量、切片策略、Embedding 模型选择、检索设置(Top K、Score 阈值)检索方式设置(混合检索、全文检索)等;
- MCP Tool:工具的丰富性、工具的描述的准确性、工具执行的稳定性等;
- SKILL:SKILL内容的质量等;
- AI 资源编排:如何有机、科学的将这些AI 资源编排在一起,从而形成一个能够更好执行任务的 Agent。
- 懂 LLM:除此之外,还要知道 LLM 是如何理解自然语言的。只有这样,才能给出 LLM 更加科学、稳定的指令(Prompt)。
通过深入理解 Agent 的执行原理及LLM理解自然语言的方式,最终将各种黑盒、不确定性转化为可控的 AI 工程,最终实现 Harness Engineering。
OneXAI 目前实现了基础的智能化框架,未来会基于底层的框架,借助各种 AI 工程化手段,实现Harness Engineering。聚焦内部的智能场景,将场景的稳定性、准确性做到最好。