在实时分析与 OLAP 领域,StarRocks 与 Apache Doris 是两款极具代表性的引擎。从技术渊源看,两者同源异构 :StarRocks 早期分支自 Apache Doris 项目,两者保留了高度一致的核心概念------都采用 MPP 分布式查询架构 、列式存储格式 ,并且都兼容 MySQL 协议与标准 SQL 语法。
也正因为这种天然的"血缘关系",从 StarRocks 迁移到 Apache Doris 的技术门槛与 SQL 重构成本极低。但在实际生产演进中,越来越多的团队选择将分析栈统一到 Apache Doris。
这一决策的驱动力来自于两个层次:一是纯粹在 OLAP 核心能力上的引擎对比与替换 ;二是业务范围扩展后,从单纯的"OLAP 引擎"向"HSAP 一体化架构"演进时,界定并收敛与周边系统(如 ES、向量数据库)的边界。
本文将深度融合"引擎直接替换"与"业务边界收敛"两大维度,并结合 1TB 规模性能基准测试数据,系统化拆解从 StarRocks 迁移至 Apache Doris 的完整 SOP 与避坑指南。
一、 为什么迁移?业务场景、性能 PK 与架构边界
核心 OLAP 引擎直接对比:SR vs Doris
在纯粹的 OLAP 报表、Ad-hoc 查询与高并发点查场景下,Doris 在性能、更新模型与运维体验上展现出明显优势。
我们在相同硬件配置(1 FE + 3 BE,32 vCPU / 128 GiB)和相同测试协议下,基于 Doris 4.2 与 StarRocks 4.1.1 进行了 1TB 规模(SF1000)的基准测试:
| Benchmark (SF1000) | StarRocks 4.1.1 | Apache Doris 4.2 | 性能表现与业务含义 |
|---|---|---|---|
| SSB 星型模型 | 19,566 ms | 14,779 ms | 总耗时降低 24.5%(13 条 Query 中 10 条更优,多表 JOIN 提升明显) |
| SSB-Flat 宽表 | 14,474 ms | 12,930 ms | 总耗时降低 10.7%(13 条 Query 中 10 条更优,扫描与聚合效率更高) |
| TPC-H 复杂分析 | 89,335 ms | 67,974 ms | 总耗时降低 23.9%(22 条 Query 中 15 条更优;多表关联 Q5 提升达 56.3%) |
在已完成的 48 条 Query 中,Doris 在 35 条 Query 上取得了更低的响应延迟。
- 高并发点查与更新 :Doris 完善的 Unique Key Merge-on-Write (MoW) 机制,结合虚拟列下推与延迟物化,避免了读取时的多版本合并开销,有效平抑高并发 UPDATE/DELETE 及 API 点查时的 CPU 飙高。
- 运维与分桶体验 :StarRocks 建表需手工预估
BUCKETS N,设大容易造成小文件爆棚,设小影响并行度;Doris 支持 Auto Bucket 自动分桶,随数据量动态调整,大幅降低 DBA 运维负担。
拓宽业务边界:从纯 OLAP 到 HSAP 一体化(与周边系统的边界)
当企业业务从传统报表拓展至日志检索、全文搜索、AI / RAG 智能体应用时,传统架构往往需要围绕 StarRocks 拼凑多套组件。Doris 则通过 HSAP 一体化能力,清晰地重新界定并收敛了这些组件的边界:
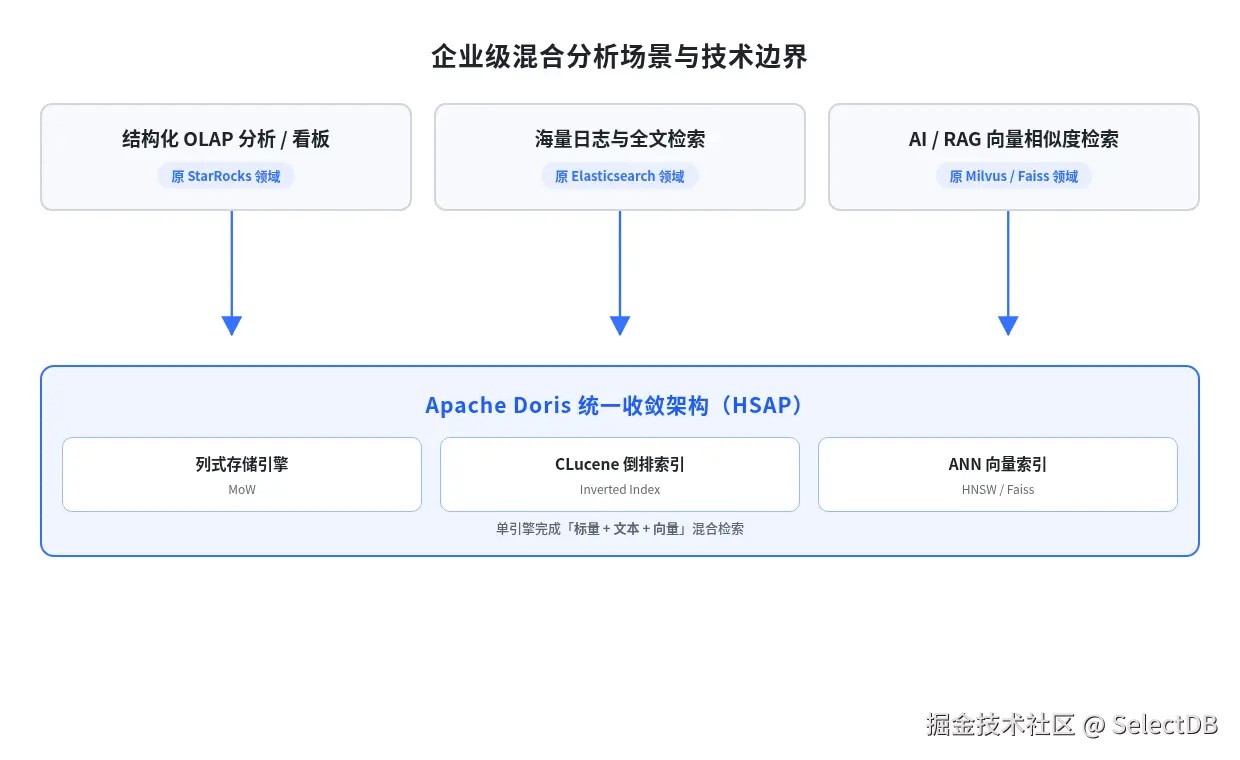
边界 1:与 Elasticsearch 的边界(日志与文本检索)
- 原架构痛点:运维日志与文本检索依赖 ES,ES JVM 内存开销巨大、存储压缩率低,且数据需要通过 ETL 双写到 OLAP 和 ES。
- 边界重定义 :Doris 内置基于 CLucene 的倒排索引(Inverted Index),直接将分词与词表打散存储于 Segment 文件中。支持文本分词与
MATCH检索,存储成本比 ES 降低 50%~70% ,使团队能够将"日志文本检索"这一业务边界直接收敛进 Doris 中。
边界 2:与独立向量数据库的边界(AI / RAG / 智能体)
- 原架构痛点:构建 RAG 智能体时,需要引入 Milvus/Faiss 处理向量,组合 MySQL/StarRocks 做标量过滤。链路长,且无法在单条 SQL 中完成联合召回。
- 边界重定义 :Doris 原生集成向量索引(ANN),支持单条 SQL 完成"标量过滤 + 文本匹配 + 向量相似度"多路召回与 RRF 算法融合。除非是超大规模(几十亿级)的纯向量相似度检索,否则大部分企业级 RAG 业务边界均可由 Doris 一站式覆盖。
二、 架构差异盘点:平滑迁移的兼容性评估
得益于"技术同源",大多普通明细表(Duplicate)与聚合表(Aggregate)的 DDL 和 SQL 能够高比例复用,但独立演进带来的细节差异仍需关注:
| 维度 | StarRocks | Apache Doris | 迁移转换建议 |
|---|---|---|---|
| 主键表/更新模型 | PRIMARY KEY | UNIQUE KEY(开启 Merge-on-Write) | 将 PRIMARY KEY 转为 UNIQUE KEY,显式配置开启 MoW,对齐高并发点查与更新语义 |
| 明细与聚合模型 | DUPLICATE KEY / AGGREGATE KEY | DUPLICATE KEY / AGGREGATE KEY | 语法高度一致,可直接复用 |
| 分桶机制 | 强制指定 DISTRIBUTED BY HASH(...) BUCKETS N | 支持 AUTO BUCKET 自动分桶 | 建议去掉固定 Bucket 数量,改用自动分桶降低运维复杂度 |
| 索引能力 | Bitmap 索引、NGram Bloom Filter | 前缀索引、Bitmap、倒排索引 (Inverted Index)、向量索引 (ANN) | 原有 LIKE 模糊查询可直接改写升级为倒排索引 MATCH 语法 |
| 外表/湖仓接入 | External Table / Catalog | Catalog / TVF(Table-Valued Function) | 推荐直接使用 Doris Catalog + View 统一管理外部湖仓 |
三、 三大核心数据搬迁方案对比
根据数据规模与业务对停机时间(Downtime)的要求,Doris 提供了多条数据迁移路径:
| 迁移方案 | 适用场景 | 数据量级 | 业务影响 | 方案优势与技术链路 |
|---|---|---|---|---|
| 方案 1:Parquet 导出 + TVF / Catalog | 历史全量数据一次性迁移 | TB ~ PB 级 | 维护窗口内处理 | 源端解耦。SR 导出 Parquet 至 S3/HDFS →\rightarrow Doris 通过 TVF(S3/HDFS TVF)结合 INSERT INTO SELECT 直连并行极速导入。 |
| 方案 2:DataX + Doriswriter | 已有 DataX 平台的现有调度 | TB 级 / 按表分区 | 按批次同步 | 依靠 DataX 批量读取 StarRocks,最终通过 Stream Load 写入 Doris,易于结合现有调度任务。 |
| 方案 3:Flink CDC / Kafka 链路双写 | 核心业务平滑无感切流 | 全量 + 实时增量 | 零停机 (Zero-Downtime) | 从上游 Kafka / Flink 建立双写链路。实时追平增量数据,待 Doris 数据校验无误后平滑切读。 |
四、 迁移实战四步法(标准 SOP)
Step 1:结构迁移(批量提取与建表改写)
可以通过遍历 StarRocks 的 information_schema 获取库表清单,批量导出 DDL 并进行规则转换:
sql
-- StarRocks 原始建表 DDL 示例
CREATE TABLE sr_orders (
order_id BIGINT NOT NULL,
user_id BIGINT NOT NULL,
order_amount DECIMAL(15, 2),
create_time DATETIME
) PRIMARY KEY(order_id)
DISTRIBUTED BY HASH(order_id) BUCKETS 32;
-- 改写后转换为 Doris DDL 最佳实践
CREATE TABLE doris_orders (
order_id BIGINT NOT NULL,
user_id BIGINT NOT NULL,
order_amount DECIMAL(15, 2),
create_time DATETIME
) UNIQUE KEY(order_id)
DISTRIBUTED BY HASH(order_id) -- 推荐使用 Doris Auto Bucket 机制
PROPERTIES (
"enable_unique_key_merge_on_write" = "true" -- 显式开启 Merge-on-Write 保证高并发点查与更新性能
);Step 2:全量与增量数据搬迁
全量搬迁:使用 S3 TVF 直连导入
若将 StarRocks 历史数据导出为 Parquet 存储于对象存储(S3/OSS),在 Doris 中可直接使用 Table-Valued Function 极速摄入:
ini
INSERT INTO doris_orders
SELECT * FROM s3(
    "uri" = "s3://migration-bucket/exports/sr_orders/*.parquet",
    "ACCESS_KEY" = "your_ak",
    "SECRET_KEY" = "your_sk",
    "format" = "parquet"
);
增量同步原则:上游分流,拒绝"反向 CDC"
尽量从真实上游(Kafka/Binlog)建立增量链路,而不是把 StarRocks 当作 CDC 源:
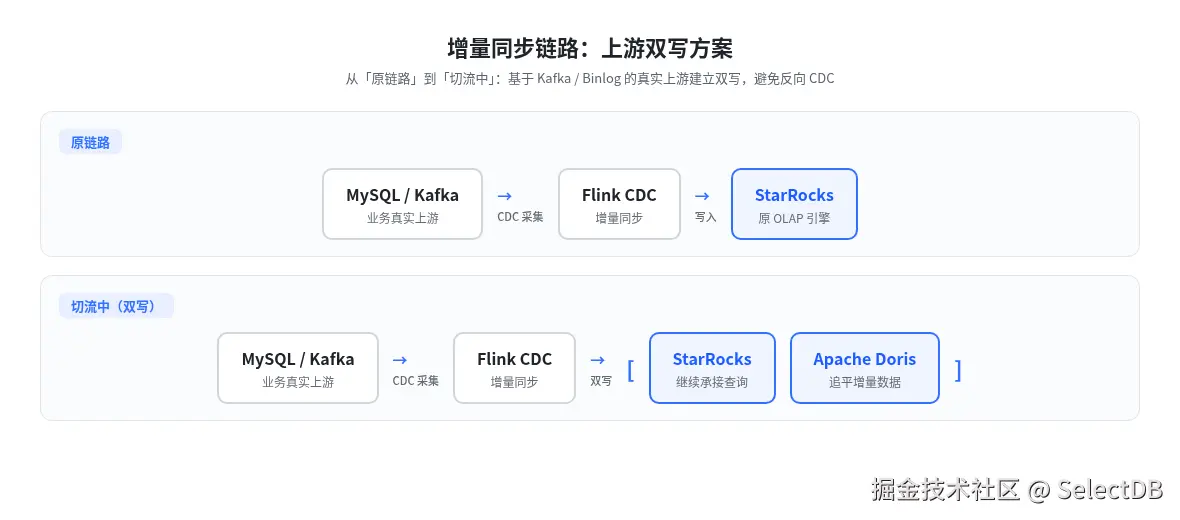
Step 3:数据一致性校验
在切流前,必须对数据进行三级对齐:
- 行数与标量汇总比对 :比对
COUNT(*),以及数值字段的SUM()、MAX()、MIN()。 - 主键粒度抽样校验 :针对订单、支付等核心表,按主键范围比对
DECIMAL精度、DATETIME时区及NULL值处理。 - 乱序与重复覆盖验证 :测试 Flink 双写场景下的覆盖更新,确保
Merge-on-Write语义与原 Primary Key 完全对齐。
Step 4:SQL 回放与灰度切流
抽取 StarRocks 审计日志(Audit Log)中的真实生产 SQL 在 Doris 集群进行回放,监控 P95/P99 延迟与资源开销。
在上线阶段,采用灰度分流策略:
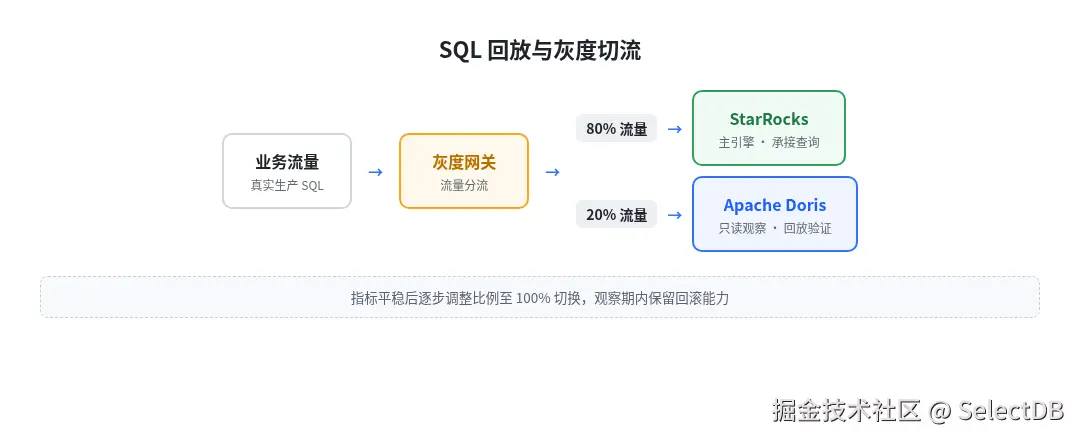
确认指标平稳后,逐步调整比例至 100% 切换,并在观察期内保留回滚能力。
五、 总结与选型建议
从 StarRocks 到 Apache Doris 的迁移,不仅是一次同源引擎间的低成本平滑替换 ,也是一次收敛数据技术栈边界、走向 HSAP 一体化的架构升级。
- 如果你的团队倾向于完全开源与自主掌控 :可以直接部署 Apache Doris 社区版,获得功能完备的 HSAP 一体化架构与活跃的社区支持。
- 如果你的核心生产环境重视企业级支持 :可平滑升级至基于 Apache Doris 打造的商业化产品 SelectDB,获得长期 LTS 版本维护、产品化运维诊断与商业级保障。