LingBot-VLA 2.0 怎么从 6B 权重走到真实机器人?55 维动作只是起点
先看一个作者构造的接入错误:模型输出了 55 个有限数,长度检查通过;但映射表把左臂关节通道接到了控制器的右臂通道。数组形状正确,动作仍会错位。这不是本文实测的机器人故障,而是说明"拿到 6B 权重"还缺哪一段应用契约。
接入时先逐项对齐 Robot Config 的通道索引、同次后训练的 Norm Stats 顺序与控制器单位,再检查离线样本的时间轴;通过后才进入后训练、开环评估和低速闭环。文末给出能复制运行的有限字段检查,但它只能比较声明,不能替你验证线缆或驱动映射。
以下模型与配置事实按 2026-10-14 官方资料核对;引用的动态 main 未固定 commit,作者未运行模型训练、GPU 推理或真机部署。^1^
模型怎样把观测变成动作
LingBot-VLA 2.0 是一套 Vision-Language-Action 基础模型。它接收摄像头画面、语言指令和机器人状态,输出机器人动作或动作块。
它的基本目标可以写成:
a_{t:t+H}=\\pi_\\theta(o_{\\le t},s_{\\le t},l)
其中:
- (o) 是视觉观测;
- (s) 是关节、末端、夹爪、底盘等机器人状态;
- (l) 是语言指令;
- (a_{t:t+H}) 是未来一段动作序列;
- (H) 是 Action Chunk 的时间长度。
它与 LingBot-VA 的关系不是"旧版和新版",而是两种不同建模重点:VLA 以动作策略为中心,VA 以未来视觉状态和动作联合建模为中心。
VLA 1.0 到 VLA 2.0 改了什么
LingBot-VLA 1.0 以双臂本体为主,VLA 2.0 把数据、动作空间和动态建模同时扩展。下表只比较有来源支持的接口与机制;旧版规模未核实时保持未知。
| 维度 | LingBot-VLA 1.0 | LingBot-VLA 2.0 |
|---|---|---|
| 预训练数据 | 前一版规模与组成未在引用来源中固定 | 约 6 万小时 |
| 机器人轨迹 | 以双臂操作为主 | 5 万小时,覆盖 20 种机器人配置 |
| 人类视频 | 不是本文的重点 | 1 万小时第一视角人类操作视频 |
| 本体范围 | 以双臂本体为主 | 单臂、双臂、半人形、人形、移动操作等 |
| 动作表示 | 旧版接口未在引用来源中固定 | 55 维全身统一状态/动作空间 |
| 动作专家 | 标准 Action Expert | 稀疏 MoE Action Expert |
| 未来动态 | 不是旧版主线 | DINO-Video 与 LingBot-Depth 双查询蒸馏 |
| 公开模型 | 前一版 checkpoint,参数量不作比较 | native-depth 6B |
官方把三个升级概括为:跨任务和跨本体泛化、扩展动作空间、预测动态建模。
公开仓库提供了什么,接入还缺什么
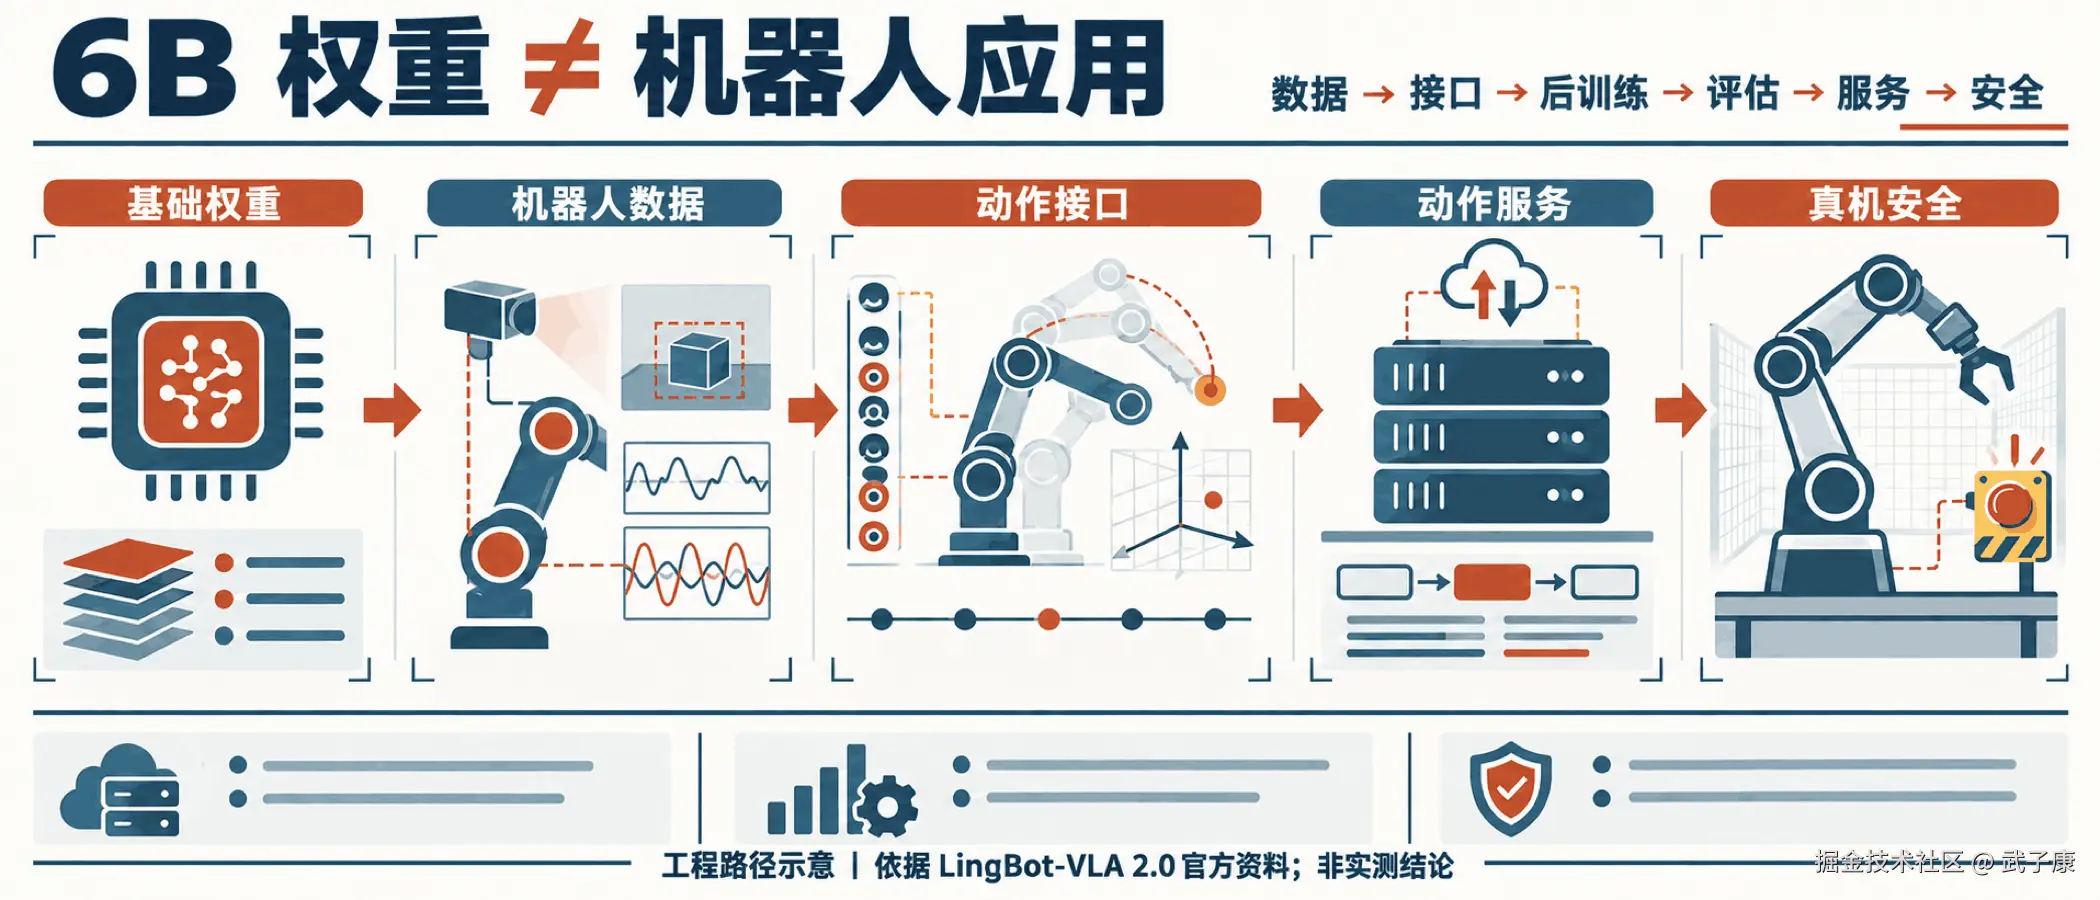
公开仓库提供了一个 native-depth 预训练 checkpoint 和一套后训练、评估、部署代码。从 checkpoint 到动作服务,中间仍然隔着数据格式、特征映射、归一化统计、评估环境和控制安全层;这些部分决定了开篇的左右通道错位能否在下发前被发现。
当前 README 还新增了一个容易被忽略的变化:2026 年 9 月 22 日加入 Distributed Muon。它不是一个把单卡训练变成单卡推理的开关,而是后训练优化器路径,要求 FSDP2 至少有两个 data-parallel rank。官方在单节点 H20 上给出了 Muon 与 Distributed Muon 的速度和 clean/randomized 结果对比;本稿只保留"速度变化伴随结果差异"这一可复核判断,不把未冻结版本的具体百分比抄成普遍结论。
因此,本文把"应用路径"写成四个必须同时对齐的对象:
text
数据与时间轴 → Robot Config 与 55 维通道 → 后训练 checkpoint → 评估/Policy Server/安全层后面所有硬件、性能和部署判断都只在官方给出的测试分母内成立;没有本地下载、训练、仿真或真机运行证据的地方,统一保留为公开资料推理。
6 万小时数据不只是规模变化
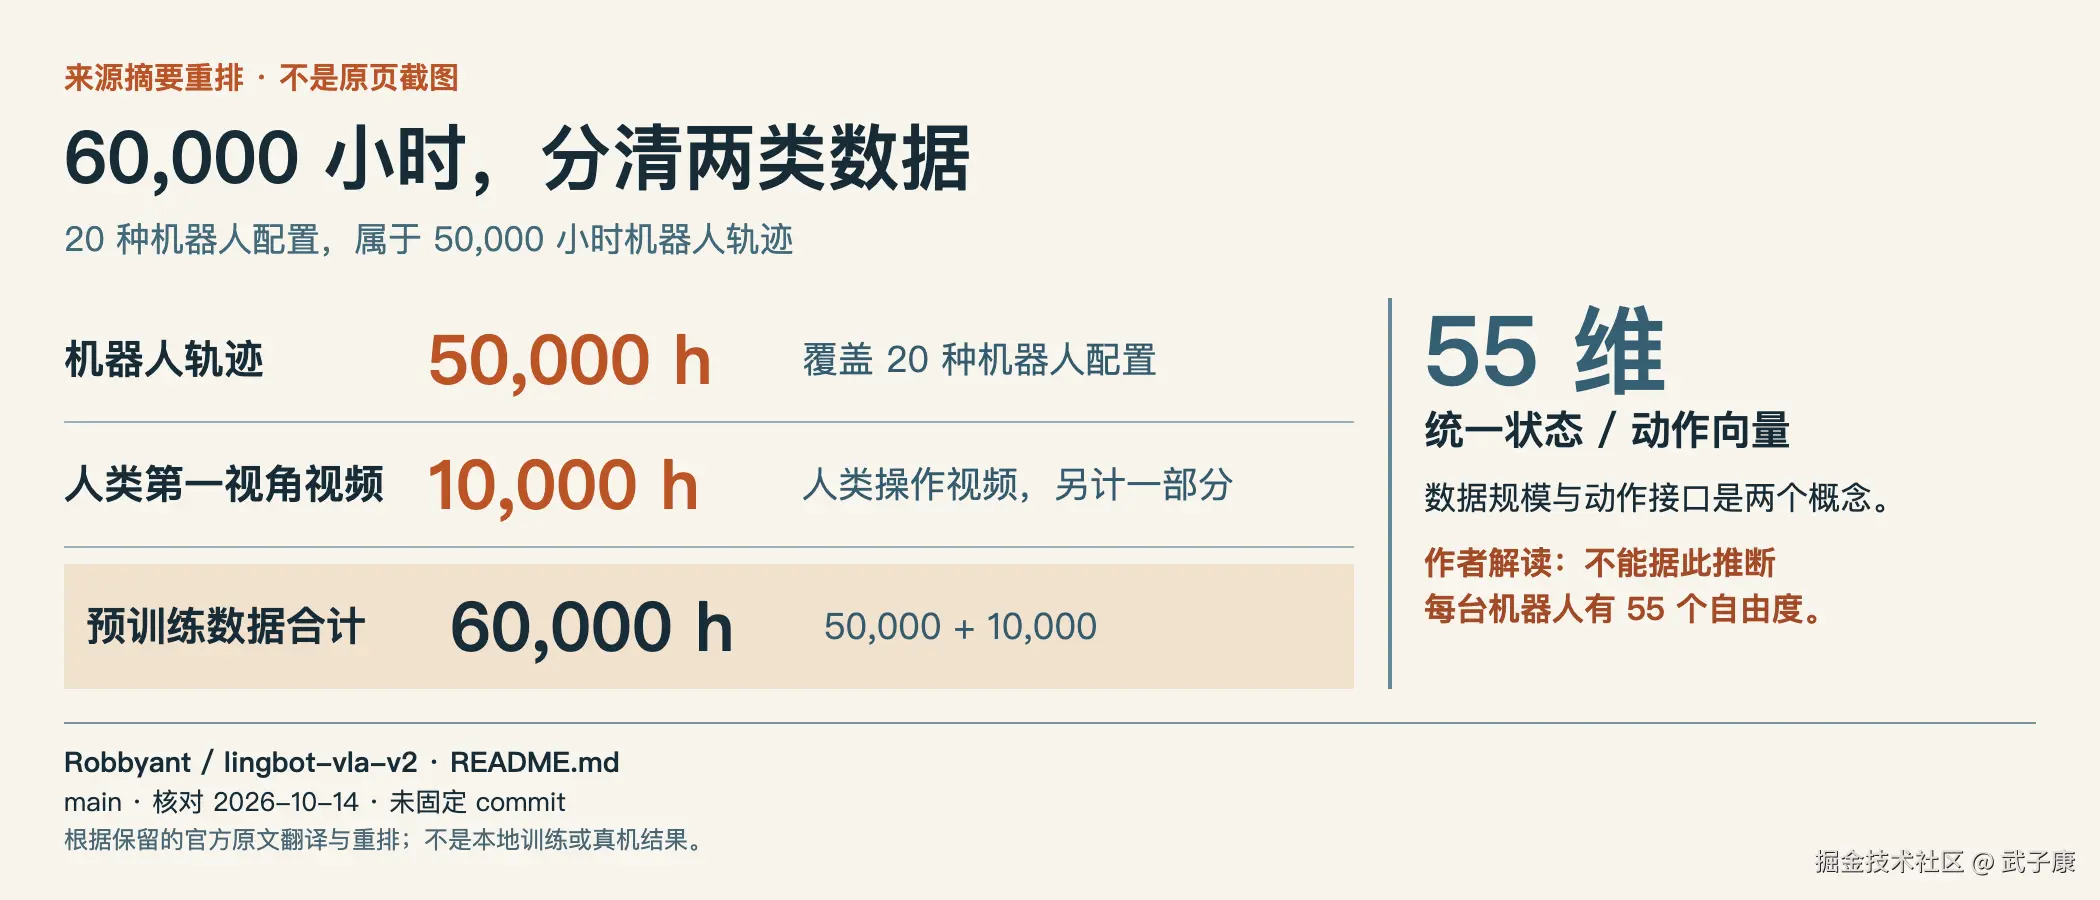
VLA 2.0 的预训练数据由两部分构成:
text
50,000 小时机器人轨迹
+ 10,000 小时第一视角人类操作视频
= 60,000 小时预训练数据
机器人数据覆盖 20 种配置。人类视频提供更广泛的物体操作、动作先验和场景多样性,但人手运动不能直接作为机器人关节动作使用,因此需要轨迹重建、标准化和筛选。
官方数据处理流程重点过滤:
- 视频与状态时间错位;
- 模糊、遮挡和多视角不同步;
- 异常速度、加速度和 jerk;
- 长时间静态信号;
- 不稳定的相机和手部运动估计;
- 与操作无关的第一视角视频。
这说明 VLA 数据的瓶颈不是简单累计小时数,而是跨机器人对齐和动作语义一致性。数据量增加只有在时间戳、相机、状态和动作都可靠时才有价值。
55 维统一动作空间
不同机器人具有不同的关节数量、末端形式和移动能力。VLA 2.0 将它们映射到一个 55 维 canonical state/action vector。
| 信号 | 维度 |
|---|---|
| 双臂关节位置 | 14 |
| 双臂末端位姿 | 14 |
| 双夹爪位置 | 2 |
| 灵巧手关节位置 | 12 |
| 腰部位置 | 4 |
| 头部位置 | 2 |
| 移动底盘信号 | 3 |
| 保留维度 | 4 |
| 合计 | 55 |
统一空间的作用不是让所有机器人都拥有 55 个实际自由度,而是提供一个固定接口。某个机器人只激活其中与自身对应的通道,其余通道通过 mask、映射或保留值处理。
这种设计带来两个收益:
第一,模型可以在不同本体之间共享视觉、语言和动作先验。第二,后训练和部署可以保持固定张量结构,减少为每台机器人改网络结构的成本。
它也带来新的风险:若坐标系、单位、旋转表示、关节顺序、左右手定义或动作频率映射错误,模型输出在数值上仍然合法,但机器人行为会完全错误。
Robot Config 是部署的核心,不是附属配置
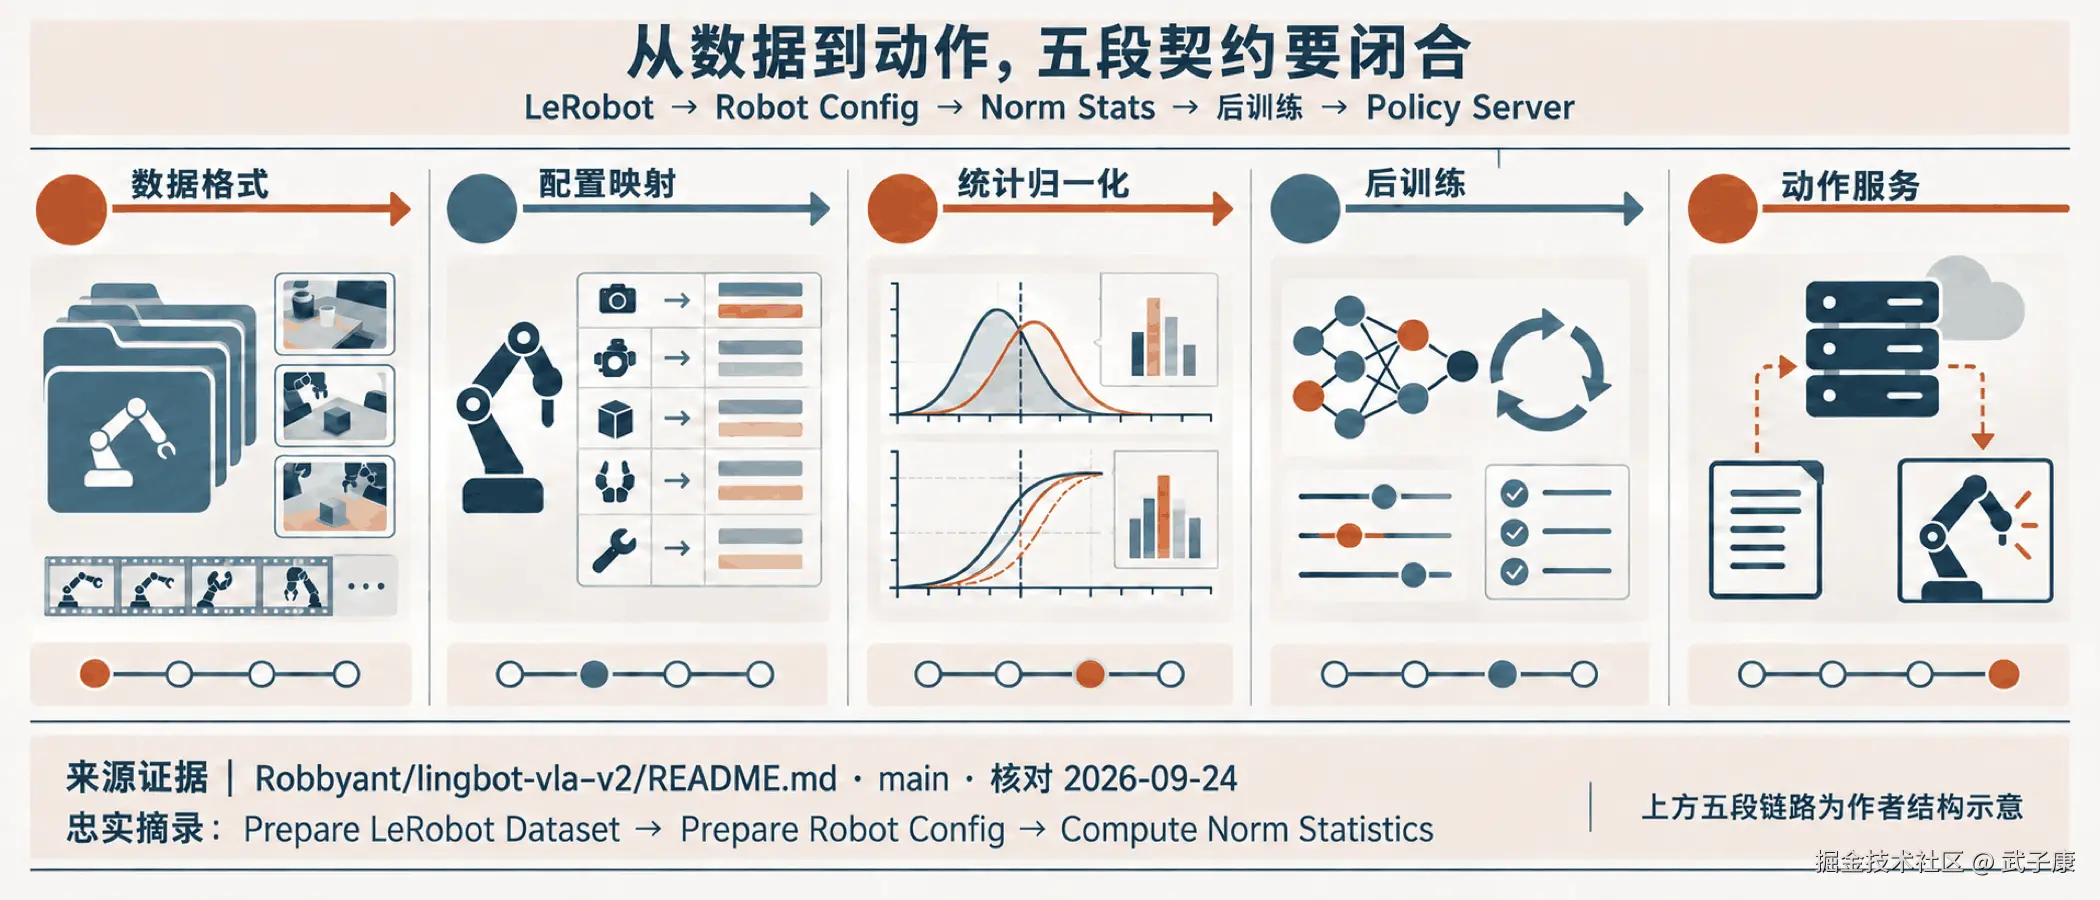
官方后训练要求为每个数据集或机器人提供 Robot Config,用来定义:
- 原始状态字段映射到哪一组统一通道;
- 原始动作字段映射到哪一组统一通道;
- 每个相机对应哪个视觉输入;
- 关节和末端的维度顺序;
- 哪些通道有效,哪些通道屏蔽;
- 归一化方法和统计文件。
一个典型配置包含:
yaml
data:
  robot_config_root: configs/robot_configs
  joints:
    - arm.position: 14
    - end.position: 14
    - effector.position: 2
    - waist.position: 4
    - head.position: 2
    - base.position: 3
    - hand.position: 12
  cameras:
    - camera_top
    - camera_wrist_left
    - camera_wrist_right
不能把另一个机器人的配置文件复制过来只修改名称。必须逐通道核对实际控制协议。
MoE Action Expert 的意义
VLA 通常由视觉语言主干与动作专家组成。主干负责理解图像、语言和高层任务语义,动作专家负责把语义映射为连续控制信号。
LingBot-VLA 2.0 在 Action Expert 内部引入稀疏 MoE。官方配置示例包含 32 个专家、Top-4 路由,并设置共享专家与路由损失。
专家的具体功能只能作为作者理解示意,实际分工来自训练与路由学习;官方没有人工指定每个专家负责双臂、底盘或灵巧手。
MoE 的目标是让通用先验和本体/任务特化模式共存,同时避免每次前向都激活全部参数。它不能自动解决跨本体问题;若数据分布严重失衡,路由仍可能塌缩到少量专家,或者把机器人身份当作捷径。
为什么 VLA 2.0 也学习未来动态
VLA 直接预测动作容易形成视觉捷径:模型看到某个外观模式就输出常见动作,却没有真正理解动作会造成什么结果。
LingBot-VLA 2.0 增加当前和未来感知查询,并从两个教师模型蒸馏:
text
LingBot-Depth:当前与未来的几何线索
DINO-Video:当前与未来的语义和时间线索
这个辅助目标迫使模型表征当前空间结构和未来变化,提高时间推理能力。
但它不会把 VLA 2.0 变成面向用户的视频生成模型。部署接口主要输出动作;未来视觉表示用于训练监督和内部表征,而不是以完整视频作为最终产品。
6B 权重公开到了什么程度
截至 2026 年 9 月 23 日,官方公开:
- GitHub 代码;
- 6B 预训练权重;
- 环境安装脚本;
- LeRobot 数据准备说明;
- Robot Config 示例;
- 归一化统计流程;
- RoboTwin 2.0 后训练配置;
- 开环评估脚本;
- 仿真部署脚本;
- 真实机器人 Policy Server;
- Apache 2.0 许可证。
当前 README 把公开预训练模型写成 native-depth 的 robbyant/lingbot-vla-v2-6b。运行时精度、评估 checkpoint 目录和显存占用由代码与配置共同决定,不能只看参数量或磁盘文件类型推断。
训练还需要额外依赖:Qwen3-VL-4B-Instruct、MoGe-2、LingBot-Depth 和 DINO-Video 教师 checkpoint/config。只下载 6B 权重并不足以复现完整后训练流程。
当前资料包使用官方 main 分支读取;本轮无法取得稳定 commit SHA,所以这部分结论记录为"截至读取日期的官方状态",不冒充不可变版本。若要复现实验,应先把仓库 commit、权重目录、配置文件和评估环境一起冻结。
基础权重为什么不能直接控制任意机器人
VLA 基础模型学到的是跨任务和跨本体先验,不知道你的机器人驱动协议、相机位置、控制频率和安全限制。
真实部署至少需要完成:
- 将数据整理为 LeRobot v2.1 或 v3.0。
- 编写 Robot Config。
- 计算状态和动作归一化统计。
- 在目标机器人数据上后训练。
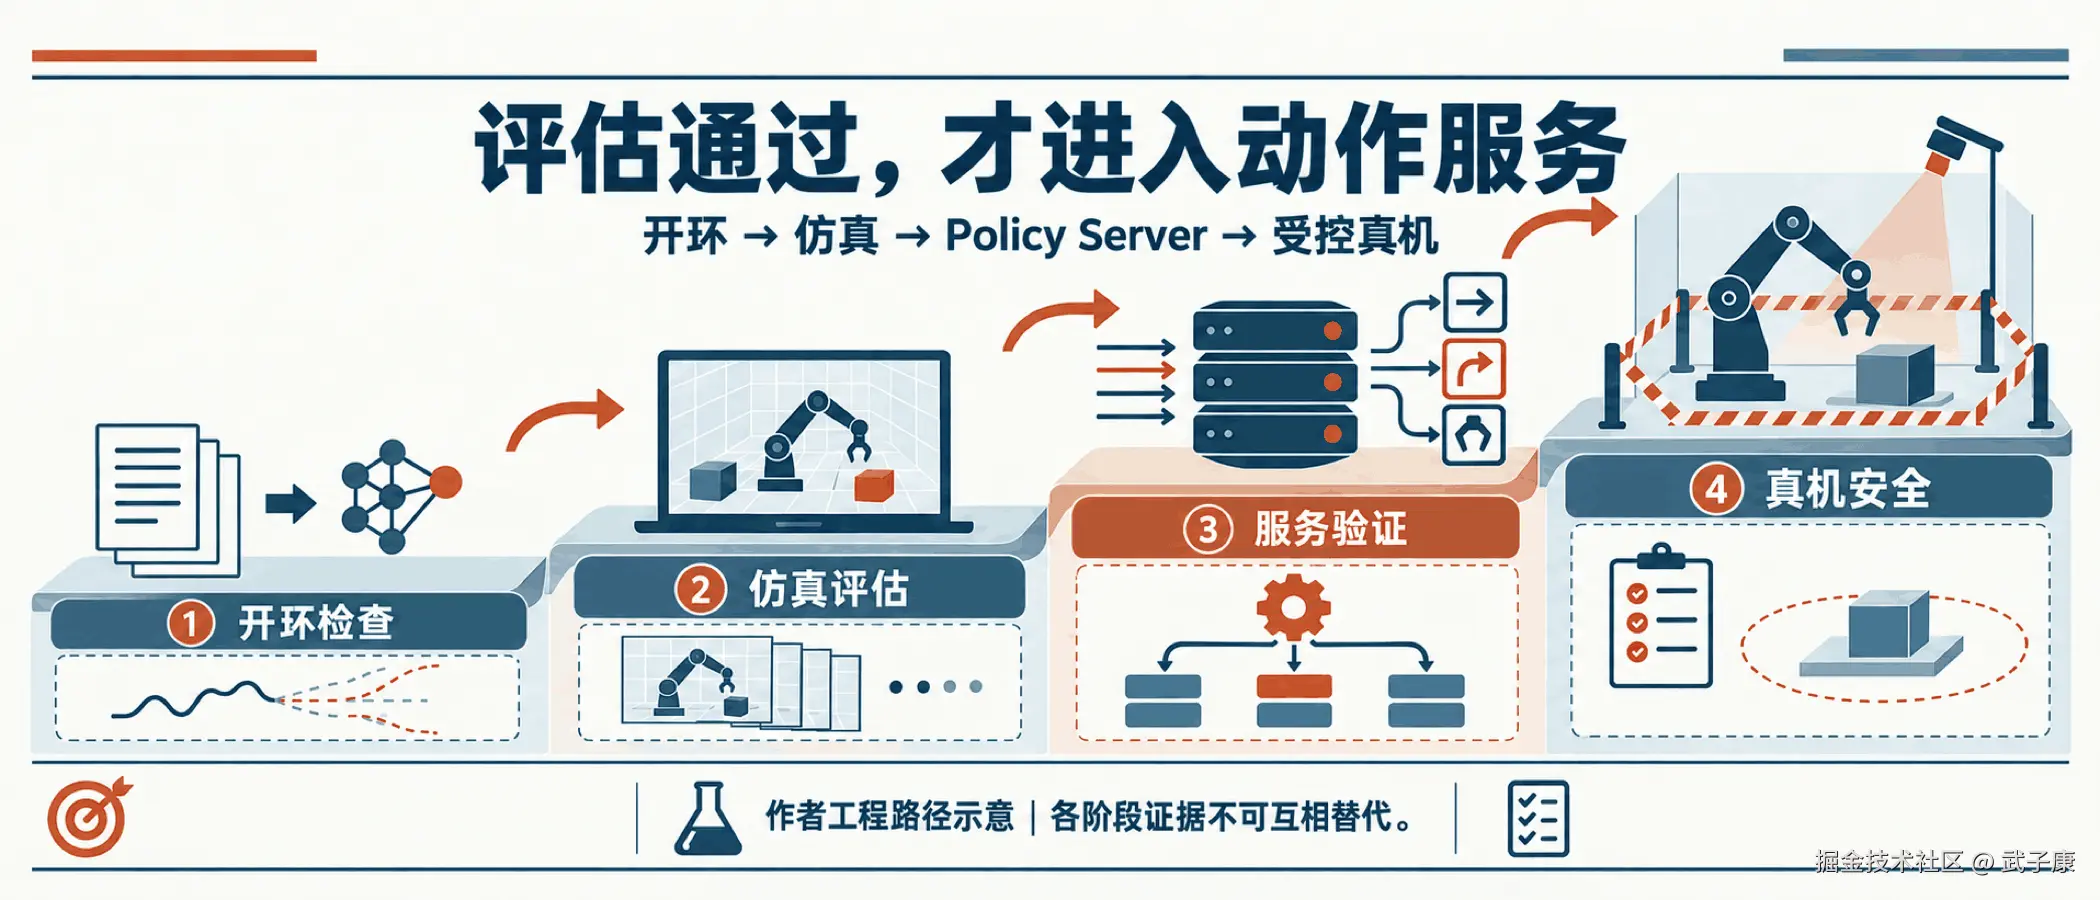
- 进行开环动作检查。
- 在仿真或低速模式进行闭环验证。
- 将后训练 checkpoint 部署为 Policy Server。
- 在机器人侧实现动作限幅、急停和状态同步。
官方后训练数据准备正好对应前三项:
| 步骤 | 输入 | 输出 |
|---|---|---|
| LeRobot 数据 | 图像、状态、动作、语言 | v2.1/v3.0 数据目录 |
| Robot Config | 原始字段定义 | 统一空间映射 YAML |
| Norm Statistics | 训练数据 | JSON 归一化统计 |
没有这些适配,模型输出不能安全地解释为真实机器人动作。
后训练流程
官方给出的 RoboTwin 示例:
bash
bash train.sh \
  tasks/vla/train_lingbotvla.py \
  ./configs/vla/robotwin/robotwin.yaml \
  --data.train_path assets/training_data/robotwin.txt \
  --data.data_name multi \
  --train.output_dir output/
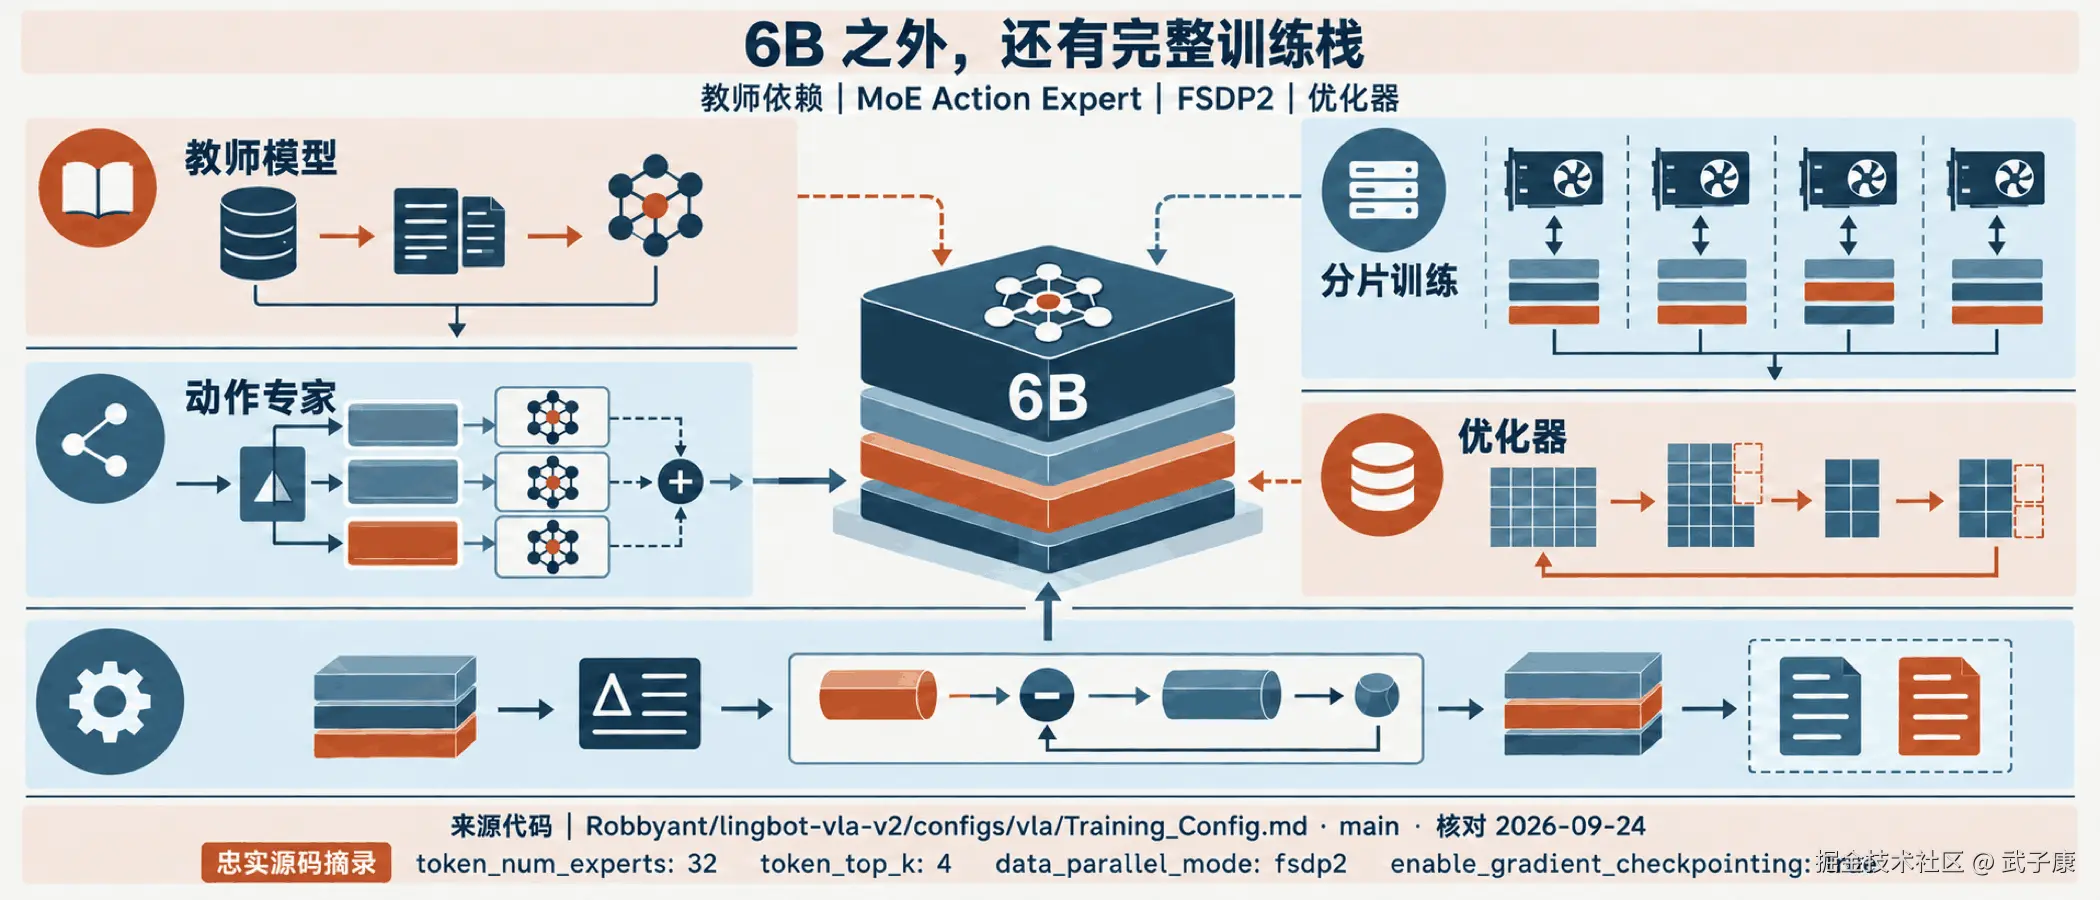
真实机器人以 configs/vla/real_robot/real_robot.yaml 为模板。下面列的是 Training_Config.md 的 Real-World 说明示例与可配置训练组件,并非当前 YAML 的默认值。本轮读取的实际 YAML 为 micro_batch_size: 32、global_batch_size: 256、enable_gradient_checkpointing: false;说明文件的 Real-World 示例写的是 micro batch 1、global batch 3、开启梯度检查点;4×A6000 命令则显式覆盖 micro batch 为 1、梯度累积为 1、global batch 为 4,并开启梯度检查点。复现时须同时冻结 YAML 与命令覆盖参数,不能只据说明示例推断实际执行条件:
- FSDP2;
- Gradient Checkpointing;
micro_batch_size: 1;- 55 维状态与动作;
- 稀疏 MoE;
torch.compile;- 未来图像、未来深度和未来视频蒸馏;
- Action Expert FP32;
- Muon 或 AdamW;
- MoE 路由辅助损失和 z-loss。
这些选项表明完整后训练是多组件、多损失、多卡导向的训练任务,而不是普通 6B LLM LoRA 的显存规模。
Distributed Muon 应该放在哪个位置
Muon 和 Distributed Muon 属于优化器选择,不能替代 Robot Config、数据质量或模型并行。官方配置说明还保留了 AdamW、Muon、DDP、FSDP1、FSDP2、gradient checkpointing 和 VLM FSDP 等可选项;不同选项会同时影响收敛、速度、内存和可复现条件。
如果采用 Distributed Muon,首轮记录至少要包含:FSDP2 版本、data-parallel rank 数、优化器参数、global batch size、梯度累积、checkpoint 格式、每步耗时和 clean/randomized 评估分数。只记录"用了 Muon"无法解释速度变化,更不能把官方 H20 的结果移植到 A6000。
开环评估与闭环部署
官方提供开环评估:
bash
export QWEN3_PATH=Qwen/Qwen3-VL-4B-Instruct

python scripts/open_loop_eval.py \
  --model_path path_to_posttraining_ckpt \
  --robo_name robotwin \
  --data_path path_to_validation_data \
  --use_length 50
开环评估用于比较预测动作与离线轨迹。它能发现维度错位、归一化错误和明显动作偏差,但不能替代闭环成功率测试。
真实机器人部署入口:
bash
export QWEN3VL_PATH=/path/to/Qwen3-VL-4B-Instruct

python -m deploy.lingbot_vla_v2_policy \
  --model_path /path/to/posttraining_ckpt \
  --use_compile \
  --use_length 25 \
  --port 8000
机器人客户端通过网络向 Policy Server 发送观测并接收动作块。这种架构把 GPU 推理与机器人控制进程解耦,但必须处理:
- 图像和状态时间戳;
- 网络延迟和抖动;
- Action Chunk 执行进度;
- 新动作覆盖旧动作的策略;
- 丢包和超时后的安全状态;
- 推理服务重启;
- 机器人急停独立于模型服务。
单卡 A6000 48GB:能推断什么,不能推断什么
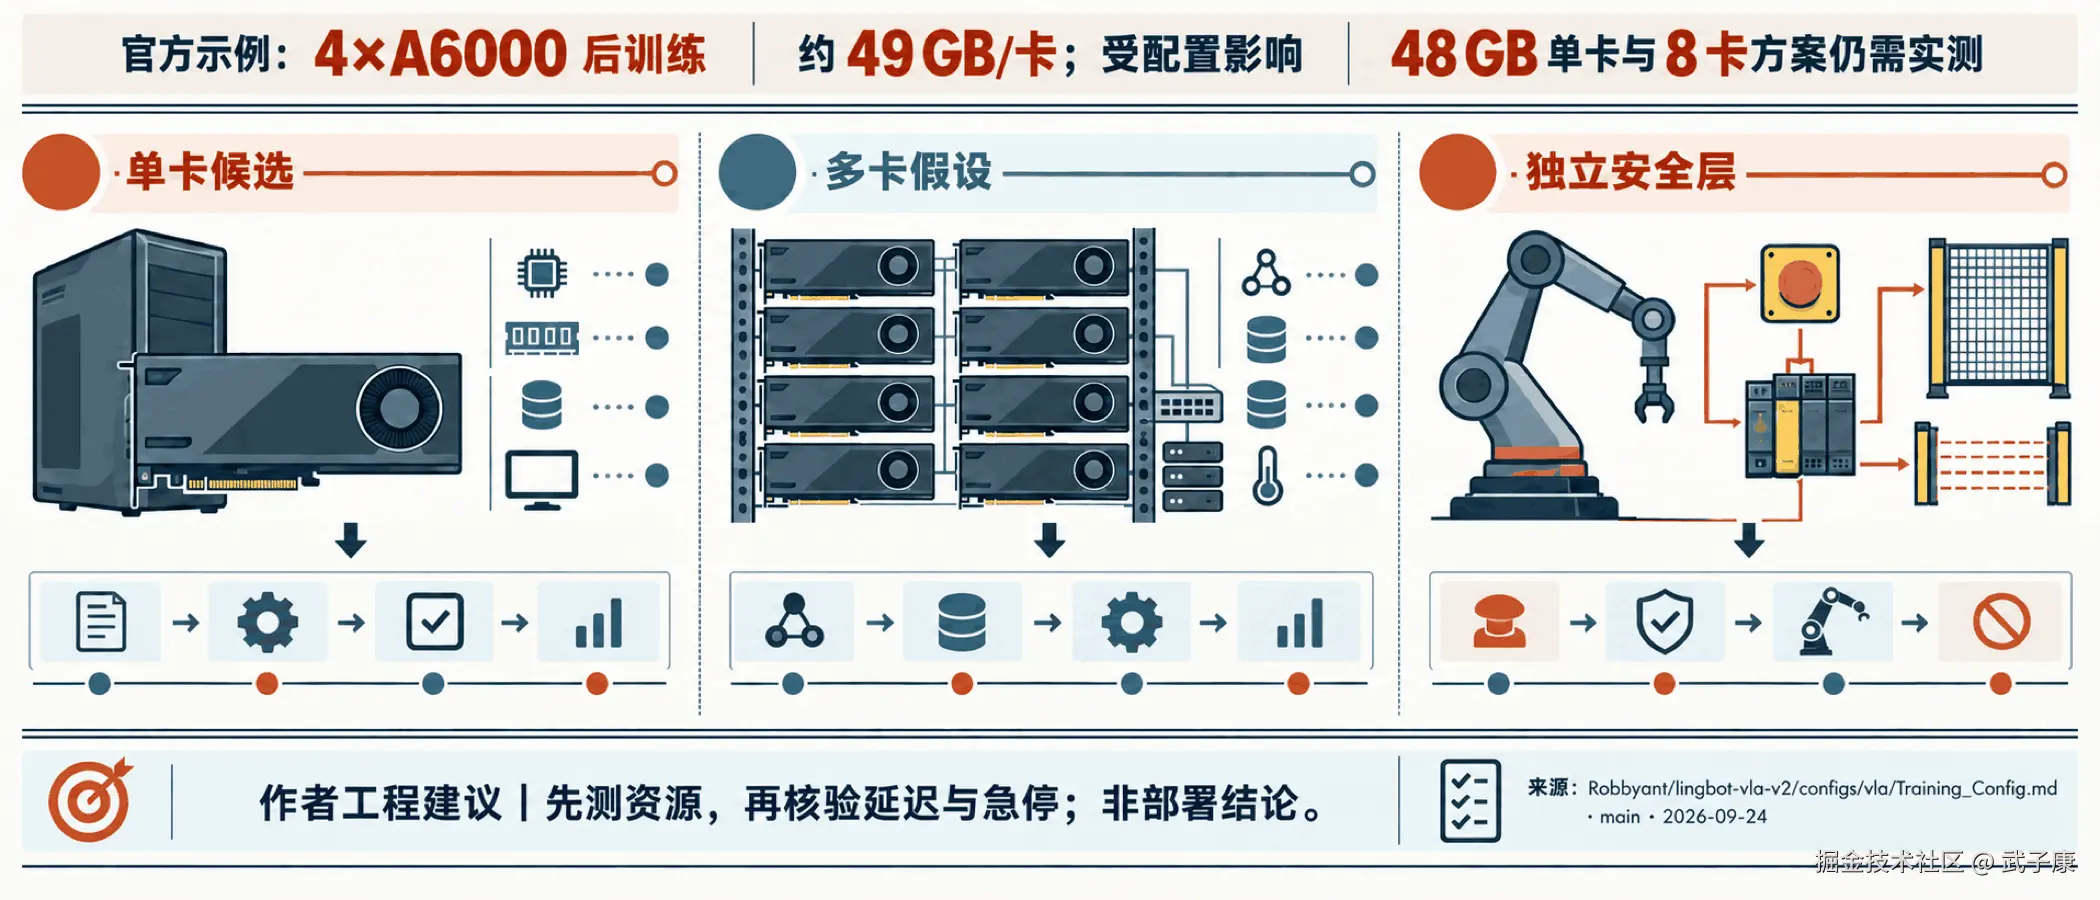
官方没有给出覆盖所有任务的统一峰值显存表,但训练配置提供了 4×A6000 后训练示例 :micro_batch_size=1、gradient_accumulation_steps=1、global_batch_size=4、启用梯度检查点。文档注明,这个示例在 A6000 类 GPU 上每卡至少约需 49 GB 显存;实际占用取决于 checkpoint、数据、图像/深度选项及梯度检查点。另一个独立观察是:官方在 NVIDIA GeForce RTX 4090D 上,使用 10 个去噪步骤的一次推理约 130 ms。
4090D 延迟不能外推为 A6000 延迟;4 卡后训练示例也不是单卡装载或本地复现证据。尤其"至少约 49 GB/卡"的条件高于 48 GB 单卡的标称容量,不能把示例写成"48 GB A6000 可直接跑通"。单卡仍需先做权重装载、依赖版本和峰值显存探针。
建议资源:
| 资源 | 建议 | 性质 |
|---|---|---|
| GPU | 1×RTX A6000 48GB | 用户硬件 |
| 系统内存 | 64 GB 起步,128 GB 更稳 | 工程估算 |
| 本地磁盘 | 100--150 GB NVMe | 工程估算,包含环境与缓存 |
| Python | 3.12 | 官方要求 |
| PyTorch | 2.8.0 | 官方要求 |
| FlashAttention | 2.8.3 | 官方安装脚本默认 |
如果确实只有单卡,优先把它当作适配和排障设备:
- 尝试基础模型或后训练 checkpoint 装载,并记录实际峰值;
- 小批量开环评估和单路相机输入;
- Robot Config 调试;
- 归一化检查;
- 小规模冻结模块实验,前提是先验证依赖与显存。
单卡不适合直接照搬官方完整全参数后训练配置。训练时除了 6B 权重,还包括梯度、优化器状态、激活、MoE 路由和教师模型。48GB 很容易不足。
8×A6000 48GB:参考官方 4 卡示例,仍需逐项验证
官方给出了 4×A6000 后训练命令示例,同时写明至少约 49 GB/卡及配置依赖;这不能直接外推到现有的 48 GB/卡,也不能证明 8 卡拓扑、通信和训练吞吐。8 卡总显存 384GB 相加仍不等于任务已经可运行。合理的生产前目标是:
- 在已有预训练权重上完成 RoboTwin 或自有机器人后训练;
- 保留未来深度/视频教师损失;
- 训练完整 Action Expert;
- 多任务和多机器人联合后训练;
- 批量仿真评估。
可作为实验起点的配置:
text
8×A6000 48GB
FSDP2
BF16 主干 + 配置中指定的 FP32 Action Expert
Gradient Checkpointing
micro_batch_size = 1
通过 gradient accumulation 调整 global batch size
256GB 系统内存起步,512GB 更稳
高速本地 NVMe
以上只是实验起点;系统内存、通信、教师模型是否常驻、数据解码方式、FSDP 分片策略和 checkpoint 保存方式都需要实际探针。当前仓库没有 8×A6000 的运行证据。
8×A6000 不适合从头复现官方 6 万小时预训练。预训练规模受到数据吞吐、训练步数、教师模型成本和集群通信限制,单机 8 卡的时间成本通常不可接受。
部署时最容易出错的五个位置
动作单位
训练数据可能使用弧度、度、米、毫米、关节增量或绝对位置。模型和控制器必须完全一致。
坐标系
末端位姿可能位于世界坐标、基座坐标、相机坐标或工具坐标。旋转可能使用四元数、欧拉角、旋转矩阵或 6D 表示。
控制频率
数据录制频率、模型输出频率和机器人底层伺服频率往往不同。必须明确重采样和动作保持逻辑。
时间对齐
相机帧、机器人状态和实际执行动作存在采集延迟。几十毫秒错位就可能让模型学到错误因果。
归一化
部署必须使用与后训练相同的统计文件。重新计算、通道顺序变化或裁剪规则不同都会造成系统性偏差。
安全边界
真实机器人不能把模型输出直接无条件下发。至少应当在模型外实现:
text
关节位置与速度限幅
工作空间边界
自碰撞与环境碰撞检查
夹爪力限制
动作连续性检查
超时回退
独立急停
人类进入工作区检测
VLA 的任务成功率不能替代工业安全验证。模型即使在离线数据和仿真中表现良好,也可能因传感器噪声、反光、遮挡和机械误差产生分布外动作。
如何判断后训练是否有效
建议把评估拆成四层:
| 层级 | 指标 | 目的 |
|---|---|---|
| 数据层 | 丢帧率、同步误差、动作分布、静态片段占比 | 确认训练输入可信 |
| 开环层 | 动作 L1/L2、方向一致率、Chunk 平滑度 | 排除映射和归一化错误 |
| 仿真层 | 任务成功率、进度分、碰撞次数 | 验证闭环策略 |
| 真机层 | 成功率、恢复率、超时、急停次数、动作延迟 | 判断工程可用性 |
训练 loss 可用于观察优化过程,但不能单独证明闭环任务成功;还需分层检查失败模式和安全事件。
先运行一个动作契约检查,不让 55 维掩盖错位
先检查开篇那类"长度对、通道错"的错误。以下只做离线字段核对,不能代替真实设备映射和控制安全检查。
下面把检查缩到一个读者能复制运行的 Python 文件。它只比较作者构造字典与动作数组,不导入模型、不解析官方 YAML。通道名称、单位、两个时间戳和 mask 全由夹具声明:这种声明一致,是进一步接入的起点,不能证明线缆、驱动或归一化文件真的对应它们。示例将相机与状态的允许时间差设为 20 ms,这是演示阈值,实际部署要由采集系统与控制周期另行确定。
运行命令为 python3 examples/check_action_contract.py,本次使用 Python 3.11.6。官方模型环境要求 Python 3.12,与这个仅用标准库的检查器不是同一套依赖。检查器要求输入字典具有代码列出的全部键,缺键会抛 KeyError;它不是接受任意输入的完整配置校验器。
python
"""Author finite fixtures: not the official Robot Config validator or robot control."""
from copy import deepcopy
from math import isfinite

# shortcut: these author fields are not the LingBot configuration schema.
def check_contract(config, action):
    if config["channels"] != config["stats_channels"]:
        return "CHANNEL_ORDER"
    if config["units"] != config["controller_units"]:
        return "UNIT_MISMATCH"
    if len(action) != 55 or len(config["mask"]) != 55:
        return "DIMENSION"
    if not all(type(x) is bool for x in config["mask"]):
        return "MASK_TYPE"
    if not all(isinstance(x, (int, float)) and not isinstance(x, bool)
               and isfinite(x) for x in action):
        return "NONFINITE"
    if config["observed_ms"] < 0 or config["state_ms"] < 0:
        return "TIMESTAMP"
    if abs(config["observed_ms"] - config["state_ms"]) > 20:
        return "TIME_SKEW"
    return "LOCAL_FIELDS_MATCH"


def main():
    config = {"channels": ["left_joint", "right_joint"],
              "stats_channels": ["left_joint", "right_joint"],
              "units": "rad", "controller_units": "rad",
              "mask": [True] * 14 + [False] * 41,
              "observed_ms": 1000, "state_ms": 1010}
    action = [0.0] * 55
    cases = [("matching", {}, action, "LOCAL_FIELDS_MATCH"),
             ("swapped_stats", {"stats_channels": ["right_joint", "left_joint"]}, action, "CHANNEL_ORDER"),
             ("degrees", {"controller_units": "deg"}, action, "UNIT_MISMATCH"),
             ("short_action", {}, action[:-1], "DIMENSION"),
             ("short_mask", {"mask": [True] * 54}, action, "DIMENSION"),
             ("numeric_mask", {"mask": [1] * 55}, action, "MASK_TYPE"),
             ("nan_action", {}, [float("nan")] + action[1:], "NONFINITE"),
             ("bool_action", {}, [True] + action[1:], "NONFINITE"),
             ("negative_clock", {"state_ms": -1}, action, "TIMESTAMP"),
             ("stale_state", {"state_ms": 1030}, action, "TIME_SKEW"),
             ("edge_20ms", {"state_ms": 1020}, action, "LOCAL_FIELDS_MATCH")]
    for name, change, values, expected in cases:
        candidate = deepcopy(config)
        candidate.update(change)
        result = check_contract(candidate, values)
        assert result == expected, (name, result)
        print(f"{name}: {result}")
    print(f"finite_cases={len(cases)}; robot_execution=UNKNOWN")


if __name__ == "__main__":
    main()
本轮真实本地 stdout 如下,进程退出码来自执行记录,不是手写成功证明:
text
matching: LOCAL_FIELDS_MATCH
swapped_stats: CHANNEL_ORDER
degrees: UNIT_MISMATCH
short_action: DIMENSION
short_mask: DIMENSION
numeric_mask: MASK_TYPE
nan_action: NONFINITE
bool_action: NONFINITE
negative_clock: TIMESTAMP
stale_state: TIME_SKEW
edge_20ms: LOCAL_FIELDS_MATCH
finite_cases=11; robot_execution=UNKNOWN
十一条断言覆盖声明匹配、归一化通道顺序交换、单位冲突、动作和 mask 少一维、数字冒充布尔 mask、NaN、布尔动作、负时间、超时差以及恰好 20 ms 的边界。这里没有加载真实归一化统计,也没有把 55 个值映射到关节;前两个通道名称只是解释顺序问题。检查所有位置数值有限,是为了演示形状合格仍有坏值,屏蔽通道也纳入这个作者规则,并不宣称官方要求完全相同。
LOCAL_FIELDS_MATCH 仅意味着函数检查的这些字段没有冲突。它不验证配置中的通道是否覆盖全部 55 维,不判断 mask 对应的机械自由度,不验证坐标、四元数、限幅、碰撞、力矩、执行频率或急停链路。即使所有断言通过,模型装载、峰值显存、实际闭环成功率仍为 UNKNOWN,不能给 Policy Server 一个"安全可下发"的状态。
接入真实数据时,应先将 Robot Config 的映射与同次后训练的 Norm Stats 逐项对照,记录控制器单位和每个通道的索引,再从离线样本核对时间差。样本不满足条件时先定位采集或配置问题,不应通过扩大容差、交换左右手名称或清零异常值来让检查变绿。通过这一层后,才进入原文所述开环、低速闭环和独立安全验证;每一层都保存自己的输入版本与结果,避免把本地算术证据越级当作真机证据。
结论
LingBot-VLA 2.0 的关键升级不是单纯把模型扩大到 6B,而是建立了一条从大规模跨本体预训练到真实机器人后训练的完整链路:
text
6 万小时异构数据
→ 55 维统一动作空间
→ MoE Action Expert
→ 未来语义与几何蒸馏
→ LeRobot 数据适配
→ Robot Config 与 Norm Stats
→ 后训练 checkpoint
→ Policy Server
→ 真实机器人闭环
第一步先拿一份离线样本,把通道索引、Norm Stats 顺序、单位和时间戳对齐;有冲突就停在采集或配置层。硬件章节列出的条件仍须在目标机器上逐项验证。只有分别取得开环、低速闭环与安全探针证据后,才讨论动作服务。
参考资料
- LingBot-VLA 2.0 官方 GitHub
- LingBot-VLA 2.0 论文
- LingBot-VLA 2.0 6B 权重
- LingBot-VLA 2.0 项目页
- LingBot-VLA 1.0 官方 GitHub
- LeRobot