OpenAI 在 10 月 26 日发布了 GPT-6.1 Terra。API 标价为每百万 token 输入 1 美元、缓存输入 0.05 美元、输出 5 美元,上下文窗口 105 万 token,单次最多输出 12.8 万 token。ChatGPT Work 和 Codex 的 Plus、Pro、Enterprise、Edu 用户当天即可使用,API 模型名是 gpt-6.1-terra。
按价格排,Terra 在 OpenAI 当前四档里排第三:Luna 最便宜,往上依次是 Terra、Sol、Astra。它的单价是 Sol 的一半、Astra 的十分之一;换到 Anthropic 那边,是 Sonnet 5.5 的一半、Opus 5.5 的四分之一。
发布文里最显眼的两个说法是「与 GPT-6 Astra 表现持平,价格只有十分之一」和「比 Claude Opus 5.5 每任务便宜约 9 倍」。本文先核对这两句话分别是在什么条件下测出来的,再用编程 agent 的实际 token 结构算一遍账,最后给出什么场景该换、什么场景不该换的判断。
结论先放在这里:这两个说法都成立,但都只针对电脑操作类任务。编程方面,OpenAI 在同一篇文章里明确写了最复杂的编程任务仍应使用 Sol 或 Astra。对编程 agent 来说,Terra 真正的意义是价格:两家的缓存读取都按输入价的 5% 收费,所以 Terra 的四分之一单价会原样体现在每次请求的成本上。
「与 Astra 持平」的测试条件
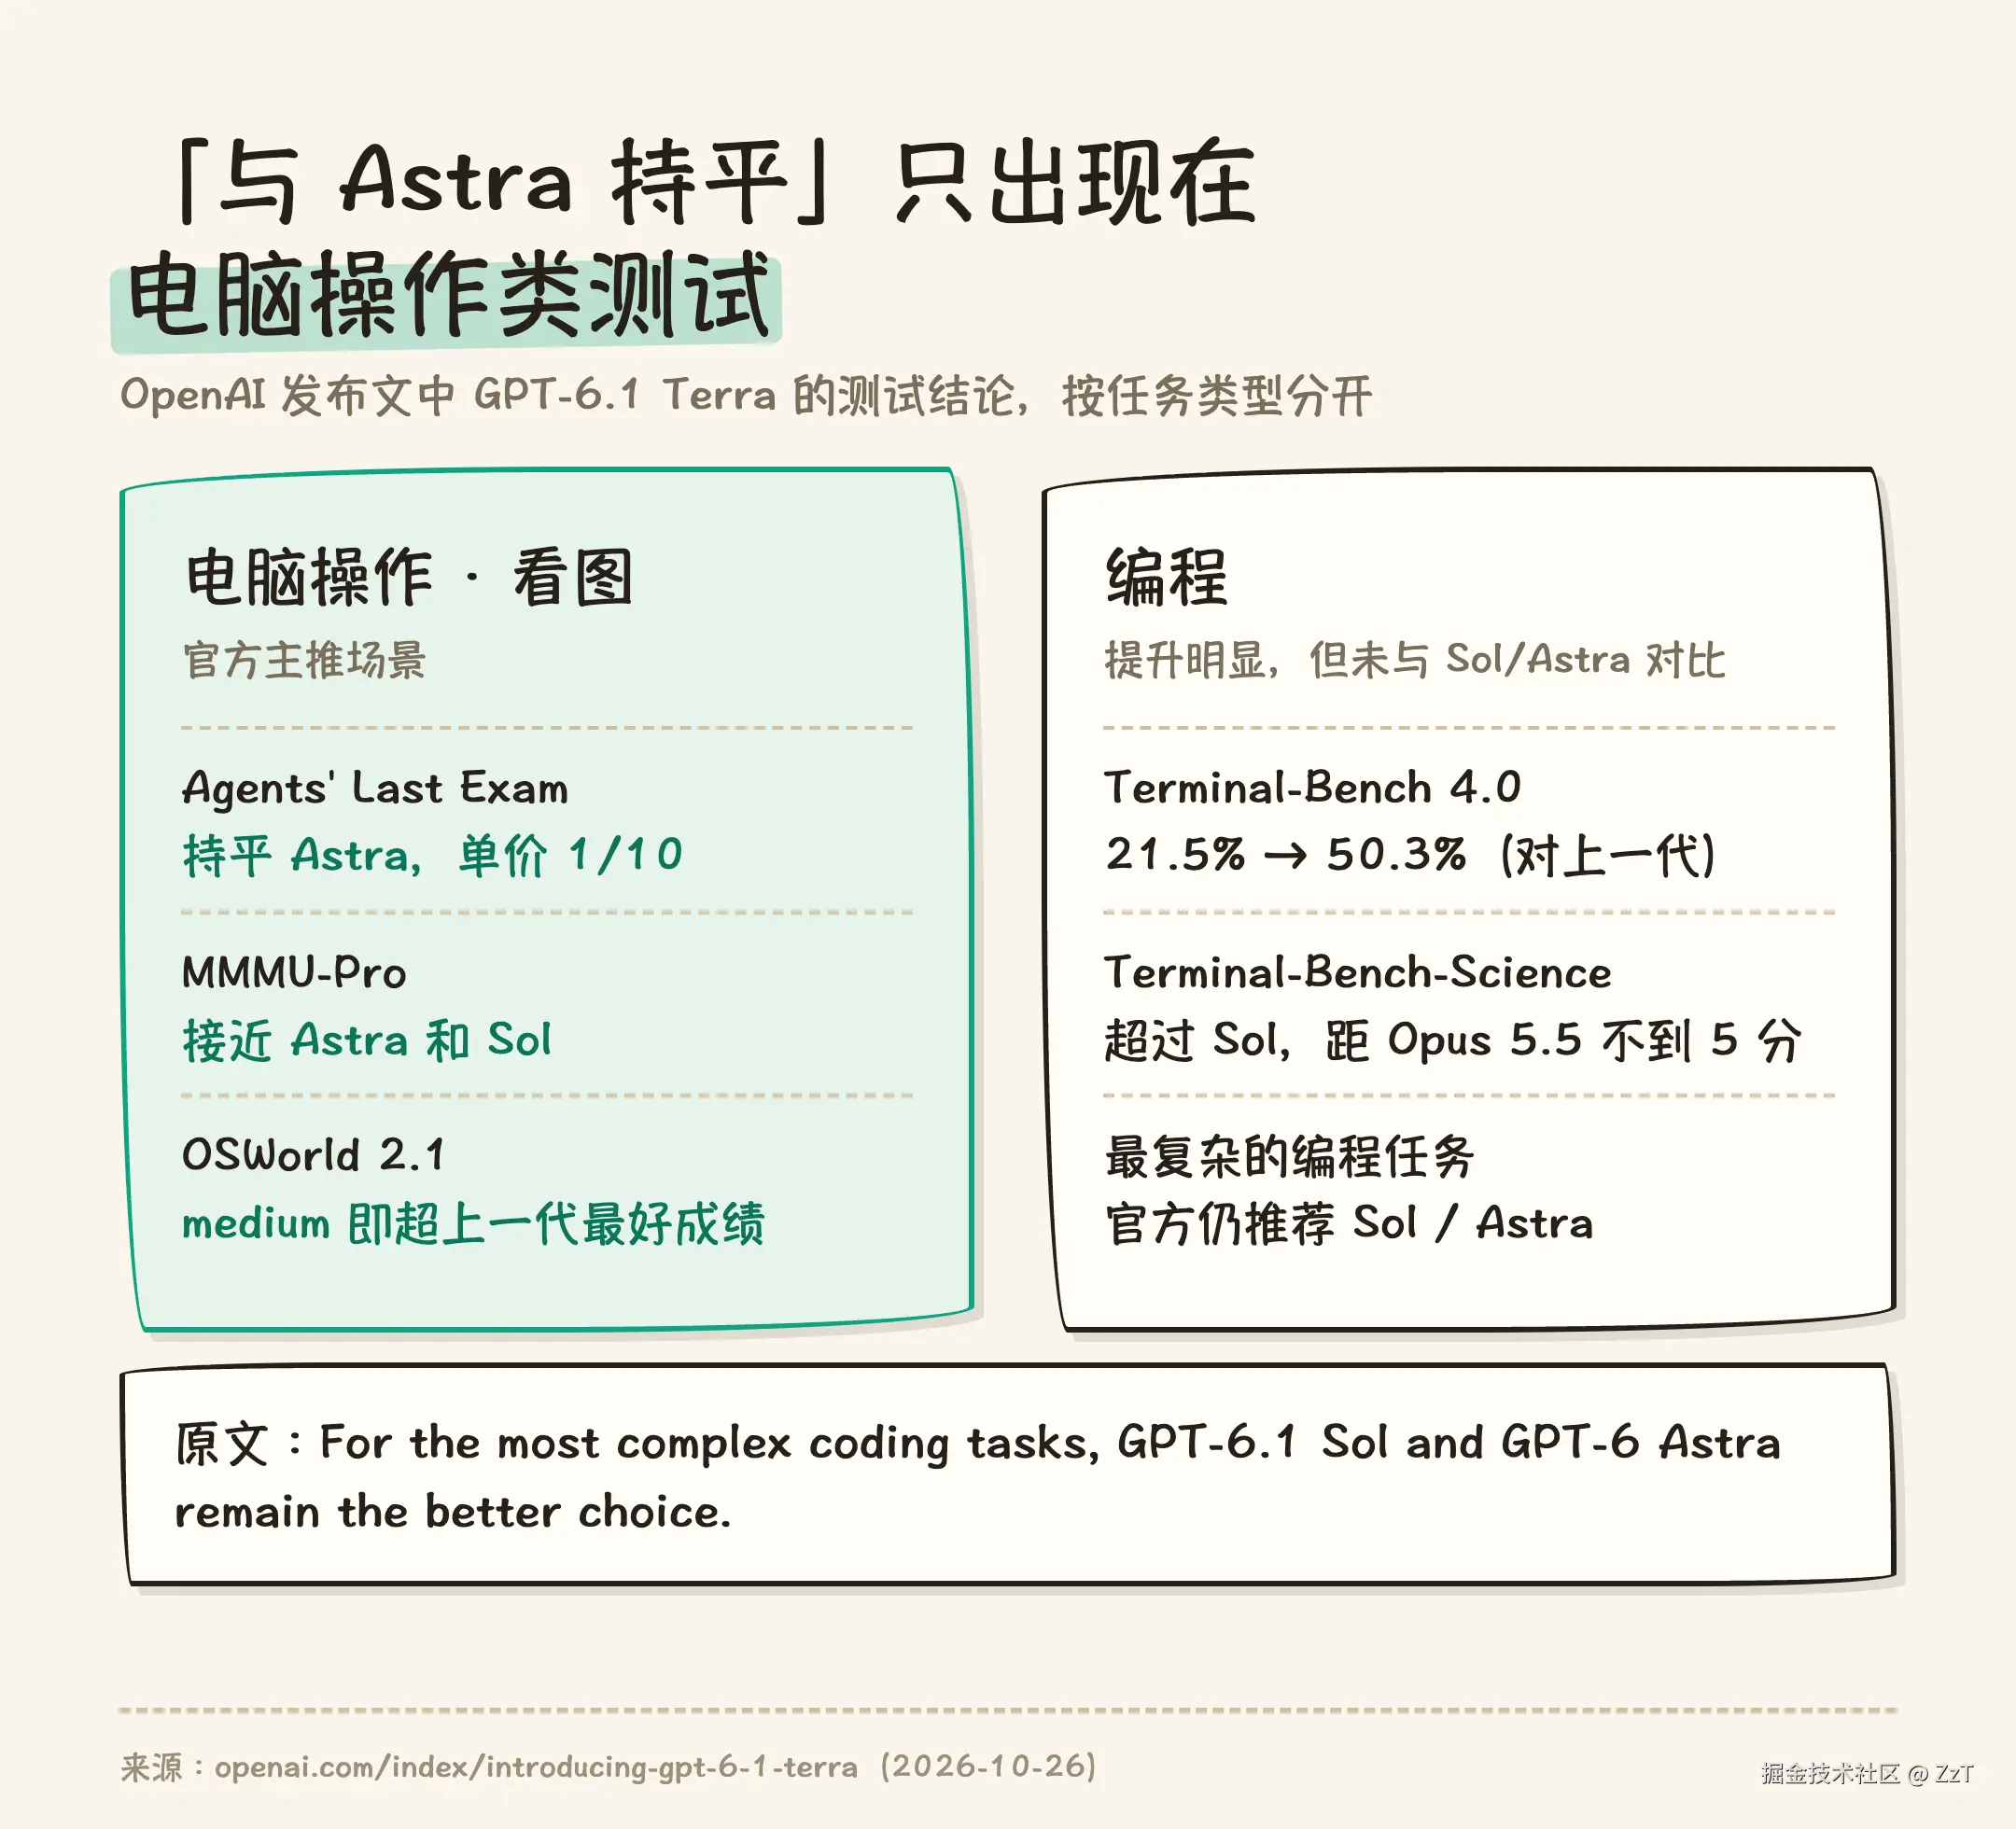
这句话的原文是:在 Agents' Last Exam 上,Terra 用 medium reasoning effort 时表现「与 GPT-6 Astra 持平,单价只有其十分之一」。
Agents' Last Exam 测的是电脑操作类的专业任务,官方举的例子是把建筑图纸做成 3D 模型、逐镜头审阅一部动画片并生成带时间码的修复日志。同一项测试里,Terra 比上一代 GPT-5.6 Terra 高 15 个百分点,成本约为后者的三分之一;完成任务的速度是 Astra 和 Sol 的三倍以上。
另外两项视觉与电脑操作测试的结论方向一致。MMMU-Pro 上,Terra 在每一档 reasoning effort 下都超过 GPT-5.6 Terra,接近 Astra 和 Sol;OSWorld 2.1 上,Terra 用 medium effort 就超过了 GPT-5.6 Terra 的最好成绩。
所以,「与 Astra 持平」指的是看图、操作桌面应用、填表这一类任务。OpenAI 给的使用场景也集中在这里,例如读取收到的发票并把明细录入财务软件。
编程能力:翻倍,但官方不推荐用于最复杂的任务
编程部分的数字是 Terminal-Bench 4.0。这项测试让 coding agent 在命令行里解决问题,例如修复一个加载时布局跳动的网页。Terra 在 max effort 下完成 50.3%,GPT-5.6 Terra 公布的成绩是 21.5%,提升超过一倍。
紧接着这组数字,原文写的是:「最复杂的编程任务,GPT-6.1 Sol 和 GPT-6 Astra 仍是更好的选择。」发布文没有给出 Terra 与 Sol、Astra 在 Terminal-Bench 上的对比分数。
科研编程方面,Terminal-Bench-Science 0.1 上 Terra 在 max effort 下超过了 Sol,与 Opus 5.5 相差不到 5 分,估算成本不到 Opus 5.5 的五分之一。
事实性也有明显改进。在 OpenAI 内部的一组诱错提示上,low effort 的错误率从 GPT-5.6 Terra 的 53.6% 降到 16.7%;max effort 下降了 18 个百分点,到 4.3%,接近 Astra 和 Sol。这组提示是 OpenAI 自建的,没有公开题目。
「比 Opus 5.5 便宜约 9 倍」的两个因子相乘不等于 9
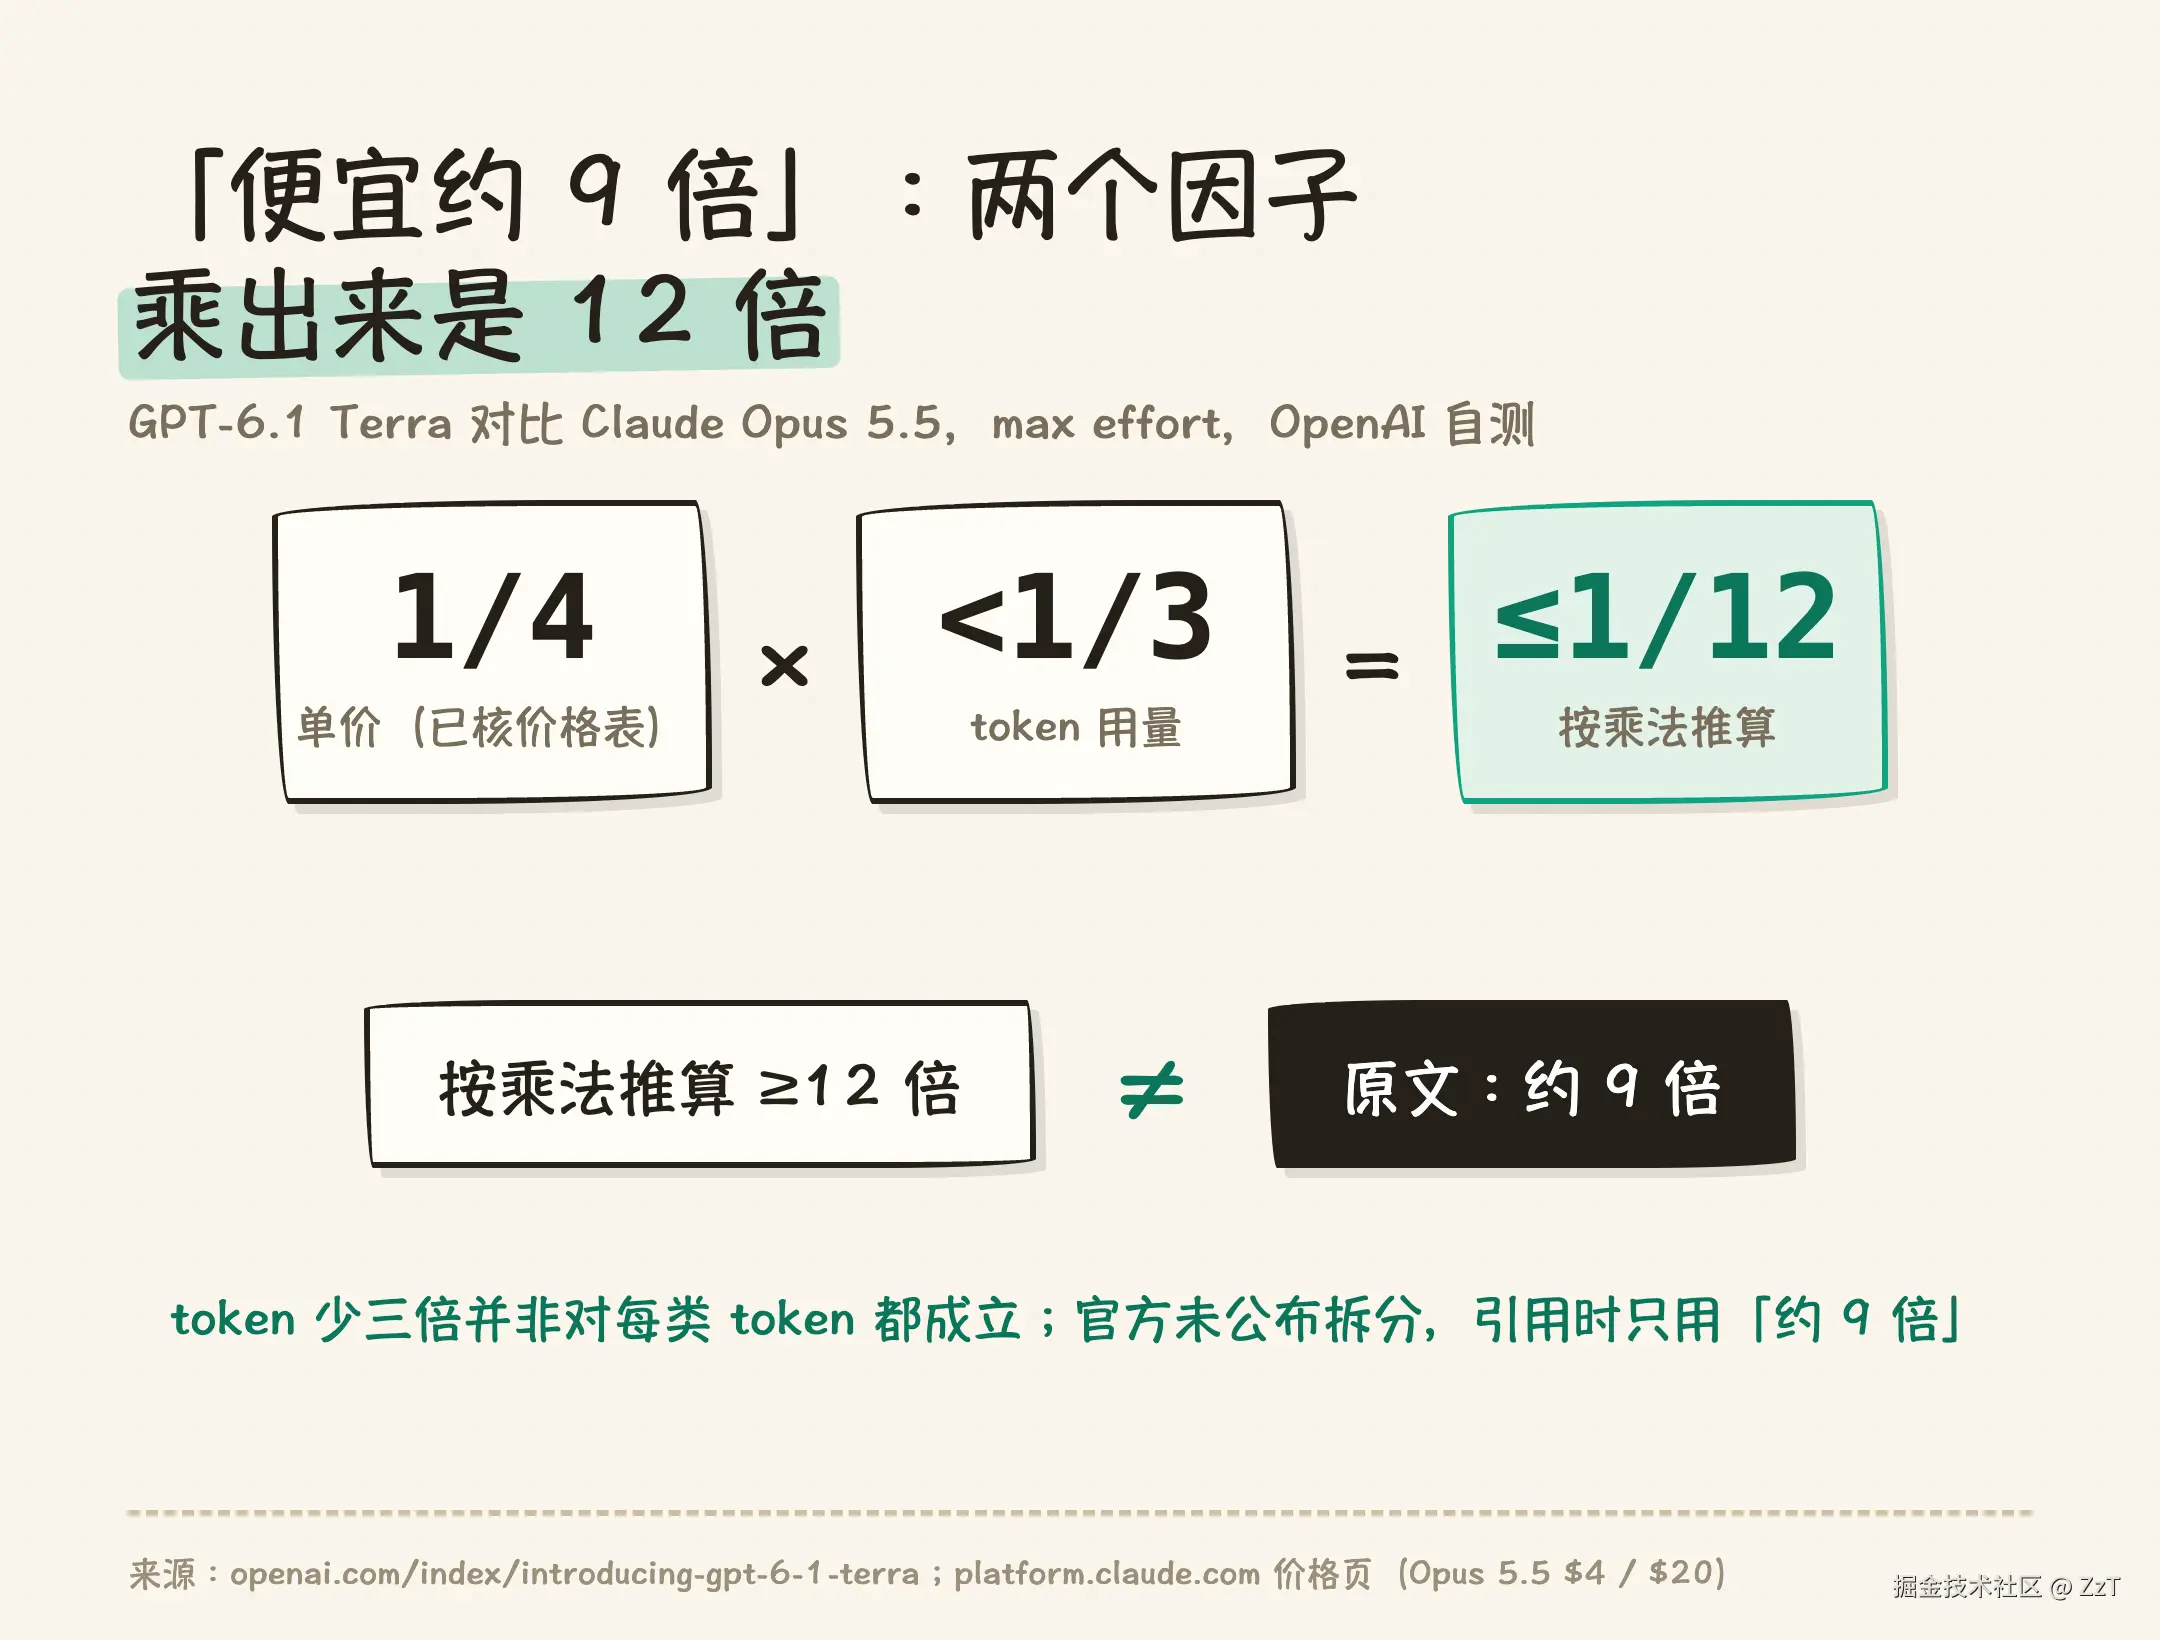
原文的表述分三句:在 max effort 下,Terra 的 token 效率是 Opus 5.5 的三倍以上;单价是 Opus 5.5 的四分之一;因此每任务成本低约 9 倍。
单价这一项可以独立核对。Anthropic 价格页上 Opus 5.5 是输入 4 美元、输出 20 美元,Terra 是 1 美元和 5 美元,正好是四分之一。
问题在乘法上。单价四分之一,token 用量三分之一以下,两项相乘应该是十二分之一或更低,而原文给的是约 9 倍。两个数字对不上,说明「token 效率三倍」并不是对所有类型的 token 都成立:较可能的情况是输出 token 少了三倍,但输入 token 没有按同样比例减少。OpenAI 没有公布每任务成本的拆分,所以引用时应该用它给出的「约 9 倍」,不能自己把两个因子相乘得出 12 倍。
另外需要注意,这组对比是 OpenAI 用自己选的测试、在 Terra 的 max effort 下测出来的,目前没有第三方复现。
编程 agent 的每次请求成本
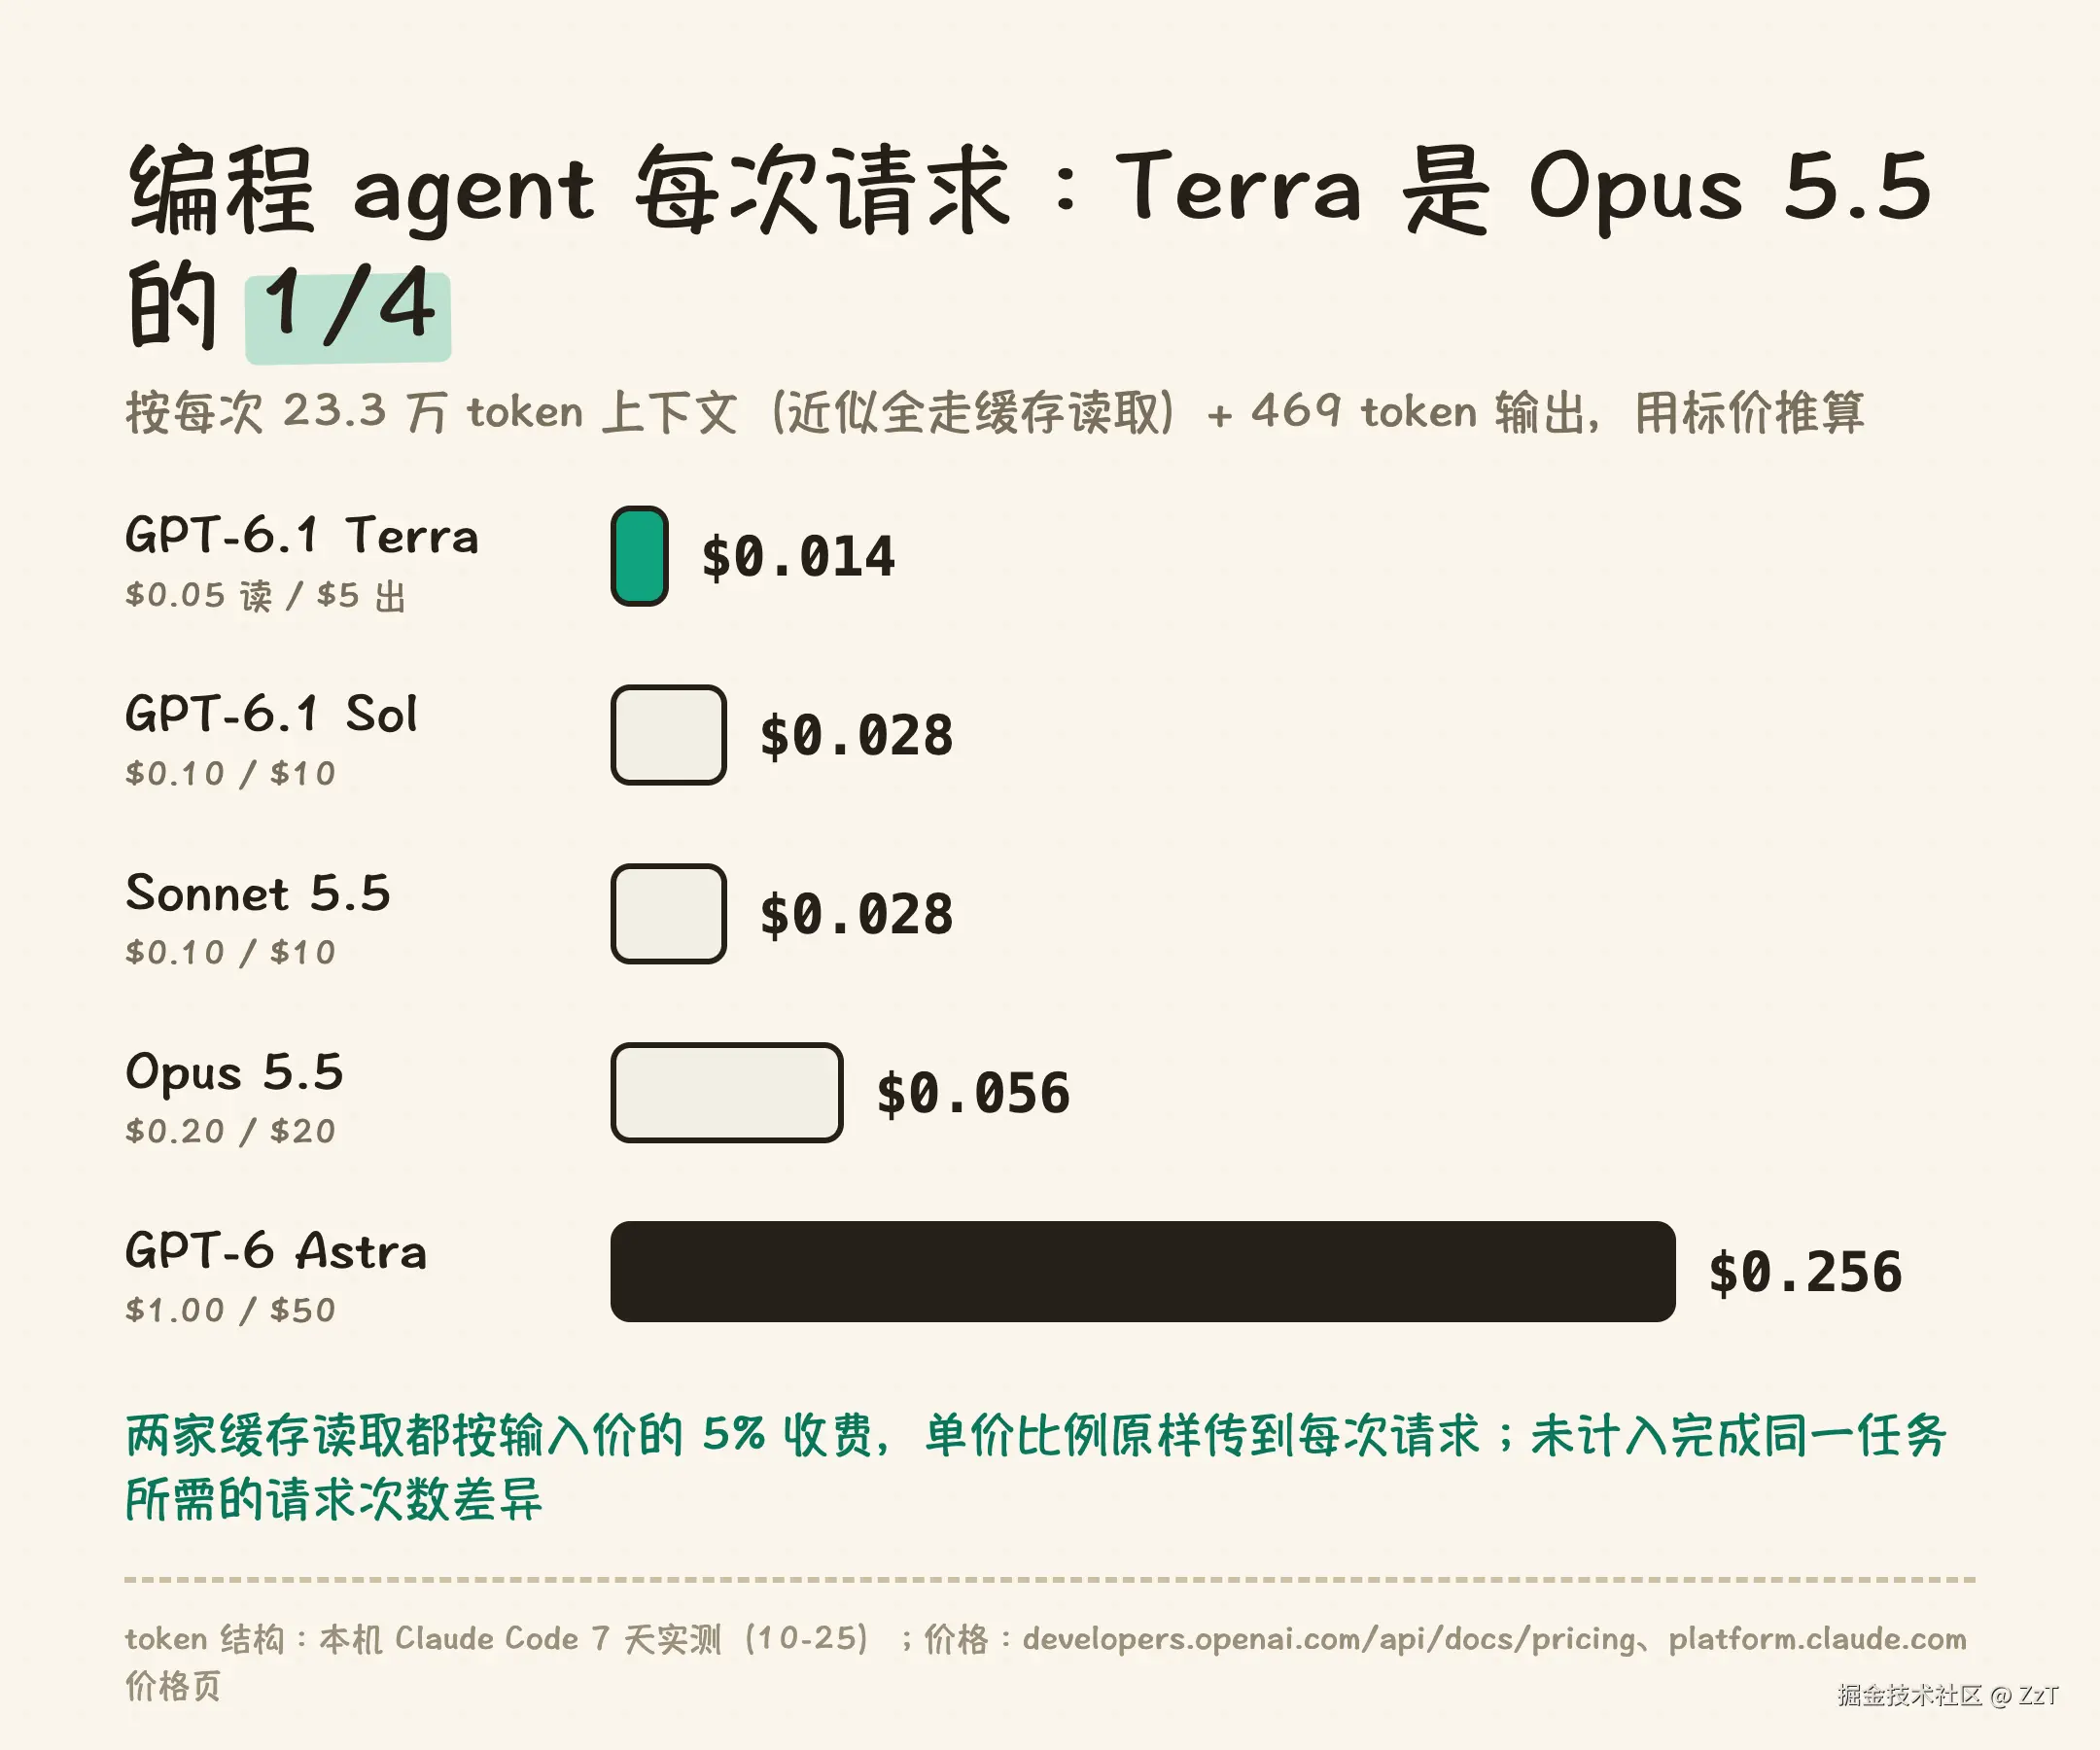
编程 agent 的 token 结构和聊天很不一样。我们 10 月 25 日用本机 7 天的 Claude Code 记录做过统计:平均每次请求带 23.3 万 token 上下文,只输出 469 个 token,绝大部分输入走缓存读取。
两家的缓存读取定价规则相同:Terra 的缓存输入是未缓存输入价的 5%,Opus 5.5 和 Sonnet 5.5 也是 0.05 倍。因此按这个结构折算,近似把输入全部算作缓存读取,Terra 每次请求约 0.014 美元,Sol 和 Sonnet 5.5 约 0.028 美元,Opus 5.5 约 0.056 美元,Astra 约 0.256 美元。
缓存读取的比例两家一致,所以单价之比原样传到了每次请求:Terra 是 Opus 5.5 的四分之一,与 Sol、Sonnet 5.5 相比是一半。这组数字只算单价,没有计入不同模型完成同一任务所需的请求次数和输出长度,那部分要看具体任务实测。
缓存写入的规则两家不同。OpenAI 提供 30 分钟和 12 小时两档保留,Terra 分别收 1.25 美元和 2.5 美元;Anthropic 是 5 分钟和 1 小时,Opus 5.5 收 5 美元和 8 美元。会话中途停顿较长的用法,缓存过期后要整段重写,这一项的差距会比上图更大。
适用场景判断
| 场景 | 判断 |
|---|---|
| 看图、填表、操作桌面应用、批量处理单据 | 可以优先试 Terra,这是官方测试覆盖最多、与 Astra 持平的领域 |
| 编程 agent 的日常改动、脚本、批量重构 | 值得用自己的任务和 Sol、Sonnet 5.5 对测一轮,单价是它们的一半 |
| 最复杂的编程任务 | 按 OpenAI 自己的建议,继续用 Sol 或 Astra |
| 需要引用「比 Opus 便宜 9 倍」 | 注明是 OpenAI 在 max effort、电脑操作类任务上的自测数字 |
还有一点会影响部署:Terra 的工具调用必须走 Responses API,原来基于 Chat Completions 写的工具调用代码需要迁移。另外,按 OpenAI 的 Preparedness Framework,Terra 的网络安全能力达到了 Critical 阈值,OpenAI 为它沿用了 Astra 的防护措施。
参考
- OpenAI,Introducing GPT-6.1 Terra:openai.com/index/intro...
- OpenAI API 模型页 gpt-6.1-terra:developers.openai.com/api/docs/mo...
- OpenAI API 价格页:developers.openai.com/api/docs/pr...
- OpenAI API Changelog(10 月 26 日条目):developers.openai.com/api/docs/ch...
- Anthropic Claude 价格页:platform.claude.com/docs/en/abo...