【计算基础|MySQL17】三大日志:undo / redo / binlog
面试问"InnoDB 怎么保证事务的 ACID",十个人里八个会蹦出 MVCC、锁、WAL,却答不清三个日志各自管哪一头。线上删错了表,你知道用 binlog 做时间点恢复;数据库突然断电重启,已提交的数据一条没少------这背后是 redo log 在干活;而一个长事务拖着不让 purge 线程清理 undo,导致 undo 表空间暴涨几十 G,又是很多人没踩过、但一定会听到的坑。
这一篇把 undo log、redo log、binlog 这"三大日志"一次讲透:各自在哪一层产生、是逻辑还是物理、什么时候写、什么时候删、崩溃恢复时谁先谁后。结尾的两阶段提交(2PC)是把 redo 和 binlog 串起来的关键,也是面试高频。所有输出都在 Docker MySQL 8.0.46 上真实跑过。
环境:Docker 起 MySQL 8.0.46(
--log-bin=mysql-bin --binlog-format=ROW,innodb_flush_log_at_trx_commit=1,sync_binlog=1),mysqlbinlog 客户端解析 binlog。
一、先站高一层:三大日志分别是谁、管什么
结论前置:undo log 管"回滚"和"MVCC",redo log 管"崩溃不丢已提交数据",binlog 管"归档"和"主从复制"。前两个是 InnoDB 内部日志,binlog 是 Server 层日志,所有存储引擎共用。
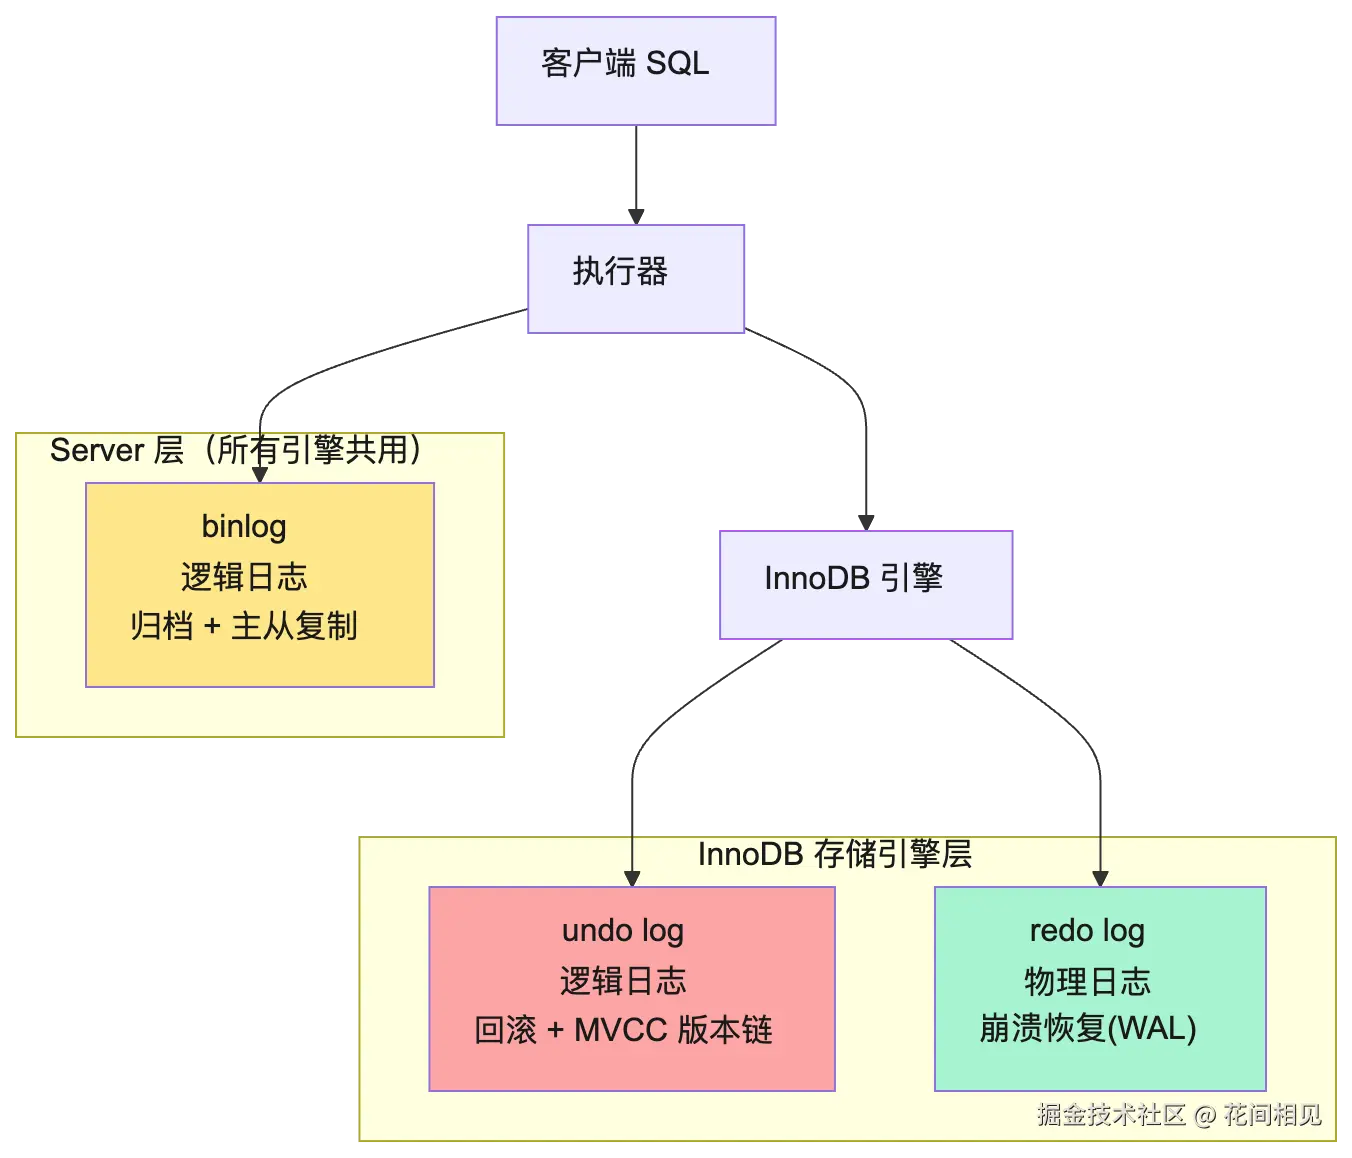
一句话记住分工:
| 日志 | 产生层 | 日志类型 | 核心职责 | 对应 ACID |
|---|---|---|---|---|
| undo log | InnoDB | 逻辑日志 | 事务回滚、MVCC 版本链 | 原子性 A + 隔离性 I |
| redo log | InnoDB | 物理日志 | 崩溃后恢复已提交但未刷盘的数据 | 持久性 D |
| binlog | Server 层 | 逻辑日志 | 时间点恢复(归档)、主从复制 | 不直接对应 ACID,是运维/复制底座 |
🔴 最容易混的一点:redo 和 undo 都在 InnoDB 内部,但 redo 记"对哪个页做了什么物理修改",undo 记"修改前长什么样(逻辑上怎么撤销)"。binlog 在 Server 层,记的是"这条 SQL/这些行最终变成了什么"。
二、undo log:回滚与 MVCC 的底牌
2.1 两个作用
undo log 干两件事:
- 事务回滚(保证原子性):事务中途出错或显式 ROLLBACK,靠 undo 把数据改回原样。
- MVCC 版本链(保证隔离性):一个行被更新后,旧版本不直接删,而是串在 undo 里,让读快照的事务能读到历史版本。
2.2 两种 undo log
| 类型 | 记录内容 | 回滚时动作 | 什么时候删 |
|---|---|---|---|
| INSERT undo log | 插入的主键 | 回滚时直接 DELETE 掉这条 | 事务提交后即可删除(INSERT 还没人看得见,没必要留) |
| UPDATE undo log | 更新前的"旧行镜像" | 回滚时把旧值写回去 | 要等没有任何 Read View 还引用它时,由 purge 线程清理 |
⚠️ 长事务为什么危险:一个事务开了快照一直不提交,它的 Read View 会"挡住" purge 线程------所有被它之后更新的行,旧版本都得留在 undo 里不能删。undo 表空间于是越撑越大,还不能自动收缩。这就是线上"一个忘了提交的事务,把磁盘吃满"的经典事故。
2.3 undo log 是逻辑日志,不是物理页镜像
很多人以为 undo 存的是"整个数据页的旧拷贝",错了。undo 是逻辑日志:它记录的是"如何反向操作"。
- 你 INSERT 了一行
(1,'a'),undo 记的逻辑动作是"把 id=1 这行删掉"; - 你 UPDATE 把
name从a改成x,undo 记的是"把 id=3 的 name 改回a"。
它不是把整个 16KB 页原样存一份,而是记录反向逻辑操作。这也是它叫"逻辑日志"的原因。
2.4 UPDATE 时 undo 怎么写、版本链怎么串

当前行头里有个 roll_pointer,指向上一个版本;上个版本里又指向上上个版本,串成一条版本链。读快照的事务顺着这条链找到自己能看见的那个版本。
2.5 undo 存哪、长什么样
MySQL 5.7 之前 undo 挤在系统表空间 ibdata1 里,不能收缩,越用越大。5.7 开始支持独立 undo 表空间,MySQL 8 默认就是两个独立文件,还支持在线截断。本机实跑:
bash
$ docker exec mysql8 bash -c "ls -la /var/lib/mysql/undo*"
-rw-r----- 1 mysql mysql 16777216 ... /var/lib/mysql/undo_001
-rw-r----- 1 mysql mysql 33554432 ... /var/lib/mysql/undo_002
sql
mysql> SHOW VARIABLES LIKE 'innodb_undo%';
+--------------------------+-------+
| Variable_name            | Value |
+--------------------------+-------+
| innodb_undo_directory     | ./    |
| innodb_undo_tablespaces   | 2     |
| innodb_undo_log_truncate | ON    |
+--------------------------+-------+
✅ 成功标志 :看到 undo_001、undo_002 两个独立文件,innodb_undo_tablespaces=2,innodb_undo_log_truncate=ON(支持在线 truncate)。
三、redo log:WAL,崩溃不丢数据的功臣
3.1 为什么需要它
磁盘一次随机 IO 是 ms 级,内存是 ns 级,差了好几个数量级。如果每次提交事务都把改动的数据页刷回磁盘,性能根本扛不住。InnoDB 的做法是 WAL(Write-Ahead Logging,预写日志):
先把"我对哪个页做了什么修改"顺序写进 redo log,再慢慢把脏页刷盘。redo 是顺序写,比随机刷数据页快得多。
这样即使数据库突然断电,重启时只要重放 redo log,就能把"已经提交、但还没来得及刷盘"的数据恢复回来------这就是持久性 D。
3.2 redo 是物理日志(physiological logging)
redo 记的不是 SQL,也不是"怎么撤销",而是**"对哪个页(page no.)的哪个偏移量,把某几个字节改成什么值"**。它定位到物理页,再描述页内的逻辑修改,这种叫 physiological logging。正因为它知道要改的是哪个页、改成什么,崩溃后重放一遍就能精确还原,速度快。

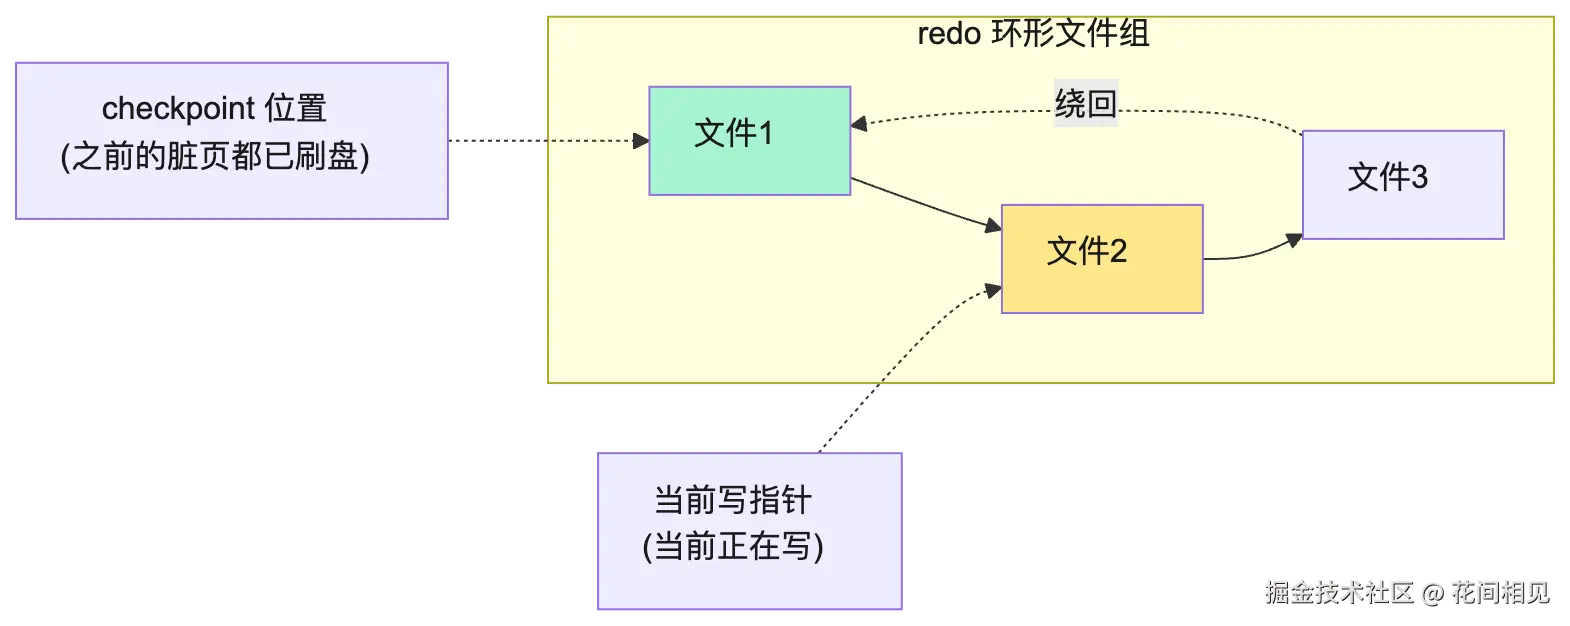
3.3 固定大小、循环写
redo log 文件大小固定,写满了就回头覆盖最早的。本机实跑(注意:MySQL 8.0.30 后用 innodb_redo_log_capacity 统一控制,旧版的 innodb_log_file_size / innodb_log_files_in_group 被取代):
sql
mysql> SHOW VARIABLES LIKE 'innodb_redo_log_capacity';
+------------------------+-----------+
| Variable_name          | Value     |
+------------------------+-----------+
| innodb_redo_log_capacity  | 104857600 |  -- 100MB
+------------------------+-----------+
bash
$ docker exec mysql8 bash -c "ls /var/lib/mysql/#innodb_redo/ | head"
#ib_redo100_tmp
#ib_redo101_tmp
#ib_redo102_tmp
...
⚠️ 版本差异 :MySQL 5.x 看到的是数据目录下两个固定的 ib_logfile0、ib_logfile1(默认各 48MB)。MySQL 8.0.30 改成了 #innodb_redo/ 目录下一组编号文件,容量动态可调,但"固定大小、循环写、写满绕回"的原理完全一样。
循环写的关键约束:当 redo 要覆盖某段日志时,必须先确保那段日志对应的脏页已经刷盘了;如果还没刷,就被迫停下来等("log wait",线程被卡住),这就是高并发写入时偶发卡顿的原因之一。
3.4 刷盘时机:innodb_flush_log_at_trx_commit
这是面试必问,也是安全性和性能的权衡。redo 先写内存里的 log buffer(默认 16MB),什么时候真正 fsync 到磁盘由这个参数决定:
sql
mysql> SHOW VARIABLES LIKE 'innodb_log_buffer_size';
+----------------------+----------+
| innodb_log_buffer_size | 16777216 |   -- 16MB
+----------------------+----------+| 取值 | commit 时动作 | 什么时候刷盘 | MySQL 崩 | 操作系统/机器崩 |
|---|---|---|---|---|
| 0 | 不刷 | 每秒刷一次 | 丢 1 秒数据 | 丢 1 秒数据 |
| 1(默认,最安全) | 每次 commit 都刷盘 | commit 时 | 不丢已提交数据 | 不丢已提交数据 |
| 2 | commit 只写到 OS page cache | 每秒从 page cache 刷盘 | 不丢(还在 OS 缓存) | 丢 1 秒数据 |
🔴 生产默认就是 1。2 比 1 快不少,但机器断电(不是 MySQL 挂,是整机掉电)时 OS page cache 里没刷的那 1 秒就没了。对多数业务,老老实实保持 1;只有能容忍极端情况下丢 1 秒的日志类、计数类业务才考虑 2。
四、binlog:归档与主从复制的日志
4.1 作用与位置
binlog 在 Server 层产生,不管你用 InnoDB 还是 MyISAM 都有。两个用途:
- 归档 / 时间点恢复(PITR):误操作后,用"全量备份 + 备份点之后的 binlog"把数据库恢复到任意时刻。
- 主从复制:主库把 binlog 发给从库重放,从库数据就跟主库一致了。
本机确认它开着:
sql
mysql> SHOW VARIABLES LIKE 'log_bin';
+---------------+-------+
| Variable_name | Value |
+---------------+-------+
| log_bin       | ON    |

mysql> SHOW BINARY LOGS;
+---------------+-----------+
| Log_name      | File_size |
+---------------+-----------+
| binlog.000003 |   2998143 |
| binlog.000004 |    947    |
+---------------+-----------+
4.2 三种格式:STATEMENT / ROW / MIXED
这是面试高频,也是实战最容易踩坑的地方。
| 格式 | 记录什么 | 优点 | 缺点 | 默认 |
|---|---|---|---|---|
| STATEMENT | 原始 SQL 文本 | 文件小 | 不确定函数(NOW()、UUID()、LIMIT 无 ORDER BY)主从不一致 |
MySQL 5.7.7 之前 |
| ROW | 每行变更的前后镜像 | 准确、不会不一致 | 文件大 | MySQL 8 默认 |
| MIXED | 一般用 STATEMENT,不安全时自动切 ROW | 兼顾 | 行为不透明 | --- |
我在本机用同一条含 NOW() 的 UPDATE 分别跑 STATEMENT 和 ROW,再用 mysqlbinlog 解析,差异一目了然。
STATEMENT 格式记录的是 SQL 原文:
bash
$ mysqlbinlog binlog.000005 | grep -E "^UPDATE|^use "
use `blog17`/*!*/;
UPDATE fmt_test SET ts=NOW() WHERE id=1
注意它记的是 NOW() 这个函数调用本身 。主从两台机器时钟不同,从库重放时 NOW() 取的是从库自己的时间戳------和主库执行时的时间不一样,数据就偏了。这就是 STATEMENT 对不确定函数不安全的铁证。
ROW 格式记录的是具体行的前后镜像:
bash
$ mysqlbinlog --base64-output=DECODE-ROWS -v binlog.000006
### UPDATE `blog17`.`fmt_test`
### WHERE
###   @1=2
###   @2='2024-01-01 00:00:00'     ← 前镜像(旧值)
### SET
###   @1=2
###   @2='2026-09-24 07:48:09'     ← 后镜像(实际写入的具体时间戳)
ROW 不关心你用了什么函数,它只记"这一行从 2024-01-01 变成了 2026-09-24 07:48:09"。从库照着实值写,绝不可能跑偏。代价是全表 UPDATE 会记录每一行的变更,binlog 体积暴涨。
binlog_row_image 控制 ROW 格式记多少列:FULL(前后镜像都记全部列,默认最安全)、MINIMAL(只记必要列)、NOBLOB(大字段没改就不记)。
4.3 binlog 怎么写、怎么刷盘
一个事务在内存里先进 binlog cache ,commit 时才一次性写进 binlog 文件,再按 sync_binlog 刷盘:
sql
mysql> SHOW VARIABLES LIKE 'sync_binlog';
+---------------+-------+
| Variable_name | Value |
+---------------+-------+
| sync_binlog   | 1     |   -- 每次 commit 都刷盘,最安全
+---------------+-------+
sync_binlog=1 表示每次事务提交都 fsync binlog,和 innodb_flush_log_at_trx_commit=1 并称"双 1",是金融级业务的标配。设成 0 则交给 OS 决定何时刷,性能高但宕机可能丢 binlog。
4.4 怎么查看 binlog
sql
mysql> SHOW BINARY LOGS;                       -- 列出所有 binlog 文件
mysql> SHOW MASTER STATUS;                     -- 当前正在写的文件和位点
mysql> SHOW BINLOG EVENTS IN 'binlog.000003';  -- 看某个文件里的事件
本机真实事件流(ROW 格式下一个 DELETE 事务长这样):
sql
Log_name        Pos    Event_type     End_log_pos  Info
binlog.000003   236    Query          313          BEGIN
binlog.000003   313    Table_map      370          table_id: 135 (blog17.t)
binlog.000003   370    Delete_rows    419          table_id: 135 flags: STMT_END_F
binlog.000003   419    Xid            450          COMMIT /* xid=851 */
用 mysqlbinlog 命令行工具能把文件解析成可读 SQL/行镜像,是做时间点恢复的核心工具(实战篇 MySQL20 会完整演示删表后怎么救回来)。
五、两阶段提交(2PC):把 redo 和 binlog 串起来
5.1 为什么需要它
问题来了:redo log 是 InnoDB 自己的,binlog 是 Server 层的,两个独立日志。如果只写了其中一个就崩了,会发生什么?
- 假设 redo 写了、事务提交了,但 binlog 还没写就崩了 → 从库(靠 binlog 复制)永远不知道这个事务,主从数据不一致。
- 假设 binlog 写了,但 redo 还没 commit 就崩了 → 主库恢复后这个事务被回滚,从库却已经重放了 binlog,主库少了一行、从库多了一行。
所以必须保证 redo 和 binlog 要么都写成功、要么都不写。MySQL 用内部两阶段提交 解决,注意这是数据库内部的 XA,不是跨库分布式事务。
5.2 流程
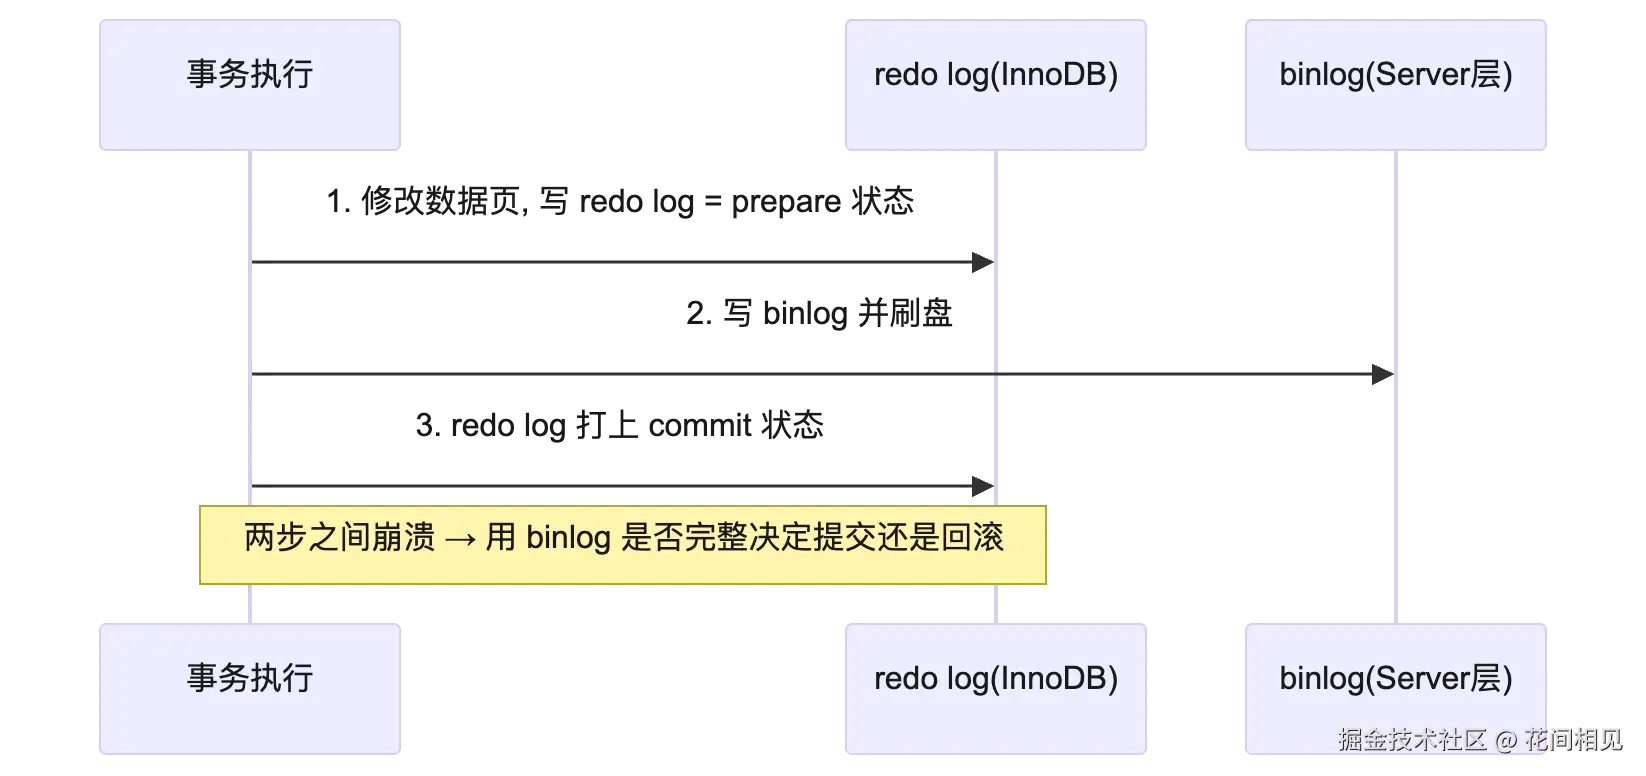
- 执行器调 InnoDB 更新数据,先写 redo log,状态置为 prepare;
- 写 binlog 并刷盘;
- InnoDB 再把 redo log 改成 commit 状态。
5.3 崩溃恢复时怎么判断
重启恢复时,扫描到 prepare 状态的 redo,就去查对应的 binlog:
| redo 状态 | binlog 状态 | 恢复动作 |
|---|---|---|
| prepare | binlog 完整存在 | 认为事务提交成功,commit |
| prepare | binlog 不完整/丢失 | 认为事务没完成,回滚 |
| 已经是 commit | --- | 什么都不做 |
这个逻辑保证了:binlog 写成功的事务一定在主库提交、一定能被从库收到;binlog 没写完的事务一定被回滚、从库也没有。两边就对齐了。
六、三大日志一表总结 + 面试怎么考
| 维度 | undo log | redo log | binlog |
|---|---|---|---|
| 产生层 | InnoDB | InnoDB | Server 层 |
| 日志类型 | 逻辑 | 物理(physiological) | 逻辑 |
| 作用 | 回滚 / MVCC | 崩溃恢复(WAL) | 归档 / 主从复制 |
| 写入时机 | 修改前记旧值 | 修改后、commit 时 | commit 时一次性写 |
| 文件特点 | 动态增长、可被 purge 清理 | 固定大小、循环写 | 滚动追加、可手动删 |
| 对应 ACID | A + I | D | 运维/复制 |
🔴 面试高频问题清单:
- 三大日志分别是什么、在哪层、什么类型、干什么用?
- 什么是 WAL?为什么 redo 是顺序写还能比随机刷页快?
innodb_flush_log_at_trx_commit三个值的区别?生产为什么默认 1?- binlog 三种格式,为什么 MySQL 8 默认 ROW?STATEMENT 对哪些函数不安全?
- 为什么需要两阶段提交?过程是什么?崩溃恢复时 prepare 状态怎么处理?
- undo log 什么时候能删?长事务为什么会撑爆 undo?
- redo 写满了会怎样?(被迫刷脏页、业务卡顿)
总结:你真正需要记住的 7 件事
- undo 管回滚+MVCC(逻辑日志,InnoDB),redo 管崩溃恢复(物理日志,InnoDB),binlog 管归档+主从(逻辑日志,Server 层)。
- undo 是逻辑日志,记"怎么反向操作";UPDATE undo 要等没有 Read View 引用才由 purge 清理,所以长事务会撑爆 undo。
- redo 靠 WAL:先顺序写日志、后台慢慢刷脏页,崩溃后重放恢复已提交数据;文件固定大小循环写。
innodb_flush_log_at_trx_commit=1是默认最安全档;配合sync_binlog=1即"双 1"。- binlog 三格式里 MySQL 8 默认 ROW------用真实行前后镜像,不靠重放 SQL,杜绝
NOW()这类不确定函数导致的主从不一致。 - redo(InnoDB)和 binlog(Server 层)是两个独立日志,靠内部两阶段提交对齐:redo prepare → 写 binlog → redo commit。
- 崩溃恢复时,prepare 状态的 redo 看 binlog 完不完整:完整就提交,不完整就回滚。
验证清单
- 能说出三大日志各自的产生层、类型、作用,并举出一个各自解决的问题
- 能解释为什么长事务会让 undo 表空间暴涨,以及 purge 线程的作用
- 能默写
innodb_flush_log_at_trx_commit三档的安全性差异,并说出"双 1"是哪两个参数 - 能用 mysqlbinlog 分别解析 STATEMENT 和 ROW 格式,指出
NOW()在两种格式下的不同记录方式 - 能画出两阶段提交流程,并说清 prepare 状态下崩溃时的恢复决策
- 能解释 redo log 为什么是固定大小循环写,写满会发生什么
- 知道 MySQL 8 的 redo 文件在
#innodb_redo/目录、用innodb_redo_log_capacity控制(而非旧版 ib_logfile)
参考资源
- MySQL 8.0 Reference Manual --- InnoDB redo log: dev.mysql.com/doc/refman/...
- MySQL 8.0 Reference Manual --- Undo logs: dev.mysql.com/doc/refman/...
- MySQL 8.0 Reference Manual --- The Binary Log: dev.mysql.com/doc/refman/...
- MySQL 8.0 Reference Manual --- mysqlbinlog 工具: dev.mysql.com/doc/refman/...
- MySQL 8.0 Reference Manual --- Replication implementation / XA: dev.mysql.com/doc/refman/...
下一篇《Buffer Pool 与内存管理》接着讲:为什么 InnoDB 读写都要先经过一块 128MB(生产动辄几十 G)的内存?普通 LRU 为什么会被一次全表扫描击穿,InnoDB 又是怎么用"年轻区/老年区 + 中点插入"防缓存污染的?Change Buffer 凭什么只给非唯一二级索引加速?脏页、双写缓冲、自适应哈希索引一次讲透。