01 引言
前两天分享一个**RapidOCR**的项目,今天又发现一款OCR项目,Python零依赖,纯Java项目, 不用GPU也能跑,这不就是为我们这种 Java 后端量身定做的吗Java后端调用OCR又多了一份选择!
02 简介
JiaJiaOCR 是一个纯 Java 的 OCR 引擎,在通用文字识别基础上,新增了手写 OCR、版面检测、表格检测与识别,覆盖印刷体 / 手写体 / 文档结构解析全场景。
它的核心优势:
- 纯 Java :没有
JNI、没有EXE/DLL、不需要 Python 运行时,一个 JAR 全搞定,直接 Maven 引就能进 Spring 项目。 - CPU 优先 :官方明确「推荐 CPU」,不依赖
GPU/CUDA,普通服务器就能跑,部署成本极低。 - 跨平台 + 信创 :支持
x86_64和ARM,覆盖Windows / Linux / macOS,还能跑在麒麟、UOS 等国产系统上。 - 懒加载:模型按需加载,用到哪个功能才加载哪个,启动快、内存省。
- 模型内嵌 :模型直接打进 JAR 里,开箱即用;也能用
-Djiajia.model.dir指定外部模型目录(支持热更新)。 - 线程安全:单个实例可并发批量识别,多线程共享一个就够了。
GitHub 地址:github.com/jiangnanboy...
03 安装
JiaJiaOCR该项目没有上传到中央仓库,需要我们自行构建。
3.1 构建
bash
mvn clean package -DskipTests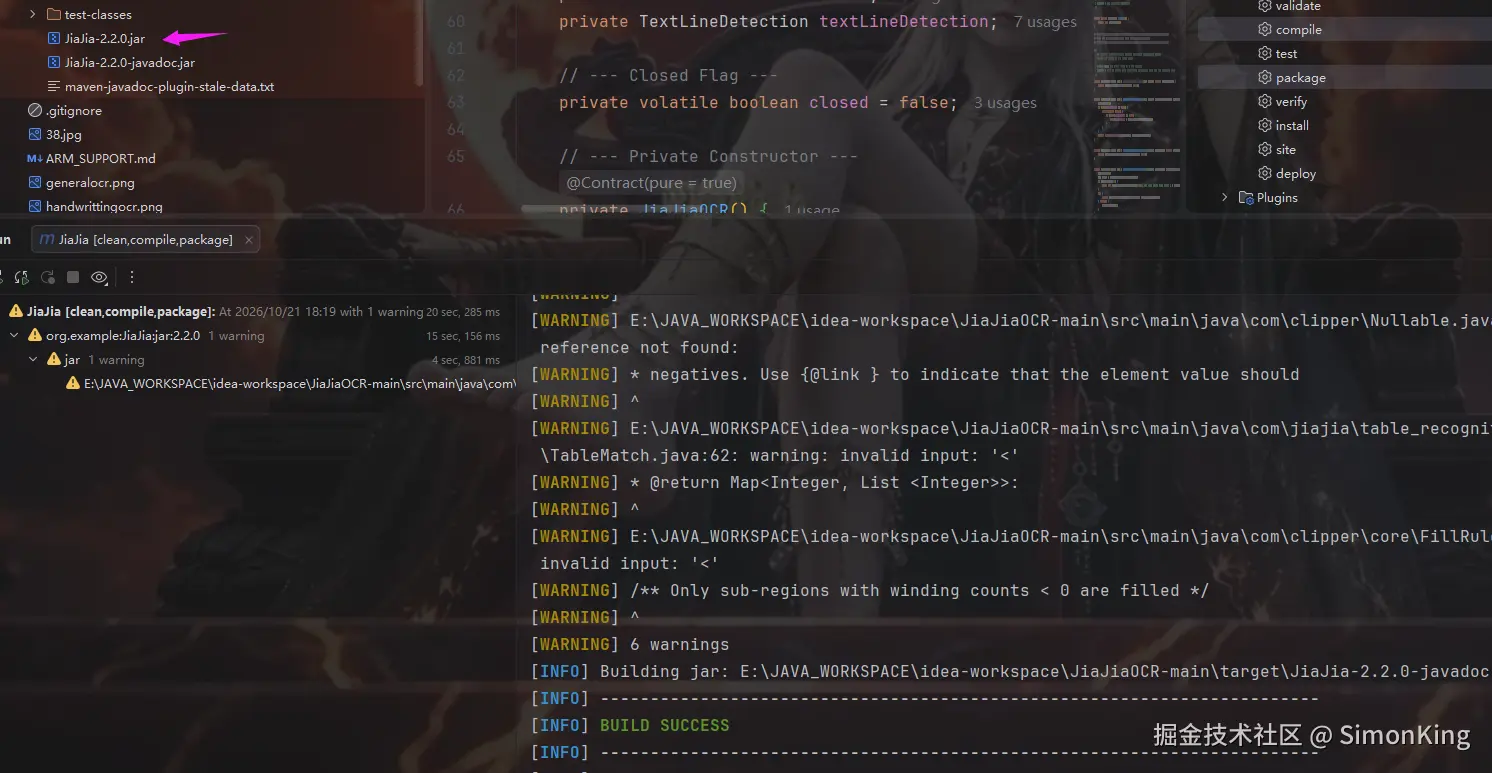
3.2 引入辅助依赖
在 pom.xml 里加这几个核心依赖(pdfbox 仅 PDF 识别才需要):
xml
<dependencies>
    <dependency>
        <groupId>com.microsoft.onnxruntime</groupId>
        <artifactId>onnxruntime</artifactId>
        <version>1.19.0</version>
    </dependency>
    <dependency>
        <groupId>org.openpnp</groupId>
        <artifactId>opencv</artifactId>
        <version>4.9.0-0</version>
    </dependency>
    <dependency>
        <groupId>org.apache.pdfbox</groupId>
        <artifactId>pdfbox</artifactId>
        <version>3.0.2</version>
    </dependency>
    <dependency>
        <groupId>org.apache.commons</groupId>
        <artifactId>commons-lang3</artifactId>
        <version>3.17.0</version>
    </dependency>
</dependencies>
3.3 需要加载模型
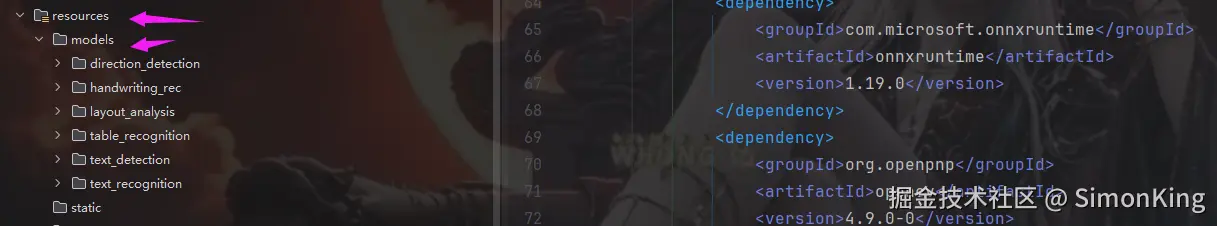
https://github.com/jiangnanboy/JiaJiaOCR/releases/tag/models下放了需要模型,我们需要提前下载下来。
可以只放到项目的classpath下的models。
04 测试
JiaJiaOCR提供了多种识别方式:
- 通用识别:中英文 / 数字 / 符号混排,返回文本、置信度、8 点坐标。
- 手写识别 :专为中文手写优化,标准数据集 92%+ 准确率,比
Tesseract的手写能力强太多。 - 文本行检测:只定位文本行位置(不识别内容),方便做版面预处理。
- 版面检测:识别标题、段落、图片、表格并给出坐标
- 表格检测:定位表格区域 + 置信度。
- 表格识别 :解析表结构为 HTML + 结构化 JSON(行列级),直接对接你后端的表单 / 入库逻辑。
- PDF 识别:多页 PDF 自动转图后批量 OCR。
- 任务取消 :长任务可传
CancellationToken,另一个线程调cancel()中断。 - 多线程批量:单个实例预热后,多线程并发调用共享实例即可,无需每线程 new 一个。
我们使用通用识别测一个就好了:
java
public class TestjiajiaOcr {

    String imagePath = "src/main/images/u.jpeg";

    @Test
    void test01() throws OrtException {
        try (JiaJiaOCR ocr = JiaJiaOCR.builder()) {
            List<Pair<Text, Box>> results = ocr.recognizeGeneralText(imagePath);
            String content = "";
            for (Pair<Text, Box> item : results) {
                content += item.getLeft().getText();
            }
            System.out.println(content);
        }
    }
}
识别目标:
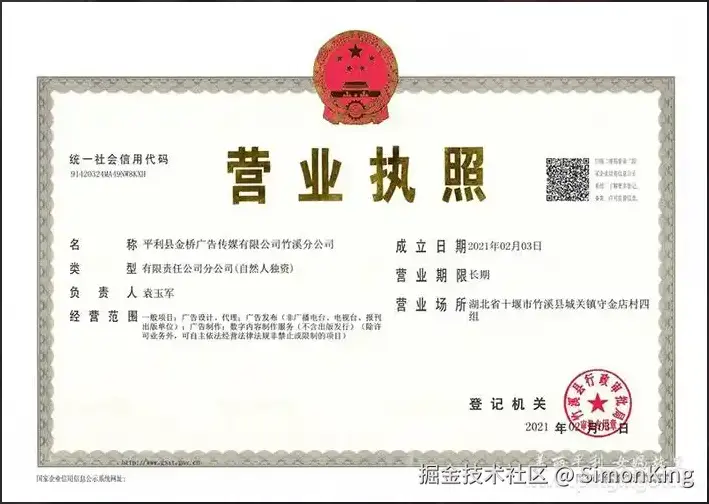
识别结果:
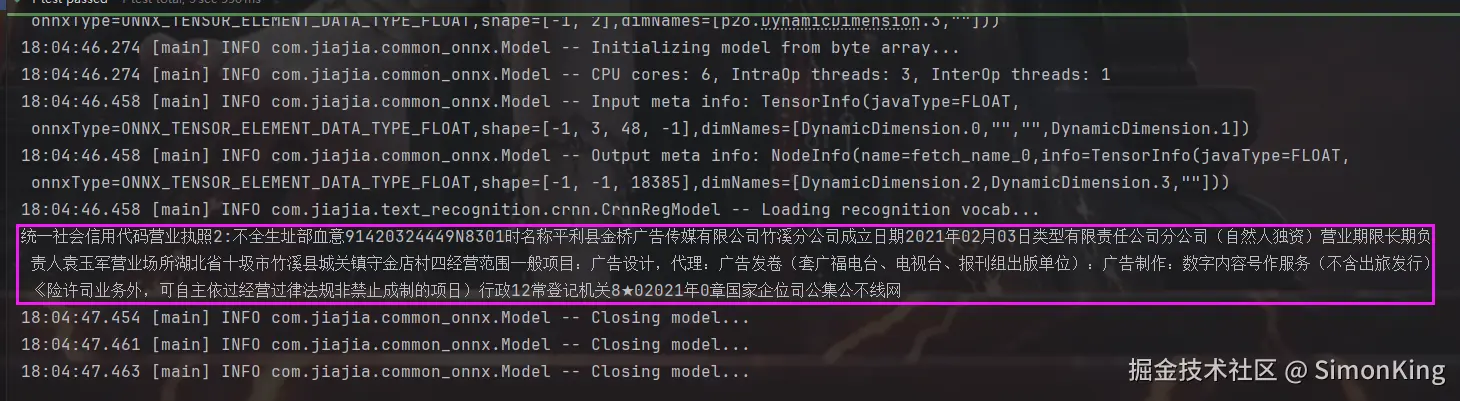
GitHub上提啊提供了其他案例,感兴趣的老铁可以去测试。
05 小结
JiaJiaOCR给纯 Java 团队提供了另一种OCR选择,虽然在GitHub上的star数只有105,不妨碍它为我们提供的可使用的工具。