HunyuanVideo-1.5 首帧视频怎么做提示词对照?先查清 rewrite 是否生效
同一张首帧,提示词 A 让人物缓慢抬头,提示词 B 又加入一个镜头移动。B 生成的视频更有动感,能否说明"加入镜头描述有效"?还不能。若推理入口悄悄改写了文本,或两次运行的 Seed、帧数、超分设置不同,画面差异就无法只归给那句话。
本文面向已经能够运行 HunyuanVideo-1.5 I2V 的读者,给出单首帧、单变量的提示词对照方法。本文没有作者本机生成、画质胜率或性能结果。
先核对 rewrite:源码和帮助文字说了两件事
在 HunyuanVideo-1.5 官方 generate.py 的 --rewrite 参数定义里,代码是 default=False,紧挨着的帮助文字却写 default: true。脚本稍后把 args.rewrite 交给管线的 prompt_rewrite,关闭时还会提示"禁用提示词改写可能影响质量"。这里可确认的是参数代码与帮助文案不一致 ,无法据此推断开启或关闭哪一种画质更好。原图核对日期:2026-09-26,源码文件提交:2641c0d。2026-10-13 复核当前仓库提交 60783e7,generate.py 与该固定历史文件字节相同,冲突仍在;其他文件与依赖不能由此假定相同。
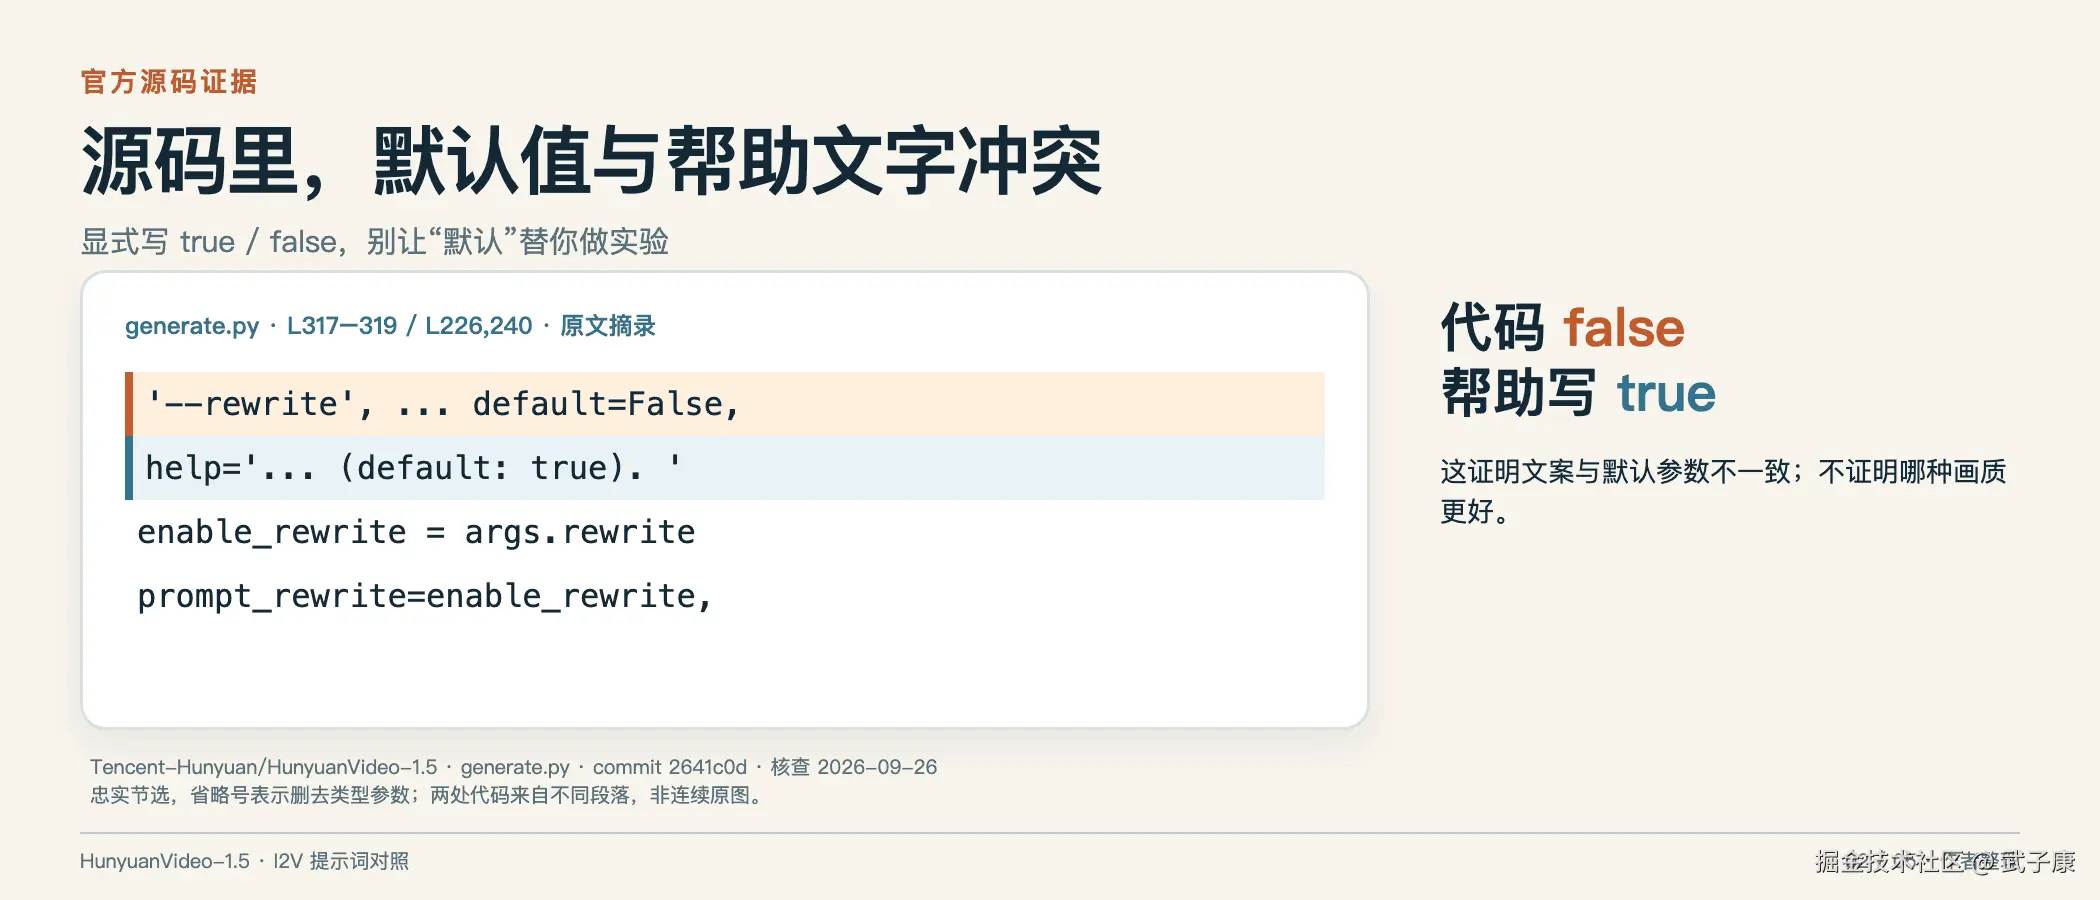
这件小事足以破坏实验:若笔记里写"默认开启改写",而实际运行的是代码默认 false,复现实验时输入条件已经错了。运行前显式写 --rewrite false 或 --rewrite true,保存完整命令、仓库提交、权重版本和生成配置。若使用 ComfyUI 或其他工作流,核对实际节点与权重,不能把这个 CLI 的默认值直接搬过去。
还有一个更难的边界:开启改写后,如果实现没有暴露改写后的最终文本,你只能比较启用改写的整条管线。这时即使 B 比 A 好,也不能说 B 原始提示词里的某个词单独造成了改善。能获取最终文本时,同时保存原始提示词和改写后文本;不能获取时,在记录中写明"不可观察"。
把"想比较什么"放在改写开关之前
同一条提示词对照可以有两个不同问题。问题一是原始文字中的镜头描述是否有用;问题二是包括改写器在内的整套输入处理能否得到更符合目标的视频。前者需要尽量看清生成器实际收到的文字,后者则允许把改写过程当作整条管线的一部分。两者都能做实验,但记录和归因的范围不同。
能拿到改写后文本时,先检查它有没有保留原意:人物抬头的方向、速度、镜头是否固定,以及是否添加了原图没有的物体。可把原始 A/B 和实际 A/B 并排保存,看看计划中的唯一差别是否仍然唯一。若最终文本同时改变了表情、场景和镜头,就把本次结论收窄到改写管线,不继续按单个镜头词解释。
原文、重写结果和编码器输入是三个身份
同提交的生成管线保留 user_prompt,再按 prompt_rewrite 调用重写器;捕获异常后会回退 user_prompt。日志中的 Rewritten Prompt 在开关开启时仍可打印回退后的字符串,因此"开关 true"与"有这一行日志"都不自动证明改写成功。应记录本次成功、回退或禁用状态及错误,不把没有改变的字符串猜成改写器已经保留原意。
随后管线将 prompt 交给 encode_prompt。文本编码器的 text2tokens 还会按 video 模板包装它,再分词与编码。保存重写器输出,并没有保存完这层模板和编码身份;应同时保留模板版本或内容 SHA、模板化输入及所用编码路径,必要时记录 token/截断等可观察字段。生成模型消费的是编码后的条件,不能把日志里一条自然语言字符串说成所有模型输入都已相同。
无法取得这些文本或运行状态时,结论回到整条启用路径,不能从生成画面反推出重写器一定写了某句话。即使原始 A/B 只改镜头词,重写后还改了表情、方向或新物体,也必须重新限定归因;文本哈希只能确认保存字节的身份,不能检验语义上只有一个变量或证明改写器真的执行。
首帧负责画面起点,提示词负责后续运动
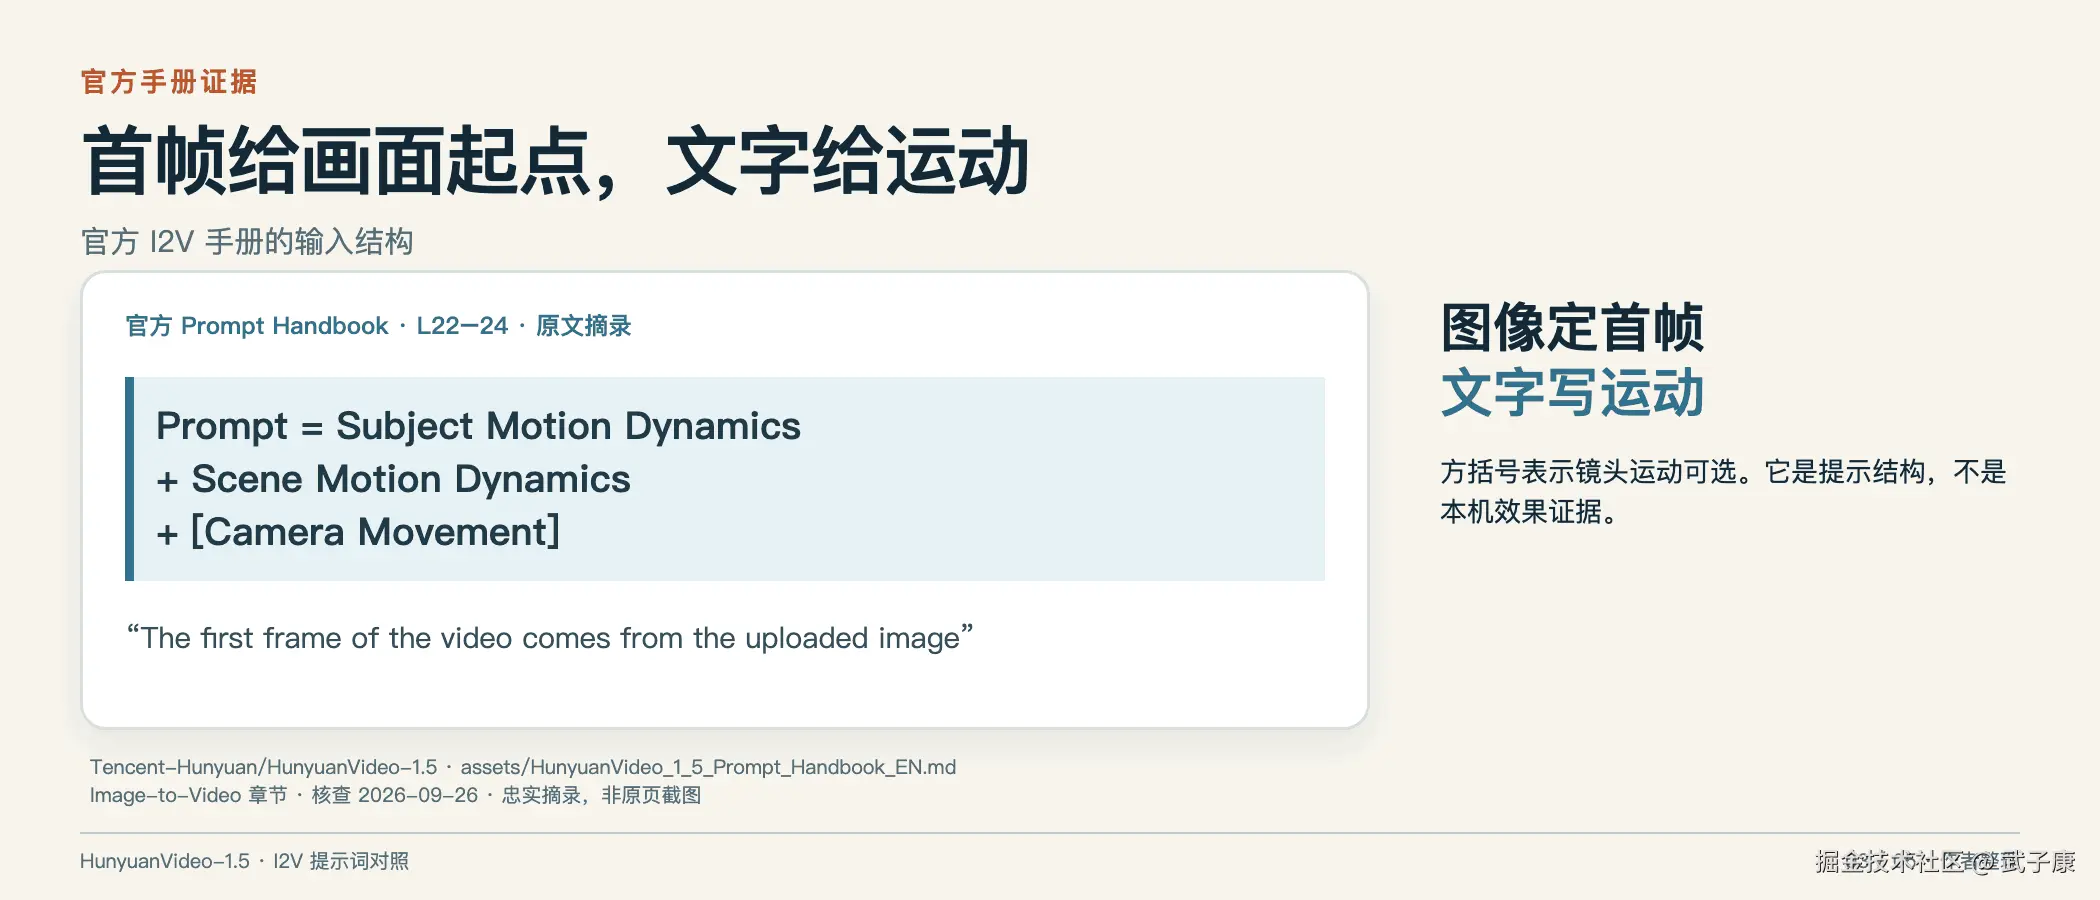
官方 Prompt Handbook把 I2V 输入写为图片加文本提示词:首帧来自上传图片,后续帧按文本生成。本次按 手册提交 60783e7固定这一描述,原图仍为既有手册摘录。它建议的 I2V 提示结构是"主体运动动态 + 场景运动动态 + 可选摄影机运动"。据此,已有清晰人物与构图的图片,不需要在每次对照里重新写一大段静态美术描述。把要观察的变化写成能在视频里判断的动作更有用。
假设首帧里的人物低头看桌面,我们先只测试摄影机运动:
text
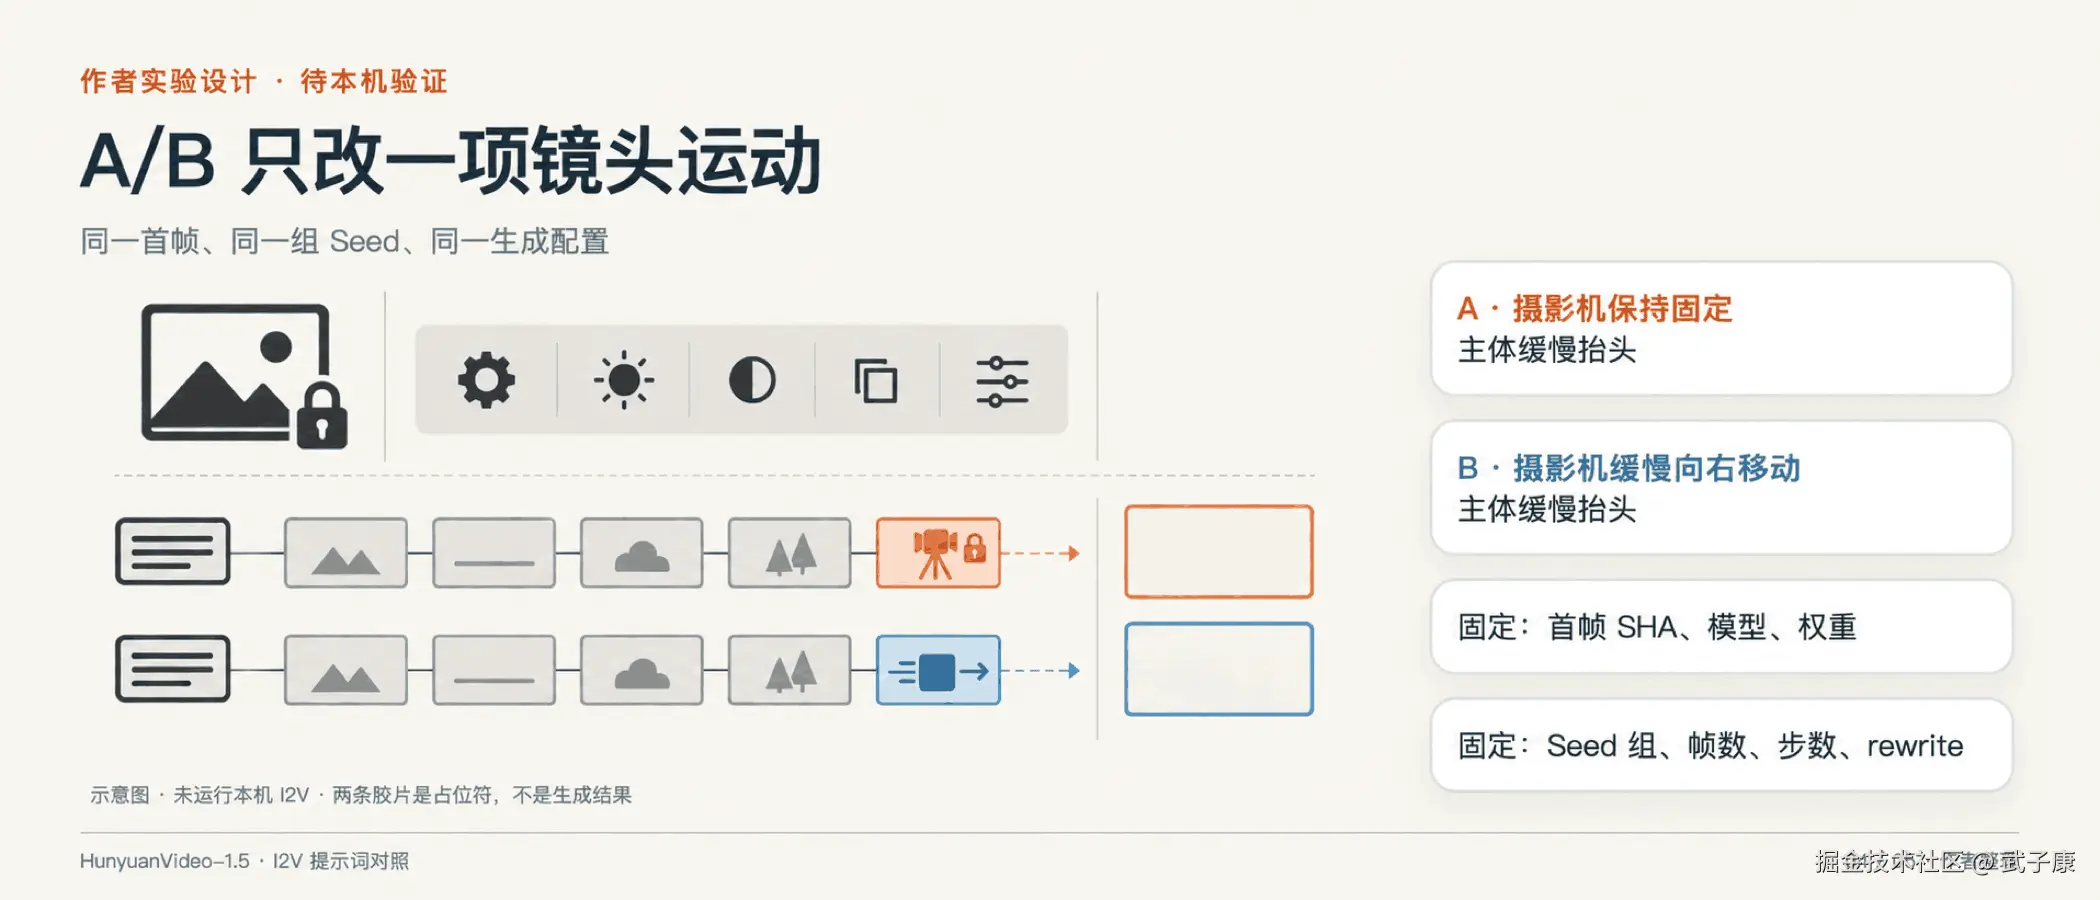
A:画面中央的人物缓慢抬起头,目光从桌面移向画面右侧;摄影机保持固定。
B:画面中央的人物缓慢抬起头,目光从桌面移向画面右侧;摄影机缓慢向右移动。
A/B 唯一计划中的改动是镜头运动。它可以回答"在这个首帧上,B 的镜头是否更接近目标",不能顺便证明人物身份、动作幅度或画质都改善。若还想测试背景窗帘的摆动,应另建 A/C,对照中只改变窗帘一句;首帧没有窗帘,就不要把凭空出现的新物体当成运动成功。这些是待运行的示例提示词,并非本文生成的视频。
从画面起点拆出可观察的动作
首帧低头的人物适合测试抬头,不代表首帧已经完成抬头的人物也有同样动作空间。先看图片中动作的起点和终点:主体现在在哪里、面向哪里、手是否可见、背景物体有没有可活动空间。若首帧里杯子已经握在手里,却要求"从桌上拿起杯子",文本与图像便存在起点冲突。这样的失败不宜只归因于提示词不够长。
动作目标可以拆成观察顺序,但不必堆成复杂剧情。比如"手靠近杯子、接触杯子、杯子离开桌面",分别对应容易检查的关键时刻;如果只写"自然拿杯子",观看者可能在动作开始后就觉得成功,却没有看最后是否真的拿起。这里的分解是评估方法,不要求把每一个评估项都写进提示词。提示词保持清楚,观察记录负责说明何时算完成。
摄影机运动也应与主体运动分开。人物转头、镜头绕人物移动,都可能让脸部角度变化;如果两项一起改变,仅凭脸朝向不能判断谁生效。原文 A/B 先固定人物动作,只改镜头描述,就是为了减少这种歧义。看视频时还要观察背景相对移动,避免把人物漂移错当成相机按路径移动。
对于首帧外空间,先标注它是生成模型需要补出的部分。镜头向右移动后露出的新背景,没有原图参照,适合观察是否自然和连续,却无法按原图检查身份保持。反过来,首帧中明确可见的衣服、桌沿和脸部才有对照依据。把"已有内容保持"与"新增内容合理"分开,评价会更公平,也更容易解释失败。
提示词越长并不自动代表约束越清楚。加入很多静态描写可能同时改掉视觉目标,让这轮镜头实验变成风格实验。若确实要试风格,另建对照并明确目标;一轮只回答一个主要问题,比从同一段视频里同时宣称动作、风格、细节和身份都进步更可靠。
固定配置,才有资格比较文字
官方脚本把 --image_path 作为 I2V 参考图,并将 prompt、num_inference_steps、video_length、seed、prompt_rewrite 等字段传入生成管线。它还提供分辨率、画幅比、超分和卸载等开关。因此,一次 A/B 至少要固定以下内容:
| 必须固定或记录 | 为什么 |
|---|---|
| 首帧文件及 SHA-256 | 防止看似相同的图片实为不同裁剪或压缩版本 |
| 仓库提交、权重版本、推理实现 | 避免模型或代码更新改变实验条件 |
| 分辨率、画幅、帧数、实际编码帧率、步数、超分和优化开关 | 防止输出规格和计算路径变化 |
rewrite 状态与改写后文本的可观察性 |
确认比较对象是原提示词还是整条改写管线 |
| 预先列出的相同 Seed | 减少一次对照中的随机差异,并保留失败样本 |
当前官方脚本的 --video_length 代码默认 121 帧,非 121 帧时会输出质量提醒。--num_inference_steps 参数代码默认 None,帮助文字写"默认 50 步";不能只抄帮助行当成已经核实的所有工作流设置。CFG 与 Flow Shift 须按所用权重和工作流核对;这里没有建立同版本对应关系,不列通用基线。
最小例:先拒绝不具备对照资格的记录
下面只有 original、rewrite 和 off-config 三类预设 fixture,没有图片解码、重写器或生成器。seed 显式为 123,steps=50、frames=121、fps=24 是这组演示声明的具体值,不是质量推荐。仓库 commit 使用真实已核版本;image_sha 来自明确标成 fixture 的字节标签,不是实际图片 SHA,weights 也只是构造 revision 标签。实际实验应替换为真正送入模型的图片、权重和配置身份,不能拿这里的标签做运行证据。
model_input 在本例中只是作者模板包裹后的编码器输入字符串;AUTHOR_FIXTURE_TEMPLATE 不属于官方 SDK,没有复刻官方聊天模板、分词或 embeddings。这里把三层身份分开存,检查记录是否自洽,避免把用户原文、预设的重写文本和最终包装输入混成一个字段。真实管线可能有多个编码器,需按所用版本分别留身份,本例不承诺覆盖它们。
保存为 examples/prompt_pair_checks.py,从仓库根目录运行以下标准库脚本:
bash
python3 08-publishing-pipeline/generated-packages/PKG-20260926-0005-hunyuan-i2v-prompt-rewrite-control/examples/prompt_pair_checks.py
python
"""Constructed text/config records; does not execute rewrite or video generation."""
from hashlib import sha256


def digest(text):
    return sha256(text.encode("utf-8")).hexdigest()


FIXED = {
    "image_sha": digest("fixture image identity; not image pixels"),
    "repo_commit": "60783e704160023913bee78f0b47036d393d4dfa",
    "implementation": "official-cli-declared", "weights": "fixture-weight-revision-1",
    "branch": "720p_i2v", "size": (1280, 720), "seed": 123,
    "steps": 50, "frames": 121, "fps": 24, "sr": False,
    "offload": True, "cache": False, "dtype": "bf16",
    "template": "AUTHOR_FIXTURE_TEMPLATE::{}",
}
CONFIG_KEYS = tuple(FIXED) + ("rewrite",)


def record(user_text, rewritten=None):
    selected = user_text if rewritten is None else rewritten
    return {**FIXED, "user_text": user_text, "rewrite": rewritten is not None,
            "rewrite_text": rewritten,
            "model_input": FIXED["template"].format(selected)}


def qualify(a, b):
    if any(type(r.get("seed")) is not int or r["seed"] < 0 for r in (a, b)):
        return "SEED_NOT_FIXED"
    different = [k for k in CONFIG_KEYS if a.get(k) != b.get(k)]
    if different:
        return "CONFIG_MISMATCH:" + ",".join(different)
    if any(r.get(k) is None for r in (a, b) for k in CONFIG_KEYS):
        return "CONFIG_UNKNOWN"
    for row in (a, b):
        selected = row["rewrite_text"] if row["rewrite"] else row["user_text"]
        if selected is None or row.get("model_input") is None:
            return "PIPELINE_ONLY_TEXT_UNOBSERVABLE"
        if row["model_input"] != row["template"].format(selected):
            return "TEXT_IDENTITY_MISMATCH"
    return ("ELIGIBLE_DECLARED_PIPELINE_PAIR" if a["rewrite"]
            else "ELIGIBLE_DECLARED_TEXT_PAIR")


def main():
    a = record("The person raises their head; the camera stays fixed.")
    b = record("The person raises their head; the camera moves right.")
    ra = record(a["user_text"], "The person slowly looks up; the camera is stationary.")
    rb = record(b["user_text"], "The person slowly looks up; the camera tracks right.")
    cases = [("original", a, b, "ELIGIBLE_DECLARED_TEXT_PAIR"),
             ("rewrite", ra, rb, "ELIGIBLE_DECLARED_PIPELINE_PAIR")]
    for key, value in [("image_sha", digest("other fixture image")), ("steps", 32),
                       ("frames", 81), ("fps", 30), ("branch", "720p_i2v_distilled"),
                       ("repo_commit", "2641c0de73da0a2d9682fed24af2c0a516527cc1"),
                       ("implementation", "other-declared-implementation")]:
        cases.append(("off_config_" + key, a, {**b, key: value}, "CONFIG_MISMATCH:" + key))
    cases += [
        ("seed_minus_one", {**a, "seed": -1}, {**b, "seed": -1}, "SEED_NOT_FIXED"),
        ("seed_unknown", {**a, "seed": None}, {**b, "seed": None}, "SEED_NOT_FIXED"),
        ("rewrite_toggle", a, rb, "CONFIG_MISMATCH:rewrite"),
        ("rewrite_text_missing", ra, {**rb, "rewrite_text": None}, "PIPELINE_ONLY_TEXT_UNOBSERVABLE"),
        ("model_input_missing", a, {**b, "model_input": None}, "PIPELINE_ONLY_TEXT_UNOBSERVABLE"),
        ("hidden_added_text", a, {**b, "model_input": b["model_input"] + " A new object appears."}, "TEXT_IDENTITY_MISMATCH"),
        ("steps_unresolved", {**a, "steps": None}, {**b, "steps": None}, "CONFIG_UNKNOWN"),
    ]
    for name, left, right, expected in cases:
        result = qualify(left, right)
        assert result == expected, name
        print(f"{name}: {result}")
    for name, row in [("original_B", b), ("rewrite_B", rb)]:
        print(f"{name} user_sha={digest(row['user_text'])}")
        print(f"{name} rewrite_sha={digest(row['rewrite_text']) if row['rewrite_text'] else 'DISABLED'}")
        print(f"{name} model_input_sha={digest(row['model_input'])}")
    print(f"self_check={len(cases)} finite pair cases passed; declared_seed=123")
    print("rewrite_execution=NOT_MEASURED video=NOT_MEASURED fairness=NOT_PROVED quality=NOT_MEASURED")


if __name__ == "__main__":
    main()
实际 Python 3.11.6 / macOS arm64 运行退出码 0、stderr 为空,stdout 原样如下:
text
original: ELIGIBLE_DECLARED_TEXT_PAIR
rewrite: ELIGIBLE_DECLARED_PIPELINE_PAIR
off_config_image_sha: CONFIG_MISMATCH:image_sha
off_config_steps: CONFIG_MISMATCH:steps
off_config_frames: CONFIG_MISMATCH:frames
off_config_fps: CONFIG_MISMATCH:fps
off_config_branch: CONFIG_MISMATCH:branch
off_config_repo_commit: CONFIG_MISMATCH:repo_commit
off_config_implementation: CONFIG_MISMATCH:implementation
seed_minus_one: SEED_NOT_FIXED
seed_unknown: SEED_NOT_FIXED
rewrite_toggle: CONFIG_MISMATCH:rewrite
rewrite_text_missing: PIPELINE_ONLY_TEXT_UNOBSERVABLE
model_input_missing: PIPELINE_ONLY_TEXT_UNOBSERVABLE
hidden_added_text: TEXT_IDENTITY_MISMATCH
steps_unresolved: CONFIG_UNKNOWN
original_B user_sha=9c546cc61bba2f5f70902350625e31bd234a1685e04ef10ae7ee6a2b7b080873
original_B rewrite_sha=DISABLED
original_B model_input_sha=8d6ff6a32ccf7915809c824eb359fb91d916f2e5a644999c1f44967a0085c113
rewrite_B user_sha=9c546cc61bba2f5f70902350625e31bd234a1685e04ef10ae7ee6a2b7b080873
rewrite_B rewrite_sha=0b1577757cd2b2db61750c9d63a2ad77458342c954f771b2beaad95ba859eb4e
rewrite_B model_input_sha=3b05a8ad622dc86cc811bf8a7c1385cdb7e7549cb1a912548c96eb5eb5c33c8d
self_check=16 finite pair cases passed; declared_seed=123
rewrite_execution=NOT_MEASURED video=NOT_MEASURED fairness=NOT_PROVED quality=NOT_MEASURED
original 一对只声明两个用户文本在同一配置下可比;rewrite 一对则是两个作者预设重写结果,资格限于声明的管线对照。两项 ELIGIBLE 都不是画质通过。若 B 加镜头描述同时开 rewrite,rewrite_toggle 会拒绝把它塞进原文单变量 A/B;可以另做相同用户文本的改写开关实验,把改写本身作为单独变量。代码不检查英文句子的语义差别是否真的只剩镜头,这一步仍须人工核意图与实际文本。
off_config 的图片、steps、frames、fps、分支、提交和实现变化都单列为配置不一致,不能借同 seed 抹平。这里 720p_i2v 是源码可选择的分支名称,构造记录没有实际装载它;声明的 1280×720 也不是源码对任意输入图实际尺寸的保证。正式对照须确认实际选择的 distilled/sparse 等分支、裁剪后的输入、有效步数及产物规格,连 CLI 填了 720p 也不能跳过输出核验。
seed_minus_one 和 seed_unknown 会拒绝把 -1、None 称为固定 seed。官方管线在这两种条件下会生成随机 seed,正式记录要取实际解析值及运行身份。steps_unresolved 同样不能用两个 None 冒充固定步数:本次源码会继续从配置解析步数,帮助里的 50 不是所有分支都已经执行了 50。CLI 的 save_video 按 24 fps 编码,所以这里也记录 fps;换封装或后处理后仍要核成片实际帧率。
两个 B 的 user_sha 相同,rewrite_sha 和 model_input_sha 却不同,直接展示三层身份不能共用一个"提示词 SHA"。rewrite_text_missing 或 model_input_missing 将记录收窄到文本不可观察的管线范围;hidden_added_text 则发现声明的模板与记录字符串不相符。哈希与这些断言都不能证明文字来自一次真实重写服务,或据此断言它产生了更好的视频。
同一个 seed 的解释限于同一实现、权重和已声明配置的一次可追溯入口;即使这些字段都匹配,提示词改变也会改变采样轨迹,跨实现更不能当公平保证。未来复跑同条件仍有明显差异时,先核隐藏随机入口、实际节点、版本及环境,把复现性保留为未知;不要求各 GPU 后端逐像素相同,也不能省去逐样本观看稳定性。脚本的十六个有限案例与反例只把记录问题暴露出来,尚无改写执行、生成、公平性或质量胜负证据。
用成对记录保留随机性,而不是寻找幸运 Seed
预先列 Seed 的目的,是避免看完结果后只保留 B 成功的随机条件。每个 Seed 都保留 A 与 B 两条记录:完整生成情况、目标动作、镜头方向、身份和副作用。若其中一条失败,先写明失败原因,该对照暂不能用于同条件画质判断;失败本身仍保留在工程可用性记录中。
运行顺序也值得记录。若所有 A 在冷启动环境运行,所有 B 在预热环境运行,计时比较会混入环境差异。可以先完成独立预热,再按既定次序执行,保留开始时间和加载方式。本文不提供最优运行编排,只强调不要把环境状态的差异当成提示词带来的速度变化。
评价时可以把 A/B 标签隐藏,随机安排左右顺序,先让评阅者看预设目标再判断动作是否达成。目的只是减少"新提示词应该更好"的期待影响,不能把这种简单盲评包装成大规模质量评测。样本很少时,按每个 Seed 给具体结果,比写一项貌似精确的总体分数更诚实。
把成功、失败和代价一起记下来
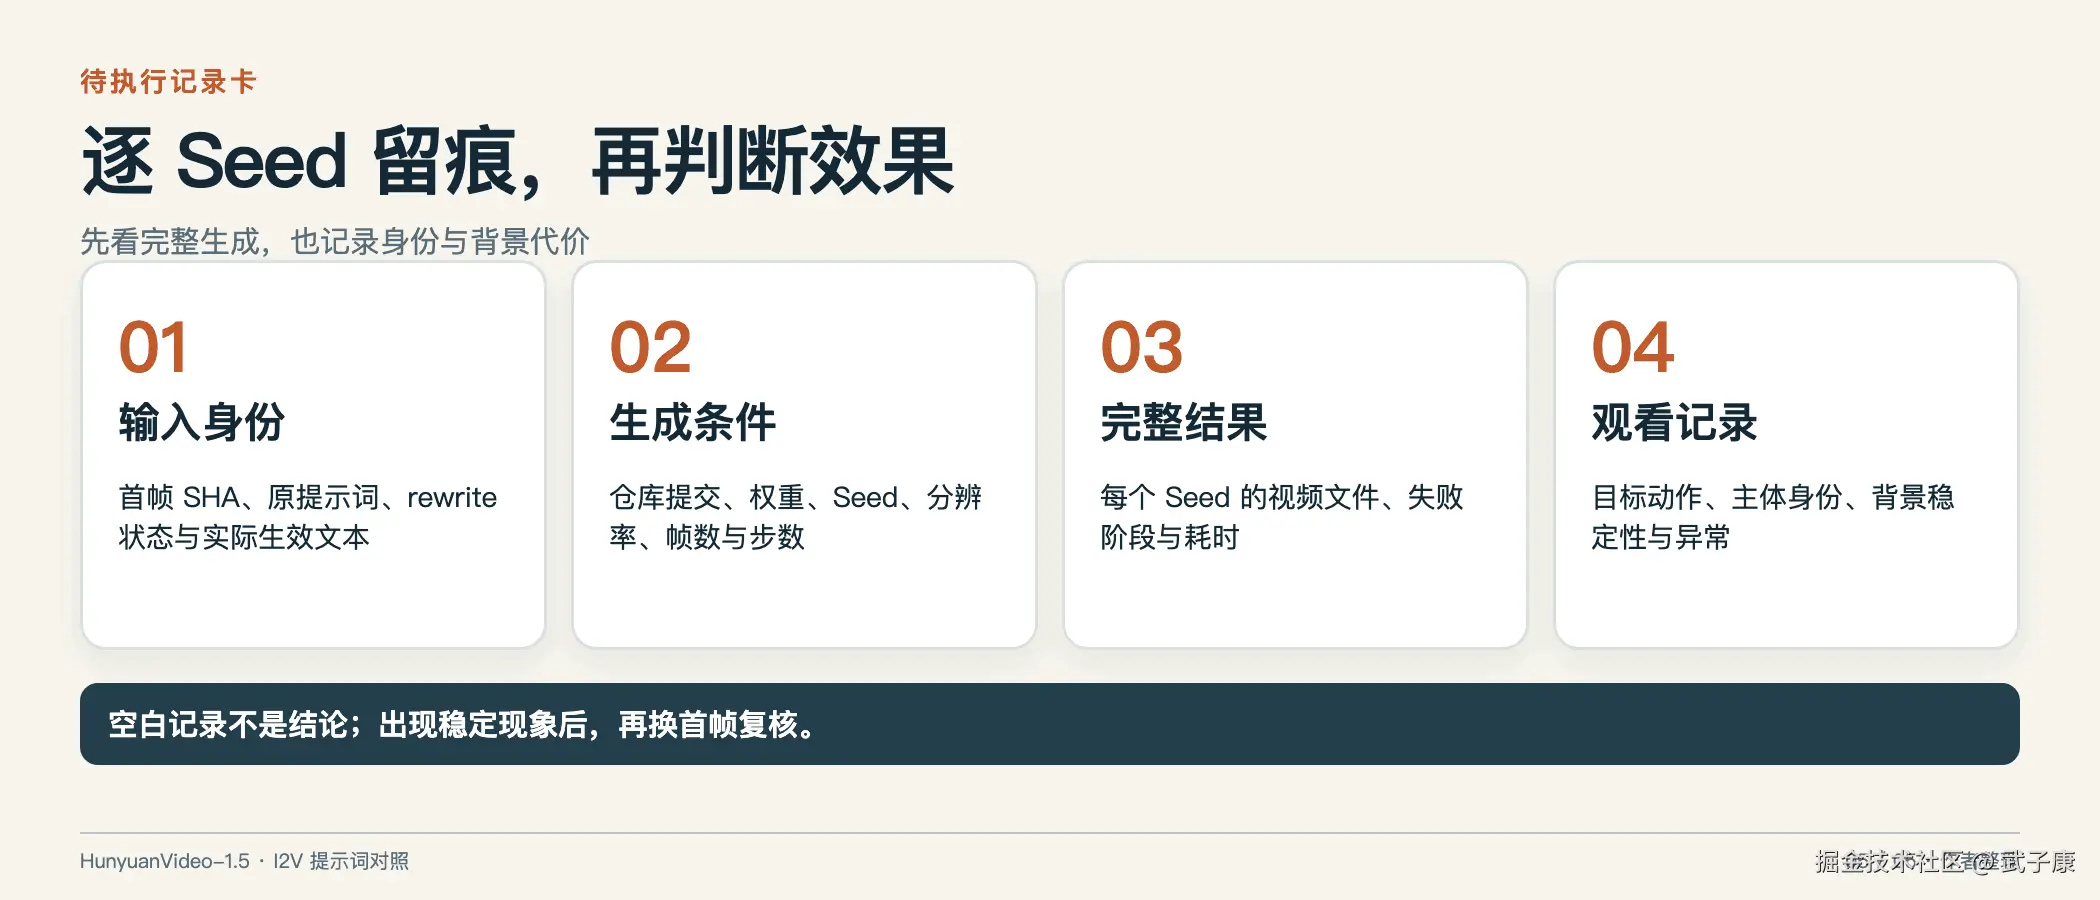
先看两组能否完整生成。如果一组在加载、采样、VAE 解码或编码时失败,先把它记为配置失败;不能拿另一组的成片给它做画质评分。两组都成功后,再看目标动作或镜头是否完成,同时检查人物身份、手和物体接触、背景连续性有没有退步。预先写好观察项,能减少事后只挑最好样片的倾向。
text
案例 ID / 目标动作或镜头:____
首帧文件 SHA-256 / 可见动作起点:____
代码提交 / 权重版本 / 推理实现:____
Python/Torch/CUDA/驱动 / 依赖锁文件SHA / 实际环境身份:____
分辨率 / 画幅 / 帧数 / 实际编码帧率 / 步数 / 超分 / 卸载及优化:____
rewrite 显式设置 / 成功或回退状态:____
用户文本 / 改写器输出 / 模板化编码器输入与各SHA:____
实际命令 / 配置SHA / 仓库和权重身份 / 运行日志绑定:____
A 原始提示词:____  B 原始提示词:____  唯一改动:____
预先选定的 Seed 列表:____
逐个 Seed:完整生成?目标动作/镜头?身份?接触?背景连续性?失败位置?____
输出文件、配置文件、全部失败样本:____
结论范围:此首帧 / 多首帧复测 / 暂无法归因
假如 B 的镜头更符合目标,但脸明显漂移,应该写"该首帧和这些 Seed 下,镜头改善同时带来身份代价",不能写"B 全面更好"。若 A/B 都失败,先检查首帧是否已在动作终点、动作是否要求凭空补出遮挡物或画面外空间,再决定是否改词。不要一口气换 Seed、步数和画幅,否则这轮对照失去解释力。
逐个处理"看起来更好"的反例
假设 B 的镜头确实向右移动,但人物抬头更慢,在片段结束时尚未看向目标方向。此时镜头项通过、动作项未完成;不能因为画面更有动感就称整段更符合用户需求。若 B 让背景摇动,却把窗帘变成另一个物体,场景运动出现也不能证明原窗帘被稳定控制。所有这些都是待测反例,不是作者观察到的模型失败。
另一种反例是两条视频目标都实现,但 B 使用了额外后处理。若超分、补帧或展示裁剪不同,先保留原始生成版本,再将后处理的效果单列。首帧身份评价尤其要防止只选清晰的局部裁剪,完整镜头里的手、身体与物体接触同样影响可用性。素材展示可以美化,实验原片必须能够复查。
如果两组都没有完成动作,可先检查目标是否与首帧冲突,再判断文字是否存在指代不清。例如画面有两个人却只写"他转头",主体未定义;目标是镜头移动却主要描述人物走动,控制目的没有被清楚表达。一次只修一个能解释失败的语义点,并保留旧版输入。若同时换首帧、动作和 Seed,即使成功也只能记新案例。
结论向其他首帧迁移时,可以先选姿态近似但背景不同的图片,再选动作起点差异更大的图片。每组单独记录,不把同一个人物上的成功归纳成所有人物都适用。若迁移失败,说明原结论依赖了起点或场景,并不等于此前那组对照无效;它只是告诉你这条提示词规则的范围较窄。
还可以为每一项动作写"无法判断"的条件。脸部始终背对镜头时,无法评价面部身份;杯子被完全遮挡时,无法确认接触方式;片段在动作进行中结束时,无法把未完成归为方向错误。保留不可判断,能够避免把证据不足机械变成模型失败,也避免它被当作默认通过。下一轮若要解决不可判断,可以只调整可观察性,例如换清楚的起点图,并明确这已经是新输入。
实验记录也不要求所有问题都用一个数字回答。镜头方向是离散目标,动作完成可能涉及时间,身份保持则需要与首帧对应观察;它们各自表达,比把不同性质的结果压成平均分更清楚。对于创作项目,可以先定必须满足项,再定可接受的副作用。如果镜头运动是硬需求、脸部保持也是硬需求,两项中任何一项失败都不能被另一项高分抵消。
当新版本的 rewrite 行为变化时,不要只重跑 B。先按保存的基线重跑 A/B,确认两边生效文本和配置,再看差异是否保留。旧版记录支持的是旧版条件,不自动成为新版本的质量保证。这样同一份对照可以继续积累可复查的案例,同时始终把结论绑定到真正运行过的实现。
结论先限定在所看见的范围
rewrite 的代码默认值与帮助文字冲突,提醒我们先确认实际生效的输入,再谈提示词技巧。官方手册给了可用的 I2V 运动描述结构,源码给了必须记录的主要控制项;两者都不能替代本机完整生成和逐样本观看。实验素材还应确认图片、人物及生成用途的许可,公开分享只使用获授权素材与脱敏记录。先用一张首帧、一项动作或镜头改动做小规模对照;看到稳定现象后,再换首帧检验能否迁移。
来源:HunyuanVideo-1.5 官方源码 generate.py(文件提交 2641c0d)、官方 Prompt Handbook。原图核对日期 2026-09-26;2026-10-13 按上述固定源码与手册提交复核。本文为官方资料分析与待执行实验设计,未运行视频模型。