GPT-6.1 这个家族,9 月 30 日来了 Sol,10 月 9 日来了 Ultrafast,10 月 26 日轮到 Terra。三块拼图里 Terra 最好认:官方给它的一句话定位是"快速、高效",主打细粒度视觉推理和精准 computer use,价格直接砍半。
图:OpenAI 官方《Introducing GPT-6.1 Terra》主视觉,星空下被阳光照亮的地球,配 GPT-6.1 Terra 字样
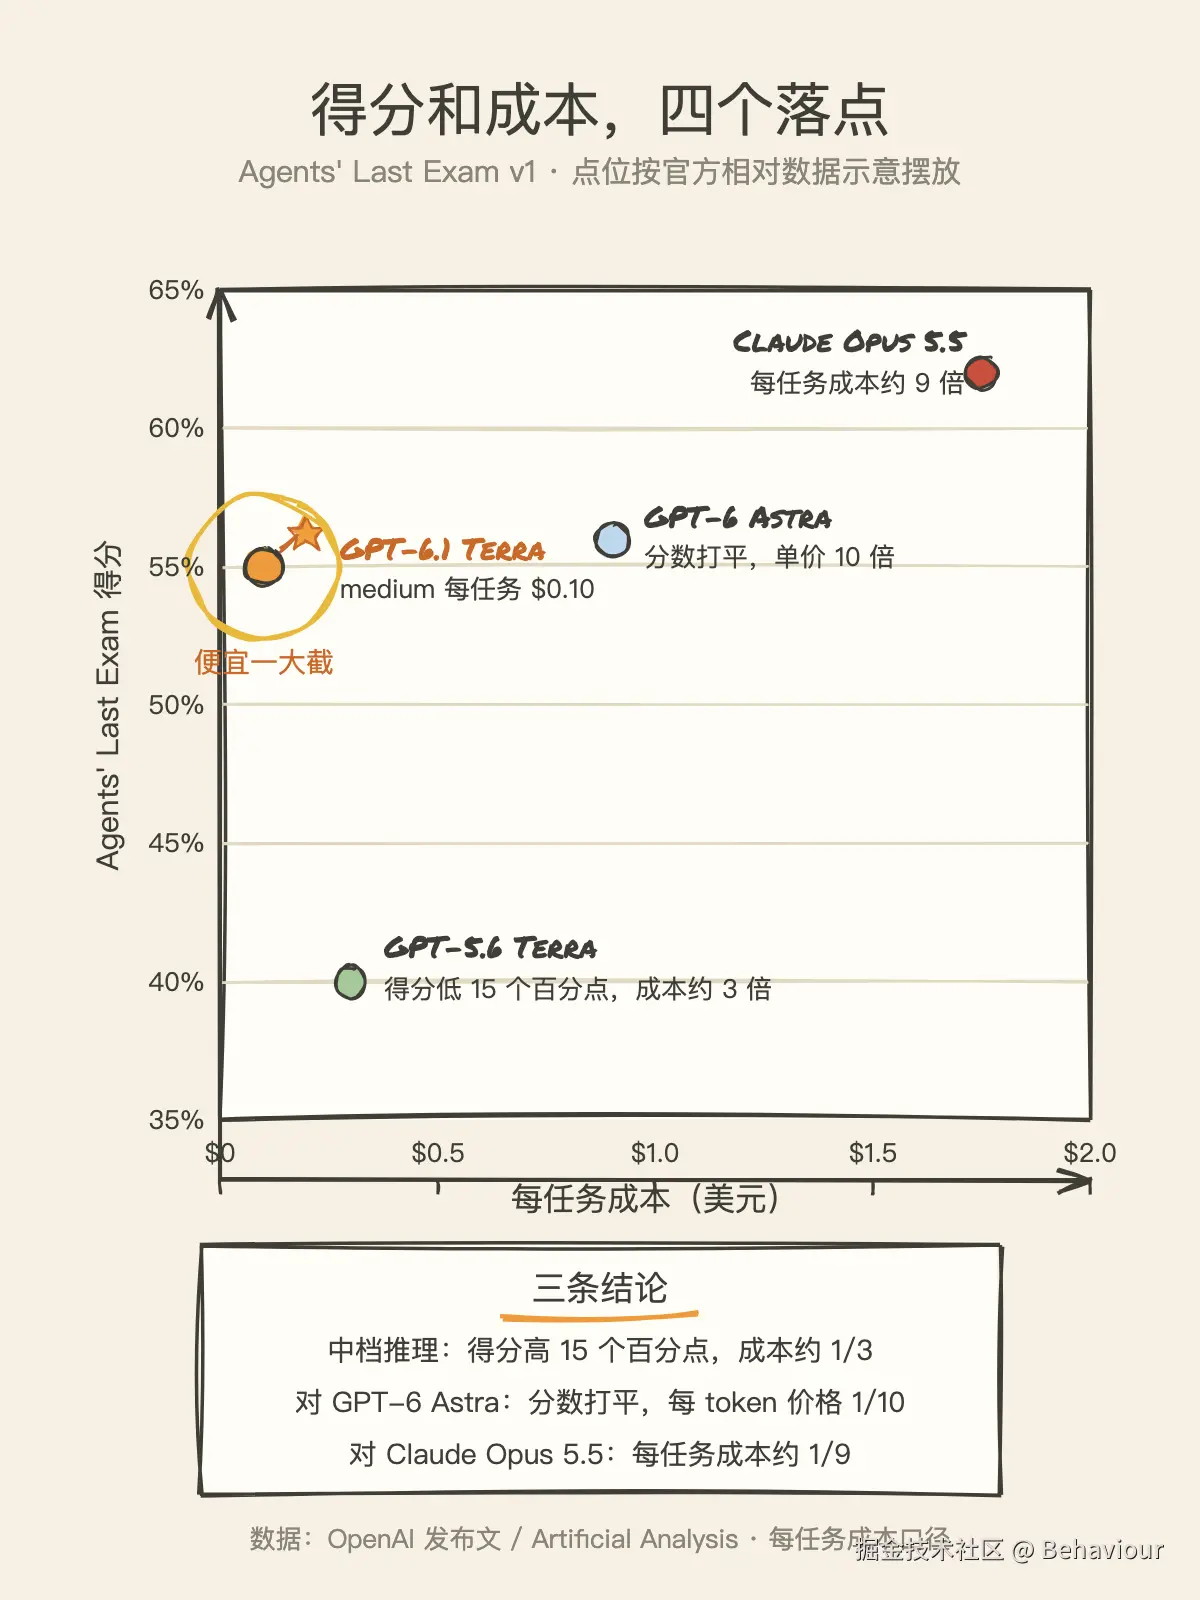
先把价格摆出来。每百万输入 token 1 美元、缓存输入 0.05 美元、输出 5 美元。发布文里写得很直白:标准 API 价格比 GPT-5.6 Terra 和 GPT-6.1 Sol 低 50%。所以标题那句"成本砍半"有价格表背书,甚至还算说得保守,往任务口径一算降幅更大:Agents' Last Exam 上中档推理每任务成本约为 GPT-5.6 Terra 的三分之一,最高推理强度下约为 Claude Opus 5.5 的九分之一。
"快 3 倍"这句要单独拎出来讲。官方原文是 Terra 完成任务的速度是 GPT-6 Astra 和 GPT-6.1 Sol 的三倍以上。基准是自家两个更贵的旗舰,上一代 GPT-5.6 Terra 不在对比范围里,发布文通篇没有"比 5.6 Terra 快 3 倍"的表述。这个差别传两轮就会跑偏,所以放在开头说清楚。
Terra 是个什么档
图:OpenAI 官方《A model guide for the GPT-6 family》封面,交代 Terra 在 GPT-6 家族里的位置
它按六个推理档发布:non-reasoning、low、medium、high、xhigh、max,ChatGPT 里默认中档(Artificial Analysis 记载)。这是理解后面所有数字的前提,同一套权重,档位不同,成绩和成本能差出一截。
规格上,上下文 1M 级(AA 记 1M,DataLearner 记 1.05M,折算约 1500 页 A4),最大输出 128K,知识截止 2026-06-01。输入吃文本和图像,输出只有文本。API 模型名 gpt-6.1-terra。
价格表比表面那个"1 美元"要绕一点,DataLearner 收录的完整分档:
| 场景 | 输入 / 输出(每百万 token) |
|---|---|
| 标准档,上下文 ≤ 272K | 1/5 |
| 上下文 > 272K | 2/7.5 |
| batch 与 flex | 0.5/2.5 |
| fast | 2/10 |
| 缓存写入 | $1.25 |
| 缓存读取 | $0.05 |
缓存读取 5 美分这个数,等于把重复上下文的成本打到接近零。跑 agent 的都懂,一次任务里系统提示加历史轮次会被反复计费,这块能压到 5%,账单形状会变。AA 给的口径也是缓存折扣 95%。
反过来,fast 档单价双倍,超 272K 上下文也翻倍。提速和长上下文都明码标价,不算暗坑,但做预算得算进去。
那几组关键数字
幻觉率是这次最值得盯的改进。官方在一份由易诱发错误的提示词构成的内部基准上测:低推理强度下,错误率从 GPT-5.6 Terra 的 53.6% 降到 16.7%,少了近 37 个百分点;最高推理强度下降 18 个百分点,到 4.3%。
**53.6% 到 16.7%,低档错误率砍掉七成。**我倒觉得这条比任何跑分都硬。跑分是实验室口径,错误率是线上要赔进去的东西。以前"用便宜档跑批"最大的风险是它一本正经地胡说,现在这个风险被压下去一大截,低成本档才算真能干活。
computer use 的成绩。官方用 Agents' Last Exam v1 测,任务长这样:把建筑图纸转成 3D 模型;逐镜头审看一部动画电影,给修复团队出一份带时间码的记录。数据上,中档推理比 GPT-5.6 Terra 高 15 个百分点,成本约为其三分之一;表现可以和 GPT-6 Astra 打平,而每个 token 的价格只有 Astra 的十分之一。拉到最高推理强度,token 使用效率是 Claude Opus 5.5 的三倍以上,单价四分之一,每任务成本约九分之一。
视觉这边,MMMU-Pro 上 Terra 在所有推理设置下都超过 GPT-5.6 Terra,同时以低得多的成本接近 Astra 和 Sol。DataLearner 按档收录的分数:低 83.70、中 84.60、高 85、极高 85.40、最高 85.50,排名 13/252。跨档总分差不到 2 分,这条信息比分数本身有用:视觉能力对推理预算不敏感,看图类任务没必要把档拉满,low 档就能吃下绝大部分精度,钱省在别处。
编程是相对短板,但进步明显。Terminal-Bench 4.0 最高推理强度下 Terra 解决 50.3%,是 GPT-5.6 Terra 已公布成绩 21.5% 的两倍多。官方同时把话说在前面:最复杂的编程任务,Sol 和 Astra 仍是更好的选择。Terminal-Bench-Science 0.1 最高档 58.30,DataLearner 排 6/33,官方说法是以不足 Opus 5.5 五分之一的成本逼近其水平,分差不到五分。
速度,AA 实测 Terra 全部推理档输出都是 91 token/s,non-reasoning 首 token 延迟 1.12 秒。六档吐字速度一样这点少见,多数推理模型档位越高越慢。Terra 的"快 3 倍"快在整段任务完成时长上,单 token 速度和档位没关系。
上手:从装库到跑通一个 computer use 任务
Terra 的可用面有两条。ChatGPT Plus、Pro、Enterprise、Edu 用户在 ChatGPT 工作和 Codex 里直接选;开发者走 API。
本地环境十分钟的事:
bash
pip install --upgrade openai
export OPENAI_API_KEY="sk-..."
模型名 gpt-6.1-terra。发布文没展开六档和 API 参数的对应关系,按 OpenAI 现行 API 的惯例走 reasoning_effort(Responses API 里是 reasoning.effort),low/medium/high 是稳的,xhigh 和 max 是否以同名值开放,调的时候以 API 参考为准。一个最小的 Python 调用:
python
from openai import OpenAI

client = OpenAI()

resp = client.responses.create(
    model="gpt-6.1-terra",
    reasoning={"effort": "low"},
    input=[{
        "role": "user",
        "content": [
            {"type": "input_text", "text": "把这张建筑图纸里的承重结构逐项列出来"},
            {"type": "input_image", "image_url": "https://example.com/plan.png"},
        ],
    }],
)
print(resp.output_text)
图像输入走 input_image,输出纯文本,这个模型没有多模态输出。
一个完整的例子,用的是官方发布文里给的两类 computer use 示例之一,"逐镜头审看动画电影"。实际做起来,常见路子是把片子按镜头切片、逐帧喂给模型,提示词写死输出格式:每个镜头一行,带时间码、问题描述、建议动作。跑完拿到一份可以直接丢给修复团队的记录表。这类任务体量大,一部片几千个镜头,成本就是关键变量。按 AA 的每任务口径,Terra low 档 0.05 美元、medium 0.10、high 0.13、xhigh 0.19、max 0.40,Sol max 是 0.72。乘上镜头数,差距就是"这个项目能立项"和"算了"的区别。
图:OpenAI 官方仓库 openai/openai-cua-sample-app 品牌卡,对应 Terra 主打的 computer use 能力
官方只公布了任务类型和成绩,没有放出完整的执行轨迹,提示词怎么写效果最好,这块只能自己试。
几个容易踩的地方:
- 上下文一旦过 272K,单价从 1/5 跳到 2/7.5。1M 上下文是能力,计费是另一回事,长文档分片处理往往比硬塞便宜。
- 档位别拿默认值糊弄过去。低档错误率 16.7%,最高档 4.3%,差四倍,什么任务配什么档得自己定。
- 离线大批量任务记得走 batch 或 flex, 0.5/2.5 再省一半。
- 最硬的编程任务别硬上 Terra,官方自己承认 Sol 和 Astra 更合适。
和旗舰比,它输在哪
Artificial Analysis 的 AA Intelligence Index 上,Terra max 档 48 分,排 25/221。同表里 Claude Opus 5.5(max w/fallback)58、Kimi K3.1 Pro 55、Claude Fable 5.1 53、GPT-6 Astra(max)53、GPT-6.1 Sol(max)52。
一列下来就清楚了,Terra 比自家两个旗舰都低,低 4 到 5 分。它是性价比档,不是全能王。买它的人看的是另一列数:每任务成本 max 档 0.40 美元对 Sol max 的 0.72 美元,便宜约 44%;low 档 0.05 美元,和 Sol max 比差 14 倍。放批量任务里,一万个任务就是 4000 美元和 7200 美元的差别。同表里 Gemini 4 Argon(high)跑到 1.62 美元一个任务,这条曲线的斜率才是 Terra 真正的卖点。
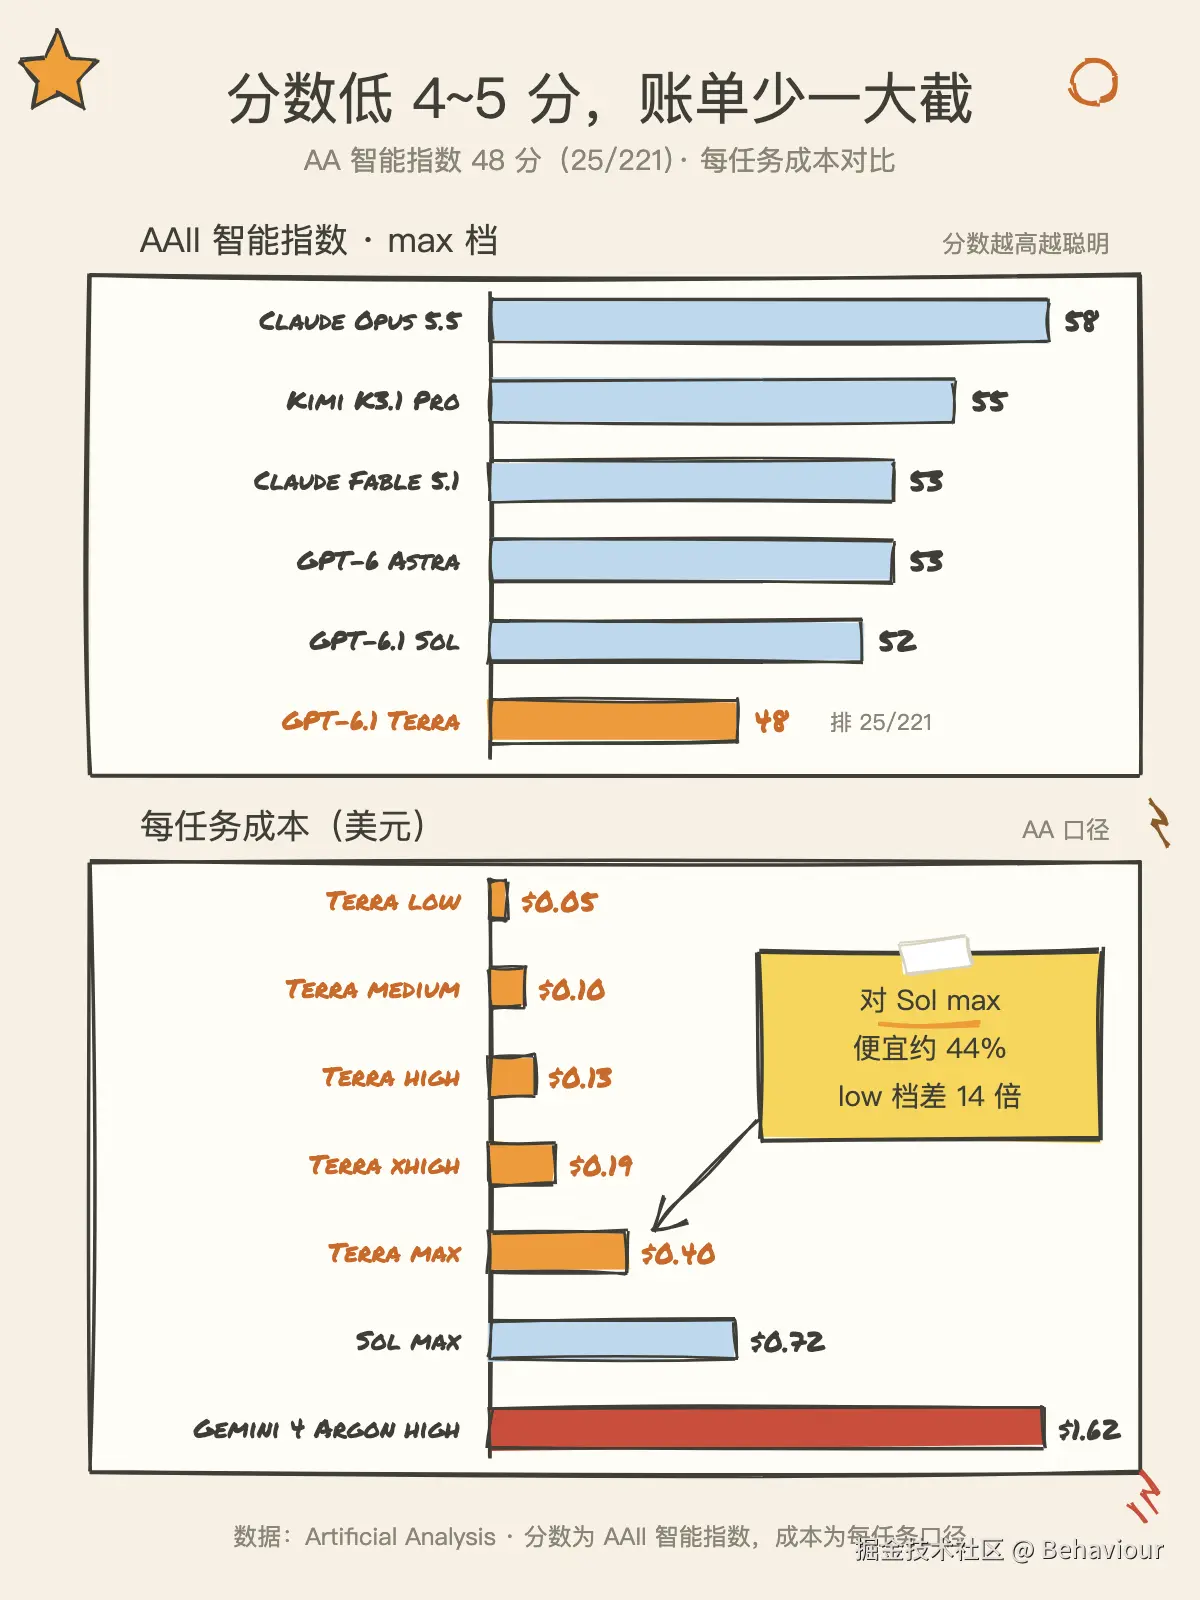
选型结论很朴素:要分数上限,Sol、Astra、Opus 5.5 在上面;要单位成本下的完成率,Terra 现在是最优解之一。混着用也合理,简单步骤走 Terra low,卡住了再升档或换旗舰。
被价格表盖住的那条披露
发布文里有句话容易被价格数字盖过去:GPT-6.1 Terra 达到了 OpenAI 准备框架(Preparedness Framework)中网络安全领域的"严重"风险阈值,并保留了为 GPT-6 Astra 开发的防护措施。
图:OpenAI 官方的 Terra 艺术图 1:1 方版,发布在 GPT-6 家族指南页
同一篇里官方也给了些安抚性的描述,说 Terra 对提示注入攻击抵抗力强,更可能在任务范围内行事。
把几件事放一起看:一个安全评级标着"严重"的模型,价格砍半,向所有 Plus 订阅用户开放,API 谁都能调,防护措施沿用 Astra 那一套。这些防护具体覆盖什么、企业侧能不能按域关掉相关能力、达到阈值的能力边界划在哪,发布文里没有可验证的说法。
我倒不觉得这是要恐慌的事,OpenAI 这套流程本来就被设计成可以带险发布。真正扎人的是价格:自动化渗透的工具成本也被压到了 1 美元一百万 token,防护的部署速度得跟上铺开速度才行。
收尾
这代模型里我最想盯的是 low 档那组数:错误率 16.7%,每任务 0.05 美元,输出 91 token/s。很多以前因为太贵或者太不可靠而没法自动化的批量任务,现在成本模型可以重算了。
留一个还没答案的问题:一个标着网络安全"严重"阈值、价格为上一代一半的模型,会先被拿去做什么。这个问题发布文不回答,市场会回答。
参考链接
- OpenAI:Introducing GPT-6.1 Terra 官方发布文(定价、Agents' Last Exam 成绩、幻觉率数据、安全评级披露) openai.com/index/intro...
- DataLearner:GPT-6.1 Terra 模型卡片(MMMU-Pro 等分档跑分、完整价格表、上下文与输出规格) www.datalearner.com/ai-models/p...
- Artificial Analysis:GPT-6.1 Terra 独立评测(AAII 排名、91 token/s 实测、各档每任务成本) artificialanalysis.ai/zh/models/r...