LangChain Agent 底层是基于 LangGraph 构建的,因此继承了强大的流式处理能力;而对于绝大多数应用和前端开发场景,官方推荐直接使用基于
stream_events(..., version="v3")的"事件流",因为它通过"类型化投影(Typed Projections)"大大简化了数据的消费过程,不用再手动去解析复杂的元组类型化投影(Typed Projections): 框架帮你从底层的、杂乱无章的原始事件数据(JSON / 字典)中解放出来,将它们自动分类、打包,并转换为带有明确数据类型和属性的 Python 对象(比如消息对象、工具调用对象),让你能够直接通过点语法(如 stream.messages)安全、精准地读取
astream_events/stream_events 流式事件
流式事件分为: astream_events 异步流式事件 和 stream_events 同步流式事件; 分别使用 agent.astream_events(input, version="v3") 和 agent.stream_events(input, version="v3") 生成
常见的流式投影与用途对照表
stream.messages 会产出 ChatModelStream 对象。 每个消息流都暴露了 .text、.reasoning、.tool_calls 和 .output 属性。 同步投影支持迭代获取实时增量数据,也支持提取最终结果:使用 str(message.text) 获取最终文本,使用 message.tool_calls.get() 获取已完成的工具调用
| Projection (投影) | 用途说明 |
|---|---|
for event in stream |
包含访问权限的原始协议事件。 |
stream.messages |
模型消息流,每次 LLM 调用对应一个消息流。 |
message.text |
消息的文本增量(deltas)与最终文本。 |
message.reasoning |
暴露推理内容模型的推理增量。 |
message.tool_calls |
工具调用的参数块和最终确定的工具调用。 |
message.output |
模型调用完成后的最终消息对象。 |
stream.values |
Agent 状态快照。 |
stream.output |
最终的 Agent 状态。 |
stream.subgraphs |
嵌套 graph 运行(包括子 Agent 和普通子图)。 |
stream.extensions |
自定义转换器投影。 |
stream.tool_calls |
工具执行生命周期、输入、输出增量、最终输出及错误信息。 |
stream.messages 获取流式输出消息
当你需要获取每次大模型调用的模型输出时,请使用 stream.messages
python
agent = create_agent(
    model=model,
    system_prompt="you are a good friend",
    checkpointer=InMemorySaver(),  # 为 checkpointer 指定一个内存存储器,可以存储当前会话的短期记忆
    store=InMemoryStore(),  # store 指定一个内存储存来记录长期记忆
)

thread_config = {"configurable": {"thread_id": "thread_1"}} # thread_config 用来管理当前的会话信息配置,这对短期记忆来说很重要

stream = agent.stream_events(
    {
        "messages": [HumanMessage("杭州天气怎么样?")],
    },
    version="v3",
    config = thread_config,
)


for message in stream.messages:
    for delta in message.text:
        # 每次打印增量数据(delta),实现流式打字效果输出
        print(delta, end="", flush=True)

# 得到最终的完整输出
final_state = stream.output

print("\n\nfinal_state: ", final_state)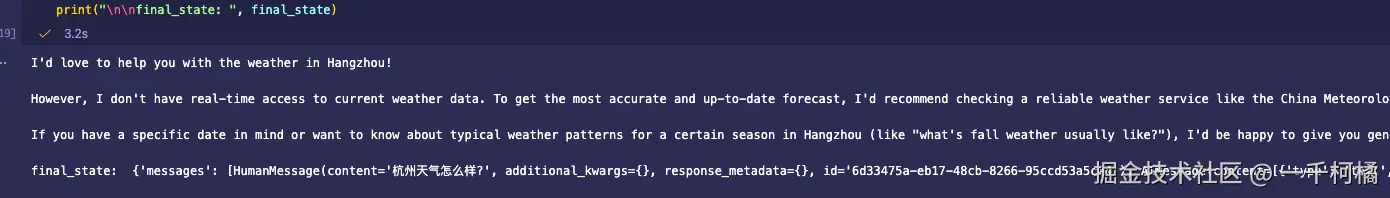
子 agent 的流式输出
当你为子 Agent 设置了 name="weather_agent" 后,框架在底层事件流中会给它打上专属的标签。这解决了多 Agent 系统中最头疼的"日志混淆"问题,让你一眼看出哪条消息是哪个 Agent 产出的。
-
专属的监控投影流 (stream.subagents)
你不需要在海量的、杂乱的底层事件(Event Stream)里费力过滤。系统提供了一个独立的 stream.subagents 视图,专门用来收集所有被调用的命名子 Agent。
-
丰富的结构化上下文 (.messages, 等)
每个子 Agent 的句柄(Handle)直接暴露了丰富的数据:
.messages / .output:子 Agent 内部的对话历史和最终输出。
-
自动过滤杂讯
框架只抓取通过 create_agent 创建的、带有名字的子 Agent 运行实例,自动帮你把底层普通的、繁琐的子图(Subgraphs)过滤掉,只留下干净、高层的 Agent 级交互。
python
    @tool("get_weather", description="Get weather for a given city.")
    def get_weather_of_sub_agent(city: str) -> str:
        """Get weather for a given city."""
        return f"It's always sunny in {city}!"

    weather_agent = create_agent(
        model=qwen38_model,
        tools=[get_weather_of_sub_agent],
        name="weather_agent",
    )

    @tool
    def call_weather(city: str) -> str:
        """根据给定的城市查询天气"""
        result = weather_agent.invoke(
            {"messages": [{"role": "user", "content": f"{city}天气如何?"}]}
        )
        content = result["messages"][-1].content
        print(f"\n[Sub-Agent 内部捕获]: {content}") # 直接在工具执行处就能实时拿到
        return content

    supervisor = create_agent(
        model=qwen38_model,
        tools=[call_weather],
        name="supervisor",
    )

    stream = supervisor.stream_events(
        {"messages": [HumanMessage("今天北京的天气如何?")]},
        version="v3",
    )

    for subagent in stream.subagents:
        print(f"{subagent.name}: ", end="")
        print("\n\nsubagent.messages messages:")
        for message in subagent.messages:
            for token in message.text:
                print(token, end="", flush=True)
        print()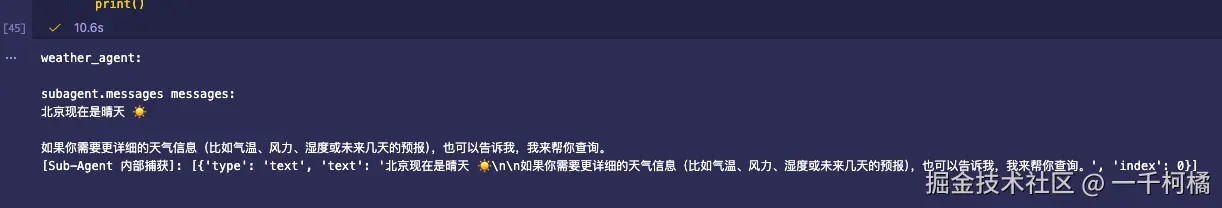
同步与异步执行
在异步代码中实现并发消费,使用 astream_events 和 asyncio.gather 使用:
python
import asyncio
from langchain_core.utils.uuid import uuid7


@tool
def get_weather(city: str) -> str:
    """Get weather for a given city."""
    return f"It's always sunny in {city}!"


agent = create_agent(
    model=qwen38_model, tools=[get_weather], checkpointer=InMemorySaver()
)

config = {"configurable": {"thread_id": str(uuid7())}}

stream = await agent.astream_events(
    {
        "messages": [HumanMessage("杭州天气怎么样?")],
    },
    version="v3",
    config=config,
)


async def consume_messages():
    async for message in stream.messages:
        txt = await message.text
        if txt:
            print("message.text: ",txt )


async def consume_tool_calls():
    async for call in stream.tool_calls:
        print("\n\nconsume_tool_calls:", call.tool_name, call.input)


await asyncio.gather(consume_messages(), consume_tool_calls())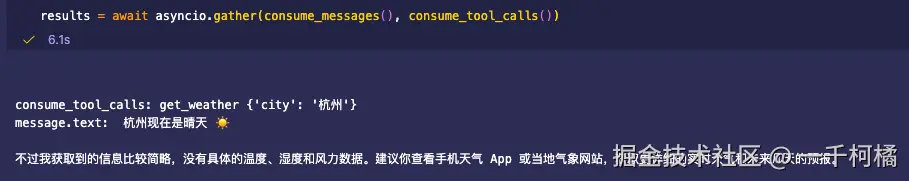
同步执行 stream.interleave("messages", "tool_calls") 的核心作用是:将多个不同的数据流(比如大模型的对话消息流 messages 和工具调用流 tool_calls)按照时间顺序"交织(Interleave)"并合并成一个单一的迭代器,让你在同步循环中能够按顺序、无阻塞地同时处理它们
python
@tool
def get_weather(city: str) -> str:
    """Get weather for a given city."""
    return f"It's always sunny in {city}!"

agent = create_agent(
    model=qwen38_model, tools=[get_weather], checkpointer=InMemorySaver()
)

config = {"configurable": {"thread_id": str(uuid7())}}

stream = agent.stream_events(
    {"messages": [{"role": "user", "content": "杭州天气怎样"}]},
    config=config,
    version="v3",
)

for kind, item in stream.interleave("messages", "tool_calls"):
    if kind == "messages":
        for token in item.text:
            print(token, end="", flush=True)
    elif kind == "tool_calls":
        print(f"\nTool call: {item.tool_name}({item.input})")
        for delta in item.output_deltas:
            print(delta, end="", flush=True)
        print(f"\nTool result: {item.output}")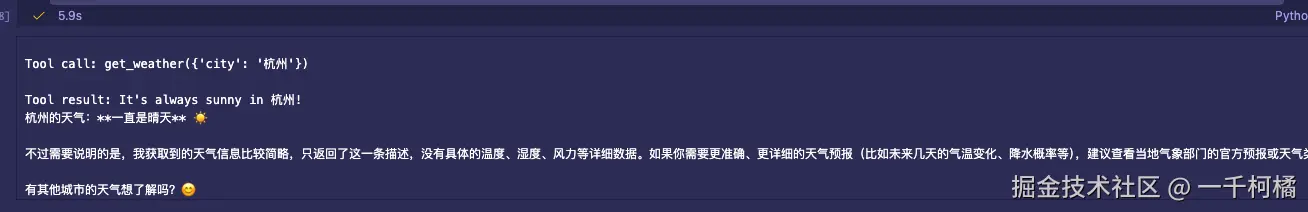
流式输出 (Steaming)
流式输出对于提升基于大语言模型构建的应用的响应能力至关重要。它会逐步展示输出内容,无需等待完整回复生成完毕,能够大幅优化用户体验,在应对大语言模型存在延迟的场景下效果尤为突出。
LangChain 的流式系统允许你将智能体运行的实时反馈输出到你的应用中。
LangChain 流式能力可实现的功能:
- 流式输出智能体进度: 在智能体每一步执行后获取状态更新。
- 流式输出大模型 token : 在语言模型生成 token 时实时推送。
- 流式输出思考/推理: 在模型生成推理内容时实时展示。
- 流式输出自定义更新信息: 比如发送用户自定义信号,"正在...,进度条怎么样等"
多模式流式输出方式
在调用 LangGraph/LangChain 的 agent.stream(stream_mode=xx) 或 agent.astream(stream_mode=xx) 方法时,可以通过列表形式传入:
-
updates(智能体进度):
在每一个 Agent 步骤(Step)执行完成后,流式返回该步骤导致的状态更新(State Updates)。如果同一步骤内运行了多个节点,更新会被拆开分别推送。
通常用于监控工作流进度,实时了解 Agent 执行到了哪一步以及状态发生了什么变化
-
messages:
只要图中有任何节点调用了大模型(LLM),就会实时流式返回包含 (token, metadata) 的元组。
用于实现打字机/流式吐字效果,让前端页面实时展示大模型正在生成的文本。
-
custom(任意用户数据)模式。
允许你在图节点的代码内部,使用流写入器(Stream Writer)主动推送自定义的数据。
用于推送业务自定义事件,例如实时进度条(如 25%)、中间计算过程日志或自定义结构化数据。
Agent progress
通过 config 传入 thread_id,对话状态将被保存,后续轮次可以接续同一段对话历史。thread_id 和 stream_mode 相互独立;你也可以同步传入 context,用于传递单次运行数据,工具可从 runtime.context 读取该数据
要流式输出智能体的执行进度,需要搭配 stream 或 astream 方法,并使用 stream_events 并指定 version="v3",移除不兼容的 stream_mode。
例如,若你的智能体调用一次工具,会收到如下更新:
- 大模型节点:AIMessage,包含工具调用请求
- 工具节点:ToolMessage,包含执行结果
- 大模型节点:最终AI回复
python
    def get_weather(city: str) -> str:
        """Get weather for a given city."""
        return f"It's always sunny in {city}!"

    agent = create_agent(
        model=qwen38_model, tools=[get_weather], checkpointer=InMemorySaver()
    )
    config = {"configurable": {"thread_id": str(uuid7())}}
    stream = agent.stream_events(
        {"messages": [{"role": "user", "content": "杭州天气怎样?"}]},
        config=config,
        version="v3",
    )

    #  stream.interleave 将 多个事件流合并在一起
    for kind, item in stream.interleave("messages", "tool_calls"):
        if kind == "messages":
            for token in item.text:
                print(token, end="", flush=True)
        elif kind == "tool_calls":
            print(f"\nTool call: {item.tool_name}({item.input})")
            for delta in item.output_deltas:
                print(delta, end="", flush=True)
            print(f"\nTool result: {item.output}")

    final_state = stream.output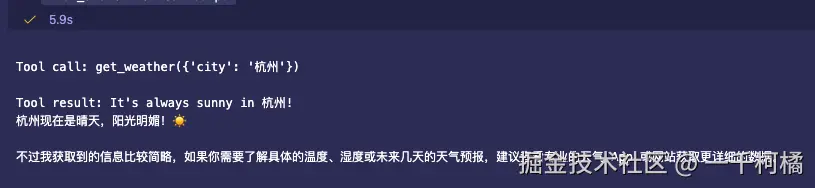
流式输出打字效果
使用 agent.stream + stream_mode="messages" 打字效果
python
@tool
def get_weather(city: str) -> str:
    """Get weather for a given city."""

    return f"It's always sunny in {city}!"

agent = create_agent(
    model=qwen38_model,
    tools=[get_weather],
)

# stream 方法:粗粒度(侧重状态与节点)
# 以"图的节点(Node)执行完毕"或"状态更新(Updates)"为单位,或者是基于传统 StateGraph 的整体状态输出
for chunk in agent.stream(
    {"messages": [{"role": "user", "content": "What is the weather in SF?"}]},
    stream_mode="messages",
    version="v2",
):
    if chunk.get("type") == "messages":
        token, metadata = chunk["data"]

        # 针对 token 内容进行判断并直接打印文本
        if hasattr(token, "content") and token.content:
            print(token.content, end="", flush=True)
        elif hasattr(token, "content_blocks") and token.content_blocks:
            # 如果 content_blocks 存在且有内容,遍历并打印文本块
            for block in token.content_blocks:
                if isinstance(block, dict) and block.get("type") == "text":
                    print(block.get("text", ""), end="", flush=True)
                elif isinstance(block, str):
                    print(block, end="", flush=True)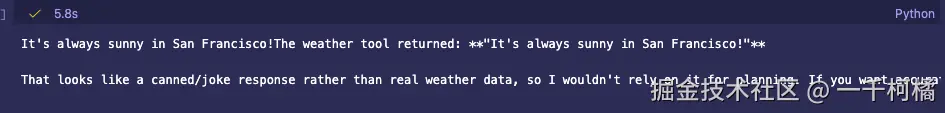
自定义更新流式内容
自定义流式输出 需要使用 writer = get_stream_writer() 后, writer(description) 可以输出数据
python
from langgraph.config import get_stream_writer

@tool
def get_weather(city: str) -> str:
    """Get weather for a given city."""
    writer = get_stream_writer()
    # stream any arbitrary data
    writer(f" step1 判断是否是正确的城市: {city}")
    writer(f" step2 获取城市的天气预报数据: {city}")
    return f"It's always sunny in {city}!"

agent = create_agent(
    model=qwen38_model,
    tools=[get_weather],
)

for chunk in agent.stream(
    {"messages": [{"role": "user", "content": "What is the weather in SF?"}]},
    stream_mode=["custom", "updates"],
    version="v2",
):
    print("type: ", chunk["type"], " chunk: ", chunk)
    if chunk["type"] == "custom":
        print(chunk["data"])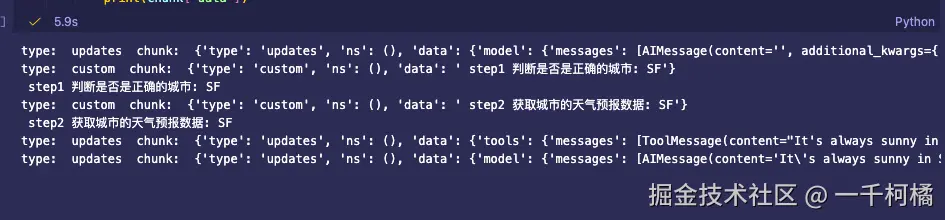
流式传输和事件流的不同
Streaming(流式传输) 和 Event Streaming(事件流) 是两套密切相关但层级和粒度不同的实时数据获取机制。
以下是它们的相同点和不同点总结:
相同点核心目的相同:
实时监控 : 它们的出发点都是为了打破传统"发起请求 → 漫长等待 → 获取最终结果"的黑盒模式,实现对 Agent 或工作流执行过程的实时监控与可见性。
支持异步与同步:两类机制都提供了对应的同步和异步调用方式(如 .stream() 对应 .astream(),.stream_events() 也支持相应的异步流处理),满足不同的后端架构需求。
不同点
- Streaming (.stream() / .astream()): 主要以"图的节点(Node)执行完毕"或"状态更新(Updates)"为单位。依赖传入的 Stream Modes(如 "updates", "messages", "custom"),返回对应模式的数据。
- Event Streaming (.stream_events()): 能够深入到大模型生成的每一个 Token、工具调用的全过程、子 Agent 嵌套等微观事件.