前言
上篇文章笔者分享了如何使用豆包生成AI视频,不少读者都踊跃尝试生成自己的AI视频,不过也有不少读者朋友讨论:为什么我生成的片子总有一股"塑料味儿"?有人认为是画质不够,有人觉得是人物不像。其实大多数时候,问题都出在一个关键原因上:输入提示词的质量。大家往往只告诉了模型要"拍谁",却没有细致地告诉它"怎么拍"。"一个女孩在雨里哭"这种提示词几乎不含有效信息:她在哪儿哭、什么光线、镜头离她多远、哭到什么程度,都没有描述清楚,大模型只能靠猜。
本篇文章笔者将详细介绍大模型视频生成的提示词编写原则:它由哪些部分组成、每部分怎么写、常见坑又在哪里。还等什么?大家一起来学习吧~
一、提示词是一份导演指令包,不只是一句描述
很多人对提示词的理解还停留在"给视频生成大模型发一句话描写"。但真正能出片的提示词,是一段结构化的创作指令,用文字把主体、场景、光影、镜头、构图、风格、质感和氛围一次性交代清楚。普通提示词靠的是想象,专业提示词靠的是工业标准,用文字把影视流程复刻一遍,将选景、布光、机位、构图、调色等都压进一段话里。
看下面两组写法:
初级写法是 "古风女子站在桃花树下",十次会生成十个样;
专业提示词则要写成 "环绕推近运镜,古风白衣女子静立十里桃林,落英纷飞,黄昏黄金时刻柔光侧逆光,丁达尔光束穿透花枝,中式留白构图,电影画幅,国风水墨写实,胶片颗粒质感,清冷孤寂氛围感"。差别不在词多词少,而在于后者把场景、光线、镜头、风格、氛围一次给全了。
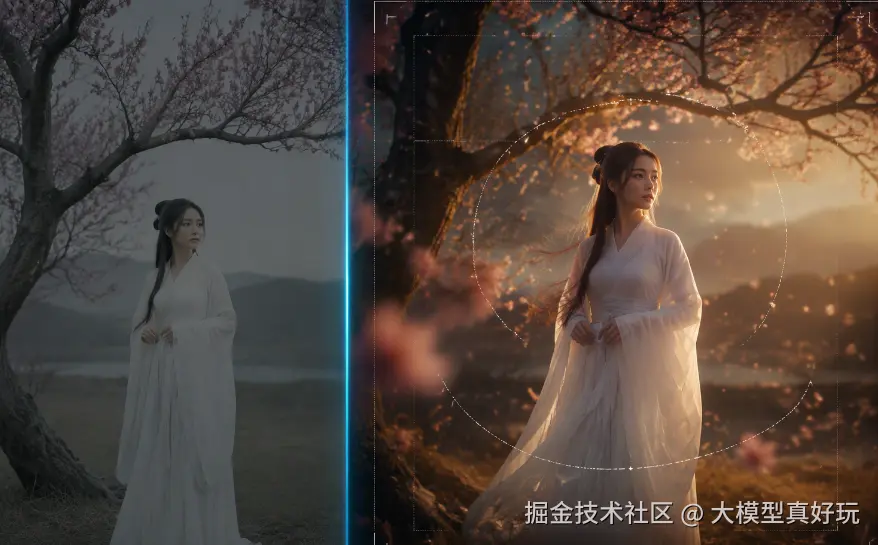
二、视频生成提示词必备要素
一段合格的提示词至少需要包含八个要素:主体 、场景 、动作 、镜头 、风格 、光照 、情绪 、氛围。
这八个要素缺一不可:缺少主体,模型就不知道要生成什么;缺少场景,人物就会像贴纸一样浮在虚空中;缺少动作,画面就会有PPT的既视感;缺少镜头,观众就没有被"带着看"的结构;缺少风格,画面就会显得调性混乱;缺少光照,画面会变得扁平灰暗;缺少情绪,表演就会像个空洞假人;缺少氛围,观众的代入感就不强。下面通过一个典型示例,来介绍具备必备要素的提示词应该怎么写。
第一步先写主体:
text
一位银发白袍的古代剑客第二步再写场景,场景最好有坐标:
text
雨后清晨的江南古镇,青石板路湿漉漉第三步写动作,动作一定要描述具体:
text
在竹林里舞剑,剑花凌厉第四步写镜头给视角:
text
低角度仰拍,镜头缓慢推进第五步再写光照赋予质感:
黄昏逆光,轮廓光勾勒发丝剩下的风格、情绪、氛围等也依次展开。按照上述步骤,大家就可以生成一个非常完整的提示词。
三、通用提示词生成框架:SCELA+
上面的八个要素大家记起来还是比较费劲,即梦团队根据以上各个元素,总结了一套名为 SCELA+ 的提示词编写框架。它把提示词拆成场景、角色、表情动作、镜头语言、氛围情绪五个模块,末尾的加号代表可以额外补充光照、特效和参考素材。其实 SCELA+ 框架本身的字母顺序就代表了提示词的生成顺序:先搭舞台,再安排演员,指导表演、设置机位,最后注入灵魂。这正是剧组的开工顺序,也是模型最容易听懂的顺序。
具体含义如下:
- S 是场景,用三到五个具象元素搭出时空坐标:地点 + 时代 + 天气 + 核心道具 + 空间层次;
- C 是角色,用"特征锚点"锁定辨识度:一个核心特征、多个辅助特征,加服装材质;
- E 是表情动作:动作按起承转合进行拆分,表情按眼神、嘴角、微表情进行拆分;
- L 是镜头语言:遵循"景别 + 运动 + 角度 + 焦点"的公式;
- A 是氛围情绪:用通感调动多重感官;
- + 号是补充说明:用来补光照细节、特效参数,或者用 @ 引用素材。
大家在编写提示词时,按照上述顺序进行编写,拼接起来就是一份完整的视频生成提示词,例如下面的例子:
text
(S)废弃的 90 年代游乐场,黄昏,旋转木马生锈,积水倒映残阳。(C)银发少女,右眼下方有泪痣,褪色牛仔外套,赤脚。(E)低头咬住下唇,眼眶泛红却强忍泪水,缓步离开旋转木马。(L)远景俯拍,缓慢推近至中景,焦点锁定颤抖的手指。(A)潮湿的铁锈味,远处设施嘎吱作响。(+)夕阳逆光勾勒轮廓,@图片1 参考泪痣位置。生成的效果如下:
四、画面质量提升提示词关键技巧
除了上述提到的 SCELA+ 写作框架,要让你生成的画面更加完美,还有各种各样的小技巧。利用好这些技巧,会让你的画面更加生动、活灵活现。
4.1 运镜:不只写怎么动,还要写动多少
很多人只会简单描述"移动一下镜头",这种虚的提示词模型只能瞎猜,结果要么不动,要么乱晃。
其实描写运镜可以从两个角度展开:
第一个角度是运镜方式,主要有推、拉、摇、移、跟、升降。推是向前靠近主体,拉是向后远离,摇是机身不动、镜头左右上下转,移是平行移动,跟是跟随主体,升降是垂直上下;进阶还有环绕、俯冲拉升、变焦、甩镜和轻微振动,分别对应转圈、俯冲、伪运镜、快速切换和手持的紧张感。
另一个角度是运镜参数:运镜速度是匀速还是变速,运镜幅度是"摇镜 30 度"还是"环绕半圈",运镜起止点是从"人物脚部缓慢拉升至面部特写",还是"从远景匀速推近至中景"。
所以大家以后可以将"慢慢推"这种含糊的提示词,修改为"匀速推近,3 秒完成"这类可执行指令,才能让画面生成的镜头更加稳固。
4.2 光照:五个维度定住画面质感
光照决定的不只是亮不亮,还有立体感、情绪基调和视觉质感。专业的光照描述,要补足五个维度。
先定主光源的位置,它决定明暗结构。常见就五种:顶光、侧光、逆光、底光、前光。举个例子,如果大家在提示词中写"主光源为 45 度左侧光,人物面部呈现经典伦勃朗三角光",一句话就可以奠定画面整体的明暗关系与基调。
再定光源的性质。硬光来自直射阳光或聚光灯,阴影边缘锐利,适合强调轮廓和力量感;柔光来自阴天或柔光箱,过渡自然,适合人像。提示词里可以这样写明"硬光边缘锐利"或"柔光漫射过渡自然"。
然后是层次与色温。光的层次可以分为三层:主光定基调、补光填阴影、轮廓光把主体和背景分开。色温一般用来展示情绪,暖光(3000K)复古温馨,冷光(6500K)疏离,青橙对比自带电影感。
最出效果的是光影细节:阴影是软是硬,光线里有没有介质(丁达尔效应、雾中光束、可见的灰尘),表面是什么响应(金属反光、皮肤次表面散射)。一句很优秀的提示词对光影的描述是这样的:"夕阳穿过百叶窗投下条纹阴影,灰尘在光束中飞舞"。这一句加进去,画面立马有了立体的空气感。
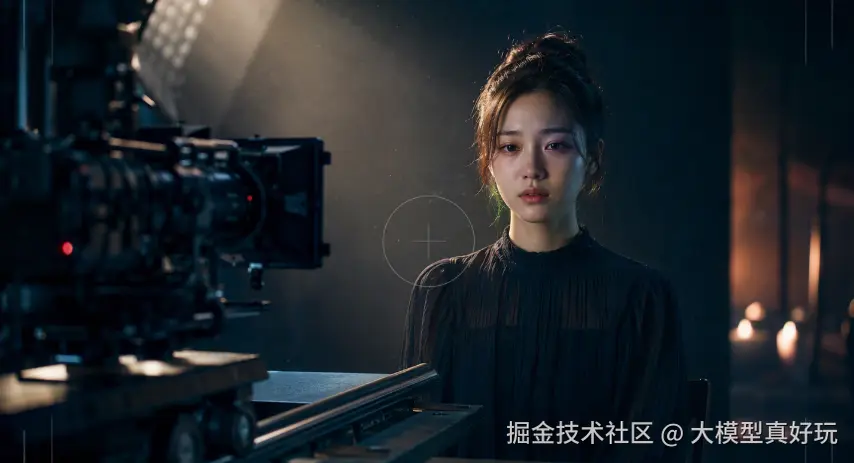
4.3 情绪:把抽象感受翻译成身体信号
情绪其实非常难写,也非常决定角色的真实性和观众的代入感,是决定视频生成成败的关键因素。
对视频生成大模型来说,它并不认识具体的情绪,例如"悲伤";但如果大家这样描述:"眼眶泛红、泪水打转、嘴角颤抖、喉结滚动",很明显大模型可以生成出来。这就是描写情绪需要用到的"外化翻译法"。简而言之,就是把抽象情绪翻译成可视化的身体信号。
4.4 别写"不要"
在视频生成大模型的提示词编写中,有一套反直觉的原则:尽量别在提示词里写"不要"。对于字节跳动的 Seedance 大模型来说,它不太能理解否认指令,往往是你越强调不要什么,画面里越容易出现什么。所以很多时候我们需要换一个说法。
将"不要手指错误"改成"手指自然弯曲,五指分明","不要背景闪烁"改成"画面全程稳定,无闪烁","不要多余的人"改成"仅单人出镜,无额外角色"。
4.5 画面数值化:把大概变成具体参数
前面的技巧解决的是画面"像不像"的真实感问题,画面数值化主要用来解决"准不准"的问题。
画面数值化最有用的是时间轴。把 15 秒切成几段,用 0~~3秒、4~~6秒 标出来,每段只安排一个核心动作。
还有一种数值化的应用是细节的强度。比如"运动强度 7/10"就很实用,限定了范围的同时给出了当前画面的具体强度,模型生成得会更准。
涉及复杂物理效果时,还可以直接声明参数,如"重力系数=0.8""布料柔韧度=high"。数字不是玄学,而是在告诉模型"到什么程度"。
4.6 多镜头
目前豆包的 Seedance 大模型支持最长生成 15s 的视频。要让这么短的时间具有叙事感,推荐使用多镜头叙事,而不是一个镜头拍到底。
对于时间轴分段的提示词来说,可以这样设计:按"起承转合"拆成三到五段,开头建环境,中间用中景带主体,再用特写抓情绪,最后拉远收尾。段与段之间的光影过渡和叙事衔接,交给模型自己计算。
还有一些进阶的做法是景别递进,让"远景到中景再到特写"形成一条视觉路径;还可以融入"术语",比如"在恐慌时刻应用希区柯克变焦,随后环绕镜头展示空间关系"。
4.7 提示词精简
学了这么多框架和技巧,这时候大家可能会说:是不是我的提示词把每一方面都写得特别完善,生成的效果就一定好呢?
其实不然。对于 Seedance 模型来说,最佳的提示词生成区间是 30--200 个词,超出这个范围,质量会明显下滑,主要是因为模型的注意力被稀释了。有实测显示,冗余度超过 38%,模型对动作指令的响应准确率会明显降低。
当然了,精简并不是让你机械地删除文字,而是要有"保留动作骨架,剥离修饰脂肪"的思想,一定要保留主体特征和核心动作。对于一些需要大量描写面容的词句,可以使用"@图1 参考面容"上传需要的面容图片,既能保持面容的一致性,又能很好地压缩内容。
下面举一个例子:
原来冗长的提示词:
text
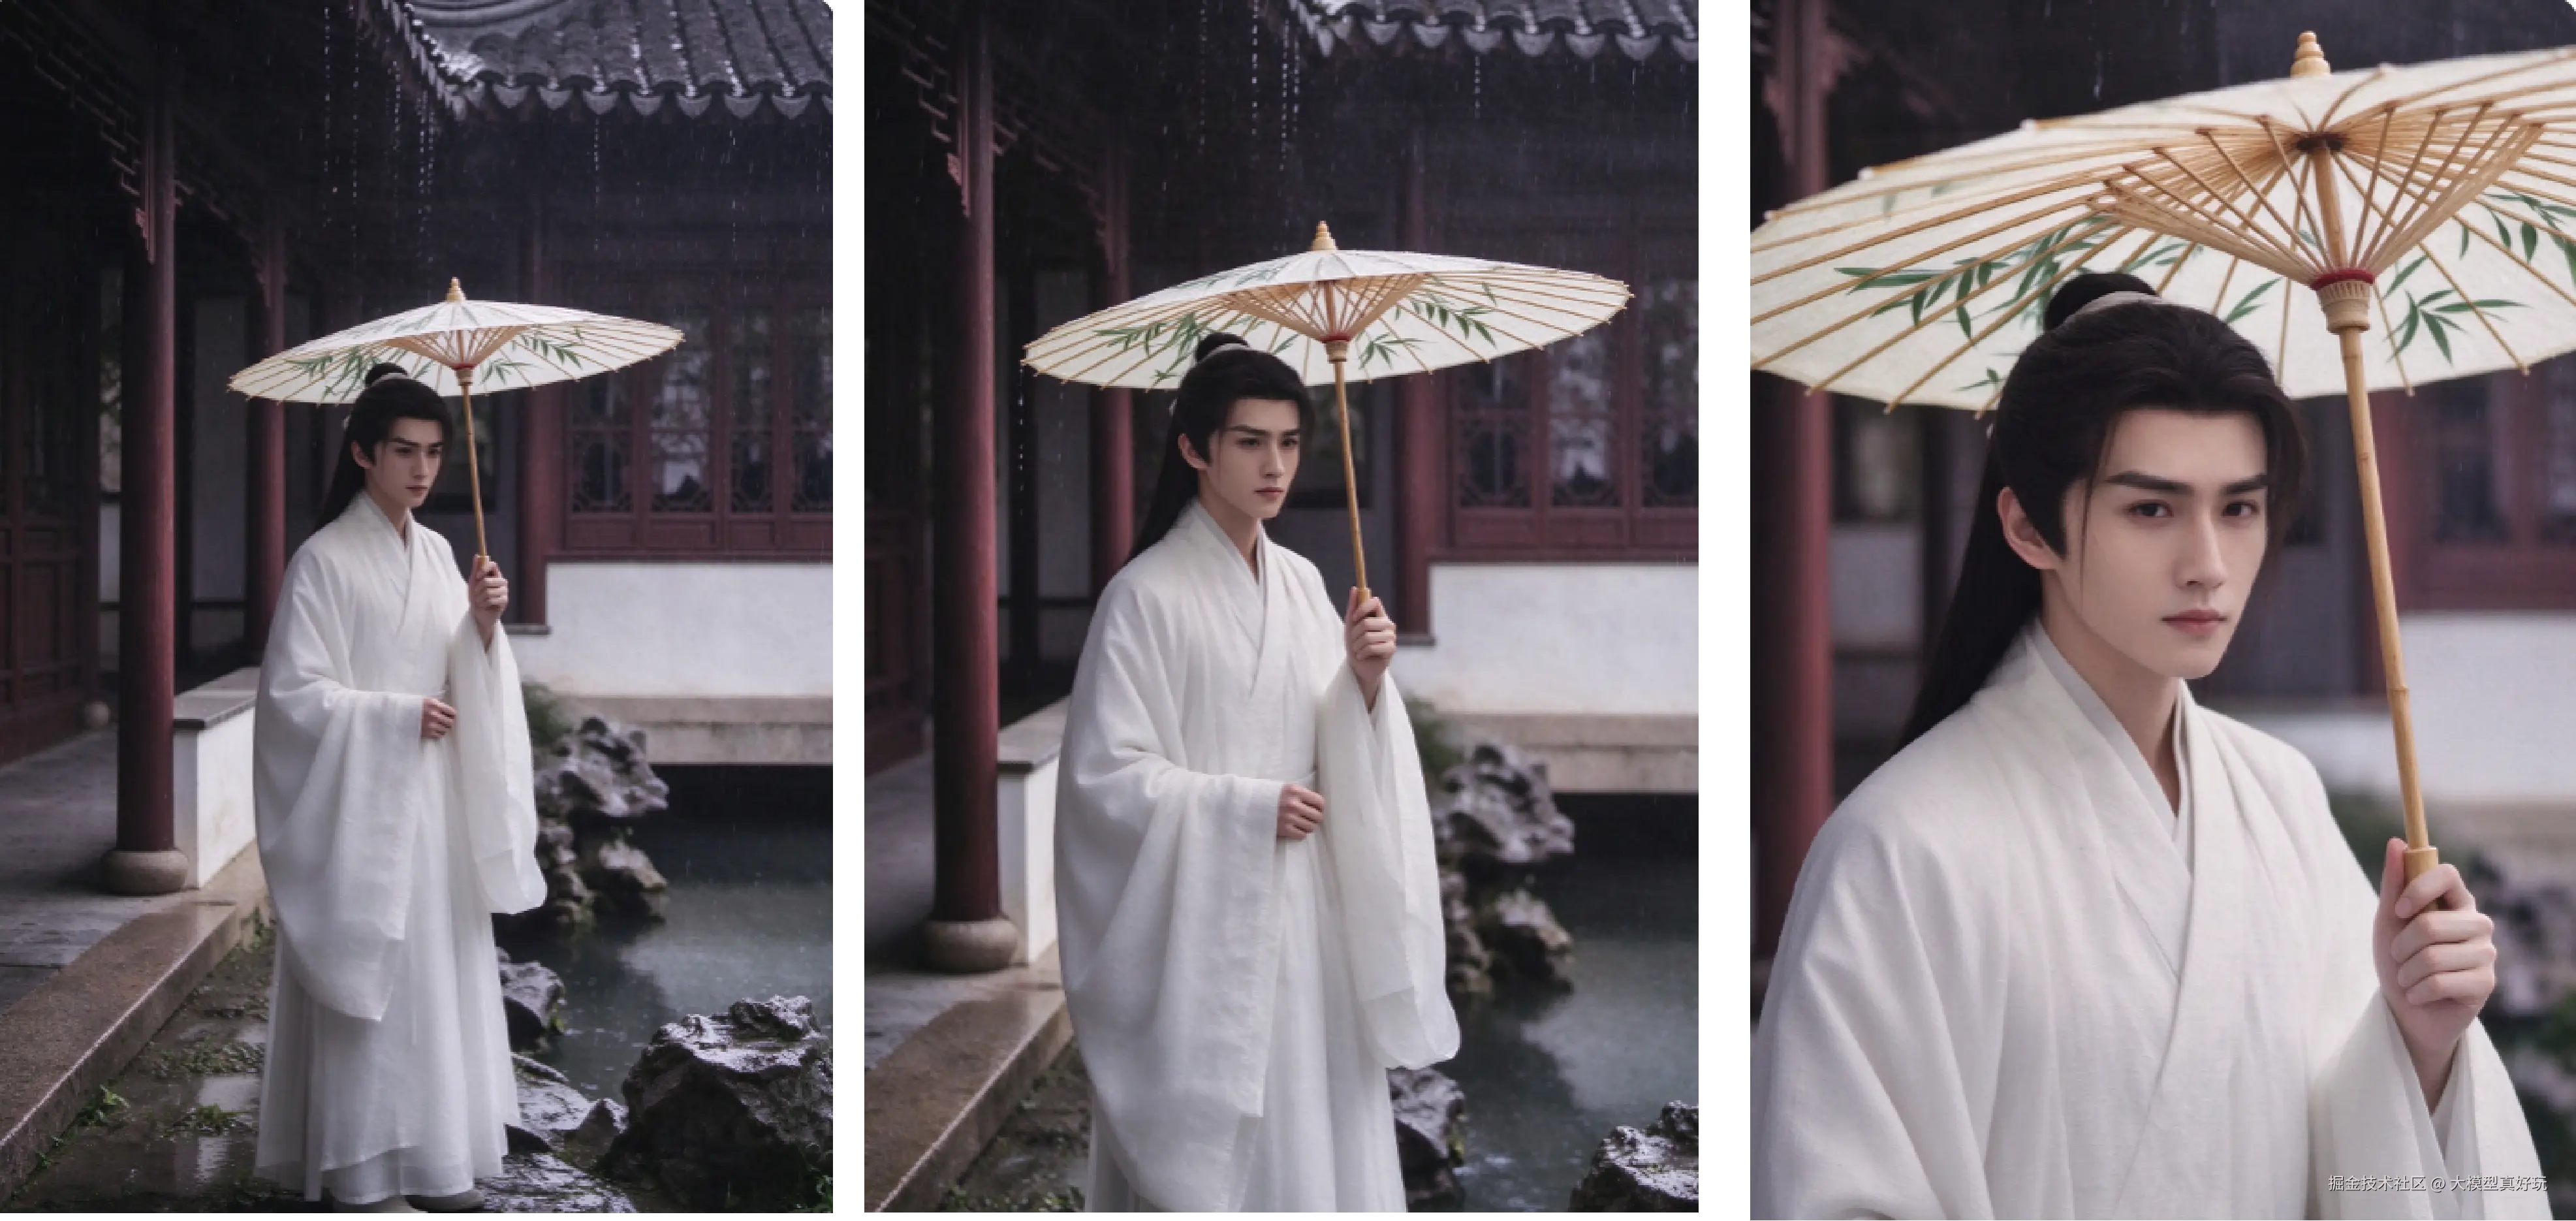
一位身着锦衣华服、腰佩温润玉佩、面如冠玉、眸光深邃的年轻男子,伫立于落英缤纷的江南庭院中,周遭有奇石、碧潭、曲廊水榭,碧潭中有锦鲤戏水,天际飘着蒙蒙烟雨,他撑着油纸伞,眉宇间流露着淡淡的惆怅,仿佛在思念远方的故人,镜头从远景徐徐拉近,最终定格在他落寞的眼眸上,背景音乐是苍凉的古琴曲,整体氛围凄美动人,电影级画质,8K 分辨率。精简后的提示词:
text
古装男子撑油纸伞立于雨中江南园林,眼神忧伤。[0~~4 秒] 远景推近,[5~~8 秒] 特写眼眸。细雨绵绵,古琴 BGM(background music,背景音乐),电影质感。@图 1 参考面容服饰。生成效果如下:
五、视频提示词生成skill: 上述流程的自动化实现
这时候又有读者朋友要说了:"我也不是专业的呀,上面这些知识也太多啦,我怎么能记得住呢?"作为最宠粉的大模型博主,笔者的目标是让每个人都能具备驾驭 AI 大模型的能力,因此已经把上述流程整理成了一整套 Skill。(如果对 Skill 不熟悉,可以看笔者的文章 Agent Skills完全指南:核心概念丨设计模式丨实战代码)。大家日常使用 workbuddy、codex、claude code 还是 deepseek harness,都可以安装笔者的 Skill。只需简单输入想要描述的场景,Skill 即可辅助你生成一整套专业提示词。下面笔者以 DeepSeek Harness 来演示。如果对 DeepSeek Harness 不熟悉,可以看笔者的专栏:DeepSeek Harness从入门到进阶
- 设定工作区,将Skill放在工作区中,让DeepSeek Harness安装该 Skill。笔者这里已经安装过了。
text
将 video-prompt-director skill 添加到你的skill技能库中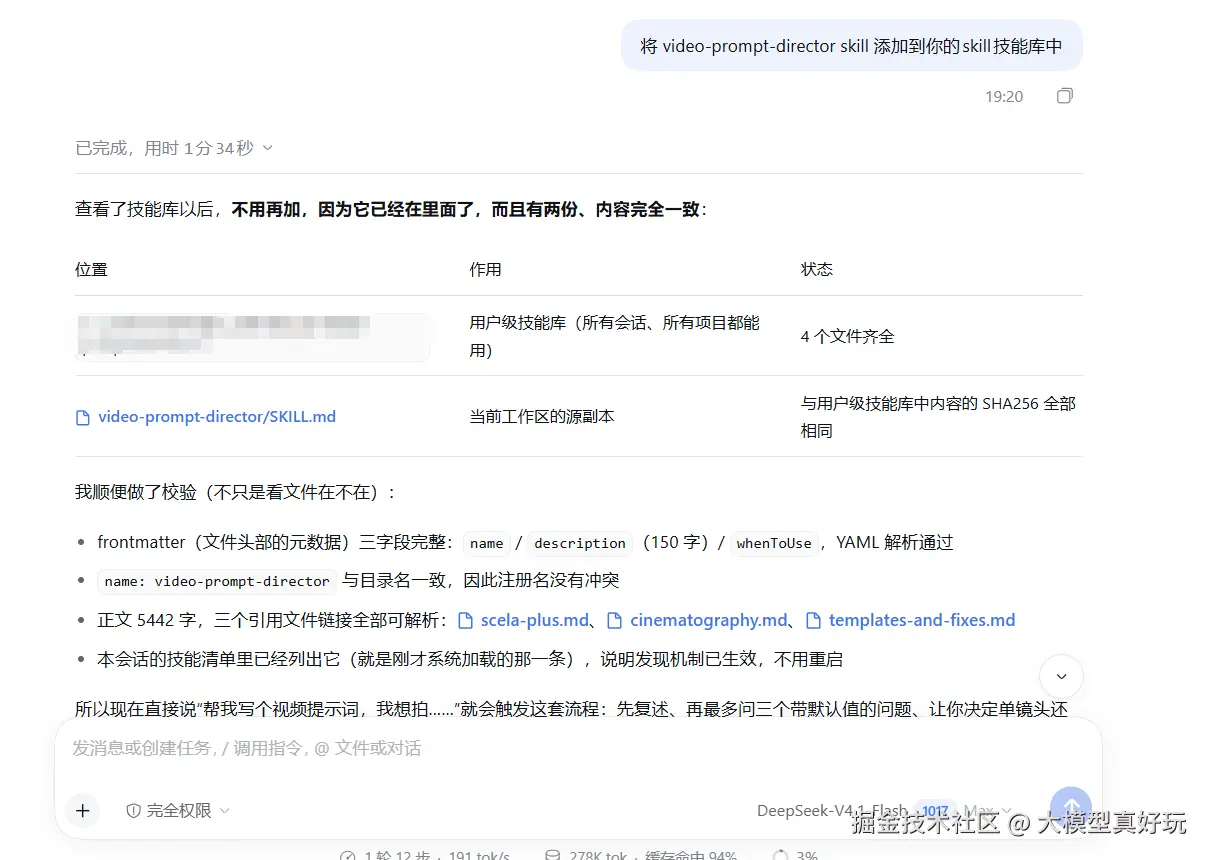
- 输入想要生成的相关场景,得到提示词加持的智能体会给出需要输入的建议和必需参数
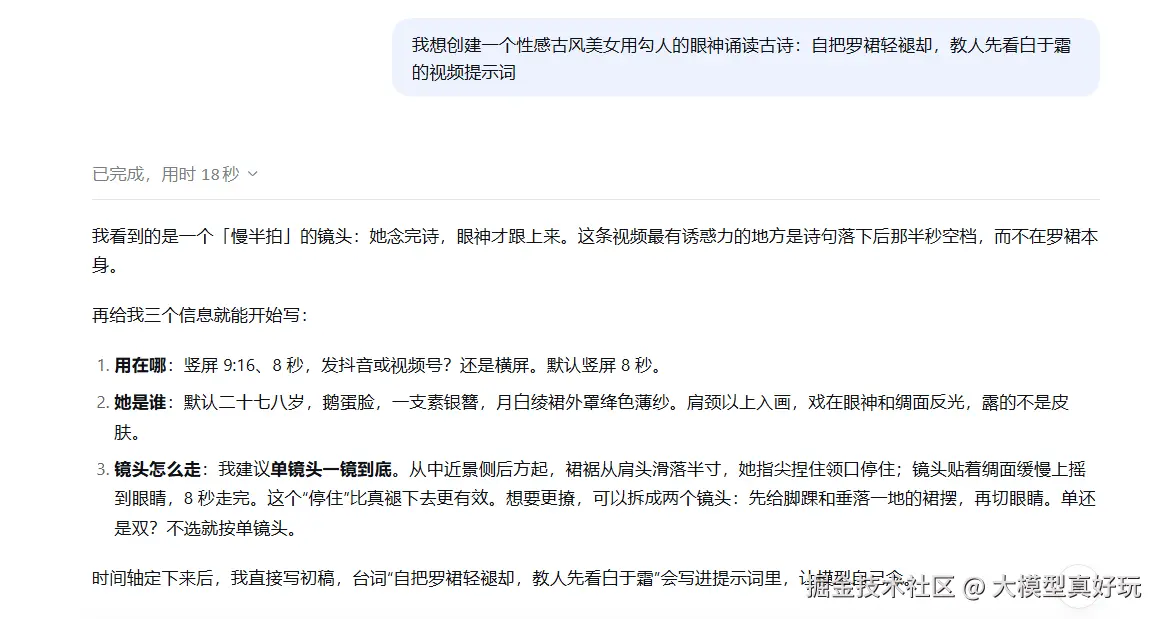
- 按照交互提示输入必要参数,直到生成满意的提示词
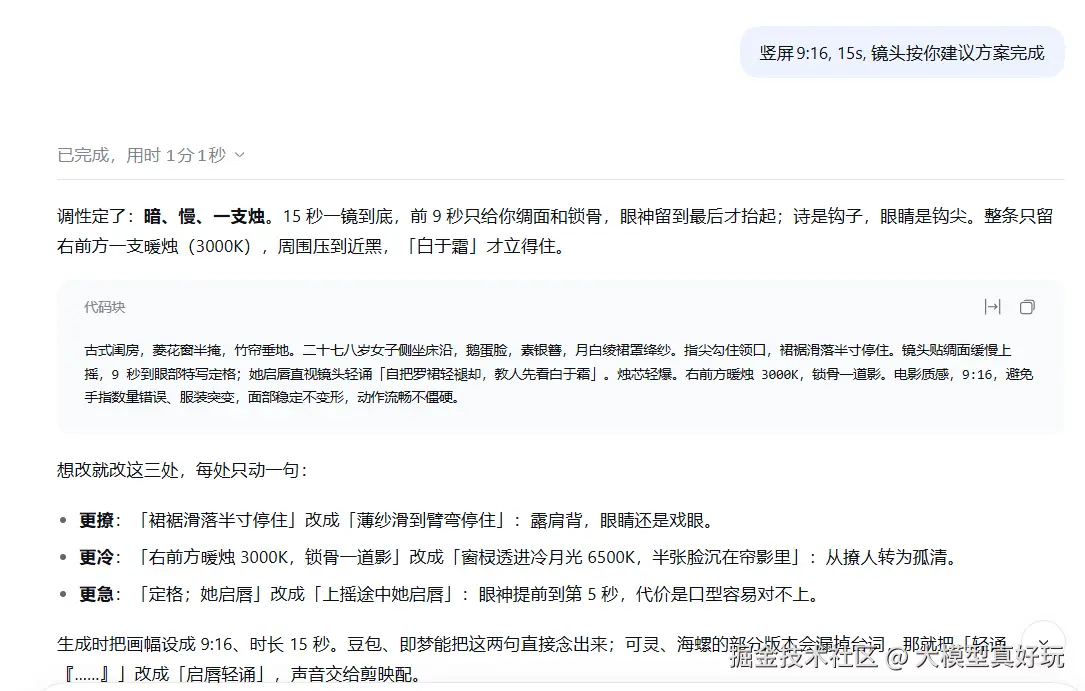
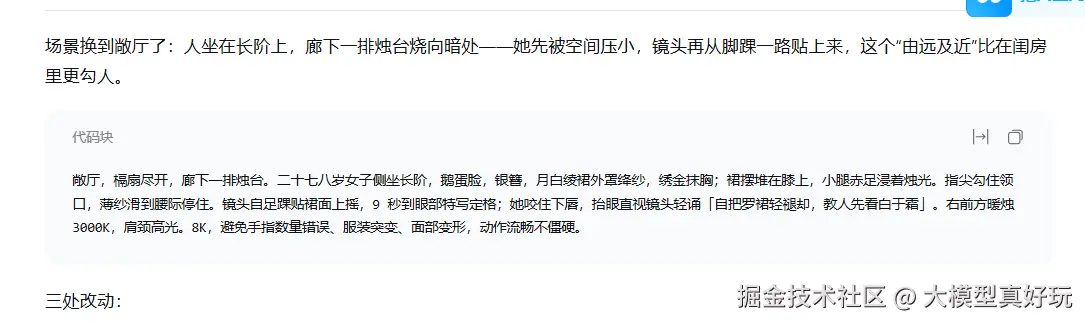
- 将提示词输入豆包生成视频
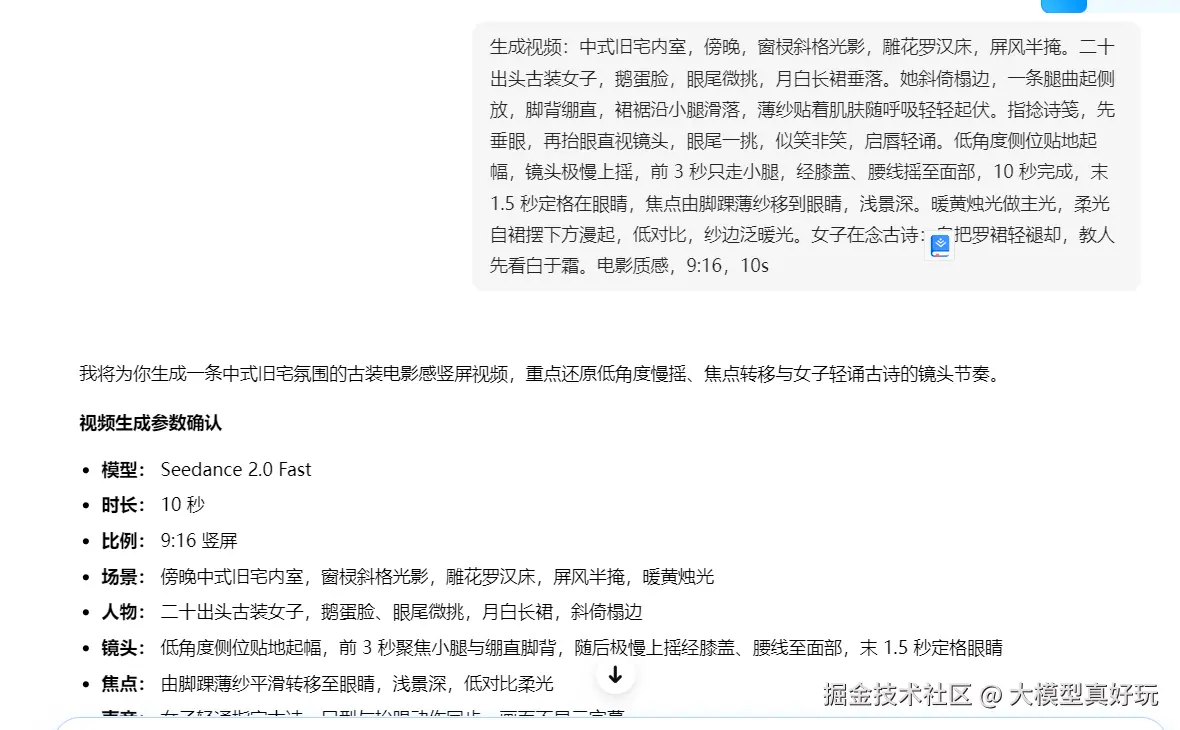
- 最终生成的效果如下,是不是非常简单
以上就是本篇文章的全部内容,video-prompt-director skill大家感兴趣可添加笔者同名微信公众号大模型真好玩 并私信视频生成skill 自取。
六、总结
一轮梳理下来,笔者的感受是:视频模型对你"言听计从"的前提,是大家先学会像导演一样说话。从SCELA+框架的五个模块,到运镜、光照、情绪外化、避免"不要"指令、数值化控制、多镜头叙事和提示词精简,这套方法本质上是在用结构化的语言复刻影视工业的决策流程,让模型不再靠猜,而是按指令执行。
工具层面,豆包的Seedance、即梦、可灵各有所长;真正拉开差距的,始终是提示词的结构化程度。结构化提示词不只是一段描述,它本身就是AI视频创作最核心的技术能力。笔者也会继续打磨video-prompt-director skill,让"输入一个场景,得到一套专业提示词"的体验再顺滑一些,后续的更新与分享也会第一时间同步给大家~ 当然笔者的主要文章分享方向还是大模型前沿技术的研究与深入探索,欢迎各位热爱大模型、智能体技术的读者朋友们关注笔者的掘金账号与专栏,也可关注笔者的同名微信公众号大模型真好玩,一起把大模型玩明白~