概述
在快速入门 Spring Data Redis 之前,我们先来做个简单的了解。在 Spring 的生态中,我们使用 Spring Data Redis 来实现对 Redis 的数据访问。可能这个时候,有人会有疑惑,市面上已经有 Redis、Redisson、Lettuce 等优秀的 Java Redis 工具库,为什么还要有 Spring Data Redis 呢?学不动了,头都要秃了!不要慌,我们先来看一张图:
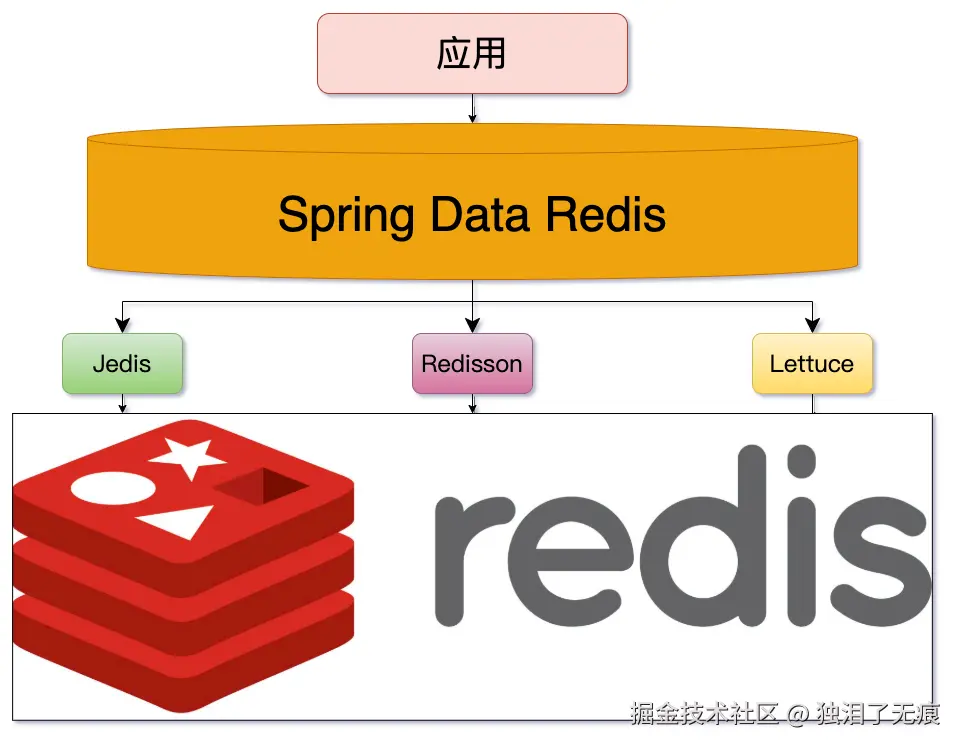
Jedis 是 Redis 官方推出的一款面向 Java 的客户端,提供了很多接口调用。并不是只有 Jedis 可以使用,像jdbc-redis、Jredis也都属于 Redis 的 Java 客户端,但他们之间是无法兼容的。如果在一个项目中使用了 Jedis,然后后来决定弃用掉改用 jdbc-redis 就比较麻烦了。Spring Data Redis 是 Spring Data 模块的一部分,专门用来支持在 Spring 应用程序对 Redis 的轻松配置和访问。Spring Data Redis 提供了统一的操作模板 RedisTemplate,封装了 Jedis、Lettuce 的 API 操作,访问 Redis 数据。所以,实际上,Spring Data Redis 内置真正访问的实际是 Jedis、Lettuce 等 API 操作。
基础建设
想象一下,你是一家跨国餐厅的经理,Redis 是你的冷库,Spring Data Redis 给你配了一个全能管家。你只需要告诉管家:"帮我把这筐苹果(Java 对象)存进 01 号柜。" 管家会自动帮你把苹果打包(序列化)、搬运、锁门,甚至还能把不同种类的货物分门别类(封装 API)。
依赖引入
在 Spring 中,spring-data-redis 项目对访问 Redis 进行了 API 封装,提供了便捷的访问方式。springBoot 项目中的子模块 spring-boot-starter-data-redis 基于 spring-data-redis 项目,做了二次封装,大大简化了 Redis 的相关配置。如果用的是 Spring Boot,则直接引入 starter,如下所示,它默认集成了 Lettuce 驱动,性能杠杠的。
xml
<!-- Spring Data Redis 依赖 -->
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-data-redis</artifactId>
</dependency>
这个 starter 会自动把 Spring Data Redis 的核心类、默认的 Lettuce 连接工厂都引入。如果需要配连接池,还需要额外引入 Apache Commons Pool2:
xml
<!-- 配置连接池需要的依赖 -->
<dependency>
    <groupId>org.apache.commons</groupId>
    <artifactId>commons-pool2</artifactId>
</dependency>
配置数据源
不同版本的 Spring Boot 配置前缀不一样,Spring Boot 2.x 使用以 spring.data.redis 为前缀属性的 RedisProperties 来配置,而 Spring Boot 3.x 则以 spring.data.redis 为前缀属性的 RedisProperties 来配置 Redis。在 resources/application.yml 文件中添加 Redis 配置,配置信息如下:
yaml
spring:
  data:
    redis:
      database: 0 # Redis 数据库索引,默认是0
      host: 127.0.0.1 # Redis 服务器地址
      port: 6379 # Redis 服务器连接端口
      password: # Redis 服务器连接密码(默认为空)
Lettuce 本身是 Netty 实现的,单个连接可以承载很多并发操作。但实际在高并发场景下,个人建议还是配置连接池,主要目的是控制连接资源的占用上限,避免突发的连接风暴。下面是一个相对合理的配置参考:
yaml
spring:
  data:
    redis:
      host: 127.0.0.1
      port: 6379
      password:
      timeout: 3s
      lettuce:
        pool:
          max-active: 16
          max-idle: 8
          min-idle: 2
max-wait: 3s| 参数 | 默认值 | 生产建议 | 简要说明 |
|---|---|---|---|
| max-active | 8 | 16~64 | 连接池中最大连接数,使用负值表示没有限制 |
| max-idle | 8 | 和 max-active 接近 | 最大空闲连接数,空闲连接太多是资源浪费 |
| min-idle | 0 | 2~4 | 最小空闲连接数,保持基本的连接储备 |
| max-wait | -1 | 3000ms | 获取连接的最大等待时间,使用负值表示无限等待 |
| timeout | 3s | 1~3s | 命令执行超时时间,超时会抛异常 |
核心配置类
Spring Data Redis 提供了两个常用的模板类:StringRedisTemplate 和 RedisTemplate,如下所示:
java
@AutoConfiguration
@ConditionalOnClass({RedisOperations.class})
@EnableConfigurationProperties({RedisProperties.class})
@Import({LettuceConnectionConfiguration.class, JedisConnectionConfiguration.class})
public class RedisAutoConfiguration {

    @Bean
    // 当RedisTemplate对象Bean在IOC容器不存在时则会执行此方法创建对象放到IOC容器
    // 若我们自己创建了RedisTemplate的对象Bean时,此方法则不会创建这个Bean对象
    @ConditionalOnMissingBean(name = {"redisTemplate"})
    // 表示当指定Bean在容器中只有一个,或者虽然有多个但是指定首选Bean
    @ConditionalOnSingleCandidate(RedisConnectionFactory.class)
    public RedisTemplate<Object, Object> redisTemplate(RedisConnectionFactory redisConnectionFactory) {
        //  键和值都是Object类型的,默认序列化方式为:JdkSerializationRedisSerializer
        //  JDK方式的序列化会导致我们的键和值转义
        RedisTemplate<Object, Object> template = new RedisTemplate();
        template.setConnectionFactory(redisConnectionFactory);
        return template;
    }

    @Bean
    // 当StringRedisTemplate的Bean对象不存在时则创建此对象放到Bean
    @ConditionalOnMissingBean
    @ConditionalOnSingleCandidate(RedisConnectionFactory.class)
    public StringRedisTemplate stringRedisTemplate(RedisConnectionFactory redisConnectionFactory) {
        //  键和值都是String类型的,默认序列化方式为:StringRedisSerializer
        return new StringRedisTemplate(redisConnectionFactory);
    }
}
我们在大多数情况下会使用 RedisTemplate 及其对应包,它把底层连接细节封装掉了,同时又保留了 Redis 的完整操作能力,该模块为Redis交互提供了高级抽象、各种操作视图和丰富的通用接口,用于针对特定的类型或键做不同的操作。其默认的 Redis 序列化方式会导致缓存的 key、value 乱码(二进制字符),不便于查看,如下图所示:
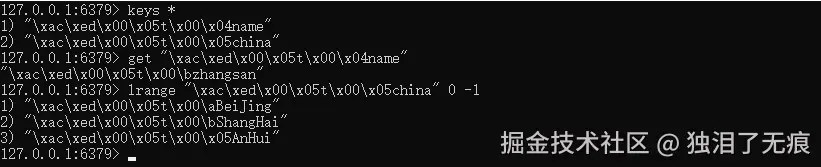
为了解决这个问题,需要自定义序列化配置。创建一个 RedisTemplate 实例,key 统一用 StringRedisSerializer,value 用 GenericJackson2JsonRedisSerializer,这样既保证了可读性,又兼容了对象反序列化。
java
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;
import org.springframework.data.redis.connection.RedisConnectionFactory;
import org.springframework.data.redis.core.RedisTemplate;
import org.springframework.data.redis.serializer.StringRedisSerializer;

@Configuration
public class RedisConfig {
    @Bean
    public RedisTemplate<String, Object> redisTemplate(RedisConnectionFactory factory) {
        // 配置我们自己的Redis模板,一般我们的key都为String,值为Object
        RedisTemplate<String, Object> redisTemplate = new RedisTemplate<>();
        // 为 Template 设置连接工厂
        redisTemplate.setConnectionFactory(factory);

        // 配置String序列化方式
        StringRedisSerializer stringRedisSerializer = new StringRedisSerializer();
        // 配置JSON序列化方式
        GenericJackson2JsonRedisSerializer jsonSerializer = new GenericJackson2JsonRedisSerializer();

        // key、hash key 用 String 序列化,保证在 Redis 客户端里可读
        redisTemplate.setKeySerializer(stringRedisSerializer);
        redisTemplate.setHashKeySerializer(stringRedisSerializer);

		// value 用 JSON 序列化,可读且跨语言
        redisTemplate.setValueSerializer(jsonSerializer);
        redisTemplate.setHashValueSerializer(jsonSerializer);

        // 设置默认序列化方式
        redisTemplate.setDefaultSerializer(stringRedisSerializer);

        redisTemplate.afterPropertiesSet();

        return redisTemplate;
    }
}
✅️ 由于本示例仅仅用于演示,因此将简单将字符串存储到 Redis,序列化对象使用 StringRedisSerializer。
使用 RedisTemplate 进行对象存储时,需要使存储对象实现 Serializable 接口,这样才能够成功将对象进行序列化。Spring Data Redis 提供了多种 Serializer 策略,这对使用 Redis 的开发者而言,实在是非常便捷。Spring Data Redis 提供了内置的 Serializer,如下表所示:
| 序列化策略 | 简要说明 |
|---|---|
| JdkSerializationRedisSerializer | 使用 JDK 的序列化手段,数据以字节流存储 |
| StringRedisSerializer | 字符串编码,数据以 String 存储 |
| JacksonJsonRedisSerializer | json 格式存储 |
| OxmSerializer | xml 格式存储 |
实战演练
在 Spring Data Redis 中提供了 RedisTemplate 工具类,里面封装了对 Redis 的操作,并且将不同的数据类型的操作 API 封装到了不同的类型中:
| API | 返回类型 | 简要说明 |
|---|---|---|
| redisTemplate.opsForValue() | ValueOperations | 操作 String 类型数据 |
| redisTemplate.opsForHash() | HashOperations | 操作 Hash 类型数据 |
| redisTemplate.opsForList() | ListOperations | 操作 List 类型数据 |
| redisTemplate.opsForSet() | SetOperations | 操作 Set 类型数据 |
| redisTemplate.opsForZSet() | ZSetOperations | 操作 SortedSet 类型数据 |
| redisTemplate | 通用命令 |
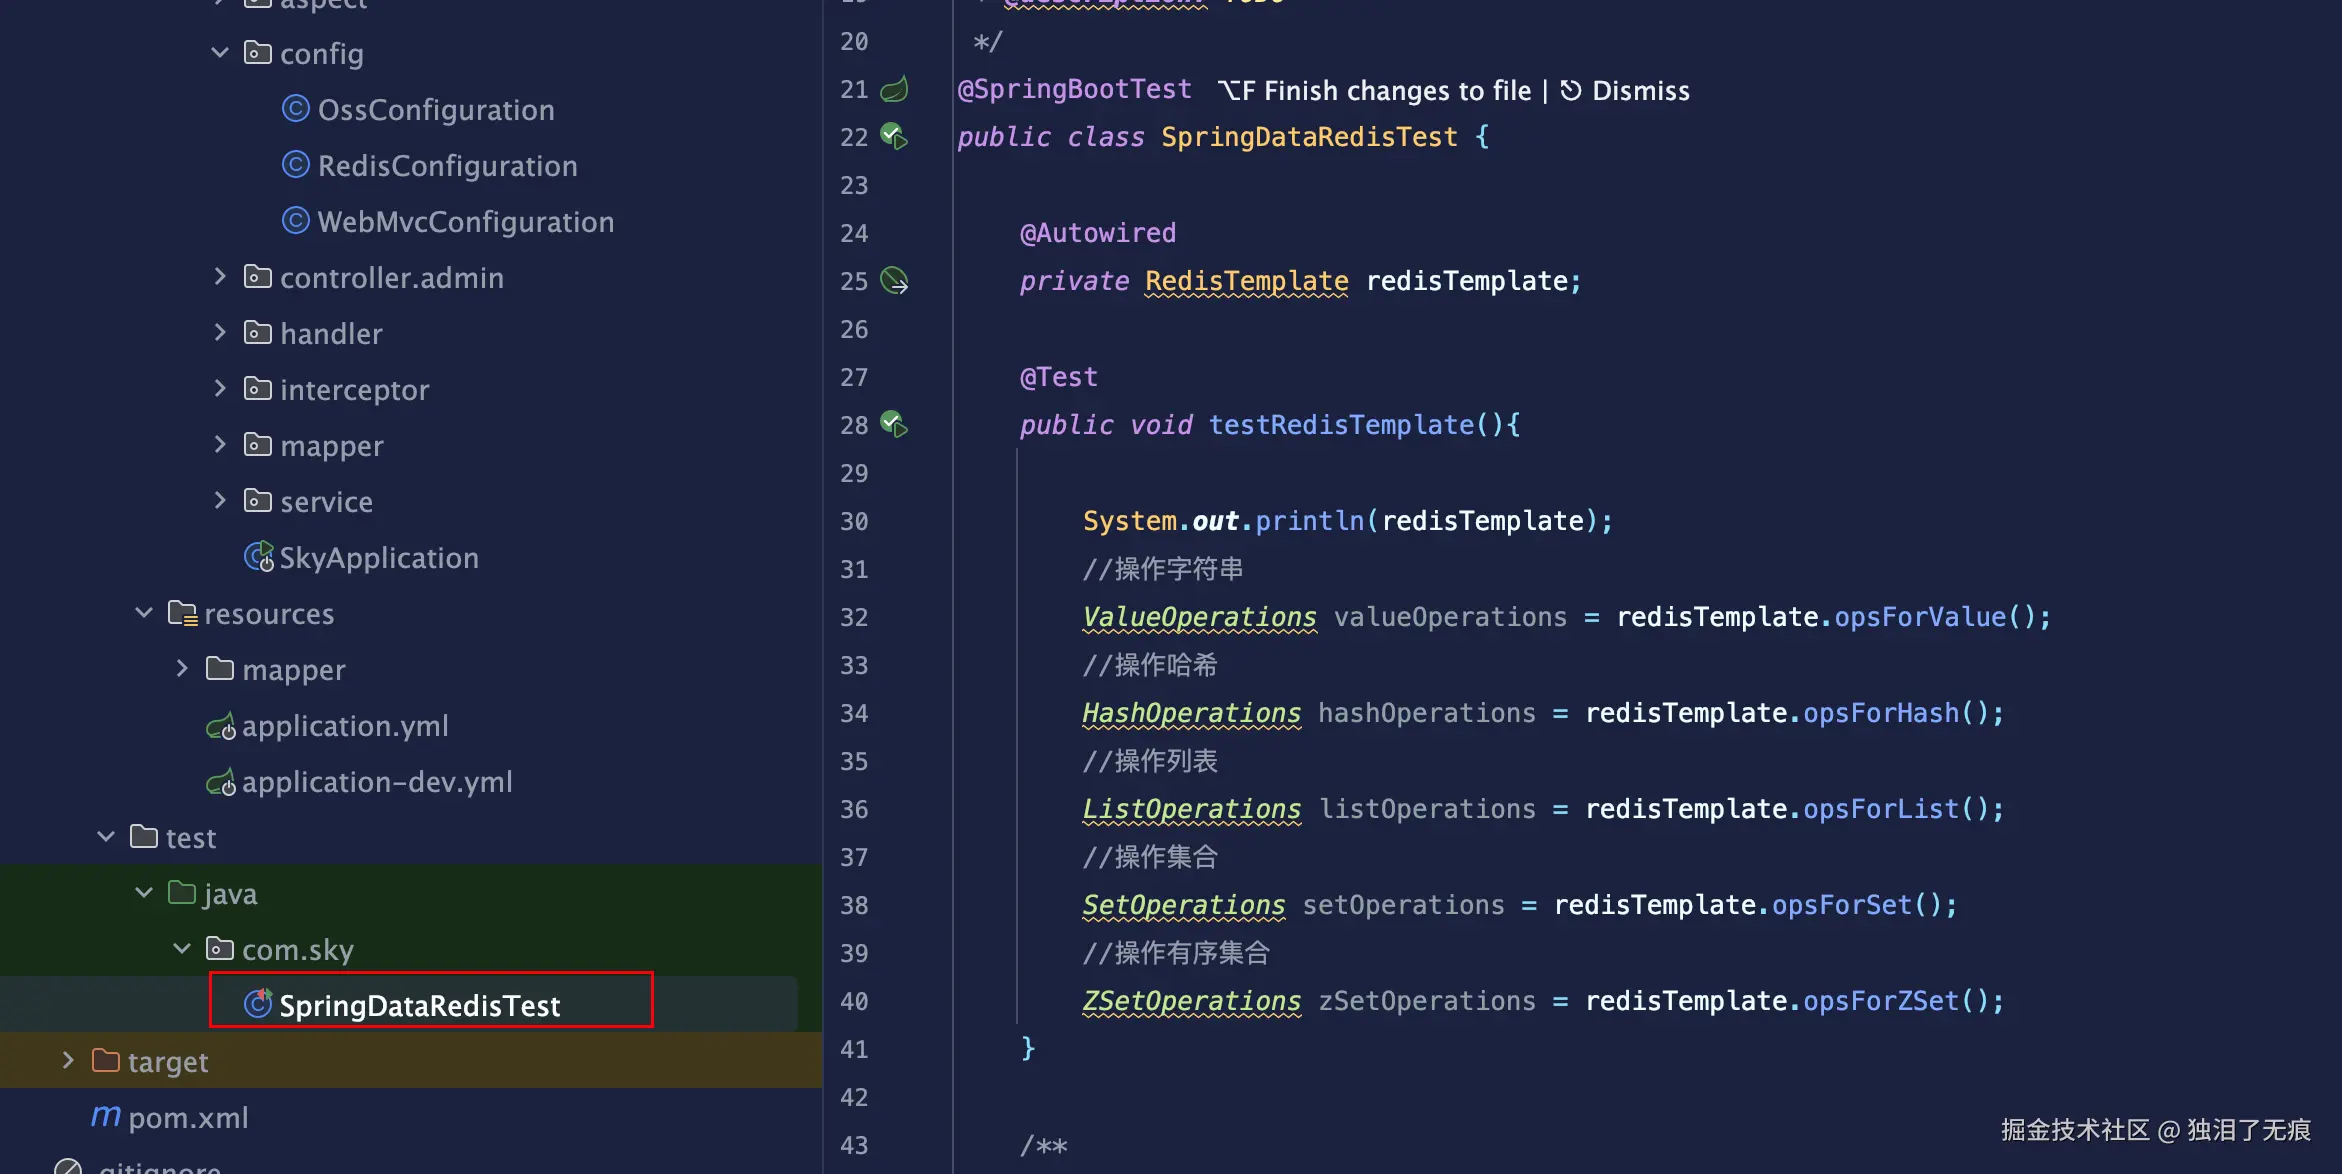
操作字符串(String):简单的"存"与"取"
String 是 Redis 中最简单的基本数据类型,也是使用频率最高的类型,可以存储任何数据,比如计数器、验证码、简单缓存。RedisTemplate 通过的 opsForValue() 获取 ValueOperations 提供字符串操作。代码如下:
java
@Autowired
private RedisTemplate<String, Object> redisTemplate;

@Test
public void valueOperationsTest() {
    String key = "spring-data-redis";
    ValueOperations<String, Object> ops = redisTemplate.opsForValue();
    // 写入数据到 Redis
    ops.set(key, "Hi! Spring Data Redis");
    // 从 Redis 获取数据
    System.out.println(ops.get(key));
}
通过 StringRedisTemplate 类,我们进行了一次 Redis SET 指令的执行。关于 RedisTemplate 是什么,我们先卖个关子,下面再来介绍。我们先来执行下测试方法,执行完成后,我们在控制台查询,看看是否真的执行成功了。
操作哈希(Hash):对象存储的最优解
Hash 就像是 Java 里的 Map,适合存储对象、购物车、Session 这类需要单独修改字段的数据,而不需要每次都序列化整个对象。通过 RedisTemplate 的 opsForHash() 可以拿到 HashOperations 进行操作,比如存用户信息,不用把整个对象序列化成一个 value,而可以把每个字段作为 hash field:
java
@Autowired
private RedisTemplate<String, Object> redisTemplate;

@Test
public void hashOperationsTest() {
    String key = "user:100";
    HashOperations<String, String, Object> hashOps = redisTemplate.opsForHash();
    // 存入一个 User 的 ID 为 100,属性名是 name,值是 Tom
    hashOps.put(key, "name", "Tom");
    hashOps.put(key, "age", "20");

    Object name = hashOps.get(key, "name");
    System.out.println(name);


    // 取出所有 Key
    Set<String> keys = hashOps.keys(key);
    keys.stream().filter(Objects::nonNull).forEach(System.out::println);

    // 取出所有 Value
    List<Object> values = hashOps.values(key);
    values.stream().filter(Objects::nonNull).forEach(System.out::println);
}
Hash 最大的好处就是可以只更新某一个字段,不需要重新写入整个对象。比如用户年龄发生变化,直接 hashOps.put 覆盖 age 字段即可。对高频更新的对象缓存来说,Hash 比 String 存整段 JSON 更节省流量和操作时间。
操作列表(List):消息队列的雏形
List 类型适合做消息队列、最新消息列表这类场景,其有序、可重复,支持两端操作,尤其是左右压入和弹出操作非常直观。通过 RedisTemplate 的 opsForList() 可以拿到 ListOperations 进行操作:
java
@Autowired
private RedisTemplate<String, Object> redisTemplate;

@Test
public void listOperationsTest() {
    String key = "listKey";
    ListOperations<String, Object> listOps = redisTemplate.opsForList();

    // 从左侧插入
    Long pushResult = listOps.leftPush(queueKey, "task-1");

    // 从右侧弹出
    Object task = listOps.rightPop(queueKey);

    // 阻塞式弹出,超时 3 秒
    Object taskWithBlock = listOps.rightPop(queueKey, 3, TimeUnit.SECONDS);

    // 批量推入
    listOps.leftPushAll(key, "a", "b", "c");

    // 范围查询:0 到 -1 代表查询所有
    List<Object> range = listOps.range(key, 0, -1);
    System.out.println(range); // 输出: [c, b, a] (后进先出)
}
✅ 这里要提个醒:List 做消息队列只是轻量方案,消息不消费会一直堆积,没有消费者组的概念,也不能做消息回放。
操作去重集合(Set)
Set 类型适合存储不重复元素,支持交集、并集、差集等数学集合操作,比如用户标签、已读记录。通过 RedisTemplate 的 opsForSet() 可以拿到 SetOperations 进行操作:
java
@Autowired
private RedisTemplate<String, Object> redisTemplate;

@Test
public void setOperationsTest() {
    SetOperations<String, Object> setOps = redisTemplate.opsForSet();

    setOps.add("article:1001:tags", "java", "redis", "spring");
    Set<Object> tags = setOps.members("article:1001:tags");
    // 判断是否存在
    Boolean isMember = setOps.isMember("article:1001:tags", "java");
}
操作有序集合(ZSet):排行榜神器
有序集合(ZSet)在集合(Set)基础上增加了分数(score)概念,适合实现排行榜、签到积分这类需要排序的场景,它的每个元素带一个 score,Redis 会根据 score 自动排序。通过 RedisTemplate 的 opsForZSet() 可以拿到 ZSetOperations 进行操作:
java
@Autowired
private RedisTemplate<String, Object> redisTemplate;

@Test
public void zSetOperationsTest() {
    ZSetOperations<String, Object> zSetOps = redisTemplate.opsForZSet();
    zSetOps.add("rank", "player1", 100);
    System.out.println(zSetOps.score("rank", "player1"));

    // 给 player1 增加 10 分
    zSetOps.incrementScore("rank", "player1", 10);
    System.out.println(zSetOps.score("rank", "player1"));
}