💡 一句话总结:NeurIPS 2026 的 CoCHI 不微调、不加参数,先给模型的预测按「对错 × 置信」分四个象限,再用因果分析找出专门负责「自信地答错」的那几个注意力头,推理时直接关掉------只动 6~10 个头,五个基准上校准误差一致下降、精度不掉,校准产物只有 40 字节。
导语:那个置信度 95% 的错误答案
先问一个可能戳到你的问题:你有没有被大模型「自信地坑过」?
不是那种支支吾吾的错------是答案本身错了,但它给出的置信度高得吓人,语气笃定、条理清晰,甚至还会帮你「总结一下要点」。做医疗问答的同行看到这种输出会心里一紧:如果模型以 95% 的置信度推荐了一个错误的用药方案,下游系统是会照单全收的。
这个问题在学术圈有个专门的名字:过度自信错误 (overconfident errors)------预测错了,但模型给这个错误分配了很高的置信度。它直接摧毁的是 LLM 的校准(calibration,即模型的「自信程度」与「实际正确率」是否匹配):一个校准良好的模型,说 90% 把握的时候,答对的比例就应该接近 90%。
那现在的解法是什么?温度缩放(Temperature Scaling,TS------给输出 logits 除一个温度系数,把概率分布「调软」或「调锐」)以及一票变体。但它们有个共同的尴尬:全都在输出层打补丁,模型内部到底为什么自信地错,一个字都没解释。体温计不准就换个刻度,病因一点没查。
RMIT 的研究团队在 NeurIPS 2026 发表的这篇论文换了个问法:**模型内部到底是哪些组件在制造「自信的错误」?能不能直接对它们动手?**答案是:能,而且只需要关掉 8 个左右的注意力头。
想自己动手试?
- 📄 论文:arXiv 2610.34994
- 📊 数据集:MMLU / MedMCQA / OpenBookQA / MedQA-USMLE / SciQ(均为 HuggingFace 公开数据集)
这篇论文到底想解决什么问题?
先把痛点说透。LLM 的校准问题在输出层的表现是「概率分布太尖」------模型把几乎全部概率质量压在一个答案上。TS 这类方法做的事情,就是把分布重新抹平一点。
听起来挺合理,为什么不够用?
- 治标不治本:TS 只调整最终输出的「锐度」,但产生过度自信的计算过程原封不动。换个任务、换个领域,温度系数可能就失效了。
- 基线成绩单很难看:论文实验里,TS 和它的自适应版 ATS 只有边际改善,某些设置下反而把校准搞得更糟;学习型校准器 Thermometer 经常把 NLL(负对数似然,越低越好)推高;推理时干预 ITI 则方差很大,在 Mistral-7B 上甚至同时搞坏精度和校准。
- 没有解释力:就算调好了,你也说不出「模型为什么自信地错」------而机制层面的答案,恰恰是修复可靠性的钥匙。
于是这篇论文把「校准」从一个输出层统计问题,重新定义成一个机制问题 :过度自信不是分布的偶然形状,而是模型内部某几个组件系统性地在推动「错误 + 高置信」这个组合。顺着机制可解释性(mechanistic interpretability,研究模型内部计算电路的领域)近两年的进展------因果头门控、因果中介分析这些工具已经能定位「哪个头对某个行为负责」------作者问:能不能用这套工具找到「自信犯错」的元凶,然后直接干预?
一句话研究问题:找到驱动过度自信错误的内部注意力头,并在推理时把它们关掉,让校准变好且精度不掉。
它的思路是什么?
CoCHI(Class-oriented Causal Head Intervention,面向类别的因果头干预)的整条流水线分三步:先分类,再归因,最后关头。一步步看。
第一步:把预测分成四个象限
CoCHI 先拿少量样本(每类最多 10 个、每个数据集最多 40 个),按两个维度给模型的预测分类:答案对不对 × 置信度高不高(阈值 0.5)。
- ✅ correct_high:答对了,且自信------模型的舒适区
- 😟 correct_low:答对了,但不自信------「运气好但心虚」
- 🔥 wrong_high :答错了,还特别自信------这就是要抓的元凶行为
- 😑 wrong_low:答错了,也不自信------危害最小的一类
为什么要分类?因为混在一起归因会互相淹没:让模型「不自信」的头和让模型「自信犯错」的头是两拨人,搅成一锅粥就分不清了。把 wrong_high 单独拎出来当分析对象,是整个方法的第一块基石。
第二步:找出每个头对每类行为的「因果责任」
归因用的是因果头门控(CHG,Causal Head Gating------一种给每个注意力头装「音量旋钮」的技术)。给每个头的输出乘一个 0 到 1 之间的门控值,然后跑两个方向相反的优化:
- 稀疏偏好分支 :优化器被鼓励把尽量多的旋钮拧到 0。如果某个头被拧到 0 之后模型在该类样本上的损失暴涨,说明它「删不得」------这是必要分数(necessary score)。
- 保留偏好分支 :优化器被鼓励把旋钮都留着。如果某个头在这种宽松环境下依然保不住大门控值,说明它「留着也是害」------反向信息构成充分分数(sufficient score)。
两个分数一组合,每个头就领到了自己的角色卡:两个分数都过线的是促进头 (facilitating,对这类行为既必要又充分),只有充分分数过线的是干扰头(interfering),其余是无关头。整个过程模型参数完全冻结,只学这些旋钮,所以严格说这不是训练,是一次「透视扫描」。
第三步:并集掩码 + 推理时直接关头
这是设计上最巧妙的一处。掩码不是只从 wrong_high 里挑,而是两路合流:
- 从 wrong_high 类取促进头------这批头是「错误放大器」,专门把错误答案的置信度抬高;
- 从 correct_high 类取非促进头------这批头对正确预测毫无贡献,只会给置信度估计添噪声。
两个集合取并集,再按归因强度排序取前 k 个(实验里 k 取 6~10)。为什么不能只掩第一路?后面的消融实验会给出血淋淋的教训。
最后推理时怎么干预?简单到有点朴素:掩码里的头,输出直接乘 0。没有激活偏置、没有参数修改、没有输出层包装。校准阶段用到的类别信息只在构造掩码时出现一次,之后对所有输入统一生效------线上部署时既不需要标签,也不需要判断「这条输入属于哪一类」。
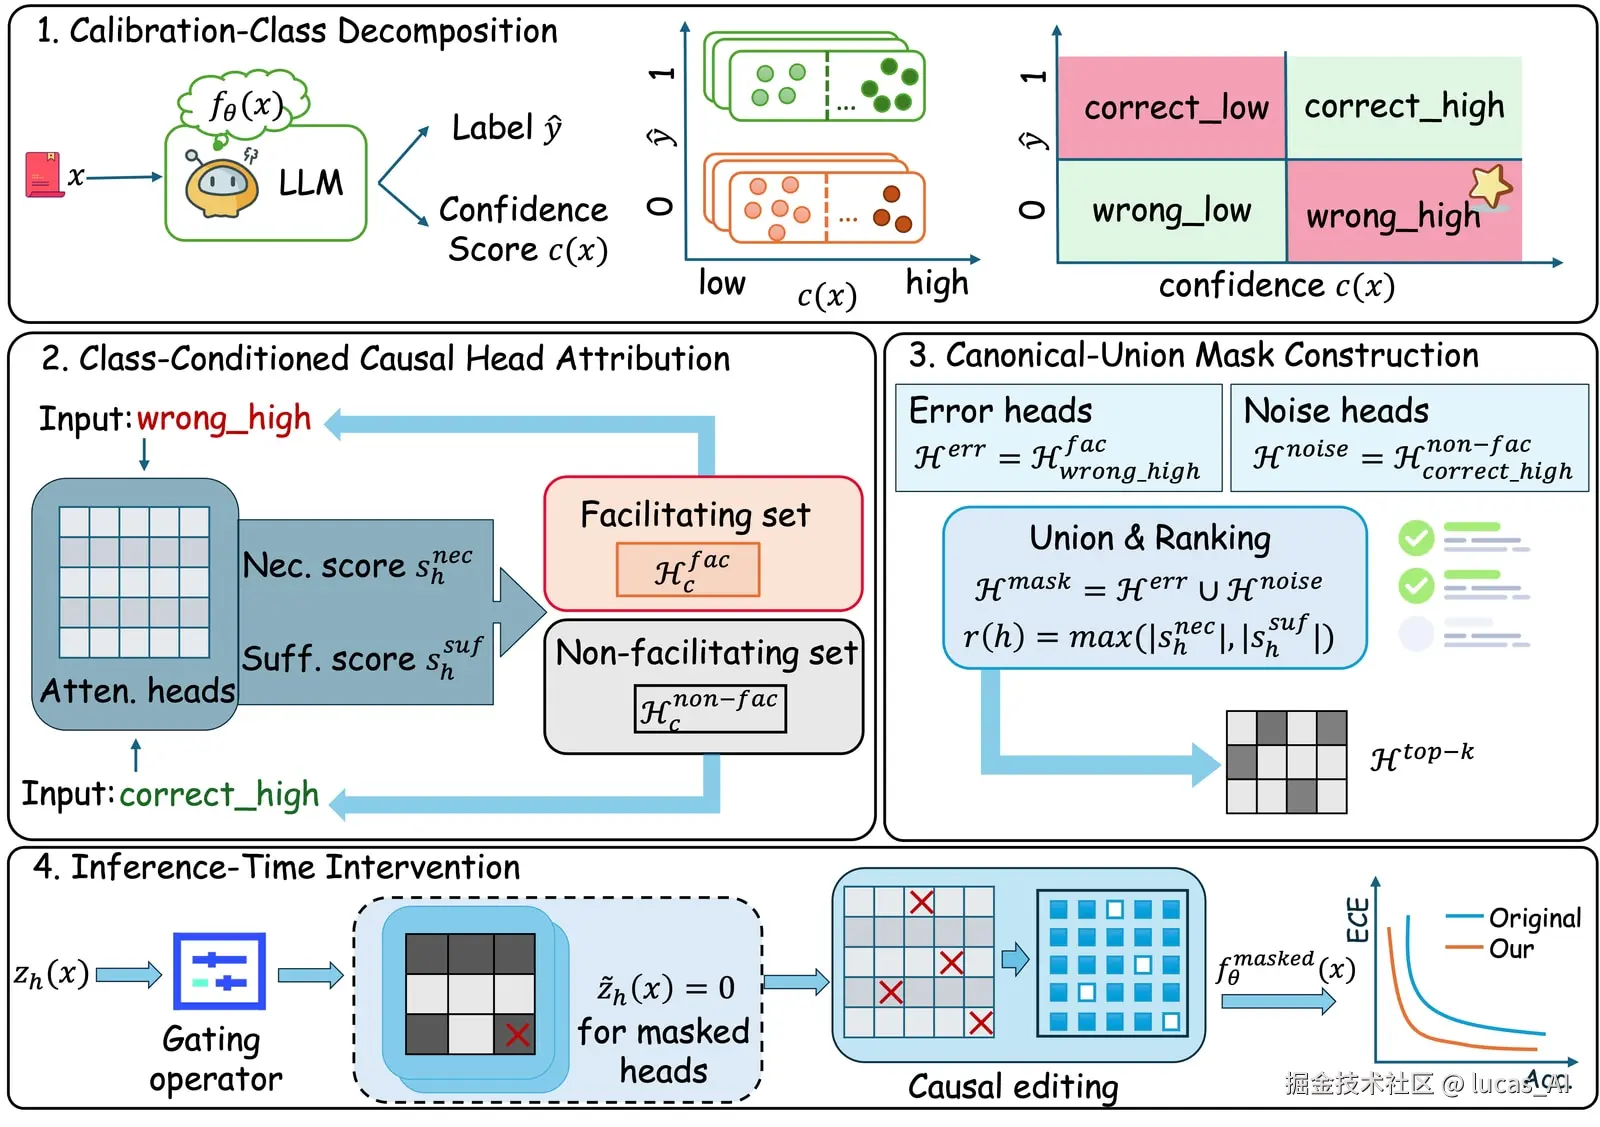
图说:CoCHI 全流程------预测先分成四个校准类别,类条件因果归因给每个头发「角色卡」,然后 wrong_high 的促进头与 correct_high 的非促进头取并集、按强度取 top-k 构成掩码,推理时把这些头的输出直接置零。
还有一个容易被忽略的工程亮点:可剪枝。因为干预就是「把这些头的输出归零」,你干脆可以把这几个头从模型里物理删掉,得到一个更小的、没有任何运行时包装的模型。相比之下,ITI 和 Thermometer 每次前向传播都要做额外计算,Thermometer 的校准产物最大能到 1 MB。
效果到底怎么样?
模型选了三个开源代表:LLaMA-3.1-8B、Gemma-2-9B、Mistral-7B-v0.1;数据集覆盖通用知识、科学、医学五个四选一基准(MMLU、MedMCQA、OpenBookQA、MedQA-USMLE、SciQ)。三个校准指标一起看:ECE(期望校准误差,越低越好)、NLL(负对数似然,越低越好)、Brier Score(概率预测的均方误差,越低越好)。
先看最说明问题的消融实验(MMLU 上)------同样都是「关掉几个头」,方式不同结果天差地别:
| 掩码策略 | Accuracy | ECE |
|---|---|---|
| 只掩 wrong_high 促进头 | 0.2044 | 0.4745 |
| 随机同规模掩码 | 0.2111 | 0.4330 |
| 掩 correct_high 干扰头 | 0.4267 | 0.0694 |
| CoCHI(并集 + top-k) | 0.6120 | 0.0490 |
这组数字最值得盯的是随机掩码那一行------它把「随便少几个头」这个替代解释彻底堵死了:随机关 8 个头,模型基本报废(精度 0.21、ECE 0.43);CoCHI 精挑细选的 8 个头,精度 0.61、ECE 0.049。校准改善来自因果归因找对了头,而不是「模型变笨了所以不自信了」这种偷梁换柱。顺便,「只掩错误放大器」的惨案(第一行)也解释了为什么要并上第二路:单侧下刀会连带破坏共享电路,得不偿失。
主实验的结论更全面:三个模型 × 五个数据集上,CoCHI 一致改善三项校准指标且精度不掉------在 LLaMA-3.1-8B 和 Mistral-7B 上精度甚至提升了。基线们则各有各的崩法:ATS 的 NLL 在多个模型上超过 1.0,Thermometer 推高 NLL,ITI 在 Mistral-7B 上精度校准双崩。
再看一张很有意思的分类别结果图:
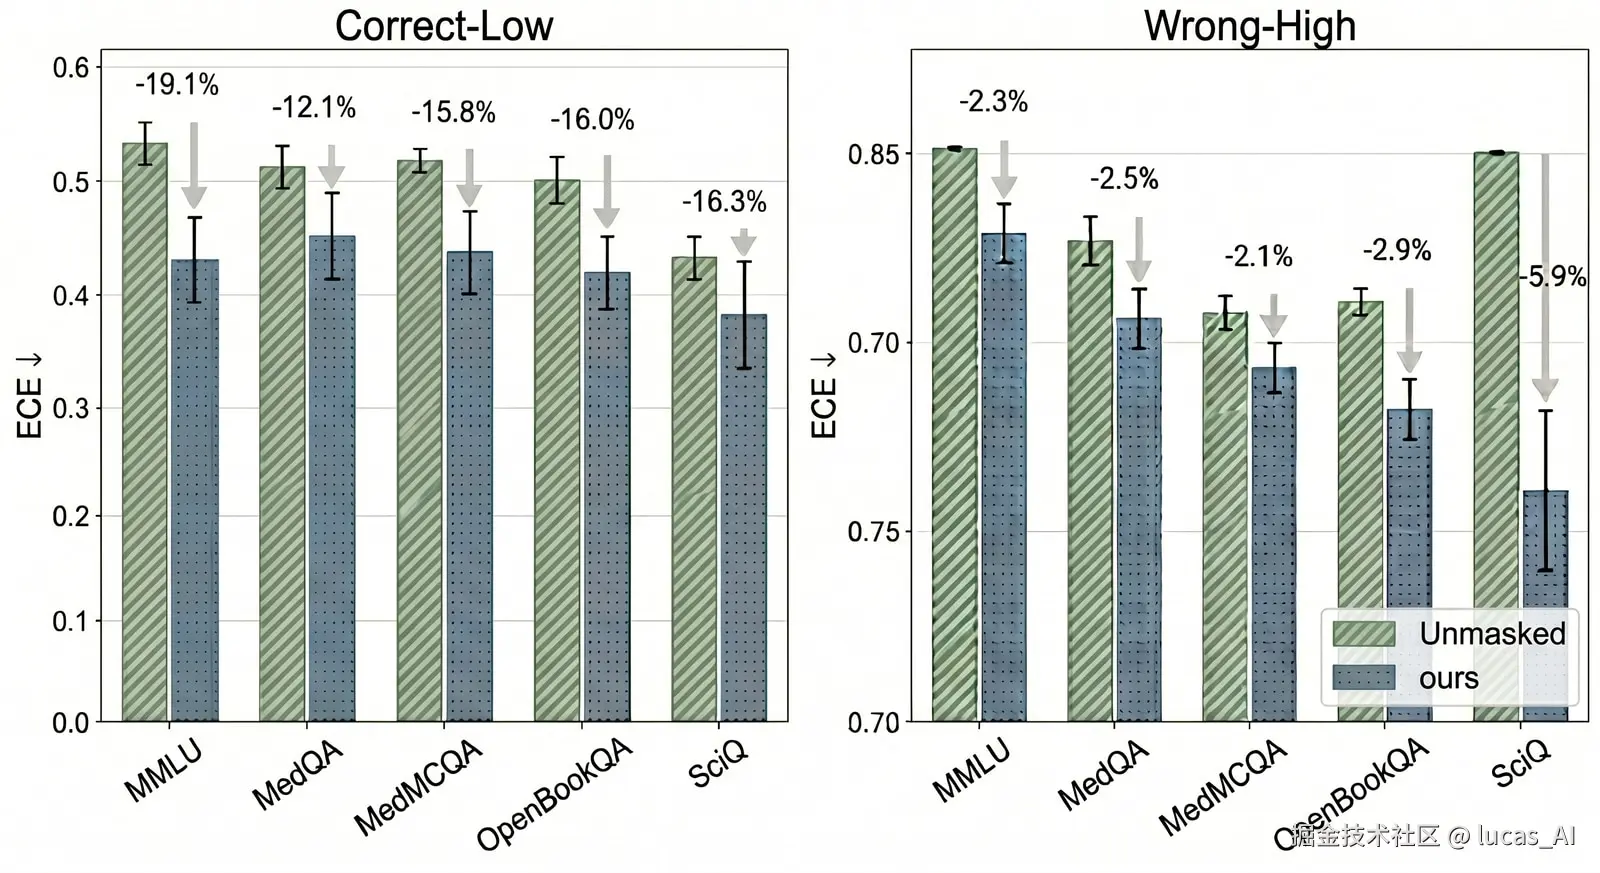
图说:五个数据集上「未掩模型 vs CoCHI」的分类别 ECE,左边是不自信但对(correct_low),右边是自信但错(wrong_high)。CoCHI 只针对 wrong_high 设计,但两边一起改善。
明明只针对「自信犯错」设计,结果「不自信但答对」的校准也跟着变好了(MMLU 上 ECE 降约 0.10,MedMCQA 降约 0.09)。我的读法是:这批被关掉的头干的其实是「给置信度注水」的活,关掉之后整个置信度系统都更老实了------当然,这是我的推测,论文只报告了现象。
最后是成本账:校准阶段一次性花 69.9 秒(40 个样本),产物是一个 40 字节的头名单,推理零开销。校准耗时随模型规模从 39 秒(Mistral-7B)到 88 秒(Gemma-2-9B),峰值显存 28~46 GiB,一张高端消费级卡就能跑。这个部署形态在同类方法里几乎没有对手。
为什么你要关心?
如果你是做大模型落地的人,这篇论文至少有三处和你直接相关:
- 🎯 高风险场景的可靠性抓手:医疗问答、法律咨询、金融决策这些场景,错误的危害不在「错」本身,而在「自信地错」。CoCHI 提供了一条不碰模型权重就能压过度自信的路径,合规审查和版本管理都好做------毕竟改动只是 8 个头的编号列表。
- 🧩 「机制补丁」可能是新的部署形态:40 字节的补丁 + 可剪枝性质,意味着你可以为不同业务场景准备不同的头名单,甚至把头物理删掉换显存。比起动辄几十 GB 的 LoRA 权重,这种补丁的分发和回滚成本几乎为零。
- 🔬 可解释性开始「修东西」了:过去机制可解释性常被调侃「只会发 paper 不会干活」,这篇给了个反例------先诊断(哪几个头在使坏)、后手术(关掉)、再复查(五基准验证)。如果你在做 agent 的行为修正(幻觉、谄媚、过度拒答),「按行为类别做条件化因果归因」这个套路值得直接抄。
理性看待
冷静几句。这个方法目前的全部证据都建立在四选一选择题上------固定答案空间里「正确性」和「置信度」都好定义,而开放生成、长程推理、多轮对话里这两样东西怎么定义都还是开放问题,方法能否迁移完全是未知数,论文自己在 Limitations 里也承认了。其次,干预粒度只在注意力头,MLP 层、残差流里的误校准来源它管不到。归因每类只用 10 个样本,top-k 头集合在采样扰动下稳不稳,论文没有给方差分析;代码也尚未开源,想复现得自己实现 CHG 双分支优化。乐观其成,但先别急着上生产。