摘要汇总
先说结论:100 亿条数据写 MySQL,逐条 INSERT 参考耗时约 231 天;把"攒批 + 并行 + 少刷盘"做透,用分片并行 +
LOAD DATA等组合可做到 3.5 小时以内------这是参考量级,随硬件、分片、数据格式和调参浮动。
这不是一篇只背八股的面试答案,而是一份能落地的工程手册:从面试官问"100 亿条怎么快速插入 MySQL"切入,先反问边界、再算 B+ 树的账------按 1KB 行、8B 主键、16KB 数据页估算"单表 2000 万"这句经验的出处;然后按 一算、二拆、三批量、四调参、五并发、六收尾 走完整链路:分库分表、真批量、LOAD DATA INFILE、MyISAM 中转(仅离线可重跑)、导入期调参及恢复、分片并行、幂等断点续传、对账校验、影子表不停服切换。
这篇文章你会带走什么?
✅ 面试标准答案:一算、二拆、三批量、四调参、五并发、六收尾,30 秒口述模板文末直接背。
🔥 最容易踩的坑 :addBatch() ≠ 真批量,连接串不加 rewriteBatchedStatements=true,网络往返一次没少。
✅ B+ 树硬账:16KB 页怎么算出"三层约 2190 万行、四层约 256 亿行"(按 1KB 行/8B 主键估算,理论容量不等于单表可承载)。
✅ 段位对照表 :逐条 INSERT 约 231 天、JDBC Batch 2.4 ~ 6 天、LOAD DATA 5.5 ~ 28 小时、分片并行 3.5 小时以内(参考量级)。
🔥 保命细节 :导入期参数改完必须恢复;幂等键、水位表断点续传、影子表 RENAME 切流量;关 binlog/降持久性仅限可重跑离线场景,且需 DBA 同意。
✅ 架构师冷水:如果这 100 亿是冷数据、日志、时序数据,它可能压根不该进 MySQL。
适合谁看? 正在准备面试的后端同学、被大表导入折磨的工程师、要做历史数据回灌的团队,以及想从"会写 SQL"往"会做架构取舍"进阶的人。
阅读姿势: 建议先收藏,再顺着六步口诀读;代码、参数表、对账清单可以直接抄作业。文末有面试加分项/减分项 和30 秒口述模板。也欢迎评论区聊聊:你一次性导入过最大的数据量是多少?踩过最离谱的坑是什么?
👍 如果这篇对你有帮助,点个赞、点个在看,转发给那个还在 for 循环里逐条 insert 的同事。关注我,下一篇继续讲《千亿级数据如何平滑分库分表迁移不停服》。
100 亿条数据如何快速写入 MySQL?从 231 天到 3.5 小时,我把面试官问懵了
前阵子有朋友面试被问懵了:100 亿条数据,怎么快速插入 MySQL?他答了句"多线程加批量插入",面试官就没再追问。后来我们一算账:100 亿条、每条按 500 字节算就是 4.5TB,逐条插入要干 231 天。今天我把从 231 天压缩到 3.5 小时的完整链路讲透,既是工程落地手册,也是面试场景题的标准答案。
一、别急着写代码:先反问,再算账
实际开发中我们经常会遇到这种"听着吓人"的需求------比如用户行为日志每天 2.7 亿条,按 3 年保留期一算,正好就是 100 亿级。遇到这种题,最忌讳的是张口就 for 循环。老手的第一反应永远是两件事:反问边界、量化规模。
1.1 六个决定方案走向的反问
| 反问 | 它决定了什么 |
|---|---|
| 数据现在存在哪里?HDFS / Kafka / CSV 文件 / 上游库 | 走 LOAD DATA INFILE 还是 JDBC 攒批 |
| 一次性历史导入,还是持续增量写入 | 一次性 → 文件批导;持续 → Kafka 削峰 + 批量消费 |
| 单条数据多大?结构化还是原始日志 | 容量评估与解析成本 |
| 导入期间要不要对外查询?QPS 多少 | 索引策略、分区策略;冷数据干脆别放 MySQL |
| 允许多长的停机窗口?能接受丢多少数据 | 敢不敢关 binlog、改刷盘策略 |
| 有没有去重 / 幂等要求 | 幂等键怎么设计 |
面试金句:面试官问"100 亿",考的第一件事就是你有没有"先澄清、再回答"的习惯,而不是张口就写 insert。前提不同,答案能差出十倍性能。
1.2 算一笔账:100 亿到底是多大
| 指标 | 估算 |
|---|---|
| 数据行数 | 100 亿(10^10) |
| 单行大小 | 200B ~ 1KB |
| 原始数据量 | 2TB ~ 10TB(按 500B 算约 4.55TB) |
| 建索引后落盘 | 再乘 1.5 ~ 2 倍,最高 15TB+ |
| 单机 MySQL 批量写入极限 | 约 1 万 ~ 5 万行/秒 |
再把各种写法的耗时拉出来看一眼,该选哪条路一目了然:
| 段位 | 写入方式 | 参考速度 | 100 亿耗时 |
|---|---|---|---|
| 青铜 | 逐条 INSERT + 自动提交 | 500 ~ 1000 行/秒 | 115 ~ 231 天 |
| 白银 | JDBC Batch + 手动事务 | 2 万 ~ 5 万行/秒 | 2.4 ~ 6 天 |
| 黄金 | MyBatis BatchExecutor | 8 万行/秒左右 | 约 1.5 天 |
| 铂金 | LOAD DATA INFILE |
10 万 ~ 50 万行/秒 | 5.5 ~ 28 小时 |
| 钻石 | MyISAM 导入再转 InnoDB | 80 万行/秒左右 | 约 3.5 小时 |
| 王者 | 分库分表 + 多机并行 + LOAD DATA | 100 万 ~ 200 万行/秒 | 3.5 小时以内 |
(速度为普通 SSD 上的参考量级,随硬件和配置浮动,但量级关系是稳的。)
1.3 为什么单表装不下:把 B+ 树的账算给你看
"单表别超过 2000 万"这句经验大家都背过,但它的科学来源很多人说不清。InnoDB 的索引是 B+ 树,数据全挂在聚簇索引的叶子节点上,一个数据页默认 16KB:
| 层级 | 计算过程 | 结果 |
|---|---|---|
| 叶子节点 | 16KB ÷ 单行 1KB | 每页约存 16 行 |
| 非叶子节点 | 16384 ÷ (主键 8B + 指针 6B) | 每节点约指向 1170 个下层节点 |
| 三层 B+ 树 | 1170 × 1170 × 16 | 约 2190 万行 |
| 四层 B+ 树 | 1170³ × 16 | 约 256 亿行 |
结论很清楚:三层 B+ 树大约能撑 2000 万行,这就是那句经验的出处;超过之后树高变四层,每次查询多一次磁盘 IO,性能断崖式下跌。所以 100 亿条至少要拆成 500 ~ 2000 张千万级分表,或者 100 个分库。
技术亮点:面试时把这笔账算出来,比背十句结论都有说服力。"2000 万"不是玄学,是 16KB 的页算出来的。
规模算清楚了,接下来看看逐条插入到底慢在哪------瓶颈的位置,可能和你想的不一样。
二、找准瓶颈:一条 INSERT 的隐藏账单
很多人以为插入慢是"SQL 执行慢",其实每次单条 INSERT 都要付下面这五笔账:
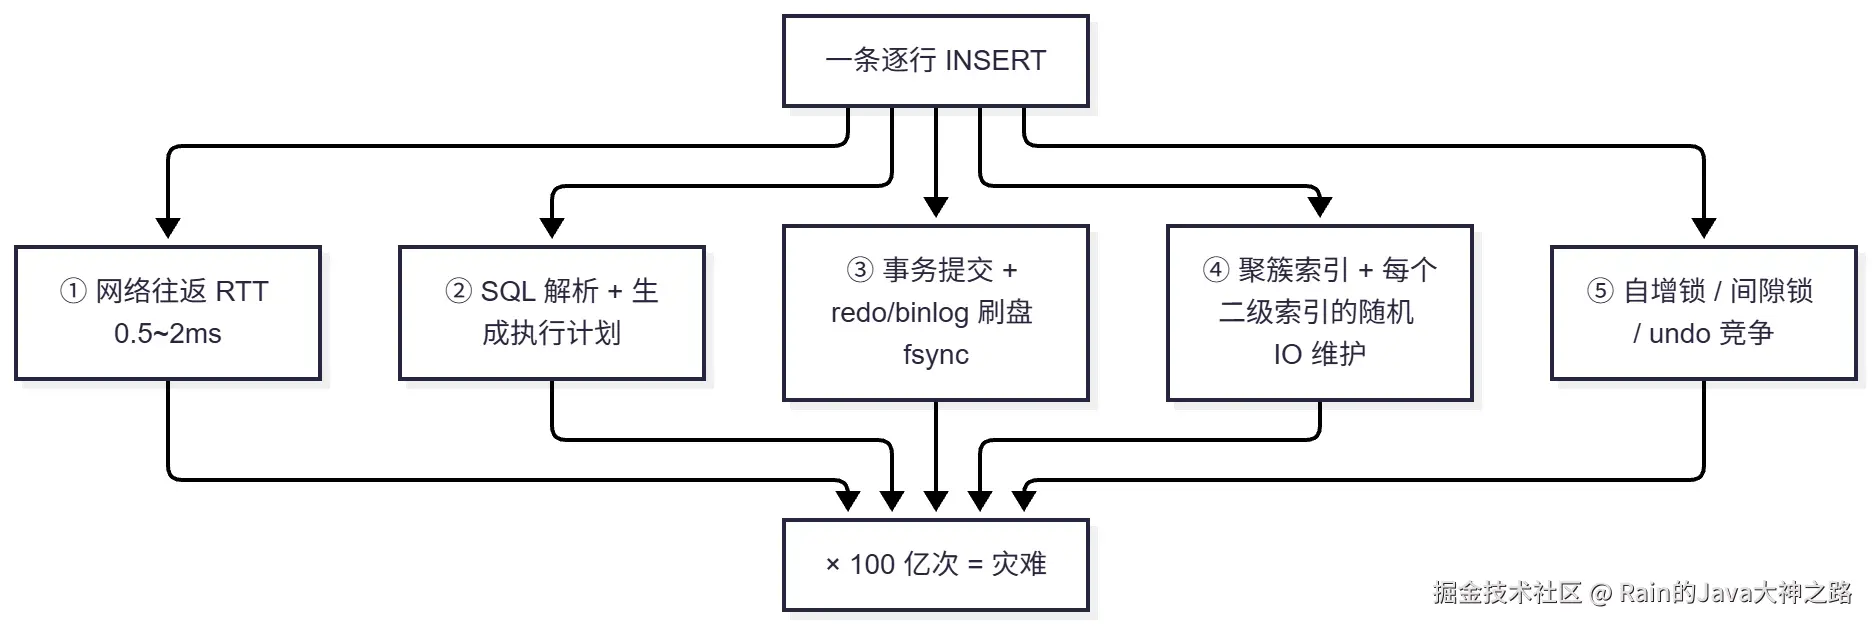
逐条插入时,每写一行就要一次网络往返、一次解析、一次 fsync 刷盘、一遍索引维护。磁盘 IOPS 就是天花板,100 亿次乘出来就是灾难。
所以所有优化的本质只有一句话:
快插的本质 = 攒批 + 并行 + 少刷盘。把"N 次"合并成"一次":一次网络往返、一次解析、一次刷盘、一次批量维护索引。
方向明确了,下面看整体路线图。
三、整体路线图:一算、二拆、三批量、四调参、五并发、六收尾
整条写入链路可以浓缩成六个动作,后面每一章展开讲一个:

再补一组小数据量下的实测参考(1000 万行,普通 SSD + InnoDB),让你对"批量化"的收益有个体感:
| 导入方式 | 1000 万行耗时 | 瓶颈说明 |
|---|---|---|
| 图形工具 / 逐行 INSERT | 1 小时以上,可能卡死 | 网络往返 + 逐条事务提交 |
| 逐行 INSERT 循环 | 2 ~ 3 小时 | 1000 万次 RTT 是最大杀手 |
| 多值 INSERT + 手动事务 | 20 ~ 30 分钟 | 解析次数降了,索引仍逐行维护 |
LOAD DATA INFILE |
10 ~ 20 分钟 | 服务端整文件灌入 |
并行 LOAD DATA(文件分片) |
5 ~ 10 分钟 | 多分片并发 + 顺序写,逼近磁盘上限 |
路线清楚了,从第一个动作"拆"开始。
四、拆:100 亿必须分库分表
4.1 拆多少片?
按刚才的 B+ 树账,单表控制在 500 万 ~ 1000 万行是 MySQL 的最优性能区间:
- 100 亿 ÷ 1000 万 = 1000 张表,常见布局是 100 库 × 10 表、16 库 × 64 表 = 1024 分片、8 库 × 64 表 = 512 张;
- 路由中间件选 ShardingSphere、Vitess、MyCat 都行,路由键用
user_id % 64这类高基数取模,或者按时间 + 业务维度切; - 分片的意义不只是装得下,更是把写入能力横向扩展 1000 倍------每个分片都是一个独立的并发单元。
4.2 分片键怎么选?怎么防倾斜?
分片键要满足三个条件:高基数、分布均匀、查询高频。最怕的就是数据倾斜------热门用户的数据全挤进一个分片,那个分片被打爆,其他分片闲着。
| 防倾斜方案 | 特点 | 适用 |
|---|---|---|
| 哈希取模 | 简单直接,扩容时要迁移 | 分片数固定的场景 |
| 一致性哈希 | 扩容只迁移少量数据 | 需要弹性扩容 |
| 预分片 + 动态路由 | 按哈希预分配,超阈值自动迁移 | 大厂常用 |
路由代码本身很简单,一个取模就够:
java
// 分片路由:user_id 这类高基数字段取模决定库和表
int dbIndex    = (int) ((userId / tablesPerDb) % dbCount);
int tableIndex = (int) (userId % tablesPerDb);
// 目标:db_{dbIndex}.t_order_{tableIndex}
4.3 别忘了冷热分离
拆完之后还要问一句:这 100 亿是不是都得是在线热数据?历史数据该归档就归档到 ClickHouse / Doris / HBase,MySQL 只留热数据,这一步能直接砍掉一大半分片压力。
拆好了,每个分片的容量天花板就定了。接下来解决"怎么写得快"。
五、批量:90% 的人都踩过"假批量"的坑
5.1 灵魂参数:rewriteBatchedStatements=true
这是我之前亲手踩过的坑:代码里写了 addBatch(),自我感觉已经是批量插入了,结果速度纹丝不动。查了抓包才发现,MySQL 驱动默认会把 batch 拆成一条条独立的 INSERT 发出去,只是省了点 Java 侧的开销,网络往返一次没少。
技术亮点:
rewriteBatchedStatements=true是 MySQL JDBC 批量的灵魂参数。开启后驱动才会把 N 条 insert 重写成INSERT INTO ... VALUES (...),(...),(...)多值插入,网络往返从 N 次变 1 次,RTT 开销直接砍 90%。不配这个参数,addBatch 就是"假批量"。
完整的连接串建议长这样:
java
String url = "jdbc:mysql://host:3306/order_db"
        + "?rewriteBatchedStatements=true"   // 把 batch 重写成多值 INSERT,灵魂参数
        + "&useServerPrepStmts=false"        // 服务端预编译与批量重写冲突,必须关
        + "&cachePrepStmts=true"             // 缓存预编译语句
        + "&allowLoadLocalInfile=true"       // 为 LOAD DATA LOCAL 铺路
        + "&useSSL=false&serverTimezone=Asia/Shanghai";
5.2 批量插入参考实现
java
private static final int BATCH_SIZE = 5000; // 2000~10000 之间的经验甜点区

public void batchInsert(List<Order> rows, DataSource ds) throws SQLException {
    String sql = "INSERT INTO t_order(id, user_id, amount, created_at) VALUES (?,?,?,?)";
    try (Connection conn = ds.getConnection()) {
        conn.setAutoCommit(false);                 // 关自动提交,否则每条一次 fsync
        try (PreparedStatement ps = conn.prepareStatement(sql)) { // 预编译 + 防注入
            int count = 0;
            for (Order o : rows) {
                ps.setLong(1, o.id);
                ps.setLong(2, o.userId);
                ps.setBigDecimal(3, o.amount);
                ps.setTimestamp(4, o.createdAt);
                ps.addBatch();
                if (++count % BATCH_SIZE == 0) {
                    ps.executeBatch();             // 真批量,一次网络往返
                    conn.commit();                 // 小步提交,防 undo 膨胀
                    ps.clearBatch();
                }
            }
            ps.executeBatch();                     // 尾批别丢
            conn.commit();
        } catch (SQLException e) {
            conn.rollback();
            throw e;                               // 失败整体回滚,交给上层重试
        }
    }
}
如果数据在内存里就是分好组的,也可以用 Lists.partition(dataList, BATCH_SIZE) 切块后丢线程池,用 CountDownLatch 或 CompletableFuture.allOf() 等全部完成,思路一样。
5.3 事务别太大,也别太小
这里有两个反面教材,我都见过真实事故:
- 事务太大:有人把上亿行塞进一个事务,undo log 膨胀到 OOM,失败回滚滚了几个小时,主从延迟飙到 8 小时;
- 事务太小:一条一提交,每次都 fsync,磁盘 IOPS 直接打满。
正确姿势:每 2000 ~ 10000 行提交一次。 单批也别盲目调大,受
max_allowed_packet(默认 4MB/64MB)限制,超了直接报Packet for query is too large。
5.4 MyBatis 用户:记得开 ExecutorType.BATCH
用 MyBatis 的话,默认的 SqlSession 还是逐条发,要显式开 BATCH 模式,并且定期 flush,别攒到最后:
java
SqlSession session = sqlSessionFactory.openSession(ExecutorType.BATCH);
try {
    LogMapper mapper = session.getMapper(LogMapper.class);
    for (int i = 0; i < list.size(); i++) {
        mapper.insert(list.get(i));
        if (i % 5000 == 0) {
            session.flushStatements();   // 定期刷盘,防内存堆积
        }
    }
    session.commit();
} finally {
    session.close();
}
批量把开销摊薄了一个数量级,但还有更狠的招------干脆绕过 SQL 解析。
六、裸写:LOAD DATA INFILE,导入的涡轮增压
6.1 为什么它能快一个数量级?
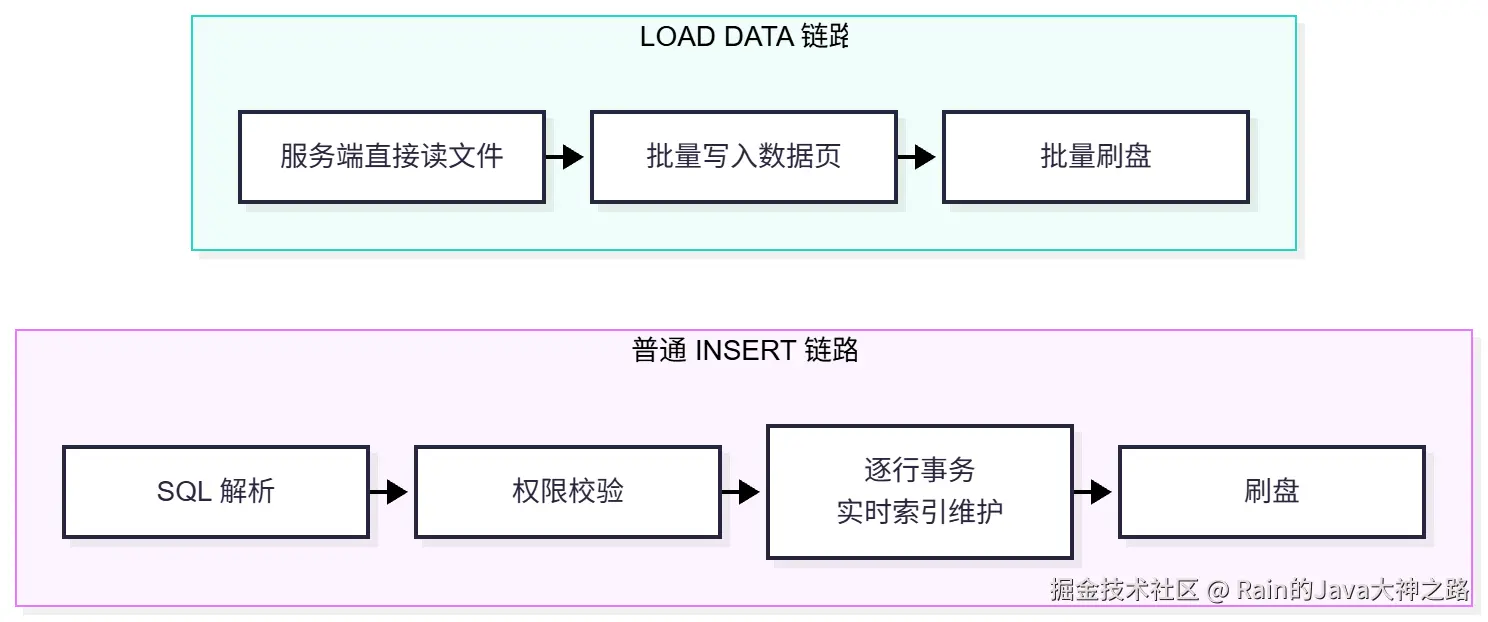
LOAD DATA INFILE 由 MySQL 服务端直接读文件、批量写入存储引擎 ,跳过了 SQL 解析、优化器、权限校验和逐行事务,几乎是"裸数据灌入",通常比批量 INSERT 再快 3 ~ 5 倍,比逐条快 10 ~ 50 倍。如果数据已经落地为文件(TB 级离线导入),它就是首选。
6.2 可直接抄的完整代码
sql
-- 导入会话先打开加速开关(导完记得恢复)
SET SESSION unique_checks       = 0;   -- 关唯一性校验
SET SESSION foreign_key_checks  = 0;   -- 关外键校验
SET SESSION sql_log_bin         = 0;   -- 从库不需同步时关 binlog,慎用!

LOAD DATA LOCAL INFILE '/data/shards/part_0001.csv'
INTO TABLE t_order
CHARACTER SET utf8mb4
FIELDS TERMINATED BY ',' OPTIONALLY ENCLOSED BY '"'
LINES TERMINATED BY '\n'
IGNORE 1 LINES                                  -- 跳过表头
(id, @user_id, @amount, @created_at)            -- 原始列先读进变量
SET amount     = NULLIF(@amount, ''),           -- 空串转 NULL,避免 NOT NULL 报错
    created_at = STR_TO_DATE(@created_at, '%Y-%m-%d %H:%i:%s');
    -- 时间戳字段也可以用 FROM_UNIXTIME(@ts),边导入边转换,省一遍清洗
如果源头是程序,CSV 要流式生成,100 亿条千万别在内存里攒:
java
try (BufferedWriter w = Files.newBufferedWriter(
        Paths.get("/data/act_" + shard + ".csv"), UTF_8, CREATE, APPEND)) {
    for (Row r : sortedRows) {          // 按主键升序写,顺序 IO
        w.write(r.id + "\t" + r.uid + "\t" + r.act + "\t" + r.ts + "\n");
    }
}
// 每个分片一个文件,多线程并行 LOAD
6.3 三个前置条件,全是坑
- 文件位置 :服务端本地文件要落在
secure_file_priv目录内;用LOCAL版本则要服务端SET GLOBAL local_infile = 1,驱动侧加allowLoadLocalInfile=true,两边都开才生效; - 格式对齐 :分隔符、换行符、编码必须严格对齐。我之前同事就踩过------CSV 里混进了一个异常分隔符,整批数据卡在第一行不动,排查了半天。统一 UTF-8、
CHARACTER SET utf8mb4,能省掉中文乱码、时间变0000这一堆破事; - 前置关校验 :
unique_checks、foreign_key_checks关掉之前,先确认源数据是干净的,否则脏数据会直接混进去。
6.4 极限玩法:MyISAM 中转,导完再转 InnoDB
如果是可以重跑的纯离线场景,还有一招更激进的:先往 MyISAM 表里灌(无事务、写入快),灌完整体转 InnoDB:
sql
-- 1. 建 MyISAM 表
CREATE TABLE t_log_myisam (
    id BIGINT UNSIGNED AUTO_INCREMENT PRIMARY KEY,
    user_id INT NOT NULL,
    action VARCHAR(64),
    create_time DATETIME
) ENGINE=MyISAM DEFAULT CHARSET=utf8mb4;

-- 2. 裸写灌入(MyISAM 可配合 DISABLE KEYS / ENABLE KEYS 延迟维护非唯一索引)
LOAD DATA INFILE '/tmp/all_data.csv' INTO TABLE t_log_myisam
FIELDS TERMINATED BY ',' LINES TERMINATED BY '\n'
(user_id, action, create_time);

-- 3. 整体转 InnoDB,相当于一次有序重建
ALTER TABLE t_log_myisam ENGINE=InnoDB;这招能把单机吞吐再往上顶一截,但它牺牲了事务安全,只适合"导坏了可以重来"的离线场景,生产在线库还是老老实实 InnoDB。
写到这里,"怎么写得快"讲完了。接下来是"怎么不出事"------幂等、断点续传、不停服切换,这些才是真正体现工程功底的地方。觉得这篇对你有帮助的话,先点个赞收藏,我们接着往下讲。
七、调参:导入期临时超频(导完必须改回来)
7.1 参数速查表
ini
# my.cnf 导入期临时配置,导完恢复
innodb_buffer_pool_size        = 物理内存的60%~80%  # 让索引维护尽量在内存完成
innodb_flush_log_at_trx_commit = 2      # 每秒刷盘一次,不再每次提交都 fsync
sync_binlog                    = 0      # binlog 不主动刷盘
innodb_log_file_size           = 4G     # redo 大一点,减少 checkpoint 频率
innodb_log_buffer_size         = 128M
innodb_autoinc_lock_mode       = 2      # 交错模式,消除并发插入的自增锁等待
innodb_autoextend_increment    = 64     # 表空间扩容步长加大,减少频繁扩容
bulk_insert_buffer_size        = 512M   # 批量插入缓冲
max_allowed_packet             = 256M   # 支撑更大的批量包
# innodb_doublewrite = 0                # 极限场景可临时关,有掉电风险,仅限可重跑
会话级再补三刀:
sql
SET autocommit = 0;
SET unique_checks = 0;        -- 关闭唯一性检查,省大量随机读
SET foreign_key_checks = 0;
7.2 这些参数到底拿什么换的
务必想清楚:这些参数本质是拿"崩溃可能丢 1 秒数据"的可靠性换吞吐,属于一次性离线场景的取舍。导入完成必须恢复双 1(
innodb_flush_log_at_trx_commit=1、sync_binlog=1),有主从的,导入期间最好跟 DBA 提前打招呼,必要时导完直接用备份重建从库。
把临时调优参数当成线上配置推荐,是面试里典型的减分项,实际工作中就是事故。
7.3 索引策略:先灌数据,后建索引
插入时维护二级索引是大量的随机 IO,页分裂严重;而导完之后统一建索引,是顺序扫描 + 排序,快一个数量级。所以标准流程是:
sql
-- 导入前:关校验、删二级索引
SET FOREIGN_KEY_CHECKS = 0;
SET UNIQUE_CHECKS = 0;
ALTER TABLE t_user DROP INDEX idx_name, DROP INDEX idx_age;

-- 导入完成后:在线重建索引、恢复校验
ALTER TABLE t_user
    ADD INDEX idx_name(name),
    ADD INDEX idx_age(age),
    ALGORITHM=INPLACE, LOCK=NONE;   -- 在线建索引,不锁表
SET FOREIGN_KEY_CHECKS = 1;
SET UNIQUE_CHECKS = 1;
技术亮点:建表时只留主键,导完再
ADD INDEX,比边插边维护索引快 30% 以上;ALGORITHM=INPLACE, LOCK=NONE保证重建索引时业务不受影响。如果是在线表做这类变更,还可以上 gh-ost / pt-online-schema-change。
7.4 地基:表结构与主键设计
这一层最容易被忽略,但影响全局:
- 主键必须有序 :
AUTO_INCREMENT或雪花 ID,保证聚簇索引顺序追加。禁用 UUID 做主键------随机写导致 B+ 树页分裂、大量随机 IO,吞吐直接砍半; - 导入前按主键排序:把随机写变成顺序写,B+ 树从"到处分裂"变成"向右追加";
- 字段类型最小化 :能用
INT不用BIGINT,能用DATETIME不用VARCHAR。行越小,一页装得越多,树越矮。
参数和结构都到位了,单机潜力基本榨干,最后一步靠并行把吞吐拉满。
八、并行:并发不是加线程那么简单
8.1 并行的正确姿势:落在分片维度
- 每个分片一个文件、一条连接、一个事务,相互隔离,天然无锁冲突,失败也只重跑该分片;
- 单表内部不要并发乱序写,会破坏顺序写、招来锁竞争,并发度应该落在"分库分表"这一层;
- 并发度不是越高越好,单机控制在 16 ~ 32 。为什么?连接数上去后,
innodb_thread_concurrency争抢加锁等待,吞吐会不升反降,甚至雪崩。HDD 场景磁头寻道开销大,并发度反而要收敛;SSD 可以适度放大。
8.2 带背压、重试、超时的分片并行代码
java
public void importAll(List<Path> shards) throws Exception {
    // 拒绝策略用 CallerRuns:队列满了让提交线程自己跑,天然背压,防 OOM
    ThreadPoolExecutor pool = new ThreadPoolExecutor(
            16, 16, 60, TimeUnit.SECONDS,
            new ArrayBlockingQueue<>(1024),
            new ThreadPoolExecutor.CallerRunsPolicy());

    List<Future<Long>> futures = new ArrayList<>();
    for (int i = 0; i < shards.size(); i++) {
        final Path file = shards.get(i);
        final int shardNo = i;   // 分片序号决定路由到哪库哪表
        futures.add(pool.submit(() -> importShardWithRetry(file, shardNo)));
    }

    long total = 0;
    for (Future<Long> f : futures) {
        try {
            total += f.get(30, TimeUnit.MINUTES);   // 超时控制,防单分片卡死拖垮全局
        } catch (TimeoutException e) {
            f.cancel(true);
            log.warn("分片导入超时,等待重试");
        }
    }
    pool.shutdown();
    log.info("导入完成,共 {} 条", total);
}

private long importShardWithRetry(Path file, int shardNo) {
    int retry = 3;
    while (true) {
        try {
            return loadDataInfile(file, shardNo);
        } catch (Exception e) {
            if (--retry <= 0) {   // 重试耗尽:降级逐条导入并记录脏数据
                log.error("分片 {} 重试失败,降级逐条导入", shardNo, e);
                return fallbackRowByRow(file, shardNo);
            }
            log.warn("分片 {} 重试中", shardNo);
        }
    }
}
如果想在途批次更精细地控制,可以加信号量背压:
java
Semaphore inFlight = new Semaphore(64);   // 控制在途批次,防止连接数爆炸
pool.submit(() -> {
    inFlight.acquire();
    try (Connection c = shardDs(shard).getConnection()) {
        bulkInsert(c, loadShardRows(shard));
    } finally {
        inFlight.release();
    }
});
大数据生态里同理,Spark 按分片键重分区后并行写,同一分片的数据连续,天然顺序写:
scala
df.repartition(2048, col("shard_id"))
  .foreachPartition { it =>
    val conn = DriverManager.getConnection(url, user, pwd)
    conn.setAutoCommit(false)
    val ps = conn.prepareStatement("insert into t_order values (?,?,?,?)")
    var n = 0
    it.foreach { row =>
      ps.setLong(1, row.getLong(0))
      ps.setLong(2, row.getLong(1))
      ps.setBigDecimal(3, row.getDecimal(2))
      ps.setTimestamp(4, row.getTimestamp(3))
      ps.addBatch()
      n += 1
      if (n % 5000 == 0) { ps.executeBatch(); conn.commit(); ps.clearBatch() }
    }
    ps.executeBatch(); conn.commit(); conn.close()
  }
8.3 三个保命细节
- 所有线程按主键升序写:既防页分裂,也防死锁。乱序并发写同一张表,死锁会让你批量回滚到怀疑人生;
- 防 OOM :流式读(分页 / 游标 /
ResultSet.TYPE_FORWARD_ONLY)+ 有界队列削峰。千万别SELECT *把 100 亿加载进 List,那是内存炸弹; - 别依赖数据库自增 ID:多机并行写入时,自增锁会把并发写串行化。ID 在应用侧预生成。
8.4 ID 生成方案对比
| 方案 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|
| 数据库自增 ID | 简单可靠 | 单点瓶颈 + 自增锁竞争 | 小量数据 |
| UUID | 全局唯一 | 无序 + 占空间,页分裂 | 别做主键 |
| 雪花算法 | 有序 + 高性能 | 时钟回拨问题 | 大厂主流 |
| 号段模式 | 高性能 + 可靠 | ID 不连续 | 美团 Leaf 等 |
雪花算法的核心逻辑(含时钟回拨防护):
java
public synchronized long nextId() {
    long timestamp = timeGen();
    if (timestamp < lastTimestamp) {
        throw new RuntimeException("时钟回拨,拒绝生成 ID");
    }
    if (timestamp == lastTimestamp) {
        sequence = (sequence + 1) & SEQUENCE_MASK;   // 同一毫秒内自增,每毫秒 4096 个
        if (sequence == 0) {
            timestamp = tilNextMillis(lastTimestamp); // 序列用完,等下一毫秒
        }
    } else {
        sequence = 0L;
    }
    lastTimestamp = timestamp;
    return ((timestamp - START_TIMESTAMP) << TIMESTAMP_SHIFT)
            | (datacenterId << DATACENTER_ID_SHIFT)
            | (workerId << WORKER_ID_SHIFT)
            | sequence;
}
写入快只是上半场,下半场是:导入到一半库挂了怎么办?导完了怎么证明一条没丢?
九、收尾:幂等、断点续传、对账与不停服切换
9.1 幂等:让重跑变得安全
重试必然带来重复写入的风险,所以每条数据要有幂等键(如 shard_id + biz_id 唯一),写入用幂等语句兜底:
sql
INSERT INTO t_order(id, user_id, amount) VALUES (?,?,?)
ON DUPLICATE KEY UPDATE amount = VALUES(amount);  -- 重跑安全
-- 或者 INSERT IGNORE:静默跳过重复,更快,但同样依赖唯一键
9.2 断点续传:只重跑失败的分片
100 亿导入跑几天很正常,中途宕机如果要从头再来,心态会崩。标准做法是分片任务落库记录水位:
sql
CREATE TABLE import_checkpoint (
    batch_id    VARCHAR(64) PRIMARY KEY,
    start_id    BIGINT,
    end_id      BIGINT,
    offset      BIGINT,        -- 该分片已导入的位点
    status      VARCHAR(20),   -- PENDING / RUNNING / DONE / FAILED
    import_time DATETIME
);
每个分片导入前查水位、跳过已完成批次,导入中定期 save(shard, offset)。宕机恢复后从位点继续,配合上面的幂等写入,可无限重试、可重入。
9.3 对账:数据对上了才算完
导完不等于导对。三件事必做:
- 总量比对 :源数据的
count/sum与 MySQL 各分片的count/sum逐一比对; - 抽样校验:按分片抽样比对字段完整性;
- 指纹校验:关键批次可以在导入前算 MD5 / checksum,导完复核。
9.4 影子表 + RENAME:不停服切换
如果导入期间线上业务不能停,用影子表方案做到业务无感:
sql
-- ① 影子表导入,先拆掉二级索引
CREATE TABLE t_log_shadow LIKE t_log;
ALTER TABLE t_log_shadow DROP INDEX idx_uid, DROP INDEX idx_ctime;

-- ② 并行 LOAD DATA 灌数据(略)

-- ③ 导完在线重建索引
ALTER TABLE t_log_shadow
    ADD INDEX idx_uid(uid),
    ADD INDEX idx_ctime(create_time),
    ALGORITHM=INPLACE, LOCK=NONE;

-- ④ 行数/抽样校验通过后,原子切换,秒级完成,失败随时回滚
RENAME TABLE t_log TO t_log_bak, t_log_shadow TO t_log;
9.5 主从延迟与在线业务保护
- 导入期间别读从库(会读到脏数据),导完直接用备份重建从库,或者用 GTID + 并行复制追延迟;
- 给导入任务加令牌桶限流,把 TPS 控制在从库可承受的范围内,预留数据库连接余量,避免把库打挂;
- 条件允许的话,用独立导入集群 + 夜间窗口,保护主库 IOPS;
- 如果要求"边导边查",用
PARTITION BY RANGE按时间分区,导入只影响最新分区,老分区做冷热分离,查询走分区裁剪。
十、全景图:两条完整链路与周边细节
10.1 一次性导入 vs 持续写入
前面讲的是离线一次性导入的链路。如果是持续写入场景,链路换成这样:

完整的数据平台视角则是:采集层(Flume / Logstash)→ 消息队列(Kafka)→ 计算层(Spark / Flink / DataX)→ MySQL 分片集群(ShardingSphere 路由)→ 数仓(ClickHouse / Doris)。离线历史回灌直接走文件批导更快,MQ 反而多一跳;流式数据才需要 MQ 削峰------场景决定方案。
10.2 硬件与操作系统层
容易被忽略,但都是真金白银的收益:
- 磁盘:SSD + RAID10;数据文件与日志文件分盘存放;
- 内存 :关闭 swap(
vm.swappiness = 0),防止缓冲池被换出; - IO 调度:SSD 用 noop / none 调度器;
- 网络:写入机器与数据库同机房部署,万兆网卡,连接池复用避免频繁建 TCP,批量打包减少往返。
10.3 先度量,再优化
怎么证明真的变快了?别靠感觉:
SHOW ENGINE INNODB STATUS的 LOG 段,看刷盘与 checkpoint 情况;Innodb_rows_inserted的每秒增量,直接反映写入速率;iostat的%util和await,看磁盘是不是已经打满。
十一、灵魂拷问:100 亿真的该放 MySQL 吗?
写到这儿必须泼一盆冷水:如果这 100 亿是冷数据归档、日志、时序数据,它可能压根不该进 MySQL。
| 场景 | 更合适的选择 |
|---|---|
| 在线交易、高并发 OLTP | MySQL 分库分表(本文方案) |
| 日志 / 时序分析 | ClickHouse、Doris |
| 海量 KV / 宽表 | HBase |
| 全文检索 | Elasticsearch |
| HTAP 混合负载 | TiDB |
| 离线数仓 | Hive + Parquet |
MySQL 的舒适区是分片后的热数据和在线事务。让合适的工具做合适的事,才是架构设计的核心。
技术亮点:面试时敢质疑题设------"100 亿如果只是分析查询,别硬塞 MySQL"------这反而是最大的加分项,体现的是架构师思维而不是背题能力。
十二、面试加餐:加分点、减分点与 30 秒模板
加分项:
- 先反问澄清------数据源、量级、实时性、去重,问清楚再答;
- 用 B+ 树算账------"2000 万"说得出原理,而不是背结论;
- 分层递进------从 SQL 写法 → 参数 → 架构,有层次不散乱;
- 有真实数字------"逐行 2 小时 vs 并行 7 分钟",比形容词有说服力;
- 提兜底与幂等------重试、降级、对账,体现工程素养;
- 主动点出取舍------关 binlog、降持久性是一次性离线场景,线上要改回来;
- 敢质疑前提------"100 亿不一定适合 MySQL"。
减分项:
- 上来就
for循环insert,或者只会一句"批量插入"; - 不知道
rewriteBatchedStatements,写了addBatch就自我感觉良好; - 不考虑分表,默认 100 亿塞一张表;
- 只谈速度,不谈一致性、幂等、可回滚;
- 把临时调优参数当成线上配置推荐。
30 秒口述模板(背下这六步口诀:一算、二拆、三批量、四调参、五并发、六收尾):
100 亿先算容量(约数 TB),单机单表不可能,所以分层来做:① 拆------分库分表 1000 片,单表压到千万级;② 批量------优先
LOAD DATA INFILE,退而求其次多值 INSERT + 手动事务,连接串必加rewriteBatchedStatements=true;③ 调参------关unique_checks、flush_log_at_trx_commit=2、调大 buffer pool,导完恢复;④ 并发------分片多线程、按主键顺序写、导入期不建二级索引;⑤ 收尾------建索引、对账校验、影子表切流量;⑥ 最后补一句:冷数据其实不该放 MySQL。
写在最后
整篇文章浓缩成一句话:把随机写变成顺序写,把单点变成并行,把逐条变成批量。
真正动手前,把这份落地清单过一遍:
- 算清容量,确认时间窗口,六个反问都有答案
- 分片方案确定,单表控制在千万行以内
- 连接串加上
rewriteBatchedStatements=true - 导入期参数已改,且明确了"谁来改回去"
- 幂等键 + 水位表设计完成
- 对账脚本(count / checksum / 抽样)就位
- 主从延迟预案已和 DBA 对齐
如果这篇对你有帮助,欢迎点赞、在看、转发给那个还在逐条 insert 的同事。关注我,下一篇讲《千亿级数据如何平滑分库分表迁移不停服》,是今天的续集。
最后留个互动问题:你一次性导入过最大的数据量是多少?花了多久?踩过最离谱的坑是什么? 评论区聊聊,互相抄个作业。