HunyuanVideo-1.5 跑得更快,先减步数还是开缓存?
一条 720p 首帧视频等太久,你可能想把采样从 50 步降到 20 步,再把 EasyCache 打开。第一帧看着没问题,速度也快了,就算找到最优配置了吗?第一帧受输入图约束,后半段动作和身份可能另有变化;两项开关同时动,也无法判断是谁节省了时间。
本文只面向已经能运行 HunyuanVideo-1.5 720p I2V 工作流 的读者。作者核查了官方模板与源码,没有本机生成视频、逐帧听审或特定显卡耗时数据。下文是一套待运行的生成实验,不是配置排行榜;新增本地已运行的记录检查只验证构造清单与算式边界。
官方模板给出的两个线索
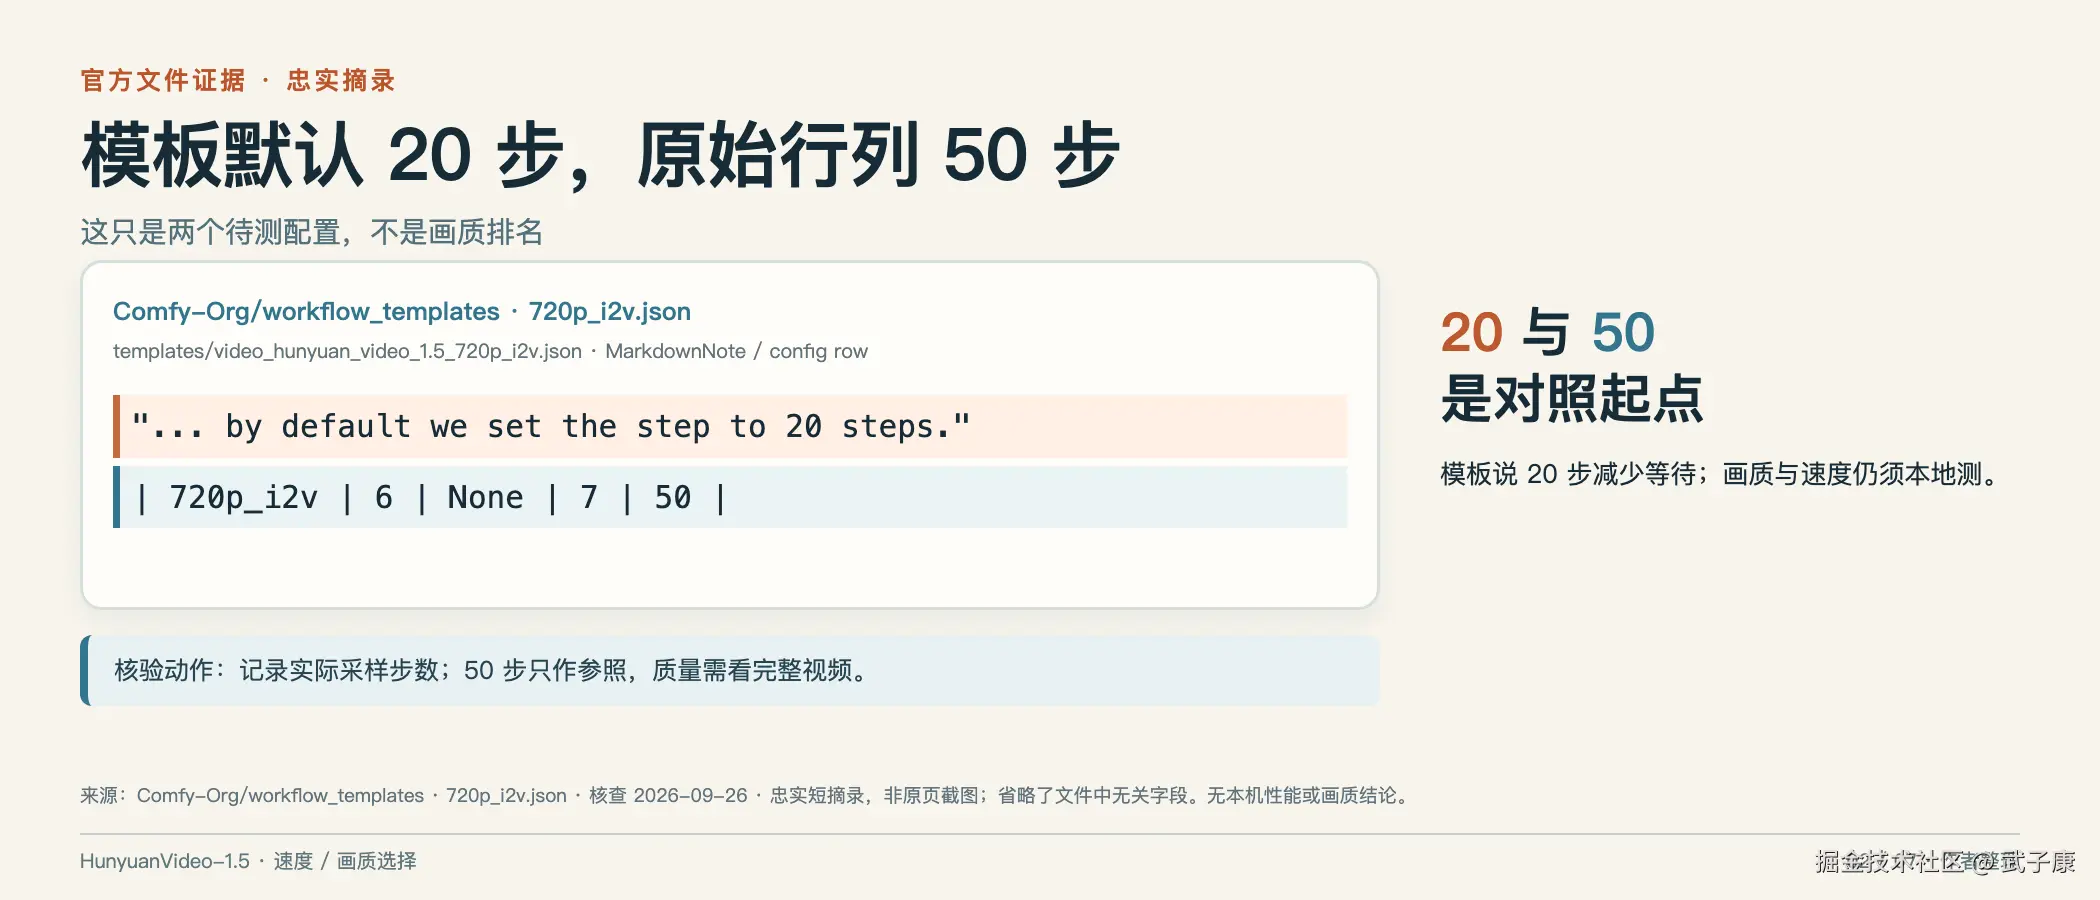
Comfy-Org 官方 720p I2V 模板的说明写道:为减少等待,模板默认把推理步数设为 20;同处列出的原始 720p I2V 配置为 50 步、CFG 6、shift 7。这说明模板提供了两个可测试的步数选择,不能证明 50 步对所有镜头更好,或 20 步在任何硬件上能快多少。不要把同一配置表里的 480p、T2V 或其他权重行混进本次比较。
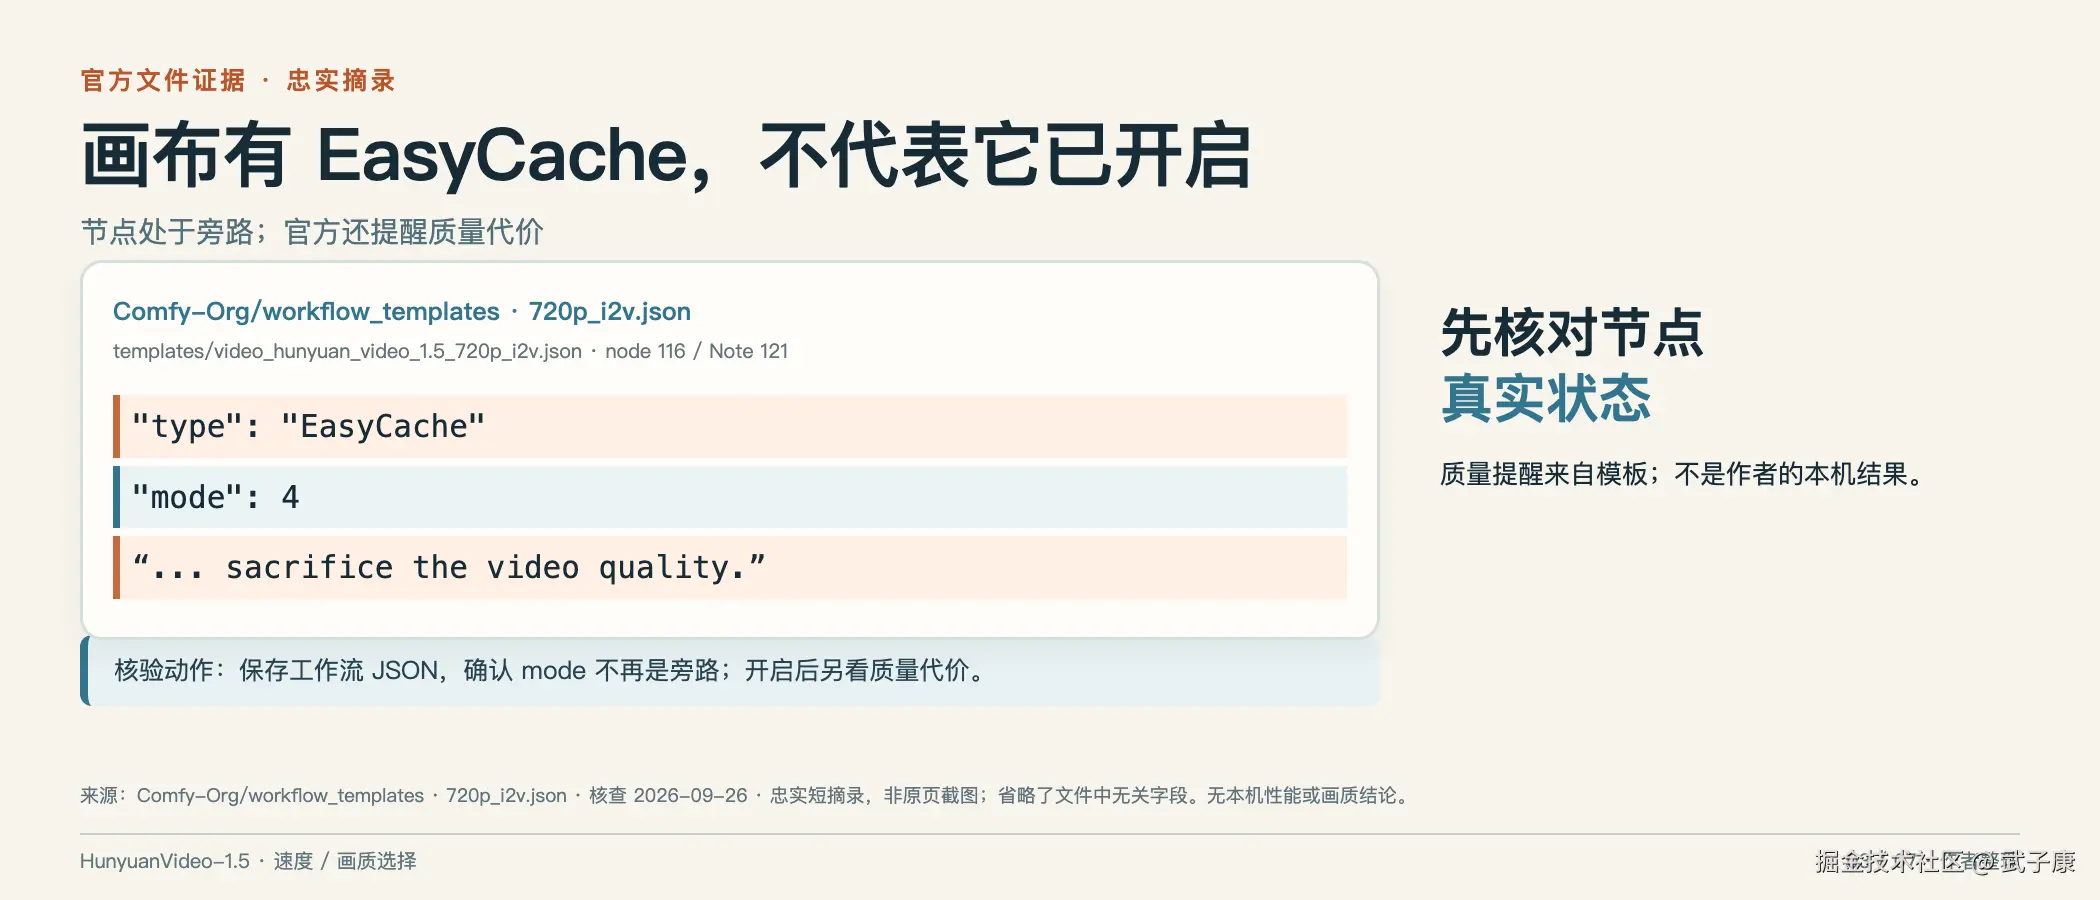
模板里还放着 EasyCache 节点,但节点 mode: 4,处于旁路状态。相邻说明提醒:启用可能加速,也会牺牲视频质量。画布上"有这个节点",不等于实验时已经开了缓存。实际运行前,要保存工作流 JSON 并核对节点模式。
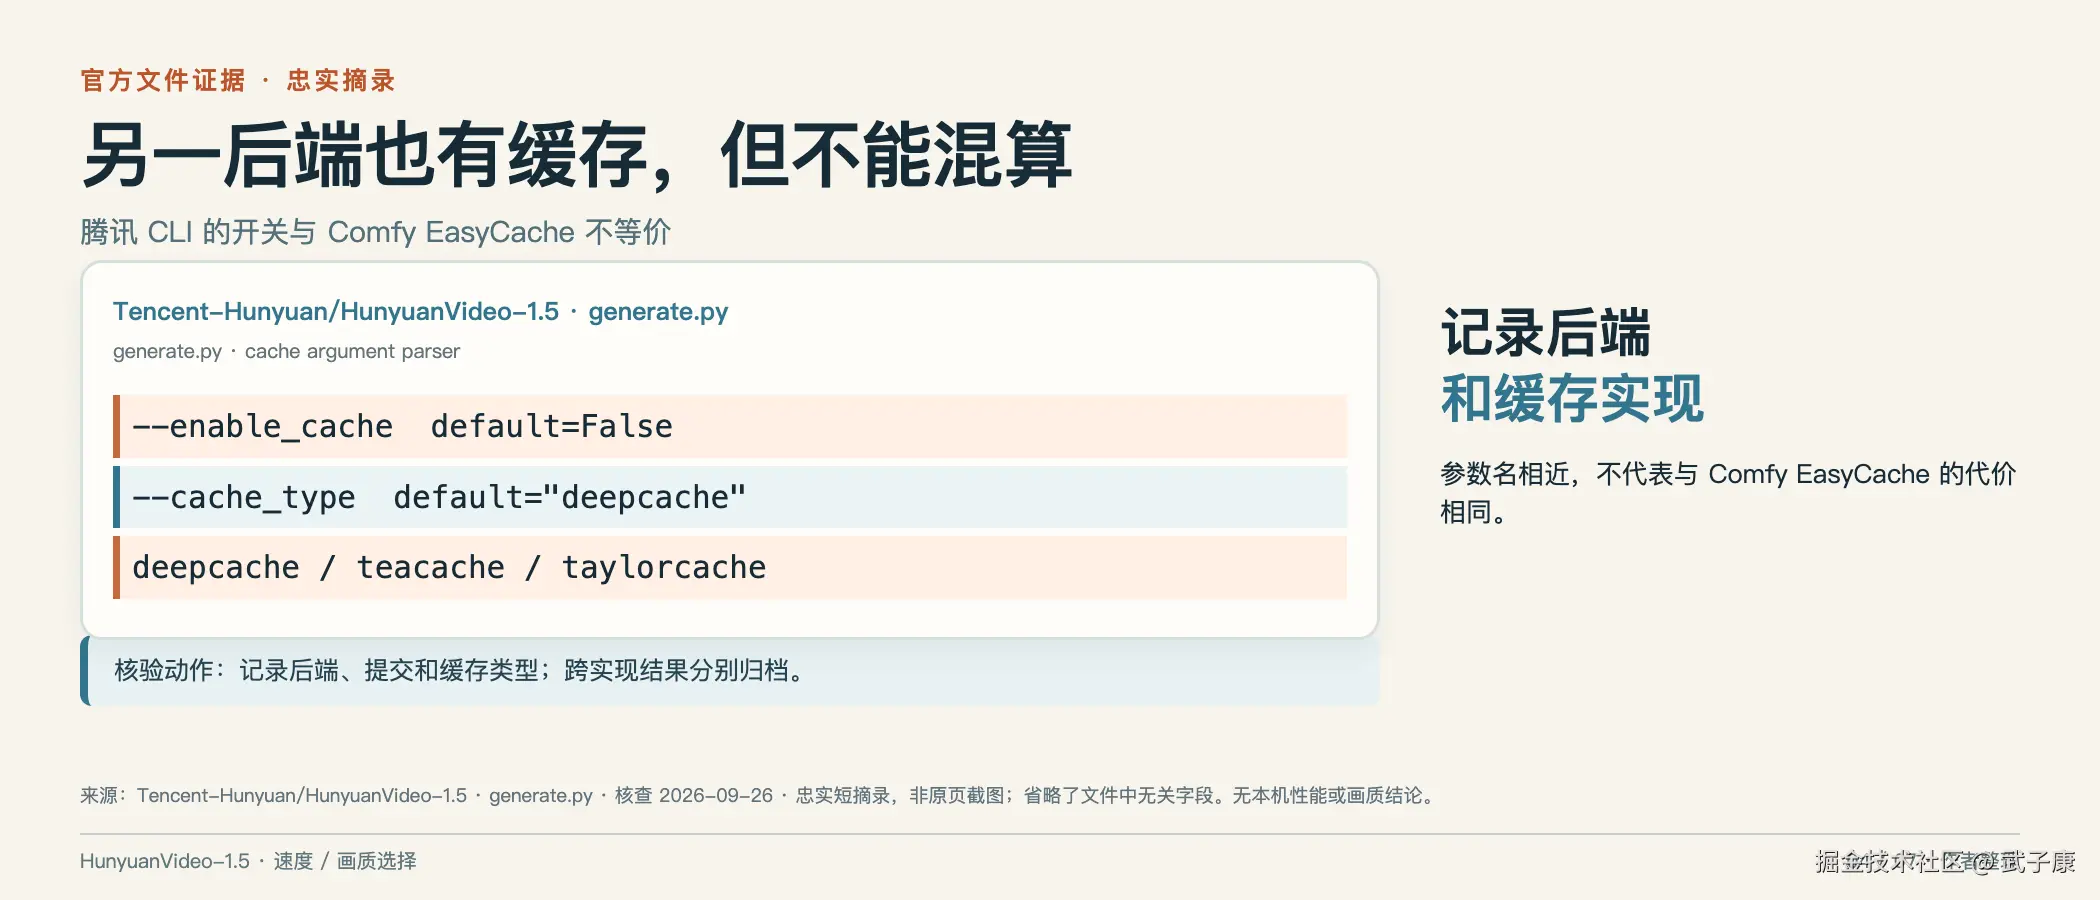
腾讯官方 generate.py另有缓存参数:--enable_cache 默认 False,--cache_type 默认 deepcache,帮助文案还列出 teacache、taylorcache。这是另一条实现路径的源码事实;不能把它们与 ComfyUI EasyCache 当成相同算法、阈值或画质代价,再直接合并成绩。初轮只选择能够完整复现的一条后端;CLI 缓存另建实验,减少同时追踪多种实现的成本。上述文件于 2026-09-26 核查;运行时还应记录实际文件提交与权重版本。
2026-10-13 复核时,上述三条来源事实仍存在。为避免 main 继续变动,本文另固定 Comfy 模板提交 cdccb2e与 腾讯 generate.py 提交 60783e7。当前模板主路 EasyCache 节点 105 和超分支路节点 116 都是 mode 4;主路 BasicScheduler 节点 126 为 20 步,CFGGuider 为 6,ModelSamplingSD3 为 shift 7。旧图仍是 9 月 26 日的忠实摘录,不表示完整工作流从未更新。不能把超分支路的步数或缓存节点,记成基础 720p 主路的执行参数。
同提交的腾讯 README明确提醒 CFG 蒸馏模型必须用 50 步;480p I2V 步数蒸馏又是不同权重路径,不能拿它的步数说明来支持本篇普通 720p I2V 的 20 步候选。generate.py 还拒绝同时启用 step-distill 和 cache。这些是特定文件的支持与参数限制,不是作者质量复测;运行前要从实际加载的权重身份确认讨论对象。
先确认节省的是哪种等待
用户觉得"太慢"时,可能指启动后很久才开始采样,也可能指采样结束后迟迟没有视频。步数与缓存主要围绕采样计算设计,不能从模板中的加速提醒推导整个工作流都等比例缩短。先拿当前路径的一次完整运行划出阶段,才能知道这两个开关是不是应该优先测试的对象。
可以做一个纯假设的时间分解:加载占 60 秒、采样占 120 秒、解码与保存占 60 秒,总共 240 秒。如果某种改动把采样降到 60 秒,总等待就变成 180 秒,而不是 120 秒。这里没有任何 Hunyuan 实测数字,只用简单算术说明收益取决于被优化阶段的占比。若原来采样只占少数时间,就更应该先看加载、卸载传输或输出处理。
画布节点状态也需要进入证据。节点存在、被连接、处于可执行模式,以及本次运行确实使用了它,是不同观察。保存的工作流 JSON 应对应实际运行版本,而不是后来为了展示整理的版本。若日志能够反映缓存是否启用,把对应日志一并保留;若只能确认节点状态,结论就写到该层,不凭画面快了倒推缓存必然生效。
三组就够,先别叠加开关
参照组 R 使用同一套可运行的 720p I2V 工作流:50 步、EasyCache 关闭。50 步来自模板中的原始配置,只是实验参照,不是本机已验证的画质最优值。如果 R 本身 OOM,先解决可运行性,不能拿失败组和成功组比画质。
| 组别 | 步数 | EasyCache | 只回答什么问题 |
|---|---|---|---|
| R:参照 | 50 | 关 | 当前工作流的耗时与完整视频表现 |
| S:减步数 | 20 | 关 | 只减少步数,采样时间与画面改变多少 |
| C:开缓存 | 50 | 开 | 保持步数,只启用此模板的 EasyCache 后怎样 |
三组固定同一张首帧、主模型、文本编码器、VAE、提示词及改写状态、分辨率、帧数、Seed 列表、采样器、CFG、shift、offload、VAE 分块和输出编码。S、C 都与 R 比;S 和 C 不是同一种优化的两个档位。减步数改变采样轨迹长度,缓存则在原步数安排中复用或近似中间计算。先做"20 步 + Cache On",即便快,也无法把速度和质量变化分配给各开关;画面更不稳定时,也无法决定应增加步数、关闭缓存还是两者都改。单项影响清楚后,才考虑组合组,并另记相互作用。
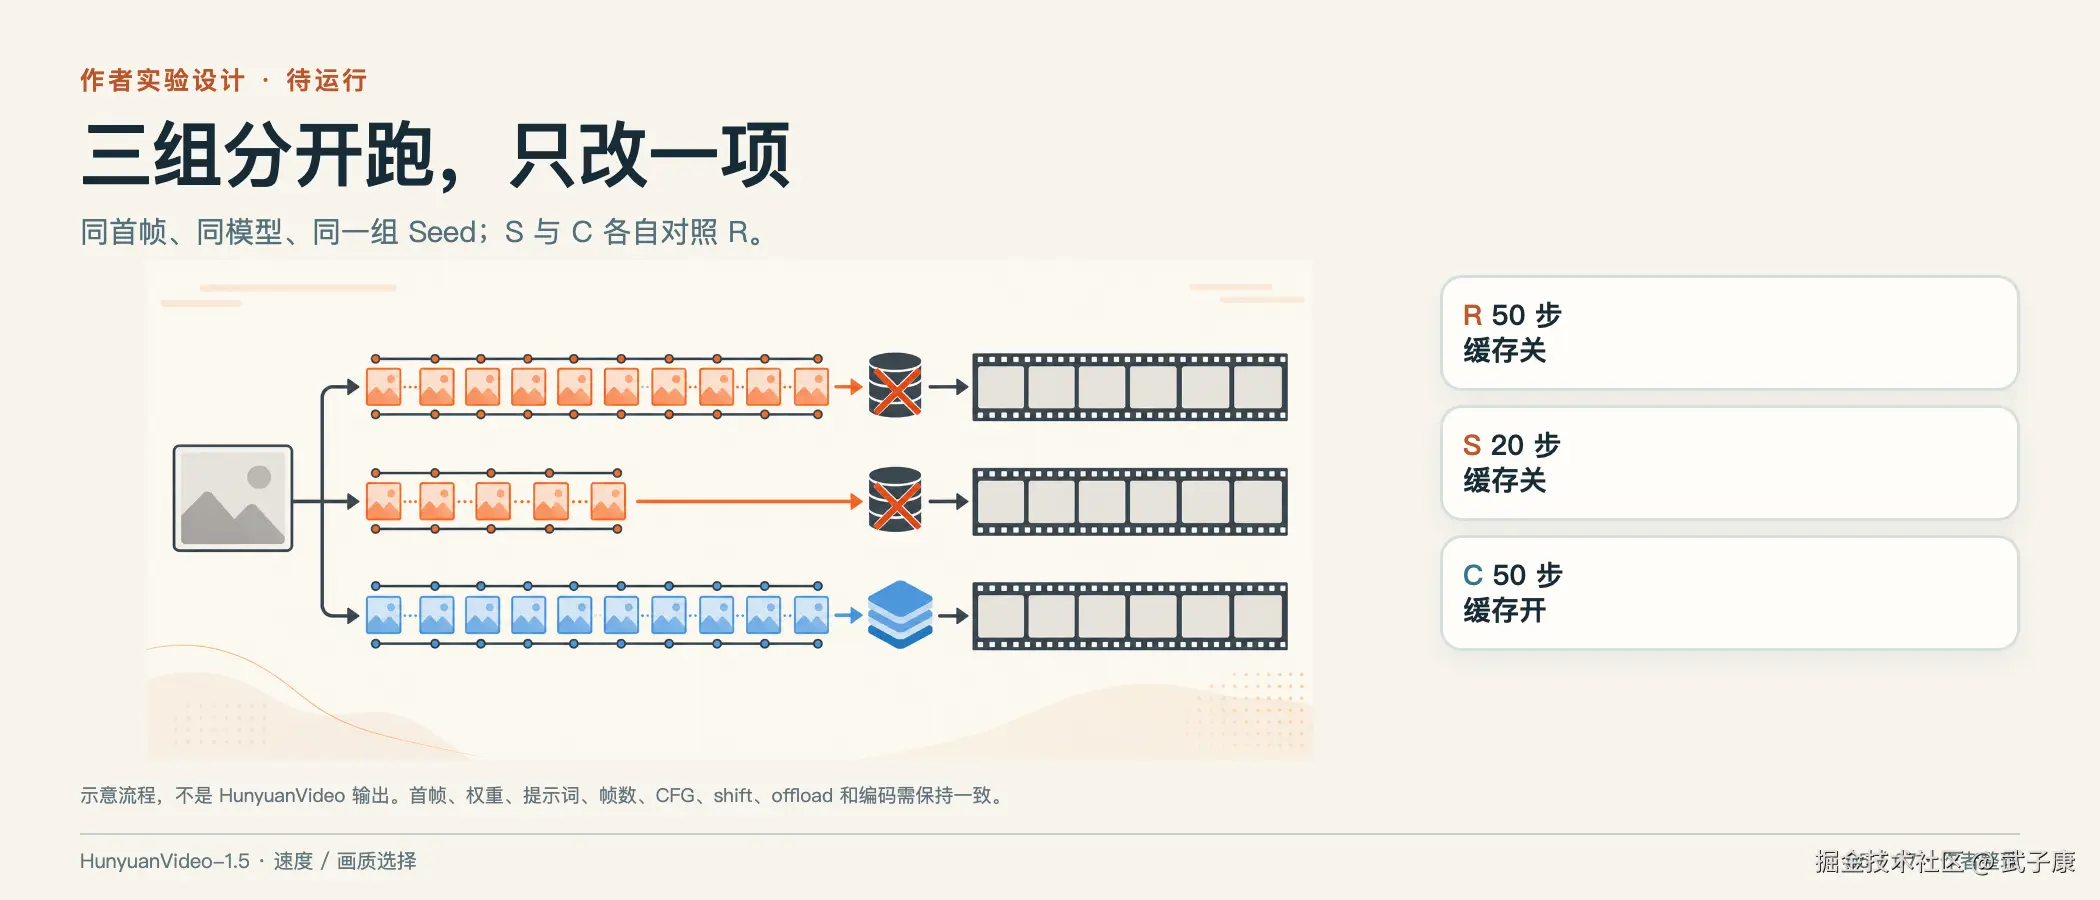
同 Seed 只让三组共享起点,配置改变后输出不同是预期。提前固定几张动作要求不同的首帧和 Seed 列表,所有组都跑全列表,保留成功、失败和超时;手部接触的失败不能用静态远景成功抵消。若某组只在特定 Seed 成功,不能筛成精选片段再称通用配置。结论可以是某些镜头用 S、另一些回到 R,不必寻找全输入统一赢家。
为什么先分开,再组合
单项测试也不能完全消除其他影响,所以每组配置仍应保存生效值。工作流可能在加载不同权重时选择不同节点,或在修改某个选项时改变另一项设置。把实际使用的 JSON 与输出一起存,而不是只记计划的 R/S/C 标签,才能发现这种隐藏变化。输入首帧经过不同裁剪、提示词发生改写、VAE 换版,都应先判为另一组条件。
若未来增加组合组,也不把单项节省时间直接相加。假设减步数已经减少了部分计算,缓存能够复用的中间计算也可能随之变化;组合收益必须重新测。质量代价同样可能在组合后加重或减轻,不能用两个单项结果代替完整成片。这里仅说明实验需要考虑相互作用,不预测 EasyCache 在具体任务上的算法行为。
可以先小范围运行,目标是发现是否存在不可接受的退步,而不是马上估计总体胜率。只要关键身份或动作出现清晰反例,就值得在同类输入上复测。反例帮助缩小配置适用范围;少量成功只能说明暂未观察到该类问题,不能证明它永远不会出现。
计时分段,画质看全片
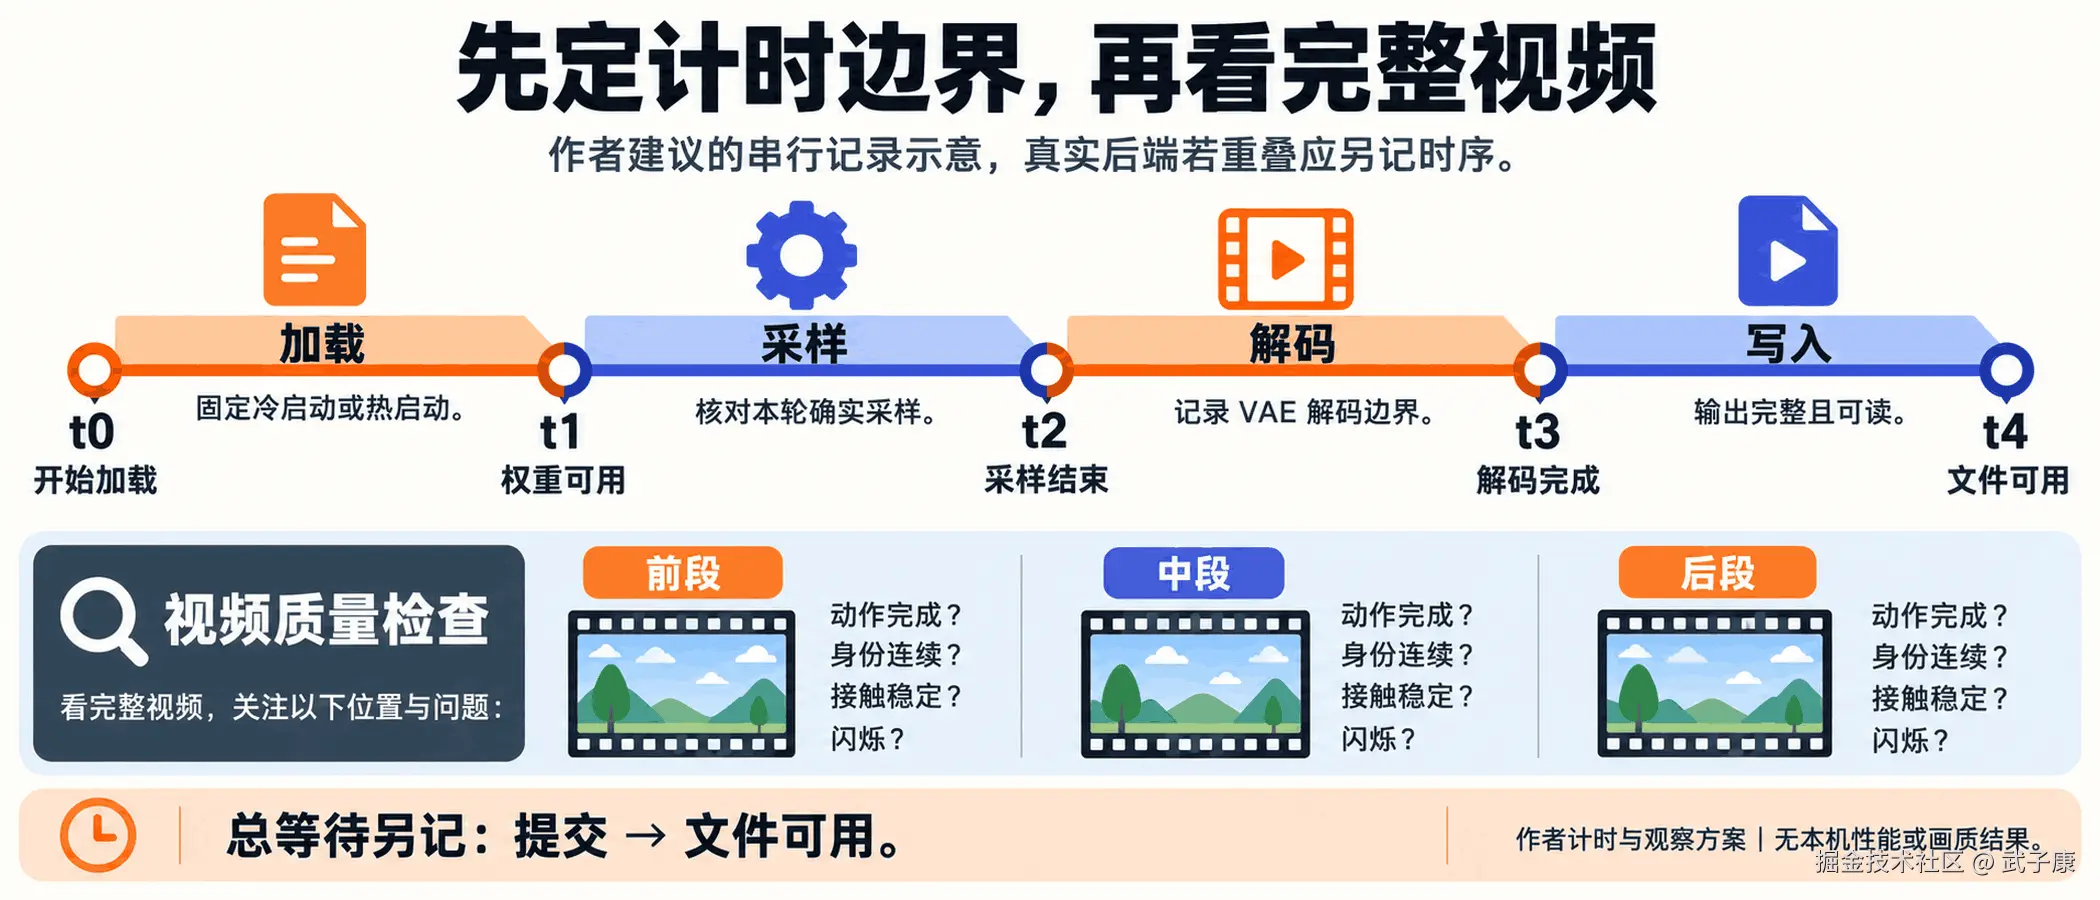
总耗时需要拆开:模型加载、采样、VAE 解码、输出写入,以及从提交到文件可用的端到端时间。缓存可能只改善采样;若解码占大头,最终等待未必明显缩短。冷启动和热启动分开记,并锁相同模型驻留方式:卸载、环境重启或是否仍在内存都会影响加载;不要把首次下载、内核编译或加载算成步数的代价。首帧预处理、排队与 MP4 封装也可能进入等待。时间戳要从相同明确边界开始和结束,不能混用提交到文件可用与独立采样的口径。再记峰值显存、主机内存与实际 offload 路径。没有现成分段日志,就在节点或进程边界打时间戳,不从总进度条推算。
画质先定义镜头动作,再并排看每条完整视频的前、中、后段:主体与身份是否连续,动作是否完成,手部和接触点是否稳定,背景和镜头运动是否突然改变,是否闪烁或结构重建。这些是作者建议的观察维度,不是官方断言 EasyCache 必然产生这些问题。微表情、细手部、快速镜头可先各取代表案例;某类出现问题,就在同类素材上扩样。
OOM、帧数不一致、解码失败、只落盘部分视频,先记为可运行性问题。只有完整且输出规格一致的视频才比画质。模型哈希、实际重写文本、Seed 或 VAE 不同,则标为不可比。
最小例:检查记录是否具备比较资格
包内附件为 examples/speed_record_contract.py,运行命令是 python3 08-publishing-pipeline/generated-packages/PKG-20260926-0006-hunyuan-i2v-speed-quality-choice/examples/speed_record_contract.py。只有标准库。它构造一张"并非图片"的 bytes 标记、两 Seed、三组记录;所有版本、时间、输出状态与规格都是人工输入,不读取模型或媒体,不运行工作流,不计时 GPU。示例 target 的 1280×720、121 帧、24 fps 只是固定合同,不能推广成全部 I2V 唯一输出格式。
程序要求 R→S 或 R→C 的固定条件和 Seed 相同、两项开关符合预先定义的组别,再检查声明的输出目标、采样执行标记及四个计时分段。分段必须有非负持续时间、按本例串行顺序排列且被端到端窗口包住;真实后端若重叠工作,就应保留自己的时序口径,不能硬套这份串行算式。即使脚本接收相同配置字段,也不能证明某节点真的生效,原始运行身份与完成边界日志仍不可少。
python
"""Check finite invented R/S/C records. No inference, file read or GPU timing."""
from copy import deepcopy
from hashlib import sha256

ARMS = {"R": (50, False), "S": (20, False), "C": (50, True)}
SEEDS = (11, 22)
FIXED = {
    "backend": "ComfyUI-demo", "commit": "demo-commit",
    "workflow": "demo-workflow", "model": "ordinary-720p-I2V-demo",
    "encoder": "demo-encoder", "vae": "demo-vae",
    "input_sha": sha256(b"invented-first-frame-not-an-image").hexdigest(),
    "prompt": "demo-action", "rewrite": False, "rewrite_text": "demo-action", "sampler": "demo-sampler",
    "cfg": 6, "shift": 7, "offload": "demo-fixed", "vae_tiling": "demo-fixed",
    "target": (1280, 720, 121, 24), "encoding": "demo-mp4",
    "cache_impl": "EasyCache-demo", "cache_settings": (0.2, 0.15, 0.95),
    "residency": "demo-hot", "environment": "demo-no-GPU",
    "timing_basis": "synthetic-sequential-wall-clock",
}
PHASES = ("load", "sample", "decode", "write")


def record(arm, seed, status="complete"):
    return {
        **FIXED, "arm": arm, "seed": seed,
        "steps": ARMS[arm][0], "cache_on": ARMS[arm][1], "status": status,
        "actual_output": FIXED["target"] if status == "complete" else None,
        "sampling_executed": True, "quality": None,
        "end_to_end": (0, 12),
        "phases": dict(zip(PHASES, ((1, 2), (2, 8), (8, 10), (10, 11)))),
    }


def timing_valid(row):
    window, phases = row.get("end_to_end"), row.get("phases", {})
    if window is None or set(phases) != set(PHASES):
        return False
    start, finish = window
    previous = start
    for name in PHASES:
        begin, end = phases[name]
        if not start <= previous <= begin <= end <= finish:
            return False
        previous = end
    return True


def pair_errors(base, candidate):
    errors = []
    for key, expected in FIXED.items():
        if key not in base or key not in candidate:
            errors.append("missing:" + key)
        elif base[key] != candidate[key] or base[key] != expected:
            errors.append("different:" + key)
    if base.get("seed") != candidate.get("seed"):
        errors.append("different:seed")
    if base["arm"] != "R" or candidate["arm"] not in ("S", "C"):
        errors.append("not_R_to_S_or_C")
    for row in (base, candidate):
        if (row["steps"], row["cache_on"]) != ARMS[row["arm"]]:
            errors.append("wrong_arm_controls")
        if row["status"] != "complete" or row["actual_output"] != FIXED["target"]:
            errors.append("incomplete_or_wrong_output")
        if not row["sampling_executed"]:
            errors.append("engine_reuse")
        if not timing_valid(row):
            errors.append("invalid_timing")
    return errors


def summarize(rows):
    planned = {(arm, seed) for arm in ARMS for seed in SEEDS}
    found = {}
    for row in rows:
        key = row["arm"], row["seed"]
        if key not in planned or key in found:
            raise ValueError("unexpected_or_duplicate_attempt")
        found[key] = row
    result = {}
    for arm in ARMS:
        statuses = [found[(arm, seed)]["status"] if (arm, seed) in found else "missing"
                    for seed in SEEDS]
        result[arm] = (statuses.count("complete"), len(SEEDS), statuses)
    return result


def main():
    base, reduced = record("R", 11), record("S", 11)
    assert pair_errors(base, reduced) == []
    assert pair_errors(base, record("C", 11)) == []
    print("fixture_input_sha=" + FIXED["input_sha"])
    print("R11_to_S11_and_C11: ELIGIBLE_RECORD_FIELDS_ONLY")
    cases = [
        ("commit", {"commit": "another-demo"}, "different:commit"),
        ("seed", {"seed": 22}, "different:seed"),
        ("rewrite", {"rewrite_text": "changed-action"}, "different:rewrite_text"),
        ("input", {"input_sha": "other-input"}, "different:input_sha"),
        ("output", {"actual_output": (1280, 720, 61, 24)}, "incomplete_or_wrong_output"),
        ("both_knobs", {"cache_on": True}, "wrong_arm_controls"),
        ("engine_reuse", {"sampling_executed": False}, "engine_reuse"),
        ("failure", {"status": "timeout"}, "incomplete_or_wrong_output"),
        ("overlap", {"phases": {**reduced["phases"], "decode": (7, 10)}}, "invalid_timing"),
        ("missing_clock", {"end_to_end": None}, "invalid_timing"),
    ]
    for name, change, expected in cases:
        changed = {**deepcopy(reduced), **change}
        errors = pair_errors(base, changed)
        assert errors == [expected], (name, errors)
        print("reject_" + name + ": " + expected)
    missing_version = deepcopy(reduced)
    del missing_version["commit"]
    assert pair_errors(base, missing_version) == ["missing:commit"]
    print("reject_missing_version: missing:commit")
    rows = [record("R", 11), record("R", 22), record("S", 11),
            record("S", 22, "timeout"), record("C", 11), record("C", 22, "OOM")]
    for arm, (complete, planned, statuses) in summarize(rows).items():
        print(f"fixture_{arm}: declared_complete={complete}/{planned} statuses={','.join(statuses)}")
    selected_successes = [row for row in rows if row["status"] == "complete"]
    assert summarize(selected_successes)["S"] == (1, 2, ["complete", "missing"])
    print("success_only_S: declared_complete=1/2 missing=1 (denominator_kept)")
    try:
        summarize(rows + [rows[0]])
    except ValueError as error:
        assert str(error) == "unexpected_or_duplicate_attempt"
        print("reject_duplicate: " + str(error))
    else:
        raise AssertionError("duplicate accepted")
    assert all(row["quality"] is None for row in rows)
    print("quality=NOT_EVALUATED real_outputs=0 gpu_runs=0")
    print("self_checks=13 counterexamples_passed")


if __name__ == "__main__":
    main()
本机 Python 3.11.6 实际运行,退出码 0;下面是程序真实 stdout,数值内容来自构造记录:
text
fixture_input_sha=9d6962db49b77ebd9b31cf045721b73c1e6986fb08f0f04ba6acf6a7a2a6c50b
R11_to_S11_and_C11: ELIGIBLE_RECORD_FIELDS_ONLY
reject_commit: different:commit
reject_seed: different:seed
reject_rewrite: different:rewrite_text
reject_input: different:input_sha
reject_output: incomplete_or_wrong_output
reject_both_knobs: wrong_arm_controls
reject_engine_reuse: engine_reuse
reject_failure: incomplete_or_wrong_output
reject_overlap: invalid_timing
reject_missing_clock: invalid_timing
reject_missing_version: missing:commit
fixture_R: declared_complete=2/2 statuses=complete,complete
fixture_S: declared_complete=1/2 statuses=complete,timeout
fixture_C: declared_complete=1/2 statuses=complete,OOM
success_only_S: declared_complete=1/2 missing=1 (denominator_kept)
reject_duplicate: unexpected_or_duplicate_attempt
quality=NOT_EVALUATED real_outputs=0 gpu_runs=0
self_checks=13 counterexamples_passed
ELIGIBLE_RECORD_FIELDS_ONLY 表示字段通过这份有限合同检查,未验证视频存在、可读或真实完整生成。declared_complete 同样只是表内声明;真实文件还要逐条核对帧数、编码、可读性和完整播放。第一组 R 为 2/2、S/C 为 1/2,也不代表质量成片率:输入既不是图像,quality 也都是 None。输出明确 NOT_EVALUATED,没有任何模式质量胜负。
分母来自预先固定的两 Seed,不来自筛选后的成功条数。把超时/OOM 行删掉,S 仍是 1/2,另一条变成 missing;重复尝试不会悄悄挤成额外成功。真实重试要另留 attempt 身份,分别报告按计划案例的完成覆盖和总尝试成本,不能把一次成功掩盖的失败时间抹掉。本例不处理任意重试系统,只拒绝有限数据集里的重复或未计划键。
十三项反例覆盖版本缺失/变化、Seed、实际重写文本、输入身份、输出帧数、同时动两个开关、执行引擎复用、超时、计时分段重叠、时钟缺失、成功筛选与重复记录。它们验证的是比较资格,不是 Hunyuan 质量;下一步仍要取得真实配置、采样日志和完整原片,才能填速度与画面结论。
计时能比较之前,先排除工作流复用
有些执行环境会复用已经完成的节点输出。若重复提交的任务没有真正重新采样,极短完成时间可能来自执行引擎复用结果,而不是生成算法变快。这与本文讨论的 EasyCache 不是同一个概念。计时记录要能够确认本轮哪些节点实际执行,必要时按环境已有办法安排新的完整采样,并保存对应日志。
阶段计时若由 GPU 异步工作影响,需要采用后端提供的正确完成边界,不能只量 Python 调用返回速度。具体实现由实际环境决定,本文没有运行环境可以验证计时器。最基本要求是解释时间戳代表提交、计算完成还是文件写入完成,并让原始日志支持这种解释。
还应保留每次运行的资源环境。其他任务占用 GPU 或主机内存时,某组可能发生不同卸载路径;若没有这些记录,偶然等待会被误写成优化效果。先记录外部占用,避免擅自停别人的任务;无法保持相同环境就将该次比较标为环境不同,待条件一致后复测。
全片质量检查可以按目标动作设置关键位置,但不只截关键帧。静态帧看得见脸部或手部细节,连续播放才能看出闪烁、动作回跳和镜头突然变化。两种观察互补。尤其第一帧由首帧图约束,首帧保持不代表后半段稳定;最终结论至少说明动作结束附近的表现和整段连续性。
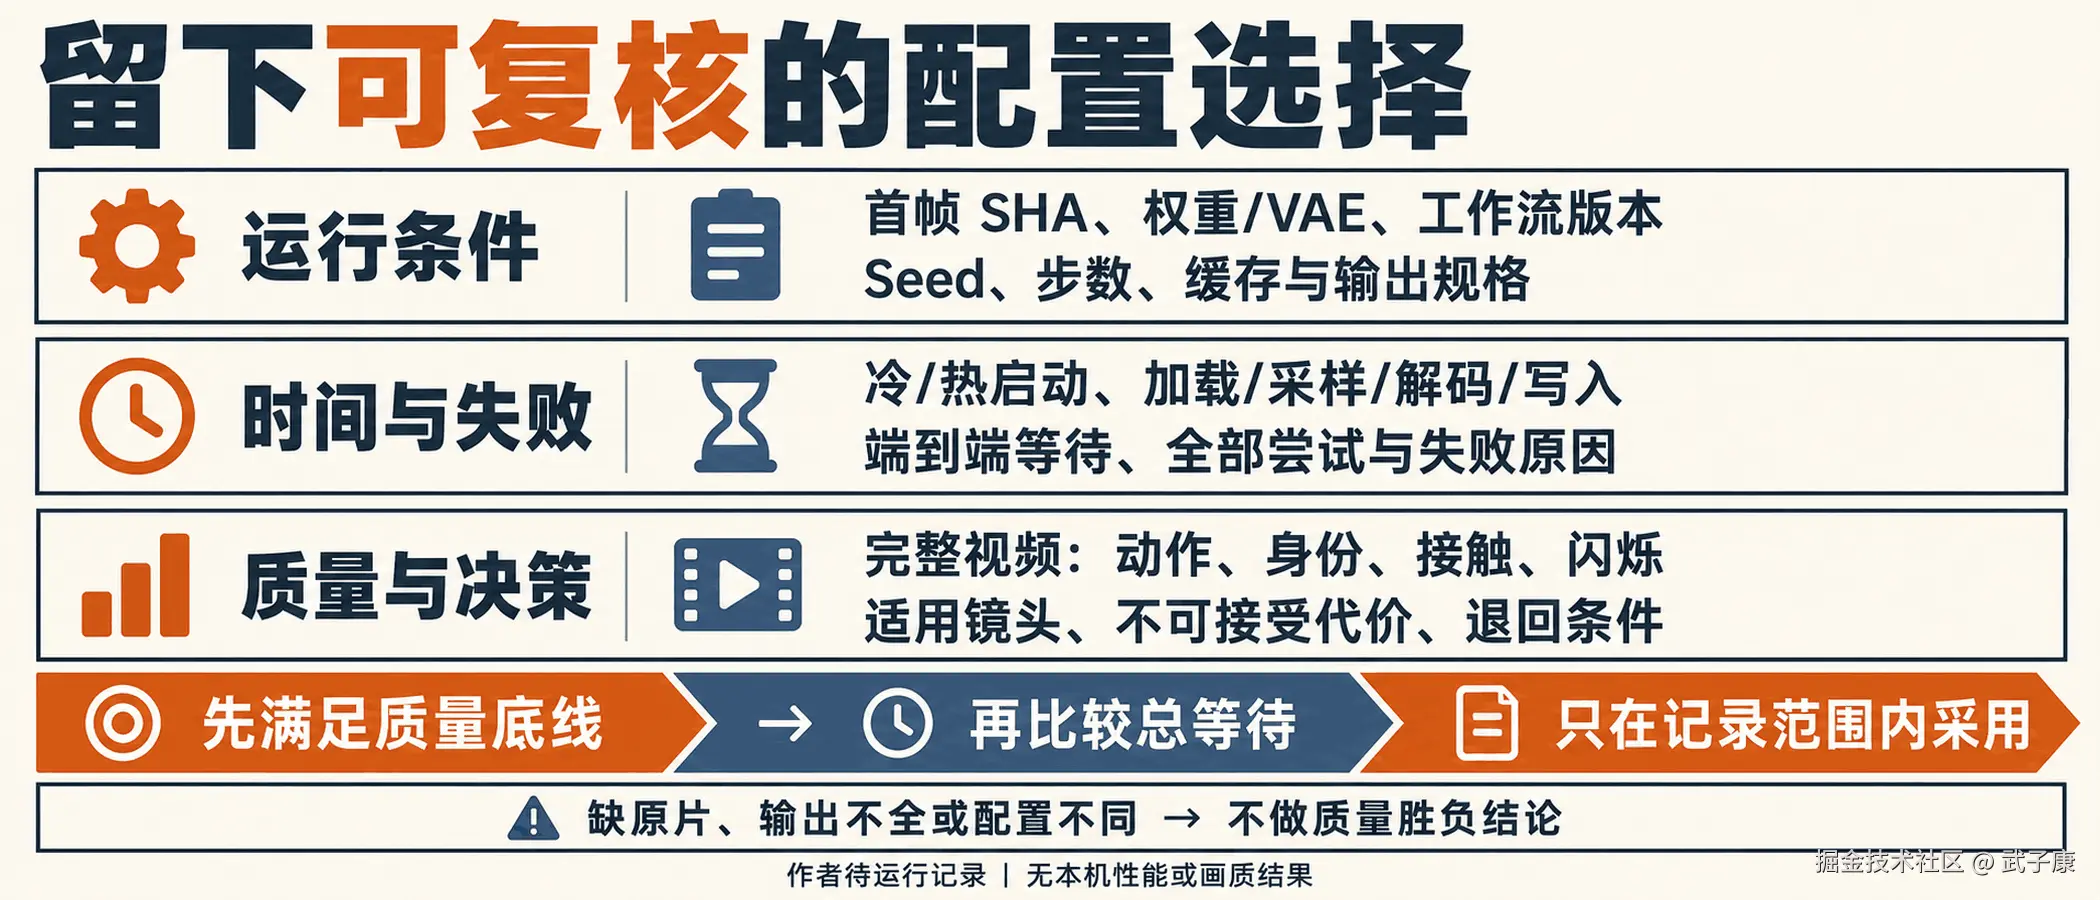
留下一张可复核的选择记录
text
镜头目标与首帧 SHA-256:____
工作流文件/代码提交、主模型/编码器/VAE 哈希:____
分辨率、帧数、采样器、CFG、shift、提示词、rewrite:____
Seed 列表、offload、VAE 分块、输出编码:____
R=50 步/Cache Off;S=20 步/Cache Off;C=50 步/EasyCache On
每组冷/热启动、加载/采样/解码/写入/端到端时间:____
峰值显存、主机内存、完整生成或失败原因:____
逐 Seed 前/中/后段的动作、身份、接触、背景与闪烁:____
所有原始视频、失败视频、工作流 JSON 与日志路径:____
结论适用的硬件、权重、后端、镜头类型与不可接受代价:____
若 S 在目标镜头上更快且质量差异可接受,可以把它列为该类任务的候选;若 C 节省采样时间,却伤及关键动作或身份,就保持关闭。若两者都不达质量底线,回到 R 或换工作流。R 无法完整运行时,先修复运行条件,本文不提供"最高质量"结论。
把速度收益换成可以执行的选择
先写不可接受的质量代价,再看速度。对人物视频,身份稳定可能是硬要求;对演示抓取动作,手和物体接触可能更关键;对简单景观漫游,细小纹理变化也许可以接受。阈值由目标任务决定,不能在看到某组特别快后临时降低标准,最后还声称整体画质不变。
可以将每条结果写成具体判断:完整生成是否成功、目标动作是否结束、身份是否保持、关键接触是否可接受、采样和端到端各节省了哪段时间。不要把这些性质不同的结果合成一个平均分。生成缺失或关键动作失败属于不可交付,不能用速度分抵消;看不清的身份或接触则标为不可判断,重新调整可观察性。
设想 S 比 R 等待更短,但某个快速转身镜头脸部明显变样,而静态人物镜头没有观察到变化。可以把 S 保留为静态镜头候选,将快速转身继续交给 R,之后再验证更多同类素材。设想 C 节省了采样时间,端到端变化却很小,应报告瓶颈仍在其他阶段,别用采样缩短比例宣传用户等待收益。这些是假设决策示例,没有构成模型质量或性能实测。
还应考虑获得一条可用视频的总尝试量。若加速配置单次快,却需要更多重试,创作者真正付出的时间未必下降。记录所有尝试及失败原因,才能比较可用片段的获得成本。小规模试验不够支持精确成片率,只能先暴露"快但常要重试"这样的待验证现象。
参照组也不是永久正确。换模型、VAE、后端或更新节点后,应重跑同样案例;保留完整输入与原始输出,让新版本与旧选择共享参照。
如果最终采用一种配置,交付记录附上它适用的镜头类型和退回条件。例如出现关键身份漂移就切回参照,出现完整输出失败先处理运行问题。退回条件不应由 Agent 根据一句"看起来还好"自行跳过,它应由当前任务的可见目标和输出证据决定。这样选择优化才不仅是改一个开关,而是知道什么时候继续用、什么时候停止用。
对结果做并排展示时,播放速度、尺寸和后处理保持一致,原片另行保存。某组若被放慢播放,动作抖动可能更明显;某组如果被缩小,细节缺陷也可能不易看见。展示方式既能帮助解释,也能制造偏差,所以判断应能回到原始文件。把配置标签暂时隐藏,可减少观看者对加速组必然更差或更好的预期。
输出不可比还包括额外超分或展示规格改变。这些可作为独立案例观看;若要恢复三组单变量比较,复测前回到冻结输入和实际生效配置,确认唯一目标开关差异。
资源峰值也不必假定会随着步数下降。减少计算次数是否降低瞬时内存需求,必须由实际过程证明;采样快和显存低是不同指标。若目标是解决显存不足,先定位失败阶段,再评估相应调整,不用缩短耗时证明容量问题已解决。本文讨论的 R/S/C 主要用于可运行路径上的速度画质取舍。
记录最后应留一项"下一轮只改什么"。如果目标镜头达成但解码等待占主导,下轮就不急着叠加采样优化;如果某类接触动作失败,就扩大同类素材观察;如果模式标签和实际执行不一致,就先修记录。每条下一步对应一个已观察问题,避免实验变成连续试开关、最后只留下最快那条的过程。
官方文件指出了可测的速度选择及质量提醒,没有替任何人完成 A/B。先分别跑通、分段计时、看完整视频,再决定改哪个开关。
参考资料
- Comfy-Org 720p I2V 官方工作流模板:步数说明、EasyCache 状态与质量提醒。
- 腾讯 HunyuanVideo-1.5
generate.py:另一实现路径的缓存参数。
首次核查:2026-09-26;本次固定提交复核:2026-10-13。新增记录检查已本地运行,本文仍无本机 I2V 输出、GPU 性能或画质结论。