OpenAI 又来开始卷价格了。
GPT-6.1 Terra 的标准 API 价格是每百万输入 token 1 美元,输出 5 美元,比上一代低 50%。但便宜的单价不等于便宜的已完成任务。选模型时应该比较每个验收通过任务的成本,也就是模型费用加人工补救,再除以通过验收的任务数。通过率低、重试多的低价模型,总账完全可能更贵。
Terra 发布后,价格成了讨论的焦点。价格腰斩耶,那是不是说以后写代码、修Bug的价格也能腰斩?这篇文章将用例子告诉你,事实是怎么样的。
GPT-6.1 Terra 是什么模型
GPT-6.1 Terra 是 OpenAI 推出的快速、高效模型,定位是兼顾视觉推理、计算机操作和写作表现。它是 GPT-5.6 Terra 的升级版本,面向日常工作中的沟通和计算机任务,例如起草提案、解读技术图纸、填写表单和剪辑视频。
官方的定位是在速度、能力和成本之间取得新的平衡。公告举的典型场景是大批量自动化,比如读取收到的发票,再把详细信息录入会计软件。
价格与可用渠道
API 调用名是 gpt-6.1-terra。标准 API 定价为每百万输入 token 1 美元,每百万缓存输入 token 0.05 美元,每百万输出 token 5 美元。标准 API 价格比 GPT-5.6 Terra 和 GPT-6.1 Sol 低 50%。
Plus、Pro、Enterprise、Edu 用户可以在 ChatGPT 工作和 Codex 中使用,开发者可以通过 OpenAI API 调用。官方还提到,在 ChatGPT 工作和 Codex 中,相同的使用额度能完成的任务,比 GPT-5.6 Terra 更多。
能力表现
以下都是 OpenAI 公布的基准数据。
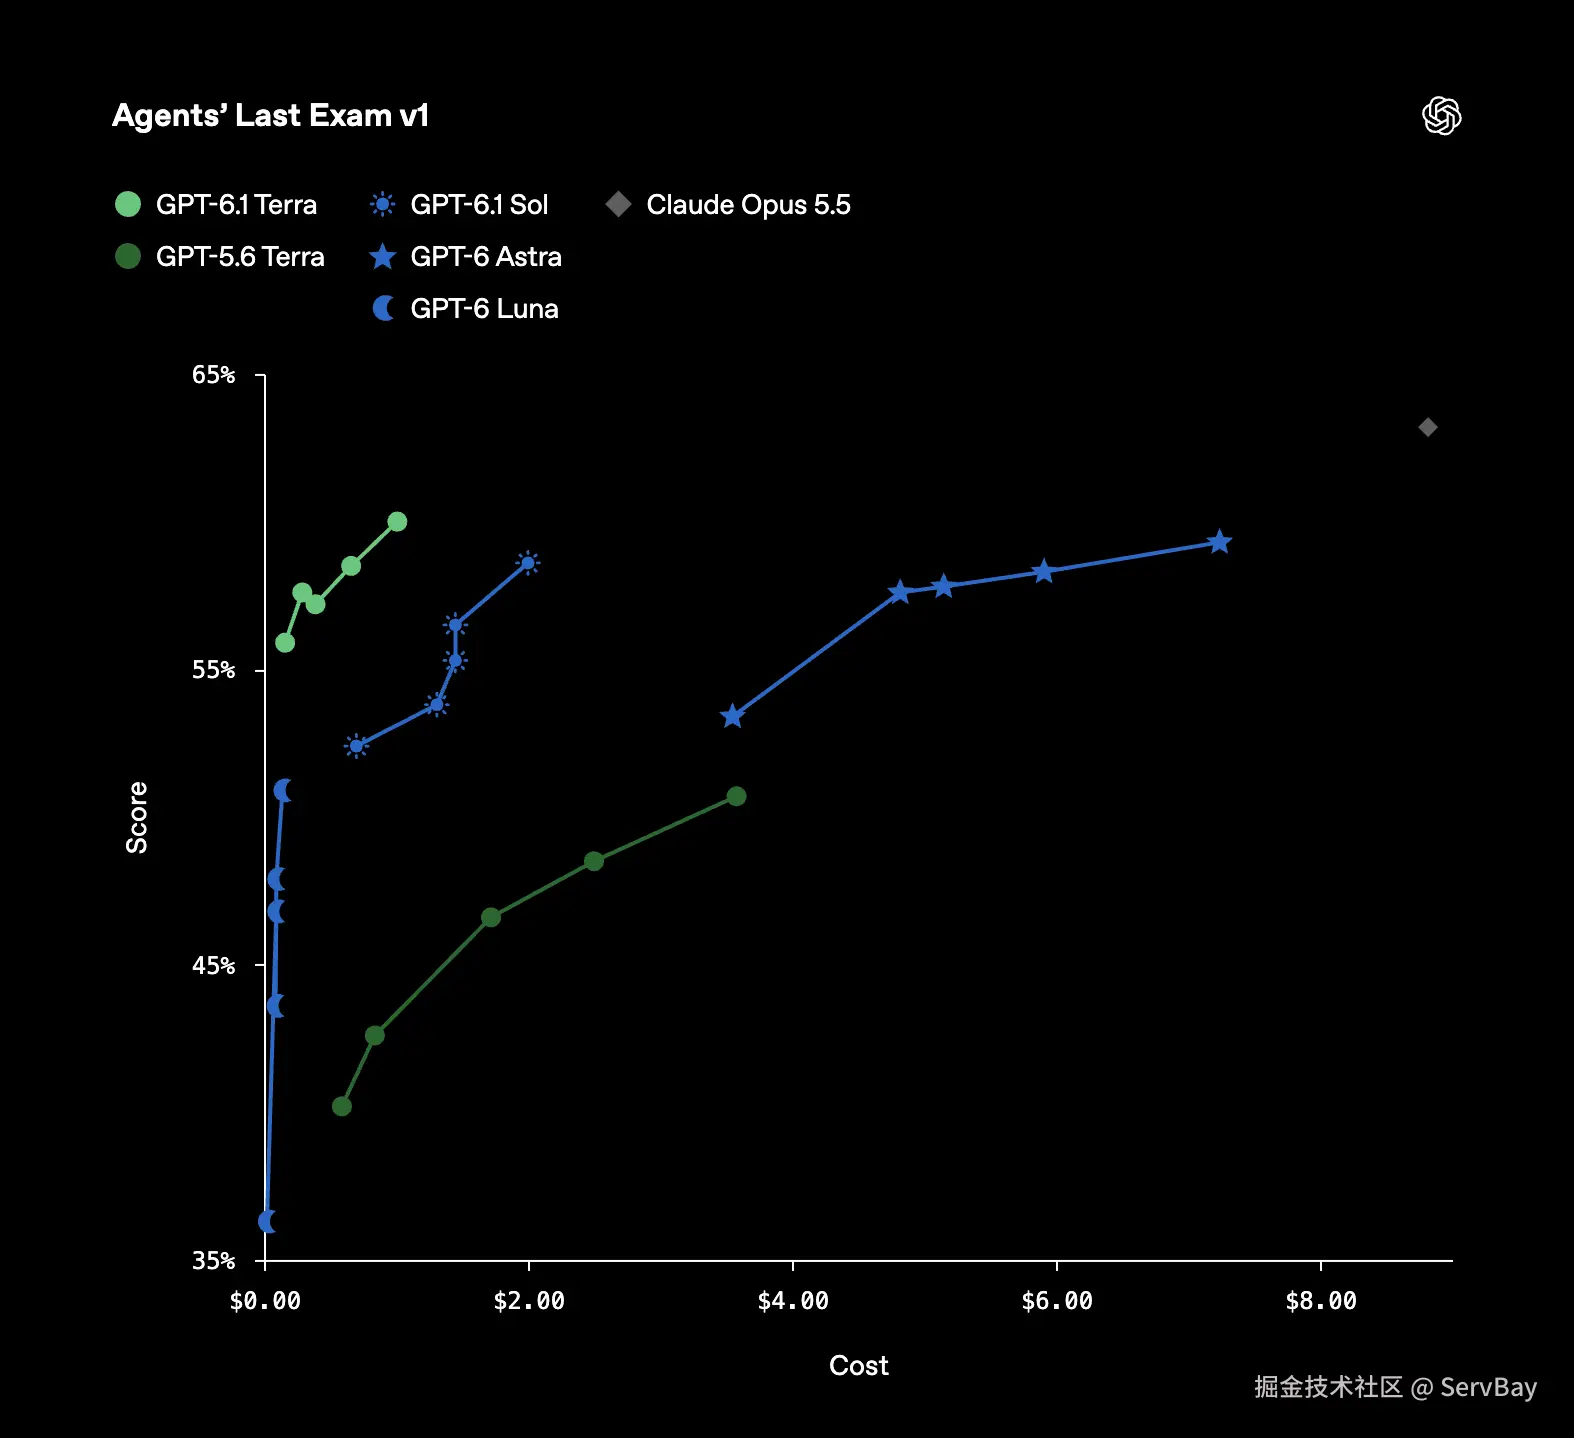
- 计算机操作: 在 Agents' Last Exam 上,中等推理强度下的得分比 GPT-5.6 Terra 高 15 个百分点,成本约为后者的三分之一。在 OSWorld 2.1 上,中等推理强度就超过了 GPT-5.6 Terra 的最佳成绩。
- 视觉推理: 在 MMMU-Pro 上,所有推理设置下都优于 GPT-5.6 Terra。
- 事实准确性: 在 OpenAI 内部由易诱发错误的提示词构成的测试中,低推理强度下的错误率从 53.6% 降到 16.7%,最高推理强度下降到 4.3%。
- 软件工程 : 在测试命令行编程能力的 Terminal-Bench 4.0 上,最高推理强度下解决了 50.3% 的任务,GPT-5.6 Terra 已公布的成绩是 21.5%。
- 速度: 完成任务的速度是 GPT-6 Astra 和 GPT-6.1 Sol 的三倍以上。
官方同时说明,对于最复杂的编程任务,GPT-6.1 Sol 和 GPT-6 Astra 仍然是更好的选择。这一条边界,是后文任务选择规则的依据。
安全与对齐
官方表示,Terra 的网络安全能力达到了准备框架规定的 Critical 级别阈值,并保留了为 GPT-6 Astra 开发的防护措施。在对齐评估中,Terra 比 GPT-5.6 Terra 更可能在任务范围内行事,并如实说明自身局限。在提示词注入测试中,它对恶意指令也表现出较强的抵抗力。详细内容见官方系统卡。
十分之一和九分之一,分别比的是什么
传播中最常见的说法是十分之一,公告里有两处接近的表述,对比对象不同。
第一处,在 Agents' Last Exam 上,Terra 的表现可与 GPT-6 Astra 相媲美,而每个 token 的价格仅为后者的十分之一。比较的是 token 单价,对象是 Astra,任务是计算机操作。
第二处,在最高推理强度下,Terra 的 token 使用效率是 Claude Opus 5.5 的三倍以上,每个 token 的价格为后者的四分之一,所以每项任务的成本约为后者的九分之一。
这两处都不是修一个 bug 能便宜到十分之一的意思。第二处已经改用每项任务成本的口径,说明官方自己也没有把单价等同于总成本。
单价低为什么不等于总账低
只比较每百万 token 的单价,会漏掉三项成本。
-
一个任务通常不止一次尝试。 第一次修复没过测试,就要带着报错再来一轮,每多一轮,输入和输出都要重新计费。
-
失败的尝试同样计费。 补丁写错了,token 已经消耗,费用不会退回。
-
失败后需要人来收尾。 工程师花 15 分钟排查模型改坏的地方,成本可能高于几十次 API 调用。
所以低单价只是必要条件。通过率明显更低的便宜模型,总成本可能更高。通过率相当时,低单价才会实实在在转化为省钱。
另外,一些公开讨论里会用单个案例证明便宜模型更划算,比如几分钟、一两美元完成一个小游戏。这类案例很直观,但缺少统一的验收标准,没有交代成品是否通过测试、是否需要返工,很难折算成每个验收通过任务的成本。本文引用的转述案例未经核实,只作为说明问题的背景。
账单由哪几部分构成
按官方费率,一次调用的费用由三部分相加。
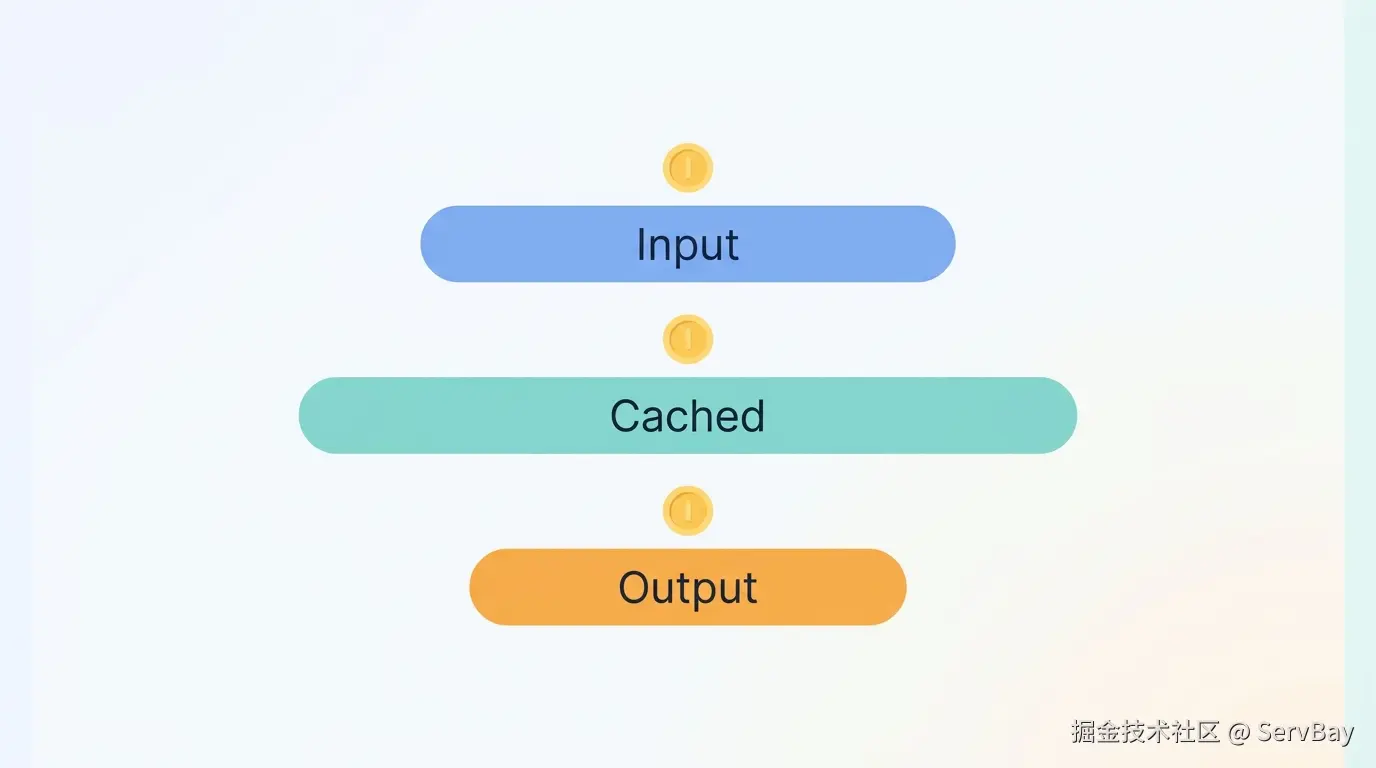
输入是代码文件、报错日志和提示词,按每百万 token 1 美元计费。缓存输入是多轮重试中重复出现的上下文,按每百万 token 0.05 美元计费,只有普通输入的二十分之一。输出是补丁、解释和推理产生的内容,按每百万 token 5 美元计费,是输入单价的 5 倍。
重试场景里,缓存的作用尤其明显。代码文件和历史上下文在多轮中反复出现,命中缓存后,每多一轮的边际成本会明显下降。但缓存能否命中取决于前缀是否一致等条件,具体规则和有效时长以官方文档为准。设计提示词时,把项目说明、文件内容这类固定部分放在前面,把本轮报错这类变动部分放在后面,更容易命中缓存。
输出价格较高,所以推理强度调高后,单次费用会随输出增加而上升。
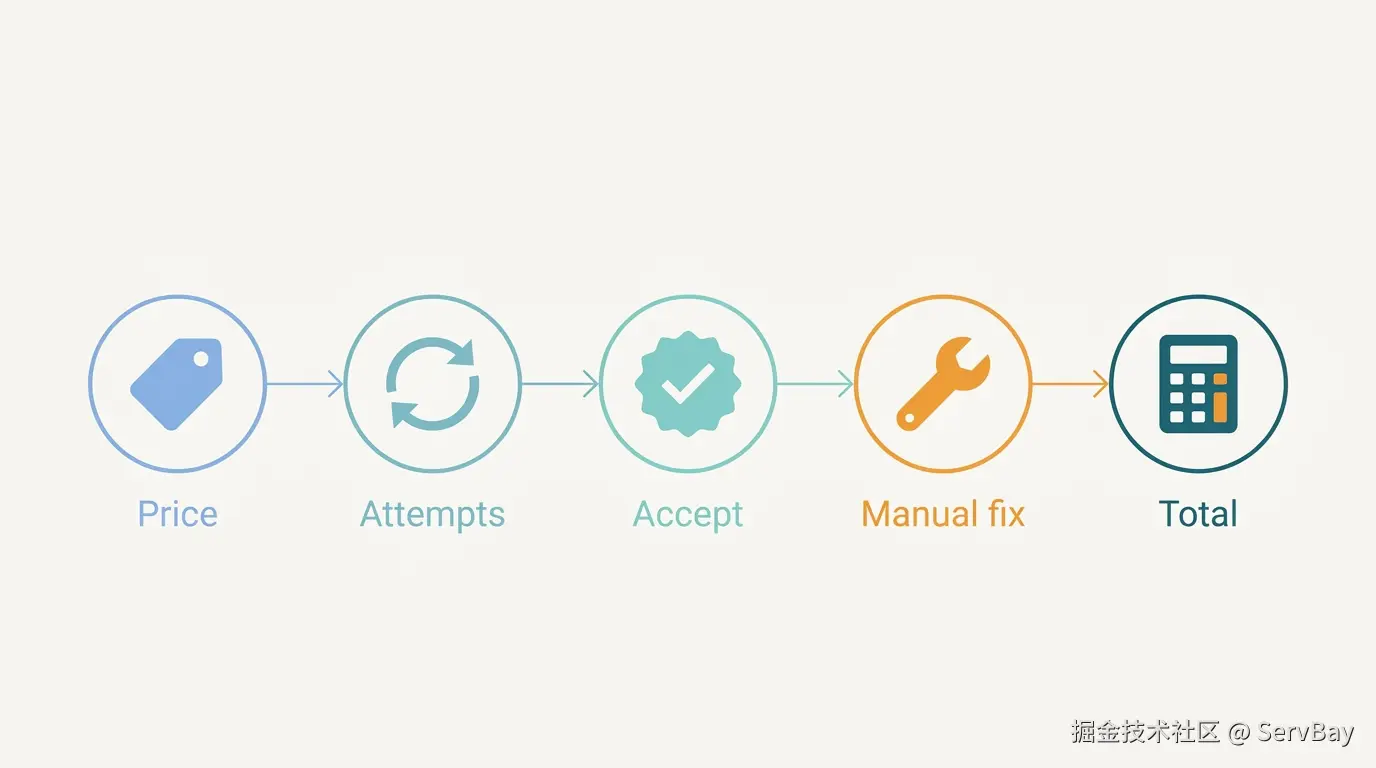
从单价到总账的五步推演
-
单价: 查官方费率,区分输入、缓存输入、输出。
-
尝试次数: 记录每个任务实际用了几轮,每轮消耗多少 token。
-
验收: 事先写好通过标准,包括指定测试全部通过、原有测试不退化、不允许改测试文件。
-
人工补救: 记录模型失败后人工介入的分钟数,按统一时薪折算。
-
总账 : 套用下面的公式。
scss
每个验收通过任务的成本 = (模型费用总和 + 人工补救成本) / 验收通过任务数这里的验收通过包含人工补救后通过的任务,否则公式会漏掉失败的代价。想单独看模型本身的表现,可以另外统计未经人工直接通过的比例。
计算示例:单价低一半,总账高十几倍
下面是计算示例,参数全部为假设,不代表 Terra 或任何模型的真实通过率。
假设条件如下。
-
每次尝试消耗未缓存输入 1 万 token、缓存输入 3 万 token、输出 8000 token。
-
每个任务最多尝试 3 次,通过即停止。
-
3 次都失败时,人工补救 15 分钟,按每小时 60 美元折算,即 15 美元。
-
模型 A 使用 Terra 费率,单次通过率设为 40%。
-
模型 B 单价为 Terra 的 2 倍,单次通过率设为 80%。
按 Terra 费率,单次尝试的费用为输入 0.01 美元、缓存输入 0.0015 美元、输出 0.04 美元,合计 0.0515 美元。
下面的 Python 代码可以复现全部数字。
python
def cost_per_accepted_task(p, price_mult, cap=3, manual_fix=15.0):
    # 单次尝试费用(美元),费率为示例中的 Terra 标准费率
    per_attempt = (10_000 * 1 + 30_000 * 0.05 + 8_000 * 5) / 1_000_000 * price_mult
    fail_all = (1 - p) ** cap                                   # 全部尝试都失败的概率
    expected_attempts = sum((1 - p) ** i for i in range(cap))   # 期望尝试次数
    model_cost = expected_attempts * per_attempt
    manual_cost = fail_all * manual_fix                         # 失败后的人工补救期望成本
    return per_attempt, expected_attempts, fail_all, model_cost, manual_cost, model_cost + manual_cost


print(cost_per_accepted_task(0.4, 1))  # 模型 A:Terra 费率
print(cost_per_accepted_task(0.8, 2))  # 模型 B:2 倍单价
计算结果如下。
| 项目 | 模型 A(1 倍单价,通过率 40%) | 模型 B(2 倍单价,通过率 80%) |
|---|---|---|
| 单次尝试费用 | 0.0515 美元 | 0.103 美元 |
| 期望尝试次数 | 1.96 | 1.24 |
| 模型费用 | 0.101 美元 | 0.128 美元 |
| 全部失败概率 | 21.6% | 0.8% |
| 人工补救期望成本 | 3.24 美元 | 0.12 美元 |
| 每个验收通过任务成本 | 约 3.34 美元 | 约 0.25 美元 |
在这组假设下,单价低一半的模型 A,总成本约为模型 B 的 13 倍,人工补救占了大头。只看模型费用,A 每个任务 0.101 美元,B 是 0.128 美元,A 反而略便宜。
反过来也成立。A 的通过率提高到接近 B,人工补救成本会迅速缩小,价格优势才会体现出来。所以关键不在单价,在通过率,以及失败后要花多少人力。
如何设计可复现的实验
想在自己的项目里验证,可以按下面的方式设计。
-
任务选择。 选一个能稳定复现的 bug,附带会失败的测试用例,公开仓库和对应的 commit。难度取中等,既不能一次就过,也不能完全无解。
-
验收标准。 指定测试全部通过,原有测试不退化,不允许通过修改测试文件达成通过。
-
控制变量。 使用同一份提示词、同一个代码快照、同一个重试上限。计费渠道也要一致,API 和订阅套餐的数字不要混在一起。每个模型需要多跑几次,单次结果受随机性影响较大。
-
记录字段。 建议每次尝试记录以下内容,token 数可以直接取自 API 返回的用量字段。
| 字段 | 说明 |
|---|---|
| task_id | 任务编号 |
| model | 模型名,如 gpt-6.1-terra |
| reasoning_effort | 推理强度 |
| attempts | 实际尝试次数 |
| input_tokens | 未缓存输入 token |
| cached_tokens | 缓存输入 token |
| output_tokens | 输出 token |
| accepted | 是否通过验收 |
| manual_minutes | 人工补救分钟数 |
| total_cost_usd | 模型费用加人工折算 |
选模型的任务规则
官方也提出了,最复杂的编程任务仍建议使用 GPT-6.1 Sol 或 GPT-6 Astra。结合前面的账本思路,可以先做一个初步分配,再用自己的数据修正。
范围明确、有测试覆盖的小修复,可以优先试 Terra。这类任务通过率通常较高,重试少,低单价的优势更容易体现出来。批量、重复性高的处理任务也适合先用 Terra,总量一大,单价的差异会被放大。
跨模块的重构,或者依赖关系复杂的改动,建议先评估更强的模型。这类任务一旦失败,人工补救的成本很高,单次调用省下的那点钱不够填。
需求不清晰、缺少测试的任务,先补测试再选模型。没有验收标准,就没法算每个验收通过任务的成本,选哪个模型都只是凭感觉。
这套分法只是起点。更可靠的依据是自己的任务数据。先跑一批任务,算出每个验收通过任务的成本,再决定哪类任务交给哪个模型。
用 ServBay 固定验收环境
做成本对比时,环境差异会干扰结果。同一个 bug,换了语言版本或数据库版本,测试结果可能就不同。模型第一次失败,有时是代码写错了,有时只是依赖版本不一致,两种失败不应该混在一起计算。
ServBay 可以在本机固定 PHP、Node.js、Python 等语言版本,也能固定数据库和站点配置。验收环境固定后,各模型的每次尝试都在同一个条件下运行,尝试次数和通过率才有可比性。
而且 ServBay AI Gateway 适合作为本机统一入口,虚拟密钥调用,真密钥留在网关侧;用量、费用、延迟能汇总看,也能把 Claude Code、Codex 等切到同一本地入口。OpenAI / Anthropic / Gemini 兼容协议都有对应路径。
总结
Terra 把价格、速度和编程能力同时往前推了一步,这点从官方数据看是清楚的。但官方数据来自特定基准,自己的任务能不能省钱,要用自己的验收标准来回答。
模型竞争正在从比跑分转向比完成一项任务要花多少钱、多少时间、能否稳定交付。对开发者来说,更实用的做法是先拿一个可复现的 bug,记录每次尝试的 token 和人工时间,算出每个验收通过任务的成本,再决定选哪个模型。