一道 LeetCode 21,题面 Easy,现场却能照出你的边界处理、指针习惯和代码洁癖。
很多人 3 分钟写完,然后挂在这几个细节上:while条件写成||→ 空指针cur忘后移 → 链表只剩一个节点return dummy→ 结果凭空多出个-1这道题不是"会不会",而是"写得干不干净、扛不扛得住追问"。 这篇不灌水,按面试实战一条龙拆透:
✅ 30 秒破题 抓住"有序 → 归并 merge"的本质,先确认边界再动手
✅ 两种解法对比 迭代 + 哨兵节点(面试首选,O(1) 空间) 递归(优雅,但 O(m+n) 栈深有爆栈风险)
✅ 10 个高频踩坑 + 自检清单 建议截图,写完代码逐条过一遍
✅ 两个拉开差距的写法 Comparator 泛化 + 小顶堆 k 路合并 从 LeetCode 21 直接跃迁到 23
✅ 面试官 9 连追问 + 30 秒口述模板 被问就是送分
✅ 自测评级 优秀 / 合格 / 待改进,看看你在哪一档
适合谁:秋招春招刷题人、链表总翻车的同学、想从"会 AC"进阶到"有工程判断"的面试者。
读完至少带走三样 : 一套能背的迭代模板 一张避坑清单 一条从 LeetCode 21 → 88 → 23 → 148 的链表归并进阶路线
一句话记住: 哨兵节点兜住头,尾指针往后推,剩下一段一把接,O(m+n) 时间、O(1) 空间。
觉得有用先收藏 ,关注「算法198题」系列,每周更新。
今日互动 :你在链表题上踩过最离谱的坑是什么?造出了环,还是 return 了 dummy?
┌──────────────────────────────┐ │ 评论区聊聊 │ 点赞最高的坑,下期专门写一篇拆解 │ 👇 你的翻车经历,可能救一个秋招人 └──────────────────────────────┘
LeetCode 21 合并两个有序链表:一道 Easy 题,凭什么刷掉一半候选人?
上周帮朋友模拟面试,让他写 LeetCode 21「合并两个有序链表」。题不难,他三分钟就写完了------然后我翻开代码一看:while 条件写成 || 导致空指针、cur 忘后移导致链表只剩一个节点、最后 return dummy 结果里凭空多了个 -1。
这道题就是面试里的"照妖镜":题面 Easy,但你一动手,边界处理、指针习惯、代码洁癖全暴露。今天我把这道题从破题思路、两种解法、踩坑清单到面试官追问一条龙讲透,准备秋招春招的同学建议收藏,刷题老手也可以对照自查。
一、先读题:30 秒抓住关键信息
将两个升序 链表合并为一个新的升序 链表并返回。新链表是通过拼接给定两个链表的所有节点组成的。
| 题目要素 | 关键信息 |
|---|---|
| 输入 | 两个非递减 排序的单链表 l1、l2 |
| 输出 | 合并后依然有序的新链表头节点 |
| 核心约束 | 直接拼接原节点,不能复制值新建节点 |
| 数据范围 | 节点数 [0, 50],节点值 [-100, 100],可能为空、可能有重复值 |
几个示例感受下:
| 输入 | 输出 |
|---|---|
l1 = [1,2,4], l2 = [1,3,4] |
[1,1,2,3,4,4] |
l1 = [], l2 = [] |
[] |
l1 = [], l2 = [0] |
[0] |
面试时拿到题,别急着写。先主动跟面试官确认三点,好感度直接拉满:
"我先确认下:① 两个链表本身有序,所以可以用双指针归并;② 节点数可能是 0,要处理空链表;③ 题目说'拼接所有节点',我理解为原地重排指针,不需要 new 新节点,空间可以做到 O(1)。"
就这一句话,面试官已经知道你是个有工程意识的人了。
二、破题:这题的本质是什么
实际开发中我们经常会遇到"两路有序数据流合并"的场景------合并两个有序日志流、数据库归并查询、归并排序的 merge 步骤。这道题本质就是归并排序里 merge 那一步的链表版。
打个比方:你手上有两副已经排好序的扑克牌,每次比较两叠牌最上面那张,小的抽出来放到新牌堆,直到有一叠抽空,另一叠整体扣上去就行。
动手之前,先想清楚 3 个问题:
- 两个链表都有序 → 天然归并场景,双指针从前往后扫,不需要重新排序;
- 结果头节点不确定 → 头来自 l1 还是 l2 取决于首轮比较,得用哨兵节点兜住,避免特判;
- 一方走完后怎么办 → 另一方剩下的本来就排好序了,整段一把接上,别再逐个比较。
顺便补一句数据结构常识:单链表节点 = 数据域 val + 指针域 next,节点在内存里不连续,靠 next 串起来,只能单向往后走------这正是合并时必须保留位置指针的原因。
三、解法一:迭代 + 哨兵节点(面试首选)
核心思想
用 哑节点(dummy) 当哨兵头,规避头节点判空的麻烦;用 cur 指针始终指向结果链表的尾部,双指针同时遍历两条原链表,谁小接谁;最后把没走完的整条链表直接拼在尾部。
一句话总结:谁小接谁,接完往后挪。
为什么非要 dummy?
很多人翻车不是翻在逻辑,是翻在"返回哪个节点"。不引入哨兵的话,结果链表的头是动态确定的,你得在循环外额外写 if (head == null) 分支去记录头节点,代码又丑又容易漏。
哨兵的作用,就是在真正的头节点前面放一个占位假人 (就像排队时先放个假人占队首),让"接节点"这个动作从头到尾统一成 cur.next = xxx,最后 return dummy.next 完事。
哨兵节点的本质:用一个无意义的前置节点,换掉一整个边界分支。代码量和出错率双降。
合并过程图解
以 l1=[1,2,4]、l2=[1,3,4] 为例,整个流程长这样:

再看指针层面的三步固定节奏:
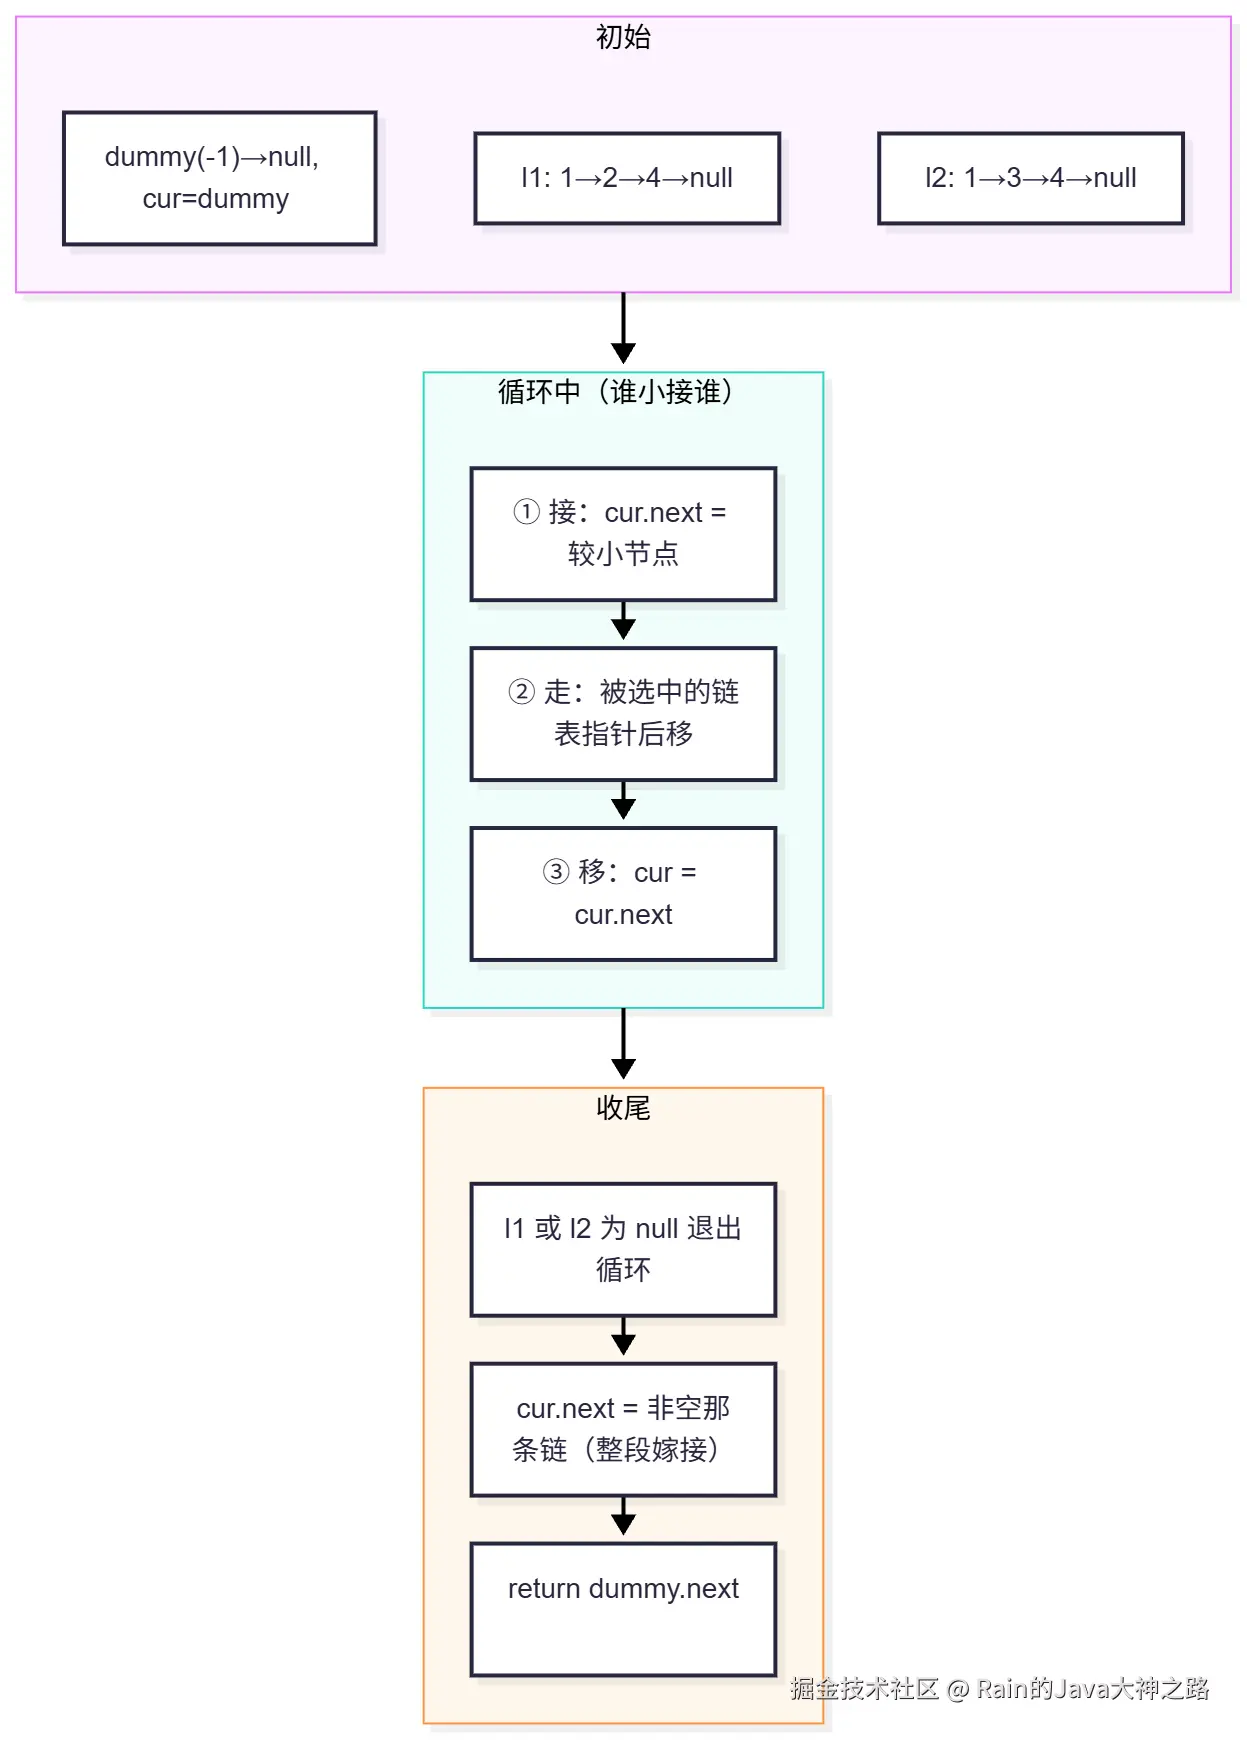
核心代码(Java)
java
/**
 * Definition for singly-linked list.
 * public class ListNode {
 *     int val;
 *     ListNode next;
 *     ListNode() {}
 *     ListNode(int val) { this.val = val; }
 *     ListNode(int val, ListNode next) { this.val = val; this.next = next; }
 * }
 */
class Solution {
    public ListNode mergeTwoLists(ListNode l1, ListNode l2) {
        // ① 哨兵节点:统一头节点逻辑,彻底消灭空指针特判
        ListNode dummy = new ListNode(-1);
        ListNode cur = dummy;              // cur 始终指向结果链表尾部

        // ② 双指针共同遍历,谁小接谁
        while (l1 != null && l2 != null) {
            if (l1.val <= l2.val) {        // ③ 用 <=,等值取 l1,保证稳定性
                cur.next = l1;
                l1 = l1.next;              // 被选中的链表指针后移
            } else {
                cur.next = l2;
                l2 = l2.next;
            }
            cur = cur.next;                // ④ 尾指针同步后移
        }

        // ⑤ 剩余段一次接完,无需再循环
        cur.next = (l1 != null) ? l1 : l2;

        return dummy.next;                 // ⑥ dummy 只是工具人,不进入结果
    }
}
这段代码的四个技术亮点
| 亮点 | 说明 | 收益 |
|---|---|---|
| 哨兵节点 dummy | 用假头统一所有插入逻辑 | 消灭"第一次插入"特判,分支少一半 |
| 剩余段一把接 | cur.next = (l1 != null) ? l1 : l2 |
循环内不用管收尾,别拿循环做 O(1) 能做的事 |
| 原地复用节点 | 只改 next 指针,不 new |
满足题目"拼接"要求,空间 O(1) |
<= 保稳定 |
等值时优先取 l1 | 等值节点相对顺序不乱 |
这里重点说下 <=:一个等号之差,体现的是稳定排序 意识。多字段排序、合并日志流这类生产场景里,稳定性是硬要求。面试官看到你用 <= 还能讲出为什么,会眼前一亮。
四、解法二:递归法(优雅,但有代价)
核心思想
递归的思维方式是"当前这一步做什么,剩下的交给下一层 ":每次选出两个头节点中较小的那个,让它的 next 指向"剩下两条链表的合并结果",层层递归直到其中一条为空。
三要素拆开看:
- 终止条件 :
l1 == null返回l2;l2 == null返回l1 - 本级逻辑 :头节点谁小,谁的
next指向"剩余部分合并的结果" - 返回:当前较小节点作为本层结果的头
java
class Solution {
    public ListNode mergeTwoLists(ListNode l1, ListNode l2) {
        // 递归出口:任一链表为空,直接返回另一条
        if (l1 == null) return l2;
        if (l2 == null) return l1;

        // 选小节点,递归合并剩余部分
        if (l1.val <= l2.val) {
            l1.next = mergeTwoLists(l1.next, l2);
            return l1;
        } else {
            l2.next = mergeTwoLists(l1, l2.next);
            return l2;
        }
    }
}
递归的精妙之处在于"信任":我信任 mergeTwoLists(剩下的部分) 一定能返回有序链表,所以我只需要决定当前谁当头------这就是分治 + 数学归纳的思想。
整个调用栈的展开和回溯过程:
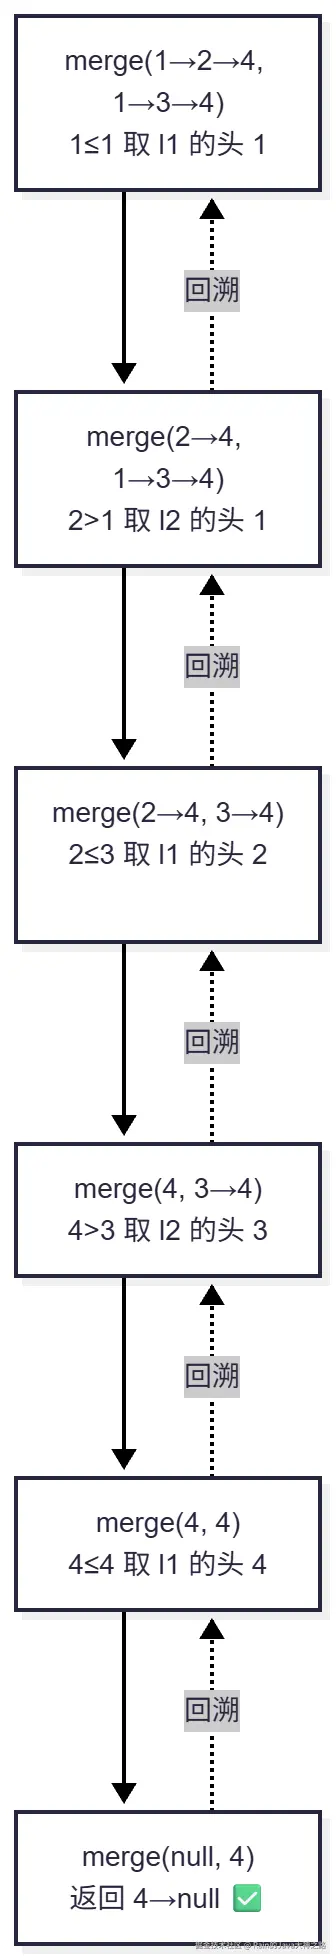
递归的隐藏工程隐患:栈溢出
时间复杂度同样是 O(m+n),每个节点最多处理一次。但空间复杂度是 O(m+n) ------递归深度等于合并后链表的长度,每一层调用都在 JVM 栈上占一个栈帧。
注意:这不是"额外数组"级别的空间,是调用栈的空间。 JVM 默认栈大小约 512KB~1MB,每层栈帧占几十到上百字节,链表长度到 10 万级,递归版本直接
StackOverflowError。
本题节点数 ≤ 50,递归没有实际风险。但生产环境或链表长度不可控时,迭代是工程上的默认答案,递归只是用来展示思维清晰度的。
五、两种解法对比与选型
| 维度 | 迭代法(哨兵 + 尾插) | 递归法 |
|---|---|---|
| 时间复杂度 | O(m+n) 一次遍历 | O(m+n) 每层处理一个节点 |
| 空间复杂度 | O(1) 原地合并 ✅ | O(m+n) 递归栈开销 ⚠️ |
| 代码简洁度 | 中等,逻辑直观 | 极简,核心 4 行 |
| 栈溢出风险 | 无 ✅ | 长链表会爆栈 💥 |
| 生产可用性 | 首选 | 需评估数据规模 |
| 面试推荐度 | ⭐⭐⭐⭐⭐ 标准答案 | ⭐⭐⭐ 加分补充 |
面试话术直接背:
"我先写迭代版,空间 O(1)、没有栈溢出风险,是工程标准答案。递归我也能写,代码更短,但栈深 O(m+n),数据量大有爆栈风险,所以生产上我选迭代。"
既展示广度,又体现工程判断力。这种"有层次的思考"比 AC 本身更有含金量。
六、技术难点与踩坑大全(重点,建议截图)
下面这张表是我把历年面试里真实翻过的车汇总出来的,每一个都对应具体的解决方案:
| # | 难点 | 为什么容易错 | 解决方案 |
|---|---|---|---|
| 1 | 头节点归属不确定 | 结果头来自 l1 还是 l2 取决于首轮比较,需要一堆特判 | 引入哨兵节点 dummy,最后 return dummy.next 统一收口 |
| 2 | 空链表 / 一长一短 | 直接访问 l1.val 抛 NPE |
while 条件保证双非空;剩余段整段嫁接,自动兼容单空、双空所有场景 |
| 3 | 指针顺序写反 → 断链 | 先移动 l1 再接节点,或先取 l1.next 再移动,直接丢节点 |
固定套路:先接 cur.next → 再走 l1 = l1.next → 后移 cur = cur.next,三步顺序不能乱 |
| 4 | 忘了移动 cur → 覆盖/死循环 | 只在某个分支里移动 cur,下一次赋值覆盖上一次的连接,链表只剩一个节点 | cur = cur.next 统一放循环末尾,别放进 if/else |
| 5 | 循环条件写错 | 写成 `while (l1 != null | |
| 6 | 等值节点稳定性丢失 | 用 < 导致相等元素跨链表乱序 |
用 <=,等值优先取 l1 |
| 7 | 习惯性 new 节点 | 把值复制到新节点,空间变 O(n) 还破坏原链表 | 原地改指针复用节点,这是 O(1) 空间的关键 |
| 8 | 递归栈溢出 | 递归深度 = m+n,长链表爆栈 | 生产用迭代;必须递归时说明"可改写为迭代" |
| 9 | 误造环 | 用"头插法"合并,指针接错导致链表成环死循环 | 坚持尾插法,绝不 new 数据节点 |
| 10 | k 路扩展超时 | k 个链表两两顺序合并,O(k·N) 超时 | 堆 / 分治降到 O(N log k),见下文 |
再附一份面试翻车自检清单,写完代码对着过一遍:
- ❌ 把值倒进数组排序再新建链表 → 空间 O(n)、破坏原结构、完全没体现链表操作,直接扣分
- ❌
if (dummy = new ListNode(-1))→ 赋值写成了判断,经典笔误 - ❌ 循环里漏了
cur = cur.next→ 结果卡在第二个节点或死循环 - ❌ 没判空就访问
l1.val→ 空指针异常 - ❌ 返回
dummy而不是dummy.next→ 结果凭空多一个 -1 - ❌ 循环结束后再写 while 逐个搬剩余节点 → 画蛇添足
七、拉开差距的两个亮点写法
如果你的目标是大厂 SSP,光写对不够。下面两段代码是我在实际面试辅导里最推荐的"秀肌肉"姿势。
亮点 1:Comparator 泛化------从"刷算法"到"写中间件"
把"比较规则"抽出去,对象链表、倒序合并都能复用:
java
public static ListNode merge(ListNode a, ListNode b, Comparator<ListNode> cmp) {
    ListNode dummy = new ListNode(0), tail = dummy;
    while (a != null && b != null) {
        if (cmp.compare(a, b) <= 0) { tail.next = a; a = a.next; }
        else                        { tail.next = b; b = b.next; }
        tail = tail.next;
    }
    tail.next = (a != null) ? a : b;
    return dummy.next;
}
面试官内心 OS:这人有抽象意识,不是背题的。 一个
Comparator参数,直接把一道算法题写出了中间件的味道。
亮点 2:k 路合并------优先队列版
这是从 21 题到 23 题的唯一正确跃迁姿势,哨兵写法原封不动复用:
java
public ListNode mergeKLists(ListNode[] lists) {
    PriorityQueue<ListNode> pq =
        new PriorityQueue<>(Comparator.comparingInt(n -> n.val));
    for (ListNode h : lists) if (h != null) pq.offer(h);   // k 个头进堆

    ListNode dummy = new ListNode(0), tail = dummy;
    while (!pq.isEmpty()) {
        ListNode cur = pq.poll();
        tail.next = cur;
        tail = cur;
        if (cur.next != null) pq.offer(cur.next);          // 后继补位
    }
    return dummy.next;
}
时间复杂度 O(N log k),N 为总节点数。
八、面试官追问集(提前准备好,被问就是送分)
Q1:为什么用哨兵节点?不用行不行?
行,但得多写一个 if (head == null) 分支记录头节点。哨兵的本质是用一点点额外空间换掉一整个边界分支,代码更短、更不容易错。
Q2:递归的空间复杂度说清楚。
递归深度等于 m+n,每层一个栈帧,空间 O(m+n)。链表节点百万级时递归版本直接崩,所以生产用迭代。
Q3:合并 K 个有序链表(LeetCode 23)怎么做?
三种思路对比:
| 方案 | 思路 | 时间复杂度 | 评价 |
|---|---|---|---|
| 依次两两合并 | 反复调用本题函数 | O(k·N) | 慢,数据量大超时 |
| 小顶堆 | 维护 K 个当前最小节点 | O(N log k) | 推荐 ✅ |
| 分治两两归并 | 像归并排序一样折半合并 | O(N log k) | 最优,对内存更友好 |
Q4:合并后要去重呢?
遇到 l1.val == l2.val 时,接一个节点、两个指针都后移,跳过重复即可。
Q5:链表是降序的怎么办?
两条路:① 各自反转后归并,视需要再反转回来;② 比较逻辑改成取大的先接,最后整体反转一次。
Q6:合并两个有序数组(LeetCode 88)和本题有什么区别?
数组版要从后往前填,避免覆盖未处理的元素;链表版只改指针没有覆盖问题,从前向后接即可。另外归并排序在数组上 merge 需要 O(n) 辅助数组,在链表上改指针原地完成,空间反而降到 O(1)。
Q7:如果原链表不允许修改,只能用新节点呢?
那就不能原地改指针,得 new ListNode 复制值再拼接,空间退化为 O(m+n)。
Q8:链表版归并排序(LeetCode 148)怎么写?
快慢指针找中点 → 断开 → 分别排序 → 调用本题的 merge 合并。本题就是它的地基。
Q9:单链表和双链表在这题上有区别吗?
双链表可以直接在尾部 O(1) 插入、支持反向遍历;单链表只能靠 dummy + tail 维护尾指针。
九、30 秒口述模板(背下来直接用)
"这题本质是归并排序的 merge 步。我用双指针 + 哨兵节点 做:dummy 消除头节点特判,循环里谁小接谁,用
<=保证稳定性;退出循环后剩余段直接整体嫁接,因为原链表已有序。时间 O(m+n),额外空间 O(1),属于原地重排。另外还有递归写法,代码更短但栈深 O(m+n),数据量大有爆栈风险,所以工程上我选迭代。如果扩展成 k 路,我会用小顶堆或分治,复杂度 O(N log k)。"
写完代码后,还可以主动补一句边界分析:"我注意了几个边界情况:l1 空、l2 空、都为空、一长一短、节点值相等------dummy + 三目运算符这套写法天然全部兼容。"不要等面试官问,主动说,好感度拉满。
最后附上面试官的评级视角,你可以自测一下自己在哪一档:
| 评级 | 表现 |
|---|---|
| 🟢 优秀 | 迭代版一次写对 + 主动提稳定性 + 能推 k 路 |
| 🟡 合格 | 能写出合并逻辑,但头节点处理啰嗦 |
| 🔴 待改进 | 新建节点拼接 / 忘记返回 dummy.next / 造出环 |
写在最后
这道题的精华不在代码长度,而在三个工程思维:用 dummy 消灭边界分支、识别"有序 → 归并"的算法本质、根据数据规模在迭代和递归之间做取舍。如果现场只剩 3 分钟,交迭代版;如果有 10 分钟,把递归和小顶堆的演进路径一并讲出来。
一句话收尾:哨兵节点兜住头,尾指针往后推,剩下一段一把接,O(m+n) 时间、O(1) 空间。
关联题目一并放这,建议按顺序刷:LeetCode 21(本题)→ LeetCode 88 合并两个有序数组 → LeetCode 23 合并K个升序链表 → LeetCode 148 排序链表,再加一道剑指 Offer 25,这条链表归并线就完整了。
觉得有用的话点个关注,这个「算法198题」系列每周更新,从链表、二叉树到动态规划一路讲到系统设计。
每周两篇,更多算法题在:mp.weixin.qq.com/mp/appmsgal...
今日互动:你在链表题上踩过最离谱的坑是什么?是造出了环,还是 return 了 dummy?评论区聊聊,点赞最高的坑我下期专门写一篇拆解。