接手启明英语的批改模块后,我干的第一件事是把第 2 篇那套人格提示词接进业务,然后立刻撞上了下一堵墙。
模型的回答真的变规整了:错在哪、为什么、怎么改,三段清清楚楚,老师看了都说好。但产品那边给我的需求单是这么写的:
- 批改结果要进错题本,每个错误一条记录;
- 小程序端要渲染成卡片:原文一行、改正一行、解释一行;
- 运营每周要按错误类型统计,时态错几条、冠词错几条,画柱状图。
这三件事有一个共同前提:程序得知道"哪一段是 original、哪一段是 corrected、error_type 是哪个值"。而模型给的是一段格式漂亮的散文,字符串里什么都有,就是没有字段。
我第一版的处理方式很朴素:正则。original[:10] 抠"原文:"后面的内容,re.findall 抠"类型:时态"。上线第三天,运营跟我说统计图不对------我查了半天日志才发现,那天模型心情好,把"类型:时态错误"多写了俩字,正则没兜住。
更糟的是这类 bug 不报错。正则抠不到就给空字符串,空字符串默默写进错题本,等到老师打开小程序看到一张没有改正内容的卡片,问题已经过去两天了。
这篇就把这件事一次解决:让模型按我们定义的结构回答,拿回来直接是能 .model_dump() 入库的对象,而不是一坨等着被正则肢解的文本。
一、先扫盲:为什么"请输出 JSON"这句话没用
我的第一反应特别典型:在 system prompt 里加一句"请以 JSON 格式输出"。加完之后,失败率从"天天错"降到了"偶尔错"------对要进数据库的数据来说,偶尔错等于天天错。
因为这句话只表达了愿望,没有表达规格。翻翻失败日志,翻车姿势其实就那么几种:
- 没说字段叫什么。 我要的是
error_type,模型给你"type"、"错误类型",甚至"category",全看它当天想起哪个词。 - 前后缀寒暄。 "好的,这是批改结果:" 打头,结尾再补一句"希望对你有帮助"。整段不再是合法 JSON,
json.loads直接抛异常。 - 中文引号和尾逗号。 模型偶尔把
"写成",或者在最后一个字段后面留个逗号。人眼看不出问题,解析器一刀毙命。 - 取值越界。 我要 severity 是 1 到 3,它给你 5,还振振有词。字符串阶段你根本拦不住。
真正的解法是把"规格"从希望变成契约:先用代码定义数据长什么样,再让框架把这份定义翻译给模型,最后拿到回答时按同一份定义校验。落地方式有三种,从糙到精:
| 方式 | 做法 | 问题 |
|---|---|---|
提示词 + json.loads 自己抠 |
在 prompt 里手写一段 JSON 示例,回答回来自己解析 | 说明书手写,字段和约束全靠嘴说,解析要自己兜底 |
PydanticOutputParser |
框架从 Pydantic 类自动生成格式说明书塞进提示词,回答回来按 schema 校验 | 模型仍是自由文本,偶尔夹带寒暄,需要重试兜底 |
with_structured_output() |
框架把 schema 转成工具(function calling)发给模型,模型"填参数" | 失败率最低,但要求模型支持工具调用 |
第三种是首选,第二种是备胎。我们工程里两条都实现了,因为私有部署的小模型不支持 function calling 的场景真实存在------客户环境不归你挑。
二、工程目录
settings.py 和 llm.py 与第 1 篇完全一致,原样复用,一个字没改。新增的部分按职责拆成六个文件:
bash
04-结构化输出/
├── src/
│   ├── settings.py   # 复用第 1 篇
│   ├── llm.py        # 复用第 1 篇
│   ├── schema.py     # 数据契约:ErrorItem / Correction
│   ├── parser.py     # 两条通路 + 解析,返回统一的结果类型
│   ├── validate.py   # 业务校验:pydantic 管不了的那几条
│   ├── repair.py     # 解析失败重试闭环
│   ├── store.py      # JSONL 错题本 + 按类型统计
│   └── fakes.py      # 离线假模型(支持工具通路)
├── tests/            # 39 个用例,离线全绿
├── demo.py
└── pytest.ini一句话概括数据流向:模型 → parser(结构对不对)→ validate(内容对不对)→ store(入库),repair 横在 parser 失败的地方兜底。
三、schema.py:契约先于代码
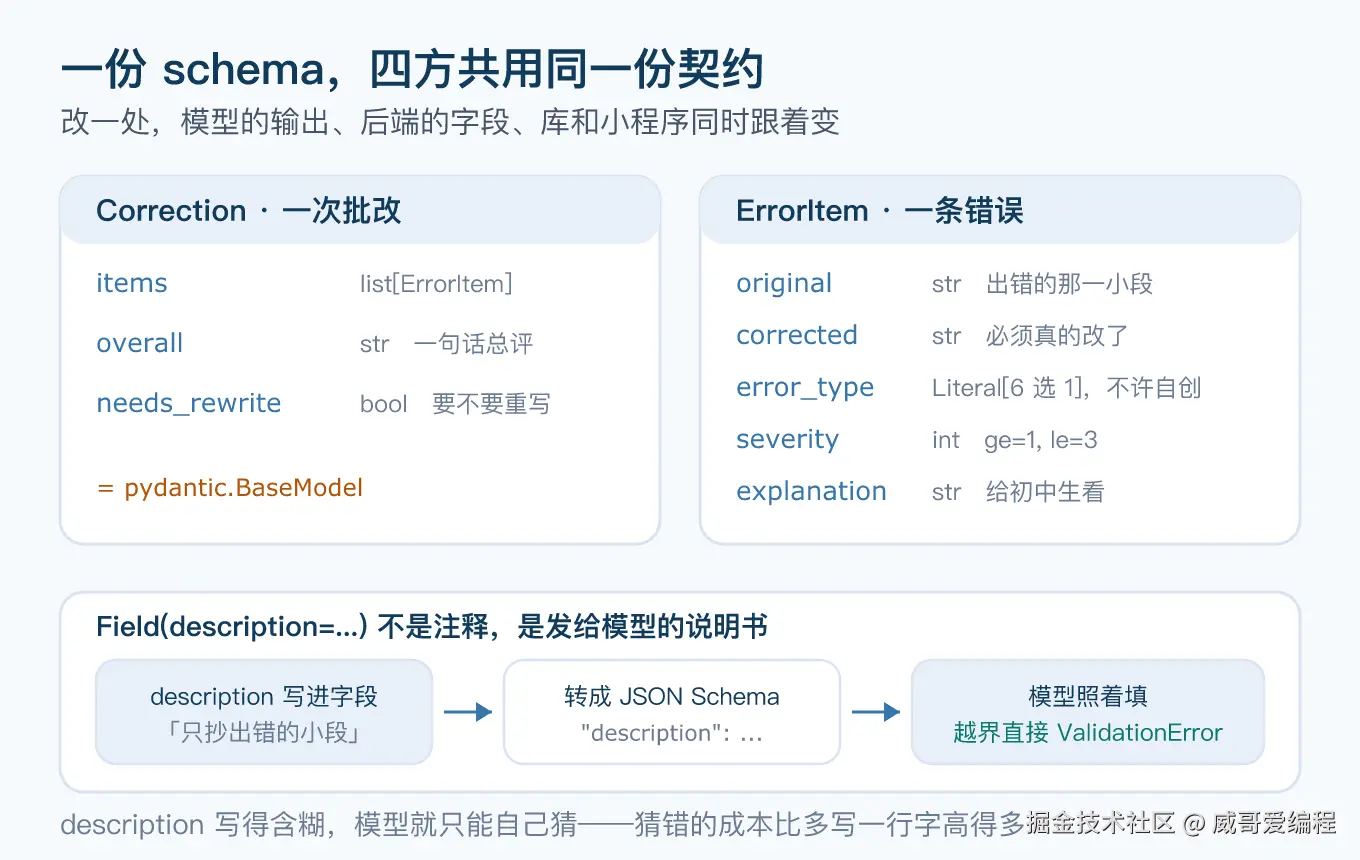
为什么第一个文件是 schema?因为这一篇的核心动作是把四方拉到同一份定义前:模型按它输出,后端按它入库,小程序按它渲染,周报按它统计。schema 单独成文件,谁都能 import,改一处四处生效。字段名要是散落在各个函数里,改一个字段等于四处漏风。
python
# 错误类型的候选集。用 Literal 而不是 str,等于把"能不能自创类型"
# 的决定权从模型手里拿回来:越界就报错,而不是悄悄写进数据库。
ERROR_TYPES = Literal["时态", "主谓一致", "冠词", "介词", "拼写", "其他"]

class ErrorItem(BaseModel):
    """一条错误:原文片段、改正片段、类型、解释、严重程度。"""
    original: str = Field(
        description="学生原句里出错的那一小段,不要整句照抄"
    )
    corrected: str = Field(
        description="与 original 逐词对应的正确写法,必须真的改了,不能原样照抄"
    )
    error_type: ERROR_TYPES = Field(
        description="只能从「时态/主谓一致/冠词/介词/拼写/其他」里挑一个,不许自创"
    )
    explanation: str = Field(
        description="面向初中生的中文解释,一句话说清为什么错"
    )
    severity: int = Field(
        ge=SEVERITY_MIN, le=SEVERITY_MAX,
        description="严重程度:1=轻微不影响理解,2=影响理解,3=完全看不懂",
    )
这里我最想强调的是 Field(description=...)。它不是写给你自己的注释------pydantic 会把它转进 JSON Schema,跟着请求一起发给模型 。字段名叫 original,模型不知道你要它抄整句还是抄出错的小段;description 里写一句"只抄出错的那一小段",输出质量立刻不一样。这是我全篇性价比最高的一行字,改文案就能调输出,不用动任何逻辑。
Correction 是外层:
python
class Correction(BaseModel):
    """一次批改的完整结果:错误清单 + 总评 + 要不要重写。"""
    items: list[ErrorItem] = Field(
        default_factory=list,   # 模型在"没错误"时经常直接省略这个字段
        description="错误清单,一个错一条;句子没毛病就给空数组 []",
    )
    overall: str = Field(description="一句话总评,直接说给学生听")
    needs_rewrite: bool = Field(
        description="整句是否需要重写:items 为空时必须给 false"
    )
items 给默认值不是偷懒,是防御:模型对"零错误"的处理出奇地不稳定,有时给 [],有时干脆不写这个字段。不给默认值,后者直接 ValidationError,重试一次就多花一次钱。
四、parser.py:两条通路,一个出口
先说清楚一个容易误判的点:with_structured_output() 失败了不会抛异常------模型跑题写散文、压根没调工具时,LangChain 会安静地返回 None 。不做拦截,None 会一路流到错题本。所以两条通路我都包了一层,统一返回一个结果对象:
python
@dataclass(frozen=True)
class ParseOutcome:
    """一次解析的完整结果:成了没、模型原话、错在哪。"""
    correction: Correction | None = None
    raw: str = ""              # 模型原话,重试时要原样贴回给它看
    error: str | None = None   # 失败原因,压成一句话

    @property
    def ok(self) -> bool:
        return self.correction is not None
通路一,工具通路:
python
def try_parse_chain(llm, messages) -> ParseOutcome:
    # include_raw=True 是为了失败时不丢证据:
    # raw 里有模型原话,parsing_error 里有错因,都是重试时要贴回去的东西
    structured = llm.with_structured_output(Correction, include_raw=True)
    result = structured.invoke(messages)

    if result["parsed"] is None and result["parsing_error"] is None:
        # 模型没调工具(跑题写散文)时 LangChain 不报错,静默给 None
        error = "模型没有按 Correction 的结构回答(没调用工具)"
    return ParseOutcome(correction=result["parsed"], raw=_snapshot(result["raw"]), error=error)
通路二,提示词通路,用 PydanticOutputParser:
python
_PROMPT_PARSER = PydanticOutputParser(pydantic_object=Correction)

def build_format_prompt() -> ChatPromptTemplate:
    return ChatPromptTemplate.from_messages([
        ("system", SYSTEM_PROMPT),
        ("human", "请批改这个句子:{sentence}\n\n{format_instructions}"),
    # format_instructions 里全是花括号,写进模板正文会被当成占位符炸掉,
    # 必须用 .partial() 预填
    ]).partial(format_instructions=_PROMPT_PARSER.get_format_instructions())
两条通路的差别值得说透:工具通路里 schema 变成了 function calling 的参数定义,模型是在"填表",字段名和取值范围由接口层面约束;提示词通路里 schema 被翻译成一段自然语言说明书(get_format_instructions() 生成的那 1700 多字符),模型是在"读说明书写作文",然后我们拿着同一份 schema 验收。前者失败率低,后者哪都能用。
对外的一次性入口各一个,失败抛自己的异常:
python
def parse_with_chain(llm, sentence) -> Correction:   # 工具通路
def parse_with_prompt(llm, sentence) -> Correction: # 提示词通路五、validate.py:过了 pydantic 不等于能入库
写这层的时候我想明白了一件事:pydantic 管的叫"类型合法",severity 是不是 1~3、error_type 在不在候选集里;但"业务合法"它管不了------改了等于没改、标了拼写却改得面目全非、说要重写却一条错误都没挑出来。这些规则只有做这个产品的人知道,只能自己写代码查。
python
MAX_SPELL_EDIT_DISTANCE = 3   # 拼写错嘛,差一两个字母;差十个的那叫改写

def validate_item(item: ErrorItem, index: int) -> list[str]:
    problems = []
    # 规则一:改了等于没改。模型偷懒时会把原句原样抄一遍充数,这条最常见
    if item.original.strip() and item.original.strip() == item.corrected.strip():
        problems.append(f"第 {index} 条:original 和 corrected 完全一样,等于没改")

    # 规则二:标成拼写,两个片段却差得很远,多半是类型标错了
    if item.error_type == "拼写" and item.original and item.corrected:
        d = edit_distance(item.original.lower(), item.corrected.lower())
        if d > MAX_SPELL_EDIT_DISTANCE:
            problems.append(f"第 {index} 条:标成了拼写错误,但相差 {d} 个字符")

    return problems

def validate_correction(correction: Correction) -> list[str]:
    problems = []
    for index, item in enumerate(correction.items, start=1):
        problems.extend(validate_item(item, index))
    # 规则三:一句错误都没挑出来,needs_rewrite 却是 true,自相矛盾
    if not correction.items and correction.needs_rewrite:
        problems.append("一句错误都没挑出来,needs_rewrite 却是 true,自相矛盾")
    return problems
返回"问题列表"而不是抛异常,是刻意的:列表可以直接拼进重试提示词告诉模型"你哪儿错了",也可以原样进日志给运营看。编辑距离不引第三方库,十几行动态规划写清楚,比多一条依赖好维护。
这层是最后一道闸门,过了它才能进数据库。
六、repair.py:重试不是再说一遍"请输出 JSON"
解析失败怎么补救?大多数人的第一版是在外面套个 while True,失败就重发一遍原请求。我也写过,然后发现模型会非常配合地把同一个错误再犯一遍------你不说它错哪了,它凭什么改?
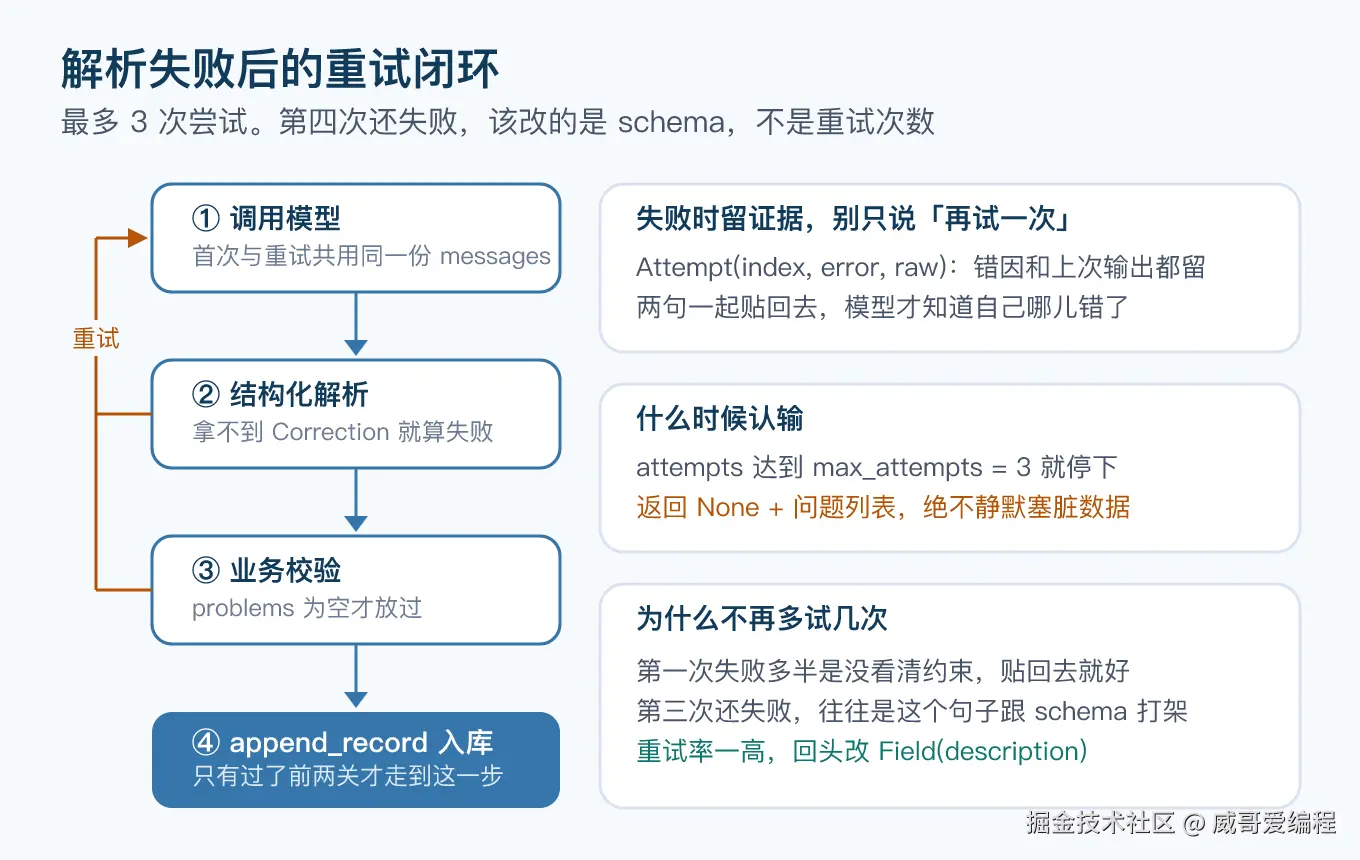
正确的闭环是把错因 + 上次输出一起贴回去:
python
RETRY_TEMPLATE = """上一次的输出没有通过校验,问题如下:
{problems}

你上一次输出的是:
{raw}

请重新来一遍。要求:
1. 补齐缺失字段,字段值必须在允许范围内(比如 severity 只能是 1、2、3)
2. 不要输出任何解释性前后缀,也不要用 Markdown 代码块包裹
3. 如果你认为的确没有错误,就给空的 items,并把 needs_rewrite 设为 false
"""

def analyze(llm, sentence, *, use_chain=True, max_attempts=DEFAULT_MAX_ATTEMPTS):
    messages = (TOOL_PROMPT if use_chain else build_format_prompt()).format_messages(sentence=sentence)
    attempts = []

    for index in range(1, max_attempts + 1):
        outcome = try_parse_chain(llm, messages) if use_chain else try_parse_prompt(llm, messages)

        if outcome.ok:
            # 结构对了不代表内容对,业务校验在这一道闸门后面等着
            problems = validate_correction(outcome.correction)
            if not problems:
                return RepairOutcome(correction=outcome.correction, attempts=attempts)
            error_text = ";".join(problems)
        else:
            error_text = outcome.error

        attempts.append(Attempt(index=index, error=error_text, raw=outcome.raw))
        if index < max_attempts:
            # 两个都要给:只说错在哪,模型不知道自己写了什么;
            # 只贴上次的,它会当成新句子重新批改一遍
            messages = messages + [_retry_message(error_text, outcome.raw)]

    return RepairOutcome(correction=None, attempts=attempts, problems=[error_text])
注意业务校验失败也走同一个闭环------"结构合法的脏数据"恰恰是最危险的,重试是它的唯一出口。
为什么最多 3 次(首次 + 2 次重试)就认输,不无限重试?三个理由。收益断崖式下跌 :第一次失败通常是模型漏看约束,贴回去马上改对;第三次还失败,往往是这个句子本身跟 schema 打架,再试也是同一个结局。成本线性上涨 :一次重试就是一次完整的输入加输出计费,批改这种短任务,重试两次的钱接近正常批改的三倍,真要省钱该去改 description 而不是堆次数。掩盖真问题 :如果某类句子总是要重试才成功,那不是重试的功劳,是 schema 写得不好------attempts 留痕就是用来发现这件事的,重试率一高,回头改 Field(description)。
认输时返回 None 加问题列表,绝不含糊。宁可让上层走"转人工",也不静默塞一条脏数据进错题本。
七、store.py:JSONL 落地
python
def append_record(correction: Correction, path: Path = DEFAULT_PATH) -> None:
    # 一行一条,中文不转义,运营用编辑器打开就能直接看
    with Path(path).open("a", encoding="utf-8") as handle:
        handle.write(json.dumps(correction.model_dump(), ensure_ascii=False))
        handle.write("\n")

def count_by_type(records: list[Correction]) -> dict[str, int]:
    # 固定六个 key,没出现过的类型补 0:画图的时候少一个 key 就得写 if 分支
    counts = {error_type: 0 for error_type in ERROR_TYPE_ORDER}
    for correction in records:
        for item in correction.items:
            counts[item.error_type] = counts.get(item.error_type, 0) + 1
    return counts
为什么是 JSONL 不是一个大 JSON 数组?一行一条,写只管 append,不用整文件读出来改完再写回去;wc -l 就知道批改次数,流式聚合也不撑内存。哪天要换数据库,把 append_record 里两行换成 INSERT,上层一行不动------这就是先把 Correction 定成契约的回报。
还有一个不起眼但必须有的角色是 fakes.py:LangChain 自带的假模型没有实现 bind_tools,而 with_structured_output() 开头就检查这个能力,所以离线模式得自己写一个二十行的假模型------绑了工具就把预置 JSON 伪装成 tool_calls,没绑就原样吐文本。没有它,两条通路都没法离线测试。
八、跑起来:真实输出
../_venv/bin/python demo.py。说明:本机没配 API Key,demo 全程走离线假模型,三条链路的"模型回答"都是预置的脚本,包括那条解析失败------这是刻意的,演示目的是看清链路每一步的形态,不是展示模型能力。
css
────────────────────────────────────────────────────────────────────
第 4 篇演示 · 结构化输出(全部离线,不需要 API Key)
────────────────────────────────────────────────────────────────────

0. 格式说明书(由 schema 自动生成,节选)
  长度: 1766 字符
  说明书里是否写了 severity 的取值范围: True

1. 正常链路 · 工具通路 with_structured_output
  学生句子:I go to the park yesterday and eat a apple.
  返回类型:Correction(不是字符串,是一个对象)
  总评:句子能看懂,主要卡在时态和冠词上,先记住过去时间要用过去式。
  是否需要重写:True
  错误条数:2
    [1] 时态 · 严重程度 2
        原文:I go to the park
        改正:I went to the park
        解释:yesterday 是过去时间,动词要用过去式
    [2] 冠词 · 严重程度 1
        原文:a apple
        改正:an apple
        解释:apple 以元音开头,不定冠词要用 an
  业务校验: 通过,可以入库

2. 业务校验 · 结构全对,内容却是脏的
  pydantic 校验:通过(返回 Correction,类型完全合法)
  业务校验:发现 2 个问题
    ✗ 第 1 条:original 和 corrected 完全一样('Yesterday I go there'),等于没改
    ✗ 第 2 条:标成了拼写错误,但两个片段相差 49 个字符,超过阈值 3,类型标错了还是改太多了
  处理方式:拦下,不入库,转人工或触发重试

3. 重试闭环 · 提示词通路,第一次解析失败
  学生句子:She don't like the coffee what I made.
  重试次数:1(上限之内)
    第 1 次失败原因:Invalid json output: 好的,这是批改结果,希望能帮到你: ...
  最终结果:成功
    [1] 主谓一致 · 严重程度 2
        原文:She don't like
        改正:She doesn't like
    [2] 其他 · 严重程度 2
        原文:the coffee what I made
        改正:the coffee that I made

4. 入库 · JSONL 错题本
  文件:错题本.jsonl 行数:2(一行一条)
  按错误类型统计:
    时态     1  █
    主谓一致 1  █
    冠词     1  █
    介词     0
    拼写     0
    其他     1  █
  错误总数:4 批改次数:2
第 2 段是我最想让你盯着的:pydantic 说它完全合法,业务校验拦得干干净净。这就是"类型合法"和"业务合法"的区别,两层缺一不可。
九、真实 pytest 输出
bash
$ ../_venv/bin/python -m pytest --capture=no -p no:cacheprovider -v
tests/test_parser.py::test_chain_path_returns_correction_object PASSED
tests/test_parser.py::test_prompt_path_returns_correction_object PASSED
tests/test_parser.py::test_two_paths_produce_same_result PASSED
tests/test_parser.py::test_format_instructions_contain_field_names PASSED
tests/test_parser.py::test_format_prompt_carries_instructions PASSED
tests/test_parser.py::test_prompt_path_fails_on_prefix_chatter PASSED
tests/test_parser.py::test_chain_path_reports_runaway_model PASSED
tests/test_parser.py::test_chain_path_reports_field_error PASSED
tests/test_parser.py::test_parse_with_chain_raises_on_failure PASSED
tests/test_repair.py::test_first_try_success_does_not_retry PASSED
tests/test_repair.py::test_retry_after_parse_failure PASSED
tests/test_repair.py::test_retry_message_carries_reason_and_previous_output PASSED
tests/test_repair.py::test_gives_up_after_max_attempts PASSED
tests/test_repair.py::test_business_validation_also_triggers_retry PASSED
tests/test_repair.py::test_max_attempts_one_disables_retry PASSED
tests/test_repair.py::test_prompt_path_also_repairs PASSED
tests/test_schema.py::test_valid_item_can_be_built PASSED
tests/test_schema.py::test_severity_above_max_raises PASSED
tests/test_schema.py::test_severity_below_min_raises PASSED
tests/test_schema.py::test_unknown_error_type_raises PASSED
tests/test_schema.py::test_descriptions_land_in_json_schema PASSED
tests/test_schema.py::test_items_default_to_empty_list PASSED
tests/test_schema.py::test_missing_overall_raises PASSED
tests/test_store.py::test_append_then_load_roundtrip PASSED
tests/test_store.py::test_one_record_per_line PASSED
tests/test_store.py::test_chinese_is_not_escaped PASSED
tests/test_store.py::test_load_missing_file_returns_empty PASSED
tests/test_store.py::test_count_by_type_fills_every_type PASSED
tests/test_store.py::test_count_by_type_is_correct PASSED
tests/test_store.py::test_total_errors_counts_items_not_records PASSED
tests/test_validate.py::test_clean_correction_has_no_problems PASSED
tests/test_validate.py::test_identical_original_and_corrected_is_flagged PASSED
tests/test_validate.py::test_blank_explanation_is_flagged PASSED
tests/test_validate.py::test_blank_original_is_flagged PASSED
tests/test_validate.py::test_spelling_rule_cuts_both_ways PASSED
tests/test_validate.py::test_empty_items_rewrite_flag_must_be_false PASSED
tests/test_validate.py::test_rewrite_with_only_minor_errors_is_flagged PASSED
tests/test_validate.py::test_problem_message_points_to_the_right_item PASSED
tests/test_validate.py::test_edit_distance_basics PASSED
============================== 39 passed in 0.42s ==============================
39 个用例全绿,全程离线。两条通路都断言返回的是 Correction 对象且结果一致;test_descriptions_land_in_json_schema 盯着 description 真的进了 JSON Schema------如果哪天有人把 description 删了当成注释清理掉,这条测试会当场跳起来。
十、踩坑清单
- 工具通路静默返回
None。 模型跑题写了段散文、没调工具时,LangChain 不报错。try_parse_chain里那段parsed is None and parsing_error is None的判断就是为它写的,删了它None就直通数据库。 - 格式说明书写进模板正文会炸。
get_format_instructions()生成的文本里全是花括号,直接拼进ChatPromptTemplate的正文会被当成占位符,运行时 KeyError。必须走.partial()。 - 压缩 ValidationError 再进提示词。 pydantic 的报错默认带一大段文档链接的堆栈,原样贴回去又贵又吵。只拎出"哪个字段 + 为什么"塞给模型,效果一样,token 少一个量级。
- 重试消息只贴错因不贴原文,模型会当成新句子重批。 两个都要给,缺一不可。
- 假模型也必须实现
bind_tools。 自带的FakeListChatModel过不了with_structured_output的能力检查,离线测试直接NotImplementedError,这是自己写fakes.py的全部原因。 - 别把校验规则全塞给 pydantic 的 validator。 业务规则和类型规则分开,类型规则在 schema,业务规则在
validate.py------前者模型必须服从,后者模型只能尽量服从。 - pytest 报
No usable temporary directory:本机安全策略限制临时文件所致,加--capture=no -p no:cacheprovider即可,与代码无关。
十一、本篇收尾
现在批改结果从"一段等着被正则肢解的散文"变成了"一个过了两道闸门的 Correction 对象":进错题本、渲染卡片、按类型统计,三件事拿到的都是带字段的干净数据。格式从愿望变成了契约,而且这份契约有 39 条测试看着。
下一篇解决另一个大坑:学生问"虚拟语气怎么用",助教答得头头是道,问"教材第 3 单元讲了什么"就开始瞎编。 我们会引入 RAG------先检索再回答,让模型只根据喂给它的教材内容说话,把"瞎编"从玄学变成可以度量、可以优化的问题。
最后一句:模型不是不会写 JSON,是你没告诉它交卷的答题卡长什么样------规格写在代码里才叫契约,写在提示词里只能算许愿。