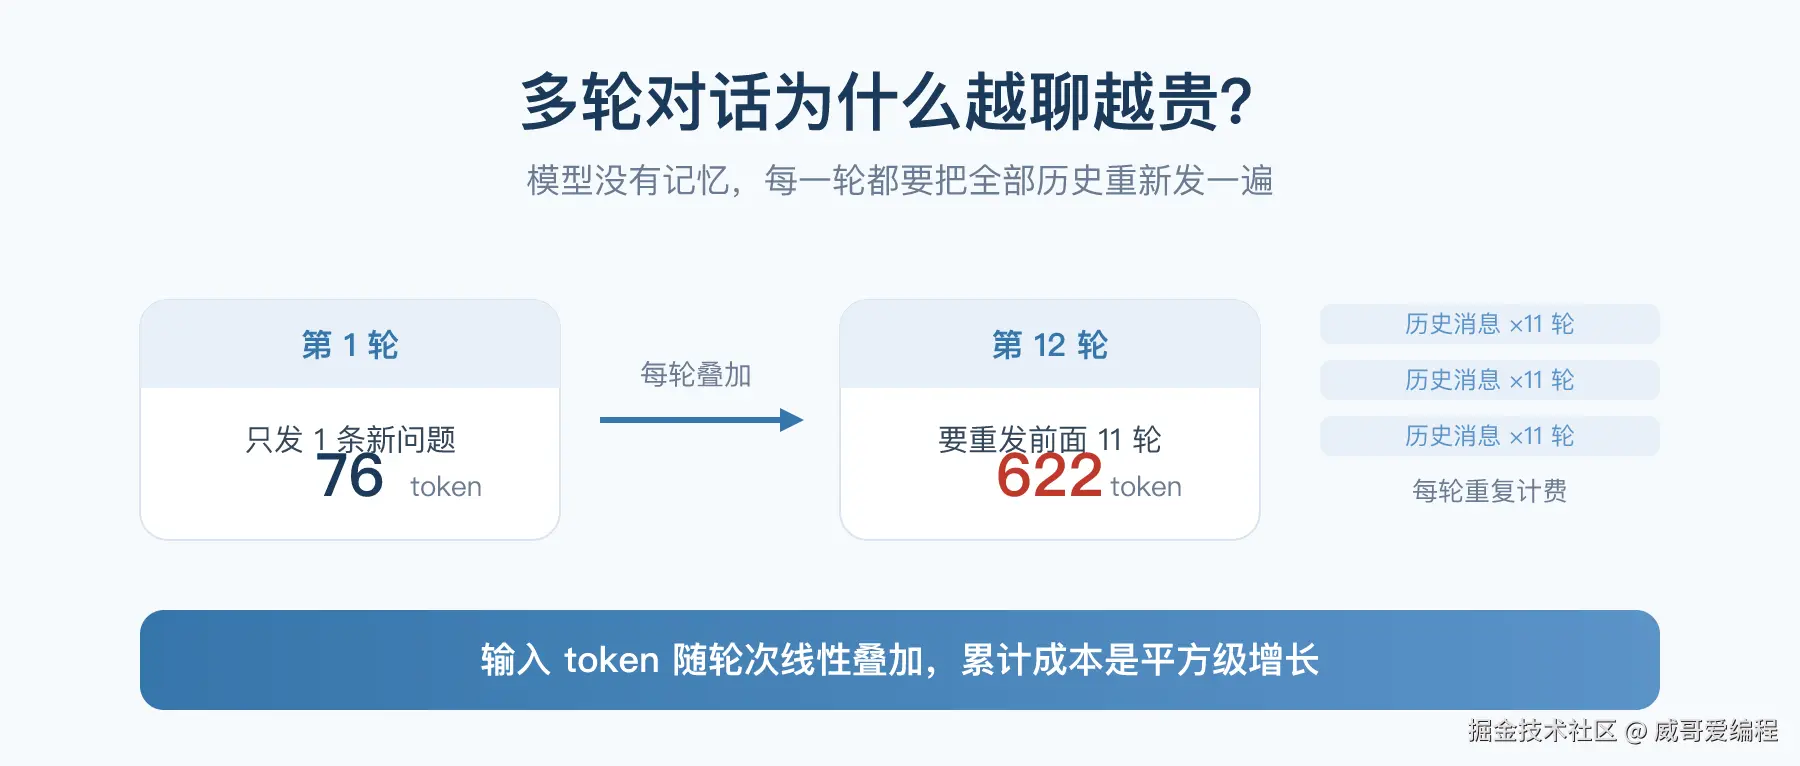
上个月给「启明英语」的助教小 E 做口语陪练,上线没几天,负责运营的同事甩给我一张账单截图,问我一句话:为什么同一个学生,聊到第 12 轮,单轮花的钱是第 1 轮的八倍?
我当时以为他看错了,结果自己一查数据,还真是。更诡异的是另一件事:一个学生两周前说过"我三个月后要考雅思 5.5",两周后小 E 给他推荐"先背四级词汇"------它把学生说过的话忘了。
这两件事其实是同一个病根。今天这一篇,我们就把"多轮对话为什么会失忆、为什么会越来越贵"彻底讲透,然后写出第一个带裁剪策略的会话管理器------你会亲眼看到账单是怎么被摁住的。
一、先扫盲:为什么聊得越久越贵
1. 模型没有记忆,每一轮都要把历史重发一遍
这是整个问题的原点,值得单独说清楚:DeepSeek 这类模型是无状态的。 它不记得上一轮你问过什么。你之所以觉得它"记得",是因为程序在每一轮请求里,把之前所有的对话一字不差地重新发了一遍。
所以"聊了 10 轮"和"第 1 轮"的区别,不是模型多记住了 10 件事,而是第 10 轮请求里塞了 9 轮的历史。第 1 轮发 76 个 token,第 12 轮就要发 622 个 token------钱花在这里。
2. 计费按 token,输入和输出分开算
一次请求分两部分计费:
- 输入(提示词):你发过去的所有内容,包括 system、历史、新问题。
- 输出(回答):模型吐回来的字。
输入通常便宜、输出贵好几倍(我们的演示里用了 2 元/百万输入、8 元/百万输出的假设值)。但多轮对话里输入才是大头------因为每轮你都在重复计费前面所有历史。第 12 轮那 622 个输入 token 里,有 500 多个是"上一轮已经付过钱"的内容。
补充一个省钱的小常识:不少厂商对"重复发送的相同前缀"提供了上下文缓存(Context Caching) ------同样的历史再发一次,命中缓存的部分按更低的价格计。这能显著摊薄多轮对话的成本,但它不能替代裁剪:缓存解决的是"重复内容的单价",裁剪解决的是"根本不该重复发的内容",两者是叠加关系,不是二选一。
3. 成本是平方级的,不是线性的
第一轮输入 76,第二轮 133,第三轮 190......每轮新增的内容固定,但"要重发的东西"越来越多。累计下来,N 轮对话的总输入 token 约等于 N × (N+1) / 2 × 单轮新增------这是平方级增长。单看一轮觉得没几个钱,放大到 1 万个学生、每人每天 20 轮,就是每天几百万 token 的量级。
4. "失忆"不是模型的错,是上下文装不下了
每个模型都有上下文窗口上限。聊得足够久,最早的消息会被顶出去(或被程序裁掉)。学生两周前说的"目标雅思 5.5",如果一直不做处理,就会在这条流水线上悄悄消失。
所以我们要解决的其实是两件事:钱(别重复计费)和记忆(长期设定别丢)。 这两件事有时候是矛盾的------省钱的滑窗会丢记忆。下面讲清楚怎么取舍。
把这几个概念落在数字上,就是一张账本:
| 概念 | 谁来决定 | 对账单的影响 |
|---|---|---|
| 单条消息 token 数 | 内容长度 + 语言(中文更贵) | 决定这一轮发多少 |
| 历史重发 | 程序每轮都会带上 | 决定 token 如何平方级叠加 |
| 上下文窗口 | 模型自身上限 | 决定"失忆"的临界点 |
| 输入/输出单价 | 官方定价(可配置) | 决定 token 怎么换成钱 |
理解这张表,后面对应的四个模块(估算、裁剪、压缩、账单)就都有了落点。
二、工程设计:三件事分开做
这一篇我们不再把逻辑塞在一个函数里,而是拆成六个模块,各管一段:
bash
03-上下文与Token/
├── src/
│   ├── settings.py   # 配置(复用第 1 篇)
│   ├── llm.py        # 模型工厂(复用第 1 篇)
│   ├── tokenizer.py  # 发请求之前先估算 token
│   ├── pricing.py    # 单价 + 单轮账单 + 累计流水
│   ├── summarizer.py # 模型压缩 + 规则降级压缩
│   ├── memory.py     # 上下文管理器(三种裁剪策略)
│   ├── session.py    # 多会话隔离
│   └── run.py        # 一轮对话的完整流程
├── tests/            # 52 个用例,离线全绿
└── demo.py核心思想一句话:先会"算"(估算 token、算账单),再会"裁"(三种策略),最后会"补"(把裁掉的重要信息压成摘要带回来)。
三、先会算:Token 估算(tokenizer.py)
在把请求发出去之前,程序就得知道这一轮要花多少钱。等 API 返回 usage 就晚了------钱已经扣了。所以我们需要一个本地、不联网的估算函数:
python
# 每多少个字符折算 1 个 token(经验值,中英比例不同)
CHARS_PER_TOKEN_ASCII = 4.0   # 英文约 4 字符 1 token
CHARS_PER_TOKEN_CJK = 1.6     # 中文约 1.6 汉字 1 token
PER_MESSAGE_OVERHEAD = 4       # 每条消息的 role/tag 包装开销

def estimate_tokens(text: str) -> int:
    if not text:
        return 0
    cjk = count_cjk_chars(text)          # 数汉字
    rest = _CJK_PATTERN.sub("", text)    # 剩下的按英文算
    total = (cjk / CHARS_PER_TOKEN_CJK) + (len(rest) / CHARS_PER_TOKEN_ASCII)
    return max(1, math.ceil(total))
两个要点:
- 中文比英文"贵"。 同样 12 个字符,"今天天气很好我们出去玩吧"比 "abcdefghijkl" 占的 token 多一倍不止。做中文产品,这个成本天生就比英文高,别拿英文的账单去对标。
- 估算不追求精确。 裁剪要的是"量级正确",不是"精确到个位"。真实 token 数以服务端返回的
usage为准,估算只负责"发之前先估"。
单条消息还要加一层固定开销,一组消息求和:
python
def message_tokens(message: BaseMessage) -> int:
    """单条消息的 token 数:正文 + 固定开销。"""
    content = getattr(message, "content", "")
    if not isinstance(content, str):   # 多模态消息里 content 可能是列表
        content = str(content)
    return estimate_tokens(content) + PER_MESSAGE_OVERHEAD


def count_tokens(messages: Sequence[BaseMessage] | BaseMessage) -> int:
    """统计一组消息的总 token 数。

    既支持传列表,也支持传单条------因为 LangChain 的
    trim_messages 传给计数器的可能是一整个列表。
    """
    if isinstance(messages, BaseMessage):
        return message_tokens(messages)
    return sum(message_tokens(m) for m in messages)
count_tokens 同时接受"单条"和"列表"不是炫技,是为了兼容 LangChain 裁剪器的调用约定------它给计数器喂的就是一个列表。这个细节我在写测试时才发现,不兼容的话,裁剪器拿到的是"整组消息被当成一条"的错数。
四、再会算钱:账单(pricing.py)
价格这里有一个原则:不把单价写死在代码里。 模型价格半年调一次是常态,写死的数字三个月后就开始骗人。所以把价格做成可配置对象:
python
@dataclass(frozen=True)
class UnitPrice:
    input_per_million: float = 0.0    # 每百万输入 token 的单价(元)
    output_per_million: float = 0.0

    def input_cost(self, tokens: int) -> float:
        return tokens / 1_000_000 * self.input_per_million
一轮的账用一个 TurnBill 记,多轮用 UsageLedger 累计------后者就是给运营看的"这个会话到底烧了多少钱"。
python
@dataclass(frozen=True)
class TurnBill:
    prompt_tokens: int
    completion_tokens: int
    input_cost: float
    output_cost: float

    @property
    def total_cost(self) -> float:
        return self.input_cost + self.output_cost
注意 DEFAULT_PRICES 里我留的是 0,含义是"没填"。查不到的模型一律按零单价处理------宁可账单显示为 0,也不算出个假数字。
单轮账单之外,还要一个累计的流水账,方便运营随时问"这个会话到底烧了多少钱":
python
@dataclass
class UsageLedger:
    bills: list[TurnBill] = field(default_factory=list)

    def add(self, bill: TurnBill) -> None:
        self.bills.append(bill)

    @property
    def total_tokens(self) -> int:
        return sum(b.total_tokens for b in self.bills)

    @property
    def total_cost(self) -> float:
        return sum(b.total_cost for b in self.bills)

    def summary_lines(self) -> list[str]:
        """一行一轮,最后一行合计------就是给运营看的对账单。"""
...为什么要把"单轮"和"累计"拆成两个对象?因为账单有两种读者:单轮账单 给技术排查(哪一轮暴涨了),累计流水给运营决策(这个产品整体烧了多少)。混在一个对象里,两边都不好用。
五、开始裁:三种策略(memory.py)
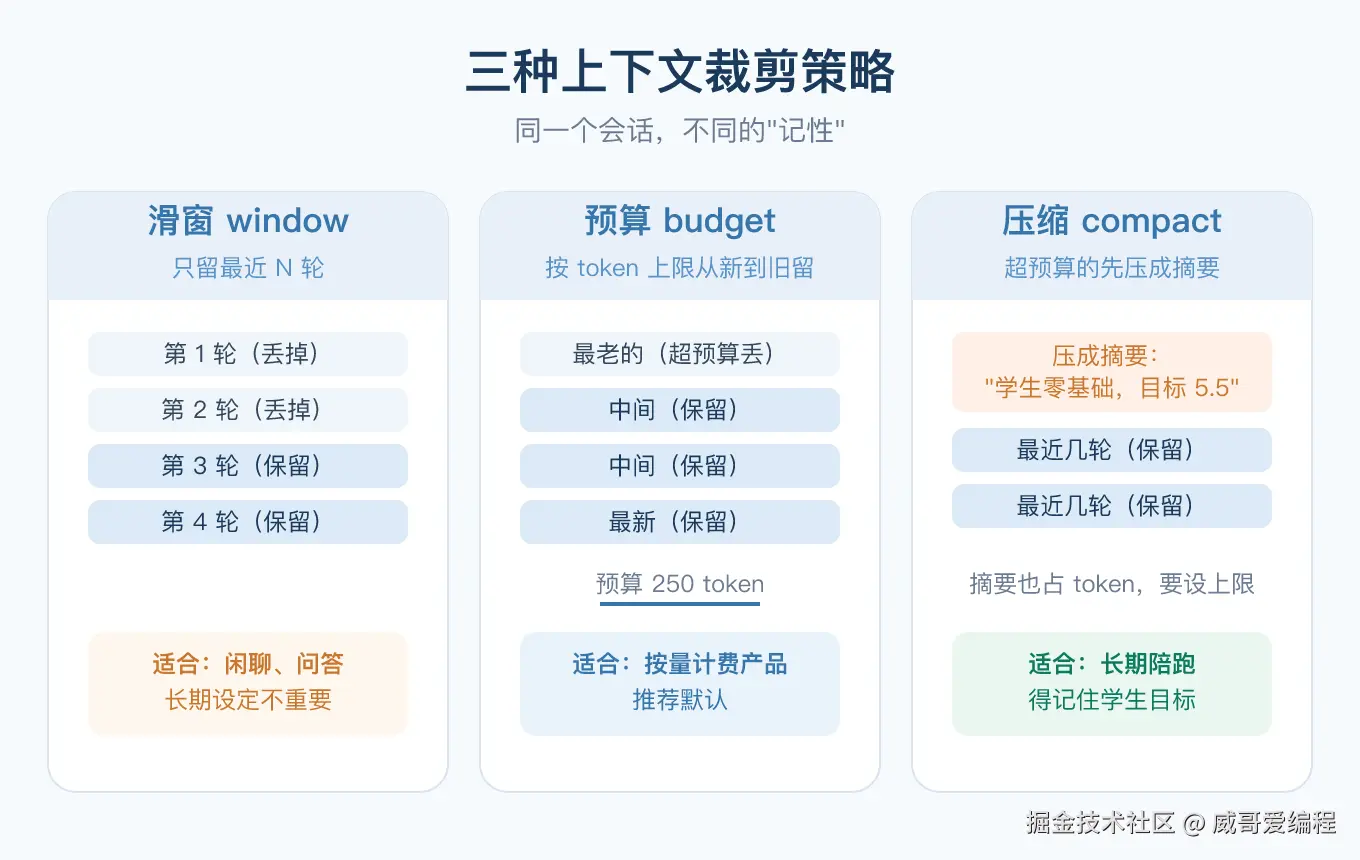
这是本篇的核心。ConversationMemory 负责三件事:记账、裁剪、压缩。裁剪有三种策略:
python
TrimStrategy = Literal["window", "budget", "compact"]window(滑窗):只保留最近 N 轮,最简单,但会丢掉"长期设定":
python
def _trim_by_turns(messages: list[BaseMessage], max_turns: int) -> list[BaseMessage]:
    """只保留最近 max_turns 轮。一轮 = 一问一答两条消息。"""
    if len(messages) <= max_turns * 2:
        return messages
    kept = messages[-(max_turns * 2):]
    # 万一被截断在一条 AI 消息上,配不成对,把这条也扔掉
    if kept and isinstance(kept[0], AIMessage):
        kept = kept[1:]
return keptbudget(预算):按 token 上限从最新往回留,超了就停。按量计费产品的默认选择:
python
def _trim_by_budget(messages: list[BaseMessage], budget: int) -> list[BaseMessage]:
    kept: list[BaseMessage] = []
    used = 0
    for message in reversed(messages):
        cost = count_tokens([message])
        if kept and used + cost > budget:
            break
        kept.append(message)
        used += cost
    kept.reverse()
return keptcompact(压缩):超预算就把最老的几轮压成摘要,带回来------兼顾省钱和记忆。
三个策略里藏着一条共同的铁律 ,我在代码里两处都写了注释:裁剪不能把"一问一答"拆散。 如果裁出来的第一条是助教的回答,模型会以为自己在接话,接着自己往下续写。所以:
python
# 如果截出来的第一条是 AI 的回答,说明配不成对,把这条也扔掉
if kept and isinstance(kept[0], AIMessage):
    kept = kept[1:]
举个具体反例感受一下:历史裁完只剩一条 AIMessage("对,要改成 He goes"),没有前文。这轮学生问的是"那我昨天那句呢",模型收到的上下文是"先是一句助教回答,然后学生问别的"------它很可能顺着那句孤零零的回答继续往下说,而不是回答新问题。这是我在真机上踩过的坑,属于那种"测试全绿、线上悄悄抽风"的 bug。
记忆对象的骨架长这样,system 单独存、历史单独存、摘要单独存,三者不混:
python
@dataclass
class ConversationMemory:
    system: str | None = None
    config: ContextConfig = field(default_factory=ContextConfig)
    llm: BaseChatModel | None = None
    summary: str = ""                                  # 压缩出来的旧事
    history: list[BaseMessage] = field(default_factory=list)

    def build_messages(self) -> list[BaseMessage]:
        """裁剪后真正要发出去的消息列表:system → 摘要槽 → 保留的历史。"""
        ...
为什么 system 和摘要要单独存?因为它们不该参与裁剪------system 是产品人格,摘要是"丢了就找不回"的长期记忆,两者永远保留,只有 history 可以被裁。这个"分层"是整个设计里最值钱的一笔:将来你想换人格、换摘要策略,都不用动裁剪逻辑。
六、会补:把丢掉的重要信息压成摘要(summarizer.py)
滑窗是"丢掉",压缩是"浓缩"。学生说"我零基础、目标雅思 5.5"------这是长期设定,丢了就再也找不回来,但原封不动挂十轮,每轮都要付租金。最好的办法是压成一句话留着。
这里也有硬规则:压缩内容必须来自真实说过的话,不许脑补。 所以压缩给两个通路:
python
def summarize_messages(llm, messages, previous_summary="") -> str:
    """用模型压缩:效果好,但要花一次调用。"""

def rule_summary(messages, previous_summary="", max_items=3) -> str:
"""规则降级:抽取学生说过的话拼成一句,不花钱、可复现。"""模型压缩自然更好,但离线、无 Key、写测试的时候,规则降级是不可替代的------它不用联网、结果 100% 可预期。生产环境里两种都要留,模型挂了自动降级。
七、隔离:一个人一个会话(session.py)
会话记忆如果做成全局变量,服务端一并发就完蛋------A 同学的问题会出现在 B 同学的上下文里。所以用 session_id 做键:
python
class SessionStore:
    def get(self, session_id: str) -> Session:
        """取会话,不存在就报错------静默新建是线上串台的头号原因。"""
        try:
            return self._sessions[session_id]
        except KeyError:
            raise KeyError(f"没有这个会话:{session_id},请先 create()") from None
这个 get 里"不存在就报错、绝不静默新建"的写法,是我从一次线上事故里学来的。当时为了方便用了"取不到就新建",结果两个学生的会话串到了一起。
八、怎么选:一张决策表
三种策略没有绝对好坏,只有"合不合适"。按场景对照着选,比背概念有用:
| 你的产品 | 推荐策略 | 理由 |
|---|---|---|
| 纯问答、闲聊、客服 | window |
长期设定不重要,图个简单可控 |
| 按量计费的陪练/批改 | budget |
直接对齐账单预算,推荐默认 |
| 长期陪跑、要记住学员目标 | compact |
省钱的同时保住关键记忆 |
还有两个独立于策略的开关,几乎每个产品都用得上:
keep_system:system 永远保留(默认开)。它是产品人格,不是数据,不该被裁。summary_budget:摘要自己的 token 上限。压缩不是免费的,摘要膨胀会反过来吃掉预算。
这两个开关独立存在,是因为它们回答的是两个不同的问题:一个是"记忆怎么留",一个是"记忆的载体能占多少"。拆开配,才能按场景调。
九、串起来:一轮对话的完整流程(run.py)
run_turn 把前面所有模块按顺序串起来。顺序很讲究,我按踩过的坑排的:
python
def run_turn(session, user_text, llm, *, price=None, auto_compact=True) -> TurnResult:
    memory = session.memory
    memory.add_user_message(user_text)          # 1. 先记下学生这轮的话
    dropped = len(memory.dropped_messages())    # 2. 看看裁掉了多少
    if auto_compact and dropped:
        memory.compact(llm)                     # 3. 有裁掉的,就地压成摘要
    messages = memory.build_messages()          # 4. 裁剪后真正要发的内容
    response = llm.invoke(messages)
    answer = str(getattr(response, "content", ""))
    # token 数以服务端为准,取不到就用本地估算兜底
    prompt_tokens = usage_value(response, "input_tokens") or count_tokens(messages)
    completion_tokens = usage_value(response, "output_tokens") or _estimate(answer)
    bill = bill_turn(MODEL, prompt_tokens, completion_tokens, price)
    session.ledger.add(bill)                    # 5. 结算
    memory.add_ai_message(answer)               # 6. 回答最后才进历史
    return TurnResult(...)
两个细节值得记住:
- 结算在回答进历史之前------这笔账按"实际发出去的"算,不含刚生成的回答。
- 服务端用量优先 。
usage_value从AIMessage.usage_metadata里取真实的input_tokens/output_tokens,取不到(比如用的假模型)才回退到本地估算。
十、跑起来:真实账单对比
python demo.py,全程离线(用假模型),模拟一个外贸业务员 12 轮的英语陪练。先看估算器对不同文本的判断:
vbnet
    6 字符 → 约   2 token   Hello!
   35 字符 → 约   9 token   He goes to school by bus every day.
   19 字符 → 约  12 token   你是一个英语老师,请批改下面这句语法。
注意第三行:19 个中文字符估出 12 token,而 35 个英文字符才 9 token------中文更贵这件事,从估算器里就该看得清清楚楚。
再看三种策略在同一段 653 token 历史下的表现:
scss
  window  (留最近 2 轮)      发出  5 条 /  125 token (原始 653 token,省下 528)
  budget  (250 token)       发出 11 条 /  268 token (原始 653 token,省下 385)
  compact (250 token)       发出 11 条 /  268 token (原始 653 token,省下 385)

  压缩出来的摘要:已聊过:我们产品叫铝合金支架,这个用英语怎么...;客户邮件里写 Please advi...;我总把 he 和 she 说错...
window 最省但也最"健忘";budget 和 compact 在省钱上一样,区别是 compact 把被裁掉的关键信息压成了摘要带回来。
再看 12 轮对话的累计账单,A 不裁剪、B 加预算裁剪:
css
  【A】不裁剪      合计  提示 4327 tok | 回答 327 tok | 总计 ¥0.0113
  【B】预算裁剪    合计  提示 2666 tok | 回答 327 tok | 总计 ¥0.0079

  结论:12 轮下来 A 烧了 4654 token,B 只烧了 2993 token,省下 35.7%。
35.7% 看着不多,是因为 12 轮还太短。这张图里那条红线上涨的斜率,就是问题的本质:
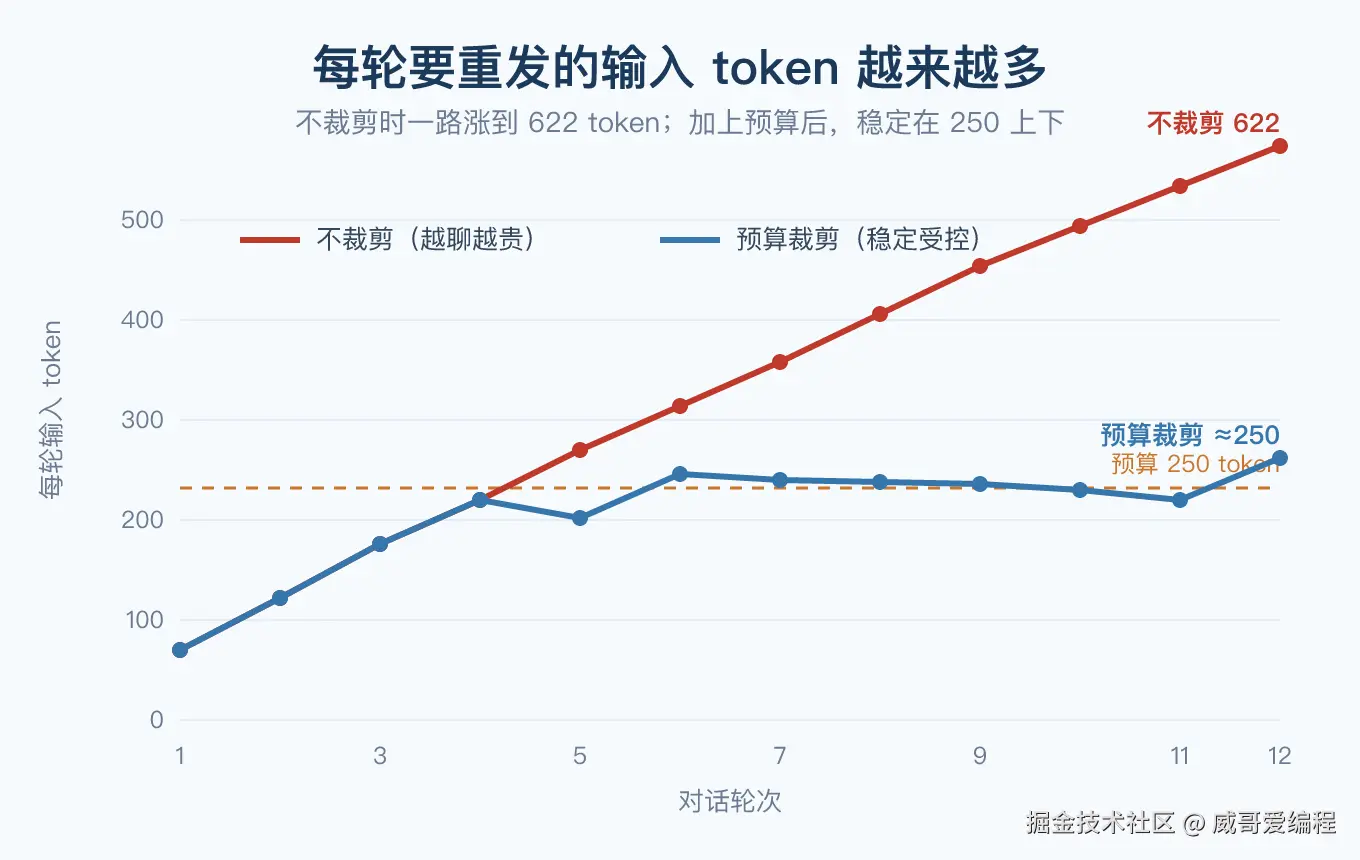
第 12 轮,不裁剪要发 622 token,裁剪后稳定在 250 上下。聊得越久,差距越大------不裁剪是平方级,裁剪后趋于一条直线。放大到规模:
  假设:10000 个学生,每人每天 20 轮,每轮新增 60 token
  不裁剪:1.26 亿 token/天 → ¥252/天
  裁剪后:0.56 亿 token/天 → ¥111/天
  一个月(30 天)差 ¥4230
这是按演示用的假设单价(2 元/百万)做的量级估算,不是真实账单。真实成本要看当期单价和实际用量。
顺带看一张单轮账单怎么来的,数字全部可核对:
  输入 512 token × ¥2.0/百万 = ¥0.001024
  输出 128 token × ¥8.0/百万 = ¥0.001024
  本轮合计 ¥0.002048(640 token)
单看一轮 ¥0.002 确实不起眼,但你要记住:这一轮里那 512 个输入 token,有 400 多个是"上一轮已经付过钱的历史"。 规模一大、轮次一多,这 400 个"重复付费"就是账单翻倍的来源。
测试结果,52 个用例全绿,全程离线:
bash
tests/test_memory.py    13 个  三种策略、成对性、摘要槽、预算截断
tests/test_pricing.py    7 个  单价、账单、流水、报告
tests/test_run.py        9 个  一轮流程、服务端用量优先、自动压缩
tests/test_session.py    8 个  多会话隔离、重复创建、成本合计
tests/test_summarizer.py 8 个  渲染、压缩、规则降级
tests/test_tokenizer.py  7 个  估算、开销、单调性

52 passed in 0.98s这组测试里我最想让你注意到两条:test_server_usage_wins_over_estimation(服务端用量优先于估算)和 test_compact_does_not_compress_twice(同一段历史不会被重复压缩)。前者守住"账单真实",后者守住"摘要不越滚越大"。
十一、踩坑清单
- 裁剪拆散了一问一答 :裁出的第一条是助教回答,模型以为自己在上半句,接着瞎编。两处
isinstance(kept[0], AIMessage)就是防这个。 - 摘要不设上限 :摘要本身也占 token,不设
summary_budget,压缩等于白做。摘要默认预算 120 token,超了会截断。 - "取不到就新建"的会话 :两个学生的上下文串台。
get取不到就抛异常,绝不静默兜底。 - 把单价写死在代码里:三个月后开始骗人。价格做成可配置,查不到就按零处理。
- 重复压缩同一段历史 :摘要越滚越长。用
_summarized_history记下已经压过的,别重复压。 - 估算器忘了消息固定开销 :每条消息除了正文还有 role 包装,忽略它,预算就比想象中紧。
PER_MESSAGE_OVERHEAD = 4。 - 拿估算值当账单 :估算只用于"发之前裁剪",结算必须优先取服务端
usage,取不到再回退。两者混为一谈,对账对不上。 - pytest 报
No usable temporary directory:本机安全策略限制临时文件,加--capture=no -p no:cacheprovider即可,与代码无关。
十二、本篇收尾
现在小 E 有了:一套能估 token、算账单的账本,三种可切换的裁剪策略,一个"丢什么补什么"的摘要槽,还有多会话隔离。那个"聊久了失忆、账单翻倍"的问题,从运营的投诉,变成了一组可以打印、可以断言、可以按预算调的数字。
下一篇解决一个更让开发者头疼的问题:模型答得挺漂亮,程序却读不懂。 我们会用 Pydantic 把输出钉死成能直接入库的结构------你将亲眼看到"错题本"是怎么从"一段散文"变成"一行 JSON"的。
最后一句:模型从没失忆,它只是把你舍不得付钱的那部分历史,一视同仁地丢掉了。