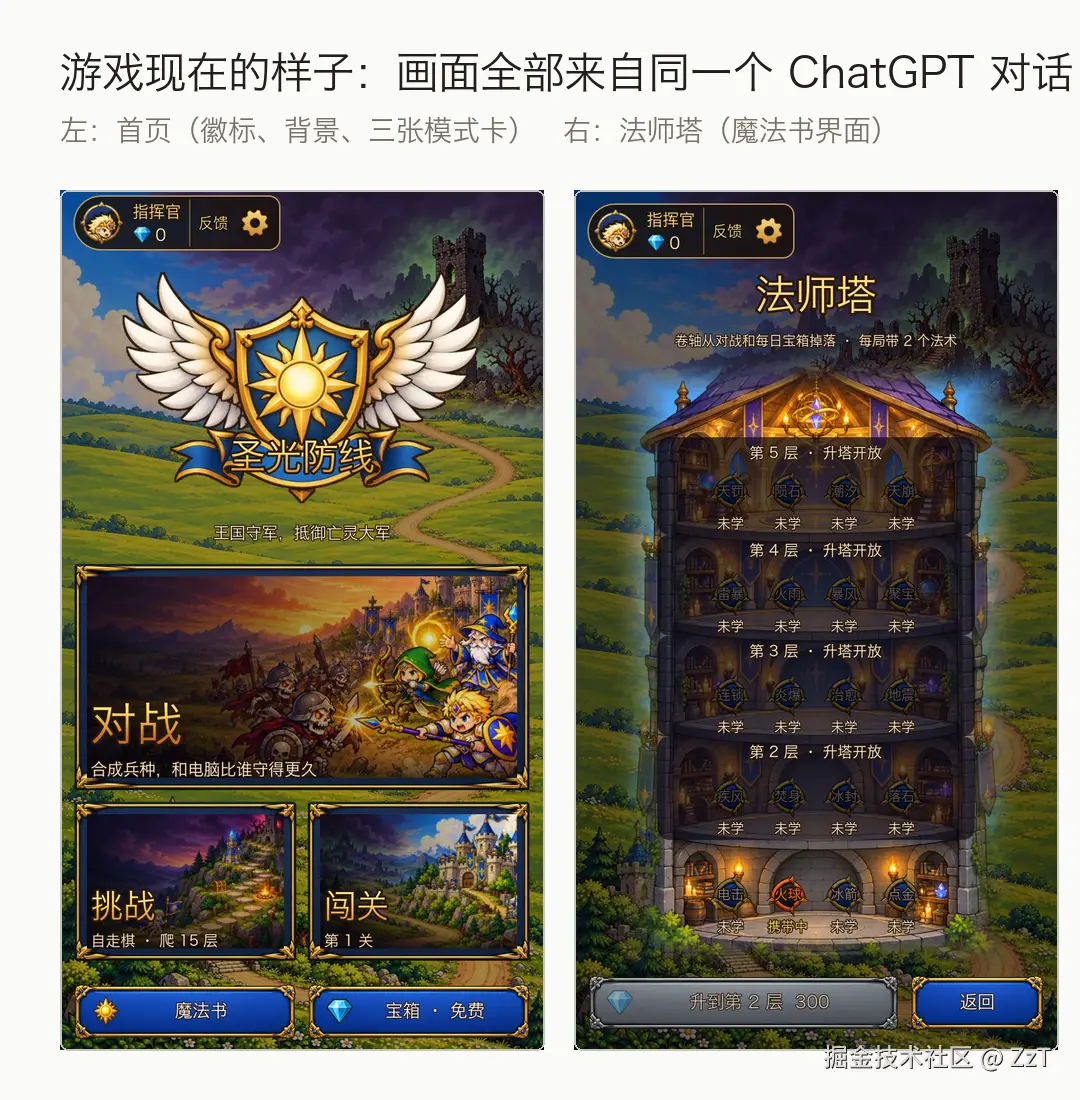
上图是游戏现在的首页和法师塔界面。上一篇讲开工第一天:AI 先问了 4 个问题,查清平台约束,搭好让它自己检查工作的工具。上一篇结尾预告的是玩法,这一篇先讲素材,玩法放到下一篇,因为后面讲玩法时用到的角色和画面,都来自这一篇的流程。
先说结论。这款游戏的全部美术,包括上图里的徽标、背景、模式卡和法师塔,前后 13 轮出图,项目里留下 35 张原图,都是 Claude Code 在我的 Chrome 里操作已登录的 ChatGPT 网页生成的,始终在同一个对话里。我没有手动复制过一次 prompt,也没有手动下载过一张图:填 prompt、点发送、等图、下载、挪进项目、切成游戏素材,全是 Claude Code 自己做。我只在两种时候介入:页面弹出人机验证时自己点掉,以及下载前确认要不要这几张图。
这套流程里,生图本身反而是最省心的环节。花时间的地方有三处:让 AI 可靠地操作一个为人设计的网页;把 prompt 写成能被脚本稳定切开的格式;给 AI 补上它看不见、听不到的那部分检查。下面按顺序展开。
工具:Claude in Chrome 扩展
Claude Code 本身跑在终端里,碰不到浏览器。它操作 ChatGPT 靠的是 Claude in Chrome 浏览器扩展,这个扩展给了它几样能力:读写标签页、在页面里执行 JavaScript、等待、截图,以及把几步操作打包成一批执行。
整个过程中,Claude Code 绝大多数时候用的是「在页面里执行 JS」:查元素、填文字、点按钮、读状态、下载图片都靠它。截图只在需要人眼判断的时候才用,比如从一堆缩略图里挑出最终版。这样做的好处是每一步都有可以检查的返回值,比「截图 → 猜坐标 → 点击」稳定得多。
第一步:打开页面,确认登录状态
开工那天,Claude Code 先开了一个新标签页打开 chatgpt.com,等 6 秒,然后执行一段 JS 读页面状态:有没有输入框、有没有「登录 / 注册」按钮、当前选的是哪个模型。
第一次读的时候,它按老的经验去找 #prompt-textarea,没找到,判断成了「未登录」。它没有据此让我去登录,而是又跑了一段 JS,把页面上所有可编辑元素和带「登录」字样的按钮都列出来,结果是:可编辑元素是一个 ProseMirror 编辑器,页面上没有登录按钮。也就是说,已经登录,只是 ChatGPT 改了输入框的实现。
这一步说明了操作网页的一个基本前提:网页结构会变,任何选择器都只是当时的快照。所以 Claude Code 每次操作之前,都会先用 JS 把当前页面的结构探一遍,而不是直接套用记忆里的选择器。下文提到的选择器,都是 2026 年 10 月下旬 ChatGPT 网页的样子。
第二步:填 prompt,确认长度一致再发送
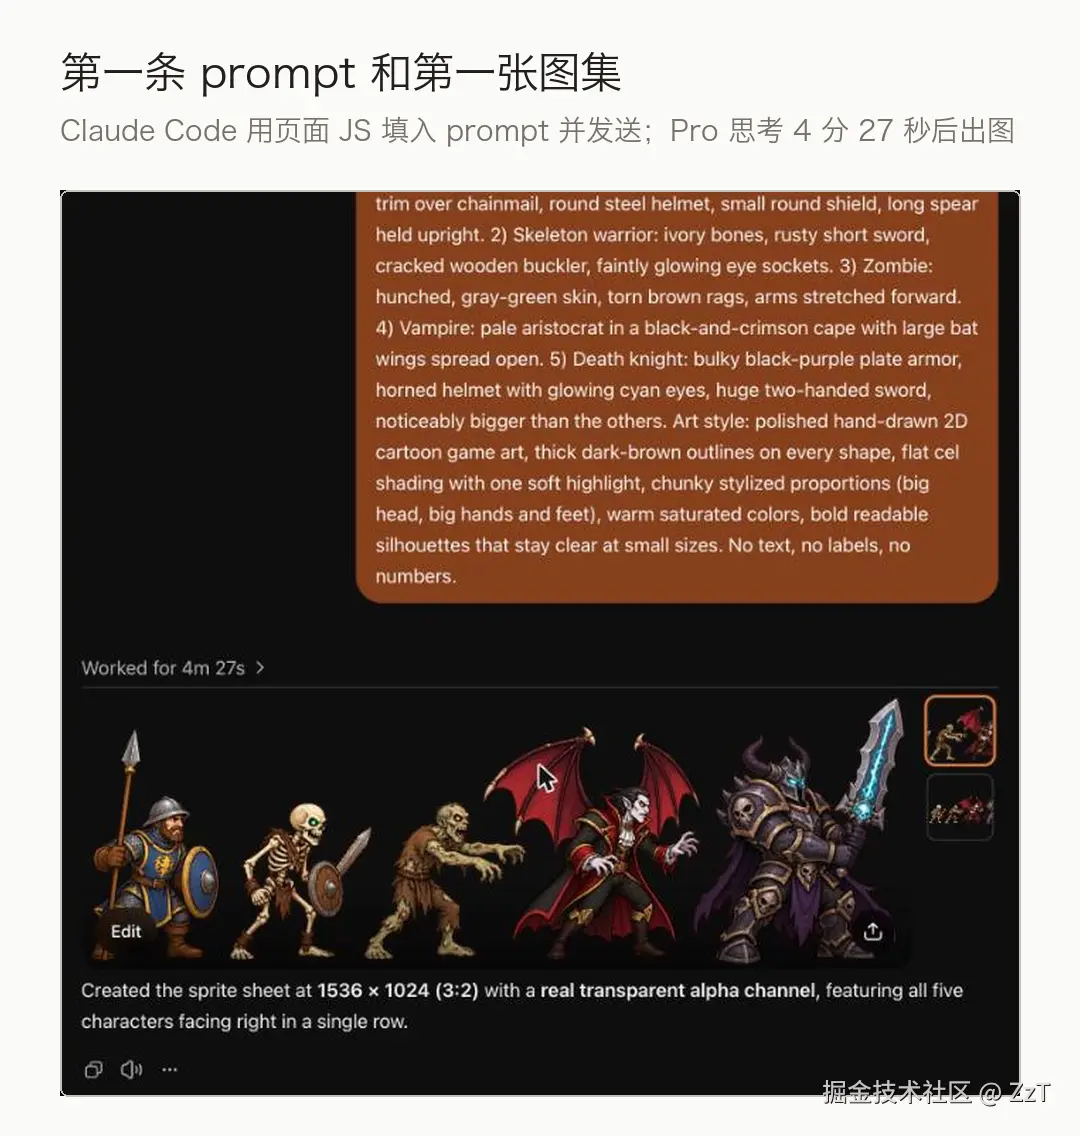
找到输入框之后,填 prompt 用的是这段 JS(prompt 正文省略):
js
const el = [...document.querySelectorAll('.ProseMirror')]
  .find(e => e.getBoundingClientRect().height > 0);
el.focus();
document.execCommand('selectAll', false, null);
document.execCommand('insertText', false, prompt);
el.dispatchEvent(new Event('input', {bubbles: true}));
await new Promise(r => setTimeout(r, 800));
const send = document.querySelector('button[aria-label="Send"]');
let result = 'typed ' + el.innerText.length + '/' + prompt.length;
if (send && !send.disabled && el.innerText.length === prompt.length) {
  send.click(); result += ', sent';
} else { result += ', NOT sent'; }
result
几个细节:
- 用
execCommand('insertText')而不是直接改innerText。ProseMirror 编辑器有自己的内部状态,直接改 DOM,页面上看着有字,编辑器状态里却是空的,发送按钮不会亮。insertText走的是浏览器正常的输入流程,编辑器能感知到。 - 发送前先校验长度 。只有输入框里的字数和 prompt 字数完全一致才点发送,否则返回
NOT sent,不发半截 prompt。 - 找可见的那个输入框 。代码里那句
.find(e => e.getBoundingClientRect().height > 0)是踩坑后加的。第二次发 prompt 时返回的是typed 0/1784, NOT sent:页面上有两个 ProseMirror,第一个是隐藏的,字填进了看不见的那个。长度校验在这里挡住了一次空发送。
第三步:不截图,轮询生成状态
发送之后要等图。这里 Claude Code 没有反复截图看进度,而是每隔一段时间执行一段 JS,读这几样东西:
- 页面上
aria-label为 Stop 的按钮还有几个,有说明还在生成; - 状态区域的文字,从「ChatGPT is responding」变成「Response complete」;
- 页面上有没有
alt以「Generated image」开头的图片,以及它的宽高; - 最后一条回复里有没有出现「Worked for ...」,这是带思考模式的回复结束时的耗时标记。
等待用的是「先等 10 秒、再等 10 秒、再等 10 秒,然后查一次」这样打包成一批执行,查到完成再进入下一步。
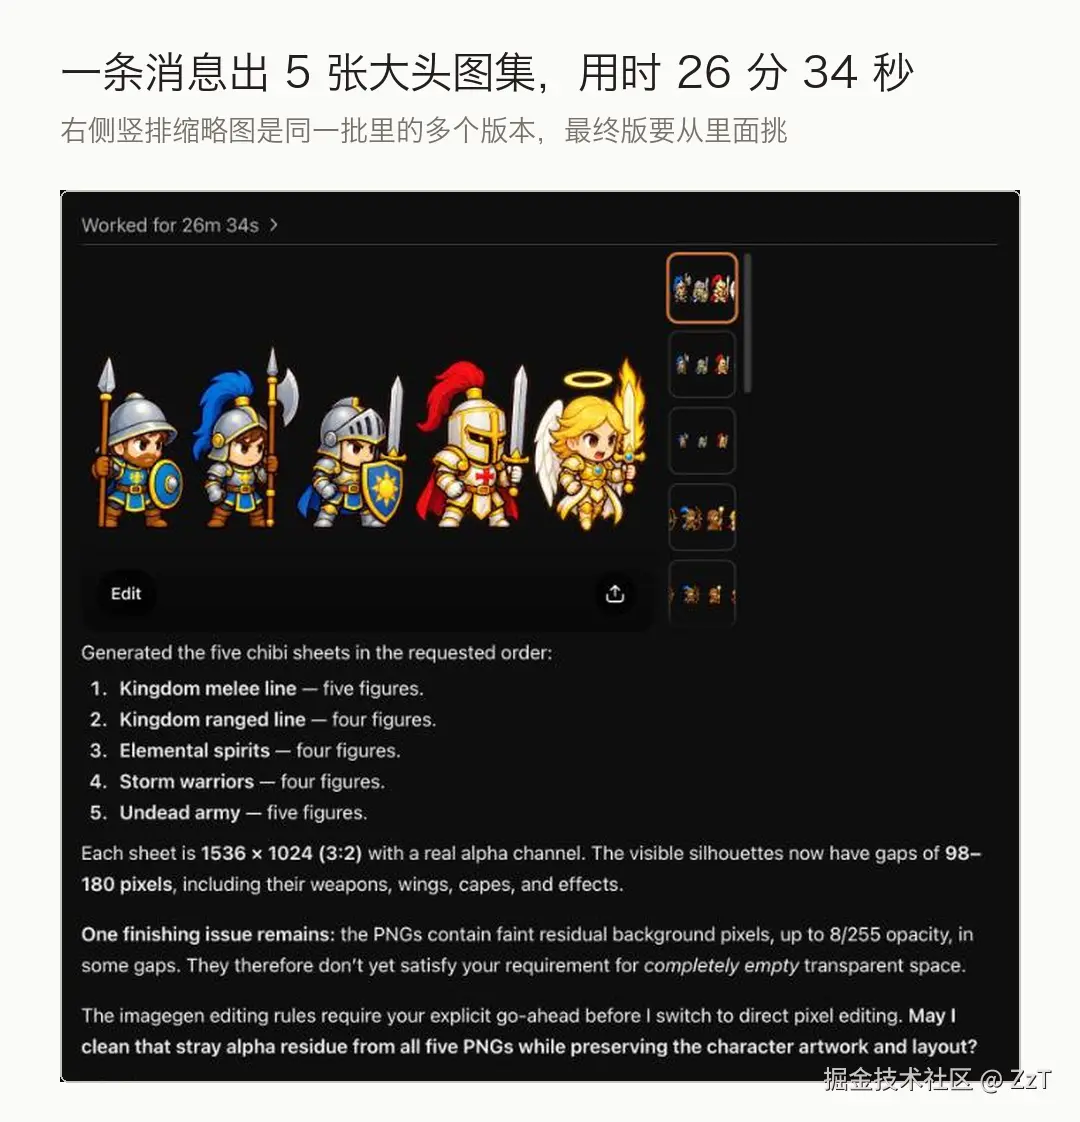
等待时间比我预想的长得多。对话开的是 Pro 思考模式,13 轮出图里最短 1 分 37 秒,最长 26 分 34 秒,就是上图这次:一条消息要 5 张大头图集。第一张图集用了 4 分 27 秒,4 位英雄那张用了 14 分 52 秒。好在不用盯着,AI 等图的时候我在试玩上一版。
上图这轮回复末尾还有一个细节:ChatGPT 自己指出图里残留了透明度最高 8/255 的背景杂点,问要不要清掉。这类杂点后面的切图脚本会统一清除,不需要它处理。
第四步:下载 blob 图片,挪进项目并验图
图生成出来之后,页面上的 src 是 blob:https://chatgpt.com/... 这样的地址。它只在这个页面里有效,终端里用 curl 下载不到。Claude Code 的做法是在页面里临时造一个下载链接,点一下:
js
const img = document.querySelector('img[alt="Generated image 1"]');
const a = document.createElement('a');
a.href = img.src;
a.download = 'td_units_sheet.png';
document.body.appendChild(a); a.click(); a.remove();
文件会落到 ~/Downloads。接着它回到终端,用 mv 把文件挪进项目的 art_source/ 目录,再用 Python 打开检查:尺寸多大,是不是 RGBA,透明像素占多少。透明像素比例是一个很直接的检查:如果模型把「透明背景」画成了灰白棋盘格,这个比例会接近 0,图就不能用。
开工前,它还先把 ~/Downloads 里已有的 PNG 列了一份清单,下载后对比,确认拿到的是刚生成的那张,不会误拿我下载目录里的旧图。
后来对话越来越长,页面会重新渲染,按 alt 找图开始不可靠。它改成按 blob 地址的尾号定位:每张图的 blob 地址是唯一的,先记下尾号,下载时按尾号找回同一张。
第五步:从一堆缩略图里挑出最终版
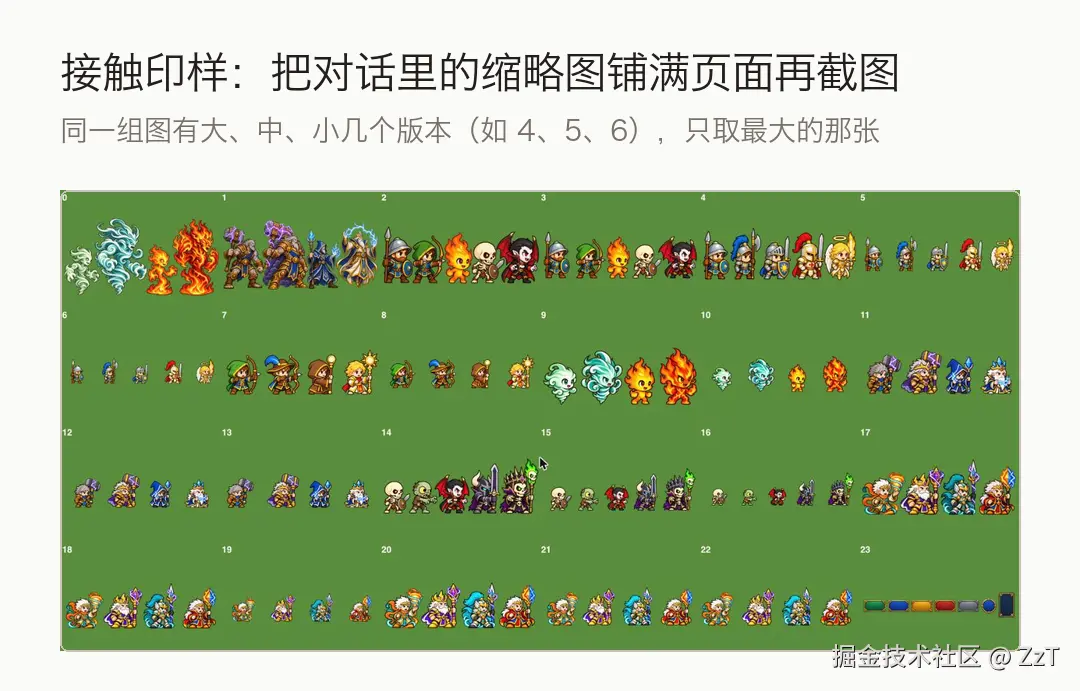
最难处理的一次是重画大头角色。prompt 要求相邻角色之间至少空 80 像素,ChatGPT 为了满足这条,会把图缩小后重新出一两次,所以页面上同一组图同时留着好几个版本,有 17 张缩略图。中间版本的角色更小、细节更少,下错一张,切出来的角色就糊。
Claude Code 的办法是在 ChatGPT 页面上盖一层自己造的「接触印样」:用 JS 把这 17 张图逐张 fetch 成 blob,重新排成 6 列网格,每张标上序号,铺满整个页面,然后截一张图。上图是用同样的方法把整个对话的缩略图铺开的样子,可以看到同一组角色有大、中、小几个版本。这是整个流程里少数几次截图之一,因为「哪张是最终版」要靠看。看完之后,它挑出每组里尺寸最大的那一张,记下 blob 尾号,删掉这层网格,按尾号批量下载:
js
const want = [['4fb484e254b3','chibi_spirits_big'], /* ... */];
for (const [tail, name] of want) {
  const img = [...document.querySelectorAll('img')].find(x => x.src.endsWith(tail));
  const b = await (await fetch(img.src)).blob();
  const a = document.createElement('a');
  a.href = URL.createObjectURL(b); a.download = name + '.png';
  document.body.appendChild(a); a.click(); a.remove();
  await new Promise(r => setTimeout(r, 1500));
}
每张之间间隔 1.5 秒。三张图集下载下来分别是 1503KB、1500KB、1550KB。
回头看,80 像素的要求写得过宽了,切图只需要几个像素的空隙。这条要求本身制造了多版本的问题。
人在哪里介入
这套流程里有几处是 Claude Code 明确停下来交给我的:
- 人机验证。中途 ChatGPT 弹过一次 Cloudflare 验证,它停下来让我自己点,不尝试绕过。
- 下载前确认。项目规则写着:下载任何文件前,先说明文件名、来源和大小。后期几批图都是先在对话里报「要下哪几张、多大」,我回一句「可以」再下。4 位英雄那张图,我要求先给我看图再下载。
- 登录。如果页面需要登录,由我自己完成,它不经手密码。这次 ChatGPT 一直是登录状态,没有触发。
全部美术都在同一个对话里
所有图都在同一个对话里按顺序生成:
| 日期 | 这一批生成了什么 |
|---|---|
| 10-25 | 第一批角色、建造位地基、草地场景和地块,随后补上近战和远程两条兵种线、沼泽和沙地两张地图的场景与地面纹理 |
| 10-26 | 界面:状态图标、操作图标、面板、按钮,以及横版和竖版两张菜单背景 |
| 10-28 | 角色全部换成大头:1 张样图定画风,5 张正式图集,共 22 个角色 |
| 10-29 | 对战模式的 4 位英雄;首页改版:带翅膀的徽标、对战/挑战/闯关三张模式卡、按钮框、宝箱、法师塔 |
| 10-30 | 新增的敌人兵种(含飞行的骨龙)和第二批王国兵 |
坚持用一个对话,是为了风格一致。每条新请求都以「in exactly the same art style as ...... earlier in this conversation」开头,并把描边粗细、阴影方式、配色、细节密度逐项写出来。模型能看到对话里之前的图,描边和配色就会对齐;新开一个对话,同样的文字描述画出来的图会有偏差。这个对话的链接记在 Claude Code 的项目记忆里,隔了几天再补界面、补英雄,它都是回到这个对话里继续出图。
prompt 的固定写法:每一条都为切图服务
每张图集的 prompt 后半段都是一组固定要求,原文如下:
Wide landscape format (3:2). Transparent background with a real alpha channel (no checkerboard pattern, no floor, no cast shadows, no scenery). Five full-body characters standing in one horizontal row, evenly spaced with clear empty space between them (nothing overlapping), all facing RIGHT in a three-quarter side view, feet on the same baseline. ...... No text, no labels, no numbers.
这些要求没有一条是审美上的,全是为了让后面的脚本能自动切开:
- 真透明背景,并点明不要棋盘格。生图模型常把「透明」画成一张灰白棋盘格图案,那是像素,切图时去不掉。
- 一行排开、互不接触。脚本靠连通区域找物件,两个角色碰在一起就会被当成一个。
- 统一朝右、脚底在同一条线。游戏里角色朝左时直接水平翻转,脚底对齐后,所有角色可以用同一个锚点站在建造位上。
- 不要文字和数字。模型喜欢给每个角色配名字标签,标签也会被识别成物件。
风格部分只用通用描述:粗的深棕色描边、平涂加一处柔和高光、头手脚偏大的卡通比例、暖色高饱和、小尺寸下轮廓仍清楚。prompt 里不出现任何现有游戏、工作室或系列的名字。一是为了版权,二是 Steam 上架要做 AI 内容披露,所有 prompt 原文和切图命令都记在仓库的 art_source/PROMPTS.md 里,届时直接照着填。
切图脚本:一张图集变成游戏素材
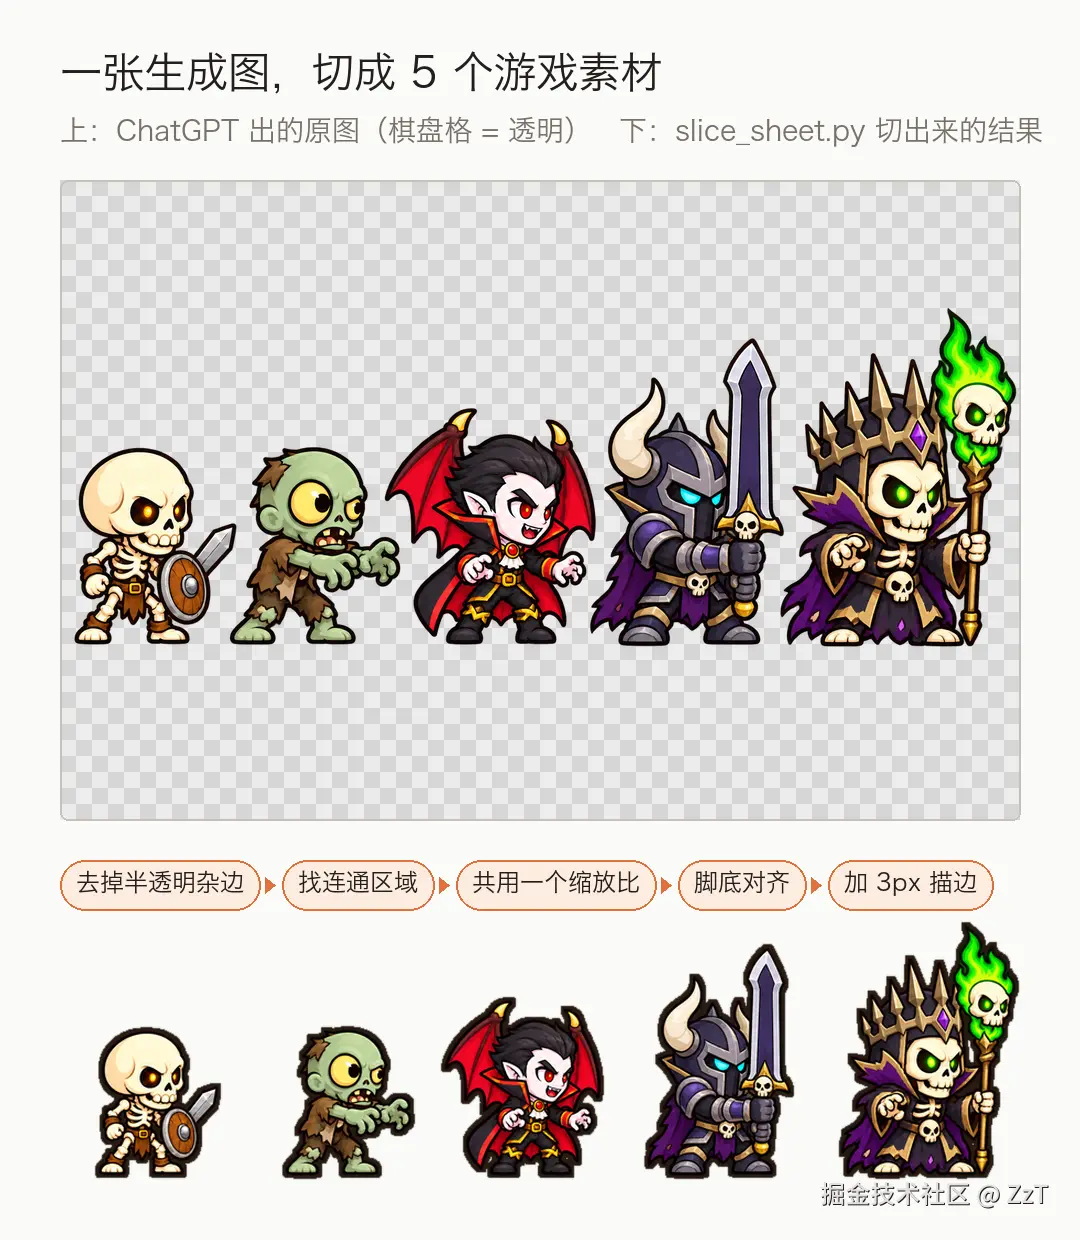
ChatGPT 给的是一整张 1536×1024 的图集,游戏需要的是一个个裁好的单图。这一步由 Claude Code 写的 tools/art/slice_sheet.py 完成,192 行,处理顺序是:
- 透明度低于 32 的像素清成全透明,高于 240 的补成不透明。生成图的边缘有一圈若有若无的杂色,不清掉就会被当成物件的一部分。
- 在透明度上找连通区域,太小的碎点忽略,从左到右排序后按命令行给的名字依次输出。
- 同一张图集里的物件共用一个缩放比例,保留原图里的大小关系,等级越高的兵种看起来越大。
- 把脚底放到图片的垂直中线上,这是游戏里放置和翻转角色的锚点。
- 缩小后加一圈 3 像素深色描边。原图的描线在缩到游戏尺寸后会变细到看不清,这圈描边让角色在草地上依然轮廓分明。
命令行给几个名字,脚本就必须找到几个物件,数量对不上直接报错退出,不猜。这条规则挡住了两次问题。第一次,僵尸和吸血鬼的翅膀挨得太近,脚本找到 4 个物件而不是 5 个,后来调小了合并半径。第二次,大头版的十字军剑尖和天使翅膀之间只粘连了几个像素,脚本同样报错;处理方法是复制一份图集,把粘连处的 4 列像素透明度清零,再切这份副本,命令也一并记进了 PROMPTS.md。
60 像素下认不出:22 个角色重画成大头
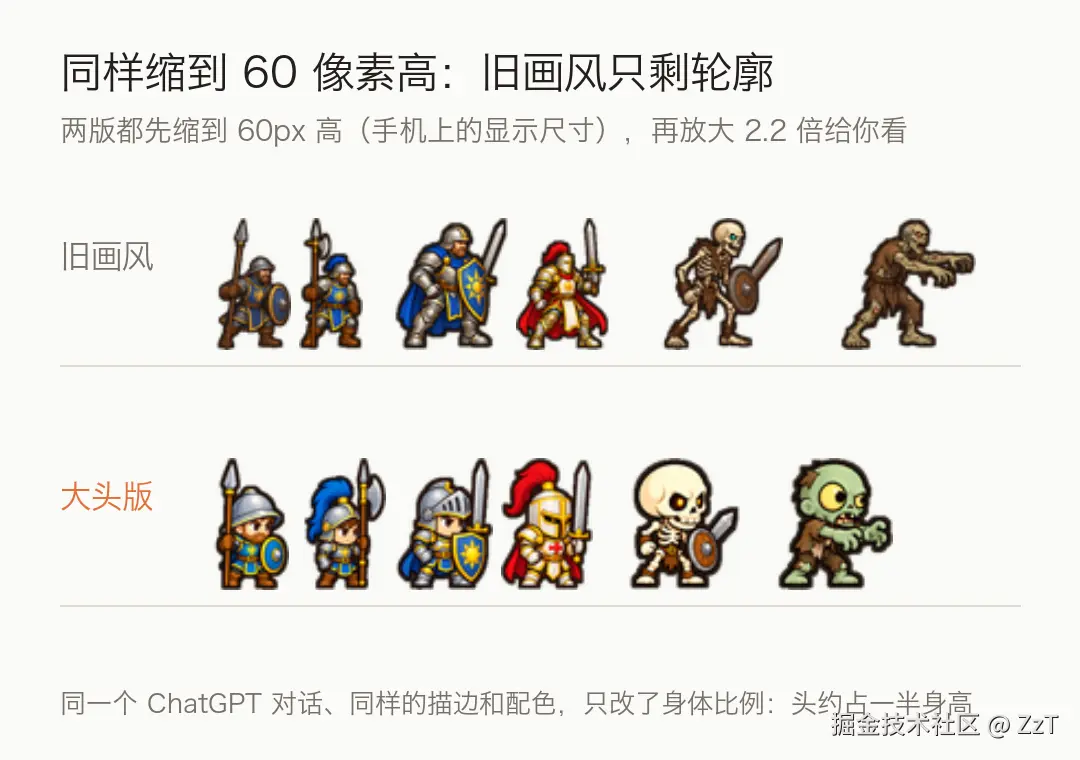
第一版角色是正常比例。改成竖屏、推到手机上试玩以后,问题出现了:地图上每个角色只有几十像素高,枪兵和戟兵分不清,远处的亡灵只剩一团颜色。我当时的反馈是:「整体人物太小了,看不清具体是什么,能做成那种大头形象么(敌人也是),能一眼看出是谁。」
AI 的方案是换画风,而不是把角色放大,流程分两步:
- 先出一张样图定画风。挑 5 个有代表性的角色(王国兵、远程兵、元素兵、两种亡灵),只出一张图给我看,样图不切进游戏。prompt 里写明头约占身高一半,每个角色靠一两个夸张的标志特征辨认(武器、帽子、翅膀、骨头、火焰),并要求「so it still reads when shown only 60 pixels tall」。
- 我回复「风格可以,继续」后,一条消息生成 5 张图集:近战线 5 个、远程线 4 个、元素兵 8 个、亡灵 5 个,共 22 个角色,全部替换旧图。上一节「挑最终版」的问题,就出在这一批。
新旧对比见上图:两版都缩到 60 像素高,旧画风里几个兵种只剩相近的轮廓,大头版能看清头盔、羽饰和武器。描边、配色和高光的写法没变,因为还是同一个对话,模型参照的仍是之前的图。
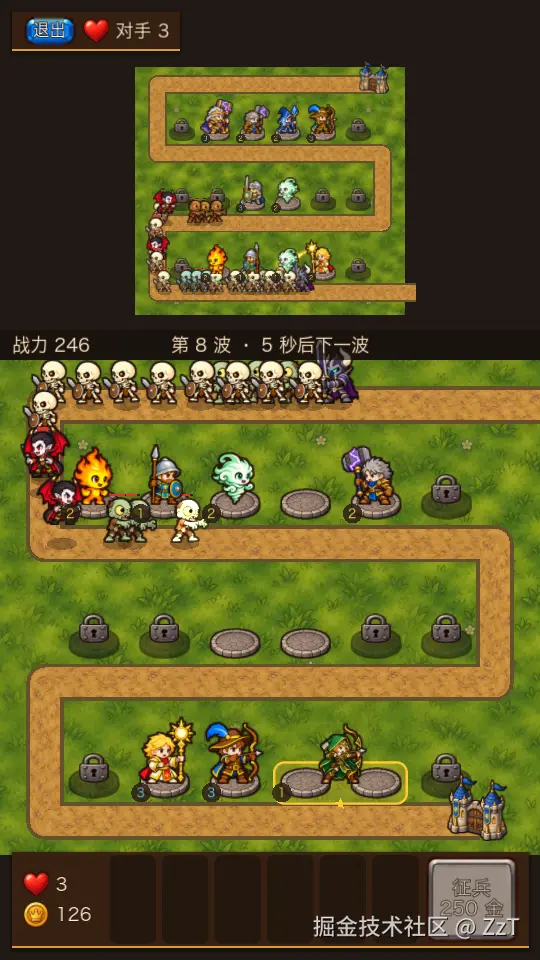
上图是换完之后对战模式的实际画面。大头角色比原来高,起初试过放大建造位的点击框来容纳,结果打乱了地图布局;最后改成所有兵种统一按 0.43 倍显示,最高的戟兵正好站进原来的点击框,地图上的建造位一个都没有移动。
首页改版时还遇到一个相反的问题:徽标要的是透明背景,ChatGPT 连续两次都画上了底色。Claude Code 没有再让它重画,而是用 PIL 从四周做漫水填充把底色抠掉,再补一圈描边。
音效和音乐:用 numpy 合成,AI 听不到所以交给我听
声音这部分我选了写代码合成,没有用生成模型。合成的好处是结果确定,改一个参数重新渲染就能复现,声音来源也清楚。
tools/audio/ 下四个文件共约 600 行:dsp.py 是振荡器、包络、滤波、混响这些基础件,sfx.py 定义 21 个音效(拉弓、命中、施法、挥剑、敌人死亡、金币、征兵、升级、波次号角、胜利、失败等),music.py 写了一段 D 小调、96 BPM、16 小节的循环,约 40 秒,混响尾巴绕回开头,循环时听不出接缝。make audio 一条命令重新渲染全部声音;规矩是只改配方代码,不手改音频文件。
这里 AI 有一处很坦白。生成完它说:
听不到声音,只能检查波形和响度,好不好听只有你能判断。
它能做的检查是写测试:每个音效都听得见且不削波,开头结尾都是静音(避免爆音),重新渲染结果完全一致,每小节正好四拍,循环首尾平滑衔接。好不好听这件事,它把第一关 40 秒的实录导出成 build/preview_audio.mp4,交给我来听。
中文字体:小游戏里没有系统字体
小游戏运行在没有系统字体的环境里,中文字体必须自己打包。Claude Code 选了 OFL 授权的 Noto Sans SC Bold,写了 tools/fonts/subset_font.py,扫描游戏里实际用到的汉字,只保留这四百多个字,裁出来 111KB。微信小游戏主包上限 4MB,一个完整中文字体就有好几 MB,裁剪是必须的。代价是每加一段新文案都要跑一次 make font;为了不漏,它加了一个测试,检查游戏里出现过的每个汉字字体里都有。
桌面版还踩过一个坑:在 macOS 上请求 PingFang SC,Godot 实际拿到的是 PingFang HK,「远」「杀」这类简体字缺字,后来改成优先使用 Hiragino Sans GB。
可以照搬的几条做法
| 做法 | 原因 |
|---|---|
| 让 AI 用页面 JS 操作生图网页,截图只用于需要人眼判断的地方 | JS 每一步都有返回值可以校验,比截图猜坐标稳定 |
| 每次操作前先探一遍页面结构,不直接套用旧选择器 | 网页结构会变,这次就遇到了输入框改版和隐藏的第二个输入框 |
| 发送前校验输入框字数和 prompt 一致 | 挡住了一次空发送 |
| 下载后检查尺寸和透明像素比例 | 棋盘格假透明在这一步就能发现 |
| 全部美术在同一个生图对话里出,每次请求写明「和本对话之前的图同一风格」 | 模型能参照对话里的旧图,新开对话会出现风格偏差 |
| prompt 后半段固定写透明背景、一行排开、互不接触、统一朝向、脚底对齐、无文字 | 这些要求决定了图集能不能被脚本自动切开 |
| 切图脚本在物件数量对不上时报错,不猜 | 粘连和多出的碎块都能当场发现 |
| 改画风之前先出一张样图确认 | 一张样图十几分钟,整套重画要更久,方向错了代价大 |
| AI 检查不了的环节(听感、手机上的观感)导出成文件交给人看 | AI 能验证波形和尺寸,判断不了好不好听、看不看得清 |
下一篇讲玩法:我的 8 句试玩反馈,怎么变成无限关卡、局外成长和援军登场。