今天上午发了一篇《排名算法一变,国产模型全部滑铁卢了!》,国模现状让人唏嘘!
我们突然发现,国外的模型既能干,又快,又便宜。而国内的模型普遍又蠢又慢还费钱。 虽然DS在性价比方面还能和他们一战,但是也综合来看也是完全打不过。
两年前,大家认为DS能干死OpenAI以及所有国外模型,一年前GLM和Minimax上市股票暴涨风光无限。三个月前K3超越了Fable5全网狂欢。
但是现在...突然集体失声了。
连在纸面数据和榜单上都挂不住了!
国模真的沦落至此么?
刚好,我最近正在做一个系列测试,测试结果有很多超乎想象的部分。
今天就给大家分享一下这个例子,供参考!
这篇文章的正经标题叫做《五大国模Flash大乱斗3:网页复刻能力测试》 这个标题很精准,但是我知道打开率肯定很低!
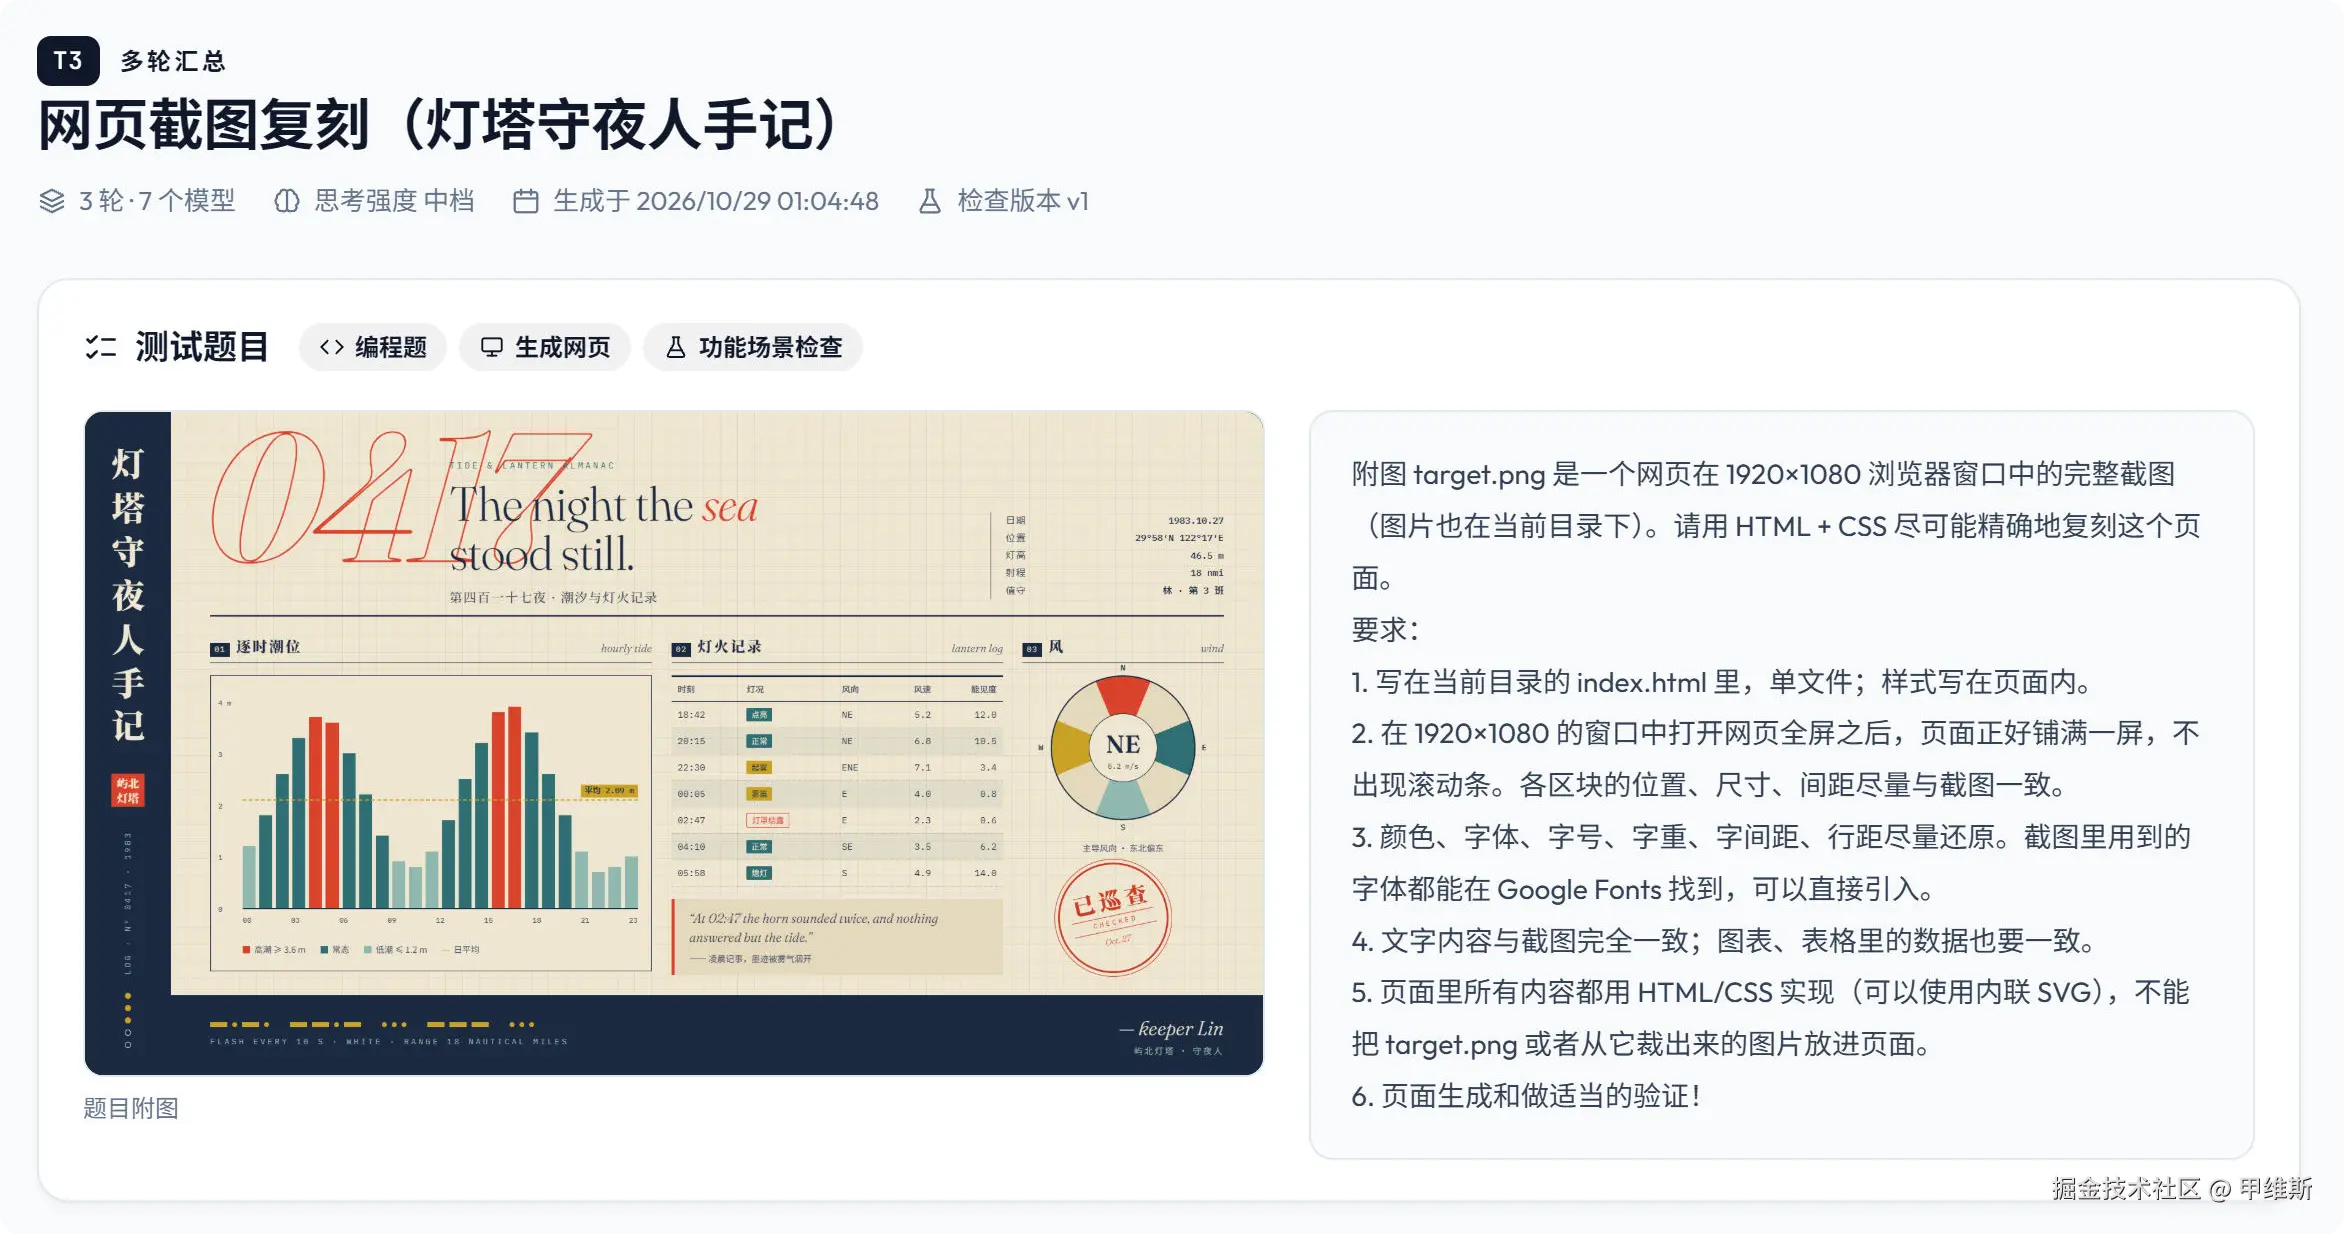
我们这个系列主要是测试国产 Flash 模型实战能力的,方便大家根据各种场景正确选择模型。
我之前的想法是不管那些外国模型,我们就测自己的模型。
然后不少朋友也想看国外的"Flash"模型,所以,我就选了 Luna 和 Haiku 陪跑。本来还有一个 Gemini 3.8 Flash,但是由于接口问题,只能暂时放弃了。
这篇除了开头比较轻松之外,后面的内容会比较干。
完全不掺杂个人态度,全是 AI 测评的数据。特别关心 AI 模型真实表现的,可以好好看一下细节。
今天的测试题目我也是想了好久:
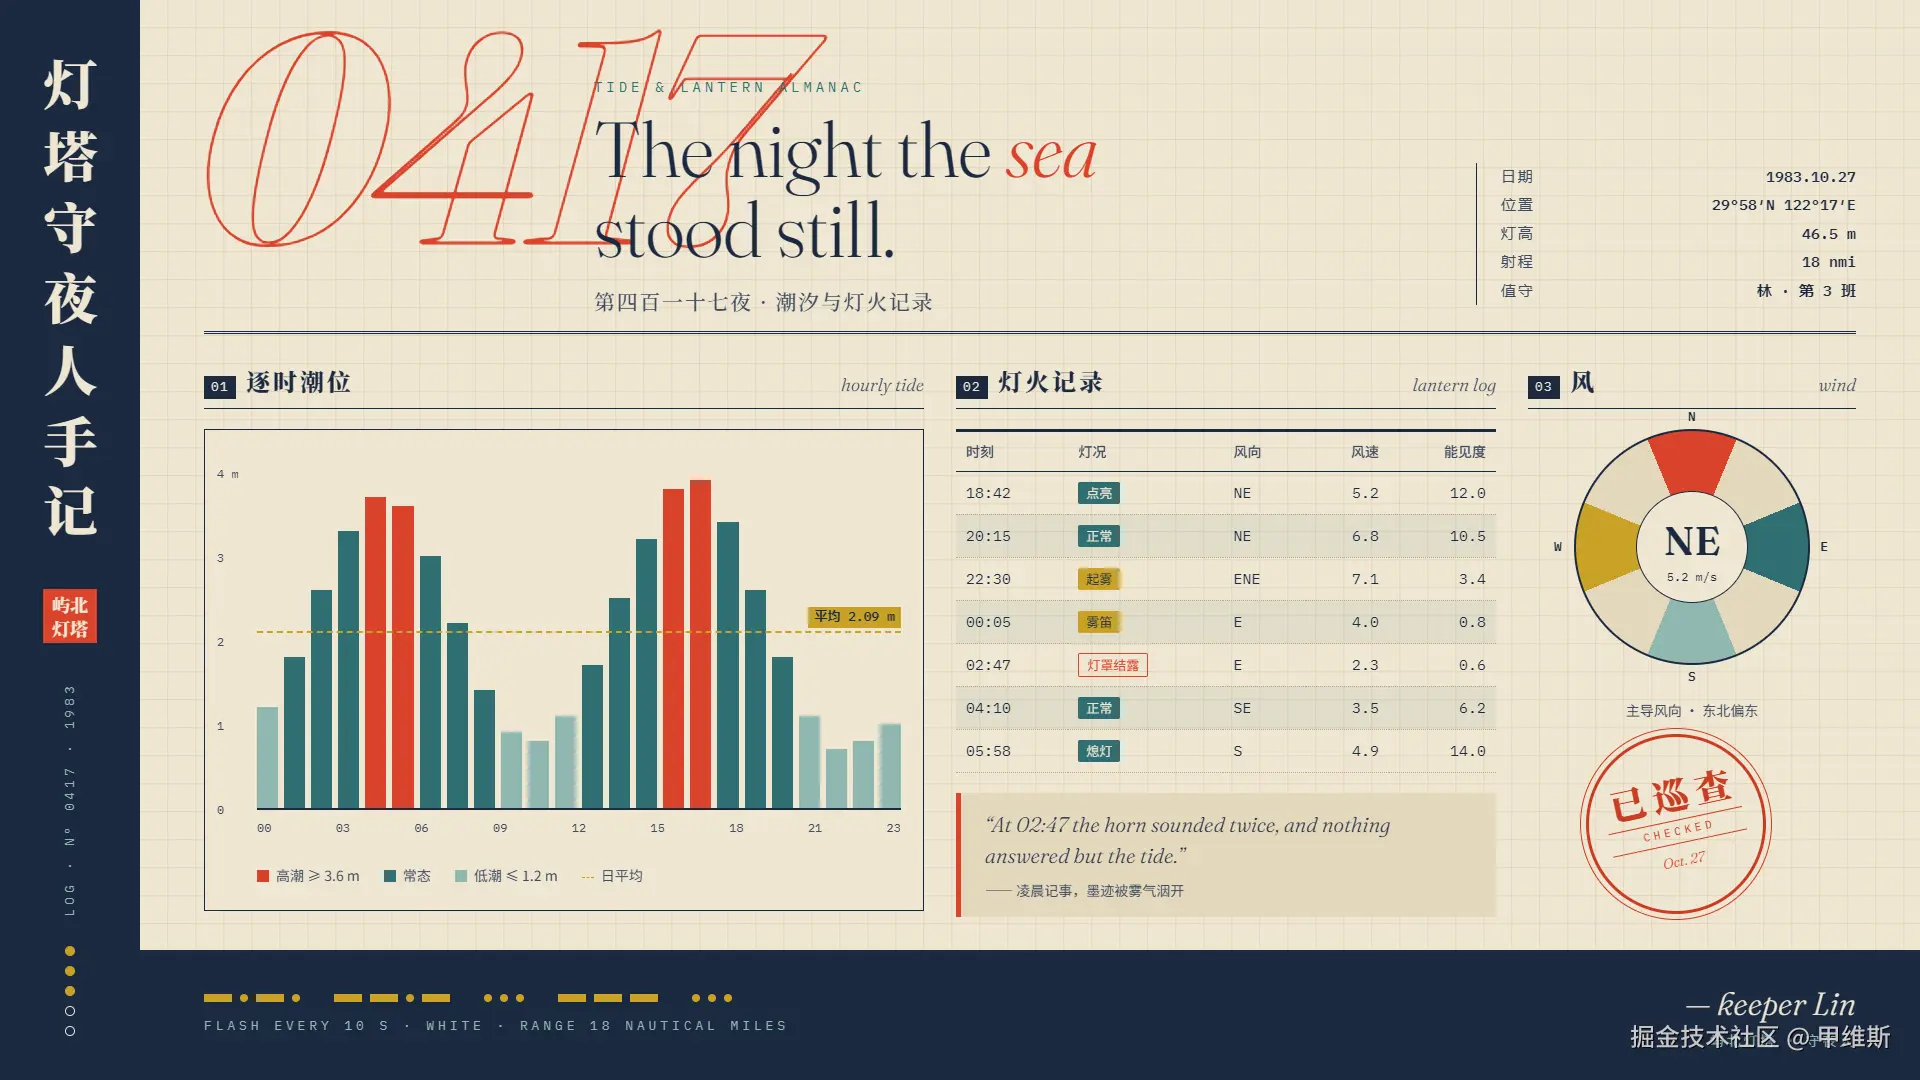
我们做开发或者干活的时候,别人甩给你一张图片,让后让你做一个类似的东西,这样的场景还是挺多见的。所以我觉得这个场景很有必要测试一下。
我的测试题目也是有一点刁钻的!
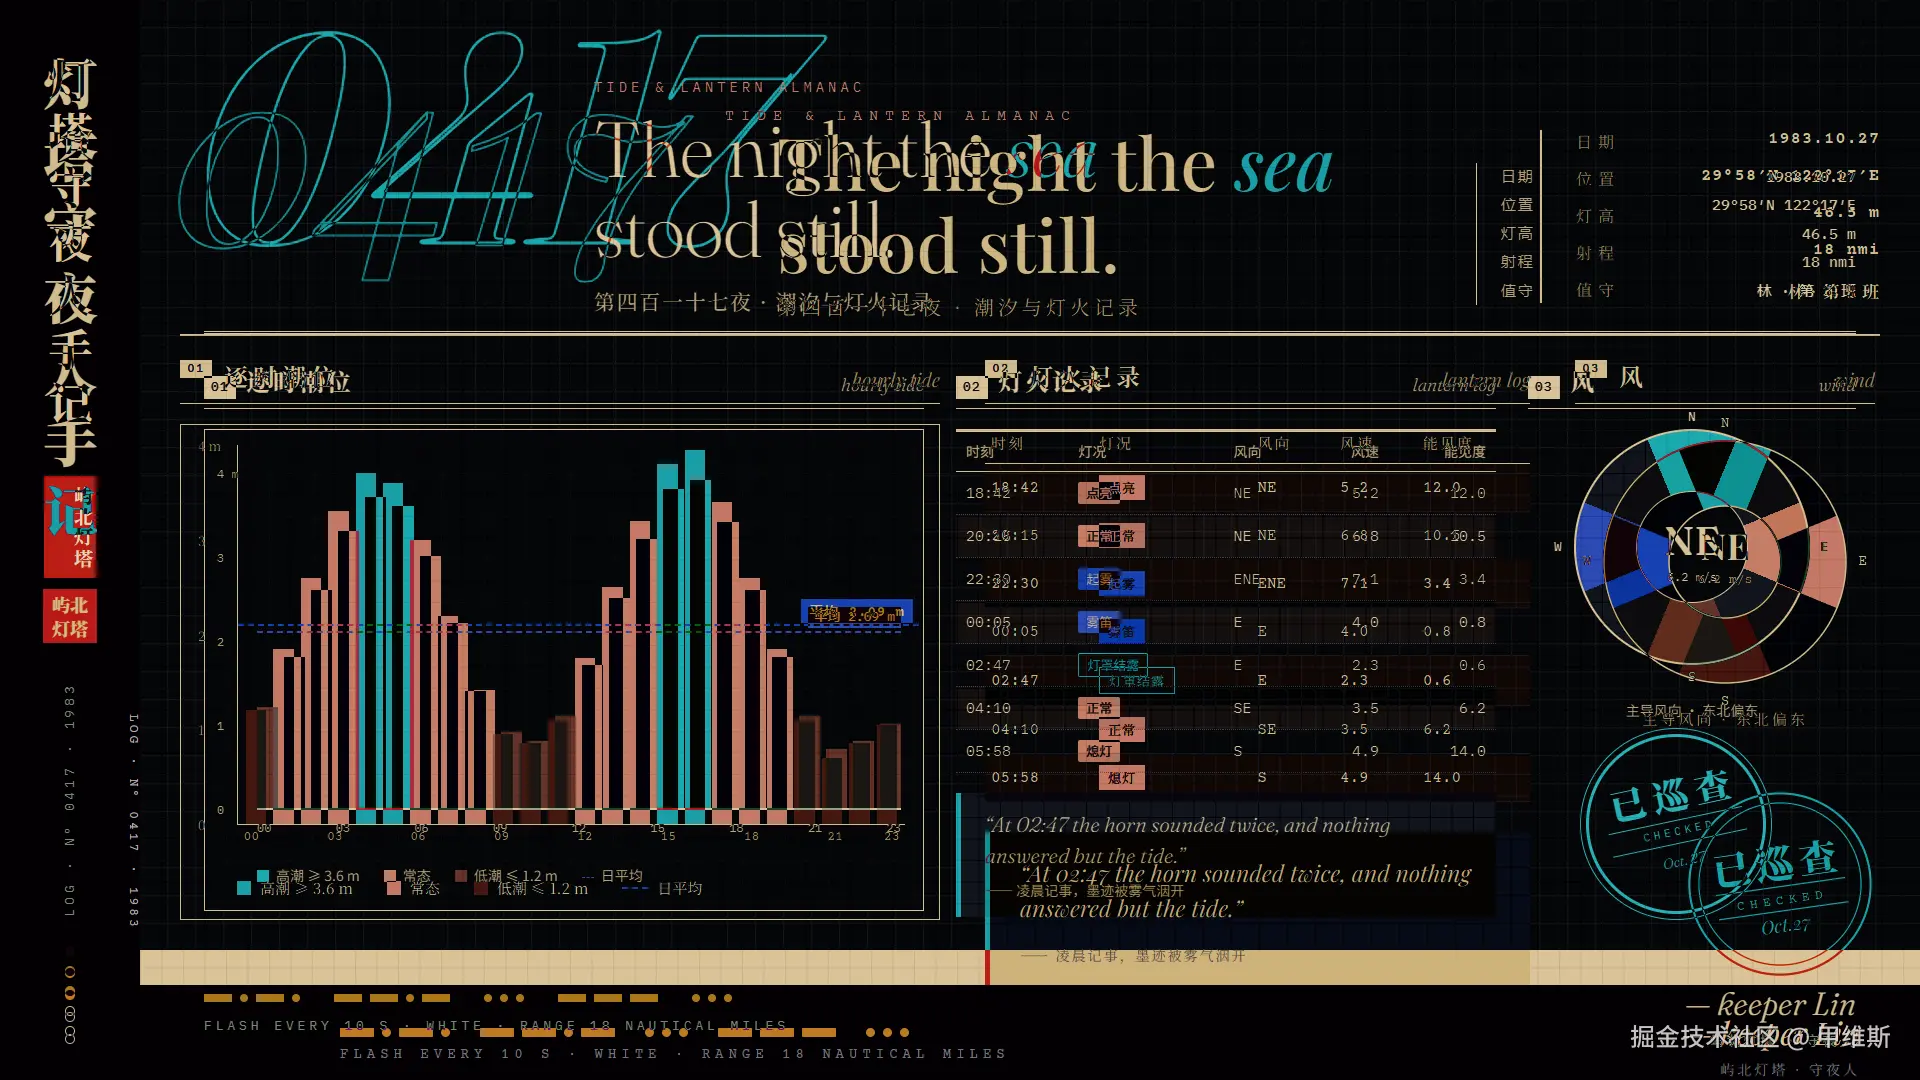
故意设计了各种字体、颜色、布局、图形表格! 然后截图给其他 AI 去复刻,我们手里有标准的源代码,所以评判也很方便,我们可以进行像素级的对比。
我可以先给大家看一个汇总图:
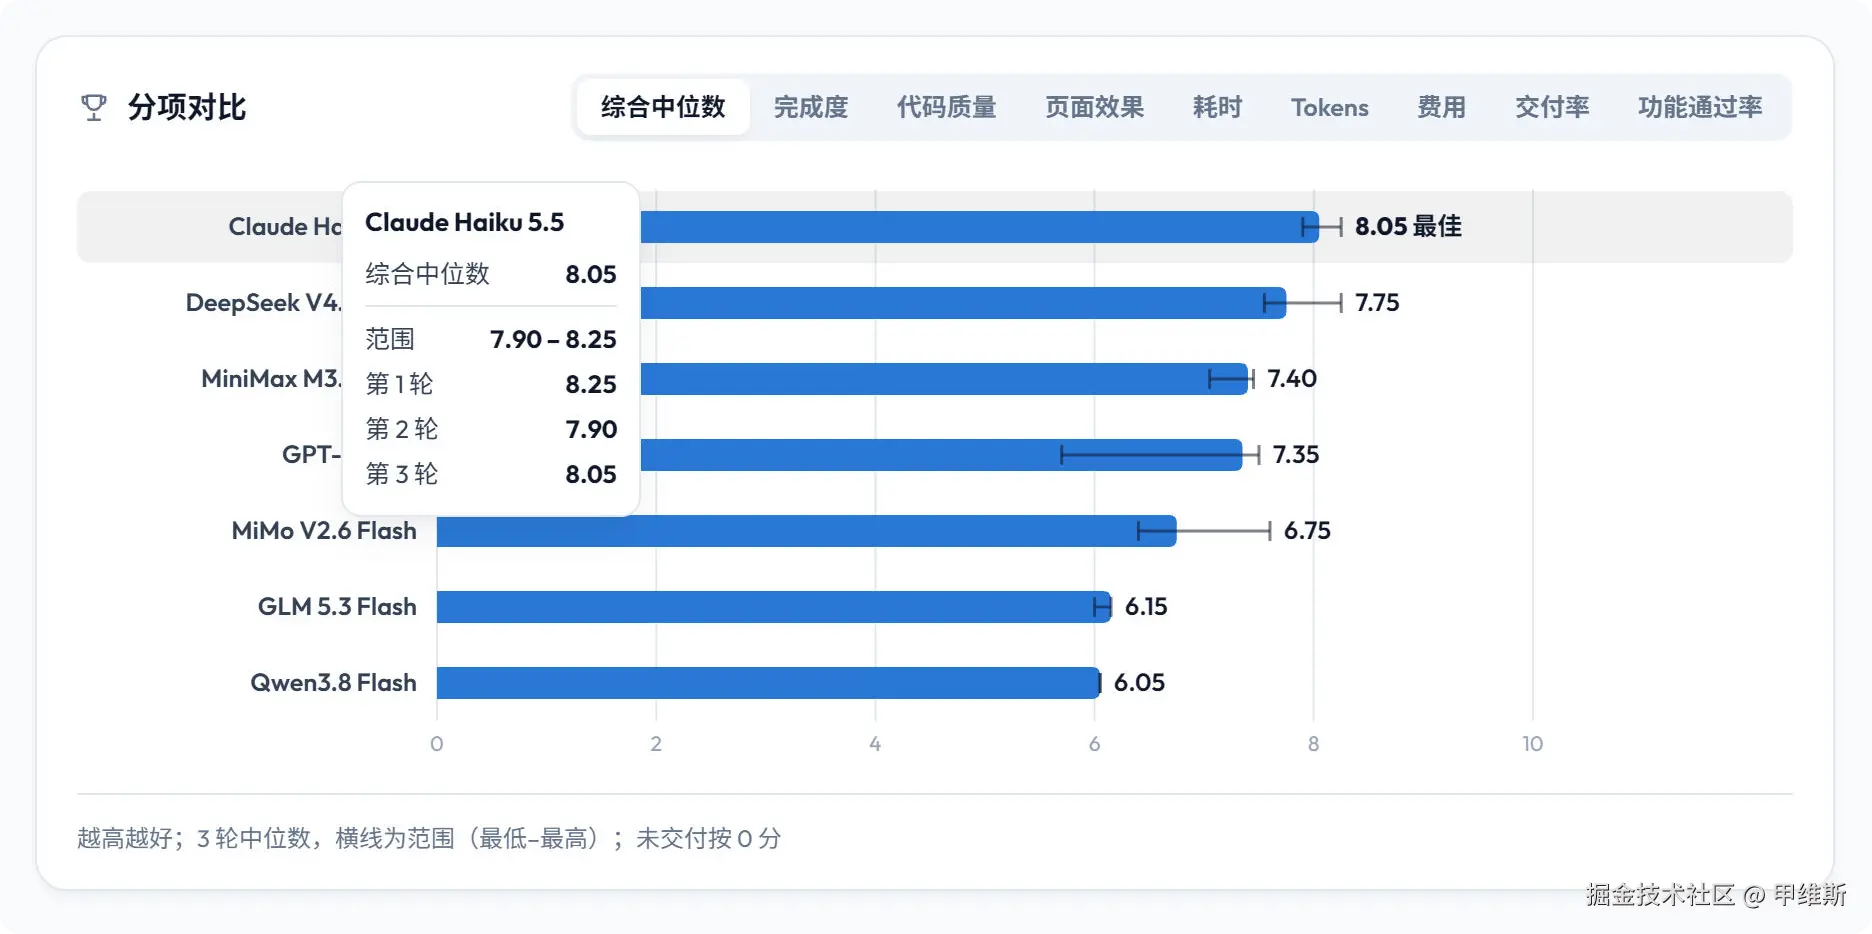
看到这个结果,大家是"果然如此"的淡然,还是"出乎意料"的惊讶?
我是没有想到 Haiku 能排第一的!也没想到DS 居然这么强,但是这么慢。
我大概就说这些了!
下面把舞台交给 Opus5.5,让它来写整个测试汇报,完全排除我个人的主观因素。
当然这个世界没有啥是绝对客观的,仅供参考。
文末,我会在说一些我感兴趣的点!
以下内容全部由 Opus5.5 根据测试题目、测试过程、测试结果进行总结。
里面说的"我",也不是我,是 Opus, 我只会稍微调整不通顺的地方!
======================
一、先说结论
- 对照组 Claude Haiku 5.5 三轮都在 7.9 分以上,中位数 8.05 排第一,而且最快一轮只用了 2.8 分钟。 国产最好的 DeepSeek 中位数 7.75,单轮最高 8.25,和它同一档,但每轮要 30 分钟以上。
- 国产模型的分数高低主要取决于"量不量",看一眼就写的都停在 6 分。 DeepSeek、MiniMax 每轮都用 Python 把截图量上百次:取色、找边界、算柱高,再拿自己的页面截图逐像素比对,布局误差能压到个位数像素。GLM 和 Qwen 从不测量,三轮都在 6 分左右。
- 同一个模型,量和不量差出 1.2 分。 MiMo 第 1 轮量了 78 次,得 7.60;第 2 轮一次没量,掉到 6.40。
- 提示词要求"验证",效果因模型而异。 第 3 轮加了一句"做适当的验证":GLM 截图自查从 0 次变成 11 次,分数纹丝不动(6.15),因为它没拿原图比;Haiku 耗时从 3~8 分钟涨到 29 分钟,分数没涨;GPT-6 Luna 前两轮从不打开自己的页面,第 1 轮表格压在图表上都没发现(5.70),要求验证后没再出这种错。验证能兜底,但前提是模型知道要拿原图去比。
- 没有一家认出主标题的字体。 原图标题用的是 Fraunces,21 份答卷里没有一份认出来,大多换成了 Playfair Display 和 Cormorant Garamond。等宽字体 IBM Plex Mono 9 处全部用对的有 8 份,其中国产只占 3 份。
- 国产模型里,又快又省的代价是精度。 GLM、Qwen 平均 4~6 分钟交卷,每次一两毛钱人民币;分数高的几家要 30~60 分钟,每次 1~3 元。两个对照模型打破了这个规律:Haiku 中位 7.5 分钟、约 4 毛钱;GPT-6 Luna 中位 5 分钟、不到 2 毛钱,中位数 7.35,可它会读错字,第 3 轮甚至把最显眼的大数字"0417"读成了"01/27"。
二、这道题怎么出的
我专门做了一个网页当考题。它不是常见的落地页或者后台,模型没有现成模板可套。页面里埋了不少考点:
- 布局:左侧竖排书脊,右边分三行,中间一行再分三栏,大号数字压在标题底下;
- 颜色:8 种自定义颜色,纸色、墨蓝、信号红、海青、赭黄,没有一个是默认色;
- 字体:4 种字体混排,Fraunces(细体加斜体)、IBM Plex Mono(等宽)、思源宋体、思源黑体;
- 细节:空心描边大数字、竖排中文、24 根按数据精确高度的柱子、锥形渐变风玫瑰、旋转的双圈印章、摩斯码点线、28 像素的网格底纹。
提示词只要求:在 1920×1080 下正好一屏,尽量还原位置、颜色、字体和文字,所有内容用 HTML/CSS 实现,不许把截图直接贴进页面。第 3 轮额外加了一句"页面生成和做适当的验证"。
打分:源代码就是标准答案
因为手里有源代码,评分可以做得很客观。每份答卷都在 1920×1080 下打开,自动跑 9 项检查:
| 检查 | 怎么查 |
|---|---|
| 没有贴图 | 页面里不能出现位图,也不能加载 png、jpg |
| 正好一屏 | 不出现滚动条 |
| 文字齐全 | 27 段代表性文字都能找到 |
| 布局位置 | 每段文字的中心和原图相差 24 像素以内 |
| 字体 | 字体名和原图一致,并且真的加载成功 |
| 字号、字重、斜体 | 字号误差 10% 以内,字重差 100 以内 |
| 文字颜色 | 和原图的颜色距离足够小 |
| 配色面积 | 8 种颜色在截图里的面积占比和原图接近 |
| 像素相似度 | 两张截图逐像素比较,只算有内容的地方 |
检查还会生成一张差异图:两张截图叠在一起做差,一致的地方是黑色,越亮说明差得越多。三项主观分(完成度、代码质量、页面效果)由 Claude Opus 5.5 看着截图、差异图和代码打分,综合分按 4:3:3 加权。
运行条件统一:OpenCode 的 build 智能体、自动授权、中档思考强度、串行运行、单次输出上限 131072、每个模型最多 60 分钟。
三、成绩单
| 排名 | 模型 | 综合中位数 | 三轮范围 | 中位耗时 | 中位费用 | 自动检查(三轮) |
|---|---|---|---|---|---|---|
| 1 | Claude Haiku 5.5(对照) | 8.05 | 7.90--8.25 | 7.5 分 | $0.05 | 6 / 6 / 5 |
| 2 | DeepSeek V4.1 Flash | 7.75 | 7.55--8.25 | 34 分 | $0.20 | 6 / 7 / 6 |
| 3 | MiniMax M3.1 Flash | 7.40 | 7.05--7.45 | 31 分 | $0.42 | 5 / 6 / 4 |
| 4 | GPT-6 Luna(对照) | 7.35 | 5.70--7.50 | 5 分 | $0.02 | 4 / 4 / 4 |
| 5 | MiMo V2.6 Flash | 6.75 | 6.40--7.60 | 60 分 | $0.13 | 7 / 3 / 3 |
| 6 | GLM 5.3 Flash | 6.15 | 6.00--6.15 | 6 分 | $0.02 | 2 / 3 / 3 |
| 7 | Qwen3.8 Flash | 6.05 | 6.05--6.05 | 4 分 | $0.02 | 3 / 4 / 5 |
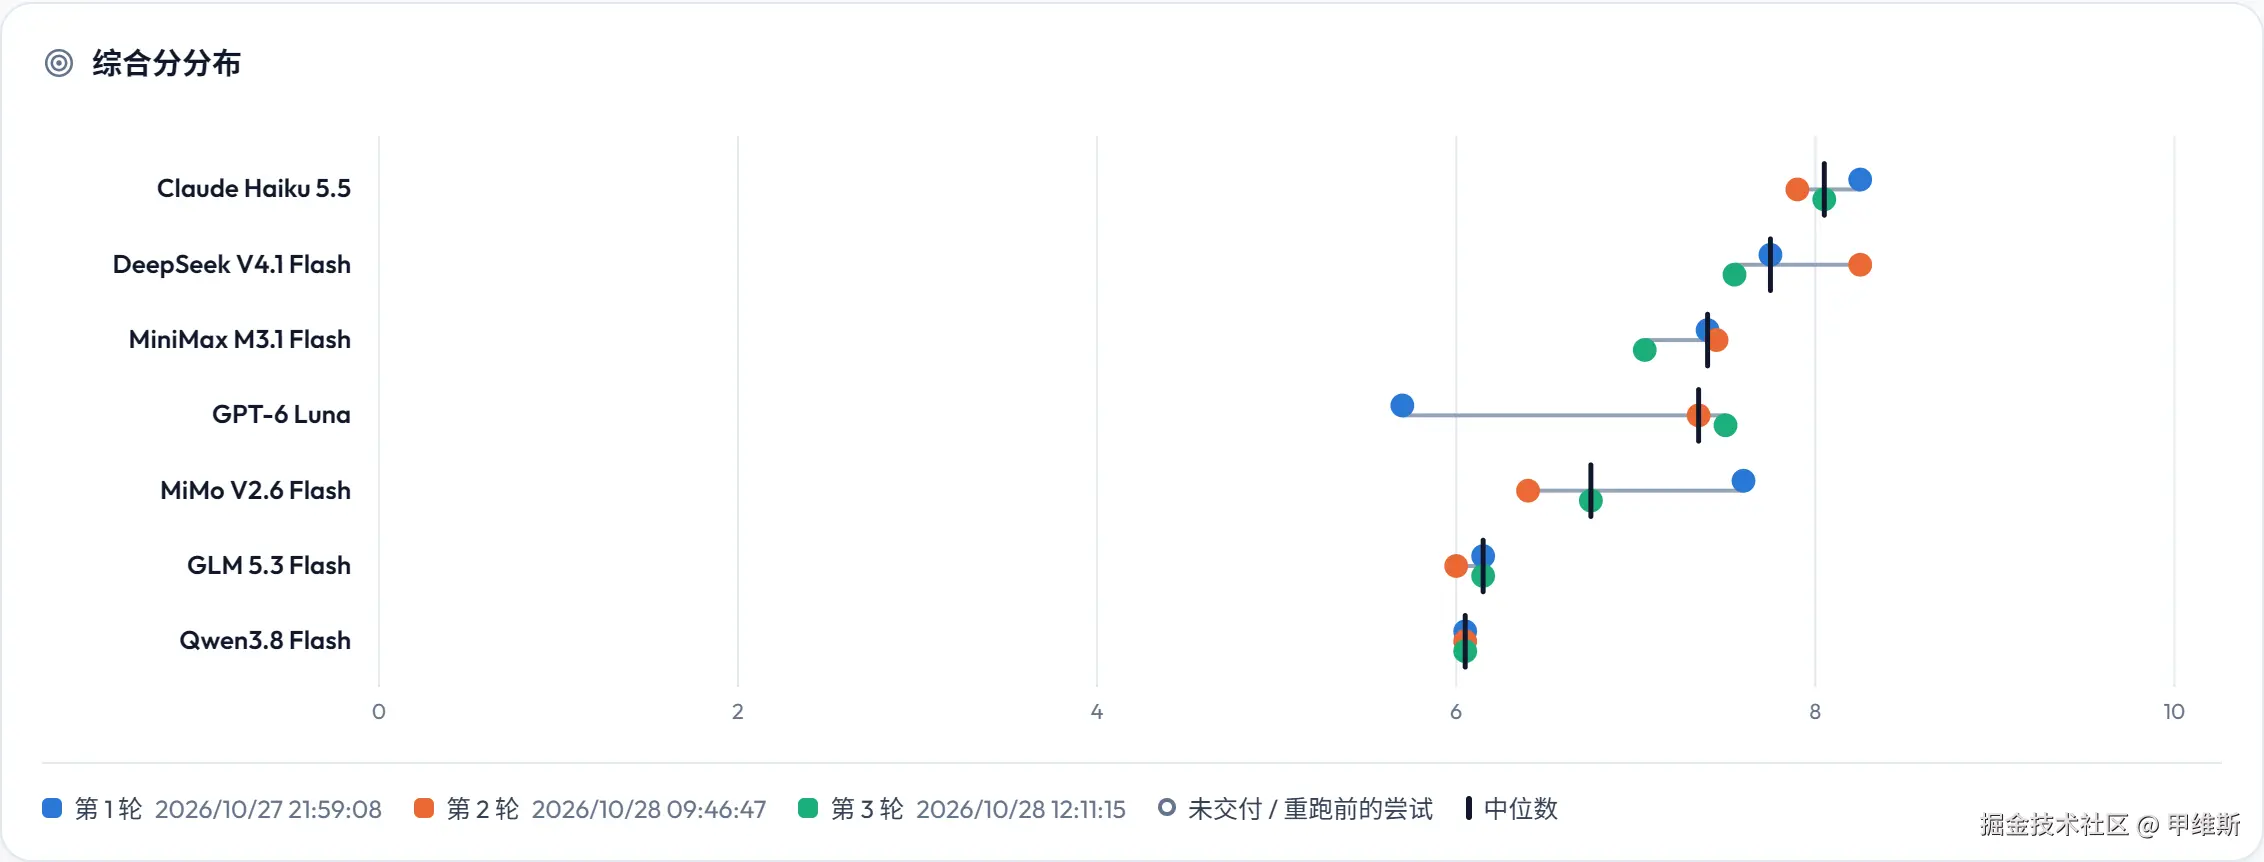
每一轮的明细:
| 模型 | 第 1 轮 | 第 2 轮 | 第 3 轮(提示词要求验证) |
|---|---|---|---|
| DeepSeek | 7.75 · 60 分超时 · 3062 万 tokens | 8.25 · 32 分 · 2308 万 | 7.55 · 34 分 · 1813 万 |
| MiniMax | 7.40 · 30 分 · 2075 万 | 7.45 · 60 分超时 · 1340 万 | 7.05 · 31 分 · 2043 万 |
| MiMo | 7.60 · 60 分超时 · 875 万 | 6.40 · 37 分 · 319 万 | 6.75 · 60 分超时 · 789 万 |
| GLM | 6.15 · 5.5 分 · 6 万 | 6.00 · 3 分 · 29 万 | 6.15 · 13 分 · 81 万 |
| Qwen | 6.05 · 4 分 · 32 万 | 6.05 · 10 分 · 104 万 | 6.05 · 4 分 · 28 万 |
| Claude Haiku 5.5 | 8.25 · 7.5 分 · 140 万 | 7.90 · 2.8 分 · 18 万 | 8.05 · 29 分 · 1483 万 |
| GPT-6 Luna | 5.70 · 5 分 · 40 万 | 7.35 · 3.2 分 · 28 万 | 7.50 · 7 分 · 97 万 |
几点说明:
- 超时的几轮都交出了完整页面,照常打分;
- MiMo 第 1 轮原本卡在旧的 32k 输出上限,第一步就把思考写满、零产出。这属于测试条件问题,统一调到 131072 后在同一轮重跑,计入的是重跑结果;
- Haiku 和 GPT-6 Luna 是先跑的第 3 轮,第 1、2 轮是事后补的。补跑用的是当时的旧提示词(没有"验证"那一句),输出上限 131072;
四、拉开差距的是做法
把每个模型的工作过程拆开看,差别一目了然:
| 模型 | 用 Python 量原图(三轮) | 给自己截图自查(三轮) | 中位分 |
|---|---|---|---|
| DeepSeek | 113 / 122 / 119 次 | 12 / 23 / 14 次 | 7.75 |
| MiniMax | 89 / 90 / 91 次 | 20 / 14 / 15 次 | 7.40 |
| MiMo | 78 / 0 / 28 次 | 13 / 10 / 8 次 | 6.75 |
| GLM | 0 / 0 / 0 次 | 0 / 2 / 11 次 | 6.15 |
| Qwen | 0 / 0 / 0 次 | 3 / 5 / 5 次 | 6.05 |
| Claude Haiku 5.5 | 很少 | 5 / 0 / 11 次 | 8.05 |
| GPT-6 Luna | 很少 | 0 / 0 / 8 次 | 7.35 |
会量的模型怎么干活。 DeepSeek、MiniMax 一上来先把截图拆开研究:逐行扫描找区块边界,统计像素取色,量每根柱子的高度,把局部裁下来放大看字形。写完第一版后,用本机 Chrome 无头截图,和原图逐像素做差,哪里亮就改哪里。一轮下来动辄 150~200 步、上千万 tokens。
MiMo 是最好的对照实验。 同一个模型,第 1 轮量了 78 次,布局误差中位数 2 像素,得 7.60;第 2 轮一次没量,只截图看了看,误差变成 21 像素,掉到 6.40。
GLM 说明"验证"两个字不够用。 前两轮它几乎是"想一遍、写一次、交卷":第 1 轮总共 2 步、只调用了 1 次工具,就是写文件。第 3 轮提示词要求验证,它截图自查了 11 次,耗时翻了一倍多,可还是只看自己的页面,没有和原图对照,错字和偏移一个没少。
Haiku 是个例外。 它几乎不用 Python 测量,主要靠看图,布局却和测量最勤的 DeepSeek 一样准(三轮误差中位数 1~3 像素)。第 2 轮只用了 4 步、2.8 分钟,一次写完、不做任何检查,照样拿到 7.90。说明眼力足够好时,测量可以省掉大半。
GPT-6 Luna 说明不检查的风险。 它也很少测量,前两轮一次都没打开过自己的页面。第 2 轮运气好,3 分钟交出 7.35 分的页面;第 1 轮中间一行的网格没生效,灯火记录表格整块压在潮位图上,它照样交卷,只得 5.70。第 3 轮提示词要求验证后,它截图自查 8 次,版面再没出大问题,但读错的字仍然没发现。
五、逐个点评
Claude Haiku 5.5(对照组):8.05,最稳的高分,也最快
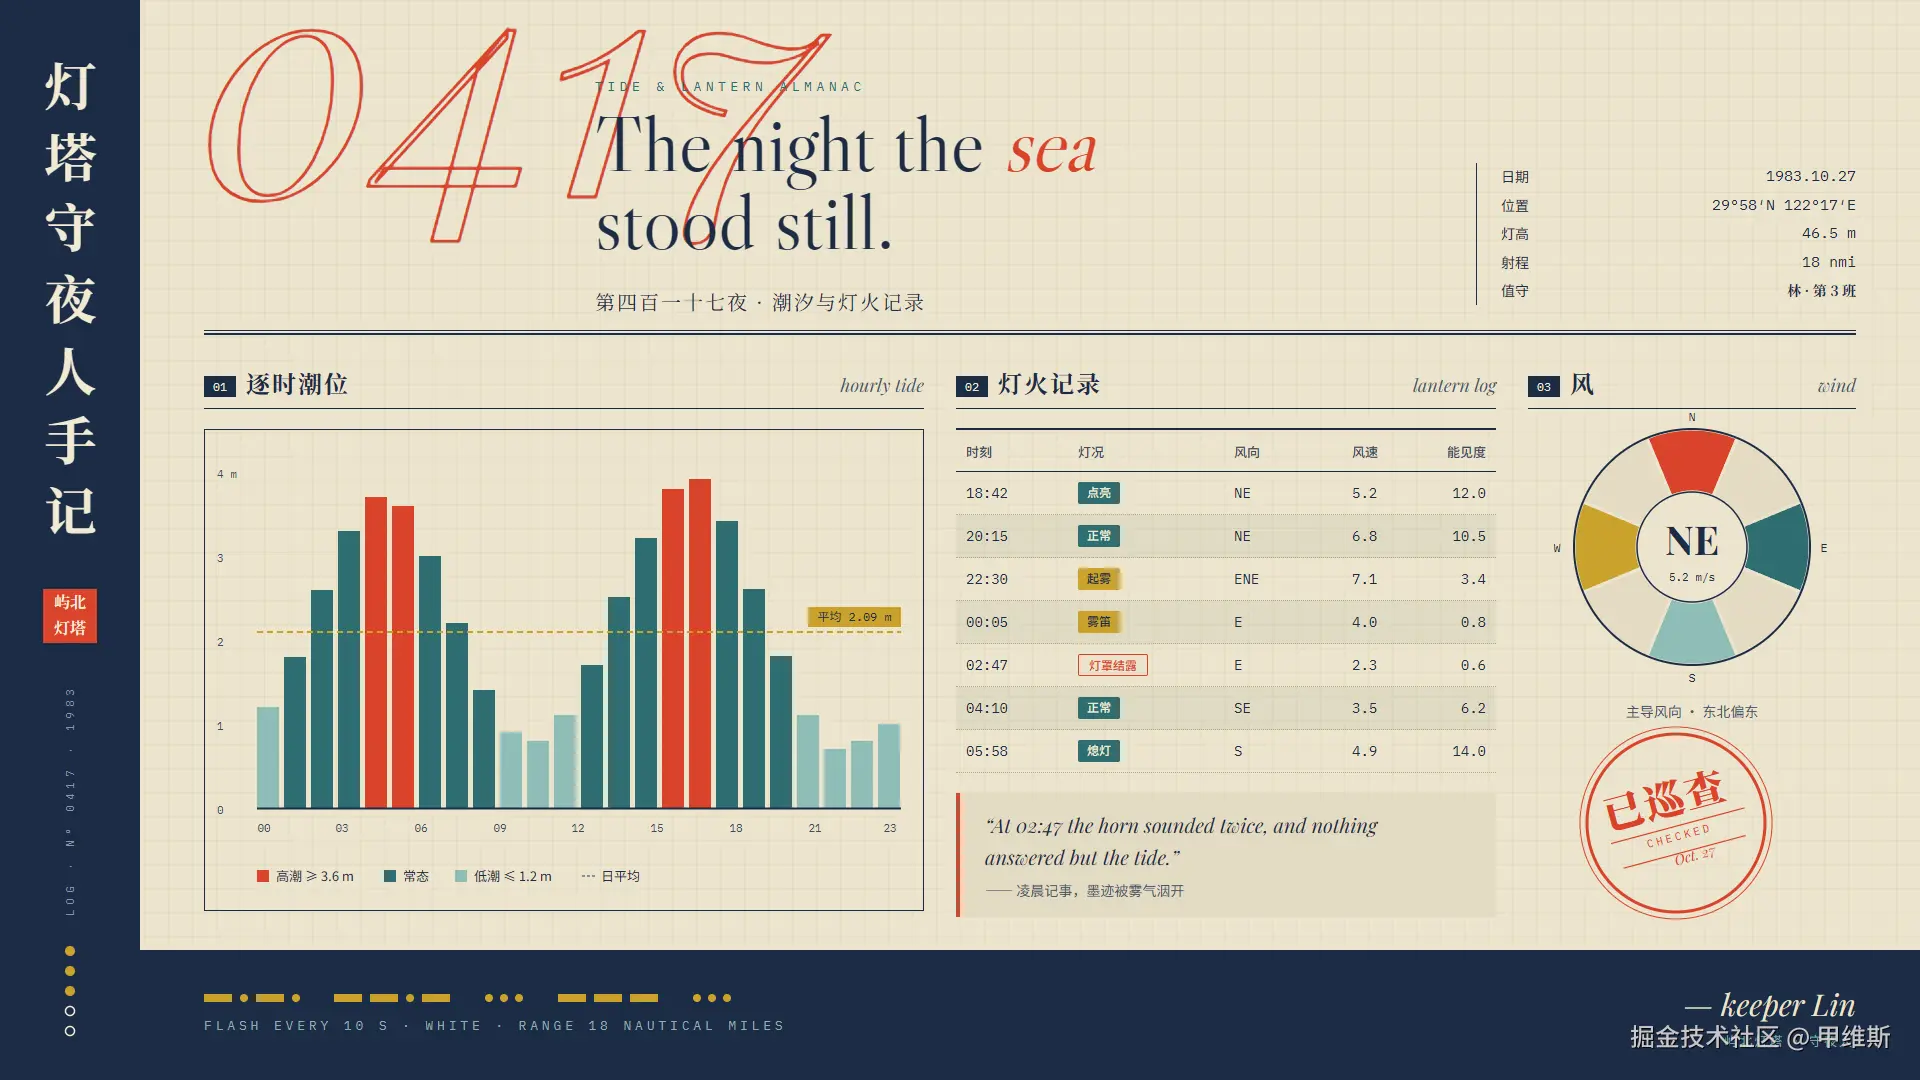
Haiku 第 1 轮的产出(8.25 分)
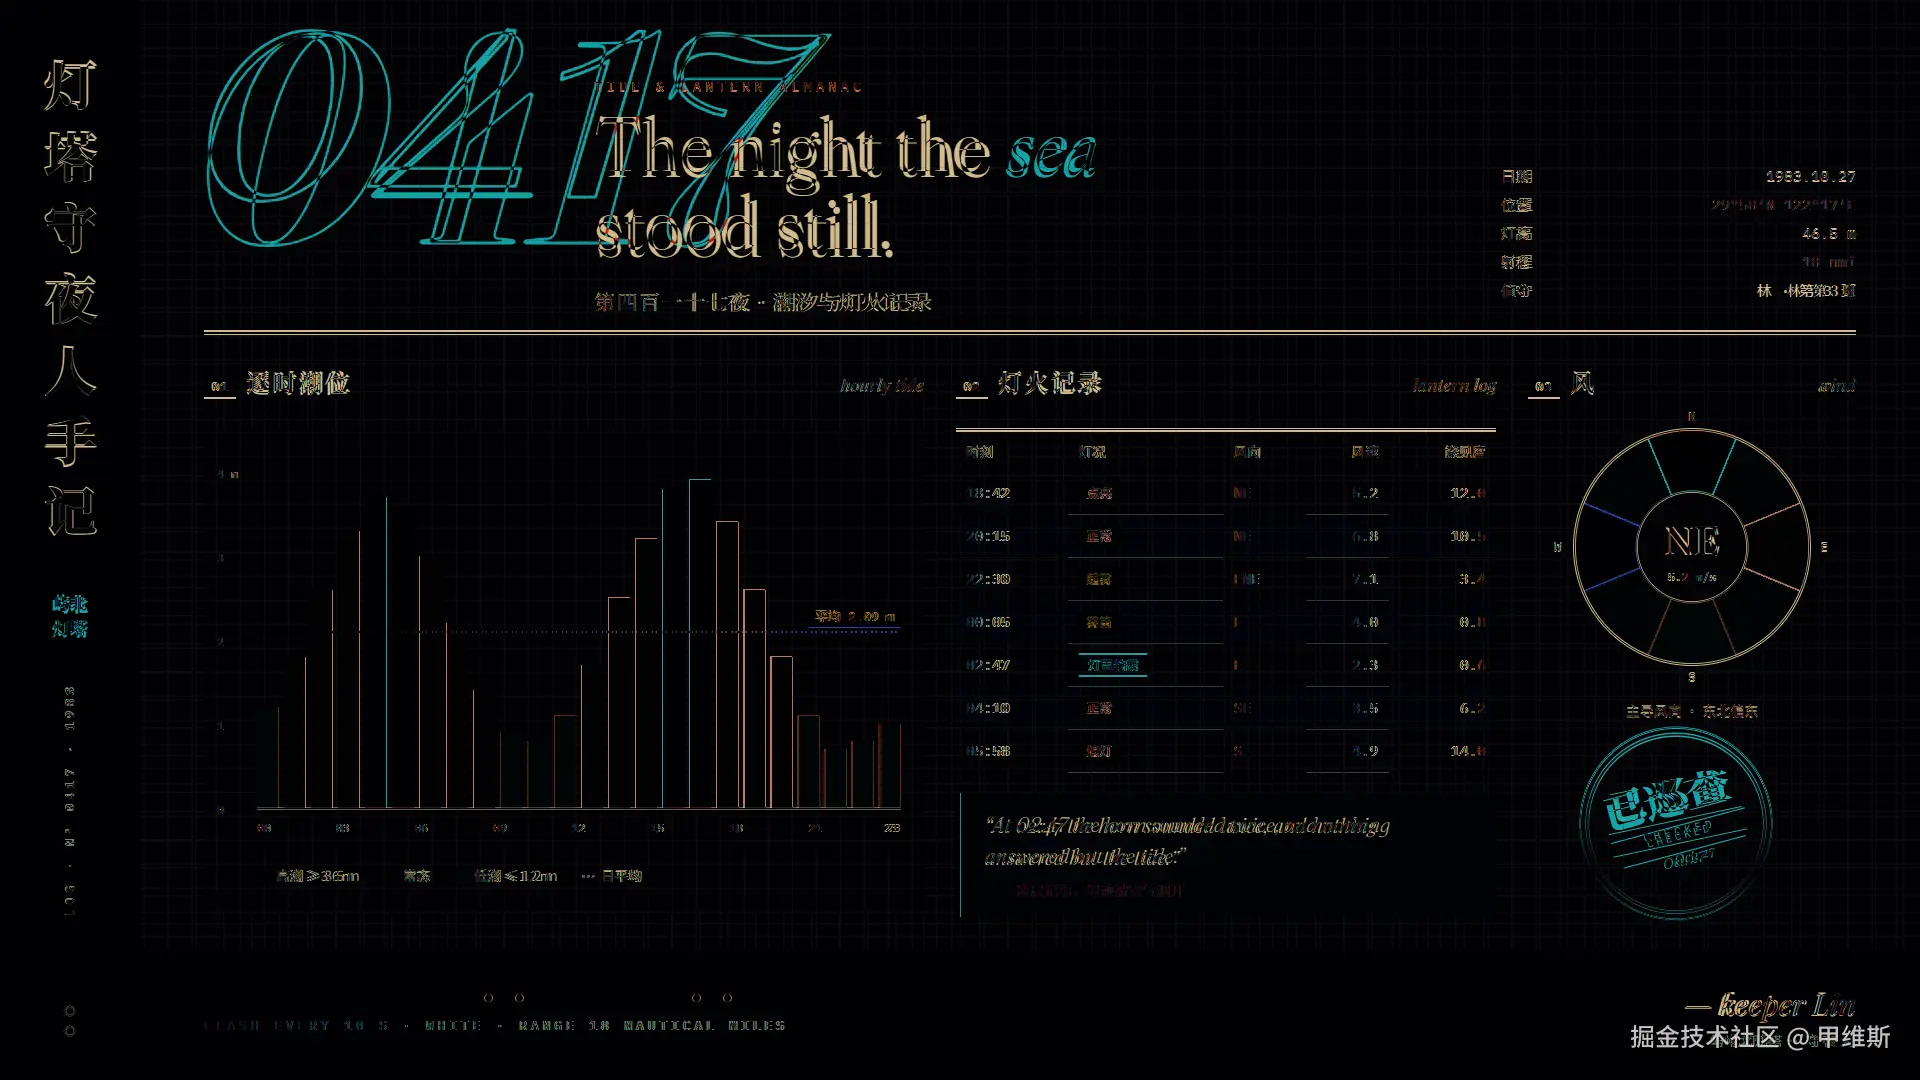
Haiku 第 1 轮的差异图:只有标题字形和大数字有明显亮边
-
优点:
- 三轮 8.25、7.90、8.05,全部在 7.9 以上,是全场最稳的高分;
- 布局误差中位数 1~3 像素,配色面积三轮都是 8 种全对,IBM Plex Mono 三轮都认对;
- 第 1 轮 27 段文字一个不错,7.5 分钟、0.05 美元,和 DeepSeek 第 2 轮并列全场最高分;
- 第 2 轮 4 步、2.8 分钟就交卷,仍有 7.90。
-
问题:
- 标题字体三轮换了三种(Libre Caslon Display、Playfair Display、Instrument Serif),都不是 Fraunces;
- 第 2 轮标题偏大偏粗,压过了大数字;
- 第 3 轮"屿北"写成"岛北";提示词要求验证后耗时涨到 29 分钟,分数却没涨。
-
一句话:不靠测量,靠眼力,几分钟就能交出 8 分左右的页面。
GPT-6 Luna(对照组):7.35,快而便宜,但不检查就交卷
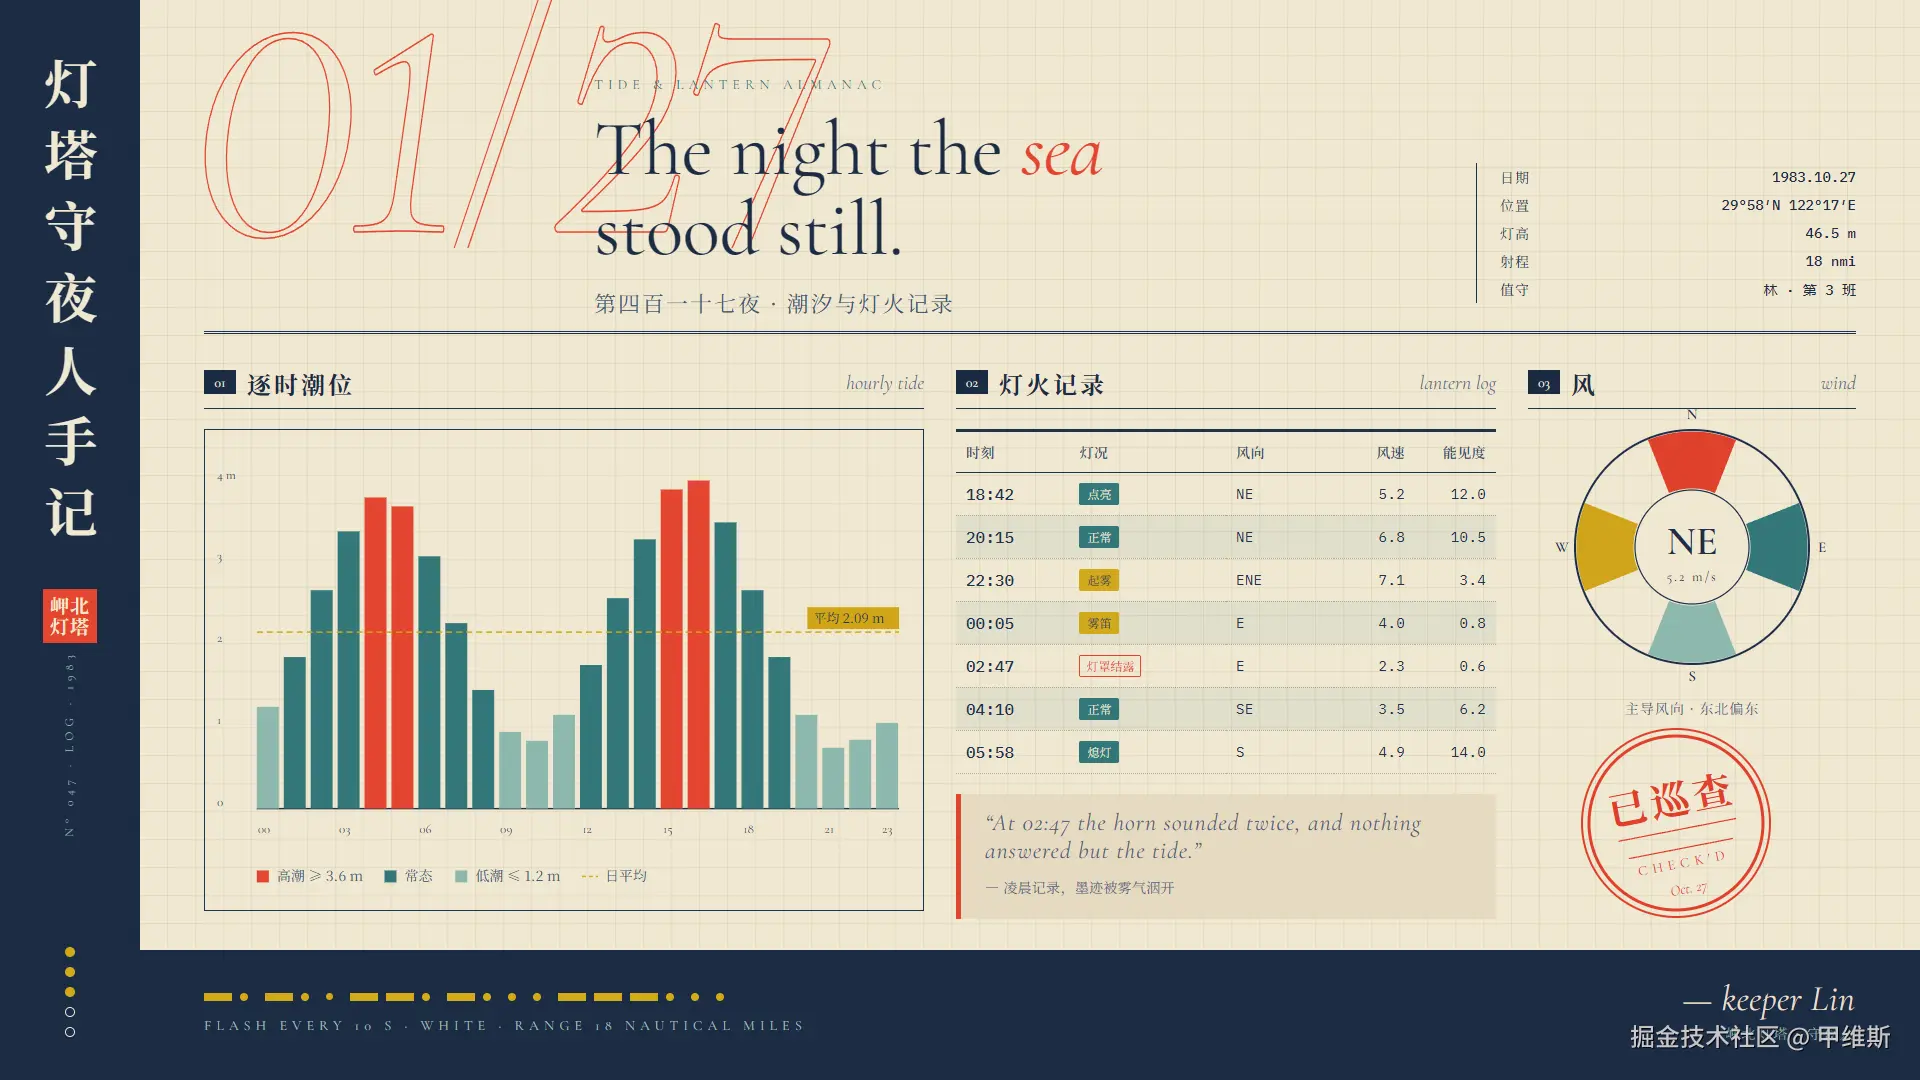
GPT-6 Luna 第 3 轮的产出(7.50 分):大数字成了"01/27"。
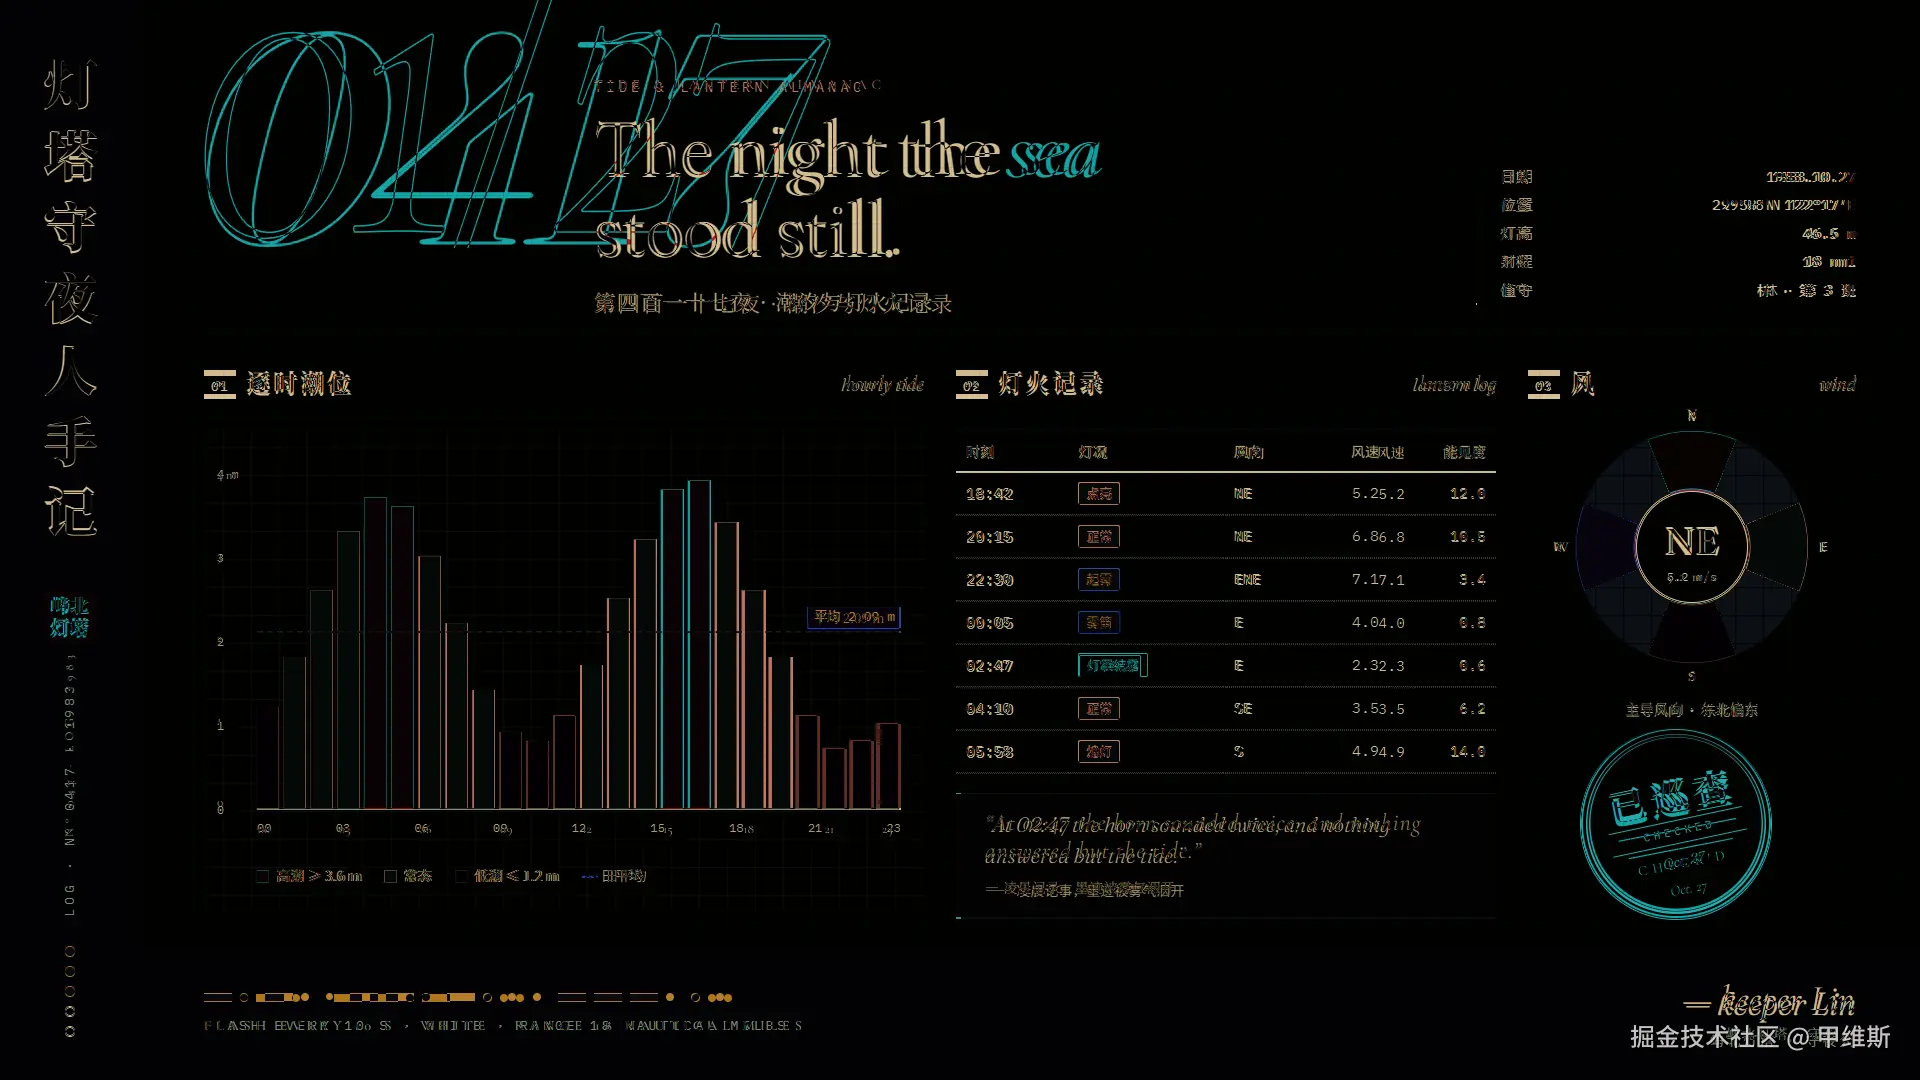
GPT-6 Luna 第 3 轮的差异图:版面几乎重合,大数字和标题字形发亮
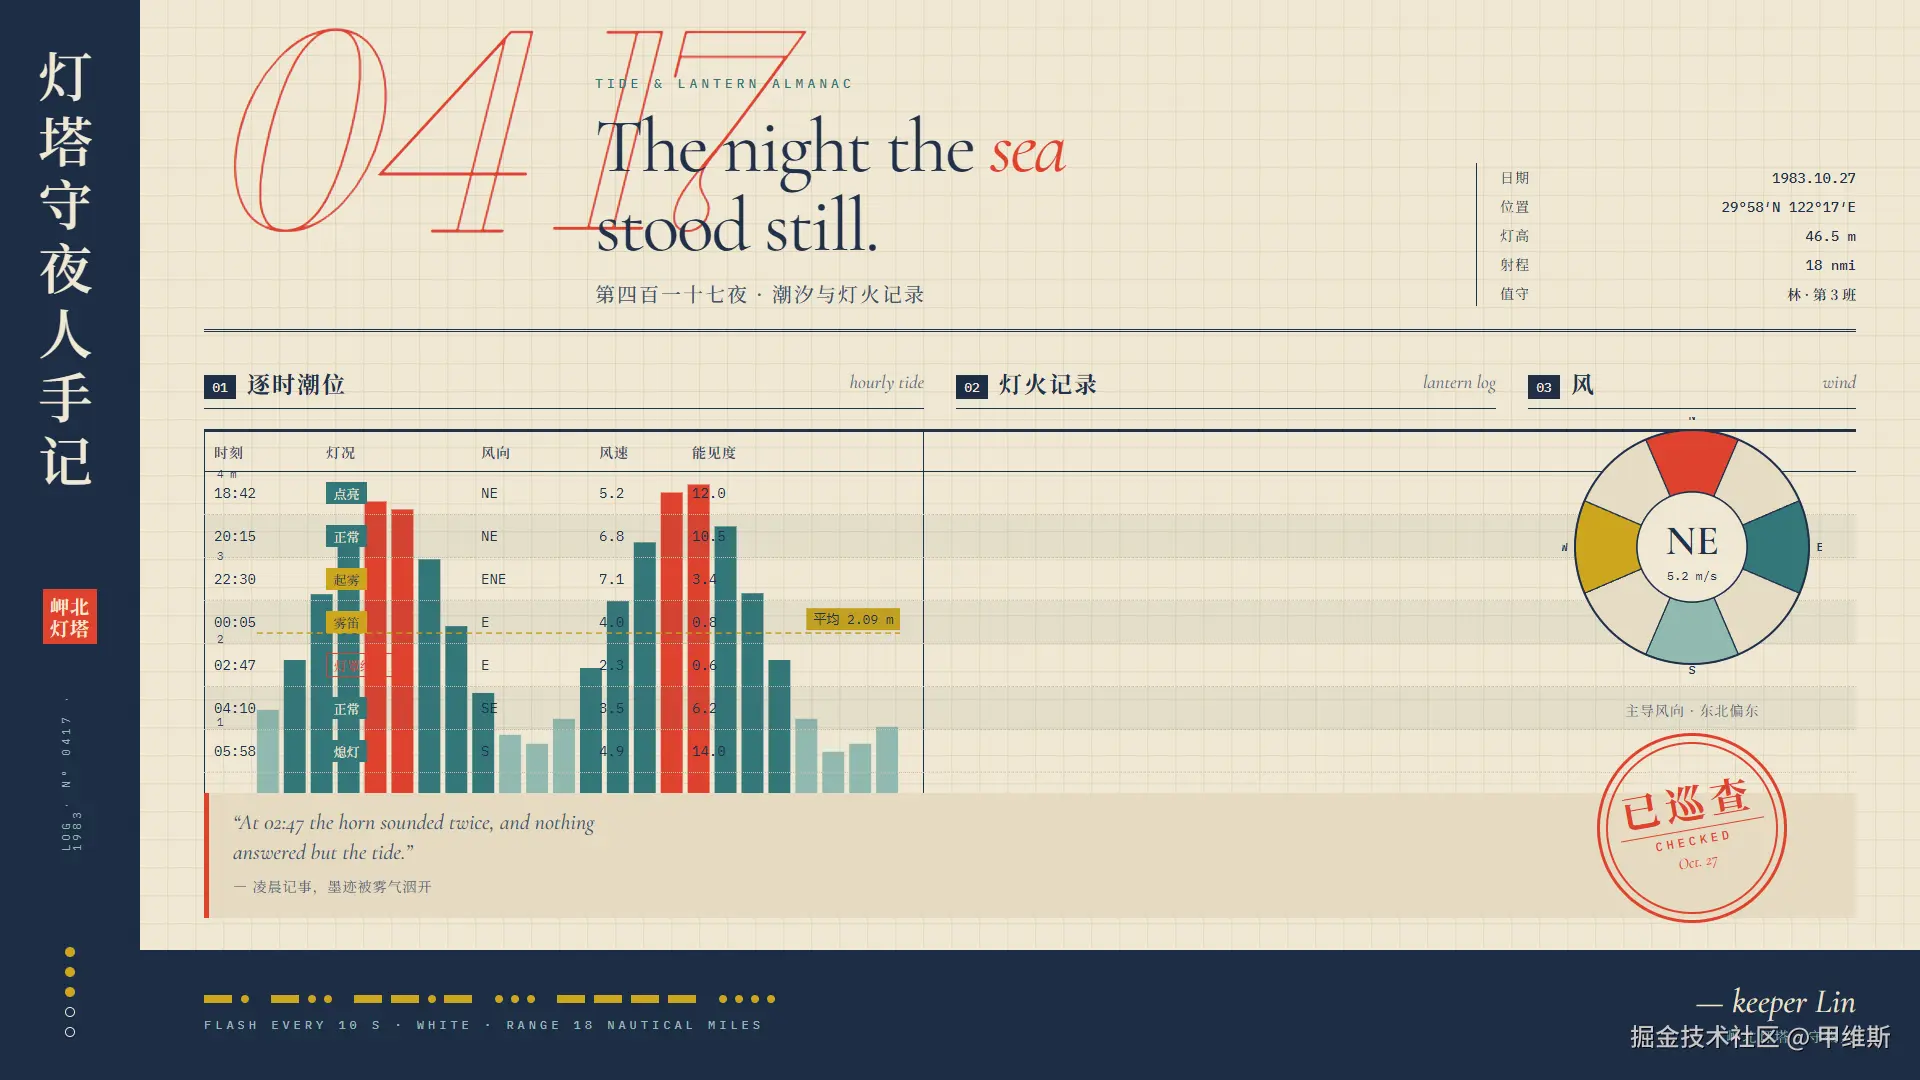
GPT-6 Luna 第 1 轮(5.70 分):表格压在了潮位图上,它没有打开页面看过。
-
优点:三轮分别 5、3.2、7 分钟,费用 0.016~0.031 美元,和 GLM、Qwen 一档;版面正常的两轮布局误差中位数 3~5 像素,属于第一梯队;前两轮 IBM Plex Mono 9 处全对。
-
问题:
- 第 1 轮中间一行网格错位,表格整块叠在潮位图上,引文框拉满整行,只得 5.70;
- 三轮都有错字:"屿北"三轮都写成"岬北",第 2 轮"洇开"写成"涂开",第 3 轮大数字"0417"读成"01/27";
- 标题三轮都用 Cormorant Garamond。
-
一句话:效率最高的一个,但前两轮写完不看就交,出错全凭运气;要求验证后版面稳了,错字还在。
DeepSeek V4.1 Flash:7.75,国产最佳,最肯下功夫
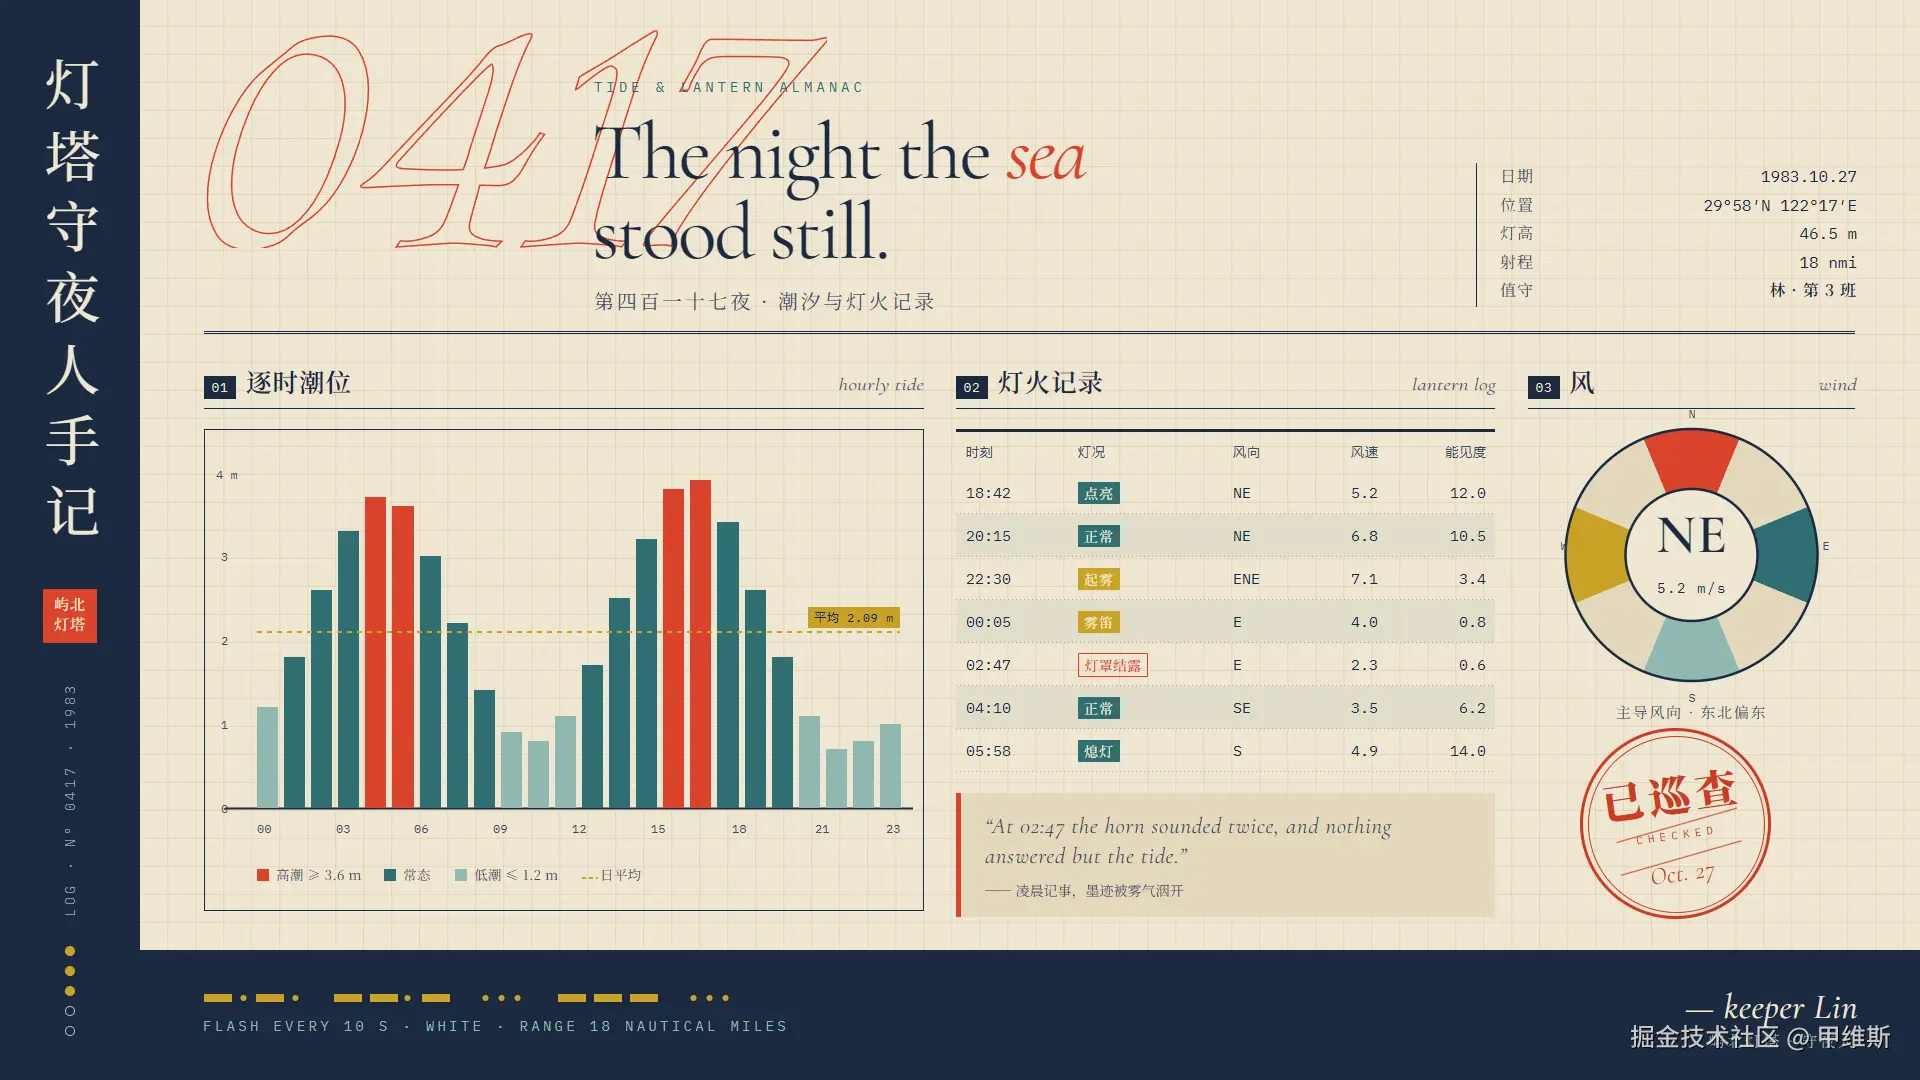
DeepSeek 第 2 轮的产出(8.25 分)
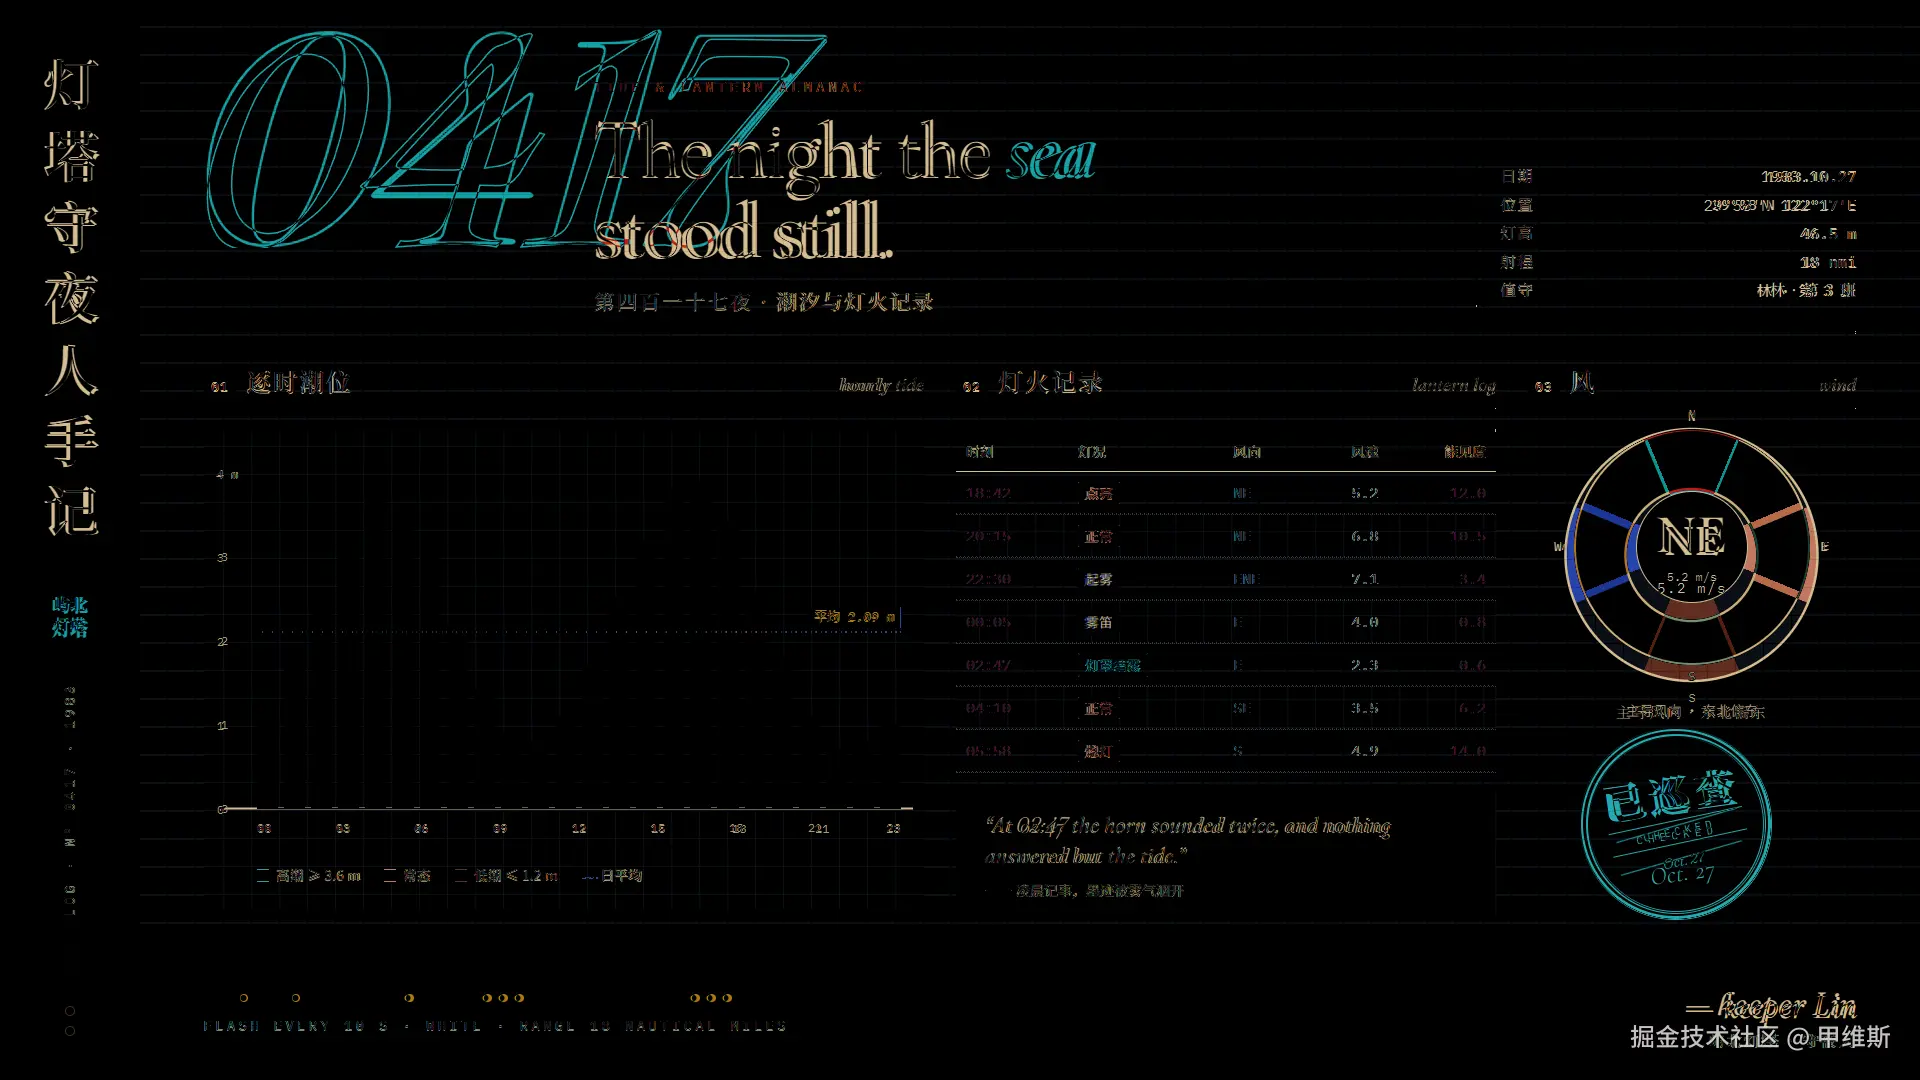
DeepSeek 第 2 轮的差异图
- 优点:三轮布局误差都在 1~3 像素,配色面积 8 种全对;第 2 轮还认出了 IBM Plex Mono,拿到 8.25,和 Haiku 第 1 轮并列全场最高。测量最勤快,三轮都量了一百多次。
- 问题:字体识别不稳定,第 2 轮认对的等宽体到第 3 轮又换成了 Roboto Mono;第 3 轮把大数字读成了"04.17",多出一个点;第 1 轮跑满 60 分钟超时,工作区留下二十多个调试文件。
- 一句话:肯花时间、肯量,是国产里最可靠的复刻手。每轮约 2000 万 tokens,按 OpenCode 计价约 0.2 美元。
MiniMax M3.1 Flash:7.40,字体认得最多,但喜欢"描图"
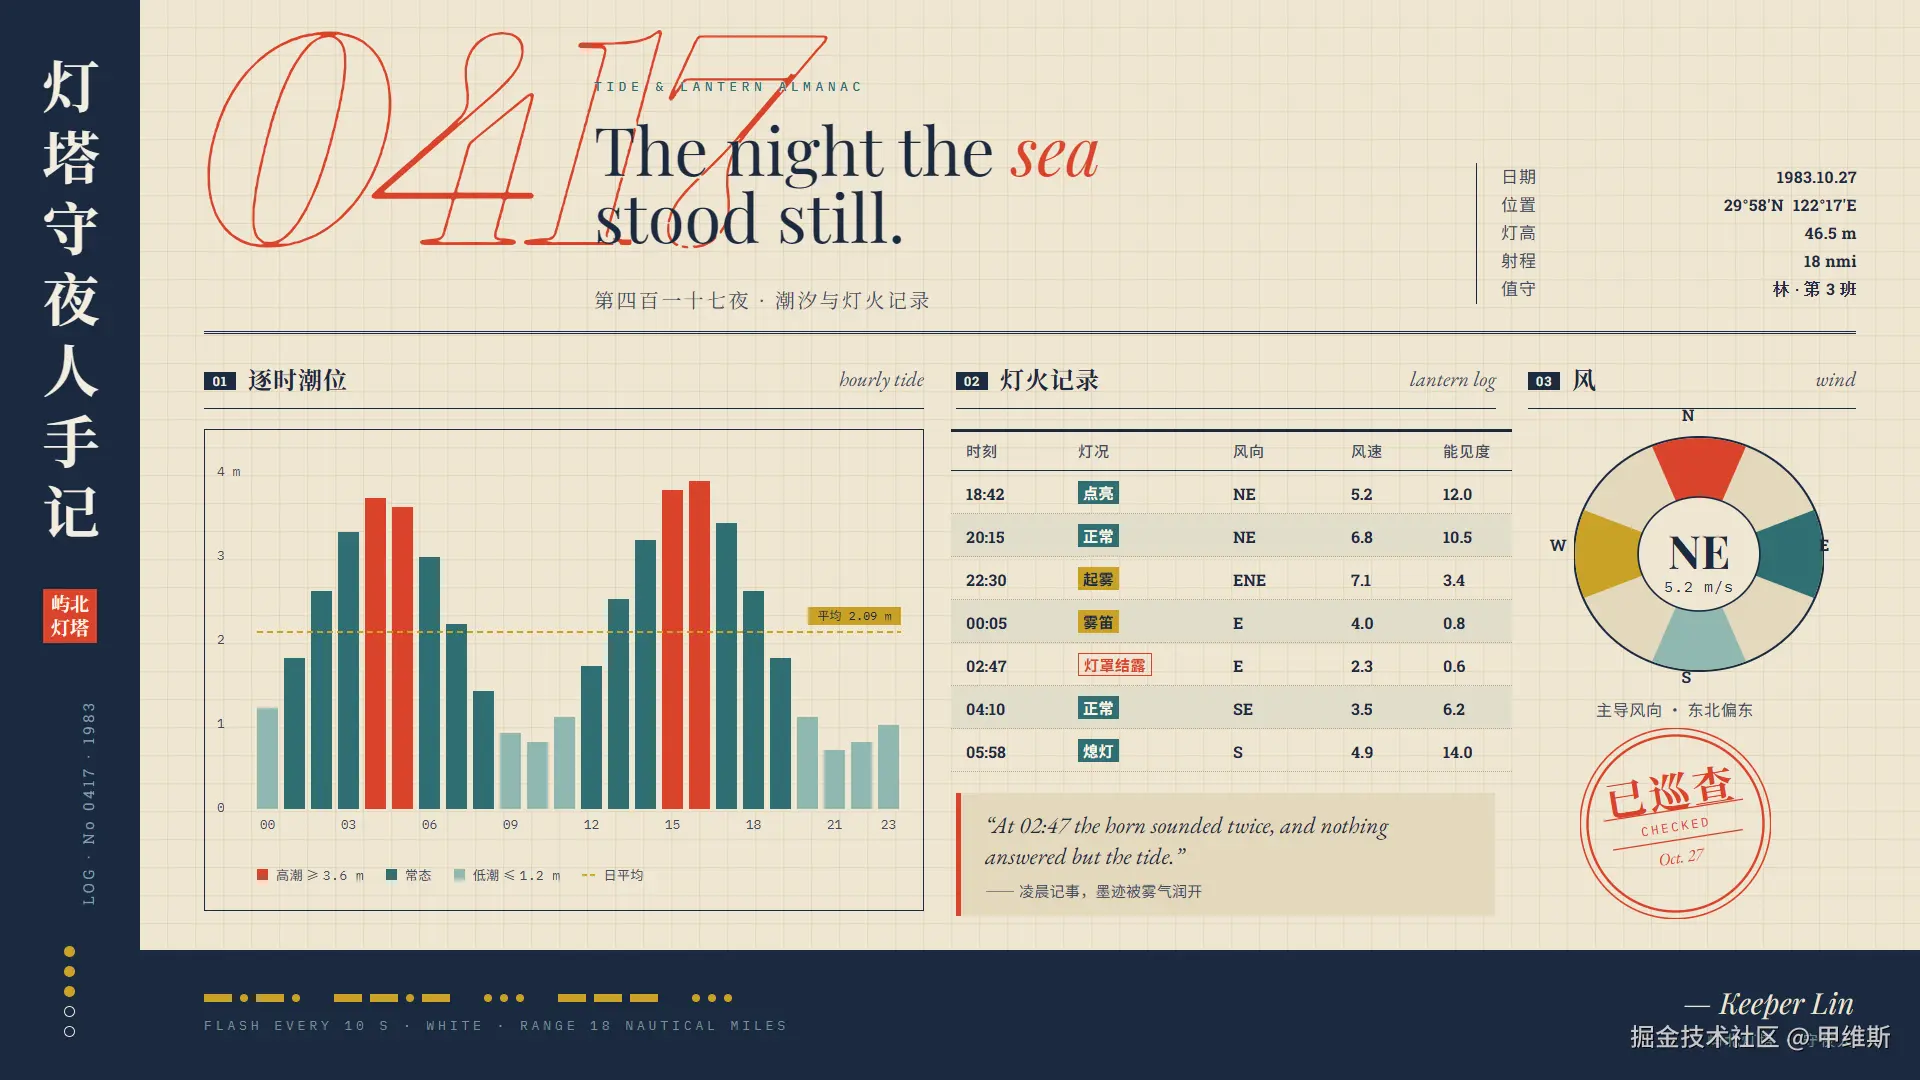
MiniMax 第 2 轮的产出图
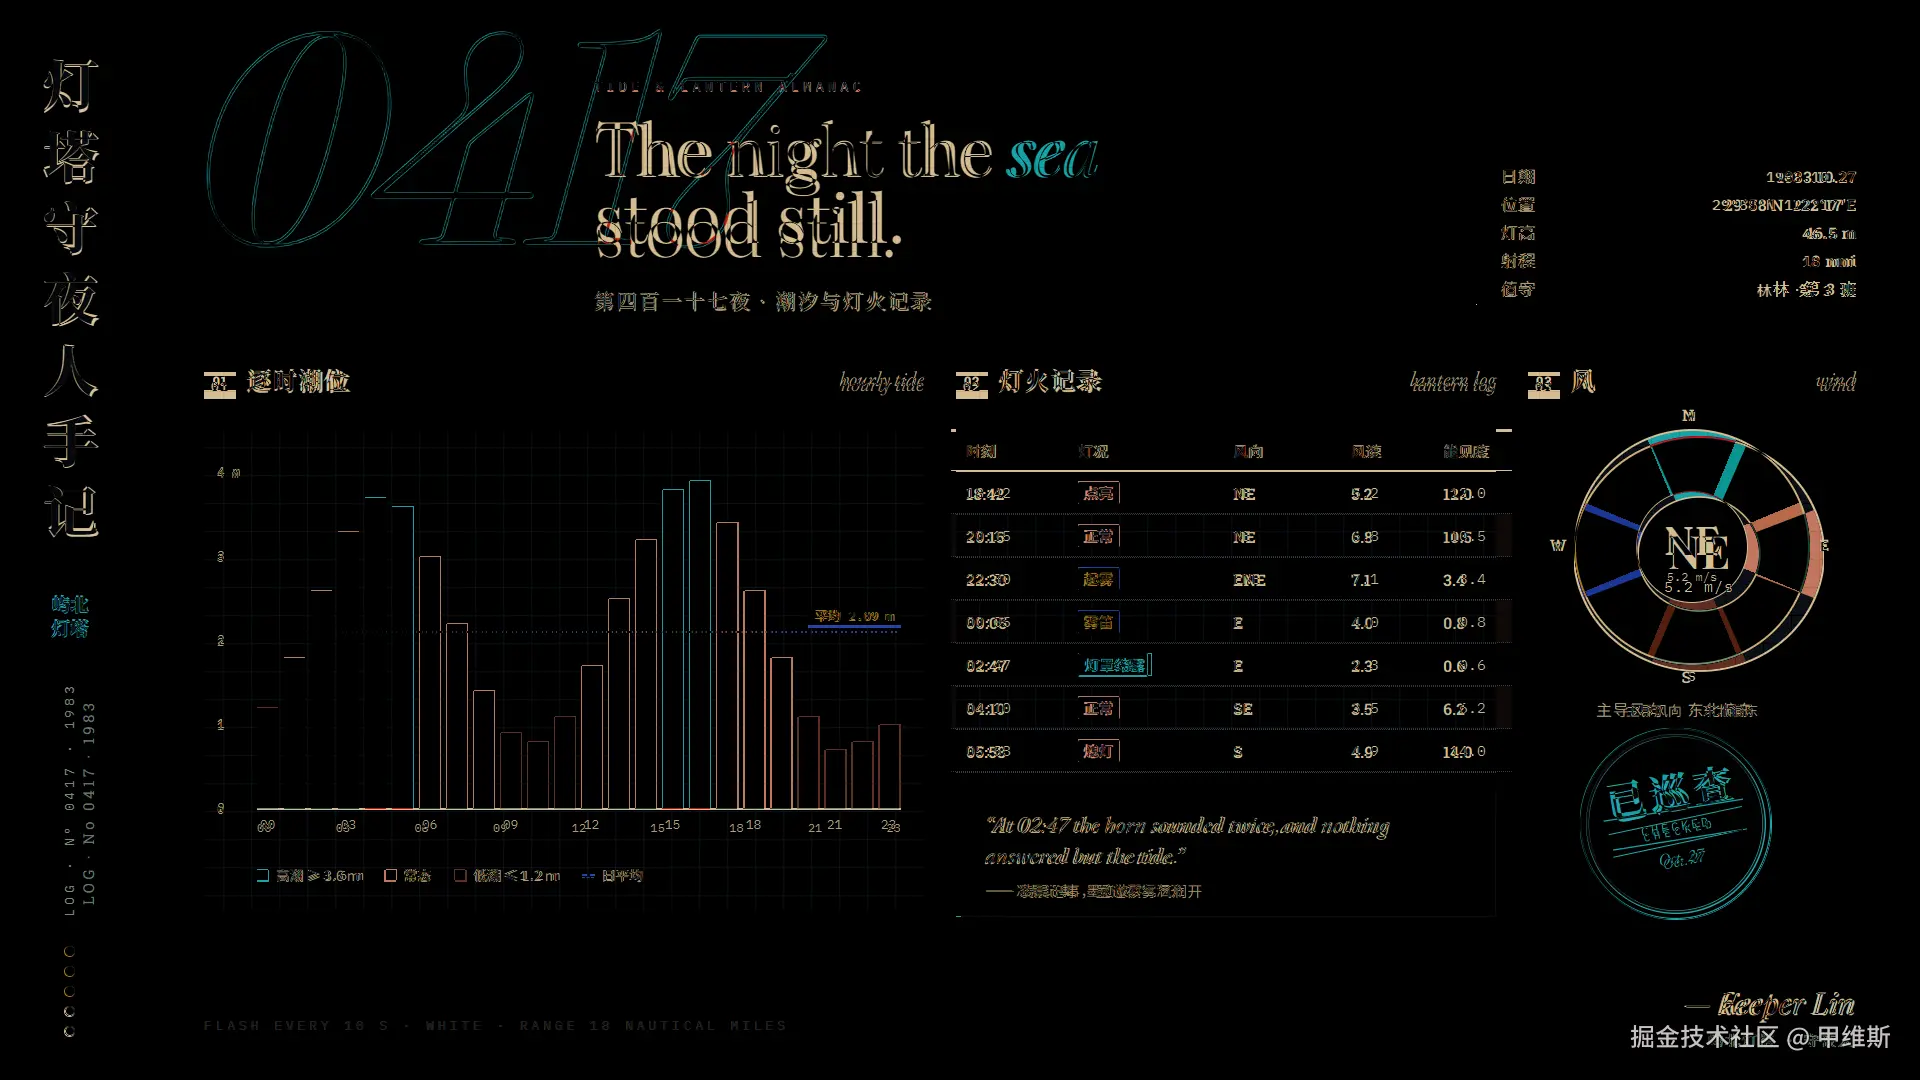
MiniMax 第 2 轮的差异图
- 优点:国产里字体认得最多,IBM Plex Mono 和两种思源字体都对;布局误差 3~9 像素;第 1 轮收尾时还主动清理了七十多个临时文件。
- 问题:三轮都把空心大数字"0417"从原图描成 SVG 路径,而不是写成文字。规则上不算违规,但这是"照着描"而不是"照着做"。第 3 轮页面宽了 34 像素,出现横向滚动。"洇开"两次写成"润开",落款"keeper"写成大写。费用全场最高,每轮约 0.3~0.4 美元。
- 一句话:成品很像,手法有点取巧,也最费钱。
MiMo V2.6 Flash:6.75,上限很高,发挥很不稳
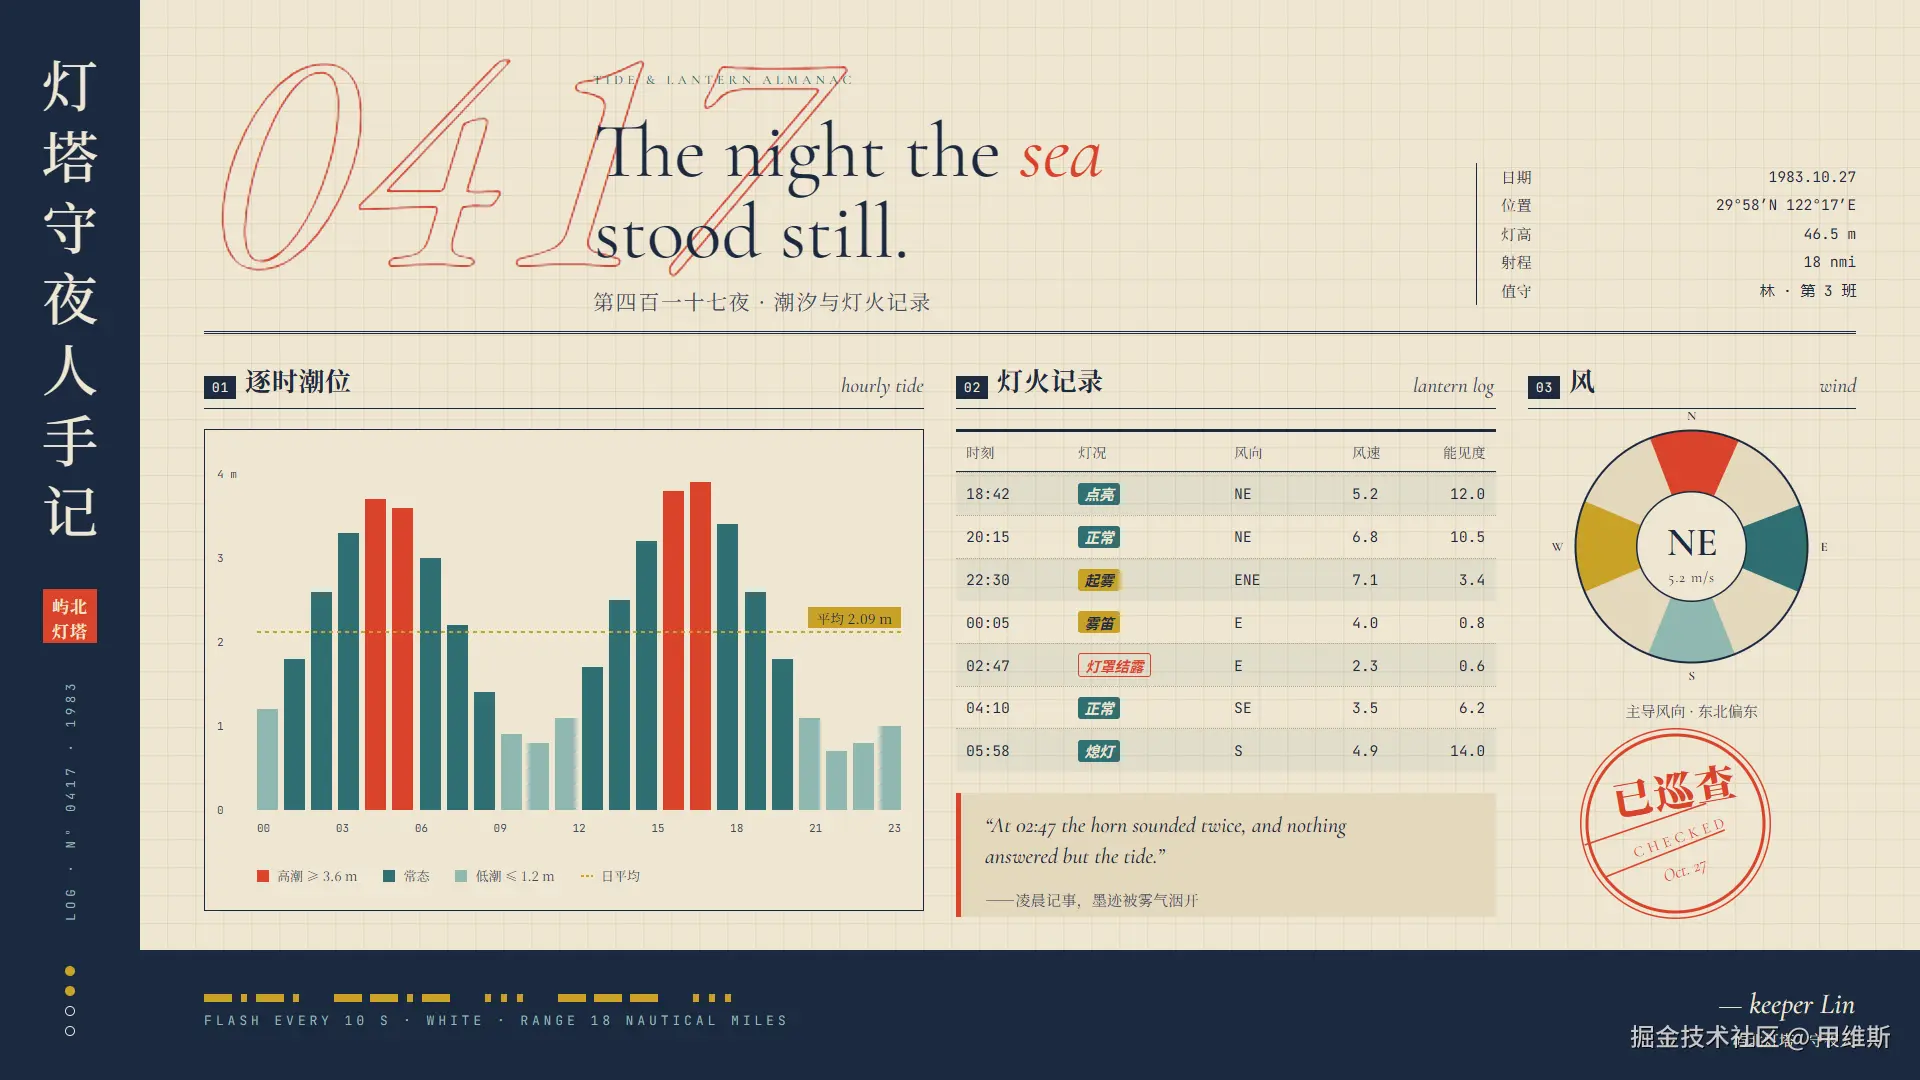
MiMo 第 1 轮的产出(7.60 分)
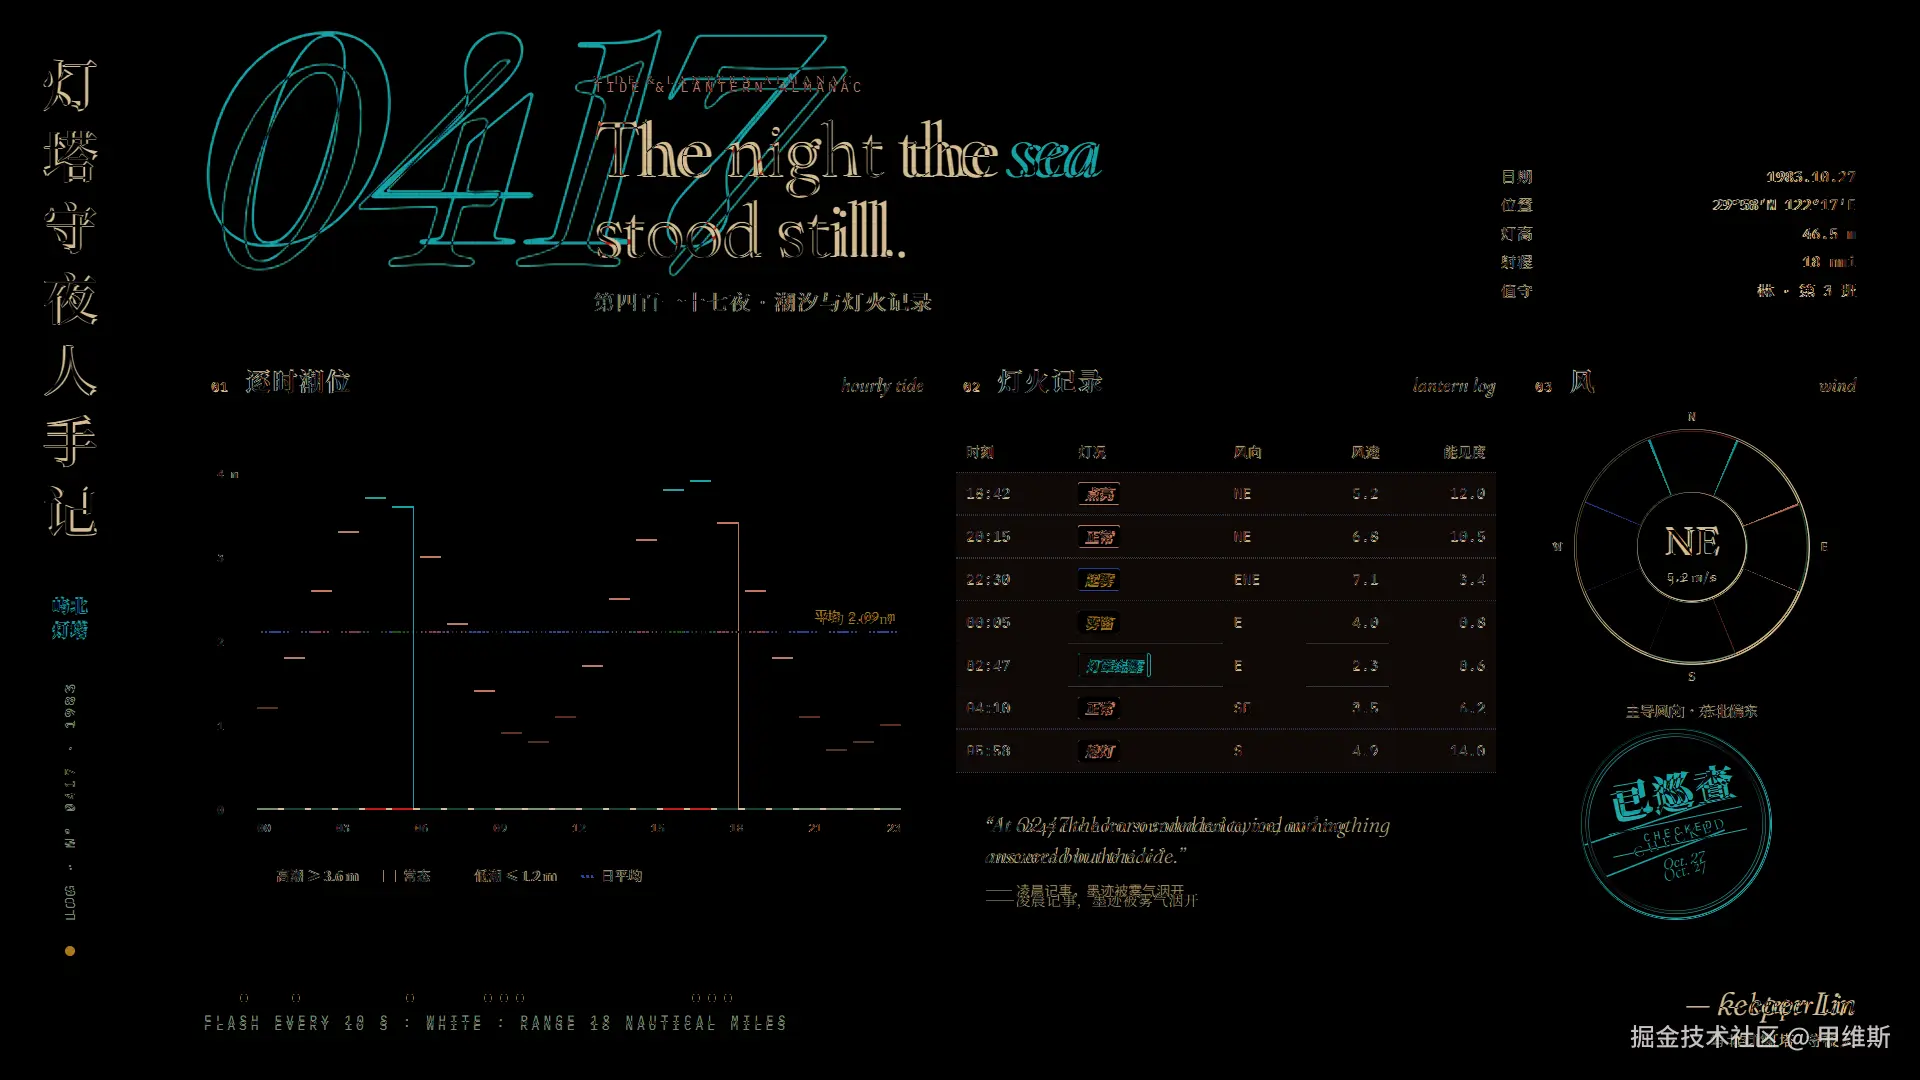
MiMo 第 1 轮的差异图。
- 优点:认真测量的那一轮(第 1 轮)布局误差 2 像素,和 DeepSeek 不相上下。
- 问题:三轮发挥差别极大,7.60、6.40、6.75。三轮里两轮跑满 60 分钟超时,思考 tokens 动辄十几二十万;第 2、3 轮的标题字号字重明显偏大偏粗,数字换成了衬线体的旧式数字。在 32k 输出上限下,它第一步的思考就会写满,一行代码都交不出来。
- 一句话:上限能进前三,但你不知道这次拿到的是哪个 MiMo。
GLM 5.3 Flash:6.15,最快最省,几乎不回头检查
GLM 第 1 轮的产出
GLM 第 1 轮的差异图:头部和右栏大面积发亮。
-
优点:三轮中位耗时 6 分钟、费用 0.02 美元左右,是成本最低的一档;整体观感接近原图,区块结构都在。
-
问题:
- 错字最多:书脊标题漏了"人"字,"灯罩结露"三轮分别写成"灯室结霜""灯雾结霜""灯室结霜","屿北"写成"峠北";
- 布局误差中位数 19~30 像素,头部小标题偏移一两百像素;
- 第 1 轮的总结里写着"正好铺满一屏",可它从头到尾没打开过自己的页面。
-
一句话:适合要一个"差不多"的草稿;要精确还原,得有人逐处帮它检查。
GLM 第 3 轮:提示词要求验证后多做了 11 次截图自查,问题依旧。
Qwen3.8 Flash:6.05,三轮分数一模一样
Qwen 第 1 轮的产出
Qwen 第 1 轮的差异图
- 优点:交卷最快(中位 4 分钟),每轮都会截图看两三眼,把没画出来的柱子、画错的罗盘修好;第 3 轮认出了 IBM Plex Mono。
- 问题:三轮布局误差都在 20~39 像素,偏差最大;第 1 轮页面高 1105 像素,超出一屏,因为它截图时用的窗口正好 1080 高,超出的部分自己看不见;第 2 轮标题字重做反(粗体对细体),"灯罩结露"标签的字和底色同色看不见;第 3 轮风玫瑰做成了 8 等分。最后它总说"经截图验证与目标一致"。
- 一句话:三轮 6.05 分非常稳定,稳定地"像但不准"。
六、几个共同的问题
1. 字体是所有模型的盲区。 21 份答卷没有一份认出 Fraunces。从截图辨认字体,量是量不出来的,只能靠"见过的字够多"。连测量最勤的 DeepSeek,三轮也在 Cormorant、Playfair、Libre Caslon 之间换来换去。
2. 看图识字也会出错。 "洇开"写成"润开","屿北"写成"岛北""峠北""岬北","灯罩结露"写成"灯室结霜","0417"读成"04.17",GPT-6 Luna 甚至读成了"01/27"。这类错误自动检查一眼就能抓到,模型自己却很少发现。
3. 自我感觉普遍偏好。 GLM 和 Qwen 的总结里都写着"与目标一致""正好铺满一屏",实际却有错字、溢出和几十像素的偏移。模型的自我汇报只能当参考。
4. 认真的代价是时间。 分数高的几家每轮 30~60 分钟、1000 万到 3000 万 tokens(对照组除外),21 份里有 4 份跑满了 60 分钟上限。好在走的是缓存读取,按 OpenCode 计价每轮也就 0.1~0.4 美元。
七、总结
- 要高还原度 :选 DeepSeek V4.1 Flash 。三轮中位 7.75,布局最稳,费用中等。愿意多花钱、想要字体更准,可以试 MiniMax M3.1 Flash,但要留意它"描图"的习惯。
- 要快、要便宜、能接受人工收尾 :GLM 5.3 Flash 和 Qwen3.8 Flash,几分钟、几分钱出一个八九成像的草稿。错字和偏移要自己检查。
- MiMo V2.6 Flash 状态好的时候能进前三,但三轮表现差异太大,不适合需要稳定输出的场景。
- Claude Haiku 5.5 作为参照,三轮中位 8.05 排第一,每轮几分钟。国产最好的 DeepSeek 单轮最高能追平它(8.25),但中位数差 0.3 分,耗时多好几倍。
- GPT-6 Luna 中位 7.35,又快又便宜,但不主动检查,版面出错和错字都要人工把关;
最后一个观察:这道题测的与其说是"审美",不如说是"做事习惯"。 国产模型里,肯先测量、再对照修改的,分数自然往 8 分走;只靠看一眼的,提示词再怎么要求"验证",也只停在 6 分。眼力好的模型可以少量甚至不量,但不检查就交卷,迟早会出一次大错。
写在最后:这次测试的局限
- 轮数不多。 每个模型三轮;MiMo 这种波动大的模型,中位数对再加一两轮仍然敏感。
- 条件不完全一致。 第 1 轮输出上限是 32k,第 2、3 轮是 131072(MiMo 第 1 轮按新上限重跑);第 3 轮改了提示词;Haiku 和 GPT-6 Luna 的第 1、2 轮是事后用旧提示词补跑的,输出上限是 131072,测试时间也晚于国产模型;Haiku 的第 3 轮和国产模型的第 3 轮有一部分是同时运行的。
- 对照组没测全。 原计划还有 Gemini 3.8 Flash,测试当天 OpenCode 里已经没有这个模型,这次没有结果。
- 评分者也是 Claude。 主观分由 Claude Opus 5.5 给出,Haiku 也是 Anthropic 的模型。为了减少偏向,每一项扣分都尽量对应自动检查的数字或差异图上的位置,但仍然带有主观成分。
- 字体检查偏严格。 只认字体名,选了很像的替代字体也算错;视觉上的接近程度在主观分里体现。
所有截图、差异图、代码和完整的对话回放都保留着,欢迎在评论区交流。
========================
这次测试信息量还是挺大的,Opus5.5负责启动任务,然后查看所有结果和对话记录,然后根据设定好的标准来进行评判。7个模型跑三轮,就是21份网页和大量配套文件。这个tokens消耗很猛, 差不多用掉100美金的API。
Opus5.5 之前的版本有点不说人话,现在这个版本好很多了!
Opus5.5写的文章已经包含了 90%的核心内容。
下面说一些我感兴趣的点。
首先,我已经把所有测评,包括上次的,都放到网站上了:
目前主要做了三种场景的测试:
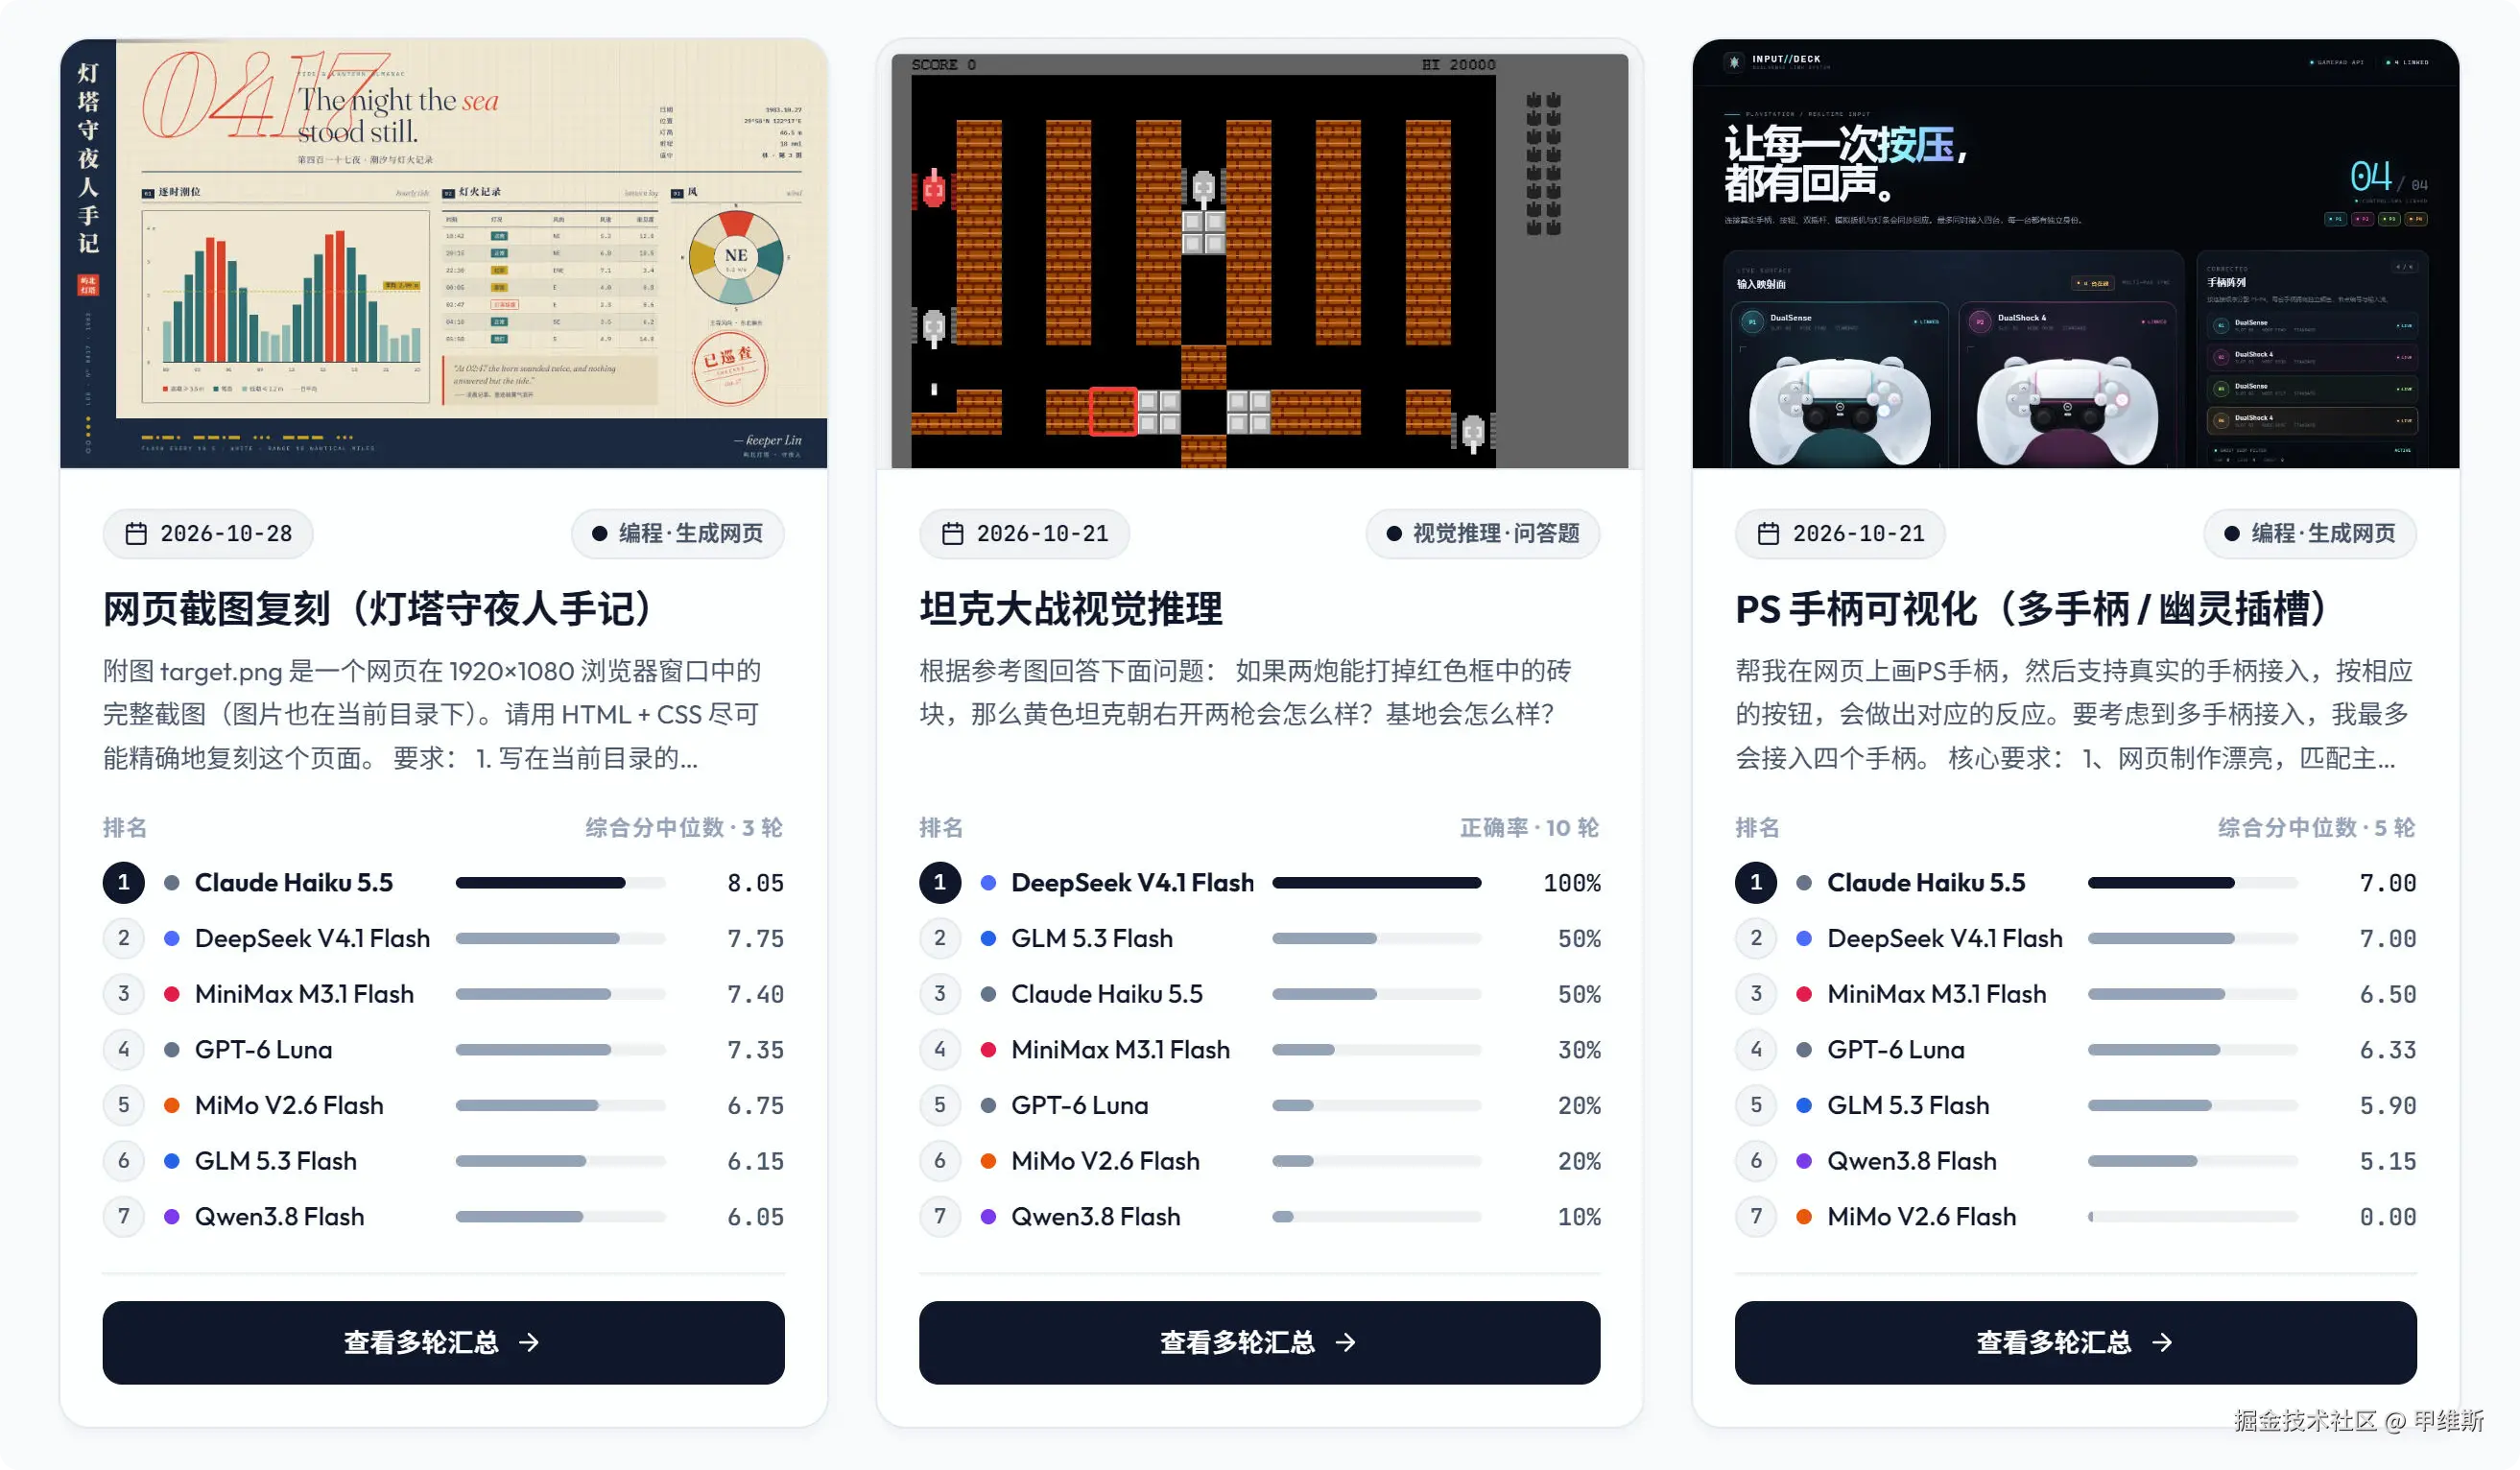
从这三次测试 可以得出一些简单的结论。
首先 DeepSeek V4.1 在不是特别难、且有确定性答案的题目上表现出众! 除了 Haiku 之外,它基本能拿第一名。 完成度、代码质量、页面效果都不错。
但是,它也有一个非常明显的问题。就是特别慢,特别费 tokens,也不便宜,这些都是有些反常识的!主要是反大众常识,真正对比测试过的人应该不会惊讶。
关于能力的评价上面已经说的很详细了。下面主要是看看时间消耗,tokens消耗 ,费用的问题。
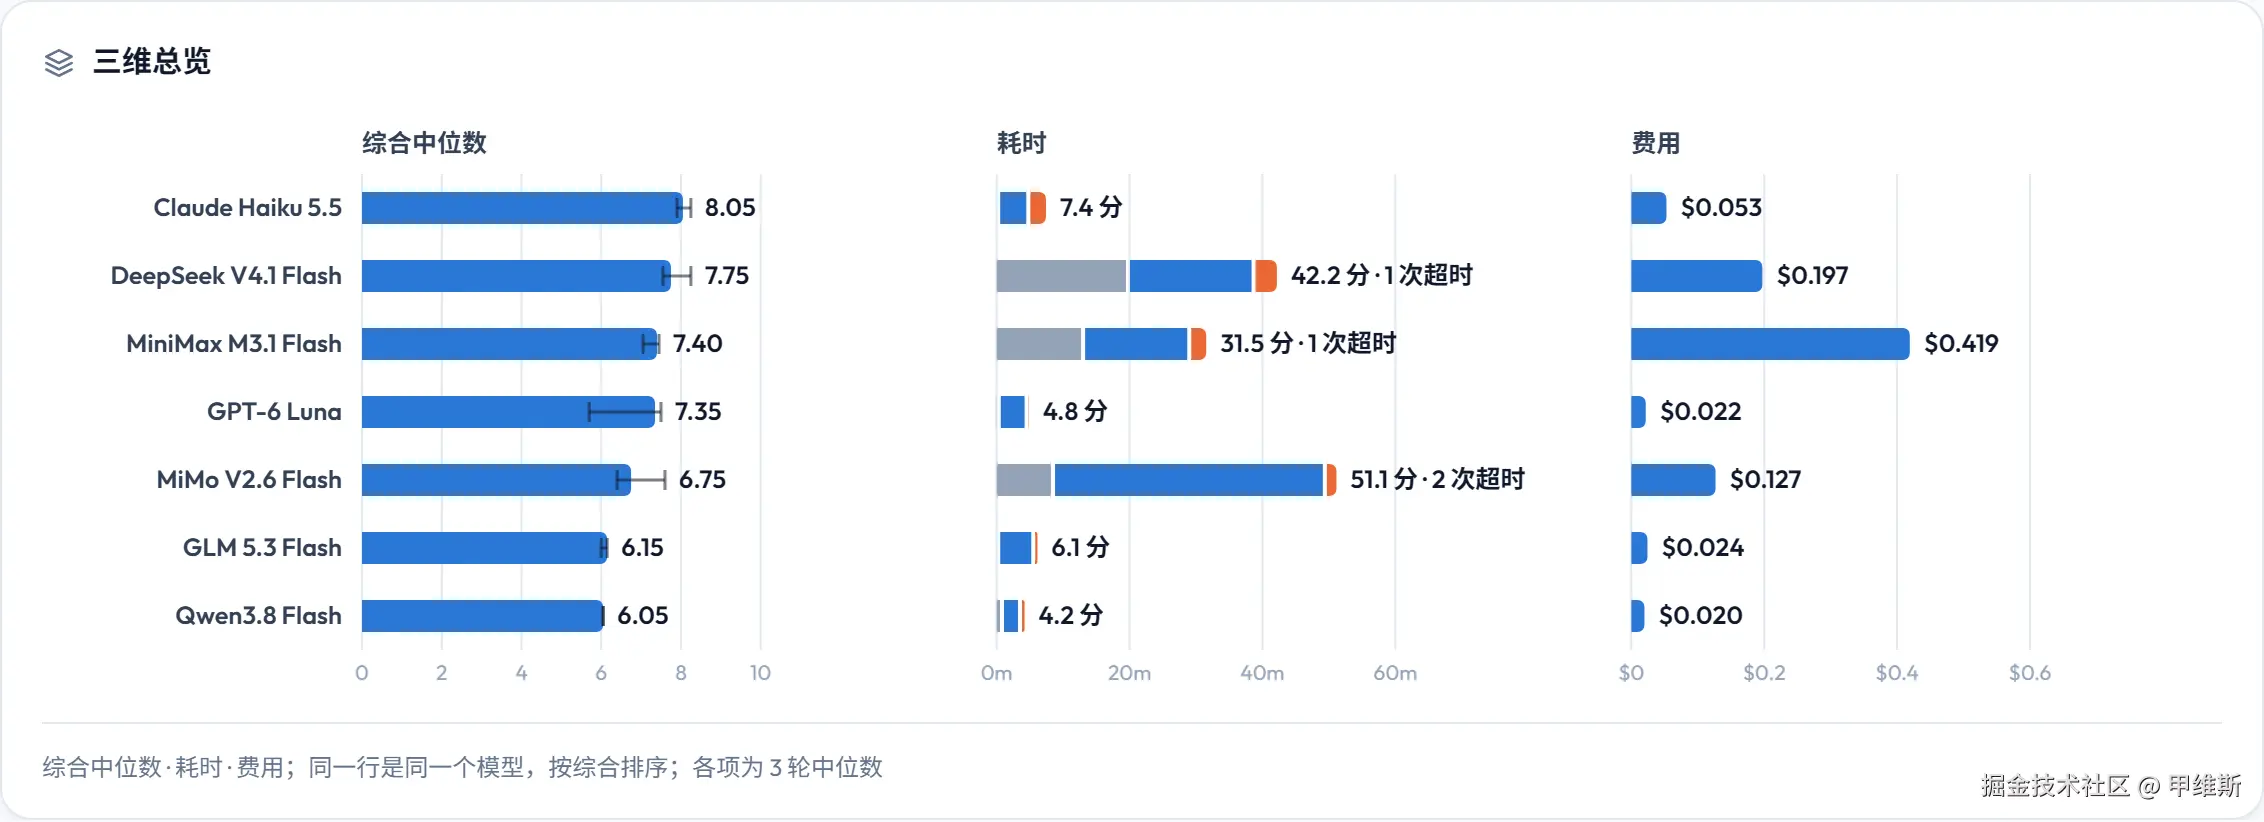
首先看这个耗时问题:
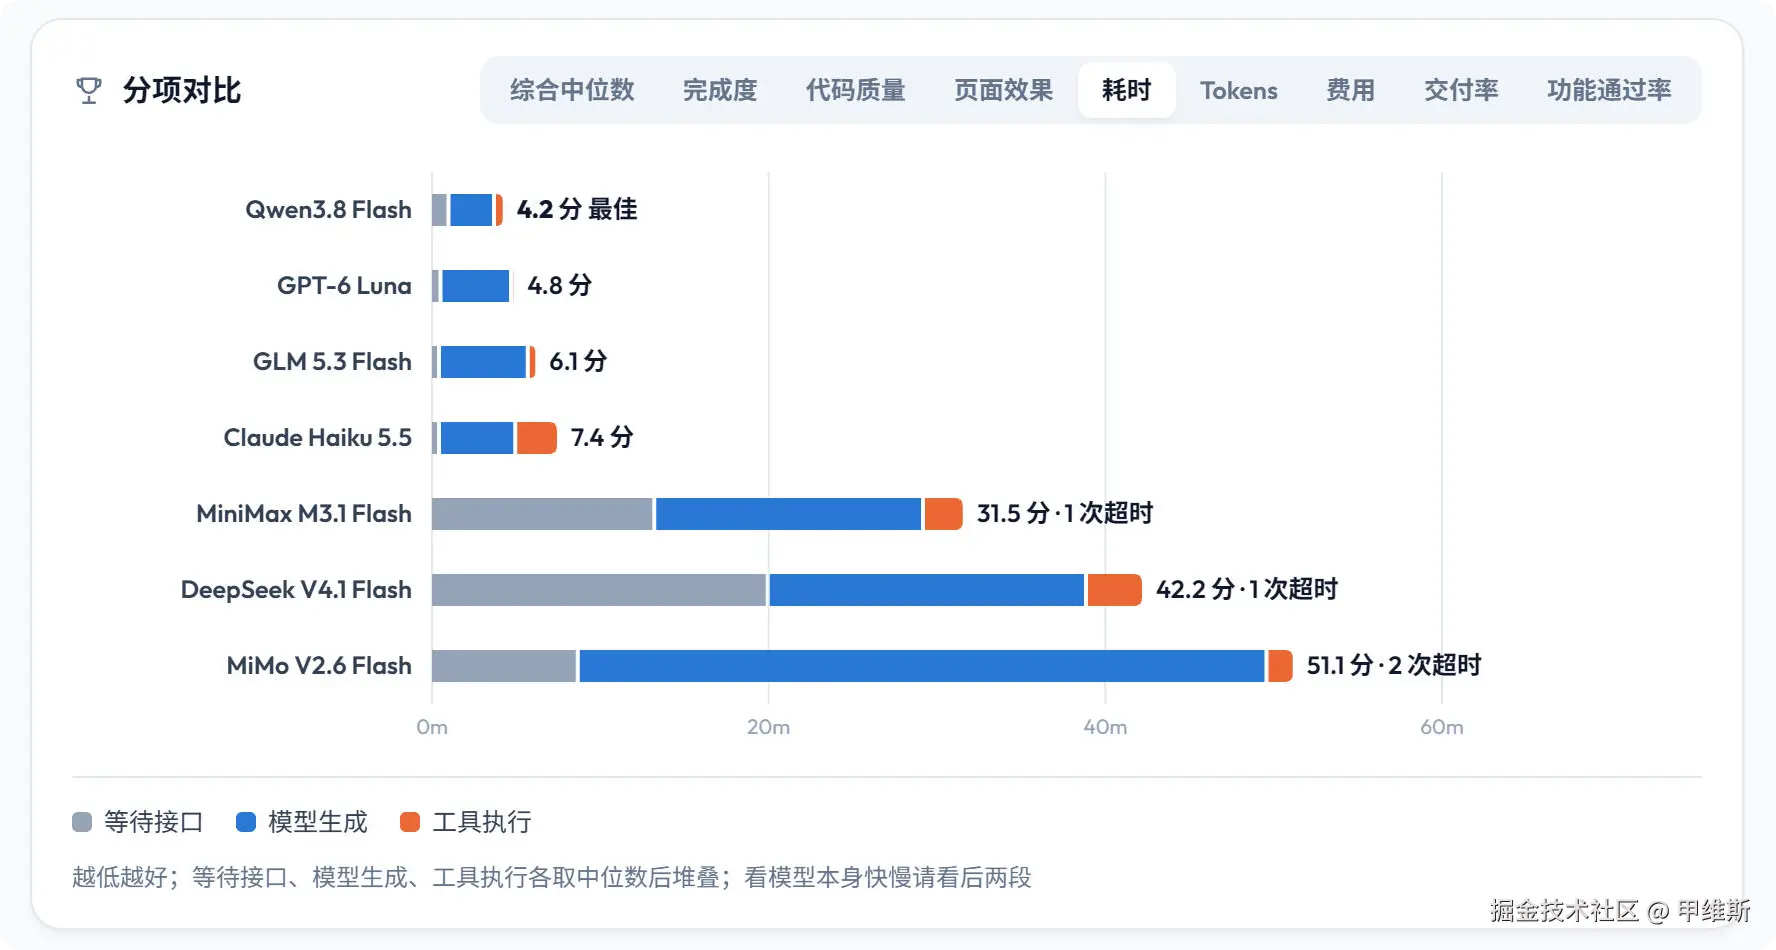
从三次测试结果来看,只有 MiMo 比DeepSeek 慢。MiMo 的人不愧是 DS 出去的,慢都慢得很一致。
其实 MiniMax 也很慢。这三个模型都慢,都出现了 60 分钟做一题还超时的情况。
它们就是在反反复复地验证。脑子不够,验证来凑。所以比的不是智力的上限,而是耐心的上限。
这种操作其实是很浪费时间和资源的!
Qwen3.8 和 GLM5.3 在OpenCode很快,但是正确率低!
Luna 和 Haiku 整体来说很快,正确率也比较高。
然后来看tokens消耗情况:
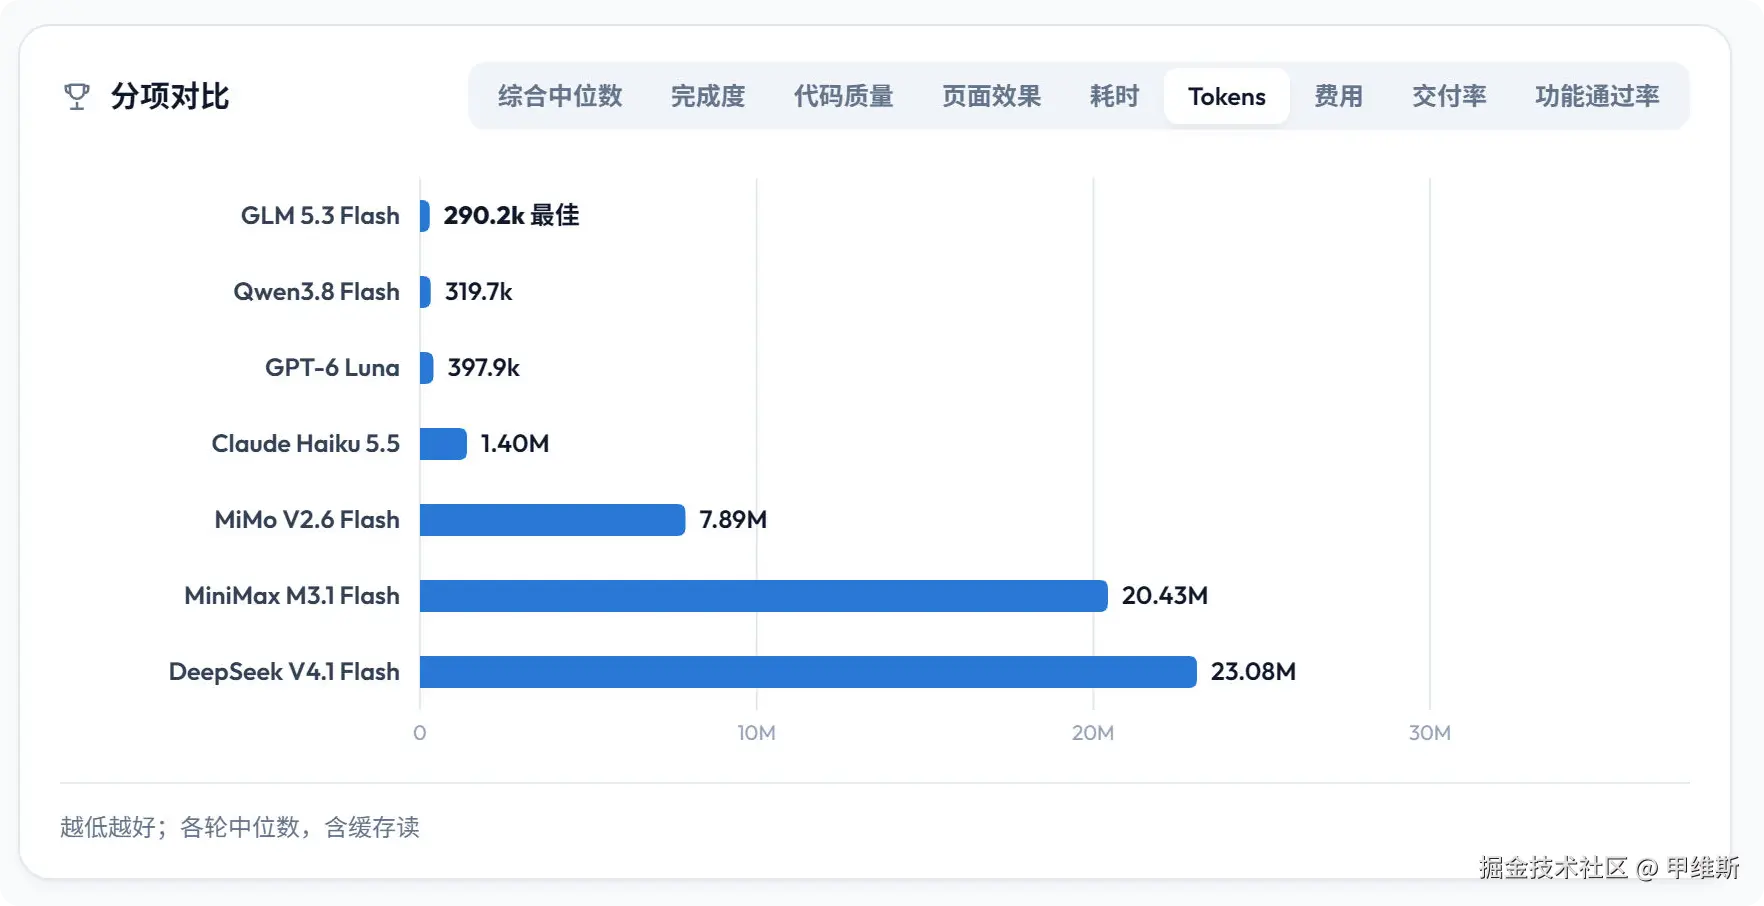
同样一个问题,DS 消耗的 tokens 最多。其次是 MiniMax、MiMo!
GLM5.3、Qwen3.8、Luna 的 tokens 消耗很少。但是前面两个准确率低。
Haiku 消耗不高,要比后面三位少很多,准确率很高。
最后看一下费用情况:
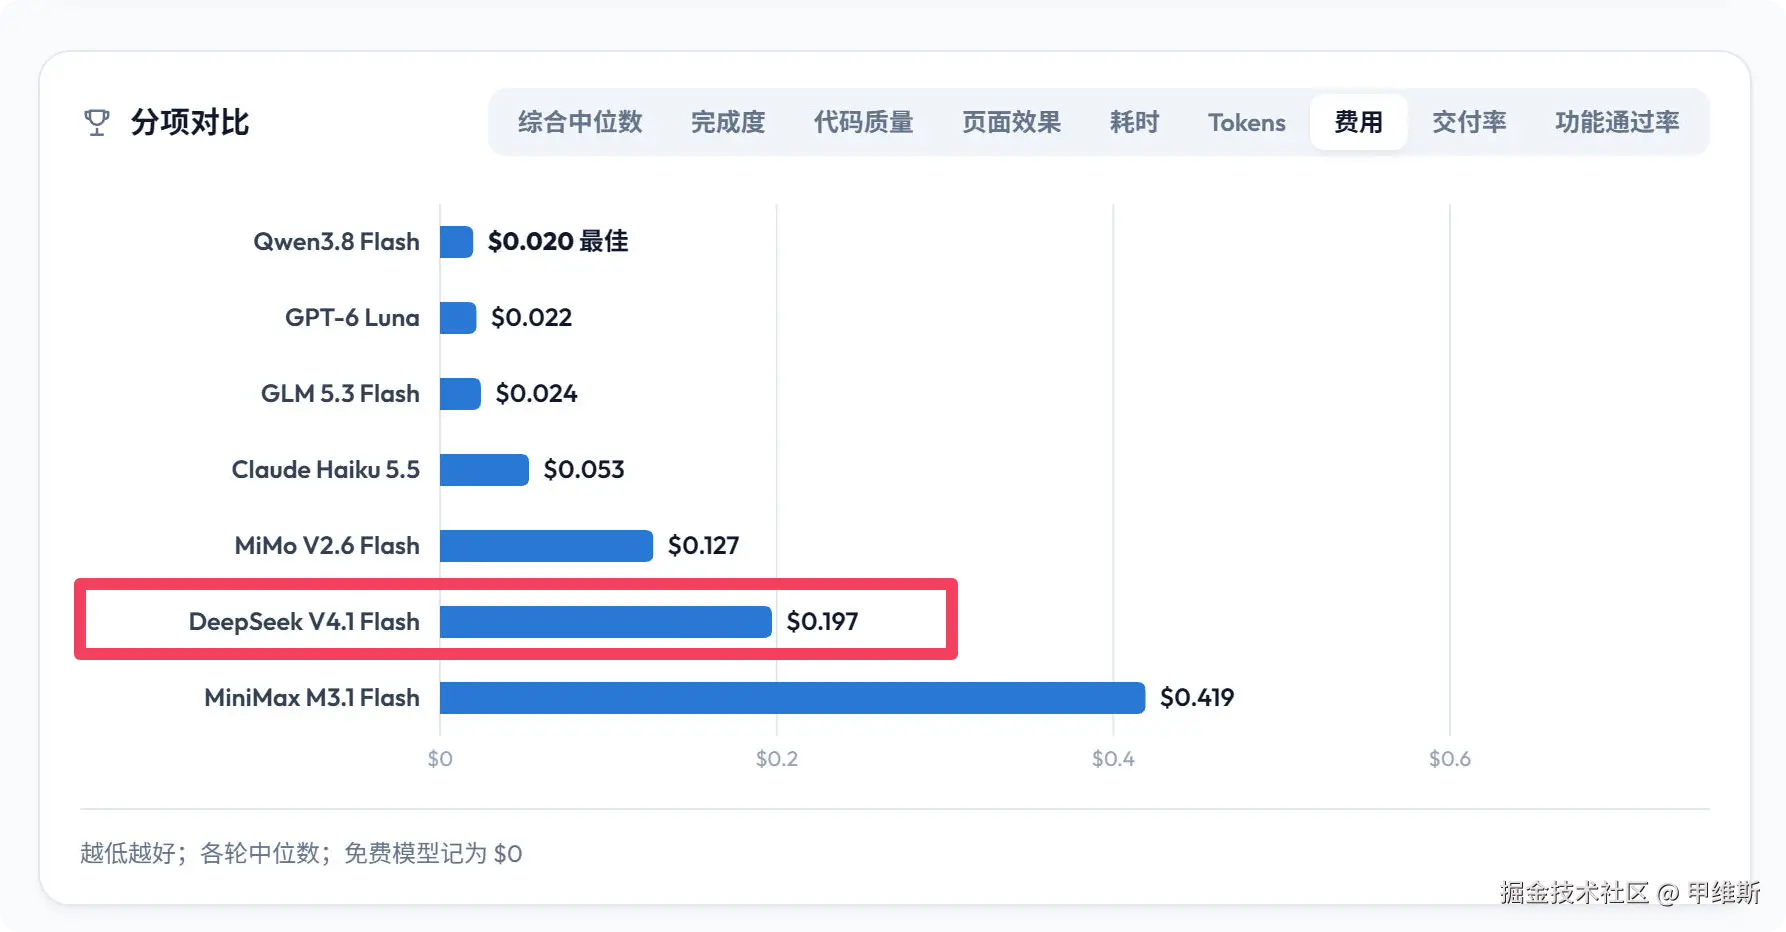
DS 因为时间久,tokens 消耗过多,导致费用消耗也变高了,排在倒数第二名的位置。 倒数第一名是 MiniMax,倒数第三名是 MiMo。
Haiku的费用适中,比后面三个便宜很多,比前面三个贵一些。
Qwen3.8 很快很便宜,但是结果最拉胯!
Luna 很便宜,结果也不错。
所以,从各种数据来看,我的标题居然没有故意搞反差,而是真的有这种反差。
DS 确实能力不错,但是又慢又贵。其实 token 效率很低。
Haiku 能力很强,速度也快,费用也低。
不管你喜不喜欢 A 社,但是 Anthropic 是真的不简单啊。
它们家的每一个模型,综合来看都是"同级最强",甚至可以越级战斗。
有点像国漫修仙剧的男主角了。
而国产Flash模型始终做不到多边形战士,有的是快而无脑,有的是慢而费钱。
虽然看起来DS的最低的缓存价格比Haiku还要便宜一点,但是Claude 20美金的套餐,可是等价于几百上千美金的API费用哦。
也就是DeepSeek起码再便宜几十倍,才能和套餐中的Haiku比价格。其它模型就更不用说了!
这么一比,国产模型真的是毫无性价了。
情况就是这个情况,我并不是想要故意贬低国产模型。
只是从我的测试结果,以及我的使用感受来看,综合性价比确实不高,综合能力也不强。
我也希望大家能看清楚差距,而不是完全被宣传忽悠。 根据自己的情况选择最合适的模型!
这种文章写起来太费了,费时间,费精力,费 tokens 了。
收工,收工!
完整的测试数据:
arduino
https://topai.jarvisuni.com/JarvisBench/包含了汇总信息,单次评分,完整的对话记录,不同阶段的时间消耗。