云 TTS 要传文本、传声音、按量计费;把 IndexTTS-2.5 部署到本地 Mac(MPS),主权重 5.1G + 4 个辅助模型约 5G,踩过 uv 空壳 venv、xet 存储下载失败、4 辅助模型漏下 4 个真坑后跑通:9.26s 音频推理 86.2s(RTF≈9.3)。本文是部署与推理的工程拆解,参数名全部锁死官方真源。
1. 为什么本地部署而不是调 API
三个绕不开的代价决定了选型:文本出本机、音色克隆要传声音、按量计费不可控。TTS 是短时高算力任务,模型一次性下载长期离线可用,适合批量旁白而非实时。IndexTTS-2.5 的硬指标:工业级中文自然度、零样本音色克隆(单参考音频)、8 维情感向量 + 语速因子 + 多语种。代价是模型大、要 GPU------主权重 5.1G 起。
2. 部署解剖(5.1G 主权重 + 4 辅助模型)
官方要求 uv 管理。本机实测的部署链:
bash
# 1. 克隆代码(不含 LFS 大文件,很快)
git clone https://github.com/index-tts/index-tts.git && cd index-tts
# 2. 建 venv + 基础依赖(Mac 切勿 --all-extras:deepspeed 编译失败)
uv sync
# 3. 🔴 若 .venv 是空的(import torch 报 ModuleNotFoundError):从 lock 强装
uv export --frozen --no-hashes --format requirements-txt -o /tmp/it_req.txt
uv pip install --python .venv/bin/python -r /tmp/it_req.txt
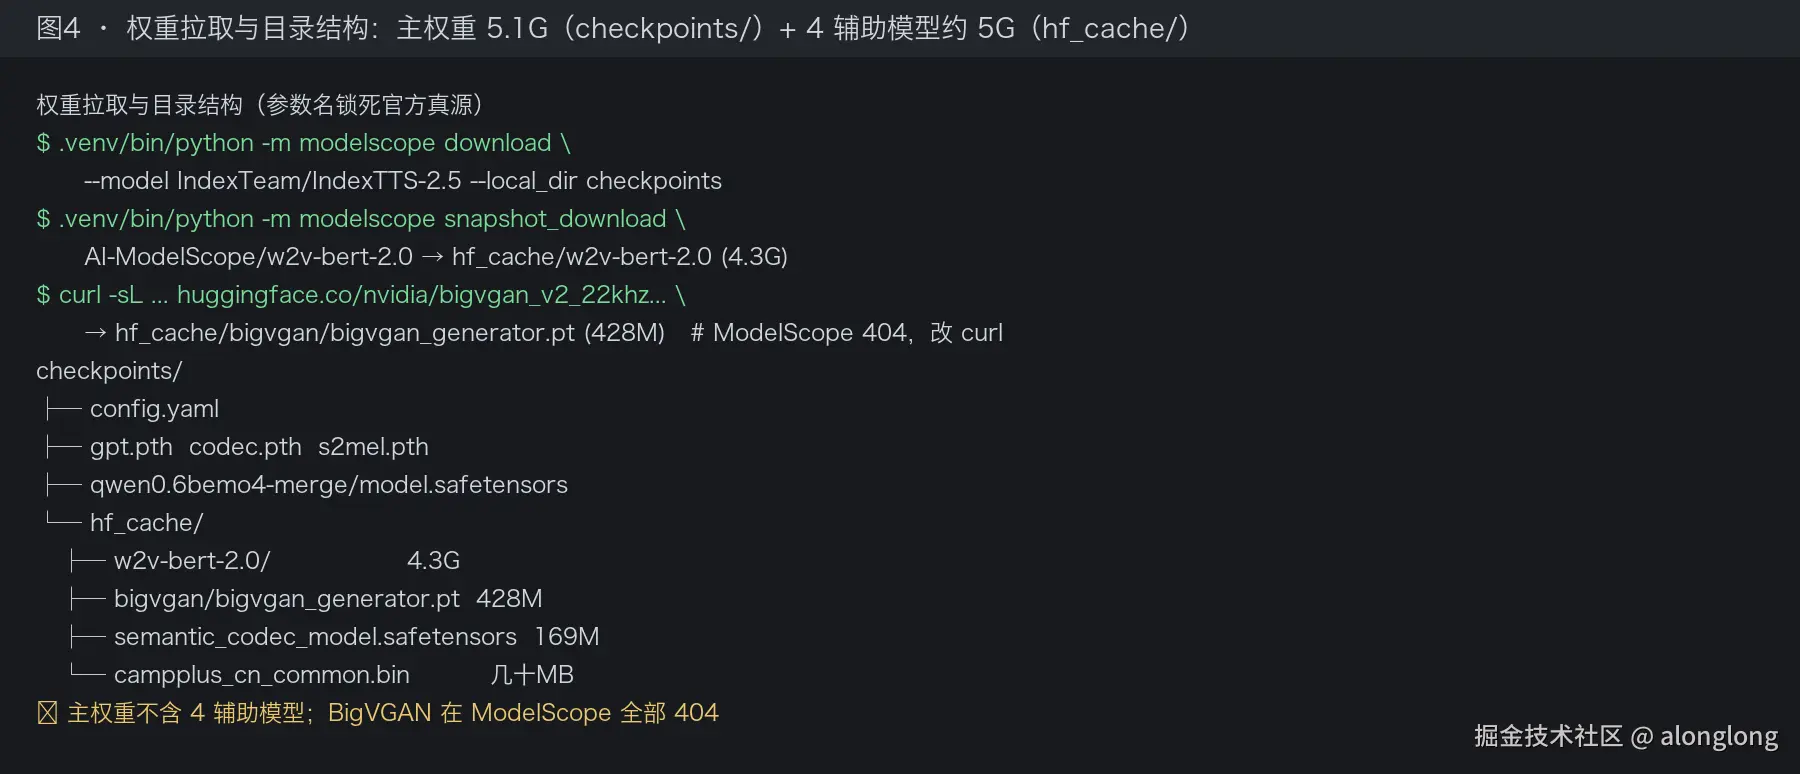
权重目录约定 checkpoints/(含 config.yaml)。🔴 关键坑:大权重是 xet 原生存储,HF 直连 / hf-mirror 全失败 (LocalEntryNotFoundError,代理对 xet 大文件 HEAD 不通)。唯一可行是 ModelScope 直连:
bash
.venv/bin/python -m modelscope download --model IndexTeam/IndexTTS-2.5 --local_dir checkpoints🔴 4 个辅助模型主权重不含,初始化时 local_files_only=True 加载,漏下任何一个都 LocalEntryNotFoundError:
| 辅助模型 | 体积 | 落盘 |
|---|---|---|
| w2v-bert-2.0 | 约 4.3G | hf_cache/w2v-bert-2.0/ |
| CAMPPlus | 几十 MB | hf_cache/campplus_cn_common.bin |
| semantic_codec | 约 169M | hf_cache/semantic_codec_model.safetensors |
| BigVGAN v2 22k | 约 428M | hf_cache/bigvgan/bigvgan_generator.pt |
其中 BigVGAN 在 ModelScope 上 nvidia/* 全部 404,改用 curl 直接跟跳转拉 HF 源(xet-bridge CDN 经代理可达)。其余 3 个走 ModelScope snapshot_download。
🔴 不要用 uv run 跑推理 :受限环境下加载重依赖会被系统 SIGKILL(137),直接用 .venv/bin/python。
3. 推理解剖(Python API,参数锁死真源)
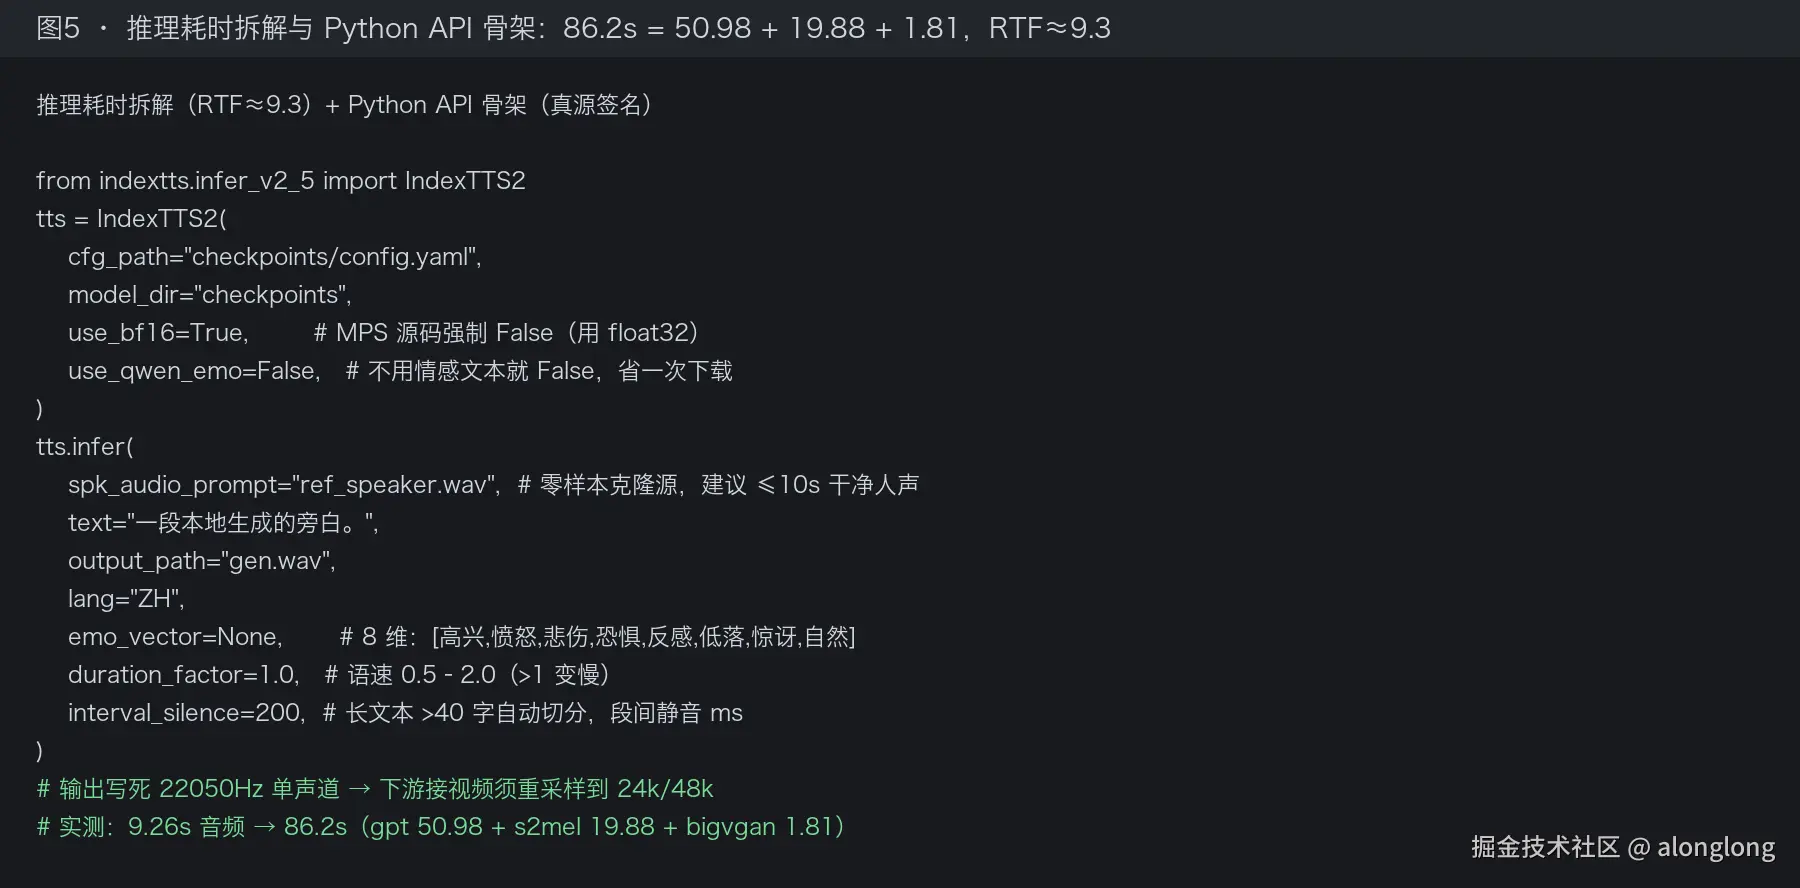
来自 indextts/infer_v2_5.py 的真实签名(inspect 真源,勿凭记忆改):
python
from indextts.infer_v2_5 import IndexTTS2

tts = IndexTTS2(
    cfg_path="checkpoints/config.yaml",
    model_dir="checkpoints",
    use_bf16=True,          # MPS 下被源码强制 False,无妨
    use_qwen_emo=False,     # 不用情感文本就 False,省一次下载
    use_cuda_kernel=False,
    use_torch_compile=False,
    use_accel=False,
)
tts.infer(
    spk_audio_prompt="ref_speaker.wav",  # 零样本克隆源,建议 ≤10s 干净人声
    text="大家好,这是一段本地生成的旁白。",
    output_path="gen.wav",
    lang="ZH",
    emo_vector=None,        # 8 维:[高兴,愤怒,悲伤,恐惧,反感,低落,惊讶,自然]
    duration_factor=1.0,    # 语速 0.5--2.0(>1 变慢)
    interval_silence=200,   # 长文本 >40 字自动切分,段间静音 ms
    text_normalization=True,
)输出规格源码写死 sampling_rate = 22050,单声道。下游接视频必须重采样到 24000/48000。
实测性能(Mac M4 Max,MPS,float32 全载内存):一段 9.26s 音频,完整推理 86.2s ,拆解 gpt 50.98 + s2mel 19.88 + bigvgan 1.81,RTF≈9.3。结论:不适合实时,适合离线批量旁白------一条 30s 短视频旁白本地等约 5 分钟,换来数据不出本机 + 音色/情感/语速完全可控 + 一次部署长期免费。
4. 复用方式与实测
 复现清单(被引用文件真实行数,门禁回扫):
| 文件 | 行数 |
|---|---|
indextts_infer.py |
138 |
零样本克隆只需一条参考音频;情感控制用 emo_vector(8 维,与情感参考音频互斥);语速用 duration_factor。低显存下文本 >40 字自动切分。验证手段:跑通 verify_out.wav 与 verify_ref.wav 对齐即说明链路 OK(官方 verify 脚本已实测生成过)。
部署与推理的完整「验证手段本身也要被验证」思路:先用官方 verify 确认能出声,再上批量旁白脚本(读 JSON plan 逐句生成 + manifest 交给音频 QA 收口)。和本地语音转写、归档门禁是同一套------链路跑通的标志是「独立复核过」,不是「脚本没报错」。