一、 背景引入:你是否也有这样的痛点?
作为一个 AI 深度使用者,这一年下来,我在各大 AI 平台(尤其是 DeepSeek)积累了 1500 多次对话。
脑子里留下了很多,但更多散落在成百上千的赛博角落里。我是一名入门一年的信安学生,每天都在折腾环境、踩坑报错、打 CTF、偶尔也陷入自我内耗的反思。
早期使用 AI 时,我遇到好答案就疯狂复制粘贴,后来发现这太耗精力,索性就让它躺在历史记录里。直到有一天,我想找回半年前解决某个"Kali Linux 源报错"的排错步骤,翻遍了历史记录,看着几百个标题一头雾水。
我突然意识到:这 1500 次对话里,大部分是废话,极少数是黄金。如果不去整理,它们就永远是占用服务器空间的赛博垃圾。
怎么在 1500 多份杂乱的 JSON 数据里,筛出真正有价值的技术排错干货和认知破局瞬间,并沉淀为可以随时检索的个人知识库?这篇文章将分享我完整的实战踩坑记录。
二、 总体设计(架构图)
如果只是写个脚本把内容存下来,那顶多叫"备份"。但这套 Pipeline 的核心在于**"清洗与提炼"**。
整个系统的运转链路如下:
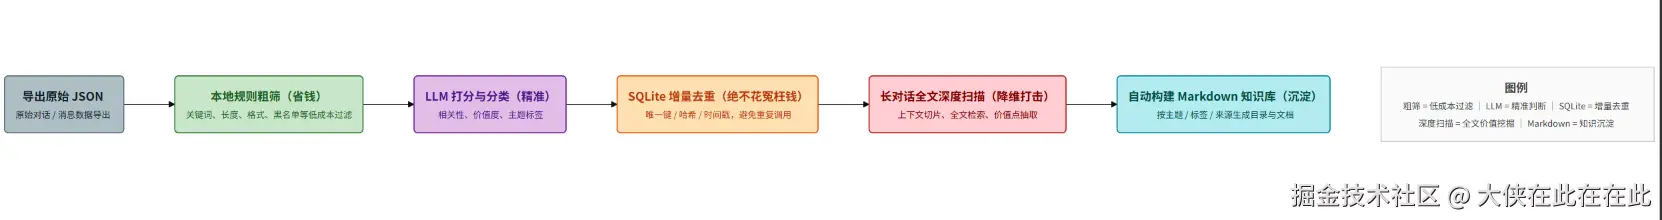
这里有一个极其重要的场景取舍:为什么我不直接用向量数据库(Vector DB)做语义检索?
很多开发者的第一反应是:把对话切片、Embedding、存入向量库,以后搜到相关的就行了。 但我否定了这个方案。因为我的目标不是"检索",而是"筛选高价值会话并蒸馏成笔记"。
向量检索找出来的是"碎片",而我要的是一份系统的排错指南(现象 -> 根因 -> 步骤)。所以我选择了:规则粗筛(本地正则)+ LLM 打分分类 + 人工 review 校准 的路线。把大模型当成"评估员",而不是"搜索器"。(值得一提的是,粗筛是为了省钱,而极少数高价值漏检,会留给后续的"长对话深度扫描"兜底)。
三、 核心亮点(技术上的降维打击)
要把 60MB 的 JSON 变成知识库,最怕的就是"无脑调 API"。一上来就全量喂给大模型,不仅容易超出上下文限制,还极其费钱。这个 Pipeline 有三个设计我认为是直击痛点的:
1. 极致的省钱:本地正则 + SQLite 指纹去重
- 本地粗筛 :我写了一组正则和关键词(比如
CTF、Linux、配置、报错),在本地过滤掉了 70% 的闲聊和废话。剩下的才去调 API。 - 指纹去重:每次跑脚本,它都会先去 SQLite 数据库里查。只要这段会话没变过,就直接跳过。这样哪怕你手残一天跑十次脚本,也绝不会多花一毛钱。
2. 让模型"认得你":深度定制化的 Prompt 为什么通用的分类器不好用?因为它们没有上下文。我在分类和打分的 Prompt 里明确写了:
"我是一个入门一年的信安学生,经常搞 CTF,会处理大量环境报错和代码配置,偶尔探讨心理认知。"
就这一句话,模型在判断《Docker 报错》时,就知道这是硬核实操,而不是随便的水聊;在判断《自我复盘》时,就知道这是有价值的心理破局。让 AI 扮演懂你的老学长,分类精准度直接起飞。
3. 长对话的"降维打击" DeepSeek 导出的 JSON 里有一个很恶心的结构:fragments。里面不仅有用户的提问(REQUEST)和 AI 的回答(RESPONSE),还包含了一堆极长的思考过程(THINK)。 如果无脑提取,Token 会直接爆炸。我写了一个专门的提取器,自动过滤掉 THINK,只保留纯净的问答 。 更狠的是,针对《我服了呀》这种聊了 1000 多条的"超长史诗级对话",只看前几句往往会误判为纯情绪宣泄(给了 1 分)。我写了一个 deep_scan.py,强制提取你在这个会话里的所有发言,拼成一篇长文喂给大模型,直接捞出了后期的"认知觉醒"和几万字里的高光金句。
四、 踩坑实录(真实开发中的一地鸡毛)
做个人项目,怎么可能不踩坑?这里记录三个让我印象最深的瞬间:
1. 经典的 Windows 文件锁死 脚本跑到一半,终端突然飙出一大段红字:PermissionError: [Errno 13] Permission denied: 'classified.csv'。 排查了半天,发现是我自己想看看中间结果,用 Excel 打开了表格。Windows 下文件被占用时,Python 是无法写入的。后来我在代码里加了 try...except,现在如果它检测到你在占用文件,会温柔地提示:"请先关闭您的 Excel"。
2. 当 CTF 干货被打成 1 分:抢救计划 第一次跑全量时,我发现《CISCN2019Web11详解》、《BUUCTF Web 第一题》全被打成了"其他/1分"。为什么?因为初期词库没写安全相关的词,直接漏掉了。 我没有傻到去重置全部 1500 条重新跑,而是写了一个脚本:只筛选出标题里带 CTF/安全/注入 的会话,把它们的 SQLite 状态退回,局部重跑。修改词库 + 局部重跑,只花了几毛钱就修复了全部误判。
3. 去重逻辑的两难:怎样才算"新会话"? 这是开发中最费脑筋的地方:
- 如果只按"会话 ID"去重:你今天在这个会话里追加了一句新提问,脚本会认为它跑过了,直接漏掉你新产生的知识。
- 如果按"整段文本哈希"去重:只要你多问了一句话,整段哈希就变了,它又会把前面几十条全喂给大模型,重复花钱。
为了解决这个问题,我引入了一种混合指纹机制:SHA-256(会话 ID + 消息总数 + 最后一条消息的时间戳)。 如果 ID 没变、消息总数和最后一条时间戳也没变,说明这个会话根本没动过,直接跳过;如果里面多了两条消息,指纹就会变化,触发重新打分。这样既省钱,又绝不会漏掉任何新增的思考。
五、 自用使用指南(Pipeline 运行清单)
如果你也想跑通这套流程,这里是我总结的 8 步执行清单:
- 数据获取 :通过官方途径(或者抓包)导出全量的
conversations.json。 - 结构解析 :写一段小脚本探测 JSON 的层级(
mapping->fragments),弄清楚数据是怎么嵌套的。 - 粗筛与增量:配置本地关键词,并利用 SQLite 存储指纹,确保每次跑脚本只处理新增或修改过的会话。
- 分类与打分 :调用 DeepSeek API。这里千万别心疼几句 Prompt 的字数,把你的身份、痛点、关注的领域写得越详细,分类和打分就越准。
- 人工校准与补救 :跑完后导出
review.csv,在 Excel 里扫一眼,对于 AI 判断失误的(比如给了 1 分的宝藏),修改taxonomy.yaml词库,局部重置重跑。 - 深度提纯(可选) :针对几百条的超长对话(比如心理学复盘、长线项目探讨),单拎出来跑一遍
deep_scan,强制全文通读,捞出后期的觉醒点。 - 知识库构建:筛选出"计算机"类里的踩坑/实操会话,让 AI 蒸馏为结构化的 Markdown 排错笔记。
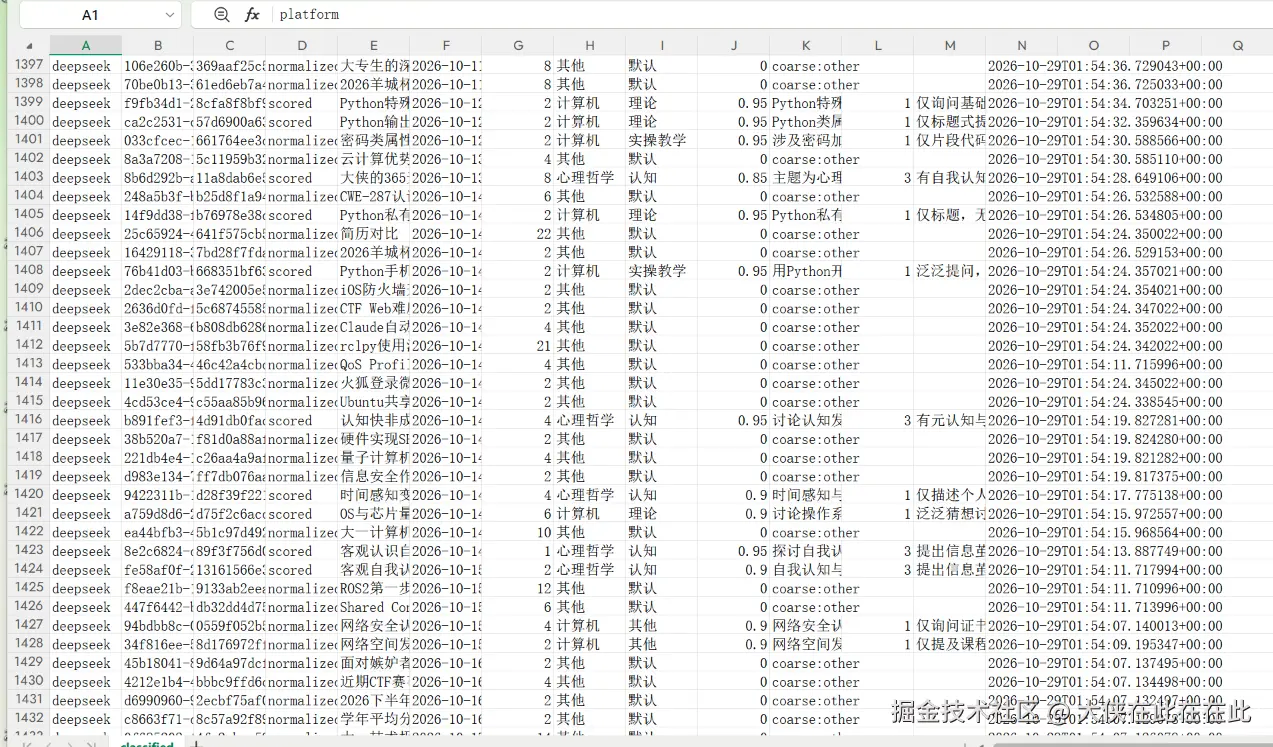
- 日常复盘:打开最终的 Excel,加上数据条,按分数降序,你的"高光时刻"一目了然。
六、 成果展示
1. Excel 分类与打分表
 2. 自动生成的 Markdown 知识库
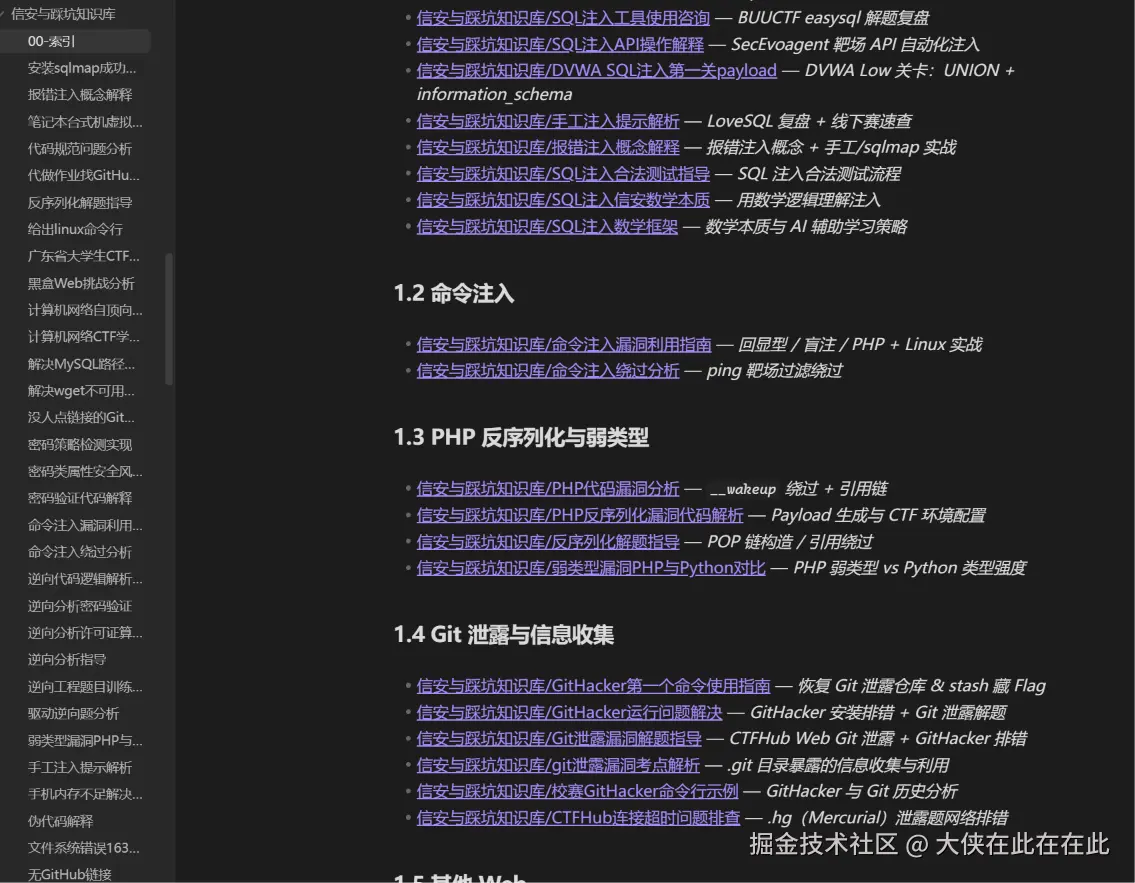
七、 开源与授人以渔
这套代码我准备整理开源到了GitHub,仓库名叫 AI-Chat-Archiver。 (过几天放)
这套脚本大概花了我几个晚上的时间,核心代码只有几百行。但比起直接丢给你一个打包好的软件,我更想分享一种**"把大模型当成数据处理引擎"**的工程思路。
因为每个人的 JSON 结构不同,每个人关注的领域也完全不同。如果你不想用我的代码,或者你导出的结构有差异,我为你准备了"授人以渔"的定制指南。
你只需要把下面这段话,连同你的 JSON 文件的前几行(脱敏后),发给任意一个代码能力强的 AI(如 DeepSeek 或 Claude),它就能为你量身定制一套:
text
我是一个 [你的专业/身份,如信安学生],我导出了一份大小为 XX MB 的 conversations.json。
它的顶层结构是 list,每条会话包含 id、title 和 mapping。mapping 的 fragments 里包含 REQUEST(用户)、RESPONSE(AI)、THINK(思考过程)。
我需要你写一个 Python 脚本:
1. 提取所有的用户提问(REQUEST)和 AI 回答(RESPONSE),丢弃 THINK。
2. 用关键词过滤出包含 '[你的核心关注词,如:CTF/报错/Linux/心理]' 的会话。
3. 写一个通用的 utils 模块,调用大模型 API(加入 SQLite 指纹去重,避免重复花钱)。
4. 帮我生成 config.yaml 和 prompts/ 里的 txt 模板。
请直接给我完整的代码结构。
结语
在这个 AI 遍地走的时代,免费生成内容已经不稀奇了。真正稀缺的,是你个人的真实踩坑经历,以及把这些经历结构化的能力。
我花不到 1 块钱,把过去一年的 1500 多次对话,变成了 Obsidian 里几百篇随时可以调用的排错指南和认知复盘。这种把"赛博垃圾"炼金成"个人外脑"的感觉,真的很爽。
希望这篇文章能给你带来一点启发,去翻翻你的历史记录吧,说不定里面也藏着一座金矿。