内置 288 组姿势、最多 5 个视角,中文检索、按姿势分组浏览,选完直接输出到工作流。附带三条实测链路:MOSS 深度控制(46 秒)、Qwen 2.1 姿态迁移(17 秒)、Krea2 深度控制(9.4 秒)。
本文首发于 luyingzhi.cn,转载请注明出处。
内容提示
图库为 AI 生成的虚构人体姿势参考线稿(3D 素体线稿),不含真实人物照片、真人面部肖像与真实商品,亦非色情内容。分类名称涉及「性感系」等题材,仅供艺术创作、AI 绘画参考与前端技术学习使用,请勿用于违法用途。
一、先说痛点:为什么需要这个节点
用 ComfyUI 出图的人大概率都遇到过这件事:同一句提示词,跑十次出来十个不同的身体。
「她坐在床边回头看」这句话里没有重心,没有膝盖角度,没有手在前还是在后。模型每次采样都自己编一个,于是你要么抽卡抽到崩溃,要么上一堆 ControlNet 但找不到合适的底图。
真正的解法不是改提示词,是把动作本身变成可观察的结构约束------一张线稿。
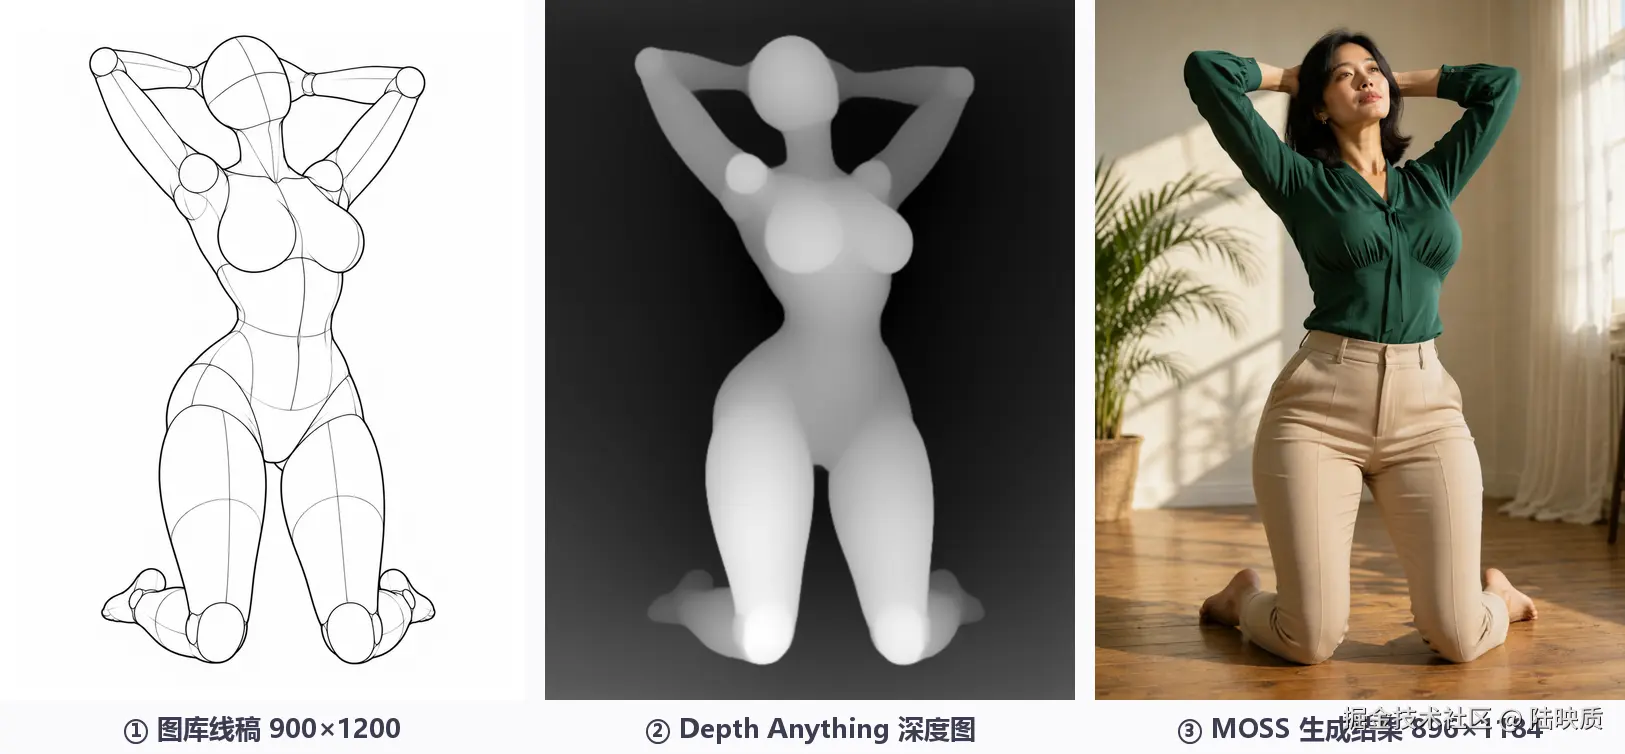
上图就是整条链路:左边图库线稿 → 中间 Depth Anything 深度图 → 右边 MOSS 生成结果。注意右边不是给线稿上色:脸部、头发、衣服、背景全是按提示词重新生成的,线稿只负责姿态和构图。
二、这个节点做了什么
comfyui-pose-gallery 是一个本地化的中文姿势图库节点,把 1,439 张姿势线稿做成 ComfyUI 里的原生节点。
| 项目 | 内容 |
|---|---|
| 姿势组数 | 288 组 |
| 参考图 | 1,439 张,原图 900×1200 PNG |
| 视角 | 每组最多 5 个:正面 / 俯视 / 仰视 / 侧面 / 斜侧 |
| 体系分类 | 上半身单人 400 · 全身单人·性感系 399 · 全身单人·标准系 365 · 双人缠绵 275 |
| 动作分类 | 26 类(站姿、坐姿、跪立、趴卧、蹲姿、前倾...) |
| 节点输出 | image(RGB 900×1200)/ width / height / pose_id / description |
| 依赖 | 仅用 ComfyUI 自带的 Pillow、NumPy、PyTorch、aiohttp |
| 素材来源 | 原作者 ギア(ai-pose-gallery.pages.dev),中文数据由 Anhao 整理 |
关键设计:不自动入队。 选完姿势你还要改提示词,节点不会擅自开跑,点「运行」才生成。
三、安装
进 ComfyUI/custom_nodes 目录:
bash
git clone https://github.com/wangweihong/comfyui-pose-gallery.git重启 ComfyUI,然后 Ctrl+Shift+R 强制刷新浏览器。
⚠️ 仓库已经直接包含全部 1,439 张原图 + 缩略图 + 中文索引 ,约 660 MB。克隆完就能离线浏览、预览原图、输出给工作流,不需要再跑任何素材下载脚本。
目录结构长这样:
text
comfyui-pose-gallery/
└── library/
    ├── data/       # 中文姿势索引和分类
    ├── img/        # 1,439 张原尺寸 PNG,900×1200
    ├── thumbs/     # 1,439 张缩略图 JPG,300×400
    └── SOURCE.json # 素材来源和版本
如果以前装过旧版(只带缩略图的版本),在图库节点目录执行一次:
bash
cd ComfyUI/custom_nodes/comfyui-pose-gallery
git pull
重启 + 强制刷新浏览器即可补齐原图。不要只复制 web/ 目录或缩略图目录,那会变成「图库能浏览,但选完姿势节点不显示图片」。
如果想把素材放在别处(比如大硬盘),设环境变量 COMFYUI_POSE_GALLERY_LIBRARY 指向完整图库根目录,该目录必须同时包含 data/、img/、thumbs/ 三件套。
四、怎么用:筛选 → 选中 → 输出
添加节点:image → Pose Gallery → Pose Gallery 姿势图库,然后点节点上的「浏览姿势图库」。
1. 高效筛选
- 四个体系页签直接标出张数和组数,先缩范围
- 动作分类下拉:站姿、坐姿、跪立、趴卧、蹲姿、前倾......
- 五个视角按钮:正面 / 俯视 / 仰视 / 侧面 / 斜侧,可单独切
- 搜索框 :支持中文动作名、姿势编号、完整图片 ID,按
/快速聚焦 - 按姿势分组 / 逐张浏览双模式:分组模式把同一动作的多角度图集中展示,一眼判断这个姿势在五个角度下是否都成立
- 点「重置筛选」恢复全部内容
2. 选中姿势
点卡片进大图,切换视角,点「使用此姿势 → ComfyUI」。
节点会立刻更新两样东西:pose_id 参数 和节点内嵌的原图预览。
3. 接到下游
输出 image 可以直接:
- 接 图像预览 节点确认选的对不对
- 接 Depth Anything 生成深度图
- 接任何图像类节点
五、三条工作流,按需选
仓库自带三条已经本地实测过的工作流,都在 example_workflows/ 下。
| 工作流 | 输入 | 用途 | 实测 |
|---|---|---|---|
| MOSS 深度控制 | 图库姿势 → Depth Anything | 从零按文字生成人物 | 896×1184,50 步,约 46.4 秒 |
| Qwen Image 2.1 | 图库姿势 + 人物参考 | 保留人物外观,只换姿态 | 896×1184,25 步,约 17 秒/张(模型已加载) |
| Krea2 深度控制 | 图库姿势 → Depth Anything V2 | 快速文生图,极致出数 | 896×1184,8 步,热加载约 9.4 秒 |
下面重点讲 MOSS 主线,另外两条放在后面简要说。
六、MOSS 深度控制:完整流程
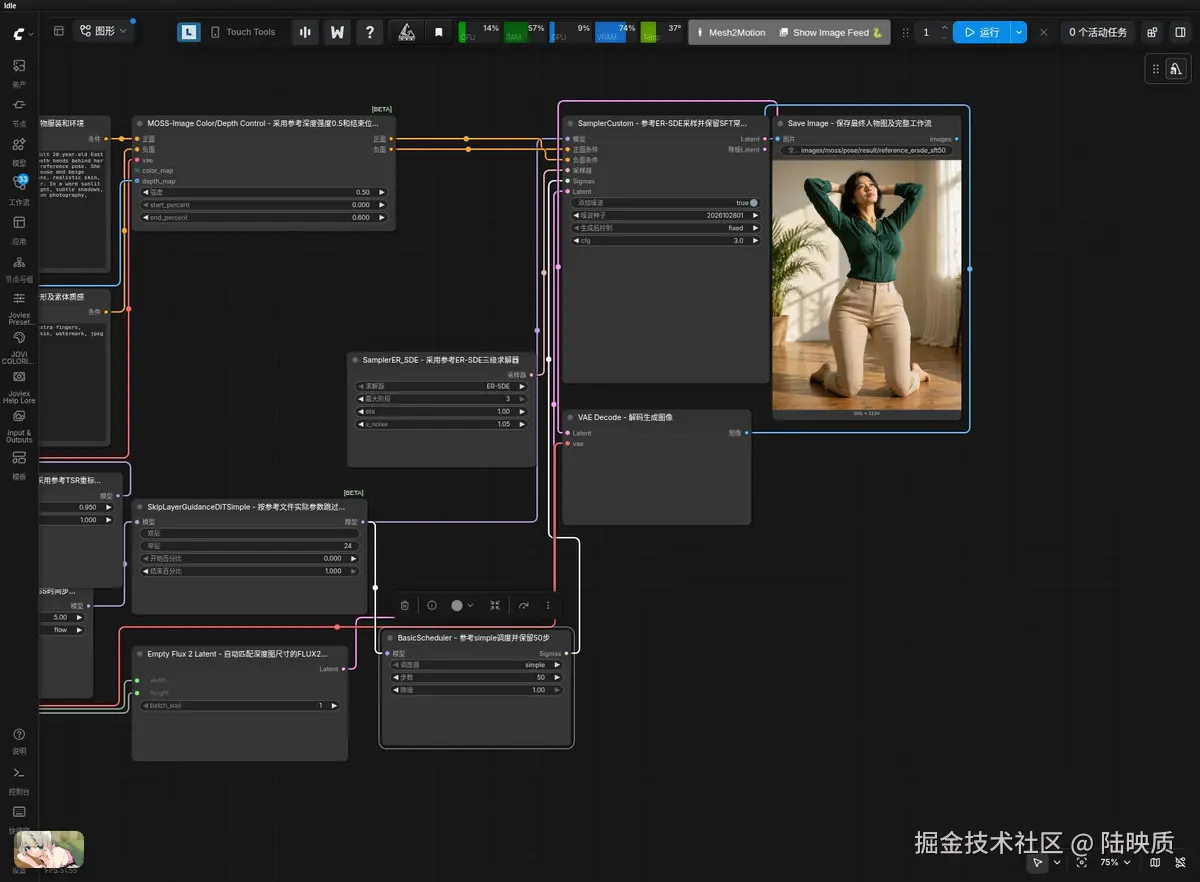
导入 example_workflows/pose_gallery_moss_sft50_reference.json。
链路:Pose Gallery → Depth Anything V2 Large → 等比缩放 → MOSS-Image Color/Depth Control → MOSS SFT → 保存
6.1 环境依赖
- ComfyUI 0.43.0 (本机实测版本),需含原生
MOSSImageControl与 MOSS 模型支持 - comfyui_controlnet_aux + Depth Anything V2 Large 权重
模型文件(放到对应 models/ 子目录):
text
models/diffusion_models/moss/moss_image_sft_bf16.safetensors
models/text_encoders/moss/qwen3.5_9b_int8_convrot.safetensors
models/vae/moss/flux2-vae.safetensors
models/loras/moss/moss_image_color_depth_control.safetensors
深度控制 LoRA 来自 Comfy-Org/MOSS-Image,适配器作者 darask0。Comfy-Org 的文件与作者的 moss-control.safetensors 字节一致,SHA-256 都是:
text
e5c0c3efd05e4269207a39de6005798f14c90c6687c89c54eaffe4b76c43a763拿到文件先核对这个 hash,可以避免下错版本导致的玄学问题。
6.2 关键:深度图怎么来
Depth Anything 会把线稿转成灰度深度图:靠近镜头的区域更亮,远处更暗,把肢体结构转成深度信息。
注意:深度图和最终生图的尺寸要保持一致。改分辨率时要同时改两处------
- 深度图的缩放尺寸
Empty Flux 2 Latent的 width/height
(参考版工作流用 GetImageSize 自动连接潜空间宽高,省了手动对齐这步)
6.3 提示词怎么写
提示词负责人物、服装、环境和光线,不负责动作细节------动作由深度图给。
但有一条硬规则:
⚠️ 提示词里写的动作必须和参考图一致。文字和深度图冲突会直接削弱姿势控制效果。
比如图库选的是跪姿,提示词里又写 "standing",模型就会两边打架,最后出来一个谁都不像的东西。
6.4 参考参数(重点)
| 参数 | 值 | 说明 |
|---|---|---|
| 采样步数 | 50 | 参考版保留 SFT 50 步 |
| 引导系数 CFG | 3.0 | |
| 采样器 | ER-SDE / simple | |
| Shift | 5 | |
| TSR | 0.95 / sigma 1 | |
| 深度强度 | 0.5 | |
| 控制结束点 | 0.6 | 控制到采样进度的 60% |
| SLG 跳过层 | 24 | ⚠️ 参考文件标题写第 22 层,实际 single_layers 是 24,本版按实际值走 |
| 分辨率 | 896×1184 |
两个调节方向(官方给的,很好用):
- 姿态贴合度不够 → 逐步提高深度强度,或延长控制范围(把 0.6 往后推)
- 素体感太重(人物像石膏像) → 降低深度强度,或让深度控制更早结束(把 0.6 往前收)
6.5 实测结果
896×1184 尺寸,约 46.4 秒一张。
主要姿态可以完整保留;脸部、头发、衣服、场景按提示词重新生成。
但要说清楚边界 :深度图不是精确骨骼控制,手指、面部细节和轮廓仍可能出现变化。建议的用法是------先用它验证构图与姿态,构图对了再往下调细节,别指望它一步到位出手指完美的成品。
输出路径(相对 ComfyUI output):
text
images/moss/pose/depth/pose_depth_*.png      # 深度图
images/moss/pose/result/moss_sft50_pose_*.png # 成图
保存的 PNG 里带了实际 API 参数和可导入的工作流,方便复现。
七、Qwen Image 2.1:保持人物,换姿势
如果你要的不是「随机生成一个人」,而是「让这个人换个姿势」,用这条。
导入 example_workflows/pose_gallery_qwen21_pose_edit.json。
- 双图输入 :图库线稿接
image_1,人物参考接image_2 - 配合 Qwen2.1 专用 Pose Studio v2 LoRA(强度 1)
- 25 步、CFG 1、Euler/simple、种子 20261029,896×1184
- 通用提示词里不写固定动作名,只保留身份、服装、画风、背景、光照
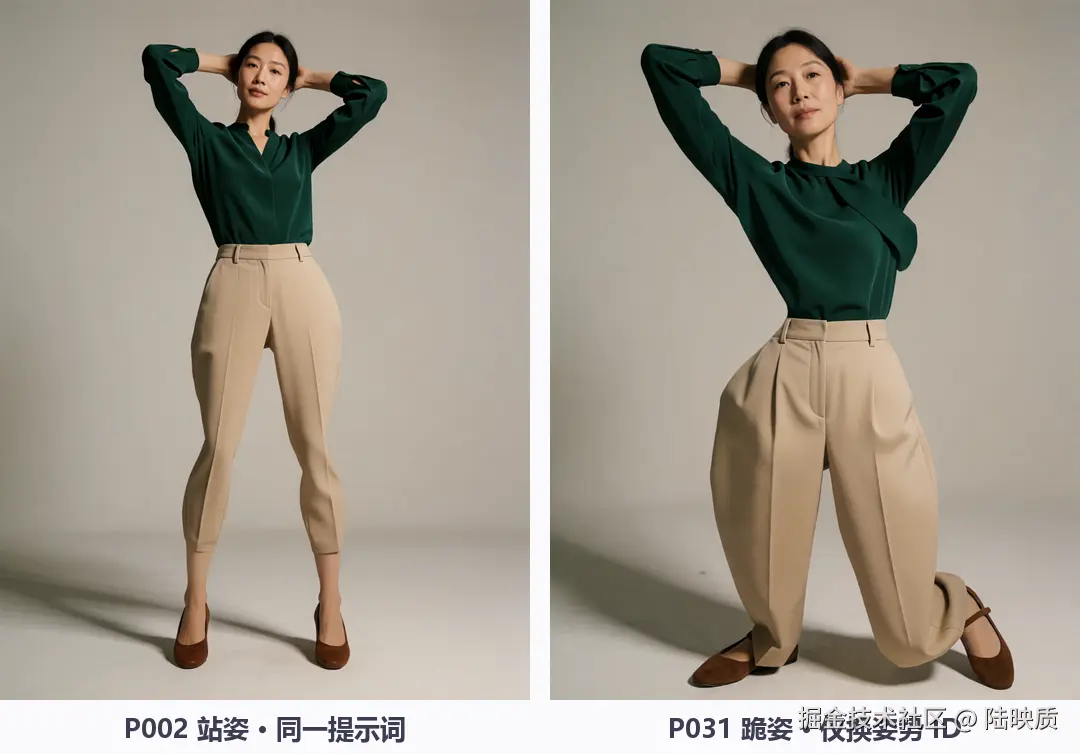
上图是同一份人物参考 + 同一份通用提示词,只切换姿势 ID 的结果:酒红上衣、白裤、发型全部保留,站姿切成跪姿。
局限也得说:复杂姿势和多人姿势尚未覆盖,可能需要补文字、调参数或重试。
想自己试的话,把 example_workflows/assets/pose_gallery_person_reference.png 复制到 ComfyUI/input/,或者直接换成你自己的参考图。
八、Krea2:9 秒出图的快线
导入 example_workflows/pose_gallery_krea2_depth.json。
链路:Pose Gallery → Depth Anything V2 Large → Krea2 Control Image Encode/Apply → Krea2 Turbo
- 8 步、CFG 1、ER-SDE/simple、深度控制强度 1
- 896×1184,首轮冷加载约 67.8 秒,模型加载后约 9.4 秒
- 纯文生图,没有人物身份参考图,人物由文字生成
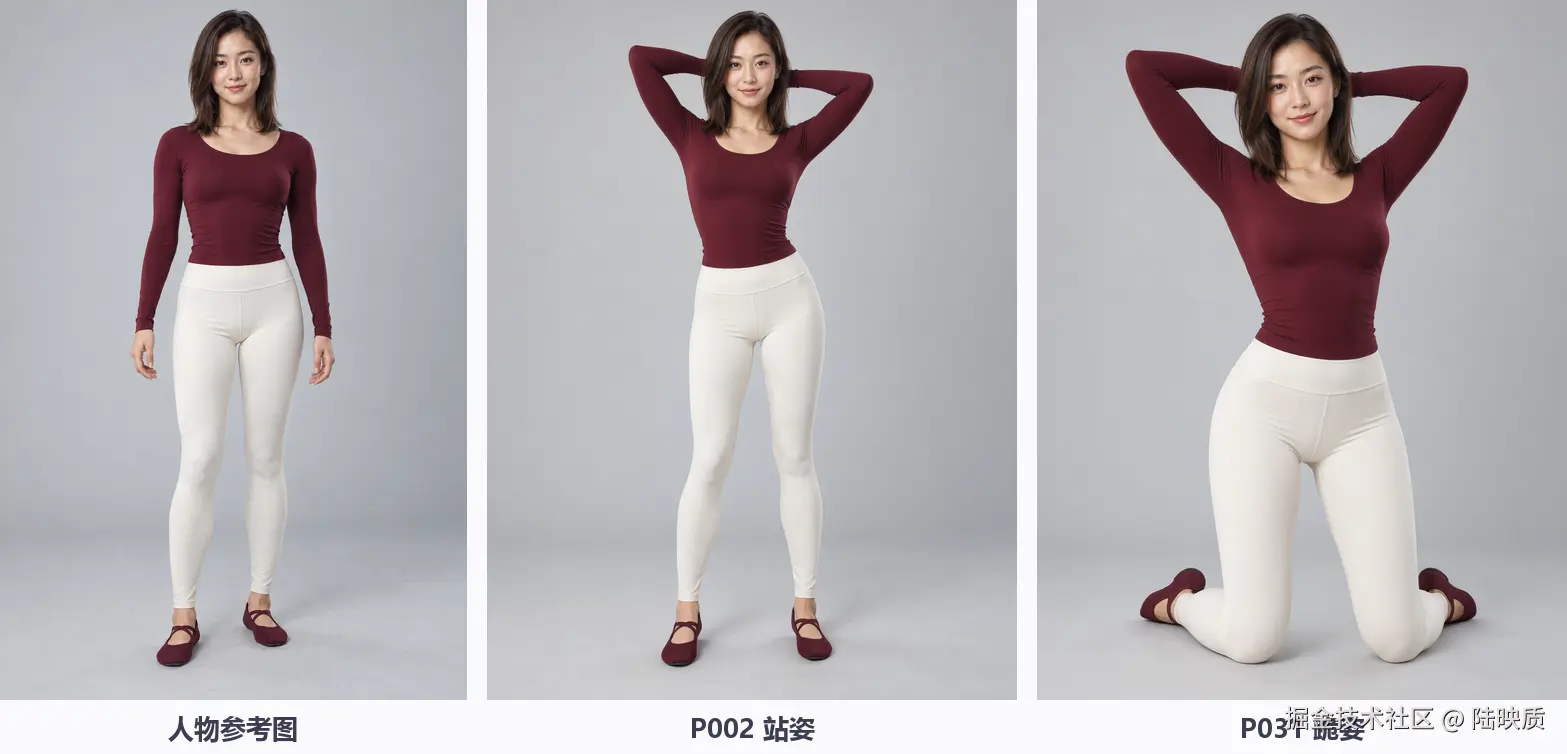
同一提示词、同一种子,只换图库姿势,分别生成站姿和跪姿。提示词只写人物、服装、场景、画风,完全不用填动作。
目前只验证了这两组,手脚细节和精确关节角度仍可能偏离,适合快速试构图。
九、几个容易踩的坑
| 坑 | 现象 | 解法 |
|---|---|---|
| 装了旧版只带缩略图 | 能浏览但选完不显示图 | git pull 补齐 library/img/,重启 + Ctrl+Shift+R |
| 提示词动作和参考图冲突 | 姿势控制明显失效 | 文字描述必须和深度图一致 |
| 只改了生图分辨率 | 构图被拉伸/错位 | 深度图缩放 + EmptyLatent 尺寸必须一起改 |
| 深度强度和结束点设太高 | 人物像素体/石膏 | 降强度,或让控制提前结束(0.6 → 0.5) |
| 用编号(P001)跟人沟通 | 对不上号 | 四个体系各自从 P001 起编 ,P001 有四个;要唯一定位请复制完整 ID,如 full_sexy_P001_front |
| 深度 LoRA 下错版本 | 效果玄学 | 核对 SHA-256 e5c0c3ef...a763 |
还有一点:如果你用 COMFYUI_POSE_GALLERY_LIBRARY 指定了自定义目录,那个目录必须包含完整的 data/ + img/ + thumbs/,只放 img 会报错。
十、安全与许可(务必看一眼)
安全设计 :图库走本地白名单目录,不联网下载;浏览器只能读取元数据里允许的图片,路径穿越和外部文件符号链接都会被拒绝。想自己验证可以跑:
bash
python -m unittest discover -s tests -v覆盖目录边界、非法 ID、文件缺失、符号链接逃逸。
许可边界(这条别忽略):
| 内容 | 许可 |
|---|---|
| 节点代码、改编的画廊页面 | MIT |
library/img/、library/thumbs/、library/data/ 里的图片与原始数据 |
不适用 MIT |
图片与原始数据的权利属于原作者 ギア (ai-pose-gallery.pages.dev),中文数据由 Anhao 整理。仓库保留了原站链接和上游来源说明,已移除上游统计脚本。
使用前请务必查看 LICENSE、NOTICE.md 和 library/LICENSE。克隆仓库不等于获得图片的数据授权,尤其不要拿图片本身做二次分发或转售。
十一、项目地址
- GitHub :github.com/wangweihong...
- 在线图库(先逛再装) :pose.t-teams.uk
- 上游中文镜像 :github.com/anhao/ai-po...
- 原作者 :ギア · ai-pose-gallery.pages.dev
仓库克隆下来就有完整的缩略图、原图和中文索引,可以离线浏览。
小结
| 你要做什么 | 用哪条 |
|---|---|
| 快速试构图 | Krea2 深度控制(~9.4s) |
| 出一张完整的、按文字描述的人物照 | MOSS 深度控制(~46.4s) |
| 让固定角色换姿势 | Qwen 2.1 姿态编辑(~17s) |
| 只想要线稿自己搭流程 | Pose Gallery 节点输出 → 接你自己的 ControlNet |
姿势这件事,从「靠提示词抽卡」变成「先选一张线稿」,出图的确定性会有质的变化。剩下的细节------手指、面部------还是得靠调整和重试,别指望一个节点解决所有问题。