中小企业跑125B 大模型:显存装不下的时候,Strata 能做什么?
 作者:吴佳浩 撰稿时间:2026-10-24 测试环境:
- GPU:RTX 5090(32GB VRAM,驱动 580.142,CUDA 13.0,PCIe Gen3 ×16)
- CPU:Intel Xeon Gold 5218 ×2(32 物理核 / 64 线程,2 个 NUMA 节点,无 AVX512-BF16)
- Memory:125.6 GiB RAM
- Storage:/workspace 3.5TB(/dev/sdb1,实测顺序写 435 MB/s)
- OS:Ubuntu 20.04.3 LTS(kernel 5.15.0-58)
- Engine:Strata v0.2.2(engine 0.1.47,CUDA 13.0,官方容器镜像)
- Model:Qwen3.8-Flash-Next Q2_0(125B 级 MoE,48 层 × 512 专家 = 24,576 个专家槽)
引言
面向工程师与研究者的体系化分析。之前我们在个人pc上做了尝试今天待大家从企业视角来来看看 这条线是不是行得通。 阿拉不止讨论「跑起来了没有」,更追问「这件事对本地部署意味着什么、代价又落在哪一层」。 125B 级 MoE 模型过去只活在几百 GB 显存的服务器上。Strata 把「模型装不下」这件事,从一道算术死题,换成了一个带宽工程题。 本文是这个系列的第一篇,只讲一件事:当显存放不下模型时,Strata 到底把什么东西放在了哪里,又是怎么把「显存缺口」翻译成「吞吐」的。
注:全文所有数字均来自本机真实运行的日志与遥测,未经验证的推算会明确标注为推算。因为阿拉好奇,所以拿一块 32GB 的卡,一道来白相相------看看这套 Spill 设计是徒有虚名,还是真的结棍。
目录
- 问题的本质:为什么「显存占用率」是个废指标
- [Strata 的显存账本:三个区、一条公式](#Strata 的显存账本:三个区、一条公式 "#%E4%BA%8Cstrata-%E7%9A%84%E6%98%BE%E5%AD%98%E8%B4%A6%E6%9C%AC%E4%B8%89%E4%B8%AA%E5%8C%BA%E4%B8%80%E6%9D%A1%E5%85%AC%E5%BC%8F")
- [一个 token 的显存之旅](#一个 token 的显存之旅 "#%E4%B8%89%E4%B8%80%E4%B8%AA-token-%E7%9A%84%E6%98%BE%E5%AD%98%E4%B9%8B%E6%97%85")
- [模型是什么格式:GGUF、pack、MTP 三层产物](#模型是什么格式:GGUF、pack、MTP 三层产物 "#%E5%9B%9B%E6%A8%A1%E5%9E%8B%E6%98%AF%E4%BB%80%E4%B9%88%E6%A0%BC%E5%BC%8Fggufpackmtp-%E4%B8%89%E5%B1%82%E4%BA%A7%E7%89%A9")
- 效率是怎么被决定的:五段传导链
- 可验证的预测:把「玄学」变成可测量的量
- 总结
一、问题的本质:为什么「显存占用率」是个废指标
1.1 先把算术摆出来
先看这台机器上真正要放进去的东西有多大。用我这套部署里实际落盘的 Q2_0:
| 文件 | 字节数 | 内容 |
|---|---|---|
| shard1 | 37,623,740,192 | dense 权重 + 全部 24,576 个专家 |
| shard2(PLE 表) | 28,800,138,432 | 320,001,536 行 × 160 维的 n-gram 表 |
| 合计 | 66.4 GB | 还不含 0.85 GB 的图像编码器与 6.5 GB 的 MTP 草稿层 |
而 RTX 5090 的显存是 32,607 MiB,约 31.8 GiB。
66.4 GB 对 31.8 GiB,缺口接近 2.1 倍。 这不是调参能解决的问题,是算术问题。
1.2 MoE 把「算力」和「显存」解耦了
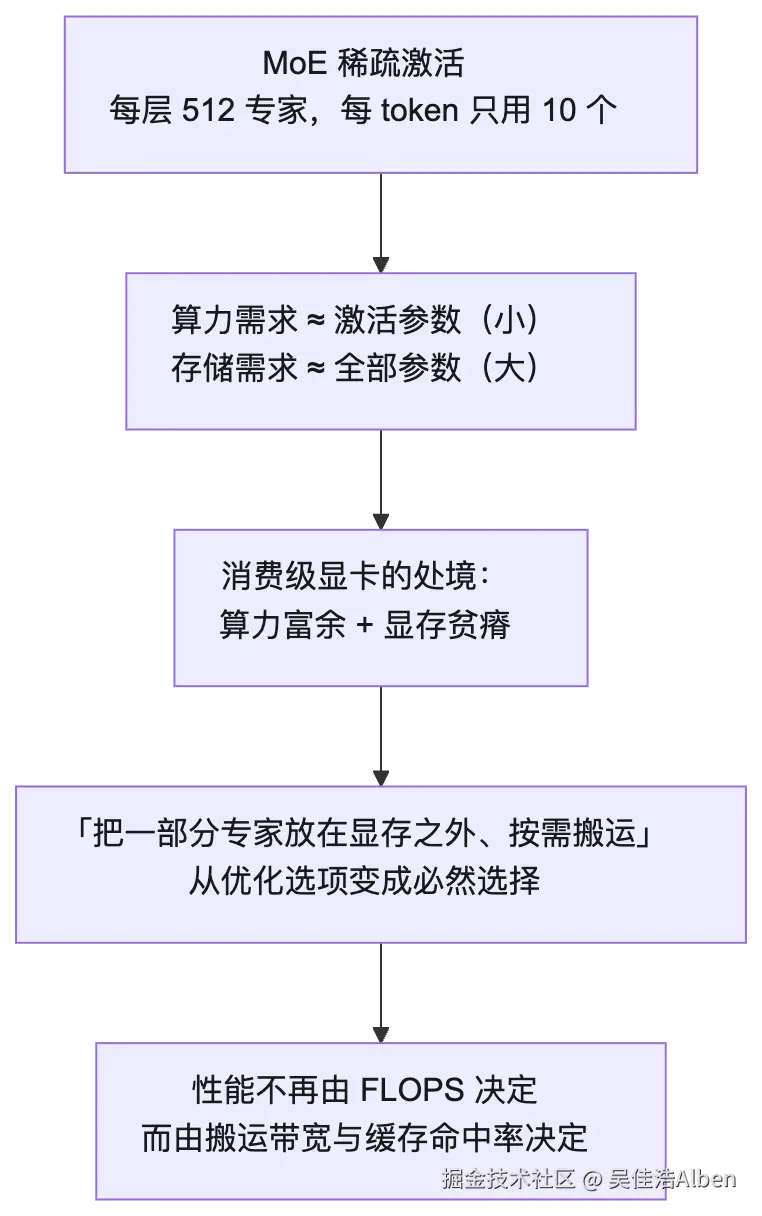
关键在于这个模型是 MoE(混合专家):48 层,每层 512 个专家,但每个 token 每层只路由 10 个。
markdown
稠密模型:算力 ∝ 总参数量
MoE 模型:算力 ∝ 激活参数量(远小于总量)
显存 ∝ 总参数量(一点没少)这条式子解释了消费级显卡的处境:算力富余,显存贫瘠。我这台机器上,压测期间 GPU 功耗峰值 472 W,而卡的上限是 575 W------算力还有余量;但显存占用稳定在 31,879 / 32,607 MiB,也就是 97.8%,一格都挤不出来了。
1.3 「显存占用率」为什么骗人
这是本文最想先纠正的一个观念。
我做了两轮完全相同的部署,唯一区别是显卡上有没有别的进程在占显存。结果:
| 指标 | 第一轮(共享) | 第二轮(独占) |
|---|---|---|
| 整卡显存占用 | 31,865 MiB | 31,879 MiB |
| 显存占用率 | 97.7% | 97.8% |
| Decode | 140.6 tok/s | 256.2 tok/s |
两轮显存占用率几乎一模一样(差 0.1 个百分点),速度却差 82%。
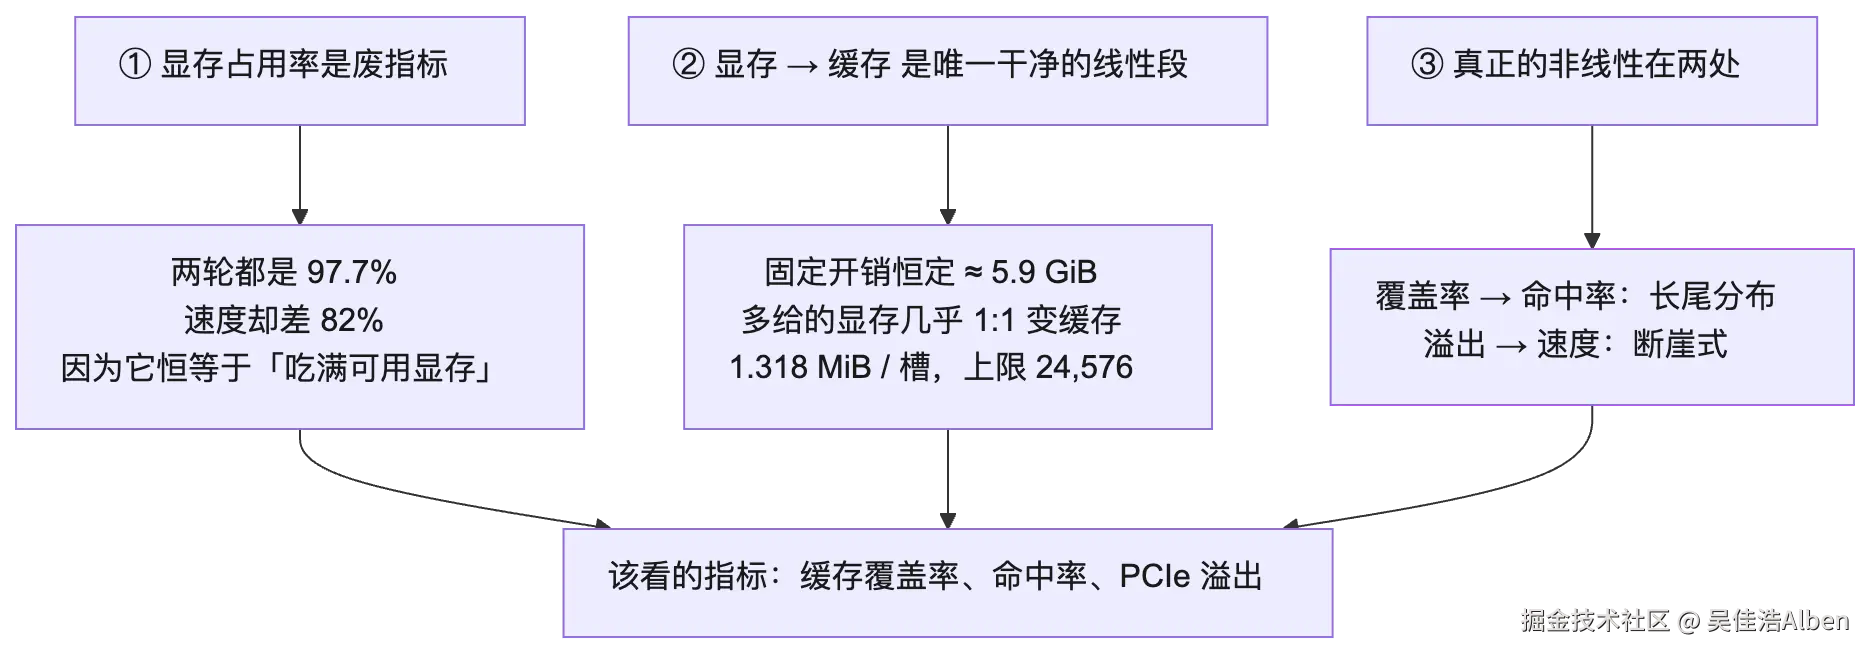
所以「显存占用 97%」这个数字本身不携带任何性能信息------因为 Strata 的设计就是把能用的显存全部吃满来放专家缓存。它不占满才是浪费。

本文后面会证明:真正决定速度的,不是显存占了多少,而是「缓存之外的专家占多少」。 前者恒等于 97%,后者才是那个会变的数。
二、Strata 的显存账本:三个区、一条公式
2.1 三个区
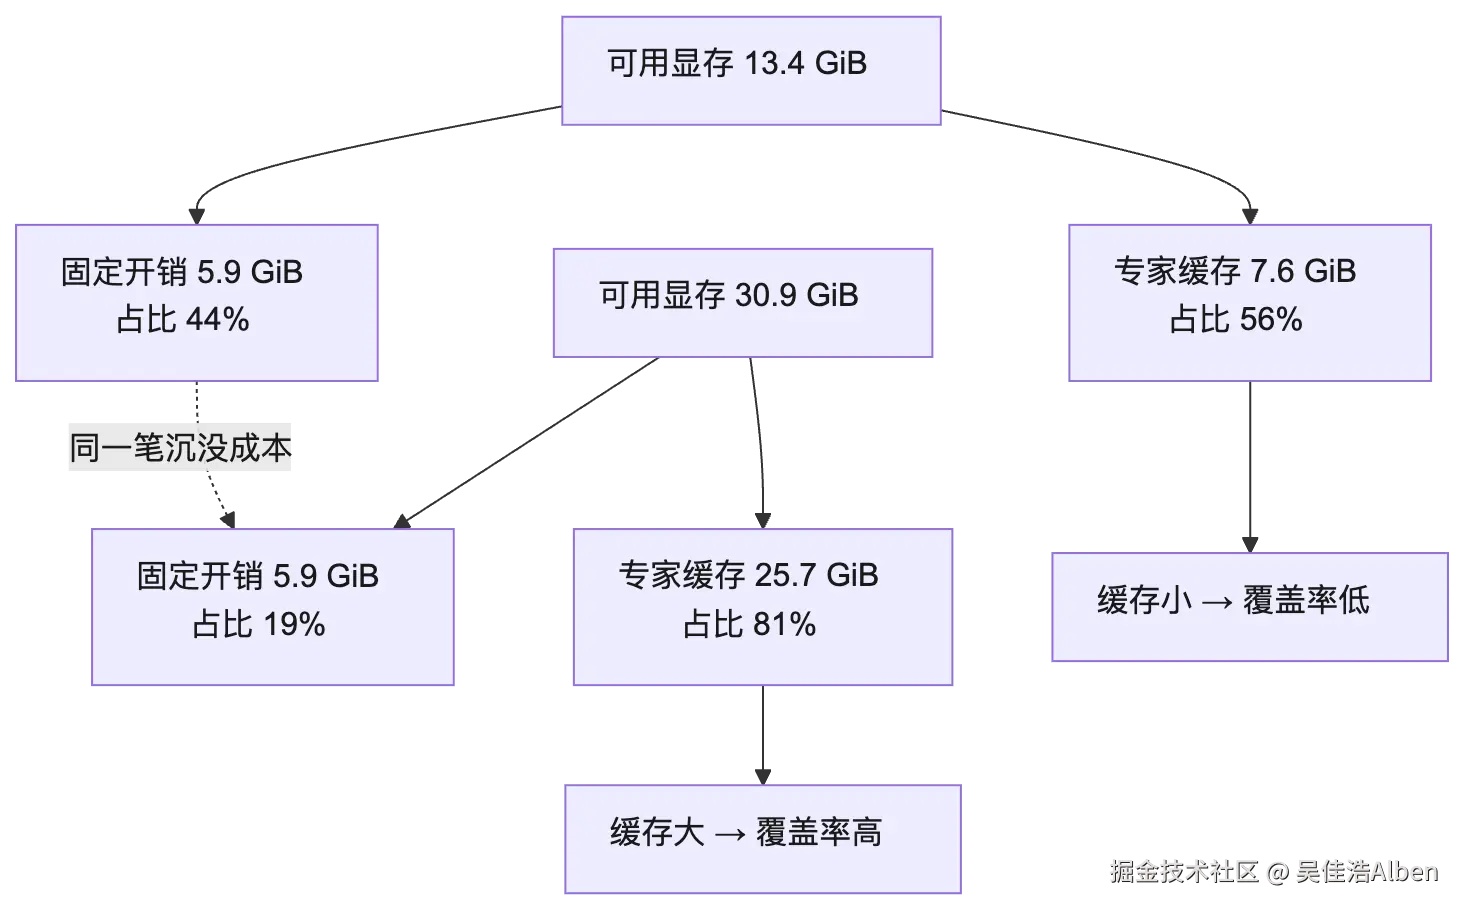
启动后的引擎日志把显存分成了清楚的三块。用第二轮(独占)的实测值:
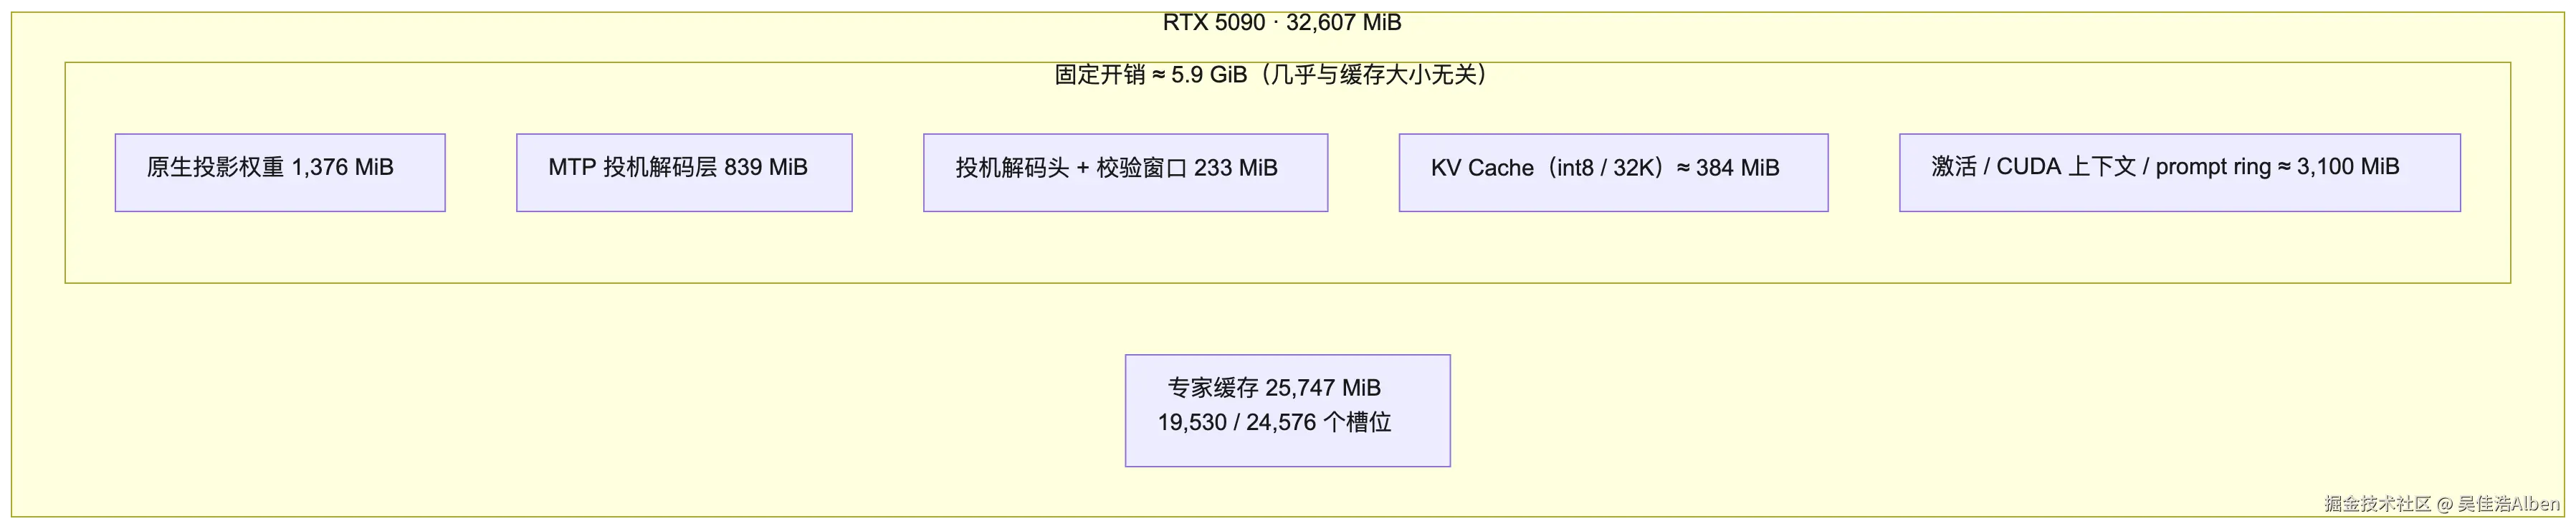
用引擎日志的原话对一遍:
text
strata generate: 301 native projection matrices, 1376.20 MiB of weights, in 1.8 s
strata mtp: draft layer loaded, 839 MiB of VRAM (experts 675, dense 111)
strata mtp: draft head over 106299 tokens (178.4 MiB)
strata verify: window up to 6 tokens, 55.0 MiB of device buffers
strata generate: expert cache auto: 26.01 GiB free, 700 MiB reserved (+184 MiB for the draft head) -> 19530 slots
strata generate: expert cache 19530 slots, 25.14 GiB of VRAM
strata serve: 410 MiB of VRAM free with everything loaded
2.2 一条可以自己算的公式
从两轮日志里能反推出这套引擎的分配常数,而且两轮完全一致:
- 每个专家槽位 1.318 MiB(7,625 / 5,784 = 1.318;25,747 / 19,530 = 1.318)
- 固定预留 700 MiB (系统)+ 184 MiB(投机解码头)
- 槽位上限 24,576(= 48 层 × 512 专家)
写成一条式子:
槽位数=min(24576, 1.318 MiB启动时空闲显存−884 MiB)
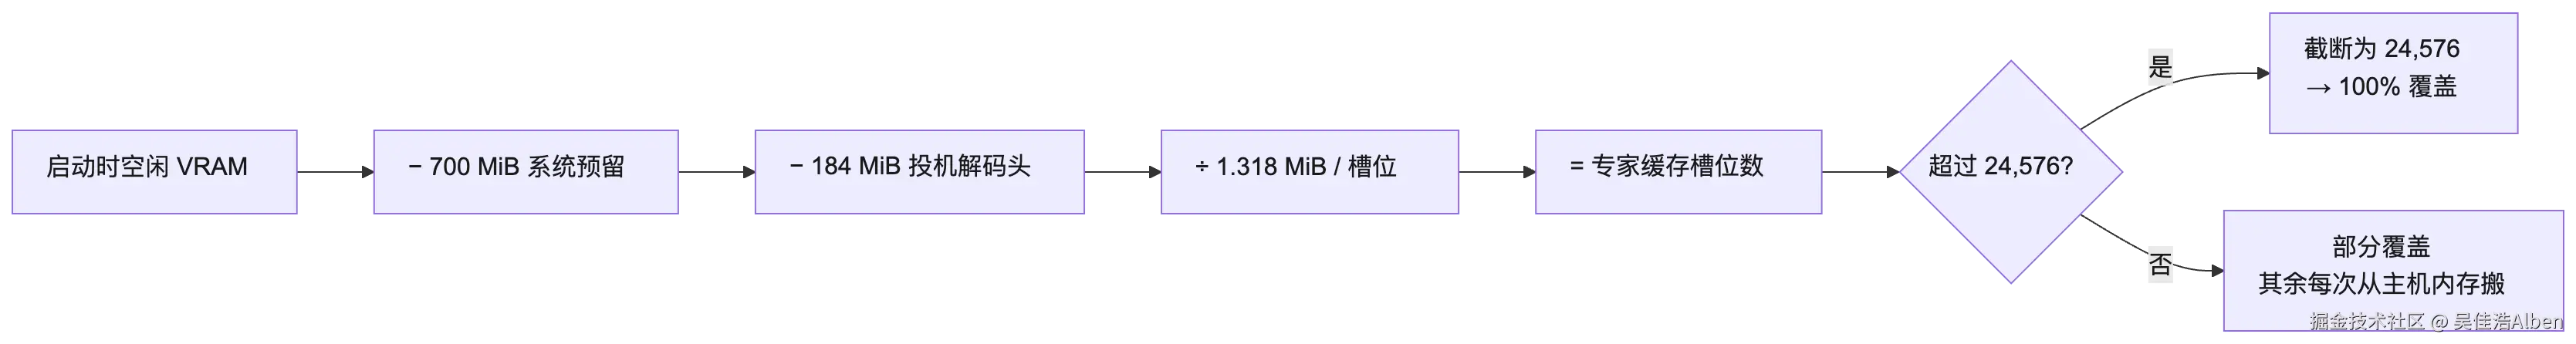
拿实测回代,三个不同显存条件下的启动全部对得上:
| 启动时空闲 | 式子 | 实际槽位 | 对账 |
|---|---|---|---|
| 6.07 GiB = 6,215 MiB | (6,215 − 884) / 1.318 = 4,045 | 4,043 | ✅ |
| 8.31 GiB = 8,509 MiB | (8,509 − 884) / 1.318 = 5,786 | 5,784 | ✅ |
| 26.01 GiB = 26,634 MiB | (26,634 − 884) / 1.318 = 19,537 | 19,530 | ✅ |
(三行都取自引擎日志原文,误差 0.04% 以内,来自字节对齐取整。)
这条公式的实际价值:你不需要跑基准,只要知道启动时能空出多少显存,就能算出这台机器能覆盖多少比例的专家。第三篇里我把它做成了一张速查表。
2.3 一个反直觉的推论:多给的显存几乎全部变成缓存
把两轮的「引擎总显存」减去「专家缓存」,得到的就是固定开销:
| 轮次 | 引擎显存 | 专家缓存 | 固定开销 | 固定开销占比 |
|---|---|---|---|---|
| 第一轮 | 13,670 MiB | 7,625 MiB | 6,045 MiB | 44.2% |
| 第二轮 | 31,674 MiB | 25,747 MiB | 5,927 MiB | 18.7% |
6,045 vs 5,927,差 2%。 也就是说,固定开销基本不随缓存大小变化。
结论很干净:你多给显卡的每一 GB 显存,几乎 1:1 变成了专家缓存。 不存在「显存越大、开销越大」的摊薄陷阱------反而是显存越大,固定开销的占比越被摊薄,显存利用效率越高。
三、一个 token 的显存之旅
前两节是静态的账本,这一节跟一个 token 走一遍完整路径,看清楚「性能」到底花在哪里。
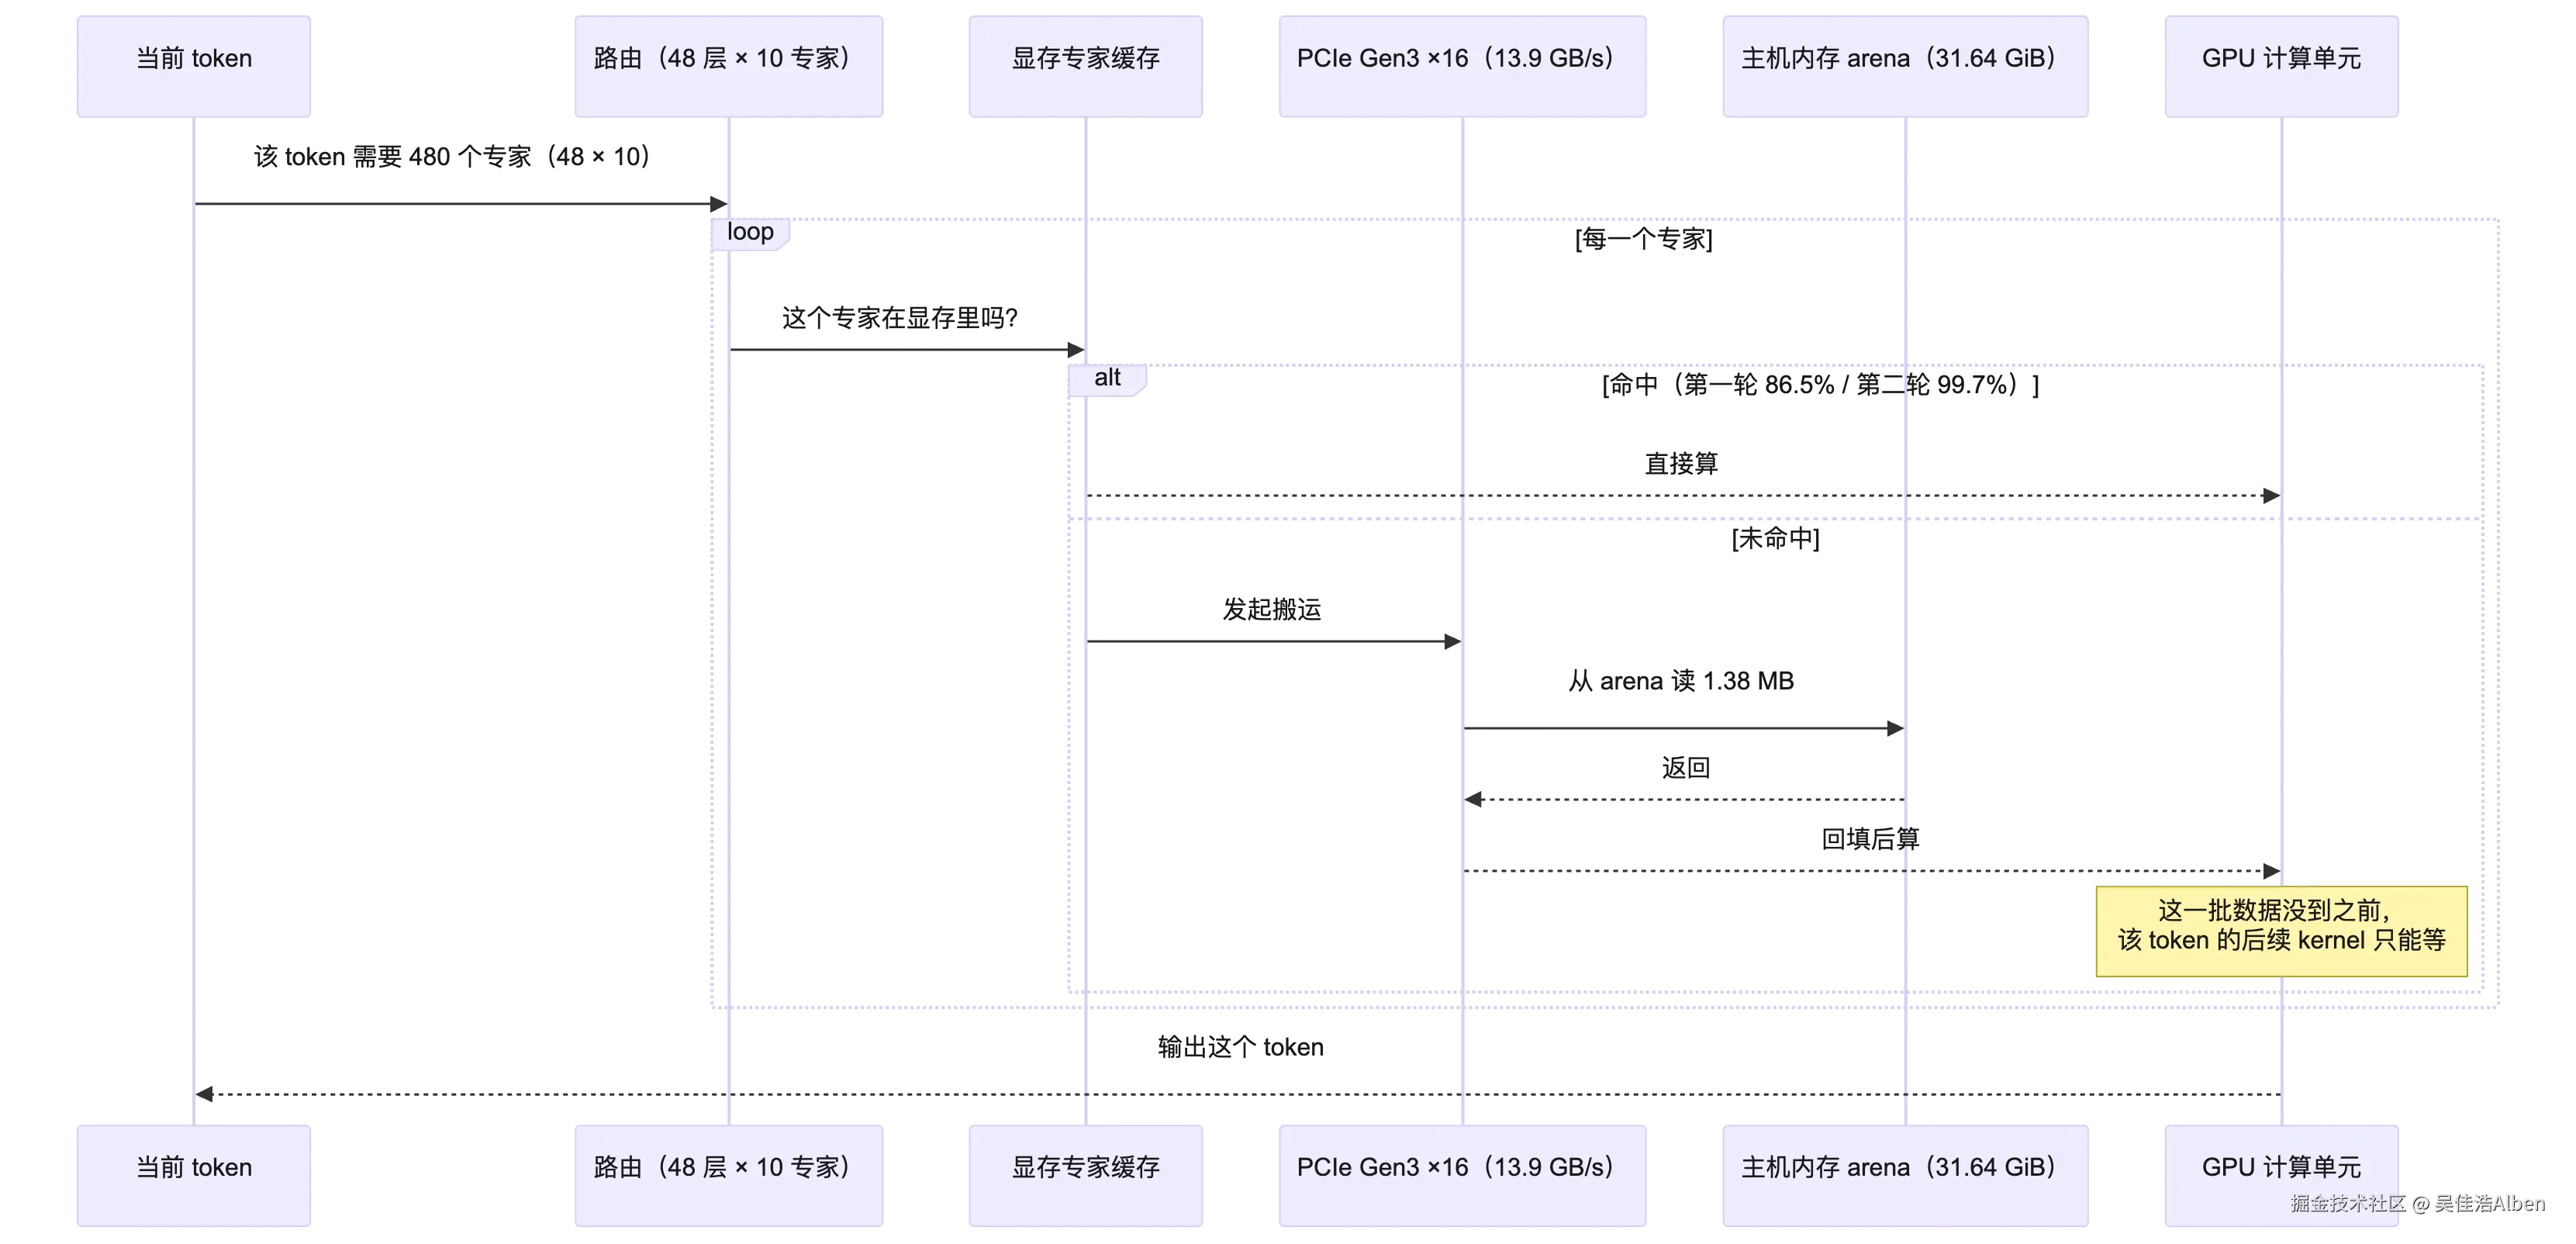
三个细节值得单独说。
3.1 为什么「全部专家」必须待在主机内存里
引擎加载时把完整的 24,576 个专家搬进了主机内存 arena:
text
strata generate: expert arena: cudaHostRegister PORTABLE ok
strata generate: loaded 31.64 GiB at 0.99 GiB/s
strata generate: expert arena read through the file cache (buffered)
31.64 GiB 常驻内存,加上 PLE 表(--ple-io ram)和进程本身,压测期间系统内存稳定在 96.3 GiB / 125.6 GiB。
这一步是「慢」的来源,也是「能跑」的前提:只有全部专家都在内存里,才能做到「未命中时立刻能搬」,而不是回头去读 SSD。
3.2 KV Cache 便宜得让人意外
我原本以为长上下文会让 KV 吞掉大量显存,实测打了脸:
| 配置 | 专家缓存 | 槽位 | 相对 32K 的差 |
|---|---|---|---|
| 32K 上下文,KV int8 | 25,747 MiB | 19,530 | 基准 |
| 64K 上下文,KV int8 | 25,692 MiB | 19,488 | −55 MiB |
上下文从 32K 翻到 64K,只多花了 55 MiB 显存。
原因是这个模型的注意力结构是带压缩的(GGUF 元数据里有 qwen4exp.attention.compress_ratios,48 层各一个压缩比),KV 本身就是压缩表示。所以在这套架构里:
上下文长度几乎不花显存,显存预算基本可以全部押在专家缓存上。
这和很多「长上下文很吃显存」的经验不同,是模型结构差异带来的红利。第三篇会用它解释「为什么 64K 上下文几乎不损失速度」。
3.3 MTP 投机解码:让一次搬运服务多个 token
Spill 架构下 decode 是逐 token 的,每个 token 都要搬一次专家。工程上的破解办法是投机解码:用一个小草稿模型先猜接下来几个 token,再让主模型一次并行校验。
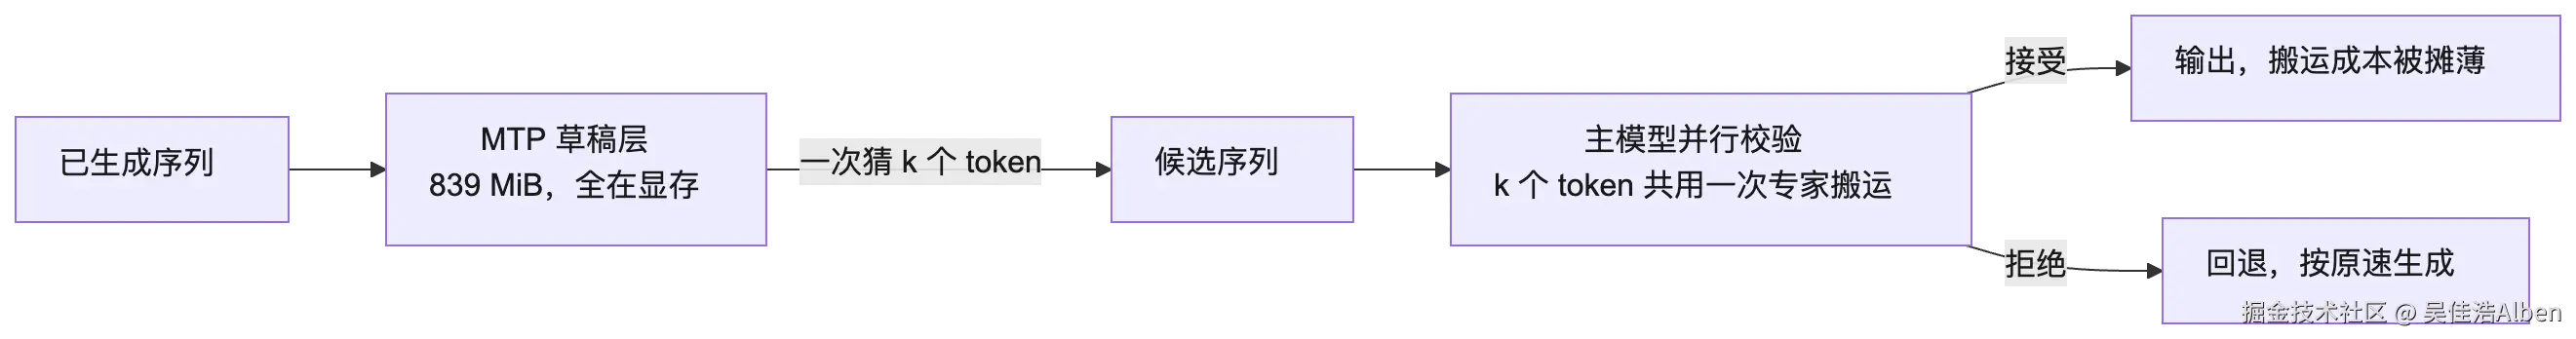
我这套配置里 MTP 的实测接受率:
| 轮次 | offered | accepted | 接受率 |
|---|---|---|---|
| 第一轮 | 79,788 | 51,029 | 64.0% |
| 第二轮 | 127,607 | 81,074 | 63.5% |
64% 的接受率意味着:大约每 1.6 个 token 就能省下一次专家搬运。这也解释了后面实测里 decode 能到 200+ tok/s------单靠「一次搬一个专家算一个 token」是做不到的。
四、模型是什么格式:GGUF、pack、MTP 三层产物
很多人以为本地推理就是「下载一个模型文件然后加载」。这套东西实际落盘是三层不同格式的产物,搞清楚它们才能理解「哪个文件对应哪块显存」。
4.1 主模型:GGUF v3,而且是混合精度
我直接读了两个分片的文件头:
| 项 | 实测 |
|---|---|
| magic / version | GGUF / 3 |
| shard1 | 35.04 GiB,1223 个 tensor |
| shard2 | 26.82 GiB,1 个 tensor |
| architecture | qwen4exp |
| 结构 | 48 层,hidden 2560,24 attn heads / 2 KV heads,512 专家,每 token 用 10 个 |
| 声明上下文 | context_length = 262144(256K) |
| 量化标注 | general.file_type = 41(Q2_0 档),quantization_version = 2,quantized_by = ISTA DASLab |
「Q2_0」只是档位标签,文件其实是混合精度。 按 tensor 统计:
| ggml 类型 | tensor 数 | 元素数 | 用在哪 |
|---|---|---|---|
| Q2_0 | 202 | 121.06 B | MoE 专家权重(主体) |
| IQ4_NL | 8 | 51.21 B | shard2 的 PLE 大表 [160, 320001536] |
| Q3_K | 91 | 1.80 B | token_embd、共享专家 up |
| IQ4_XS | 56 | 0.82 B | attn_qkv 等 |
| Q5_K | 16 | 0.76 B | output 等 |
| BF16 | 483 | 0.74 B | hyper-connection 权重 |
| Q4_K / Q6_K / Q4_0 / Q5_0 / Q8_0 | 38 / 12 / 16 / 7 / 2 | ~0.5 B | 各类投影与共享专家 |
| F32 / F16 | 292 / 1 | 2.6 M | 各种 norm、ple_conv1d |
所以它是「2-bit 专家 + 4~6 bit 投影 + BF16 超连接」的混合精度,不是一个统一 2-bit 文件。这也是为什么同样的「Q2_0」在不同仓库里质量表现会不一样------混合策略不同。
4.2 运行时产物:三层落盘
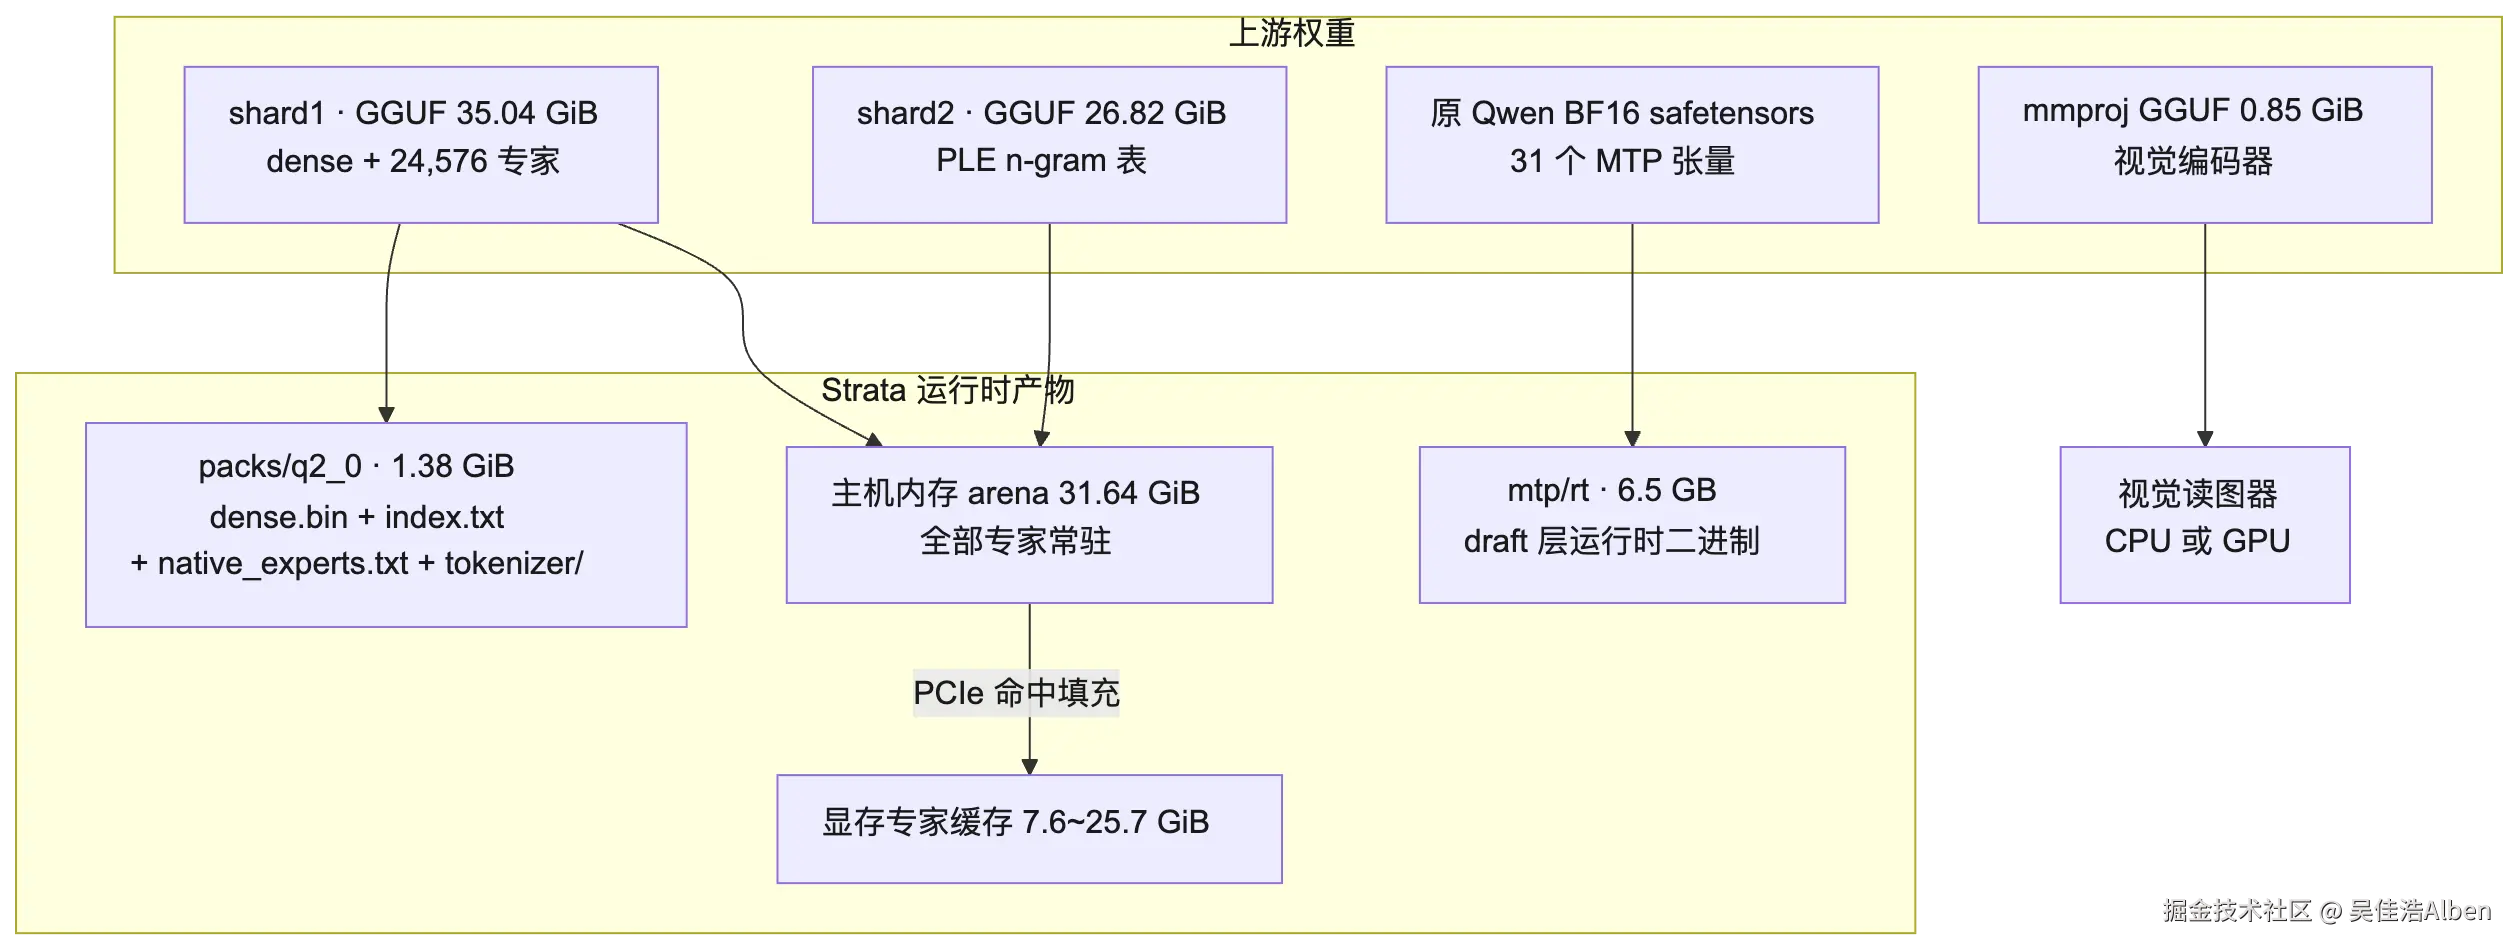
各层的作用:
| 产物 | 大小 | 格式 | 作用 |
|---|---|---|---|
packs/q2_0/ |
1.38 GiB | Strata pack v3(dense.bin + index.txt 1081 行 + native_experts.txt + tokenizer) |
原生投影矩阵、专家偏移表、分词器 |
| 主机 arena | 31.64 GiB | 进程匿名内存 + cudaHostRegister |
全部专家常驻,按需搬运 |
| 显存专家缓存 | 可变 | GPU 显存 | 存最热的专家 |
mtp/rt/ |
6.5 GB | 裸二进制(dense.bin / experts.bin / draft_vocab.bin)+ 889 MB GGUF |
投机解码草稿层 |
引擎的启动参数正好把这五块串起来:
bash
strata --serve \
  --pack      /data/Strata-data/packs/q2_0 \
  --native    /data/Strata-data/models/Q2_0/...-00001-of-00002.gguf \
  --ple-gguf  /data/Strata-data/models/Q2_0/...-00002-of-00002.gguf \
  --mtp       /data/Strata-data/mtp/rt \
  --max-context 32768 --kv int8 --ple-io ram
4.3 这套格式带来的两个后果
后果一:不能直接丢给 vLLM / SGLang。 它要的是 GGUF + 专门的运行时;HF safetensors 那套流程吃不了。
后果二:目录结构就是显存账本的物理映射。 之前那 31.64 GiB 的 arena 和 25.7 GiB 的缓存,都能在磁盘上找到对应来源------这也意味着换更小的量化档,省下来的是 arena,而不是缓存。这一点在第三篇选型时会用到。
五、效率是怎么被决定的:五段传导链
到这里,静态结构已经清楚。接下来把「显存」和「tok/s」之间的因果链接起来------这是本文的核心,也是第二篇实测要逐段验证的东西。

五段的性质完全不同:
| 段 | 关系 | 我实测的形态 | 可优化性 |
|---|---|---|---|
| ① 显存 → 缓存 | 线性,1:1 | 固定开销恒定,多给的全进缓存 | 加显存 |
| ② 缓存 → 覆盖率 | 线性 | 1.318 MiB/槽,上限 24,576 | 与①同源 |
| ③ 覆盖率 → 命中率 | 强非线性(长尾) | 覆盖率 23.5% → 命中率 86.5% | 靠 profile 排序 |
| ④ 命中率 → PCIe 溢出 | 放大 | 命中 86.5% → 溢出 2.5% | 靠③ |
| ⑤ 溢出 → 速度 | 断崖 | 溢出 0.5% 即掉 39% 速度 | 靠④ |
这条链里真正"非线性"的是第③段和第⑤段。 而第①段那个漂亮的 1:1,恰恰是最容易被误读的地方------很多人看到「显存翻倍只快 1.8 倍」就以为存在「边际递减」,其实是把第③⑤段的非线性算到了第①段头上。
第二篇会把这条链逐段用 2,890 条逐请求遥测拆开验证。
5.1 一个必须先说清的坑:不是「搬得慢」,是「等得久」
按带宽算,未命中的成本不该那么贵:
ini
每 token 480 次专家查表 × 1% 溢出 = 4.8 个专家
× 1.38 MB = 6.6 MB / token
÷ 13.9 GB/s(实测 PCIe Gen3 ×16)= 0.47 ms
而 141 tok/s = 7.1 ms / token
→ 0.47 / 7.1 ≈ 6.6%
理论上只该慢 6.6%,但我实测在 0.5% 溢出时就已经慢了 39%。差了 6 倍。
原因不在带宽,在同步:PCIe 搬运是异步发起的,但主模型的 attention 与 MoE 计算有严格的数据依赖,一批专家没到,后续 kernel 只能干等。等待期间 GPU 表面上是「忙」的,实际在空转:
| 轮次 | GPU 利用率 | 功耗均值 | 功耗占上限 | 我的判断 |
|---|---|---|---|---|
| 第一轮 | 89.1% | 230 W | 40% | 假忙(在等 PCIe) |
| 第二轮 | 89.8% | 337 W | 59% | 真忙(在算) |
「GPU 利用率」这个指标在这类架构上是失效的------它只回答「有没有活干」,不回答「干的活有没有产出」。第二篇会用功耗曲线把这个现象坐实。
六、可验证的预测:把「玄学」变成可测量的量
理论讲完,得给出可以被证伪的预测。基于上面五段链,我在跑第二轮之前写下了四条预测:
| # | 预测 | 验证方式 |
|---|---|---|
| P1 | 专家缓存从 7.6 GiB 扩到 25.7 GiB,覆盖率从 23.5% 升到 79.5% | 引擎日志的槽位数 |
| P2 | 命中率会非线性上升,但升幅远小于覆盖率升幅(长尾) | 逐请求 telemetry 的 hit_rate |
| P3 | 命中率上升会几乎消灭 PCIe 溢出 | 逐请求 telemetry 的 pcie % |
| P4 | decode 的提升幅度会远大于显存投入的"线性直觉",但低于「溢出归零」的极限 | 同协议基准对比 |
第二轮实测结果(详见第二篇):
| # | 预测 | 实测 | 判定 |
|---|---|---|---|
| P1 | 覆盖率 23.5% → 79.5% | 5,784 → 19,530 槽(= 23.5% → 79.5%) | ✅ |
| P2 | 命中率非线性上升 | 86.5% → 99.7%(+13.2 点,远小于 +56 点) | ✅ |
| P3 | PCIe 溢出几乎消失 | 0.50% → 0.00% | ✅ |
| P4 | decode 大幅提升 | 140.6 → 256.2 tok/s(+82%) | ✅ |
四条全中,说明这条五段链不是一个「事后编出来的故事」,而是能在跑之前就能预测、跑之后能被数据对上的机制。
七、总结
7.1 本篇的三条结论
7.2 一句话判断
消费级显卡跑 125B MoE,难的不是让它算得动------它算得动,功耗只用掉六成;难的是让热专家待在显存里。 而这件事的上限,被一条简单的式子锁死:
(可用显存 − 884 MiB) / 1.318 MiB,最多 24,576 个槽。
7.3 下一篇讲什么
第二篇拿着这套机制去做对照实验:同一台机器、同一份模型、同一套参数,只把显卡上别人的 18 GB 占用停掉,然后用两轮完整基准 + 2,890 条逐请求遥测,把五段传导链逐段量化,给出「每 GiB 显存值多少 tok/s」「多少 PCIe 溢出会掉多少速度」这种可以直接拿去做容量规划的数字。
附录:本篇引用的原始证据
A.1 两轮引擎分配对比
| 项 | 第一轮(共享) | 第二轮(独占) |
|---|---|---|
| GPU1 其他占用 | 18,106 MiB | 0 |
| 启动时空闲 VRAM | 8.31 GiB | 26.01 GiB |
| 专家缓存槽位 | 5,784 | 19,530 |
| 专家缓存大小 | 7,625 MiB | 25,747 MiB |
| 引擎总显存 | 13,670 MiB | 31,674 MiB |
| 固定开销 | 6,045 MiB | 5,927 MiB |
| 加载后剩余 VRAM | 410 MiB | 410 MiB |
| 主机 arena | 31.64 GiB | 31.64 GiB |
| 系统内存占用 | 104.97 GiB | 96.31 GiB |
A.2 模型文件校验(可直接复核)
| 文件 | 字节数 | SHA-256 |
|---|---|---|
| shard1 | 37,623,740,192 | 69820c02ec7d0b45ef2ebb19d6620299db749fe2aded7f39f93c6b88b199b720 |
| shard2 | 28,800,138,432 | 316b46f3a2dbd68c900f43136ab9449f9dcc3725dfd8c794847c204bc161e113 |
A.3 引擎启动日志关键行(原文摘录)
下面每一行都取自 docker.engine.log 原文。同一个字段在不同次启动中会有小幅浮动(比如 arena 装载速率实测在 0.94 -- 2.58 GiB/s 之间,MTP 草稿层占用在 820 -- 839 MiB 之间),这是页缓存与内存压力的正常差异,不影响上面的公式。
text
strata generate: memory guard: limit 125.6 GiB (source: meminfo), current 30.6 GiB,
                 reclaimable cache credited 0.0 GiB; available 94.9 GiB (MemAvailable 94.9 GiB), floor 2560 MiB
strata generate: 301 native projection matrices, 1376.20 MiB of weights, in 1.8 s
strata generate: PLE table locked in RAM (--ple-io ram) in 3.8 s
strata generate: profile /opt/strata/terminal/data/expert-profile.bin: 24576 ranked pairs, built for 24576 slots
strata mtp: draft layer loaded, 839 MiB of VRAM (experts 675, dense 111), files read in 0.54 s (1442 MiB/s)
strata mtp: draft head over 106299 tokens (178.4 MiB)
strata generate: PCIe probe: 13.9 GB/s host->device (best of 13.8 13.8 13.9 13.9) -> pcie_frac 0.38 (default 0.55)
strata generate: this CPU has no AVX-512: the expert kernels run on AVX-2 (multi-token for the i-quant gate/up rows)
strata generate: expert arena: MAP_HUGETLB unavailable (needed 16201 2 MiB pages, vm.nr_hugepages=0)
strata generate: loaded 31.64 GiB at 0.99 GiB/s
strata generate: expert cache auto: 26.01 GiB free, 700 MiB reserved (+184 MiB for the draft head) -> 19530 slots
strata generate: expert cache 19530 slots, 25.14 GiB of VRAM
strata generate: pre-filled 19530 of 19530 slots from the profile in 2.1 s (12936 MB/s); slot 0 verified
strata serve: prompt chunk auto: 8192 tokens, a 384-slot ring
strata verify: window up to 6 tokens, 55.0 MiB of device buffers
strata serve: 410 MiB of VRAM free with everything loaded
A.4 本篇的测量限制
- 只测了 Q2_0 一档,不能跨量化档外推;IQ3_XXS / IQ3_S 的 arena 更大,槽位公式相同但覆盖率起点不同。
- KV 的 384 MiB 与「激活/CUDA 上下文」的 3,100 MiB 为结构推算,非直接测量,误差约 ±300 MiB。
- 固定开销恒定的结论来自多个数据点(13 次启动中,缓存 4,043 / 5,784 / 17,279 / 18,240 / 19,530 槽均有样本),固定开销始终在 5.9--6.0 GiB 区间,但该结论未在 48 GB 卡上验证。
- PCIe 固定为 Gen3 ×16(实测 13.9 GB/s),换平台会移动第五段「断崖」的位置,但定性结论不变。
- 单卡、单模型、单网络环境;同机另一张 4090 全程被 vLLM 占据,未参与任何测量,但可能对 PCIe/内存带宽有轻微干扰。
邦友们,第一篇到这里就把「为什么」讲完了:显存不够时,Strata 不是把模型变瘦,而是把「装不下」重新定义成「缓存哪些」。
下一篇是这套系列里数字最多的一篇------我会把显卡上那 18 GB 的占用停掉,用同一套配置重跑,然后拿 2,890 条遥测告诉你:这 18 GB 到底值多少 tok/s,又卡在哪个小数点上。
如果本文对你有所帮助,欢迎点赞、收藏、转发,也欢迎关注 「全栈架构师笔记」。下一次,我们继续一起把这些新东西跑明白、测明白,也讲明白。