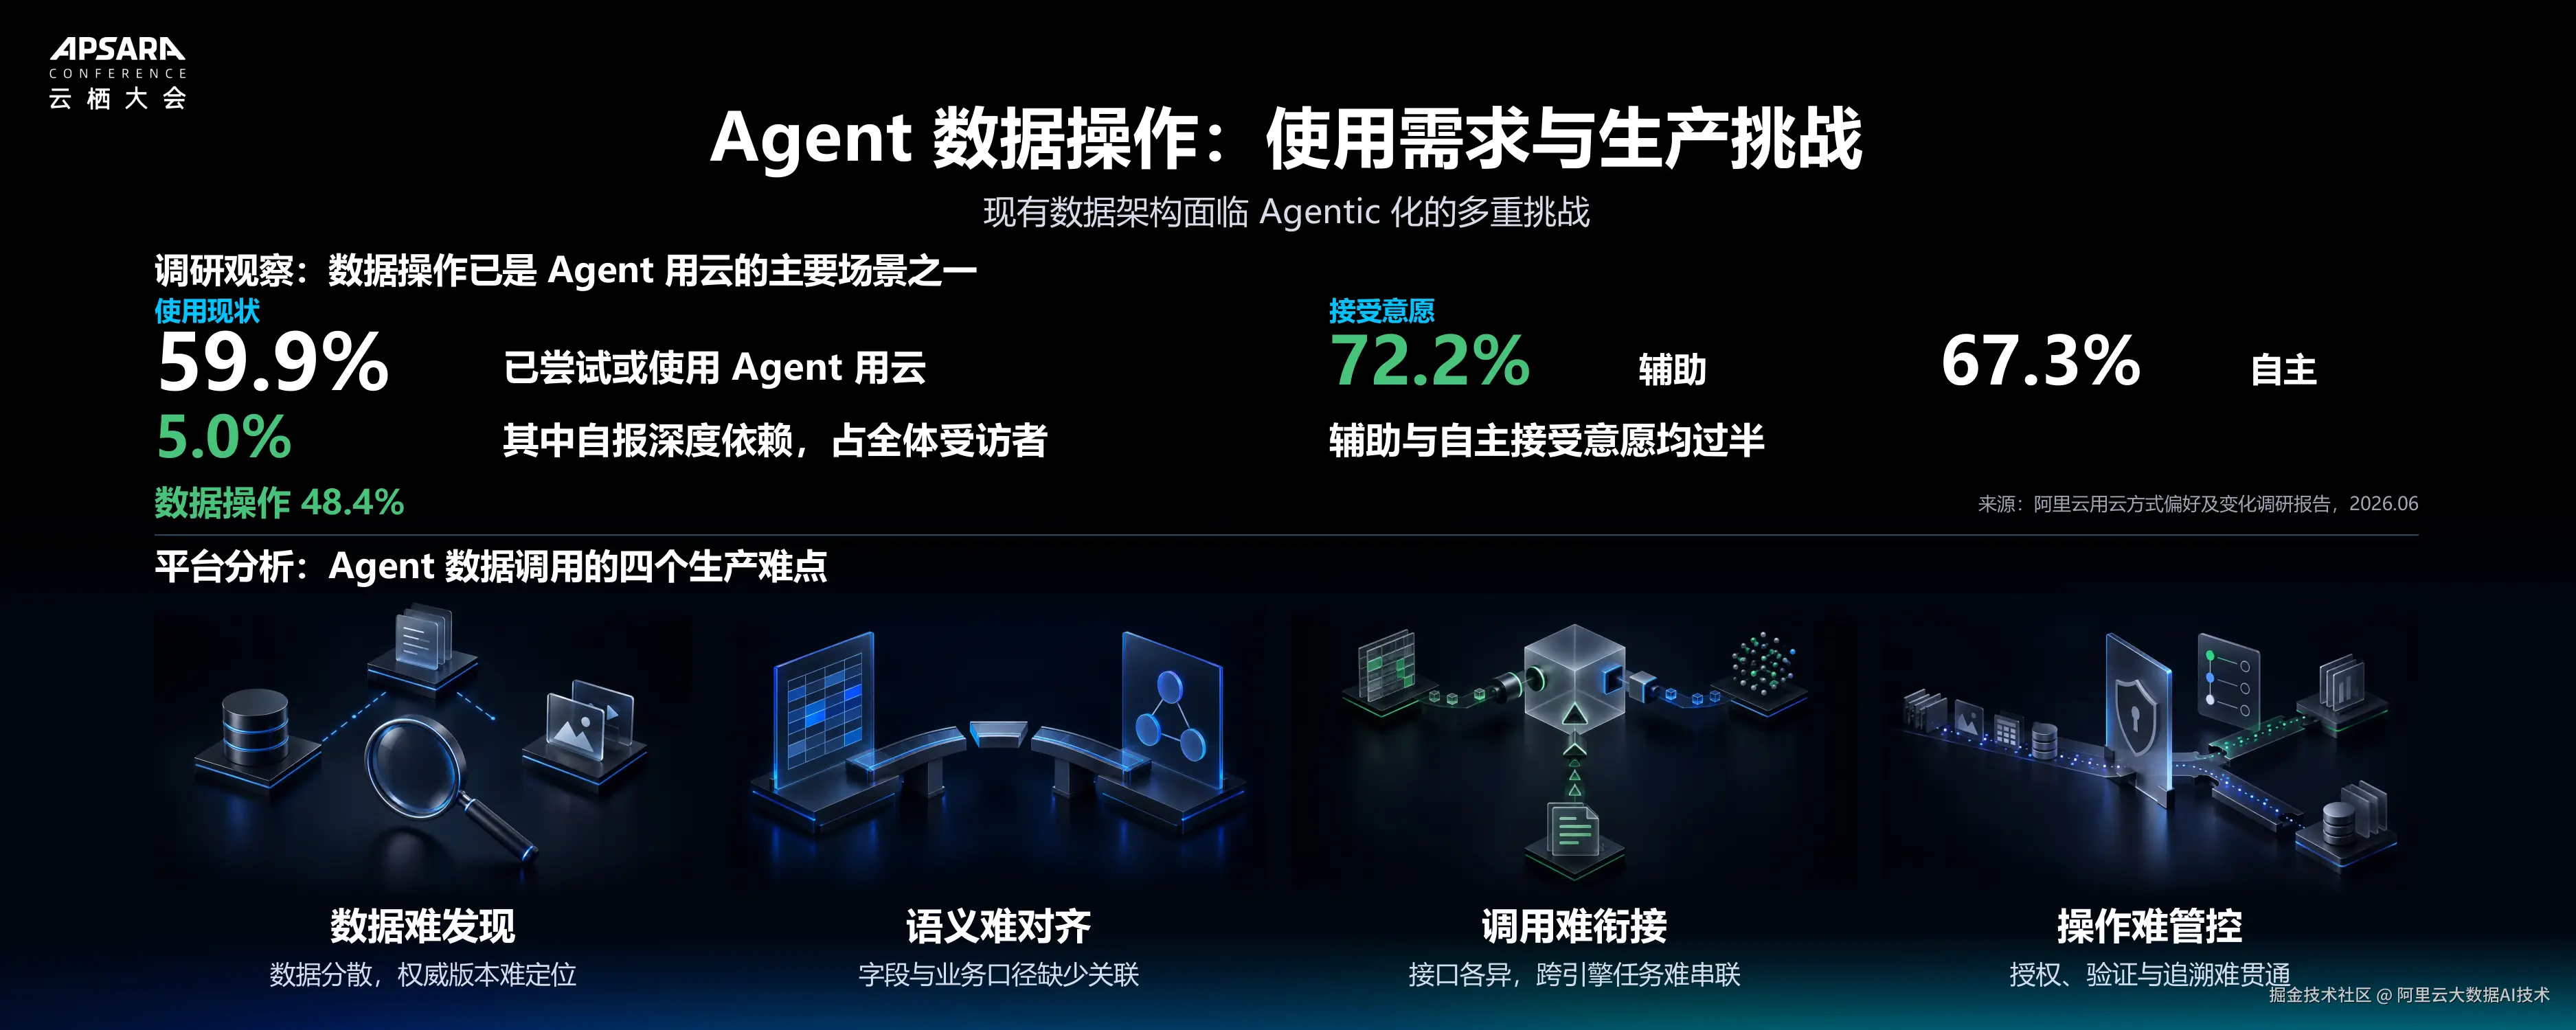
过去一年,几乎每个团队都做过 Agent 的 Demo,演示里,它能听懂需求、找到数据、跑出结果;可一旦放进企业真实的数据、系统与权限环境中,同样的任务就开始处处受阻:数据散落在不同系统里,找不到那个权威版本;字段和业务口径对不上,Agent 只能猜;各引擎接口不一,跨系统的任务串不起来;授权、验证与追溯无法贯通,谁用了什么数据说不清。
今年,阿里云 OpenLake 进一步向 Agentic Lake 演进。作为统一数据底座,DLF 持续增强全模态数据管理、湖上检索、开放访问和托管优化能力,协同计算引擎与 DataWorks,支撑 BI、Agent 应用与模型训练共享可信的数据资产。
Agent 数据操作的需求与生产挑战
我们的第一个观察来自用户的实际使用情况。根据《阿里云用云方式偏好及变化调研报告》(2026 年 6 月),59.9% 的受访者已经尝试或使用 Agent 用云,数据操作这一场景的占比为 48.4%。这说明,使用 Agent 操作数据已经是一个重要的应用方向。
但另一项数字值得关注:自报深度依赖 Agent 的用户,占全体受访者的比例只有 5.0%。Agent 的使用已经开始普及,调研显示,尝试使用与深度依赖之间仍存在明显差距。如何让 Agent 稳定接入真实数据与业务流程,是下一阶段需要解决的问题。很多能力在介绍或演示中看起来很精彩,实际落地时却仍会遇到阻碍。
这些阻碍主要集中在四个方面。首先是数据难发现:数据分散在不同系统中,难以定位权威版本。其次是语义难对齐:字段与业务口径之间缺少清晰关联。第三是调用难衔接:不同系统的接口各异,跨引擎的任务难以串联。第四是操作难管控:授权、验证和追溯难以贯通。
因此,我们的判断是,Agent 应用已经成为现实,但从尝试使用走向规模化生产应用,还需要解决数据架构和平台能力上的一系列问题。
Lakehouse 从 BI 分析走向 AI 应用
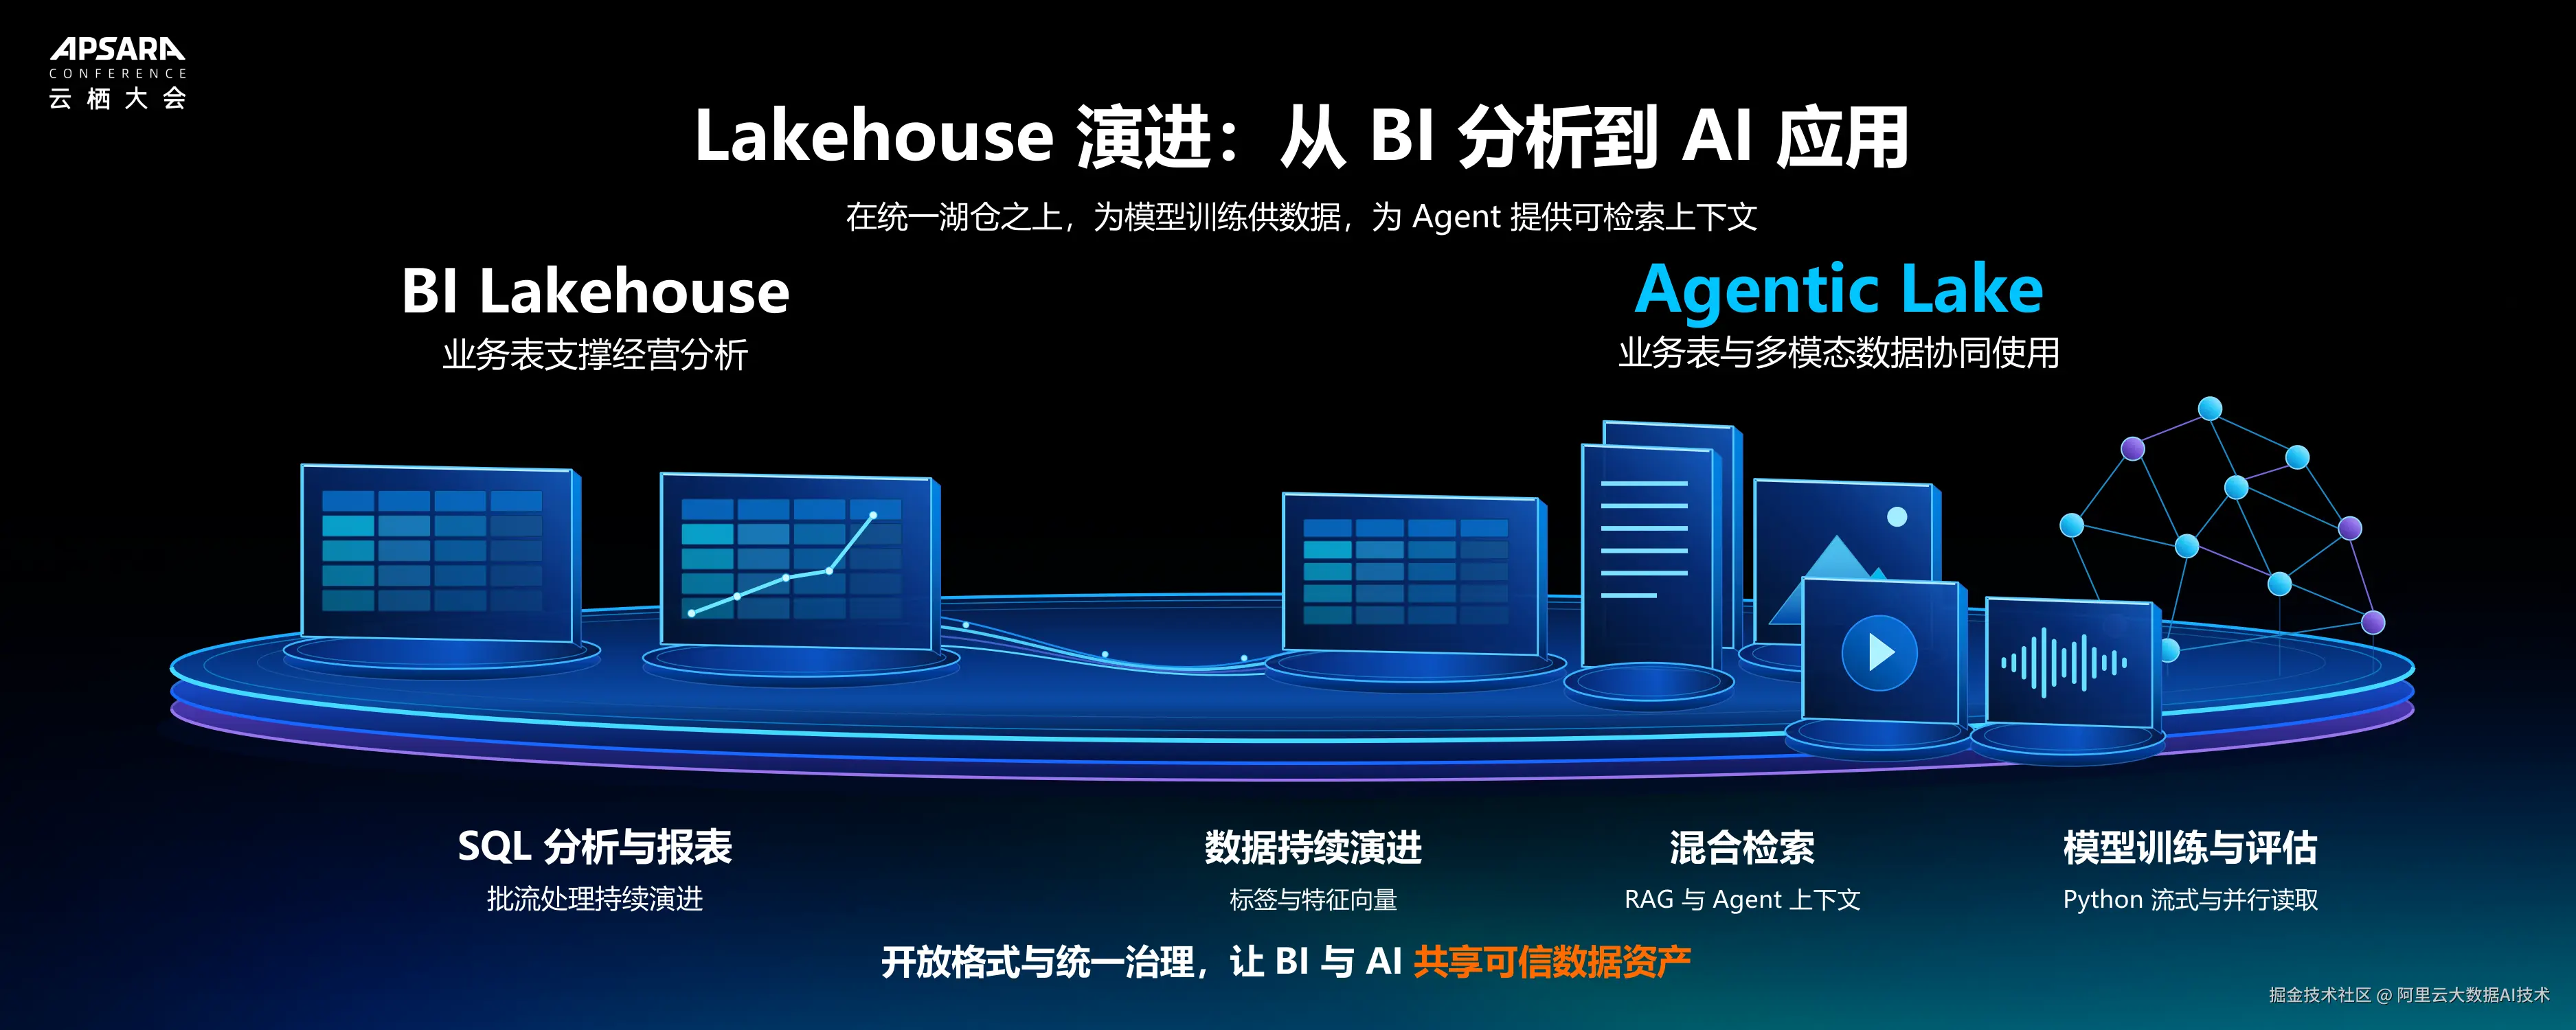
第二个观察来自产品和技术的发展。过去,Lakehouse 主要面向 BI 场景:把数据汇聚起来,为不同业务提供分析能力。在这一过程中,我们也持续提升数据处理的时效性,将数据新鲜度从 T+1 的天级,逐步推进到分钟级、秒级,甚至亚秒级。让 Lakehouse 演进为 Streaming Lakehouse,是此前两年阿里云持续投入的方向。
到了上一年,我们开始强调,面向 BI 的这一阶段演进已经取得了阶段性进展,下一步需要重点考虑如何服务 Agent。我们希望 Agent 能够在 Lakehouse 上运行,将所需的数据汇聚起来,并把总结、整理后的上下文信息,也就是 Context,沉淀到湖上。
在此基础上,无论是湖上数据的检索和分析,还是进一步面向 Agent 和模型开展强化训练,都可以围绕同一个平台展开。业务表与多模态数据能够协同使用,标签、特征向量和混合检索也可以成为这一体系的一部分,为 RAG、Agent 上下文以及模型训练和评估提供数据。
我们希望 BI 与 AI 使用同一份可信的数据资产,持续迭代和演进。从这一趋势出发,我们认为 Lakehouse 已经进入 Agentic Lake 阶段,需要在技术和产品上,为 Agent 做更多准备。
OpenLake Agentic Lake:让数据流与工作流协同
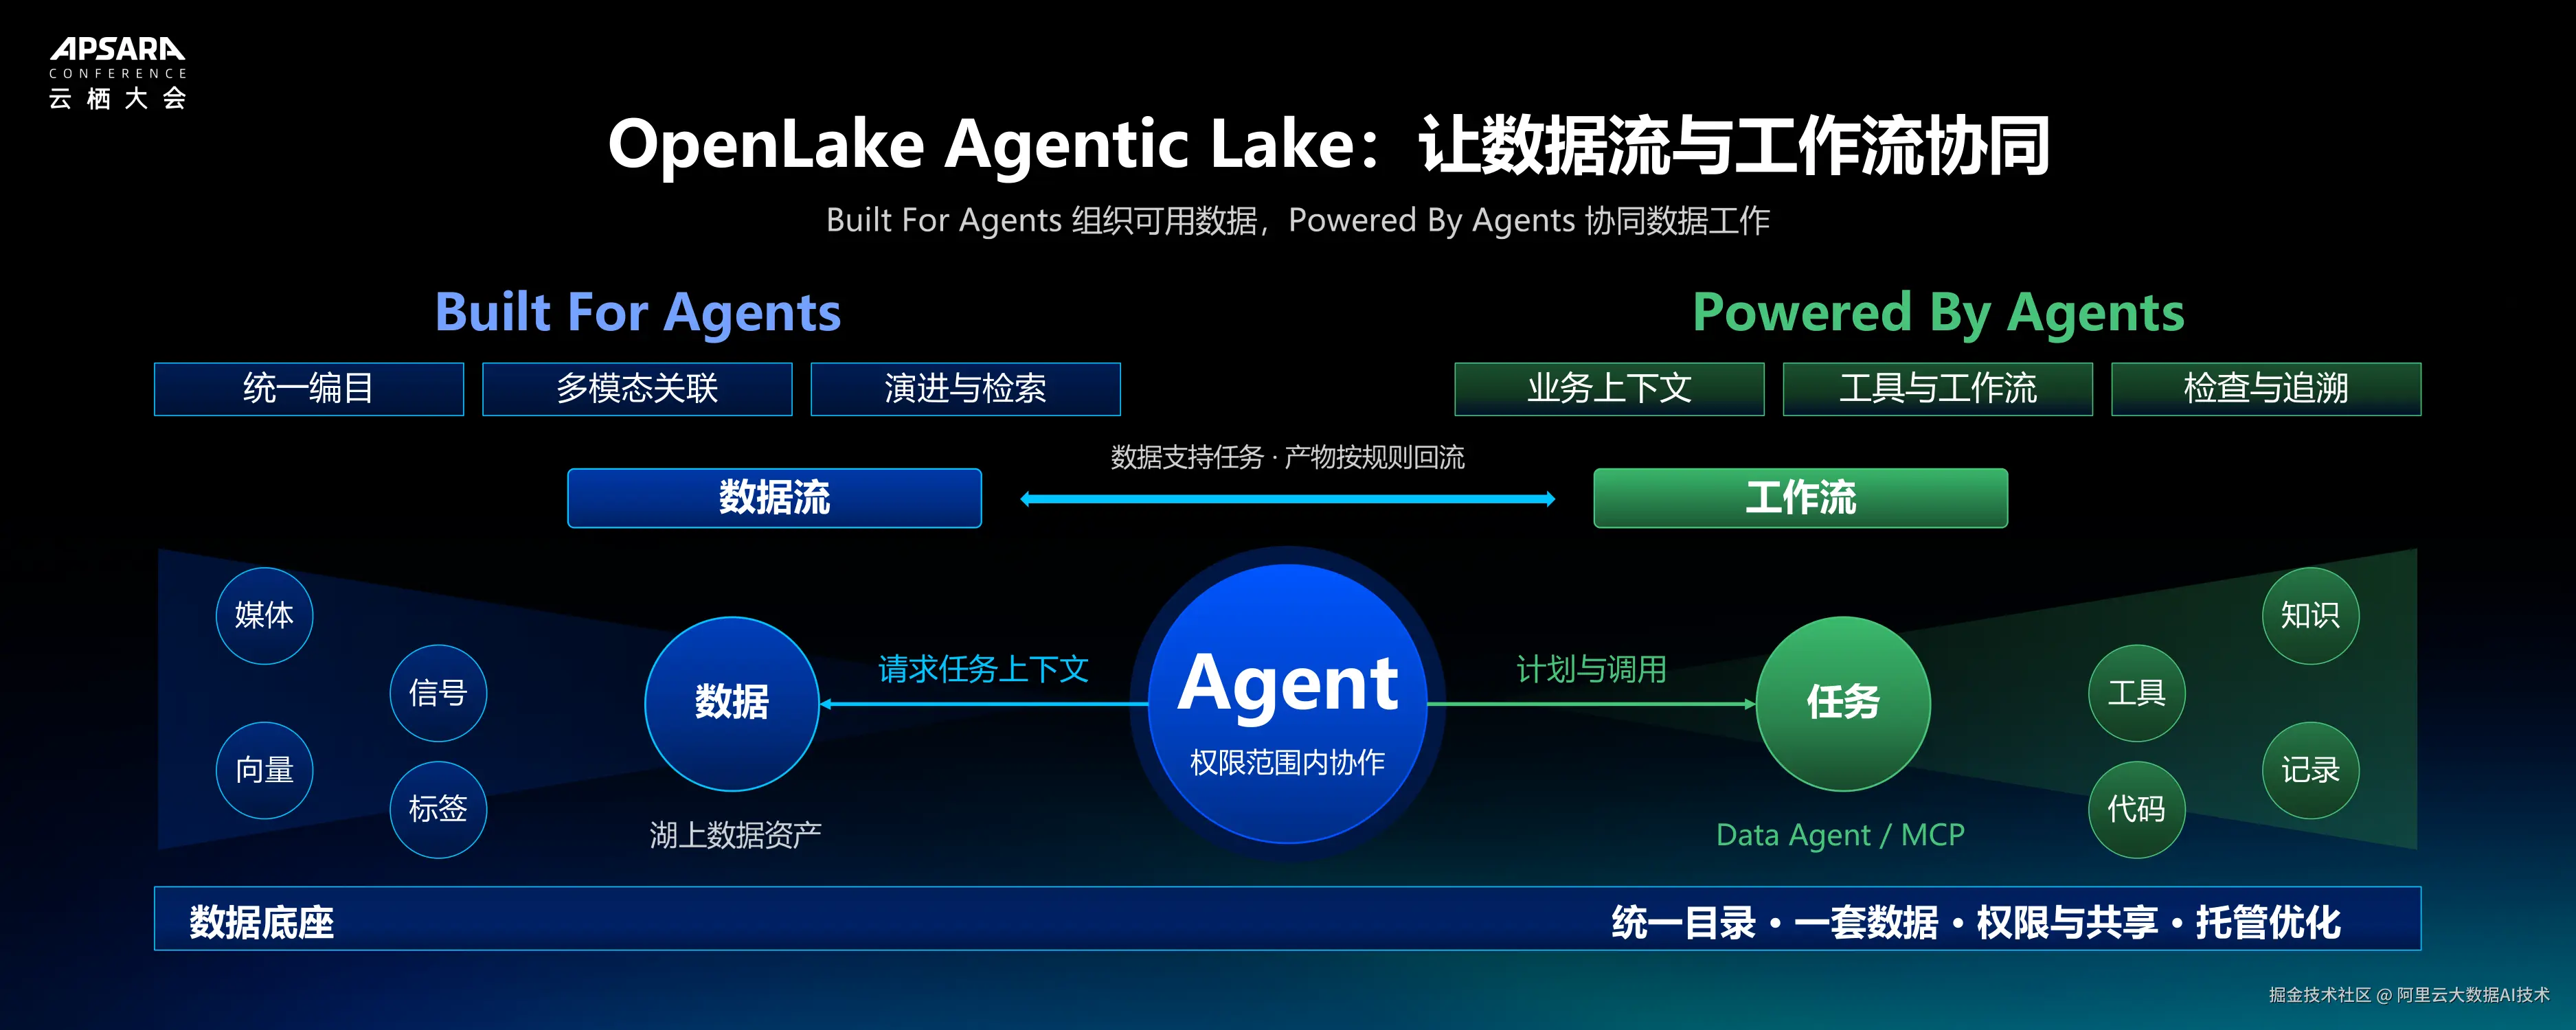
基于这些观察,我们希望在 OpenLake 的基础上继续演进。理解这一方案,可以从 Agent 的两侧入手:一侧是数据,另一侧是任务。
很多关于 Agent 的讨论集中在应用层,底层的数据基础设施往往被提及得较少。但 Agent 要高效、精准地运行,离不开数据,也离不开完整的上下文信息。这些数据既包括结构化数据,也包括半结构化和非结构化数据,还包括媒体、信号、标签、向量等不同形态的信息。因此,数据是第一个关键词。
另一个关键词是任务。Agent 要高效执行任务,需要可编排的工作流。具体实现可以采用 Agentic Workflow,也可以采用定制方式,或由人参与其中。无论采用哪种方式,都需要将 Agent 使用的工具、信息以及执行过程中生成的代码衔接起来。这些代码也可能由 Agent 自身生成,例如 Python 代码。
我们希望,通过湖平台的升级,Agent 一方面能够更好地调用企业级数据,让企业已有的数据资产真正被使用起来;另一方面,能够通过更完善的工作流,顺畅、高效地运行。数据流与工作流在权限范围内协同,才能进一步支撑企业级 Agent 的规模化生产落地。这也是 Built For Agents、Powered By Agents 所表达的方向。
阿里云OpenLake统一数据底座与多引擎协同
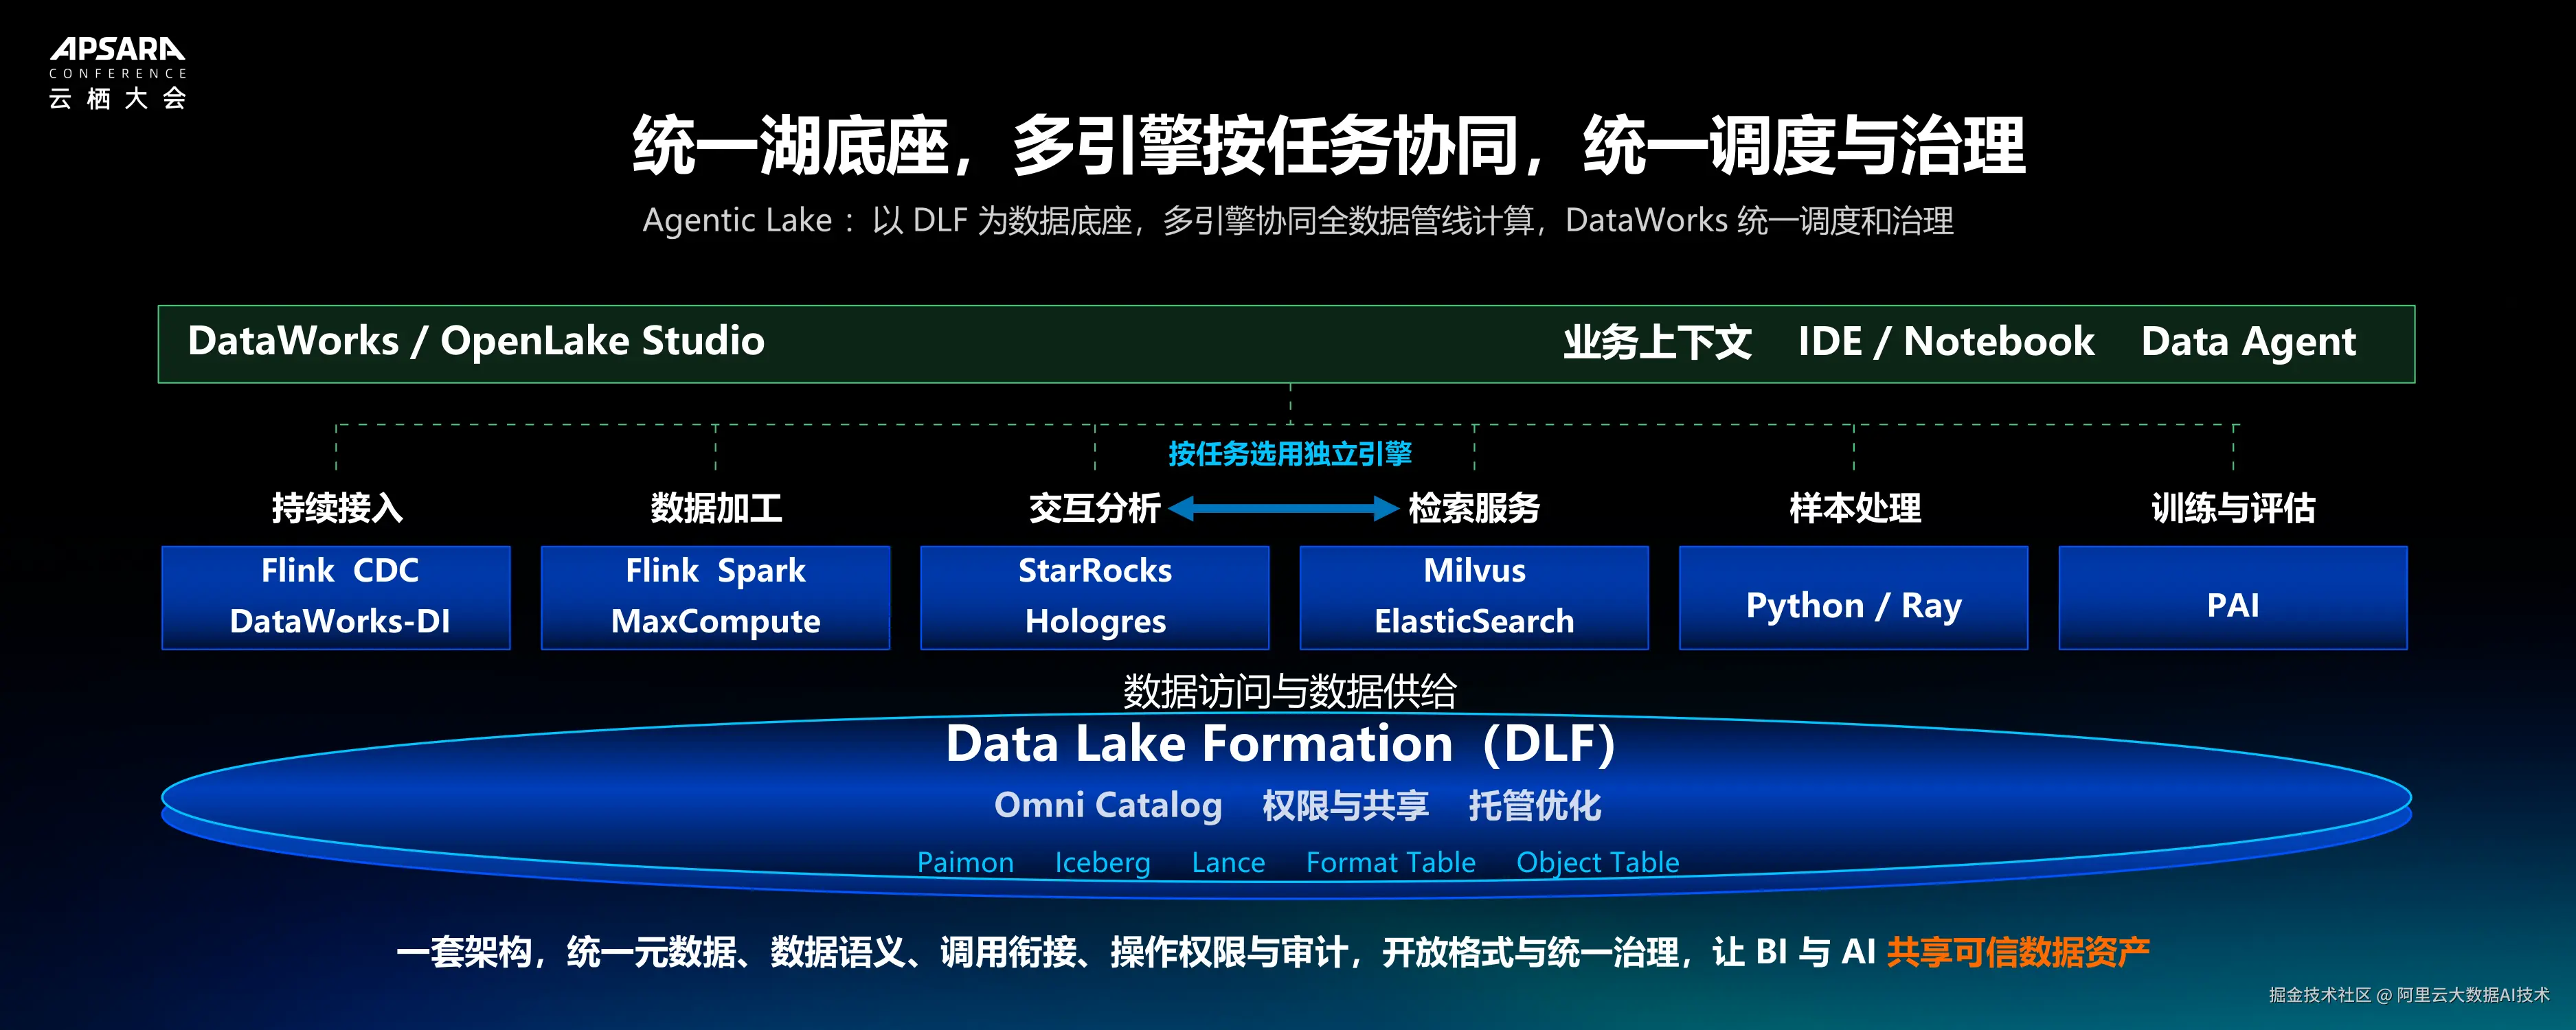
具体到方案,我们希望企业面向 BI 和 AI 的数据资产,能够由同一个平台管理。第一层是统一的全模态数据底座,用一套底座沉淀企业的数据资产,为 Agent 的规模化生产应用提供基础。
第二层是计算与处理。Agent 运行过程中涉及的数据加工流程,应当能够根据任务需要,灵活选择不同的计算引擎协同完成。例如,实时数据摄取、实时处理,以及适合实时链路的 Embedding 和索引构建,可以选择 Flink;偏离线的批计算任务,可以选择 Spark;检索和分析任务可以选择相应的检索分析引擎;AI 训练任务则可以选择 PAI。
这些引擎需要与底层平台做好产品化衔接,使整套系统能够以可规模化的方式运行。在图中的架构里,持续接入、数据加工、交互分析、检索服务、样本处理、训练与评估等任务,各自选用适合的引擎,共同访问 DLF 数据底座。
最上层则需要统一的管理与治理平台,管理元数据、血缘、数据地图等信息,同时提供更自然的交互方式。通过 DataWorks、OpenLake Studio 和 Data Agent,用户可以用自然语言让 Agent 辅助搭建 Data Pipeline,也可以执行检索、分析等操作。
因此,整个方案由统一的全模态湖底座、多引擎按任务协同,以及统一调度和治理共同构成。它希望在一套架构中衔接元数据、数据语义、调用、权限和审计,让 BI 与 AI 共享可信的数据资产。
阿里云DLF 作为全模态 AI 数据底座
在 Agent 时代,要让应用规模化进入生产,一个重要前提是拥有统一的数据底座。过去构建数据系统时,企业常常将不同类型的数据放在不同系统里:业务数据在业务库,向量在向量库,非结构化数据又由另一套系统管理。当 Agent 需要统一使用这些数据时,就会遇到大量衔接问题。
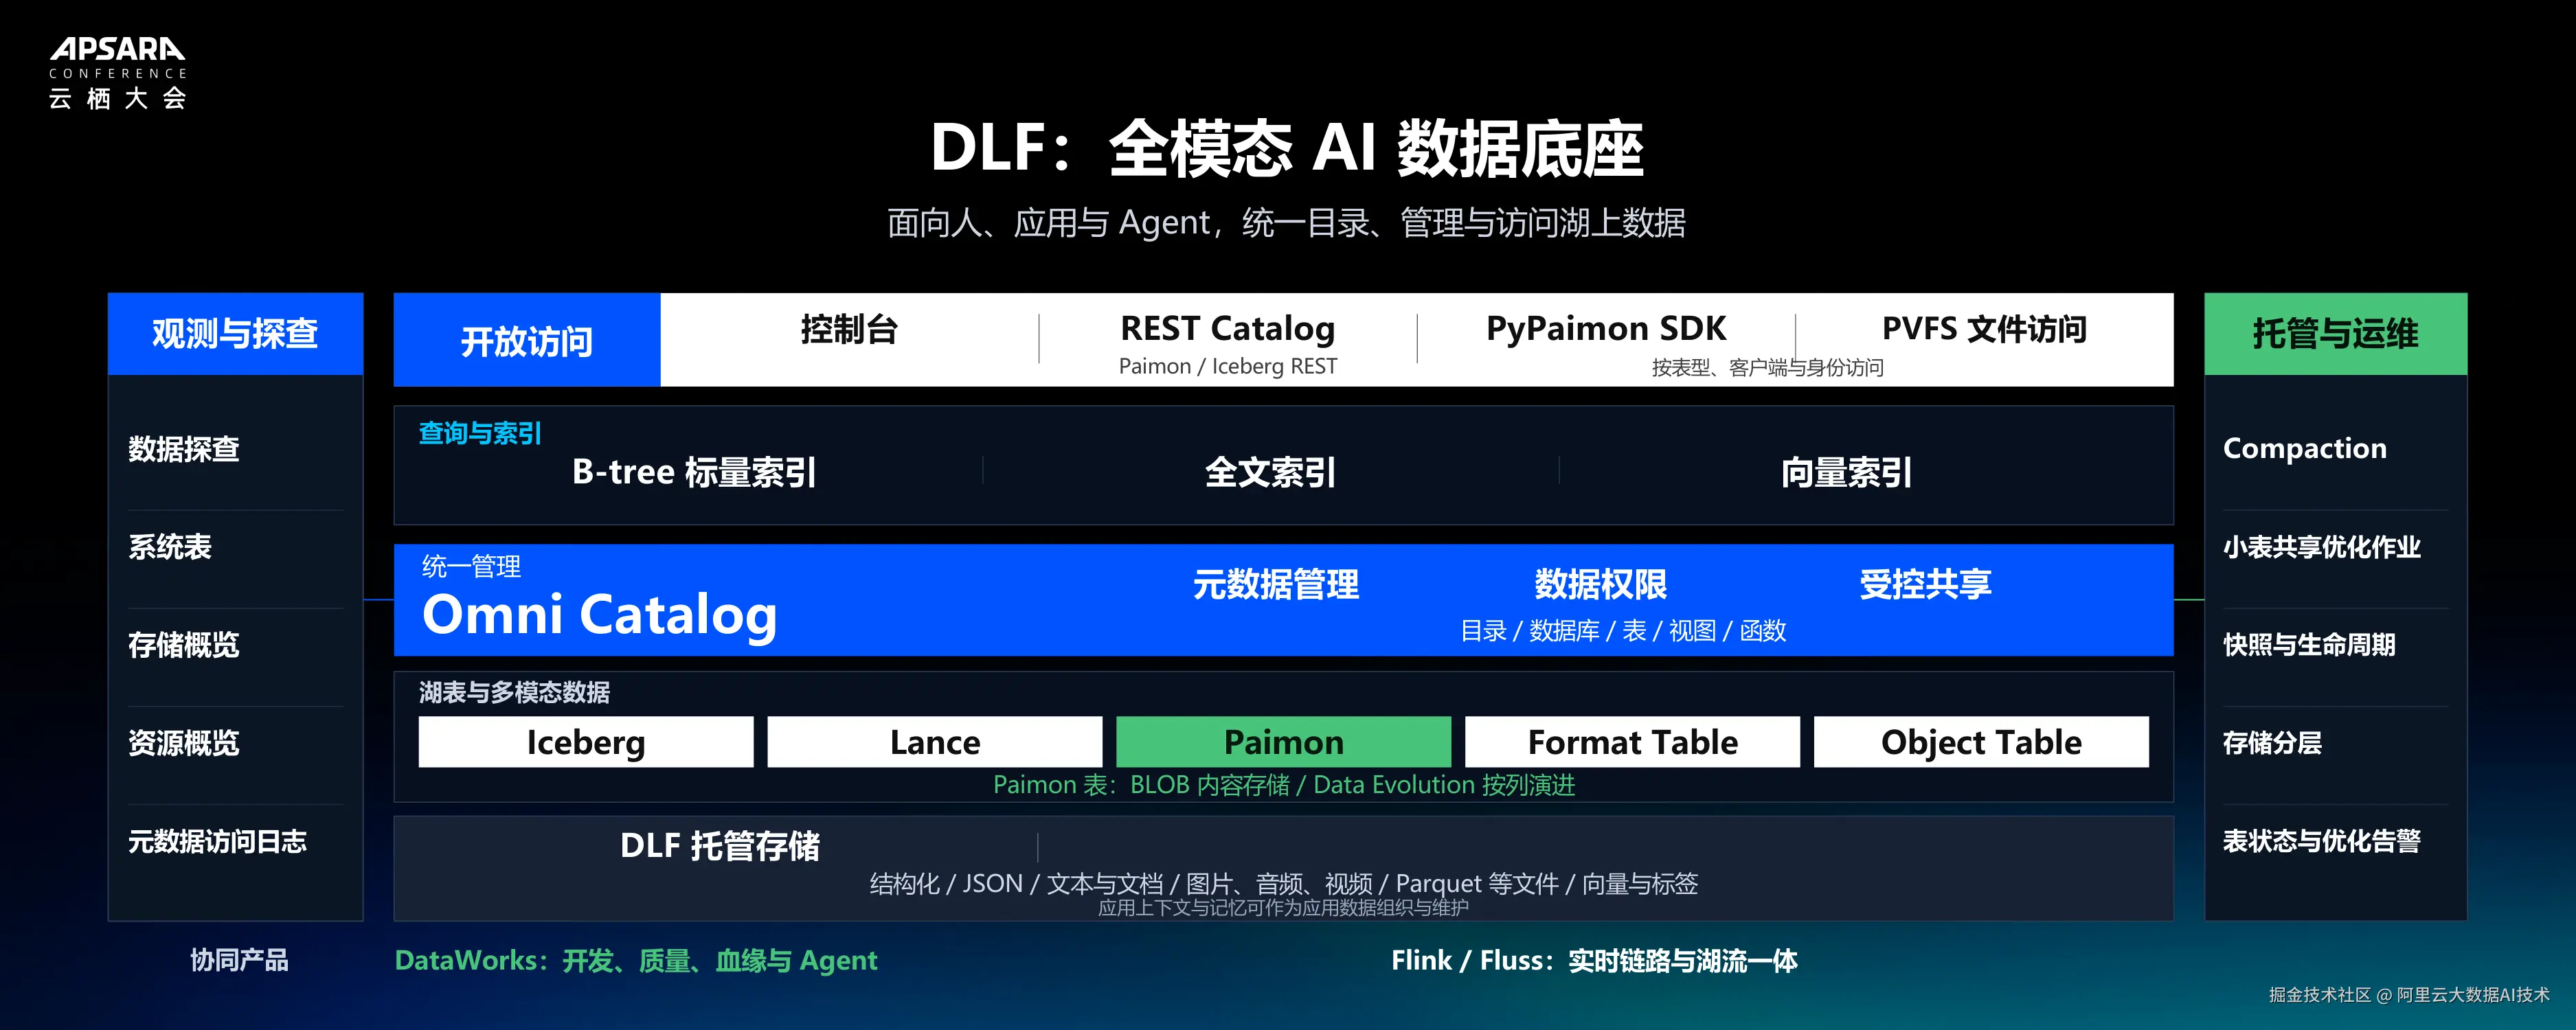
在阿里云的 Agentic Lake 方案中,我们希望通过 DLF,也就是 Data Lake Formation,提供统一的全模态底座。标量、向量、结构化和非结构化数据可以围绕同一张逻辑湖表组织,供 Agent 统一使用和调度。这里强调的是逻辑上的关联和统一管理,原始媒体与业务字段可以采用不同的物理存储方式。
在湖表和元数据层,Omni Catalog 提供统一目录,平台支持 Paimon、Iceberg、Lance、Format Table 和 Object Table 等不同表型。阿里云也持续参与和推动 Apache Paimon 的发展,尤其重视其实时能力,以及面向全模态数据的管理和处理能力。
数据进入湖之后,还需要能够被有效利用。因此,平台提供湖上索引,包括 B-tree 标量索引、全文索引和向量索引。演讲中提到的向量索引路线包括 IVF 和 DiskANN,其目的都是让湖上的数据和上下文更容易被检索、发现和使用。
在访问层,我们非常强调开放性。Agent 时代存在大量协同工作,开放的平台才能让更多 Agent 和不同场景调用数据、使用资产。与此同时,作为企业级平台,DLF 也需要提供数据探查、运行观测、托管运维、快照和生命周期管理等能力,支撑底座高效、稳定地运行。
DLF通过开放生态连接引擎与 AI 工具
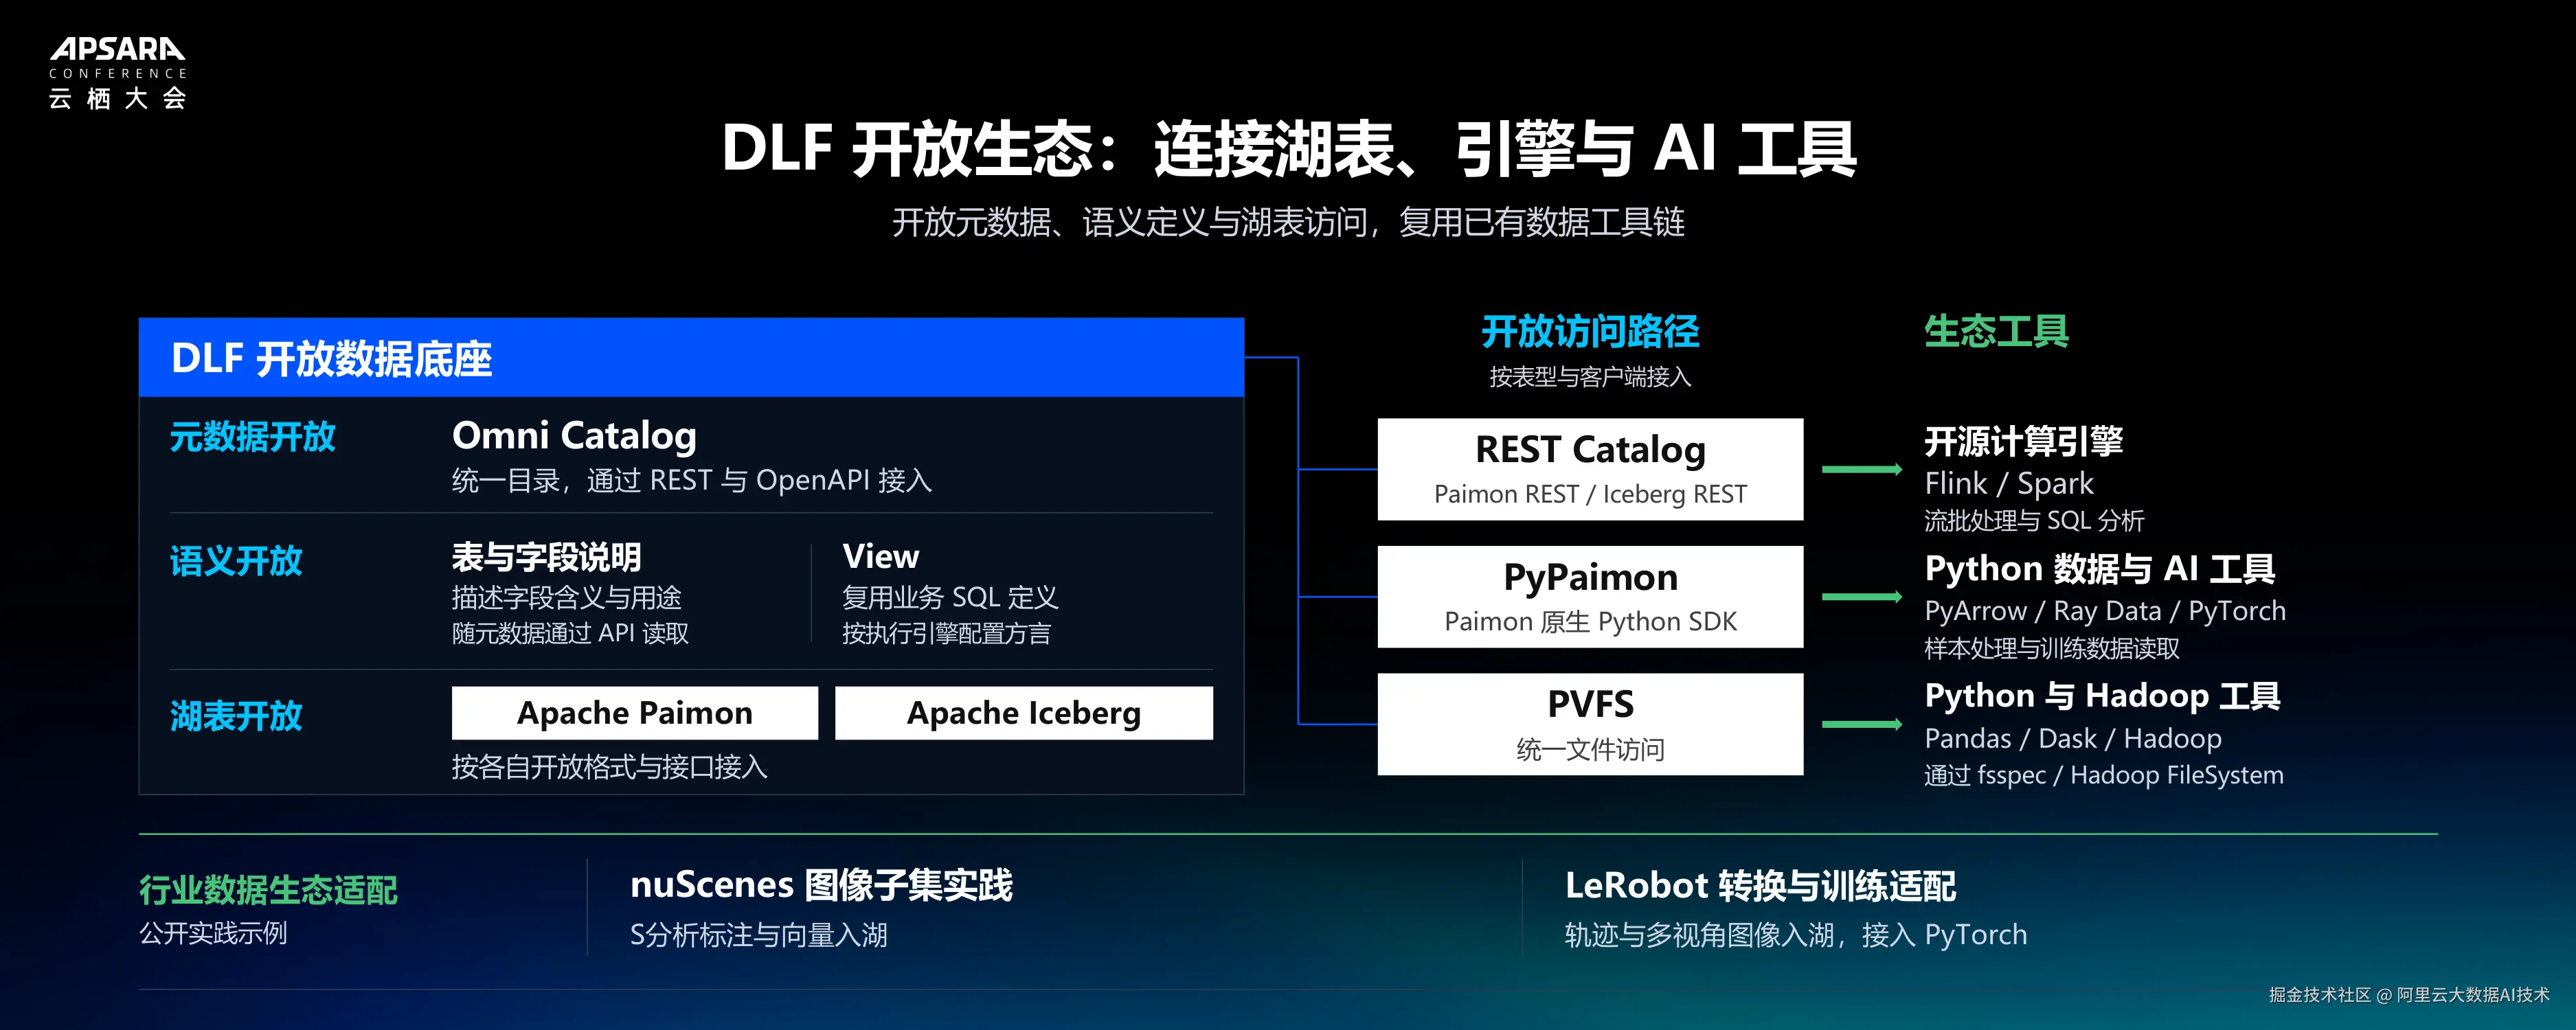
过去一年,我们越来越明确地认同一个方向:平台接口必须开放,才能被不同的 Agent、Sandbox 和工具调用。开放能力应当体现在元数据、语义定义和湖表访问等多个层面,使用户能够复用已有的数据工具链。
在 DLF 中,Paimon 和 Iceberg 可以通过各自的 REST Catalog 等开放接口接入。Omni Catalog 统一组织元数据,表与字段说明帮助表达数据含义,View 则可以复用业务 SQL 定义。具体的访问方式,需要根据表型和客户端进行适配。
面向训练供数,我们可以通过 PyPaimon 等方式,让 Python 和 AI 工具更方便地使用湖上数据。图中还展示了 PyArrow、Ray Data、PyTorch 等工具链,以及通过 PVFS 对接的 Python 和 Hadoop 文件访问路径。这样,湖上的数据就能够进入样本处理、数据读取和训练流程。
在行业数据生态方面,我们也在对接具身等场景,例如 nuScenes 数据集的图像子集实践,以及 LeRobot 的转换与训练适配。通过这些连接,我们希望让训练更容易基于湖上数据开展,并逐步达到生产可用的要求。
DLF企业级数据控制面与数据使用边界
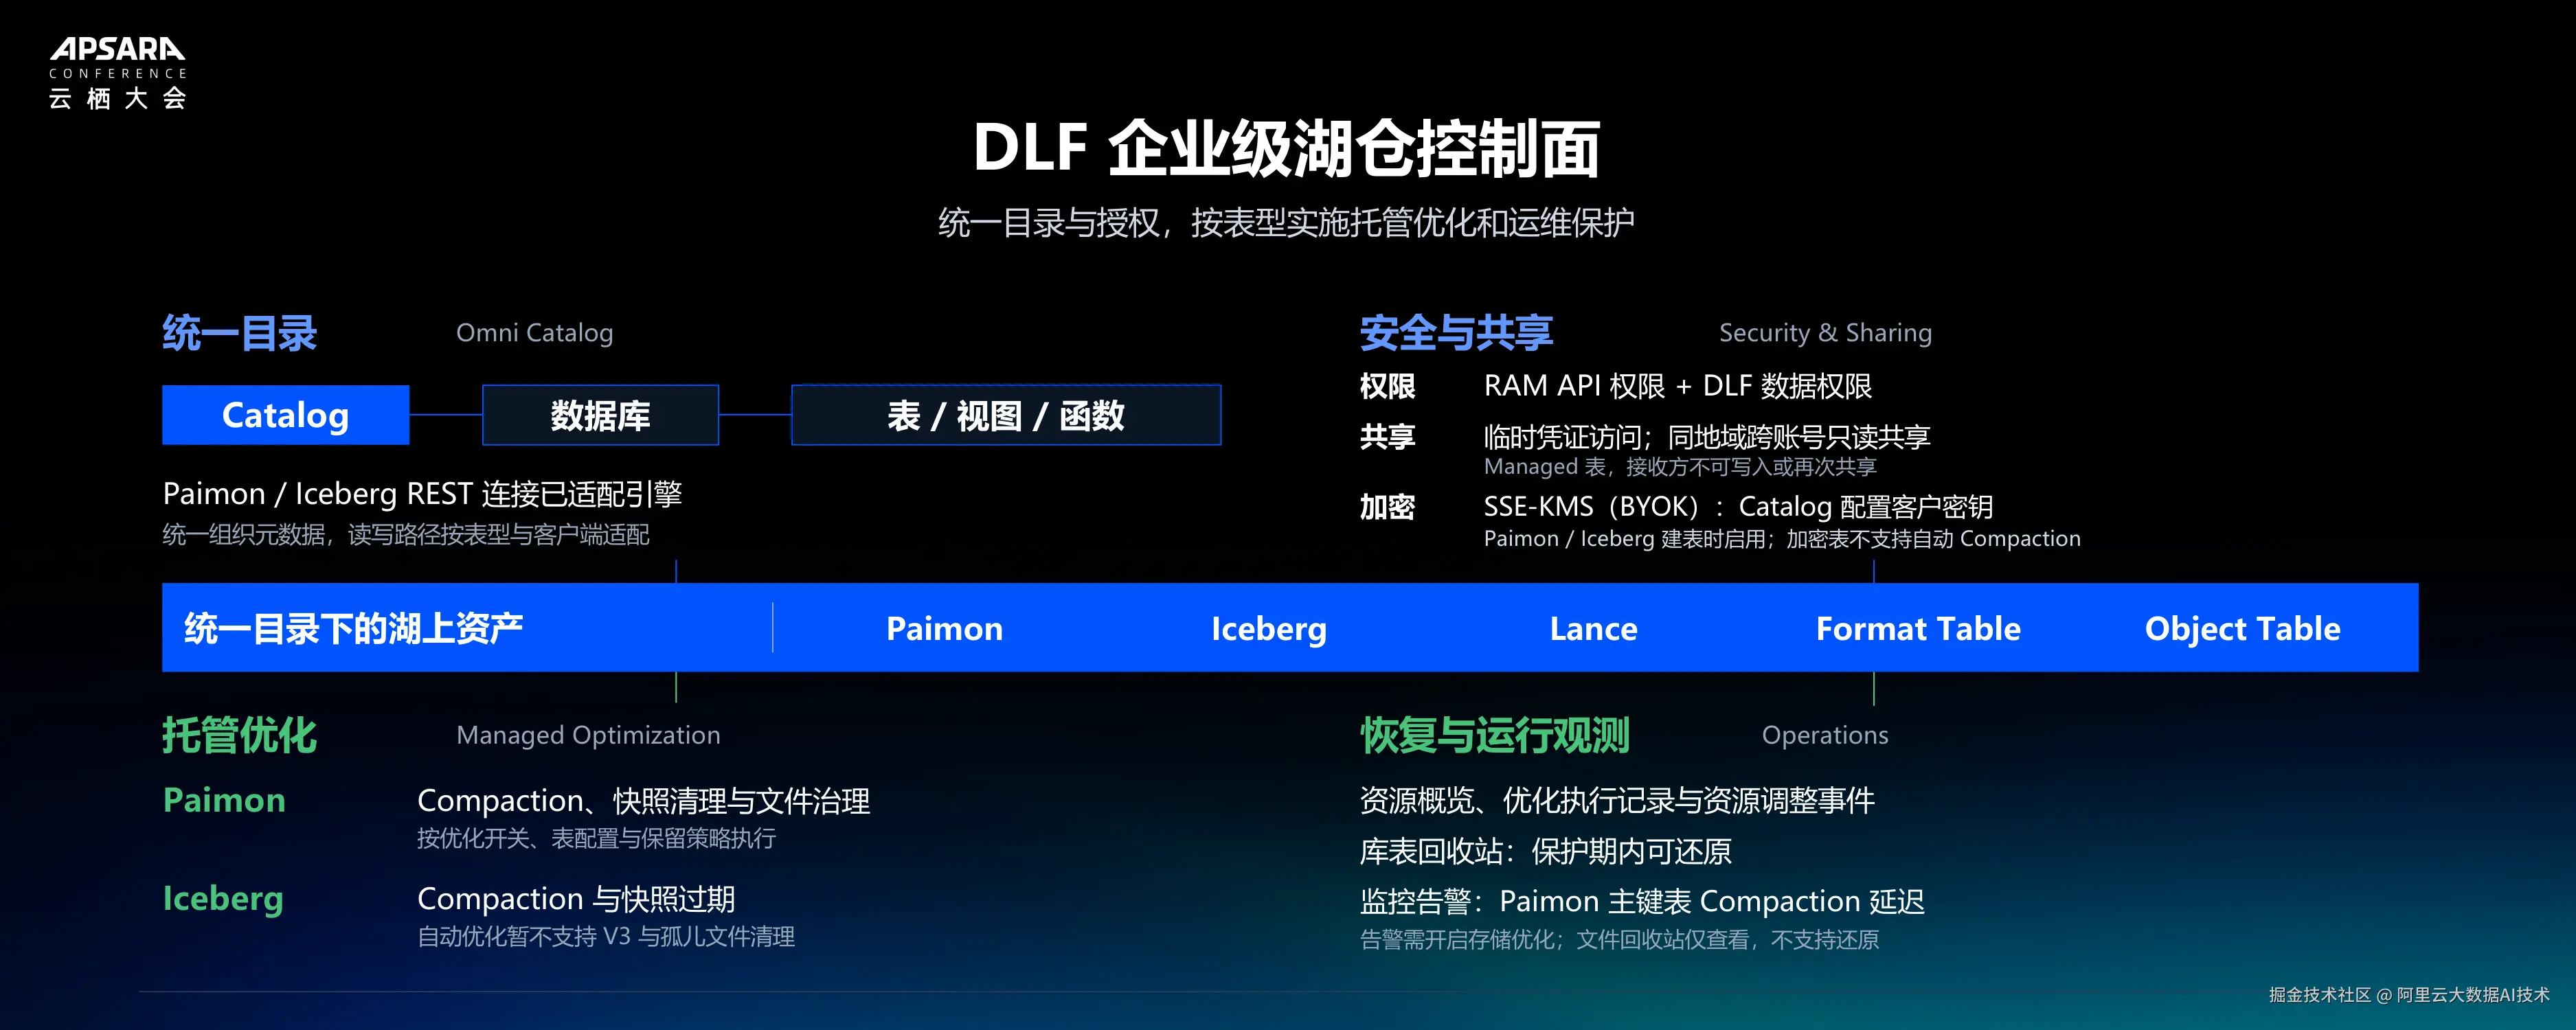
开放之外,企业级平台同样需要完善的控制面。Omni Catalog 提供统一目录,让数据更容易被发现和管理。不同类型的湖上资产在同一目录下组织,具体的读写路径则按表型和客户端适配。
权限控制需要足够精细。我们强调行列级的细粒度权限控制,因为企业内部会存在不同的 Agent,每个 Agent 都应当按需、在授权范围内使用数据,避免越权。PPT 展示的权限体系包括 RAM API 权限与 DLF 数据权限;具体到不同表型和访问路径,仍需以相应的权限支持范围为准。
在数据保护方面,平台提供 KMS 加密能力。PPT 中列明的是 SSE-KMS(BYOK),可在 Catalog 配置客户密钥,并在 Paimon、Iceberg 建表时启用。同时,这些能力存在具体边界,例如加密表不支持自动 Compaction;共享场景中,同地域跨账号只读共享的 Managed 表,接收方不可写入或再次共享。
在运维管理方面,我们对 Compaction 做了较多优化,希望通过文件合并减少小文件带来的影响,提升系统吞吐能力。结合快照清理、文件治理、资源观测和告警,平台可以持续维护湖表的运行状态。不同表型的托管优化能力也有区别,实际使用时需要结合表配置、优化开关和保留策略。
DLF Paimon:在同一逻辑湖表中关联媒体与特征
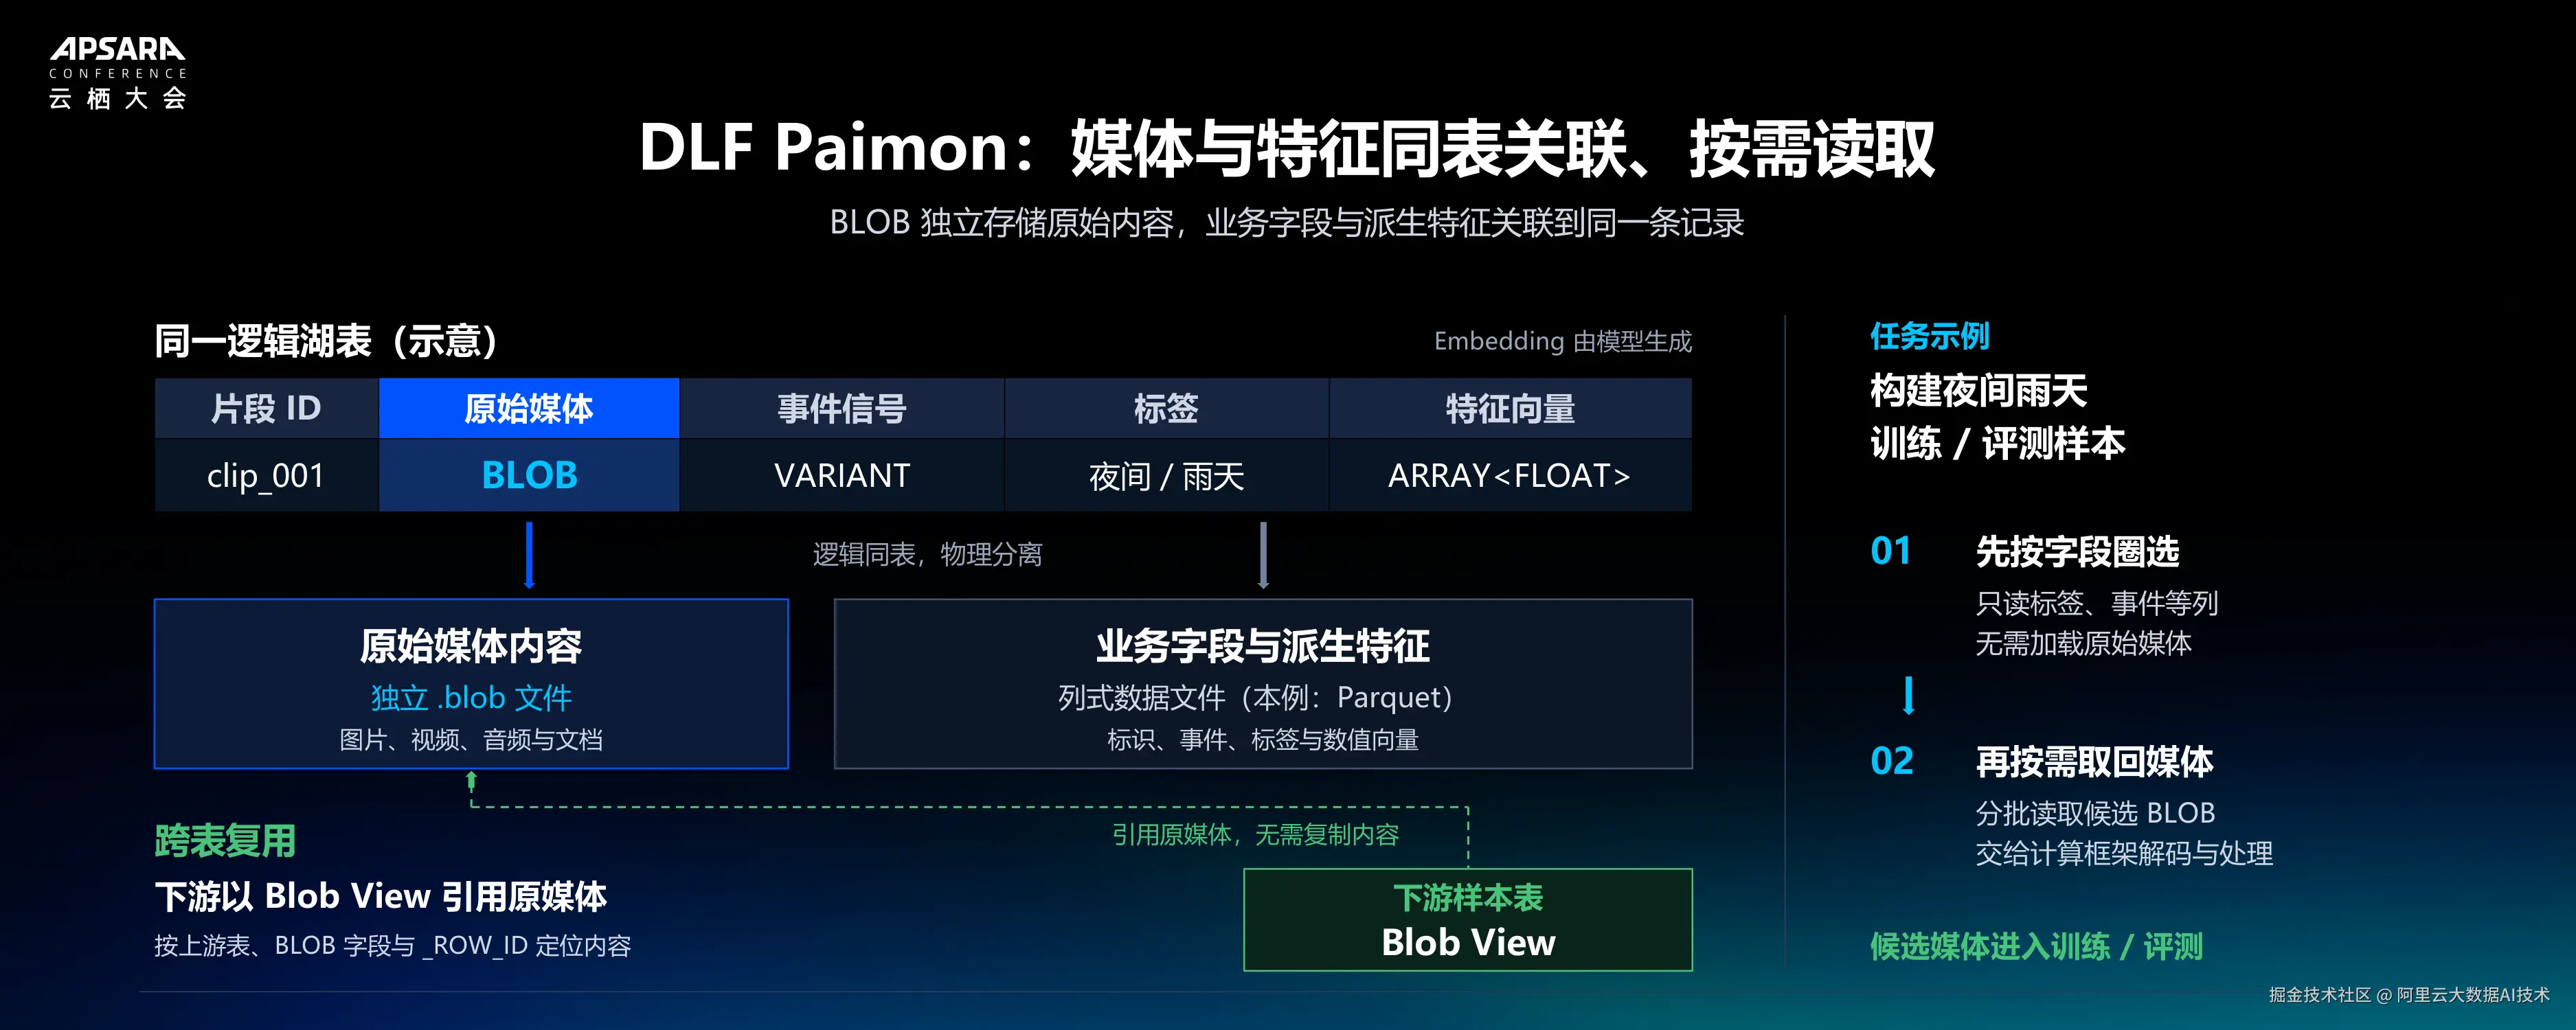
全模态数据管理的重要特征,是让不同类型的数据资产能够在同一张逻辑湖表中关联起来。在 DLF Paimon 表中,一条记录可以包含片段 ID、原始媒体、事件信号、标签以及特征向量。
例如,视频片段、图片等原始内容可以通过 BLOB 承载;描述性文本和标签可以放在相应的业务字段中;事件信号等 JSON 数据可以使用 VARIANT 表达;模型生成的 Embedding 则可以写入向量字段,示例为 ARRAY。演讲还提到,DLF 可以异步构建向量索引,便于后续在湖上管理索引和执行检索。
同表管理并不意味着所有内容都存放在同一个物理文件中。PPT 展示的是逻辑同表、物理分离:原始媒体保存在独立的 .blob 文件中,标识、事件、标签和数值向量等业务字段与派生特征保存在列式数据文件中。下游还可以通过 Blob View 引用原媒体,避免重复复制内容。
这样,在构建训练或评测样本时,可以先读取标签、事件等字段,圈选候选数据,不必一开始就加载原始媒体;随后再分批读取需要的 BLOB,交给计算框架解码和处理。媒体与特征保持关联,同时能够按任务需要读取。
DLF Cache 让热点湖数据靠近计算
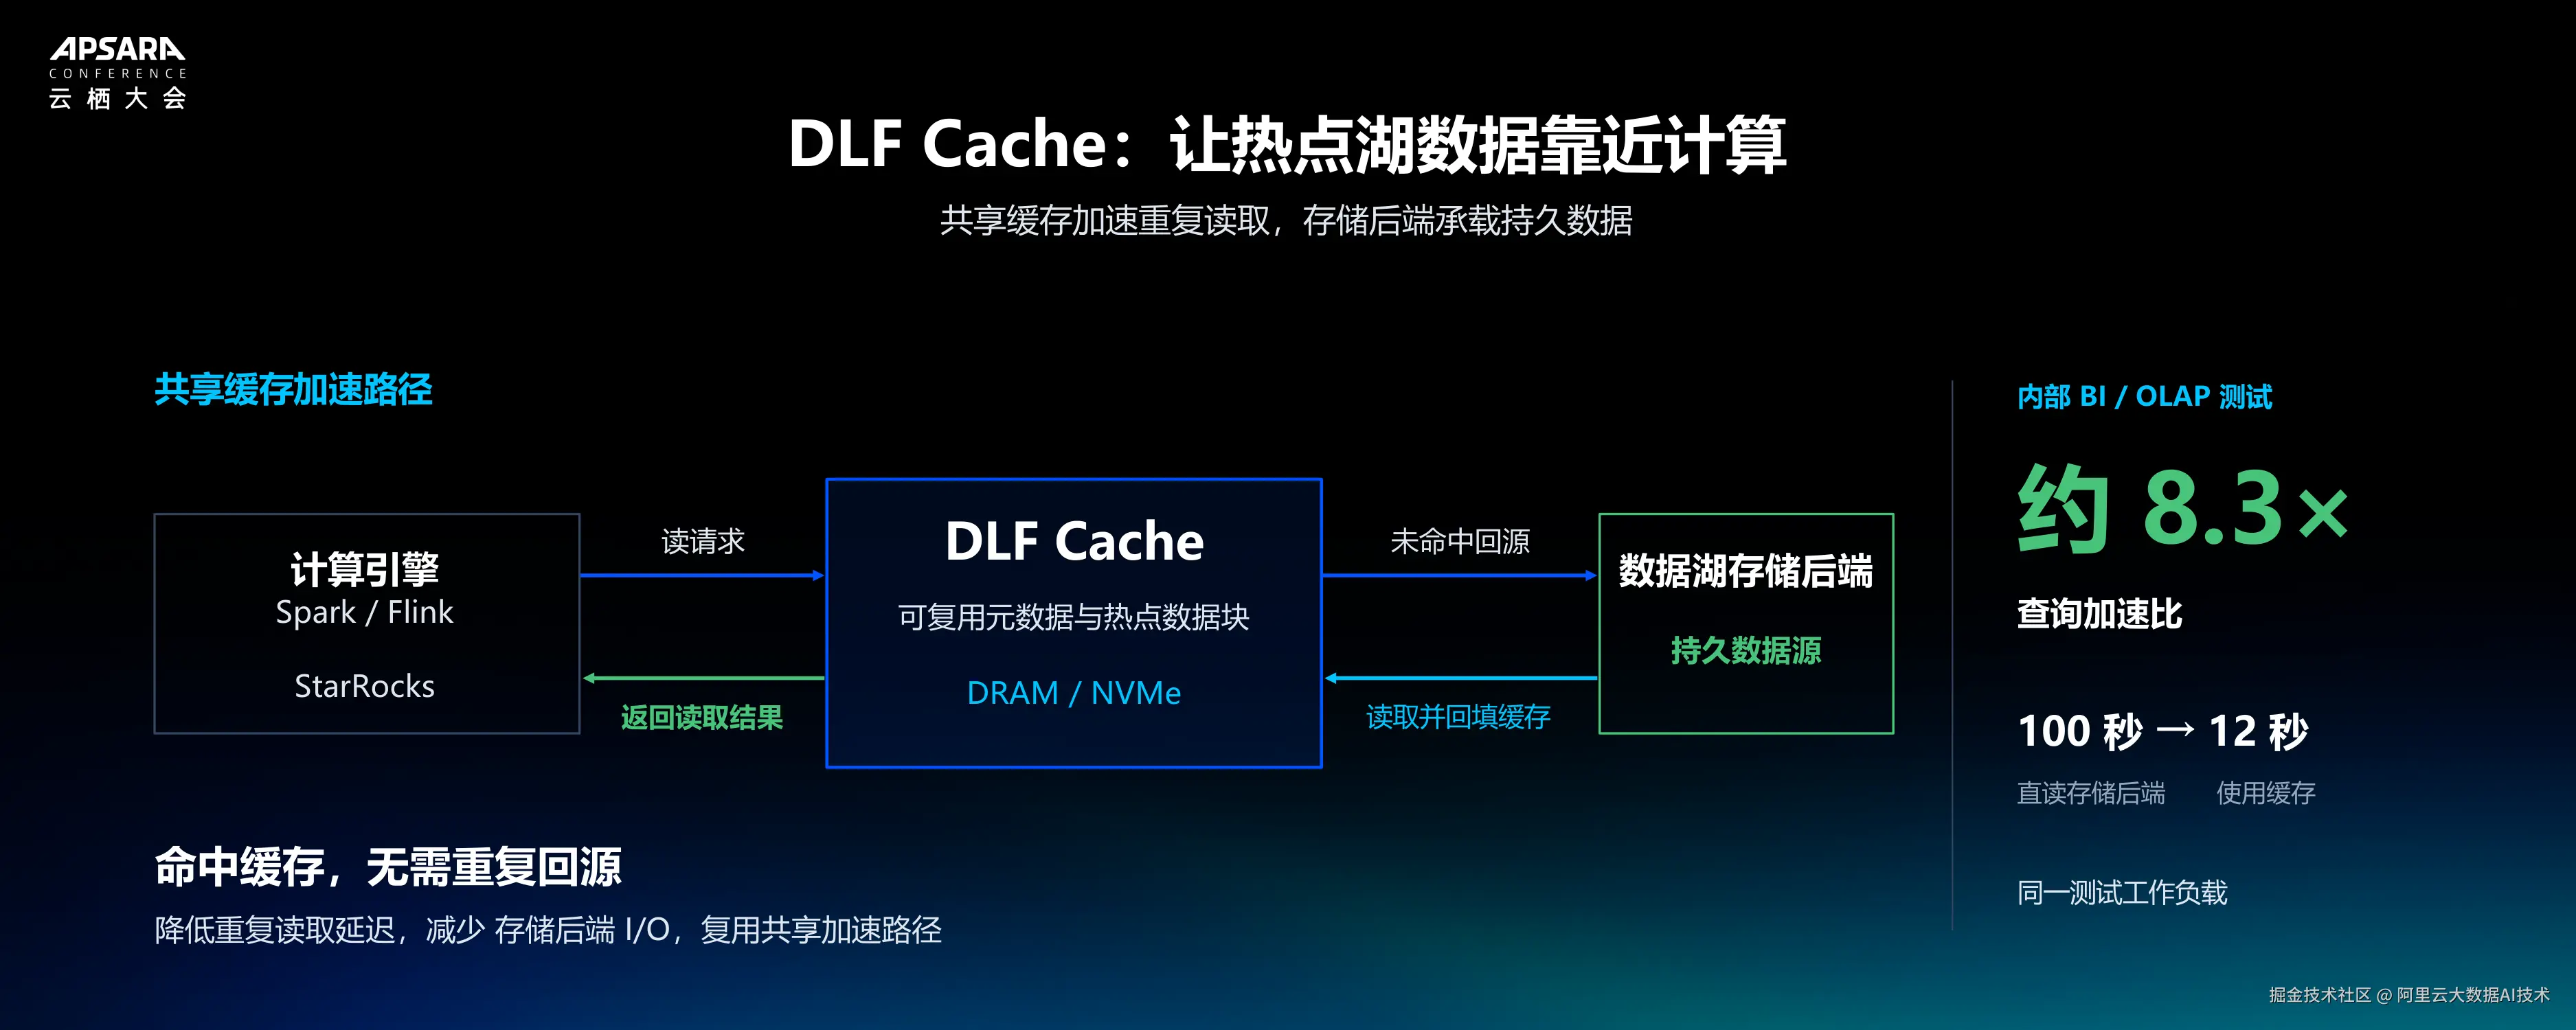
除了统一管理数据,我们还需要提高数据使用的效率。为此,DLF 提供缓存服务,让热点数据更靠近计算。对于 ETL 等存在重复读取的场景,缓存加速能够帮助数据更快地被访问,减少重复访问存储后端的开销。
在训练场景中,我们尤其不希望 GPU 等待数据。演讲中也提到,可以结合快照或版本管理,对训练所需的数据集进行预热。围绕这些使用方式,缓存能够改善数据供给效率。
PPT 展示的共享缓存路径位于计算引擎和持久存储之间,可复用元数据与热点数据块:命中缓存时直接返回结果,未命中时从存储后端读取并回填缓存。在同一内部 BI/OLAP 测试负载下,查询耗时从 100 秒降至 12 秒,对应约 8.3 倍加速。这个数字反映的是该测试场景下的结果。
Paimon 2.0 的更新与查询性能
如果全模态数据要支撑规模化生产,性能和效率同样关键。我们围绕数据更新、Compaction 和读取进行了 Benchmark 测试,希望验证产品在这些环节的改进。
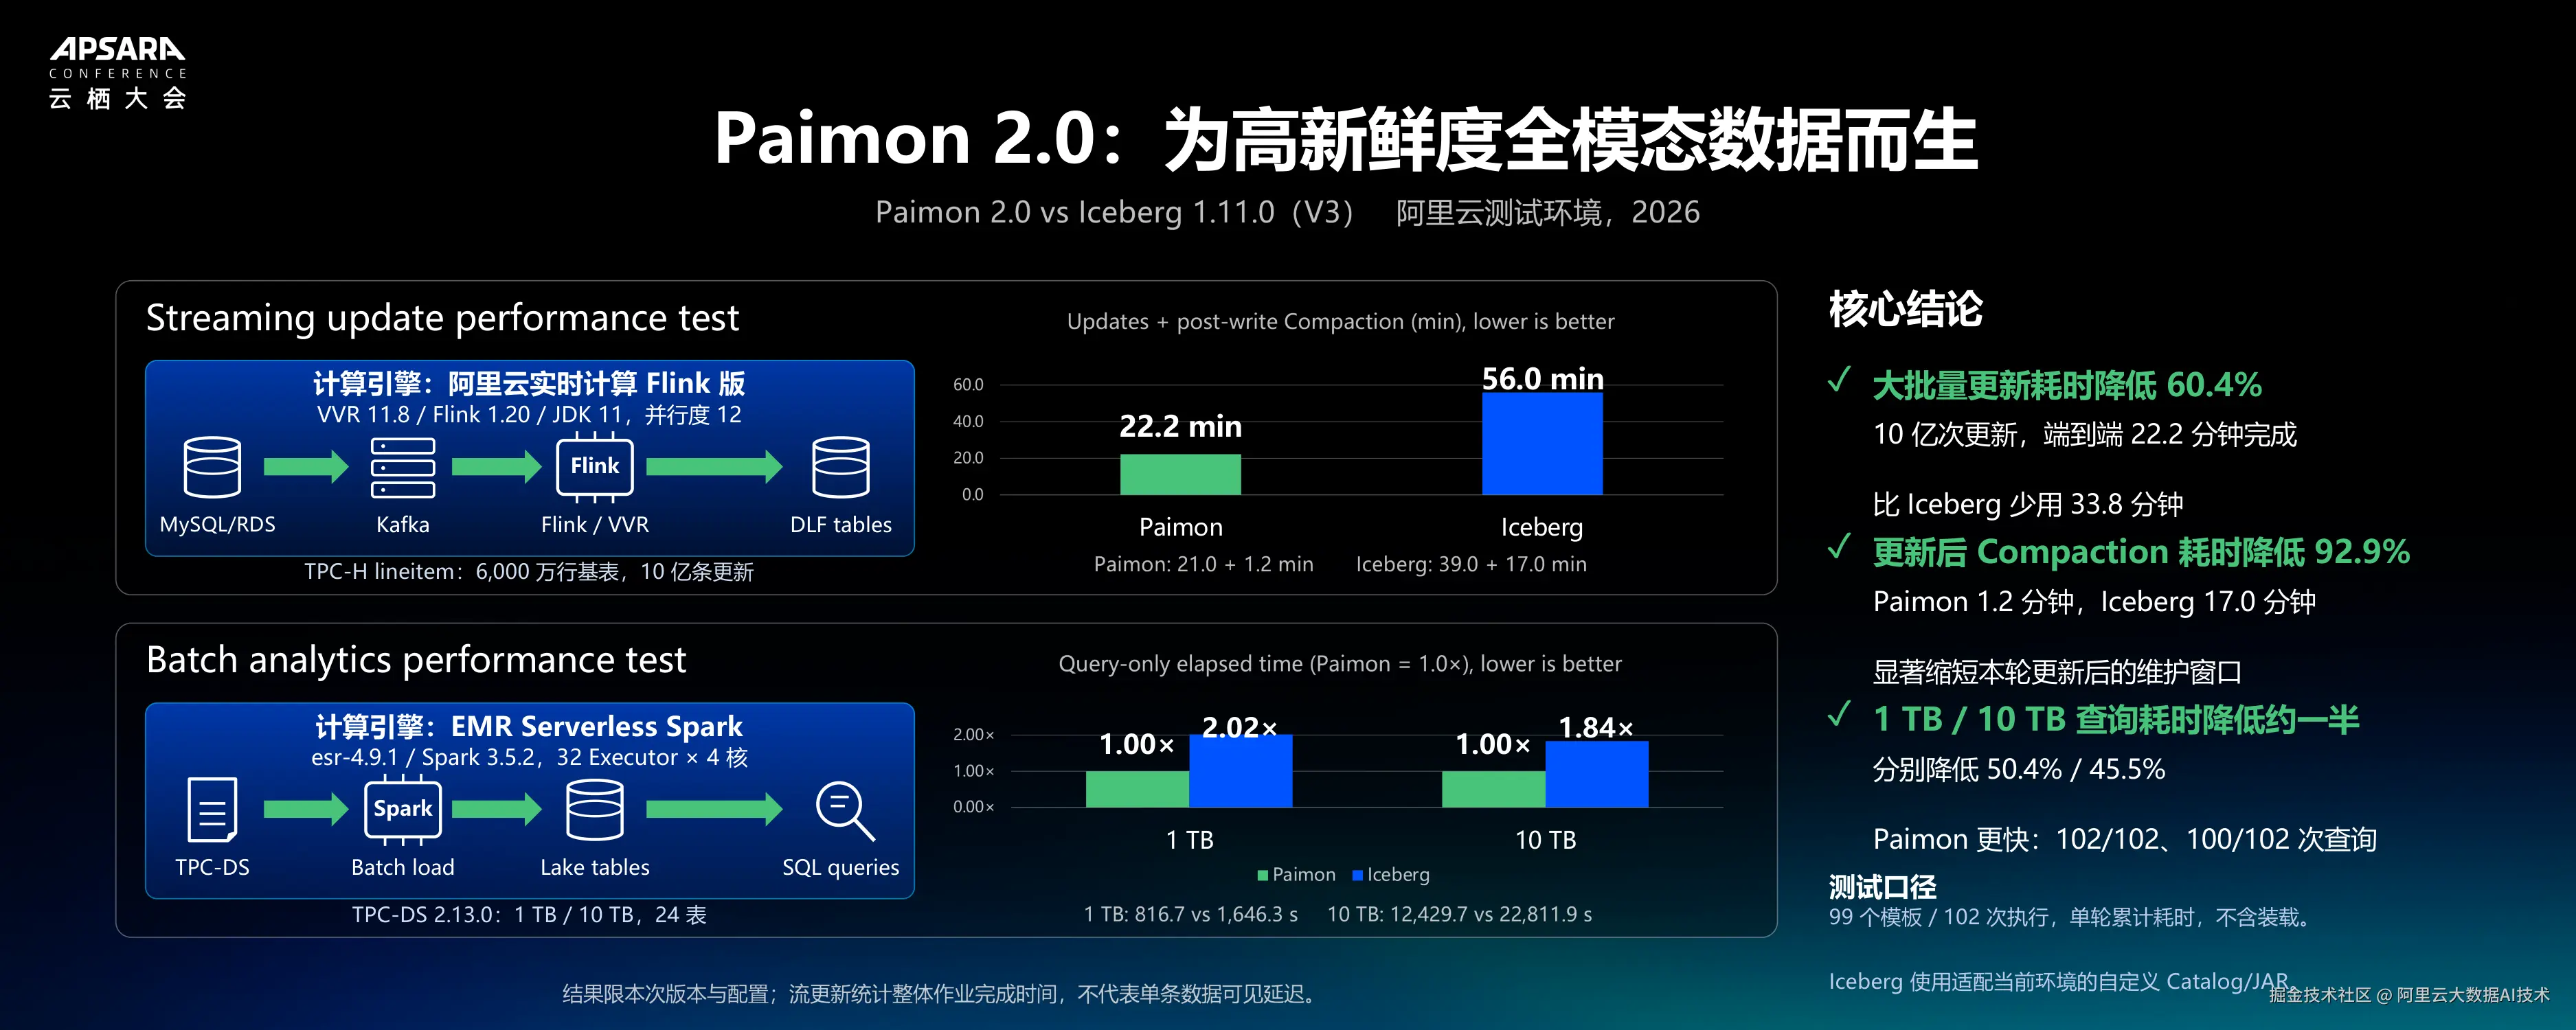
在流式更新测试中,基于阿里云实时计算 Flink 版,对 6,000 万行的 TPC-H lineitem 基表执行 10 亿条更新。Paimon 端到端耗时为 22.2 分钟,Iceberg 为 56.0 分钟,减少了 33.8 分钟,耗时降低 60.4%。
在这轮更新后的 Compaction 测试中,Paimon 耗时为 1.2 分钟,Iceberg 为 17.0 分钟,耗时降低 92.9%,相应缩短了更新后的维护窗口。
在 EMR Serverless Spark 上进行的 TPC-DS 批量分析测试中,1 TB 和 10 TB 数据规模下,Paimon 的查询耗时分别降低 50.4% 和 45.5%,对应约 2.02 倍和 1.84 倍的速度。102 次查询执行中,Paimon 分别在 102 次和 100 次执行中更快。
这些结果对应 PPT 列明的测试环境与口径:流式测试使用 VVR 11.8、Flink 1.20、JDK 11,并行度为 12;批量分析使用 Spark 3.5.2,32 个 Executor,每个 4 核。查询统计为 99 个模板、102 次执行的单轮累计耗时,不包含数据装载。它们说明了对应测试条件下的表现,也是我们过去一年产品迭代的一部分。
DLF存储优化
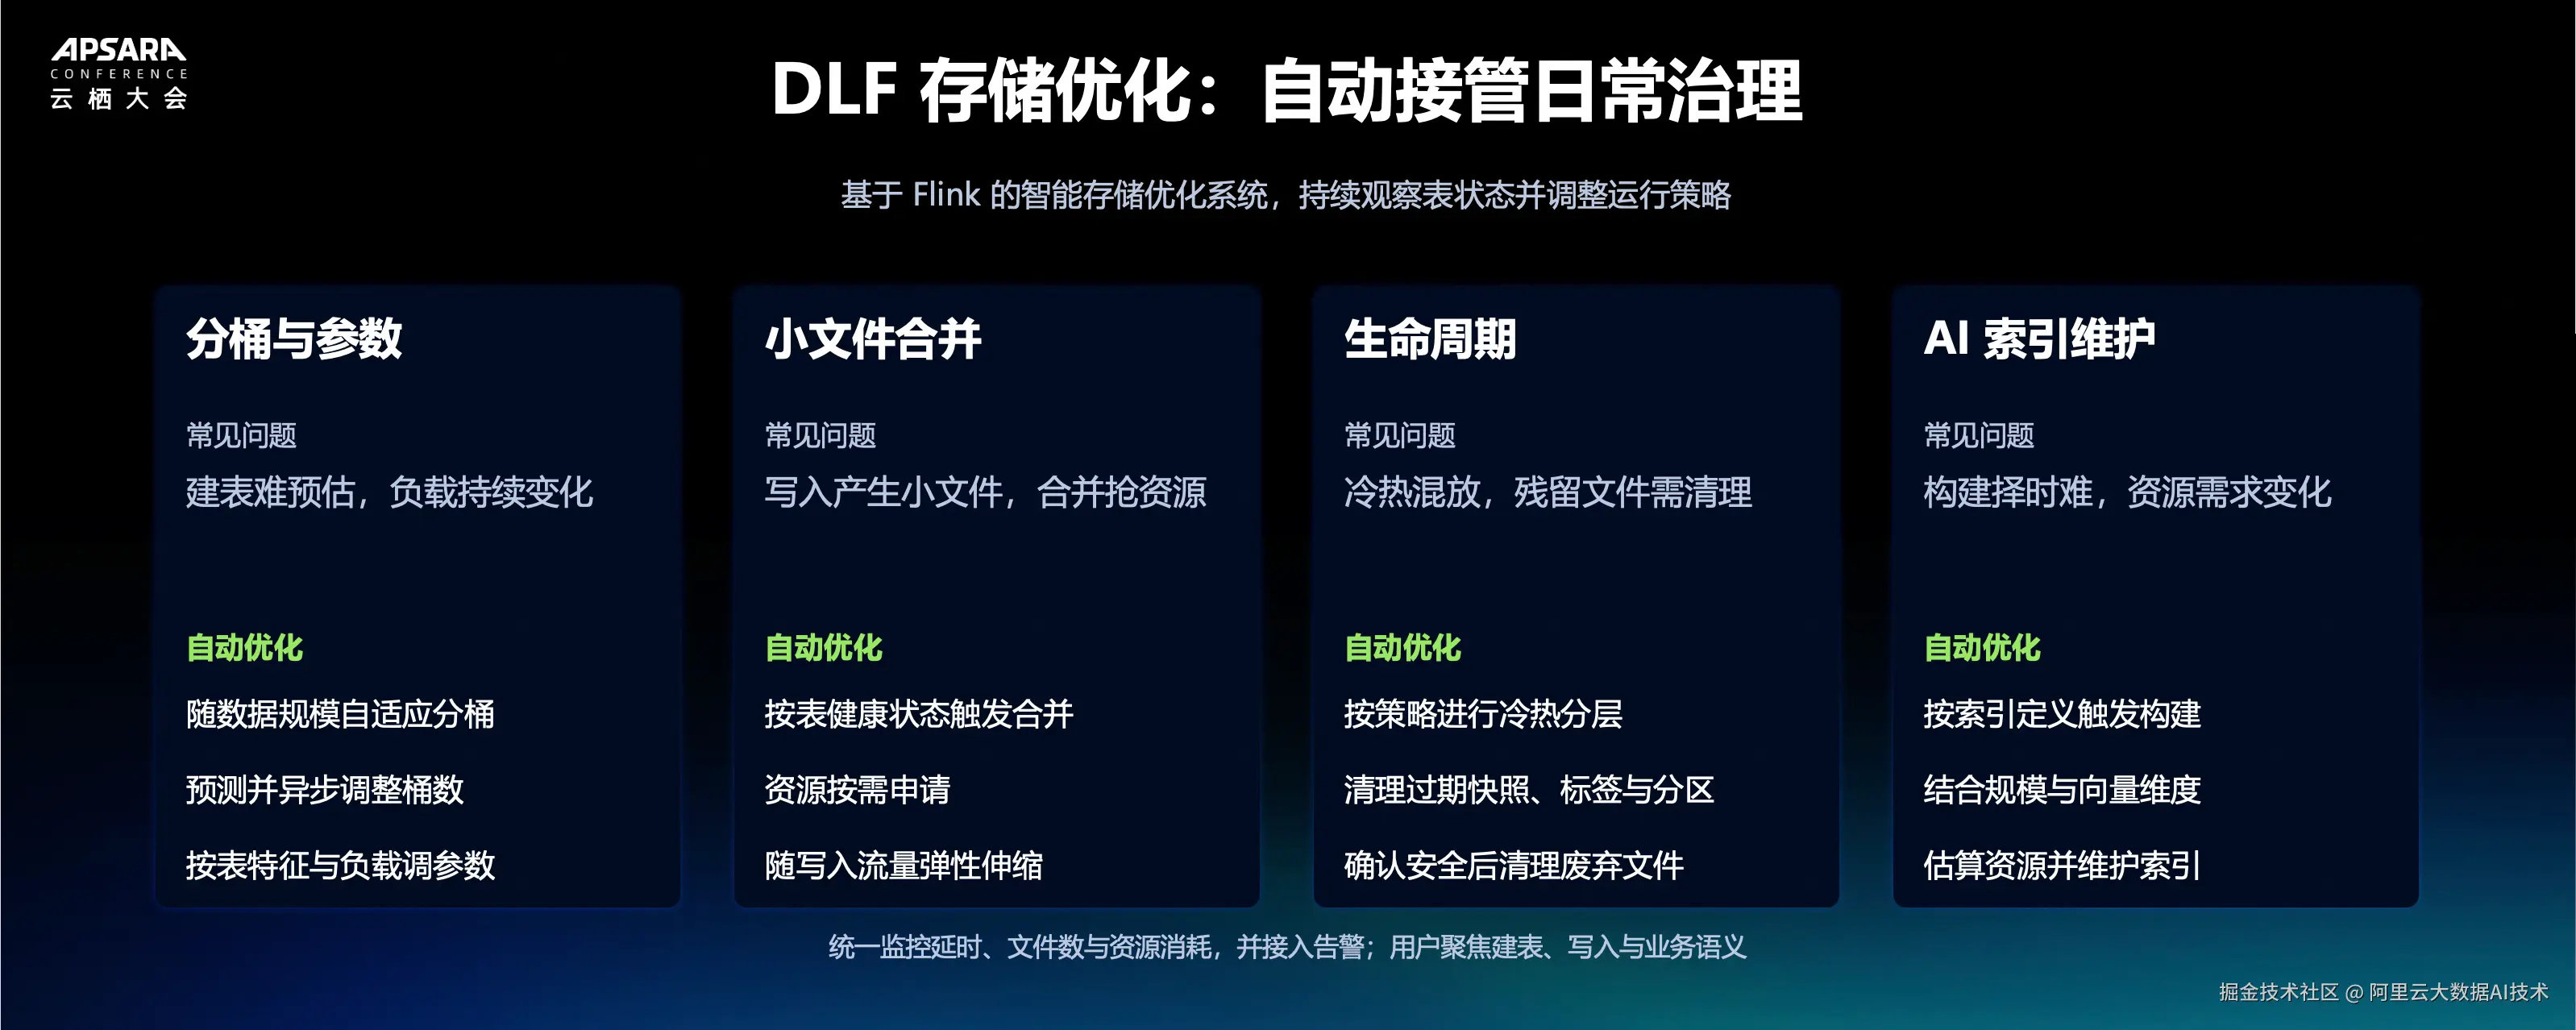
除了更新和查询性能,数据湖能否长期稳定运行,还取决于日常治理。随着数据持续写入,建表时设置的分桶和参数未必始终适合业务负载,小文件、历史快照和索引也需要持续维护。我们希望通过基于 Flink 的智能存储优化系统,持续观察表状态并调整运行策略,让用户更多地聚焦建表、数据写入和业务语义,而不必反复处理底层维护工作。
首先是分桶与参数优化。建表时,用户往往难以准确预估后续的数据规模和读写负载。针对这一问题,系统可以随数据规模自适应分桶,预测并异步调整桶数,同时结合表特征与负载调整参数,使数据组织方式能够随业务变化持续优化。
其次是小文件合并。持续写入会产生小文件,而合并任务本身也会消耗计算资源。DLF 根据表的健康状态触发合并,按需申请资源,并随写入流量弹性伸缩。这样,文件治理不再只是固定周期执行的维护任务,而是能够结合表状态和负载变化进行调整。
在生命周期管理方面,平台按策略进行冷热分层,清理过期快照、标签与分区,并在确认安全后清理废弃文件,减少历史数据和残留文件持续占用存储。同时,面向 AI 场景的索引维护,系统可以按索引定义触发构建,结合数据规模与向量维度估算资源需求,并承担后续维护工作。
这些能力共同构成了湖表的日常治理体系。平台统一监控延时、文件数和资源消耗,并接入告警,让分桶调整、文件合并、生命周期与索引维护能够在可观测的基础上持续运行。
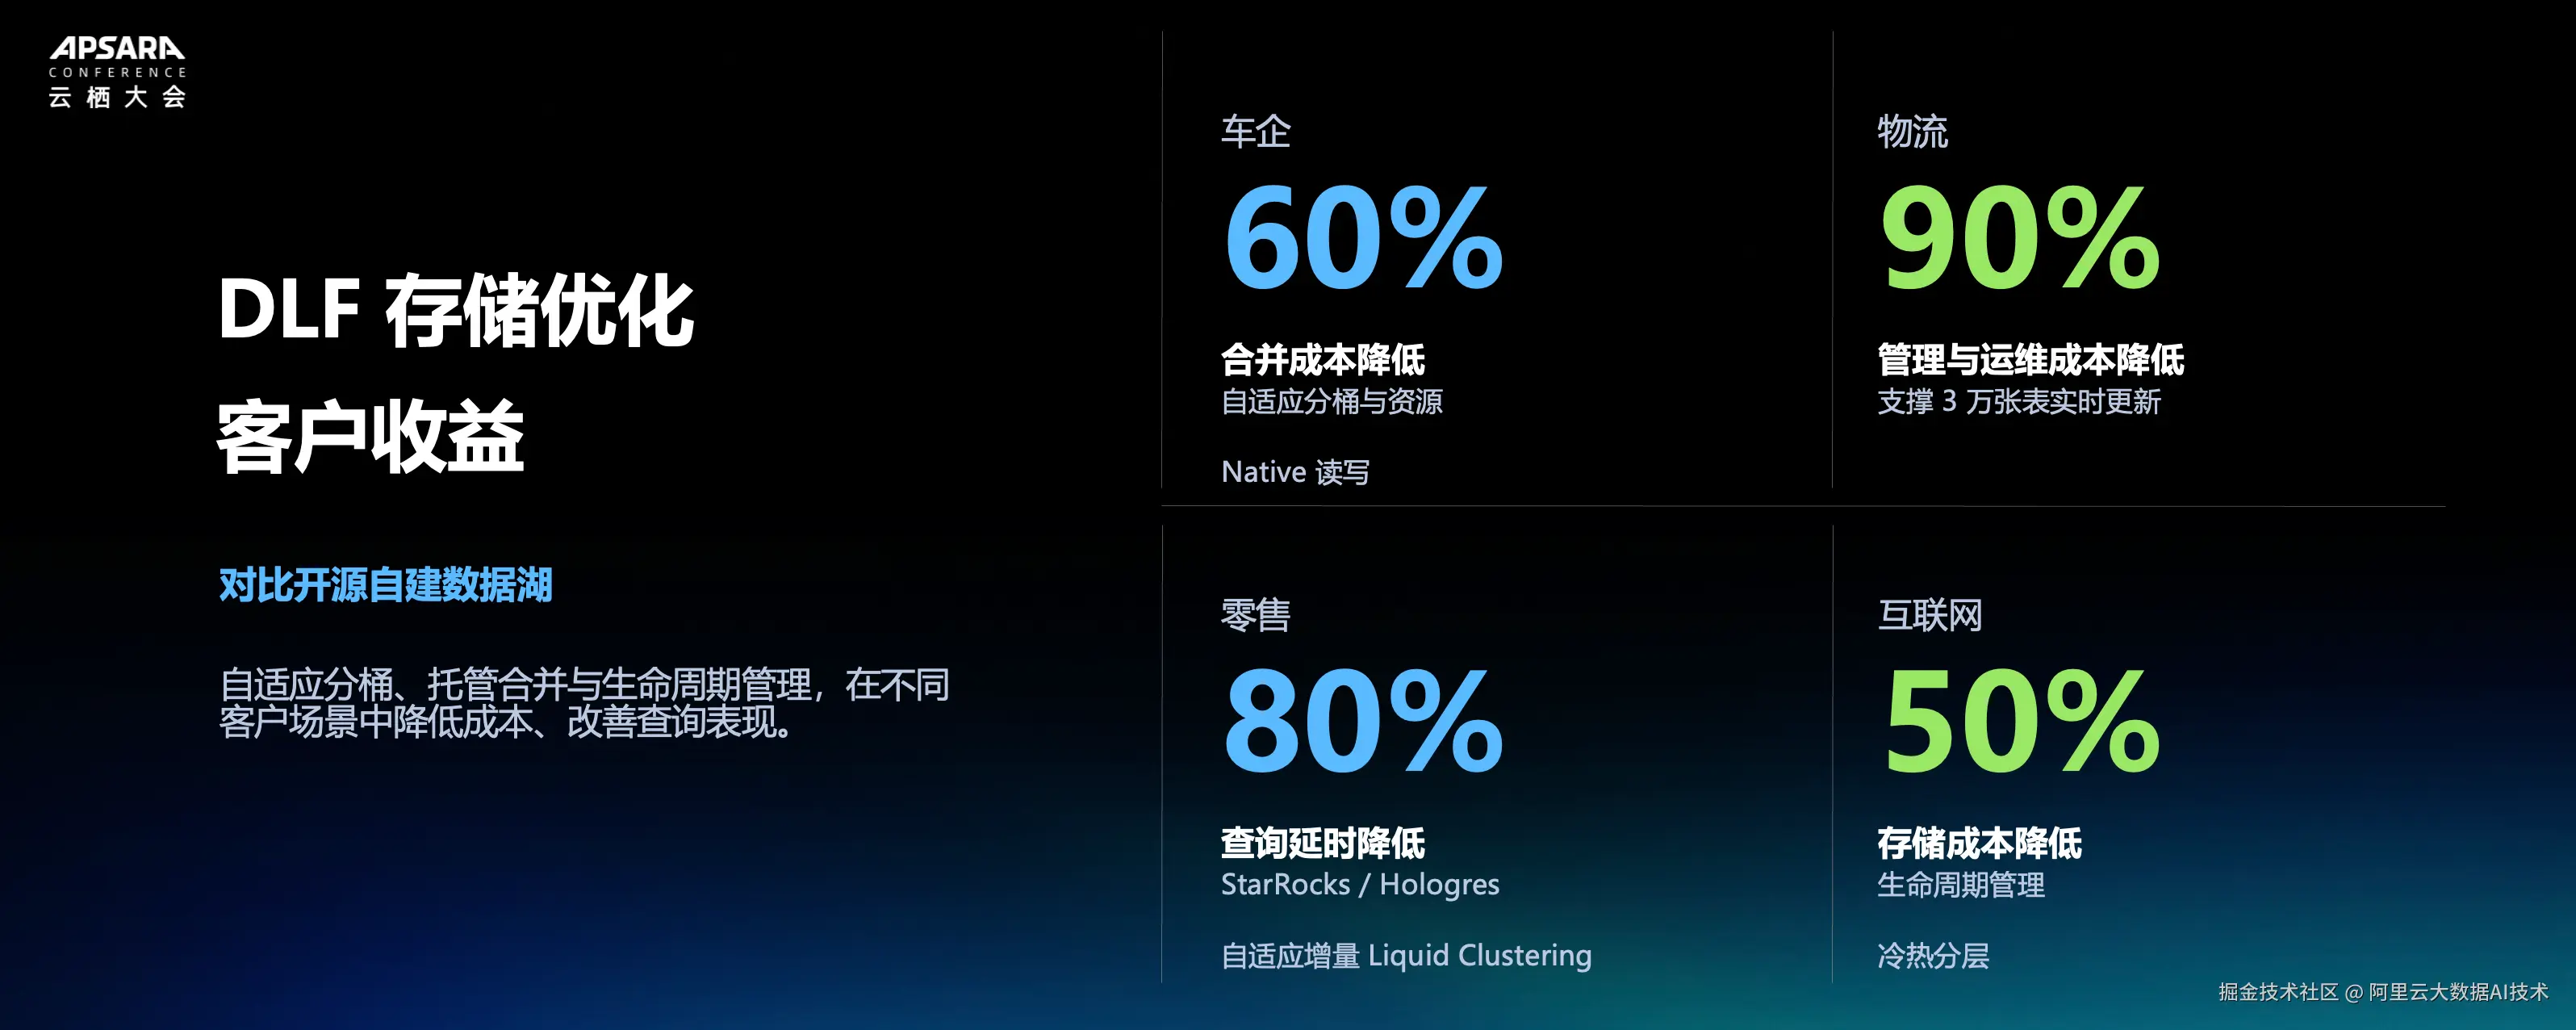
这些优化也体现在不同客户场景的实际收益中。图中以开源自建数据湖为对比基准:车企场景结合自适应分桶、资源优化与 Native 读写,合并成本降低 60%;物流场景在支撑 3 万张表实时更新的同时,管理与运维成本降低 90%。
在零售场景中,结合自适应增量 Liquid Clustering,以及 StarRocks、Hologres 的查询链路,查询延时降低 80%;互联网场景则通过生命周期管理与冷热分层,存储成本降低 50%。这些数字分别对应图中列举的客户实践,并不代表所有业务都能获得相同比例的收益,但也说明,数据湖的优化不仅涉及计算性能,还包括数据组织、存储成本与运维投入。
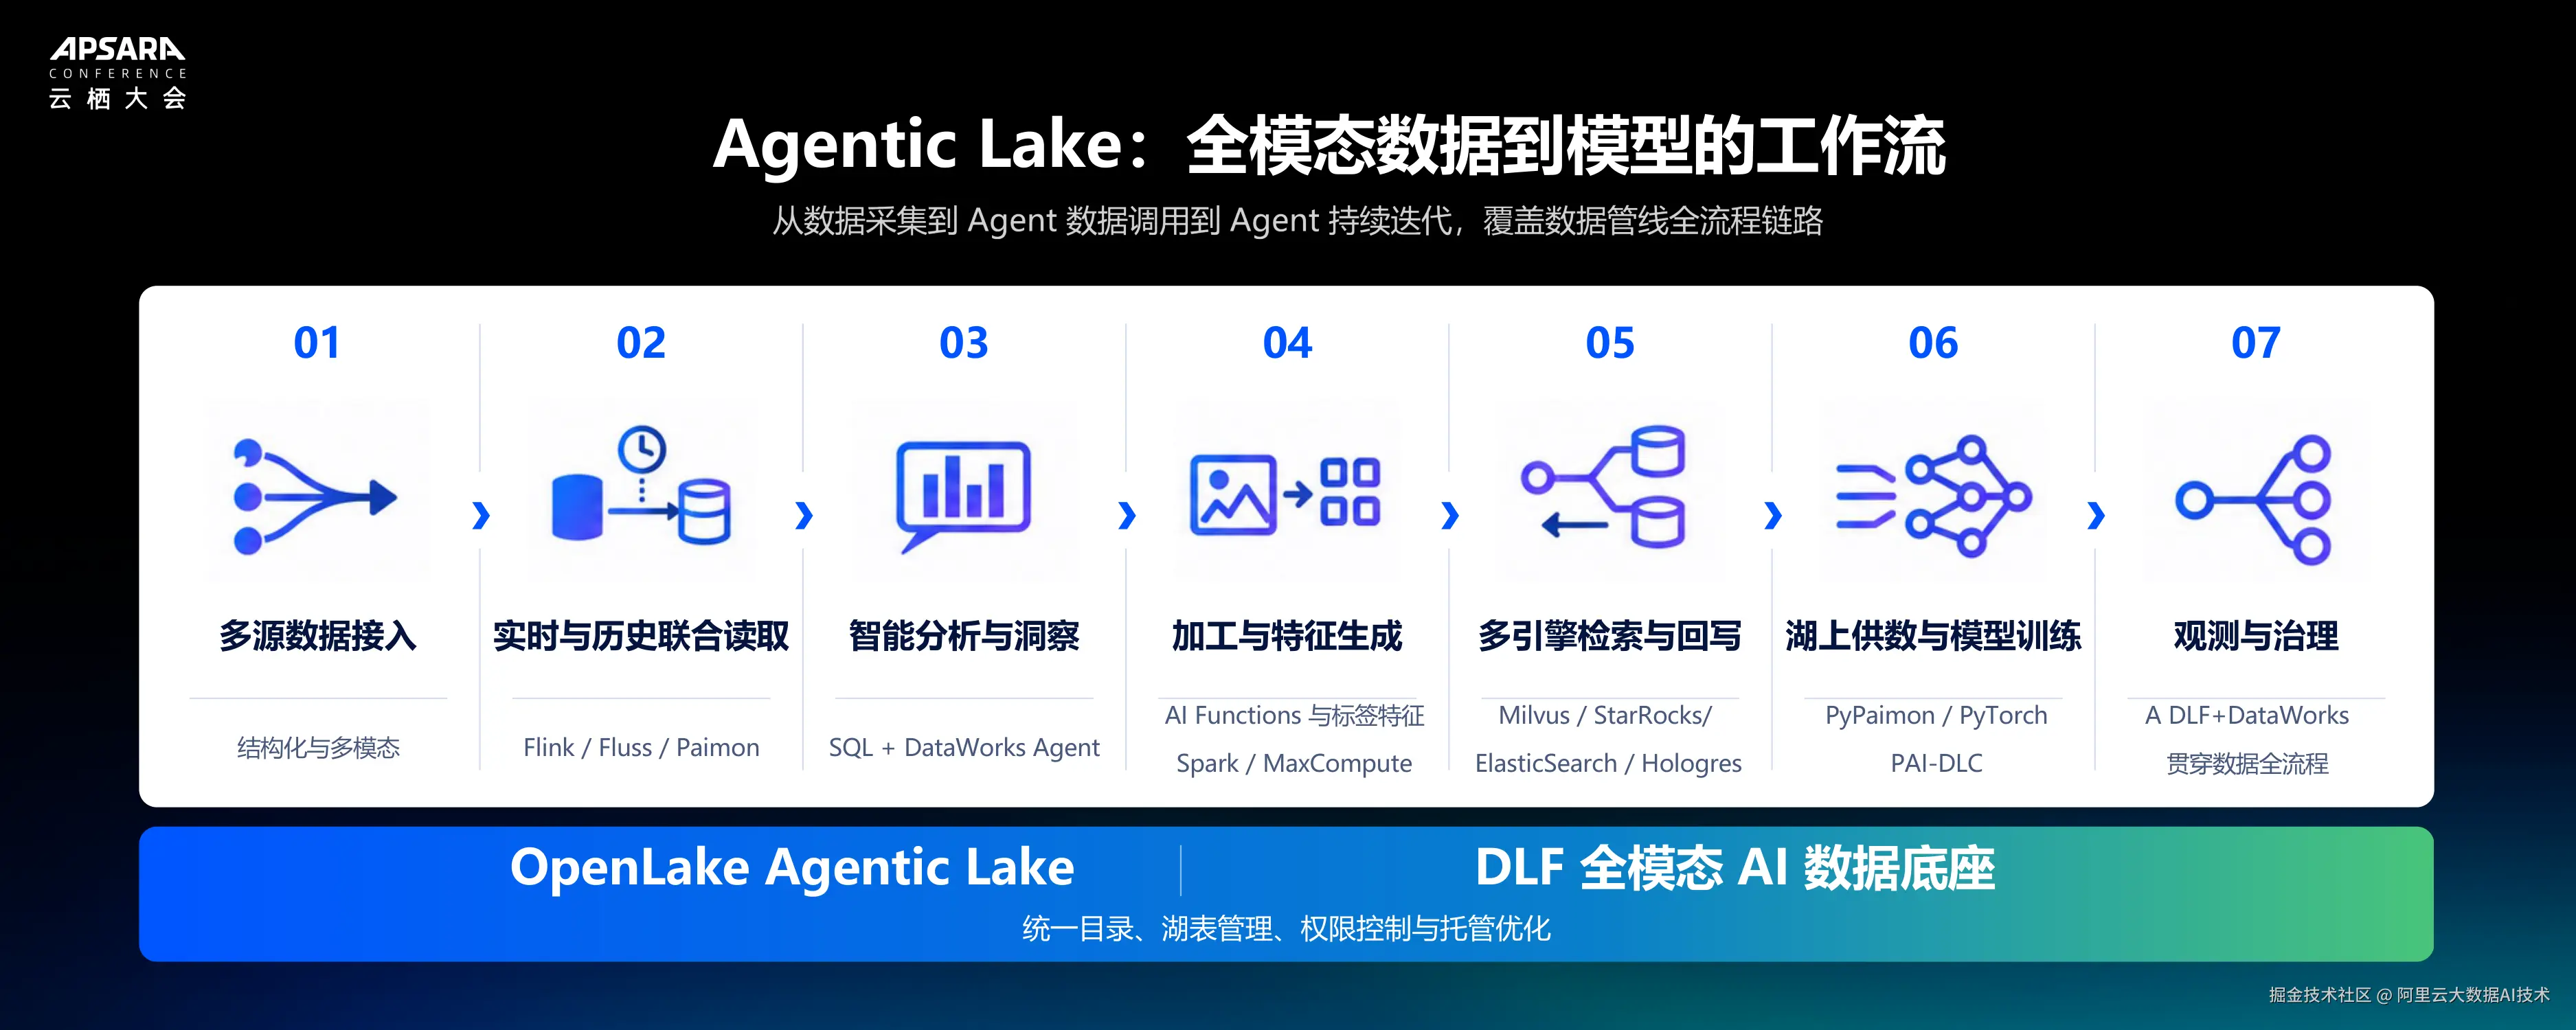
Agentic Lake示例:从全模态数据到模型的端到端工作流
从场景来看,我们希望 Agentic Lake 能够支持从全模态数据到模型的端到端 Pipeline。首先是多源数据接入,将不同类型的数据摄取到湖中。其次是实时数据与历史数据的联合读取。Agent 读取数据时,往往既需要最新的实时信息,也需要历史数据;我们希望通过统一的读取方式,让两者能够一起被使用。
数据进入这一流程后,可以继续进行智能分析、OLAP 查询、数据加工、特征生成与回写,以及湖上的混合检索。这些环节由不同引擎协同完成,形成从数据准备到使用的完整链路。
当数据准备完成后,就可以进一步为模型训练提供数据,并支持模型使用和质量评估。示例展示了 PyPaimon、PyTorch 和 PAI-DLC 等面向训练的衔接方式。整个过程还需要可管控、可理解、可观测。因此,我们也重视端到端血缘能力。演讲中强调,血缘不仅要覆盖表级,还希望深入文件级,以便理解数据经过哪些加工处理、最终进入哪些环节。统一的治理和观测,需要贯穿这条工作流。
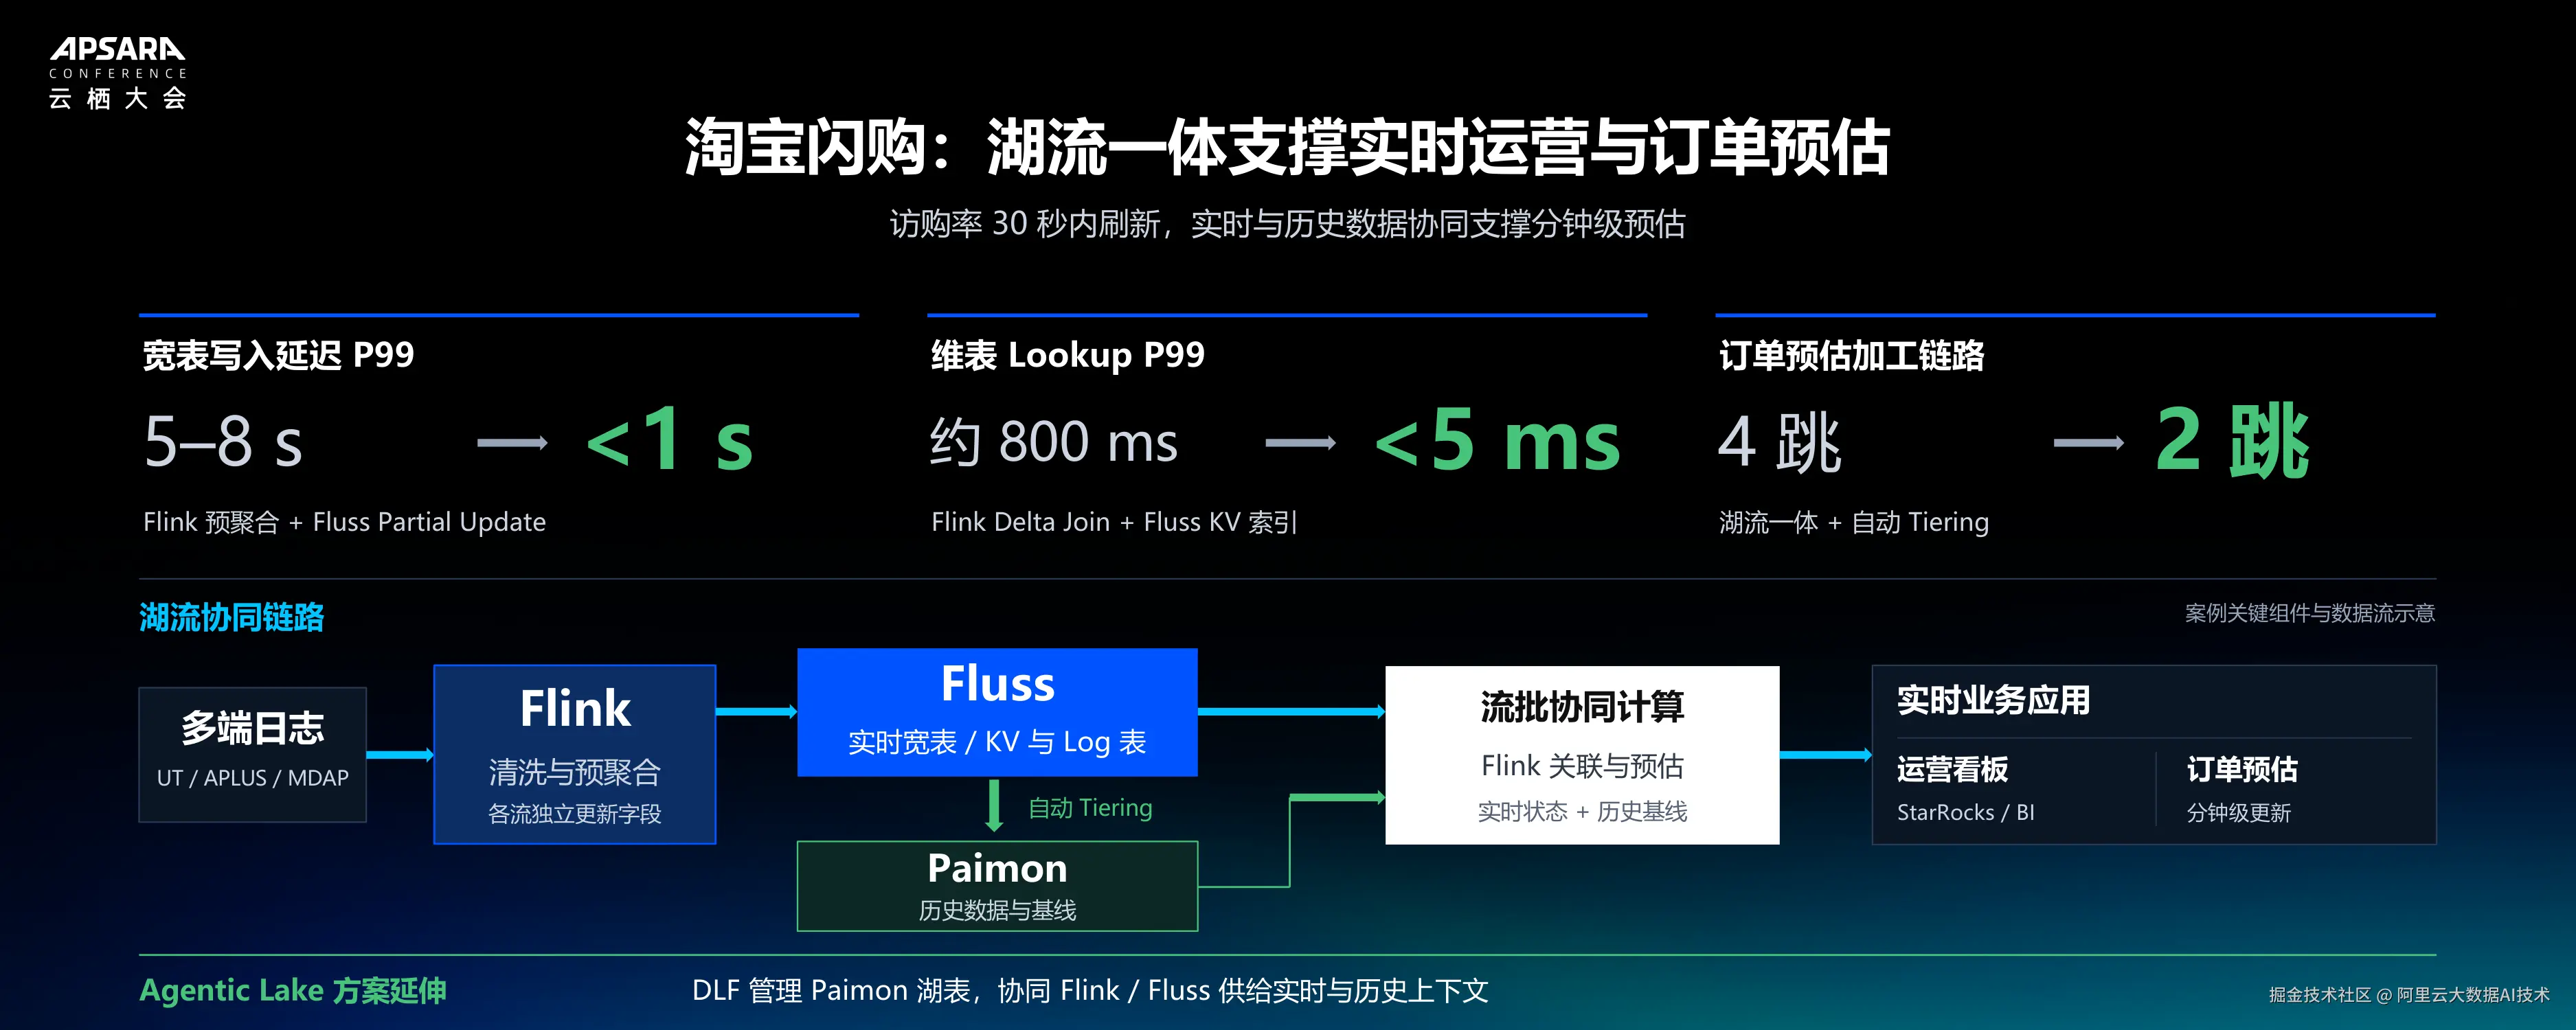
场景一:淘宝闪购的湖流一体实践
淘宝闪购是我们内部的一个实践案例。上一年分享的重点是湖流一体和实时加速;在此基础上,我们继续完善实时与历史数据的协同,为进一步的 Agentic 化服务提供数据基础。
这一案例中,访购率能够在 30 秒内刷新,实时数据与历史数据共同支撑分钟级订单预估。多端日志经过 Flink 清洗与预聚合,进入 Fluss 的实时宽表、KV 与 Log 表,再通过自动 Tiering 与 Paimon 中的历史数据和基线协同,由 Flink 完成关联与预估,并服务运营看板和订单预估等业务。
PPT 给出了几个具体指标:宽表写入延迟 P99 从 5---8 秒降低到 1 秒以内,维表 Lookup 的 P99 从约 800 毫秒降低到 5 毫秒以内,订单预估加工链路从 4 跳缩短到 2 跳。这些改进分别结合了 Flink 预聚合、Fluss Partial Update、Delta Join、KV 索引以及湖流协同等能力。
在 Agentic Lake 方案中,DLF 管理 Paimon 湖表,并协同 Flink、Fluss 提供实时与历史上下文,使已有的实时数据体系进一步服务 Agent 的数据使用需求。
场景二:通过一条 SQL 完成湖上混合检索
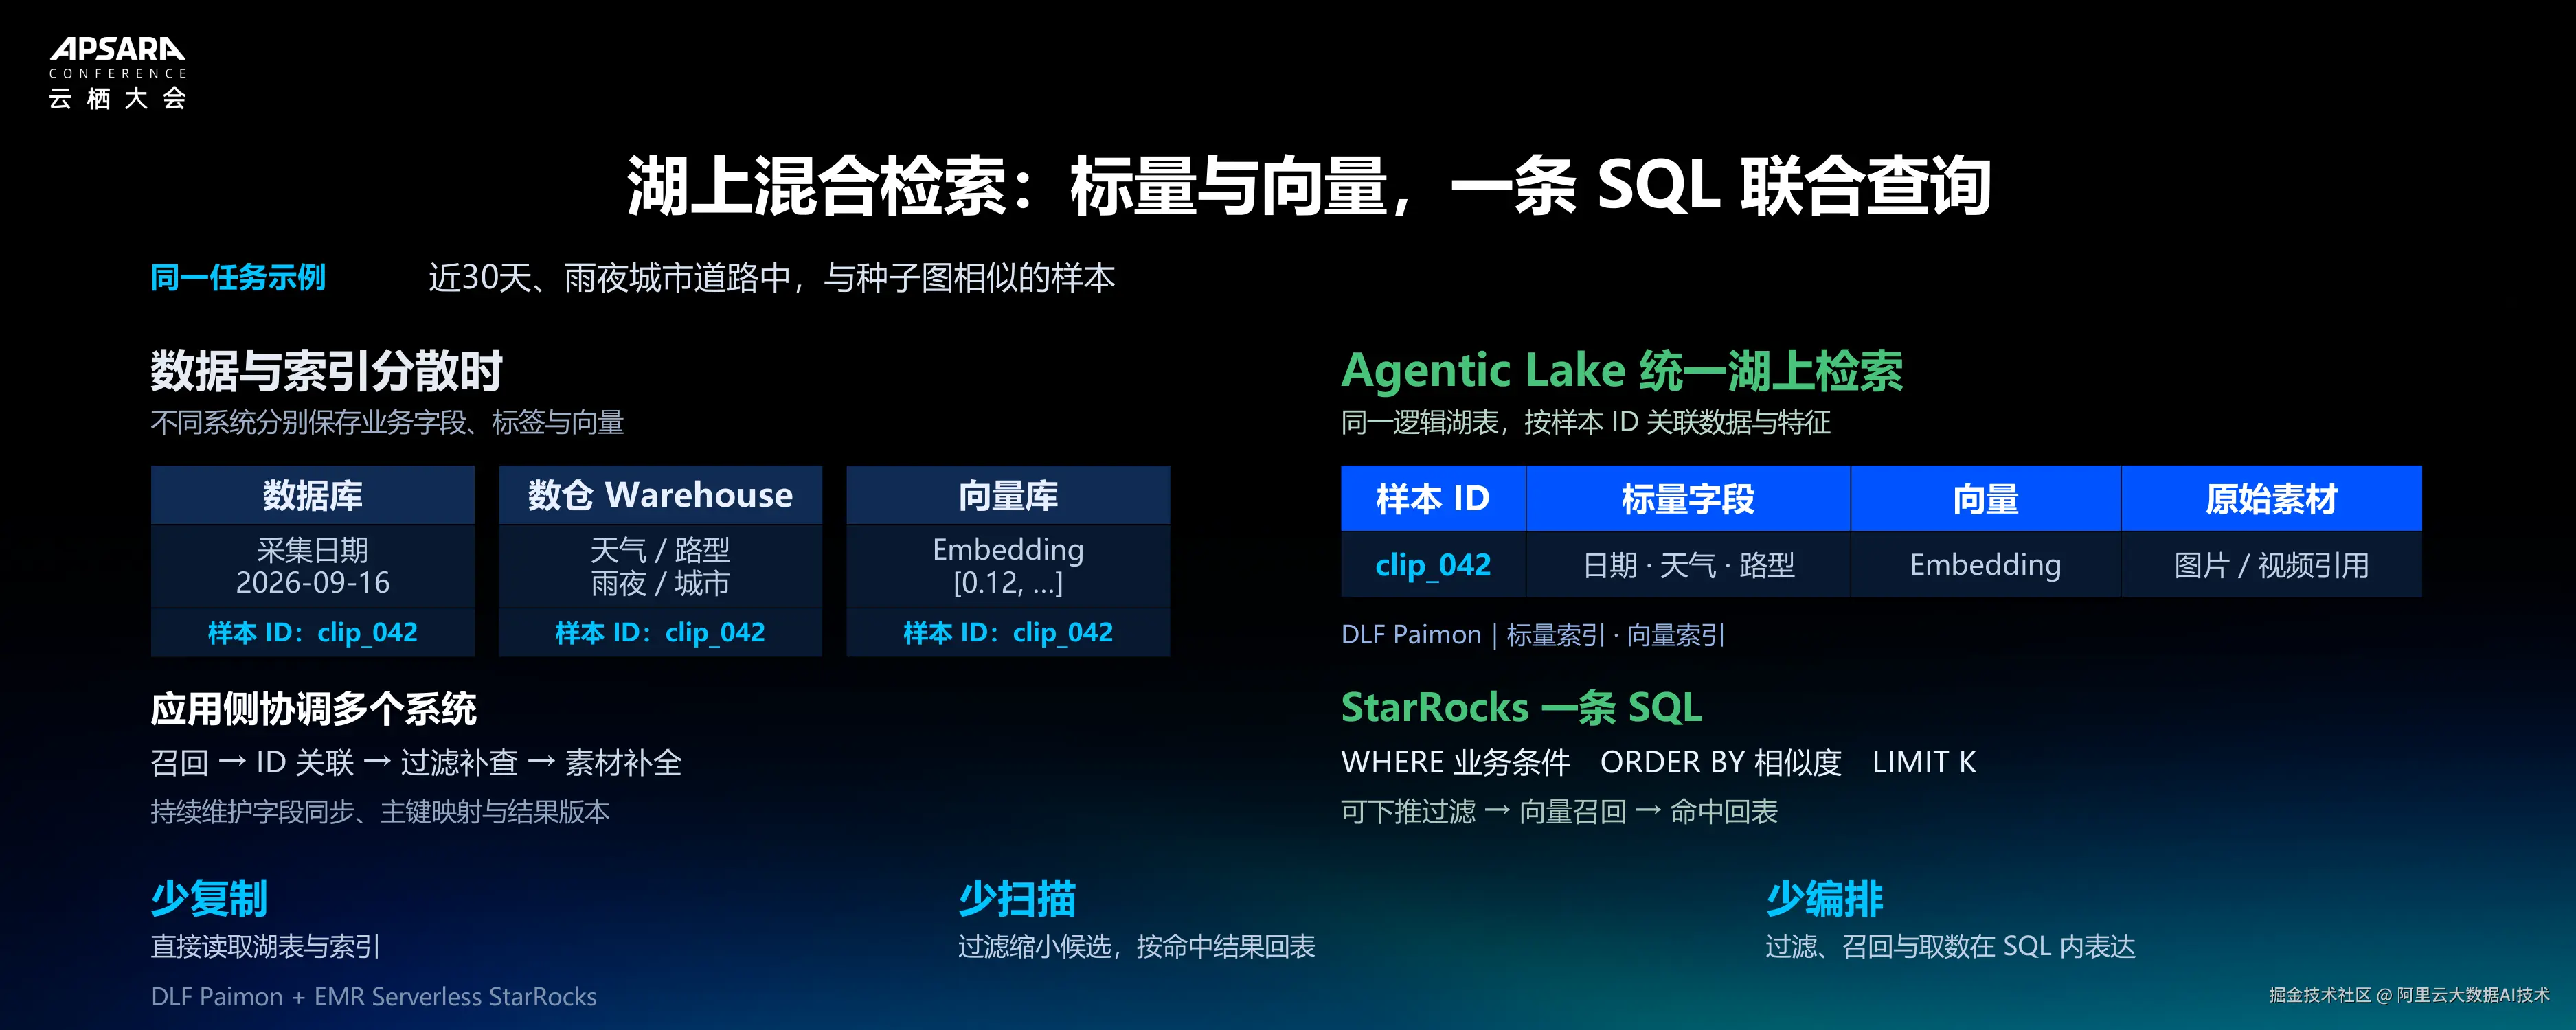
所有数据入湖、资产沉淀,最终都要服务于使用。对于湖上的检索,我们希望用一条 SQL 表达标量与向量的混合查询:先根据业务字段进行过滤,再结合向量相似度完成召回,检索出需要的数据资产。
PPT 中的例子是寻找近 30 天、雨夜城市道路中,与一张种子图相似的样本。如果日期、天气、路型和向量分散在不同系统,应用侧就需要协调召回、ID 关联、过滤补查和素材补全,并持续维护字段同步、主键映射与结果版本。
在统一湖上检索方式下,这些字段、向量和原始素材引用围绕同一个样本 ID 关联。借助 DLF Paimon 与 EMR Serverless StarRocks,可以在 SQL 中用 WHERE 表达业务条件,按相似度排序,并通过 LIMIT K 取回结果。这样,过滤、召回和取数可以在同一条查询中表达,让湖上的数据更容易被发现和使用。
场景三:具身智能数据管线
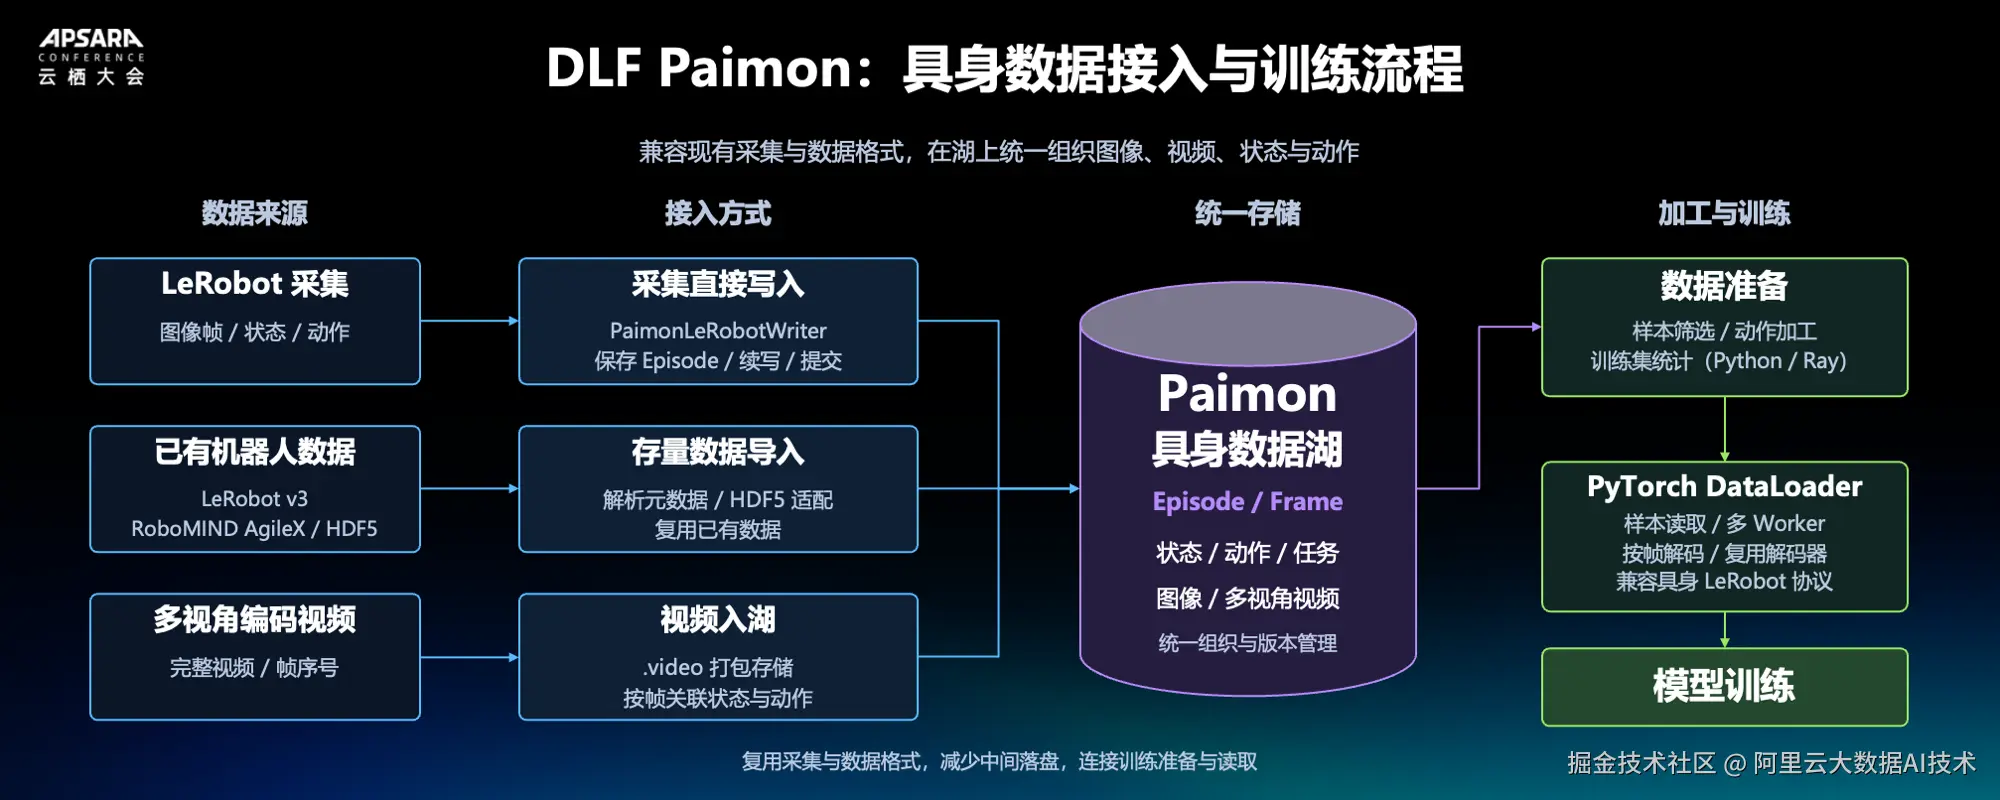
具身智能对数据底座提出了更具体的要求。训练所需的数据不仅包括图像和视频,还包括与之对应的状态、动作和任务信息。这些内容需要按照同一次交互过程,也就是 Episode,以及其中的 Frame 组织起来。我们希望在兼容现有采集方式和数据格式的基础上,通过 DLF Paimon 将这些数据统一管理,并衔接后续的数据准备与模型训练。
在数据接入方面,第一条是采集直接写入:LeRobot 采集得到的图像帧、状态与动作,可以通过 PaimonLeRobotWriter 写入湖中,支持 Episode 的保存、续写与提交。第二条是存量数据导入:对于已有的 LeRobot v3、RoboMIND AgileX 以及 HDF5 等数据,通过元数据解析与格式适配复用已有资产,不必重新采集。第三条是多视角编码视频入湖:将完整视频以 video 形式打包存储,再通过帧序号关联相应的状态与动作。
这三类数据最终汇入 Paimon 具身数据湖,围绕 Episode 和 Frame 统一组织状态、动作、任务、图像及多视角视频,并进行版本管理。这样,数据准备与训练读取可以基于同一套关联关系展开,而不必在各个环节分别维护媒体文件与动作数据之间的对应关系。
数据入湖后,可以通过 Python、Ray 等工具进行样本筛选、动作加工和训练集统计。准备好的样本再交给 PyTorch DataLoader 读取,结合多 Worker、按帧解码和解码器复用等方式,为模型训练提供数据。
这一管线的重点,不是要求用户重建一套采集和训练工具,而是复用现有的数据格式与工具链,在湖上完成统一组织,减少中间落盘,并连接数据准备、样本读取和模型训练。对于需要持续采集数据、反复筛选样本并迭代模型的具身智能场景,这也是全模态数据底座的一种具体应用方式。
场景四:Happy Horse 的多模态训练数据底座
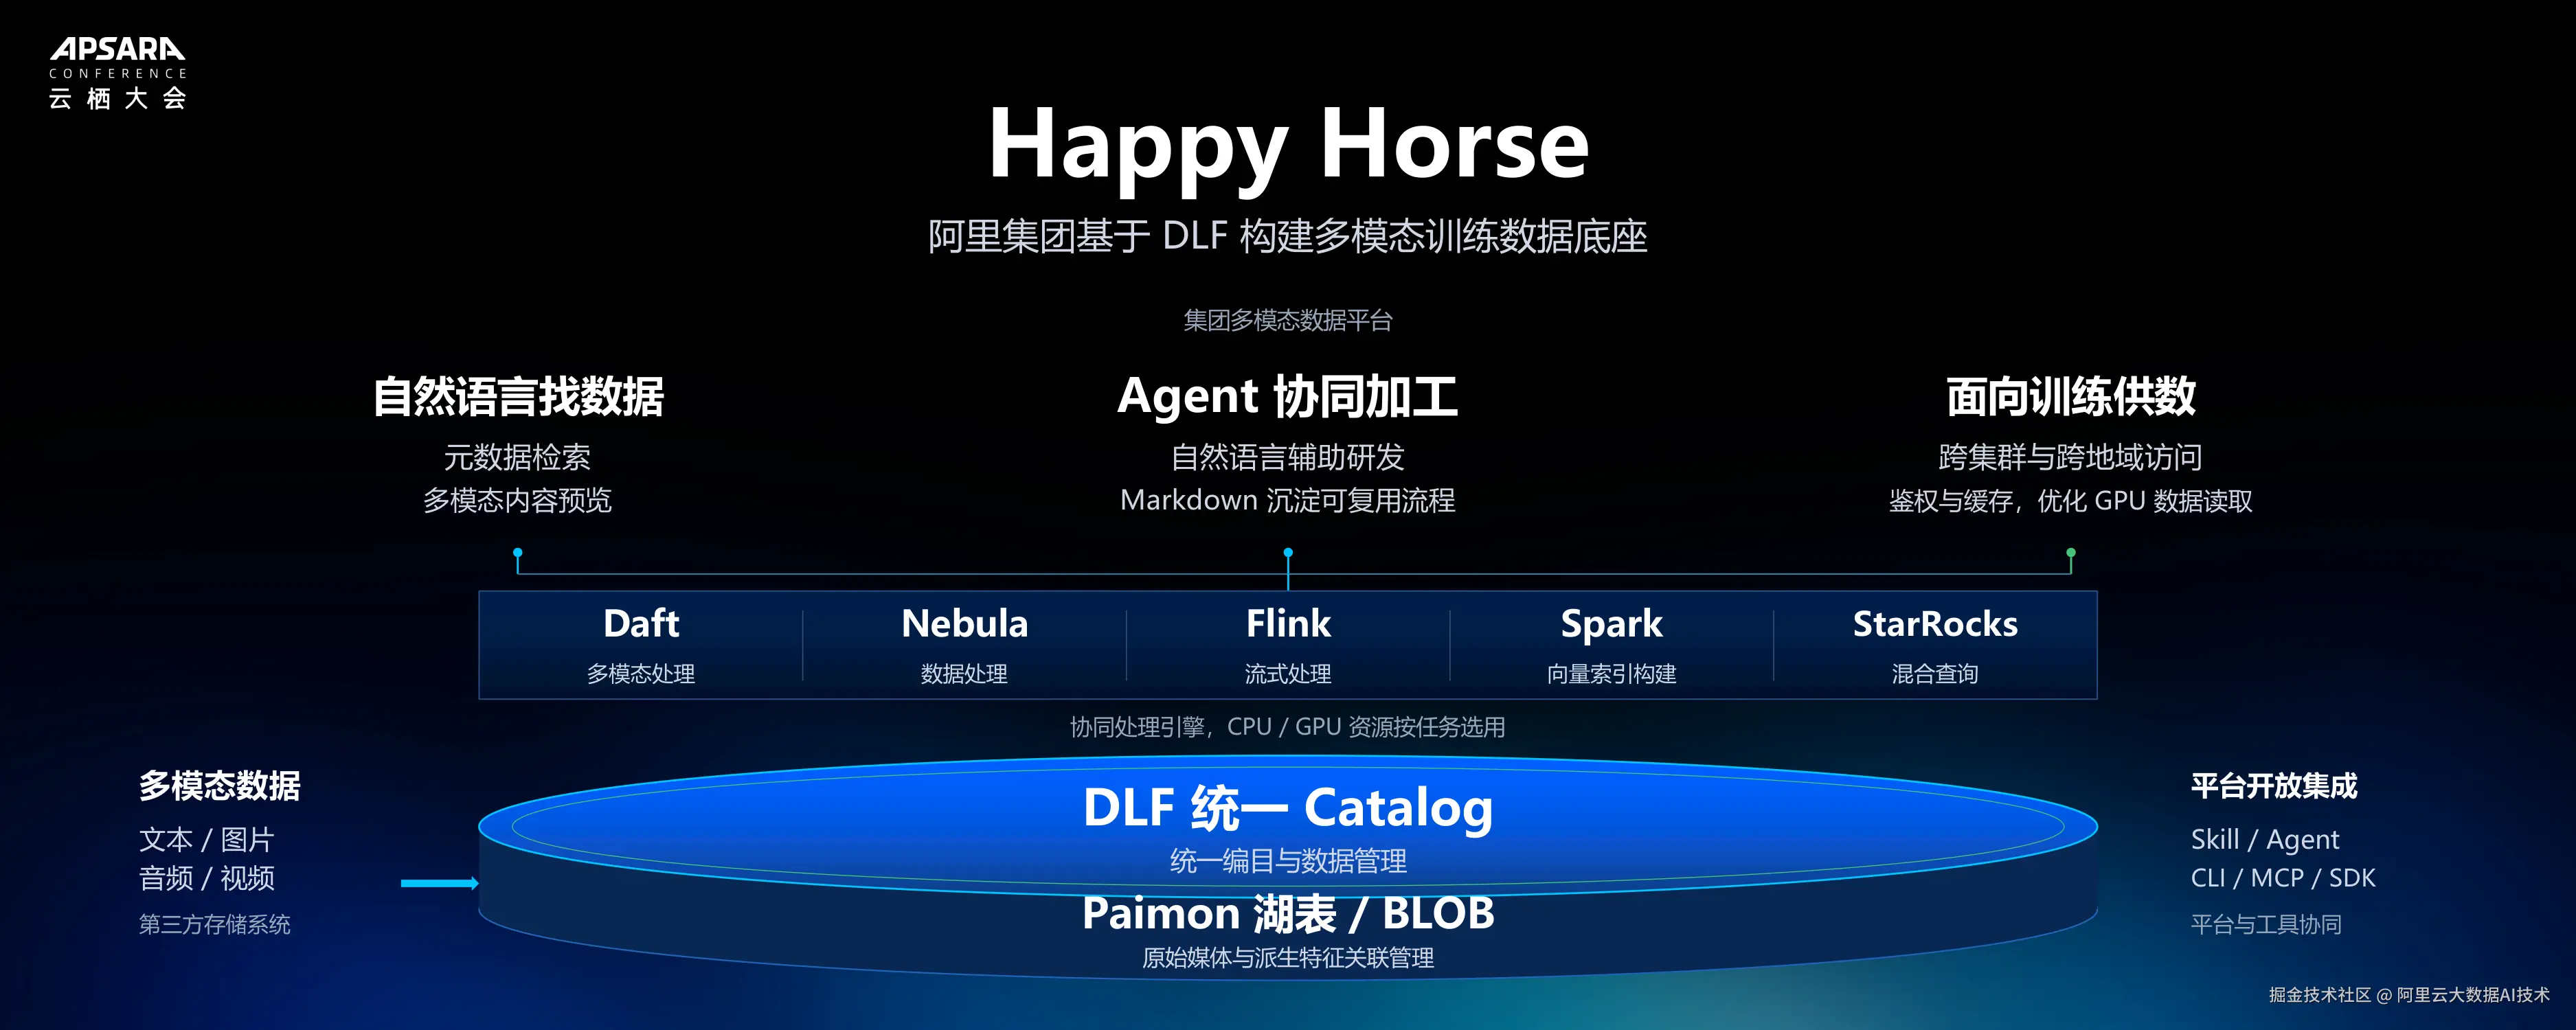
另一个内部案例是 Happy Horse。视频数据量非常大。在我们的内部场景中,单张湖表所承载的数据量可以接近 1 EB。这类规模对湖表承载能力、数据查找、协同加工和训练供数都有较高要求,我们希望通过统一的数据底座,支持大规模多模态数据的持续使用。
围绕 Happy Horse 的训练场景,平台首先需要让用户能够通过自然语言查找和发现湖上数据,结合元数据检索与多模态内容预览,找到需要的素材。其次,可以通过 Agent 协同加工这些数据,并将可复用的流程沉淀下来。
更进一步,平台需要持续为训练提供数据集,使模型能够不断迭代。PPT 展示了 DLF 统一 Catalog、Paimon 湖表与 BLOB 对原始媒体及派生特征的关联管理,以及 Daft、Nebula、Flink、Spark、StarRocks 等处理引擎的协同。CPU、GPU 资源按任务选择,训练供数还涉及跨集群、跨地域访问,以及鉴权和缓存等能力。
在这一体系中,数据查找、Agent 加工和训练供数围绕同一套数据基础展开。我们希望让湖上数据更容易被组织、处理和持续用于模型训练。
面向更多行业持续演进
除了内部案例,我们也看到更多企业开始探索相应的应用。在本次云栖大会前一天的分享中,小鹏在机器人和汽车相关场景中,介绍了基于 DLF、OpenLake 构建 Agentic 应用的进展。这部分客户实践没有在本次演讲中展开,但它反映了企业正在把相关能力带入实际业务。
我们也与制药行业的专家交流,讨论如何用 OpenLake 支撑制药进入 AI 化的迭代流程和生命周期。我们并不是制药领域的专家,但从数据平台的角度,相信 OpenLake 向 Agentic Lake 的升级,能够为 AI 制药过程的迭代效率提供帮助。这是我们希望继续探索和验证的方向。
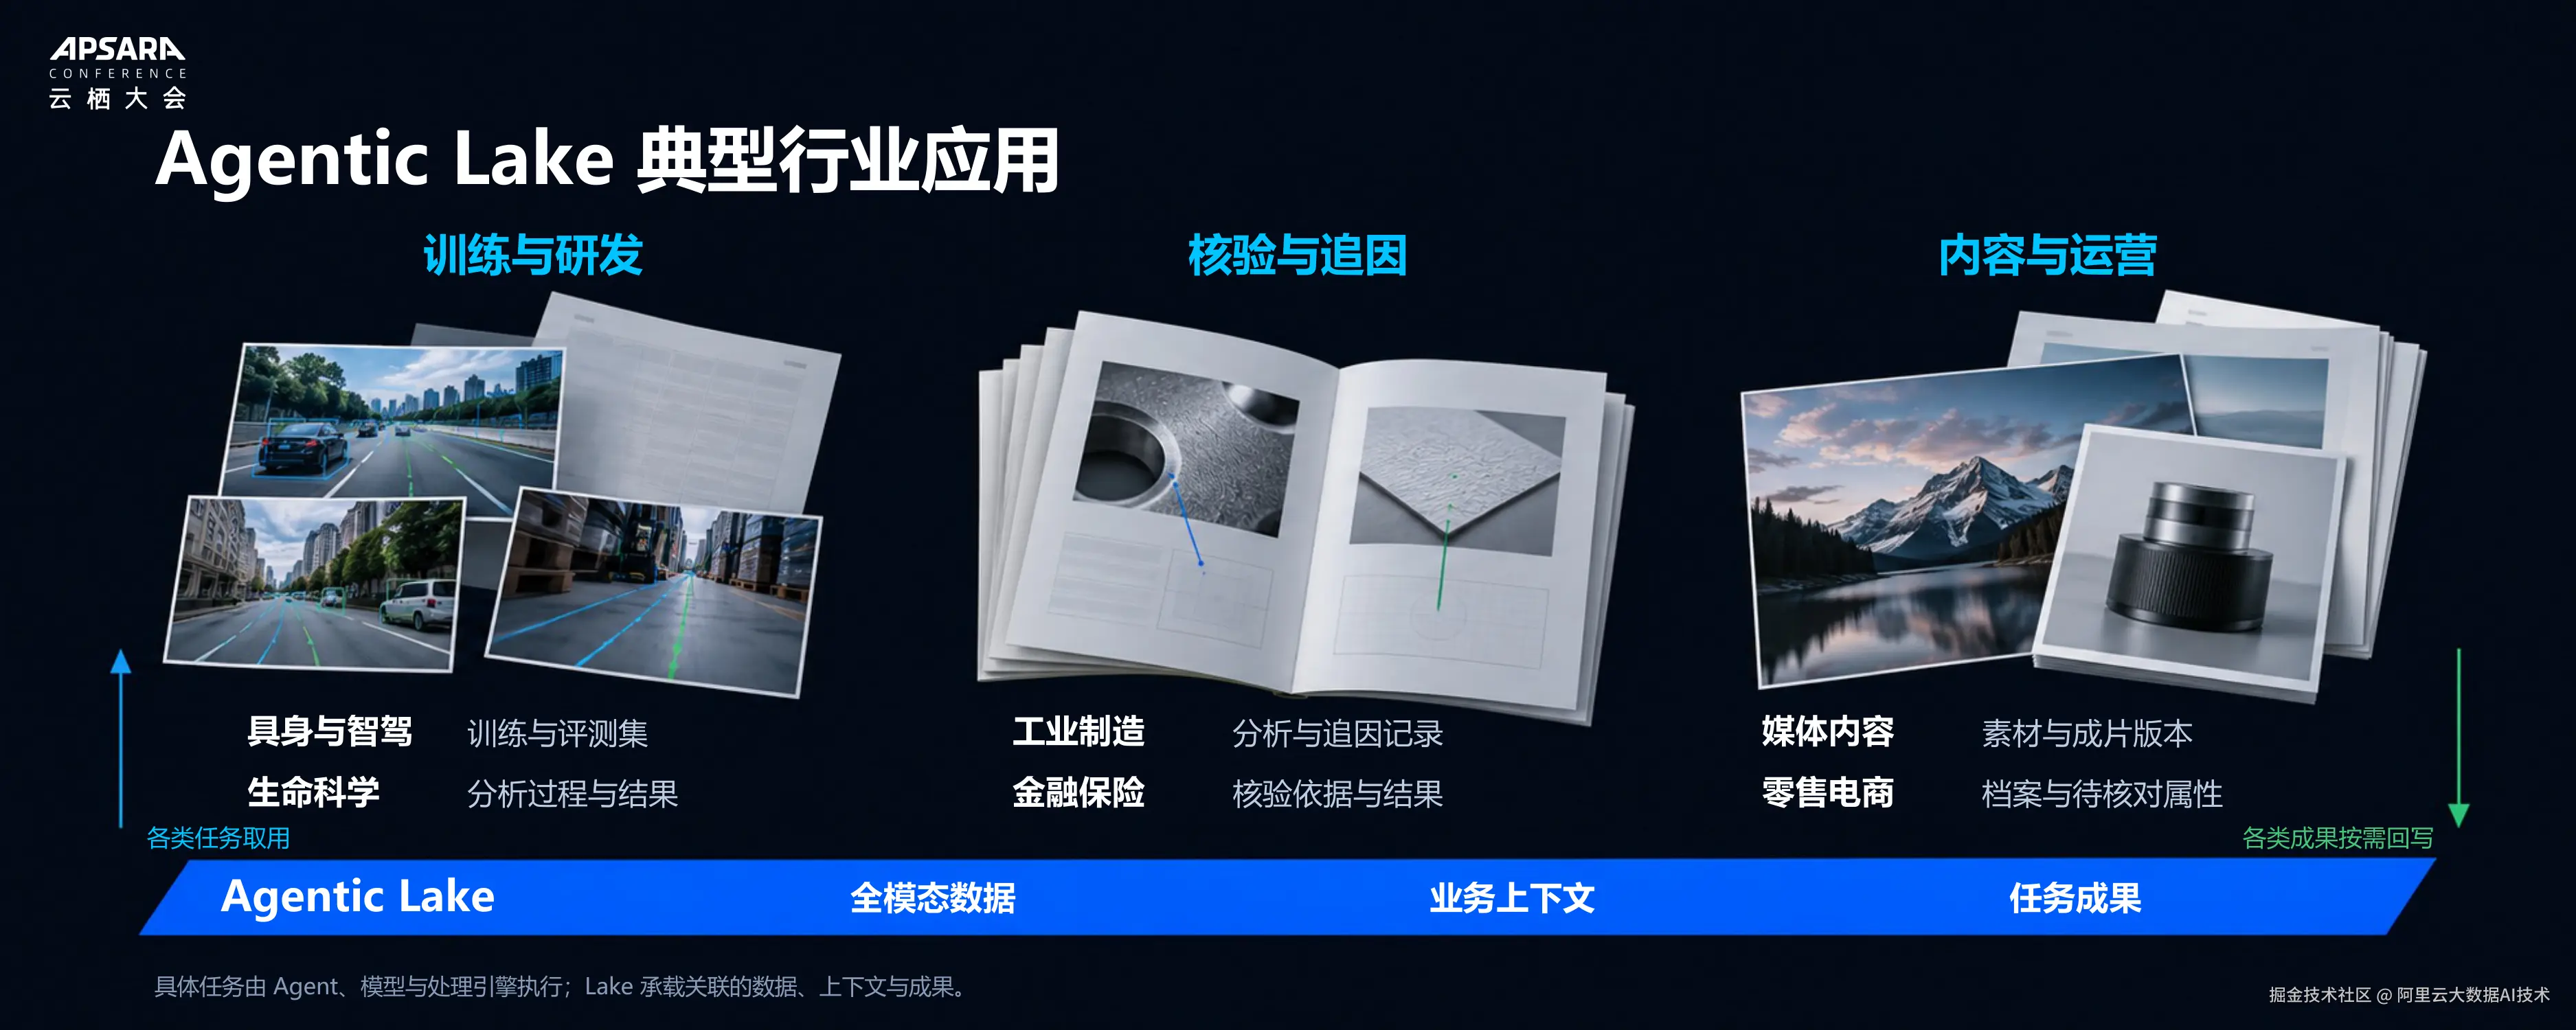
制造企业同样关心,如何通过整套 OpenLake 方案进一步提升业务效率。围绕这些需求,我们已经开展了不少交流。还有具身与智驾、生命科学、工业制造、金融保险、媒体内容、零售电商等典型行业方向。具体任务由 Agent、模型和处理引擎执行,Lake 则承载关联的数据、业务上下文与任务成果。
我们希望继续获得来自真实业务的输入,与各行业团队深入交流,让 OpenLake、Agentic Lake 持续迭代,更好地支撑企业场景中的应用,也期待在下一次交流中看到更多实际进展。