New API 源码解析:一个生产级 AI 网关的架构与实现
本文基于 QuantumNous/new-api(AGPLv3,fork 自 one-api)2026 年 10 月的源码通读整理。所有代码引用均标注文件与位置,方便对照仓库阅读。行号可能随后续版本演进变化,以函数名检索为准。
如果把一个自托管 AI 网关拆开看,它要解决的问题其实就三个:请求发给谁(调度)、怎么把话说得让所有模型都懂(协议)、怎么把钱算对(计费)。
市面上讲 New API 的文章大多在讲怎么部署、怎么配渠道。这篇不聊这些------我把整个仓库通读了一遍,从源码里挑出七组最值得学的机制,按"一次请求从进门到结算"的顺序讲清楚。读完你会发现:理解了 abilities 倒排索引、RelayKit 星型转换、预扣---结算---退款这套账本,就理解了这个项目大半的工程决策。
先用四个数字建立体感:
- 47:渠道适配器实现数量,覆盖 OpenAI / Claude / Gemini / Azure / Bedrock / Vertex 等 40+ 厂商;
- 4:原生互转的协议数------OpenAI Chat、OpenAI Responses、Anthropic Messages、Gemini;
- 500,000:内部计价单位换算(500K quota = 1 美元),所有账本的分子分母都是它;
- 60s:多节点部署时配置在节点间的同步周期------改一次配置,一分钟内全集群生效,不用重启。
一、整体架构:三段式分层 + 一条存储中间件带
整个系统是典型的"管理面 + 数据面"双平面网关:管理面(/api)承载控制台操作,数据面(/v1、/v1beta、/v1/tasks)承担对 AI 客户端的中继转发。
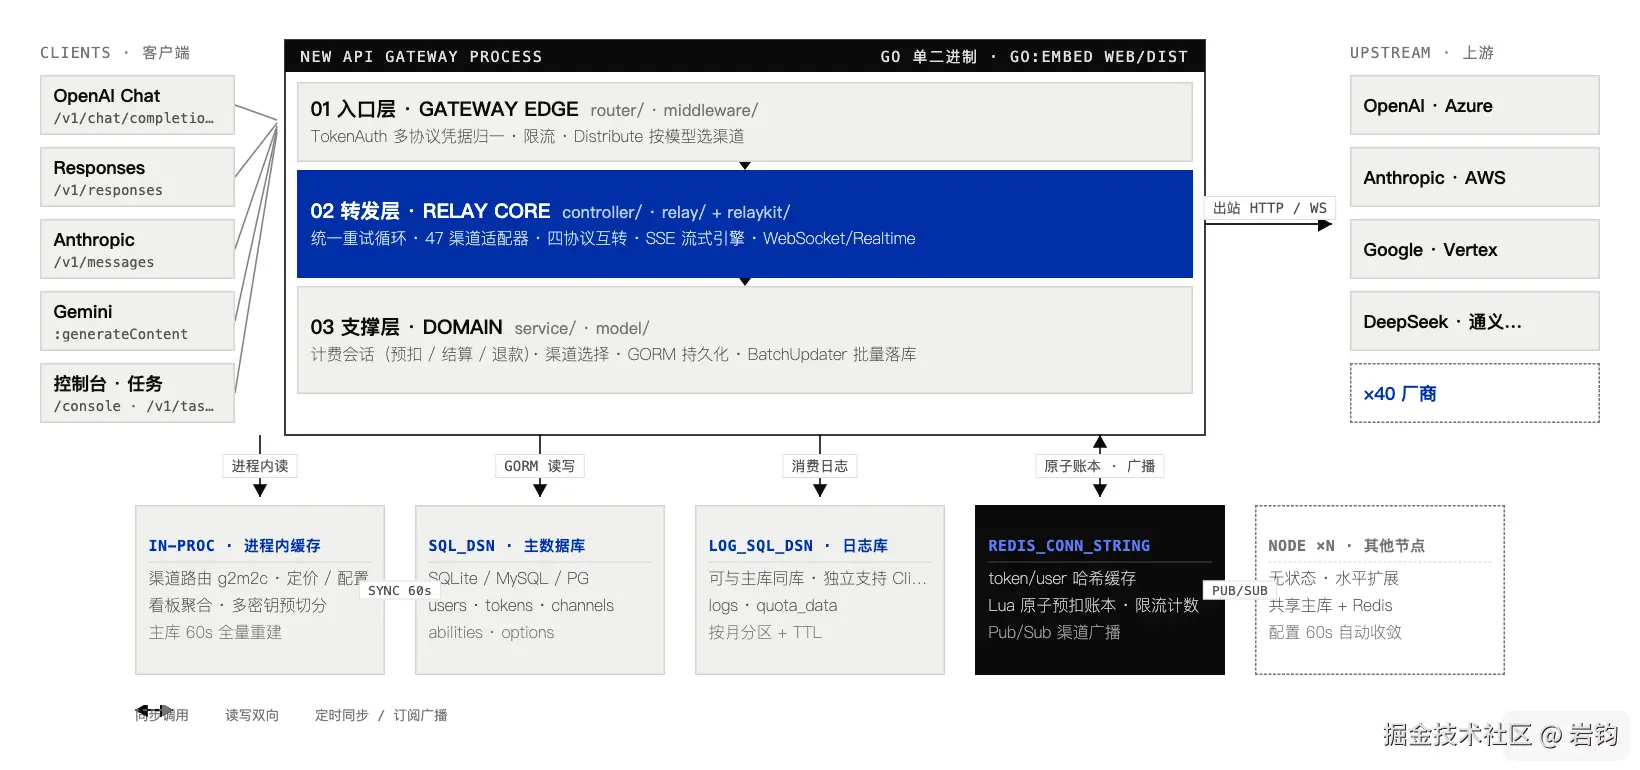
三个值得单独点出的工程决策:
- 单二进制交付 。前端 React 构建产物经
go:embed直接编译进 Go 可执行文件------docker run即起,Electron 桌面版也只是 spawn 同一个二进制。 - 协议转换与 token 计数拆成独立模块 。
relaykit/和tokenkit/两个 Go module 被明确禁止反向依赖宿主,可以单独构建、单独复用。relaykit 运行时只依赖 uuid / lo / gjson / sjson 四个库。 - 存储分了四个角色,不是一个数据库包打天下:进程内缓存管路由和定价(每 60 秒从主库全量重建)、主数据库管业务表、日志库可独立部署(重度用户上 ClickHouse,按月分区 + TTL)、Redis 做跨节点账本和广播。下文讲计费时会展开最后这一块。
二、一次请求的完整旅程
这是全文的主线。一次 POST /v1/chat/completions,从进门到结算,七步:
scss
01 TokenAuth   多协议凭据归一 → Redis 优先查令牌 → IP 白名单 → 注入用户上下文
02 限流         总数令牌桶 + 成功数滑动窗口(失败不占成功额度)
03 Distribute  解析 model → abilities 索引选渠道 → 取本轮使用的密钥
04 预扣费       tokenkit 本地估算输入 → 定价组装 → Redis Lua 原子扣减
05 重试循环     失败换渠道降优先级层 → BodyStorage 重放请求体
06 适配转发     ConvertRequest → DoApiRequest 发往上游
07 流式结算 SSE 逐帧转发回客户端 → 按上游真实 usage 结算有一个贯穿全链路的设计值得先记住:请求体在整个生命周期里只有一份副本 。common/body_storage.go 实现了一个可反复 Seek 的存储(小请求驻内存、大请求落盘),中间件解析 model、适配器做协议转换、透传模式、以及每一轮重试的"重放",都读自同一个存储;外发请求还会补齐 ContentLength 和 GetBody,让 net/http 传输层自身的重试也能完整重放------从根上杜绝"重试发出去一个空 body"。
记住这张七步图,后面讲的每个机制,都是其中某一步的展开。
三、渠道调度:abilities 倒排索引
这是整个项目我最推荐精读的设计。
3.1 为什么叫"倒排"
channels 表的自然形态是从主体到属性的正排存储:
ini
id=1  name="OpenAI-A"  models="gpt-4o,gpt-4o-mini,o3"  group="default,vip"
id=2 name="Claude-B" models="claude-3.5,claude-4" group="default"模型列表是渠道的属性------就像书的目录,按章节顺序排内容。但网关每次要问的是反过来的问题 :"谁能服务 gpt-4o?"用正排回答它只能全表拉出来、逐条解析逗号分隔的 models 字符串再过滤:O(渠道数 × 模型数),且 TEXT 字段上的 LIKE 查询完全无法走索引。
New API 的做法是预先把所有渠道的属性反向排列 ------以查询键为主键,物化成一张 abilities 表:
go
// model/ability.go
type Ability struct {
    Group     string `gorm:"type:varchar(64);primaryKey;autoIncrement:false"`
    Model     string `gorm:"type:varchar(255);primaryKey;autoIncrement:false"`
    ChannelId int    `gorm:"primaryKey;autoIncrement:false;index"`
    Enabled   bool
    Priority  *int64 `gorm:"bigint;default:0;index"`
    Weight    uint   `gorm:"default:0;index"`
}
复合主键 (group, model, channel_id) 把"哪个渠道可以在哪个分组服务哪个模型"这个三角关系压成了一次索引查询:
sql
SELECT * FROM abilities WHERE `group`=? AND model=? AND enabled=true;这就是倒排索引的思想------同 Google 搜索里"单词 → 包含它的网页"、Elasticsearch 里"term → doc_ids"是同一件事:以查询键为主索引,物化多对多关系,为高频反向查询预建索引 。它划算的根源在于这是"写少读多"的数据:渠道配置几个月改一次,每秒几十次请求都在查。构建倒排的函数就是同文件里的 AddAbilities()(读 Models × Group 笛卡尔积分块插入),渠道变更时事务内先删后插维护。
3.2 选择算法:三个机制
在倒排索引之上,是 model/channel_cache.go 的 GetRandomSatisfiedChannel(启用 Redis 时隐式开启内存缓存,全量渠道构建成 group2model2channels 二级 map):
- 优先级分层,重试即降级。这是全项目最巧的一处代码------重试次数直接复用为优先级层级下标:
go
// model/ability.go · getPriority
// 第 N 次重试自动取第 N 层优先级
priorities, _ := getPriority(group, model)   // 去重降序
targetPriority := priorities[retry]首轮落在最高优先级层,第一次重试自动降到次高层,超出层数固定在最低层。auto 分组更聪明:每个分组内先把所有层级耗尽,才切换下一个分组------一个"组下标 + 组内层级"的小状态机就实现了"同层重试 → 降层 → 跨组"的完整故障降级链,没有引入任何额外的状态对象。
-
平滑加权随机。权重全零就等概率;平均权重小于 10 就先放大 100 倍再随机------防止小权重渠道在整数运算里被取整"饿死",保证流量分配忠实于配置。
-
会话亲和 + 多密钥 。同一会话优先复用上次成功的渠道(保证上下文不漂移);一个渠道可以配多个上游密钥,轮询取用且游标持久化------缓存重建也不会从头再来;单个密钥被禁用写入状态列表,全部密钥失败才禁用整个渠道。
四、失败重试闭环:决策与副作用分离
重试的主循环在 controller/relay.go 的 Relay() 里,getChannel() 就在循环体内部------所以这个项目里"重试"的真实语义是换一个渠道再调度一次,而非原路重发:
go
for ; retryParam.GetRetry() <= common.RetryTimes; retryParam.IncreaseRetry() {
    channel, err := getChannel(c, info, retryParam)      // ① 每轮重新选渠道
    bodyStorage, _ := common.GetBodyStorage(c)           // ② 请求体重放
    c.Request.Body = io.NopCloser(bodyStorage)
    newAPIError = relayHandler(c, info)                  // ③ 转发
    if newAPIError == nil { return }                     //    成功即退出
    decision := service.DecideRelayRetry(...)            // ④ 决策
    service.RecordPolicyFailure(...)                    // ⑤ 策略事件落日志
    processChannelError(...)                             // ⑥ 副作用
    if decision.Action != "retry" { break }
}调度与重试是咬合在一起的,三个咬合点:
- 每轮循环就是一次调度------重试循环是驱动器,调度器是每轮的决策函数;
- 一个共享的数字 :
retry在重试侧是"第几次尝试"(时间维度),在调度侧是"用第几层优先级"(空间维度),一次传参完成了"重试即降级"; - 失败信息回流改写调度的输入 :每轮失败的副作用把渠道禁用后写
abilities.enabled=false并从内存缓存摘除------下一轮调度(以及所有并发请求的调度)直接看不到这个渠道。反向也成立:钉死渠道(sk-xxx-{id})或严格会话亲和失败时,DecideRelayRetry直接返回 stop,连重试资格都没有。
DecideRelayRetry(service/relay_error.go:20)本身值得整读------只有 99 行的文件里,9 个 return 分支按优先级排列:严格会话 → 钉死渠道 → 渠道级错误 → 不可重试标记 → 次数耗尽 → 2xx 排除 → 未知状态码 → 命中重试码 → 兜底不重试。
其中最值得学的是"决策与副作用分离 ":每个错误对象 NewAPIError 自带元标记(IsChannelError / IsSkipRetryError,relaykit/types/error.go:371/378),策略函数只读标记不做判断;错误在哪里产生,就在哪里把该说的说完 。默认重试码区间是 100-199、300-399、401-407、409-499、500-503、505-523、525-599------即 429 和大部分 5xx 可重试(换渠道),400、408、504、524 明确不重试(400 是客户端的错,换了也没用;超时类错误说明链路慢,立刻换渠道比原路等更划算)。每次 stop/retry 的决策原因全量写入请求日志的"策略事件"------出问题能回答"当时为什么没重试",这是可复盘性。
副作用是异步的:401 命中自动禁用码时用 gopool.Go 异步禁用渠道(不阻塞请求线程),并通过 Redis Pub/Sub 广播各节点掐掉该渠道上的 WebSocket 长连接。
五、适配器模式:47 Adaptors, One Contract
47 个渠道适配器共享同一个 Adaptor 契约(relay/channel/adapter.go),由 relay/relay_adaptor.go:50 的 GetAdaptor(apiType) switch-case 分发。设计取舍很聪明:格式转换(ConvertOpenAIRequest / ConvertClaudeRequest / ConvertGeminiRequest 等)做成可组合的纯函数,真正的网络 IO 委托给三个公共实现 ------relay/channel/api_request.go 的 DoApiRequest(L315)/ DoFormRequest(L345)/ DoWssRequest(L381)。
效果是:新接一个渠道,只需要关心三件事------URL 怎么拼、鉴权头怎么设、请求体长什么样。对比 relay/channel/openai/adaptor.go:192 和 relay/channel/claude/adaptor.go:116 的 SetupRequestHeader,你会发现两者除了鉴权头(Authorization: Bearer vs x-api-key + anthropic-version)和 URL 拼法不同,结构一模一样------差异被压缩到几个纯函数里,其余全部淹没在公共实现的复用中。claude/adaptor.go 只有 182 行,是"最小完整适配器"的活教材。
六、协议转换:OpenAI Chat 是星型枢纽
四种协议互转,注册表里一共 12 个转换器------但不是 12 条两两直连的网状线路,而是以 OpenAI Chat 为中心的星型拓扑 。真正写转换逻辑的只有 6 个(Claude↔Chat、Gemini↔Chat、Chat↔Responses 各一对),其余 6 个全是组合。看 relaykit/relayconvert/text_converter_registry.go 里 Claude→Gemini 的注册:
go
ID:      requestConverterClaudeToGemini,
Quality: TextConverterQualityDiscouraged,
Req: TextRequestSide{
    StepConverters: []string{
        ConverterClaudeMessagesToOpenAIChat,   // 第 1 跳:Claude → Chat
        ConverterOpenAIChatToGeminiContent,    // 第 2 跳:Chat → Gemini
    },
},它没有任何自己的转换逻辑,只是把两个已存在的直连转换器串成链。这就是星型的本质:n 个协议全互转需要 O(n²) 个转换器,以 Chat 为枢纽只需要 O(n),其余路径用组合覆盖------新增一个协议只要写 2 条(该协议 ↔ Chat),存量路径自动复用。
为什么选 OpenAI Chat 做枢纽?它是客户端生态的事实标准(绝大多数 SDK 说的是它),又是表达力最全的中间格式(工具调用、多模态、流式增量都能映射),而且 Chat↔Responses 同属 OpenAI 家族,这一对的质量标了 good(其余 fair)。代价是两跳可能丢字段(每次转换都是一次有损翻译),所以 Claude↔Gemini 这条纯两跳路径被标为 discouraged。
实现上分四层(relaykit/relayconvert/,约 2600 行):
- 注册表与路由 :转换器按
(From, To)注册进路由表,注册时做了很硬的防御性校验(Convert与StepConverters互斥、step 链必须首尾相接)------错误的转换矩阵在启动期就被panic挡掉; - 请求侧执行链 (
executeRequestSteps):先抽工具、逐跳转换、再装回工具。工具调用是四种协议差异最大的点,先统一抽成一份"工具集合",转换过程不碰它,最后按目标协议重新编码------避免每一跳都处理工具差异; - 流式响应侧状态机 (
ResponseStreamState):多跳流式不是"一行转一行",而是每跳持有独立状态、一个上游事件可能被放大或压缩为多个、收尾补发的终止事件继续流经后续步骤; - 宿主粘合层 (
convmeta.Meta):转换器自己没有网络、没有计费,一切会话上下文(上游模型名、用户设置、推理参数状态)通过这个接口传递,宿主的RelayInfo实现它。
所有无法映射的字段会生成结构化诊断(code/path/severity)落进请求日志;损耗策略 ToolLossPolicy 三档可选:allow(默认)、safe(请求阶段遇 error 级损耗即报错)、strict(任何损耗都拒绝)。对业务敏感的场景开 strict------宁可失败,不可静默丢。
七、SSE 流式引擎:三协程 + 一个主循环
流式转发是网关最容易出事的地方。整个引擎在 relay/helper/stream_scanner.go(316 行),所有渠道共用这一个入口 StreamScannerHandler(L83)------每个渠道只传进来一个闭包(负责把自家上游格式翻译成客户端格式),引擎统一处理并发、超时、保活、断开这些通用难题: 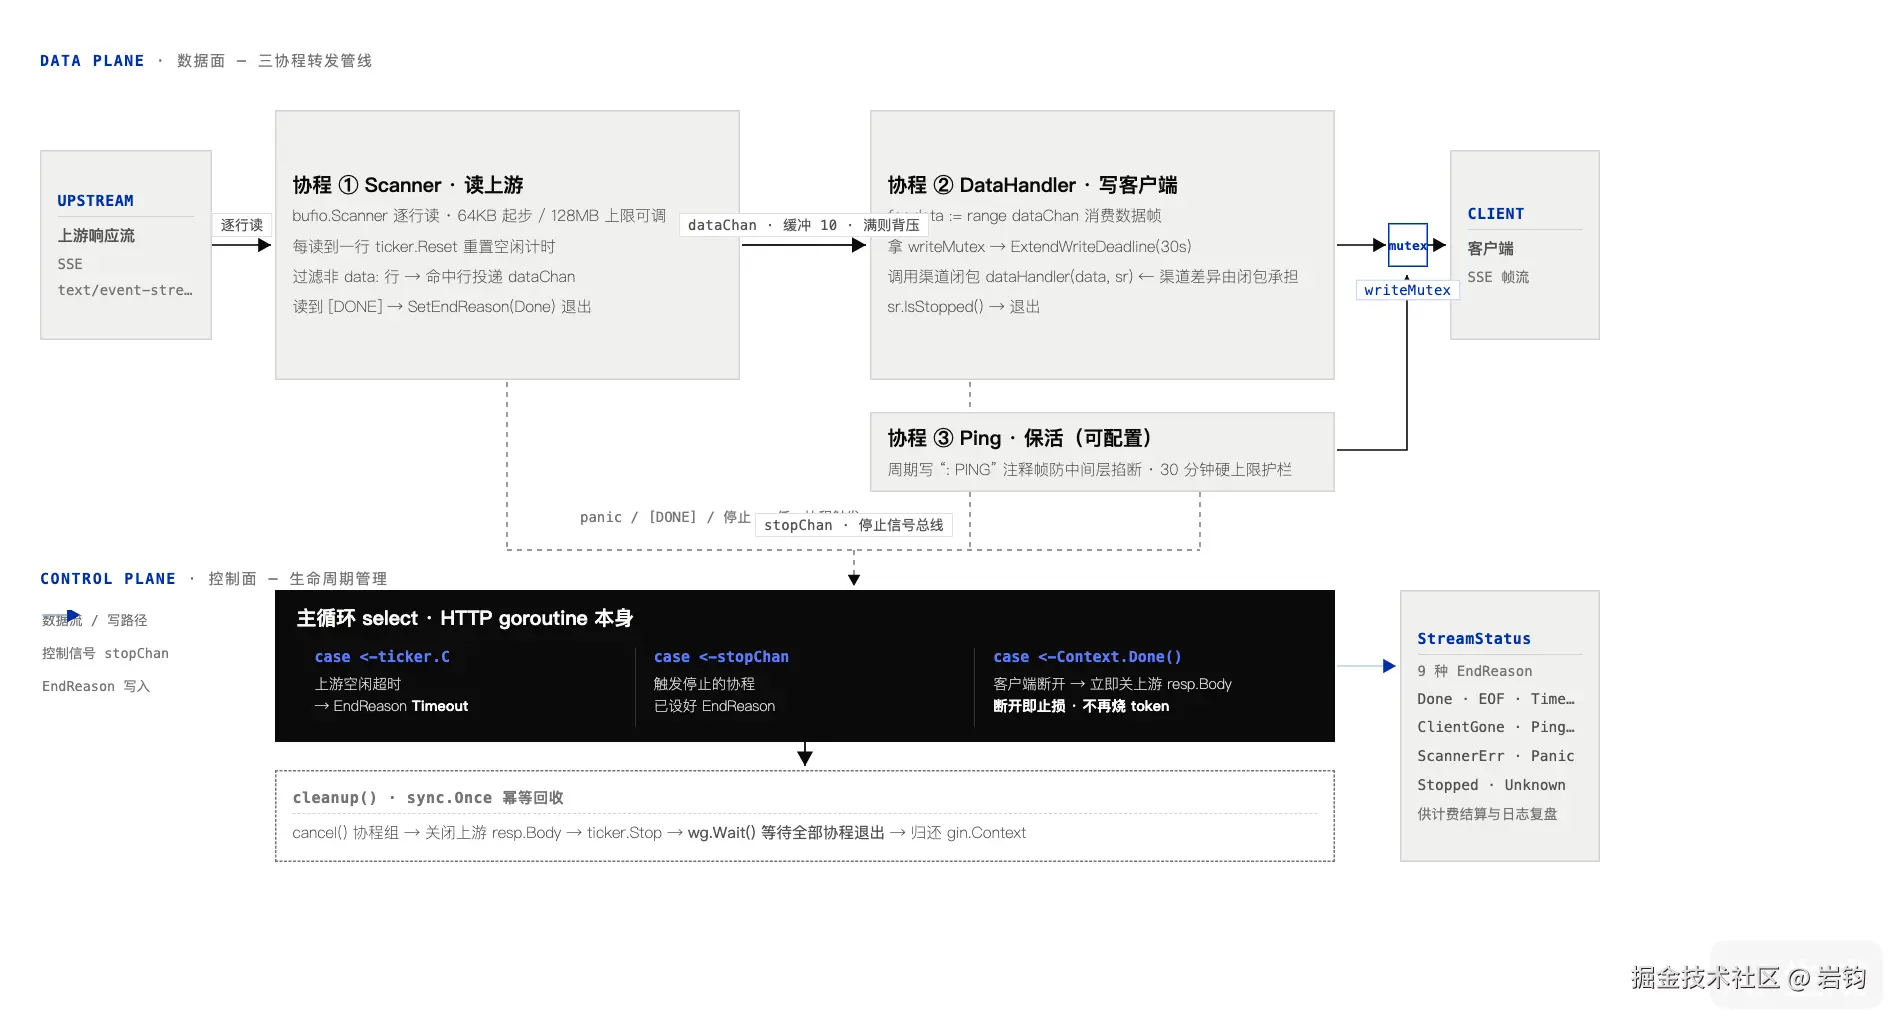
几个关键的防御设计:
- 断开即止损 :主循环监听客户端断开,
cleanup()里立即关闭上游resp.Body------不为一个已经放弃的请求继续烧钱烧 token。这是长连接 + 计费场景下最重要的止损设计; - 每帧写超时 :DataHandler 每次写回前
ExtendWriteDeadline给 30 秒写超时------慢客户端拖不死协程; - 写锁是请求内的 :
writeMutex是函数局部变量,只防止 ping 与 dataHandler 交叉写同一个 ResponseWriter,跨请求之间没有共享锁; - 协程回收严谨 :
cleanup用sync.Once保证幂等,wg.Wait()等三个协程全部退出后才把 gin.Context 归还连接池------防止协程引用被复用的 Context 产生串号写; - panic 全覆盖 :三个协程都带 recover 并把原因写进统一的
StreamStatus(9 种 EndReason),供计费与日志复盘。
还有一个容易忽略的边界:引擎入口在 compatible_handler.go:151 的 httpResp.StatusCode != 200 检查之后 ------上游拒绝(429/500)时客户端还没收到任何字节,构造错误回到重试循环换渠道毫无成本;而一旦 200 进入引擎、SSE 响应头写给客户端,HTTP 响应已提交,中途断流再也不可能重试了,只能记录 EndReason 并按已收数据结算。这条分水岭把"重试"与"流式"两个世界干净地切开了。
八、计费体系:预扣 --- 结算 --- 退款
计费是一个完整生命周期,代码三角是:relay/helper/price.go(预扣估算)、service/text_quota.go(实际计算)、service/billing.go(差额结算)。
8.1 预扣:一份押金
请求进入重试循环前,PrepareRequestBilling(relay/request_billing.go:25)做四件事:敏感词检查 → tokenkit 本地估算输入 token(OpenAI 家族 tiktoken 精确计数,其余家族按 10 类文本特征加权估算)→ 组装定价 → 预扣额度:
arduino
预扣 = 估算输入 token × 预扣倍率 × ModelRatio × GroupRatio      // 按量计费
预扣 = ModelPrice × QuotaPerUnit × GroupRatio // 按次计费注意预扣只算输入 (输出未知),这是刻意的保守估计------它是一份押金,不是最终账单。三个特殊处理:余额高于"信任额度"(默认 $10)的用户直接跳过预扣 (高并发下的账本压力优化,结算时一次性校准);免费模型跳过整个账本流程;阶梯表达式计费会在预扣时冻结一个计费快照(表达式哈希、命中档位、分组倍率),重试换渠道也复用同一份,保证一次请求只按一套规则算钱。
预扣的物理实现是 Redis Lua 脚本(model/quota_reserve.go:19)------"检查余额"和"扣减"在同一个脚本内原子完成:
lua
if HGET key 'Quota' < amount then return 0 end   -- 不足 → 明确拒绝
HINCRBY key 'Quota' -amount                      -- 原子扣减
8.2 结算:整单重算 + 差额校准
响应完成后,calculateTextQuotaSummary(text_quota.go:227)用上游返回的真实 usage 把整单完整算一遍(全程 shopspring/decimal 防浮点漂移):
markdown
实际费用 = (输入明细 + 输出 × CompletionRatio) × ModelRatio × GroupRatio
输入明细 = 基础 token
         + 缓存读 × CacheRatio            // gpt-4o=0.5, claude=0.1
         + 缓存写(5m/1h) × 分档倍率         // Claude 长效缓存更贵
         + 图片 token × ImageRatio
+ Gemini 音频独立输入价一个必须处理的语义陷阱:Claude 与 OpenAI 的 usage 口径不同 ------OpenAI 的 prompt_tokens 包含缓存部分(要剔除再按缓存价单算),Claude 的 input_tokens 本不含缓存(不能减)。代码里 IsClaudeUsageSemantic 的两组分支(L305/L314)就是为此存在,搞错这对分支缓存钱就会算重。OpenAI 的 cache-write 还会报未调整的前缀数导致基础量为负------L344 有一处 clamp 到 0 的防御。
然后是差额结算(billing.go:52):delta = 实际费用 − 预扣值,正数补扣、负数退款、为零不动。注意结算时输入部分也被重算了 ------不是"预扣的输入费保留不动、只补输出费",整单是一个原子账目,预扣只是临时押金。类比酒店:预扣是前台刷的预授权,结算是退房时按实际消费(房费 + minibar + 延迟退房费)开的全额账单,预授权多退少补。
结算的两步提交(BillingSession.Settle)防的是双退:资金先提交并置 fundingSettled,此后令牌调整失败只记日志,且 settled 标志让后续 Refund 直接短路------资金已结算的会话永远不可能再被退款 。全失败路径的 Refund 则是幂等(标志位)+ 异步(协程池)+ 不可重试(钱包退款非幂等,宁可漏退日志可见,不可重复退款)。
8.3 Redis 不是缓存,是权威账本
这是计费体系里最值得展开的一层。看一个典型函数 DecreaseUserQuota(model/user.go:1387):
go
func DecreaseUserQuota(id, quota int, db bool) error {
    gopool.Go(func() { cacheDecrUserQuota(id, quota) })   // ① Redis 立即生效
    if !db && common.BatchUpdateEnabled {
        addNewRecord(BatchUpdateTypeUserQuota, id, -quota) // ② DB 5 秒后聚合追平
        return nil
    }
    return decreaseUserQuota(id, quota)
}
预扣/结算永远先改 Redis(毫秒级),数据库由 BatchUpdater 5 秒后追平。在这 5 秒窗口里,余额检查与原子预扣全部以 Redis 为准 ------两个并发请求不会因为 DB 延迟而双扣。Redis 不可用时降级为 DB 条件更新(UPDATE ... WHERE quota >= ?,影响行数即成败)保持无竞态。
配套的细节都是围绕"账本不能错"设计的:
- 充值也必须补缓存 (
syncCreditUserQuotaCache):授信若绕过缓存,新充的额度在缓存过期前"看不见",会被误判余额不足------借方贷方必须走同一个账本; - fence 变更栅栏 (
token_cache.go:28):token 变更写库前先SET fence EX 10s再删缓存,持有变更前快照的读者无法在缓存清除后立刻把旧值写回------10 秒罩住"DB 写入 + 读者读改写"的窗口; - auth version 地板:改密等限制性变更用单调递增版本号做更强的栅栏,旧会话快照永远无法重新授权------这是安全属性,时间型栅栏罩不住;
- live hash 只刷 TTL、绝不覆盖字段 :任何 DB 快照都不许覆盖热哈希的
RemainQuota------预扣改的是 Redis 先行,DB 快照必然更旧,覆盖一次就丢一次扣减。
8.4 钱不够扣怎么办:三道防线 + 一个哲学
结算补差超出余额时,WalletFunding.Settle 没有失败分支 ------无条件扣,余额变负数。这不是疏漏:所有可能导致欠费的路径要么已被事前挡住(进门检查 403、预扣原子拒绝、图片任务事中补扣),要么就是设计上故意放行的 ------reserveFunding 的代码注释写得很直白:
全额无条件扣减,余额不足的部分记为欠费(余额可为负),不中断请求,保证日志记录的预扣额度与用户余额的实际变动始终对账一致。
主要来源是信任旁路(余额充足跳过预扣的单子实际花超了)和流式响应中途无法反悔(不能给用户发半截回答再插一条"余额不足")。欠费之后的处置:余额显示负数、下一次请求进门即 403、审计日志可追溯。欠费上限天然被"单笔请求最大费用"封顶------这个取舍保住了三样东西:请求路径吞吐(不阻塞)、账目对账一致性(永不双扣漏记)、用户体验(已开始的响应不中断)。宁可承担一单欠费,也不把每个请求都阻塞在预扣上。
九、鉴权与访问控制:双平面 + 双计数器
数据面(/v1/*)走 TokenAuth(middleware/auth.go:528),第一步是多协议凭据归一 :Claude SDK 的 x-api-key、Gemini SDK 的 ?key=、Realtime WebSocket 的 Sec-WebSocket-Protocol: openai-insecure-api-key.{key}、MJ 代理的 mj-api-secret,全部被识别并统一改写为标准 Bearer------一把网关签发的 Key 通吃四种协议 SDK。随后查令牌(Redis 缓存键为 Key 的 HMAC,明钥不落 Redis)→ IP CIDR 白名单 → 用户缓存 → 两级分组决策 (令牌组必须在用户组可用集合内,防越权用高级分组)→ 注入模型白名单、auto 分组、钉渠道约束等上下文。sk-xxx-{channelId} 钉渠道后缀仅管理员可用。
控制面(/api)是三层凭据:PAT(数据库只存 SHA-256 指纹,路由级 scope 声明表 fail-closed ------未声明的路由一律拒绝)、会话(短效 JWT + 刷新 Cookie + auth_version 提升令旧会话失效)。细粒度权限用 Casbin,但模型刻意极简------纯 ACL 无角色继承段 ,角色编码进 subject 字符串,判定链是:root 短路 → 未注册权限拒绝 → 用户级显式覆盖(显式拒绝终局)→ 角色基线兜底。权限资源由代码注册表声明,多节点由 StartPolicySync 周期 ReloadPolicy 保证收敛。
限流在鉴权之后、选渠道之前,模型请求限流维护两个独立计数器 :总数限制用令牌桶(允许突发、平滑速率),成功数限制用 List 近似滑动窗口------且只有响应成功才计数,失败不占用成功额度(429/超时本就不消耗上游成功配额,计进去等于自己跟自己过不去)。Redis 模式下全节点共享计数;内存模式下每节点独立,部署时需按拓扑评估总额。
为什么需要限流?五个层次的理由里最硬的两条:上游配额保护 (防止单用户烧光你花钱买的上游资源,把"公共池"变成"按人头分配的额度")和成本失控防护(LLM 按 token 计费且输出无上限,一个写错的死循环脚本可以在一分钟里烧完一个月预算------限流是账单之外的第一道闸)。
十、三条工程哲学
最后,从源码里淘三条可以直接带回自己项目的工程启示:
1. 单副本可重放 。BodyStorage 一份 Seek-able 存储贯穿鉴权、转换、透传、每轮重试,外发请求补齐 ContentLength 与 GetBody。带来的直接收益:重试零拷贝、语义绝对一致(重试发出的请求体和第一次完全相同)。很多时候"数据只建一份、到处只读"比到处深拷贝便宜得多也安全得多。
2. 重试即降级 。重试次数复用为优先级层级下标,一次传参就实现了"同层重试 → 降层 → 跨组"的完整故障降级链。不一定所有状态都需要新对象------把两个本就存在的量(尝试次数、层级下标)语义打通,复杂度就消失了。
3. 强弱一致分流。配置类(options、渠道路由)走最终一致(60s 全量重建,免重启);账本类(余额)走强一致(Redis Lua 原子操作,DB 异步追平)。按数据性质分流一致性等级,而不是一刀切上分布式事务------窗口期内以 Redis 为权威,就同时拿到了吞吐和正确性。
结语
New API 的本质,是把"多上游、多协议、多格式"这个分布式问题拆成渠道调度、协议转换、计费账本三条可独立演化的主线,再用一份可重放的请求体和一套可复盘的重试策略把它们串成高可用的数据面。
如果时间有限只读三处代码,按这个顺序:model/ability.go 的 getPriority + service/channel_select.go 的 RetryParam(理解"重试即降级");relay/helper/stream_scanner.go 全文 316 行(理解流式的全部坑位);model/quota_reserve.go 的 Lua 脚本 + service/billing_session.go 的 Settle/Refund(理解账本的正确性从哪来)。