晚上八点,家长的黄金咨询时段,运营突然在群里刷屏:小E卡住了。
我看了一眼后台,症状比"卡住"难看得多。有的家长转圈三秒然后看到一句报错;有的等了九秒,换来同一个错误;还有一位家长运气好,等了五秒拿到了答案------而这个问题本地测试从来没有超过两秒。
那天晚上我翻自己代码,找到了答案:调用模型的地方,我包了一层 try / except Exception,失败就重试三次。写的时候我觉得这叫"稳妥",实际上它是我后面所有灾难的总开关:网络抖动,它重试;限速 429,它重试;我自己的 Key 配错了,它也重试三次------每一次都完整计费,每一秒都让家长等。
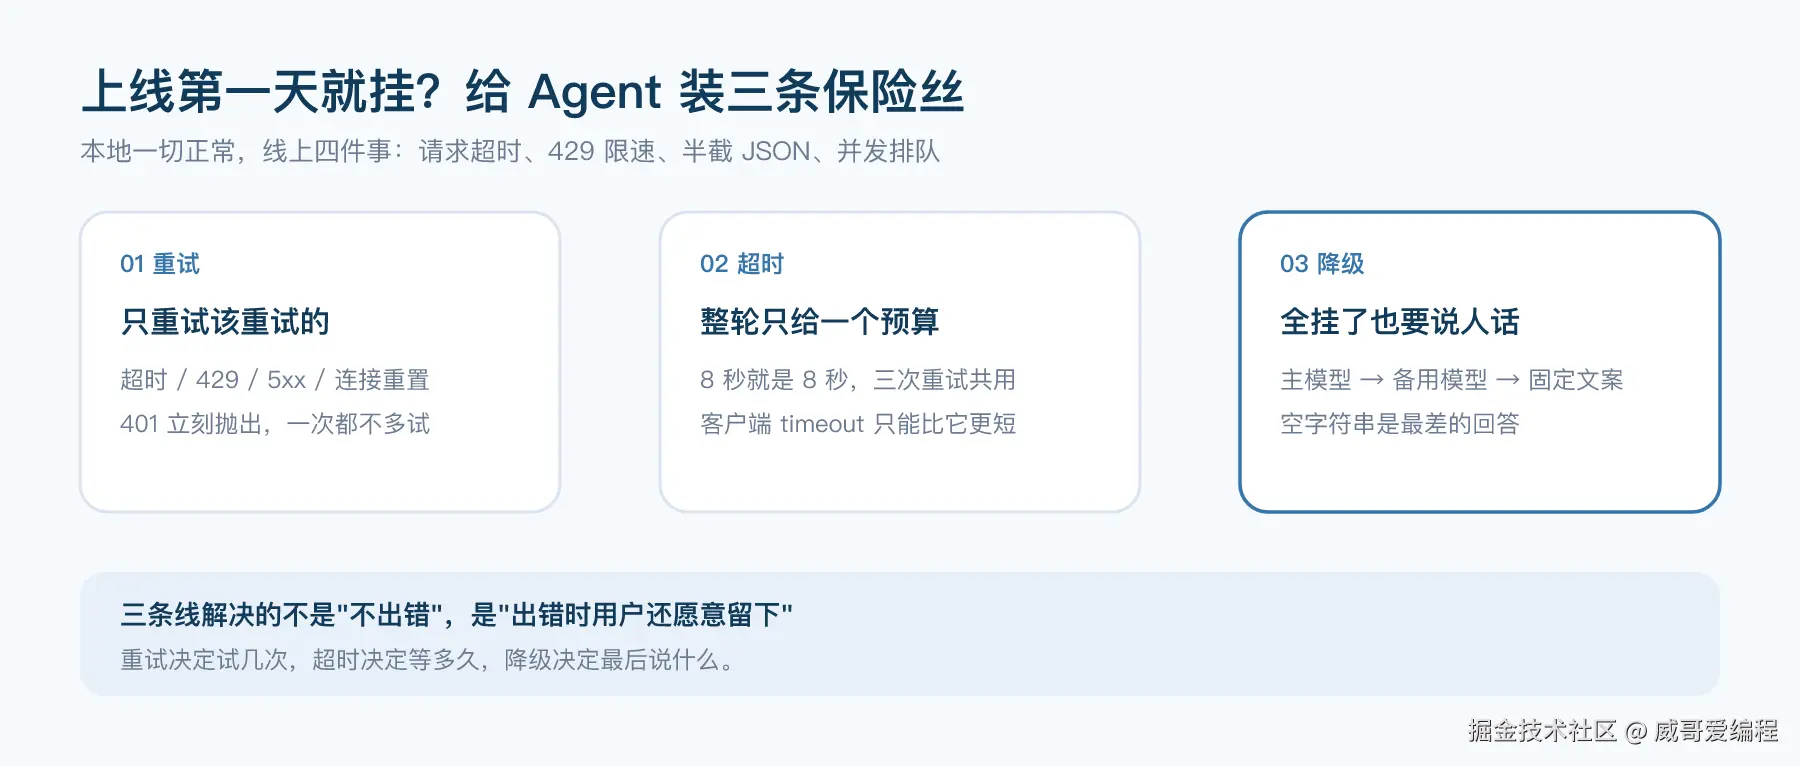
这一篇就讲这件事怎么根治:给小E装上重试、超时、降级三条保险丝,让程序在"出错"这件事上表现得像个成年人。
一、先扫盲:错误分三种性质,处置方式完全不同
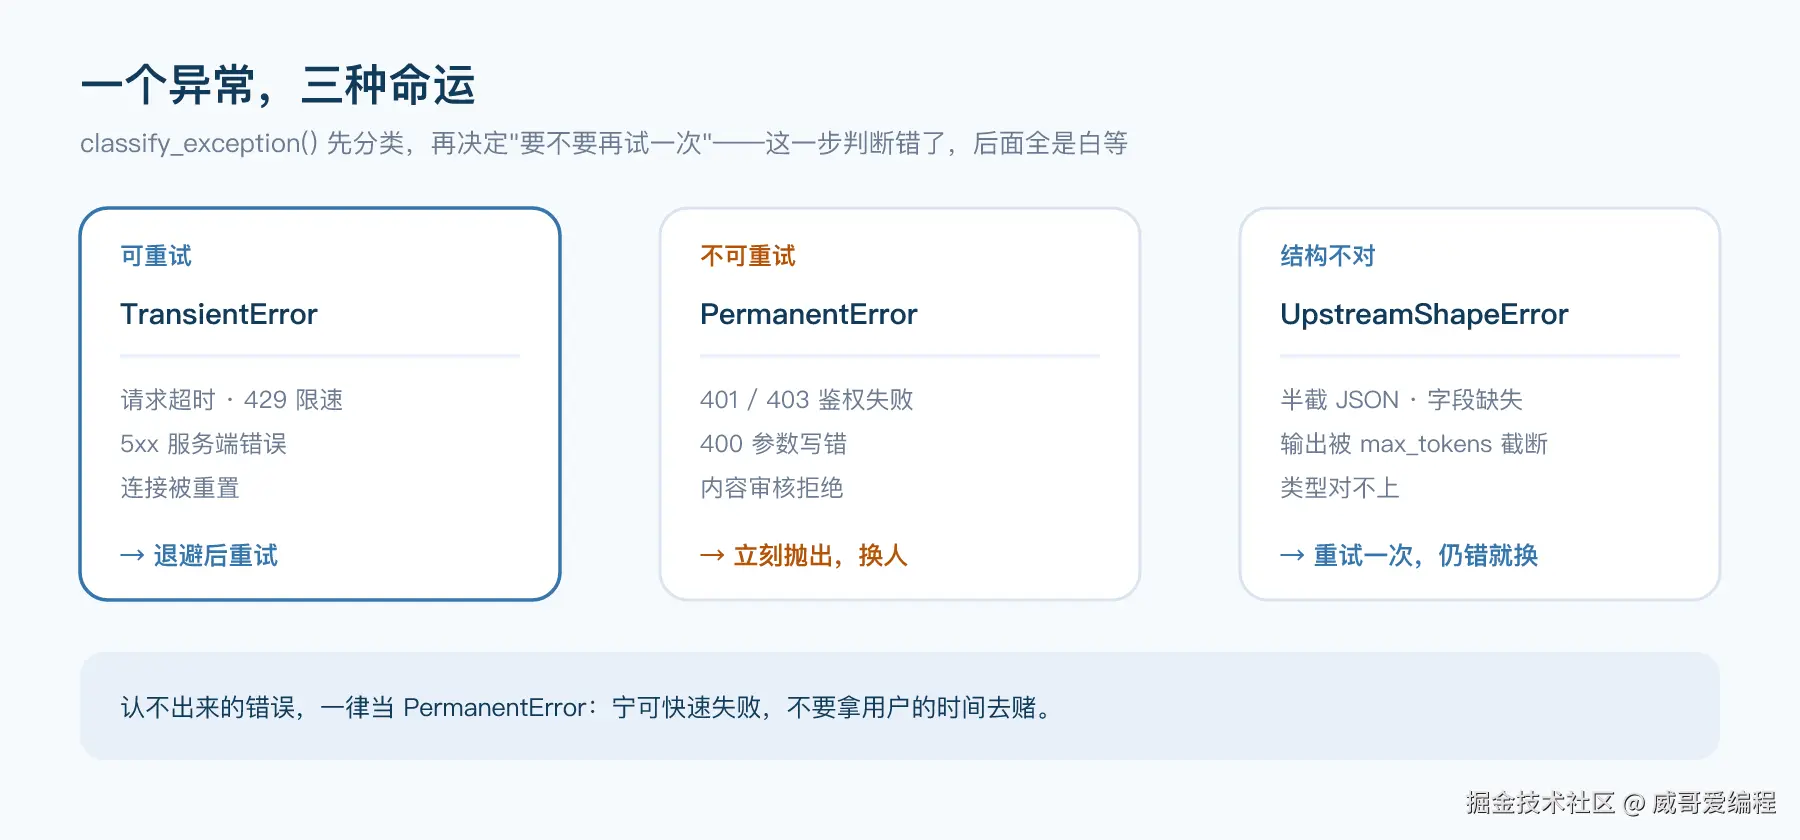
第一种:临时故障,等一下再来可能就好。 超时、429 限速、5xx、连接被重置。这类错的特点是"这次失败可能是偶然的"------隔壁机器同样的请求就成功了。处置方式:退避一下,重试。
第二种:确定性失败,再来一万次也一样。 401/403 鉴权失败、400 参数写错、内容审核拒绝。你的 Key 过期了,重试三次的结果是三张一样的 401,外加三次计费和用户多等的九秒。处置方式:立刻停,别碰重试按钮,要么换 Key 要么改参数。
第三种:结果回来了,但结构不对。 半截 JSON、字段缺失、输出被截断。它经常是网络抽风或 max_tokens 卡住的副产物,重试一次常常就好;但如果反复出现,说明该改的是提示词或参数,不是重试次数。所以我把它单独列成一类:可以重试,但要单独统计------重试率一高就是警报。
"全局 try/except 重试三次"为什么是最糟糕的方案
因为 except Exception 意味着它不区分上面三种性质。后果按严重程度排:
- 用户多等。 每次重试之间还有退避等待。三次重试,用户实际等的是"三次请求 + 两次等待",九秒起步,而结局往往是同一句 401。
- 钱多花。 每次重试都是一次完整的输入 + 输出计费。这不是保险,是给已经失败的事情再买两份。
- 真问题被埋掉。 如果 80% 的请求都在靠重试续命,
try/except里根本看不出来------没有日志、没有分类、没有统计,你以为系统健康,其实在 ICU。
重试从来不是问题,无差别重试才是。
超时要设在客户端还是服务端
都要,而且它们的分工必须清楚。服务端网关的超时你改不了;客户端 timeout 是你在构造模型时传的那个数,它管的是单次 HTTP 请求,不是整轮对话;真正兜底的应该是在你自己代码里划的一条线------deadline,"这轮请求总共只给 8 秒"。
最容易被坑的地方在这里:timeout=20 加上 SDK 自带 max_retries=2,最坏耗时是 20 × 3 = 60 秒,因为每次重试都重新计时。用户看到的不是 20 秒上限,是一分钟白屏。所以规则只有一句:谁更短谁说了算------单次 timeout 必须服从整轮 deadline。
重试会不会把副作用执行两遍
会。重试的语义就是"同一个请求可能被发两次"。查课表这种读接口无所谓;但"扣一次课时""发送课程提醒"这种带副作用的操作,重试成功的那一刻,家长会收到两条一样的消息。解法不新鲜:给操作带上唯一的 request_id,服务端见过的直接返回上次的结果,或者本地先落一张幂等表。本篇的示例都是读接口,但这条原则请抄在墙上。
退避为什么必须带抖动
想象一个线上课开售的瞬间:一千个家长同时提问,DeepSeek 返回了一波 429。如果所有机器的第一次重试都精确地等 0.2 秒------那 0.2 秒之后,又是一千个请求整齐地撞上去,429 再来一遍。抖动(jitter)就是给退避时间加一点随机量,把"整齐的重试大军"打散成涓涓细流。一行代码的事,防的是雪崩。
二、工程目录
ruby
08-稳定性/
├── src/
│   ├── settings.py   # 复用第 2 篇
│   ├── llm.py        # 复用第 2 篇(唯一改动:max_retries 从 2 改为 0,见下文)
│   ├── errors.py     # 异常三分法 + classify_exception()
│   ├── retry.py      # 指数退避 + 抖动 + 总预算 + AttemptLog
│   ├── timeout.py    # Deadline 整轮预算、单次 timeout 切片
│   ├── fallback.py   # 降级链:主模型 → 备用模型 → 人话文案
│   ├── budget.py     # 单次 / 单会话 token 护栏
│   ├── guard.py      # safe_ask():四个闸门串成一条线
│   └── fakes.py      # 按剧本演出的假模型
├── tests/            # 40 个离线用例
├── demo.py
└── pytest.ini / requirements.txt / README.md / .env.example / .gitignore
settings.py 和 llm.py 原样从第 2 篇复用------除了一行:llm.py 里写死的 max_retries=2 改成了默认 0。原因马上讲。
三、errors.py:先分类,再谈重试
python
class AgentError(Exception):
    """所有"我方定义"的异常的共同祖先。"""

    kind = "unknown"
    retryable = False

    def __init__(self, message, *, status_code=None, cause=None):
        super().__init__(message)
        self.status_code = status_code
        self.cause = cause
        self.logs = []   # 由 call_with_retry 回填,失败也要留下"试过几次"


class TransientError(AgentError):
    kind = "transient"
    retryable = True


class PermanentError(AgentError):
    kind = "permanent"
    retryable = False


class UpstreamShapeError(TransientError):
    """半截 JSON、字段缺失。继承 Transient:它常常重试一次就好。"""
    kind = "shape"
三个决定值得说透:
第一,retryable 是重试层唯一要看的开关。 分类逻辑全部住在 classify_exception() 里,重试层只数次数、等一会儿、再打一次。职责干净了,测试才写得出来。
第二,UpstreamShapeError 继承 TransientError。 半截 JSON 多半是流被截断,重试一次往往就好。单独建类不是为了换处置方式,是为了在日志里把"网络抖"和"模型没按格式来"分开------前者查网络,后者改提示词。
第三,认不出来的错误一律当不可重试。 未知错误重试三次,只是把一个故障变成三个故障。宁可快速失败、留一条清楚的日志,也不要拿用户的时间去赌。
python
def classify_exception(exc) -> AgentError:
    """把任意异常翻译成我们的三类之一。"""
    if isinstance(exc, AgentError):
        return exc
    for mapper in (_from_openai, _from_requests, _from_httpx):
        mapped = mapper(exc)
        if mapped is not None:
            return mapped
    if isinstance(exc, (TimeoutError, ConnectionError)):
        return TransientError(f"底层网络异常:{exc}", cause=exc)
    mapped = _from_text(exc)          # 类型认不出,按报错文本里的关键词认
    if mapped is not None:
        return mapped
    return PermanentError(f"未识别的错误,按不可重试处理:{type(exc).__name__}: {exc}",
                          cause=exc)
_from_openai 是主路径------DeepSeek 走 OpenAI 兼容协议,429 进来时是 RateLimitError(带 status_code),超时是 APITimeoutError。这里有个必须写注释的顺序问题:APITimeoutError 是 APIConnectionError 的子类,先判父类就会把"超时"写成"连不上",日志里查不出真凶。
四、retry.py:只重试该重试的,并且留下证据
python
def backoff_delay(index, *, base_delay=0.2, jitter=0.1, rand=random.random):
    """第 index 次失败之后该等多久(index 从 1 开始)。"""
    raw = min(MAX_DELAY, base_delay * (2 ** (index - 1)))
    factor = 1.0 + (rand() * 2.0 - 1.0) * jitter   # ±10% 的随机浮动
    return max(0.0, raw * factor)
指数退避 + 抖动,一共就两行。rand 是个可注入的随机函数:真实环境传 random.random,测试里传一个固定值,就能把"纯指数"和"带抖动"分别断言出来。
python
def call_with_retry(fn, *, attempts=3, base_delay=0.2, jitter=0.1,
                    max_total_wait=2.0, deadline=None,
                    sleep=time.sleep, clock=time.monotonic, rand=random.random):
    for index in range(1, attempts + 1):
        if deadline is not None:
            deadline.check()          # 预算见底就别再发请求了

        started = clock()
        try:
            value = fn()
        except Exception as exc:
            error = classify_exception(exc)
            logs.append(AttemptLog(index, False, clock() - started,
                                   error.kind, str(error)[:160]))
            error.logs = list(logs)   # 失败也留痕,catch 之后还能打印

            if not error.retryable:
                raise error from exc  # 401 走这里:一次都不多试

            last_error = error
            if index >= attempts:
                break

            delay = backoff_delay(index, base_delay=base_delay, jitter=jitter, rand=rand)
            if deadline is not None:
                delay = min(delay, deadline.remaining)
            if waited_total + delay > max_total_wait:
                raise last_error from exc   # 预算不够再等,直接放弃
            sleep(delay)
            waited_total += delay
        else:
            logs.append(AttemptLog(index, True, clock() - started, "ok", ""))
            return RetryResult(value=value, logs=logs)
raise last_error三个保险丝全在这个函数里:只重试 retryable ;退避带抖动 ;总预算 max_total_wait------累计等待一旦要超预算就放弃,把最后一次的真实错误抛出去,而不是让用户以为又点了三次。
我最想让你注意到的是返回值:不是裸结果,是 RetryResult(value, logs),每个 AttemptLog 记着第几次、耗时、失败原因、这次失败后睡了多久。重试从"黑盒里的运气"变成了可以打印、可以统计的数据。"今天 transient 占 12%、shape 占 3%"这种话,你可以说得出来。
sleep / clock / rand 全部做成了参数。这不是洁癖:测试里塞一个不睡的 sleep,40 个用例总共跑不到一秒;不注入的话,光"重试两次"一个用例就得真睡 0.6 秒。
五、timeout.py:deadline 是你在自己代码里划的线
python
class DeadlineExceeded(PermanentError):
    """整轮预算用完。刻意不可重试:再试只会让用户多等一轮。"""
    kind = "deadline"


class Deadline:
    def __init__(self, total_seconds, *, clock=time.monotonic):
        self.total_seconds = float(total_seconds)
        self._clock = clock
        self._start = clock()

    @property
    def remaining(self):
        return max(0.0, self.total_seconds - self.elapsed)

    def check(self):
        if self.remaining <= 0.0:
            raise DeadlineExceeded(f"整轮预算 {self.total_seconds:.1f}s 已用完")
clock 可注入,测试里塞一个手摇时钟,"过了 8 秒"在微秒内就能演完。DeadlineExceeded 继承 PermanentError------预算都花光了,重试个啥?
还有一个容易被忽略的细节:三次重试共享 8 秒预算,不能 给第一次单次 timeout 8 秒,否则它一超时,后面两次已经没时间了。所以 slice_for() 把剩余预算按尝试次数切片:
python
def slice_for(self, attempts, *, cap=DEFAULT_TIMEOUT, floor=MIN_TIMEOUT):
    """把剩余预算切成 attempts 份,作为单次请求的 timeout。"""
    share = self.remaining / max(1, attempts)
    return min(cap, max(floor, share))
现在可以交代 llm.py 那一行改动了:第 2 篇写死的 max_retries=2 改成默认 0。SDK 自带的重试看不见错误类型、不留日志、每次重新计时,叠上我们自己的 call_with_retry 就是 3 × 3 = 9 次请求。重试权必须收回到一个地方,这条和其他"不要重复记账"的原则一回事。
六、fallback.py:全挂了也要说人话
python
DEGRADED_TEXT = (
    "小E现在有点忙,这个问题我先记下了。"
    "着急的话直接找任课老师,我恢复后会尽快回你。"
)

def run_with_fallback(chain, prompt, *, parse=None, deadline=None, ...):
    for llm in chain:
        try:
            result = call_with_retry(lambda llm=llm: _ask_one(llm, prompt, parse), ...)
        except AgentError as err:
            attempts_meta.append(ModelAttempt(name, False, err.kind, str(err)))
            last_reason = f"{name}: {err}"
            continue            # 这个模型不行,换下一个
        return Answer(text=result.value, model=name, attempts=attempts_meta, ...)
return Answer(text=DEGRADED_TEXT, degraded=True, reason=last_reason, ...)注意一个反直觉的点:401 这种永久错误也会跳到下一个模型。主模型的 Key 过期不代表备用模型的 Key 也过期了------永久错误只跳过这一个模型,不终止整条链。
降级文案我给自己定了三条:说清"我现在不行",不装正常;给一条出路;不承诺做不到的事("我马上回你"这种话,系统并不会真的回)。最差的兜底是返回空字符串,用户盯着一个空白气泡,比看到报错还慌。
七、budget.py:先查余额,再花钱
python
class Budget:
    def check(self, estimated: int) -> None:
        """发请求之前问一句"还花得起吗"。花不起就抛,别发。"""
        if estimated > self.per_call:
            raise BudgetExceeded(f"这一次就要约 {estimated} token,超过单次上限 {self.per_call}")
        if self.used + estimated > self.per_session:
            raise BudgetExceeded(f"今天已用 {self.used} token,再问会超过上限 {self.per_session}")

    def charge(self, tokens: int) -> int:
return self.counter.add(tokens) # 成功之后才记账为什么必须在发请求之前 检查?等拿到 usage 再判断,钱已经花出去了。预算是刹车,不是账单。TokenCounter 是个独立的小对象,上线时把 get/add 换成 Redis 的 INCR,Budget 一行不用改。额度用完返回的是另一句文案------"今天的提问额度用完啦",这是规则不是故障,话术不一样。
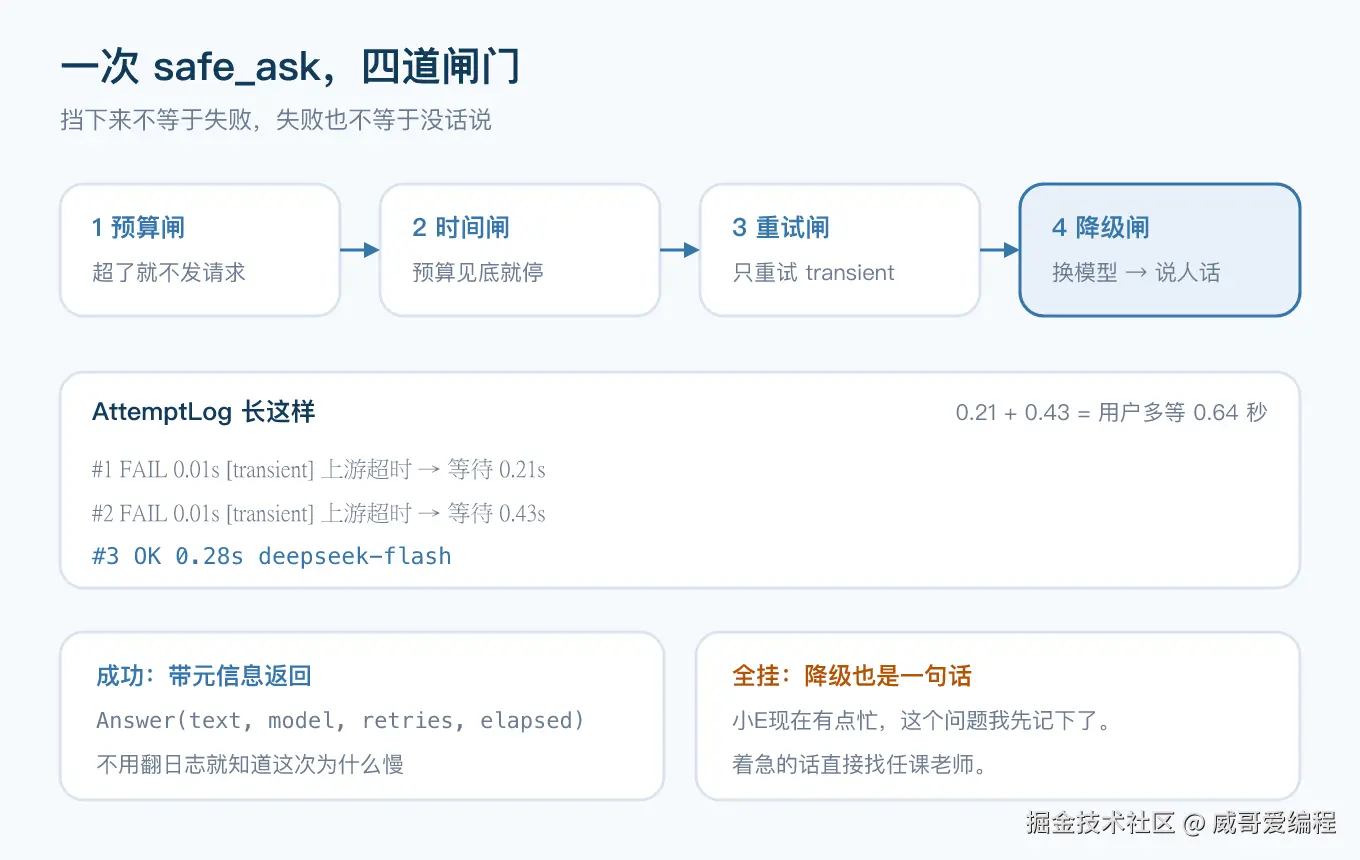
八、guard.py:四个闸门串成一条线
python
def safe_ask(question, llms, *, budget=None, deadline=None, parse=None, ...):
    prompt = build_prompt(question)
    input_tokens = estimate_tokens(prompt)

    if budget is not None:                # 闸门一:预算(最便宜,先挡)
        try:
            budget.check(input_tokens)
        except BudgetExceeded as err:
            return Answer(text=BUDGET_TEXT, blocked=True, reason=str(err))

    answer = run_with_fallback(           # 闸门二三四:时间 → 重试 → 降级
        llms, prompt, parse=parse, deadline=deadline, ...)

    if budget is not None and answer.ok:  # 只有真产出回答才扣额度
        budget.charge(input_tokens + estimate_tokens(answer.text))
    return answer
顺序是刻意的:预算闸最便宜,挡在最前面------一句话就超额度,没必要发请求;时间闸在每次尝试前检查,别把用户的 8 秒花在第三次注定失败的重试上;降级闸垫底,保证用户永远收到一句完整的话。
返回值是带元信息的 Answer:用了哪个模型、重试几次、降级没降级、花了多少 token、总共多久。产品经理问"这次为什么慢",你不用翻服务器日志。
九、跑起来:四种故障,离线演一遍
python demo.py------四个剧本不联网、不要 Key,由 fakes.py 里的 ScriptedChat 按剧本抛出和 SDK 真实抛出同类的异常(构造时连 status_code 都是原样的)。真实输出:
ini
──────────────────────────────────────────────────────────────
【剧本一:前两次超时,第三次成功】
  #1 FAIL  0.00s [transient] 上游超时:请求发出去了,没等到完整响应 → 等待 0.05s
  #2 FAIL  0.00s [transient] 上游超时:请求发出去了,没等到完整响应 → 等待 0.11s
  #3 OK    0.00s [ok]
  模型调用次数:3
  结果:model=deepseek-flash degraded=False 重试=2 耗时=0.17s
  回复学生:时态错误:every day 要求一般现在时,应改为 He goes to school by bus.

──────────────────────────────────────────────────────────────
【剧本二:Key 过期(401),一次就停】
  #1 FAIL  0.00s [permanent] 上游返回 HTTP 401:Invalid API key
  模型调用次数:1
  结果:model=None degraded=True 重试=0 耗时=0.00s
  回复学生:小E现在有点忙,这个问题我先记下了。着急的话直接找任课老师,我恢复后会尽快回你。

──────────────────────────────────────────────────────────────
【剧本三:返回半截 JSON,重试后成功】
  #1 FAIL  0.00s [shape] 返回结构不符合约定:Unterminated string starting at: ... → 等待 0.05s
  #2 OK    0.00s [ok]
  模型调用次数:2
  结果:model=deepseek-flash degraded=False 重试=1 耗时=0.06s
  回复学生:主谓不一致:He 是第三人称单数,go 要变成 goes。

──────────────────────────────────────────────────────────────
【剧本四:两个模型全挂,走降级】
  (两个模型各试 3 次,全部 HTTP 503,日志略)
  模型调用次数:6
  结果:model=None degraded=True 重试=4 耗时=0.32s
  回复学生:小E现在有点忙,这个问题我先记下了。着急的话直接找任课老师,我恢复后会尽快回你。
(演示把退避压缩到了 0.05 秒起步,打印出来的等待时长是真的。)四个剧本对着看特别清楚:剧本二只调了 1 次模型,剧本一调了 3 次------判断"该不该重试"的从来看的不是运气,是错误分类。
十、真实 pytest 输出
bash
tests/test_errors.py ............            [ 30%]
tests/test_fallback.py ......                [ 45%]
tests/test_guard.py .........                [ 67%]
tests/test_retry.py ........                 [ 87%]
tests/test_timeout.py .....                  [100%]
40 passed in 0.88s
40 个用例全绿,全程离线,整个测试不到一秒。几条我最得意的:
test_permanent_error_is_never_retried:断言 401 时fn只被调了 1 次,注释里写着"401 重试三次 = 用户白等 9 秒 + 三次计费"------这条测试就是在给那晚的事故还债。test_jitter_makes_two_waits_different:同样的base_delay=1.0,注入两个不同的随机数,断言两次等待不相等,且都落在 ±10% 的带里。test_deadline_is_shared_across_retries:三次重试共享一个 0.3 秒的 deadline,SleepSpy会推进假时钟,断言累计等待没超预算。test_budget_blocks_before_any_request:断言llm.calls == 0------额度不够就不该发请求。
十一、踩坑清单
- SDK 自带重试和自己的重试相乘。
ChatDeepSeek的max_retries=2叠上我写的"重试三次",最坏 9 次请求。这是那晚"九秒报错"的主犯之一。现在llm.py里默认 0,重试只住在call_with_retry一个地方。 - 超时乘法。
timeout=20× 3 次尝试 = 60 秒白屏。SDK 的 timeout 是每次尝试各自计时,不是总预算;总预算只能是你在自己代码里的Deadline。 - 把"结构不对"一开始当成永久错误。 早期版本半截 JSON 直接降级,家长三天两头看到"小E现在有点忙"。把它挪进可重试类之后,降级率掉了一个数量级------顺带发现重试率高的那几天,都是 max_tokens 配小了。
- 重试把副作用执行两遍。 课程提醒上线第二天,有家长收到了两条一样的通知。读接口随便重试,写接口必须先挂幂等键,这条要在设计阶段想清楚,不是上线后补的。
- 预算放在拿到 usage 之后查。 有一版护栏等响应回来才扣账,高峰期一小时就刷穿了当天的额度。预算必须挡在请求之前,哪怕估得不准------量级正确就够。
- 测试里真的 sleep。 最早的
test_retry要真等 1.2 秒,40 个用例近 40 秒。把sleep / clock / rand做成参数之后,整套测试不到一秒。延时可注入是可测性的前提,不是优化。 - 降级文案写成"服务异常"。 早期兜底就四个字,家长截图发群里问"是不是倒闭了"。降级文案要给人出路、给预期,它和回答一样是产品文案,值得配测试。
十二、本篇收尾
现在小E的四条命都有了着落:该重试的会退避着重试并留下 AttemptLog,整轮请求被 Deadline 按住,额度被 Budget 挡在发请求之前,所有模型都挂了用户也能收到一句完整的话。上线第三天又遇到一次平台侧抖动,运营群里安安静静------保险丝烧断的样子,就是没有存在感的样子。
但"稳定"只是及格线。真正的难题还在后面:每次改 system prompt、换 temperature,你凭什么判断"变好了"?凭感觉吗?我凭感觉改了半年,直到有一天发现一个"优化"让批改准确率掉了八个百分点。下一篇我们做离线评测:把"改了提示词到底有没有变好"从玄学变成一个可以跑的数字。
最后一句:重试不是给错误铺路,是给偶然让路------分不清这两者的程序,只会让用户陪着它的犹豫一起等。