接着上一篇文章《用 STM32 搞清楚 FreeRTOS 的任务上下文到底是什么》搞明白上下文的本质,接下来探讨上下文的切换,这部分内容细节很多,要真正理解上下文的切换过程,需要有一定的 FreeRTOS 和 Cortex-M 的基础知识作为支撑,建议收藏备用。
先把结论摆出来
一次任务切换就三件事:PendSV 进来时把旧任务的现场压到它自己的栈上;vTaskSwitchContext 换掉 pxCurrentTCB 这个指针;PendSV 退出前把新任务的现场弹回去。
在不考虑 TrustZone、FPU 等额外细节的情况下,真正"保存/恢复"的活儿只有 9 个字(r4~r11 + r14),另外 8 个字是硬件在你还没反应过来时就已经压好的。
最容易被忽略的一点:在 bx r14 之前,你改的永远只是栈指针,寄存器是硬件在异常返回那一刻替你换的。
很多人读 port.c 读不下去,是因为一上来就撞见 mrs r0, psp 和 stmdb r0!, {r4-r11, r14},不知道这些寄存器从哪来、要往哪去。所以我先用一个表格把整件事的前提讲清楚,后面再看汇编就不会晕:
| 谁 | 干了什么 |
|---|---|
| SysTick 中断 | 发现"该切了",往 ICSR 里写一个 bit,然后退出 |
| 硬件(异常进入) | 自动把 8 个字压到任务栈上,并把 PSP 往下挪 0x20 |
| PendSV 汇编 | 再把 9 个字压上去,把栈顶记进 TCB |
vTaskSwitchContext |
只改一个全局指针 pxCurrentTCB |
| PendSV 汇编(后半段) | 按新 TCB 的栈顶弹回 9 个字,把 PSP 换成新值 |
| 硬件(异常返回) | 自动弹掉那 8 个字,PC 指向任务的下一条指令 |
SysTick:它只负责按需触发切换
SysTick 是 Cortex-M 内核里的一个 24 位递减计数器。FreeRTOS 在 vPortSetupTimerInterrupt() 里把它配成 configTICK_RATE_HZ 的频率,一般 1000 Hz,也就是 1 ms 响一次。
中断进来以后,跑到的是这里:
c
/* xPortSysTickHandler 函数 */
portDISABLE_INTERRUPTS();
if( xTaskIncrementTick() != pdFALSE )
{
    portNVIC_INT_CTRL_REG = portNVIC_PENDSVSET_BIT;
}
portENABLE_INTERRUPTS();
就三句话,值得一个一个说。
第一句先关中断。 用的是 vPortRaiseBASEPRI(),把 BASEPRI 抬到 configMAX_SYSCALL_INTERRUPT_PRIORITY。为什么要关?因为 xTaskIncrementTick() 会动就绪链表和延时链表,如果这时候来个更高优先级的中断、而它恰好调了 xxxFromISR(),链表就被改花了。
第二句是全部的业务逻辑。 xTaskIncrementTick() 的内部细节不属于本文着重讲的内容,概括下来就是它干了三件事:tick 计数加一;把延时到期的任务从延时链表挪回就绪链表;判断时间片是不是用完了。它返回 pdFALSE 表示"没必要切",返回 pdTRUE 表示"要切换任务"。
注意这里的分工:它只决定要不要切,不执行真正的切换。
第三句就是按需触发。 如果需要切换任务,portNVIC_INT_CTRL_REG 就是 ICSR,地址 0xE000ED04;portNVIC_PENDSVSET_BIT 是 1 << 28,也就是 PENDSVSET 位。写进去的一瞬间,PendSV 异常被"挂起"(pending),但不会立刻跳过去。
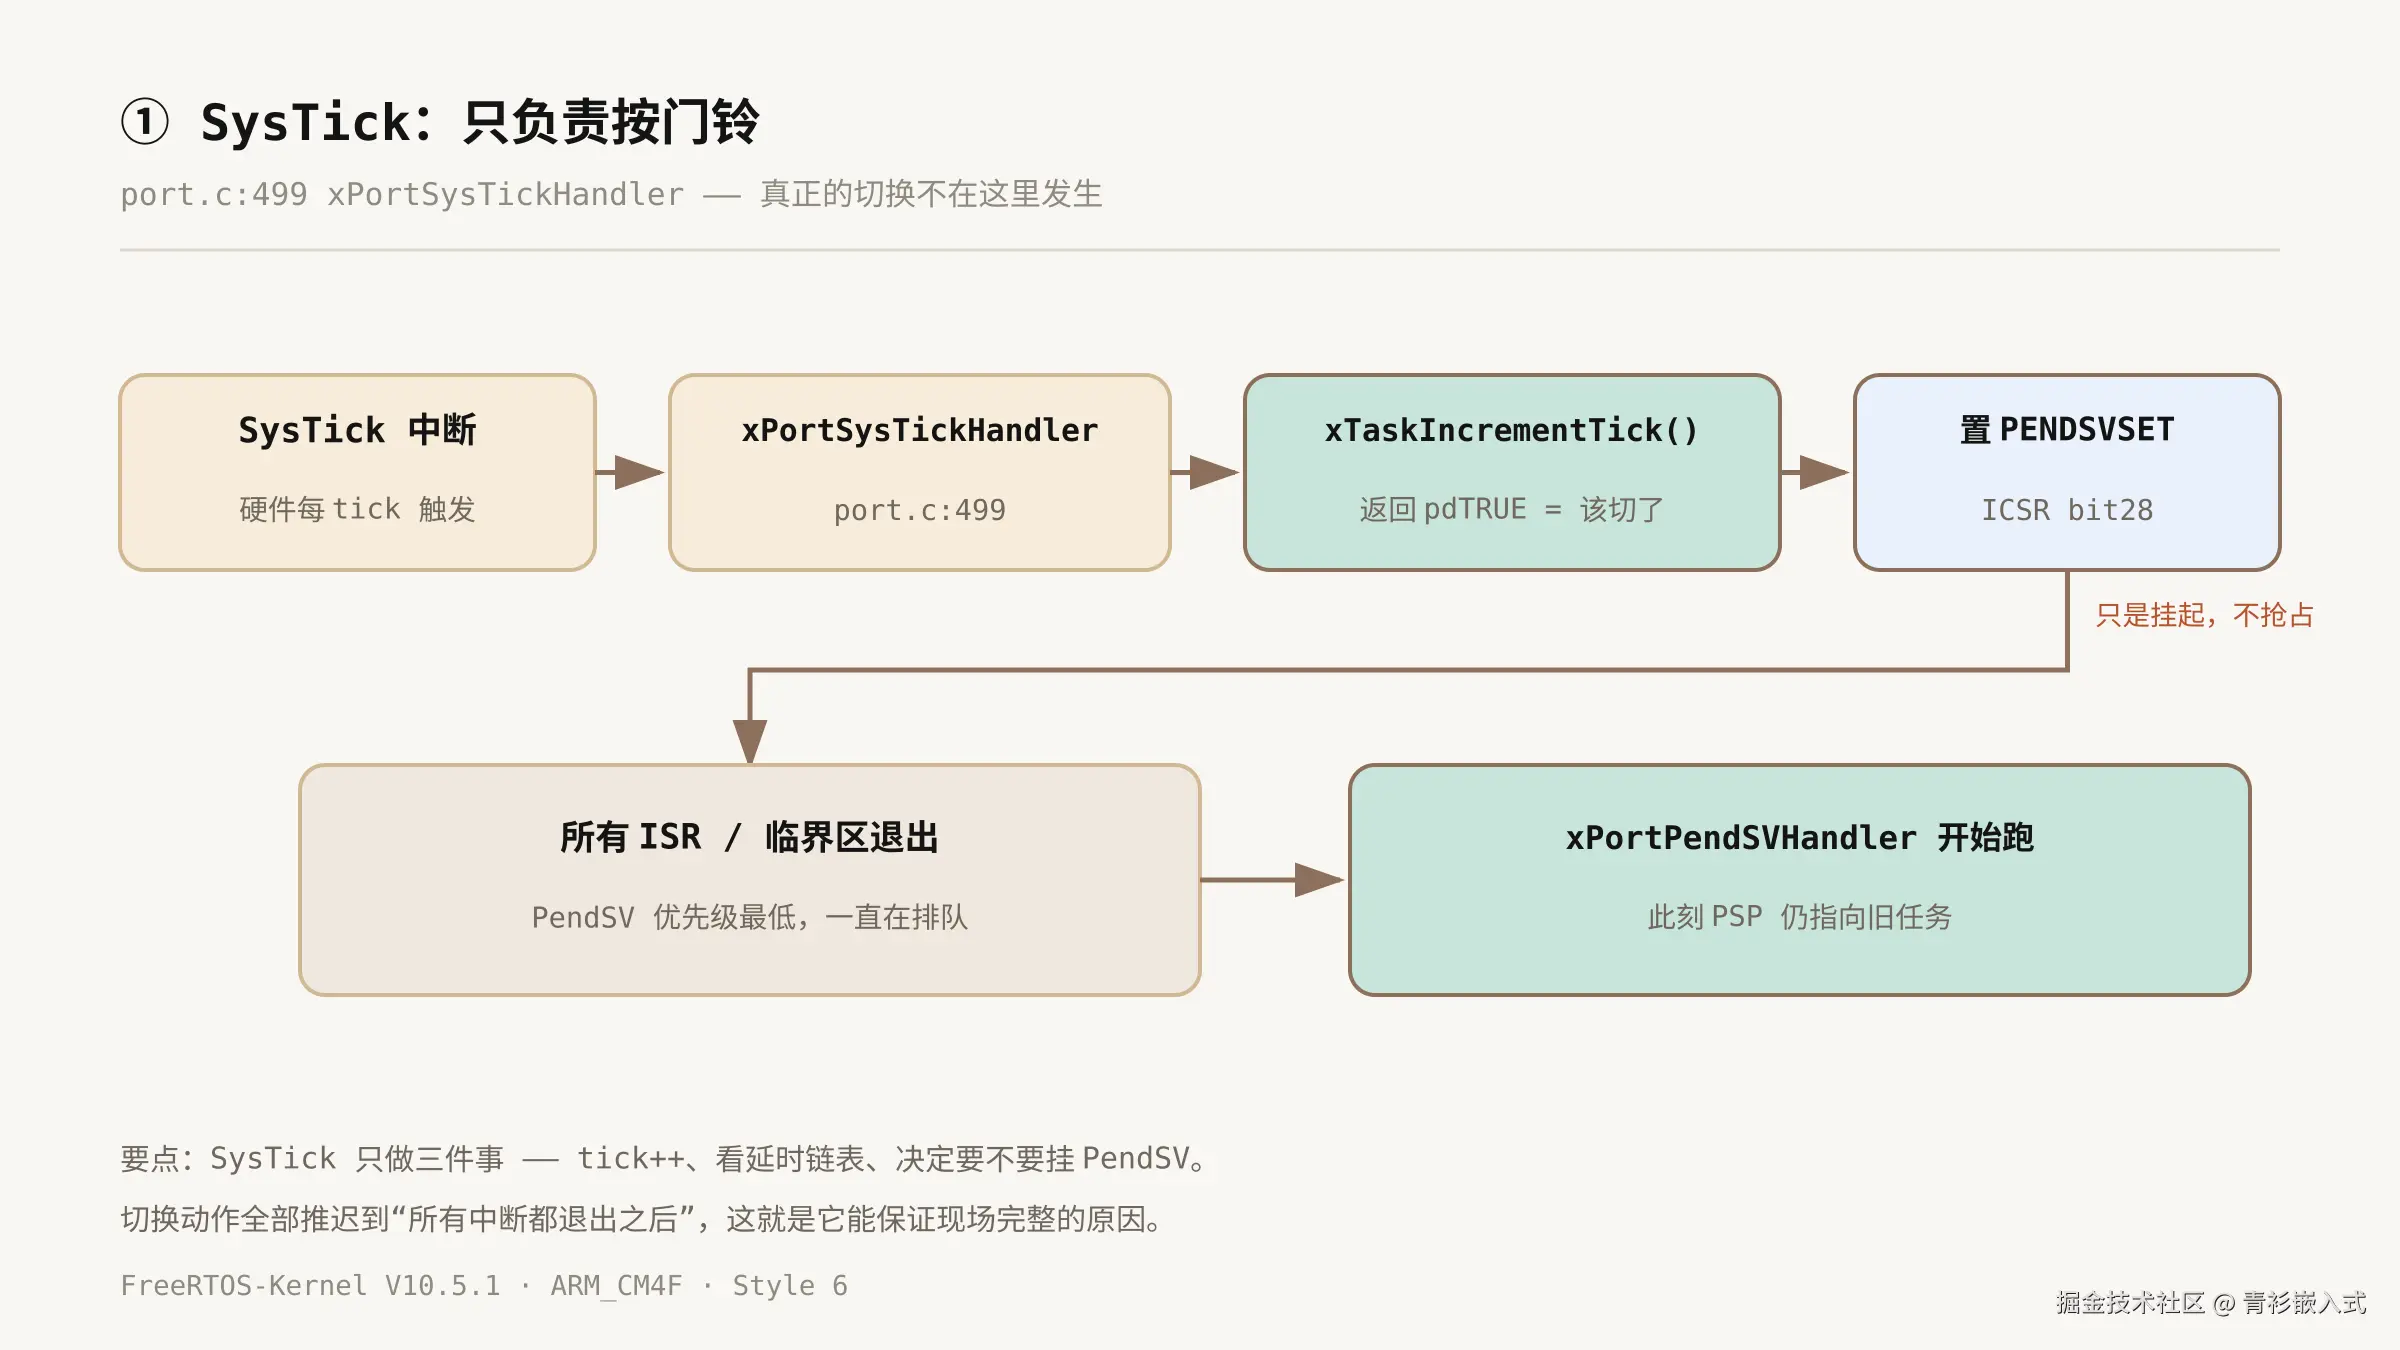
F1:SysTick 只把 PendSV 挂起,真正执行要等所有中断都退出
这张图里最右边那个"只是挂起,不抢占"的标注,是理解后面所有内容的前提。SysTick 和 PendSV 的优先级是同一个值(configKERNEL_INTERRUPT_PRIORITY,最低),而同优先级异常不能互相抢占------所以 SysTick 正在跑的时候,就算 PendSV 已经 pending,也得等 Systick 中断退出。
顺便说一句:任务自己调 taskYIELD(),走的是同一条路。portmacro.h:76 里 portYIELD() 的定义就是往同一个 ICSR 位写 1。主动让出和被动抢占,最后都汇到 PendSV 这一个出口。
为什么偏偏是 PendSV
如果只是"需要一个地方做切换",随便找个中断都行。为什么 FreeRTOS 非要造一个 PendSV 出来?
3.1 因为它可以被推迟到"最合适的时候"
PendSV 是一个纯软件触发的异常,它的优先级可以编程。FreeRTOS 在启动调度器时做了这么一件事:
c
portNVIC_SHPR3_REG |=
    portNVIC_PENDSV_PRI;
portNVIC_SHPR3_REG |=
    portNVIC_SYSTICK_PRI;
SHPR3 是 0xE000ED20,专门放 PendSV 和 SysTick 的优先级。这两行把两者的优先级都设成 configKERNEL_INTERRUPT_PRIORITY,也就是最低。
最低意味着什么?意味着只要还有任何中断在处理、或者还在排队,PendSV 就得等。等所有 ISR 全部退出、等所有 pending 的中断都执行完,它才是最后一个上场的。
这恰好就是上下文切换需要的时机:没有任何中断正在使用栈的时候。
3.2 因为"一个 tick 内可能有很多任务要切,但只需要切一次"
假设一个 tick 里,三个任务同时被解锁,优先级都比你高。如果每个事件都触发一次切换,你要切三次。而 PendSV 是 pending 型异常,多次 PENDSVSET 只会让它"挂起一次"------它天然把这一堆请求合并成了一次。
3.3 因为在临界区里它切不进去
taskENTER_CRITICAL() 会把 BASEPRI 抬到 configMAX_SYSCALL_INTERRUPT_PRIORITY。PendSV 的优先级比这个阈值还低(数值更大),所以在临界区里挂起的 PendSV 会被硬件直接屏蔽 ,一直等到 BASEPRI 放下来。
硬件先动手:你还没跑第一行汇编,栈已经变了
这是最容易混淆的地方。
4.1 先分清两条栈:PSP 和 MSP
Cortex-M 有两条栈指针:MSP(主栈)和 PSP(任务栈)。
- Handler 模式(所有异常处理)一律用 MSP
- Thread 模式 (任务代码)用哪个,由
CONTROL.SPSEL决定
FreeRTOS 的规矩是:任务跑在 Thread 模式 + PSP,中断跑在 Handler 模式 + MSP。
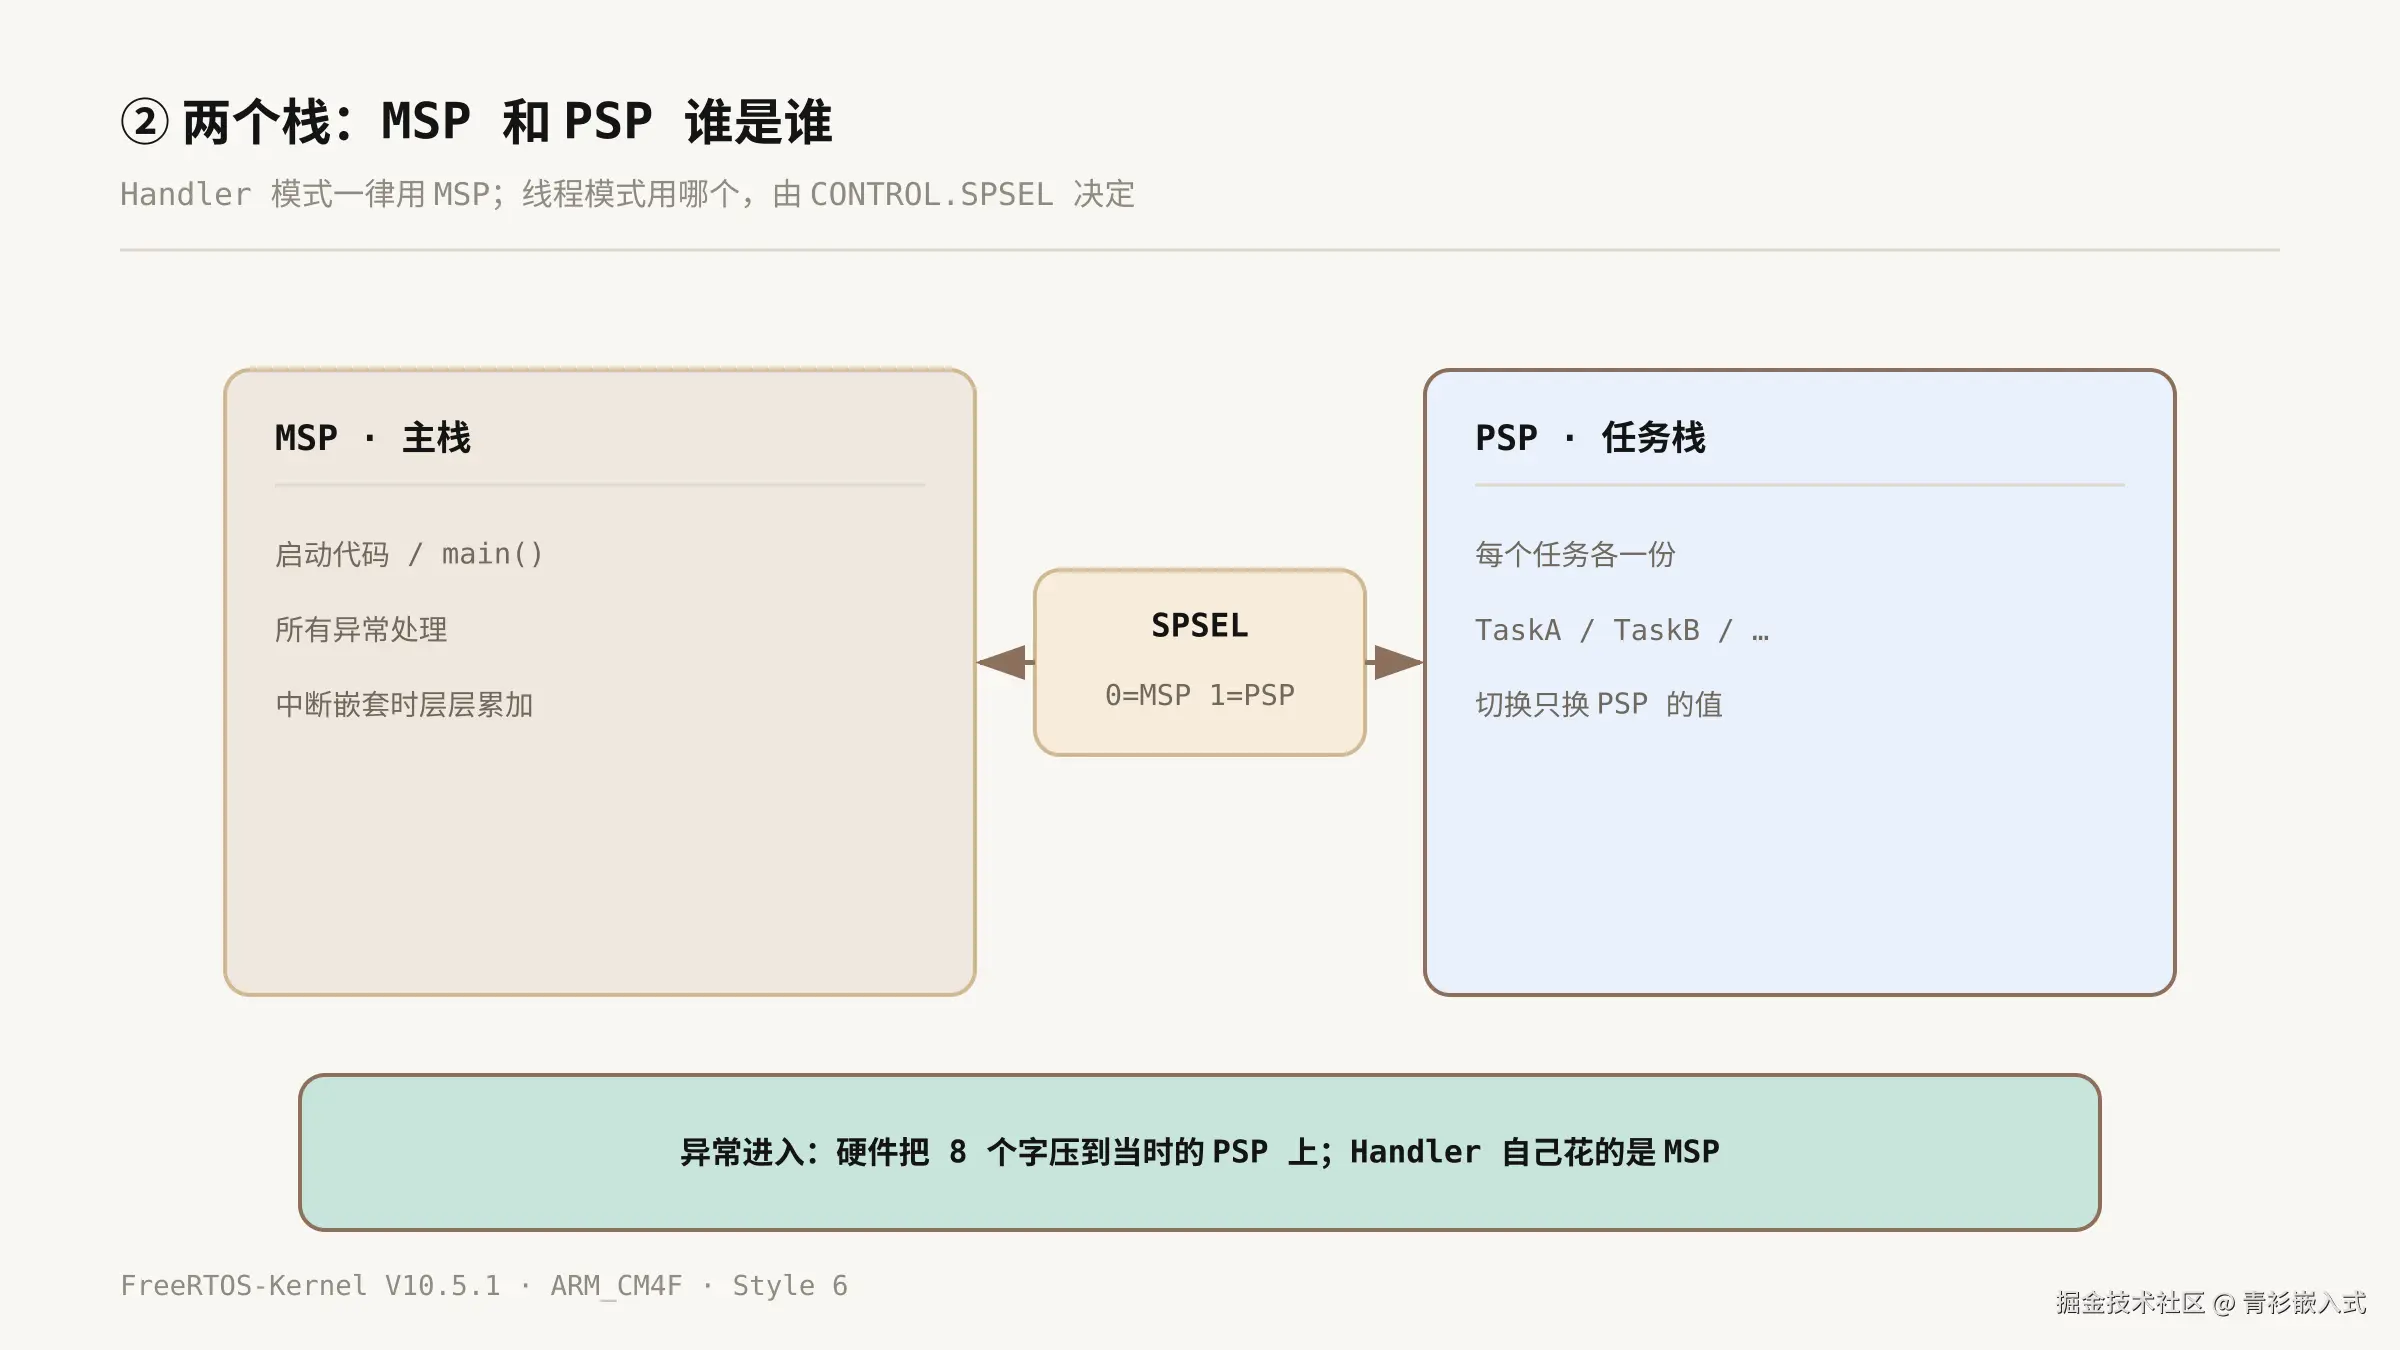
F2:任务用 PSP,中断用 MSP,两者互不干扰
这条隔离特别重要:正因为它俩是两条独立的栈,PendSV 在处理切换时才能一边用 MSP 存自己的临时变量(stmdb sp!, {r0, r3} 存的就是 MSP),一边操作任务栈。
4.2 异常进入时,硬件压了 8 个字(不考虑浮点)
当 PendSV 被响应、CPU 决定进入异常处理时,硬件(不是软件)会往被打断那一刻正在用的栈(任务就是 PSP)上压 8 个字:
xPSR      ← 含 Thumb 位、对齐位
PC        ← 被打断那条指令的下一条
LR        ← 返回地址(R14 的旧值)
R12
R3
R2
R1
R0
压完,PSP 减 0x20。注意顺序:先压 xPSR,最后压 R0,而栈是向低地址长的,所以 R0 落在最低地址------这正是为什么 PSP 最后停在 R0 那一格。
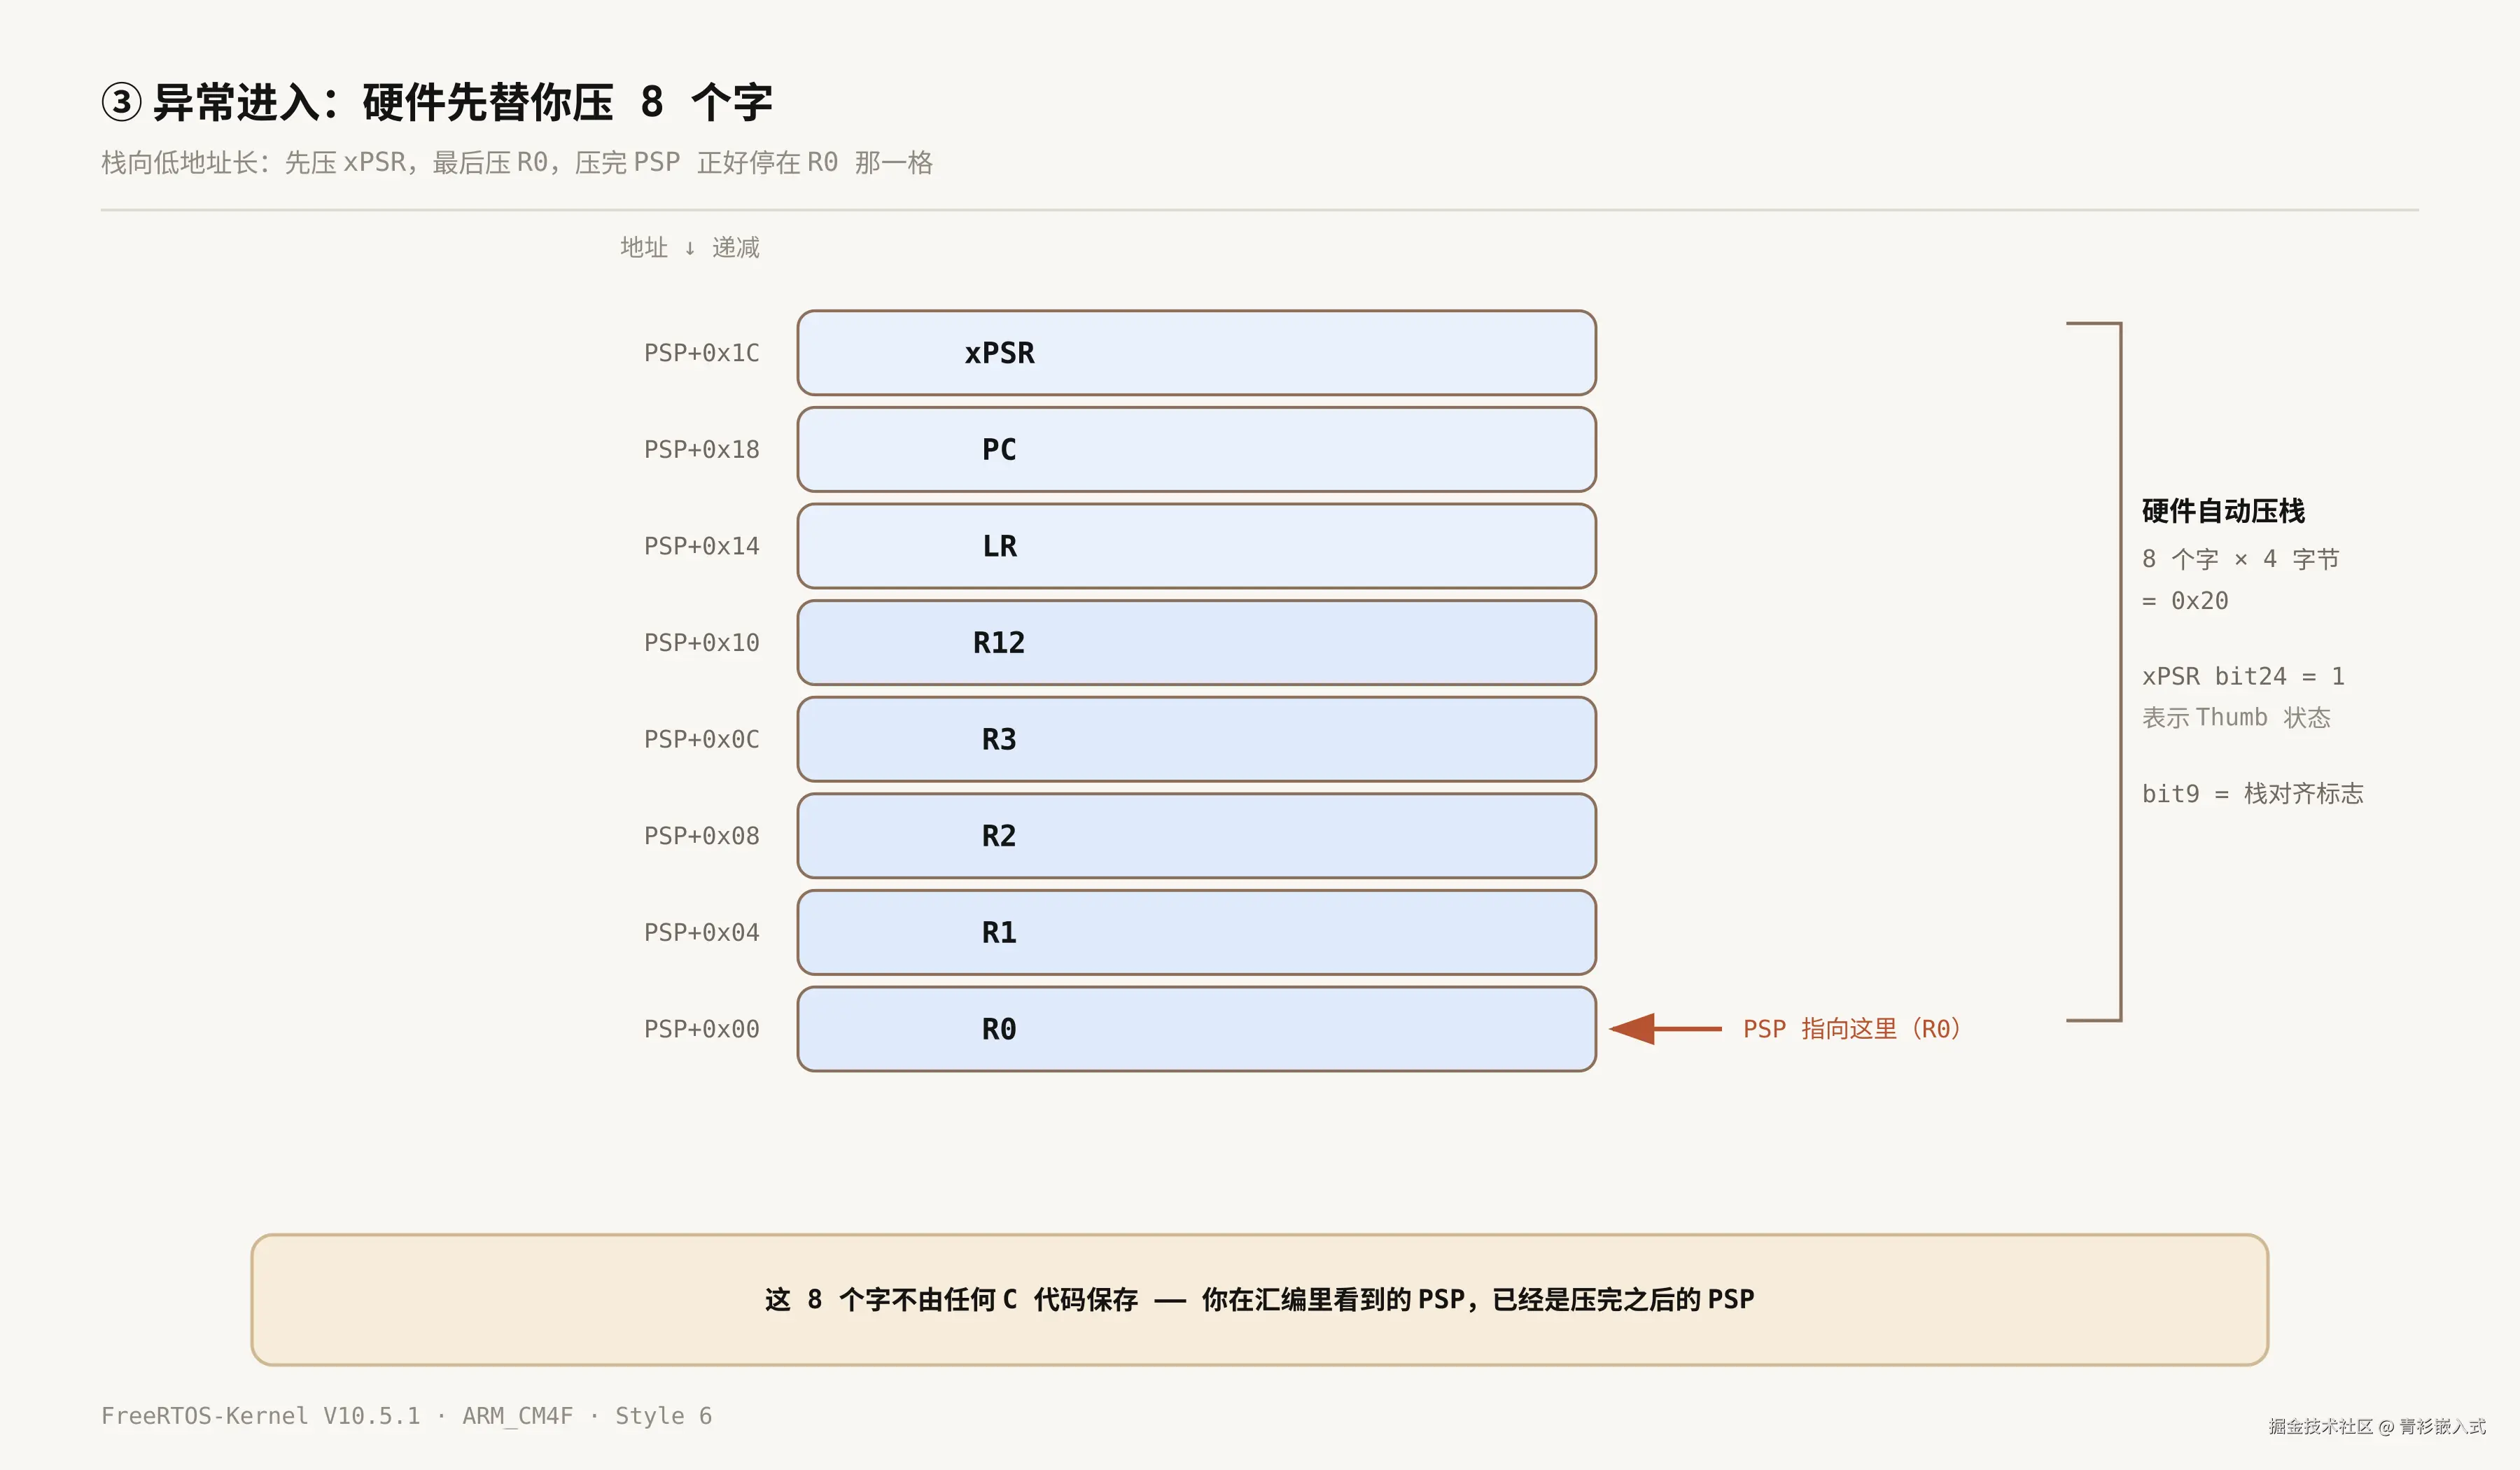
F3:8 个字、0x20 字节,压完 PSP 正好停在 R0 那一格
这张图里有两个细节,值得停一下:
xPSR 的 bit24 是 1。 它表示"Thumb 状态"。Cortex-M 只支持 Thumb,这个位要是不对,异常返回时会直接进 HardFault。pxPortInitialiseStack() 里构造假栈帧时,portINITIAL_XPSR 就是 0x01000000 ------ 一个 bit24 孤零零地立在那儿。
xPSR 的 bit9 是栈对齐标志。 AAPCS 要求 8 字节对齐,编译器假设 SP 是 8 对齐的。如果异常发生时 SP 恰好只 4 字节对齐,硬件会插一个字把栈"垫"成 8 对齐,并把 bit9 置 1;异常返回时它照着 bit9 把这个垫子撤掉。所以你在任务里看到的栈永远是 8 对齐的------这个保证不是编译器给的,是硬件给的。
软件接手:xPortPendSVHandler 逐行
终于到正文了。整个函数按"段"来拆,一共五段,每段只干一件事。
先给骨架,八行伪代码,你看完这个再往下读细节会舒服很多:
读 PSP           →  找到旧任务
找到 TCB         →  准备记账
压 9 个字        →  保存现场
找最高优先级任务  →  换 pxCurrentTCB
弹 9 个字        →  换 PSP,bx r14
第一段:把 PSP 读出来
asm
mrs  r0, psp
isb
mrs 是"把特殊寄存器搬到通用寄存器"。这一句把当前 PSP 的值读进 r0------注意,这个 PSP 已经不是任务被切走时的值了,它已经被硬件减掉了 0x20,正指着栈帧里 R0 那一格。
这就是为什么后面 stmdb r0! 能接着往下压:硬件压完,PSP 已经在"栈帧底部",你在它下面继续压,两块栈帧天然是连续的。
isb(指令同步屏障)看着多余,其实不是。异常进入时硬件刚改过 SP,这条屏障保证后面的指令看到的是"改完之后"的状态。这种细节在 Cortex-M 的 port 里到处都是,编译器的重排比你想的激进。
第二段:找到当前任务的 TCB
asm
ldr  r3, =pxCurrentTCB
ldr  r2, [r3]
pxCurrentTCB 是个全局指针,指向当前正在跑的任务的 TCB。第一句把它的地址 装进 r3,第二句解引用,把TCB 的地址装进 r2。
你可能会问:为什么不直接 ldr r2, =pxCurrentTCB 然后 ldr r2,[r2]?因为它需要把 &pxCurrentTCB 留着后面用(第五段还要再用一次 [r3] 读新值)。汇编里没有"顺手再取一次地址"这种便宜事,寄存器要抠着用。
ldr r3, =... 这种写法,最终生成的是从字面量池取数。你看函数末尾:
asm
.align 4
pxCurrentTCBConst: .word pxCurrentTCB
一个藏在代码段里的指针常量。这也是这个函数必须声明 __attribute__((naked)) 的原因:编译器不能给它插序言/尾声,否则还没等你保存现场,压栈和寄存器改写就已经发生了。
第三段:保存现场(核心的 5 行)
asm
tst  r14, #0x10
it   eq
vstmdbeq r0!, {s16-s31}
stmdb r0!, {r4-r11, r14}
str  r0, [r2]
这五行是全文的技术核心,一行一行来。
tst r14, #0x10 :r14 就是 LR,但此刻它里面装的不是返回地址,而是 EXC_RETURN------一个由硬件在异常进入时写好的"回程车票"。bit4 = 0 表示"这个任务有浮点上下文",bit4 = 1 表示"没有"。
it eq + vstmdbeq r0!, {s16-s31} :如果 bit4 是 0,就把 16 个高段浮点寄存器(s16~s31,64 字节)也压进去。eq 后缀配合 it 块,是 Thumb-2 的"条件执行"写法。
这里我要提醒一句:M4F 的 FPU 有"懒加载"机制(FPCCR 的 ASPEN/LSPE),硬件会替你先省掉 s0 ~ s15 的保存。这个话题暂不展开讨论,你只要记住结论:s0 ~ s15 硬件管,s16 ~ s31 得软件管,判据就是 EXC_RETURN 的 bit4。
stmdb r0!, {r4-r11, r14} :把 9 个字压进去。stmdb 是"先减后存"(Decrement Before),! 表示写回 r0。
为什么是这 9 个?因为 r0 ~ r3、r12、LR、PC、xPSR 那 8 个硬件已经压过了,而调用者保存寄存器里剩下的 r4 ~ r11 没人管,必须软件来。
那 r14 为什么也在里面?因为它现在装的是 EXC_RETURN,后面会用到。而接下来要 bl vTaskSwitchContext,C 函数会把 LR 用掉。所以必须先把这张车票存进任务自己的栈里,等切换回来再取出来。
还有个容易看漏的细节:为什么是 stmdb r0! 而不是 stmdb sp!?因为此刻 sp 指向 MSP(Handler 模式),而你要压的是任务栈。r0 里装的是 PSP 的值,它在这一段里就是"临时栈指针"。整段汇编从头到尾没碰过 sp,任务栈只通过 r0 访问。
str r0, [r2] :把新的栈顶写进 TCB 的第一个成员 pxTopOfStack。TCB 结构体的第一个字段就是它,所以这里是 [r2],偏移 0。
到这里,旧任务的现场就"冻结"完了。此时:
- 任务栈里多了 9 个字(用了 FPU 的话是 25 个)
pxCurrentTCB->pxTopOfStack指向 r4 那一格- PSP 还停在硬件栈帧底部,没动过
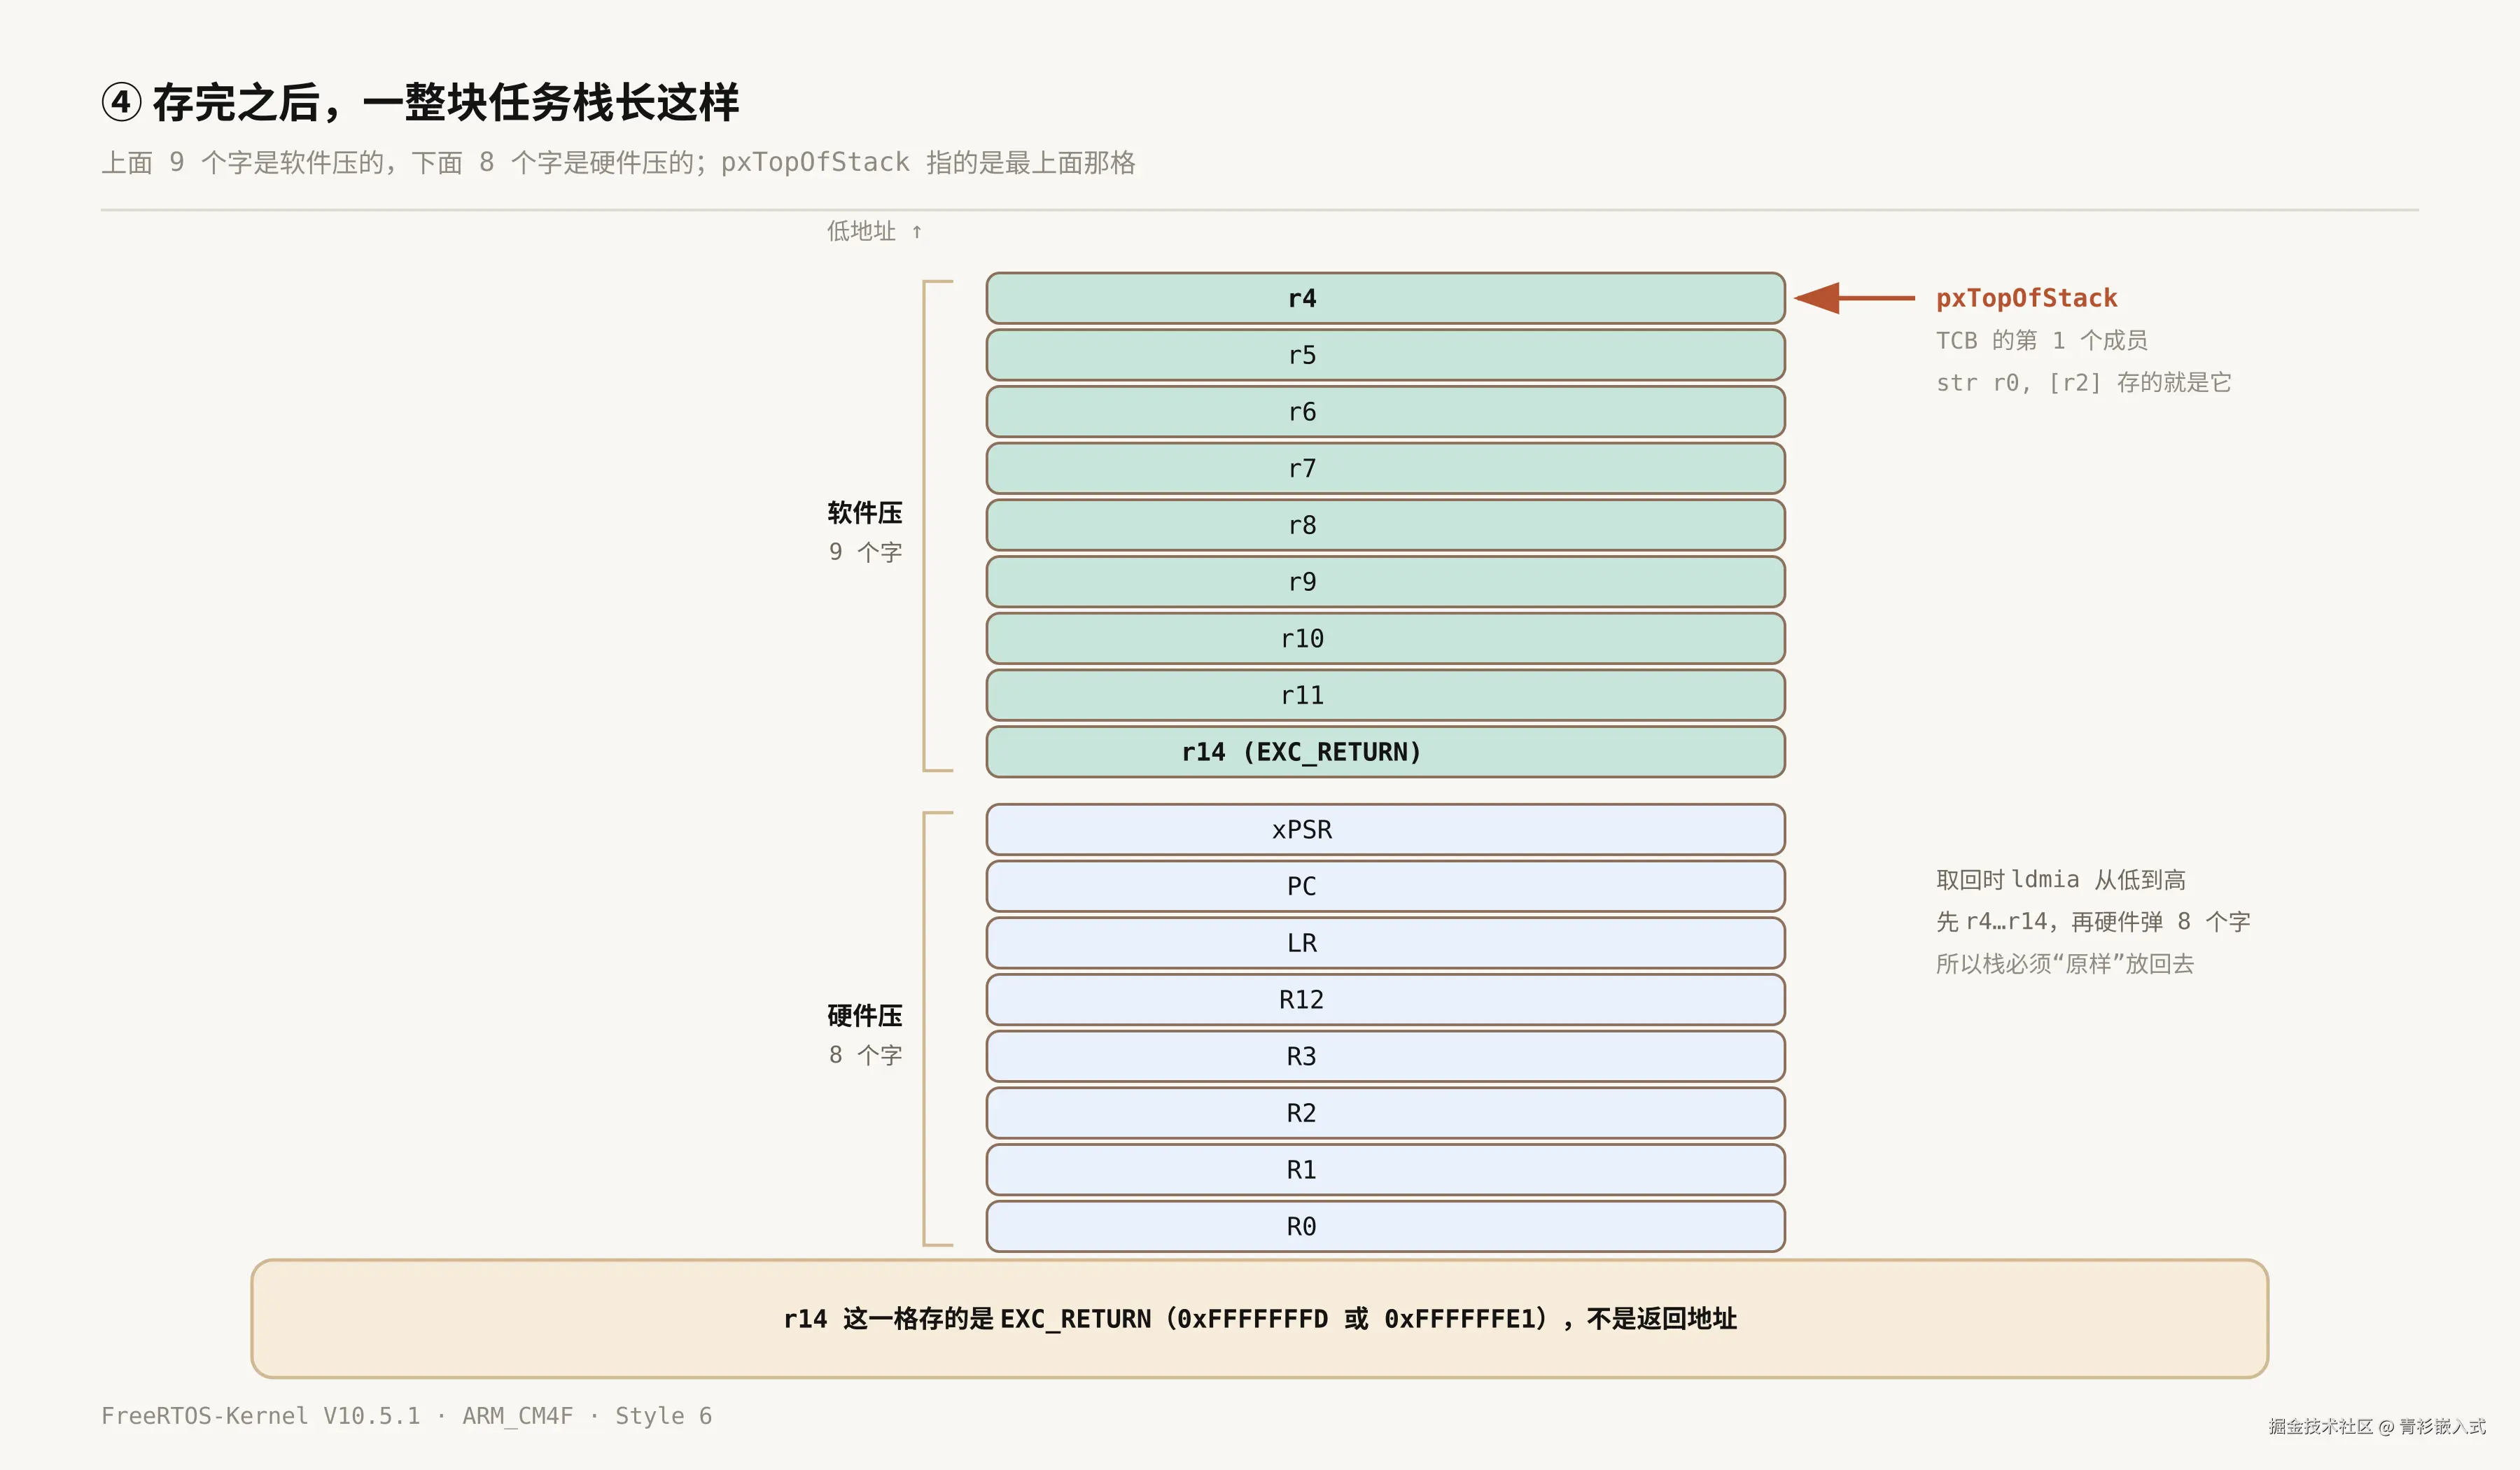
F4:上面 9 个字是软件压的,下面 8 个是硬件压的,pxTopOfStack 指最上面那格
第四段:关中断、换任务、开中断
asm
stmdb sp!, {r0, r3}
mov  r0, %0
msr  basepri, r0
dsb
isb
bl   vTaskSwitchContext
先说 stmdb sp!, {r0, r3}。r0 是新栈顶、r3 是 &pxCurrentTCB,这两个值等会儿还要用,但 bl 会跳进 C 函数,C 函数有权把 r0~r3 随便改。所以先存起来------存在MSP 上(sp 在 Handler 模式就是 MSP),不是任务栈,避免污染任务栈。
然后是重点:mov r0, %0 / msr basepri, r0。 这几行的意思是:把 BASEPRI 抬到"可调用 FreeRTOS API 的最高优先级",相当于屏蔽掉所有能调 xxxFromISR() 的中断。
为什么关?因为 vTaskSwitchContext 要遍历就绪链表、要改 pxCurrentTCB。如果这中间来个中断,而它调了 xQueueSendFromISR 之类把某个任务塞进就绪链表,链表的结构就在你遍历到一半时变了。轻则选错人,重则链表指针踩坏。
这里有个细节值得注意:PendSV 已经是最低优先级了,理论上不会有比它更低的中断来抢它 。但"更高优先级的中断"照样能打断它,而那些中断恰恰是唯一能调 FromISR API 的东西。所以这段屏蔽是必须的。
函数返回后立刻 msr basepri, #0(放开)再 ldmia sp!, {r0, r3}(把两个值捞回来)。注意此时 r0 和 r3 还是"旧任务时期"的值,但没关系------r3 里存的是 &pxCurrentTCB,这个地址不变;r0 是旧栈顶,第五段第一句就会把它覆盖掉。
第五段:换成新任务,然后"返回"
asm
ldr  r1, [r3]
ldr  r0, [r1]
ldmia r0!, {r4-r11, r14}
ldr r1, [r3]:r3 还是 &pxCurrentTCB,但 [r3] 里的值已经变了------vTaskSwitchContext 把它改成了新任务。所以 r1 = 新任务的 TCB。
ldr r0, [r1]:取 TCB 第一个成员,新任务的 pxTopOfStack。
ldmia r0!, {r4-r11, r14}:按地址从低到高弹 9 个字,正好和当初 stmdb 的顺序对称。! 表示 r0 跟着往上走。
然后是浮点:
asm
tst  r14, #0x10
it   eq
vldmiaeq r0!, {s16-s31}
跟保存那段完全对称:读回来的 EXC_RETURN 如果 bit4 是 0,说明当初存了 s16~s31,现在弹回来。
最后三行:
asm
msr  psp, r0
isb
bx   r14
msr psp, r0:把 PSP 换成新任务的栈指针。这一句是"换栈"的全部动作------从这一刻起,PSP 指向新任务的硬件栈帧。
bx r14:这不是普通返回。r14 里是 EXC_RETURN,bx 到它会让硬件识别成"异常返回",于是硬件开始收尾:按 EXC_RETURN 里指定的栈,弹出 8 个字,PC 跳到任务的断点,PSP 回到任务被切走时的值。
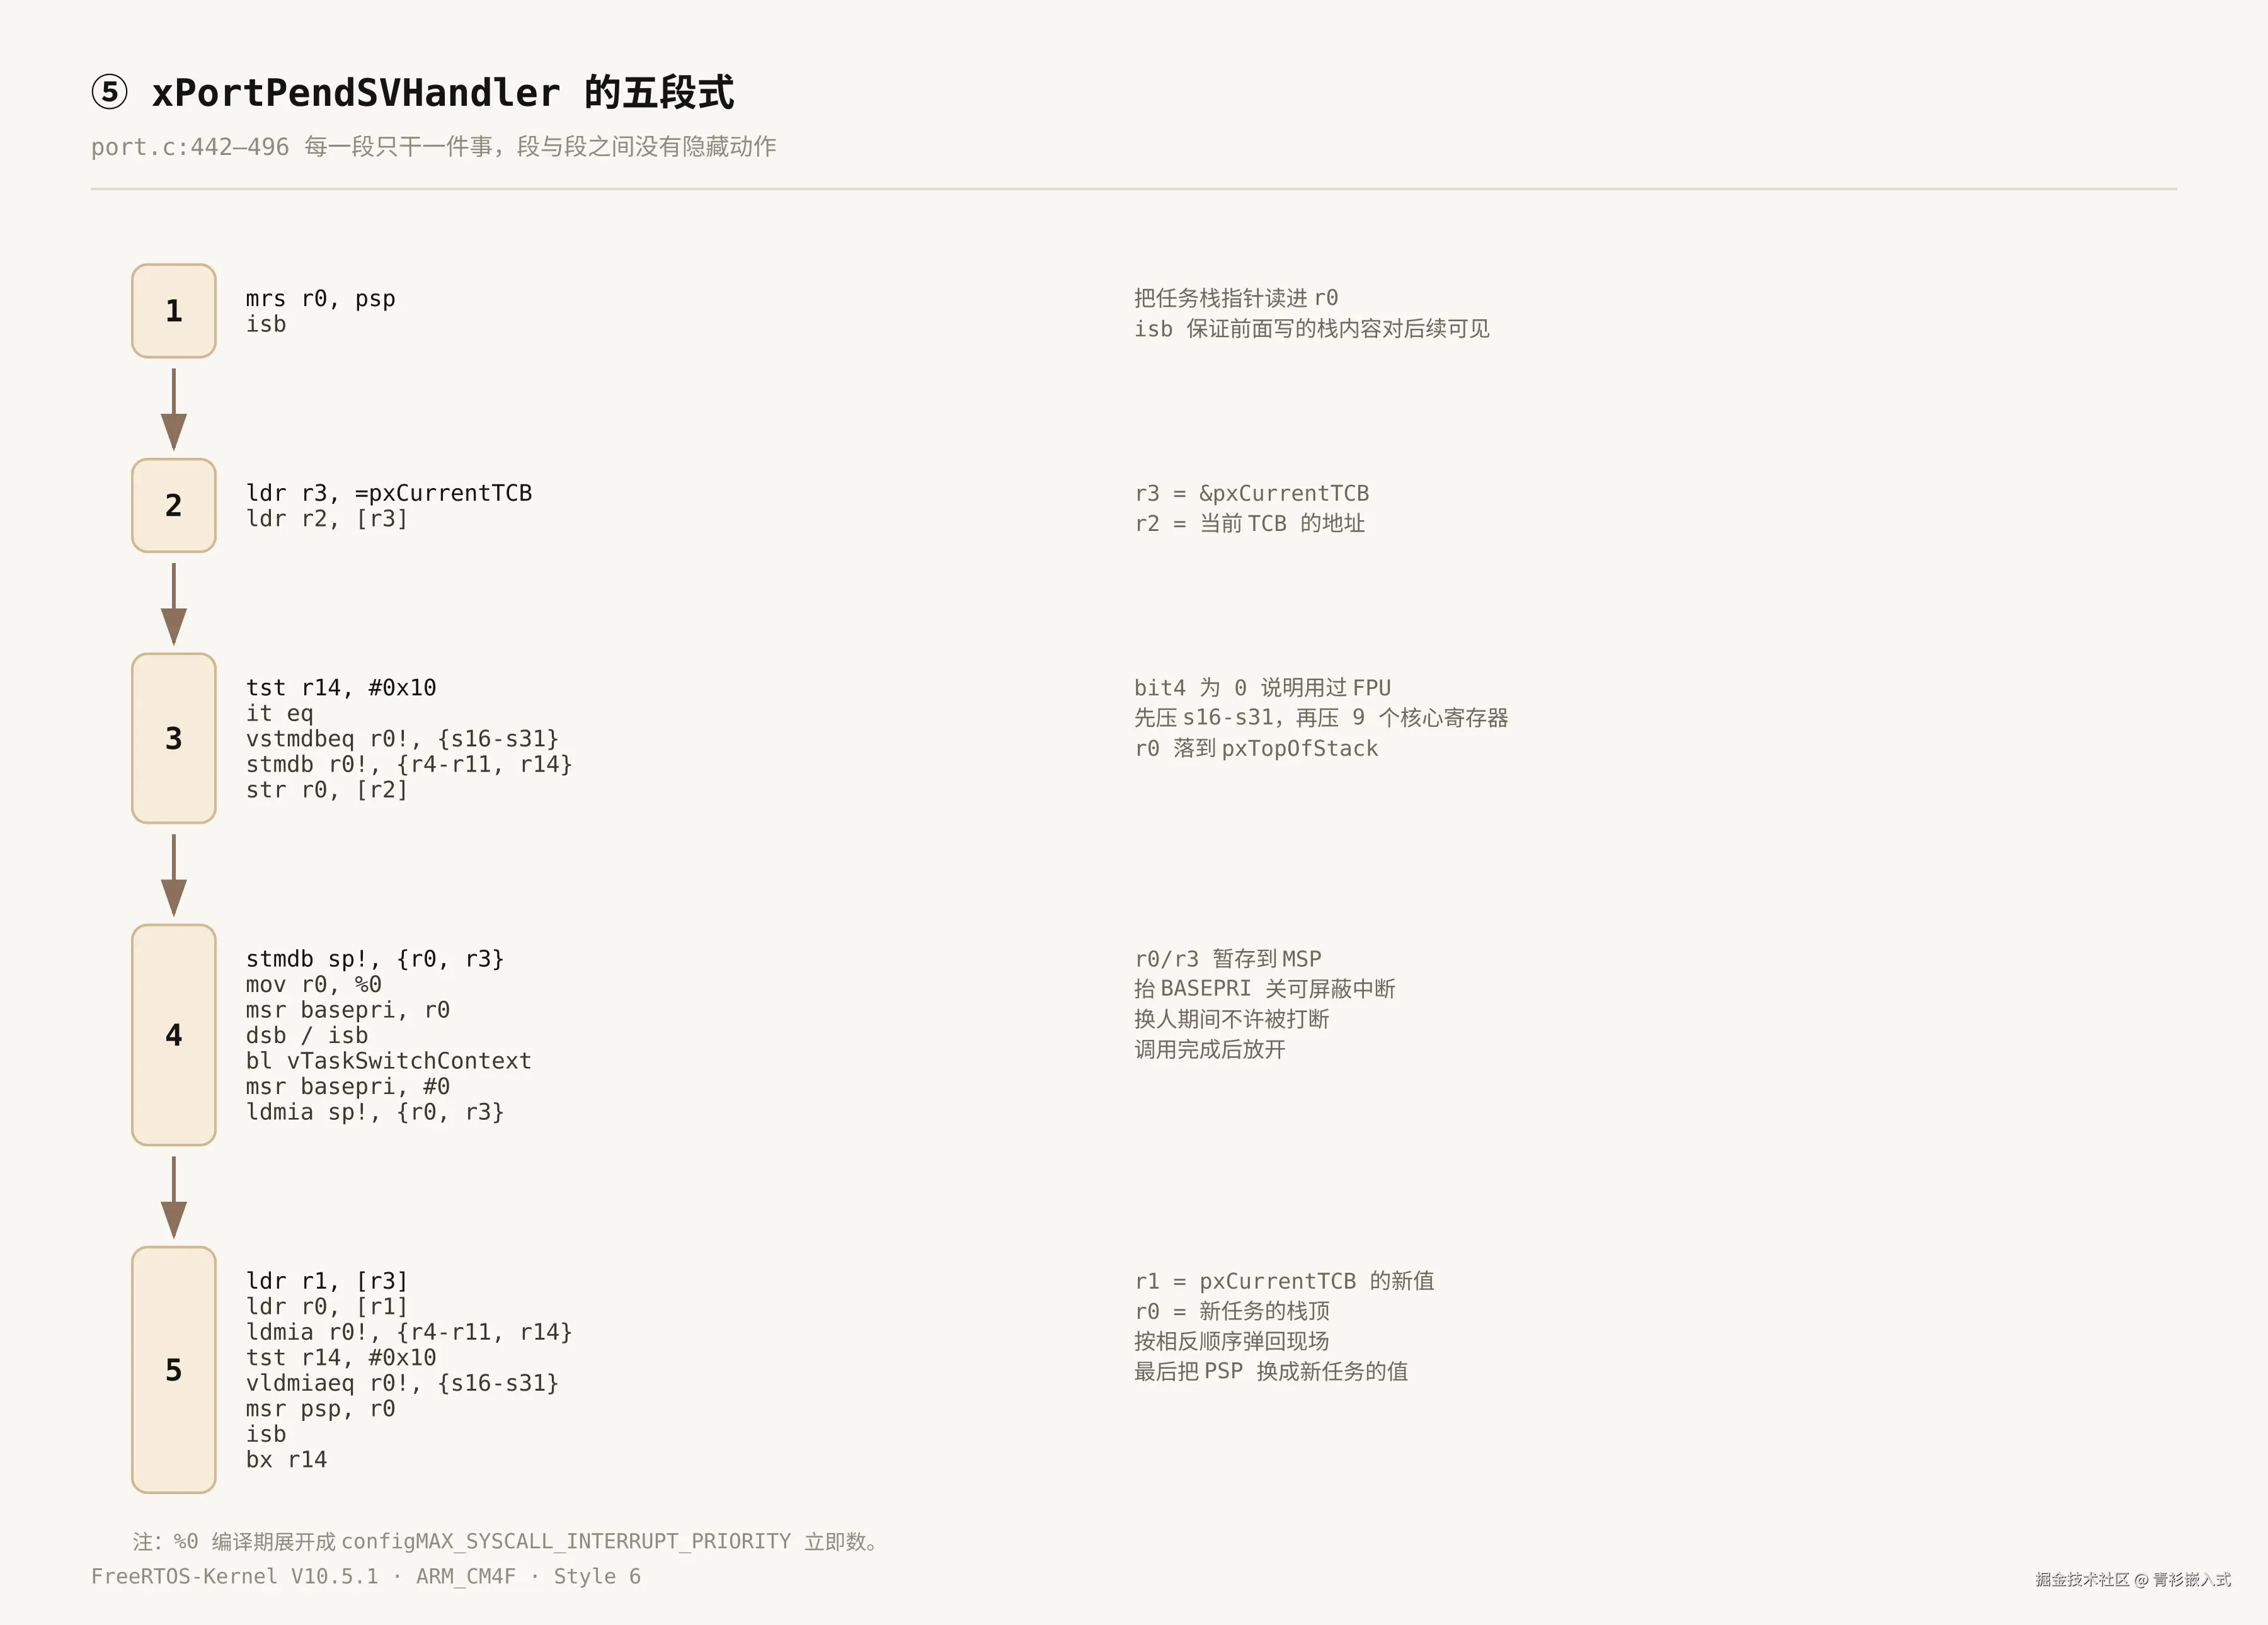
F5:五段式,每段只干一件事
vTaskSwitchContext:只换了个指针
这个名字听起来很唬人,其实它一行寄存器都没碰。核心在 tasks.c:3009。
c
if( uxSchedulerSuspended != pdFALSE )
{
    xYieldPending = pdTRUE;
}
else
{
    xYieldPending = pdFALSE;
    taskSELECT_HIGHEST_PRIORITY_TASK();
}
就这么点东西。调度器被挂起(比如在 vTaskSuspendAll() 里)的时候,它不切,只记一个"欠一次切换"的标记 xYieldPending;等到恢复调度器时再补上。
正常路径里,中间还夹着一堆可选的活儿:运行时统计、栈溢出检查(taskCHECK_FOR_STACK_OVERFLOW())、TLS 切换、errno 保存。这些都由 configXXX 开关控制,默认关掉的话编译完就什么都不剩。
真正选任务的是那个宏。它有两个版本,取决于 configUSE_PORT_OPTIMISED_TASK_SELECTION:
c
/* 通用版 */
while( listLIST_IS_EMPTY(
   &pxReadyTasksLists[uxTopPriority] ) )
{
    configASSERT( uxTopPriority );
    --uxTopPriority;
}
从 uxTopReadyPriority 这个"当前最高优先级"往下逐级找,找到第一个非空链表就是答案。
打开优化后走的是另一条路:把优先级变成一个位图,用 CLZ(Count Leading Zeros)一条指令算出最高位。代价是优先级数量受寄存器位宽限制(M4 上一般 32 个)。
选出来之后:
c
listGET_OWNER_OF_NEXT_ENTRY(
    pxCurrentTCB,
&pxReadyTasksLists[uxTopPriority] );这个宏不只是"取第一个",它会把链表指针往后挪一格。所以同一优先级的多个任务,每次切换都轮到下一个------这就是时间片轮转的全部实现,没有额外的计时器。
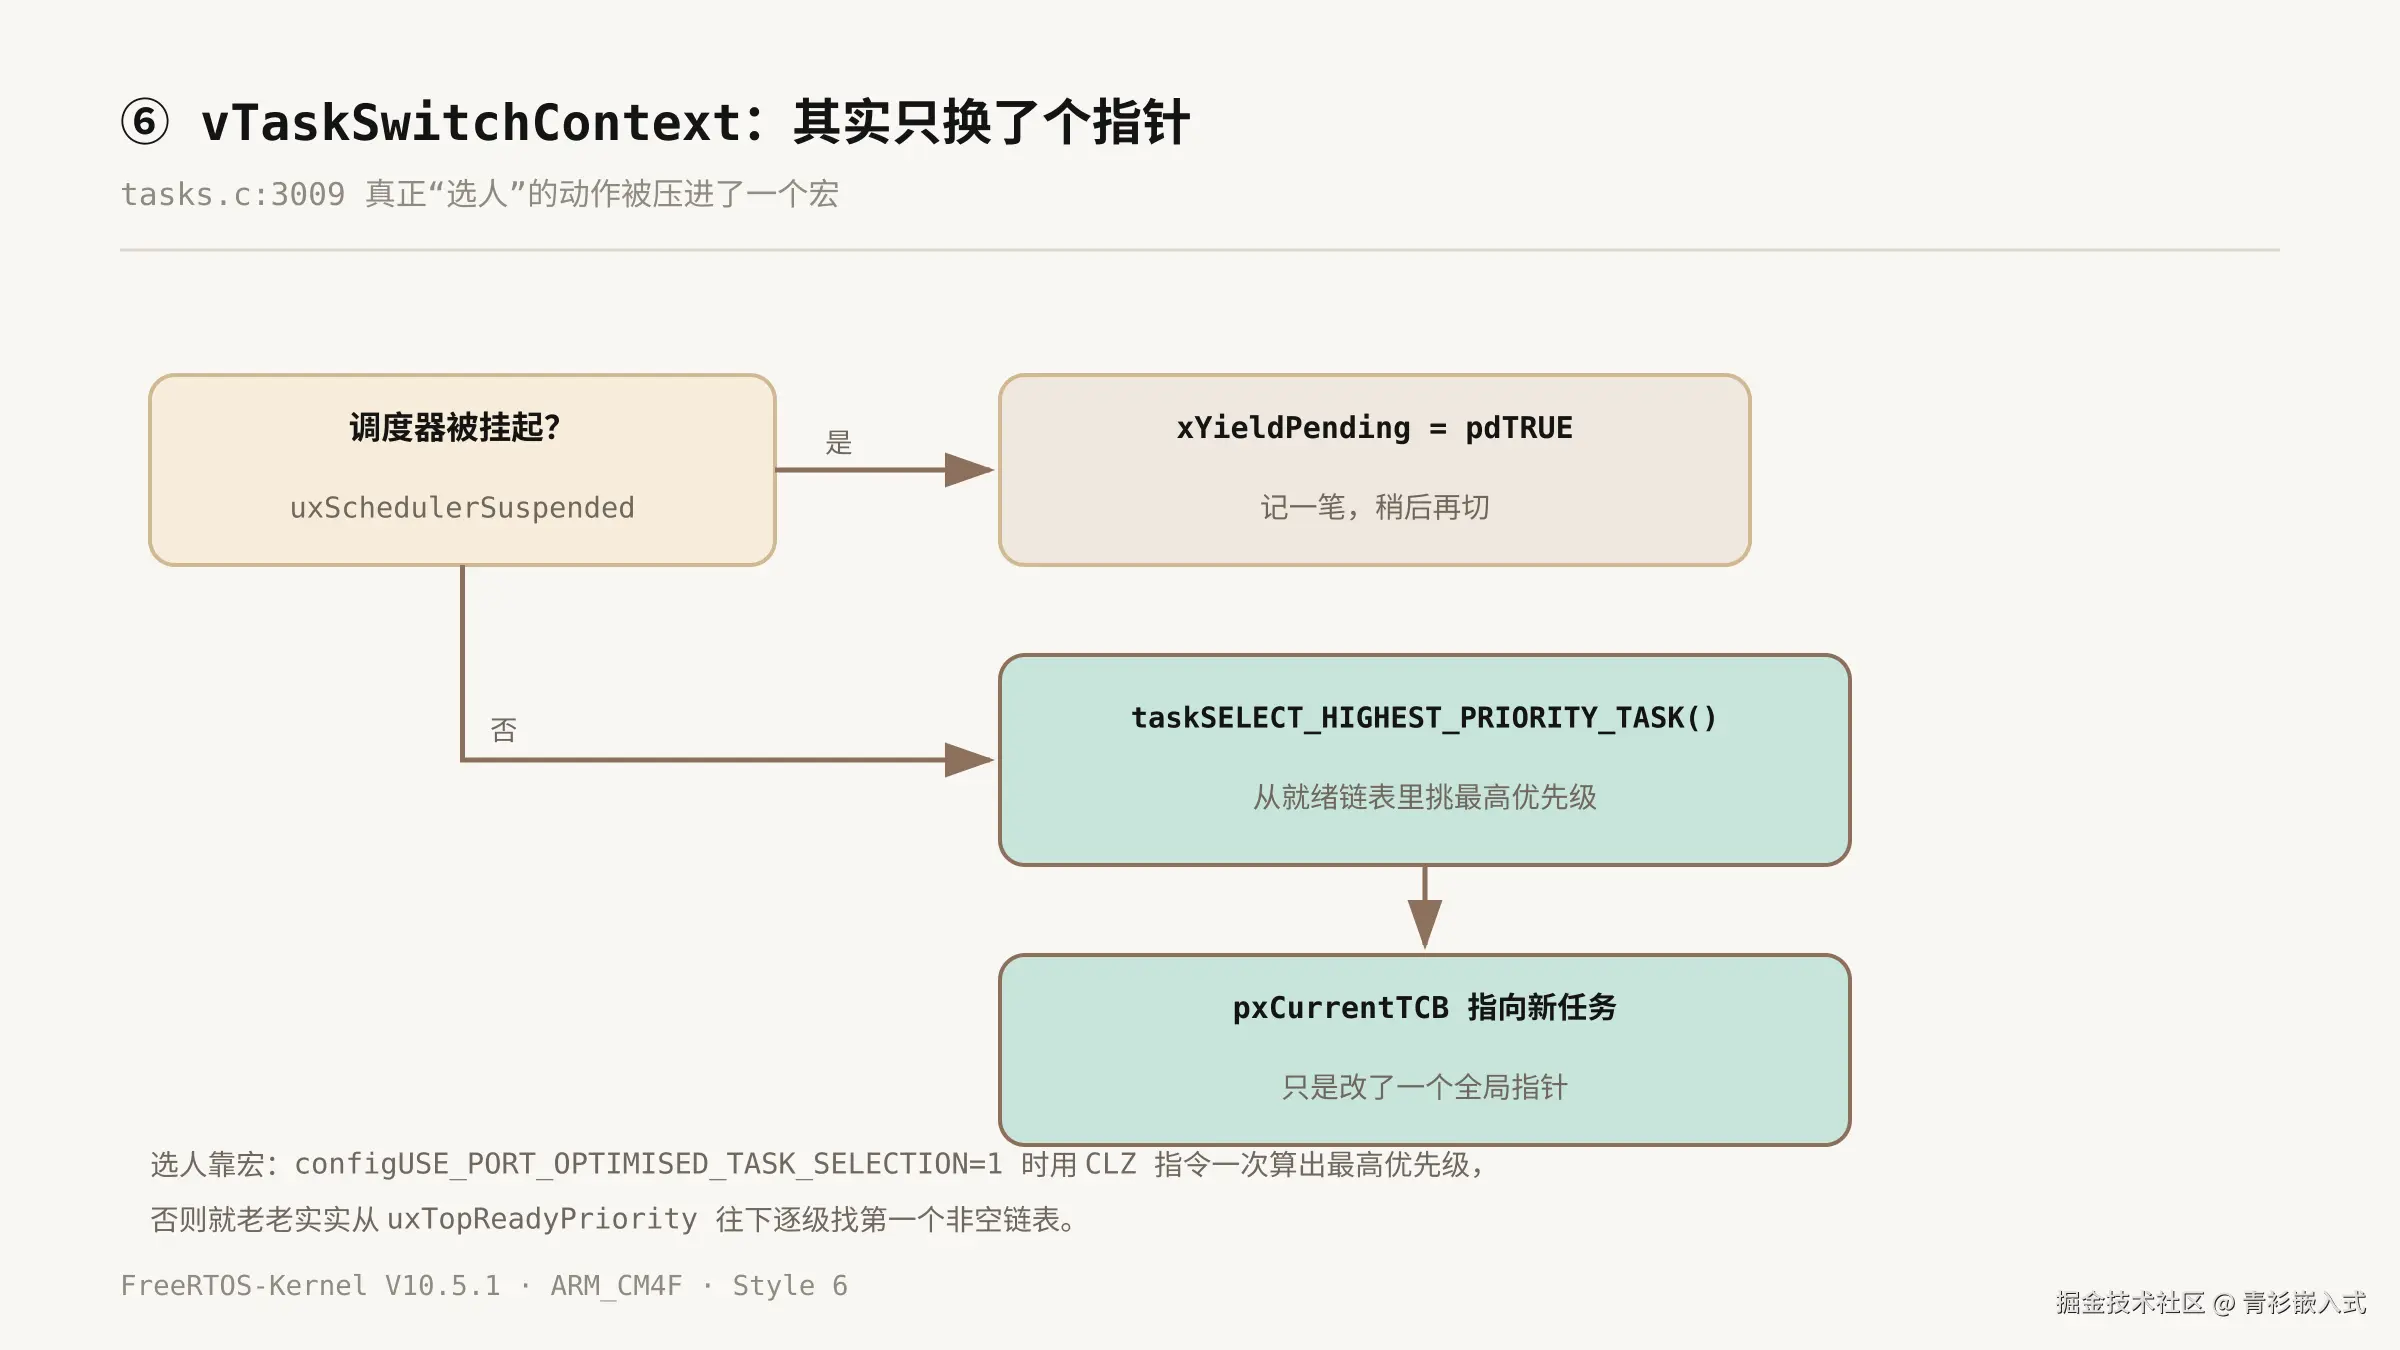
F6:它只改 pxCurrentTCB,寄存器的事它一概不管
记住这个分层:vTaskSwitchContext 负责"选谁",PendSV 负责"怎么换"。 两者通过 pxCurrentTCB 这一个全局变量交接,中间没有任何函数调用返回值的传递。
bx r14 之后发生了什么
bx r14 那一瞬间,CPU 发现目标地址是 EXC_RETURN 的编码,于是不跳转,而是启动异常返回流程。它要看两件事:用哪条栈 、要不要恢复浮点。
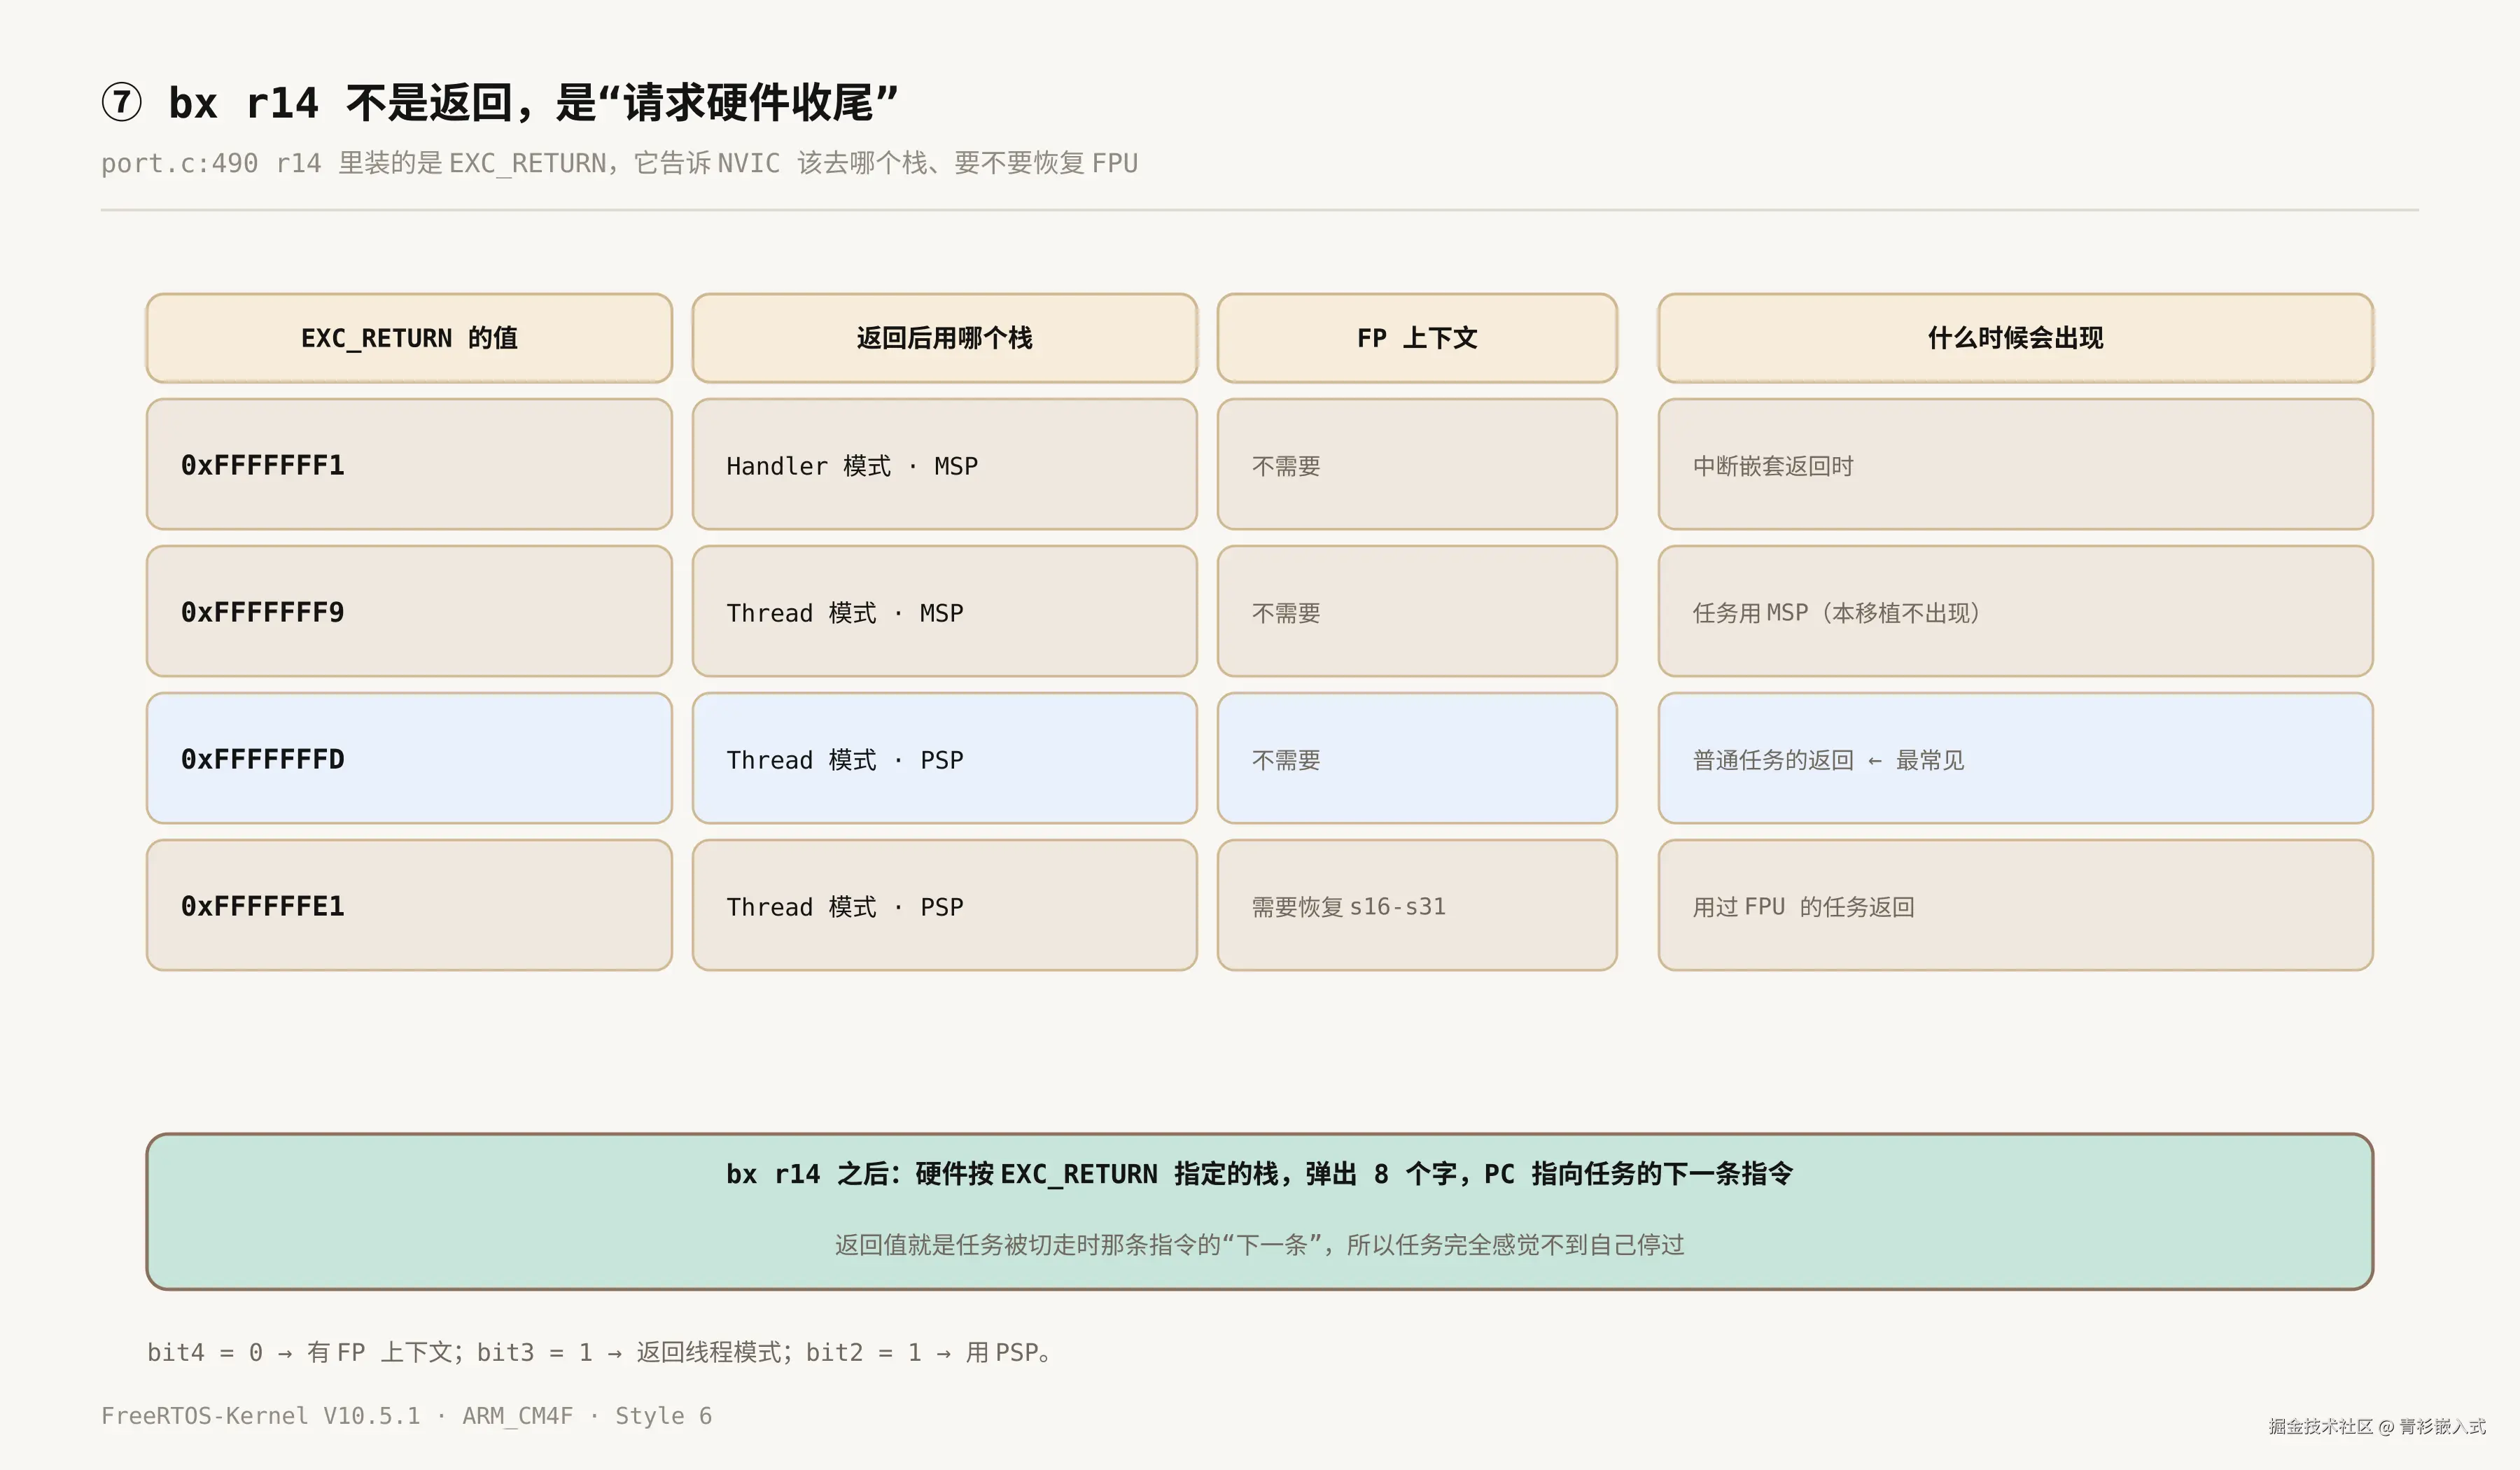
F7:四种 EXC_RETURN,日常只会见到 0xFFFFFFFD 和 0xFFFFFFE1
编码规则其实很直白,bit3 和 bit2 决定一切:
- bit3 = 1 → 返回 Thread 模式;= 0 → 返回 Handler 模式
- bit2 = 1 → 用 PSP;= 0 → 用 MSP
- bit4 = 0 → 有浮点上下文,需要恢复 s0~s15 + FPSCR
于是:
| 值 | 含义 |
|---|---|
0xFFFFFFF1 |
回 Handler 模式、用 MSP(中断嵌套返回) |
0xFFFFFFF9 |
回 Thread 模式、用 MSP(本移植不出现) |
0xFFFFFFFD |
回 Thread 模式、用 PSP(普通任务) |
0xFFFFFFE1 |
同上,但带浮点上下文 |
FreeRTOS 的 pxPortInitialiseStack() 里,假栈帧的 EXC_RETURN 就写死成 0xFFFFFFFD(portINITIAL_EXC_RETURN)。因为新任务默认是"没用过 FPU"的状态。
这张表读错会怎样?如果你把 0xFFFFFFFD 当成普通返回地址去 bx,CPU 会跳到一个非法地址,当场 HardFault;如果手工拼栈帧时把 bit4 弄反了,硬件会认为"这个任务没有浮点上下文",于是跳过 s0~s15 的恢复------任务继续算,最后得到一个看不出规律的小数。所以做栈切换相关的 hack 时,EXC_RETURN 只能"抄",不能"估"。
返回流程干的事,正好是异常进入的逆操作:从 PSP 弹出 xPSR、PC、LR、R12、R3~R0,然后把 PSP 加回 0x20。PC 弹出来的值,就是任务被切走时那条指令的下一条------所以任务恢复后接着往下跑,完全不知道自己中间停过几百毫秒。
到这里,一个完整的闭环就通了。回头看那几十行汇编,它其实只做了一件很朴素的事:把"当前 CPU 状态"从一个内存地址搬到另一个内存地址,然后让硬件相信这是一次正常的异常返回。
持续分享嵌入式开发经验,感谢点赞、关注!