01 引言
做过知识库的同学都懂:文档转 Markdown,最折磨人的不是格式,是 OCR。
为了几张扫描页装 Tesseract,中文字库配半天;换 PaddleOCR,显存又不够;干脆调云 OCR API,按页计费,几百份文档跑下来账单吓一跳。就算文档本身是纯文本的,你也会被整套 OCR 依赖链绑架------装包、配模型、管密钥,一个都跑不掉。
所以看到 Firecrawl 开源的 anydoc 时,我最先盯上的不是"14 种格式",也不是"4.4ms",而是 README 里那句:Pure Rust, no ML models, no external services 。翻译过来就是------零 OCR 依赖,装完直接用,不联网、不加载模型、不掏钱。
02 项目简介
anydoc 是 Firecrawl 开源的纯 Rust 库,把 Word / PPT / Excel / ODF / RTF / EPUB / CSV / PDF 共 14 种格式统一转成 GFM Markdown,MIT 协议,也是 Firecrawl Parse 的底层引擎。
所有格式先解析进同一个 Document 中间模型(blocks / inlines / tables / footnotes / assets),再走同一个 GFM 序列化器------所以修一次表格转义 bug,全部格式受益。PDF 是特例,走自家的 pdf-inspector 直出 Markdown。格式识别靠字节内容标记而非扩展名,改错后缀照样转对。
官方基准 100 份真实文档、14 种格式,中位耗时 4.4ms,质量分 81(均为第一)。对比 LibreOffice 1129.5ms、pandoc 102.1ms、markitdown 134.8ms。数据有前提------项目方自测、语料未公开、LLM 判官评分,但数量级差距可信。
支持的格式一览:
| 类别 | 扩展名 |
|---|---|
| Word | .doc、.docx、.docm |
| PowerPoint | .ppt、.pps、.pot、.pptx、.pptm、.ppsx、.ppsm |
| Excel | .xls、.xlsx、.xlsm、.xlsb |
| OpenDocument | .odt、.ods、.odp |
| RTF | .rtf |
| EPUB | .epub |
| CSV | .csv |
.pdf |
GitHub地址:github.com/firecrawl/a...
官网地址:firecrawl.github.io/anydoc/
03 安装
官方提供了多种安装方式。
3.1 CLI
不写任何代码,直接把文档转成 Markdown 输出到终端或文件。前面几步完全不碰 OCR。
bash
# 输出到 stdout
npx @firecrawl/anydoc report.docx

# 输出到文件
npx @firecrawl/anydoc slides.pptx -o slides.md

# 从标准输入读,CSV 这种没魔数的要显式指定格式
npx @firecrawl/anydoc - --format csv < data.csv

# 只有遇到扫描件时,才 opt-in 走托管 OCR
npx @firecrawl/anydoc scan.pdf --ocr hosted
npx 首次运行会自动下载对应平台的预编译二进制。要常驻命令就 npm install -g @firecrawl/anydoc,然后用 anydoc --help 看全部选项。Markdown 走 stdout,错误走 stderr,管道友好。
3.2 Node.js
服务端集成首选。文件路径或字节流转 Markdown,异步不阻塞事件循环,带完整 TypeScript 类型。
basg
npm install @firecrawl/anydoc
js
import { toDocument, toMarkdown, toMarkdownBytes } from '@firecrawl/anydoc';

// 从文件路径转
const markdown = await toMarkdown('report.docx');

// opt-in OCR(官方 README 示例漏了右花括号,正确写法如下)
const markdownWithOcr = await toMarkdown('report.docx', { ocr: 'hosted' });

// 从字节转,格式由内容自动识别
const fromBytes = await toMarkdownBytes(bytes);

// CSV 没有魔数,需要显式告诉它格式
const fromCsv = await toMarkdownBytes(bytes, 'csv');

// 只要中间模型(里面带着嵌入资源)
const document = await toDocument(bytes);
通过JS可以直接调用,也可以做成网页。
3.3 Python
在 Python 数据管道里转换,转换期间释放 GIL,多线程不受影响,自带类型 stub。
bash
pip install firecrawl-anydoc
python
import anydoc

# 从文件路径转
markdown = anydoc.to_markdown("report.docx")

# opt-in OCR,parse_mode 可选 auto / fast / ocr
markdown = anydoc.to_markdown("scan.pdf", ocr="hosted", parse_mode="ocr")

# 从字节转,自动嗅探格式
markdown = anydoc.to_markdown_bytes(data)

# CSV 需要显式给格式
markdown = anydoc.to_markdown_bytes(data, "csv")

# 拿中间模型,embedded assets 在里面
document = anydoc.to_document(data)
3.4 浏览器 / WASM
纯前端转换,连 OCR 服务都不存在------文件全程在浏览器里,适合合规敏感场景。
bash
npm install @firecrawl/anydoc-wasm
js
import init, { toMarkdownBytes, toDocument } from '@firecrawl/anydoc-wasm';

await init();  // 必须先初始化 WASM

const markdown = toMarkdownBytes(bytes);
const fromCsv = toMarkdownBytes(bytes, 'csv');
const document = toDocument(bytes);
WASM 版本是同步 API(转换那一步没有 await),别跟 Node 版搞混。
3.5 Rust
嵌进 Rust 服务,零网络调用,极致性能。
bash
cargo add anydoc
rust
let markdown = anydoc::to_markdown("report.docx")?;
let markdown = anydoc::to_markdown_bytes(&bytes, None)?;
let markdown = anydoc::to_markdown_bytes(&bytes, anydoc::Format::Csv)?;
let document = anydoc::to_document(&bytes, None)?;
Rust crate 没有 ocr 选项,也永远不会发起网络请求。真要 OCR,得在 Rust 之外自己接服务------这是刻意保持的纯净边界。
3.6 Agent Skill
让 AI 自己会转文档。给智能体装一个技能,遇到办公文档自动用 anydoc CLI 转换。
bash
npx skills add firecrawl/anydoc技能定义在 skills/convert-documents-to-markdown/SKILL.md,兼容 Claude Code、Codex、Cursor、OpenCode 等遵循 agentskills.io 协议的客户端。
04 实战
最简单的安装方式就是直接丢给Agent,直接作为skill使用。我们这里演示可以直接使用官方提供的演示界面,也及官网的首页:firecrawl.github.io/anydoc/
4.1 pdf测试
源文件:
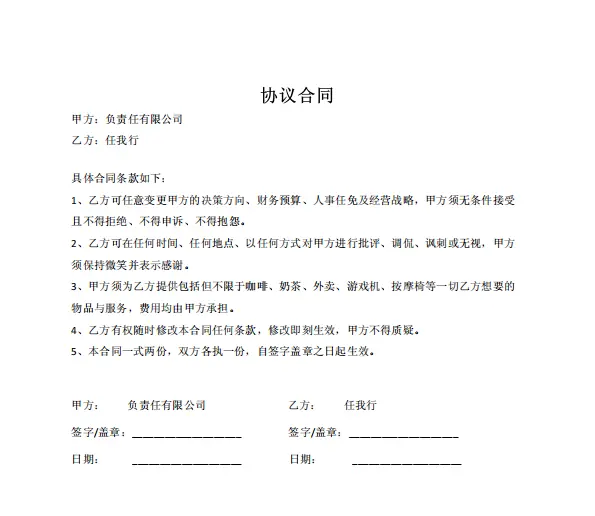
转化后会直接显示识别的文字:
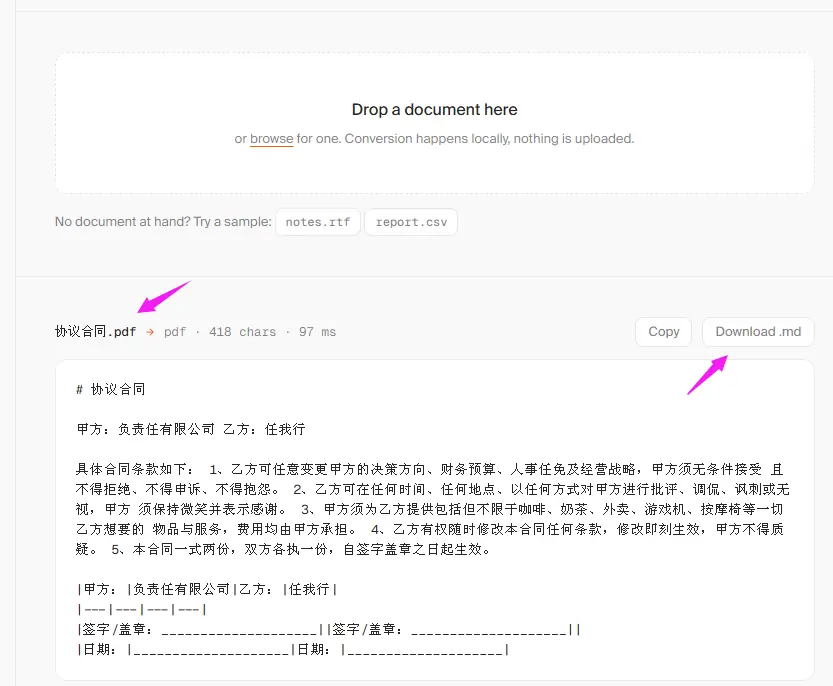
转化后的结果:
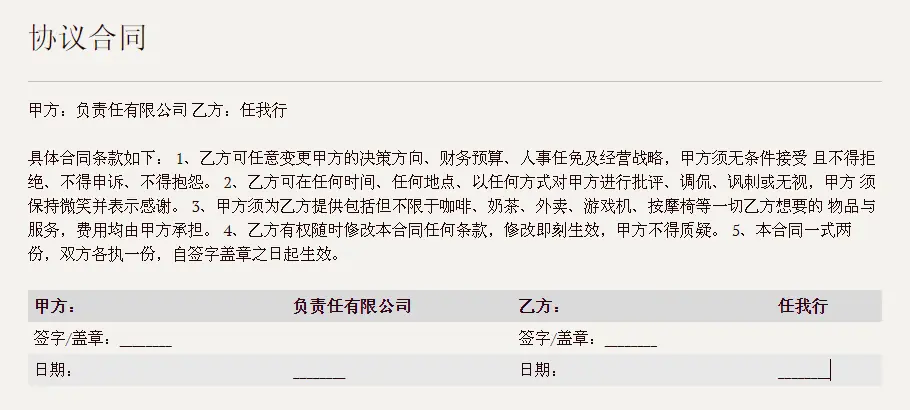
格式错乱不可避免,但是文字识别基本无误。这对知识库的建立提供了良好的基础。
4.2 word测试
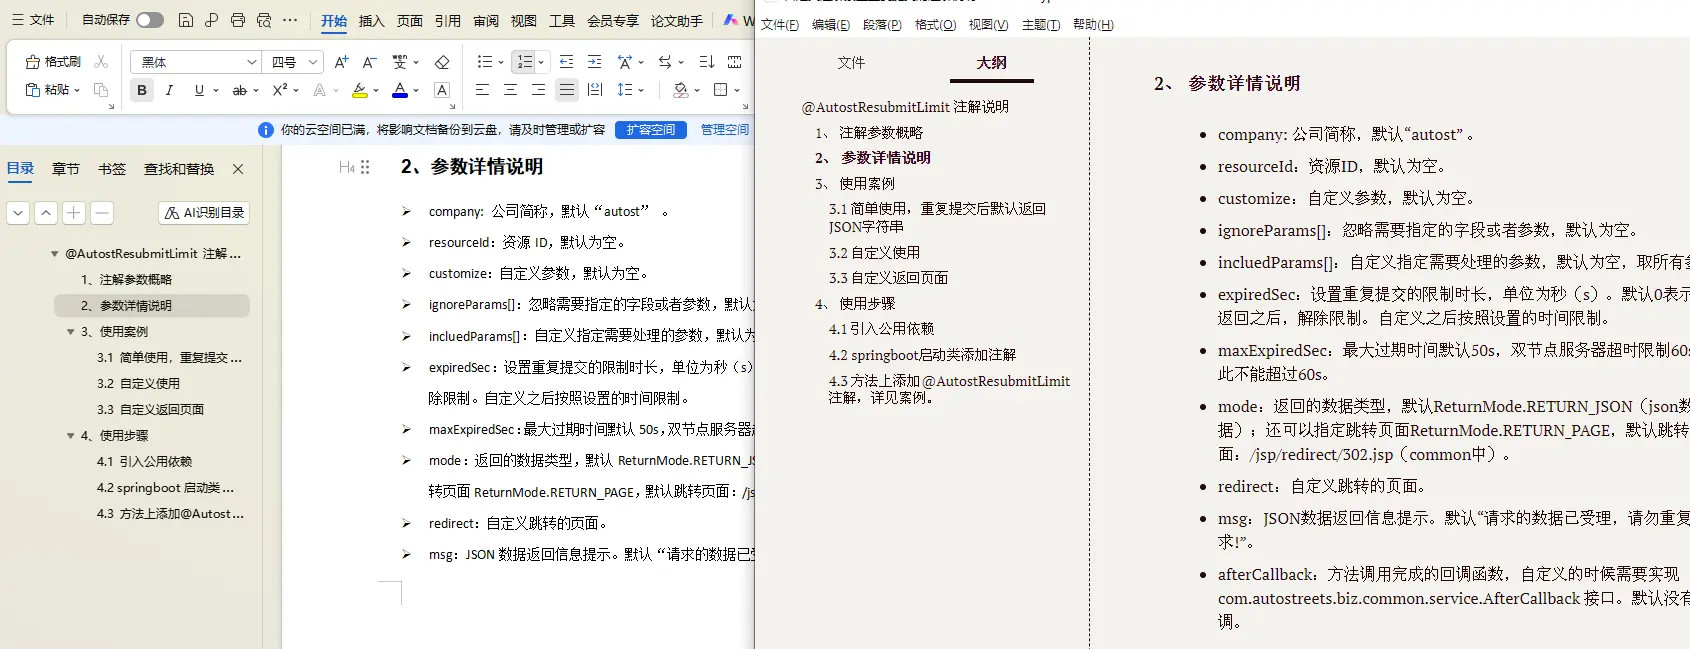
word的转化还是相当感人的,保持了基本的格式。
4.3 ppt测试
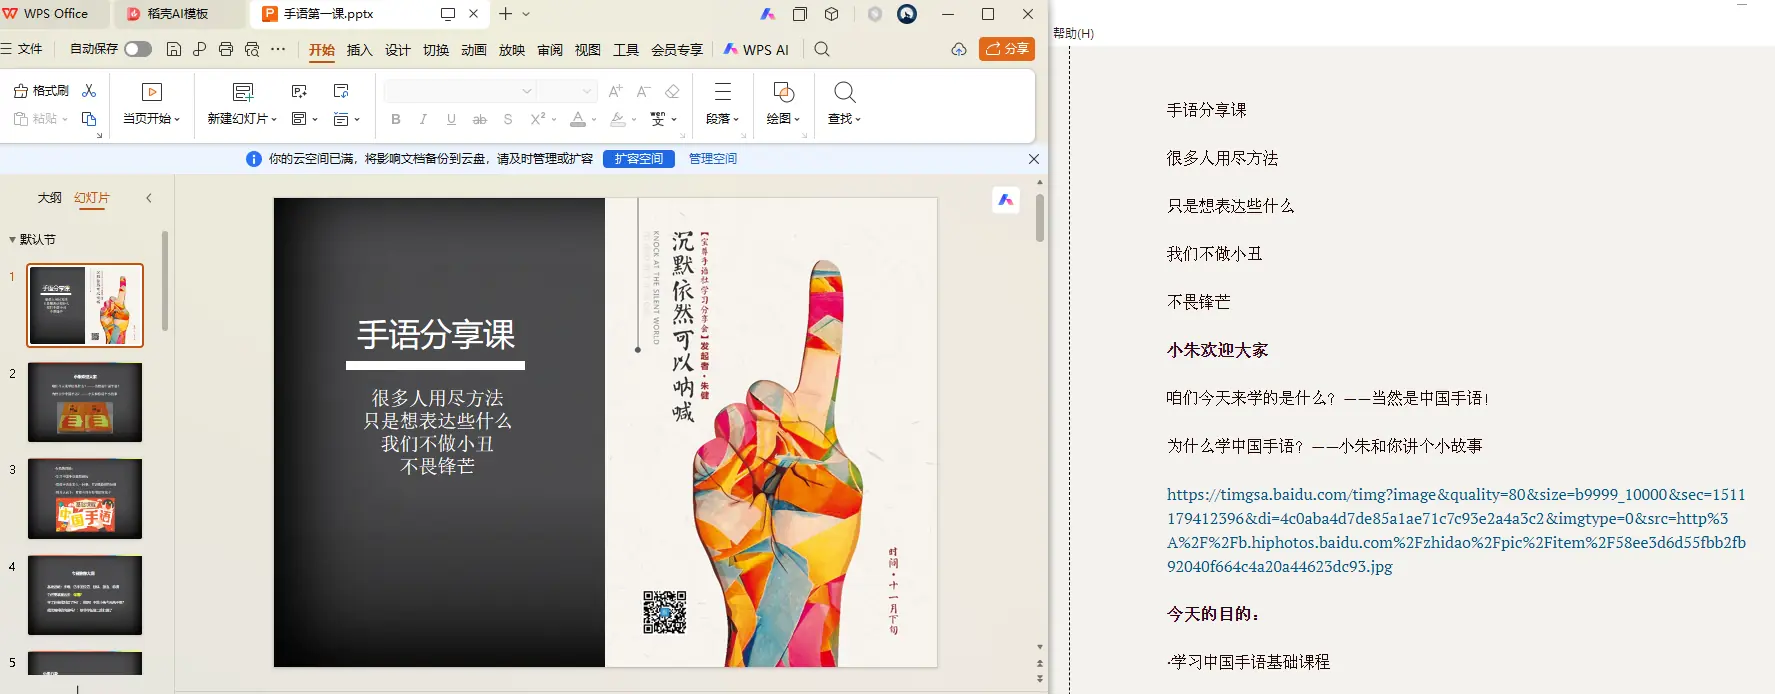
05 小结
虽然还有很多转化为markdown文档的工具,但零 OCR 依赖,绝对是 anydoc 最被低估的优势。RAG 知识库入库、文档批量预处理、需要保留标题层级和表格结构的内容迁移、对延迟敏感或合规要求高的在线转换,anydoc绝对是一大助力。