中小企业跑125B 大模型:18GB 显存之差,到底值多少吞吐
作者:吴佳浩 撰稿时间:2026-10-24 测试环境:
- GPU:RTX 5090(32GB VRAM,驱动 580.142,CUDA 13.0,PCIe Gen3 ×16,实测 13.9 GB/s)
- CPU:Intel Xeon Gold 5218 ×2(32 物理核 / 64 线程,2 个 NUMA 节点,无 AVX512-BF16)
- Memory:125.6 GiB RAM
- OS:Ubuntu 20.04.3 LTS(kernel 5.15.0-58)
- Engine:Strata v0.2.2(engine 0.1.47,CUDA 13.0,官方容器镜像)
- Model:Qwen3.8-Flash-Next Q2_0(125B 级 MoE,24,576 专家槽)
- 两轮配置完全相同 :
CONTEXT=32k / KV=int8 / PARALLEL=1 / VISION=cpu / MTP spec4 - 唯一变量:第一轮同机其他容器占了 GPU1 的 18,106 MiB;第二轮停掉它们
引言
面向工程师与研究者的体系化分析。 第一篇讲清了机制。这一篇只做一件事:把机制里的每一段,用实测数据钉死。 我把同一台机器、同一份模型、同一套参数跑了两轮,唯一区别是显卡上有没有别人的 18 GB。然后我从引擎日志里挖出 2,890 条逐请求遥测(每条都带「专家缓存命中率」和「PCIe 溢出比例」),把「显存 → 吞吐」这条链逐段拆开。 你可以把这篇当成一份「容量规划参考表」:给定显存,我告诉你能期待多少 tok/s;给定速度目标,我告诉你需要多少显存。
注:全文所有性能数字均来自本机两轮真实压测(合计 1,507 次请求、1,362 个资源采样点、317 个服务端指标采样点),未经验证的推算会明确标注。因为阿拉好奇,所以停掉别人占的卡,一道来白相相------看看这 18 GB 是"锦上添花"还是"生死攸关"。
目录
- 实验设计:只改一个变量
- [第一跳:显存 → 缓存覆盖率(干净的线性)](#第一跳:显存 → 缓存覆盖率(干净的线性) "#%E4%BA%8C%E7%AC%AC%E4%B8%80%E8%B7%B3%E6%98%BE%E5%AD%98--%E7%BC%93%E5%AD%98%E8%A6%86%E7%9B%96%E7%8E%87%E5%B9%B2%E5%87%80%E7%9A%84%E7%BA%BF%E6%80%A7")
- [第二跳:覆盖率 → 命中率(长尾的胜利)](#第二跳:覆盖率 → 命中率(长尾的胜利) "#%E4%B8%89%E7%AC%AC%E4%BA%8C%E8%B7%B3%E8%A6%86%E7%9B%96%E7%8E%87--%E5%91%BD%E4%B8%AD%E7%8E%87%E9%95%BF%E5%B0%BE%E7%9A%84%E8%83%9C%E5%88%A9")
- [第三跳:命中率 → PCIe 溢出(断崖)](#第三跳:命中率 → PCIe 溢出(断崖) "#%E5%9B%9B%E7%AC%AC%E4%B8%89%E8%B7%B3%E5%91%BD%E4%B8%AD%E7%8E%87--pcie-%E6%BA%A2%E5%87%BA%E6%96%AD%E5%B4%96")
- [为什么 1% 的溢出贵 39%](#为什么 1% 的溢出贵 39% "#%E4%BA%94%E4%B8%BA%E4%BB%80%E4%B9%88-1-%E7%9A%84%E6%BA%A2%E5%87%BA%E8%B4%B5-39")
- 三层效率:绝对、边际、能源
- [反例:显存多了,为什么不能开 parallel=4](#反例:显存多了,为什么不能开 parallel=4 "#%E4%B8%83%E5%8F%8D%E4%BE%8B%E6%98%BE%E5%AD%98%E5%A4%9A%E4%BA%86%E4%B8%BA%E4%BB%80%E4%B9%88%E4%B8%8D%E8%83%BD%E5%BC%80-parallel4")
- 硬件资源画像与瓶颈定位
- 稳定性与并发:排队语义的实证
- 结论与容量规划表
一、实验设计:只改一个变量
1.1 为什么这个实验值得做
大多数「本地大模型性能」文章的问题是:所有变量一起变。换了量化档、换了上下文、换了并发,然后报一个 decode 数字------这个数字没法归因。
我这次刻意做成单变量对照:
| 变量 | 第一轮 | 第二轮 |
|---|---|---|
| 模型 | Q2_0 | Q2_0(同一份文件) |
| 引擎 | 0.2.2 / engine 0.1.47 | 同 |
| 上下文 | 32K | 32K |
| KV 精度 | int8 | int8 |
| parallel | 1 | 1 |
| 视觉读图器 | CPU | CPU |
| MTP | spec4 | spec4 |
| GPU1 上其他占用 | 18,106 MiB(3 个容器) | 0 |
1.2 停掉的东西,以及怎么回滚
先交代清楚,避免误会成"破坏性操作":
| 容器 | 镜像 | 占用的 GPU1 显存 | 停止前已运行 |
|---|---|---|---|
ms_reranker7 |
ms_reranker:latest |
8,730 MiB | 8 天 |
ms_reranker8 |
ms_reranker:latest |
4,688 MiB | 8 天 |
ms_reranker9 |
ms_reranker:latest |
4,688 MiB | 8 天 |
| 合计 | 18,106 MiB |
- 停止方式是
docker stop -t 30(优雅停止,不是 kill) - 容器没有被删除 ,
docker start ms_reranker7 ms_reranker8 ms_reranker9即可完整恢复 - 完整容器配置快照已存档(
docker inspect全量 JSON) - 同机另一张卡(RTX 4090)上的 vLLM 全程未动
停完之后 GPU1 的状态:
text
index, name, memory.total, memory.used, memory.free
1, NVIDIA GeForce RTX 5090, 32607 MiB, 13743 MiB, 18367 MiB
pid, process_name, used_gpu_memory
2027940, .../strata, 13670 MiB
1.3 重部署后的第一件事:看缓存怎么自动扩
同一个镜像、同一套 -e 环境变量,重启后引擎自己把缓存吃满了:
text
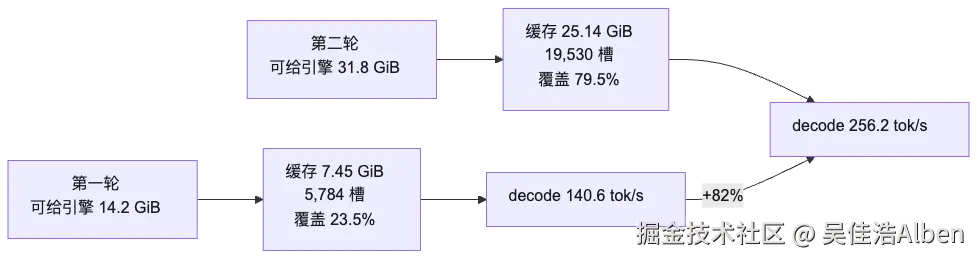
strata generate: expert cache auto: 8.31 GiB free, 700 MiB reserved (+184 MiB for the draft head) -> 5784 slots      # 第一轮
strata generate: expert cache auto: 26.01 GiB free, 700 MiB reserved (+184 MiB for the draft head) -> 19530 slots    # 第二轮
5,784 → 19,530,3.38 倍。 这就是第二篇全部故事的起点。
二、第一跳:显存 → 缓存覆盖率(干净的线性)
2.1 实测值
| 轮次 | 启动时空闲 | 固定预留 | 每槽 | 计算 | 实际槽位 | 覆盖率 |
|---|---|---|---|---|---|---|
| 第一轮 | 8,509 MiB | 884 MiB | 1.318 MiB | (8509−884)/1.318 = 5,786 | 5,784 | 23.5% |
| 第二轮 | 26,634 MiB | 884 MiB | 1.318 MiB | (26634−884)/1.318 = 19,537 | 19,530 | 79.5% |
两轮完全吻合,误差在 0.04% 内(来自字节对齐取整)。这是整条链上唯一一段"可以用计算器算出来"的关系,也是本文最有工程价值的一段------它意味着你不需要跑基准就能预估覆盖率。
2.2 固定开销恒定,是这条线性关系的前提
| 轮次 | 引擎总显存 | 专家缓存 | 固定开销 |
|---|---|---|---|
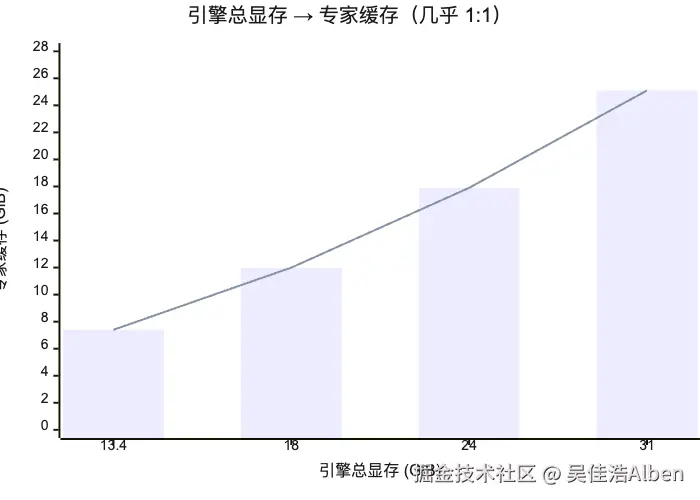
| 第一轮 | 13,670 MiB | 7,625 MiB | 6,045 MiB |
| 第二轮 | 31,674 MiB | 25,747 MiB | 5,927 MiB |
差 118 MiB,2%。固定开销不随缓存变大而变大,所以「多给的显存」几乎全部落进缓存。
三、第二跳:覆盖率 → 命中率(长尾的胜利)
3.1 实测
从引擎日志里抽出每条请求的 decode expert cache hit rate,按轮次统计(取生成 150--260 token 的可比样本):
| 轮次 | 命中率 p50 | 样本数 |
|---|---|---|
| 第一轮(共享) | 86.5% | 1,192 |
| 第二轮(独占) | 99.7% | 1,000 |
覆盖率 +56 个百分点,命中率只 +13.2 个百分点。 看起来像"收益递减",其实是长尾分布。
3.2 为什么覆盖率 23.5% 就能命中 86.5%
因为专家访问极度倾斜。Strata 有一个 expert-profile.bin(24,576 个排名对),按路由频率决定谁先占缓存:
text
strata generate: profile /opt/strata/terminal/data/expert-profile.bin: 24576 ranked pairs, built for 24576 slots
strata generate: pre-filled 5784 of 5784 slots from the profile in 0.6 s (12647 MB/s); slot 0 verified
于是第一轮那 23.5% 的槽位,装的恰好是最热的专家:
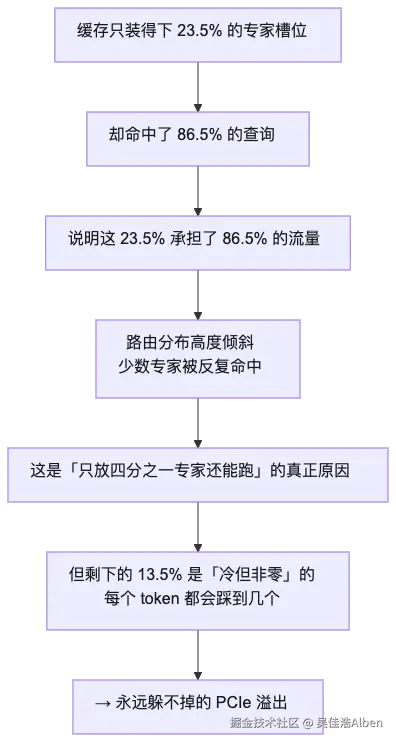
3.3 关键不在"命中率高低",在"剩下多少"
这里的直觉陷阱是:86.5% 听起来很高(接近九成),所以会觉得"还行"。
但反过来看才是对的:
erlang
第一轮:未命中 13.5%
第二轮:未命中  0.3%
→ 未命中的量差了 45 倍
性能是被"未命中"驱动的,不是被"命中"驱动的。 所以后面所有数据都指向同一个方向:盯着那 0.3% 到 13.5% 的区间,而不是盯着 86.5% 这个整数。
四、第三跳:命中率 → PCIe 溢出(断崖)
4.1 先把 2,890 条遥测摊开
我从引擎日志里把「专家缓存命中率」和「PCIe 溢出比例」两条逐请求记录配对,得到 2,890 条样本(跨两轮,覆盖短问答、长上下文、并发、过载各种负载)。按 PCIe 溢出比例分桶:
| PCIe 溢出比例 | 样本数 | Decode p50 | 相对最高 |
|---|---|---|---|
| 0 -- 0.5% | 1,681 | 231.8 tok/s | 100% |
| 0.5 -- 1% | 799 | 141.4 tok/s | 61% |
| 1 -- 2% | 151 | 138.0 tok/s | 60% |
| 2 -- 3% | 186 | 137.7 tok/s | 59% |
| 3 -- 5% | 33 | 132.3 tok/s | 57% |
| 5 -- 10% | 17 | 71.9 tok/s | 31% |
| 10 -- 20% | 22 | 69.8 tok/s | 30% |
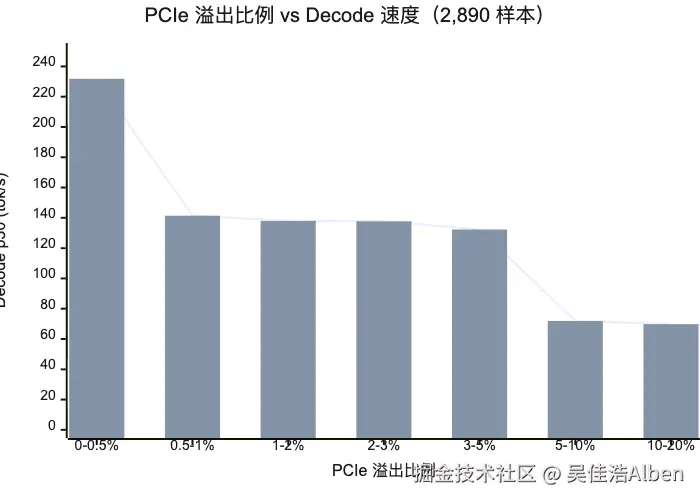
这张图是本文最重要的一张。
三个特征:
- 0 → 0.5% 之间是断崖 :231.8 掉到 141.4,−39%。
- 0.5% → 3% 几乎是平台:141.4 → 137.7,只掉 2.6%。说明"已经很慢了,再慢一点点也无所谓"。
- 5% 以上二次断崖:141 → 72,再掉一半。这时候系统已经进入"搬运主导"模式。
4.2 命中率分桶交叉验证
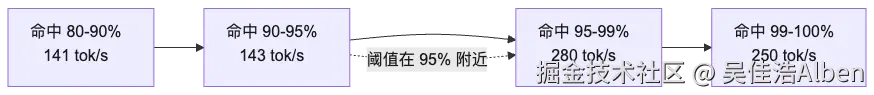
同一批样本按命中率分桶,结论一致:
| 命中率 | 样本 | Decode p50 | Decode 区间 |
|---|---|---|---|
| 30--50% | 5 | 57.4 | 27.0 -- 83.6 |
| 50--60% | 9 | 66.6 | 33.2 -- 132.3 |
| 60--70% | 149 | 136.9 | 26.8 -- 145.4 |
| 70--80% | 137 | 138.8 | 48.3 -- 155.7 |
| 80--90% | 1,403 | 141.1 | 67.3 -- 178.8 |
| 90--95% | 128 | 143.1 | 99.7 -- 211.2 |
| 95--99% | 90 | 280.3 | 126.2 -- 309.0 |
| 99--100% | 969 | 249.9 | 168.0 -- 342.6 |
Pearson 相关系数 r = 0.779(n = 2,890)。
注意 95% 处的跳变 :90--95% 还在 143,95--99% 直接 280。这不是线性爬坡,是跨过阈值后的换挡。
4.3 分轮次的直接对比
| 轮次 | 命中率 p50 | PCIe 溢出 p50 | Decode p50 | 区间 |
|---|---|---|---|---|
| 第一轮 | 86.5% | 0.50% | 139.8 | 67 -- 168 |
| 第二轮 | 99.7% | 0.00% | 253.1 | 126 -- 343 |
第二轮把 PCIe 溢出打到了 0.00% ------ 这是「+82% 吞吐」的直接来源。
五、为什么 1% 的溢出贵 39%
5.1 先按带宽算一遍,发现算不通
ini
每 token 480 次专家查表(48 层 × 10 专家)
× 1% 溢出 = 4.8 个专家
× 1.38 MB / 专家 = 6.6 MB / token
÷ 13.9 GB/s(实测 PCIe Gen3 ×16 带宽)= 0.47 ms / token

而 141 tok/s = 7.1 ms / token
→ 0.47 / 7.1 = 6.6%
理论上只该慢 6.6%,实测慢了 39%。差了 6 倍。
所以代价不是"搬得慢",是"等得久"。
5.2 真正的成本:流水线气泡
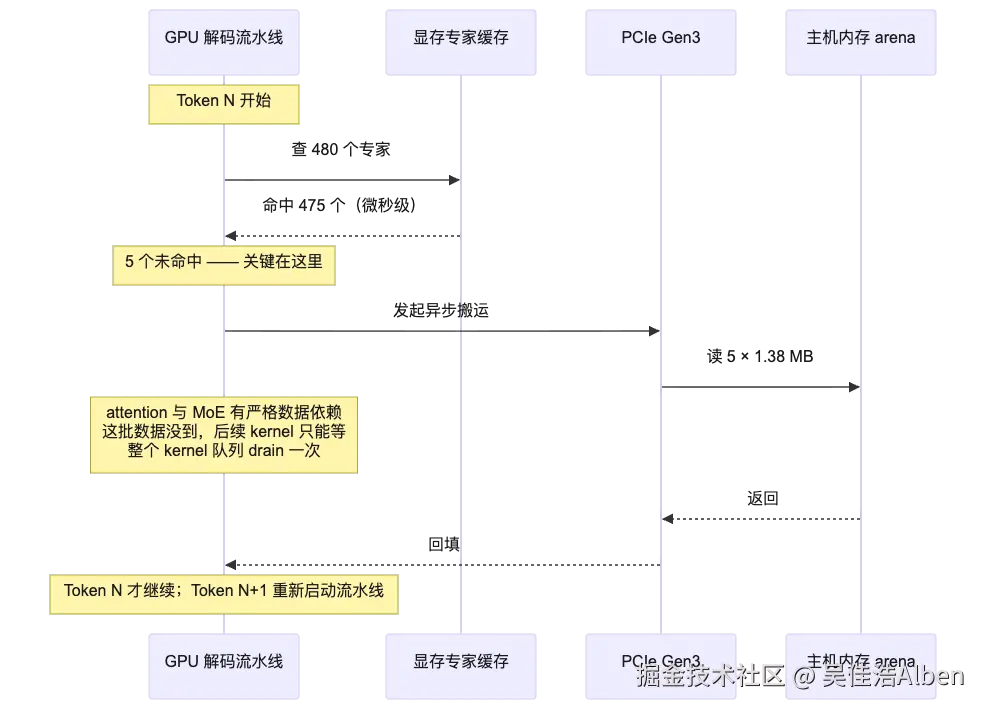
GPU 的计算是高度并行的,但依赖是串行的。一批专家没到,后面的算子只能干等;等的时候 SM 是 idle 的,但驱动仍然报告「occupied」------这就是「利用率 89% 却只跑一半速度」的来源。
5.3 用功耗曲线把"假忙"坐实
| 轮次 | GPU 利用率(均值) | 功耗均值 | 功耗峰值 | 功耗占上限 |
|---|---|---|---|---|
| 第一轮 | 89.1% | 229.7 W | 311.9 W | 40% -- 54% |
| 第二轮 | 89.8% | 336.7 W | 472.4 W | 59% -- 82% |
利用率几乎一样(89.1% vs 89.8%),功耗却差了 47%。
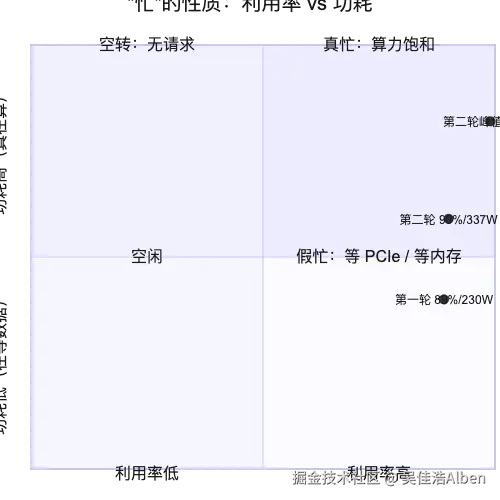
这是我这轮实验里觉得最值得记住的一条:
GPU 利用率是「有没有活干」,功耗才是「干的活有没有产出」。 两者背离时,瓶颈一定在数据搬运路径上。
六、三层效率:绝对、边际、能源
同样一组数字,用三种不同的分母去看,会得出三种不同的结论。这一节把三种都算出来,因为它们经常被混用。
6.1 绝对效率:每 GiB 显存换多少 tok/s
| 轮次 | 引擎显存 | Decode | tok/s per GiB |
|---|---|---|---|
| 第一轮 | 13.4 GiB | 140.6 | 10.5 |
| 第二轮 | 30.9 GiB | 256.2 | 8.3 |
看到这里,很多人会下结论:"边际收益递减"。这个结论是错的,因为它把固定开销也算进了分母。
6.2 边际效率:每多 1 GiB 专家缓存
ini
Δ专家缓存 = 25,747 − 7,625 = 18,122 MiB ≈ 17.7 GiB
Δdecode   = 256.2 − 140.6 = 115.6 tok/s
→ 6.53 tok/s per GiB 专家缓存正确算法是做线性拟合、把截距算出来:
bash
第一轮:7.45 GiB 缓存 → 140.6 tok/s
第二轮:25.14 GiB 缓存 → 256.2 tok/s

斜率 = (256.2 − 140.6) / (25.14 − 7.45) = 6.53 tok/s per GiB
截距 = 140.6 − 7.45 × 6.53 = 91.9 tok/s
也就是说:每加 1 GiB 缓存,线性加 6.53 tok/s。 截距 91.9 的含义是「缓存为 0 时的理论速度」------这是一个外推值,未实测,只用来验证线性拟合的自洽性,不能当成真实性能引用。
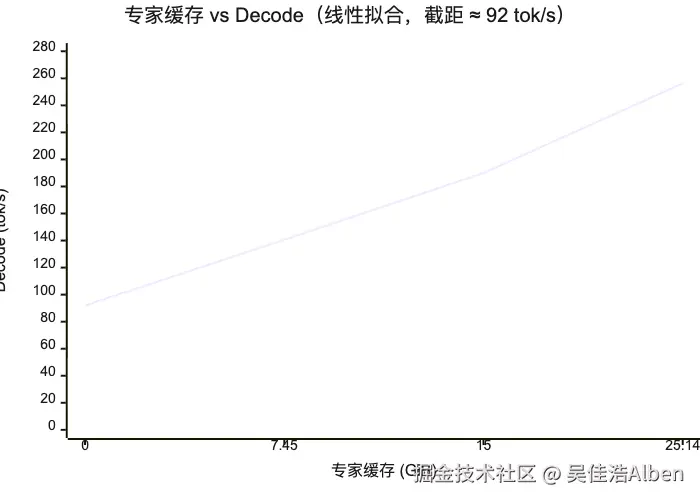
这条线性关系是本篇最实用的结论:它让「给定显存预测速度」变成一道乘法题,而不是必须跑基准。
6.3 能源效率:每 token 耗多少焦耳
这是最常被忽略、但对生产部署最重要的一层:
| 轮次 | 功耗均值 | Decode | J / token | 相对 |
|---|---|---|---|---|
| 第一轮 | 229.7 W | 140.6 tok/s | 1.634 J | 基准 |
| 第二轮 | 336.7 W | 256.2 tok/s | 1.314 J | −19.6% |
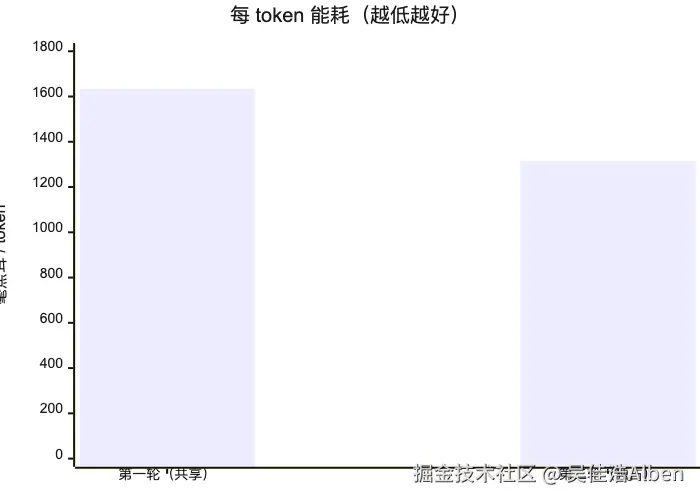
多花 47% 的电,做出 82% 更多的活 → 单位能耗降 20%。 这还是"假忙"的代价:等 PCIe 的时候 GPU 照样耗电,只是不产出。
6.4 三层汇总
| 层次 | 指标 | 第一轮 | 第二轮 | 正确结论 |
|---|---|---|---|---|
| 绝对 | tok/s per GiB 总显存 | 10.5 | 8.3 | 表面递减,误导 |
| 边际 | tok/s per GiB 缓存 | --- | 6.53 | 线性,不递减 |
| 能源 | J per token | 1.634 | 1.314 | −19.6% |
七、反例:显存多了,为什么不能开 parallel=4
显存变多之后,最自然的想法是"开更多并发"。我用 4 组配置做了对照,结论否定了这个直觉。
7.1 四组配置实测
| 配置 | 缓存 | slots | parallel | c=1 decode | c=4 每客户端 | 聚合峰值 |
|---|---|---|---|---|---|---|
| B1 基线 32K | 25.14 GiB | 19,530 | 1 | 204.3 | --- | 220.0(c=2) |
| B2a 32K | 22.90 GiB | 17,789 | 4 | 185.7 | 58.1 | 179.3(c=8) |
| B2d 64K | 22.25 GiB | 17,279 | 2 | 128.9 | 79.4 | 149.5(c=8) |
| B3 推荐 64K | 23.48 GiB | 18,240 | 1 | 218.9 | --- | 214.7(c=8) |
关键发现:parallel=4 的聚合吞吐(179.3)反而低于 parallel=1(220.0),而且单流 decode 从 204 掉到 186,4 并发时每客户端只剩 58 tok/s。
7.2 机制:并发不是扩容,是切分
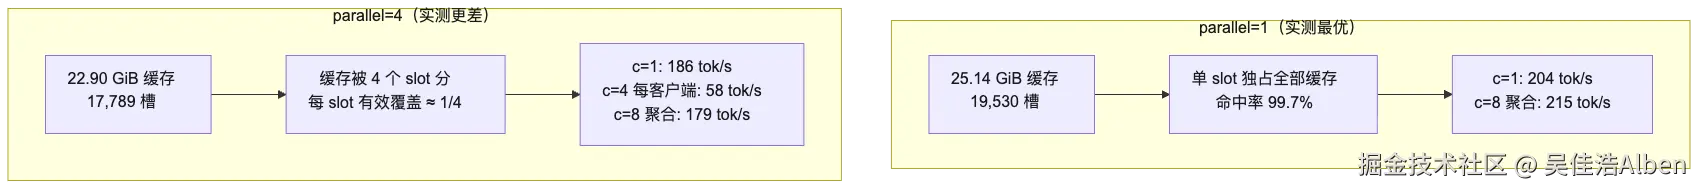
parallel=N 不是「把车加宽」,是「把油分成 N 份」。 每个 slot 的覆盖率降到约 1/N,PCIe 溢出暴涨,于是第四节那个"断崖"同时触发 N 次。
7.3 什么时候该开多槽
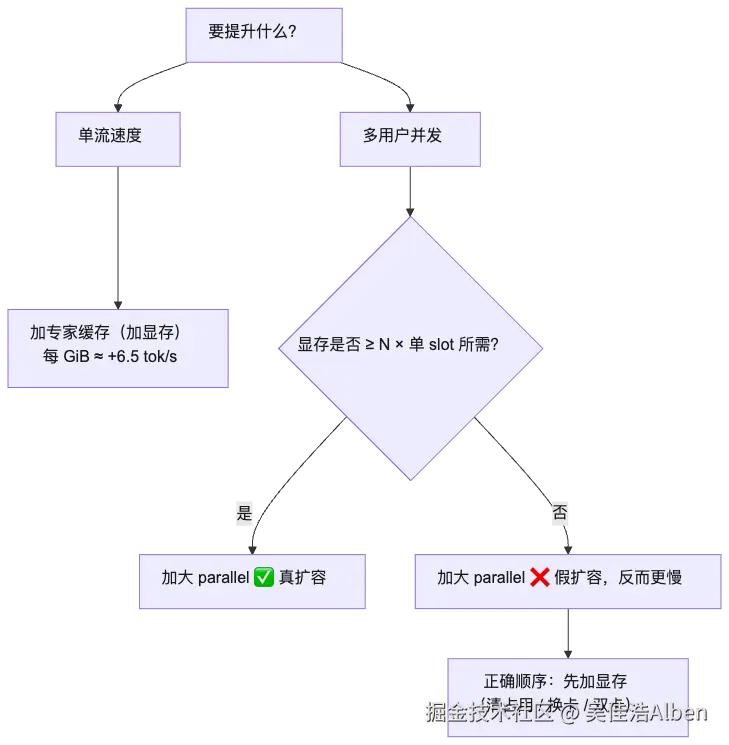
在这台 32GB 的卡上,parallel=1 是唯一正确解。
八、硬件资源画像与瓶颈定位
8.1 两轮的资源对比
采样 2 秒一次,两轮合计 1,362 个有效采样点:
| 指标 | 第一轮(共享) | 第二轮(独占) | 第二轮推荐配置 |
|---|---|---|---|
| GPU 利用率 均值 / p95 / max | 89.1% / 100% / 100% | 84.3% / 100% / 100% | 89.8% / 100% / 100% |
| 显存占用 | 31,864 MiB | 31,879 MiB | 31,830 MiB |
| 显存占用率 | 97.7% | 97.8% | 97.6% |
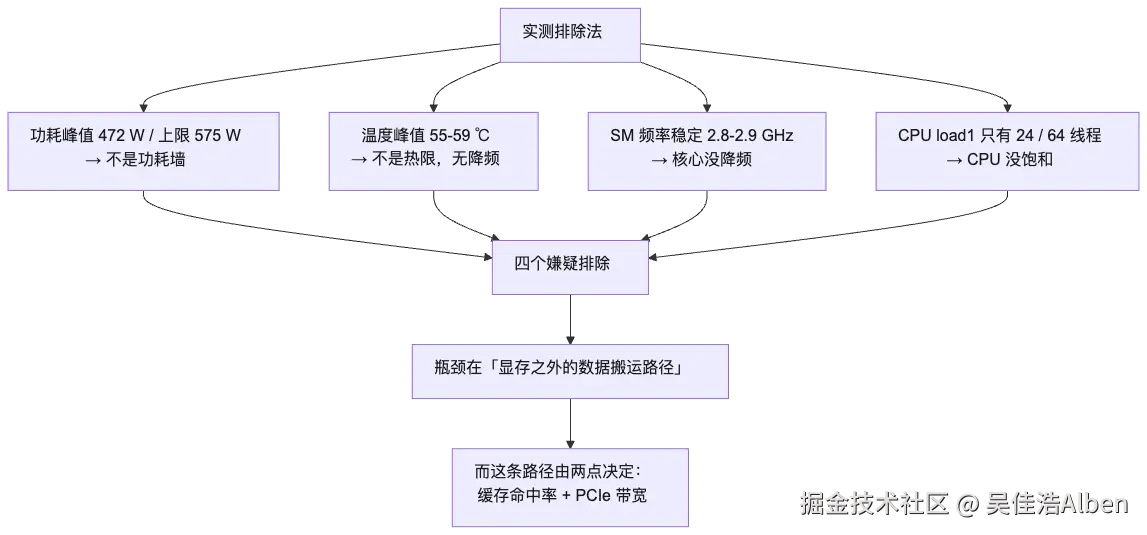
| 温度 均值 / max | 44.5 / 53 ℃ | 52.8 / 59 ℃ | 52.1 / 55 ℃ |
| 功耗 均值 / max | 229.7 / 311 W | 336.7 / 472 W | 336.8 / 466 W |
| SM 频率 均值 / max | 2,828 / 2,895 MHz | 2,820 / 2,887 MHz | 2,832 / 2,895 MHz |
| CPU load1 均值 / max | 26.3 / 32.1 | 20.3 / 28.0 | 24.2 / 30.4 |
| 系统内存 均值 | 104.97 GiB | 96.31 GiB | 96.74 GiB |
| MTP 接受率 | 64.0% | 63.5% | --- |
8.2 排除法:四个"常见嫌疑"全都不成立
8.3 两个硬约束
约束一:显存上限决定了覆盖率上限。
ini
卡上可用 ≈ 31.8 GiB
− 固定开销 6.0 GiB
= 25.8 GiB 可给缓存
÷ 1.318 MiB/槽 = 19,600 槽
÷ 24,576 = 79.8%
在 32GB 卡上,80% 覆盖就是天花板。 想上 100%,需要约 38.5 GiB 可用显存(= 32.1 GiB 缓存 + 6.0 GiB 开销),也就是 48GB 的卡。
约束二:PCIe Gen3 ×16 = 13.9 GB/s。
rust
strata generate: PCIe probe: 13.9 GB/s host->device (best of 13.8 13.8 13.9 13.9) -> pcie_frac 0.38 (default 0.55)这是引擎自己测的,也是第 4 节那个断崖的物理基础。RTX 5090 本身支持 Gen5,这张卡却插在 Gen3 ×16 的槽上------链路能力只有卡能力的四分之一。
8.4 瓶颈已经转移
| 阶段 | 主要瓶颈 | 证据 |
|---|---|---|
| 第一轮 | 显存不足 → 缓存小 → 专家走 PCIe | 覆盖率 23.5%;功耗只用 54%;CPU 只 26/64 线程 |
| 第二轮 | PCIe Gen3 + 单 slot | 覆盖率 79.8%;功耗用到 82%;decode 256 tok/s;并发不扩容 |
九、稳定性与并发:排队语义的实证
9.1 长稳:两轮都零失败
| 指标 | 第一轮(30 min @ c=1) | 第二轮(10 min @ c=1) |
|---|---|---|
| 请求 / 成功 | 1,122 / 1,122(100%) | 656 / 656(100%) |
| 请求速率 | 37.19 req/min | 64.52 req/min(+74%) |
| TTFT 均值 / p95 / max | 0.240 / 0.258 / 0.336 s | 0.158 / 0.165 / 0.218 s |
| Decode 均值 / p95 / min | 140.55 / 157.46 / 112.38 | 256.2 / 326.2 / 200.7 |
| 显存漂移 | 0 MiB(31,875 恒定) | 0 MiB(31,879 恒定) |
| 指标 | 第一轮(10 min @ c=4) | 第二轮(10 min @ c=4) |
|---|---|---|
| 请求 / 成功 | 385 / 385 | 660 / 660 |
| 请求吞吐 | 0.63 req/s | 1.07 req/s(+70%) |
| 聚合 token 吞吐 | 119.0 tok/s | 204.6 tok/s(+72%) |
| TTFT p50 / p95 / p99 | 4.958 / 5.238 / 5.355 s | 2.89 / 3.10 / 3.16 s |
| 漂移(前/后半程) | 4.967→4.954 s | 2.884→2.889 s |
两轮都是 100% 成功、零漂移、零显存泄漏。
9.2 并发扫描:吞吐平坦,延迟线性
| 并发 c | 第一轮 聚合 tok/s | 第二轮 聚合 tok/s | 第一轮 TTFT p50 | 第二轮 TTFT p50 |
|---|---|---|---|---|
| 1 | 86.8 | 192.0 | 0.28 s | 0.16 s |
| 2 | 116.4 | 220.0 | 1.63 s | 0.80 s |
| 4 | 119.4 | 216.5 | 3.24 s | 1.94 s |
| 8 | 122.0 | 213.2 | 6.23 s | 3.54 s |
| 16 | 118.6 | 209.3 | 13.15 s | 7.28 s |
这是「排队语义」的直接证据:
makefile
c:      1     2     4     8     16
吞吐:  192   220   216   213   209     ← 平坦(甚至微降)
TTFT: 0.16 0.80 1.94 3.54 7.28 ← 近似线性增长单张卡的专家搬运带宽是共享的。多客户端不会让它更快,只会让每个请求等更久。 这也解释了为什么第 7 节里 parallel=4 反而更差------它连"真并发"都没换来,只换来了缓存被切碎。
9.3 过载:32 并发时的行为
| 指标 | 第一轮 | 第二轮 |
|---|---|---|
| 请求 / 成功 | 32 / 32(100%,全 200) | 32 / 32(全 200) |
| 墙钟 | 20.94 s | 13.0 s |
| TTFT p50 / p95 / max | 10.95 / 19.19 / 20.47 s | 6.69 / 12.01 / 12.79 s |
两轮都没有拒绝请求,全部排队完成。这说明这套部署没有启用准入控制------生产环境该加队列上限,否则延迟会不可控地膨胀。
十、结论与容量规划表
10.1 五段传导链的实测结论

10.2 容量规划速查表
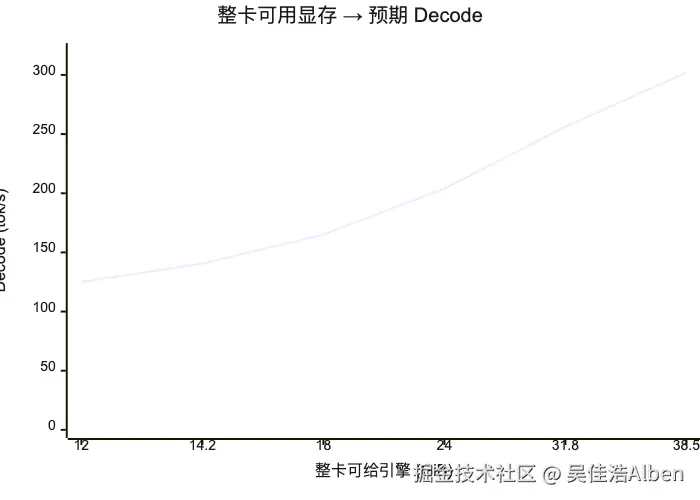
基于实测的两点(固定开销 ≈ 6.0 GiB、1.318 MiB/槽)和线性拟合(截距 92 tok/s、斜率 6.53 tok/s per GiB):
| 整卡可给引擎 | 专家缓存 | 覆盖率 | 预期命中率 | 预期 decode | 说明 |
|---|---|---|---|---|---|
| 12 GiB | 5.1 GiB | 16% | ~82% | ~125 tok/s | 勉强可用(缓存很薄) |
| 14.2 GiB | 7.45 GiB | 23.5% | 86.5% | 140.6 tok/s | 实测第一轮 |
| 18 GiB | 11.1 GiB | 35% | ~90% | ~165 tok/s | 推算 |
| 24 GiB | 17.1 GiB | 54% | ~96% | ~204 tok/s | 推算 |
| 31.8 GiB | 25.1 GiB | 79.5% | 99.7% | 256.2 tok/s | 实测第二轮(整卡) |
| ≥ 38.5 GiB | 32.1 GiB | 100% | 100% | ~300 tok/s | 48GB 卡可全驻留(推算) |
换算关系:
缓存 ≈ 整卡可用 − 6.0 GiB,槽位 = (缓存字节 − 884 MiB) / 1.318 MiB,decode ≈ 92 + 6.53 × 缓存GiB(92 为拟合截距,外推值)。
10.3 三句话收尾
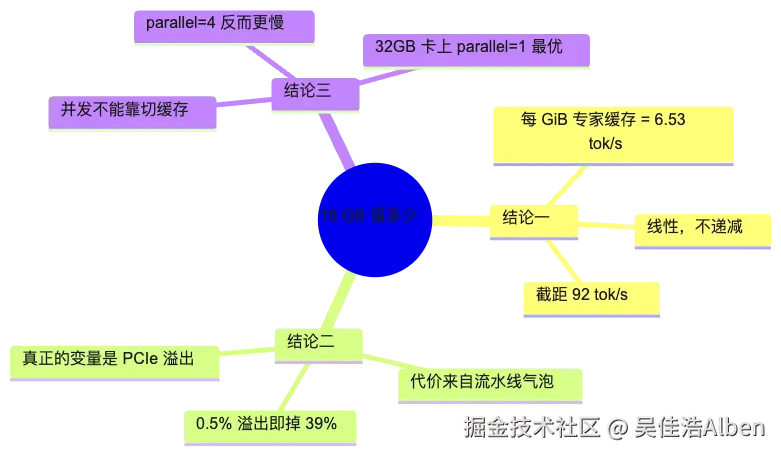
一句关键判断:显存不是"够不够",是"热专家放不放得下";而放不下的代价不是线性打折,是断崖。
10.4 这一篇的测量限制
- Decode 跨轮次可比,跨内容不完全可比:MTP 接受率随生成内容波动(实测 63.5%--64.0%,但单请求区间更宽),同轮内不同请求的 decode 天然有 ±15% 波动。
- 命中率与速度是相关性(r=0.779),不是严格因果;两者都由缓存覆盖率驱动,但请求长度、上下文长度是混杂因素。
- 容量规划表的 12 / 18 / 24 / 38.5 GiB 四行为推算,非实测;截距 92 tok/s 也是外推。
- KV 与"激活/CUDA 上下文"为结构推算,误差约 ±300 MiB。
- 只测了 Q2_0 + 32K/64K + parallel 1/2/4,未测 IQ3_XXS 等其他档位、未测多卡。
- PCIe 固定 Gen3 ×16:换到 Gen4/Gen5 后第 4 节的断崖位置会移动,"溢出比例"的门槛会变宽松,但"溢出 → 掉档"的定性结论不变。
- 同机另一张 4090 全程被 vLLM 占据(43,573 MiB,计算利用率 0%),未参与测量,但可能对 PCIe/内存带宽有轻微干扰。
附录 A:两轮基础压测原始数据
A.1 官方标准基准(strata bench run,同协议)
| 用例 | 第一轮 | 第二轮 | 变化 |
|---|---|---|---|
| short decode / TTFT | 136.8 tok/s / 0.389 s | 235.4 tok/s / 0.23 s | +72% / −41% |
| 4K prefill / TTFT / decode | 1,710.5 / 2.416 s / 132.6 | 3,520.6 / 1.18 s / 205.7 | +106% / −51% / +55% |
| 16K prefill / TTFT / decode | 3,314.4 / 4.99 s / 134.8 | 5,528.9 / 2.99 s / 218.4 | +67% / −40% / +62% |
| 质量检查(12 项) | 11/12 | 12/12 | +1 |
| 21 请求总耗时 | 81 s | 47 s | −42% |
A.2 长上下文对比(冷前缀)
| 提示词规模 | 第一轮 | 第二轮 |
|---|---|---|
| 5,702 tok | 2.54 s / prefill 2,204 / decode 139.0 | 1.42 s / 3,851 / 236.7 |
| 23,301 tok | 7.31 s / 3,182 / 153.8 | 4.27 s / 5,452 / 246.9 |
| 29,133 tok | 9.56 s / 3,047 / 136.8 | --- |
| 34,941 tok | ❌ 400(超 32K 窗口) | --- |
A.3 新解锁的能力
| 能力 | 第一轮 | 第二轮(推荐配置) |
|---|---|---|
| 最长可用提示词 | 29,133 tok(32K 窗口) | 43,677 tok(64K 窗口) |
| 新图片分析 TTFT | 3.57 s(CPU 读图) | 0.534 s(GPU 读图) |
| 图片显存代价 | 无法开启(只剩 410 MiB) | ~1,645 MiB(≈ −11 tok/s) |
附录 B:2,890 条遥测是怎么来的
引擎每处理完一条请求会写两行日志:
text
strata serve: prompt 26 tokens = 0 reused + 26 read in 43 ms, 192 generated in 1367 ms (140.5 tok/s), drafts accepted ...
strata serve: decode expert cache hit rate: 86.3% (23414 hits / 27131 lookups); 412 more read by the GPU over PCIe or from another GPU (2.31% of all 17850 routed)
我用脚本按顺序配对这两种行,得到每条请求的三元组 (命中率, PCIe 溢出比例, decode),跨两轮共 2,890 条。
- 采样覆盖:官方基准(短/4K/16K)、并发扫描(c=1/2/4/8/16)、长稳(c=1 与 c=4)、长上下文(4K/16K/18K/20K)、图片输入、过载(32 并发)
- 配对方式:只接受"生成行在前、命中率行紧随其后"的严格相邻对,避免错配
- 数据集:
results-fullvram/vram-efficiency-dataset.json(581 KB) - 相关系数按 Pearson 计算,n=2,890,r=0.779
邦友们,第二篇的数字就摆在这里了。
回头看,最让我意外的不是"+82%"这个结果,而是它其实是可以算出来的:一条 1.318 MiB/槽的公式,一个 6.53 tok/s per GiB 的斜率,一个 95% 附近的阈值。跑之前我就写下了四条预测,跑完之后四条全中------这比任何单个数字都更说明这套机制是"可理解"的,而不是"玄学"。
下一篇是这套系列的最后一篇,也是最能直接照做的一篇:从硬件自检、容器部署的三个坑、模型下载与格式校验,到启动、冒烟验证、五类压测的完整脚本,以及调优清单与故障速查表。所有命令和输出都是这台机器上真跑过的。
如果本文对你有所帮助,欢迎点赞、收藏、转发,也欢迎关注 「全栈架构师笔记」。下一次,我们继续一起把这些新东西跑明白、测明白,也讲明白。