效果预览(体验地址: http://emoji.timegogo.top/)
一、需求背景
mac 的「字符检视器」提供了大量可用的 Emoji**(📌✅ ★⚙...)**,但这些字符大多只绑定了极少量的关键词,且只能通过这些关键词进行检索。
而实际上很多字符能够表达的语义不止这些关键词。
于是当想要根据一个关键词去搜索与之语义相关/相近的图标时,可能出现搜不到的问题。
在撰写文档的过程中,就经常会出现这种问题,觉得文字太多了,想给某个标题/内容加一个视觉锚点,于是想直接按照标题/内容的简短文案去搜,结果发现根本搜不到。所以最终要么只能充分发挥自己的想象力🤔,要么放弃。而现在,你有了第三个选择,那就是用 「Emoji 语义检索」!
二、解决思路
1️⃣ 在官方给 emoji 设置的关键词基础之上,再**增加关键词的数量**,让一个 emoji 可以被更多的关键词命中。
2️⃣ 给 emoji 增加语义化的描述。从而在原有关键词检索的基础上,再**增加一层语义检索**,提高命中概率。
三、方案调研
3.0 目标和约束
约束:
- 本地没有 GPU,也租不起 GPU 服务器(完全不挣钱)。
- 在阿里云上发现有一个免费额度为 ¥300 的 ECS 服务器羊毛可以薅(使用最低规格 2 核 2 G 能薅 101 天,2 核 4 G 能薅 32 天),优先争取用最低规格来提供服务(能用久一点╮(╯▽╰)╭)。
目标:
- 将检索服务部署在本地或云服务,优先争取部署到云服务,达到对外可用的状态。
- 用最小的硬件成本,提供一个能基本满足要求的服务。
3.1 数据源
此处我们最终需要的数据是**「Emoji - (关键词列表 + 语义化描述)」**的映射对。
那么基础的 Emoji 数据源从哪里来呢?
Unicode CLDR(权威基准)
Unicode 官方 emoji 关键词源,包含 short name + keywords,所有 emoji 词库的源头。
这个库包含了全量的 unicode,但我们只需要其中的 emoji 部分即可,
unicode/cldr 仓库有专门存放 unicode + 关键词的 XML 文件 annotation,而且按照语言进行了区分。
同时配套了有 emoji 的清单文件 emoji-test.txt 可以用来过滤,只保留 emoji,排除其他 unicode 字符
xml
<annotation cp="♯">升号 | 升音符 | 音乐 | 音符</annotation>
<annotation cp="♯" type="tts">升号</annotation>
<annotation cp="😀">嘿嘿 | 笑脸 | 脸 | 高兴</annotation>
<annotation cp="😀" type="tts">嘿嘿</annotation>
plain
# subgroup: hand-fingers-open
1F44B               ; fully-qualified     # 👋 E0.6 waving hand
1F44B 1F3FB         ; fully-qualified     # 👋🏻 E1.0 waving hand: light skin tone
Emojibase(工程化 JSON)
基于 CLDR 预处理,自带多语言 JSON(含简体中文关键词),开箱即用。
json
[
  {
    "label": "笑哭了",
    "hexcode": "1F602",
    "tags": [
      "lol",
      "喜极而泣",
      "大笑",
      "眼泪",
      "笑",
      "笑哭",
      "脸"
    ],
    "emoji": "😂",
    "text": "",
    "type": 1,
    "order": 8,
    "group": 0,
    "subgroup": 0,
    "version": 0.6,
    "emoticon": ":')"
  },
]- label - 标签,一定不为空
- tags - 标签数组,可能为空
这两个字段可以都作为关键词的来源
使用方式:
- 通过 yarn/npm 直接安装
- 单独下载某个需要的 json 文件
EmojiNet(学术多义 emoji 词库)
2389 个 emoji,每个 emoji 区分多个语义 sense,附带关联关键词,解决 emoji 多义问题
json
[
  {
    "category": null,
    "keywords": ["racing", "running", "woman", "marathon"],
    "definition": "The female version of the ?? Runner emoji. The Woman Running emoji is a sequence of the ?? Runner, ? Female Sign and ? Variation Selector-16 http:\/\/emojipedia.org\/woman-running\/",
    "name": "woman running",
    "unicode": "U+1F3C3 U+200D U+2640 U+FE0F",
    "shortcode": null,
    "senses": {
      "adjectives": [
        {
          "bn:00109994a": [
            "Of advancing the ball by running",
            "Moving or advancing by running."
          ]
        }
      ],
      "verbs": [
        {
          "bn:00093170v": [
            "Move fast by using one's feet, with one foot off the ground at any given time",
            "To move quickly by alternately making a short jump off of either foot.",
            "To move forward quickly upon two feet by alternately making a short jump off either foot."
          ]
        },
        {
          "bn:00083395v": [
            "Move fast",
            "To drive fast.",
            "To move fast.",
            "To go fast.",
            "To drive fast; to step on the accelerator."
          ]
        }
      ],
      "nouns": [
        {
          "bn:00001530n": [
            "A woman is a female human.",
            "Female adult human",
            "An animal of the sex that produces eggs.",
            "An adult human member of the sex that produces ova and bears young.",
            "An adult female human.",
            "An adult female person (as opposed to a man)",
            "Adult female human being."
          ]
        },
        {
          "bn:00065828n": [
            "A competition of speed",
            "Competition where the goal is to complete the course as fast as possible",
            "The sport of competing in races.",
            "The sport of engaging in contests of speed",
            "Sport contest of speed.",
            "In sport, racing is a competition of speed, against an objective criterion, usually a clock or to a specific point."
          ]
        }
      ]
    }
  },
]- keywords,关键词列表
- definition,定义,本来是一个挺不错的数据;但是里面包含了多个未知含义的
?或??,而且最后还出现了一个 URI;所以感觉整体下来的可用度不是很高,有点可惜。 - secses,这里就是上面提到的多个语义 sense,包含了形容词、名词、动词等多个角度的定义,但是对于本次需求来说用不上。
emoji-datasource(iamcal,全量 JSON 元数据)
前端生态最流行 emoji 数据源,JSON 包含字符、codepoint、name、keywords、肤色变体,跟进 Emoji 16.0
json
[
    {
        "name": "WHITE UP POINTING INDEX",
        "unified": "261D-FE0F",
        "non_qualified": "261D",
        "docomo": null,
        "au": "E4F6",
        "softbank": "E00F",
        "google": "FEB98",
        "image": "261d.png",
        "sheet_x": 1,
        "sheet_y": 2,
        "short_name": "point_up",
        "short_names": [
            "point_up"
        ],
        "text": null,
        "texts": null,
        "category": "People & Body",
        "subcategory": "hand-single-finger",
        "sort_order": 170,
        "added_in": "1.4",
        "has_img_apple": true,
        "has_img_google": true,
        "has_img_twitter": true,
        "has_img_facebook": false,
        "skin_variations": {
            "1F3FB": {
                "unified": "261D-1F3FB",
                "image": "261d-1f3fb.png",
                "sheet_x": 1,
                "sheet_y": 3,
                "added_in": "6.0",
                "has_img_apple": true,
                "has_img_google": false,
                "has_img_twitter": false,
                "has_img_facebook": false,
            }
            ...
            "1F3FB-1F3FC": {
                ...
            }
        },
        "obsoletes": "ABCD-1234",
        "obsoleted_by": "5678-90EF"
    },
    ...
]
缺少关键词数据,不符合需求。
综合对比
综合对比上面四个开源的 emoji 数据集。
- ❌
unicode/cldr,虽然作为最权威的数据源,也是其他所有 emoji 数据的来源,但是它包含了全量的 unicode 字符,需要自行结合两个文件去进行筛选过滤,同时还需要转换格式,较为麻烦。 - ✅ ** **Emojibase 是当前看来最贴合需求,同时使用成本也是最低的一个数据源。
- ❌ EmojiNet 虽然注解最丰富,但是注解的可用性并不是很高。而且最为核心的关键词数据在 emoji base 中已经能够提供。
- ❌ Emoji datasource 中缺少关键词数据,不符合本项目的需求。
综上所述,最终选择使用 emoji base 这个数据源。
目前已经获得了 Emoji 对应的关键词,但是依然缺少语义化描述这一项,语义化描述需要在后面的处理中进一步补充。
3.2 双路召回方案
这个项目中希望结合「关键词检索」和「语义检索」两种检索方式。所以在检索上采用:**「稠密检索 + 稀疏检索 + 双路召回重排序」**的方案。
关于「稠密检索」的知识,可以看:《稠密检索(Dense Retrieval)》
关于「稀疏检索」的知识,可以看:《稀疏检索(Sparse Retrieval)》
关于「双路召回重排」的知识,可以看:《双路召回重排序》
3.2.1 双路集成实现
❌****方案一:Elasticsearch
自带 BM25 + 向量检索,但对于 emoji 场景太重,不适合。
方案二: 使用同时支持「稠密+稀疏」的模型
在《稠密检索(Dense Retrieval)》中介绍「主流模型」时,提到 BGE M3 模型能同时支持稠密向量、稀疏词向量、多向量检索(混合检索),一个模型同时做 Dense + Sparse。
除此之外,还有 mGTE-TRM (gte-multilingual-base)、UEmbed系列、**HyReC。**下面进行对比:
| 核心能力 | 中文检索表现 | 硬件成本(FP16 推理) | |
|---|---|---|---|
| BGE M3 | 568M 参数;稠密 + 稀疏 + ColBERT 多向量 三合一;8192 上下文;多语言支持 | C-MTEB 混合检索 nDCG@10 约 67 分;通用中文检索标杆,长短文本均衡,生态最成熟 | 显存约 1.2GB;CPU 可流畅运行;单句编码 < 5ms |
| mGTE-TRM | ~305M 活跃参数;稠密 + 学习型稀疏 双模式;8192 上下文;支持弹性维度裁剪 | C-MTEB 混合检索与 BGE M3 持平;长文本场景占优,短文本接近;工业级成熟度 | 显存约 0.7GB;比 BGE M3 轻量 40%+;编码速度快 30% 左右 |
| UEmbed 系列 | 2B/4B/9B 三档;稠密 + SPLADE 稀疏 双模式;多模态统一建模(文 / 图 / 视频) | 9B 版 MMEB-v2 稠密 71.8、稀疏 71.0,中文精度第一梯队;2B 版持平 BGE M3,4B 版明显超越 | 2B 版显存约 4GB;4B 版约 8GB;9B 版约 18GB;解码器架构推理延迟更高 |
| HyReC-base | ~110M 参数;稠密 + 词典式稀疏 一体化;中文分词歧义专项优化;仅支持短文本(512 上下文) | C-MTEB 混合检索 nDCG@10 约 70.4 分,比 BGE M3 高 3.4%;纯中文短文本精度突出 | 显存约 0.3GB;极轻量,CPU 无压力;工程化工具链不完善 |
中文检索表现:
精度排序(纯中文短文本检索):UEmbed-9B > HyReC-base > BGE M3 ≈ mGTE-TRM ≈ UEmbed-2B
通用场景均衡性排序:BGE M3 > mGTE-TRM > UEmbed > HyReC
硬件成本:
HyReC-base < mGTE-TRM < BGE M3 ≪ UEmbed-2B < UEmbed-4B < UEmbed-9B
模型选型结论:
- UEmbed 系列模型参数为亿级,在 emoji 这个场景性能完全过剩,但硬件成本高,不合适。
- HyReC-base 纯中文短文本精度突出的优势虽然恰好命中 emoji 这个场景的特征,但工程化工具链不完善,所以也舍弃。
- 顺排下来,BGE M3 是最优的选择。资源消耗与 mGTE-TRM 相近(略高),但精度和生态完善度都比 mGTE-TRM 更好。
选定模型之后,还需要确认 3 件事:
- 模型怎么加载?
- 编码出的稠密、稀疏向量怎么保存?
- 要不要 rerank?
1️⃣ 先说第一个问题,BGE M3 模型怎么加载?
这里选择**「FlagEmbedding 框架」**,它是BGE M3 的官方标准实现框架,是最稳定、最省心的落地方式。
2️⃣ 关于第二个问题,编码出的向量怎么保存?在 emoji 这个小语料的场景,有两种方案可选:
- 轻量方案:本地文件存储 ➕ 纯 Python 混合检索
- 工业级扩展方案:使用向量数据库,推荐 Qdrant(原生支持稠密 ➕ 稀疏混合检索,部署门槛最低)
在当前 emoji 检索的场景下,使用 Qdrant 相比本地存储+Python 检索 ,性能层面收益不明显,但在工程化层面有收益。
emoji 的语料在 5000 条以内,两种方案的检索延迟都在 1~2ms。但在持久化存储、并发访问这些方面,使用 Qdrant 更省事。
| 本地纯 Python 方案 | Qdrant 方案 | |
|---|---|---|
| 持久化存储 | 手动读写 npy/json 文件,程序启动全量加载到内存;数据量大时启动极慢 | 数据落地磁盘,支持增量读写,启动无需全量加载,随时可用 |
| 增量增删改 | 新增 / 删除 emoji 需重新编码、修改数组、重写文件,容易出错且无法原子操作 | 支持单条 / 批量增删改,实时生效,和操作普通关系型数据库一样简单 |
| 并发访问 | 原生单线程,做成 API 服务需要自己加锁、处理队列,容易出并发问题 | 原生支持 HTTP/gRPC 接口,内置并发处理,可直接作为检索服务对外提供 |
| 条件过滤 | 需要自己手写元数据过滤逻辑,先过滤再计算,性能差 | 原生支持 payload 字段过滤,可按分类、标签、情绪等条件筛选检索结果,索引级优化 |
该项目的目标是做成线上可用的服务,需要支持并发、存储等机制,所以向量保存层面,选择使用 Qdrant 的方案。
3️⃣ 关于第三个问题,要不要针对召回结果做一层 rerank?
结论是不需要。因为 emoji 场景的语料规模极小,召回的精度已经足够了,再加入 rerank 环节的性价比很低。
只有当语料规模很大,或者查询非常口语化、模糊化时;才有必要增加 rerank 环节。
相比「双路集成实现」,「双路分开实现」的方式具备以下优势:
- **组件完全解耦,选型自由度拉满。**稠密和稀疏都可以各自独立选择当前最优的方案,理论上能达到的精度上限更高。同时因为解耦了,两个组件可以独立升级迭代。
- 稀疏检索的可控性、解释性更强。BGE M3 的稀疏检索依靠的是内部的「学习型稀疏向量」,而非基于词频统计,属于黑盒检索。传统的 BM25 稀疏检索算法,完全基于词频统计匹配,逻辑逻辑透明可解释。
但同时它也有一些劣势:
- 工程复杂度显著提升了。需要维护两套独立的编码储存检索链路,需要额外开发结果融合、去重、排序的逻辑。
- 开箱即用效果更差,调优的门槛更高了。两路召回的分数分布差异大,融合逻辑会影响最终结果的优劣,调参成本高。
等一下,上面似乎忽略了一个很重要的问题 ------ 我是带着硬件成本上的硬约束(2 核 2 G 的云服务器)来设计方案的。
估算一下 BGE M3 + Qdrant 稳定运行的硬件规格最低要求是 4 核 4 G(🥲尴尬,超了)。
所以,目前看来,双路集成实现虽然省事,但我似乎没法用上了(穷)。
只能往双路分开实现上找出路了!
3.2.2 双路分开实现
这里的方案思路是:轻量稠密模型(少吃模型内存) + BM25 稀疏(不吃模型内存)
下面不再赘述,直接给出选型结论:
| 模块 | 最优选型 |
|---|---|
| 稠密检索模型 | gte-base-zh,加载框架用 sentence-transformers |
| 向量存储与检索引擎 | Qdrant |
| 稀疏检索实现 | Jieba 中文分词 + Qdrant 全文 BM25 索引 |
| 双路结果融合 | 首选 RRF(倒数秩融合),备选 分数归一化加权求和 |
gte-base-zh,中文专用轻量稠密检索模型,主打小体积、快推理、低资源占用,是工业界落地非常成熟的中文基础 Embedding 方案。在 2 核 2 G 的硬件环境下,ROI 最高:
- 资源压力极小 :原生 FP32 下内存仅 400MB 左右,INT8 量化后可压缩到 200MB 以内,搭配 Qdrant 和 Web 服务,2GB 内存非常宽裕,不会出现 OOM 风险;
- 效果完全够用:emoji 描述都是几十字以内的短文本,匹配逻辑以关键词 + 基础语义为主,gte-base-zh 的中文语义能力完全覆盖需求,和大模型的实际体验差异极小;
- 推理速度更快:2 核 CPU 环境下单次编码仅 20~30ms,端到端检索延迟更低,工具类场景体验更流畅。
四、实施流程
4.1 数据准备
目标数据格式:
json
{
  "label": "笑哭了",
  "hexcode": "1F602",
  "tags": [
    "lol",
    "喜极而泣",
    "大笑",
    "眼泪",
    "笑",
    "笑哭",
    "脸"
  ],
  "emoji": "😂",
  "description": ""
}
label,hexcode,tags,emoji直接来自 Emojibasedescription通过调用 LLM,根据label和tags字段来生成
- 从 Emojibase 下载原始数据,代码链接
- 结构化清洗(读入原始数据、过滤不可搜索的 item、统计摘要),代码链接
- 生成 description,调用 Deepseek API,基于 hexcode、label、tags、group 生成(分批合并 emoji,批量生成),代码链接
- 扩充 keywords,调用 Deepseek API,基于 label、tags、description、group 生成补充的关键词列表(批量扩充),代码链接
4.2 离线构建检索库
核心流程:语料准备 → 分词预处理 → 稠密编码 → Qdrant 建库写入
4.3 双路检索 + RRF 融合(在线查询)
- 双路召回默认取前 50 个结果 ,通过常量
CANDIDATE_K设置。 - RRF 融合后,默认取前 20 个结果 ,默认值由常量
DEFAULT_LIMIT设置,另外可以通过 query 查询参数limit修改。 - 双路之间的融合权重比例默认为 1:1 ,通过常量
DENSE_WEIGHT和SPARSE_WEIGHT修改。
4.4 低配服务器专项优化
为了适配 2 核 2 G 的低配置硬件规格,
- 部署环境去掉 torch 运行时,改用 ONNX Runtime,节省运行时内存。
容器部署路径不安装 PyTorch,而是用 ONNX Runtime(CPU 执行器)加载离线导出的 gte-base-zh ONNX 图。
torch 运行时有额外几百 MB 的常驻内存消耗(算子库、线程池、CUDA 探测桩),使用 ONNX Runtime 省掉这额外几百 MB 的常驻内存开支。 - 动态 INT8 量化,节省运行时内存、计算开销。
权重经动态量化为 per-channel QUInt8,权重减小到原来的 1/4(388M -> 98M),权重是常驻内存,这部分节省 75% (约290MB)的常驻内存开支。
查询速度也提升 2 倍+。
精度代价在可接收范围内:与 fp32 余弦 0.97--0.98,检索 hit@5 仍为 20/20。 - **batch_size=64 分批编码,防 OOM
**dense 编码时,按 64 的批大小执行,last-hidden-state 为 64 * 128 * 768 * 4B ≈ 25MB;如果全量 emojis(1923 条)一次性送入编码,last-hidden-state 为 1923 * 128 * 768 * 4B ≈ 755MB,OOM 的概率大。
4.5 FastAPI + GUI
服务端使用的是 Python 技术栈,选择 FastAPI 框架来将 search 函数暴露为 HTTP 接口。
emoji 搜索交互形式固定,UI 没有频繁更新的需求,因此直接用最简的 html + css + js 实现。
4.6 部署发布
部署的目标是阿里云 ECS 实例。
编写部署脚本 deploy.sh,一键执行部署。
部署核心动作:
- **同步代码与资产,**同步范围包括:前后端代码、脚本、Docker 配置、data 数据、及其它配置文件等等。
- **预置基础镜像,把 **python3.12和 qdrant 提前拉到 ECS 的 docker 本地镜像库,后续构建不需要再联网拉取。
- **构建镜像,**在 ECS 上执行
docker compose build,构建 api service 的镜像。 - **启动 Compose,**启动 qdrant 和 api service 两个容器。
- **健康检查,**本次发起一个 curl 请求,确保容器 run 成功,服务已经可用。
总结
本项目具有两个显著的特征:
第一个是检索的对象 emoji,语料规模很小,并且全部为中文短文本。
第二个是**硬件成本非常受限**,只有一个 2 核 2G 的 ECS 弹性计算服务实例。而实际上可用的内存容量比标注的 2G 还要更小,只有 1.6G 的总容量,(另外接近 400 MB 的内存空间来自于硬件保留 + 内核预留 + kdump 预留)。
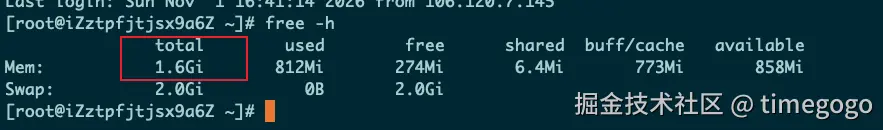
结合上述两个特征,决定了我必须选一个足够小但是又够用的模型,来尽可能降低对硬件要求,尤其是对内存的要求。但还好 emoji 的语料规模恰好很小,不到 2000 条长度基本在十几个词到几十个词的中文短文本,所以小参数模型也能有足够好的表现,反而大参数模型对于效果的提升不显著。
另外,其实相比起模型性能,语料本身的质量对检索效果的影响占比更高,「更贴切的语义描述」、「更多相关的关键词」,这两个因素需要做好。
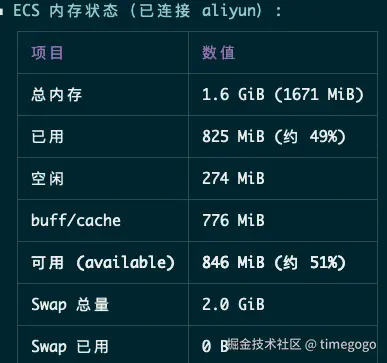
那么最终,通过用 ONNX Runtime 推理框架替换 torch,动态 INT8 量化权重等方式,最终把一个 emoji 的稠密稀疏检索服务塞进了一台 2 核 2 G 的 ECS 实例中,并且还留出了足够(50%)的资源余量。
| 进程 | 内存占用 |
|---|---|
| uvicorn 进程( 即 api service) | 424MB / 24.7% |
| docker 和 qdrant | 67MB / 3.9% |
最终效果呈现(附上访问链接: http://emoji.timegogo.top/)
完结撒花 🎉🎉