随着 大模型 与向量检索技术的飞速发展,传统的纯文本关键词搜索(如基于 BM25 的倒排索引)在面对图片、语音、视频片段及跨模态复杂查询时已显得力不从心。如何构建一个能听、能看、能懂语义的统一智能搜索平台?
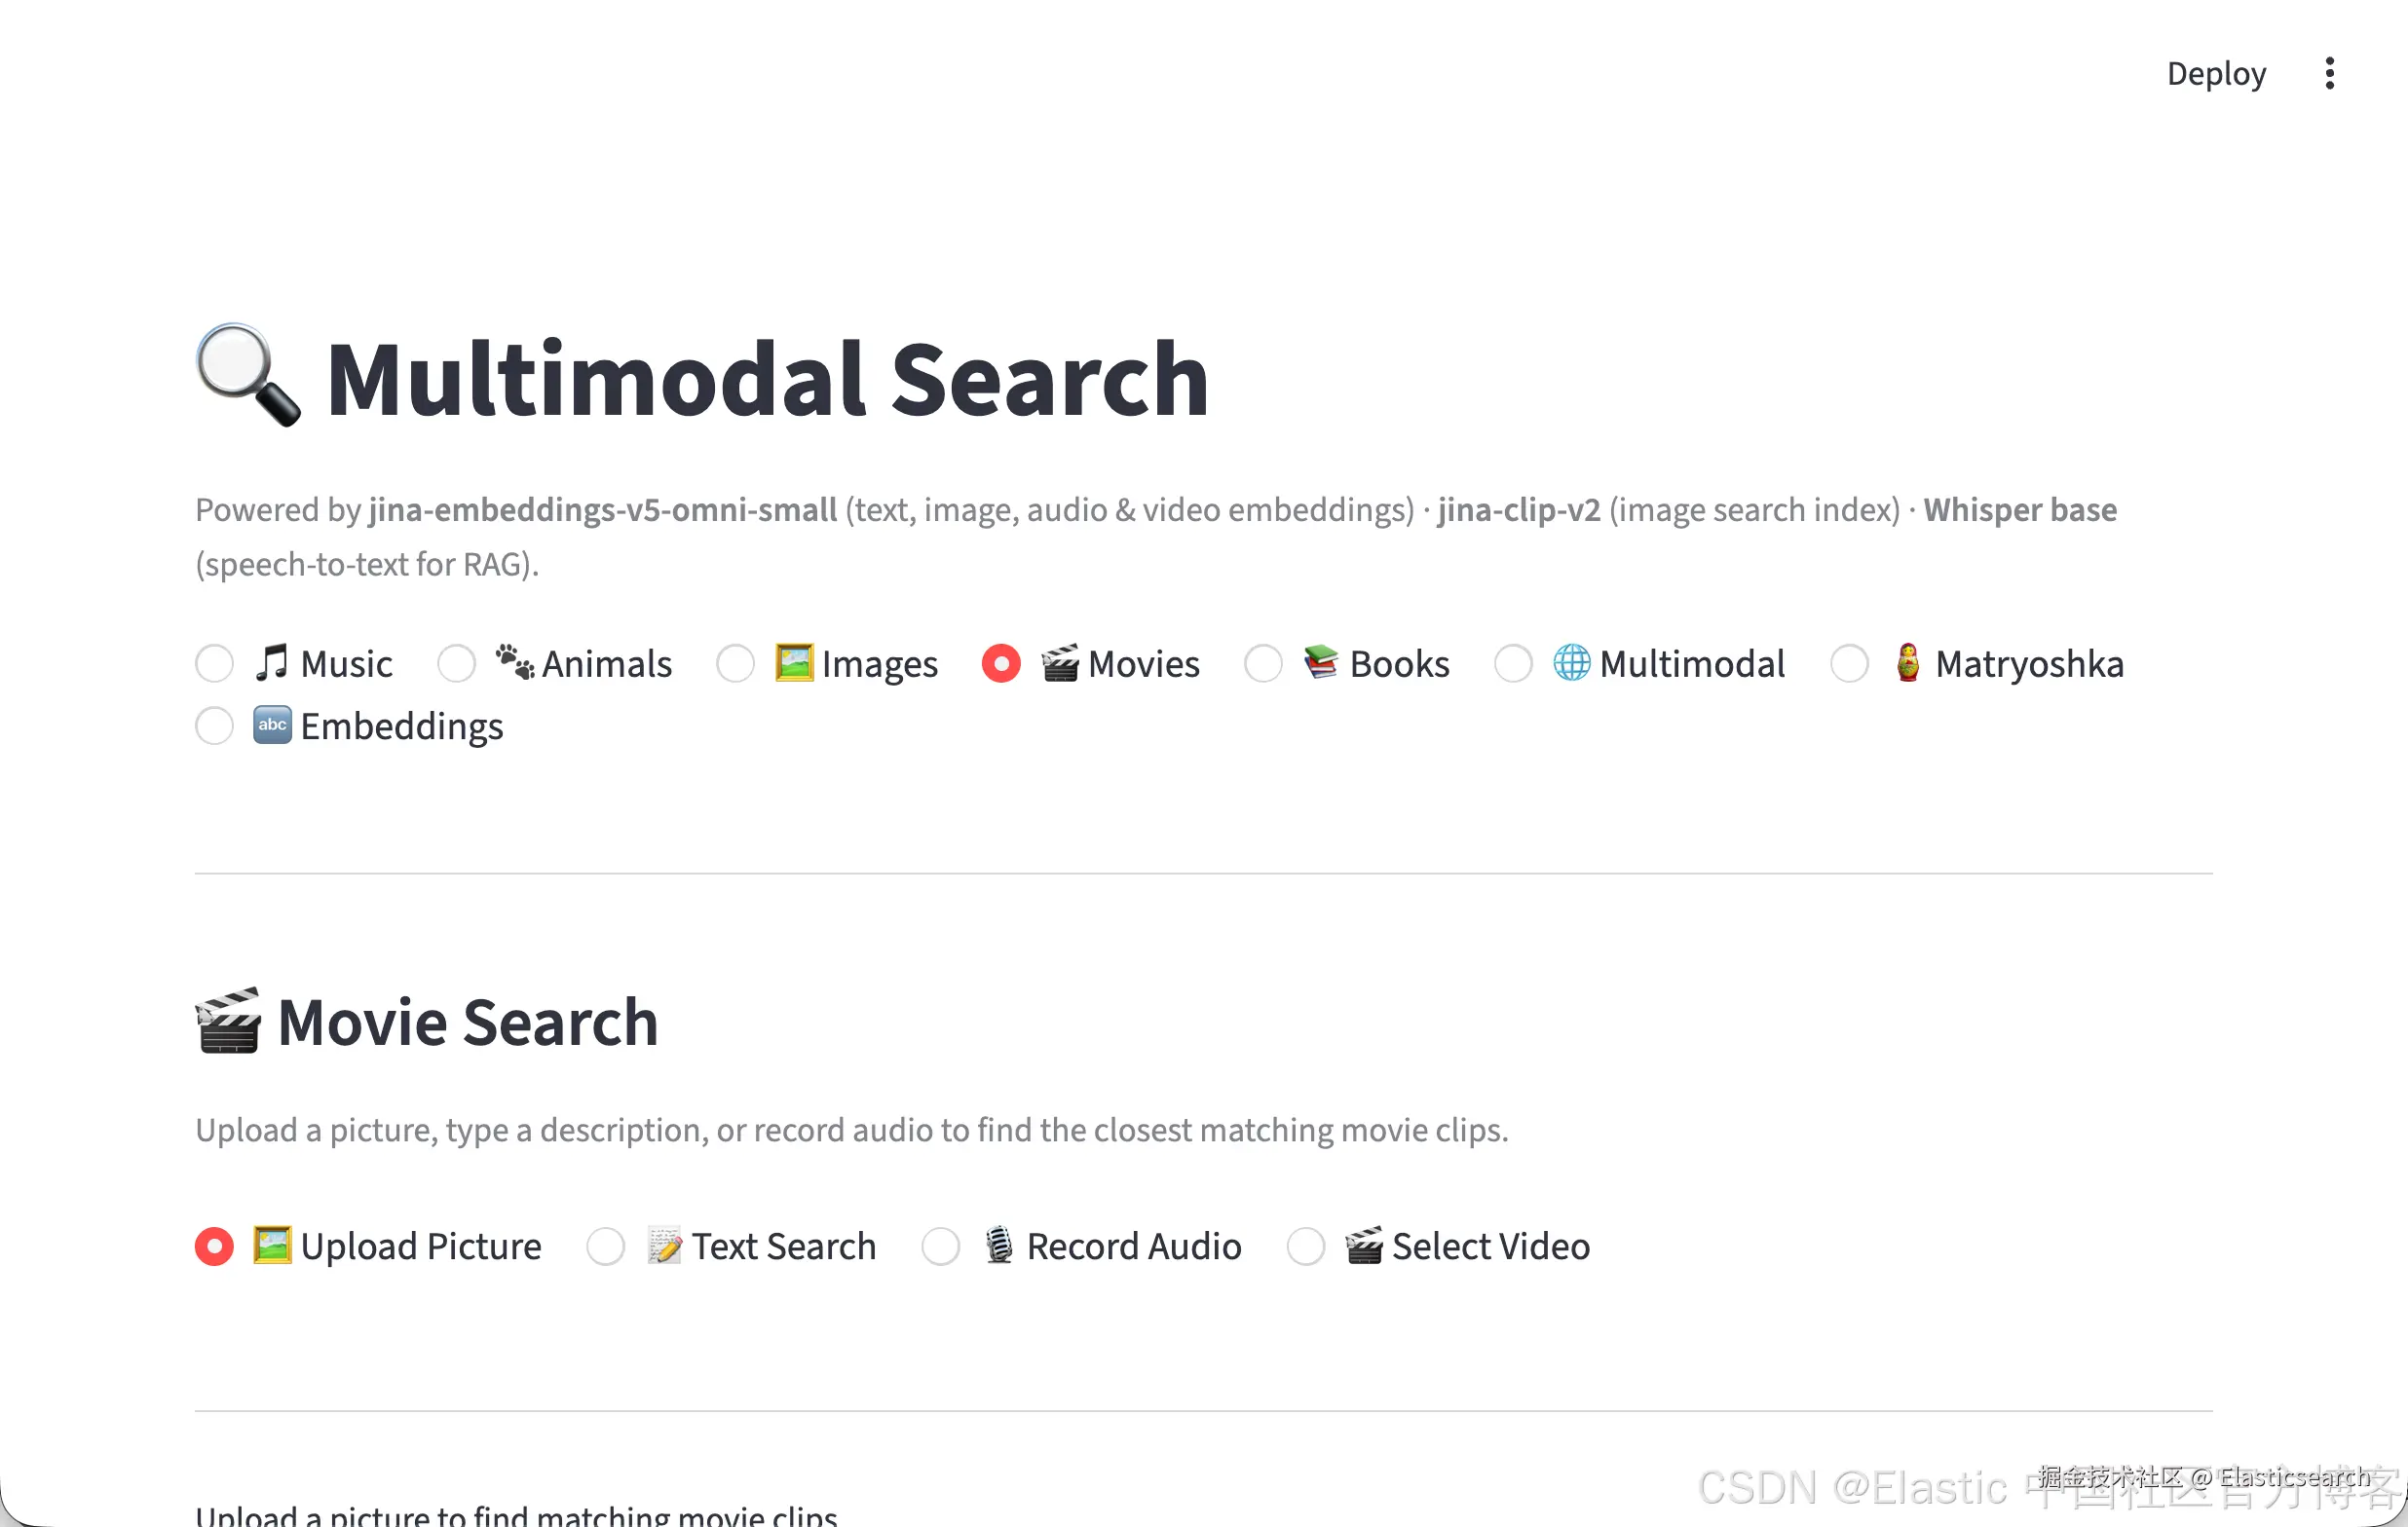
开源项目 elastic_multimodal_search(作者:刘晓国 / liu-xiao-guo)给出了绝佳示范。该项目结合了 Elasticsearch 的高性能分布式 向量索引 能力与 Jina AI 的多模态 Embedding 模型体系,打造了一个涵盖 音乐、动物、图像、电影、图书、多模态、套娃降维、向量可视化 等 8 大模式的 Streamlit 开源演示平台。
本文将深度解析该项目的架构设计、核心技术亮点及 8 大搜索场景实现。
 www.bilibili.com/video/BV1tL...
一、 系统架构与核心技术亮点
elastic_multimodal_search 的核心理念是将**不同模态的数据映射到同一个向量空间(Shared Embedding Space)**中,再利用 Elasticsearch 的 k-NN 向量检索 与 BM25 词法检索 进行融合匹配。
1. Jina AI 多模态模型矩阵
项目集成了 Jina AI 多款先进的前沿模型:
jinaai/jina-embeddings-v5-omni-small:处理文本、图像、音频与视频的主力多模态向量模型。jinaai/jina-embeddings-v5-omni-small-retrieval:专门适配套娃(Matryoshka)截断检索。jinaai/jina-clip-v2:高性能图像与文本跨模态匹配模型。jinaai/jina-embeddings-v4:用于词向量可视化的基础模型。jina-reranker-v3:用于最终检索结果的精细二次重排序(Reranking)。
2. 多检索模式与融合算法
- 词法搜索(Lexical Search):基于标准的 BM25 全文检索,支持英文词干提取与停用词过滤。
- 语义搜索(Semantic Search):对密集向量字段进行 Elasticsearch k-NN 向量匹配。
- 混合搜索(Hybrid Search) :采用倒数排名融合(RRF, Reciprocal Rank Fusion)或线性加权组合(Linear Combination),将传统匹配精准度与向量语义表达力完美融合。
3. Matryoshka(套娃)向量截断与降本增效
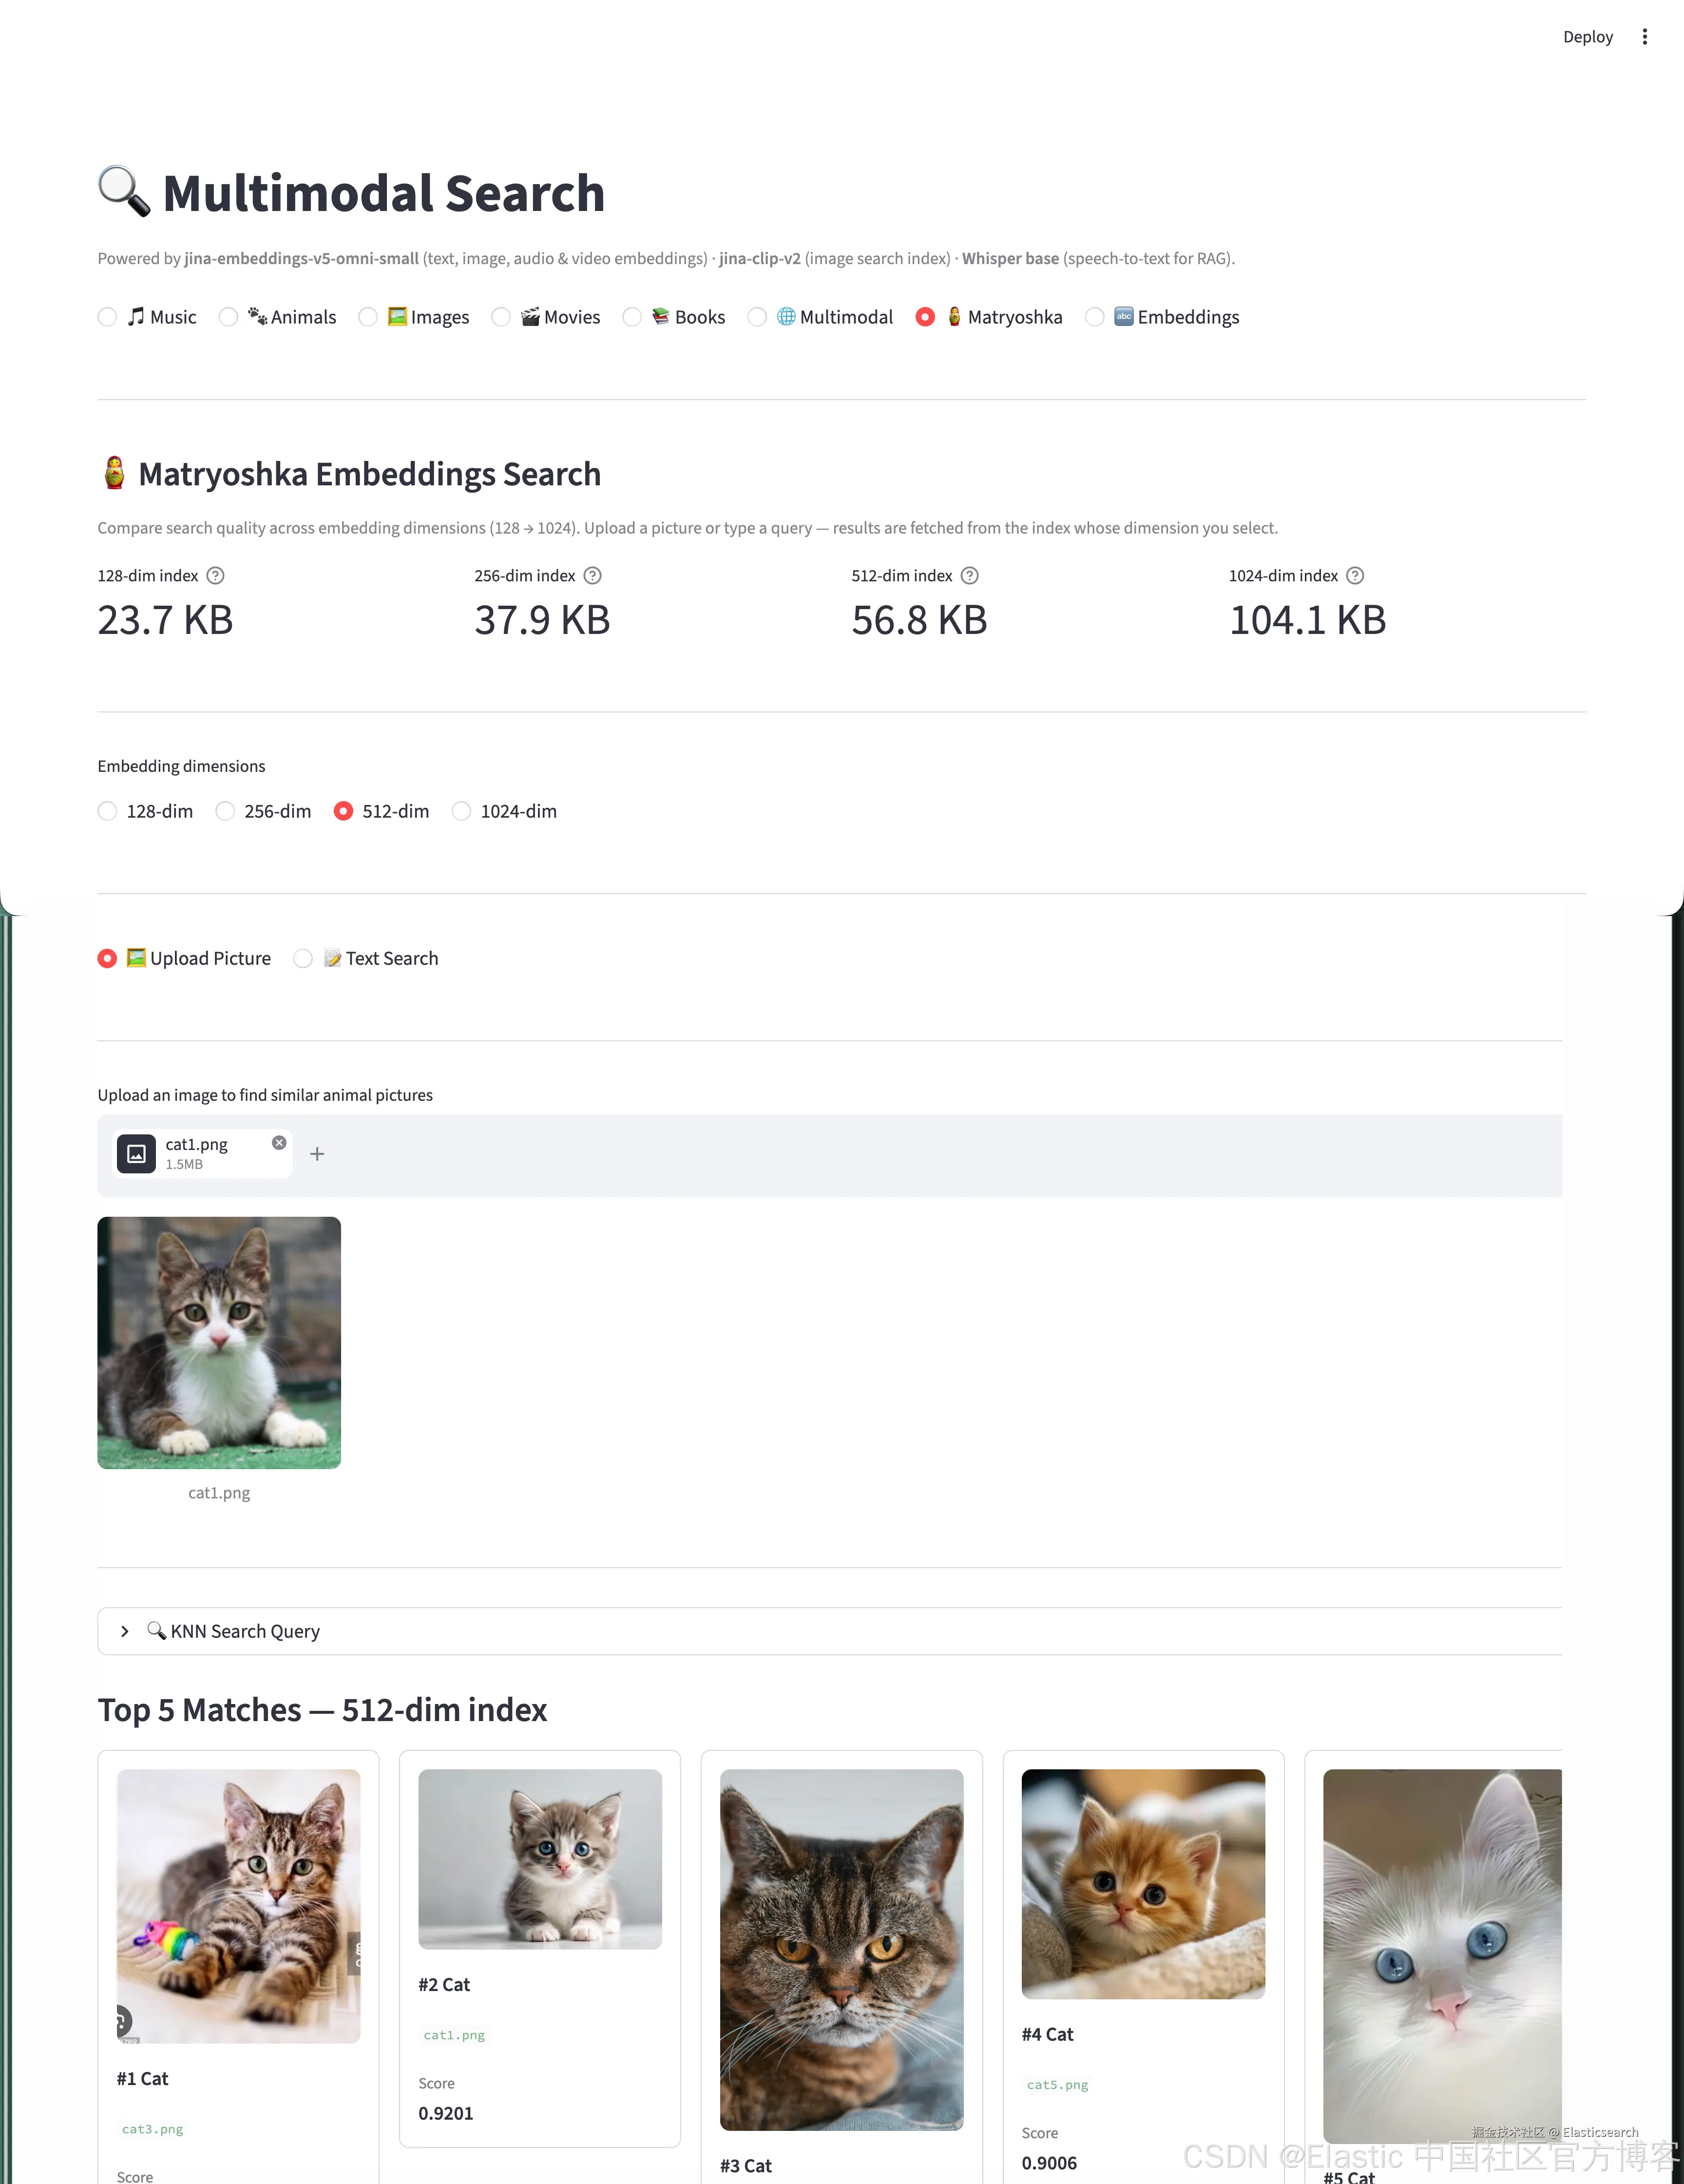
高维向量(如 1024 维)虽然精度高,但存储与计算成本不菲。项目展示了 Matryoshka 嵌入技术 ,可将向量动态截断至 128 / 256 / 512 / 1024 维,帮助开发者在检索精度与系统延迟/存储开销之间找到最佳平衡点。
4. 语音转换与 RAG(检索增强生成)
集成 OpenAI Whisper 模型进行语音识别(Speech-to-Text),配合 OpenRouter (GPT-4o-mini) 或 Google Gemini 3 Flash,实现从"语音输入 → 向量检索 → 大模型总结回答"的端到端接地回答(Grounded Answer)。
二、 8 大核心搜索模式详解
在 search_app.py 构建的交互界面中,包含 8 个针对特定数据集和索引的搜索模块:
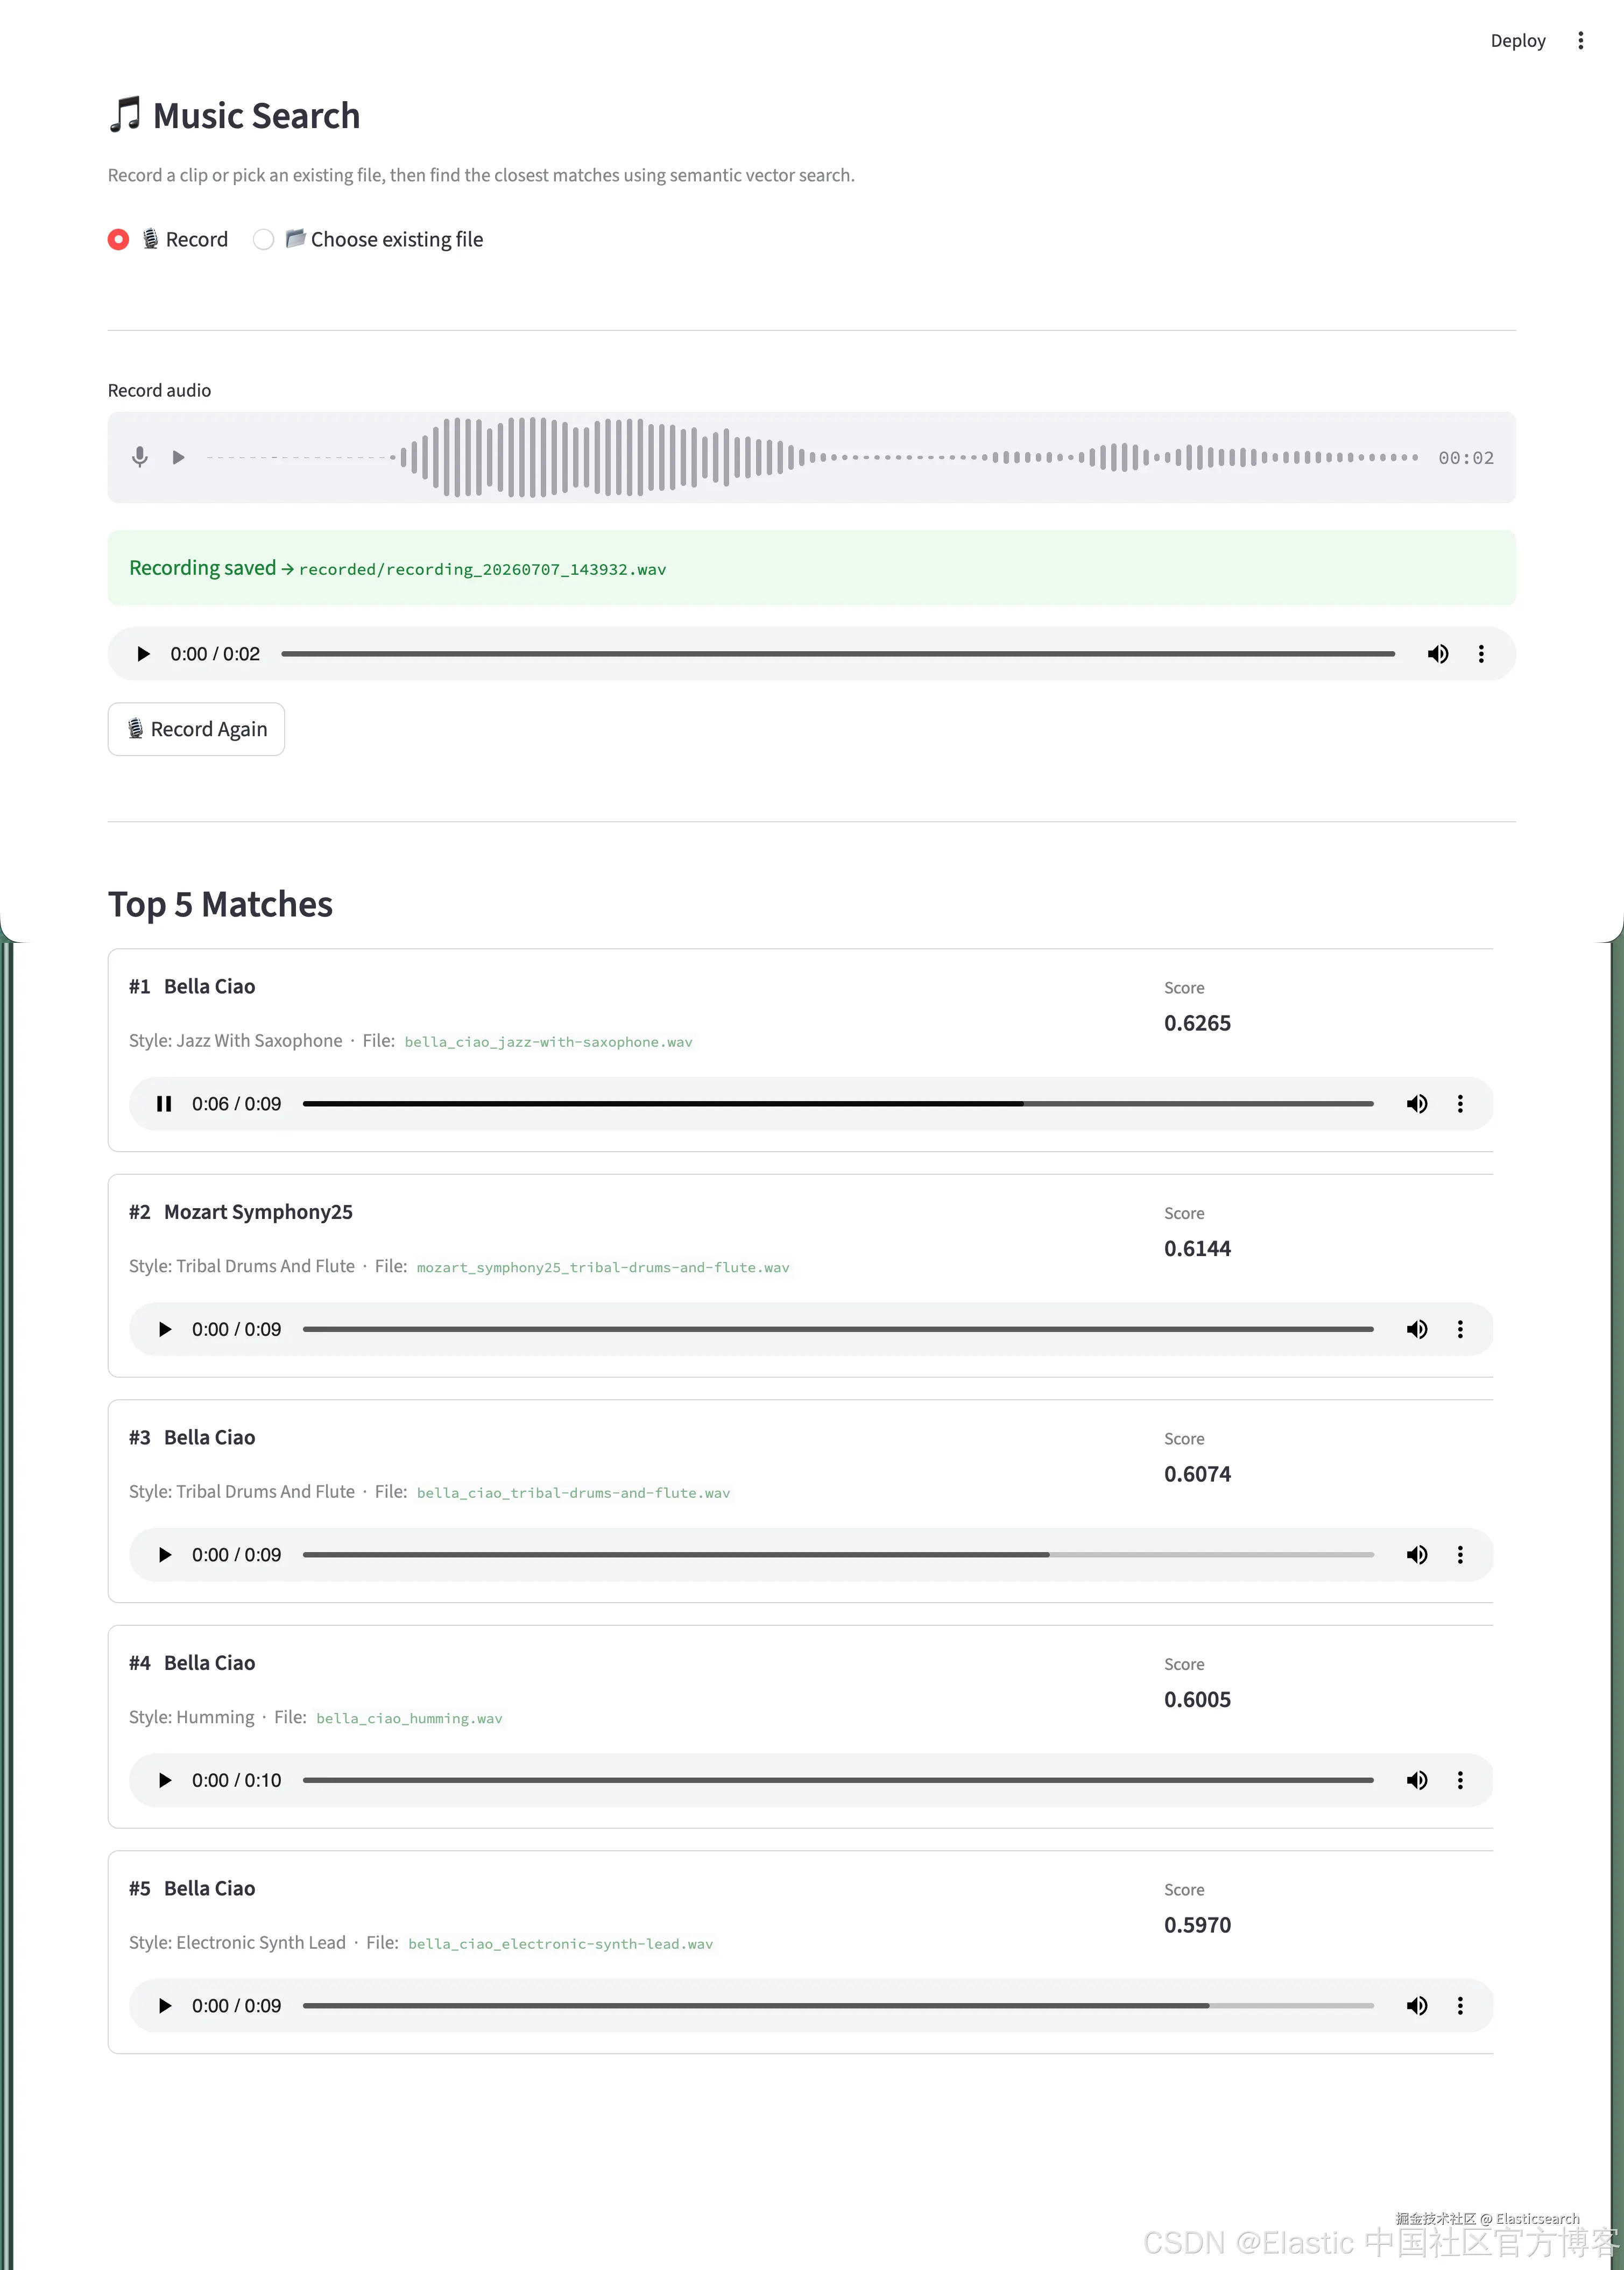
1. 🎵 音乐搜索 (Music Search)
- 对应索引 :
music_embeddings - 实现机制 :既可以通过自然语言文本描述(如 "chill electronic beats for studying"),也可以直接录制/上传一段音频。系统利用音频向量与文本向量共处同一空间的特性,精准匹配音乐库。
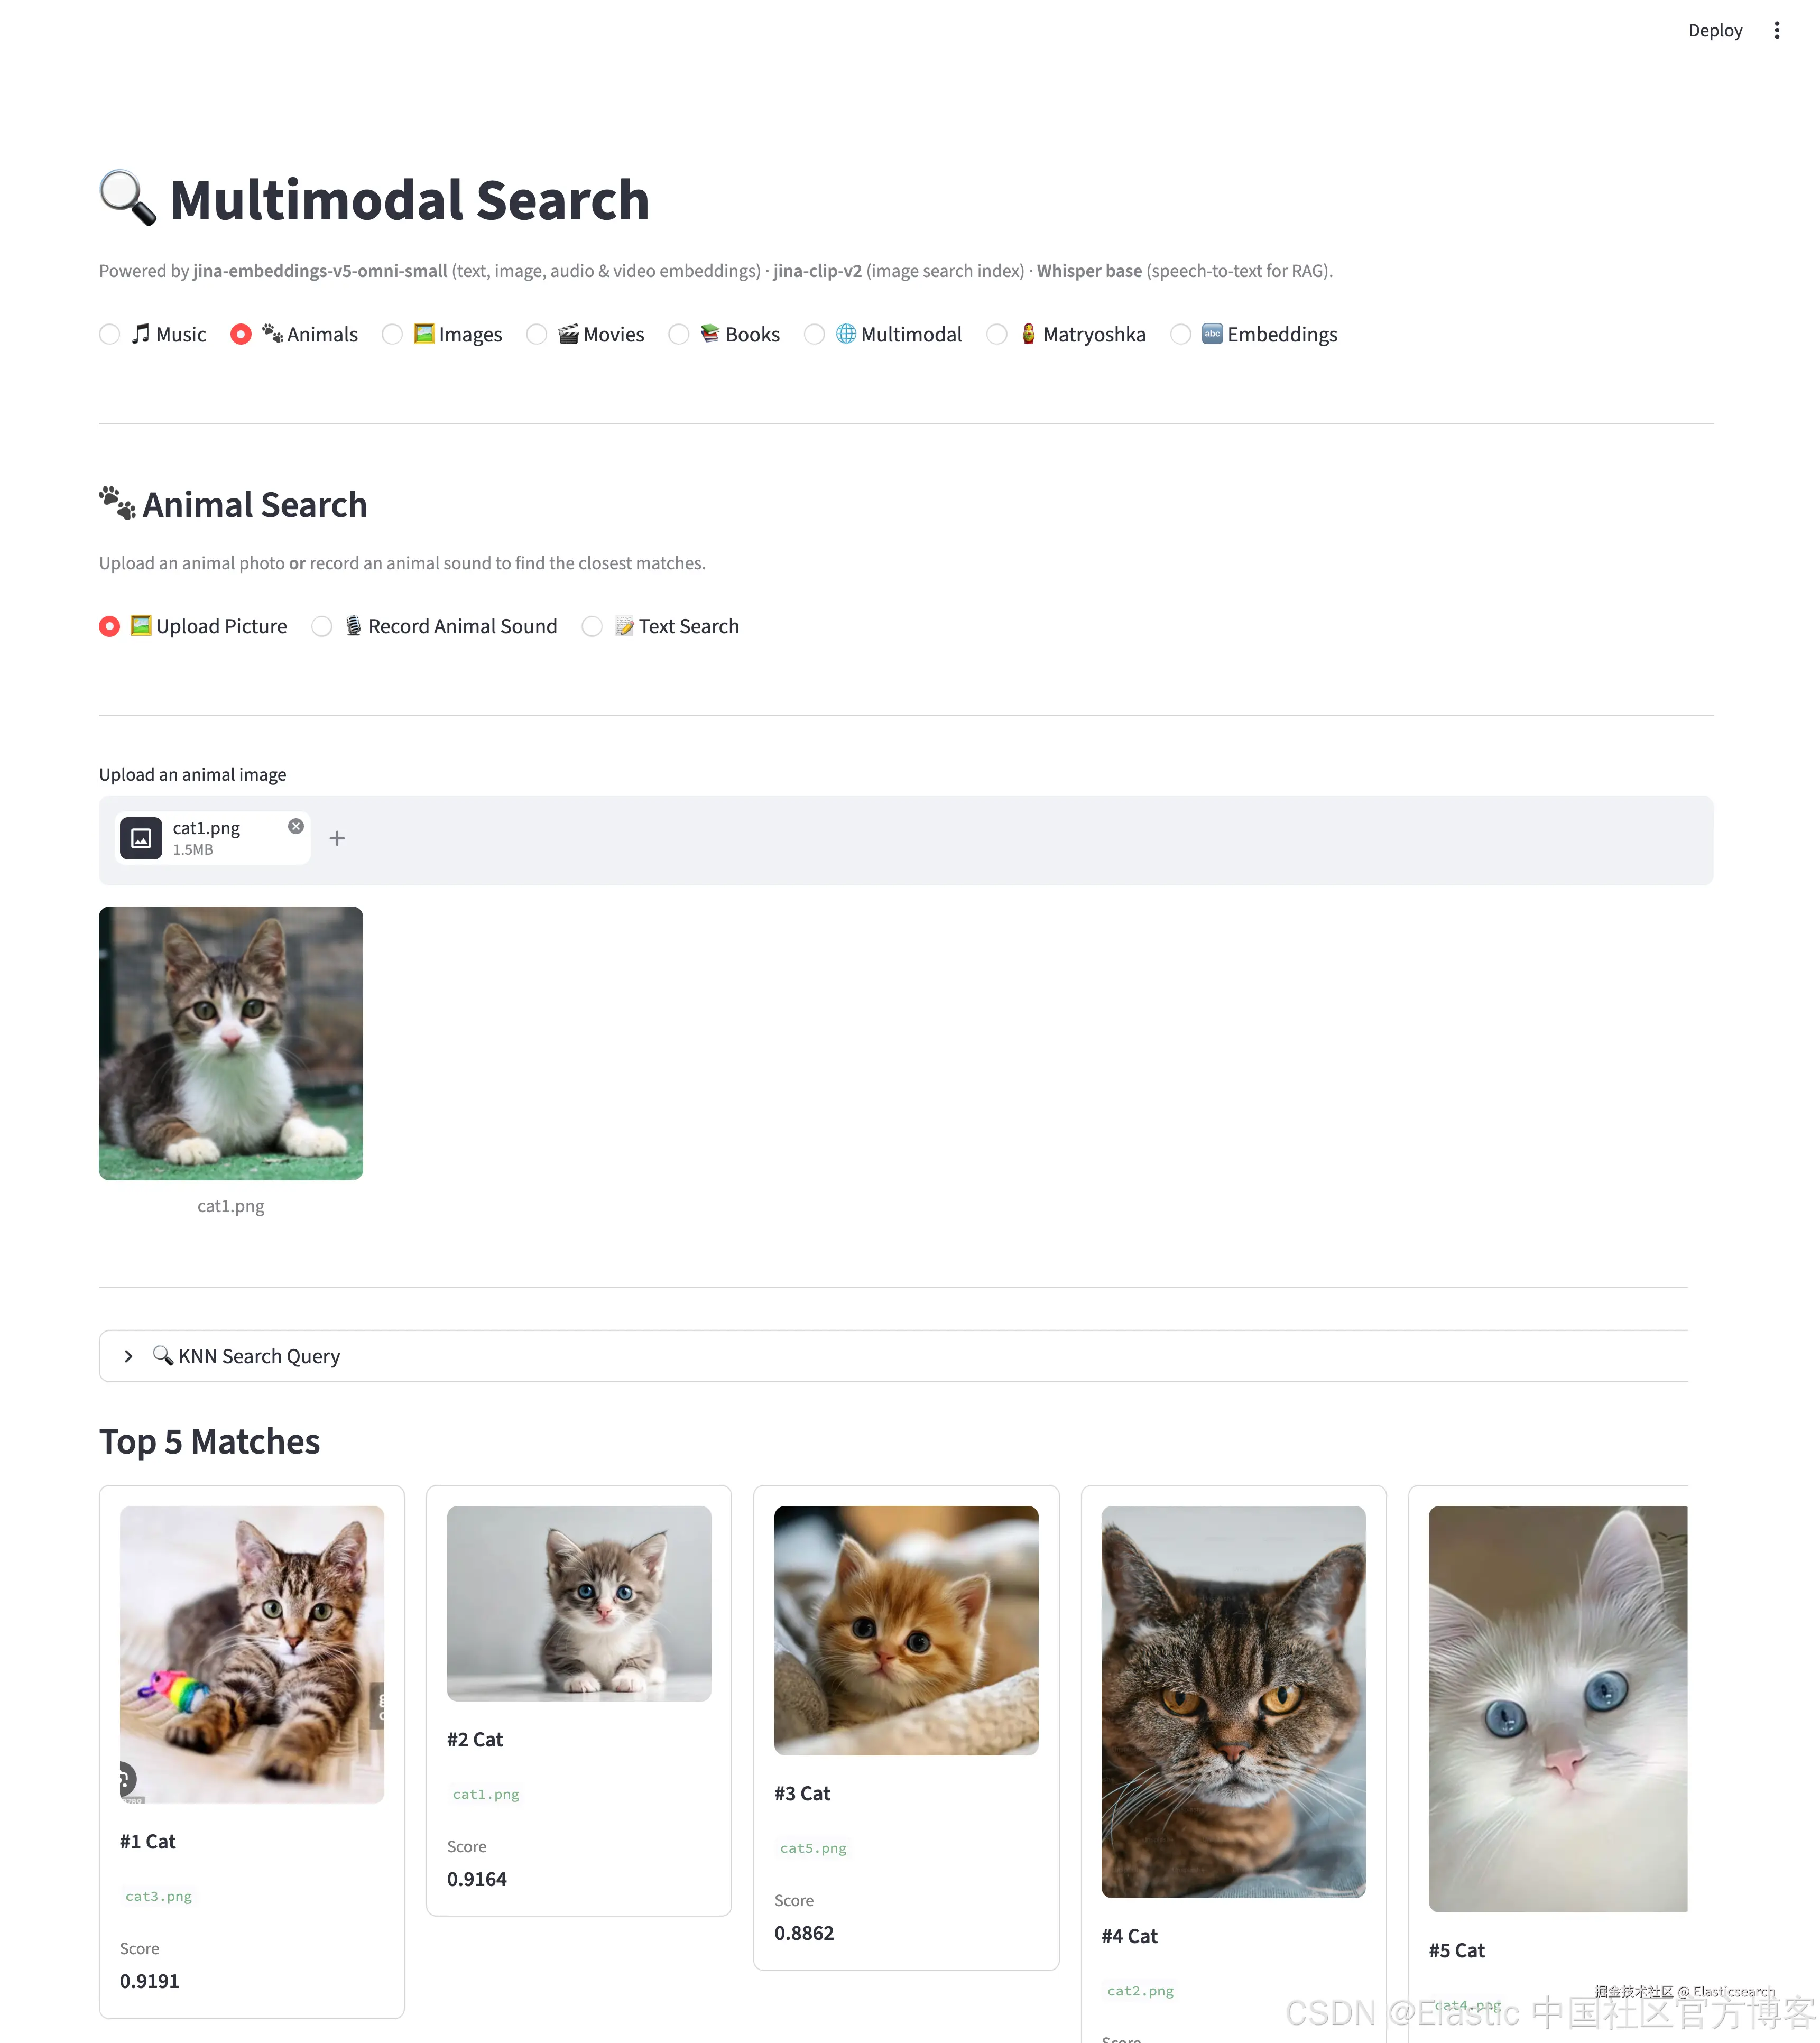
2. 🐾 动物搜索 (Animals Search)
- 对应索引 :
animal_embeddings - 实现机制 :支持以图搜图 、以声搜图/文 、以文搜声/图。例如上传一张狮子吼叫的照片或声音片段,系统能同时检索出对应的动物图像与录音。
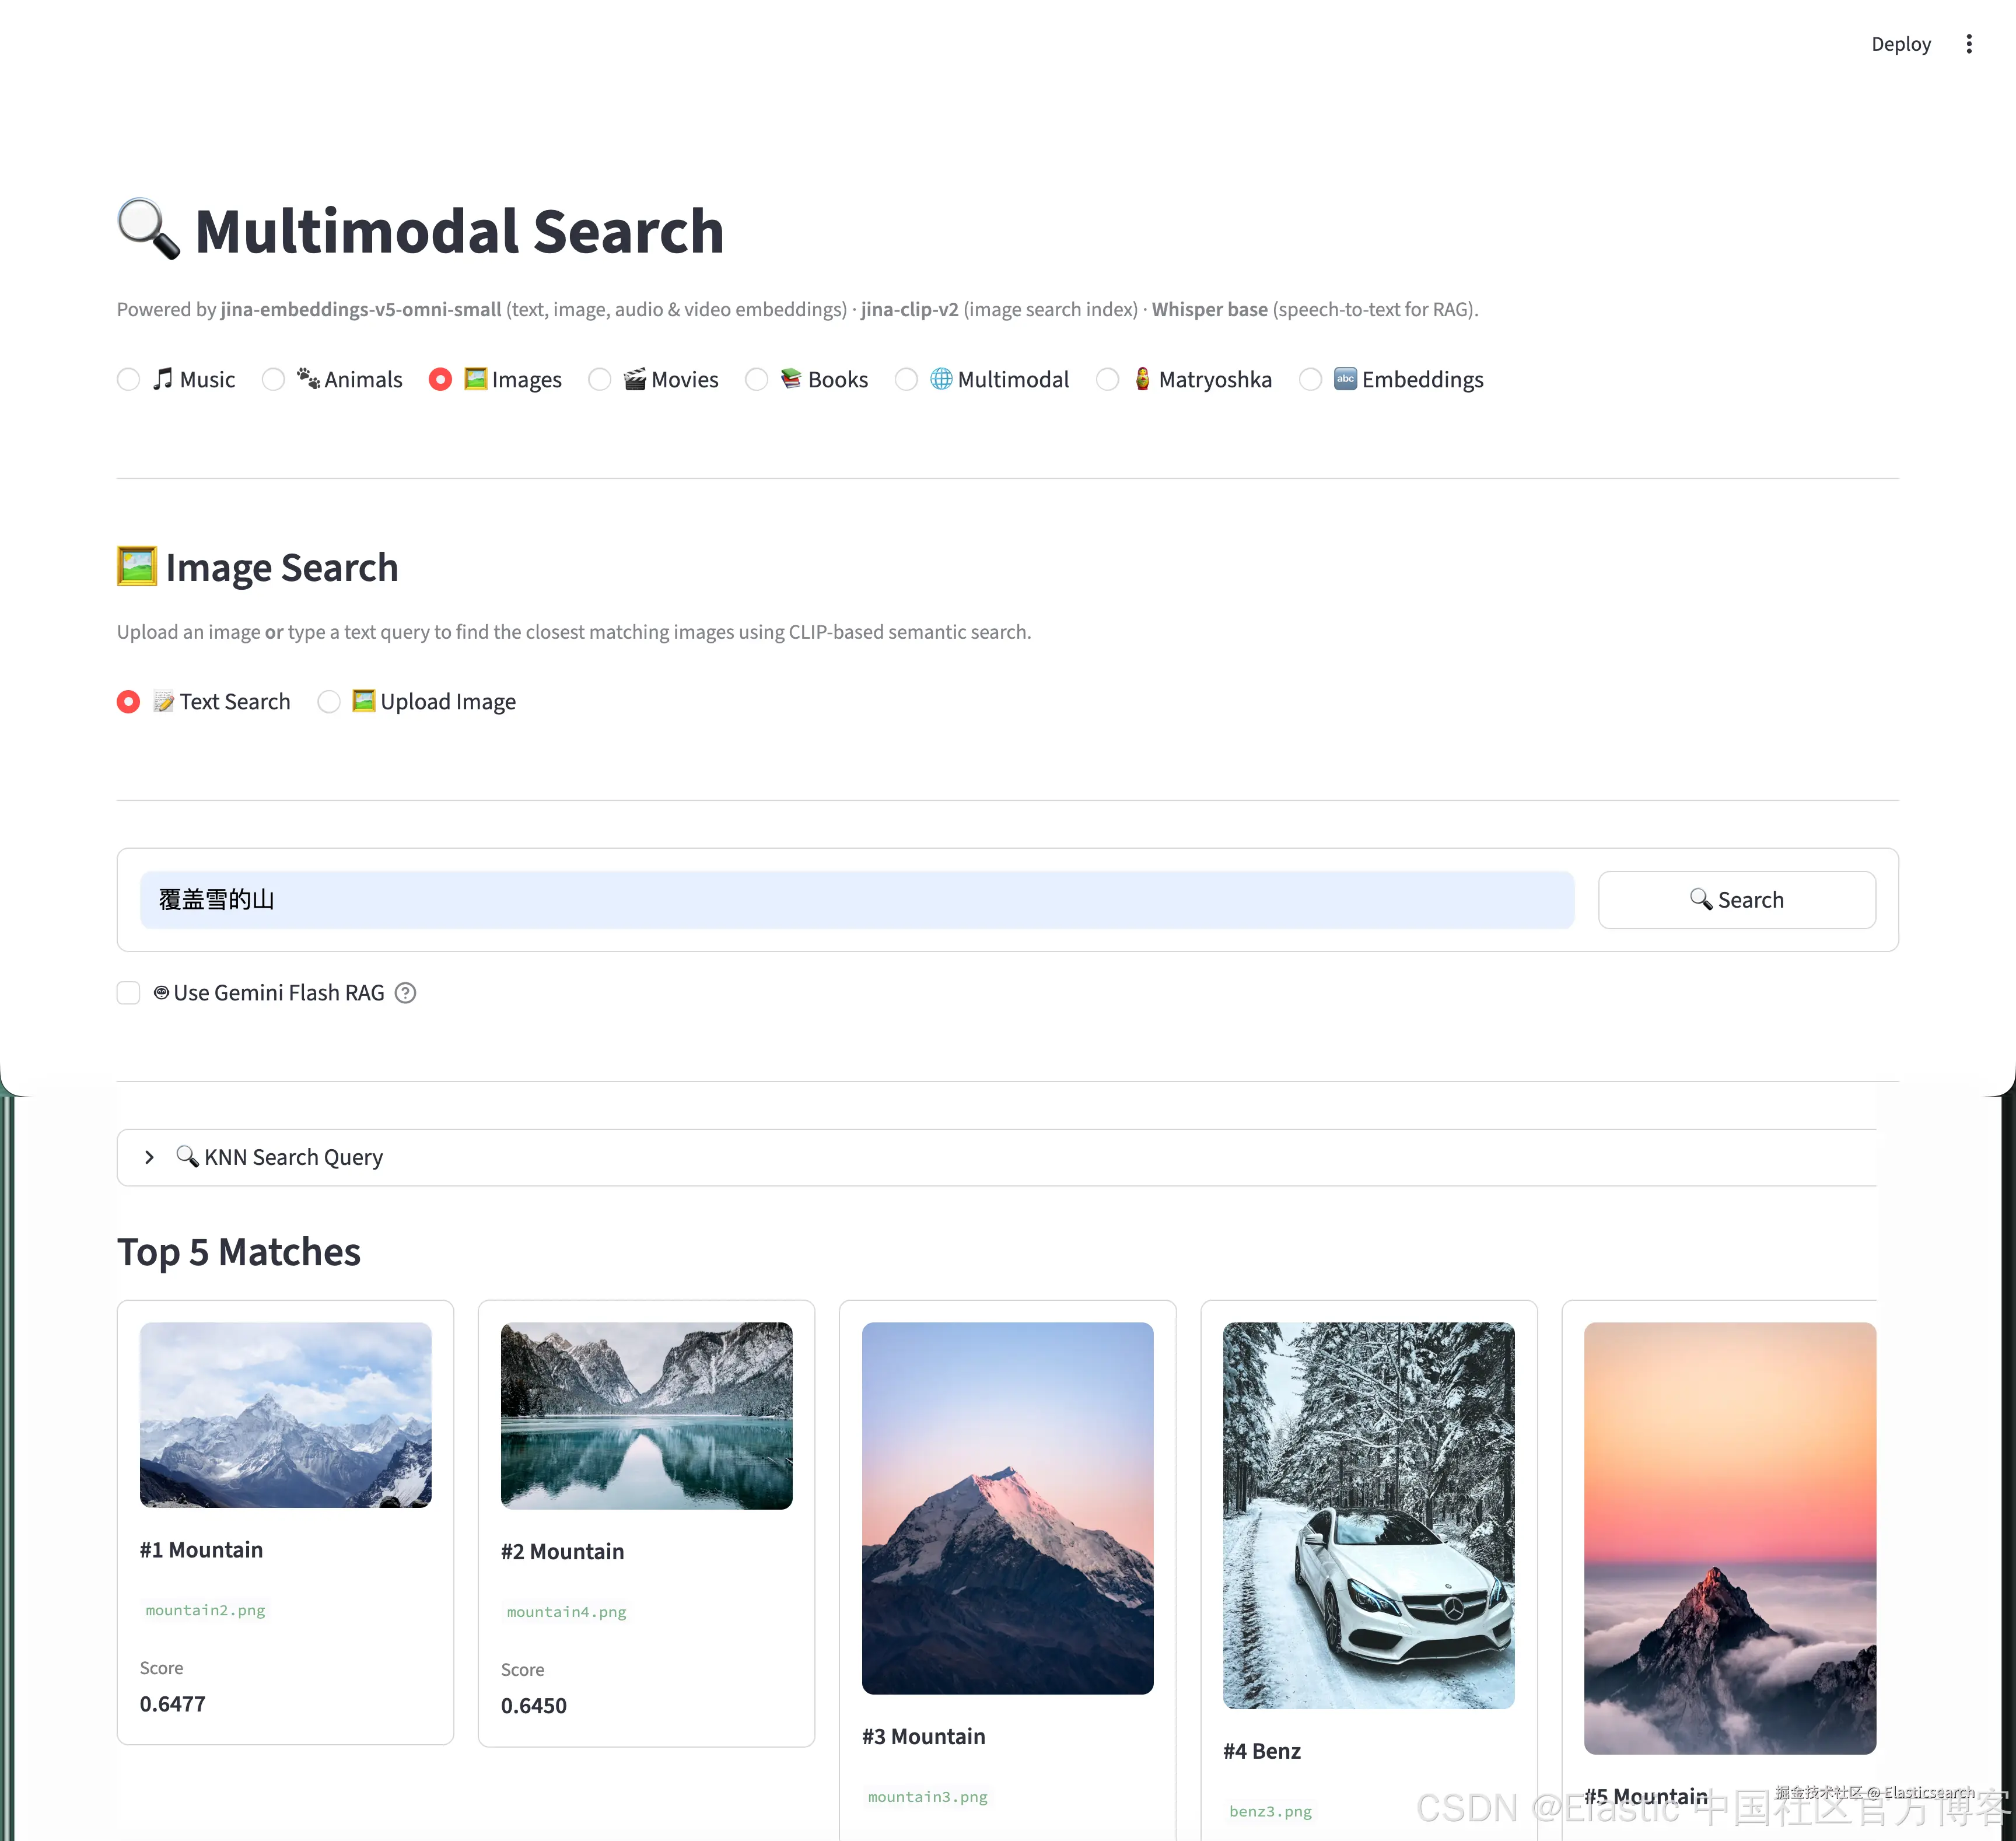
3. 🖼️ 图像搜索 (Images Search)
- 对应索引 :
image_embeddings - 实现机制 :基于
jina-clip-v2模型。用户输入 "a red sports car parked by the ocean" 或上传一张汽车照片,快速查找到图库中最贴切的高清图片。
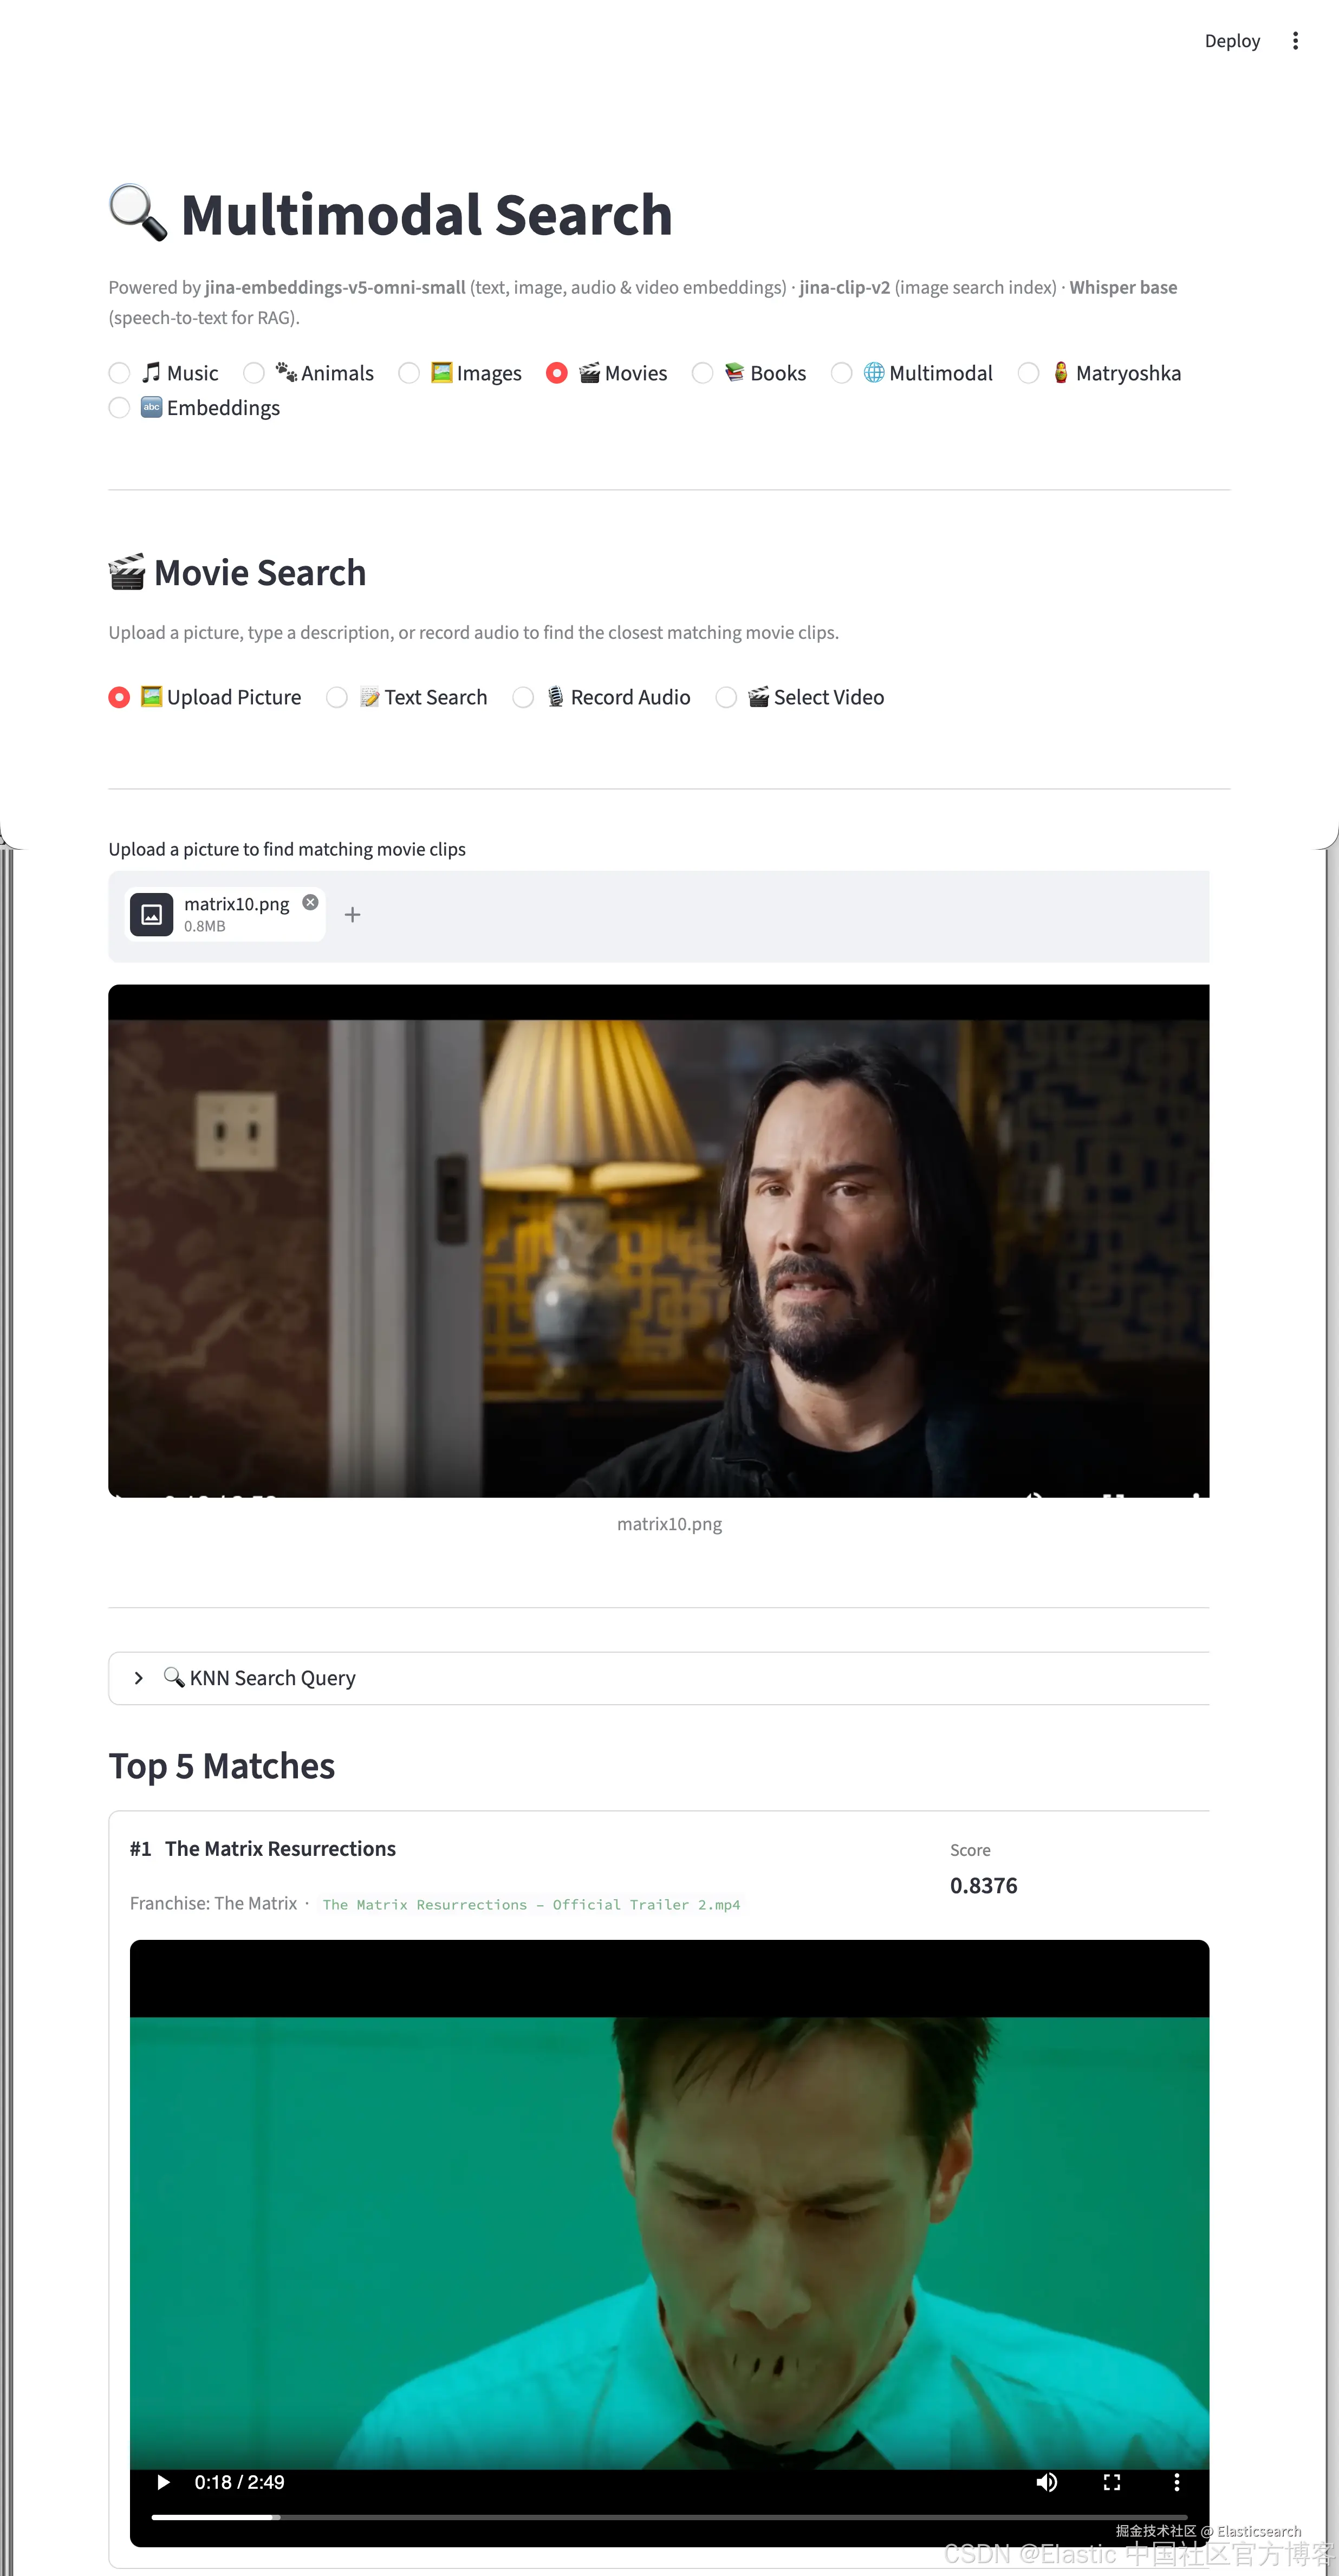
4. 🎬 电影剪辑搜索 (Movies Search)
- 对应索引 :
movie_embeddings - 实现机制:将电影视频提取的关键帧(Video Frames)构建向量索引。支持通过场景剧照、经典台词文本或背景音频来检索电影片段。
5. 📚 图书与 RAG 搜索 (Books Search)
- 对应索引 :
book_embeddings - 实现机制:涵盖词法、语义、混合检索。同时支持语音录音提问,结合 Whisper 转写与 LLM,将检索出的 Top-K 图书片段喂给大模型生成有据可依的解答。
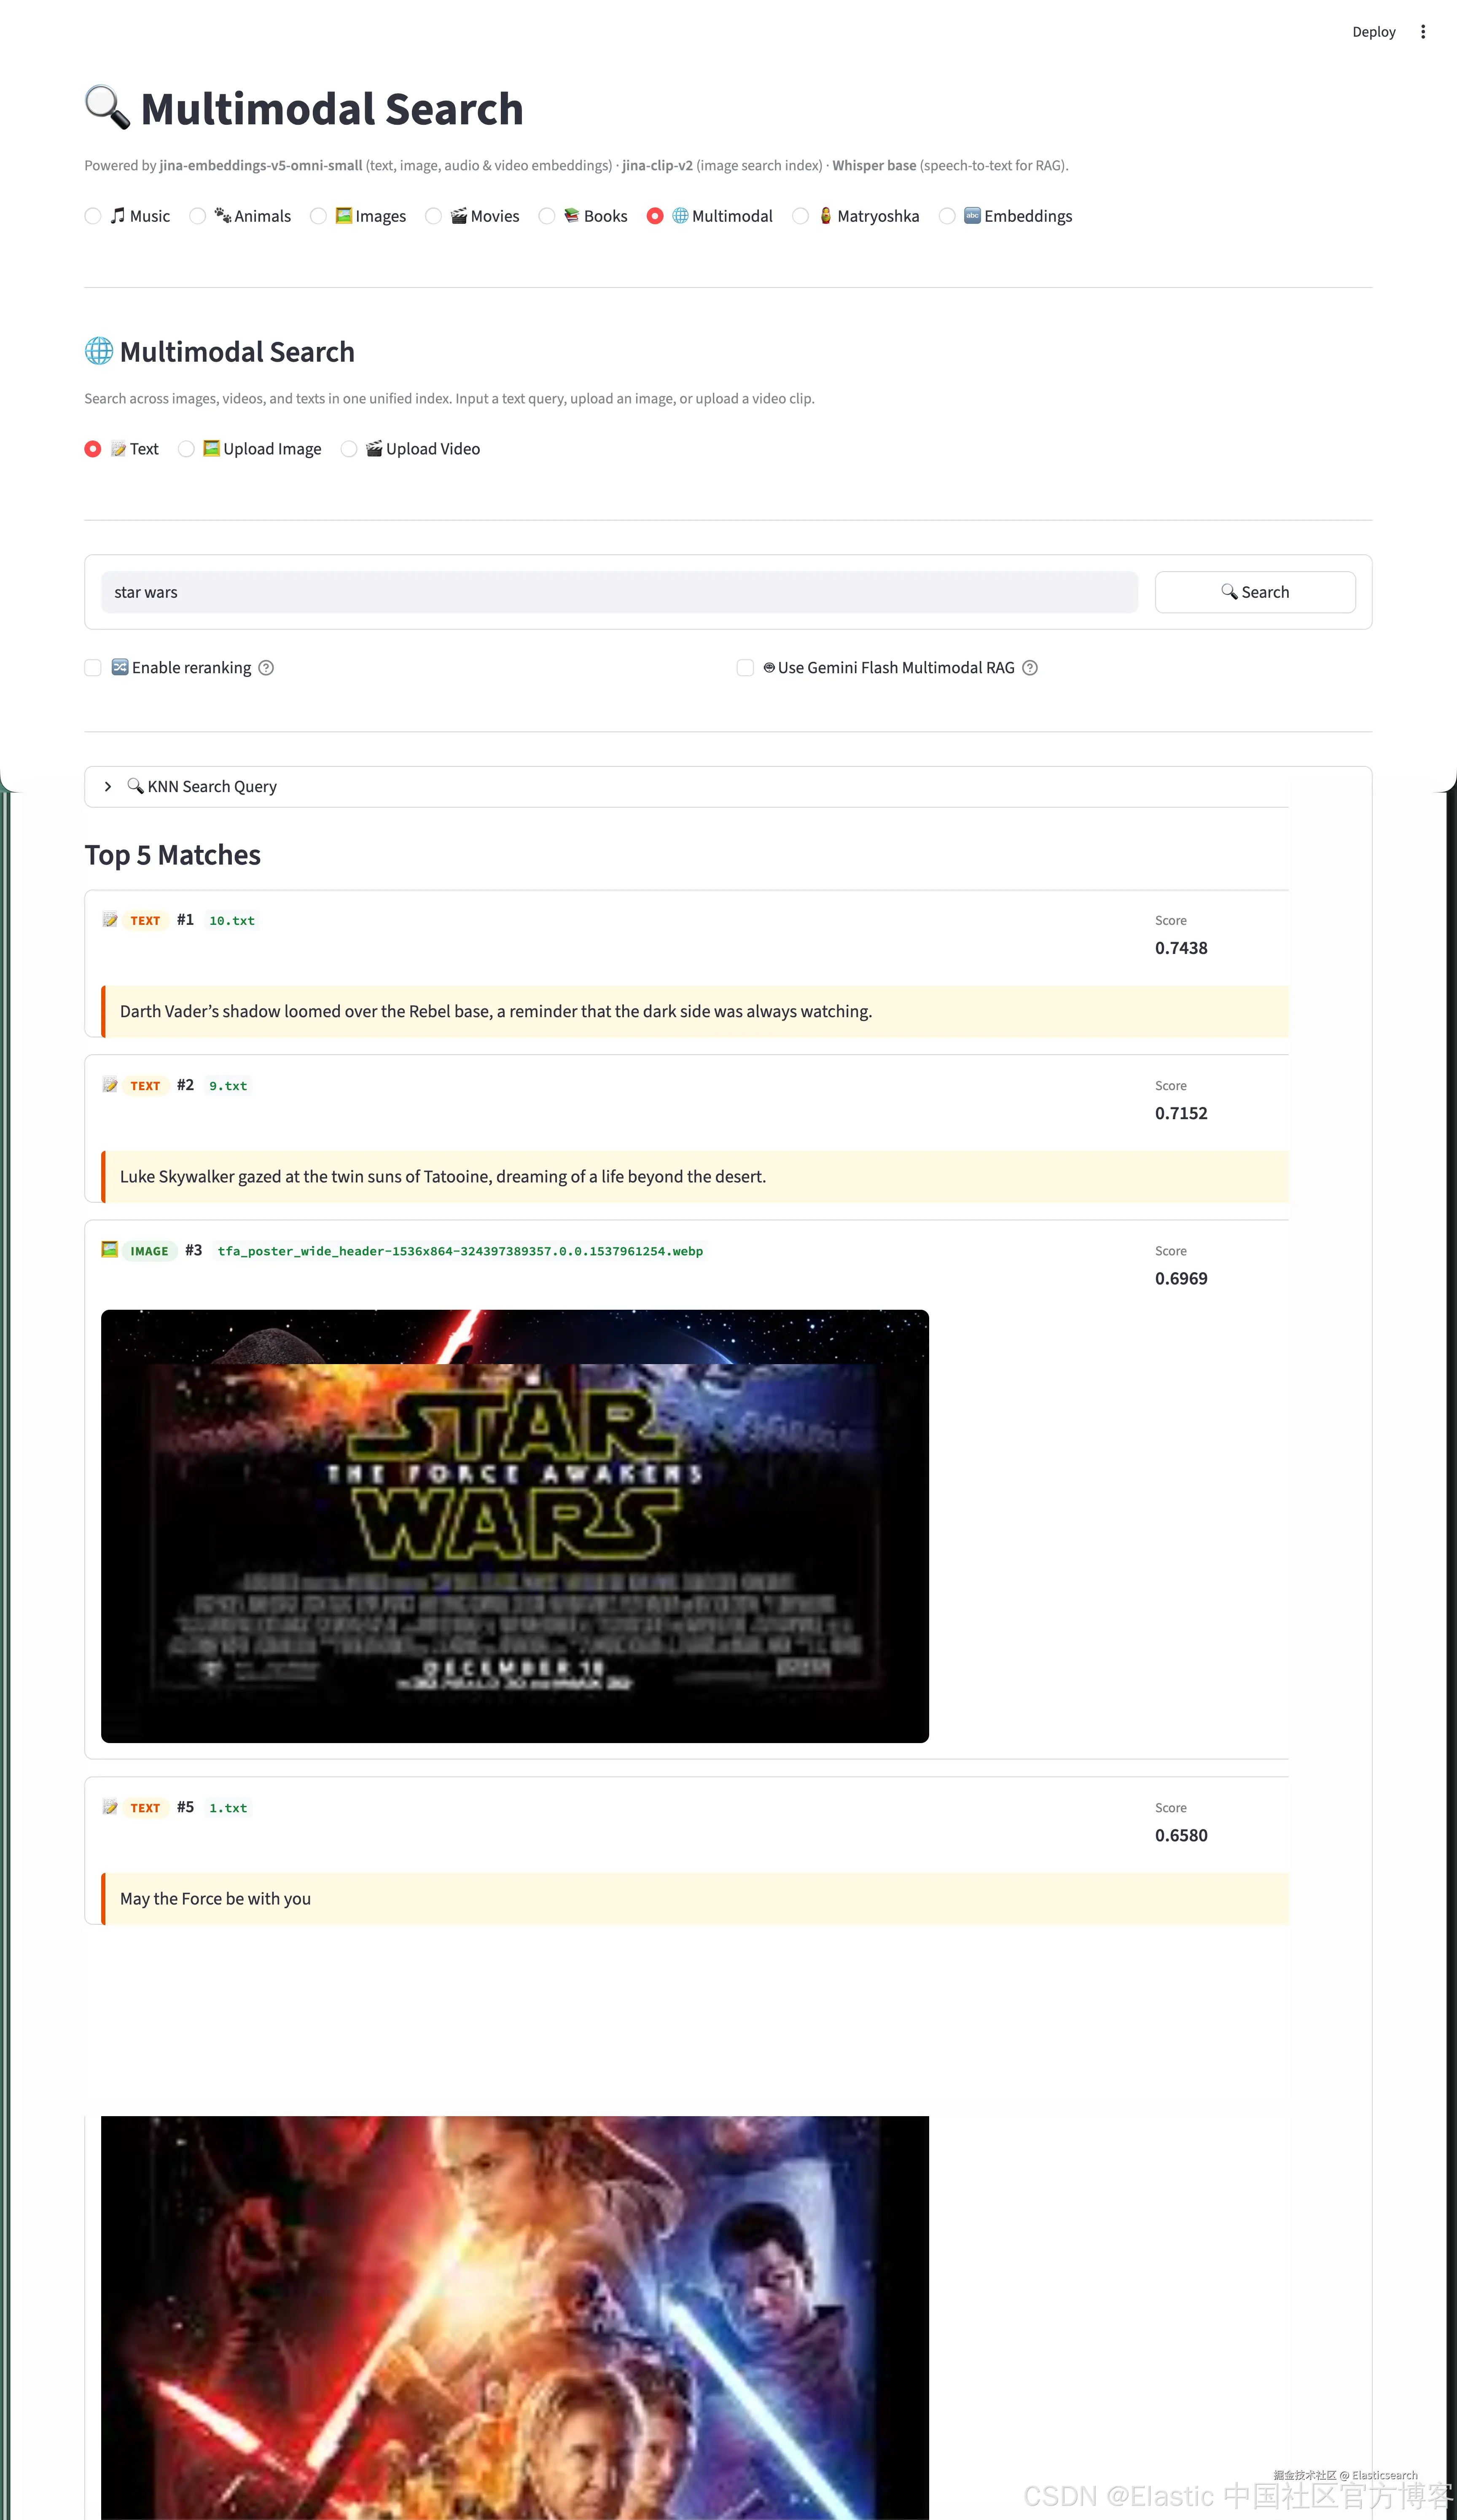
6. 🌐 跨模态综合搜索 (Multimodal Search)
- 对应索引 :
multimodal-embeddings - 实现机制:打破所有数据类型壁垒,在同一个通用索引库中同时对文本、图片、音频进行自由交叉检索。
7. 🪆 套娃嵌入测试 (Matryoshka Embeddings)
- 对应索引 :
music_embeddings(维度截断演示) - 实现机制:提供交互选项,让开发者实时对比相同查询在 128 维与 1024 维下的搜索响应时间与召回结果差异。
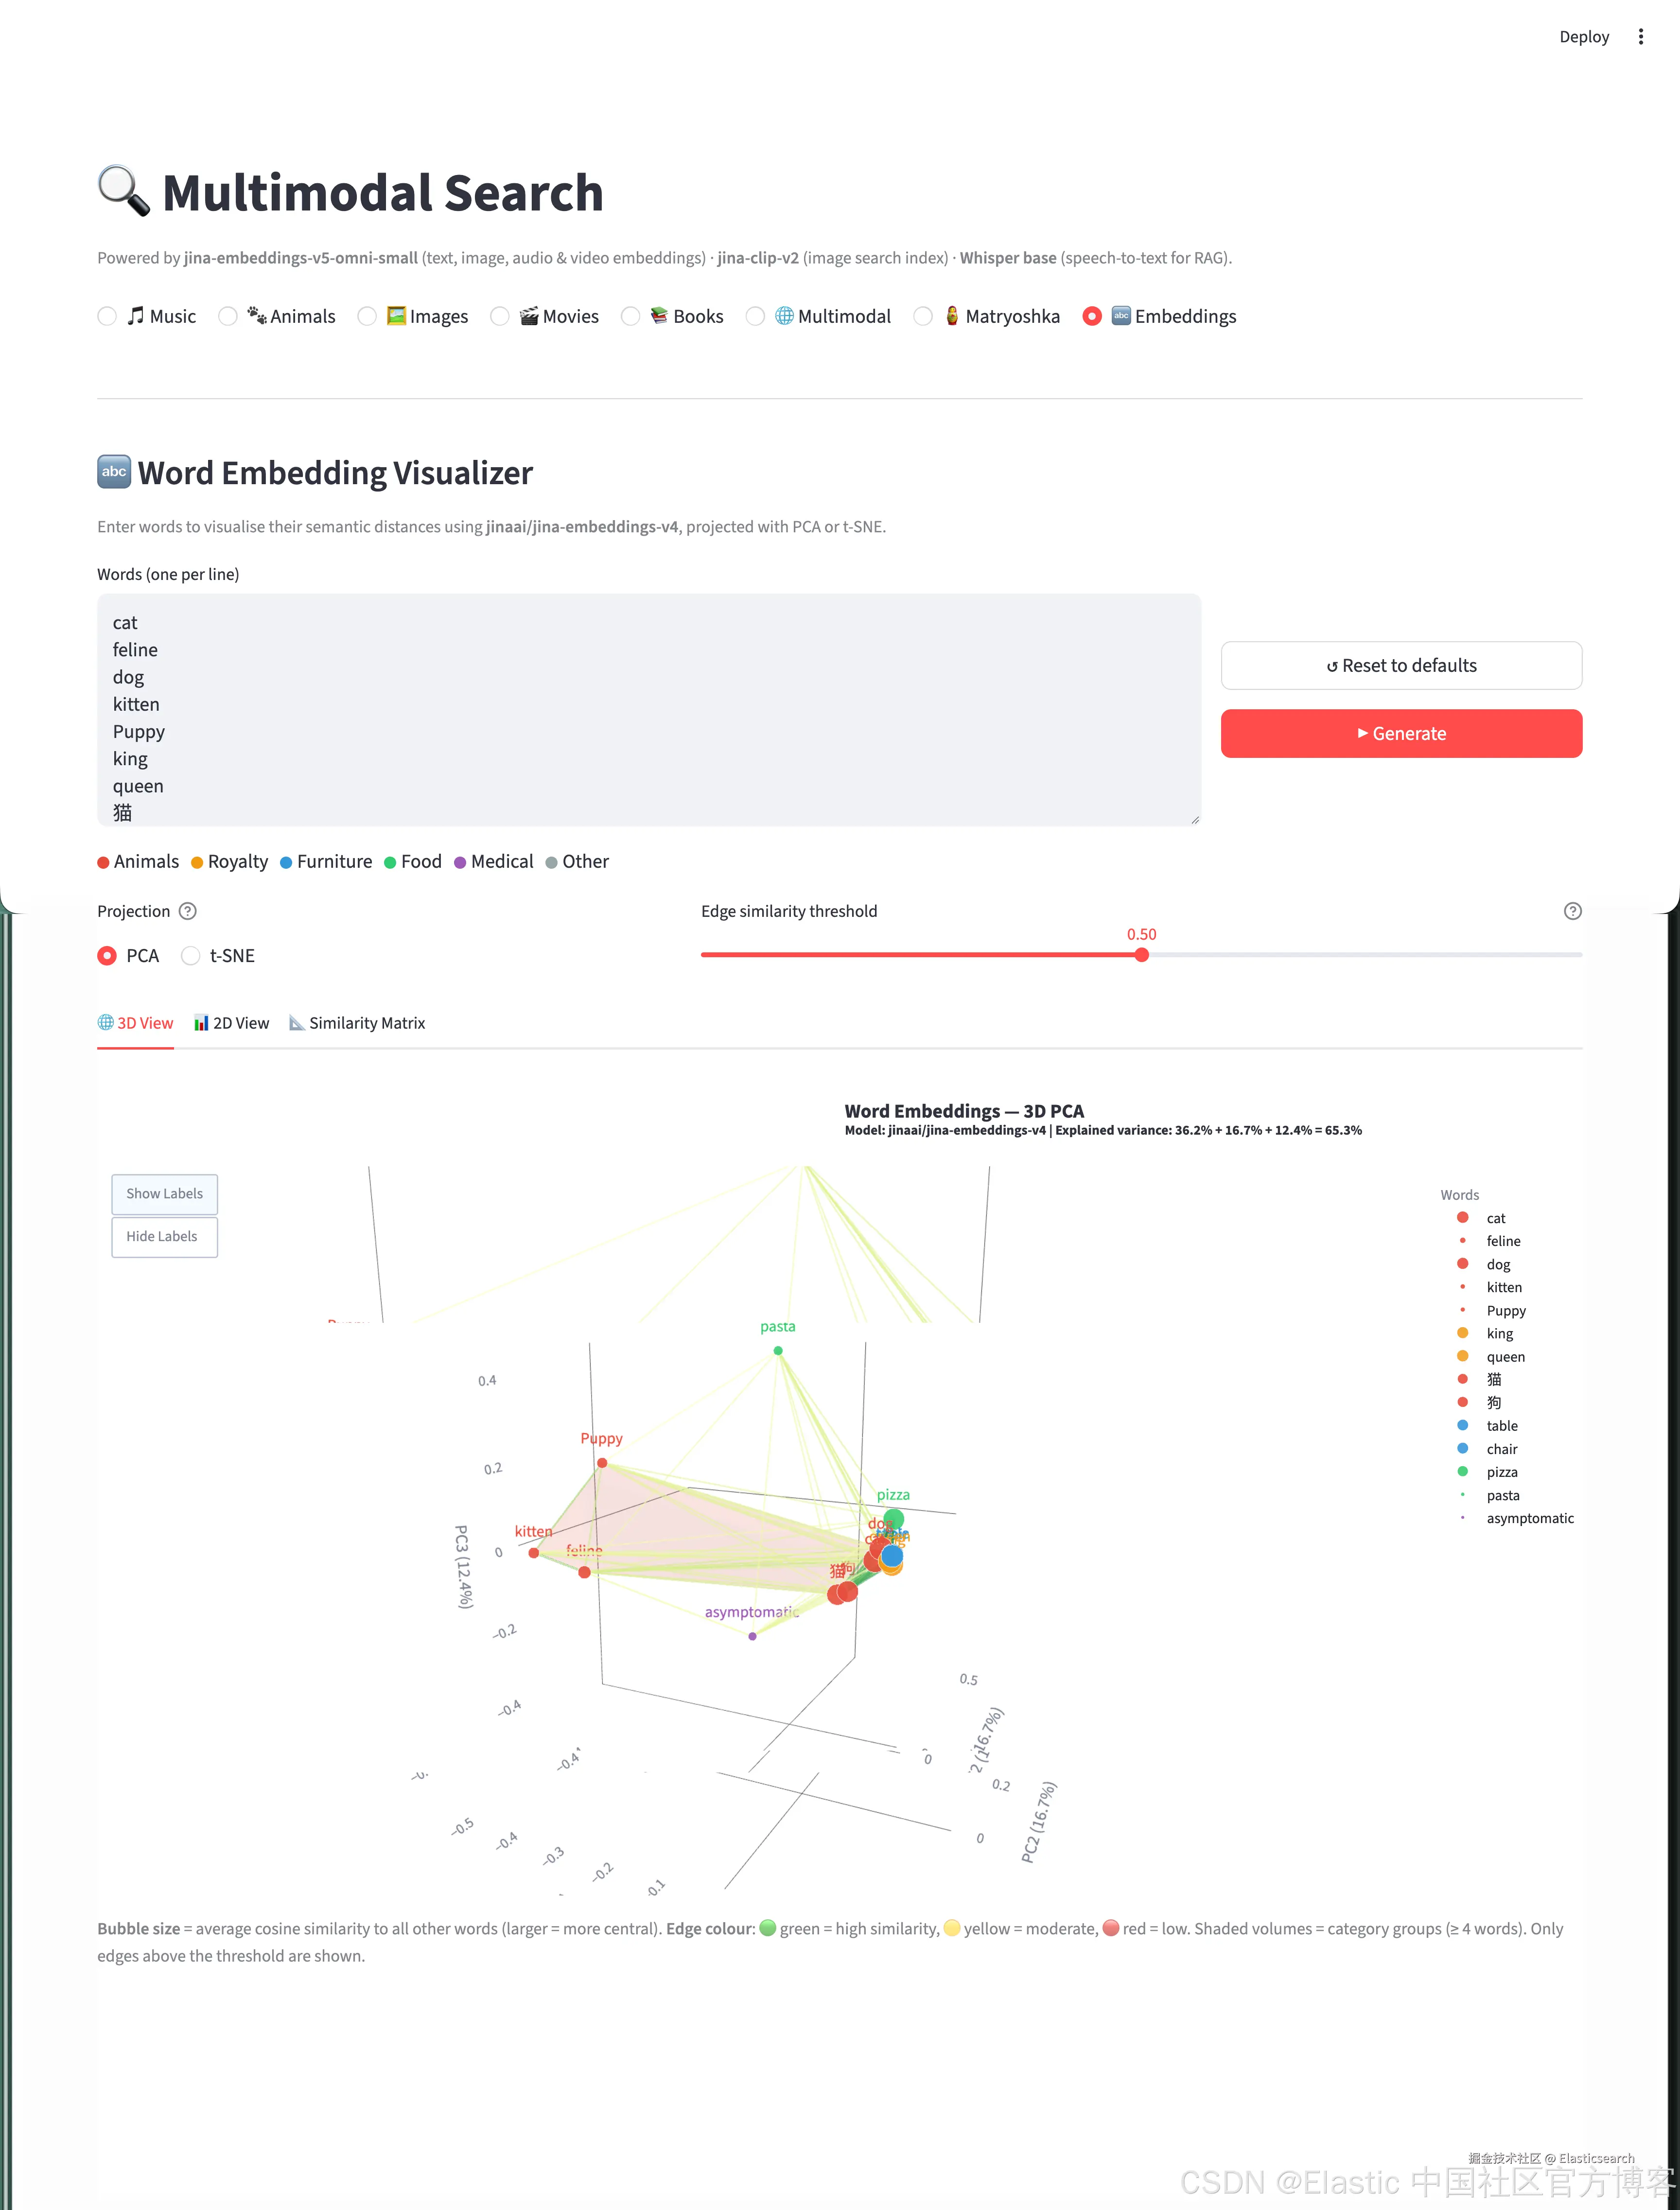
8. 🔤 词向量可视化 (Word Embedding Visualizer)
- 实现机制:内存计算模块,借助 PCA 与 t-SNE 降维算法,在 2D / 3D 空间中动态直观地渲染词向量之间的空间几何距离。
三、 数据写入与快速上手指南
1. 环境准备
项目要求 Python 3.10+ 及可运行的 Elasticsearch 8+ 集群。
bash
`

1.  # 克隆仓库
2.  git clone https://github.com/liu-xiao-guo/elastic_multimodal_search
3.  cd elastic_multimodal_search

5.  # 安装依赖
6.  pip install -r requirements.txt

`AI代码解释
2. 配置环境变量
复制配置文件模板 .env.example 并填写凭证:
bash
`cp env.example .env` AI代码解释在 .env 中配置 Elasticsearch 与 API 密钥:
ini
`

1.  ES_URL="https://<your-cluster>:9200"
2.  ES_API_KEY="<your-elasticsearch-api-key>"
3.  OPENROUTE_API_KEY="<your-openrouter-api-key>"
4.  GEMINI_FLASH_API_KEY="<your-gemini-api-key>"

`AI代码解释
3. 数据写入管道 (Data Ingestion)
在启动 Web 页面前,先运行数据写入脚本将各自目录下的样例数据生成向量并写入 Elasticsearch 索引:
bash
`

1.  python ingest_audios.py       # 音乐音频写入 (music_embeddings)
2.  python ingest_animals.py      # 动物图文音频写入 (animal_embeddings)
3.  python ingest_images.py       # 图片数据集写入 (image_embeddings)
4.  python ingest_movies.py       # 电影视频帧写入 (movie_embeddings)
5.  python ingest_books.py        # 图书文本段落写入 (book_embeddings)
6.  python ingest_multimodal.py   # 跨模态综合数据写入
7.  python ingest_matryoshka.py   # 套娃索引构建

`AI代码解释
4. 启动 Streamlit 应用
arduino
`streamlit run search_app.py` AI代码解释默认会在浏览器打开 http://localhost:8501,即可开始体验全模态搜索。
四、 总结
elastic_multimodal_search 是一个结构清晰、覆盖全面且极具实操价值的开源项目。它不仅展示了 Jina AI 多模态模型 在非结构化数据表征上的强悍性能,也展现了 Elasticsearch 在混合检索(BM25 + k-NN + RRF)以及多模态 RAG 架构上的工程实践。
无论是准备构建企业级智能知识库、多媒体图库检索系统,还是探索音视频多模态推荐,该项目都提供了非常优秀的代码模版与架构参考。